Конечно, тяжело быть химиком уважаемый автор поста! Ведь каждый нормальный химик знает, что оборотней убивает серебро, этакое слегка или не слегка потемнелое, местами до черноты покрытое всякими сульфидами серебра.
Если это действительно оборотни, то как известно у них громадная регенерация и вследствие ускоренный метаболизм, поэтому при попадании в организм солей серебра у них посереет кожа, выпадет клочками шкурка и они скончаются от отравления.
А железо им нанесет просто раны, хотя, конечно, топором можно и расчленить, если ты из родом из Питера)
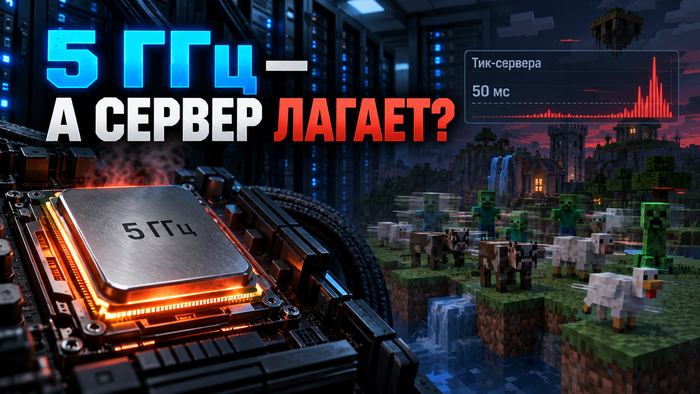
Частота одного ядра и стабильность тика игрового сервера связаны через главный поток. Однопоточная производительность игрового сервера определяет результат, когда именно этот поток задерживает тик. Сравнивать CPU только по GHz нельзя, так как на время тика влияют IPC, кэш, память, серверная сборка и тепловые лимиты.
Почему скорость одного ядра важнее общего числа ядер?
Внутри одного тика работа идёт последовательно: пока главный поток не закончит обновление мира, сервер не начнёт следующий тик. Дополнительные ядра помогают фоновым задачам, но не сокращают эту цепочку. Если сервер упирается именно в главный поток, решает скорость одного ядра под длительной нагрузкой, а не их количество.
Показать последовательную работу одного игрового тика
Тик начинается с набора действий, которые должны сохранить состояние мира. Сервер обновляет сущности и блоки, выполняет запланированные задачи, вызывает код плагинов или модов и обрабатывает часть работы с чанками. Конкретный порядок зависит от серверной реализации и версии, однако следующий тик не может полноценно начаться, пока главный поток не закончит обязательную часть текущего.
Не вся работа проходит на одном ядре. Сетевые потоки принимают пакеты, отдельные пулы могут сжимать данные, загружать или генерировать чанки, а сборщик мусора JVM использует собственные потоки. Результаты фоновой работы всё равно часто нужны главному потоку. Если очередь не готова или требует синхронизации, тик ждёт её завершения.
Скорость прохождения этого участка и называют однопоточной производительностью игрового сервера. Дополнительные ядра освобождают главный поток от части фоновой нагрузки и не дают вспомогательным очередям конкурировать за одно и то же процессорное время. Они полезны, хотя ускорение не становится линейным: восемь ядер не превращают тик длительностью 80 мс в тик на 10 мс.
Отличить паспортный boost от устойчивого effective clock
Гигагерцы в спецификации CPU обычно означают максимальный boost на одном-двух ядрах, а не частоту, которую процессор держит в течение длительного прогона. На это влияют governor, лимиты мощности, температура, число активных ядер и настройки прошивки. В виртуальной машине гостевая ОС иногда видит номинальную частоту или неполные датчики, поэтому показания нужно сопоставлять с телеметрией хоста или условиями тарифа.
Частота CPU и tick rate что-то значат только вместе: записывать их нужно одновременно. Частота без MSPT не показывает, успевает ли сервер закончить тик, а MSPT без сведений о частоте не объясняет просадку из-за троттлинга. Для устойчивого режима нужен прогрев, после которого температура и энергопотребление перестают быстро расти.
На Linux базовую картину дают lscpu, cpupower frequency-info и turbostat. Последний показывает effective clock и температуру лишь на поддерживаемом оборудовании и обычно требует прав администратора. На VPS часть полей может отсутствовать, поэтому сравнение строят по MSPT и данным провайдера.
Почему одинаковые GHz дают разный тик
За один такт разные архитектуры выполняют разный объём работы. На результат влияют IPC, предсказание переходов и задержка кэша. Игровой код часто идёт по цепочкам связанных объектов и обильно ветвится, поэтому промахи кэша и ошибки предсказания случаются часто. Задержка при промахе определяется памятью и кэшем, а не частотой ядра, поэтому два процессора с одинаковыми GHz дают разное время тика.
Рабочая выборка тоже меняет результат. Мир с большим числом сущностей и сложной автоматикой сильнее нагружает кэш и память, чем пустой тестовый мир. Поэтому, например, стабильность тика Minecraft проверяют на копии рабочего мира или на близком воспроизводимом сценарии.
Что лучше предсказывает стабильность тика: частота или IPC?
Ни частота, ни IPC по отдельности не предсказывают стабильность тика. Результат определяет объём работы, который конкретное ядро успевает выполнить в этой сборке при устойчивой частоте. Сравнение по MSPT на одинаковом мире учитывает архитектуру, кэш и память, а выбор по заявленным GHz может поставить процессоры не в том порядке.
Частота против IPC для игрового сервера проверяется только прогоном на конкретной сборке. Синтетический single-core тест сужает список до двух-трёх процессоров, а дальше решает ваш мир и сценарий.
Развести главный поток и задачи, которым помогают дополнительные ядра
Часть нагрузки выполняется вне главного потока. Сеть, сжатие пакетов, отдельные операции с чанками и фоновые задачи плагинов могут использовать другие ядра, если это предусмотрено реализацией. Такие потоки снимают часть работы с главного потока, хотя суммарная нагрузка на процессор всё равно растёт. Доступ к состоянию мира по-прежнему часто требует серверного потока, поэтому вынести в фон можно не каждую задачу.
Главный поток может ждать результат фоновой работы. Например, генерация чанка в фоне помогает только тогда, когда данные готовы к моменту обращения. Если задача задержалась, ожидание увеличивает время тика. Пауза stop-the-world при сборке мусора тоже останавливает прикладные потоки, даже когда другие ядра свободны.
Поэтому высокое MSPT не стоит сразу объяснять скоростью одного ядра. Профиль может показать ожидание блокировки, загрузку чанка, синхронную запись или паузу JVM. В такой ситуации покупка CPU с более высоким boost изменит меньше, чем устранение блокировки, настройка памяти или перенос тяжёлой операции из критического пути.
Найти tick-bound участок через MSPT и spark
Частота тиков показывает, выдерживает ли сервер заданный темп, но скрывает форму задержек. При цели 20 тиков/с бюджет одного тика составляет 50 мс. Среднее MSPT может оставаться ниже этого значения, когда редкие пики уже вызывают рывки. Поэтому вместе с медианой нужны p95 и p99 времени тика за один период нагрузки.
Профилировщик spark связывает длинные тики с кодом главного потока. Чтобы профиль что-то значил, сценарий во время съёма должен быть заранее задан и воспроизводим. У tick-bound сервера значительная доля CPU приходится на обработку мира, сущностей или конкретного плагина. Если основное время уходит на ожидание, GC или дисковый ввод-вывод, причина находится в другом месте.
Результат профилирования придётся сравнивать: с другим процессором, с прошлой версией сборки или с чужим замером. Для этого одного скриншота профиля будет мало. Копию мира обычно хранят отдельно, а рядом с ней записывают её идентификатор, версию ядра сервера, список плагинов или модов, онлайн, view distance, simulation distance и описание действий. Распределение MSPT, профиль главного потока и журнал GC должны охватывать один интервал, так как совпадающие временные метки помогают отличить процессорный предел от паузы сборщика мусора.
Уравнять мир, конфигурацию и тепловой режим
Правильное сравнение начинается с копий одного мира и одной серверной сборки. Настройки JVM, RAM, плагины, моды, view distance и действия игроков остаются одинаковыми. Описание стенда содержит цель, например 20 TPS, и онлайн. Каждый такой кандидат проходит минимум три прогретых повтора, а порядок запусков чередуется.
Как правильно измерять стабильность времени тика?
Запустите одинаковый сценарий на копии мира с одной версией сервера, JVM, плагинов и модов.
После прогрева одновременно запишите MSPT, профиль главного потока, effective clock, температуру и журнал GC.
Повторите прогон минимум трижды и сравните медиану, p95 и p99 при одинаковом онлайне и тепловом режиме.
Отдельно записывают и конфигурацию машины: топологию CPU, SMT, governor, лимиты мощности и маску ядер, доступную процессу. В Linux часть данных собирают так:
Число 12345 нужно заменить на PID нужного Java-процесса. taskset записывает его маску и не меняет pinning. На VPS turbostat может не показать температуру или лимиты мощности. Профиль spark должен охватывать те же 180 секунд. Итоговая папка хранит конфигурацию, сырые выводы, профиль и CSV с номером повтора, сценарием, медианой, p95, p99 и effective clock. Если датчик недоступен, поле остаётся пустым.
Оценивать хвост тика и запас роста
Из двух процессоров тот, у которого средний MSPT ниже, может иметь худший хвост. Для игрока редкие длинные тики заметнее небольшой разницы в медиане, поэтому tick-time distribution нужно смотреть целиком. Если p99 приближается к 50 мс уже при обычном онлайне, сервер почти не оставляет запаса для генерации чанков, массового события или временного роста числа сущностей.
Каждый сценарий прогоняют отдельно. Idle показывает фоновую нагрузку без игроков: тикающие чанки спавна и работу JVM. Обычный онлайн задаёт рабочую точку, генерация территорий нагружает чанки, а массовое событие резко увеличивает число операций с сущностями и пакетами. У каждого такого режима свой критический путь, поэтому одно усреднённое число по всем прогонам скроет разницу между ними.
Запас считают по самому тяжёлому штатному сценарию, и условное число игроков тут ничего не даёт. Удвоение онлайна не должно удваивать MSPT, потому что результат зависит от распределения игроков, ферм, плагинов и загруженных чанков. На практике сервер считают готовым, если рабочий p99 укладывается в SLO, а тяжёлый тест не вызывает длительного отставания.
Сформулировать критерий покупки без рейтинга по GHz
Процессор сначала выбирают по бенчмарку близкой версии игры и похожей конфигурации. Single-thread performance сужает список, дальше отобранные процессоры проходят тест на копии мира. Результат теста сопоставляют с ценой, ядрами для сети, чанков и garbage collection, доступной памятью и условиями эксплуатации. Более быстрый главный поток не компенсирует медленное хранилище или тесный лимит RAM.
Опубликованный кем-то результат пригоден только вместе с описанием стенда. Оно должно содержать версию сервера, мир, онлайн, JVM, длительность, число повторов и тепловой режим. Один максимум тиков в секунду без распределения MSPT и профиля не отвечает на вопрос о стабильности.
У провайдера стоит узнать модель CPU, правила распределения vCPU, steal time и частоту, которую ядро держит под нагрузкой. На VPS одна только модель не скажет о доле ядра и о конкуренции на хосте. На выделенном сервере результат зависит от governor, охлаждения и лимитов мощности.
Частота одного ядра и стабильность тика игрового сервера сходятся в одном: сколько работы ядро успевает сделать за отведённые тику 50 мс. Подходящий CPU держит меньший хвост MSPT на вашей сборке после прогрева. Строка boost в спецификации об этом не говорит. Для проверки нужны копия мира, одинаковый сценарий, профиль главного потока и несколько повторов.
У этого способа есть граница, и её видно по тому же профилю. Если тик ждёт диск, блокировку или паузу JVM, замена процессора лаг не уберёт. Сначала профиль должен показать, где именно теряется время, и только потом имеет смысл сравнивать архитектуры, частоту и цену. Так нехватка одного ядра отделяется от ошибки в конфигурации.
Почему игровой сервер лагает даже на CPU с высокой частотой
Все мы с вами привыкли к тому, что балом на рынке x86-процессоров правят всем известные Intel и AMD. Некоторые читатели могут вспомнить также процессоры VIA (Centaur), которые массово применялись в тонких клиентах и ноутбуках в середине нулевых, единицы знают про чипы Transmeta серии Crusoe, которые отличались концептуально близкой к Эльбрусу VLIW-архитектурой, ну а совсем уж гики могут вспомнить Vortex86 - экзотические x86-процессоры, предназначенные для встраиваемых систем.
Однако люди незаслуженно забывают про Cyrix MediaGX - уникальный процессор родом из 1997 года, который интегрировал в двух чипах целый компьютер: и видеокарту, и звуковую карту, и PCI/ISA/IDE-контроллеры, и даже USB! Что за чудесный процессор сделала Cyrix, каким образом он прожил почти до конца нулевых, и причём тут AMD - читайте в сегодняшней статье!
❯ Предисловие
Компания Cyrix широко известна в кругах гиков ретрокомпьютинга. Во время гонки x86-совместимых процессоров в конце 80-х и начале 90-х, фирма прославилась за счёт выпуска быстрых FPU для 286'ых и 386'ых процессоров - причём они не просто работали не хуже чем чипы от Intel и AMD, но ещё и заметно обгоняли их во многих задачах. Дело в том, что архитектура ПК в те годы была максимально модульной для возможности урезания функционала и соответственно удешевления и без того дорогих компьютеров. Засунуть FPU в один чип с процессором не позволял огромный техпроцесс и дороговизна кристалла, а поскольку архитектура x86-ых позволяла расширять свою ISA за счёт инструкции ESC и подключения внешних сопроцессоров на IO-шину процессора, инженеры Intel решили вынести модуль для обработки чисел с плавающей точкой в отдельный чип - и его апгрейд с Intel x87 на Cyrix x87 помогал заметно ускорить как инженерный и бизнес-софт, так и 3D-игры.
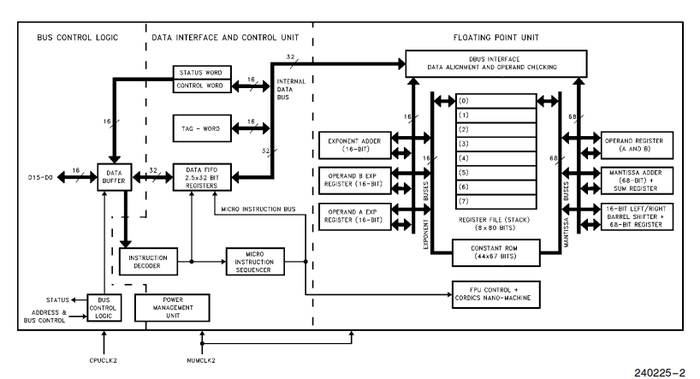
Концептуальная архитектура 387'ого - мы можем наблюдать собственный регистровый файл, декодер инструкций и даже ROM с микрокодом. По сути, это сам по себе был маленький процессор, только для чисел с плавающей точкой!
FastMath был выпущен в ноябре 1989 года и стал первым успехом для Cyrix на рынке ПК-железа. Успех на поприще математических сопроцессоров позволил компании включится в полноценную гонку x86-совместимых процессоров и представить свои первые чипы - 486SLC и 486DLC в 1992 году. Несмотря на название, оба процессора предназначались для апгрейда старых 386'ых систем и были с ними Pin-to-pin совместимыми, благодаря чему их производительность заметно вырастала благодаря добавлению L1-кэша (правда всего 1КБ, по сравнению с 8КБ в 486DX), реализации новых для 486'ого инструкций, а также возможности исполнения многих инструкций за один такт.
Что за "новые для 486'ого инструкции"?
Справедливости ради, их там было совсем мало. Буквально для очистки кэша и атомарных операций над операндами. Атомарные операции нужны для, как вы уже понимаете, реализации SMP.
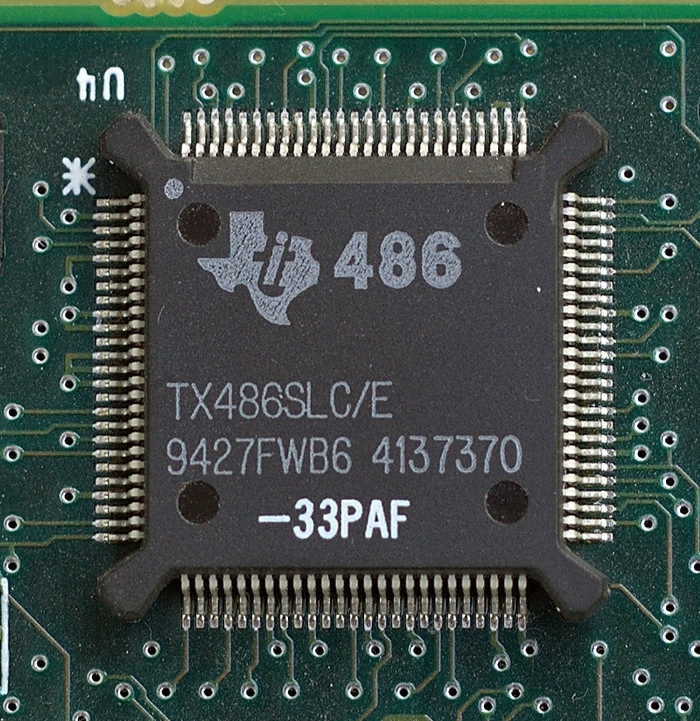
486SLC/DLC производился IBM и Ti. Чипы обоих вендоров отличались между собой в основном объёмом кэша. Фото Appaloosa с Вики
На практике 486SLC был весьма странным процессором, поскольку настоящий i486'ой он не догонял из-за использования урезанной 16-битной шины 386SX, в то время как полноценный 32х-битный 486DLC показывал себя уже вполне неплохо. Кроме того, в 486SLC не было FPU и для работы с числами с плавающей точкой необходимо было устанавливать сопроцессор, поэтому с "настоящим" 486'ым процессор конкурировать не мог.
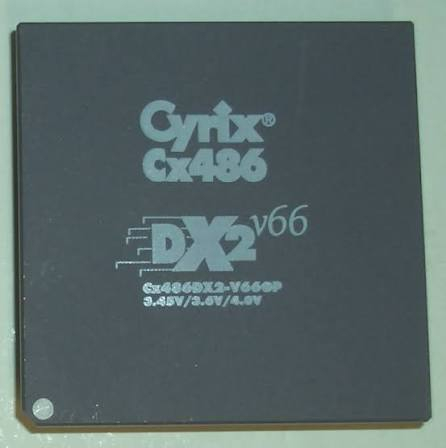
Ещё через год, в 1993 году, Cyrix представила свой первый "полноценный" 486-ой - Cx486SX и 486DX. Как и аналоги от Intel, SX отличался от DX отсутствием встроенного FPU и объёмом L1-кэша (2КБ против 8КБ), в остальном же процессоры были близки к 80486 и даже работали на тех же самых частотах. Главной фишкой процессоров Cyrix была цена - они стоили заметно дешевле чипов от Intel, при этом не так сильно уступая им по производительности, благодаря чему были популярны в бюджетных и среднебюджетных сборках.
Cx486. Фото с сайта RetroWeb
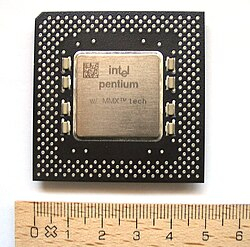
Только вот в 1993 году, Intel уже представила Pentium - следующее поколение процессоров, которое вчистую уделывало любые существующие на тот момент 486'ые за счёт реализации суперскалярной архитектуры (возможности обработки двух инструкций за один такт), крутого FPU, и, самого важного, предсказания переходов. Cyrix не отставала, и будучи производителем процессоров для апгрейда старых систем, представила 5x86 в 1995 году, который был одним из самых быстрых ядер для Socket 3 и местами обгонял Pentium.
Pentium 1. Фото из Википедии.
В том же году вышел легендарный 6x86, который стал одновременно успехом на рынке среднебюджетных ПК и провалом на рынке игровых. Инженеры сделали упор на оптимизацию целочисленного АЛУ, забив на FPU (который в P1 был реально очень шустрым), из-за чего все новые игры с floating-point арифметикой (а таких становилось всё больше и больше) и программными растеризаторами банально лагали, а ещё у 6x86 на ядре M1 не было поддержки MMX.
В 1997 году, National Semiconductor выкупила Cyrix и свернула разработки высокопроизводительных процессоров в пользу недорогих систем на кристалле для сборки реально бюджетных систем "топ за свои деньги". Результатом стало появление MediaGX - уникального процессора, который в связке с чипом-компаньоном позволял реализовать полноценный ПК на минимальной компонентной базе.
❯ Что это за процессор?
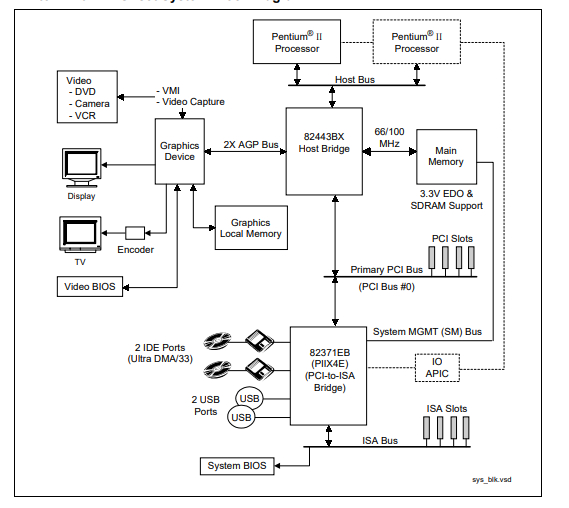
Платформа MediaGX по своей натуре заметно отличалась от архитектуры классических Intel-совместимых ПК. В обычных ПК процессору нужно было как минимум два-три чипа обвязки для полноценной работы: северный мост, который выполнял задачи контроллера памяти, PCI, AGP, и других высокоскоростных шин, а также объединял нескольких процессоров в SMP-профиль, и южный мост - который выполнял роль хаба для низкоскоростных шин типа ISA, USB и LPC.
Блок-схема компьютера на 440BX. Взято из даташита
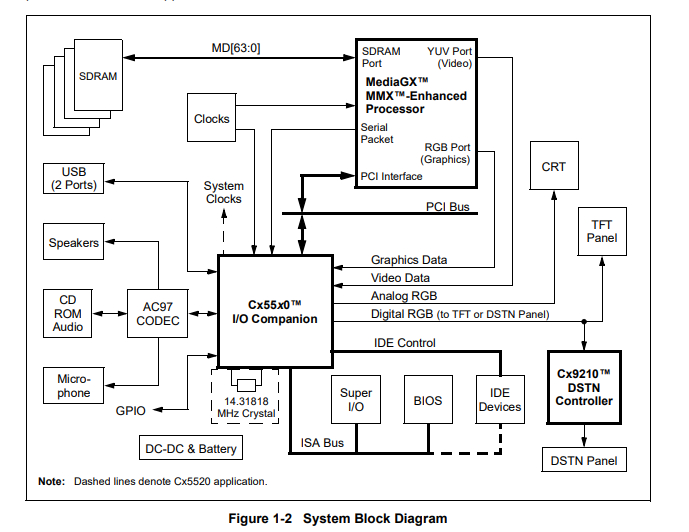
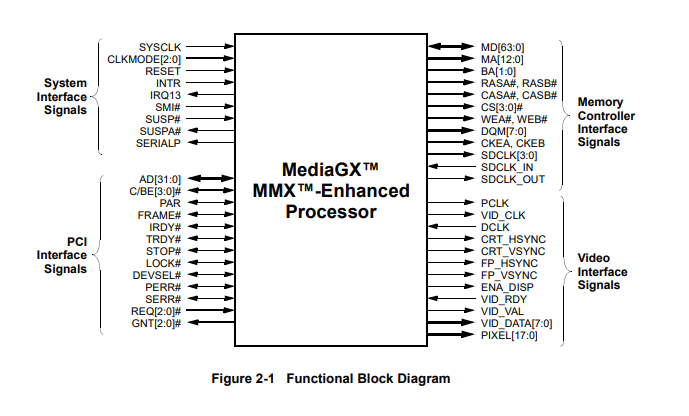
MediaGX же хватало всего два чипа - самого процессора и хаба Cx55x0. При этом функционал северного моста сразу же был интегрирован в процессор:
MediaGX подключался напрямую к оперативной памяти, как и современные чипы от Intel/AMD после ~2010 года. Контроллер памяти поддерживал до двух модулей SDRAM DIMM, позволяя установить до 128МБ памяти - солидный объём для 1997 года.
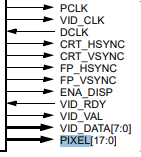
В процессор было встроено VGA-совместимое видеоядро, которое помимо вывода фреймбуфера и аппаратного курсора, также умело в аппаратный блиттинг с поддержкой всех DDraw растровых операций. Однако выводом VGA/LVDS/STN занимался сопроцессор, который брал данные от видеоядра через шину
Шина видеоядра была параллельной и напоминала современные 565. При этом формированием сигналов синхронизации занимался тоже процессор, а не Cx55x0.
Также в процессор был сразу же встроен PCI-контроллер, который и подключал чип-компаньон в качестве обычного PCI-устройства. На контрасте с 440BX, такое решение выглядит ну... очень экзотическим.
Нехилый уровень интеграции по меркам 1997 года на 350нм техпроцессе, да?
Блок схема компьютера на MediaGX. Скриншот из даташита
А ведь и само процессорное ядро было достаточно неплохим на момент выхода. С точки зрения CPU-части, MediaGX мог легко конкурировать не только с Pentium 1, но и Pentium MMX. Судите сами:
Первое, и самое крутое - MediaGX поддерживал SIMD в лице MMX, который к 1997 году начало использовать всё больше и больше мультимедийного софта.
Помимо целочисленного АЛУ, в MediaGX был интегрирован не самый плохой FPU для работы современных 3D-игр. Правда отсутствие поддержки AGP было критичным уже к 1998 году в мире гейминга, поэтому игровой платформой MediaGX назвать нельзя (ну разве что для 2D-игр, которым FPU чаще всего был не нужен).
Процессор мог работать на частоте до 300МГц, имел 16КБ L1-кэша, поддерживал виртуализацию и имел 6-стайдиный конвейер. Многие инструкции он мог выполнять за один такт.
Чисто технически это развитие ядер Cx586, которые в свою очередь берут корни от 486'ых. И тем не менее, на момент 1997 года это были очень неплохие процессоры для бюджетного сегмента, благо сам чип стоил около 60-100$ в закупке, что роняло цены на компьютеры ниже 1.500$.
Какие шины торчат в процессоре
Однако в отличии от Cx586, MediaGX нельзя было установить в обычный компьютер с Intel-овским сокетом и чипсетом, и поэтому для работы был необходимо хаб. Как вы уже могли понять по схеме выше, хаб подключен как обычное PCI-устройство в паре с специальной последовательной шиной по типу OneWire (возможно вариация Cyrix на тему SMBUS). В задачи хаба входило:
Аппаратное декодирование MPEG1/MPEG2. Дело в том, что в те годы процессоры ещё не могли нормально воспроизводить видео DVD-качества с софтовым декодером. Для просмотра фильмов на ПК необходимо было покупать видеокарту с поддержкой DVD-ускорения по типу ATi Rage или Nvidia Riva TNT. Cyrix же запилила этот функционал ещё в 1997 году, да ещё и с возможностью вывода в качестве оверлея - то есть даже не тратя ресурсы процессора/видеоускорителя на блиттинг и преобразование цветовых пространств!
Вывод изображения из видеоускорителя в процессоре на экран. Вот тут начиналось самое интересное: видеоускоритель "скармливал" изображение и клоки хабу, а тот в свою очередь либо преобразовывал цифровые данные в аналоговые для VGA-мониторов, либо в почти идентичную параллельную шину для TFT-матриц ноутбуков, либо через специальный контроллер Cx9210 в формат для DSTN-матриц.
AC97-совместимый аудиопорт. Чисто технически хаб был и звуковой картой с полной эмуляцией SoundBlaster 16, однако задачи ЦАП'а он не выполнял - этим занимался отдельный чип под названием аудиокодек, к которому хаб подключался с помощью I2S-подобной шины.
Помимо этого, хаб включал в себя функционал контроллера ISA, USB и IDE. Целых два USB в 1997 - это сильно!
Как и Intel'овским ПК, Cyrix'овской платформе для работы необходим был мультиконтроллер - он отвечал за включение/выключение/переход в режим сна (чипсет поддерживал APM - ранний аналог ACPI), контроллер клавиатуры (если речь о ноутбуке), работу с флэшкой BIOS'а, LPC и некоторые другие задачи.
❯ Изучаем плату
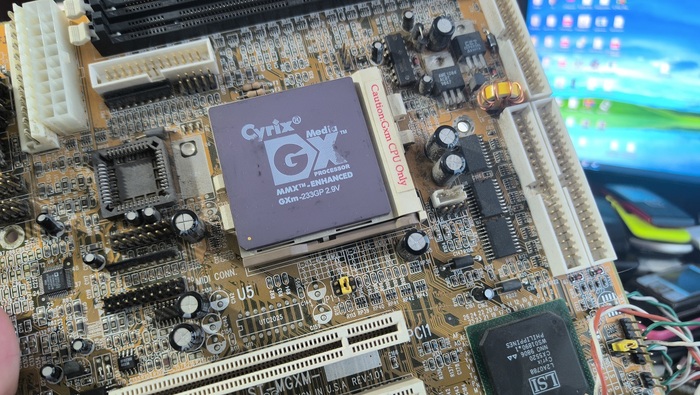
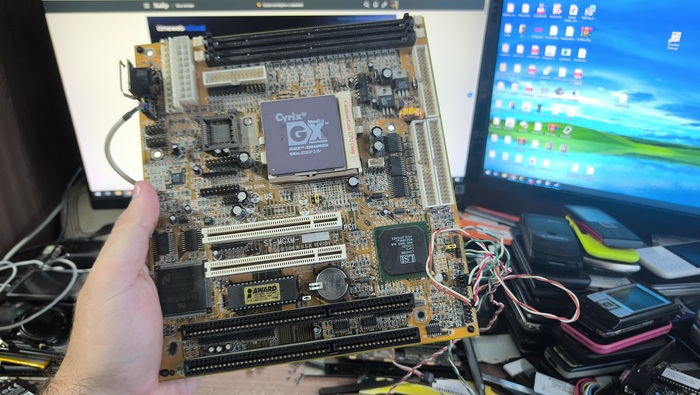
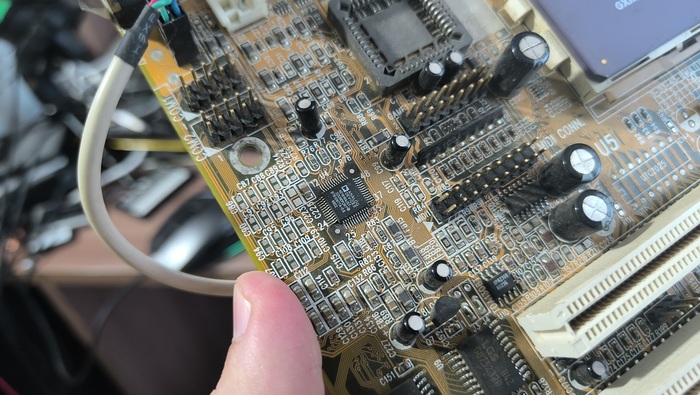
По традиции блога, мы с вами просто обязаны изучить на практике материнскую плату типичного Cyrix-компьютера. В качестве оной у нас выступит SuperTek ST-MGXm на базе хаба Cx5520, выпущенная в далеком 1998 году. Плату подарил мне читатель, за что ему огромное спасибо, однако фактическую работоспособность я пока не проверял. Оставим это для практической статьи про MediaGX :)
У платы есть как AT, так и ATX разъёмы питания, два слота под SDRAM-память, два PCI и два ISA. В общем, всего по две штуки.
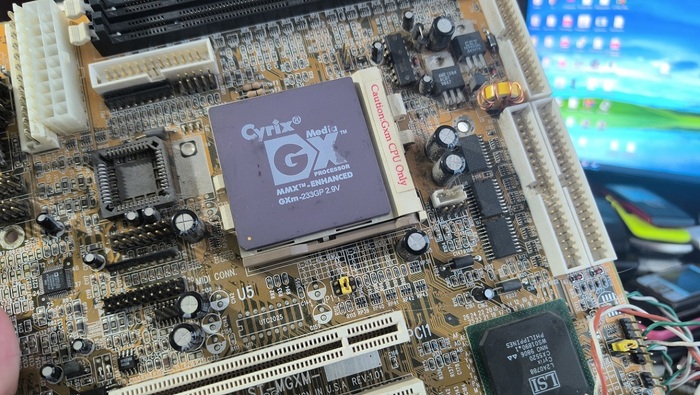
Самым большим чипом на плате является процессор. Сокет у него кастомный, обычный Intel'овский или AMD'шный процессор сюда поставить нельзя, о чём гласит соответствующий стикер на сокете. Помимо PGA-корпуса, процессор выпускался также в BGA для ноутбуков и тонких клиентов. Правда ноутбуков на MediaGX я не видел - хотя очень хотелось бы пощупать!
Его питание формирует всего один однофазный ШИМ-контроллер TLT494CN, а клок формируется PLL'кой в процессоре относительно частоты шины PCI (SYSCLK), а не FSB, как в Intel'ах.
Чуть ниже расположился хаб - тот самый Cx5520 производства LSI. Наверное в 1997'ом было даже немного необычно осознавать то, что эти два чипа - уже практически готовый компьютер.
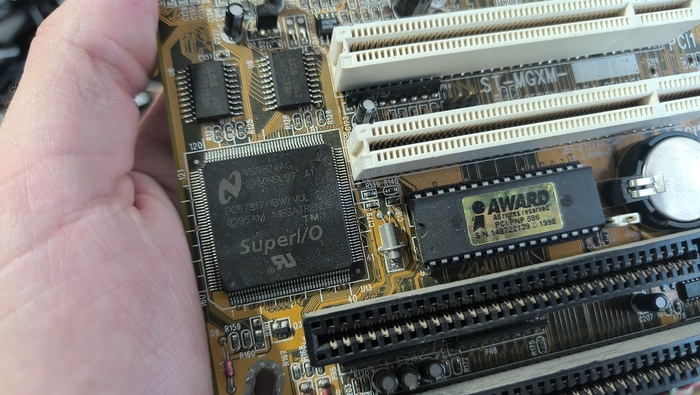
Рядом с слотами PCI и ISA расположилась микросхема с BIOS и мультиконтроллер VS0824AG. На нем красуется лого National Semiconductor (которая выкупила Cyrix в 1997) и каких‑то конкретных упоминаний об этом чипе в сети я не нашел — так что скорее всего это что‑то кастомное специально для MediaGX.
За звук отвечает ЦАП от Analog Devices и усилитель APA2308. И... в целом, это все! Сравните с компонентной базой любой платы на Pentium II и почувствуйте разницу в том, насколько плата для MediaGX простая!
❯ Заключение
В целом, Cyrix MediaGX — один из немногих примеров альтернативных x86-платформ. Другой подобной может быть только TransMeta Crusoe, где север также был встроен в процессор. Интересно и то, что в конце‑концов, MediaGX был выкуплен AMD, который затем был переименован в AMD Geode и применялся в тонких клиентах и Embedded‑платах типа PC104 вплоть до конца нулевых. А потом в 2011 внезапно появился AMD Brazos, который интегрировал в себе процессор и GPU... Что‑то очень знакомо, да?:) Так вот — именно Cyrix MediaGX я считаю первым настоящим APU в мире, за 14 лет до появления официального определения этого термина!
Ну а я надеюсь, что вам было интересно. Подписывайтесь на блог, чтобы не пропускать новые статьи каждую неделю! А если вам интересна тематика ремонта, моддинга и программирования для гаджетов прошлых лет — подписывайтесь на мой Telegram‑канал «Клуб фанатов балдежа„, куда я выкладываю бэкстейджи статей, ссылки на новые статьи и видео, а также иногда выкладываю полезные посты. А ролики (не всегда дублирующие статьи) можно найти на моём YouTube канале“.»
А если вы хотите что‑нибудь подарить из железа и увидеть о нём статью — пишите мне в Telegram. Меня очень интересуют самые разные гаджеты: начиная от игровых консолей и любых связанных с геймингом устройств, телефонов, смартфонов, КПК, заканчивая ретро‑компьютерами и ноутбуками. Кто знает, может героем следующейподобной статьи окажется ноутбук из 90-х?:‑)
Особенно сильно я люблю ковыряться в ноутбуках из начала 90-х. Источник
После обзоров устройства не продаются, а остаются в моей коллекции. Когда‑нибудь я хочу сделать музей, где к каждому устройству можно будет приложить QR и почитать мою статью. Кто знает, вдруг на следующей неделе я также подробно расскажу про девайс из вашей юности?:)
Кстати, у меня есть GameBoy Advance SP, под который я очень хочу написать игру. Однако мой экземпляр был залит водой и кофе. Может у кого‑то есть донор с дохлой платой, откуда я смог бы взять контроллер питания? У меня AGS-101.
Записал своё битье головой о стенку, рык от потребности найти на шкафу клавиатуру, вместо разбитой в ярости, нытье, подшаманил ии “интеллектом” для проверки версий .. ну, совершенно непонятно кому интересно будет.
Конечно, наверняка есть гораздо более умные люди, которые гораздо продуктивнее применили имеющийся багаж и даже зарабатывают на этом.. Буду рад увидеть в комментариях версии и варианты, которые я почему-то попусти.
Для лл: есть кучка видюшек, захотелось их применить в 2026 году. Результат: это возможно, но узкоспециально.
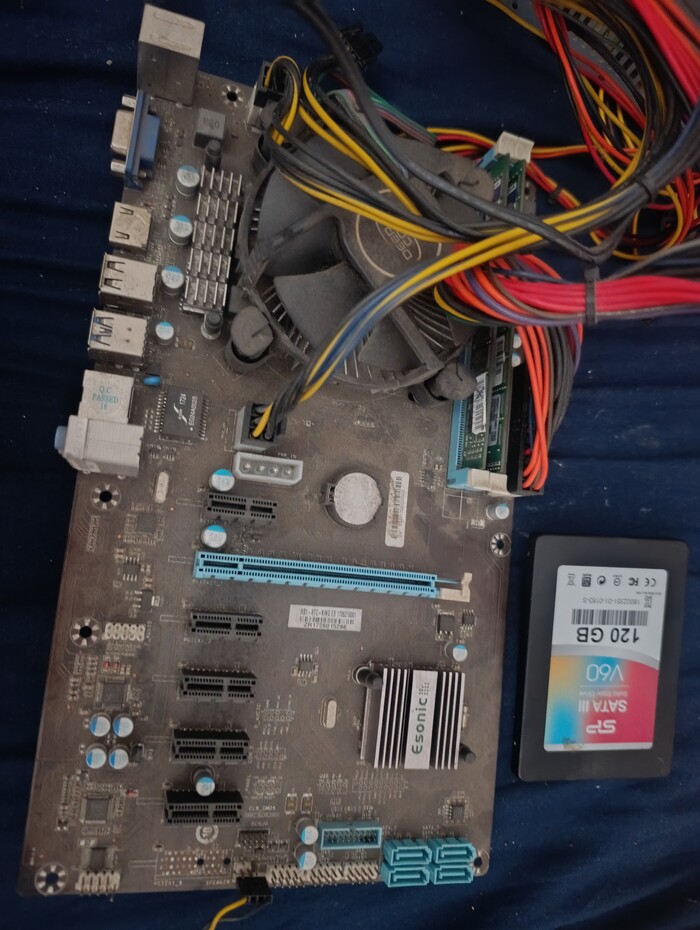
Завалялись у меня после майнинга десять видеокарт RX 580. Решил проверить - жива ли Polaris в 2026-м. Вот что вышло.
1/2
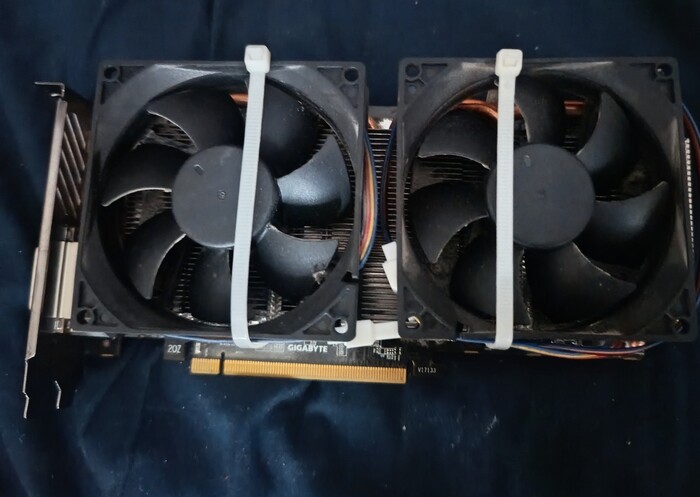
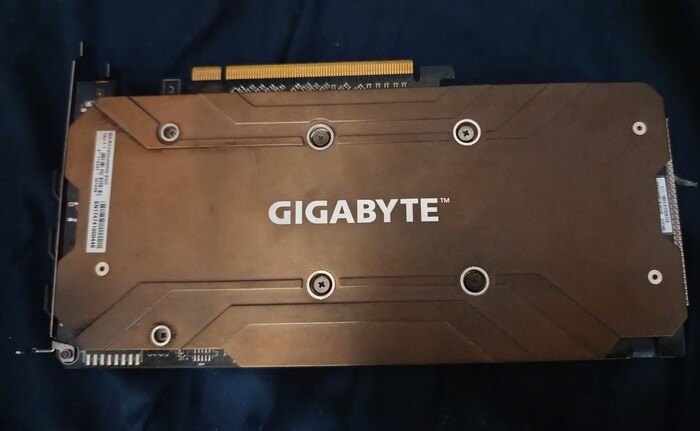
Rx580 8gb, с кастомными вентиляторами
Началось всё с генеральной уборки. Лезу на антресоли, а там - коробка. Не просто коробка, а Коробка. С десятью Gigabyte RX 580 Gaming на 8 гигов. Rev 1.1, если вы понимаете о чём я. Серая металлическая броня, кастомные вентиляторы, приделанные на пластиковых стяжках и такой конкретный слой пыли, что сразу вспоминается 2017-й - бум крипты, когда эти карты продавались по цене внедорожника, а я, молодой и наивный, собрал ферму на балконе. Эфир.. Жена тогда говорила, что я либо разбогатею, либо сгорим. Поджарился только пукан, на счетах за свет, а карты остались. Крипта упала, хотя что-то я успел вывести.. Тогда ферма окупилась.. я разобрал риги, спрятал всё на антресоль и благополучно забыл на восемь лет.
А тут - нейросети. ChatGPT, Stable Diffusion, вся эта движуха. И я подумал: блин, у меня же десять видеокарт. Восемь гигов каждая. В сумме - восемьдесят гигов видеопамяти! Это ж, по идее, какая-то махина должна получиться. Суперкомпьютер в гараже. Запущу 70-миллиардную LLaMA, буду свой ChatGPT дома держать, может даже соседям за Wi-Fi продавать. Ну, вы поняли - я опять стал молодым и наивным.
Что это за зверь, коротко
Для тех, кто не в теме: видеокарты Radeon RX 580 - это архитектура Polaris, или GCN 4.0. Выпускалась в 2017 году. 8 гигов GDDR5, пропускная способность памяти где-то 256 ГБ/с, вычислительная мощность около 6 терафлопс в FP32. Когда она вышла, это была рабочая лошадка для 1080p-гейминга. Сейчас, в 2026-м, это, конечно, антиквариат. Но антиквариат рабочий - карты-то заводятся, вентиляторы крутятся, и даже пыль вроде бы не убила чипы за восемь лет хранения.
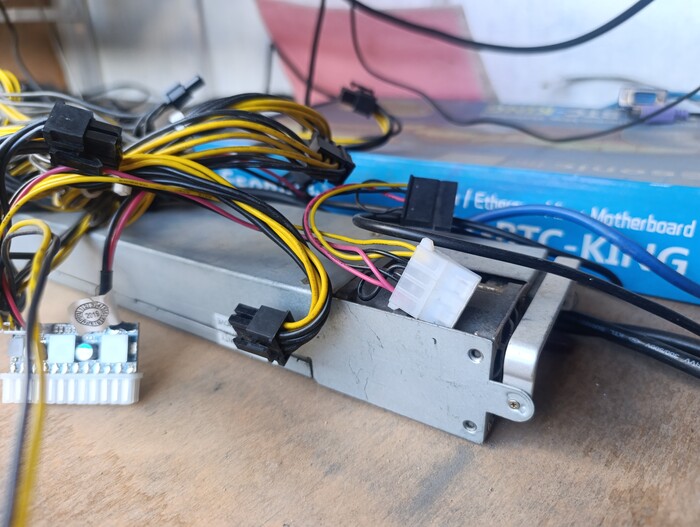
Первым делом я их отмыл. Не полностью, конечно - не до уровня капитального ремонта с перекаткой термопрокладок, но продул компрессором, поменял термопасту (которая превратилась в плитку шоколада), и стал думать - как это всё подключить. Потому что десять карт - это не просто "воткнул в материнку". Моя текущая рабочая станция имеет три слота PCIe, и то один из них x4. Для десяти карт нужны райзеры, разветвители, и, самое главное, блок питания. Или два. Или три. Потому что каждая RX 580 жрёт под 185 ватт в пике. Десять карт - это полтора-два киловатта только на них. Плюс система. Плюс монитор, если вдруг понадобится. Короче, счет за свет снова начал сниться мне кошмарами, но это лирика. Ну хотя как “лирика”, за это время свет подорожал больше чем х2.. С 3.77 примерно на 8.90 (будет через месяц).. Примерно 6.5 и 10.2 цента.. На той же антресоли откопал серверный блок питания, стал вспоминать, каким контроллером он запускается, паутину из проводов, ригов и дополнительных проводочков стал распутывать.. Стал дёргать ии вопросами, что как в современном мире..
Серверный блок питания с контроллером
Попытка первая: "Я запущу ChatGPT дома!"
Пошёл я по пути классического энтузиаста. Скачал Ollama. Потому что Ollama - это же просто, там одна команда в терминале, "ollama run llama3.1", и вроде как всё летает. Запускаю на своей основной машине (там RTX 3070, кстати, живёт) - работает. Красота. Думаю, сейчас перенесу всё на ферму, подключу десять RX 580, и пойду в рай. В хорошем смысле.
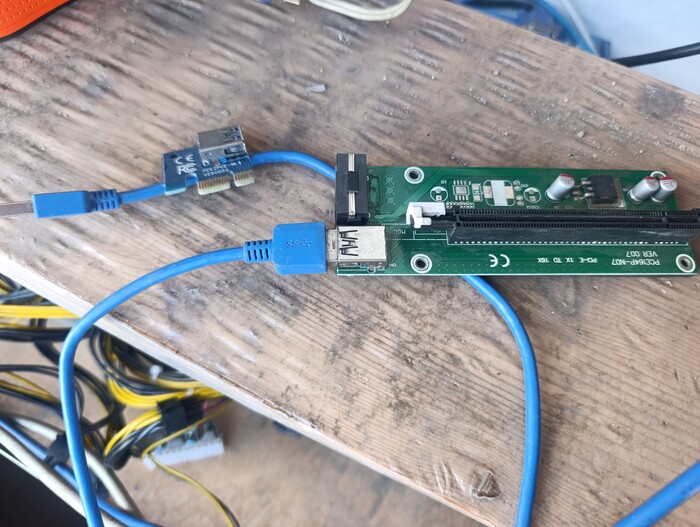
Райзер, кабель, переходник
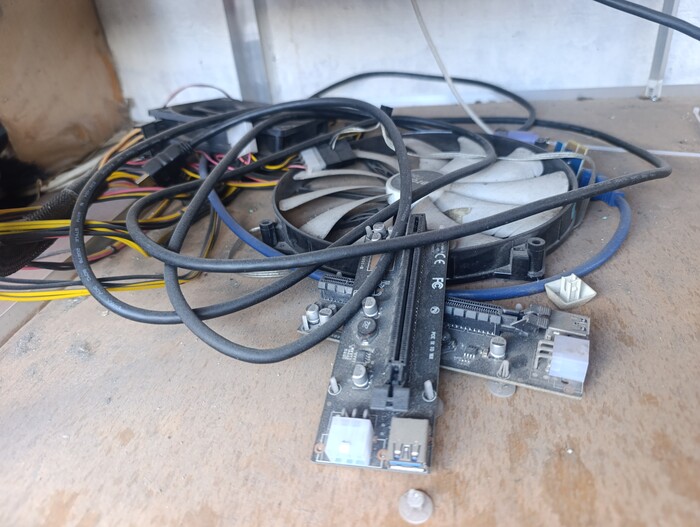
Райзеры, кулеры, вентиляторы
Ага. Щас.
Ollama, как выяснилось, под Linux использует либо CUDA (для Nvidia), либо ROCm (для AMD). И тут я впервые столкнулся со стеной. AMD, оказывается, официально убила поддержку Polaris в ROCm ещё в пятой версии. То есть мои RX 580 - это как бы AMD, но “не такие” AMD. ROCm требует более новые карты, на архитектуре CDNA или RDNA. А Polaris - это старая школа, GCN. И современный PyTorch, современный Ollama, vLLM, Text Generation Inference - всё это на Polaris просто не стартует. Я часа три плясал с бубном вокруг драйверов amdgpu-pro, пытался заставить ROCm 4.x работать на современном Ubuntu 24.04, и чуть не сломал систему. Заработало .. Ну, как сказать… работает, но только если вы готовы сидеть на древнем ядре Linux и древнем ROCm, который не умеет современные модели. Короче, тупик.
Материнская плата H81-BTC-KING, SSD диск, можно и с флешки стартовать
Есть, кстати, ещё вариант с DirectML на Windows. Я даже попробовал ComfyUI через DirectML - запускается, но работает так, будто карта не RX 580, а встроенное видео 2010 года. И проект ZLUDA (который транслирует CUDA в ROCm) - он тоже не спасает, потому что ZLUDA опирается на... правильно, на ROCm. А его нет. Короче, весь этот путь - в мусор.
Спасение: llama.cpp и Vulkan
Тут я вспомнил про старого доброго товарища - llama.cpp. Это такой проект, который изначально делался для запуска LLM на CPU, но потом оброс бэкендами подо всё. И есть там Vulkan-бэкенд. Vulkan - это низкоуровневый графический API, который работает почти везде. И на RX 580 тоже.
Собрал llama.cpp с флагом `GGML_VULKAN=ON`. Запускаю. И - охренеть - работает.
Скачал LLaMA 3.1 8B Instruct в квантовании Q4_K_M (это такой формат, который сжимает веса модели, жертвуя чуть-чуть качества, но зато влезает в память). Запускаю на одной RX 580 через Vulkan, и карта выдаёт примерно 15-20 токенов в секунду на генерации. Для домашнего чат-бота - более чем. Можно разговаривать, можно код писать, можно рецепты борща спрашивать. Восемь гигов памяти как раз хватает для 8B-модели в Q4_K_M с небольшим контекстом.
И тут я понял главное: если у меня десять карт, я могу запустить десять независимых инстансов. То есть не одну большую модель (об этом позже), а десять маленьких, но рабочих серверов. Поставил Nginx как балансировщик, поднял на каждой карте свой `llama-server` на отдельном порту, и получил домашний кластер для 8B-моделей. Для команды разработчиков, для тестирования, для агентов - это реально полезно. Десять параллельных запросов одновременно, без очереди.
Но, конечно, мне было мало. Я же хотел 70B модель. Я же хотел большой ИИ.
Попытка вторая: "А давайте 70B запустим?"
Скачал LLaMA 3.3 70B Instruct, тоже в Q4_K_M. Весит она где-то 35-40 гигабайт. Вроде бы влезает в 80 гигов моей фермы. Запускаю llama.cpp с параметром `-ngl 99` (чтобы все слои модели ушли на GPU), и...
Работает.
Но. Но… еще одна разбитая клавиатура…
Скорость - примерно 1-3 токена в секунду. ОДИН - ТРИ! Это примерно одно слово в секунду. Диалог в таком темпе напоминает переписку с марсианином через радиотелескоп. Ты задаёшь вопрос, идёшь заваривать чай, возвращаешься - а он ещё думает.
Почему так медленно? Потому что llama.cpp на десяти RX 580 через Vulkan работает в режиме pipeline parallelism (или layer split). Это значит, что слои нейросети раскидываются по картам: первая карта считает слои 0-10, передаёт результат второй, вторая считает слои 11-20, передаёт третьей, и так далее. В каждый момент времени работает только одна карта. Остальные девять простаивают и ждут. И передача данных между ними идёт через PCIe, который на этих картах (особенно через райзеры x1) - узкое горлышко.
Я пытался ускорить через tensor parallelism (когда все карты работают одновременно, разбивая матрицы), но это требует NVLink или хотя бы быстрый interconnect. У RX 580 нет NVLink. У них даже нет SLI/CrossFire в современном понимании. Через Vulkan это не работает. Так что 70B модель запускается - но как эксперимент, а не как рабочий инструмент.
30B модель, кстати, влезает на 4-5 картах. Тоже работает, тоже не быстро, но для тестов сойдёт.
Stable Diffusion: можно, но медленно
Дальше я решил картинки генерировать. Скачал `stable-diffusion.cpp` - это такой же порт, как llama.cpp, но для картинок. Vulkan-бэкенд, запускаю SD 1.5 в формате GGUF.
Результат: картинка 512×512 генерируется примерно 72 секунды.
Для сравнения: на моей RTX 3070 та же картинка - за 3-5 секунд. На RX 580 - минута с лишним. FLUX.1 schnell (это более новая модель) - вообще 14 минут на одну картинку.
Десять карт = десять потоков генерации. То есть если мне нужно сгенерировать 100 превьюшек для какого-то проекта - я ставлю пакетную обработку, и за ночь оно нагенерирует. Но для интерактивного "нарисуй мне кота" - это боль.
Кстати, про ComfyUI и Automatic1111 - забудьте. Они требуют либо CUDA, либо ROCm. На RX 580 не заведутся нормально. Только `stable-diffusion.cpp` или аналогичные порты на Vulkan. И из-за энергонеэффективности это куча сожжённого электричества.. дешевле подписка на генерирующую модель..
Видеотранскодинг: тут unexpectedly хорошо
Круто! Реально круто!
А вот тут меня ждал сюрприз.! Оказывается, у RX 580 есть аппаратный видеокодер AMD VCE (Video Coding Engine). Он умеет кодировать H.264 и HEVC (H.265) на лету, не нагружая основные вычислительные блоки.
Я поднял ffmpeg-ферму. Каждой карте даю свой файл, она через VAAPI/AMF кодирует в HEVC с нужным битрейтом. Десять карт = десять параллельных потоков перекодирования. У меня завалялся архив старых видео с GoPro - сотни гигабайт в несжатом или слабо сжатом видео. Я их пакетно перегнал в HEVC, и сэкономил дискового пространства процентов 60. При этом CPU почти не напрягался - всё делали видеокарты. Хоть какой профит..
Если вы работаете с видео, если у вас есть архивы, если вы делаете рипы или готовите контент для стриминговых сервисов (нужны версии в разных битрейтах) - это реально полезное применение. RX 580 для этого подходят идеально. Запишем в книжечку.
Hashcat: для тех, кто в теме безопасности
Поставил Hashcat. Он работает через OpenCL, и Polaris в OpenCL ещё как-то держится.
На одной RX 580:
- MD5: около 6-8 миллиардов хешей в секунду
- WPA2 (Wi-Fi): 120-150 тысяч попыток в секунду
- NTLM: 10-12 миллиардов в секунду
На десяти картах - умножаем. Это серьёзная мощность для аудита безопасности, пентестов, проверки резистентности паролей. Легально, востребовано, и карты тут чувствуют себя как рыба в воде. Ну, довольно узкая ниша, нужно иметь под это заказчиков… и не из даркнета, а по договору.. Нам проблем не надо.
Рендеринг: LuxCoreRender, но не Blender
Тут я обломался. Blender, начиная с версии 3.0, выкинул OpenCL и перешёл на HIP. А HIP для архитектуры Polaris не существует. То есть в Blender Cycles мои десять карт - просто зрители. Они не рендерят.
Но есть отдельный движок - LuxCoreRender. Он до сих пор поддерживает OpenCL, и на RX 580 работает. Я поднял десять рендер-нод, и они через сеть рендерят сцены. Не Cycles, не Eevee, но если вы не привязаны к Blender-шейдерам - вполне рабочий инструмент. Для архвизов, для анимаций, где не нужны специфичные фичи Blender - пойдёт.
BOINC и наука: карма вместо денег
Поставил BOINC. Это такая платформа распределённых вычислений - Einstein@home, MilkyWay@home, Asteroids@home, GPUgrid. RX 580 поддерживает OpenCL 2.0, и многие проекты на нём работают.
С Folding@home, кстати, оказалось сложнее. Он требует OpenCL 1.2+, а встроенные драйверы Mesa в Linux дают только OpenCL 1.1. Чтобы заработало, нужны проприетарные драйверы amdgpu-pro или старые Radeon Pro Drivers с ROCm 4.x. Я не стал заморачиваться, потому что BOINC-а мне хватило.
Денег это не приносит, но мысль, что мои два киловатта где-то ищут гравитационные волны или моделируют галактики - приятная. Кому нужна карма и интересно заниматься этим, то хорошее дело.
Майнинг на rx580 в 2026-м: только если электричество даром
Ну, конечно, я проверил. Ради старой дружбы.
Смотрю на whattomine и аналоги. RX 580 в 2026 году при цене электричества 6-8 рублей за кВтч (или 0.08-0.10) приносит отрицательную прибыль. То есть она добывает, например, какой-нибудь NIR или ETC, но электричество стоит дороже, чем стоит намайненное. Где-то 0.10-0.20 в день(!) с карты, а счет за свет вгоняет в глубокий минус.
Если у вас есть бесплатная розетка (солнечные панели, работа оплачивает, или вы живете рядом с ГЭС) - тогда да, можно копать что-то вроде FLUX или ETC. Но в реальных условиях - это хобби для альтруистов. Есть ещё тема с криптокотлами, но там, опять же, лучше ставить железку-майнер и этим котлом надо что то греть, а в городской квартире греть нечего… ну, опять возвращаюсь к тому, что у меня была тема именно приспособить конкретные имеющиеся на руках железки..
Что я НЕ смог сделать (и почему)
Честно скажу - есть вещи, которые я либо не проверял лично, либо знаю, что не работают, но не экспериментировал до конца:
- Fine-tuning / обучение моделей. Теоретически, через какие-то древние версии PyTorch с ROCm 4.x можно попытаться, но я не нашёл рабочего способа запустить LoRA или полноценный файнтюн на Polaris. Backward pass (обратное распространение ошибки) в Vulkan/OpenCL для трансформеров - это боль, и никто это нормально не реализовал. Так что учить модели на этой ферме - скорее всего, нет.
- Ollama, vLLM, Text Generation Inference. Все они требуют ROCm или CUDA. На RX 580 - никак.
- Игровой ИИ, DLSS-аналоги, FSR3 frame generation. Всё это требует современных архитектур. Polaris тут беспомощен.
- Децентрализованные сети вроде Render Network или Livepeer. Они обычно требуют карты поновее. Не проверял лично, но в списках поддерживаемых GPU Polaris я не видел.
Энергопотребление: цифры, от которых хочется плакать
Давайте посчитаем вместе, чтобы вы понимали масштаб трагедии.
- Одна RX 580: 185 ватт в пике
- Десять карт: 1850 ватт
- Системы (CPU, RAM, диски, райзеры, вентиляторы): ещё 200-250 ватт
- Итого: два киловатта постоянной нагрузки
За сутки - 48 кВтч. За месяц - 1440 кВтч. Это как два мощных кондиционера, работающих круглосуточно. Если у вас нет промышленного тарифа или солнечных панелей - счет за свет будет конкретным.
Блоки питания: для такой фермы нужно либо два серверных БП по 1200 ватт, либо один майнинговый на 2400 ватт. И обязательно open-frame корпус или стойка, потому что в закрытом корпусе десять карт превратятся в печь за пять минут. Ну или, по дикому, можно на длинных проводочках пространственно распределить на проволочках подвесить и будет такая пространственная конструкция.. Выглядит дико, занимает кучу места.. У меня на балконе стоит отдельный вентилятор, гоняющий воздух через риг, иначе температура под 90 градусов лезет. А при перегреве карты могут сдохнуть, это не надо..
Вывод: что же делать с десятью RX 580?
После двух недель экспериментов я пришёл к такой картине.
Если вы хотите одну быструю большую нейросеть (70B модель, которая отвечает быстро) - продавайте. Серьёзно. Продайте восемь карт, докиньте денег, купите одну RTX 3090/4090 на 24 гига или RX 7900 XTX. Будет счастье, скорость, и никаких танцев с Vulkan. (Не является инвестиционной рекомендацией, цены могут измениться)
Если же ваши задачи параллелятся - то есть вам нужно много независимых потоков, а не один сверхбыстрый - тогда ферма жива. Вот реальные сценарии:
1. Десять LLM-серверов с 8B моделями для команды/друзей/лаборатории. Через llama.cpp + Vulkan + балансировщик. Работает, летает, полезно.
2. Видеотранскодинг-ферма. Самый неожиданно практичный сценарий. VCE кодирует, не напрягая CPU, и делает это быстро.
3. Hashcat-ферма для пентестов. Если вы в информационной безопасности - это рабочий инструмент.
4. Рендер-ферма через LuxCoreRender. Не Blender, но если вы готовы пересесть - работает.
5. BOINC и наука. Для души. Для тех, кому важно, что GPU считает что-то полезное, а не просто греет воздух.
6. Облачный гейминг. Десять сессий Sunshine/Apollo для LAN-вечеринок. Требует мощного CPU и сети, но возможно.
7. Майнинг. Только при бесплатном электричестве. Иначе - спонсор энергокомпании.
Продажа карт на Авито
Масса объявлений стоит по 2000 рублей за карту.. некоторое количество от 4, 5 до 7, 5 тысяч. Таким образом, продав 10 карт можно получить максимум 75000, и плюс-минус.
Rtx 3090 на 24 гб стоит от 60 до 80.. Гораздо более быстрая карта но памяти в 3 раза меньше чем было. Надо смотреть применимость и отсюда делать вывод, что важнее: 10 потоков и 80 гб общий объём памяти или быстродействие на одной карте и 24 гб.
Иногда стоит пробовать продавать именно оптом, одним лотом: кому-то это может оказаться более удобным и он заплатит больше, чем искать у разных продавцов разрозненные карты и каждый раз платить за доставку..
Если у вас тоже завалялись старые карты - не выбрасывайте. Они ещё могут. Но будьте реалистами: это не суперкомпьютер, это десять старых, но верных рабочих лошадок. Каждая по отдельности тянет свою телегу. А вместе - они просто десять телег.
---
P.S. Если кто-то знает, как заставить Polaris делать fine-tuning через что-то отличное от ROCm - пишите в комменты. Я перепробовал всё, что нашёл, но, может, есть какой-то шаманский способ, о котором Google молчит. И да, я знаю, что лучше продать. Жена тоже знает. Но продать - это же скучно, правда?
Да, реально, ребят если у кого то похожая боль была и есть варианты как сейчас это использовать энергетически и экономически эффективно буду очень рад увидеть идеи в комментариях.
Генеративный ИИ, конечно, применялся как для создания “сложных букв”, так и для проверки грамматики. В современном мире, безусловно, проще воспользоваться ИИ, чем тратить время на изучение множества форумов в поисках информации. Без подобного инструмента исследования бы затянулись гораздо на больший срок и, скорее всего, сломав больше клавиатур я бросил бы все это на полпути..
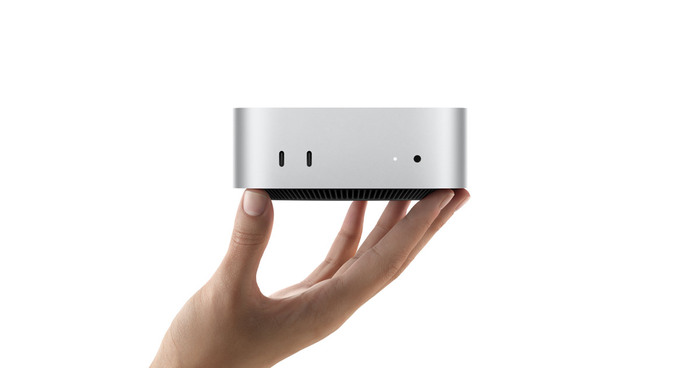
Пока все спорят о дефиците видеокарт, OpenAI, по данным The Information, тихо собрала десятки тысяч Mac mini и Mac Studio. Не для рендеринга и не для сборки приложений — на этих коробочках учат ИИ-агентов пользоваться компьютером.
Логика неожиданная, но железная. Агента, который должен сам управлять компьютером, невозможно натренировать в вакууме: ему нужна живая операционная система, где он видит экран, двигает курсор, промахивается мимо кнопки и получает обратную связь — и так миллионы раз подряд. Такая нагрузка упирается не в мощность параллельных вычислений, как предобучение больших моделей, а в объём памяти и количество независимо работающих машин. Ферма из маленьких компьютеров с общей памятью подходит для этого лучше, чем стойка ускорителей.
Учить работать с macOS можно только на macOS. Есть и вторая причина, чисто юридическая: macOS законно запускается только на железе Apple, эмуляторы тут не спасают. Поэтому лаборатории и берут именно фирменные коробки. Anthropic пошла тем же путём, но арендует мощности Mac mini через Amazon Web Services вместо закупки собственного парка.
Спрос уже виден в цифрах Apple: выручка компании по направлению Mac в июньском квартале выросла почти на 29%, до 10,4 млрд долларов. Конфигурации с большим объёмом оперативной памяти на фоне общего дефицита памяти разлетелись так, что сроки поставки растянулись на недели и месяцы, — а 25 августа Apple досрочно обновила обе линейки.
Компьютерные агенты — то, за счёт чего ИИ обещают перевести из «отвечает на вопросы» в «делает работу за вас». И оказалось, что упражняться им надо не в облаке абстракций, а в обычной пользовательской ОС, на настольном железе, ничем не отличающемся от того, что стоит у вас на столе. Тренажёром для будущих агентов стал самый обычный компьютер.
Компания HTC запомнилась нам в первую очередь по коммуникатором и смартфонам из нулевых. В портфолио тайваньской фирмы затесались сотни легендарных устройств, начиная от QTek'ов с i‑Mate'ами, заканчивая HP iPaq и даже Palm'ами. Однако один из девайсов, вышедший в далёком 2005 году, был особенным — поскольку совмещал в себе функционал смартфона и мобильного компьютера в одном корпусе...
Сегодня мы с вами изучим легендарный HTC Universal — смартфон‑трансформер на Windows Mobile, и по традиции рубрики изучим его конструктив, схемотехнику и компонентную базу. Интересно? Тогда жду вас под катом!
❯ Предисловие
Мы уже не раз с вами изучали устройства от HTC. В рамках прошлых статей мы разбирали, изучали компонентную базу и даже апгрейдили оперативную память культовых моделей по типу HTC Magician. При этом устройства тайваньской фирмы можно поделить на три поколения:
Поколение XScale и StrongARM — 2001–2005 год. В это время компания активно использовала связку из процессоров Intel PXA и модемов Texas Instruments Calypso, создав на относительно унифицированной платформе десятки устройств. HTC Wallaby, HTC Magician, Palm Treo 650 — всё это устройства на базе схожей платформы.
Поколение OMAP — 2004–2008 год. Впервые процессоры Texas Instruments OMAP, компания HTC использовала ещё в 2004 году — в кнопочном смартфоне с Windows Mobile на борту. Уже в 2005'ом году, OMAP850 начали ставить практически во все новые модели — даже несмотря на то, что это был заметный даунгрейд по сравнению с более старыми PXA. Но тут решала экономия — в OMAP'ы был интегрирован модем.
Поколение Qualcomm — 2007–2015 год. В 2007 году, HTC перешла к тяжелой артиллерии и начала использовать топовые процессоры Qualcomm, которые уделывали по производительности любые другие процессоры для смартфонов.
HTC Universal, о котором мы с вами сегодня поговорим, относится как раз к первому поколению и работает на базе процессора от Intel. Аппарат вышел в далёком 2005 году, стоил солидные 1.200$ (примерно как сейчас 2.000$ — почти в два раза дороже iPhone 17 Pro Max) и продавался аж под восемью разными названиями. Всё дело в том, что HTC вплоть до 2006'ого свой бренд не развивали, а разрабатывали устройства для продажи другими брендами под своим названием — такой подход называется ODM и используется, например, Samsung и Xiaomi для своих бюджетных смартфонов.
И если сейчас ODM‑устройство — это клеймо бюджетности, то в те годы об HTC так сказать было нельзя. Компания делала весьма экзотические и необычные коммуникаторы, которые работали на топовом железе, стоили кучу денег и поддавались моддингу. Самый частый апгрейд — установка кастомной и почищенной прошивки, далее усиленный аккумулятор, ну а редким (и желанным) тюнингом была установка увеличенного в два раза объёма оперативной памяти!
Об Universal я мечтал давно и смог заполучить его только сейчас — благодаря читателю Ярославу, которые занимается перевозками гаджетов из Китая. Подписчик выкупил устройство, организовал его доставку в Россию и подарил мне его — за что ему огромное спасибо... Но вот незадача, аккумулятор в устройстве был вспухший и совсем не держал заряд — так что придется его перепаковать!
❯ Разбираем
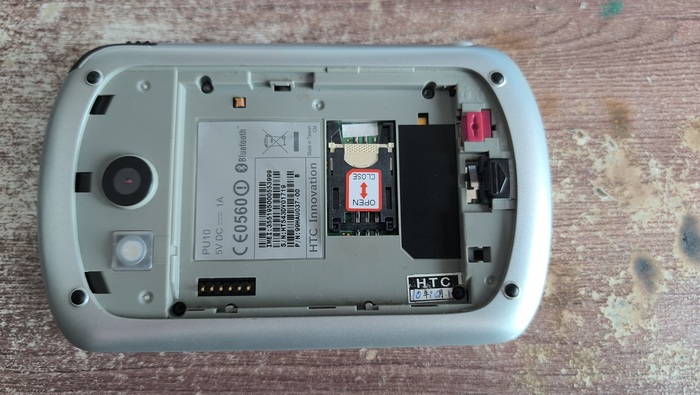
По традиции блога, наш девайс полагается разобрать и изучить что же у него находится «под капотом». В отличии от более поздних устройств от HTC, Universal разбирается относительно легко и просто: достаточно лишь снять заднюю крышку и открутить четыре винта, после чего расщелкнуть клипсы и снять заднюю часть корпуса.
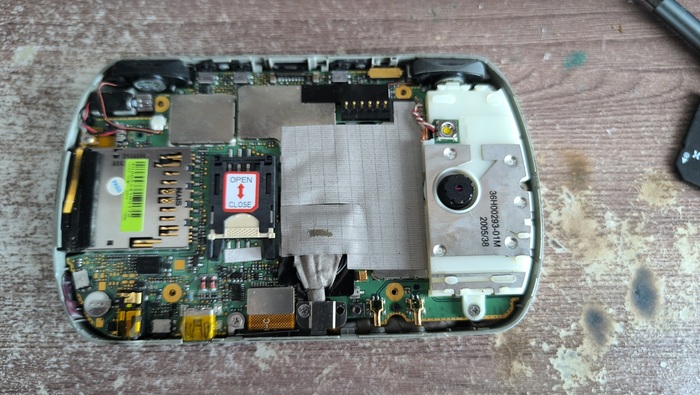
Далее нам открывается вид на материнскую плату устройства — и здесь сразу есть на что обратить внимание. Во первых, у Universal уже в 2005'ом был стереозвук — что для смартфонов тех лет было большой редкостью. Это сейчас даже в бюджетках ставят по два динамика, но в те годы это был удел исключительно флагманов.
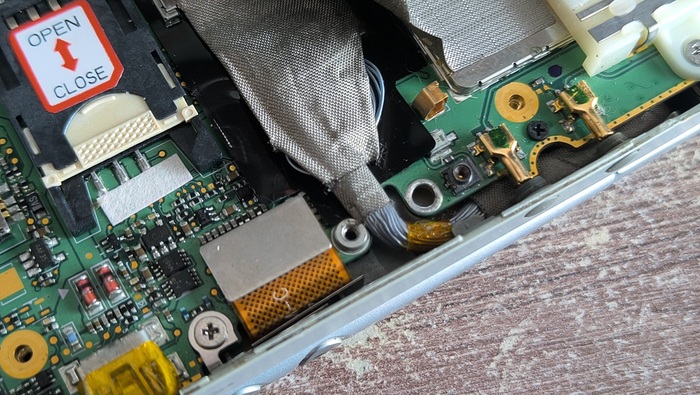
А во вторых, в качестве межплатного шлейфа используется сразу два шлейфа из жильных проводов, прямо как в Nokia E90, Toshiba Portege G900 и большинстве ноутбуков из нулевых. Такие шлейфы страдают от износа в гораздо меньшей степени, нежели обычные плоские FPC‑варианты, поэтому HTC здесь можно выразить респект. Кроме того, такие шлейфы вполне поддаются ремонту.
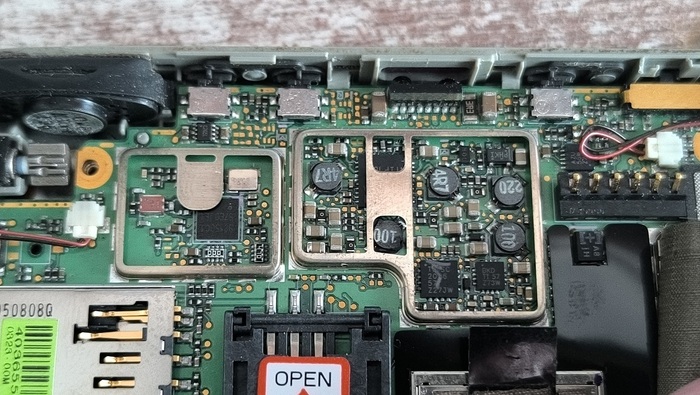
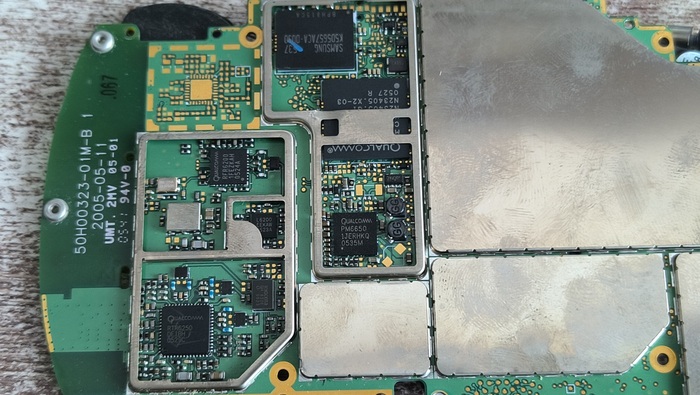
Сама плата состоит из двух частей — «периферии» вместе с RF‑частью и основных модулей. С обратной стороны скрывается периферия — можно увидеть контроллер зарядки литиевых аккумуляторов, DC‑DC преобразователи, контроллер тачскрина от Ti, а также RF‑усилитель и мелкую логику.
Основной сок находится с фронтальной части платы, где в первую очередь в глаза бросается модем. HTC Universal был первым коммуникатором на WM с поддержкой 3G, поэтому привычный Ti Calypso инженеры HTC заменили на Qualcomm MSM6250. По правде сказать, 6250'ый уже сам по себе был неплохим процессором и в одном чипе скрывал:
Одно ядро ARM926EJ‑S, работающее на частоте до ~180МГц и с ~16КБ кэша инструкций и ~16КБ кэша данных. Поскольку MSM6250 — это бейсбенд, он сам по себе мог быть центральным процессором обычного кнопочного телефона и в таком случае именно он выполняет задачи обработки пользовательского интерфейса, игр, приложений и тому подобное
Кастомный DSP под названием QDSP4000. Используется для кодирования и декодирования голоса, а также низкоуровневой работы с датаграммами GSM‑сети.
Видеоускоритель Defender2 3D. Да, это прямой предок современных Adreno, и да, он умел ускорять 3D‑графику уже в 2003 году. На тот момент это было очень круто и экзотично, первые массовые смартфоны с 3D‑ускорителями пошли только в 2006–2007 году (SE M600, Nokia N95 и iPhone 2G). Иронично что сам HTC Universal ускорение 3D не поддерживает.
Кучу периферии — включая контроллеры I2S, I2C, SPI, GPIO, клавиатуры и дисплеев.
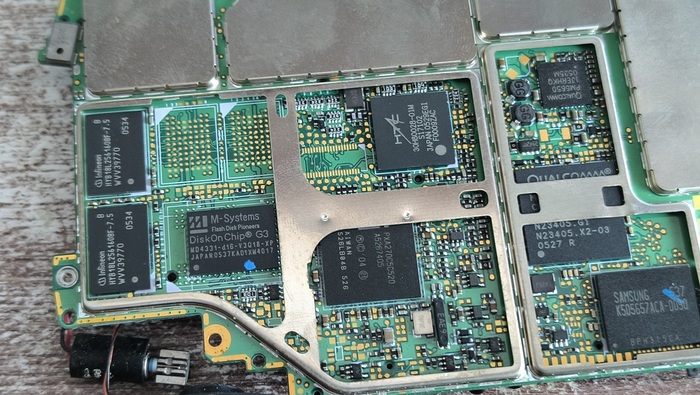
Неплохо по меркам 2003'го года, да? В паре с ним стоит специальный контроллер питания только для модема — Qualcomm PM6650, а также микросхема MCP с PSRAM и NOR‑памятью неизвестного объёма Samsung K5D5657ACA‑D090.
Правее модема расположился RF‑фронтэнд RTR6250, который скрывает в себе детали реализации приёмо‑передатчика, а также усилитель RFR6200.
Под самым большим экраном скрывается сердце устройства — процессор Intel PXA270, который в рамках блога получил статус легендарного. Внутри него скрывается:
Одно ARMv5‑совместимое ядро, построенное на микроархитектуре Intel XScale, и способное работать на частоте до 624МГц. Помимо ARMv5, XScale также поддерживал набор инструкций Wireless MMX — то есть SIMD, а также имел 32 килобайта L1-кэша инструкций + 32 килобайта L1-кэша данных.
Возможность выполнения до 800 миллионов инструкций в секунду (MIPS) при максимальной рабочей частоте.
Контроллеры шин общего назначения: UART, I2C, SPI, USB.
Периферийные модули для управления DRAM, NAND и NOR‑памятью, а также контроллер SD‑карт.
Контроллеры клавиатуры, дисплея, ШИМ, GPIO и даже встроенный RTC...
64МБ встроенной NOR‑памяти типа StrataFlash (в PXA272)
И всё это будучи изготовленным на 180нм техпроцессе!
Круто, да? Левее процессора расположились чипы SDRAM‑памяти Infineon, объёмом по 32МБ каждый. При желании их можно легко заменить на чипы по 64МБ — и получить в сумме 128 мегабайт оперативной памяти. Также рядом расположился NAND‑чип DiskOnChip с пользовательскими данными и кастомная микросхема от HTC, предположительно выполняющая роль контроллера питания или SMC.
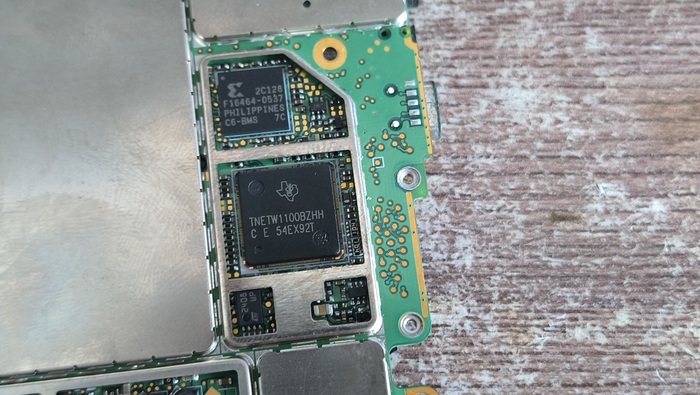
Чуть выше процессора можно увидеть чип Ti TNET, выполняющий роль Wi‑Fi контроллера, а рядом с ним трансивер MAX2820.
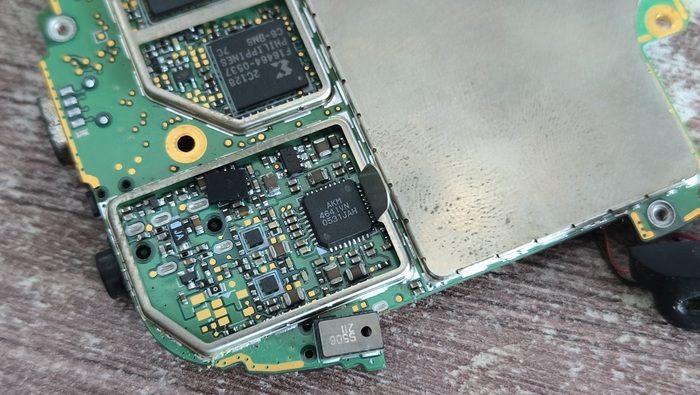
В качестве аудиокодека используется Asahi AK4641VN, подключенный к процессору через шину I2S и обеспечивающий очень даже неплохое качество звука. Флагман же!
❯ Заключение
Вот таким был HTC Universal. Девайс уж действительно вселенского масштаба и конструктивно вызывает уважение — при этом в отличии от более поздних устройств HTC у него весьма простой и адекватный обслуживаемый конструктив. В последующие годы HTC ещё раз пытались совмещать концепцию компьютера и смартфона в одном корпусе — но увы и ах, форм‑фактор не взлетел, а далее уже появился iPhone. А что вы думаете по этому поводу?
Ну а я надеюсь, что вам было интересно. Подписывайтесь на блог, чтобы не пропускать новые статьи каждую неделю! А если вам интересна тематика ремонта, моддинга и программирования для гаджетов прошлых лет — подписывайтесь на мой Telegram‑канал «Клуб фанатов балдежа„, куда я выкладываю бэкстейджи статей, ссылки на новые статьи и видео, а также иногда выкладываю полезные посты и щитпостю. А ролики (не всегда дублирующие статьи) можно найти на моём YouTube канале.“»
А если вы хотите что‑нибудь подарить из железа и увидеть о нём статью — пишите мне в Telegram. Меня очень интересуют самые разные гаджеты: начиная от игровых консолей и любых связанных с геймингом устройств, телефонов, смартфонов, КПК, заканчивая ретро‑компьютерами и ноутбуками. Кто знает, может героем следующейподобной статьи окажется ноутбук из 90-х?:‑)
Особенно сильно я люблю ковыряться в ноутбуках из начала 90-х. Источник
После обзоров устройства не продаются, а остаются в моей коллекции. Когда‑нибудь я хочу сделать музей, где к каждому устройству можно будет приложить QR и почитать мою статью. Кто знает, вдруг на следующей неделе я также подробно расскажу про девайс из вашей юности?:)
Кстати, у меня есть GameBoy Advance SP, под который я очень хочу написать игру. Однако мой экземпляр был залит водой и кофе. Может у кого‑то есть донор с дохлой платой, откуда я смог бы взять контроллер питания? У меня AGS-101.
Исследователи Томского политехнического университета разработали способ переработки каменного угля в жидкое топливо с помощью микроволнового пиролиза и специальных добавок. В результате потребление электроэнергии удалось сократить в 4,3 раза, а затраты энергии на производство 1 кг топлива — до 3,6 раза.
Во время экспериментов исследователи протестировали несколько доступных материалов. Наиболее эффективным оказался оксид железа, который помог углю лучше поглощать микроволновое излучение.
Новая технология дала немного меньший выход топлива с каждой тонны угля, но цена каждого произведенного килограмма оказалась существенно ниже благодаря меньшему потреблению электроэнергии. Полученный в процессе пиролиза газ по составу пригоден для переработки в жидкое топливо, что особенно важно для труднодоступных районов с дефицитным энергоснабжением.