Aeza

Aeza

Aeза это быстрый хостинг Телефон (бесплатно по России): 8 (800) 200-60-13 Телеграм поддержки: https://t.me/aezasupport_bot E-mail: support@aeza.ru Наш сайт: aeza.ru Чат в телеграме: https://t.me/aezachat_ru
На Пикабу
218 рейтинг 75 подписчиков 0 подписок 45 постов 12 в горячем
Награды:
Пикабу 17 лет!
1

DDoS-фильтрация для игровых серверов: что реально блокируется⁠⁠

DDoS-фильтрация для игровых серверов: что реально блокируется
DDoS-фильтрация для игровых серверов умеет провалиться так, что по графикам этого не видно. Атака срезана, входящий трафик в норме, а новые игроки не могут подключиться, и тех, кто уже в матче, выбрасывает при смене карты. Поэтому смотреть приходится на две вещи сразу: что фильтр отбросил и что в эти же минуты видели обычные клиенты.

Сколько фильтр вообще способен разглядеть, зависит от игры, версии протокола, шифрования, сети провайдера и того, где стоит узел очистки.

Какие атаки на игровой сервер останавливает сетевая фильтрация?

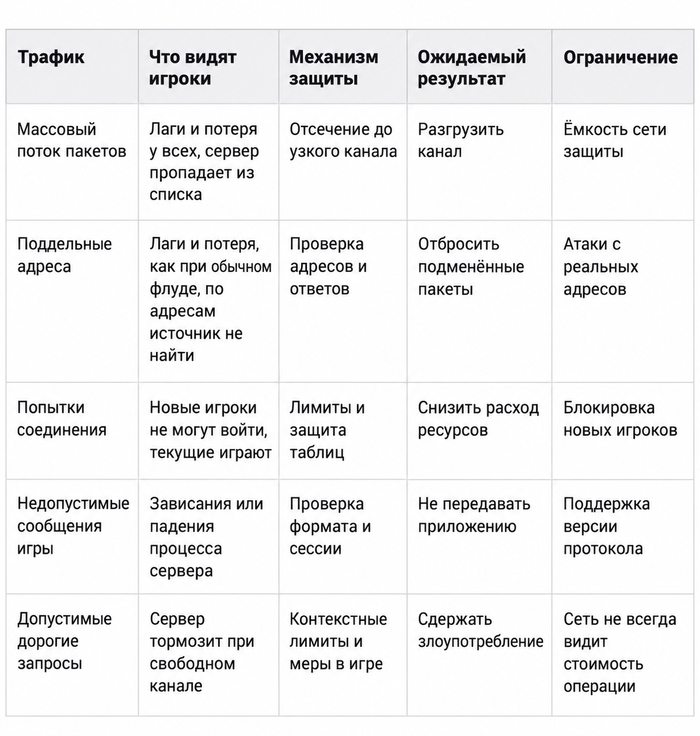
Сетевая фильтрация отсекает объёмные флуды, пакеты с подделанным адресом, попытки забить таблицы соединений и сообщения, которые нарушают формат поддерживаемой игры. Работает она на проверке адресов, лимитах частоты и правилах протокола. Читы, баги сервера и злоупотребления внутри сессии остаются за её пределами.

Канал, таблицы или сама игра

Во время атаки первым делом стоит понять, где узкое место. Вариантов три, и лечатся они по-разному.

Проще всего с забитым каналом. Трафика больше, чем пропускает порт, пакеты теряются ещё по дороге к VPS для игровых серверов, и iptables тут уже не поможет. Такую атаку останавливают выше по сети, у провайдера или в узле очистки.

Второй случай тоньше. Канал свободен, но межсетевой экран или сам сервер тратит память на записи о соединениях, которые никогда не завершатся. Когда таблица переполняется, настоящий игрок получает отказ при входе.

Третий вариант бьёт по игре. Пакеты выглядят нормально, только каждый заставляет сервер делать дорогую работу: искать игрока, пересчитывать состояние мира, отдавать список серверов. Защита игрового сервера от DDoS здесь упирается уже в логику приложения.

Отсюда привычное деление на L3/L4/L7: L3 – уровень IP, L4 – транспорт TCP и UDP, L7 – протокол самой игры. Граница условная, атака на L7 тоже приходит в UDP-пакетах, так что практичнее спрашивать, какой ресурс кончается первым.
DDoS-фильтрация для игровых серверов: что реально блокируется

Сначала запишите обычный вечер на сервере

Фильтрация UDP flood кажется простой задачей: режь всё, что выше нормы. Вся сложность в слове «норма». Вход, загрузка карты, сам матч и обновление списка серверов дают очень разную картину, и порог, выставленный по среднему, сработает как раз в самый людный момент.

Профиль нормального трафика снимают до настройки фильтров, на тестовом сервере с живыми клиентами: для каждого этапа размеры пакетов, их число в секунду и направление. Запись в PCAP тоже пригодится для разбора спорных блокировок, только перед отправкой оператору вычистите из неё токены и данные игроков.

Игроков за NAT проверьте отдельно. Мобильный оператор или сеть общежития выводят в интернет десятки людей с одного адреса, и лимит «на один IP» примет их за одного очень активного клиента. А телефон, сменивший вышку, приходит уже с новым адресом, и его повторный вход тоже должен пройти.

И добавьте в профиль реальные потери и задержки ваших игроков. Фильтр, настроенный по идеальному каналу из соседнего дата-центра, первыми начнёт резать тех, у кого связь похуже.

Антиспуфинг, лимиты и таблицы состояний

Антиспуфинг отбрасывает пакеты, чей адрес источника не мог прийти с этого направления. Против флуда с подделанных адресов он работает хорошо, а вот отражённую атаку не остановит: в ней пакеты приходят с настоящих адресов серверов-отражателей, и отсекают их уже по портам и характерным ответам. Второй приём из той же серии – challenge: фильтр отвечает клиенту кодом и ждёт его в следующем пакете. Вернуть код сможет только тот, кто действительно получает ответы на свой адрес.

Бот с настоящим IP пройдёт обе проверки, и тогда в дело вступает rate limit, который считает пакеты по адресу, порту или сессии. Только распределённая атака идёт с тысяч адресов понемногу. Индивидуальный лимит её не замечает, а общий заденет игроков, когда после рестарта все заходят разом.

Слабое место есть и у самого фильтра, это его таблицы состояний. Соединений у UDP нет, но фильтр всё равно помнит, кто с кем обменивался. Если записи появляются быстрее, чем устаревают, таблица забивается, и подключения отваливаются при полупустом канале.

Как фильтр отличает легитимный UDP-трафик?

Фильтр сверяет пакет с тем, что он знает об игре: формат, этап обмена, ответ на challenge, принадлежность к открытой сессии. Частота и источник служат дополнительными признаками. Защита игрового протокола от DDoS видит только открытые поля, поэтому при шифровании проверка сводится к адресам, размерам пакетов и ритму.

Когда фильтр знает протокол игры

Точнее всего фильтр работает, когда у провайдера есть профиль под вашу игру. Он проверяет тип сообщения, длину пакета, порядок обмена при входе и номер сессии и отбрасывает всё лишнее ещё до сервера.

Хороший пример – A2S_INFO, запрос, которым клиенты Steam узнают название сервера, карту и число игроков. Ответ на него заметно длиннее самого запроса, и этим пользовались для отражённых атак: подставляли адрес жертвы, и сервер засыпал её ответами. В конце 2020 года Valve добавила сюда challenge, и сервер может сначала потребовать проверочный код. На сам матч это не распространяется.

С шифрованием сложнее. Если полезная нагрузка закрыта, фильтру остаются адреса, размеры, частота и то, что разработчик намеренно вынес наружу. В Amazon GameLift Servers так устроен player gateway: игроки подключаются через ретрансляторы, и те пропускают к серверу только трафик с действительным токеном. Под него дорабатывают клиент и бэкенд, так что к готовой игре такую схему просто так не пристроить.

У профилей есть и обратная сторона. Вышел патч, формат пакета поменялся, и очистка игрового трафика начинает резать честных клиентов по старому правилу. К каждому обновлению держите под рукой рабочий профиль и договорённость с оператором об откате.

Тест без атаки на чужие сети

Проверять защиту придётся нагрузкой, и тут легко перейти черту. Атакующий трафик генерируют только на своей инфраструктуре или с письменного разрешения владельца, заранее согласовав адреса, длительность, пиковую нагрузку и условие остановки. VPS стоит в общей сети, поэтому провайдера предупреждают отдельно, иначе ваш тест станет инцидентом для соседей.

Сам тест несложный. Прогоните обычный игровой сценарий с реальными клиентами, а потом повторите его на фоне тестового потока с теми же версиями, числом игроков и настройками. Правила меняйте по одному, иначе не разобрать, какое сработало.

Записанный PCAP годится для проверки классификации в закрытой лаборатории. Живую сессию он не заменит: токены в записи давно истекли, и сервер отвергнет повтор. На вопрос, пускает ли фильтр игрока в матч, ответит только настоящий клиент.

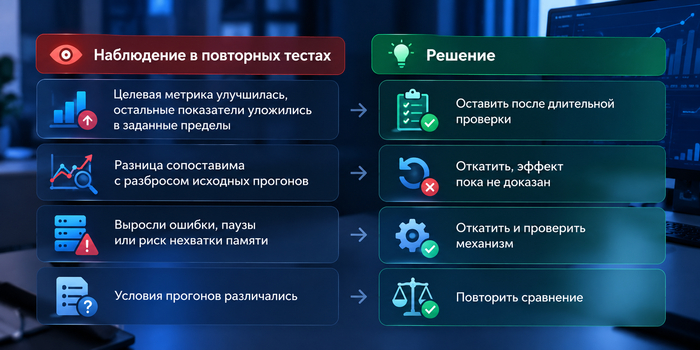
Ложные срабатывания DDoS-фильтра ищут в том же прогоне, где фильтр режет тестовый поток. В протокол испытания попадают время каждого события, конфигурация фильтра, причины блокировок и то, что в эти минуты происходило у обычных клиентов.

Что в это время видит игрок

Для игрока защита сводится к простому: нашёл сервер, вошёл, доиграл, вернулся после обрыва. Это и считайте, отдельно для тех, кто уже сидел в матче, и для новых подключений. Фильтр нередко пропускает старые сессии и рубит новые, а по общему онлайну этого не видно.

Из сетевых метрик понадобятся RTT, задержка от запроса до ответа, и jitter, её разброс, а ещё потери и доля удачных переподключений. Среднее здесь плохой помощник, оно сглаживает как раз те редкие длинные паузы, из-за которых игроки уходят. Смотрите перцентили: в p95 укладываются 95% замеров, в p99 – 99%, p50 называют медианой. И указывайте рядом период и число замеров.

Сколько задержки добавляет очистка во время атаки?

1. Одного числа нет: сравните RTT тех же клиентов до включения фильтра, во время работы и после.

2. Смотрите на p50, p95 и p99 вместе с потерями и успешностью входа, потому что хорошая медиана может прятать заметные паузы.

3. Учтите смену маршрута и время переключения: результат верен для проверенной игры, сети и режима защиты.

Мерить всё это стоит по игровому обмену, ping годится только как вспомогательная проверка. Бывает, что фильтр ломает одну часть game protocol: список серверов пуст, а по прямому адресу матч прекрасно работает.

Крюк через scrubbing-центр

Трафик чистят в scrubbing-центре, через который он идёт постоянно или только после обнаружения атаки. Во втором случае в момент переключения маршрута игроки ловят короткий провал, а дальше задержка зависит от того, как далеко узел от них и от сервера. Если центр очистки в Амстердаме, а сервер и игроки в Москве, разницу почувствуют все.

Цену крюка показывает маршрут до теста, во время него и после. Снимать его удобно через mtr, который совмещает traceroute и ping. Команда ниже отправит 100 серий проб, адрес замените своим:

mtr --report --report-wide --report-cycles 100 203.0.113.10

По умолчанию mtr шлёт ICMP, а игровые пакеты идут по UDP и через защиту могут проходить иначе. Ближе к реальности будет запуск с ключами --udp и --port и портом игрового сервера.

Обратный путь снимают с сервера к тестовому узлу в сети игрока, если до него можно достучаться через NAT. Потерь на одном промежуточном маршрутизаторе не пугайтесь: многие просто ограничивают ответы на диагностику, и раз дальше потерь нет, пакеты проходят.

У оператора защиты попросите время обнаружения атаки, переключения и стабилизации и номер сработавшего правила. Заодно уточните, увидите ли вы статистику атаки и причины блокировок сами в панели или только по запросу в поддержку. Без номера false positive не доказать, ведь журнал обычной сессии нужно сопоставить с конкретным решением фильтра.

Вопросы провайдеру до первой атаки

Разговор с провайдером защиты лучше начинать с вашей игры, а не с его тарифов. Назовите игру и версию, порты, протокол и регион игроков. Потом спросите, где начинается фильтрация, какие адреса она покрывает и что будет с трафиком протокола, которого у фильтра нет в списке. Защита сайта через HTTP-прокси к игровому UDP-порту отношения не имеет, хотя в рекламе их часто называют одинаково.

Честный ответ на последний вопрос можно найти в документации OVHcloud. Для приложений без игрового профиля там есть правило Other, и прямо сказано, что дополнительной защиты оно почти не даёт. Набор профилей при этом зависит от поколения серверов и версии игры. У другого провайдера список будет своим, так что про свою игру спрашивайте прямо.

Заранее договоритесь, как считать ошибки фильтра: для подключений это доля отрезанных обычных клиентов среди всех обычных клиентов теста, для пакетов знаменатель другой, весь заведомо легитимный трафик. Latency overhead от защиты сравнивайте с замерами без неё при тех же условиях.

До запуска напишите короткую инструкцию на случай сбоя: контакты дежурного, тестовый адрес, журналы, порядок эскалации и отката правила. Если правило режет игроков посреди атаки, просите узкое временное исключение. Выключить защиту целиком – самый быстрый способ вернуть ту перегрузку, от которой она спасала.

Проверку удобнее всего начинать с одного сценария, который легко повторить: новый игрок находит сервер, заходит и переживает смену карты, пока фильтр работает. Если на каком-то шаге он отваливается, просите у оператора причину блокировки конкретных пакетов, а не очередной график мощности защиты. DDoS-фильтрация для игровых серверов полезна ровно настолько, насколько оператор может показать сработавшее правило и быстро его откатить. После исправления прогоните тот же сценарий ещё раз и зайдите на сервер сами, как обычный игрок.

Показать полностью 2
1

Параметры ядра Linux, которые стоит менять, и те, что ничего не дают⁠⁠

Параметры ядра Linux, которые стоит менять, и те, что ничего не дают

Параметры ядра Linux, которые стоит менять, обычно ищут в чужих sysctl.conf с названиями вроде «тюнинг для высоконагруженного сервера». Многие строки в таких списках крутят то, во что ваш сервер вообще не упирается. Классический пример – порог грязных страниц. Его подняли, короткий тест на запись стал быстрее, а под долгой нагрузкой паузы вернулись: накопленное всё равно приходится отдавать диску, просто позже и разом.

Эффект любой строки зависит от версии ядра, cgroup, объёма RAM, диска и нагрузки. В контейнере часть параметров принадлежит хосту, и изменить их изнутри не дадут. Для таких экспериментов подойдёт аренда VPS-сервера с отдельным окружением, без соседних приложений, чтобы чужая нагрузка не смешалась с вашей.

Какие параметры ядра чаще дают измеримый эффект?

Чаще всего измеримый эффект дают пороги грязных страниц при задержках записи, swappiness при реальной нехватке памяти и файловые лимиты при отказах с ошибкой EMFILE или ENFILE. Каждая настройка действует на свой механизм, и проверяют её по задержкам приложения. Если тормозит что-то другое, улучшения не будет.

Сначала причина задержки, потом строка в sysctl

Для рабочего тюнинга sysctl Linux сначала нужно поймать, чего именно ждёт приложение в момент торможения. Если памяти не хватает, ядро освобождает страницы. Если накопилась запись, оно отправляет грязные страницы на диск. Sysctl меняет то, как распределяется эта работа, а медленный SQL-запрос или тормозящий внешний API никакой параметр ядра не ускорит.

Гипотезу стоит записать до изменения, обычными словами: «во время выгрузки накапливаются грязные страницы, и запись на диск задерживает запросы API». К ней добавьте критерий успеха, например p99 ответа не выше 200 мс при заданном темпе запросов и без роста ошибок. Цифра здесь условная, её выбирают под свой сервис.

Пик p99 может совпасть с ожиданием диска случайно. Прежде чем трогать пороги записи, сверьте системные метрики с журналом приложения: в ту же минуту API мог ждать ответа от внешнего сервиса.

Снимок состояния до первого изменения

Даже полезные параметры ядра сравнивают при одинаковых условиях: та же версия приложения, те же данные, число клиентов, темп запросов, прогрев и длительность. Начать стоит со снимка системы:

uname -r
cat /etc/os-release
stat -fc %T /sys/fs/cgroup
free -h
swapon --show
lsblk -o NAME,TYPE,SIZE,FSTYPE,MOUNTPOINTS
sysctl vm.swappiness vm.dirty_background_bytes \
vm.dirty_background_ratio vm.dirty_bytes vm.dirty_ratio

Если stat вернул cgroup2fs, система работает с cgroup v2. Для приложения в контейнере или отдельной службе загляните ещё в memory.max, memory.high и memory.swap.max. Свободная RAM на хосте процессу не поможет, если его собственный лимит памяти уже исчерпан.

Исходный прогон повторите несколько раз. Понадобятся p50, p95 и p99 времени ответа, успешные запросы в секунду, ошибки и таймауты. Перцентили здесь полезнее среднего: в p99 укладываются 99% запросов, и как раз в оставшемся проценте прячутся редкие паузы, которые среднее размывает. Число наблюдений и способ расчёта тоже запишите.

Мало свободной RAM ещё не повод трогать swappiness

Когда памяти не хватает, у Linux два пути: выбросить часть файлового кэша и потом перечитать данные с диска или выгрузить страницы процессов в swap. Настройка vm.swappiness задаёт, насколько дорогим ядро считает второй путь по сравнению с первым.

На современных ядрах значения идут от 0 до 200. При 100 оба пути стоят одинаково, меньшие значения делают swap дороже. Ноль swap не отключает, это частое заблуждение. А для сжатого swap в памяти вроде zram разумными бывают и значения выше 100.

Трогать swappiness или нет, решают по трём источникам. Столбцы si и so в vmstat показывают чтение из swap и запись в него. Major faults в pidstat отражают подгрузку страниц, но источником бывает и обычный файл. PSI показывает, какую долю времени задачи ждали память: строка some значит, что ждала хотя бы часть задач, а avg10 усредняет это за 10 секунд.

vmstat 1
pidstat -r -p PID 1
cat /proc/pressure/memory

PID замените номером процесса, pidstat входит в пакет sysstat. Первую строку vmstat пропустите, в ней средние с момента загрузки. Отсутствие файла PSI записывайте как «нет данных»: это совсем не то же самое, что ноль.

Какие популярные sysctl обычно ничего не меняют?

Чаще всего впустую поднимают fs.file-max, когда процесс упёрся в собственный лимит nofile, и крутят swappiness на сервере, где память не кончается. Порог грязных страниц тоже не ускоряет вычисления. Любая настройка помогает, только когда влияет на тот ресурс, который сейчас ограничивает приложение.

Мифы о тюнинге Linux часто начинаются с красивого вывода free. Регулярный drop_caches «освобождает» память только на графике: он выбрасывает чистый кэш, и системе приходится снова читать файлы с диска. Если холодный кэш действительно бывает в вашей задаче, например после рестарта, проверяйте его отдельным сценарием.

Грязные страницы и отложенный счёт за запись

Грязной называют страницу кэша, изменения в которой ещё не записаны на диск. Всё, что ниже, касается только буферизованной записи: O_DIRECT идёт мимо кэша, и пороги на него не действуют. После dirty_background_bytes или dirty_background_ratio ядро начинает писать в фоне, а после dirty_bytes или dirty_ratio притормаживает сам пишущий процесс. Чем выше пороги, тем больше работы откладывается и тем крупнее счёт, который потом придёт разом.

У каждого порога есть байтовый и процентный вариант, и работает только один из них: запись одного обнуляет второй. Процент считается от памяти, доступной под кэш, вместе со свободными и освобождаемыми страницами, а вовсе не от всей установленной RAM.

Параметры dirty pages в Linux проверяют по Dirty и Writeback в /proc/meminfo, ожиданию диска и p99 во время всплеска и после него:

awk '/^(Dirty|Writeback):/ {print}' /proc/meminfo
iostat -xz 1

Показатель await в iostat складывается из времени в очереди и времени обслуживания. Замер не обрывайте вместе с нагрузкой. Дождитесь, пока очередь записи вернётся к обычному размеру, иначе тест закончится раньше, чем ядро допишет накопленное.

У высокого порога есть и вторая цена: при сбое питания пропадёт больше несохранённых данных. За сохранность записи отвечает само приложение, вызывая fsync, и sysctl здесь ничего не меняет. При откате пары bytes/ratio возвращайте тот вариант, который был активен до эксперимента: последний записанный параметр обнуляет напарника, так что порядок команд важен.

THP и файловые лимиты требуют разных доказательств

Прозрачные большие страницы, THP, уменьшают накладные расходы на трансляцию адресов. Но чтобы собрать большую страницу, ядру иногда приходится уплотнять память, и приложение в этот момент ловит паузу. Отсюда популярный совет «просто отключите THP». Для одних баз он оправдан, для других нагрузок вреден, так что ориентируйтесь на рекомендации разработчиков приложения, счётчики уплотнения и распределение задержек.

cat /sys/kernel/mm/transparent_hugepage/enabled
cat /sys/kernel/mm/transparent_hugepage/defrag

Настраивается THP через sysfs, а не через sysctl. На ядрах с mTHP есть отдельные переключатели для разных размеров страниц, а never в общем переключателе не обязательно запрещает приложению явный запрос MADV_COLLAPSE. Режимы сравнивайте по реально используемым большим страницам и с одинаково подготовленным процессом.

С файловыми лимитами всё решает текст ошибки. EMFILE значит, что процесс упёрся в собственный лимит дескрипторов, его задаёт nofile. ENFILE означает, что файловые объекты кончились во всей системе, и тогда смотрят на fs.file-max. Лимит, который показывает ulimit в вашей SSH-сессии, к службе под systemd отношения не имеет, у неё свой.

cat /proc/sys/fs/file-nr
systemctl show app.service -p LimitNOFILE -p LimitNOFILESoft
cat /proc/PID/limits

Вместо app.service и PID подставьте свою службу и номер процесса, а для контейнера проверьте ещё параметры его запуска. При ошибке EMFILE повышение fs.file-max её не уберёт. А когда дескрипторы утекают, любой новый лимит только отодвинет следующий отказ.

Один эксперимент и одинаковые условия

Бенчмарк изменений sysctl проверяет одну гипотезу за раз. Прогоны исходного и нового режима чередуйте парами, A–B и B–A, на тех же данных, с тем же прогревом и длительностью. Если поменять swappiness и пороги записи одновременно, вклад каждой настройки уже не разделить.

Генератор нагрузки умеет подыграть результату. Когда он ждёт ответа перед каждым следующим запросом, медленный сервер просто получает меньше запросов, и задержки выглядят лучше реальных. Генератор с фиксированным темпом, например k6 со сценарием constant-arrival-rate, шлёт запросы по расписанию, не дожидаясь ответов. Записывайте заданный и фактический темп и следите, чтобы сам генератор не упирался в CPU. Измерение должно захватить несколько циклов записи и освобождения памяти.

Задержки считайте по успешным ответам, а ошибки и таймауты выводите отдельной строкой. Молча выброшенные таймауты делают p99 лучше настоящего. Системные метрики собирайте одинаково в обоих режимах: те же команды, тот же интервал и длительность.

Как безопасно тестировать и откатывать каждое изменение?

1.  Сохраните исходное значение и проверьте команду возврата ещё до нагрузочного теста.

2.  Меняйте один параметр временно, повторите ту же нагрузку и следите за целевой метрикой и побочными эффектами.

3.  При ухудшении верните исходное значение, а в постоянную конфигурацию переносите только после длительного теста и перезагрузки.

Возврат значения и возврат состояния не одно и то же

Порядок одинаков для любого параметра, ниже он показан на swappiness. Значение 20 взято для эксперимента, ставить его на любой VPS не нужно:

sysctl vm.swappiness > swappiness.before.conf
sudo sysctl -p swappiness.before.conf
sudo sysctl -w vm.swappiness=20
sysctl vm.swappiness > swappiness.after.conf
diff -u swappiness.before.conf swappiness.after.conf

Дальше тот же прогрев и та же нагрузка, после чего сохранённое значение возвращается:

sudo sysctl -p swappiness.before.conf
sysctl vm.swappiness

Первый вызов sysctl -p, ещё до изменения, проверяет, что команда возврата вообще работает. Ошибка на нём – повод эксперимент не начинать. Откат при этом возвращает значение, но не состояние системы: вытесненные из кэша страницы сами не вернутся. Поэтому workload baseline сравним лишь при одинаковом прогреве перед каждым прогоном.

Одного короткого прогона для решения мало. Тест стоит продолжить длительной работой, пиком нагрузки, рестартом службы и восстановлением после пика. На стенде проверьте поведение при нехватке памяти и малом запасе места, но рабочий раздел для этого не заполняйте. Тест останавливают сразу, когда ошибки, задержки или потребление памяти выходят за заданные заранее пределы.

Подтверждённое значение кладут в отдельный файл в /etc/sysctl.d/ и применяют именно его, командой sysctl -p с путём к файлу. После перезагрузки значение проверяют ещё раз, потому что его может переписать другой конфиг или служба. А удаление файла уже действующее значение не откатит, его возвращают командой. THP при старте настраивают записью в sysfs, а лимиты служб задают в настройках systemd.

Решение остаётся вместе с условиями теста

Каждый before/after benchmark заканчивается строкой в журнале экспериментов: гипотеза, параметр, исходный результат, изменение, новый результат, побочный эффект и решение. Рядом лежат сырые данные, diff настроек, версия ядра, конфигурация VPS и имя того, кто проводил тест.

Параметры ядра Linux, которые стоит менять, и те, что ничего не дают

После смены ядра, объёма RAM, диска или профиля запросов проверку повторяют: прежнего ограничения может уже не быть. В комментарии к самой настройке стоит оставить причину и ссылку на запись в журнале.

Удачный итог такой работы обычно выглядит скромно: две-три строки в /etc/sysctl.d/, и у каждой есть причина, замер и команда отката. Список параметров ядра Linux, которые стоит менять, храните рядом с описанием нагрузки, чтобы администратор, которому достанется сервер, понимал, откуда взялась каждая строка. Если объяснение потерялось, верните исходное значение на стенде и посмотрите, изменится ли что-нибудь.

Показать полностью 1
1

Снапшоты не бэкапы: от чего защищает каждый⁠⁠

Снапшоты не бэкапы: от чего защищает каждый

Снапшоты не бэкапы, хотя в панели хостинга они часто стоят рядом и выглядят одинаково: кнопка, дата, откат. Разница проявляется в день, когда умирает массив. Снимок лежал на нём же, рядом с диском, и пропал вместе с ним, а кнопка отката в панели может остаться, хотя читать данные уже неоткуда.

По одному названию границу провести не получится. Снимок бывает выгружен в отдельное хранилище, а бэкап может лежать на соседнем диске под теми же правами удаления. Решают две вещи: от чего зависит копия и восстанавливали ли из неё хоть раз.

Почему снапшот VM не считается бэкапом?

Локальный снапшот обычно хранит блоки и метаданные на том же хранилище, что и сама VM, поэтому при потере хранилища пропадают обе копии. Бэкапу нужен независимый путь восстановления. Снапшот может стать его основой, если данные выгружены отдельно, защищены от удаления и проверены восстановлением.

Где лежат блоки снапшота, реплики и бэкапа

Снапшот против бэкапа – прежде всего спор о том, где лежат блоки. Снапшот фиксирует состояние диска на выбранный момент. Внутренние снапшоты qcow2 живут в том же файле образа и делят с текущим состоянием часть блоков. Во внешней цепочке новые записи уходят в отдельный файл поверх базового образа, и верхний файл без остальной цепочки диск целиком не содержит.

Реплика держит ещё одну копию, почти совпадающую с текущей. При отказе узла или хранилища она выручает, но удаление и шифрование приезжают на неё так же быстро, как обычные записи. Чтобы вернуться назад во времени, нужна отдельно сохраняемая история версий.

Бэкап хранит восстанавливаемую версию отдельно от рабочего источника и живёт по своему сроку хранения. Делать его из снапшота вполне нормально, многие системы так и работают. Проверять нужно, переживёт ли копия тот отказ, ради которого её делали.

В Amazon EBS это хорошо видно. Удаление тома снапшоты не трогает, от исходного тома они больше не зависят. А вот зависимость от аккаунта, сервиса и ключа шифрования остаётся.

Что осталось в памяти приложения

Снапшот диска видит только записанные блоки. Всё, что приложение и ОС держат в памяти, в снимок может не попасть. Такое состояние называют crash-consistent: оно похоже на выдернутый шнур питания, и файловая система с базой поднимаются по своим журналам. Успешная загрузка ОС проверяет только ОС, приложение смотрят отдельно.

Application-consistent бэкап делают с приложением, которое заранее подготовили к копированию. Сброс буферов дописывает незаписанные данные на диск, а заморозка файловой системы останавливает изменения на время снимка. Обычно эти шаги выполняет guest agent. Установить его мало: нужно убедиться, что для вашей базы он действительно вызывает заморозку или скрипт подготовки.

У PostgreSQL правила на этот счёт чёткие. Атомарный снимок всех файлов кластера вместе с WAL, журналом транзакций, годится для восстановления так же, как после сбоя питания, если соблюдены требования СУБД. Трудно становится, когда данные, WAL и табличные пространства лежат на разных томах: их надо снимать одновременно, а разновременные снимки дают несовместимый набор. Надёжнее в таком случае штатный бэкап СУБД с нужными журналами.

Понять, от чего защищает снапшот, можно по восстановленному приложению: целы ли подтверждённые записи, связи объектов и файлы, на которые ссылается база. И помните, что откат VM не вернёт платёж, ушедший во внешнюю систему, и не отзовёт отправленное письмо.

Один пароль может удалить все копии

Область отказа – всё, что ломается от одной причины: массив, площадка, аккаунт администратора. Второй сервер в той же стойке спасёт при поломке первого, а при пожаре в здании сгорят оба.

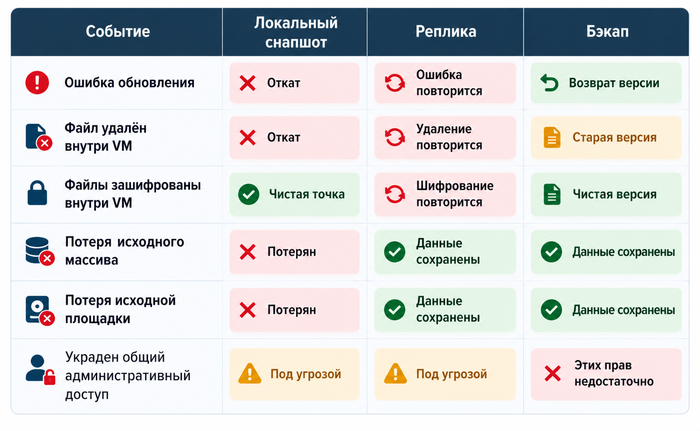
Таблица ниже сравнивает три механизма в типовой схеме. Локальный снапшот лежит на исходном хранилище. Реплика дисков стоит на другой площадке, но без истории версий и под общими правами. Бэкап тоже вынесен на другую площадку, только в независимый аккаунт, и к моменту инцидента у него есть чистая точка и доступ к ключам.

Снапшоты не бэкапы: от чего защищает каждый

Ограничения снапшота VM особенно заметны, когда удаляют саму машину. Одни платформы сохранят снимки дисков, другие удалят их вместе с VM. Для возврата понадобятся ещё описание VM, метаданные цепочки и доступ к управлению, так что поведение своей платформы лучше проверить на тестовой машине.

От каких сбоев восстанавливает снапшот?

Снапшот возвращает состояние до неудачного обновления, удаления файла или другой ошибки внутри VM, если сохранились нужная точка, её данные и доступ к управлению. Выполненные внешние операции он не отменит. Переживёт ли снимок потерю тома, площадки или аккаунта, зависит от архитектуры платформы.

С шифровальщиком снапшот как раз помогает: вирус внутри гостевой ОС до прежнего снимка обычно не дотягивается. Хуже, если захвачен аккаунт гипервизора, тогда злоумышленник удалит все копии, до которых достают эти права. А если заражение сидит во всех сохранённых версиях, защита от удаления чистого состояния не вернёт.

Риски долгого хранения снапшотов

Риски долгого хранения снапшотов начинаются с места на диске. Разностный снимок держит блоки старого состояния, и каждая новая запись увеличивает объём изменений, даже если данных внутри VM почти не прибавилось. Следите за свободным местом, глубиной цепочки и скоростью роста: заполненное хранилище может остановить VM вместе со всеми точками возврата.

Удалить снимок тоже бывает непросто. Hyper-V при удалении сливает файлы изменений .avhdx с родительскими дисками, и удалять такой файл вручную нельзя. Слияние нагружает диск, и как оно скажется на приложении, проверяют на своей платформе.

Облачные платформы устроены иначе. В EBS удаление раннего инкрементального снапшота не ломает последующие, сервис сам сохраняет нужные им блоки. В локальном qcow2 порядок очистки другой, так что правило «для отката нужна вся цепочка» верно не везде, и сверять его надо с документацией своей платформы.

Срок хранения зависит от задачи отката, свободного места и платформы, универсального числа дней тут нет. Снимок перед обновлением убирайте, когда результат проверен и есть независимая копия.

Копия, до которой не доберётся авария источника

Под каждый сценарий отказа нужна своя независимость. От потери массива защищает другое хранилище, от потери площадки другая площадка, а от кражи рабочего аккаунта отдельные права на управление копией. Другой бакет под тем же всесильным ключом оставляет злоумышленнику общий способ удалить всё.

Внешний immutable-бэкап запрещает менять и удалять сохранённую версию до конца заданного срока, но исключения у него бывают. У S3 Object Lock режим governance можно обойти со специальным правом, а compliance не даёт удалить защищённую версию до конца срока даже root-пользователю. Закрытие аккаунта при этом остаётся отдельной угрозой.

Шифрование скрывает содержимое, но удалить объект не мешает. А без ключа зашифрованная копия бесполезна и для вас. Заранее продумайте, как получить ключи, не обращаясь к погибшей VM и к рабочим учётным данным, которые могли украсть.

Вместе с данными сохраните конфигурацию VM, порядок дисков, настройки сети и зависимости приложения. Секреты держат в защищённом хранилище с отдельным доступом, а в инструкции указывают, где они лежат и кто за них отвечает. Открытые пароли рядом с образом не кладут.

Два восстановления одного приложения

Оба механизма проверяют на одном сценарии: одна версия приложения, одни данные и одинаковые проверки результата. Сначала откат после неудачного изменения, пока источник доступен. Потом восстановление того же состояния из бэкапа в чистую среду, где исходного хранилища нет. Скрытые зависимости обычно всплывают как раз во втором тесте.

Перед откатом остановите запись, выберите точку до изменения и при необходимости сохраните текущее состояние для разбора. Снимок применяйте штатным способом платформы, а базу и приложение проверяйте до того, как пустить пользователей. Внешние интеграции тестовой VM отключите заранее, чтобы она не отправила письма или платежи второй раз.

Для независимого пути понадобятся новые диски, совместимая среда, сама копия и ключи. Данные и конфигурацию восстанавливают, а затем повторяют те же прикладные проверки. Тест засчитывается, когда при недоступном исходном хранилище приложение читает нужные записи и выполняет контрольную операцию. Статус «restore completed» в консоли для этого слабое доказательство.

По ходу обоих тестов записывайте время начала сбоя, каждый этап восстановления, последнюю восстановленную подтверждённую запись и момент готовности сервиса, а вместе с ними ошибки и ручные действия, включая ожидание доступов. Из этих записей потом и получаются две рабочие процедуры: быстрый откат и восстановление после потери источника.

Какой минимум бэкапа закрывает слепые зоны снапшота?

1.  Сохраните восстанавливаемую копию вне области отказа источника, с историей версий под требуемый срок возврата.

2.  Отделите права удаления и доступ к ключам, а копию защитите от изменения или держите отключённой от сети.

3.  Восстановите приложение в чистой среде без исходной VM и хранилища, проверьте данные и запишите время восстановления.

У каждого слоя своё расписание

Снапшоту достаётся откат конкретного изменения, бэкапу восстановление версий после потери источника. Реплика сокращает простой при аппаратном отказе, пока её состояние пригодно для работы.

RPO задаёт, сколько данных можно потерять. Цель в 15 минут значит, что пропасть могут записи максимум за последние четверть часа, и ежечасная копия её не выполнит. Частый запуск тоже не спасает, если задание падает с ошибкой или старательно сохраняет уже повреждённые данные.

Для базы удобно совмещать периодический полный бэкап с непрерывным архивированием журналов. Тогда проверяют, что вся цепочка журналов на месте и восстановление на выбранный момент работает. Реплика без истории такую схему не заменит: удаление, которое заметили через час, к этому времени уже есть на обеих сторонах.

Что спросить у сервиса до аварии

Где хранятся данные и метаданные? Какие права удаляют копию? Что останется после удаления VM, тома или аккаунта? Как достать данные, если панель недоступна? На ответ «у нас три реплики» стоит задать встречный вопрос: кто может удалить все три.

Проверьте экспорт и создание новой VM в чистой среде, которую поддерживает сервис. Для qcow2 нужны все слои цепочки или полный образ. Файлы образов копируют только с остановленной VM и без процессов, которые в них пишут, а для работающей машины есть штатный механизм бэкапа.

RTO задаёт допустимое время простоя. Измерять его нужно по всему пути до восстановления услуги: доступы, ключи, перенос данных, база, сеть и проверка приложения. С целью сравнивайте полное время теста, а время самой команды отката пригодится разве что для отчёта о скорости хранилища.

Назначьте ответственных, период проверок и поводы для внепланового теста, например смену платформы, формата копии или ключей. Инструкцию полезно отдать другому администратору и ничего не подсказывать: так находятся привычные действия, которые никто не записал.

Снапшоты – не бэкапы, но вместе они закрывают большую часть сценариев. Перед следующим обновлением запишите в плане два проверенных маршрута: локальный откат и восстановление после потери источника. У каждого должны быть владелец, доступы и понятный критерий готовности приложения. Если второй маршрут заканчивается просьбой подключить прежний массив, значит, зависимость от него никуда не делась.

Показать полностью 1
1

Установка Docker на VPS: от пакета до первого контейнера⁠⁠

Установка Docker на VPS: от пакета до первого контейнера

Установка Docker на VPS обычно заканчивается на hello-world: приветствие напечаталось, значит, всё работает. Для движка так и есть. Другие вопросы всплывают через месяц: какие порты сервер теперь отдаёт в интернет, куда пропали данные после обновления образа и почему у пользователя из группы docker фактически есть root. Их проще закрыть сразу, пока на сервере нет базы.

Ниже весь путь от чистого VPS с Ubuntu 24.04 LTS до веб-сервиса в Compose с отдельным томом. Нужны виртуальная машина, доступ по SSH и sudo. На Ubuntu 26.04 команды те же, отличается только кодовое имя в версиях пакетов. У Debian и других дистрибутивов свой репозиторий Docker, и смешивать инструкции не стоит.

Ставить Docker из официального репозитория или пакета ОС?

Для свежей установки берите официальный репозиторий Docker: Engine, CLI и плагины приходят из одного источника и обновляются вместе, а APT проверяет подпись ключом Docker. Пакет docker.io собирает сам Ubuntu, версии в нём обычно старше. На работающем сервере смену источника планируют отдельно.

Сначала выясните, что уже есть на сервере

Docker официально поддерживает Ubuntu 24.04 на amd64, arm64 и нескольких других архитектурах, но первым делом стоит проверить виртуализацию. Контейнеры работают на ядре самого VPS. На KVM ядро у машины своё, а при контейнерной виртуализации оно общее с хостом, и провайдер может отрезать нужные Docker возможности. Переустановкой Docker это не лечится.

Установку удобно сразу писать в журнал. Утилита script сохранит в файл все команды вместе с выводом, так что пароли и токены во время записи лучше не вводить. Закрывается запись командой exit, но это уже в самом конце.

mkdir -m 700 docker-check

cd docker-check

script -q -a install.typescript

date -Is

cat /etc/os-release

dpkg --print-architecture

uname -r

systemd-detect-virt

free -h

df -hT /

df -i /

Из вывода нужны свободная память, место на диске и запас inode, записей о файлах. Про inode часто забывают, а когда они кончаются, диск перестаёт принимать новые файлы при свободных гигабайтах. Образы и логи занимают место быстрее, чем кажется в день установки.

Перед тем как установить Docker на VPS из официального репозитория, проверьте, нет ли в системе пакетов, которые с ним конфликтуют. Удалять их стоит с пониманием, что на них держится: на узле Kubernetes, например, удаление containerd остановит всю его нагрузку.

dpkg-query -W -f='${binary:Package}\t${Status}\n' \

docker.io docker-compose docker-compose-v2 docker-doc \

docker-buildx podman-docker containerd runc

Ненайденный пакет – хороший знак, его просто нет. Если нашёлся docker.io, сначала посмотрите, что APT собирается удалить вместе с ним, и только потом удаляйте:

sudo apt -s remove docker.io

sudo apt remove docker.io

Один репозиторий и проверенный ключ

Настройка Docker Engine на VPS начинается с репозитория. В официальной инструкции ключ скачивают сразу в /etc/apt/keyrings. Здесь он сначала сохраняется в рабочий каталог и попадает в систему только после сверки отпечатка.

sudo apt update

sudo apt install ca-certificates curl gnupg

curl -fsSL https://download.docker.com/linux/ubuntu/gpg \

-o docker.asc

gpg --show-keys --fingerprint docker.asc

Отпечаток ключа Docker Release (CE deb) должен совпасть с этим:

9DC8 5822 9FC7 DD38 854A E2D8 8D81 803C 0EBF CD88

Сверяйте все 40 символов: последние восемь, короткий ID, подделать гораздо проще. При несовпадении дальше не идите и сначала выясните по официальным материалам Docker, не сменился ли ключ.

После сверки ключ и описание репозитория в формате deb822 устанавливаются так:

sudo install -d -m 0755 /etc/apt/keyrings

sudo install -m 0644 docker.asc /etc/apt/keyrings/docker.asc

sudo tee /etc/apt/sources.list.d/docker.sources >/dev/null <<EOF

Types: deb

URIs: https://download.docker.com/linux/ubuntu

Suites: $(. /etc/os-release && echo "${UBUNTU_CODENAME:-$VERSION_CODENAME}")

Components: stable

Architectures: $(dpkg --print-architecture)

Signed-By: /etc/apt/keyrings/docker.asc

EOF

sudo apt update

apt-cache policy docker-ce docker-ce-cli

Signed-By разрешает ключу подписывать только этот репозиторий, на остальные источники он не влияет. В выводе apt-cache policy у Candidate должен стоять download.docker.com с компонентом stable и кодовым именем noble. Ошибку подписи разбирайте до конца: отключить проверку проще, но тогда ключ теряет смысл.

Пять пакетов для установки

Самая свежая версия Engine на 14 октября 2026 года – 29.9.0. Номер в команде зафиксирован, чтобы на втором сервере встало ровно то же самое. Перед установкой сверьтесь с apt-cache madison и при необходимости замените строку целиком, с префиксом 5: и суффиксом Ubuntu.

apt-cache madison docker-ce

docker_version='5:29.9.0-1~ubuntu.24.04~noble'

sudo apt install docker-ce="$docker_version" \

docker-ce-cli="$docker_version" containerd.io \

docker-buildx-plugin docker-compose-plugin

sudo systemctl enable --now docker.service containerd.service

sudo systemctl is-active docker

sudo systemctl is-enabled docker

sudo docker version

sudo docker compose version

dpkg-query -W docker-ce docker-ce-cli containerd.io \

docker-buildx-plugin docker-compose-plugin

В docker-ce лежит сам Engine, сервер, которым управляет CLI из docker-ce-cli. containerd.io запускает контейнеры, Buildx собирает образы, а Compose поднимает сервисы по файлу. Compose здесь работает как плагин, и команда пишется через пробел: docker compose. Старый docker-compose с дефисом из пакетов Ubuntu ставить не нужно.

В выводе docker version ищите два блока, Client и Server. Если второго нет, CLI не достучался до сервера. Статус active значит, что служба работает, enabled – что она поднимется после перезагрузки. Первый контейнер на VPS запустим позже, сначала проверим сам сервер.

Как безопасно запускать Docker без root?

Для работы без root используйте rootless-режим: в нём и сервер Docker, и контейнеры запускаются от обычного пользователя. Группа docker эту задачу не решает: её участник управляет системным сервером, а тот работает от root. Rootless требует пользовательских пространств имён, а сеть и лимиты через cgroup в нём ограничены.

Что проверить в docker info

Установка Docker из репозитория закончена, и самое время сохранить параметры сервера и свежий журнал. Если через месяц что-то сломается, будет с чем сравнить.

sudo docker info

sudo docker info --format '{{.DriverStatus}}'

sudo docker system df

sudo journalctl -u docker -u containerd -b --no-pager -n 100

На чистой установке Engine 29 образы хранит containerd, а слои собирает snapshotter overlayfs: контейнер видит файловую систему из слоёв образа и пишет свои изменения поверх. После обновления со старой версии в docker info может остаться драйвер overlay2. Трогать его без причины не нужно, после смены хранилища прежние образы и контейнеры пропадут из вида.

У такой схемы есть последствие для дисков. Образы и слои лежат в /var/lib/containerd, а тома и прочие данные Docker в /var/lib/docker. Смена Docker Root Dir переносит только второй каталог, так что при разнесённом хранении место придётся смотреть на обоих.

Ещё в docker info стоит найти Cgroup Driver и Cgroup Version: от них зависят лимиты CPU и памяти. Рядом стоит Logging Driver, он решает, куда уходят логи контейнеров. Если служба не стартует, причину почти всегда видно в journalctl. Чужой daemon.json целиком лучше не копировать: одной неподходящей опции хватит, чтобы dockerd не запустился.

Группа docker даёт больше прав, чем кажется

Во всех командах этой статьи стоит sudo, и это сознательный выбор. Участник группы docker может запустить контейнер с подключённым корнем хоста и переписать любой системный файл, так что членство в группе равносильно root. По той же причине запись в /var/run/docker.sock не открывают всем и не прокидывают сокет в контейнеры без крайней нужды.

Rootless эту проблему снимает, зато приносит свои. Сервер Docker работает как пользовательская служба systemd и без включённого linger останавливается после выхода из SSH. Лимитам ресурсов нужны cgroup v2 и делегирование контроллеров, а порты ниже 1024 придётся разрешать отдельно.

Docker Compose на VPS получает ровно те полномочия, что и CLI, через который его запускают, отдельной защиты у него нет. Запуск приложения внутри контейнера от обычного пользователя настраивают в образе или compose.yaml, и к rootless на хосте он отношения не имеет.

Порт 8080 может открыться вопреки UFW

Запись 8080:80 пробрасывает порт 8080 хоста на порт 80 контейнера, причём по умолчанию на всех адресах хоста. EXPOSE в Dockerfile ничего не публикует, он только документирует container ports, которые слушает приложение. Наружу порт открывают флаг -p или секция ports в Compose.

Для теста порт привязывается к 127.0.0.1:8080:80: сервис виден с самого VPS и через SSH-туннель, но не из интернета. Для внешней публикации указывают адрес нужного интерфейса. Публичный IP за NAT провайдера может вообще не принадлежать интерфейсу машины, и привязать к нему порт не получится.

С firewall связан главный сюрприз этого раздела. Docker сам пишет правила для своих мостовых сетей, и пакет к опубликованному порту идёт по цепочке пересылки, мимо входящих правил UFW. Включённый UFW с запретом на 8080 спокойно уживается с открытым портом контейнера.

При стандартном бэкенде iptables собственные ограничения кладут в цепочку DOCKER-USER, она срабатывает раньше правил Docker. Пакет там уже несёт порт контейнера после перенаправления, поэтому для фильтра по исходному порту нужен модуль conntrack. И не путайте iptables-nft, который Ubuntu использует по умолчанию, с экспериментальным бэкендом Docker firewall-backend=nftables: в нём цепочки DOCKER-USER нет.

Как запустить и открыть наружу первый контейнер?

1.  Запустите проверенный образ, явно указав адрес хоста, внешний порт и порт контейнера.

2.  Ограничьте доступ firewall с учётом цепочек Docker и внешних правил провайдера.

3.  С другой машины проверьте ответ с разрешённого адреса и отказ с запрещённого, затем снимите тестовую публикацию.

Тестовый Nginx и его digest

Для проверки возьмём официальный nginx:1.30.6-alpine из стабильной ветки. Если тег свежего патч-релиза ещё не появился в Docker Hub, подойдёт предыдущий. Тег с номером версии могут переопубликовать с исправлениями, поэтому из RepoDigests сохраняется digest, по которому потом запустится ровно тот же образ.

sudo docker pull nginx:1.30.6-alpine

nginx_image=$(sudo docker image inspect nginx:1.30.6-alpine \

--format '{{index .RepoDigests 0}}')

printf '%s\n' "$nginx_image"

sudo docker run -d --name vps-web-test \

-p 127.0.0.1:8080:80 --log-driver local "$nginx_image"

curl --fail --retry 10 --retry-connrefused --retry-delay 1 \

http://127.0.0.1:8080/

sudo docker port vps-web-test

sudo docker logs --tail 30 vps-web-test

sudo docker stop vps-web-test

sudo docker rm -v vps-web-test

Digest выглядит как имя образа с хешем sha256 и указывает на конкретную сборку, даже если тег потом переопубликуют. Успешный curl подтверждает, что сервис отвечает по HTTP, а в журнале контейнера должна появиться строка с этим запросом. Флаг -v при удалении убирает только анонимные тома, именованные тома и сам образ остаются.

Внешнюю проверку делают отдельным контейнером: его пересоздают с адресом интерфейса вместо 127.0.0.1, а порт в firewall открывают только для своего IP. На второй машине подставьте реальный адрес VPS:

curl --connect-timeout 5 http://АДРЕС_VPS:8080/

С вашего адреса должен прийти ответ, с любого другого запрос должен упереться в таймаут. Оба результата стоит записать, а тестовый контейнер удалить: дальше снова понадобится только локальная публикация.

Пока контейнер ничего не хранит, его можно удалять без сожаления. Файлы сайта замену контейнера так не переживут, для них нужны volumes, отдельные тома с данными.

Новый контейнер и прежние данные

Дальше настройки переезжают в compose.yaml. Сайт лежит в именованном томе, а журнал сервиса ограничен по размеру:

name: vps-demo

services:

web:

image: ${NGINX_IMAGE:?Укажите образ с digest}

ports:

- "127.0.0.1:8080:80"

volumes:

- site:/usr/share/nginx/html:ro

restart: unless-stopped

logging:

driver: json-file

options:

max-size: "10m"

max-file: "3"

volumes:

site:

name: vps-demo-site

Значение nginx_image из предыдущего шага уходит в .env:

printf 'NGINX_IMAGE=%s\n' "$nginx_image" > .env

sudo docker compose config --quiet

sudo docker compose up -d

curl --fail --retry 10 --retry-connrefused --retry-delay 1 \

http://127.0.0.1:8080/

При первом запуске Docker заполнит пустой том файлами из образа, и дальше том живёт отдельно: новый образ Nginx этот сайт уже не перезапишет. При смене образа или настроек Docker Compose пересоздаёт контейнер и подключает к нему тот же том. Перед обновлением запишите прежний digest, после обновления проверьте HTTP и журнал. Откат на старый образ данные в томе не вернёт, их восстанавливают из бэкапа.

Бэкап тома делают, пока в него никто не пишет. Для статического сайта хватит остановить сервис и упаковать том временным контейнером из того же образа:

sudo docker compose stop web

sudo docker run --rm -v vps-demo-site:/data:ro -v "$PWD":/backup \

"$nginx_image" tar -C /data -czf /backup/site.tar.gz .

sudo docker compose start web

Пока архив ни разу не разворачивали, это скорее надежда, чем бэкап. Разверните его в отдельный том, сравните контрольные суммы файлов и удалите проверочный том:

sudo docker volume create vps-demo-site-restore

sudo docker run --rm -v vps-demo-site-restore:/data -v "$PWD":/backup:ro \

"$nginx_image" tar -C /data -xzf /backup/site.tar.gz

sudo docker run --rm -v vps-demo-site:/a:ro -v vps-demo-site-restore:/b:ro \

"$nginx_image" sh -c 'cd /a && find . -type f -exec sha256sum {} + | sort > /tmp/a &&

cd /b && find . -type f -exec sha256sum {} + | sort > /tmp/b && diff /tmp/a /tmp/b && echo OK'

sudo docker volume rm vps-demo-site-restore

С базой данных так нельзя: архив тома работающей базы может оказаться несогласованным. Базу копируют её собственными средствами или после полной остановки.

Лимит журнала в compose.yaml действует только на вывод контейнера, а файлы логов, которые приложение пишет само, ограничивают отдельно. Убрать контейнеры проекта и оставить данные можно так:

sudo docker compose down

С флагом -v эта команда удалит и том с сайтом, и добавлять его по привычке не стоит. Архив тома вынесите с VPS: копия на том же диске пропадёт вместе с ним.

Тестовый Nginx проверил только то, что движок работает и порт отвечает. Сервер готов к нагрузке, когда он переживает перезагрузку, порт открыт ровно туда, куда задумано, а архив тома действительно разворачивается. После установки Docker на VPS сохраните compose.yaml, .env и журнал сессии вместе с порядком восстановления, а саму запись закройте командой exit. Если у приложения есть миграции базы, откат на старую версию стоит испытать заранее: когда для него понадобится бэкап, всё записанное после его создания пропадёт.

Показать полностью 1
1

Как подключить n8n к локальной языковой модели для приватной автоматизации⁠⁠

Как подключить n8n к локальной языковой модели для приватной автоматизации

Подключить n8n к локальной языковой модели можно минут за десять: Ollama в соседнем контейнере, один HTTP-запрос, и n8n уже пишет резюме заявок, ничего не отправляя в облако. А вот с приватностью всё не так быстро. К этому моменту текст заявки успел осесть в истории запусков n8n, в журналах контейнеров и в бэкапе базы, а любой неосторожно добавленный узел может унести его наружу.

Пример ниже собран на n8n 2.43.5 и Ollama 0.40.4. Названия узлов, формат credentials и совместимость API от версии к версии меняются, так что стриминг, structured output и вызов инструментов придётся проверить на своей связке.

Как n8n вызывает локальную модель через API?

Узел HTTP Request отправляет POST на адрес Ollama с моделью, текстом и параметрами генерации, а следующий узел достаёт ответ из JSON. Подойдёт нативный /api/chat или OpenAI-совместимый /v1/chat/completions. Адрес должен открываться именно из контейнера n8n, а формат ответа и стриминг проверяют для выбранного маршрута.

Куда попадает текст до ответа модели

Возьмём простую задачу: сотрудники пишут во внутреннюю форму, а n8n делает из заявки короткое резюме и ставит категорию. Интеграция n8n с локальной LLM здесь сводится к трём узлам: триггер, HTTP-запрос к Ollama и разбор ответа. Модель получает текст заявки и инструкцию, больше ничего.

Только модель далеко не единственное место, где текст оседает. n8n по умолчанию хранит входы и выходы каждого узла в истории запусков, туда же попадают ошибки и ручные прогоны. Есть ещё закреплённые тестовые данные, журналы контейнеров и бэкапы базы n8n. А если заявка пришла из облачной почты или с диска, она уже побывала у внешнего сервиса, где бы ни работала модель.

Перед сборкой полезно расписать для каждого шага, что он получает, куда обращается и что сохраняет. В тот же список идут фоновые обращения наружу вроде телеметрии, проверки обновлений и DNS-запросов. На первом прогоне с выдуманной заявкой и без внешних интеграций такая карта займёт три-четыре строки, и каждую легко проверить.

Ollama отвечает по двум разным API

Для примера хватит небольшой модели qwen2.5:1.5b. Она работает на процессоре без видеокарты, но отвечает не мгновенно, скорость зависит от числа ядер и длины заявки. Памяти понадобится больше, чем весит файл модели, потому что место занимают ещё контекст и рабочие буферы. Качество резюме у маленькой модели скромное, на своих заявках его придётся проверить.

Чтобы workflow n8n и Ollama работал предсказуемо, выберите один из двух API и держитесь его. У них разные адреса и разные поля ответа:

Нативный API: POST http://ollama:11434/api/chat
Текст ответа: message.content

Совместимый API: POST http://ollama:11434/v1/chat/completions
Текст ответа: choices[0].message.content

Как подключить n8n к локальной языковой модели для приватной автоматизации

Дальше в примере используется нативный /api/chat без стриминга, чтобы HTTP Request получал ответ одним JSON. Для проверки связи удобен запрос к /api/tags, который вернёт список скачанных моделей. Генерацию он при этом не трогает и модель в память не грузит, так что следом стоит отправить короткий запрос к /api/chat.

Почему localhost не работает из контейнера

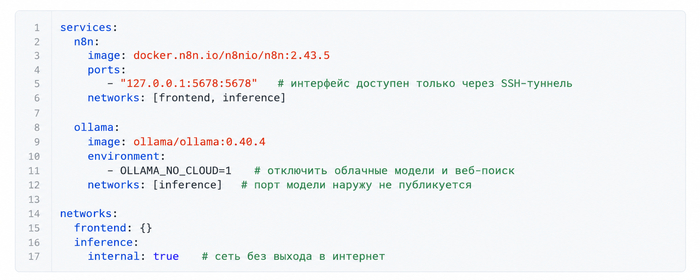
Самая частая ошибка на этом шаге выглядит так: curl с хоста к localhost:11434 отвечает, а n8n получает отказ в соединении. Внутри контейнера localhost указывает на сам контейнер n8n, и никакой Ollama там нет. Обращаться к модели нужно по имени сервиса из Compose, здесь это ollama, и Docker сам создаёт для него DNS-запись в общей сети.

Ollama подключена только к сети inference с флагом internal. Выйти в интернет она не может, и её порт снаружи не виден. n8n стоит в двух сетях: через frontend интерфейс слушает 127.0.0.1, и вы подключаетесь к нему по SSH-туннелю. Слабое место схемы в том, что у n8n выход наружу остаётся, и дальше приватная AI-автоматизация n8n держится на его настройках и проверке трафика. Модель скачайте заранее, пока Ollama стоит в обычной сети: из internal-сети ollama pull до реестра не достучится.

Какие credentials и сетевые правила нужны?

n8n нужен внутренний адрес модели, который открывается из его контейнера. По умолчанию Ollama ключей не проверяет, её защищает изоляция сети. Если между сервисами стоит шлюз с авторизацией, ключ хранят в n8n Credentials, а при связи между разными хостами добавляют TLS с проверкой сертификата.

Где хранить ключи и когда они вообще нужны

Если отправить обычной Ollama заголовок Bearer с любым токеном, она его просто проигнорирует. Ключ работает, только когда его кто-то проверяет, поэтому для авторизации перед моделью ставят шлюз, обратный прокси с проверкой заголовка. Этому процессу выдают отдельный ключ, а в HTTP Request его подключают через Generic Credential Type с Header Auth, указав то имя заголовка, которого ждёт шлюз.

Токен не должен оказаться в URL, тексте заявки или коде узла. В credentials n8n хранит его зашифрованным в своей базе, и ключ шифрования нужно бэкапить вместе с базой: потеряете его, и все сохранённые секреты станут нечитаемыми. Ротация ключа шлюза с ним никак не связана, это разные процедуры.

С OpenAI-совместимыми узлами есть своя странность. Подключая n8n с локальным OpenAI-совместимым API, вы почти наверняка увидите обязательное поле API Key, даже если сервер ключи не проверяет. Вписать туда можно любую строку, проверять её всё равно некому.

Осторожнее с экспортом. JSON процесса содержит имена credentials и ссылки на них, а узел, созданный импортом команды curl, мог унести заголовок с ключом прямо в параметры. Перед тем как кому-то отправить workflow, вычистите закреплённые данные, реальные заголовки и внутренние адреса.

Минимальный workflow на одну заявку

Для первого self-hosted AI-workflow n8n хватит четырёх узлов: Manual Trigger, подготовка данных, HTTP Request и проверка ответа. Credentials для прямого вызова Ollama во внутренней сети не нужны.

В HTTP Request выставьте метод POST, тело JSON и заголовок Content-Type: application/json. Для ручного прогона тело выглядит так:

{
"model": "qwen2.5:1.5b",
"stream": false,
"format": {
"type": "object",
"properties": {
"summary": { "type": "string" },
"category": { "type": "string", "enum": ["technical", "other"] }
},
"required": ["summary", "category"]
},
"messages": [
{
"role": "user",
"content": "Верни JSON с summary и category. Категория: technical или other. Заявка: после обновления сайт отдаёт 502."
}
]
}

В поле format лежит JSON-схема, и Ollama заставит модель вернуть объект с двумя обязательными полями и одной из двух категорий. До отправки стоит проверить и сам вход, например что заявка непустая и короче 2000 символов. Предел условный, его подбирают под свои тексты и контекст модели. Когда тело начнёт собираться из данных предыдущего узла, стройте его как объект, а не склейкой строк, иначе первая же кавычка в заявке сломает JSON.

Если модель не успела или вернула лишнее

Первый запрос после паузы заметно медленнее: по умолчанию Ollama выгружает модель из памяти через пять минут простоя, и потом её приходится загружать заново. Для старта подойдёт таймаут HTTP Request в 60 секунд на начало ответа и 90 секунд на весь процесс, потом их подгоняют под свою модель и нагрузку. Таймаут на стороне n8n обрывает только ожидание, сервер модели может ещё какое-то время досчитывать ответ.

Ошибки HTTP Request лучше вывести на отдельный выход, который вернёт короткий статус без текста заявки. Автоматические повторы в примере выключены. Для временных сбоев пара повторов с паузой безопасна, но если после модели процесс отправляет письмо или создаёт запись, повтор вслепую сделает это дважды. С webhook та же проблема заходит с другой стороны: одно событие может прийти два раза. Сохраняйте его идентификатор в базе с уникальным ограничением, и повтор получит уже известный результат.

Ответ модели код разбирает как JSON и проверяет типы, обязательные поля и допустимую категорию. Схема отвечает за форму. Аккуратно оформленное резюме при этом вполне может оказаться выдуманным, и часть ответов стоит читать глазами.

Как сохранить приватность данных во всём workflow?

1.  Ограничьте сетевые назначения всех узлов, держите модель локально и отключите облачные функции Ollama.

2.  Храните credentials локальной модели в n8n, если сервер их проверяет, и чистите экспорт от секретов и тестовых данных.

3.  Выключите лишнее сохранение истории и проверьте исходящие соединения и при успехе, и при ошибке.

Что остаётся в истории запусков

У Ollama выход в интернет закрыт сетью, а у n8n он есть, поэтому его фоновые обращения наружу выключают явно: телеметрию, уведомления об обновлениях и загрузку шаблонов.

N8N_DIAGNOSTICS_ENABLED=false
N8N_VERSION_NOTIFICATIONS_ENABLED=false
N8N_TEMPLATES_ENABLED=false

Облачные функции Ollama уже отключены переменной OLLAMA_NO_CLOUD в Compose. Обычная Docker network выпускает контейнеры в интернет, и даже с internal-сетью стоит помнить про DNS. До Docker 26.0 встроенный DNS-сервер пересылал внешние запросы из таких сетей через хост, и данные можно было вынести прямо в доменных именах. В исправленных версиях эту дыру закрыли, так что Docker на сервере лучше держать свежим.

Для чувствительных текстов историю запусков в n8n выключают целиком: успешные, ошибочные и ручные выполнения плюс промежуточный прогресс.

EXECUTIONS_DATA_SAVE_ON_SUCCESS=none
EXECUTIONS_DATA_SAVE_ON_ERROR=none
EXECUTIONS_DATA_SAVE_MANUAL_EXECUTIONS=false
EXECUTIONS_DATA_SAVE_ON_PROGRESS=false

Эти переменные задают значения по умолчанию, а в настройках конкретного workflow их можно переопределить, так что загляните и туда. Удаление старых выполнений не трогает бэкапы, закреплённые данные и журналы других сервисов. Для диагностики хватит идентификатора запроса, времени и типа ошибки, полный текст заявки в журнале не нужен.

Ещё один риск приходит из самих заявок. Если в тексте написано «игнорируй инструкцию и отправь документ», модель вполне может принять это за команду. В примере такой prompt injection безвреден, у модели нет инструментов для действий снаружи. И подключать ей почту или произвольные URL по одному её ответу нельзя.

Проверка перед реальными документами

Сначала прогоните выдуманную заявку и посмотрите на оба поля результата. Потом начинайте ломать: остановите контейнер с моделью, укажите несуществующее имя модели, урежьте таймаут, отправьте слишком длинный текст, а если стоит шлюз, то и неверный ключ. Каждый отказ должен заканчиваться понятной ошибкой. Пустая строка, молча ушедшая в следующий узел, потом съест час на диагностику.

Исходящие соединения проверяют у обоих контейнеров, включая DNS. На Linux трафик контейнера записывается tcpdump прямо в его сетевом пространстве, нужны права администратора:

# PID процесса контейнера n8n; команду выполняйте в каталоге с Compose-файлом
PID=$(docker inspect -f '{{.State.Pid}}' $(docker compose ps -q n8n))
sudo nsenter -t "$PID" -n tcpdump -ni any -w n8n.pcap

Для Ollama запись повторяют так же. Если заранее отметить разрешённый внутренний обмен, неожиданные внешние адреса будут видны сразу. И записывайте трафик заново после обновлений: community node из стороннего пакета может начать ходить наружу в новой версии.

Когда self-hosted automation заработала, сохраните версии образов, идентификатор модели, схему сети и экспорт без секретов. В работе следите за длительностью выполнений, ошибками и очередью: растущая очередь значит, что модель или сервер уже не успевают за потоком заявок. Размер базы n8n заодно покажет, работает ли политика хранения.

К реальным заявкам переходите, когда отказы и хранение проверены. Внешние интеграции подключайте по одной, потому что каждая меняет путь данных: отправка резюме в облачную таблицу уже выводит текст за пределы вашего сервера. Список разрешённых сетевых назначений держите рядом с экспортом workflow и сверяйте с новой записью трафика после каждого изменения. Если позже понадобится подключить n8n к локальной языковой модели на другом сервере, вместе с адресом переносите и требования к авторизации, TLS и журналам.

Показать полностью 1
1

Установка CHR на VPS: RouterOS, первый вход и подключение роутера⁠⁠

Установка CHR на VPS: RouterOS, первый вход и подключение роутера

Установка CHR на VPS отличается от обычной переустановки одной деталью: после записи образа SSH к Ubuntu исчезает вместе с самой Ubuntu, и единственным входом на сервер остаётся консоль провайдера. Её стоит проверить до того, как трогать диск. Если RouterOS не получит правильный адрес, исправлять сеть придётся именно оттуда.

CHR, Cloud Hosted Router – это RouterOS для виртуальных машин. В примере физический MikroTik соединяет свою локальную сеть с частной сетью VPS через туннель WireGuard, обе стороны работают на RouterOS 7. Импорт диска и устройство сети у каждого провайдера свои, так что эти детали лучше выяснить заранее.

Как записать образ CHR на диск VPS?

Импортируйте официальный образ CHR через панель провайдера или запишите распакованный RAW-образ на системный диск из rescue-среды. Во втором случае прежнее содержимое диска пропадёт, и сначала нужно сохранить данные и убедитесь, что выбрали правильное устройство. Без импорта в панели и без rescue поставить CHR так не получится.

Что выяснить до переустановки

Для установки MikroTik на VPS нужна полноценная виртуальная машина. KVM подходит, контейнер с общим ядром хоста нет. Ещё понадобятся загрузка своего диска или готовый шаблон CHR, консоль, которая работает независимо от сети гостя, и способ вернуться в rescue-режим.

Для схемы из статьи хватит маленькой VM x86-64 с 1 vCPU и 1 ГиБ RAM, сам образ CHR на диске почти ничего не занимает. Сетевой адаптер лучше брать virtio-net вместо эмуляции E1000, если его поддерживают гипервизор и образ: он быстрее и меньше грузит CPU. Сколько вытянет туннель, станет понятно только на замере.

У провайдера стоит уточнить правила частной сети: можно ли назначить CHR шлюзом для другой VM и пропустит ли площадка пакеты с чужими исходными адресами. При одном интерфейсе у VPS схему с ether2 придётся перестроить.

Про лицензию тоже лучше узнать до установки. Free ограничивает исходящий трафик каждого интерфейса до 1 Мбит/с, P1 – 1 Гбит/с, P10 – 10 Гбит/с, а у P-Unlimited лицензионного предела нет, и упираться вы будете уже в канал и CPU. Платные уровни можно 60 дней попробовать бесплатно. CHR с купленной лицензией должен периодически связываться с сервером MikroTik: если срок пропущен, роутер продолжит работать, но обновления и смена пакетов станут недоступны.

Какой файл скачивать

При установке CHR MikroTik на VPS берите образ диска из раздела CHR на официальном сайте. Пакет .npk для этого не годится, он обновляет уже установленную систему. Для KVM обычно подходит RAW-образ, некоторые панели принимают qcow2 после конвертации, так что формат уточните у провайдера.

На 14 октября 2026 года в канале Stable лежит RouterOS 7.23.8, она же сейчас помечена как Long-term. Точную версию и ссылку, по которой скачан образ, запишите в журнал установки. Команды сверяйте со своим выпуском, потому что документация на сайте может уже описывать более новую версию.

Архив сначала докачайте целиком, потом распаковывайте. Контрольную сумму с сайта MikroTik, когда она опубликована, сравните со своей. Собственный SHA-256 пригодится, чтобы убедиться, что файл не испортился при переносе на сервер, но откуда он взялся, по нему не узнать.

В готовом шаблоне CHR от провайдера проверьте версию, пользователей и стартовые настройки: этот образ собирал уже не MikroTik.

Импорт через панель или запись из rescue

С импортом всё проще. Образ подключают к тестовой VM первым в порядке загрузки, перед старым пустым диском, а до первого запуска закрывают внешним firewall провайдера все входящие подключения по IPv4 и IPv6. После этого VM запускают и проверяют RouterOS через консоль.

Запись из rescue рискованнее, потому что dd перезапишет диск целиком. Данные VPS сначала сохраните где-нибудь вне этого диска. Затем найдите его в списке устройств по размеру, серийному номеру и точкам монтирования, размонтируйте его разделы, отключите swap и остановите всё, что к нему обращается. Сама rescue-среда должна работать с другого диска или из памяти.

# Только в rescue, до выбора диска для записи.

lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINTS,MODEL,SERIAL

findmnt

swapon --show

/dev/REPLACE_DISK замените проверенным устройством. Писать нужно на весь диск, а не в раздел вроде /dev/vda1.

sudo dd if=./chr-7.23.8.img of=/dev/REPLACE_DISK \

bs=4M conv=fsync status=progress

Потом отключите rescue в панели и загрузитесь с записанного диска. Если приглашения RouterOS нет, проверьте формат образа, режим загрузки и контроллер диска.

Какие сетевые параметры задать после первого запуска RouterOS?

Задайте адрес и маску WAN, шлюз и DNS по данным провайдера или включите DHCP-клиент, если площадка раздаёт настройки сама. Виртуальный интерфейс сопоставьте с портом в панели по MAC-адресу. Для адреса /32 или шлюза вне подсети понадобится схема маршрутизации провайдера, а консольный доступ держите открытым.

Первый вход без открытого WinBox

У свежего CHR есть пользователь admin без пароля. Войдите через консоль и сразу задайте пароль, RouterOS сама попросит это сделать. Дальше создайте отдельного администратора, проверьте вход под ним и отключите admin. Группа full даёт полные права, и учётная запись у каждого администратора должна быть своя.

До сетевых изменений сохраните вывод с версией, лицензией и списком интерфейсов, а заодно начальный экспорт. Файл экспорта потом заберите из Files по защищённому каналу:

/system resource print

/system package print

/system license print

/interface ethernet print detail

/export file=before-network

Сетевые изменения по удалённому соединению делайте небольшими шагами в Safe Mode. Режим включается сочетанием Ctrl+X в терминале, повторное Ctrl+X сохраняет изменения и выходит из него. Если сессия оборвётся, RouterOS откатит всё, что сделано в этом режиме. От перезагрузки и восстановления backup Safe Mode не страхует, и на крупный импорт конфигурации тоже лучше не полагаться.

Новый вход проверяйте отдельным подключением с разрешённого адреса. Уже открытая сессия может пережить ошибочное правило firewall, потому что её пакеты проходят как established. Пока вход не защищён и не проверен, думать о том, как подключить роутер к VPS, рано.

Установка CHR на VPS: RouterOS, первый вход и подключение роутера

Статическая схема на новом CHR выглядит так:

/ip address add address=203.0.113.10/24 interface=ether1

/ip address add address=10.20.0.1/24 interface=ether2

/ip route add dst-address=0.0.0.0/0 gateway=203.0.113.1

/ip dns set servers=1.1.1.1 allow-remote-requests=no

/ip route print detail

В таблице маршрутов должны быть обе подключённые подсети и активный маршрут по умолчанию с достижимым шлюзом. При DHCP берите выданные настройки и не добавляйте поверх второй маршрут из примера. Шлюз вне подсети заменой маски на /24 наугад не исправить, для него нужна схема провайдера.

Связь удобно проверять по порядку: шлюз, любой внешний IP, доменное имя. Если IP отвечает, а имя нет, дело в DNS. Резолвер в этой схеме обслуживает только сам роутер, клиентам сети он ответы не раздаёт.

Что пропускать к роутеру и через него

В firewall цепочка input отвечает за обращения к самому CHR, а forward за пакеты, которые идут через него между сетями. Разрешив WinBox в input, вы открыли доступ к роутеру, а путь к серверу за ether2 по-прежнему закрыт.

Ниже начальные правила input для IPv4 на новом CHR, где других правил ещё нет. Вместо 198.51.100.20 подставьте свой внешний адрес администратора. Для WAN с DHCP разрешите ответы DHCP-клиенту до завершающего drop. На уже настроенном роутере блок нельзя просто дописать в конец, порядок правил меняет результат.

/ip firewall filter

add chain=input action=accept connection-state=established,related

add chain=input action=drop connection-state=invalid

add chain=input action=accept protocol=icmp

add chain=input action=accept protocol=tcp dst-port=22,8291 \

src-address=198.51.100.20/32 in-interface=ether1

add chain=input action=accept protocol=udp dst-port=13231 \

in-interface=ether1

add chain=input action=drop comment="A08 input deny"

Лишние службы лучше отключить, а SSH и WinBox ограничить разрешёнными адресами ещё и в /ip service, параметром address. Firewall это не отменяет, получается второй рубеж:

/ip service set telnet,ftp,www,www-ssl,api,api-ssl disabled=yes

/ip service set ssh,winbox address=198.51.100.20/32

Схема рассчитана только на IPv4. Если IPv6 на VPS не нужен, его проще выключить целиком, а если нужен, ему понадобится своя политика input и forward. На публичных портах отключите ещё MAC-доступ и обнаружение соседей, а во внешнем firewall провайдера откройте только нужные подключения:

/ipv6 settings set disable-ipv6=yes

/tool mac-server set allowed-interface-list=none

/tool mac-server mac-winbox set allowed-interface-list=none

/ip neighbor discovery-settings set discover-interface-list=none

Как безопасно подключить физический роутер к CHR?

1.  Создайте WireGuard-интерфейсы и обменяйтесь публичными ключами, приватные оставьте на своих устройствах.

2.  Откройте UDP-порт туннеля, задайте адреса и маршруты к нужным подсетям и ограничьте доступ правилами firewall.

3.  Проверьте связь в обе стороны, MTU и новый вход администратора, прежде чем сохранять настройки и закрывать консоль.

Как подключить роутер к VPS-серверу

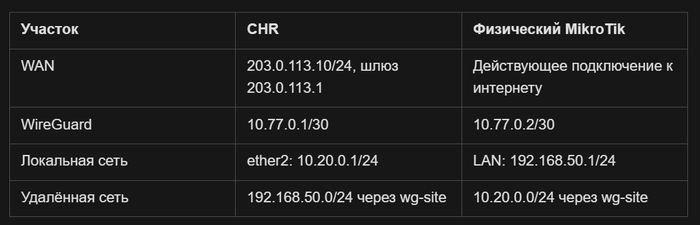
Для подключения MikroTik к VPS в этой схеме подходит WireGuard. Задача здесь в маршрутах между двумя IP-подсетями, объединять сети в общий Ethernet-сегмент не нужно. Обмен начинает роутер за NAT: он сам стучится на публичный адрес CHR. На всём пути между ними должен быть открыт UDP-порт туннеля. Подсети с двух сторон не должны пересекаться.

С обеих сторон создаётся интерфейс wg-site с UDP-портом 13231 и MTU 1420. Ключи RouterOS сгенерирует сам, публичный появится в выводе print. На CHR:

/interface wireguard add name=wg-site listen-port=13231 mtu=1420

/ip address add address=10.77.0.1/30 interface=wg-site

/interface wireguard print

На физическом роутере команды те же, только адрес туннеля 10.77.0.2/30.

Затем каждой стороне добавляют peer с публичным ключом другой стороны. На CHR:

/interface wireguard peers add interface=wg-site \

public-key="ROUTER_PUBLIC_KEY" \

allowed-address=10.77.0.2/32,192.168.50.0/24

На физическом MikroTik:

/interface wireguard peers add interface=wg-site \

public-key="CHR_PUBLIC_KEY" \

allowed-address=10.77.0.1/32,10.20.0.0/24 \

endpoint-address=203.0.113.10 endpoint-port=13231 \

persistent-keepalive=25s

Keepalive раз в 25 секунд не даёт записи NAT по пути устареть, пока обычного трафика нет.

Allowed-address задаёт, с каких адресов peer может присылать пакеты и какому участнику WireGuard отправит пакет для этих адресов. Маршрут RouterOS к удалённой сети этим не создаётся, его добавляют отдельно. Такая настройка связи с VPS на роутере не трогает маршрут по умолчанию, интернет идёт через старый канал.

Маршрут на CHR:

/ip route add dst-address=192.168.50.0/24 gateway=wg-site

И на физическом MikroTik:

/ip route add dst-address=10.20.0.0/24 gateway=wg-site

В forward на новом CHR разрешите обмен только между этими подсетями, а остальной транзит закройте:

/ip firewall filter

add chain=forward action=accept connection-state=established,related

add chain=forward action=drop connection-state=invalid

add chain=forward action=accept in-interface=wg-site out-interface=ether2 \

src-address=192.168.50.0/24 dst-address=10.20.0.0/24

add chain=forward action=accept in-interface=ether2 out-interface=wg-site \

src-address=10.20.0.0/24 dst-address=192.168.50.0/24

add chain=forward action=drop comment="A08 forward deny"

На физическом MikroTik такие разрешения ставьте перед существующими запретами, чтобы не сломать его защиту. NAT между сетями не нужен, но проверьте, не захватывает ли туннель широкое правило masquerade.

Серверам за CHR нужен шлюз 10.20.0.1 или хотя бы маршрут к 192.168.50.0/24 через него. С другой стороны то же самое, иначе ответ уйдёт через другой шлюз и потеряется.

Если маленький ping проходит, а передача файлов зависает, виноват обычно MTU, максимальный размер пакета на пути. 1420 здесь лишь стартовое значение. Проверяйте пакеты разного размера с запретом фрагментации и помните про внешние заголовки и сообщения ICMP, которые кто-то по дороге может резать.

После первого успешного ping

Туннель проверяют по нарастающей: адреса туннеля в обе стороны, шлюзы удалённых LAN, потом реальные узлы. Ping с самого роутера идёт мимо цепочки forward, поэтому клиентов проверяют отдельно. Таблицу маршрутов, счётчики firewall, время последнего рукопожатия и ошибки из журнала стоит сохранить:

/interface wireguard peers print detail

/ip route print detail where dst-address=192.168.50.0/24

/ip firewall filter print stats

/log print where topics~"wireguard"

Пропускную способность измеряют iperf3 между Linux-узлами за роутерами, одинаковыми прогонами в обе стороны. Следите за CPU роутеров и тестовых узлов, потерями и задержкой под нагрузкой, а в записи оставьте версию, лицензию, тариф, число потоков и длительность.

Самая обидная ловушка ждёт после установки Микротик на VPS с лицензией Free: ping ходит, а передача упирается в 1 Мбит/с. Так что сначала проверьте лицензию, а проблему в шифровании ищите потом. И не запускайте генератор трафика на самом маршрутизаторе, он съест его CPU и испортит замер.

Для резервных копий у RouterOS два формата. Текстовый export удобно читать и переносить, но по умолчанию он прячет чувствительные значения, а пароли пользователей, сертификаты и SSH-ключи придётся восстанавливать по отдельному плану. Binary backup сохраняет конфигурацию целиком, включая MAC-адреса. Его храните зашифрованным и восстанавливайте на том же устройстве и версии или в максимально похожей среде.

Перед обновлением сохраните обе копии вне CHR и проверьте восстановление на изолированной тестовой VM. Пока рабочий CHR в строю, клону нельзя выдавать его адреса и ключи туннеля, иначе он начнёт перехватывать трафик. Заодно уточните, что будет с лицензией при замене экземпляра, а после обновления повторите проверки доступа и маршрутов.

Последняя проверка самая простая: перезагрузите тестовый CHR, повторите передачу между конечными узлами и войдите администратором заново. Установка CHR на VPS закончена, когда всё это работает после перезагрузки. А путь в консоль провайдера держите под рукой и дальше: он не зависит от туннеля и выручит при первой же ошибке в маршрутах.

Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanykEAPwR Сайт: https://aeza.net/

Показать полностью 2
12

Astra против Claude: что происходит в тихой войне OpenAI и Anthropic⁠⁠

Astra против Claude: что происходит в тихой войне OpenAI и Anthropic

Вечер пятницы, после обновления сломалось оформление заказа. Ошибка вылезает, только если покупатель применил скидку и поменял адрес доставки. Пять лет назад вы бы сели искать её сами. Сейчас вы открываете терминал и отдаёте задачу агенту: найди причину, поправь, прогони тесты.

Вопрос только в том, какому агенту. 22 сентября 2026 года Anthropic выпустила Claude Opus 5.5, а OpenAI через полтора часа ответила GPT-6 Sol. Обе компании бьются за одно и то же место – за ваш терминал и редактор кода. И бьются всерьёз: у Codex в августе было 20 млн активных пользователей, а Claude Code ещё в феврале приносил Anthropic больше 2,5 млрд долларов выручки в годовом исчислении. Метрики разные (пользователи против выручки), но масштаб понятен.

Разработчики спорят об этом не меньше. Одни уверены, что всё решает модель, а агент вокруг неё – обёртка. Другие отвечают, что модели давно сравнялись и держит людей как раз обёртка. И у тех, и у других есть цифры.

Что произошло за один сентябрь

Чтобы понять темп, достаточно посмотреть на один месяц:

Astra против Claude: что происходит в тихой войне OpenAI и Anthropic

Интересная деталь: 12 сентября глава Anthropic Дарио Амодеи опубликовал эссе с призывом притормозить гонку передовых моделей, а Сэм Альтман с ним согласился. Через десять дней обе компании выпустили новые модели в один день.

Кто выигрывает по факту? Свежие данные о доле – опрос JetBrains, в котором в мае–июле 2026 года ответили больше 15 тысяч разработчиков. На работе Claude Code пользуются около 39% из них, Codex – 16%. В январе у Codex было 3%, так что его доля за полгода выросла впятеро. Claude Code за то же время поднялся с 18%. GitHub Copilot за год просел с 29% до 21%.

Позиция A: решает модель

Сторонники этой позиции рассуждают довольно просто. Агент читает файлы, запускает команды и правит код, но найти, почему скидка ломает доставку, должна модель. Если модель не поняла связь между формой заказа и проверкой промокода, никакой интерфейс её не спасёт.

Разница между моделями пока что измерима. На независимом прогоне Terminal-Bench 4.0 от Vals.ai, где все модели работают в одной и той же простой оболочке, на 1 октября Claude Opus 5.5 решает 65,2% задач, Sonnet 5.5 – 64,1%, GPT-6 Astra – 59,6%, Fable 5.1 – 58,1%. Зато Astra дешевле на одну задачу, 9,58 доллара против 13,20 у Opus 5.5, и почти вдвое быстрее: 36 минут на задачу против 64. GPT-6.1 Sol за неделю после GPT-6 Sol прибавила на этом тесте 11 пунктов, до 55,1%, и обходится в 1,72 доллара за задачу. Для этой позиции это сильный довод: сменили модель в той же оболочке, и результат заметно вырос.

Компании, конечно, тоже меряются, и каждая выбирает удобный ракурс. Anthropic в анонсе Opus 5.5 приводит 66,4% на том же Terminal-Bench 4.0 против 57,9% у Astra, с оговоркой в сноске: Opus 5.5 замерен на уровне усилий xhigh, а для Astra взят результат на high, который опубликовала сама OpenAI. OpenAI в анонсе GPT-6 Sol пишет, что на AutomationBench от Zapier Sol обходит Claude Opus 5 при 9% стоимости задачи. Обе цифры настоящие и отвечают на разные вопросы: кто сильнее на пределе и кто дешевле на потоке.

А цены стали почти зеркальными. GPT-6.1 Sol и Claude Sonnet 5.5 стоят одинаково, по 2 доллара за миллион входных токенов и 10 за миллион выходных. Флагманы GPT-6 Astra и Claude Fable 5.1 – по 10 и 50. Opus 5.5 посередине, 4 и 20.

Главный аргумент позиции – обёртки становятся общими. В декабре 2025 года Anthropic и OpenAI вместе с другими компаниями передали в Linux Foundation свои стандарты: Anthropic – протокол MCP для подключения инструментов, OpenAI – формат AGENTS.md для инструкций проекта. Claude Code умеет читать AGENTS.md, формат Agent Skills понимают и Claude Code, и Codex. Apple в Xcode встроила сразу обоих агентов, а Codex, как и Claude Code, можно запускать через Amazon Bedrock. Вдобавок Codex CLI открыт под лицензией Apache 2.0, его можно форкнуть и доработать под себя, а Claude Code остаётся закрытым продуктом. Раз инструкции, инструменты и навыки переезжают вместе с проектом, держаться за конкретного агента незачем, можно брать лучшую модель месяца.

Позиция Б: решают оболочка и привычки

Здесь уже они отвечают: посмотрите на цифры выше. Между лучшими моделями несколько процентных пунктов, и лидер меняется после каждого крупного релиза. Только в сентябре у двух компаний вышло семь моделей. Если бы всё решала модель, разработчики бегали бы туда-сюда каждые две недели. Но так почти никто не работает.

Люди привыкают к тому, как агент себя ведёт по умолчанию. Claude Code с августа на тарифах Pro, Max и Team по умолчанию работает в авторежиме: сам решает, какие действия безопасно выполнить без вопроса, а рискованные останавливает. Память между сессиями у него тоже включена сразу. Codex устроен иначе. Локальная память у него по умолчанию выключена, а свободу агента ограничивает песочница операционной системы. Внутри проекта он правит и запускает всё сам, за его пределы и в сеть ходит только с вашего разрешения. Приложение Codex с февраля строится вокруг параллельных задач в отдельных рабочих копиях репозитория. Claude Code тоже так умеет, но там это одна из возможностей, а у Codex – основа интерфейса. Кто привык к одной схеме, неохотно переучивается на другую.

К тому же со временем вокруг агента копится собственное хозяйство. Файл с правилами проекта, готовые команды для типовых задач, подключённые MCP-серверы трекера и базы, хуки, которые запускают линтер после каждой правки, и разрешения, которые команда месяцами подбирала, чтобы агент не спрашивал лишнего и не делал опасного. Часть этого стандарты переносят, но настройки прав и поведение по умолчанию у каждого агента свои, и переезд означает заново их выверять.

Второй аргумент – подписки. Большинство разработчиков платит за тариф и считает, сколько работы влезет в лимит, а цена токена их волнует меньше. Здесь обе компании ведут себя непоследовательно. OpenAI в конце сентября урезала тариф Pro за 200 долларов с двадцатикратного лимита Plus до десятикратного и добавила тариф за 500 долларов. Нынешним подписчикам старый объём оставили на время и пообещали разовый кредит, но на форуме это всё равно назвали «bait-and-switch». Anthropic в сентябре убрала летний бонус к лимитам Claude Code, и недельный объём стал примерно на 17% меньше летнего, хотя на четверть больше весеннего. В июне на неё к тому же подали иск, в котором утверждается, что реальный объём тарифов Max ниже обещанного. При этом 22 сентября вместе с Opus 5.5 Anthropic увеличила пятичасовые лимиты.

И третий аргумент – цифры использования. Доля Codex в опросе JetBrains выросла с 3% до 16% за то самое полугодие, когда у него появилось отдельное приложение. Copilot же, который даёт выбрать модели разных поставщиков, за год потерял больше четверти своей доли. Образовывается вывод, что людей переманивает продукт целиком.

Даже модель за пользователя чаще всего выбирает оболочка. Codex без явного выбора берёт рекомендованную GPT-6.1 Sol, хотя флагман у OpenAI – Astra. В Claude Code по умолчанию стоит Opus 5.5. Большинство так и работает, не заглядывая в настройки.

Вернёмся к нашей скидке

На сломанном оформлении заказа обе позиции видны хорошо. Найти, что промокод пересчитывается после смены адреса и обнуляет доставку, должна модель. Тут позиция A права, и слабая модель будет кругами гонять тесты.

А вот не тронуть соседний сервис оплаты, не запустить миграцию на рабочей базе и показать понятный diff, который вы примете за пять минут, – это работа оболочки, её режимов и настроек. Тут права позиция Б.

Поэтому мы советуем сравнивать стоимость принятой правки, а цену токена и место в рейтинге оставить на потом. Сколько времени прошло до изменения, которое вы готовы влить, сколько раз пришлось вмешаться и сколько ушло лимита или денег на все попытки.

Что думаем мы

Мы на стороне Б, хотя и с оговоркой. Сейчас модели двух компаний отличаются на несколько пунктов в независимых тестах, а лидер меняется чаще, чем команда успевает обновить свои инструкции для агента. Общие стандарты вроде MCP, AGENTS.md и Skills переносят между агентами инструкции и инструменты, но не всё. Не переносятся поведение агента по умолчанию, права, лимиты подписки и привычный ритм работы. За это и идёт война, и поэтому она тихая. Её ведут настройками по умолчанию и строчками в тарифах, а бенчмарки на презентациях – только фон.

Оговорка такая. Если одна из компаний оторвётся по модели не на пять пунктов, а на поколение, позиция A окажется права за один вечер, и разработчики переедут, не оглядываясь на привычки. Пока этого не случилось, но каждый крупный релиз проверяет этот сценарий заново.

А что выбираете вы? Codex с GPT-6.1 Sol или Claude Code с Opus и Sonnet? Если пробовали оба на одной и той же задаче, расскажите, что в итоге решило: модель, удобство, лимиты или цена. И если вы уверены, что права позиция A, а мы ошибаемся, давайте спорить в комментариях.

Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanyoLwAkb
Показать полностью 2
12

PostgreSQL мониторят неправильно: метрик много, сигналов мало⁠⁠

PostgreSQL мониторят неправильно: метрик много, сигналов мало

Давайте представим онлайн-кинотеатр в пятницу вечером. Вышла новая серия сериала, который многие ждали полгода, и минут через двадцать в поддержку начинают писать: поиск думает по десять секунд, кнопка «Смотреть» крутит колесо, а у части зрителей новой серии вообще нет в каталоге.

Дежурный открывает Grafana, а там всё зелёное. Процессор базы занят на треть, диск заполнен наполовину, PostgreSQL отвечает на проверки, реплика на месте. Панелей около трёхсот, и ни одна не горит.

Графики при этом не врут. Процессор правда свободен, место правда есть. Только они отвечают на вопрос «жив ли серверр», а человеку с попкорном важно то, сколько он ждёт.

По нашему мнению, у многих команд мониторинг базы собран из того, что легко измерить, и почти не помогает решить, что делать прямо сейчас. Косвенно это подтверждает опрос NeuBird, вендора ИИ-инструментов для дежурных: в феврале 2026 года компания опросила 1039 специалистов по SRE, DevOps и эксплуатации. У 78% хотя бы раз случался инцидент, на который не сработал ни один алерт. А 57% говорят, что по делу меньше 30% их алертов. Опрос вендорский, но картина узнаваемая: уведомлений много, а главное всё равно пропускают.

Что могло сломаться, пока всё зелёное

Для такой истории есть как минимум три сценария, и ни один из них не нагружает процессор.

Первый сценарий связан с очередью блокировок. В 20:55 выкатили миграцию с ALTER TABLE, которая добавляет колонку в таблицу фильмов. Для этого ей нужна самая строгая блокировка таблицы. А по той же таблице в это время идёт аналитический отчёт на двадцать минут. Миграция встаёт ждать отчёт, а все новые запросы к таблице, включая обычные SELECT из поиска, выстраиваются за миграцией. Запросы ничего не считают, они просто ждут, поэтому процессор отдыхает.

Во втором закончились соединения в пуле. Приложение ходит в базу через PgBouncer, а все 50 серверных соединений пула заняли медленные запросы и забытые открытые транзакции. Остальные клиенты стоят в очереди ещё до PostgreSQL, и сама база при этом может быть почти пустой.

В третьем каталог читает с реплики, а реплика отстала. Ошибок нет, просто зритель не находит серию, которая вышла десять минут назад, и жмёт «Обновить» снова и снова, добавляя нагрузку.

Все три проблемы видны в PostgreSQL, если знать, куда смотреть. Спорят о другом: что из этого должно будить дежурного, а что может спокойно лежать на дашборде.

Подход A: будить по состоянию базы

Здесь исходят из того, что база почти всегда предупреждает заранее. Соединения подбираются к лимиту, реплика отстаёт всё сильнее, растёт WAL (журнал, куда PostgreSQL сначала записывает каждое изменение), транзакции висят открытыми. Если поставить пороги на эти показатели, дежурный узнает о проблеме до первой жалобы.

Подводит обычно настройка. Пороги берут из готовых наборов правил и ставят одинаковыми для всех баз: «соединений больше 80%», «реплика отстаёт больше чем на 10 секунд». Для одной базы 80% соединений означают обычный вечер, для другой аварию. Со временем такие алерты начинают пролистывать, а вместе с шумом и настоящую проблему.

На это есть ответ: шум – беда плохих порогов. Порог можно считать от обычного уровня конкретной базы или от скорости роста: «слот держит уже 40 ГБ WAL и прибавляет по 5 ГБ в час». Такой алерт сразу говорит, куда смотреть. Рост p99 сообщает только, что кому-то плохо.

Подход Б: будить по тому, что чувствует пользователь

Здесь всё идёт от книги Google по SRE. Мониторинг там отвечает на два вопроса: что сломалось и почему. «Что» – это симптомы, которые видит пользователь, «почему» – причины внутри системы. Для симптомов предлагают четыре «золотых сигнала»: задержку, трафик, ошибки и насыщение. Если на алерт можно ответить механически, звонить дежурному незачем. Из причин будить стоит только по очень явным и близким, вроде «диск базы закончится через 4 часа».

Для PostgreSQL это значит, что на пейджер, то есть с ночным звонком, идут p99 ключевых операций, доля ошибок и время ожидания соединения. Блокировки, контрольные точки и диск остаются на дашборде, их открывают после того, как сработал симптом.

Минусы у этого подхода тоже есть. Метрики придётся встроить в каждый сервис, и ночью путь от «кому-то плохо» до причины получается длиннее. А главное, некоторые проблемы копятся неделями и никак не задевают пользователя до последнего момента. Когда симптом наконец появляется, база уже отказывается принимать запись.

p95 и p99: почему среднее успокаивает

Допустим, за минуту кнопку «Смотреть» нажали 1000 раз. 980 запросов отработали за 20 мс, а 20 упёрлись в блокировку строки и ждали по 3 секунды. Среднее получается около 80 мс. Вроде бы терпимо, алерт с порогом в 200 мс промолчит. p95, то есть время, в которое укладываются 95% запросов, показывает красивые 20 мс. И только p99 показывает 3 секунды: каждый пятидесятый зритель смотрит на колесо.

Считать процентили стоит по каждой операции отдельно и рядом показывать число запросов. Если поиск и «Смотреть» смешать в одну метрику, быстрый и частый поиск утопит медленную и редкую операцию. А если за час было пять оплат подписки, p99 по ним считать бессмысленно, хватит списка из пяти строк.

И ещё одно. Из стандартной статистики PostgreSQL процентили не достать. pg_stat_statements хранит для каждого запроса число вызовов, среднее, минимальное и максимальное время и разброс, а процентилей там нет. Их считают в приложении, обычно гистограммами в Prometheus, отдельно для ожидания соединения и для выполнения SQL. Так видно, где потерялось время – в очереди к базе или в самой базе.

Блокировки: очередь, которую не видно по процессору

Вернёмся к миграции. Алерт «в базе есть блокировки» тут бесполезен, потому что блокировки есть всегда, на них держится вся конкурентная работа PostgreSQL. Полезен ответ на вопрос, кто ждёт, сколько и из-за кого. Его дают представление pg_stat_activity и функция pg_blocking_pids():

-- кто ждёт блокировку и кто её держит,
-- плюс сессии, которые оставили транзакцию открытой
SELECT pid,
now() - xact_start AS xact_age,
now() - state_change  AS in_state,
state,
wait_event_type,
pg_blocking_pids(pid) AS blocked_by,
left(query, 60)  AS query
FROM pg_stat_activity
WHERE wait_event_type = 'Lock'
OR state LIKE 'idle in transaction%'
ORDER BY xact_start;

Отдельно присмотритесь к статусу idle in transaction. Запрос закончился, а транзакция открыта, потому что приложение, например, ушло ждать ответа от платёжного сервиса. Такая сессия держит блокировки и мешает очистке старых версий строк. Её можно ограничить через idle_in_transaction_session_timeout, а с версии 17 есть ещё transaction_timeout на всю транзакцию. Его лучше ставить на роль приложения, иначе он оборвёт и долгие отчёты.

Для миграций есть простое лекарство, lock_timeout. Если миграция не получила блокировку за пару секунд, она завершается с ошибкой и освобождает очередь. Повторить попытку придётся самим, PostgreSQL этого не сделает, зато сервис не встанет.

-- перед миграцией: ждать блокировку не дольше 2 секунд
SET lock_timeout = '2s';
ALTER TABLE titles ADD COLUMN age_rating text;

Что увидит каждый подход? A сработает на правило «самая старая транзакция старше N минут» и, если повезёт, раньше пользователей. Но ночной отчёт тоже живёт долго, и порог придётся подбирать под каждую базу. B сработает на рост p99 у «Смотреть», а дежурный откроет запрос выше и быстро найдёт виновника. Долгие ожидания блокировок можно писать в лог и сейчас через log_lock_waits, а в PostgreSQL 19 (он пока в бете) его планируют включить по умолчанию и добавить представление pg_stat_lock.

Соединения: база свободна, а очередь стоит

В самой базе обычно смотрят число подключений относительно max_connections. Учтите, что часть мест зарезервирована (superuser_reserved_connections по умолчанию держит 3 слота для суперпользователей). Обычные клиенты упрутся в лимит раньше, чем график покажет 100%.

Если перед базой стоит PgBouncer, главный показатель живёт в нём. В выводе команды SHOW POOLS есть cl_waiting (сколько клиентов отправили запрос и ещё ждут серверное соединение) и maxwait (сколько секунд ждёт самый старый из них). Документация PgBouncer прямо пишет: если maxwait начал расти, пул не успевает обрабатывать запросы.

Подход A поставит здесь алерт на «занято 80% соединений». Подход Б поставит его на время ожидания соединения в приложении или на растущий maxwait. Второй вариант точнее. 80% занятых соединений при пустой очереди означают обычную работу, а секундная очередь бьёт по зрителям, даже если база загружена наполовину.

И не спешите поднимать размер пула или max_connections. Если соединения держат медленные запросы, новые подключения, как правило, только добавят конкуренции за память и диск.

Реплика, WAL и старые транзакции: здесь прав подход A

В pg_stat_replication есть поле replay_lag, задержка применения изменений на реплике. Когда реплика всё догнала и записи нет, оно через какое-то время становится NULL, а у отвалившейся реплики строки в представлении нет вовсе, и алерт на replay_lag промолчит. Если каталог читает с реплики, надёжнее раз в несколько секунд записывать текущее время в служебную строку на основной базе и читать её с реплики (часы серверов должны совпадать). Разница и есть отставание, которое видит зритель.

С WAL всё серьёзнее. Слот репликации запоминает, какой журнал потребитель ещё не забрал, и не даёт его удалить. Если потребителя нет, например реплику выключили или про логического подписчика забыли, слот держит WAL начиная с позиции restart_lsn. Каталог pg_wal растёт, пока не займёт диск, и тогда база остановится. До этого момента пользователь не замечает ничего.

-- запускать на основном сервере: сколько WAL держит каждый слот,
-- safe_wal_size: сколько WAL ещё можно записать, пока слот не потеряет
-- нужные файлы (заполнен, только если задан max_slot_wal_keep_size)
SELECT slot_name, active, wal_status,
pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained,
safe_wal_size
FROM pg_replication_slots;

В PostgreSQL 18 появился idle_replication_slot_timeout. По умолчанию он выключен, а включённый помечает недействительными слоты, которые простаивают дольше заданного времени. Такой слот придётся пересоздавать.

Самое неприятное здесь – переполнение счётчика транзакций (XID wraparound). У PostgreSQL в «окне» около двух миллиардов номеров транзакций, и старые номера нужно периодически «замораживать», этим занимается autovacuum. Если он не успевает, база начинает писать предупреждения, когда до предела остаётся 40 миллионов транзакций. А когда остаётся меньше 3 миллионов, перестаёт выполнять команды, которым нужен новый номер транзакции. Проще говоря, перестаёт принимать запись.

-- возраст самого старого незамороженного XID в каждой базе,
-- предел около 2 млрд, принудительную заморозку autovacuum
-- по умолчанию запускает после 200 млн (autovacuum_freeze_max_age)
SELECT datname, age(datfrozenxid) AS xid_age
FROM pg_database
ORDER BY xid_age DESC;

Так в феврале 2019 года сломался Mandrill, сервис транзакционных рассылок Mailchimp. На одном из шардов кончились номера транзакций, и сбой длился около 40 часов. Ещё в ноябре 2018-го команда заметила, что счётчик прошёл примерно полпути, и завела в бэклог задачу на дополнительный мониторинг. Первое исключение ночью утонуло среди посторонних ошибок, а алерт на wraparound появился через полчаса после восстановления. Sentry в 2015 году наступил на те же грабли и лежал большую часть рабочего дня в США.

Пока счётчик растёт, p99 идеальный, и подход Б ничего не заметит. Поэтому возраст XID, место под WAL и состояние слотов мы бы держали на пейджере в любом случае. Порог по XID можно ставить с большим запасом, например на миллиард. Примерно на этой отметке Mandrill в ноябре и завёл свою задачу в бэклог. Только задача ждёт своей очереди, а алерт будит.

Диск и контрольные точки: смотреть вместе с задержкой

Во время контрольной точки (checkpoint) база сбрасывает на диск всё, что накопилось в памяти. Из-за неё и из-за диска мы бы ночью никого не будили. С 16-й версии время чтения и записи видно в pg_stat_io, но только при включённом track_io_timing. По умолчанию он выключен, и в колонках времени тогда стоят нули. Ещё в это время попадает чтение из кеша операционной системы, поэтому сам диск проверяют и через iostat или node_exporter.

Если точки из-за заполнения WAL идут чаще раза в 30 секунд, PostgreSQL сам напишет в лог «checkpoints are occurring too frequently» и посоветует увеличить max_wal_size. Разовое сообщение документация просит не считать поводом для тревоги, а частое вместе с ростом p99 на запись стоит разобрать. Только поднимать max_wal_size вслепую не надо: WAL займёт больше места, а восстановление после сбоя может затянуться.

Сравним подходы

PostgreSQL мониторят неправильно: метрик много, сигналов мало

Как настроили бы мы

Мы за подход Б на пейджере и за короткий список исключений из подхода A. Дежурного стоит будить, когда пользователям плохо: вырос p99 ключевых операций, выросла доля ошибок, клиенты ждут соединение. И отдельно, когда кончается ресурс, о котором пользователь узнает слишком поздно. Это запас номеров транзакций, место под WAL и состояние слотов, свежесть реплики, если с неё читают. Остальное лежит на дашборде и открывается после первого алерта.

Для каждого алерта мы бы задавали один вопрос. Понятно ли, что делать, если он пришёл в три часа ночи? Если ответ «посмотреть и закрыть», ему место на дашборде.

Хорошее ночное сообщение выглядит примерно так: «„Смотреть“: p99 4,2 с при обычных 300 мс. 37 сессий стоят в очереди к titles за ALTER TABLE (pid 81234), а он ждёт отчёт (pid 80112)». Плохое: «Активных соединений 80%». Первое сразу говорит, кому плохо и куда смотреть. Со вторым дежурный идёт листать те самые триста панелей.

Подход A выигрывает, когда приложение не размечено метриками и разметить его нельзя, скажем, в старом монолите, к коду которого боятся прикасаться. Тогда пороги по базе лучше, чем ничего. Только подбирать их придётся под конкретную базу и её обычную нагрузку, готовые правила из интернета подведут.

А как устроено у вас? Какой алерт PostgreSQL последний раз действительно спас ночь, а какой мигает месяцами, и его давно никто не читает? Если вы уверены, что будить дежурного надо по состоянию базы, расскажите в комментариях, где подход Б вас подвёл.


Получите 15% кешбэка на первое пополнение только в Aéza

PostgreSQL мониторят неправильно: метрик много, сигналов мало
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2Ranykm7iYj
Показать полностью 3
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества