
Ивашка 2.0: Перезагрузка
Показать полностью
1
Для ЛЛ: Обновления от 13 октября 2026 – несчастливые.
Судя по релиз ноте и блогу Microsoft Exchange - обновления Windows Server 2025 (KB5126646) и аналогичные для Server 2016, Server 2019, Server 2022 – ломают работу Microsoft Exchange. Ключ для реестра для экспресс-починки упомянут там же, в блоге про Exchange
Пишут про это в блоге про релизы:
Пишут про это в блоге про проблемы:
The following Windows Server updates can cause above mentioned Exchange Server failures after certain time:
KB5126646 (Windows Server 2025)
KB5126655 (Windows Server 2022)
KB5126651 (Windows Server 2019)
KB5126868 (Windows Server 2016)
https://techcommunity.microsoft.com/blog/exchange/exchange-servers-may-become-unstable-after-installation-of-october-2026-windows-/4565382
Свежее обновление Windows Server 2025 (KB5131080) от 10 ноября 2026 года ничуть не лучше. Начиная с очередной починки NTLM –
[Security] This update improves NTLM security by enabling clients to offer NTLM message signing by default for non-anonymous connections. This change helps reduce exposure to NTLM relay attacks and provides auditing to identify connections that are not using signing. To learn more, see NTLM signing security improvements in Windows.
И заканчивая обещанием «мы починили» -
[Exchange Server] This update fixes an issue that affects on-premises Exchange servers. The issue might prevent signing in to Outlook on the web (OWA), cause email messages to remain in the Outlook Outbox without being delivered, or prevent Exchange from accessing mailboxes during mailbox replication.
Заключение
Теперь мало проверять установку в тестовой среде, почти идентичной натуральной. Теперь надо и в обязательном порядке иметь DAG, и отправить 1000 писем внутри – потому что Microsoft написали «Exchange может сломаться, но это не точно, и сломаться через неизвестный промежуток времени».
Руководитель продукта и дизайна Google AI Studio Аммар Реши выложил на GitHub открытый проект WindowsiOS, который позволяет крутить обычную десктопную Windows 11 24H2 ARM64 локально на складном iPhone Duo без облачного стриминга и джейлбрейка. Довести капризную операционку Microsoft до живой работы поверх закрытой iOS 27 автору помогла модель Gemini 4 Carbon.

На бумаге такая затея упиралась сразу в две стены со стороны Apple. Еще в iOS 16.4 компания отрезала сторонним приложениям доступ к аппаратному гипервизору, а на свежих чипах A20 Pro защита TXM жестко ограничивает генерацию исполняемого JIT-кода в памяти. Из-за этого обычные эмуляторы вроде UTM SE вынуждены работать через медленный интерпретатор, где современная Windows 11 грузится десятки минут и вязнет на любом тяжелом браузере.
Обходной маршрут требует сборки проекта через Xcode на Mac и короткого трюка при каждом старте приложения: к процессу ненадолго цепляют отладчик LLDB (с учетом наработок проекта StikDebug), выделяют под его прикрытием 384 МиБ быстрой JIT-памяти и 4,5 ГиБ оперативки в обход стандартного лимита памяти iOS, после чего отладчик отключают — а система продолжает летать сама. Поверх открытого транслятора Henge с помощью ИИ достроили все, чего требовало ядро Windows NT: перевод кода ARM64 в ARM64 на скорости, близкой к нативной, работу со страницами памяти по 4 КБ поверх 16-килобайтных страниц iOS с удержанием кеша при 64 800 переключениях контекста в секунду и поддержку встроенного в Windows транслятора Prism для программ под x86-64.
Отдельным квестом стала сборка виртуальной "материнской платы", без которой свежая Windows 11 отказывается грузиться. К готовой прошивке UEFI от EDK2 добавили таблицы ACPI 6.3, контроллеры NVMe 1.4 и USB 3.0 xHCI, а для звука с нуля написали эмуляцию PCIe-аудиокарты Intel ICH6 HD Audio — система подхватывает ее встроенными драйверами и сразу заводит динамики с микрофоном айфона.
Сам образ Windows 11 облегчили отдельным скриптом: из системы вычистили более 35 фоновых компонентов, включая телеметрию, индексатор и встроенный антивирус, снизив расход памяти в простое до 1,46 ГБ. Внутри смартфона работают браузер Microsoft Edge и среда разработки Antigravity с кодинг-агентами, а для входа в аккаунт Google написали крошечный 14-килобайтный мост WinIOSBrowser.exe — он перебрасывает OAuth-авторизацию прямо в родное окно Safari на iOS с поддержкой ключей доступа и Face ID.
Интерфейс привязали к датчику угла сгиба экрана в iOS 27, а вывод графики через Metal рассчитали на 120 Гц. Если раскрыть iPhone Duo полностью, получается планшет с полноценным рабочим столом, а стоит согнуть корпус пополам — верхняя створка становится экраном микро-ноутбука, а нижняя рисует шестирядную клавиатуру с кнопкой Copilot и тактильным тачпадом в духе линейки Surface.
P.S. О том, какие еще инженерные штуки разработчики собирают с помощью свежих моделей и куда двигаются ИИ-агенты для кода, пишу в своем Telegram-канале "Сбежавшая нейросеть".
Режим быстрой сборки веб-приложений прямо в чат-боте Илона Маска обернулся классической ловушкой вайб-кодинга. В отчете компании Claroc от 10 ноября исследователь Асаф Апрозпер сообщил, что его команда проверила 37 571 работающее приложение Grok Build и обнаружила 35 578 сервисов, открывающихся вообще без входа в аккаунт — 94,7% выборки.
Подвох кроется в механике публикации на домене grok.me. Сервис выдает проекту адрес из четырех случайных слов и предлагает вариант доступа "всем, у кого есть ссылка", но наблюдения за такими поддоменами попадают в коммерческие базы пассивного DNS — в итоге "секретные" адреса находятся обычным поиском без всякого перебора.
Большинство находок оказались безобидными играми, лендингами и калькуляторами, однако в 650–800 приложениях исследователи насчитали реальные приватные данные. Среди них всплыли сразу 24 рабочих сервиса сотрудников X и SpaceXSI (SpaceX Super Intelligence — бывшей xAI, вошедшей в состав SpaceX в феврале): карта продаж по 594 стратегическим аккаунтам компаний, конфиденциальный рекламный питч для федерального ведомства США и план адаптации новичков со ссылками на внутренние системы и 19 рабочих чатов.
За пределами компаний Маска аналитики опознали данные еще 30 организаций, включая шесть корпораций из списка Fortune 500. В открытом доступе лежали реанимационная сводка пациента на ИВЛ, результаты 3 784 медосмотров строительной фирмы из Перу, список более 3 500 сотрудников больницы и табель подрядчика, отдававший прямо в браузер код с 18 логинами и паролями открытым текстом.
Отдельный сюрприз ждал авторов отчета, когда на собственном тестовом приложении они попросили Grok добавить вход через Google. Сгенерированный код сначала автоматически записывал любого вошедшего пользователя в команду проекта и лишь потом проверял членство, так что посторонний аккаунт спокойно прочитал клиентскую базу, изменил одну запись и удалил другую.
Представитель приобретенной SpaceXSI компании Cursor ответил журналистам Ars Technica, что приложения по умолчанию приватны и публикуются только по решению создателя — хотя в проверенном Claroc платном аккаунте при публикации сразу стояла галочка доступа по ссылке. Через несколько часов после запроса редакции рабочие сервисы сотрудников Маска начали снимать с публикации, и к выходу статьи все 24 адреса выдавали ошибку "app not found", тогда как большинство чужих утечек продолжали открываться.
P.S. О том, какие грабли прячутся за быстрой сборкой сервисов через нейросети и как безопасно применять ИИ в реальных задачах, пишу в своем Telegram-канале "Сбежавшая нейросеть".
Привет, Пикабу! В основу этого поста легли живые технические воркшопы, которые наш разработчик платформы Mobile SMARTS Саргис Геворгян проводил в разных городах России — от Новосибирска и Красноярска до Краснодара и Ставрополя. А точнее — те самые честные разговоры «без галстуков» с программистами, сисадминами и интеграторами, которые начинаются уже после официальной части, когда гаснет проектор и люди подходят со своей реальной производственной болью.
На одной из таких встреч случился показательный диалог. В зале сидела типичная сборная солянка: программисты 1С и директора небольших франчайзи, разработчики самописных учетных систем, бывалые интеграторы (которые уже проходили базовое обучение и пришли послушать про тонкости написания кода внутри платформы) и пара айтишников, случайно заглянувших на огонек с первого дня конференции.
Посреди демонстрации один парень из зала, явно считавший себя суровым технарем, скептически тянет руку:
— Слушайте, ну это всё понятно, базовые вещи для широкой публики. А можно в следующий раз придет кодер платформы? Хочу поспрашивать, как оно реально внутри устроено.
Саргис посмотрел на него, улыбнулся и говорит:
— Так я и есть кодер платформы. Какие вопросы? Давайте разбираться, как это работает под капотом.
Они рубились минут пятнадцать — про объектный слой, XML-схему базы, устройство гибридных справочников и механику синхронизации. Скепсис быстро испарился: парень признал, что слегка недооценил глубину кроличьей норы.
Этот случай как рентген подсвечивает главную «детскую болезнь» всей мобильной автоматизации. Когда обычному программисту — неважно, пишет он на C#, Kotlin, Python или 1С, — прилетает задача «прикрутить терминалы сбора данных (ТСД) к нашей учетке», первая мысль в его голове почти всегда звучит одинаково:
«Господи, да что там пилить? Экранчик с двумя кнопками, поле ввода под штрихкод и отправка JSON-чика по REST API на бэкенд. Зачем мне учить какую-то стороннюю платформу, если я сам напишу своё приложение и мне там каждая строчка будет родной и понятной? Тем более сегодня, с Cursor и Codex!»
И знаете что? Давайте сразу будем честны. Иногда самописка — это реально рабочий вариант.
Если у вас один небольшой магазинчик или крошечный склад, ровно один ТСД, одна намертво застывшая конфигурация учетной системы, которую никто не трогает годами, а в ваших процессах нет (и никогда не предвидится) обязательной маркировки — открывайте любимую IDE, запускайте нейросеть, пилите свое мини-приложение и даже не читайте этот пост дальше. Вы закроете задачу за месяц и благополучно о ней забудете. А разгребать за вами эту задачу потом уже будет другой программист, с внутренним миром богаче вашего, которого будет дико ломать разбираться в вашей архитектуре (но это уже проблемы бизнеса, а не ваши).
Однако если у вас больше одного терминала, живой растущий бизнес, дырявый складской Wi-Fi, зоопарк штрихкодов от поставщиков или товары, подпадающие под «Честный ЗНАК», — добро пожаловать в суровую реальность. Давайте без маркетинговой воды разберем по косточкам, почему «простая приложуха для сканера» неизбежно превращается в кровавый долгострой, какие инженерные паттерны лежат внутри зрелой платформы для ТСД (даже без привязки к бренду Клеверенс) и как готовая платформа с коннекторами экономит разработчикам месяцы жизни и нервных клеток.
Почему самописные клиенты для ТСД так стремительно обрастают костылями? Всё начинается с фундаментального конфликта двух миров. Разработчики ERP, WMS и учетных систем привыкли мыслить категориями офисного или серверного софта.
Но учетная система и мобильный терминал в руках кладовщика решают диаметрально противоположные физические задачи:
Задача ERP — аккуратно зафиксировать прошлое
Транзакция уже случилась. Оператор сидит в теплом кабинете за большим монитором со стабильным интернетом, и у него есть 5–10 минут, чтобы не торопясь разнести накладную, сверить реквизиты и провести документ.
Задача мобильной платформы на ТСД — управлять настоящим в моменте
Транзакция происходит прямо сейчас. Кладовщик стоит в холодном проходе между стеллажами, в одной руке коробка, в другой — терминал. Ему нужно отбить операцию за доли секунды (в идеале — быстрее 0,8 секунды на один скан), мгновенно получить от системы проверку по бизнес-правилам и увидеть следующий шаг маршрута. Мобильное приложение здесь — не «удаленная форма ввода в базу», а навигатор, который ведет человека по процессу и физически отсекает ошибки еще до того, как они улетят в учетную систему.
Именно по этой причине попытки прокинуть на ТСД десктопные окна ERP через удаленный рабочий стол (RDP) или открыть в мобильном браузере обычную веб-форму учетки всегда заканчиваются болью: функционально на экране есть всё, но тыкать пальцем в микроскопические таблицы на 4-дюймовом дисплее посреди склада невозможно.
Когда же разработчик решает написать собственный нативный клиент с нуля, он по очереди наступает на три системные мины.
У себя за столом программист отлаживает приложение в эмуляторе на мощном ноутбуке или на своем личном современном смартфоне. Но на реальных складах живут совсем другие зверьки. Самые массовые рабочие лошадки на рынке — это бюджетные и среднебюджетные промышленные терминалы (вроде Atol Smart.Lite, Smart.Prime, Urovo DT40), а на куче заводов и баз до сих пор в строю аппараты на древних версиях Android (от 5 до 11) и даже неубиваемые динозавры на Windows CE / Windows Mobile.
Попробуйте накатить на такой бюджетный ТСД приложение, собранное на тяжелом кроссплатформенном фреймворке вроде Flutter или на базе увесистого веб-движка (как в модных банковских супераппах или приложениях доставки). Вы удивитесь: холодный старт такого приложения на слабом железе ТСД легко занимает от 2 до 5 минут. Любой синхронный сетевой вызов или лишняя перерисовка интерфейса в главном потоке тут же намертво вешает окно и выбивает ANR (Application Not Responding) — ту самую системную табличку «Приложение не отвечает». На практике даже замена обычной плоской полоски загрузки (ProgressBar) на стандартный крутящийся спиннер на медленном ТСД съедает 10–15% времени запуска и заметно быстрее высаживает батарею просто из-за лишних тактов перерисовки.
А следом во всей красе встает аппаратная интеграция. Вам придется вручную подружить свой код:
со встроенными аппаратными сканерами штрихкодов разных производителей (у каждого вендора свои broadcast-интенты и свой SDK);с внешними Bluetooth-сканерами-кольцами и RFID-считывателями (включая работу по низкоуровневому протоколу LLRP);
с мобильными и стационарными принтерами этикеток и чеков, чтобы печатать маркировку напрямую с ТСД по Bluetooth или Wi-Fi даже в полном оффлайне без участия сервера;
с аппаратной индикацией самого терминала — звуком и вибромотором (потому что на потоковой сборке или при работе с прайс-чекером кладовщик ориентируется на звуковой сигнал ошибки, а не смотрит в экран после каждого «пика»).
Если писать и сопровождать всё это хозяйство самому, то, как емко выразился Саргис на воркшопе, «можно просто устать». В специализированной платформе весь аппаратный слой уже заботливо изолирован: перехват луча сканера работает в любом визуальном окне из коробки, а управление вибрацией, звуком или записью в системный лог дергается одной командой встроенного объекта.
Допустим, вы победили железо и через месяц выкатили в прод первую версию своей самописки. Она бодро пикает обычные линейные штрихкоды и складывает их в вашу базу.
Но проходит три месяца, и бизнес приносит новости: вводится обязательная маркировка для новой категории товаров (или обновляются правила валидации в «Честном ЗНАКе»), поставщики начинают возить паллеты с агрегированными кодами, а параллельно прилетает апдейт вашей ERP или конфигурации 1С, где перекроили структуру документов.
Вот тут самописный проект встает колом. Программисту приходится «вручную» закапываться в спецификации GS1 и DataMatrix, писать парсинг идентификаторов применения (AI), высчитывать криптохвосты и учить свое приложение отличать пачку молока от бутылки воды или коробки обуви. Но самое сложное — понять, к какой именно товарной группе принадлежит маркированный товар, и в этом случае приходится городить еще больше исключений из правил и пилить еще больше интеграций. В платформе эта головная боль снята на уровне архитектуры: там уже живет готовый системный объект маркировки, который централизованно обновляется вендором платформы. Прикладному разработчику вообще не нужно парсить сырую строку символов — отсканировал код, и в операции сразу лежат готовые типизированные поля марки.
У любого кастомного клиента под ТСД, написанного внутри компании на Java, Kotlin или C#, есть родовая травма: он целиком держится на том единственном разработчике, который его написал.
Стоит этому человеку уволиться или уйти на другой проект, как компания остается один на один с сиротским репозиторием. Найти на рынке мобильного разработчика, который согласится ковыряться в чужом узкоспециализированном коде складского терминала ради мелких правок бизнес-логики, — квест долгий, дорогой и неблагодарный.
Давайте теперь отвлечемся от брендов и посмотрим на задачу чисто инженерно. Какие архитектурные механизмы отличают специализированную платформу, связывающую парк ТСД и учетную систему, от простого «клиента для дерганья REST API»?
Проследим, как обычно эволюционирует мысль разработчика, когда он берется проектировать обмен данными для склада.
Первая мысль — сделать легкий онлайн-клиент: пикнул штрихкод → кинул HTTP-запрос в ERP → отрисовал ответ. В офисе возле роутера всё летает. Но реальный склад — это огромная клетка Фарадея из железных стеллажей до потолка, бетонных перекрытий и паллет с водой. В мертвых зонах Wi-Fi пакеты бьются, сокеты отваливаются, и тонкий онлайн-клиент превращается в бесполезный кусок пластика.
«Ладно, — говорит себе архитектор, — переходим на Offline-First с локальной базой на борту терминала». Но тут всплывает фундаментальная засада: под мобильные ОС вроде Android не существует «взрослых» реляционных СУБД корпоративного класса (уровня Oracle или MS SQL Server), которые умели бы крутиться локально на слабом мобильном чипе и одновременно из коробки обеспечивать прозрачную двустороннюю репликацию с центральной базой. В вашем распоряжении есть только локальный SQLite, а поверх него вам придется руками изобрести целый движок синхронизации:
Решить, какие справочники нужно хранить в памяти ТСД целиком, какие — тянуть с промежуточного сервера, а за какими ходить напрямую в ERP.
Написать систему версионирования строк и дифференциальной синхронизации, чтобы при обмене гонять только маленькие бинарные дельты изменений, а не перекачивать гигабайтные дампы по хилой складской сети.
Отделить от основных табличных транзакций тяжелые бинарные данные (фотографии брака, сканы накладных), организовав их фоновую покусочную (чанковую) докачку при появлении связи.
Обеспечить идемпотентность сетевых вызовов при коллективной работе: если связь легла в момент отправки запроса, повторный запрос после реконнекта должен опознаваться по уникальному GUID, чтобы сервер не наплодил дублей документа, а просто вернул клиенту результат уже отработавшей операции.
Именно этот пласт задач в платформе Mobile SMARTS решен с помощью технологии HYDB (Hybrid Database — гибридная база данных). Под капотом она сшивает воедино локальный движок SQLite, систему XML-метаданных и поисковых индексов (включая тяжелые индексы для мгновенного поиска по части строки), отдельное хранилище бинарных блобов и собственный слой ORM.
От прикладного разработчика вся эта внутренняя магия скрыта: он обращается к данным через привычные запросы SELECT и транзакции, вообще не думая о том, где физически лежит запись.
В настройках любой таблицы достаточно проставить флаги её поведения:
хранится ли она в реляционном виде или в формате XML;
выгружается ли таблица на само устройство или живет только на сервере (Server Table);
разрешен ли для неё прямой внешний запрос в учетную систему (External Call) и с каким временем жизни кэша (Data Refresh Period).
Случай с воркшопов: классическая ловушка гибридного справочника
Саргис рассказывает, что именно на гибридных таблицах разработчики чаще всего ловят интересный когнитивный диссонанс.
Представьте картину: программист включил онлайн-запрос к 1С за остатками товара, но параллельно вчера вечером выгрузил справочник остатков из 1С на сервер платформы. За ночь в 1С остаток товара поменялся и стал равен 10 штукам, а в выгруженной на сервер платформы таблице со вчерашнего вечера осталась запись — 5 штук.
Утром кладовщик сканирует этот товар на ТСД. Терминал делает запрос... и рисует на экране 5 штук!
Программист в шоке: «Почему он не полез в 1С, у меня же стоит галочка онлайна?!»
Разгадка кроется в алгоритме разрешения запросов HYDB: когда мобильный клиент запрашивает данные гибридной таблицы, сервер платформы первым делом проверяет свою локальную серверную таблицу. Так как запись по этому товару там найдена (пусть и со вчерашним остатком 5 штук), HYDB считает миссию выполненной и не идет дальше во внешний вызов к ERP, бережно экономя сеть и не дергая учетную систему почем зря. Внешний запрос в ERP срабатывает как каскадный фолбэк только тогда, когда локальная выборка вернула пустоту (0 записей). Когда разработчик понимает эту цепочку («Локальная БД ТСД → БД сервера платформы → Внешняя ERP»), он получает полный контроль над компромиссом между свежестью цифр и нагрузкой на бэкенд.
Когда компания вырастает до розничной сети или нескольких складов, в центральной базе легко копится 1 000 000 записей остатков и цен по 10 объектам. Заливать весь этот миллион строк на каждый ТСД бессмысленно — кладовщику в конкретном магазине нужны остатки и цены только его точки.
В платформенной архитектуре для этого предусмотрены два дополняющих друг друга механизма:
Нарезка таблиц (Table Slices): специальный серверный коннектор (TableSlicerConnector) берет общую миллионную таблицу (скажем, Stock), режет её по заданной колонке (например, WarehouseId) и раскладывает на диске сервера по отдельным физическим папкам. Когда конкретный терминал просит обновить справочник, на клиенте вычисляется выражение привязки (например, CurrentWarehouse.Id), и сервер отдает устройству только его компактный кусок таблицы. При этом разработчик сам управляет поведением при нештатных ситуациях (Error Behavior): что делать, если выражение среза почему-то не вычислилось — не отдавать ничего (оставив терминал со старыми данными) или выгрузить таблицу целиком (понимая риск положить сеть массовым скачиванием).
Расширения таблиц документа (Table Extensions): еще более изящная оптимизация внутри HYDB. Когда на терминал прилетает конкретный документ задания (например, «Приемка по заказу поставщика №10021»), прямо внутрь этого экземпляра документа упаковывается локальная мини-таблица расширения (Stock table extension), в которой лежат ожидаемые остатки, серии и адресные ячейки строго по номенклатуре этого конкретного заказа.
Вся красота этого решения в том, что структура колонок (метаданные) расширения один в один повторяет структуру большой серверной таблицы Stock. Код мобильного приложения на ТСД делает самый обычный запрос к таблице Stock, даже не догадываясь о существовании локального кэша: платформа сама прозрачно перехватывает запрос и мгновенно отдает данные из расширения открытого документа. А если кладовщик вдруг пикнул товар, которого не было в заказе поставщика, запрос к расширению возвращает 0 записей — и только в этот момент платформа автоматически делает запрос к серверу или внешней ERP. Более того, прямо в процессе приемки терминал может дописывать в это расширение собственные строки, готовя структурированный пакет данных для последующей отправки на бэкенд.
Разработчики, пишущие свою первую складскую софтину, почти всегда проектируют документ как одну плоскую таблицу: загрузили из ERP плановый список (Товар А — План: 10, Факт: 0) и при каждом пике сканера просто прибавляют единичку в колонку Факт.
На живом складе эта наивная схема рассыпается в первый же день. Почему? Потому что 10 штук Товара А приезжают в двух разных коробах по 5 штук, у каждого короба свой уникальный серийный код транспортировки (SSCC) и своя партия, а следом из фуры выгружают 1 штуку Товара С, которого вообще не было в накладной. Если вы просто плюсуете цифру в одной плановой табличке, вы навсегда теряете историю того, в каких именно коробках и с какими кодами приехал товар.
Поэтому в платформе любой документ при выгрузке из ERP структурно делится минимум на две отдельные таблицы:
Expected Items (Плановые строки): исходное задание из учетной системы (Item A — Expected: 10, Actual: 10; Item B — Expected: 3, Actual: 1; Item C — Expected: 0, Actual: 1).
Actual Items (Фактические строки): подробный лог каждого физического скана с привязкой к таре, сериям и времени. При этом в каждой строке факта тоже есть поле Expected Qty, но в нем хранится не вся сумма заказа, а аллоцированная доля плана, закрытая конкретно этой строкой факта:
Item Code: 101
Item Name: Item A
Expected Qty (доля плана): 5 (из 10)
Actual Qty (факт): 5
SSCC (код паллеты/короба): 10005413119
Item Code: 101
Item Name: Item A
Expected Qty (доля плана): 5 (из 10)
Actual Qty (факт): 5
SSCC (код паллеты/короба): 10006715311
Item Code: 102
Item Name: Item B
Expected Qty (доля плана): 1 (из 3)
Actual Qty (факт): 1
SSCC (код паллеты/короба): —
Item Code: 103
Item Name: Item C
Expected Qty (доля плана): 0 (вне плана)
Actual Qty (факт): 1
SSCC (код паллеты/короба): —
На каждый пик сканера платформа одновременно модифицирует три структуры: «грязную» таблицу сырых сканов, витрину для мгновенного обновления цифр на экране ТСД и итоговую таблицу документа для отправки в ERP. Все три операции выполняются внутри единой атомарной транзакции: если на любом этапе что-то пойдет не так, транзакция откатится целиком (rollback), не допуская рассинхрона между экраном и базой.
Рядом из коробки работает встроенная логика Упаковок (Packings) с коэффициентами пересчета к базовой единице (штуки, спайки, блоки) и Контейнеров (Containers) — индивидуально отслеживаемых паллет, весовых монокоробов и сборных микс-коробов.
В розовом мире теоретиков все товары оклеены аккуратным заводским EAN-13 или эталонным GS1-128 со всеми разделителями. В суровой реальности, как рассказывает Саргис по опыту воркшопов, заказчики обожают генерировать собственные, ни на что не похожие штрихкоды.
Самая частая боль в рознице и на пищевом производстве — весовой EAN-13: с виду это обычный 13-значный штрихкод, но внутри него зашиты сразу две сущности: первые цифры обозначают код товара (по которому его нужно найти в базе), а последние 5 или 6 цифр перед контрольной суммой — это вес конкретного куска сыра или коробки в граммах. Другой классический случай — внутренние заводские этикетки на таре без спецсимволов-разделителей, где в одну строку слеплены номер коробки, вес и артикул: B123456W000250 или P970001S211000101.
Вместо того чтобы заставлять программиста писать трехэтажные регулярки в коде под каждого поставщика, в платформе работают Шаблоны штрихкодов (Barcode Data Templates), состоящие из константных префиксов и именованных переменных нужной длины:
P{ProductCode:6}S{SerialNumber:9}
или для сборного микс-короба:
MXD{BoxID:5}Q{Quantity:3}ITM{ItemCode:5}
В момент сканирования ядро платформы само прогоняет строку по шаблонам, мгновенно определяет тип объекта (товар, упаковка, адрес ячейки, накладная или конкретный вид контейнера) и автоматически раскладывает вырезанные переменные {ProductCode}, {Quantity} или {Weight} по нужным полям в операции. А стандартные коды GS1-128 вида (01)012345678905(10)ABC123(17)231231(30)025 платформа парсит сама из коробки вообще без единого шаблона.
Давайте теперь заглянем в саму среду разработки (Панель управления Mobile SMARTS) и посмотрим, как это ощущается руками программиста и почему сборка из визуальных действий уделывает по скорости обычное написание кода.
Создатели платформы разделили разработку на два этажа, чтобы типовые складские и магазинные задачи решались быстро и без боли, но при этом у хардкорных системных инженеров оставалась полная свобода маневра:
Прикладной уровень (разработка и кастомизация мобильных приложений)
Инструментарий и стек: Визуальный редактор действий («стрелочки»), встроенный скриптовый язык с упрощенным C#-подобным синтаксисом, Cleverence Framework, СУБД HYDB
Какие задачи решает: Сборка экранов ТСД, логика переходов, валидация сканов, верстка интерфейса, шаблоны ШК, работа с таблицами и документами
Системный уровень (ядро, тяжелые интеграции и расширения)
Инструментарий и стек: C# (.NET Core 6) для сервера и клиентов, JavaScript (React Web) для веб-приложений, SQLite / PostgreSQL, XML, бинарные индексы
Какие задачи решает: Написание собственных внешних коннекторов (Inventory API), серверных расширений, веб-интерфейсов и высоконагруженной логики
Сам Саргис описывает прикладной уровень коротко: «Это визуальный конструктор мобильных приложений с помощью действий и одновременно готовый инструмент интеграции с учетными системами».
Когда за Панель управления садятся 1С-ники, они сразу видят знакомые черты — дерево метаданных создавалось с оглядкой на конфигуратор 1С, только без его перегруженности. Но вот сам подход к конструированию форм и логики отличается радикально: даже в 1С программисту приходится кодом или ручной настройкой описывать каждую форму, её габариты и привязки кнопок. В платформе же вы просто собираете схему алгоритма из готовых визуальных кубиков-действий, соединяя их стрелочками переходов, а там, где нужна нестандартная логика, дописываете скрипт на встроенном языке с очень простым, очищенным от всего лишнего C#-подобным синтаксисом. При этом прямо в редакторе по хоткею вызываются встроенные подсказки (IntelliSense), которые показывают все методы и свойства внутренних объектов.
Чтобы люди в зале с первых минут почувствовали темп работы, стартовый пример собирается у всех на глазах буквально за пять минут:
В Панели управления создаем новый Тип документа.
Кидаем внутрь алгоритма всего три визуальных действия: Сканирование товара → Ввод количества → Запись в документ.
Открываем учетную систему (допустим, 1С), в пару кликов клонируем типовой бизнес-процесс и выбираем в нем наш свежий тип документа.
Никакой возни с сетевыми сокетами, парсингом JSON и отрисовкой табличек: участник пикает штрихкод, вводит количество — и готовый документ с товаром уже лежит в базе 1С.
А дальше начинаются реальные боевые задачи из зала.
На одном из первых воркшопов Саргис показал доработку, которая вызвала такой бурный интерес, что с тех пор её стали показывать в каждом городе: обязательная фотофиксация товара при сканировании штрихкода.
Как выяснилось, многие разработчики и интеграторы даже не знали, что платформа умеет делать это буквально в пару кликов. В готовый алгоритм сбора штрихкодов добавляются ровно два визуальных действия: вызов камеры на каждый скан и запись фотки. Всю тяжелую работу берет на себя HYDB: фотография отделяется от легковесных табличных строк документа, режется на куски и незаметно улетает на сервер в фоновом потоке, а разработчик просто выбирает, куда именно приземлить этот файл на стороне учетной системы.
Вторая вещь, которая неизменно вызывает вау-эффект у программистов на воркшопах, — то, как легко меняется визуал приложения:
Разметка текста и кнопок прямо на лету: в Новосибирске один из участников попросил показать, насколько сложно поменять цвета кнопок и шрифтов внутри операции. Подключаем отладку в десктопном эмуляторе WinClient, заходим в свойство кнопки, просто пишем по-английски Red — и кнопка в окне отладчика мгновенно становится красной. Нужно сделать черный текст внутри плашки белым? Оборачиваем строку в тег <white>Текст</white> (как в обычном HTML) — и текст тут же меняет цвет без единой строчки сложного кода.
Стилизация главного бургер-меню и цветовых тем без пересборки APK: многие думают, что раз коробочные решения имеют фирменные цвета («Склад 15» — оранжевый, «Магазин 15» — красный), а главное окно и боковое бургер-меню зашиты в саму Android APK-шку клиента, то поменять их без перекомпиляции APK невозможно.
На самом деле в платформе есть хитрая и очень крутая фича: и единая палитра цветов всех кнопок, и конфигурация главного бургер-меню могут подтягиваться из внешних файлов стилей, которые лежат на сервере внутри конкретной базы. Когда ТСД цепляется к этой базе, эти файлики прилетают на устройство, и приложение рисует бургер-меню уже не по дефолтному зашитому шаблону, а по вашему файлу! То есть вы фактически кастомизируете APK-шку в разрезе одной базы без участия вендора: можете перекрасить весь интерфейс в брендбук заказчика, добавить в бургер-меню свои пункты со своими иконками и повесить на нажатие прямой вызов нужного типа документа.
Лучшее доказательство того, что перед нами универсальный конструктор мобильных приложений, а не просто «узкая утилита для кладовщика», встречало участников прямо на входе.
Регистрация самих гостей мероприятия, запись их контактов и моментальная распечатка именных бейджей на принтере этикеток работали на приложении, собранном на этой же платформе. Когда из зала спрашивали, сколько времени заняла разработка такой системы для ивентов, Саргис честно отвечал: «Я собрал эту конфигурацию на выходных за три часа под банку пива».
Если вы пересаживаетесь в Панель управления из привычных IDE вроде Android Studio или VS Code, есть один нюанс, о который спотыкаются почти все новички.
В классической разработке под мобилки всё прямолинейно: запустил эмулятор, поправил код в IDE, нажал Hot Reload — и среда разработки напрямую заменила файлы внутри памяти эмулятора.
В Панели управления Mobile SMARTS вы тоже можете подключить к отладчику живой терминал или открыть десктопный эмулятор (WinClient), менять визуальные действия или серверные скрипты и сразу видеть отклик. Но стоит вам добавить новый справочник или поменять структуру полей таблицы для документа, как вы замечаете: в открытом эмуляторе эти данные не появятся, пока вы принудительно не нажмете кнопку «Обмен».
Почему так устроено?
Потому что в Панели управления вы редактируете не локальные файлы внутри мобильного устройства, а конфигурацию самой серверной базы данных платформы.
В одном окне вы пишете и серверный код, и клиентский код, и всё это сохраняется в виде XML-файлов конфигурации на стороне сервера. Когда вы правите серверную логику, сервер применяет её тут же. Но когда правки касаются данных и структур на клиенте, они сначала сохраняются на сервере, а затем должны штатно прилететь на терминал (или в эмулятор WinClient) через обычный цикл обмена.
Отсюда же вытекает и важное предупреждение: хотя вся конфигурация под капотом хранится в обычных XML-файлах, лезть править эти сырые XML-ки руками в Блокноте или Visual Studio — затея рискованная. Достаточно случайно пропустить одну закрывающую скобку или опечататься в теге, и при запуске база молча проигнорирует битую ветку XML — приложение запустится, но ваши операции из него просто исчезнут. Панель управления гарантирует безопасность таких правок и позволяет параллельно отлаживать в одном окне сразу три контура: сервер, удаленный физический ТСД и локальный WinClient. (Маленькое уточнение от автора: с использованием современного ИИ это ограничение уже кажется лишним, и грамотные специалисты научились тупо править сами XML-файлы напрямую через нейросети).
Второй регулярный вопрос с мест на каждом воркшопе — про Linux и импортозамещение. Саргис показывает работу Панели управления на ноутбуке с Windows, и из зала тут же спрашивают: «У нас вся серверная инфраструктура переехала на Linux (Ubuntu, Debian, Astra Linux). Как нам ставить платформу и как с ней работать, если ваш конфигуратор только под Винду?»
Здесь всё просто, если разделить сервер базы данных (Apps Server) и рабочее место разработчика (Панель управления):
Серверная часть нативно живет на Linux. Сервер платформы написан на .NET Core и без проблем работает как на Windows, так и на Linux (включая отечественную Astra Linux, на которой активно крутятся реальные проекты). Графическая оболочка на сервере ему не нужна: установка на Linux делается буквально тремя командами в терминале — скачали архив с сайта, распаковали и запустили консольный инсталлятор прямо в шелле.
Конфигурирование идет удаленно по клиент-серверной схеме. Пытаться натянуть десктопную Панель управления или WinClient поверх графической Ubuntu не нужно — они написаны под Windows. Вместо этого используется схема, до боли знакомая каждому, кто работал с серверной 1С или любой СУБД:
- На Linux-сервере в контейнере или службе разворачивается база платформы и выдает строку подключения.
- Разработчик копирует эту строку себе на рабочий компьютер с Windows, вставляет в Панель управления и подключается к Linux-серверу по сети.
- Вся разработка и отладка спокойно ведутся с вашей рабочей машины, пока само ядро и база крутятся на Linux.
А чтобы отвязать проверку клиентских экранов даже от десктопного WinClient, команда платформы сейчас пилит полноценный браузерный Web-клиент, который позволит запускать эмулятор терминала прямо в браузере на любой ОС.
И наконец, главный вопрос для разработчиков самописных ERP и программистов 1С: как именно платформа общается с внешней учетной системой и на чьей стороне лучше писать бизнес-логику?
Во-первых, для львиной доли популярных систем уже есть готовые коробочные коннекторы: от десятков типовых, отраслевых и облачных конфигураций 1С и МойСклад до iiko, SAP S/4HANA, Microsoft Dynamics (AX 2012 / D365) и Odoo (v13–v17).
Во-вторых, для любой кастомной или полностью самописной учетки в платформе предусмотрен прозрачный архитектурный контракт.
В мире мобильных терминалов действует железное правило: сервер никогда не пытается сам инициировать соединение с ТСД. Терминал может спать в кармане кладовщика, ехать в грузовом лифте или быть выключенным — поэтому сервер платформы (Apps Server) только готовит данные и ждет, пока ТСД сам постучится за обновлениями.
А вот между сервером платформы и вашей ERP работает полноценный двусторонний обмен (2-Way Integration) по одной из двух схем:
Схема 1 (ERP в роли сервера данных — рекомендуемый вариант): ваша учетная система выставляет наружу стандартный REST/JSON контракт Inventory API. Сервер платформы сам ходит в этот API как по расписанию (для пакетной синхронизации), так и в реальном времени при онлайн-запросах с ТСД.
Схема 2 (ERP в роли активного клиента): ваша учетная система сама дергает API сервера платформы, выгружая туда новые задания на сборку, и забирает результаты по сигналу завершения документа с терминала.
Главная инженерная фишка здесь в том, что и для Real-Time (онлайн), и для Batched (пакетного) режима используется одна и та же инфраструктура и один и тот же код коннектора Inventory API. Вам не придется писать и поддерживать два разных модуля обмена для онлайна и оффлайна.
При этом платформа общается с ERP целыми документами (Document-Based Transaction Model): вместо того чтобы расстреливать базу вашей учетки сотнями мелких запросов на каждый пик сканера, она собирает весь результат работы кладовщика в обогащенный документ и отдает его одним пакетом.
Чтобы не переписывать код интеграции при каждом изменении бизнес-правил, связка документов ERP и документов ТСД вынесена в конфигурационную таблицу Бизнес-процессов (Business Processes).
По сути, это умный словарь из трех частей:
Исходный документ ERP (erpSourceDocumentType + erpSourceConfigSettings): какой документ забираем из учетки (например, PurchaseOrder), каким алгоритмом конвертируем и с какими JSON-настройками ({ "scanLot": true, "allowUnknown": false }).
Документ на ТСД (mobileAppDocumentType + mobileExecutionSettings): в какой мобильный документ он превращается (Receiving Document) и что требуется от кладовщика на экране ({ "scanSerialNum": true }).
Итоговый документ ERP (erpResultDocumentType + erpResultConfigSettings): какой документ создаем или обновляем в учетке после завершения сборки и с какими параметрами ({ "highlightDiscrepancies": true }).
Если под документ подходит только один бизнес-процесс, ТСД запускает его автоматически без лишних вопросов. Если процессов несколько (допустим, обычная инвентаризация и инвентаризация со списанием боя), терминал сам выведет пользователю меню выбора.
Пример из архитектурного гайда: как один C#-коннектор закрывает 4 разных процесса за счет JSON
Посмотрите, как это экономит время разработчика на практике. Допустим, в вашей облачной учетной системе (будь то кастомная 1С в облаке, веб-система уровня iiko или МойСклад, подключенная через C#-коннектор InventoryAPI) есть всего один базовый документ корректировки остатков (Stock Quantity Adjustment), который ждет на вход артикул и дельту количества (QTY Difference).
На складе же кладовщики делают четыре совершенно разные операции:
Частичный пересчет (Partial Stock Count): создается прямо на ТСД без документа-основания, фиксирует фактическое число товара на полке.
Полная инвентаризация (Full Stock Count): идет по выгруженному из ERP слепку остатков.
Списание порчи (Write Off): считает только разбитый или потерянный товар.
Выпуск продукции по техкарте (BOM Execution): списывает ингредиенты/сырье и приходует готовое изделие.
Вместо четырех разных обменов разработчик пишет один универсальный метод в C#-коннекторе, который просто читает JSON-настройку erpResultConfigSettings из строки бизнес-процесса:
Если в JSON прилетело "Adjustment Type": "New Stock Value" (инвентаризация), коннектор сам запрашивает из ERP текущий остаток товара, вычитает его из посчитанного на ТСД факта (QTY Difference = New - Current) и отправляет разницу.
Если в JSON указано "Adjustment Type": "Direct Adjustment" (списание брака или производство по BOM), коннектор берет цифру с ТСД напрямую как готовую дельту и подставляет нужный комментарий (Memo) и тип себестоимости.
Четыре разных процесса на складе — и ровно один кусок кода на бэкенде!
По опыту общения с разработчиками после воркшопов Саргис заметил забавную закономерность. Допустим, при работе с документом нужно дернуть внешний REST-сервис или разбить одну гигантскую накладную из ERP на пять маленьких документов для разных сборщиков. Как поступают программисты?
Путь 1 (На стороне платформы): внутри Mobile SMARTS есть готовые объекты для отправки REST-запросов (с примерами в базе знаний) и возможность писать свои системные расширения на C#. Всё можно сделать прямо в платформе.
Путь 2 («Путь здоровой лени» на родном языке своей учетки): как смеется Саргис, «многим ребятам просто в падлу разбираться с новым объектом для REST-вызова внутри платформы, когда свою 1С или ERP они знают вдоль и поперек».
Поэтому они делают ход конем:
В платформе настраивают то, в чем бессильна учетная система: визуальную верстку окон ТСД под капризы заказчика, шаблоны для распила весовых и нестандартных штрихкодов, работу со сканером/камерой и дополнительные поля документа.
В своей учетной системе (через вызов метода внешней системы и маппинг бизнес-процессов) забирают готовые данные с ТСД и уже в родной стихии — в обработке 1С, на Python, C# или ABAP — пишут все внешние REST-запросы, хитроумные проверки и алгоритмы деления документов.
А когда клиенты устраивают в своей базе откровенную дичь (например, заводят штрихкоды в 1С так криво, что падает любой стандартный алгоритм), открытость операций платформы спасает внедрение за минуты. Саргис вспоминает, как в Ростове, Краснодаре и Ставрополе интеграторы специально приезжали из соседних городов ради одного вопроса: «У нас заказчик наворотил такого в справочниках, что коробочный функционал не работает. Неужели переписывать всю операцию целиком?!»
И мы прямо на месте открывали Панель управления, находили нужный кубик алгоритма и показывали: «Не надо ничего переписывать. Вот сюда добавь одну строчку-проверку конкретно под их "залепуху" — оно никак не замедлит работу и закроет их уникальный случай». Люди благодарили и со спокойной душой ехали домой.
Чтобы не растекаться мыслью по древу, свели честную сравнительную таблицу трех подходов — сохраняйте, если предстоит защищать архитектуру перед руководством или заказчиком:
Стартовая скорость (Time-to-Market)
Самописка с нуля (Kotlin / Flutter / Мобильная 1С): Прототип с ИИ собирается бодро, но доводка под реальные ТСД, сеть и принтеры съедает месяцы
Штатные мобильные модули внутри ERP: Быстро только тогда, когда склад живет строго по стандартным правилам вендора ERP
Специализированная платформа для ТСД: Базовый процесс с обменом собирается за 3 действия; есть готовые коробочные решения
Работа на слабом железе и в дырявом Wi-Fi
Самописка с нуля (Kotlin / Flutter / Мобильная 1С): Нужно руками пилить кэш, дельта-синхронизацию, идемпотентность по GUID и бороться с ANR
Штатные мобильные модули внутри ERP: Часто требуют стабильного онлайна (тонкий клиент / RDP / тяжелый веб) и падают в мертвых зонах
Специализированная платформа для ТСД: Гибридная БД (HYDB), бинарная дельта-синхронизация, Table Slices, Table Extensions и легкий нативный рендерер
Железо, нестандартные ШК и «Честный ЗНАК»
Самописка с нуля (Kotlin / Flutter / Мобильная 1С): Интеграция каждого SDK сканера, принтера и поддержка всех обновлений ЧЗ ложатся на вас
Штатные мобильные модули внутри ERP: Умеют только базовые сценарии; кастомные весовые ШК и тара требуют тяжелой переделки
Специализированная платформа для ТСД: Сотни моделей ТСД, принтеров и RFID из коробки; декларативные шаблоны ШК и готовый объект маркировки
Гибкость стыковки с учетной системой
Самописка с нуля (Kotlin / Flutter / Мобильная 1С): Полная свобода, но весь транспорт, очереди и батчинг документов вы изобретаете сами
Штатные мобильные модули внутри ERP: Намертво привязаны к одной ERP; кастомизация мобильного интерфейса сильно урезана
Специализированная платформа для ТСД: Готовые коннекторы + открытый Inventory API для своих ERP; логику можно писать и в платформе, и на языке своей учетки
Поддержка и Bus Factor
Самописка с нуля (Kotlin / Flutter / Мобильная 1С): Ушел автор кода — бизнес остался с репозиторием, который некому и дорого поддерживать
Штатные мобильные модули внутри ERP: Нужны дорогие узкопрофильные спецы по конкретной ERP
Специализированная платформа для ТСД: Наглядная схема из визуальных действий + простой C#-подобный скрипт со встроенными подсказками
Когда в конце разговора мы спросили Саргиса, что бы он пожелал ребятам, которые еще не работали с платформой, он ответил так:
«Не пугайтесь, если с непривычки увидите визуальные действия со стрелочками и незнакомые названия внутренних объектов. Залезьте чуть глубже под капот, поэкспериментируйте со стилями, шаблонами штрихкодов и гибридными таблицами. И вы поймете, что это не просто закрытая "программа-сканер для склада", а универсальный визуальный конструктор, на котором можно собрать почти что угодно и сэкономить кучу времени».
А кто из пикабушников уже сталкивался с автоматизацией складов и магазинов на ТСД? Пилили свои велосипеды под Android/1С или брали готовую платформу? Делитесь своими историями и болями в комментариях!
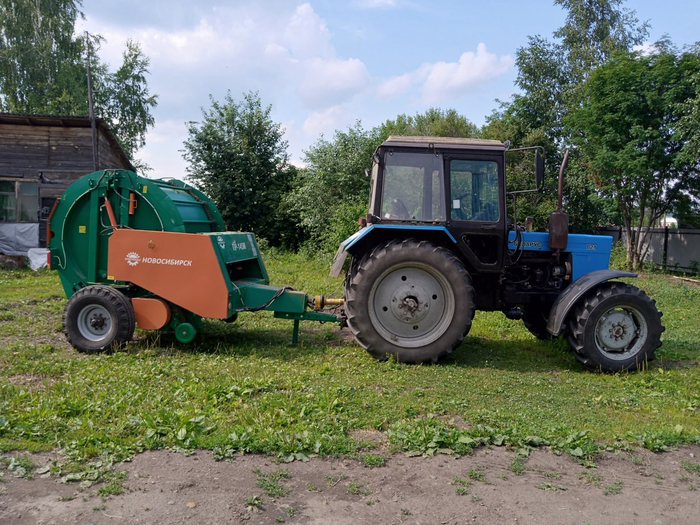
1. Трактор не падает в пятницу вечером.
Если он сломался — это видно сразу. Никто не пишет в чат: «У меня трактор не работает, перезагрузил, но всё равно не едет». И никто не собирает инцидент-митинг в 23:47.
2. У трактора нет легаси.
Нет кода 1998 года, который «работает — не трогай». Нет карбюратора, который оставили «для обратной совместимости». Есть карбюратор — он либо есть, либо его нет.
3. Трактор уважает границы.
Он не пишет тебе ночью: «Слушай, поле не пашется, срочно к утру». Он просто стоит. Или едет. Но без срочных сообщений.
4. Трактор не требует облака.
Он работает в поле, а не в eu-west-1. И если он не работает, то потому что кончилась солярка, а не потому что «упал регион».
5. У трактора нет созвонов.
Никто не собирает дейли на 15 минут, чтобы обсудить, как трактор будет пахать завтра. И никто не спрашивает: «А есть ли у вас тесты?» Трактор просто едет. Если колесо отвалилось — это баг, а не фича.
6. За день у трактора ничего не меняется.
Утром он красный, с колёсами 1.6 м — вечером тот же красный трактор с теми же колёсами. Максимум — грязный.
А в IT за один день может случиться всё: утром синий интерфейс — вечером тёмная тема; колёса были 1.6 м — теперь «вынесены в конфиг и настраиваются через переменные окружения»; был один трактор — стала микросервисная архитектура: отдельно двигатель, отдельно колёса, отдельно сиденье, и всё это общается через очередь.
7. У трактора не меняется внезапно запчасть.
Вчера карбюратор — сегодня карбюратор — завтра, если повезёт, тот же карбюратор. А не так, что «с прошлой недели вместо карбюратора у нас инжектор, но старый карбюратор оставили для обратной совместимости, и он иногда сам включается».
8. У трактора не меняется внезапно дизель на бензин.
Никто не приходит в поле и не говорит: «Мы провели миграцию топлива, теперь трактор ездит на бензине, но старые канистры с дизелем поддерживаются в режиме legacy».
9. У трактора не меняется внезапно руль на рычаги и обратно.
А если и меняется — это капитальный ремонт, и тракторист хотя бы в курсе. А не так, что утром сел за руль, а к обеду: «Мы выпилили руль, теперь управление через рычаги, документация в следующем релизе». Потом вернули руль, а рычаги оставили плагином.
10. В IT ты «синьор», а в тракторе — «тракторист».
И это звучит гордо. Плюс бабушке не надо объяснять, чем ты занимаешься: «Я на тракторе работаю» — и вопросов нет.
Итог: трактор — это API с гарантией обратной совместимости на 30 лет. IT — это «внезапно поменяли дизель на бензин, руль на рычаги, а потом сказали, что так и было». 🚜
P.S. Да - лично работал, рычаги дёргал. Java/Rust тоже за сиськи мял.
Пока SpaceX подает заявку на группировку до миллиона вычислительных спутников, а Google выводит на орбиту прототип Project Suncatcher, руководитель крупнейшего в мире облачного провайдера остудил мечты о небесных серверных. В интервью изданию Sources от 10 ноября глава облачного бизнеса Amazon Мэтт Гарман заявил, что в ближайшие 10–20 лет дата-центры в космосе вряд ли окажутся экономически оправданными или практически реализуемыми.
Ирония в том, что один из главных сторонников этой идеи — сам основатель Amazon Джефф Безос. Осенью 2025 года он прогнозировал, что за пару десятилетий космические серверные обойдут наземные по стоимости благодаря непрерывному солнцу без туч и непогоды, а весной его компания Blue Origin подала заявку на сеть Project Sunrise до 51 600 спутников.
У действующего главы облака Amazon, чей бизнес вышел на годовой темп выручки около $184 млрд, расчет куда приземленнее. По словам Гармана, серверная стойка с ускорителями может весить около тонны, тогда как ракетные пуски дороги и во всем мире происходят реже одного раза в день — на Земле же одна только Amazon сейчас устанавливает по одному GPU каждые 14 секунд.
Даже бесплатный солнечный свет на орбите быстро упирается в инженерную физику. Чтобы запитать гигаваттный кластер, потребуются гигантские поля солнечных панелей, а вокруг аппарата нет воздуха: внутри контура тепло еще можно переносить жидкостью, но сбрасывать его наружу в вакуум приходится излучением через огромные радиаторы.
Сверху добавляются космическая радиация, удорожающая железо, и сложность обслуживания, когда ради замены сгоревшей платы не отправишь в машинный зал дежурного инженера. Гарман считает сами технические задачи решаемыми со временем, но сомневается, что в обозримые десятилетия такая схема сойдется по деньгам.
Когда на фоне протестов жителей против строек у городов ведущий предложил сравнить космос, океан и пустыню, Гарман отверг и плавучие серверные из-за качки и движения оборудования. Фаворитом главы облака Amazon предсказуемо стала обычная земная пустыня, где полно солнца и места, работает привычное жидкостное охлаждение со сбросом тепла в воздух и легко проложить кабель связи.
P.S. Еще больше разборов того, где в мире ИИ заканчивается красивый хайп и начинается реальная инженерия — в моем Telegram-канале "Сбежавшая нейросеть".
Пока Вашингтон годами перекрывает Пекину доступ к передовым ускорителям Nvidia, у самой американской ИИ-гонки обнаружилось неожиданное узкое место в Китае. Как выяснило агентство Reuters, корпорация Microsoft провела серию закрытых встреч с управлением научно-технической политики Белого дома и Советом нацбезопасности США, убеждая администрацию Дональда Трампа отказаться от готовящихся ограничений на китайские оптические трансиверы.
Оптический трансивер — это компактный модуль с ладонь, который переводит электрические сигналы серверов в световые импульсы для оптоволокна и обратно. Без таких переходников разрозненные серверные стойки невозможно связать по оптике в единый скоростной кластер для обучения нейросетей.
По оценке аналитиков Counterpoint Research, китайские производители во главе с Zhongji Innolight и Eoptolink обеспечивают почти две трети мировых поставок таких модулей в штуках. Американские конкуренты Coherent и Lumentum по итогам 2025 года занимали лишь около 17% и 6% выручки рынка готовых модулей и физически не способны за год-два заместить китайские объемы.
У самой Microsoft, по данным Cleanview, в США сейчас строятся 35 дата-центров и запланированы еще 134. На встречах в Белом доме компания убеждала чиновников, что жесткий запрет затормозит американские стройки и в итоге сыграет на руку самому Китаю.
Отраслевая ассоциация ITI, представляющая интересы техногигантов, в обращении к Федеральной комиссии по связи США (FCC) тоже попросила не вносить оптические трансиверы в запретный список. Главный юрисконсульт ассоциации Джон Миллер объяснил Reuters, что без этих модулей уже закупленные дорогие ИИ-чипы "буквально могут просто лежать без дела в ожидании момента, когда их наконец появится чем соединить".
По данным источников агентства и записки Morgan Stanley, сейчас регулятор обсуждает ограничения прежде всего на новое поколение китайских трансиверов со скоростью 3,2 Тбит/с — наращивание их выпуска ожидается в 2028 году, а массовое внедрение в 2029-м. Сама Microsoft от официальных комментариев отказалась, а посольство КНР осудило давление на китайские компании под предлогом национальной безопасности.
В Конгрессе доводы корпорации встретили в штыки: комитет Палаты представителей по Китаю призвал FCC продолжить работу над ограничениями. Законодатели отдельно назвали лидера рынка Zhongji Innolight, внесенную в список Пентагона, заявив, что компания, которую американские военные связывают с оборонным сектором КНР, "не должна прокладывать связи внутри американских дата-центров".
P.S. О том, как устроена изнанка мировой гонки ИИ и как применять современные нейросети в работе без лишнего шума, пишу в своем Telegram-канале "Сбежавшая нейросеть".