
Главное, реклама работает
Раздел Моя страница после удара по питерскому ЦОД-у Вконтакте/подстанции, питавшей ЦОД.
Раздел Моя страница после удара по питерскому ЦОД-у Вконтакте/подстанции, питавшей ЦОД.
По следам первого поста серии- продолжаю, как и обещал, постом про железо.
Сразу обмолвлюсь о том, что и так написал в первом посте серии- сейчас накопители стоят ОЧЕНЬ ДОРОГО, поэтому цельная система, если у вас нет особых условий (а это или наличие железа вида "по полкам валяется", или же если сервисы, которые вас интересуют- на зависят сильно от накопителей. ) - тоже будет дорогой.
Плюс целиком покрыть огромный рынок БУ, даже тематического- просто нереально, поэтому тут я не буду рассматривать совсем "гиковские" варианты типа "Зион с Алиэкспресс". Это не делает эти конфигурации плохими, просто иначе пост выйдет километровым.
В целом системы для селф-хоста можно разделить на следующие категории:
1) "Особые" случаи- как правило это SBC (Single Board Computer, одноплатный компьютер) вроде различного рода * Pi (Raspberry Pi, она же "Малинка" , Banana\Orange\.... Pi), или же немного изврата с адаптацией железа с других платформ под нужды селф-хоста. В первом посте я описал, что минимальной планкой для селф-хоста сейчас ставлю 6 т.р. + накопители, и описал, что за эти деньги можно ожидать ТВ-бокса китайских небольших компаний, прошиваемого на Линукс. И я все ещё считаю, что для ультра-бюджетного "Вкатывания" в селф-хост это один из лучших вариантов. Почему? Об чуть позже.
2) Неттопы\Мини-ПК\ноутбуки. Всё это -вполне подходящие варианты, хоть и с рядом условностей. Они, как правило, сильно дороже (если речь идёт о хотя бы отдалённо свежем железе) , но при этом это компактное решение, которое потянет бОльшую часть вычислительной нагрузки вне ИИ-среды.
3) Полноценные ПК , самосбор. Вариант более чем рабочий, но с рядом ощутимых оговорок.
4) NAS (Network Access Storage) или ему подобные "Коробочные" решения. Плюс - как правило- работает из коробки, и часто обладает функциями, которые в других вариантах категорий 1-2 из коробки не найти- RAID\зеркалированием, например. Минус- обычно дороже , часто- вендор-лок, и доступный софт может , в зависимости от платформы, быть ограничен.
Это -основные категории. Они могут спокойно пересекаться от модели к модели по производительности, по стоимости, по фичам. Категория в данном случае определяет скорее форм-фактор устройства.
Далее я рассмотрю основные, на мой взгляд, варианты в каждой категории, распишу примерные ценники , плюсы и минусы.
Вариант А:
ТВ-бокс на Android, прошитый на Linux.
В чём преимущество?
Всё просто:
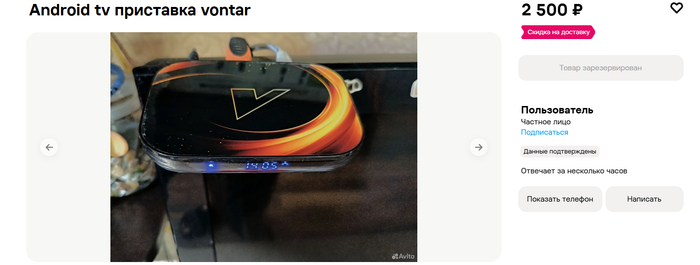
Обычно ценник на них чуть выше (3.5-5 т.р.) , но это всё ещё хорошее предложение.
Плюсы- за эти деньги получается полностью готовая к подключению накопителя коробочка, которая сразу обладает и WiFi\BT, и аппаратным декодированием H264\H265, и гигабитным LAN-портом, ест ~10 ватт , при желании помещается в карман, и может работать полностью пассивно, без шума вентиляторов.
При этом на борт ставится вполне полноценный Linux (обычно Armbian) ,и такой бокс запросто держит десяток не самых требовательных приложений.
Минусы- нужно очень тщательно выбирать модель (уровень поддержки может разниться от "Всё сразу заработало" до "Ни вайфая, ни сетевой, только консоль в зелёной гамме"), ограничен выбор дистрибутивов Linux (базово обычно Armbian, изредка встречаются Arch-based сборки типа той же Manjaro. Процесс запуска Linux может быть не самым очевидным, а установка "полноценно" в память самого бокса- хлопотной.
Производительность таких ТВ-боксов находится где-то на уровне флагманских телефонов начала десятых годов, или даже ниже. Казалось бы- этого очень, ОЧЕНЬ мало, но на практике- этого достаточно в разумных пределах . Тяжелые сетапы вроде Nextcloud+ Immich+ Homeassistant + Jellyfin такая коробочка не потянет ,но по одному-два эти сервисы вполне можно использовать. Или же пяток-десяток сервисов , не сильно требовательных к железу.
В целом- это вполне рабочий вариант, если селф-хост пробовать впервые. Если даже "не зайдёт" - коробок прошивается на Android и служит просто ТВ-приставкой, или же прошивается в ретроигровую консоль, или... Не шумит, много не ест, в зависимости от модели и поддержки- может требовать изредка перезагрузки.
Общий минус что категории приставок, что мини-ПК - это отсутствие возможности зеркалирования дисков или создания RAID-массивов нативно.
Вариант Б:
Неттоп\Мини-ПК.
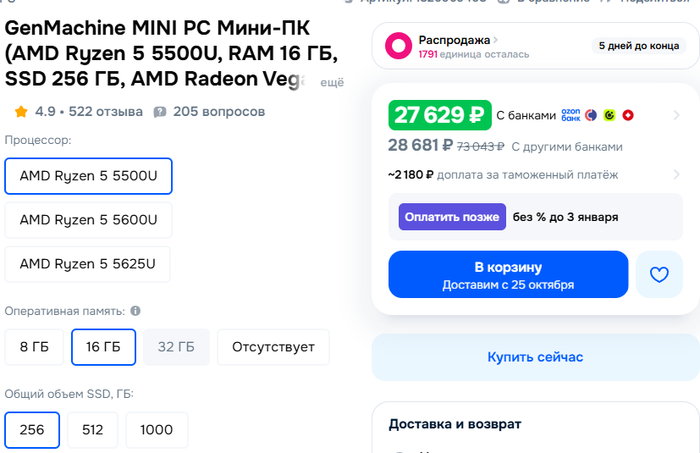
Это решение уже классом выше . Даже условный Intel N150 даст в конечном итоге сильно бОльше свободы в плане запуска сервисов, а Ryzen 3000\5000\6000\7000 -вообще может потянуть даже простенькую ИИ-нагрузку.
Ценник, разумеется, тоже улетает вверх, но тут по-разному. Новый фирменный мини-ПК может варьироваться от ~15 т.р. за сетап на условном N150\Ryzen 3***U и с 8 ГБ оперативной памяти, постепенно повышаясь до ~ 25-30 т.р. за сетапы на Ryzen 5500u и ближайших к нему (в сборке с накопителем и оперативной памятью), и уходя дальше- к сборкам на Ryzen 255, и совсем навороченным машинам на Ryzen 3** AI\HX за 200+ тысяч рублей. Для домашней серверной нагрузки это избыточно, за исключением локальных нейросетей.
Плюсы:
Всё ещё легче, меньше, тише , чем полноценный сборный ПК. В отличии от тв-боксов- уже довольно легко апгрейдится (не всегда, есть модели с распаянной памятью, особенно в области "инженерных" чипов). Сетапы на N100\N150\N200 могут работать пассивно (за счёт массивного корпуса, выступающего радиатором), Райзены - как правило с ноутбучной "Турбиной" . Это уже не полная тишина, но в комнате с таким всё ещё можно спокойно спать.
Зато это полноценный X86\64 , т.е. выбирать дистрибутивы можно спокойно, вплоть до "специфичных", мощности уже хватит для полноценной нагрузки полным набором софта вне ИИ-среды, плюс N*** у Интела обладают отличным встроенным декодером\энкодером видео , а Ryzen - кодируют видео на iGPU (VAAPI).
Практически всегда- опять же "Batteries Included", т.е. на борту уже будет Wi-Fi\BT приёмник, но портов USB сильно больше, могут быть дополнительные фичи.
Минусы- ценник взлетает быстро, тишина, опять же, уже не полная (модели с "турбиной" могут основательно реветь во время активной нагрузки), у некоторых моделей всё ещё присутствуют костыли в плане совместимости драйверов с Linux (в основном Wi-Fi\BT модулей или Ethernet-адаптеров). Всё ещё в большинстве случаев нет поддержки RAID.
В целом- модели нижнего и среднего ценового- вполне пользуются популярностью в виде "домашних серверов", хотя и не без конкуренции со стороны БУ -рынка.
Вариант В: SOC, также известный как одноплатник.
По сути- это решение где-то между ТВ-боксом и мини-ПК. Как правило- в основе всё ещё ARM-чипы, от всё того же S905X* до RK3588 и выше. В эту категорию попадают различные * Pi (Raspberry Pi\Banana Pi\ Orange Pi \ Rock * и т.д. ). В отличии от ТВ-боксов- у таких плат, как правило, есть полноценные выходы GPIO, SATA\NVME M2, иногда - несколько Ethernet разъемов и готовые сборки Linux под конкретную плату.
Плюсы- всё ещё тихо, холодно , но гораздо производительнее.
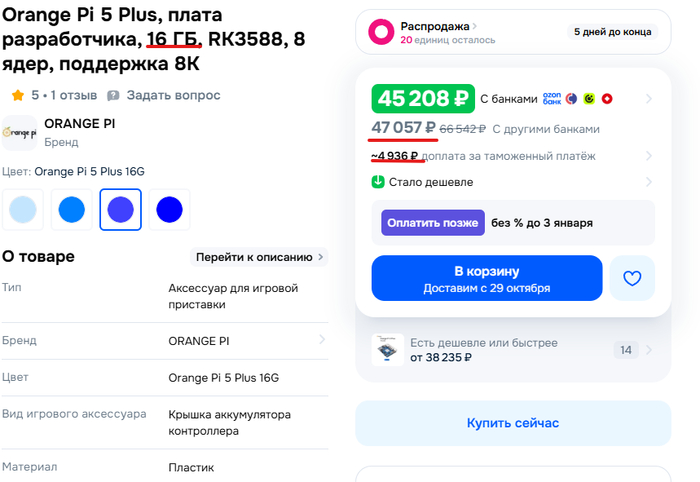
Минусы- дорого (ДОРОГО) относительно прямой производительности, нуждается в докупке "аксессуаров" (корпуса, БП , "шапки" , т.е. платы расширения, адаптеры Wi-Fi и BT для большинства моделей (на скриншоте выше- чисто плата. Вообще без "обвеса". За него можно смело добавлять 10-15 тысяч к стоимости.). Увы , но этот вариант из селф-хоста всё чаще выпадает, просто потому, что полноценный "сервер" на RK3588 выходит в сумму, сравнимую с полноценным мини-ПК , при этом разница в производительности будет колоссальной. GPIO- однозначно полезны, но реально нужны только совсем небольшому кругу энтузиастов, в сфере селф-хоста- редко. По сфере SOC\SBC кризис памяти ударил больнее всего, фактически сегмент убит.
Вариант Г: Самосбор на основе полноценного ПК.
То, что обычно представляют при словах "Домашний сервер" .
Тут всё просто- берём обычный компьютер, ставим "серверную" ОС. Места под жесткие диски- уйма. Запас по питанию- огромный (если БП позволяет) . Процессор\ОЗУ\ГП - можно варьировать как угодно.
Плюсы- модульность полноценная, апгрейд- прост как три копейки. Любой необходимый набор интерфейсов . Полноценный RAID при наличии достаточного количества дисков .
Минусы- попытки сэкономить где только можно рискуют породить монстра. Сосуществование с огромным гудящим 24\7 гробом в одной комнате может быть довольно неприятным. А собрать такой ПК маленьким, тихим и сбалансированным- может быть или дорого, или довольно нетривиально. В "народной" нынче платформе AM4 материнских плат формата Mini-ITX не слишком много, корпус- ещё можно найти, но в целом- это относительно хлопотно. Плюс основной нюанс селф-хоста - "сам управляешь- сам несёшь ответственность" тут работает в два конца- самостоятельно собранный ПК - это принятие ответственности за сборку.
Разумеется, что сборка навроде AM5 Ryzen 7***X + 32 GB DDR5 + какой бы то ни было GPU, на в Mini-ITX корпусе объемом в несколько литров, да с тихоньким кулером- это прямо мечта от мира домашних серверов. Но :а) ДОРОГО. б) Сборка такого ПК уже требует опыта от сборщика, т.к. часто там процесс сборки отличается от "обычного" , в) имеет смысл только в случае полноценных станций для локального ИИ- для всего остального это слишком большая вычислительная мощь, ещё и выливающаяся в неплохой жор электроэнергии.
Вариант Д: БУ-рынок ПК\неттопов, Авито, списанный энтерпрайз.
Это рынок, уже требующий определенного опыта. На площадках типа Реддита, обычно, когда заходит речь об "оптимальном" железе - часто звучит что-то наподобие "ThinkCentre с Ebay за 100-200$" ,и в зависимости от обстоятельств- это вполне может быть актуальным выбором. Часто за те же деньги, которые обойдётся мини-пк с маркетплейсов , можно взять БУ ноутбук на той же платформе,или даже мощнее. Нужно ли- вопрос, но возможно.
Но стоит понимать, что Авито- это в принципе мир в себе.
Поэтому покрыть рынок БУ ПК одним постом- в принципе, на мой взгляд, практически нереально.
Вариант Е: NAS.
Тут всё просто- это решение, которое работает "Из коробки". Оно уже рассчитано на какое-то количество дисков, как правило- поддерживает NAS, обладает операционной системой, специально заточенной на селф-хост с поддержкой каких-то базовых сервисов.
Аппаратно они делятся на два крупных вида:
X86-64 . Тут всё просто -это, по сути, просто неттоп\мини-пк, к которому производитель сразу приделал RAID-контроллер и распланировал корпус под N дисков. Обычно это оборачивается ощутимым повышением ценника, что может вывести аналог неттопа за 20 т.р. в ценовой диапазон ближе к 40-50.
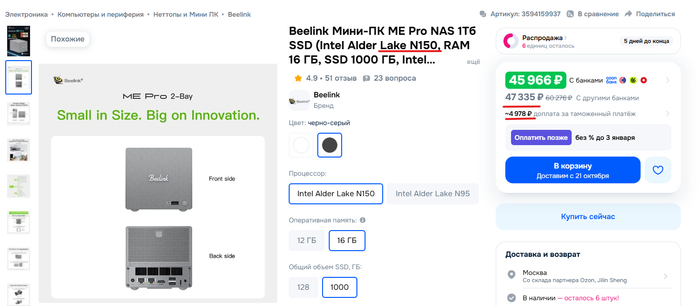
Мини-ПК на аналогичной платформе может стоить практически вдвое дешевле.
ARM- как правило, остро заточены под задуманный производителем сет программ. Может варьироваться от "Просто диск с доступом по сети через приложение" до полноценной поддержки Docker и настроенного производителем "магазина приложений". Стоит понимать, что подобные штуки, хоть и хорошо выглядят "из коробки" -могут быть проблемными в тонкой настройке .
Важно- всё больше NAS отказывается от поддержки 2.5\3.5 HDD, переходя на NVME-only хранилище. Перед покупкой обязательно стоит проверить поддерживаемые конфигурации дисков.
По сути- по мощности, по функционалу и по ценнику, эти категории могут легко пересекаться, а могут и прямо находиться на разных углах. Те же NAS часто могут обладать железом даже слабее, чем дешёвый TV-бокс, но закрывать основную его слабость- отсутствие гибкости в подключении и выборе накопителей.
Но в целом- это основные категории, в которых имеет смысл смотреть. Это недёшево, но тут остаётся только пожать плечами. Именно подорожание комплектующих, по сути, сейчас вышибает селф-хост в "нишевое" хобби.
Мини-ПК, служащий мне сейчас "сервером" , взятый когда-то за ~ 20 т.р. - сейчас даже на БУ-рынке приближается к 25-30 в стоимости . Жесткий диск, взятый года полтора -два назад за 7 т.р., сейчас в том же магазине приближается к 25 т.р. . И т.д.
В целом, несмотря на то, что я начал эту серию постов- я не могу однозначно порекомендовать сейчас влезать в селф-хост. Повторю вывод из первого поста- хорошо, если у вас есть "ненужное" железо или накопители. В противном случае- слишком дорого.
Итоговая лестница производительности:
TV-Box (S905X*) => ARM NAS => High-Tier SBC (одноплатник на 3588 или Amlogic S92*) => N150\ Ryzen 3*** => Ryzen 5***\6***\7*** => Десктопный Intel\Ryzen свежих поколений => Флагманские "мобильные" чипы => флагманские десктопные сборки.
X86-64 NAS просто ложатся в категорию по чипу, а не в отдельный слот.
В следующем посте я рассмотрю "сопутствующие траты" и подобные моменты (Роутер , и его роль в "домашнем сервере" , различного рода "адаптеры" для нестандартных протоколов, ИБП, и т.д.), а затем- перейду уже к чисто программной части - ОС (их целая россыпь!) , основным механизмам (Натив\VM\Контейнеры, доменные имена -DNS-DDNS, реверс-прокси, порт-форвардинг и т.д.) , и затем уже - полноценно побежим по софту, от крупных платформ (Jellyfin\HomeAssistant\Nextcloud\*arr) к более тематическим программам.
Недавние масштабные сбои у крупных почтовых провайдеров в очередной раз напомнили старую ИТ-мудрость: «Облако — это просто чей-то чужой компьютер». Когда внешний сервис ложится отдохнуть, работа встает у всего офиса. Договоры не отправляются, клиенты ждут, бухгалтерия паникует, а руководство смотрит на сисадмина так, будто это он лично перегрыз кабель.
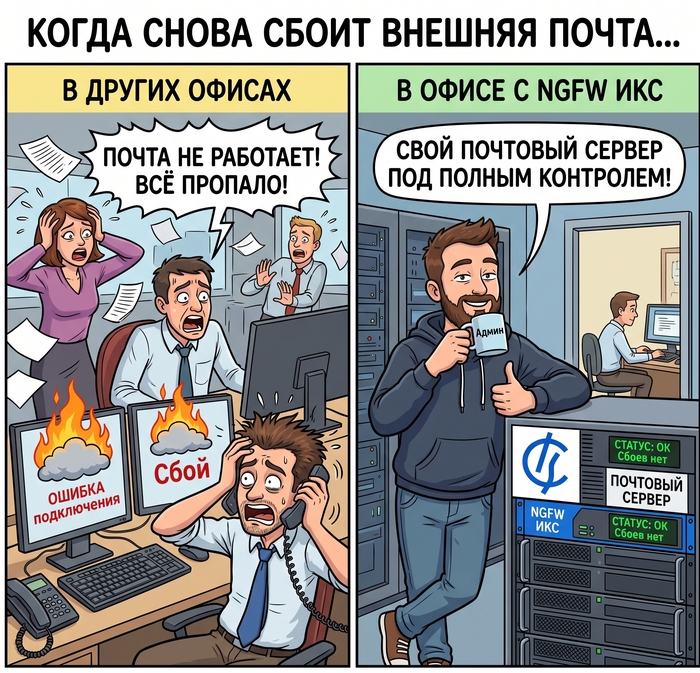
Своя почта внутри периметра организации — это гарантия того, что ваши данные и переписки зависят только от вас. И чтобы не собирать почтовик на коленке, настраивая конфиги ночами, хотим напомнить про наш продукт.
В составе интернет-шлюза NGFW ИКС уже есть полноценный встроенный Почтовый сервер. Разворачивается внутри вашей инфраструктуры и остается под вашим полным контролем.
Что под капотом (и почему за него не стыдно):
Полный контроль над ящиками: есть мастер-аккаунт для доступа ко всей почте, делегирование прав и удобные общие адресные книги.
Порядок с местом на дисках: можно смотреть общий объем почты по всему домену (удобно для оценки), настраивать квоты (с уведомлениями отправителю, если ящик забит) и автоматически удалять старые письма по дате.
Безопасность: передача писем идет строго по зашифрованному каналу, а для исходящих сообщений настроена проверка и автоматическое добавление DKIM-подписи (чтобы ваши письма не улетали в спам у партнеров).
Удобная миграция: есть встроенный сборщик почты.
Поле «Описание»: мелочь, а приятно — доступно для всех доменов и конкретных ящиков, чтобы не путаться, кто есть кто.
Отдельная история — защита от спама Мы понимаем, как раздражают письма с предложениями «увеличить продажи» и фишинговые рассылки. Поэтому вкрутили многоуровневую систему очистки:
Движки на выбор: Kaspersky Anti-Spam, проверенный SpamAssassin и быстрый Rspamd.
Поддержка серых списков (GreyListing) — отлично отсекает примитивных спам-ботов.
Черные списки DNSBL.
Ручная настройка блэк- и вайт-листов по email, IP-адресам и даже отдельным фразам.
Вместо заключения
Мы знаем, что любой нормальный админ не поверит красивым текстам, пока не пощупает всё сам. Поэтому ИКС не нужно покупать вслепую. Вы можете развернуть его в своей инфраструктуре и полноценно протестировать.
Если тема актуальна и хочется спать спокойно, не завися от настроения крупных ИТ-гигантов — заходите на наш сайт, оставляйте заявку на тест и возвращайте контроль над почтой в свои руки.
Всем привет. Словами многих блогеров, которым сейчас уже практически не верят- "Я очень не хотел делать этот пост". Это , отчасти, правда. Но в свете последних событий с ЦОДами Яндекса- несколько клиентов пришли с благодарностью, заодно дав понять, что тема селф-хоста, несмотря на ценовой скачок железа, всё ещё остаётся актуальной, хоть и стала более нишевой.
Поэтому я решил начать на Пикабу серию постов, посвященных тематике селф-хоста. Начиная от "Меты" , т.е. общих понятий, принципов, и механизмов, заканчивая обзорами на крупные или малоизвестные софтины в этом направлении. Серия будет длинной, т.к. вопрос очень, ОЧЕНЬ объёмный- я надеюсь хотя бы раз-два в неделю расписывать короткие обзоры на софт, но ничего, увы, обещать не могу. Первое время постов будет много, т.к. я буду излагать основы, затем- как пойдёт. От плюсов-минусов моё желание расписывать свой опыт зависит мало, поэтому даже если уйду в отрицательный рейтинг- да и шут с ним.
Этот пост будет довольно рваным, т.к. какой-то единой темы и идеи у него нет, просто формирую общую идею будущей серии.
На данный момент я занимаюсь настройкой "homelab" под ключ. Не скажу, что услуга пользуется огромным спросом, но он есть. Сразу обмолвлюсь- во избежание обвинений в предвзятости- на Пикабу, и в других источниках, если я буду их заводить- я НЕ буду оставлять никаких данных о контактах и рекламу собственных услуг. Для меня это принципиально. Я здесь не для рекламы, а для того, чтобы, возможно, подарить хобби хотя бы небольшому количеству людей. Хобби, которое в данный момент стало нишевым, но всё ещё позволяет относительно бюджетно стартовать, и приносит плюшки то тут, то там в повседневной жизни.
ВАЖНО: я НЕ сторонник "отказа от корпораций". Селф-хост в моих глазах- это не про "ОНИ НЕ ПОХИТЯТ МОИ ДАННЫЕ" , и не про корпорации добра, зла, и прочие. Я просто хочу получить систему, которую смогу подстраивать под себя более гибко, чем имеющиеся сервисы- аналоги, и которая будет закрывать мои потребности, которые не закрывают имеющиеся на рынке сервисы. Это не акт борьбы, революции против бигтеха, это просто "своё хочу".
Итак, начинаем.
Селф-хост (Self-host) - это процесс, при котором человек (или группа людей) необходимые им сервисы заводит на собственных вычислительных мощностях. В принципе- это всё определение, да. Что это будут за мощности- дело запускающего. Они могут быть в том числе арендованы "В облаке", но обычно всё сводится в том или ином виде к концепции "домашнего сервера" - какой-то железяки, которая лежит дома, 24\7 подключённая к питанию и Интернету, и на которой запущен некоторый набор программ.
В последние ~10 лет селф-хост стал набирать популярность. Практически все нынешние крупные проекты в этом направлении появились где-то в начале-середине десятых годов, а сейчас имеют крупные сформировавшиеся сообщества.
Причина, по которой это произошло за границей- в основном сводится к паре столпов:
а) Ужесточение анти-пиратского законодательства. Блокировки пиратских CDN и изъятие серверов, "подсадные" юристы в P2P сетях, из-за которых скачивание торрента в какой-нибудь Германии запросто оборачивается многотысячным штрафом.
б) Постепенное увеличение подписочной нагрузки. Западное общество, особенно в США- довольно сильно закредитовано. Подписки на контент в этом случае ложатся примерно в ту же корзину, что и платежи по кредиткам- это "текущая нагрузка". Когда практически единственным сервисом был Нетфликс- это работало даже на уменьшение пиратства как такового- геморрой с поиском контента не стоит пары баксов за "расшаренную" подписку. Но с тех пор контент распочковался по десятку-двум платформ, каждая- с эксклюзивами, каждая с отдельной оплатой, и при этом - ещё и дорожающей.
в) Общее отторжение принимаемых в пределах технологического сектора решений. Постепенно идея того, что хранимые на серверах корпораций данные- не твои, они могут быть не просто отобраны у тебя, но и использованы тебе во вред. Через что-то подобное средний пользователь прошёл ещё в нулевых на взлетё условных фейсбуков и ВКонтакте- тогда на волне восторга от концепции там могли спокойно оставить номер телефона на всеобщее обозрение, а то и вовсе фото, которые не предполагали кому-то показывать. Постепенно рядовой пользователь приучился разделять свои данные на "свои" и "публичные" . Сейчас подобное происходит несколько глобальнее. Инициативы типа Stop Killing Games в том числе поднимают и этот вопрос, т.к. предмет обсуждения хоть и отличается, но лежит в одной плоскости.
В случае с РФ добавляется ещё пара моментов, ставших актуальными за последние года:
а) Массовый отзыв лицензий на контент с отечественных стримингов , плюс борьба зарубежных сервисов с пользователями под VPN, и разворот в сторону геоблока в целом.
б) Общее нагнетание атмосферы "интернет не нужОн" - постоянные разговоры о белых списках, платном международном трафике, и т.д.
в) Прилёты по ЦОДам открывают новый слой во всей этой ситуации, да.
Ну и остаётся то самое "убеждение". "Всё своё ношу с собой" и прочая идеология.
Ровно в том же, что и за рубежом- твой контент остаётся с тобой. Твои фото- твои, доступны тебе в любое время, не будут удалены из-за того, что нейросеть при заливе обнаружила там что-то нехорошее, не будут принудительно сжаты для сокращения издержек, тебя не будут шантажировать тем, что если ты перестанешь платить на месяц-два - фото просто удалят.
Плюс номер два- селф-хост системы могут быть гораздо более гибкими, чем их "сервисные" аналоги. Возможно и обратное, да. Но из того же Nextcloud можно собрать не просто облако, а "твоё" облако- с нужным тебе функционалом, вмещающее не только файлы и документы, но и штуки, которые интересны именно тебе- книгу рецептов, журнал КБЖУ, или хранилище моделей для 3D-печати с предпросмотром.
Плюс номер три- прямой доступ из локальной сети в отсутствие связи. Если провайдер уронил доступ к интернету , но ты сидишь дома, и сервер у тебя под кроватью- данные доступны. Это не без нюансов (при схеме "провайдер уронил интернет" - не будет доступа извне, или же нужен резервный канал), но это остаётся верным в большинстве ситуаций. Исключение- белые списки. Но БС это в принципе штука, которая практически любую логику связи ломает напрочь.
Основных минусов на данный момент четыре. И два из них взаимосвязаны.
Первый- довольно большие затраты в момент старта. В будущих постах я распишу совершенно разные сетапы и по стоимости, и по мощности. Но факт остаётся фактом- если у вас нет железа на руках , то это немаленький чек на старте. Перебивает ли это подписки- вопрос, на который каждый отвечает себе сам.
Второй - сейчас ОЧЕНЬ, ОЧЕНЬ плохая ситуация с ценами на накопители. Если у вас есть , условно, "завалявшийся" жесткий диск или SSD- это очень круто. Но ценник на классические HDD улетел в космос. Модель, которую я года полтора назад брал за 7 т.р. (4ТБ HDD) , сейчас еле-еле можно найти за 25. Терабайтный HDD фактически ушёл по стоимости выше, чем терабайтный SSD из бюджеток. Это ОЧЕНЬ ДОРОГО. И увы, но пока не начнёт сдуваться (именно сдуваться) ИИ-пузырь - улучшения вряд ли будут. Будет дороже. Будет сложнее.
Третий- данные твои. Ответственность за них- тоже твоя . Умер диск, и данные не зеркалировались- попрощайся с ними. По незананию сделал rm -rf /? Попрощайся с ними. Ты решил переустановить систему, а потом понял, что сервис шифрует данные ,а ключ ты не сохранил? Исход понятен. И так далее. Нет волшебного Яндекса, который хотя бы попытается восстановить твои данные, если у них откажет ЦОД (пока отказов не станет слишком много). Ответственность целиком на тебе. Это ВАЖНО, и именно это ломает розовые очки большинству селф-хостеров в момент первой поломки. Ломает с хрустом, после чего, как правило, многие просто уходят из селф-хоста и больше не оглядываются.
Тут чисто моё мнение, т.к. объективно- вопрос сложный.
Селф-хост имеет смысл, если:
1) У вас есть "ненужное" железо. Сейчас, повторюсь, селф-хост это ДОРОГО.
Старый ПК, который вы уже пообновляли. Жесткие диски, которые лежат ещё с прошлых железяк типа ноутбуков. В таком сетапе можно как минимум начать вообще без боли. Понравится- окей. Не понравится - железяки просто вернутся на полку.
2) У вас есть не самые большие деньги и накопитель, но вопрос интересен и попробовать хочется.
Для себя минимальную планку я установил примерно в 6 т.р. и терабайтный накопитель сверху. О железе как таковом будет следующий пост, где я распишу разные ценовые категории серверов и то, что на них получится\не получится запустить. Но если не брать откровенно рандомные ПК с Авито- то 6 т.р. это минимальная планка, представляют которую , внезапно, даже не ПК, а прошиваемые на Linux ТВ-боксы на китайских платформах. Vontar X3 я испытывал в течении сервера примерно год-полтора, и хотя не без проблем- но с ним вполне можно окунуться в эту среду. К тому же в случае чего такие штуки довольно просто прошиваются обратно на исходную, и остаются рабочим ТВ-боксом.
3) У вас есть деньги, и хочется хобби.
Тут всё просто - селф-хост это буквально цифровая версия ,условно, жигулей в гараже. На доведение селф-хост сетапа под себя можно запросто убить год-два веселых посиделок по вечерам, и при этом какую-то отдачу в быту ты будешь от этого чувствовать. Это весело. Ну и навыки в ИТ понемногу, но качает.
4) У вас есть интерес к "умному дому", или ваши потребности в плане сервисов лежат НЕ в плоскости ИИ и киношко-музыкальной мультимедии.
Селф-хост - не обязательно про огромные количества данных. Умный дом- вполне себе вариант селф-хоста, и при этом наличие домашнего сервера сильно расширяет возможности и свободу выбора в плане железяк умного дома.
Кроме кино,музыки и фото, которые занимают на накопителях подавляющее большинство места -есть ещё десятки программ и проектов, которые не сильно требовательны к накопителям, но успешно интегрируются в повседневную жизнь. И хотя в основном, говоря про селф-хост, вспоминают именно Plex\Jellyfin и *arr -ими всё далеко не ограничивается.
Смысла лезть в селф-хост НЕТ, если :
1) Вас полностью устраивает текущее состояние подписок и прочего, за которые вы платите, а риски, связанные с недавними событиями или блокировками- вы считаете приемлемыми.
2) У вас очень небольшой бюджет, и нет свободных накопителей. Слишком дорого сейчас. Увы. Плюс сервер под кроватью- это хоть и не самые большие, но затраты на розетку.
3) Вы не готовы к тому, что софт будет время от времени отказывать, сервер надо иногда перезагружать , обновлять и в принципе периодически уделять ему время.
4) Вы предпочитаете "под ключ" решения, даже если они дороже или менее функциональны. Это нормально.
Более детально определить, привлекает ли вас идея селф-хоста, можно будет по ходу серии постов.
В принципе- на этом первый пост, наверно, и закончу. Следующий пост в ближайшие пару дней будет по "железу" - распишу основные конфигурации от ультра-бюджетных до ультра-дорогих, рассмотрю "коробочные" решения и их плюсы и минусы, распишу не-серверные затраты на селф-хост. Постараюсь уделить больше времени оформлению поста, иллюстрациям и прочему.
Комментарии буду по возможности читать, на вопросы охотно отвечу. Сразу замечу- я попытаюсь излагать вещи так, чтобы они были понятны, условно, человеку "не в теме". Это может приводить к тому, что достаточно сложные вопросы я буду упрощать до более примитивных , а это, как правило, порождает неточности.
После атак на дата-центры Яндекса начались разговоры о том, что ещё немного и Рунет закончится. Когда одновременно не вызывается такси, не проходит оплата и не открывается рабочая почта, поверить в это довольно легко. Особенно если рядом уже объясняют, сколько серверов осталось до цифрового средневековья.
Я решил разобраться, что действительно произошло, сколько у Яндекса дата-центров и почему наличие резервных копий не спасает от всех неприятностей. Получилась история серьёзнее, чем «ничего страшного, сейчас перезагрузят», но оснований объявлять скорые похороны всего рунета я тоже не нашёл.
Начнём с того, что подтверждено. В ночь с 7 на 8 октября был повреждён дата-центр в Сасово, его работу полностью остановили. 9 октября пострадала площадка в Калуге, где вышла из строя часть инфраструктуры. 11 октября Яндекс сообщил об остановке дата-центра во Владимире после новой атаки. По сообщениям компании, сотрудники этих площадок не пострадали.
Здесь уже есть существенная поправка к пересказам: три атакованные площадки не означают три полностью уничтоженных дата-центра. Работа может остановиться из-за повреждения электроснабжения, охлаждения или связи, даже если часть серверов сохранилась. И наоборот, внешне целое здание ещё ничего не говорит о работоспособности оборудования внутри. Полной публичной картины повреждений пока нет.
При этом последствия вполне реальные. Yandex Cloud, облачная платформа компании, прямо назвала режим работы аварийным и рекомендовала клиентам задействовать альтернативные площадки для восстановления. В опубликованных 13 октября рекомендациях компания всё ещё не называла сроки полного восстановления сервисов. Так что рассказывать, будто всё происходящее существует только в панических заголовках, тоже было бы странно.
Почему проблемы одной компании ощущаются как проблемы всего интернета? Потому что Яндекс давно обслуживает гораздо больше, чем собственный поиск.
Дата-центр представляет собой комплекс с серверами, системами хранения, электропитанием, охлаждением и связью. На этих серверах работают программы, которые принимают ваши заказы, показывают документы, рассчитывают маршруты и проводят другие операции. Часть оборудования Яндекс использует для своих сервисов, а часть предоставляет другим компаниям через Yandex Cloud. Бизнес арендует вычислительные ресурсы вместо того, чтобы покупать и обслуживать собственные серверы.
По итогам первого полугодия 2026 года у Yandex Cloud было около 64 тысяч клиентов. Это не значит, что все они одновременно перестали работать. Но масштаб зависимости становится понятнее: проблемы облака могут затронуть множество компаний, на вывесках которых вообще нет слова «Яндекс».
Допустим, интернет-магазин хранит в таком облаке базу заказов. Его главная страница может открываться, фотографии товаров могут загружаться, а оформить покупку уже не получится. У другого сервиса работает всё, кроме входа через стороннюю систему авторизации. Третий не может обратиться к нужному хранилищу. Пользователь видит несколько сломавшихся приложений подряд и вполне естественно говорит: «Что-то интернет сегодня не работает».
Технически связь при этом может сохраняться. Провайдер продолжает передавать данные, другие сайты доступны, сообщения доходят. Но человеку, который не может получить заказ или воспользоваться рабочим сервисом, от этого разграничения не сильно легче.
А сколько у Яндекса вообще дата-центров? Здесь даже с подсчётом есть нюанс. В новостях часто встречается цифра пять. Она действительно фигурирует в публичных описаниях инфраструктуры компании. Однако в марте 2026 года Яндекс объявил о вводе новой зоны доступности на базе ещё одного полноценного дата-центра. Если учитывать этот комплекс отдельно от прежних пяти, по опубликованным сообщениям получается шесть.
При этом количество дата-центров всей компании и количество зон её облачной платформы считать одним и тем же нельзя. Зона доступности описывает отдельную часть облачной инфраструктуры, в которой клиент размещает свои ресурсы. Это не универсальная единица измерения всего хозяйства Яндекса.
Но даже точная цифра не позволит посчитать ущерб простым делением. Шесть дата-центров не обязательно дают шесть одинаковых долей мощности. У площадок могут различаться размер, оборудование, фактическая загрузка и задачи. Потерять половину зданий не обязательно означает потерять половину вычислений. А сохранение половины вычислений ещё не гарантирует, что на них можно немедленно запустить всё остальное.
Удобная арифметика «три из пяти, значит, осталось 40% Яндекса» заканчивается примерно там, где начинается устройство настоящей системы.
Но ведь у них должны быть резервы. Почему тогда вообще что-то падает? Резервирование всегда рассчитывают на определённые неисправности. Сервер может пережить отказ диска, приложение может пережить отказ сервера, а распределённая система может пережить недоступность целой площадки. Это разные уровни защиты.
Яндекс публично рассказывал о принципе «минус один дата-центр»: собственные сервисы распределяют так, чтобы они сохраняли работоспособность при потере одной площадки. Для проверки проводят учения с отключением дата-центров от внешнего мира. Но способность пережить одну такую аварию не означает возможность без последствий пережить несколько подряд.
Вот условный пример, который не описывает реальные мощности Яндекса. Есть три одинаковые площадки, каждая загружена на 60%. Одна отключилась, её работу поровну распределили между двумя оставшимися. Теперь они загружены примерно на 90%. Система продолжает работать, но свободного места почти не осталось. Если до восстановления первой площадки отключается ещё одна, последней достаётся нагрузка на 180% её возможностей. Отправить её туда технически можно. Убедить оборудование обработать её целиком уже сложнее.
Именно поэтому после первого сбоя система может выглядеть почти здоровой, хотя запас прочности уже потрачен. Следующая авария происходит в гораздо менее благоприятных условиях.
Есть ещё одна тонкость. Некоторые распределённые базы данных должны согласовывать изменения между несколькими копиями. Если доступных участников становится недостаточно, система может остановить запись, чтобы не получить противоречивые данные. Поэтому ситуация «информация сохранилась, но пользоваться сервисом полностью нельзя» вполне возможна.
Например, увидеть остаток на счёте и безопасно провести новую операцию для программы представляют собой разные задачи. Наличие читаемой копии ещё не решает вторую.
А резервная копия почему не помогает всё быстро включить? Она помогает восстановиться, но сама по себе работающим сервисом не является.
Полезно различать три вещи. Реплика хранит актуальную копию данных и получает изменения по мере работы системы. Бэкап сохраняет состояние на определённый момент, к которому можно вернуться после повреждения или удаления информации. А запас вычислительной мощности позволяет где-то запустить программы, которые будут с этими данными работать.
Можно иметь хорошую резервную копию и не иметь свободного сервера нужного размера. Можно иметь сервер, но ещё несколько часов переносить на него данные. Можно перенести данные и обнаружить, что для запуска приложения нужны дополнительные настройки, доступы и другие сервисы. А после запуска ещё требуется проверить, что система работает правильно.
К тому же реплика и бэкап защищают от разных неприятностей. Если программа ошибочно удалила записи, реплика может послушно повторить удаление. Тогда пригодится сохранённая версия до ошибки. Если пропала площадка, полезна доступная копия в другом месте. Слово «резервирование» одно, а задач под ним довольно много.
Поэтому фраза «ну у них же есть бэкап» примерно так же описывает восстановление бизнеса, как «у меня есть чемодан» описывает готовность к переезду. Важная часть действительно имеется. Остальное ещё предстоит организовать.
Что в такой ситуации делают инженеры? Восстановление идёт одновременно по нескольким направлениям.
На повреждённой площадке сначала нужно обеспечить безопасность, оценить состояние инженерных систем и оборудования. Подать питание обратно недостаточно: необходимо понимать, что его можно подавать, что охлаждение работает и что повторное включение не создаст новых проблем.
Параллельно команды сервисов используют сохранившиеся ресурсы. Где-то переключают работу на готовые копии, где-то разворачивают системы из резервных данных. Проверяют согласованность информации, восстанавливают связи между компонентами и постепенно возвращают нагрузку. Часть функций при этом может временно оставаться отключённой.
Это объясняет, почему сервисы возвращаются не одновременно. Один уже открывается, другой позволяет только посмотреть данные, третий работает медленно, четвёртый пока недоступен. Даже у одного приложения разные действия могут восстанавливаться в разное время.
В текущей ситуации Yandex Cloud ограничивала выделение дополнительных ресурсов и рекомендовала использовать внешние площадки. В рекомендациях есть способы переноса данных и восстановления систем. Это хороший пример того, что «облачные мощности» в конце концов упираются в вполне физические компьютеры. Кнопка создания сервера не производит процессоры.
Причём возвращение приложения в строй и восстановление повреждённого дата-центра могут происходить в совершенно разные сроки. Сервис можно запустить на другой площадке раньше окончания ремонта. А потом ещё потребуется вернуть ему нормальную производительность и резервирование. Сообщение «всё снова открывается» не обязательно означает, что система уже вернулась к прежней устойчивости.
Можно ли из всего этого сделать вывод, что пользовательские данные потеряны? Нет, по одной недоступности сервиса такой вывод сделать нельзя. Но и обещать сохранность абсолютно всей информации всех клиентов без результатов проверок было бы нечестно.
Для разных данных используются разные способы хранения и защиты. Например, 11 октября руководство финтех-направления Яндекса сообщило, что записи о счетах хранятся в нескольких копиях на разных площадках, их целостность проверили и потерь записей не обнаружили. Это заявление относится к конкретным данным конкретного направления. Автоматически распространять его на каждый файл, каждую базу и каждый клиентский проект нельзя.
У клиентов облака многое зависит ещё и от того, как они построили свои системы. Если компания разместила приложение только в одной зоне и не подготовила восстановление, сам факт аренды ресурсов у крупного провайдера не создаёт ей автоматически вторую работающую копию бизнеса.
Теперь к главному: сколько дата-центров должно отключиться, чтобы «лёг Рунет»? Такого универсального числа нет.
Рунет не хранится целиком у Яндекса. Интернет состоит из множества соединённых сетей разных операторов. Поверх них работают сайты, приложения и облачные платформы. Поэтому серьёзный сбой одного провайдера вычислений может нарушить работу огромного количества сервисов, но из этого не следует автоматическое отключение всех остальных сетей и ресурсов.
Для оценки действительно масштабной потери связи важны работа операторов, доступность маршрутов передачи данных, электроснабжение, системы доменных имён и наличие альтернативных соединений. Массовые перебои возможны из-за крупных аварий, ошибок программного обеспечения, неправильных настроек или административных ограничений. Считать их вероятность по числу повреждённых серверных зданий бессмысленно.
У нас уже был наглядный пример. 30 января 2024 года множество пользователей столкнулось с недоступностью сайтов в зоне .ru. Координационный центр связал произошедшее со сбоем в механизме DNSSEC, который защищает систему доменных имён. Если совсем просто, возникла проблема с проверкой адресов сайтов. Для столь заметного сбоя не потребовалось физического уничтожения дата-центров.
Обратная ситуация тоже возможна: связь между сетями сохраняется, но многие привычные сервисы недоступны из-за проблем с их вычислительной инфраструктурой. В повседневной речи обе ситуации назовут «интернет упал», хотя причины, последствия и способы восстановления будут разными.
Распределённость интернета помогает переживать неисправности. Но она не делает его неуязвимым. Если много компаний пользуется одной и той же платформой, её проблемы расходятся далеко за пределы её собственного приложения. Чем больше таких общих зависимостей, тем заметнее последствия одного крупного инцидента.
Поэтому я бы не подписывался ни под «Рунету конец», ни под «обычный сбой, чего вы переживаете». Для Яндекса и части его клиентов это серьёзный кризис: потеря доступных мощностей, простой, расходы на восстановление и работа с уменьшенным резервом. Для людей за этим стоят вполне конкретные сорванные заказы, недоступные документы и остановившиеся рабочие процессы.
А вот прогноз о скором исчезновении всего российского интернета требует совсем других доказательств. Их нельзя заменить подсчётом дата-центров.
Больше разборов про технологии и то, как они влияют на нашу жизнь, в «Пост Завтра». Подписывайтесь пожааалуйста
Источники и подробности
«Коммерсантъ»: что известно об атаке на дата-центр во Владимире. Хронология событий, сообщения компании и последствия для сервисов.
РБК: постепенное восстановление сервисов Яндекса. Какие функции возвращались к работе и почему ограничения сохранялись.
«Коммерсантъ»: последствия атак для облачного рынка. Нехватка вычислительных мощностей, перенос клиентских систем и сложности восстановления.
РБК: последствия сбоев для бизнеса и самозанятых. Пример того, как проблемы инфраструктуры затрагивают сторонние рабочие процессы.
РБК: причина массового сбоя Рунета 30 января 2024 года. Тот самый случай с DNSSEC, когда массовая недоступность сайтов возникла без уничтожения дата-центров.
Диском этим не пользовался, но так как при установке разного ПО он расползался как зараза по компу, то каким то образом был установлен и диск, и туда попало небольшое количество личных фото. Последствия следующие, большая часть из того что там было отображена пустыми пиктограммами, а сами фото уехали в Казахстан на домен https://disk.yandex.kz , то есть данные перемещены за границу, и перещено видимо то что осталось, будем наблюдать. Лично у меня хранится все на жестких дисках. Представляю сейчас состояние тех у кого все было на яндекс диске.

Давайте представим онлайн-кинотеатр в пятницу вечером. Вышла новая серия сериала, который многие ждали полгода, и минут через двадцать в поддержку начинают писать: поиск думает по десять секунд, кнопка «Смотреть» крутит колесо, а у части зрителей новой серии вообще нет в каталоге.
Дежурный открывает Grafana, а там всё зелёное. Процессор базы занят на треть, диск заполнен наполовину, PostgreSQL отвечает на проверки, реплика на месте. Панелей около трёхсот, и ни одна не горит.
Графики при этом не врут. Процессор правда свободен, место правда есть. Только они отвечают на вопрос «жив ли серверр», а человеку с попкорном важно то, сколько он ждёт.
По нашему мнению, у многих команд мониторинг базы собран из того, что легко измерить, и почти не помогает решить, что делать прямо сейчас. Косвенно это подтверждает опрос NeuBird, вендора ИИ-инструментов для дежурных: в феврале 2026 года компания опросила 1039 специалистов по SRE, DevOps и эксплуатации. У 78% хотя бы раз случался инцидент, на который не сработал ни один алерт. А 57% говорят, что по делу меньше 30% их алертов. Опрос вендорский, но картина узнаваемая: уведомлений много, а главное всё равно пропускают.
Что могло сломаться, пока всё зелёное
Для такой истории есть как минимум три сценария, и ни один из них не нагружает процессор.
Первый сценарий связан с очередью блокировок. В 20:55 выкатили миграцию с ALTER TABLE, которая добавляет колонку в таблицу фильмов. Для этого ей нужна самая строгая блокировка таблицы. А по той же таблице в это время идёт аналитический отчёт на двадцать минут. Миграция встаёт ждать отчёт, а все новые запросы к таблице, включая обычные SELECT из поиска, выстраиваются за миграцией. Запросы ничего не считают, они просто ждут, поэтому процессор отдыхает.
Во втором закончились соединения в пуле. Приложение ходит в базу через PgBouncer, а все 50 серверных соединений пула заняли медленные запросы и забытые открытые транзакции. Остальные клиенты стоят в очереди ещё до PostgreSQL, и сама база при этом может быть почти пустой.
В третьем каталог читает с реплики, а реплика отстала. Ошибок нет, просто зритель не находит серию, которая вышла десять минут назад, и жмёт «Обновить» снова и снова, добавляя нагрузку.
Все три проблемы видны в PostgreSQL, если знать, куда смотреть. Спорят о другом: что из этого должно будить дежурного, а что может спокойно лежать на дашборде.
Здесь исходят из того, что база почти всегда предупреждает заранее. Соединения подбираются к лимиту, реплика отстаёт всё сильнее, растёт WAL (журнал, куда PostgreSQL сначала записывает каждое изменение), транзакции висят открытыми. Если поставить пороги на эти показатели, дежурный узнает о проблеме до первой жалобы.
Подводит обычно настройка. Пороги берут из готовых наборов правил и ставят одинаковыми для всех баз: «соединений больше 80%», «реплика отстаёт больше чем на 10 секунд». Для одной базы 80% соединений означают обычный вечер, для другой аварию. Со временем такие алерты начинают пролистывать, а вместе с шумом и настоящую проблему.
На это есть ответ: шум – беда плохих порогов. Порог можно считать от обычного уровня конкретной базы или от скорости роста: «слот держит уже 40 ГБ WAL и прибавляет по 5 ГБ в час». Такой алерт сразу говорит, куда смотреть. Рост p99 сообщает только, что кому-то плохо.
Здесь всё идёт от книги Google по SRE. Мониторинг там отвечает на два вопроса: что сломалось и почему. «Что» – это симптомы, которые видит пользователь, «почему» – причины внутри системы. Для симптомов предлагают четыре «золотых сигнала»: задержку, трафик, ошибки и насыщение. Если на алерт можно ответить механически, звонить дежурному незачем. Из причин будить стоит только по очень явным и близким, вроде «диск базы закончится через 4 часа».
Для PostgreSQL это значит, что на пейджер, то есть с ночным звонком, идут p99 ключевых операций, доля ошибок и время ожидания соединения. Блокировки, контрольные точки и диск остаются на дашборде, их открывают после того, как сработал симптом.
Минусы у этого подхода тоже есть. Метрики придётся встроить в каждый сервис, и ночью путь от «кому-то плохо» до причины получается длиннее. А главное, некоторые проблемы копятся неделями и никак не задевают пользователя до последнего момента. Когда симптом наконец появляется, база уже отказывается принимать запись.
Допустим, за минуту кнопку «Смотреть» нажали 1000 раз. 980 запросов отработали за 20 мс, а 20 упёрлись в блокировку строки и ждали по 3 секунды. Среднее получается около 80 мс. Вроде бы терпимо, алерт с порогом в 200 мс промолчит. p95, то есть время, в которое укладываются 95% запросов, показывает красивые 20 мс. И только p99 показывает 3 секунды: каждый пятидесятый зритель смотрит на колесо.
Считать процентили стоит по каждой операции отдельно и рядом показывать число запросов. Если поиск и «Смотреть» смешать в одну метрику, быстрый и частый поиск утопит медленную и редкую операцию. А если за час было пять оплат подписки, p99 по ним считать бессмысленно, хватит списка из пяти строк.
И ещё одно. Из стандартной статистики PostgreSQL процентили не достать. pg_stat_statements хранит для каждого запроса число вызовов, среднее, минимальное и максимальное время и разброс, а процентилей там нет. Их считают в приложении, обычно гистограммами в Prometheus, отдельно для ожидания соединения и для выполнения SQL. Так видно, где потерялось время – в очереди к базе или в самой базе.
Вернёмся к миграции. Алерт «в базе есть блокировки» тут бесполезен, потому что блокировки есть всегда, на них держится вся конкурентная работа PostgreSQL. Полезен ответ на вопрос, кто ждёт, сколько и из-за кого. Его дают представление pg_stat_activity и функция pg_blocking_pids():
-- кто ждёт блокировку и кто её держит,
-- плюс сессии, которые оставили транзакцию открытой
SELECT pid,
now() - xact_start AS xact_age,
now() - state_change AS in_state,
state,
wait_event_type,
pg_blocking_pids(pid) AS blocked_by,
left(query, 60) AS query
FROM pg_stat_activity
WHERE wait_event_type = 'Lock'
OR state LIKE 'idle in transaction%'
ORDER BY xact_start;
Отдельно присмотритесь к статусу idle in transaction. Запрос закончился, а транзакция открыта, потому что приложение, например, ушло ждать ответа от платёжного сервиса. Такая сессия держит блокировки и мешает очистке старых версий строк. Её можно ограничить через idle_in_transaction_session_timeout, а с версии 17 есть ещё transaction_timeout на всю транзакцию. Его лучше ставить на роль приложения, иначе он оборвёт и долгие отчёты.
Для миграций есть простое лекарство, lock_timeout. Если миграция не получила блокировку за пару секунд, она завершается с ошибкой и освобождает очередь. Повторить попытку придётся самим, PostgreSQL этого не сделает, зато сервис не встанет.
-- перед миграцией: ждать блокировку не дольше 2 секунд
SET lock_timeout = '2s';
ALTER TABLE titles ADD COLUMN age_rating text;
Что увидит каждый подход? A сработает на правило «самая старая транзакция старше N минут» и, если повезёт, раньше пользователей. Но ночной отчёт тоже живёт долго, и порог придётся подбирать под каждую базу. B сработает на рост p99 у «Смотреть», а дежурный откроет запрос выше и быстро найдёт виновника. Долгие ожидания блокировок можно писать в лог и сейчас через log_lock_waits, а в PostgreSQL 19 (он пока в бете) его планируют включить по умолчанию и добавить представление pg_stat_lock.
В самой базе обычно смотрят число подключений относительно max_connections. Учтите, что часть мест зарезервирована (superuser_reserved_connections по умолчанию держит 3 слота для суперпользователей). Обычные клиенты упрутся в лимит раньше, чем график покажет 100%.
Если перед базой стоит PgBouncer, главный показатель живёт в нём. В выводе команды SHOW POOLS есть cl_waiting (сколько клиентов отправили запрос и ещё ждут серверное соединение) и maxwait (сколько секунд ждёт самый старый из них). Документация PgBouncer прямо пишет: если maxwait начал расти, пул не успевает обрабатывать запросы.
Подход A поставит здесь алерт на «занято 80% соединений». Подход Б поставит его на время ожидания соединения в приложении или на растущий maxwait. Второй вариант точнее. 80% занятых соединений при пустой очереди означают обычную работу, а секундная очередь бьёт по зрителям, даже если база загружена наполовину.
И не спешите поднимать размер пула или max_connections. Если соединения держат медленные запросы, новые подключения, как правило, только добавят конкуренции за память и диск.
В pg_stat_replication есть поле replay_lag, задержка применения изменений на реплике. Когда реплика всё догнала и записи нет, оно через какое-то время становится NULL, а у отвалившейся реплики строки в представлении нет вовсе, и алерт на replay_lag промолчит. Если каталог читает с реплики, надёжнее раз в несколько секунд записывать текущее время в служебную строку на основной базе и читать её с реплики (часы серверов должны совпадать). Разница и есть отставание, которое видит зритель.
С WAL всё серьёзнее. Слот репликации запоминает, какой журнал потребитель ещё не забрал, и не даёт его удалить. Если потребителя нет, например реплику выключили или про логического подписчика забыли, слот держит WAL начиная с позиции restart_lsn. Каталог pg_wal растёт, пока не займёт диск, и тогда база остановится. До этого момента пользователь не замечает ничего.
-- запускать на основном сервере: сколько WAL держит каждый слот,
-- safe_wal_size: сколько WAL ещё можно записать, пока слот не потеряет
-- нужные файлы (заполнен, только если задан max_slot_wal_keep_size)
SELECT slot_name, active, wal_status,
pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained,
safe_wal_size
FROM pg_replication_slots;
В PostgreSQL 18 появился idle_replication_slot_timeout. По умолчанию он выключен, а включённый помечает недействительными слоты, которые простаивают дольше заданного времени. Такой слот придётся пересоздавать.
Самое неприятное здесь – переполнение счётчика транзакций (XID wraparound). У PostgreSQL в «окне» около двух миллиардов номеров транзакций, и старые номера нужно периодически «замораживать», этим занимается autovacuum. Если он не успевает, база начинает писать предупреждения, когда до предела остаётся 40 миллионов транзакций. А когда остаётся меньше 3 миллионов, перестаёт выполнять команды, которым нужен новый номер транзакции. Проще говоря, перестаёт принимать запись.
-- возраст самого старого незамороженного XID в каждой базе,
-- предел около 2 млрд, принудительную заморозку autovacuum
-- по умолчанию запускает после 200 млн (autovacuum_freeze_max_age)
SELECT datname, age(datfrozenxid) AS xid_age
FROM pg_database
ORDER BY xid_age DESC;
Так в феврале 2019 года сломался Mandrill, сервис транзакционных рассылок Mailchimp. На одном из шардов кончились номера транзакций, и сбой длился около 40 часов. Ещё в ноябре 2018-го команда заметила, что счётчик прошёл примерно полпути, и завела в бэклог задачу на дополнительный мониторинг. Первое исключение ночью утонуло среди посторонних ошибок, а алерт на wraparound появился через полчаса после восстановления. Sentry в 2015 году наступил на те же грабли и лежал большую часть рабочего дня в США.
Пока счётчик растёт, p99 идеальный, и подход Б ничего не заметит. Поэтому возраст XID, место под WAL и состояние слотов мы бы держали на пейджере в любом случае. Порог по XID можно ставить с большим запасом, например на миллиард. Примерно на этой отметке Mandrill в ноябре и завёл свою задачу в бэклог. Только задача ждёт своей очереди, а алерт будит.
Во время контрольной точки (checkpoint) база сбрасывает на диск всё, что накопилось в памяти. Из-за неё и из-за диска мы бы ночью никого не будили. С 16-й версии время чтения и записи видно в pg_stat_io, но только при включённом track_io_timing. По умолчанию он выключен, и в колонках времени тогда стоят нули. Ещё в это время попадает чтение из кеша операционной системы, поэтому сам диск проверяют и через iostat или node_exporter.
Если точки из-за заполнения WAL идут чаще раза в 30 секунд, PostgreSQL сам напишет в лог «checkpoints are occurring too frequently» и посоветует увеличить max_wal_size. Разовое сообщение документация просит не считать поводом для тревоги, а частое вместе с ростом p99 на запись стоит разобрать. Только поднимать max_wal_size вслепую не надо: WAL займёт больше места, а восстановление после сбоя может затянуться.
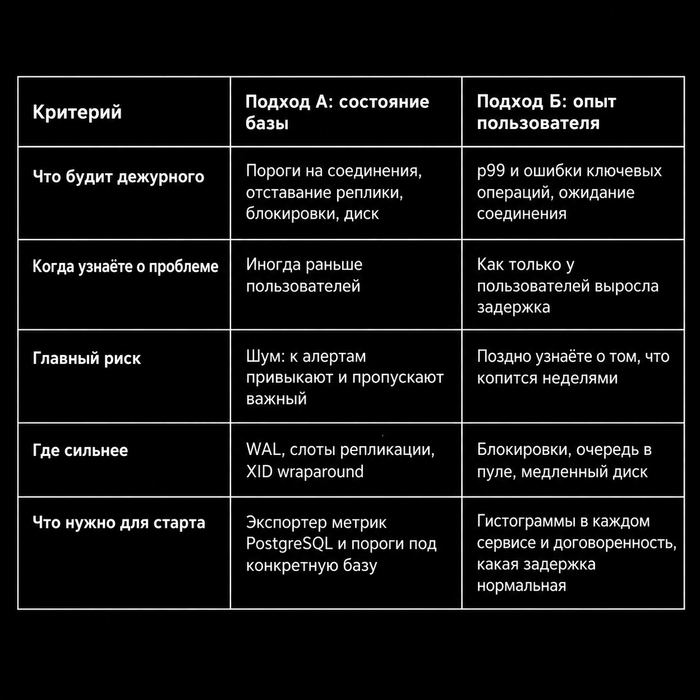
Мы за подход Б на пейджере и за короткий список исключений из подхода A. Дежурного стоит будить, когда пользователям плохо: вырос p99 ключевых операций, выросла доля ошибок, клиенты ждут соединение. И отдельно, когда кончается ресурс, о котором пользователь узнает слишком поздно. Это запас номеров транзакций, место под WAL и состояние слотов, свежесть реплики, если с неё читают. Остальное лежит на дашборде и открывается после первого алерта.
Для каждого алерта мы бы задавали один вопрос. Понятно ли, что делать, если он пришёл в три часа ночи? Если ответ «посмотреть и закрыть», ему место на дашборде.
Хорошее ночное сообщение выглядит примерно так: «„Смотреть“: p99 4,2 с при обычных 300 мс. 37 сессий стоят в очереди к titles за ALTER TABLE (pid 81234), а он ждёт отчёт (pid 80112)». Плохое: «Активных соединений 80%». Первое сразу говорит, кому плохо и куда смотреть. Со вторым дежурный идёт листать те самые триста панелей.
Подход A выигрывает, когда приложение не размечено метриками и разметить его нельзя, скажем, в старом монолите, к коду которого боятся прикасаться. Тогда пороги по базе лучше, чем ничего. Только подбирать их придётся под конкретную базу и её обычную нагрузку, готовые правила из интернета подведут.
А как устроено у вас? Какой алерт PostgreSQL последний раз действительно спас ночь, а какой мигает месяцами, и его давно никто не читает? Если вы уверены, что будить дежурного надо по состоянию базы, расскажите в комментариях, где подход Б вас подвёл.
Получите 15% кешбэка на первое пополнение только в Aéza