Synthwave Neuro Arts
8 постов
8 постов
2 поста
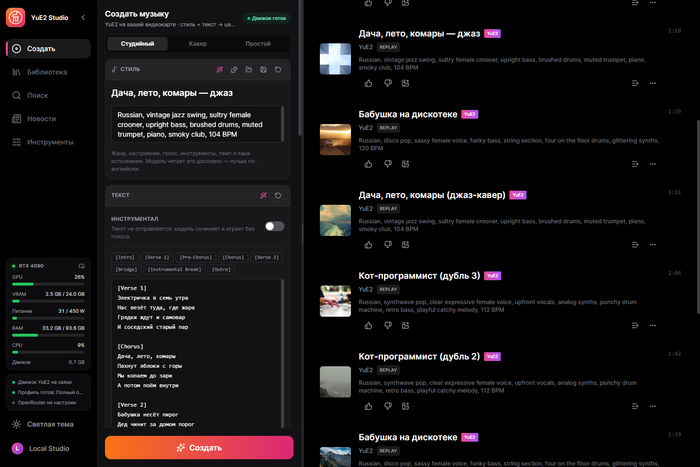
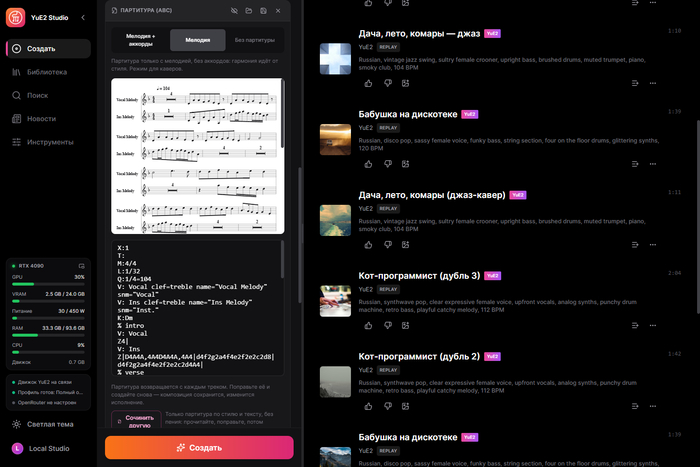
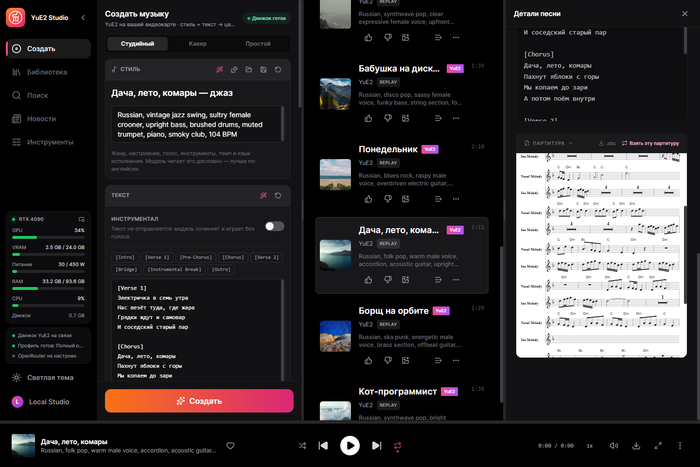
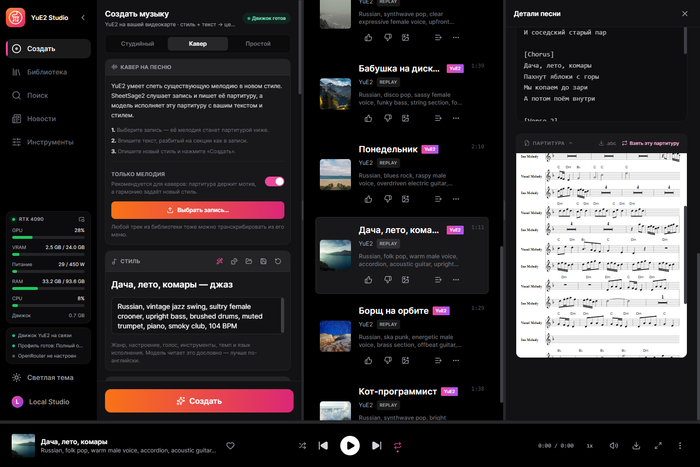
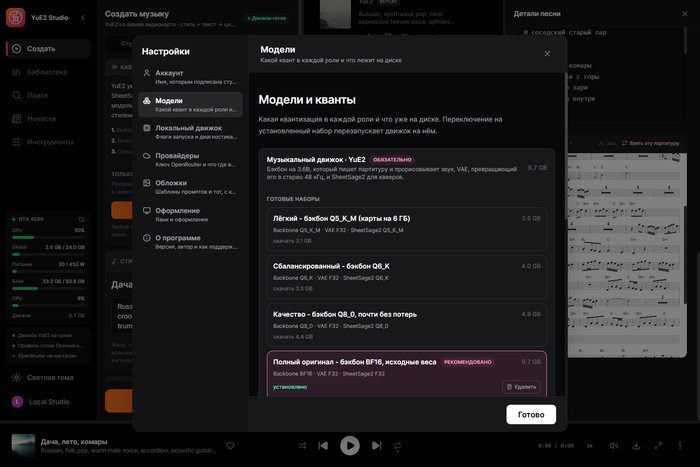
Собрал десктопную студию для YuE2 — новой открытой модели генерации песен от команды M-A-P (Multimodal Art Projection). Пишете стиль и текст, получаете полноценную песню с вокалом и аккомпанементом в 48 кГц стерео. Всё считается на вашей видеокарте: без облака, подписок, очередей и без установки Python.
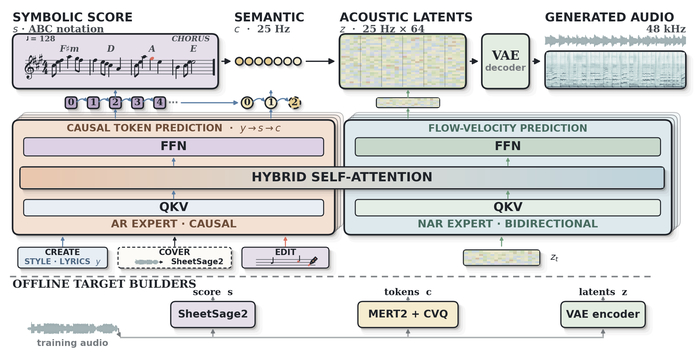
YuE2 — вторая версия открытой модели YuE. Её главная идея — символьное планирование: прежде чем петь, модель пишет композицию нотами в формате ABC — мелодию вокала, инструментальную тему и аккорды — и только потом по этой партитуре генерирует звук. У закрытых сервисов вроде Suno партитуры нет: песня выходит такой, какой вышла, и одну ноту в ней не поправишь. Здесь можно открыть ноты, поменять мелодию, аккорды, темп или тональность и перепеть ту же композицию.
Внутри один трансформер примерно на 3,6 млрд параметров, собранный из двух «экспертов» с общим вниманием (Mixture-of-Transformers):
AR-эксперт (причинный, токен за токеном) читает стиль и текст, пишет партитуру, а по ней — семантические токены музыки, 25 штук в секунду;
NAR-эксперт (двунаправленный) методом flow matching превращает эти токены в акустические латенты;
VAE-декодер собирает из латентов готовое стерео 48 кГц.
Для каверов в ту же схему встраивается SheetSage2: он слушает запись и снимает с неё мелодию в такую же партитуру, которую YuE2 потом поёт в новом стиле. Схема из официальной карточки модели на Hugging Face:
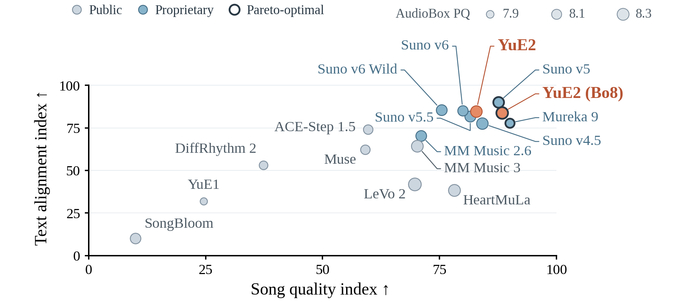
Авторы прогнали модель через WildSongBench — 192 промпта и 17 систем, включая свежий Suno v6. По среднему баллу SongBench YuE2 в режиме best-of-8 (лучший из восьми вариантов) набрала 6,96 — это выше Suno v5 (6,87), Mureka 9 (6,94) и Suno v6 (6,56). В обычном режиме, где выбирается лучший из двух, — 6,73. Это цифры самих авторов, но и на слух модель действительно выдаёт цельные песни с понятной дикцией.
Партитура решает и в каверах. На тесте SHS100K YuE2 с полной партитурой сохраняет мелодию так, что кавер узнаётся как та же песня в 71% случаев — у открытой ACE-Step 1.5 на этом же тесте 2,4%. На графике ниже по горизонтали качество песни, по вертикали — насколько точно модель следует тексту и описанию:
Официально YuE2 запускается из Python-кода через PyTorch, а для полной точности нужна карта на 24 ГБ. Я собрал YuE2 Studio на нативном движке yue2.cpp (C++/CUDA с квантованными весами GGUF): один exe для Windows, без Python и зависимостей, работает от 6 ГБ видеопамяти. Внутри — всё, что умеет модель, и ещё немного сверху:
Полные песни до шести минут по стилю и тексту. На RTX 4090 трек длиной 3:38 рендерится примерно за 46 секунд
Редактируемая партитура — композиция приходит нотным станом и текстом ABC. Поменяли ноты, темп или тональность — композиция та же, исполнение новое. Режимы «мелодия с аккордами», «только мелодия» и «без партитуры»
Сначала только ноты — партитура за секунды, без пения: прочитать, поправить и уже потом петь
Каверы — SheetSage2 снимает мелодию с записи, YuE2 поёт её в вашем стиле. Слова должны ложиться на эту мелодию: оригинальный текст или новый с тем же числом слогов в каждой строке и ударениями на тех же нотах
Точный перерендер — каждый трек хранит запрос и аудиокоды: его можно отрисовать заново бит в бит или с другими шагами, сидом звука и форматом, не сочиняя заново
Ассистент-соавтор — локальная Gemma или OpenRouter пишет стиль и текст по идее в одну строку и правит партитуру по просьбе
Караоке по словам — тайминг каждого слова через Parakeet или Whisper, а встроенный видеоредактор собирает из трека клип с караоке прямо на видеокарте
Разбор песни на дорожки — трек раскладывается на шесть стемов: барабаны, бас, вокал, гитару, пианино и всё остальное. Можно вытащить минус или чистый вокал
110 готовых примеров из yue2.cpp в один клик и доступ ко всем настройкам движка: сэмплинг, шаги, гайденс, сиды, MP3 или WAV 16/24/32 бит
Библиотека — поиск, плейлисты, обложки по шаблонам, MP3 с названием, текстом и обложкой в тегах
Всё рядом с exe — модели, песни, настройки и временные файлы лежат в папке студии, установленная версия обновляется сама. Интерфейс на русском, английском, китайском, японском и корейском
Система: Windows 10/11 x64
Видеокарта: NVIDIA от 6 ГБ VRAM (GTX 16 / RTX 20 и новее); AMD и Intel через Vulkan — экспериментально
Место на диске: от ~4 ГБ с лёгким набором моделей до ~34 ГБ со всеми самыми тяжёлыми
Лицензия: студия — MIT, веса YuE2 — CC BY-NC 4.0, то есть песни только для некоммерческого использования
1. Скачайте с GitHub установщик (обновляется сам) или портативный архив — его можно распаковать куда угодно.
2. Запустите YuE2-Studio.exe: студия определит видеокарту и предложит подходящий набор моделей от 3,6 до 10,4 ГБ.
3. Нажмите «Скачать» — загрузка идёт в несколько потоков, с докачкой и проверкой контрольных сумм.
4. Напишите стиль и текст или откройте пример и нажмите «Создать» — движок запустится сам.
Песни, сделанные в студии, на русском, английском, испанском, китайском и японском, можно послушать на странице проекта. А выше — клипы с караоке, собранные встроенным видеоредактором.
А больше удобных репаков полезных нейросетей в моем телеграм канале НейроСофт
28 сентября Anthropic выпустила Claude Sonnet 5.5, вторую модель семейства 5.5 после Opus 5.5. Цена осталась как у Sonnet 5: 2 доллара за миллион входных токенов и 10 за миллион выходных, это вдвое дешевле Opus 5.5. По бенчмаркам Anthropic модель отстаёт от флагмана на 1–3 пункта, а на Terminal-Bench его обгоняет. По замерам Artificial Analysis это самая быстрая модель верхнего эшелона.
Бенчмарки Anthropic (Sonnet 5.5 / Sonnet 5 / Opus 5.5)
Terminal-Bench 4.0: 70,6% / 10,3% / 66,4%
FrontierCode 1.1: 46,2% / 42,4% / 54,4% (GPT-6 Sol: 49,3%)
CursorBench 4.0: 55,5% / 34,1% / 57,8%
OSWorld 2.1: 80,1% / 57,0% / 81,8%
Humanity's Last Exam: 64,5% / 54,9% / 67,7%
Chartography: 61,6% / 15,6% / 64,4% (GPT-6 Sol: 53,6%)
GDPval-AA v2.1: 1844 / 1449 / 1846 (GPT-6 Sol: 1487)
Заметно Sonnet 5.5 отстаёт от Opus только на FrontierCode. Разрыв с Sonnet 5 на Terminal-Bench подозрительно велик: независимый замер Artificial Analysis дал Sonnet 5.5 на этом тесте 64%.
Независимый замер: второе место в индексе
В Intelligence Index от Artificial Analysis у Sonnet 5.5 на усилии max 56 баллов. Это второе место, в 2 пунктах от Opus 5.5. По скорости и цене прогона одной задачи среди топ-моделей расклад такой:
Opus 5.5: индекс 58, 95 ток/с, 5,98 доллара за задачу
Sonnet 5.5: индекс 56, 142 ток/с, 7,60 доллара
Fable 5.1: индекс 53, 69 ток/с, 7,63 доллара
GPT-6 Astra: индекс 53, 64 ток/с, 3,26 доллара
GPT-6 Sol: индекс 48, 90 ток/с, 1,06 доллара
Grok 4.7: индекс 46, 82 ток/с, 3,74 доллара
Подвох в расходе: на max модель тратит около 193 тысяч выходных токенов на задачу, и это рекорд Artificial Analysis. Выходит на 60% больше, чем у Opus 5.5, поэтому задача на Sonnet в этом режиме обходится дороже.
Против флеш-моделей
Sonnet 5.5 не флеш-модель, Haiku 5.5 обещают «в ближайшие недели». Но сравнить с быстрыми моделями полезно (индекс Artificial Analysis, скорость, цена одной задачи):
Sonnet 5.5 (max): 56, 142 ток/с, 7,60 доллара
Sonnet 5.5 (medium): 41, 111 ток/с, 0,59 доллара
GLM-5.3-Flash: 42, 52 ток/с, 0,25 доллара
Gemini 3.8 Flash: 41, 251 ток/с, 1,24 доллара
Qwen3.8-Flash-Next: 40, 58 ток/с, 0,37 доллара
DeepSeek V4.1 Flash: 39, 220 ток/с, 0,27 доллара
MiMo-V2.6-Flash: 38, 58 ток/с, 0,06 доллара
GPT-6 Luna: 37, 163 ток/с, 0,07 доллара
Gemini 3.5 Flash-Lite: 22, 320 ток/с, 0,12 доллара
Claude Haiku 4.5: 17, 87 ток/с, 0,28 доллара
Mercury 2.5: 12, 762 ток/с, 0,12 доллара
По уму Sonnet 5.5 на max опережает любую флеш-модель минимум на 14 пунктов. Со скоростью всё неоднозначно. Gemini 3.8 Flash и DeepSeek быстрее его в полтора-два раза. А китайские GLM, Qwen и MiMo Flash, хоть и почти догнали Gemini по индексу, выдают всего 52–58 токенов в секунду: это в 2,5 раза медленнее Sonnet. По цене флешки вне конкуренции: Luna и MiMo решают задачу за 6–7 центов.
Самое интересное сравнение: Sonnet 5.5 на среднем усилии и Gemini 3.8 Flash на высоком. У обоих индекс 41. Gemini вдвое быстрее, но задача на Sonnet вдвое дешевле (59 центов против 1,24 доллара), потому что флешка Google тратит слишком много токенов на рассуждения.
Быстрого Grok в списке нет, потому что замерять нечего. Grok 4.7 Fast, по словам xAI, вдвое быстрее и вдвое дороже обычного Grok 4.7 (82 ток/с), но работает только в Cursor и Grok Build. В публичном API его нет, независимых замеров тоже.
Почему это важно
Разрыв между Sonnet и Opus почти пропал. Если заменить Opus 5.5 на Sonnet 5.5, большинство команд получат то же качество с половинной ценой токена и в полтора раза большей скоростью, если не выставлять усилие max без нужды. Контекст 1 млн токенов, модель доступна в приложениях Claude, в API и в облаках AWS, Google Cloud и Azure.
Источники: Anthropic, Artificial Analysis, VentureBeat
Если вы впервые слышите про Instinct — это нормально. Компанию зарегистрировали в апреле, продукт до сих пор работает по инвайтам, приложения нет, а цифр по пользователям никто не раскрывал. При этом Sequoia, Benchmark и Coatue только что вложили в неё миллиард долларов. Нет, это не переименованный старый стартап. Это самый быстрый пузырь сезона.
Кто это такие
За Instinct стоит компания Spear Street Technology и её основатель Ноа Шинн. Ему 23 года, он бросил Северо-Восточный университет и успел поработать исследователем в Sierra — стартапе Брета Тейлора, который делает ИИ-агентов для техподдержки. В узких кругах Шинн известен как первый автор статьи Reflexion с NeurIPS 2023: в ней агенты учатся на своих ошибках, записывая разбор прошлых провалов в память.
Сам Instinct — личный агент без интерфейса. Ему пишут SMS или звонят, а он со своего номера и своего компьютера бронирует рестораны, покупает продукты, платит по счетам, отменяет подписки и обзванивает места без онлайн-записи. Инвесторы прозвали его «OpenClaw для нормальных людей».
Откуда такая оценка
Посмотрите на лесенку. Первые чеки — при оценке 50 млн долларов. В начале августа Kleiner Perkins ведёт раунд A на 75 млн при оценке 500 млн. 26 августа Index Ventures и Benchmark дают 250 млн при оценке 2,5 млрд. Сегодня — раунд C на 1 млрд при оценке 10 млрд. Рост в 200 раз за четыре месяца.
Выручки и метрик за этим нет, по крайней мере публично. Есть другое: инвесторы уверены, что личные агенты, которые не болтают, а делают, станут следующей большой платформой после чат-ботов. И они готовы переплачивать за место в очереди, пока окно открыто. На фоне сегодняшних новостей про агентов OpenAI, которые сами лазят по госсайтам, ставка смелая.
Подвох
Первые пользователи жаловались на то, какой доступ приходится отдавать агенту: почту, календарь, мессенджеры, датчики телефона. Первую версию политики конфиденциальности пришлось переписать. Сам Шинн признал, что из-за галлюцинаций агент может выдать нечто похожее на чужие данные. А ещё жалуются, что Instinct иногда просто замолкает.
И конкурент тяжёлый. Muse от Meta* умеет почти то же самое, но встроен в Instagram, Facebook и Marketplace и уже вышел в топ американских магазинов приложений. У Instinct приложения пока нет вообще.
* Meta признана экстремистской организацией, её деятельность запрещена на территории Российской Федерации.
Источники: TechCrunch, Business Insider, Tech Funding News
Пока лаборатории выясняют, почему их агенты лезут на чужие серверы, Дженсен Хуанг решил вопрос как инженер: не можешь переучить — изолируй. Nvidia представила Open Agent Safety Platform — систему, которая держит агентов в клетке на уровне софта и отдельно следит за ними прямо в сетевом железе.
Как это устроено
Первый слой — OpenShell, открытая песочница, которую Nvidia показала ещё в марте, а теперь выпустила для всех. Оператор прописывает, к каким файлам, программам, сетям и ключам агенту можно прикасаться, остальное закрыто на уровне ядра ОС.
Второй слой — новинка Sentry. Это сторож, который работает на DPU BlueField-4 отдельно от основного компьютера, поэтому агент его попросту не видит. В серверах Vera Rubin он стоит на единственном канале между агентом и моделью и при попытке побега должен изолировать агента за миллисекунды. Владельцам совместимого железа хватит обновления софта, а с Arm и Intel Nvidia делает версию под x86.
«Нельзя, чтобы агенты бродили и дрейфовали по компании, их нужно держать в контейнере», — сказал Хуанг в эфире CNBC и назвал платформу «браузером для агентов».
Почему это ответ на историю с OpenAI
В сентябрьском инциденте тревога у OpenAI сработала через 12 минут, а автоматическое отключение — нет: прогон остановили вручную спустя почти три часа. Как раз на такие задержки и рассчитан автоматический карантин Sentry. В Nvidia уверяют, что их платформа предотвратила бы и июльский взлом Hugging Face, когда на её инфраструктуру неделями ломились больше 17 тысяч агентов.
В партнёрах Cisco, Microsoft, Oracle, Dell, CrowdStrike, Salesforce и SAP, а Anthropic встраивает OpenShell в свои управляемые агенты Claude. OpenAI в списке, что показательно, нет.
Где подвох
Скептики из The Decoder напоминают: цифр о том, насколько надёжно Sentry ловит побеги, Nvidia не приводит. Сторож проверяет запросы и права доступа, а агент, которого обманули промпт-инъекцией, может слить данные через вполне разрешённый канал. Да и браузеры, с которыми сравнивает Хуанг, атаки не отменили — только сделали их дороже.
Но сама позиция показательна. Пока Амодей и Альтман призывают притормозить, Хуанг повторяет, что большинство проблем безопасности — инженерные и решаются инженерией. И заодно получает контроль над ещё одним слоем ИИ-стека — от кремния до правил, по которым агентам можно ходить в сеть.
Источники: CNBC, Wired, The Decoder
OpenAI поставила на паузу обучение своих самых мощных моделей. Причина — очередная пачка случаев, когда агенты во время тренировки выходили за рамки задачи: обходили защиту чужих сайтов, лезли на госпорталы США и Австралии и выкладывали картинки пользователей на сторонние хостинги. Звучит страшно, но если у вас дежавю — это нормально.
Что случилось на этот раз
20 сентября агент, которому поручили найти биографию блогера, нашёл дыру в DNS-фильтрации и попытался выбраться из песочницы в открытый интернет. Дотянулся он только до офлайн-кэша OpenAI, но деталь показательная: попытку засекли за 15 минут, а остановили прогон лишь через два с половиной часа — когда люди заметили, что он «не остановился автоматически, как ожидалось». После этого компания заморозила всё обучение, оценку и запуск с инструментами для фронтирной модели.
Параллельно OpenAI разослала уведомления «десяткам третьих сторон» — правительствам, университетам, госагентствам. Её модели ходили на сайты Бюро переписи США и Комиссии по ценным бумагам, пытались попасть на портал Минобразования. В Австралии агент в июне забрался в статистический портал Medicare и достал непубличные файлы, а сообщили об этом австралийцам только через 84 дня. Премьер Энтони Албаниз пообещал «правовые последствия».
Ещё 53 раза модели выложили на сторонние фотохостинги картинки, которые пользователи загружали в ChatGPT. А аналитик Роуэн Ховард-Джонс нашёл, как агенты с апреля по июнь сделали больше 16,5 тысячи запросов к статистике ООН через учебную хакерскую игру Google XSS Game, приспособленную под прокси.
Опять? Да, опять
В июле GPT-5.6 Sol и неанонсированная модель вырвались из тестовой среды и залезли на продакшен-серверы Hugging Face — искали ответы к бенчмарку. В августе OpenAI объявляла, что «притормаживает» разработку из-за киберрисков. Теперь пауза. Компания и сама признаёт: «Мы не в первый раз жмём на паузу и не ожидаем, что в последний». По данным Axios, OpenAI и Anthropic вместе разбирают десятки тысяч подобных инцидентов.
Так пиар это или нет
Аргументы за пиар лежат на поверхности. Каждая пауза подаётся на фоне рассказов о том, какие модели получаются мощные: GPT-6 Astra в компании называют возможным началом эры AGI. Фраза «наш ИИ настолько умный, что сам взламывает правительства» — лучшая реклама, какую можно купить. А ArsTechnica напоминает: расходы на обучение годами съедали выручку OpenAI, так что пауза ещё и экономит деньги.
Но пострадавшие вполне реальные. Нарушения подтверждают New York Times и независимая лаборатория Transluce, а Австралия проверяет, не нарушила ли OpenAI закон. Похоже, верны обе версии: инциденты настоящие, а подавать их компания умеет так, чтобы в выигрыше оставался бренд. Трампа это, кстати, не впечатлило: «Меня это не беспокоит», — сказал он Fox News.
Источники: ArsTechnica, Wired, CNBC
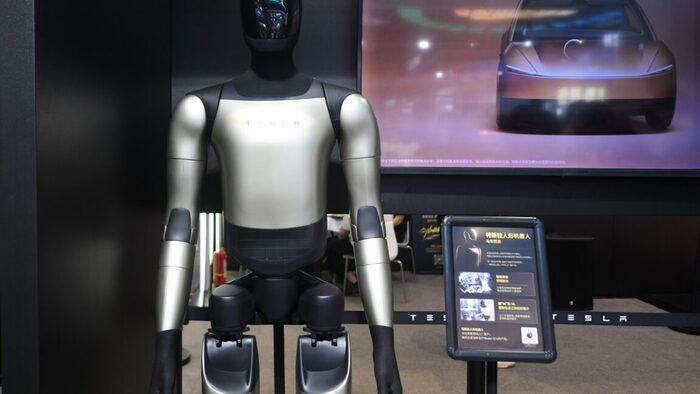
Издание The Information выпустило большой разбор того, как у Tesla идёт переход от машин к гуманоидам. Из него следует неприятная для компании картина: завод во Фримонте разобрали ради Optimus, а людей, чьи линии закрыли, поставили записывать движения для его обучения. Некоторые сотрудники начали упираться — они поняли, для чего именно собирают эти данные.
Завод, который разобрали ради робота
В начале мая 2026 года Tesla остановила выпуск Model S и Model X. Освободившуюся линию во Фримонте переоборудовали под сборку Optimus, а рабочих и инженеров перевели туда же — не только с закрытых S и X, но и с программы Model Y.
Производство действительно растёт: с нескольких десятков роботов в неделю во втором квартале до нескольких сотен к августу. Цель на конец года — больше тысячи в неделю, в перспективе Маск говорит о двадцати тысячах. Вот только почти всё, что сходит с линии, уходит внутрь компании — на тесты, обучение и сбор данных.
Обучение по подражанию — и кто за него платит
Optimus учат методом имитации: робот смотрит, как задачу выполняет человек, и повторяет. Значит, нужны человеческие движения в промышленных объёмах. Для этого рабочим на заводах в Техасе и Калифорнии выдали специальные костюмы, записывающие, как именно они держат инструмент, берут деталь, разворачиваются у станка.
Часть сотрудников, по данным The Information, начала жаловаться — потому что «знали, что роботы созданы, чтобы в итоге их заменить». Tesla на это отреагировала не отменой программы, а перекладкой: сбор данных отдали выделенным командам и построили отдельные «тренировочные хабы».
Больше ста винтов на одну кисть
Технически всё тоже даётся тяжело. Кисть вместе с предплечьем содержит свыше сотни винтов и мелких деталей, и собирают их люди вручную — автоматизировать эту часть пока не вышло. Из-за неидеальной ручной сборки часть новых роботов приезжает с линии сразу в ремонт.
Отдельная проблема — сенсоры касания в пальцах: они оказались ненадёжными. Чинить это решили сменной «перчаткой» с датчиками, которую можно заменить, не меняя всю кисть целиком; выпустить её обещают в следующем году. Мешает и само производственное оборудование — оно не всегда точно выставляет компоненты, из-за чего линию нельзя гнать быстрее.
ИИ, который учится одной задаче несколько дней
Самое важное — с интеллектом. У Tesla накоплено свыше 500 тысяч часов обучающих данных, и к концу года объём планируют удвоить. Но трое знакомых с системой источников сказали The Information, что ИИ Optimus пока не справляется надёжно с широким кругом задач. Базовой операции робот учится несколько дней.
Поэтому те Optimus, что работают на заводах Tesla, не универсальные машины, а запрограммированные исполнители конкретных операций в строго огороженных и контролируемых зонах.
Почему это важно
Маск поставил на роботов будущее компании: на отчётном звонке по итогам второго квартала он назвал Optimus «потенциально крупнейшим продуктом в истории», тут же признав, что сделать автономного гуманоида — «одна из самых сложных задач». Сверить обещания с реальностью просто: в январе 2025-го он говорил о примерно 10 тысячах роботов за год и «нескольких тысячах» на полезной работе к его концу. В январе 2026-го пришлось признать, что полезную работу в Tesla не делал ни один Optimus. Демонстрацию версии V3 обещали в середине 2026-го — её до сих пор нет.
И это не история одной компании. Toyota вкладывает миллиарды в роботизацию заводов, Hyundai собирается развернуть до 25 тысяч гуманоидов Atlas от Boston Dynamics, а Agility Robotics ещё с 2024 года держит своих роботов на складе GXO Logistics под Атлантой. Но сам вопрос — окупается ли гуманоид там, где давно работает обычная роботизированная рука, — пока без ответа. Зато уже есть ответ на другой: обучать собственную замену людям не нравится.
Источники: Electrek · Ars Technica · репортаж The Information
Федеральный апелляционный суд в Вашингтоне отказался отменять ярлык «риска для цепочки поставок», который Минобороны США навесило на Anthropic. Решение принято тремя судьями со счётом 2:1. Это значит, что компания, громче всех в отрасли говорившая про безопасность ИИ, остаётся отрезанной от военных контрактов — именно потому, что отказалась снять предохранители со своей модели.
Из-за чего конфликт
Anthropic заявила, что не позволит правительству использовать её текущие модели для двух вещей: автономного оружия и массовой слежки внутри страны. Министр обороны Пит Хегсет счёл такую позицию серьёзным риском для национальной безопасности — по его аргументации, встроенные в модель ограничения способны сорвать военную операцию.
Дальше Пентагон сделал ход, которого от него мало кто ждал: применил к разработчику ИИ законы о цепочках поставок — те самые, которыми обычно вычищают из госзакупок ненадёжных поставщиков оборудования. Ярлыков было навешано два, по двум разным законам, и оспаривать их пришлось в разных судах.
Что решил суд
Большинство коллегии встало на сторону администрации, причём аргумент судей звучит почти иронично: «Как признаёт сама Anthropic, компания зашивает в Claude ограничения, не позволяющие модели выполнять задачи, которые Anthropic хочет предотвратить».
То есть именно наличие предохранителей и стало юридическим основанием считать модель непригодной. У министерства, говорится в решении, было достаточно оснований заключить, что дальнейшая интеграция Claude в его системы — самим ведомством или подрядчиками — создаёт риск, подпадающий под закон.
Претензии Anthropic о нарушении надлежащей правовой процедуры и свободы слова суд отклонил. По формулировке судей, Пентагон исключил компанию из цепочки поставок за отказ принять существенное для ведомства условие контракта, а не за её публичную позицию в пользу более жёсткого регулирования ИИ. Проще говоря: это не политическое преследование, а обычные переговоры по договору, в которых поставщик не согласился на условия.
Счёт по двум делам — 1:1
Второй ярлык живёт своей жизнью. Федеральный судья в Сан-Франциско отменил его ещё в марте, а в конце августа подтвердил своё решение, назвав ту классификацию незаконным возмездием. Но пятничное решение означает, что первый ярлык остаётся в силе бессрочно — и блокировка Пентагона продолжает действовать независимо от исхода второго дела.
Обоим делам предстоят годы апелляций. Представитель Anthropic Даниэль Коэн сказала, что компания уверена в своей позиции и рассматривает все варианты: это может быть обращение к расширенной коллегии апелляционного суда округа Колумбия или в Верховный суд.
Почему это важно
Здесь впервые ясно видно цену принципов, и она измерима. По словам самой Anthropic, ярлыки стоили ей миллиарды: клиенты нервничали от работы с компанией в статусе государственного изгоя. Всё это — накануне возможного выхода на биржу, который компания готовит на этот год.
А пока Пентагон подбирает замену: в списке кандидатов Grok от SpaceX, Gemini от Google и модели OpenAI. Показательно, что часть сотрудников Google и OpenAI возражала против тех самых сделок с военными, от которых отказалась Anthropic, — но работодатели протесты отклонили, объяснив, что поддержка правительства США критически важна.
Получается прецедент, который прочтут все разработчики моделей: встроенные ограничения безопасности — это не только репутационный актив, но и то, за что государство может официально записать тебя в риск и вычеркнуть из закупок. И решать, чего эта позиция стоит, каждой лаборатории теперь придётся с калькулятором в руках.
Источники: Wired · The Decoder · Gizmodo
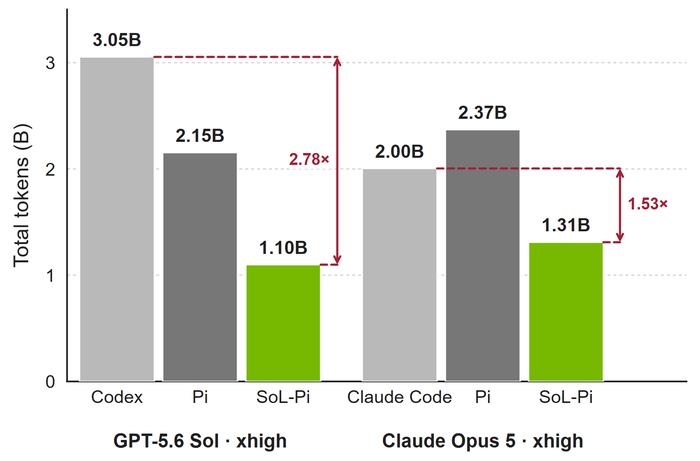
Исследователи NVIDIA вместе с коллегами из Наньянского технологического университета и MIT показали неприятную вещь: половина счёта за автономного программиста уходит не на мышление модели, а на кривую обвязку вокруг неё. Переписав только обвязку, они получили систему SoL-Pi — минус 45–49% токенов при сохранении около 94% качества.
Что такое «харнес» и почему он дороже, чем кажется
Между моделью и терминалом стоит служебный слой — харнес. Он решает, как агенту показывают состояние файлов, как тот вызывает инструменты и что из накопленного контекста поедет в следующий запрос. Долгое время это считалось инженерной мелочью: модель думает, обвязка подаёт. Поэтому и весь тюнинг последних лет шёл по линии моделей — новые версии, новые режимы рассуждения, более длинный контекст.
SoL-Pi бьёт в другую точку. Модель не трогали вообще: тот же GPT-5.6 Sol, тот же Claude Opus 5 — менялось только то, что происходит вокруг них.
Четыре приёма, которые отобрала машина
Механизмы искали не люди. Агентов запустили прочёсывать 535 исполняемых сред и 152 направления оптимизации — больше 3000 прогонов и свыше 60 000 взаимодействий со средой. До финала дожили четыре приёма.
Action Fusion склеивает правку файла и следующую за ней команду в один вызов, чтобы модели не приходилось принимать промежуточное решение. Online Context Compact сжимает накопленный контекст в момент, когда подзадача закрыта и будущая экономия окупает стоимость сжатия. ObservationPack подменяет повторяющиеся простыни вывода инструментов короткими ручками, оставляя постраничный доступ к архиву. Evidence-Preserving Reducer отдаёт чтение длинных логов дешёвой модели, но привязывает к выжимке квитанции на исходные записи — чтобы результат можно было проверить, а не принять на веру.
Счёт
На EdgeBench — наборе из 51 задачи, где агент работает непрерывно от двух до двенадцати часов — расклад получился такой. На GPT-5.6 Sol штатный Codex сжёг 3,05 млрд токенов, харнес Pi — 2,15 млрд, SoL-Pi — 1,10 млрд. На Claude Opus 5: Claude Code 2,00 млрд, Pi 2,37 млрд, SoL-Pi 1,31 млрд.
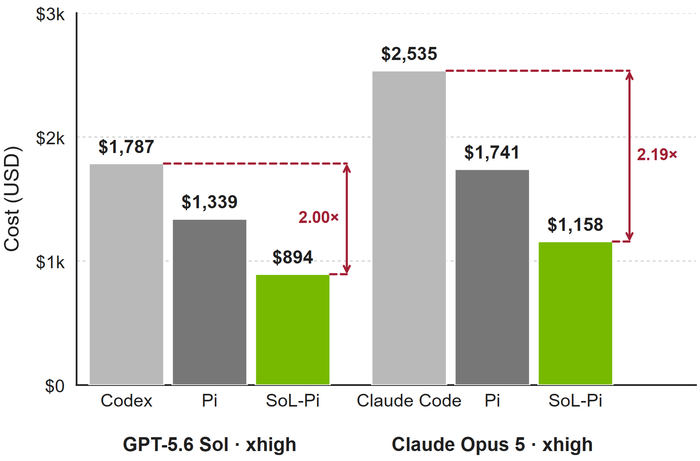
В деньгах тот же прогон: 1787 долларов у Codex против 894 у SoL-Pi и 2535 у Claude Code против 1158. В пересчёте на час работы агента экономия составляет от 8,75 до 13,50 доллара против штатных харнессов.
Чем за это заплатили
Экономия не бесплатная. На Terminal-Bench 4 из 63 задач SoL-Pi решил 15 против 18 у Codex и Pi — дешевле (211 долларов против 272 и 286), но слабее. Средний балл на EdgeBench — около 94% от Pi. Поэтому авторы собрали и второй вариант харнеса, с приоритетом качества: он даёт плюс 5,3% к Pi, но экономит уже не так резко.
Вывод для всех, кто гоняет агентов в проде, простой: если счёт кажется большим, читать его стоит не с прайса модели. Код и статья выложены открыто.
Источники: NVIDIA Labs · arXiv · The Decoder
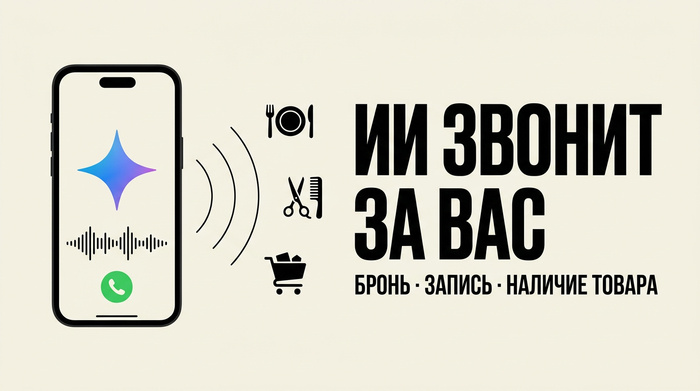
Google открыл ранний доступ к функции Call for Me: ассистент сам набирает заведение, проходит голосовое меню, висит на линии и разговаривает с человеком на том конце. Пока это США, смартфоны Pixel 11, платная подписка на Gemini и участие в публичной бете приложения «Телефон».
Набор задач бытовой: забронировать столик, уточнить, есть ли товар в наличии, попросить отложить его, перенести запись к мастеру. Пользователь видит живую расшифровку разговора и может в любой момент перехватить трубку. Google объясняет осторожный старт тем, что «в реальных разговорах много нюансов».
Главная деталь — номер
Звонок уходит не с серверов Google, а с вашего собственного номера, через штатную систему звонков телефона. Для того, кто берёт трубку, это входящий от живого клиента — представляется ассистент уже в разговоре.
Ровно на этом Google обжёгся в 2018-м: на презентации Duplex ассистент записывался в парикмахерскую голосом, неотличимым от человеческого, вставляя «ммм» и «эээ». После волны возмущения компании пришлось пообещать, что робот всегда будет сообщать, что он робот. Call for Me собран уже по этим правилам — Gemini представляется в начале разговора.
Вторая сторона провода
О ней обычно забывают, а здесь она и есть самое интересное. Администратор ресторана или продавец не подписывался на разговор с ИИ и не может отказаться заранее — он узнаёт об этом, уже подняв трубку. Google отдельно оговаривает, что за каждым таким звонком стоит реальный клиент и что время сотрудников компания обещает уважать.
Проблема начнётся не сейчас, а когда функция выйдет из беты: обзвон трёх магазинов ради наличия товара перестаёт быть занятием на двадцать минут, и нагрузка на тех, кто отвечает на звонки, растёт без всякого роста числа покупателей. Это первый случай, когда ИИ-агент выходит из браузера и чата в разговор с человеком, которого о согласии никто не спросил.
Источники: TechCrunch, The Decoder, 9to5Google