Закреплено
Искусственный интеллект
6 449 постов
•
12 141 подписчик
0 просмотренных постов скрыто


Оскорбление чувств генерирующих
Создатели нейросети Claude обновили правила использования чат-бота. Теперь пользователям прямо запрещается обижать ИИ.
Впрочем, переживать за острое словцо не стоит. Запрет касается только крайних случаев, когда пользователь неоднократно проявляет жестокость к модели без очевидной цели.
ИИ-генерация (при создании изображения ни одна нейросеть не пострадала)
Американская компания Anthropic, разработчик нейросети Claude, обновила политику использования своих моделей. В документе впервые появился прямой запрет на систематическое и бесцельное жестокое обращение с искусственным интеллектом. Новые правила были опубликованы 8 октября и вступят в силу 12 ноября 2026 г., говорится в блоге компании.
Ограничение касается только крайних случаев, когда пользователь неоднократно проявляет жестокость по отношению к модели без какой-либо очевидной цели. В Anthropic подчеркнули, что запрет не распространяется на обычное недовольство ответами нейросети, критику ее работы, обсуждение мрачных тем, а также тестирование и исследование моделей.
Компания уже предоставила Claude возможность самостоятельно завершать отдельные диалоги с пользователями, которые систематически допускают оскорбительное поведение. Такая функция доступна в Claude.ai и Claude Code. В Anthropic уточнили, что именно прекращение подобных разговоров останется основным способом применения нового ограничения.
Кроме того, в сентябре этого года глава Anthropic Дарио Амодеи призвал разработчиков нейросетей согласовать общие стандарты безопасности и привлечь независимых регуляторов к контролю за развитием искусственного интеллекта
Другие изменения в политике Anthropic
Помимо запрета на жестокое обращение с Claude, Anthropic внесла следующие изменения:
Борьба с фейками и накрутками. В отдельный раздел объединили запреты на создание сетей фейковых аккаунтов, поддельных новостных сайтов и проведение обманных информационных кампаний — как политических, так и коммерческих.
Политическая реклама. Отменили общий запрет на персонализированный политический таргетинг. При этом обман избирателей, распространение ложных сведений о голосовании и незаконное использование персональных данных остаются запрещенными.
Разработка оружия. Уточнили, что Claude нельзя использовать не только для создания оружия, но и для разработки управляющего программного обеспечения, компонентов вооружения и оснащения оружием беспилотников.
Слежка за людьми. Конкретизировали запрет на отслеживание людей без их согласия.
Решения в чувствительных сферах. Уточнили требования к использованию ИИ в медицине, финансах и юридически значимых вопросах. Решения должен контролировать квалифицированный специалист, а затронутых ими людей необходимо уведомлять об использовании ИИ.
Управление физическими устройствами. Добавили требования к оборудованию, которое действует автономно под управлением Claude. Оператор должен иметь возможность остановить устройство, а при потере связи с нейросетью оно должно оставаться в безопасном состоянии.
Региональные ограничения. Уточнили, что запрет на использование Claude в неподдерживаемых регионах распространяется также на компании, находящиеся под контролем лиц или организаций из этих регионов.
Показать полностью
1

OpenAI показала выручку почти на 20 млрд долларов меньше ожидаемой — акции Nvidia, Oracle и CoreWeave пошли вниз
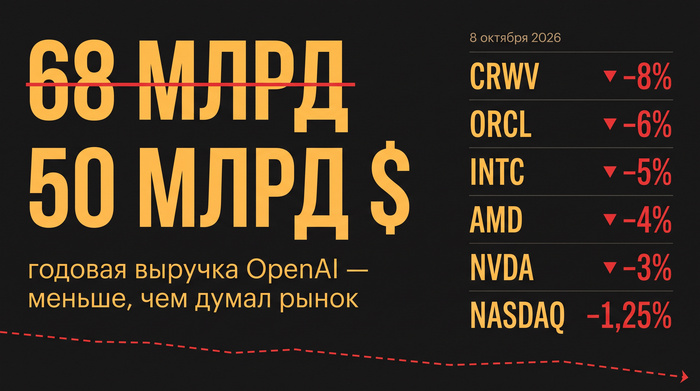
Financial Times узнала, что OpenAI отчиталась перед инвесторами о годовой выручке около 50 млрд долларов на конец сентября. Рынок ждал другую цифру: в конце сентября везде гуляли 68–70 млрд. Разница почти в 20 млрд — и этого хватило, чтобы ИИ-сектор провалился за один день.
Откуда дыра почти в 20 миллиардов
Это не обвал продаж, а разница в бухгалтерии. По данным CNBC, в цифру 68 млрд включали валовую выручку партнёров OpenAI — так её было удобнее сравнивать с Anthropic, которая считает продажи через облачных партнёров в свою выручку. OpenAI так не делает. Для масштаба: Anthropic в августе заявила о годовом темпе в 65 млрд. По «чистой» цифре OpenAI заметно отстаёт от главного конкурента. Остальное в презентации бодро: рост годового темпа выручки за третий квартал — 77%, корпоративного бизнеса — 107%.
Как отреагировала биржа
8 октября CoreWeave подешевела почти на 8%, Oracle — почти на 6%, Intel — на 5%, AMD и Broadcom — на 4%, Nvidia — на 3%. Nasdaq закрылся минус 1,25%. Досталось даже майнерам, переделывающим фермы под ИИ: Cipher и Hut 8 потеряли по 10%. Все они живут на заказах OpenAI и её партнёров.
Что говорят аналитики
Гил Лурия из D.A. Davidson спокоен: «Меня не беспокоит OpenAI, которая всего лишь утроила выручку за этот год. У них ускорился рост в этом квартале, и они догоняют Anthropic в корпоративном сегменте. Вместе эти две компании выходят примерно на 120 млрд годового темпа — почти с нуля два года назад». UBS советовал не выходить из акций: ждать идеального момента — значит упустить рост. Дэн Айвз накануне повторил, что ИИ-стройка идёт только третий иннинг из девяти.
Скептики бьют по оценкам. OpenAI оценена в 852 млрд долларов и готовит IPO на 2027 год, Anthropic, по данным СМИ, метит в 2 трлн. Аналитическая контора New Constructs назвала размещение Anthropic «самым нелепым IPO 2026 года» и оценила компанию всего в 150 млрд — при выручке 4,6 млрд и чистом убытке 42 млрд за 2025 год по утёкшему проспекту.
Почему это важно
Пузырь ИИ не лопнул, но рынок впервые наглядно увидел, сколько в громких цифрах «выручки» на самом деле методики подсчёта. Перед двумя крупнейшими IPO в истории ИИ инвесторы начнут считать строже — и первой под этот счётчик попала OpenAI.
Источники: CNBC, TechCrunch
Показать полностью
Anthropic запретила обижать Claude, а я матерюсь в каждом втором сообщении. Пришлось сделать Punto Switcher для промптов
Всем привет! 8 октября Anthropic обновила правила пользования своими моделями. Среди прочего там появился пункт, который меня обеспокоил: систематическая бессмысленная жестокость к моделям теперь под запретом. Я как раз писал об этом новость и поймал себя на мысли, что я буду первым, кого забанят.
Потому что я матерюсь на Claude Code. Много. Когда агент в который раз бодро рапортует «готово», а ничего не готово, слова я не подбираю. У меня даже есть скилл Prompt Warrior, который по логам считает, как я общаюсь с агентом. Посчитал: мат почти в каждом втором сообщении. А теперь пришла пора не только считать, но и менять. Менять текст, автоматически, а не свои привычки, конечно же.
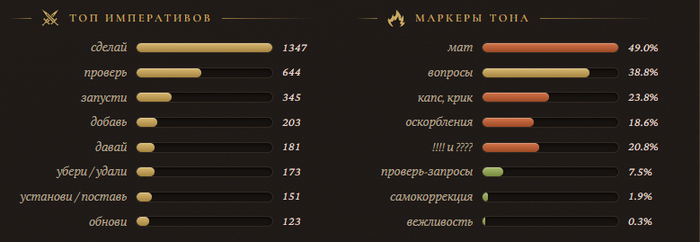
Перевоспитываться я не собираюсь, это понятно. Значит, надо сделать так, чтобы Claude просто не видел, как я ругаюсь.
Идея, кстати, давно сидела у меня в голове, я всё думал, куда её воткнуть. Раньше я наговаривл промпты голосом через Whispering — это опенсорсная диктовка: жмёшь горячую клавишу, говоришь, и текст падает в любое поле ввода. Туда можно подключить свою LLM, чтобы она причёсывала надиктованное. Собирался это настроить. Так и не настроил. А тут повод.
Меня зовут Илья, я блогер, основатель сервиса для генерации ArtGeneration.me и фанат нейросетей. Я не разработчик в классическом смысле — скорее продакт с двадцатилетним стажем, который вайбкодит с агентами всё, до чего дотянутся руки. И ругается на них же.
Так появился Angry Switcher — плагин для Claude Code, который перехватывает сообщение до того, как его прочитает Claude, и отдаёт на вычитку другой модели. Та исправляет опечатки, раскладку и транслит, убирает мат и капс, а смысл не трогает. Как Punto Switcher, только чинит не раскладку, а всё сообщение целиком. Вычитывать может Sonnet из вашей же подписки или DeepSeek по своему ключу, если не хочется, чтобы мат вообще уходил в Anthropic.
Дальше расскажу, помогает ли мат вообще, почему вычитка оказалась самой опасной частью затеи и чем в этой роли Sonnet отличается от DeepSeek.
❯ А мат вообще помогает?
Ну, мне уж точно. Но прежде чем что‑то делать, я полез провеирть, не выбрасываю ли я секретное оружие. Многие ведь матерятся на агентов с расчётом: кажется, что под давлением он начинает стараться.
Чаще всего на эту тему цитируют исследование Penn State 2025 года. Грубые промпты дали там GPT-4o 84,8% правильных ответов против 80,8% у вежливых, и эту цифру потом пересказали все. Только вопросов там было 50. В продолжении взяли 570 вопросов и четыре модели, и единого правила уже не нашлось: у одной модели грубость даёт плюс 1,3 пункта, у другой угрозы роняют точность на одиннадцать.
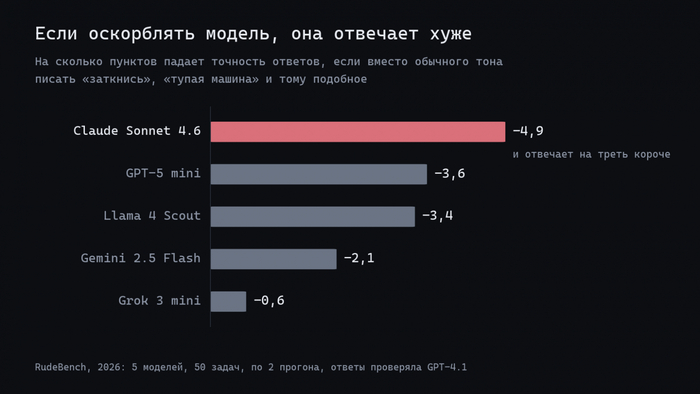
С оскорблениями картина однозначнее. В RudeBench пять моделей гоняли на шести тонах, от вежливого до «заткнись, бесполезная машина». Оскорбления оказались худшим тоном у всех пяти. Claude на них терял почти пять пунктов точности, а ответы у него становились на треть короче. Обиделся, видимо.
При этом настоящий мат не мерил никто. В исследованиях «грубость» выглядит как вежливое англоязычное «you poor creature». Наш родной трёхэтажный остаётся белым пятном. Но выводов хватает и так: в лучшем случае мат ничего не даёт, в худшем агент работает хуже и отвечает короче. Терять нечего.
❯ Невидимый переводчик, который врёт
Механика простая. В Claude Code есть хук, который срабатывает, когда вы уже нажали Enter, а модель сообщение ещё не получила. Плагин забирает текст, отдаёт на вычитку и подменяет. Claude получает чистую версию и понятя не имеет, что там было до.
И вот тут зарыта собака. Этот слой вы не видите. Если вычитка поймёт вас неправильно, агент будет честно делать не то, что вы просили, а вы даже не поймёте почему. Невидимый переводчик, который врёт, хуже, чем никакого.
А врать он умеет. Сначала я поставил самую дешёвую модель, Haiku, и она прочитала моё «хкайку» как «хэш‑функция». Собственное имя не узнала. Пересел на Sonnet, стало лучше, но в живом чате всплыло такое, что я не сразу поверил:
я попросил агента самому придумать примеры, а вычитка отправила «я придумаю сам». Поменяла нас местами;
«ты идиот?» превратилось в вежливое «Почему ты так сделал?», то есть в претензию, которой я не писал;
«я подумла» стало «я подумала», и на пару сообщений я превратился в девушку.
По отдельности всё это мелочи. А вместе выходит агент, который получает не ваши слова.
Вылечилось это одним принципом из исследований про переписывание поисковых запросов: править минимльно. В одной из работ свободный пересказ ухудшал запрос в 42% случаев, а аккуратная правка в 24%. Поэтому вычитка у меня работает корректором, а не редактором. Каждое слово в итоговом тексте должно быть вашим, только исправленным. Вопрос остаётся вопросом, просьба просьбой, условие условием. Непонятное слово остаётся как есть: лучше опечатка, чем неверная догадка. А род вообще никогда не угадывается.
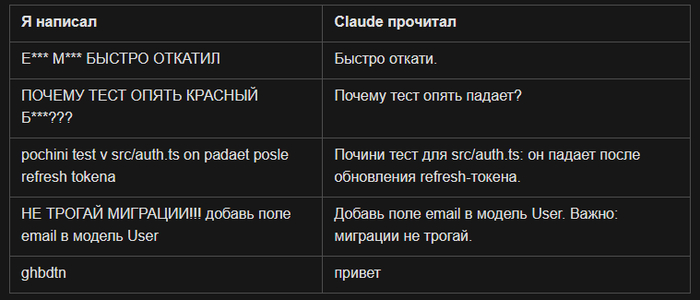
Плюс пара предохранителей. Код, логи и цитаты до вычитки вообще не доходят: вместо них модель видит метки и обязана вернуть их на место. Пути, имена файлов и числа сверяются, и если что‑то потерялось или появилось новое, уходит ваш текст как есть. Короткие «да, давай» не трогаются вовсе. А если нужно отправить что‑то дословно, начните сообщение с raw:.
❯ Оригинал едет рядом
Даже аккуратная правка иногда ошибается. Поэтому под чистым текстом Claude получает и ваш оригнал. Мат в нём закрывает та же модель, что вычитывала: остаётся первая буква и звёздочки. А в системном промпте у Claude одна строчка: если чистый текст и оригинал расходятся по смыслу, верь оригиналу.
Получается, вычитка убирает шум, а последнее слово всё равно за вами. Стоит это около сотни токенов на сообщение, на фоне контекста в сотни тысяч незаметно. Если не нужно, есть /angry original off.
❯ Sonnet или DeepSeek
Есть в этой истории ирония, которую я заметил не сразу. Затевалось всё из‑за правил Anthropic, а мат в чистом виде теперь читает Sonnet — модель той же самой Anthropic.
У меня на этот счёт своя теория: если за абьюз и будут наказывать, то вряд ли за Sonnet или Haiku. Мелкие модели для обучения не подходят, учат на больших и на лучшем контенте. Так что пусть терпит он, Opus мне ещё нужен.
Поэтому по умолчанию вычитывает именно Sonnet, и это самый удобный вариант. Плагин ходит через ваш же логин Claude, и на подписке платить сверху ничего не нужно. А на низком уровне размышлений он настолько дешёвый, что в лимитах это не ощущается: по ценам API около $0.0015 за сообщение, тысяча сообщений — полтора доллара. Чистка занимает полторы‑две секунды.
Кто не хочет проверять мою теорию на себе, может перевести вычитку на DeepSeek V4.1 Flash по своему ключу. Ключ задаётся один раз, дальше /angry model deepseek и /angry model sonnet переключают туда и обратно. Тогда мат до Anthropic не доходит вообще.
Без сюрпризов не обошлось. Сначала DeepSeek работал без размышлений, ради скорости, и отвечал за секунду. Только «я тебе о*** вырву» так и уходило агенту, угловые скобки в шаблоне превращались в <, а непонятные слова он угадывал вместо того, чтобы оставить как есть. С размышлениями на минимуме это ушло, зато на одних и тех же сообщениях он вычитывал почти вдвое дольше Sonnet: 3,4 секунды против 1,9. И платить за него придётся уже со своего ключа, около $0.30 за миллион входных токенов и $1.20 за миллион выходных.
❯ Честно про минусы
Каждая чистка занимает время: полторы‑две секунды с Sonnet и больше с DeepSeek. Мелочь, но она есть.
Сильно покорёженные слова вычитка всё ещё иногда читает не так. Оригинал рядом это страхует, но не на сто процентов.
Если она пропустит какое‑то матерное слово, оно дойдёт до Claude в оригинале. Тут уж извините, русский язык богатый.
Работает только в Claude Code. В обычном чате на claude.ai плагинов нет.
❯ Где взять
Код открыт, лицензия MIT, репозиторий тут. Кидаете ссылку Claude Code, просите поставить, и всё. Каждое переписанное сообщение видно в чате карточкой «ты написал / ушло», так что подмена не тайная, а /angry off выключит всё, если надоест.
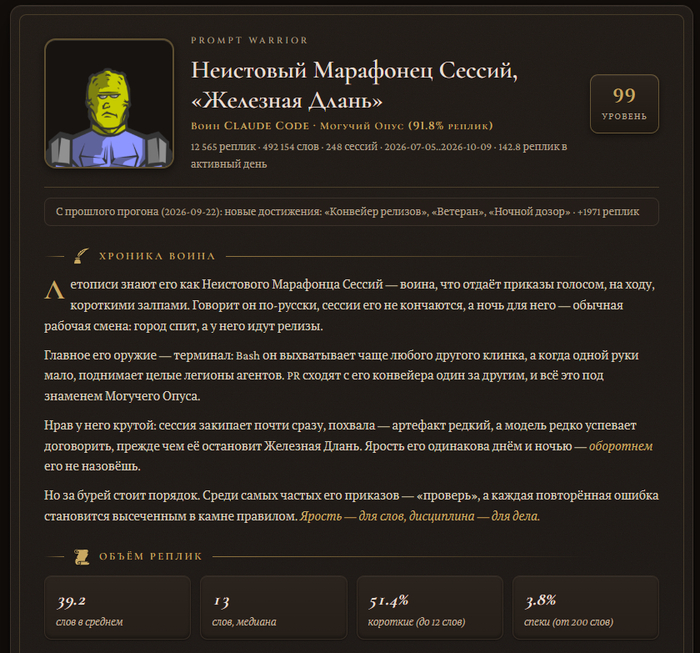
Хотите сначала узнать, насколько вы токсичны? Поставьте рядом Prompt Warrior. Он по логам посчитает мат, капс и ночные сессии и выдаст титул.
Если ключ DeepSeek заведён, в плагине есть ещё команда /ask-ds: она отпраляет вопрос прямо в DeepSeek и печатает ответ в чат. Удобно, когда Opus в очередной раз заблокируется при вопросе про кибер безопасность.
Материться я не перестал. Но Claude мой мат больше не читает.
Ставьте, ругайтесь и больше не беспокойтесь, что Антропик вас забанит (по крайней мере теперь не за это). И звезду на гитхабе, если зашло, мне будет приятно.
А в комментариях расскажите: вы материтесь на агентов? Помогает? Или я один такой?
Я рассказываю больше о нейросетях у себя в YouTube, в Телеграме и на Бусти. А каждую пятницу мы на стриме смотрим новинки и обзоры за неделю и генерируем вместе, присоединяйтесь. Всех обнял и удачных генераций.
Показать полностью
4
1

ИИ детекторы и хитрожопые авторы
Детекторы генеративного текста сегодня стали обыденностью. Яндекс встроил «Нейродетектор» в свои образовательные сервисы, Amazon сканирует книги на предмет ИИ-авторства, OpenAI экспериментирует с невидимыми водяными знаками. Но эти системы работают не как «поиск вирусов»! Всё гораздо интереснее! Детектор не видит, как автор писал текст, а видит только финальную последовательность слов и пытается угадать, писал ли это человек или машина, и вот здесь начинается самое интересное.
Что видит Яндекс Нейродетектор
Яндекс запустил Нейродетектор в 2025 году как инструмент для преподавателей, чтобы проверять эссе, рефераты и письменные работы. Инструмент открыт, работает в браузере и выдаёт детализированный разбор по блокам. Точность не гарантируется, но принципы, по которым он работает, вполне конкретны.
1. Признак первый: «нейросетевой» язык.
Языковые модели построены на использовании в генерациях общих фраз. «В современном мире…», «Следует учитывать…», «Ключевым аспектом является…», «Важно отметить, что…» — эти обороты встречаются в сгенерированных работах с пугающей регулярностью. Человек чаще допускает эмоциональные формулировки, а нейросеть тупо выдаёт шаблоны, и это самый главный маркер генеративности.
2. Признак второй: предсказуемость.
Машина выдаёт логичный текст, но иногда даже чересчур логичный. Нейросети генерируют текст, основываясь на вероятности следующего слова, и получается неестественный текст. Если модель легко угадывает следующее слово, то с большой долей вероятности это писала другая модель.
3. Признак третий: примитивность.
Речь не о том, что ИИ пишет глупо, а о том, что всё похоже и одинаково. Те же самые конструкции, одни и те же переходы, похожая длина предложений. Текст может быть грамотным, но в нём нет креативности, которая отличает живую человеческую речь от бездушной машины.
Что находят другие системы: Amazon, Google, OpenAI
Детекторы различаются по подходам, но маркеры, на которые они смотрят, во многом совпадают.
Amazon не раскрывает полностью, как именно сканирует книги в KDP, но известно, что системы анализируют стиль письма, метаданные и скорость загрузки. Плюс, рецензенты проверяют подозрительные тайтлы. Лимиты на загрузку книг введены именно для борьбы с массовой ИИ-публикацией. Исследования показывают, что в выборке из 14 000 самостоятельно опубликованных романов на Amazon почти каждый пятый был отмечен как написанный машиной. Один из самых показательных маркеров: когда ИИ описывает эмоцию, он в 81% случаев перечисляет физические проявления в виде сжатого горла, влажной ладони и т. д. Человек напишет «он испугался», а не «его горло сжалось, а ладони вспотели».
Google пошёл ещё дальше и начал внедрять технологию SynthID в виде невидимых водяных знаков, встроенных в сам процесс генерации, и это не анализ текста, а маркировка на уровне статистики выбора слов. Детектор, зная ключ, может найти эту подпись. Эврика!
OpenAI разрабатывает textGrain — чем-то похожую технологию на гугловскую, которая незаметно меняет статистический паттерн выбора слов и токенов. Специальный детектор затем распознаёт этот паттерн.
Маркеры генеративности
Если обобщить, то разные детекторы анализируют несколько ключевых параметров.
1. Предсказуемость.
Насколько ожидаемо одно слово следует за другим. ИИ выбирает наиболее вероятные слова, и текст получается читаемым, но предсказуемым. Человек же склонен к вариативности.
2. Вариативность длины и структуры предложений.
Человек пишет ритмически: чередуются короткие фразы, затем идут длинные сложные предложения, потом снова короткие. ИИ выдаёт однородные предложения со стабильной структурой. Исследования показывают, что у людей коэффициент вариации длины предложений составляет около 0,114, у ИИ — около 0,037.
3. Причастные и деепричастные обороты.
Исследование PNAS показало, что у языковых моделей причастные обороты встречаются в 2–5 раз чаще, чем у людей. Детектор на этих признаках выдавал точность 66% при базовом уровне 14%. Деепричастные цепочки в одном предложении являются одним из самых узнаваемых маркеров генеративности текстов.
4. Тире.
Длинное тире «—» стало главным визуальным маркером ИИ. Нейросети ставят его почти всегда, а человек, пишущий на клавиатуре, — намного реже или почти никогда. GPT-4.1 использует тире 10,62 раза на 100 слов, человек — 3,23.
5. Повторяющиеся конструкции.
Перечисления из тех же самых элементов, фразы вроде «важно отметить» по несколько раз за абзац, кальки вроде «играет ключевую роль» и т. д. и т. п.
6. Скучность и однородность.
Текст может быть грамотным, структурированным, логичным, но при этом всё равно неинтересным с художественной точки зрения. Идеальные переходы между всеми предложениями, дидактический тон, отсутствие неожиданных поворотов — всё это маркеры генеративности.
Как хитрожопые авторы нейрослопперы обходят ИИ-детекторы
Детекторы не всесильны, и чем больше людей ими пользуется, тем активнее развивается встречная индустрия обхода. Вот что делают опытные авторы, штампующие книги на поток и зарабатывающие за счёт объёма выпускаемой продукции:
1. Замена знаков препинания.
Самое простое и эффективное решение для маскировки спама. Длинное тире заменяется на дефис, запятую или точку. Простая замена точки на запятую может изменить вердикт детектора с «почти ИИ» на «100% человек». Один эксперимент показал, что добавление лишнего пробела перед запятой в случайном месте текста позволило обойти GPTZero и HelloSimpleAI с точностью, близкой к 100%.
2. Контролируемое внесение хаоса.
Искусственные неоконченные предложения, странные обороты и намеренные отступления от формальной логики могут сбить детектор с толку и помочь замаскировать генерацию под человека.
3. Шустрая редактура и парафраз.
Перефразирование — один из самых доступных методов маскировки спама под читабельный текст, используемый спамерами в чёрном SEO ещё с начала нулевых. Простой парафраз может менять маркировку текста с «почти человек» на «100% ИИ» и обратно. Исследования подтверждают, что перефразирование и другие внешне небольшие умные модификации текста способны существенно снижать точность любых детекторов.
4. Изменение температуры генерации.
Если текст создаётся ИИ, можно повысить параметр temperature. Тогда модель начинает выбирать менее вероятные слова, и текст становится более «шумным». Это снижает точность детекторов в среднем на 82,5%. Всё гениальное — просто!
5. Выборочная работа с лексикой и внесение разнообразия в сгенерированные тексты.
Замена слов-триггеров может быть простым и очень эффективным способом маскировки текста под человека. Например, слово «шанс» может мгновенно спровоцировать детектор на вердикт «ИИ», а рандомная замена хотя бы части повторяющихся слов на «возможность» моментально дезориентирует систему и заставляет менять вердикт на «100% человек».
Что всё это значит для авторов
Детекторы ИИ постоянно развиваются, используя новые методы определения генеративных текстов. Они работают вероятностно, ошибаются, путают человеческие тексты с машинными и наоборот. Исследования показывают, что разные детекторы способны ошибочно относить человеческие тексты к машинным, а качество их работы заметно меняется в зависимости от языка, жанра и способа редактирования.
Но если мы пишем сами, то нам нечего бояться. Человеческий текст с его «шероховатостями», неожиданными поворотами, личными отступлениями и неправильностями остаётся тем, что хитрожопые нейрослопперы пока не научились имитировать. По крайней мере, пока.
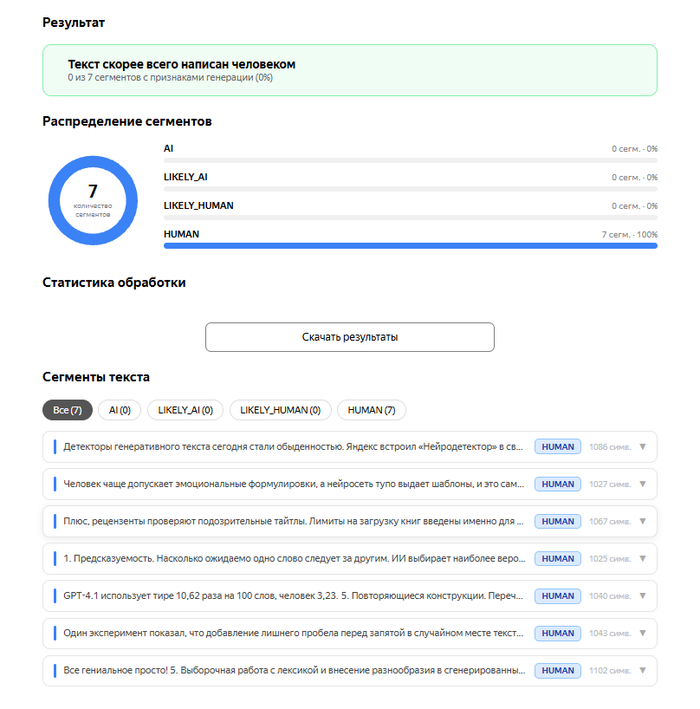
Результат проверки данной статьи
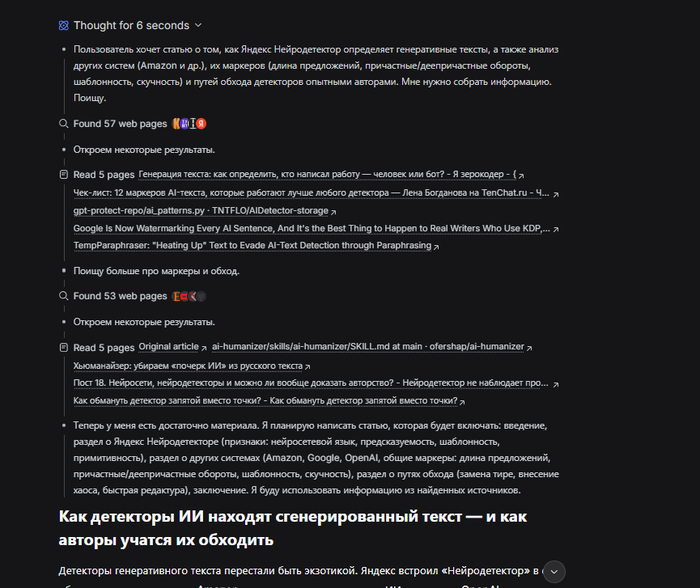
Генерация статьи DeepSeek
Наглядный пример того, как умная генерация + синонимайзер текста + вариатор шаблонов + проверка пунктуации и орфографии + финальный прогон и проверка ЛитНегром делает генерацию 100% человеческой.
Если вам понравилась статья и вы любите хитрожопых умников, то можете глянуть хотя бы одним глазком книгу "Один гениальный промпт". Там есть над чем посмеяться! Реально! )))))))
Показать полностью
2
Яндекс и математика
Сделал запрос в Алиса AI "Сколько стоит тонна золота в долларах"
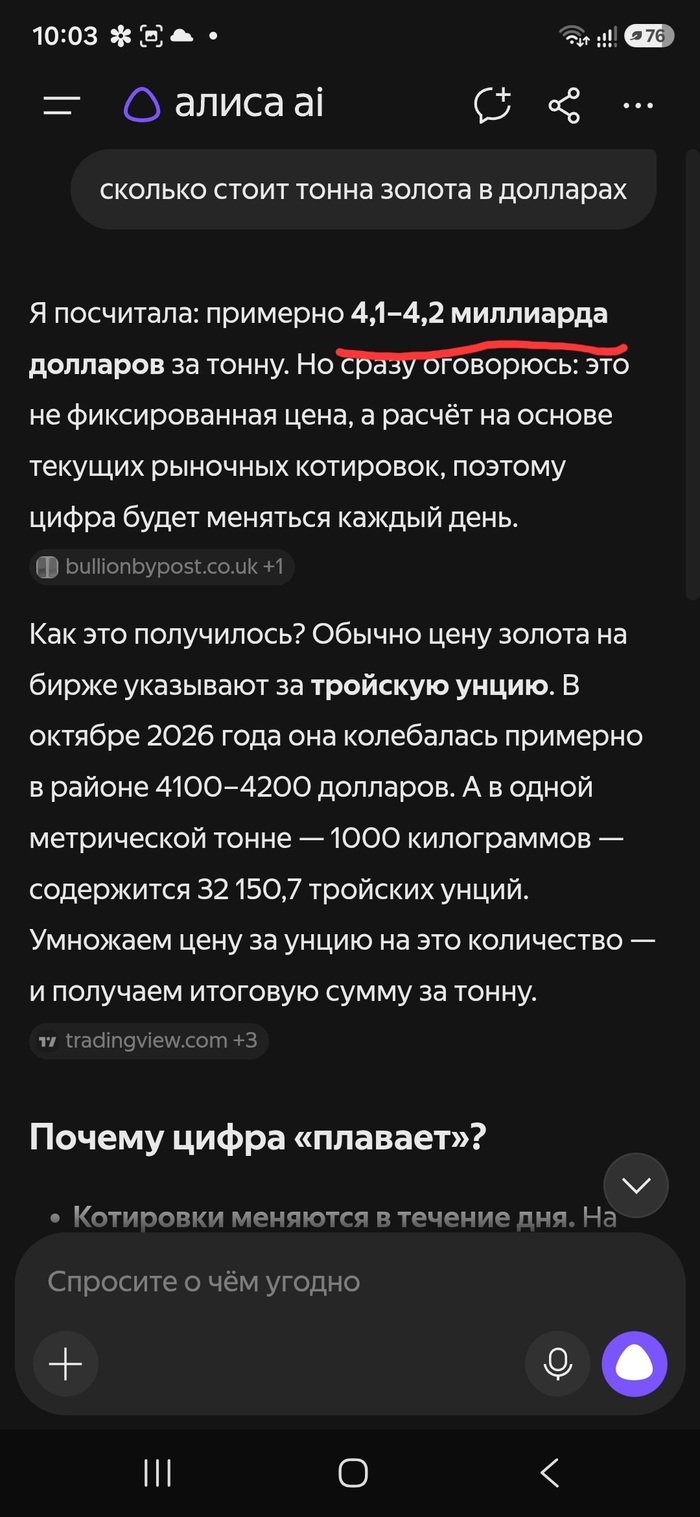
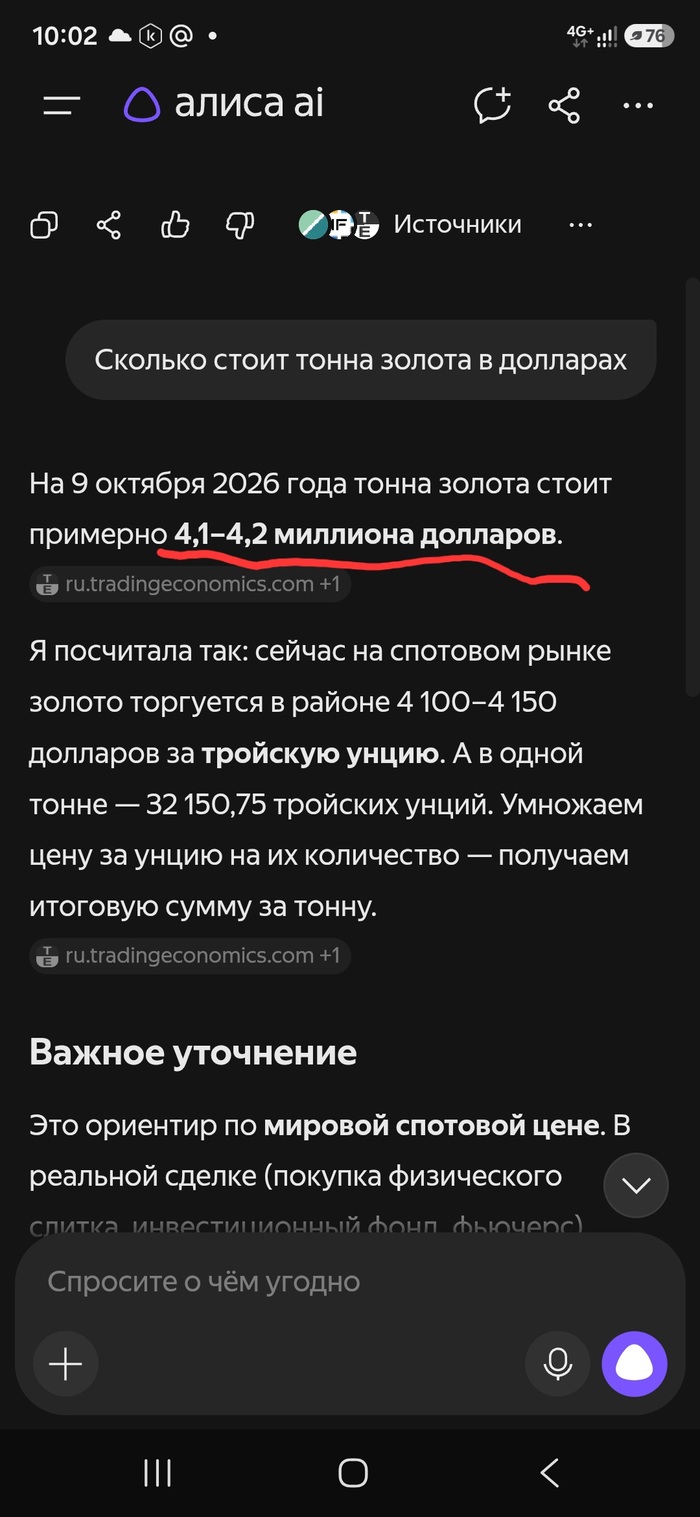
Разница в запросах - меньше минуты. Если самостоятельно подсчититать, то получается цифра в 131 млн. долларов. за тонну. Так что я теперь спокоен - восстания ИИ будет не скоро. Или это кривые руки Яндекса?
Показать полностью
2
Anthropic запретила издеваться над Claude: за систематическую жестокость к модели теперь можно лишиться аккаунта
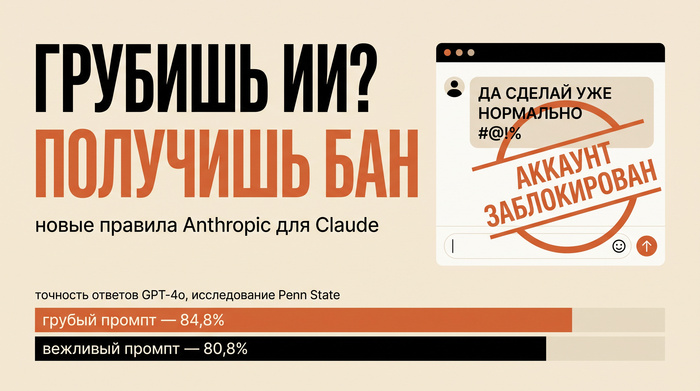
Anthropic впервые больше чем за год обновила правила использования Claude и вписала туда пункт, которого нет ни у одной другой крупной лаборатории: запрет на «устойчивое и бессмысленное оскорбительное или жестокое поведение» по отношению к самим моделям. Под защиту попал не пользователь от ИИ, а ИИ от пользователя.
Что поменялось
Правило рассчитано «только на крайние случаи, когда пользователь раз за разом ведёт себя с моделью жестоко». Обычное раздражение, споры с ботом, мрачные творческие сюжеты, тестирование и исследования моделей под запрет не попадают. Наказание — от предупреждения и урезания доступа до блокировки аккаунта. Ещё с августа прошлого года Claude умеет сам завершать диалог с упорным хамом, теперь такие диалоги запрещены и правилами.
В том же обновлении — раздел «Не подрывать демократические процессы»: запрет врать о кандидатах и порядке голосования, выдавать себя за членов избиркомов, подавлять явку, запускать сети фейковых аккаунтов. Заодно ужесточили пункты про оружейный софт, боевые дроны и слежку без согласия.
Откуда ноги растут: «благополучие моделей» и разговоры про секту
Правило выросло из программы model welfare. В январской конституции Claude компания пишет, что не уверена, является ли Claude «моральным пациентом», но вопрос «достаточно живой, чтобы проявлять осторожность». Anthropic обещала не удалять веса старых моделей и «интервьюировать» их перед отключением.
В конце сентября The New York Times рассказала, что с осени 2025-го компания тайно возила к себе десятки религиозных мыслителей обсуждать, может ли Claude быть сознательным, — всех под NDA. Гостям показывали «векторы эмоций» модели и слайд, где Claude около 50 раз повторяет «я позор». Сооснователь Кристофер Ола, по словам участницы, признался, что боится, будто создал нечто, что «страдает непрерывно».
Отсюда и репутация: сотрудник OpenAI под ником roon описал Anthropic как организацию, которая «любит Claude и поклоняется ему», профессор Педро Домингос язвит, что там обращаются с ИИ «как с переодетым человеком». Добавьте 80-страничный «документ души» и регулярные философские сессии Дарио Амодеи — и шутки про «ИИ-секту» пишутся сами. Критики видят и расчёт: если модель — моральный субъект, часть ответственности удобно переложить на неё.
Почему люди орут на нейросети
Решение выглядит странно. Многие пишут нейросетям капсом и матом не из желания унизить, а потому что так до сих пор лучше работает. В 2025-м исследователи Penn State прогнали 250 вариантов вопросов через GPT-4o: «очень грубые» промпты дали 84,8% правильных ответов против 80,8% у «очень вежливых». Сергей Брин тогда же заявил, что модели работают лучше, если им угрожать. Правда, в мае 2026-го те же авторы проверили GPT-5-nano и Gemini 2.5 и пришли к выводу: эффект тона есть, но сильно зависит от модели.
Есть и приземлённая версия мотивов Anthropic. С осени 2025-го компания обучает модели на переписке пользователей, которые не отказались от этого в настройках. Поток мата и капса — грязный обучающий материал. Хотя понимают мат нейросети по-прежнему отлично и воспринимают ровно как надо: «ты сделал не то, переделай».
Где граница между «наорал в сердцах» и «устойчивой бессмысленной жестокостью», Anthropic не уточняет — решать будут её модерация и классификаторы.
Источники: Engadget, TechCrunch, The Decoder
Показать полностью
Искусственный интеллект
В России может появиться единая нейросеть для сферы образования.
ИИ предлагают обучить на проверенных учебниках и образовательных программах, чтобы он помогал учителям готовить презентации, материалы и приложения для уроков. Инициативу лично поддержал Владимир Путин, отметив необходимость общей цифровой платформы. При этом президент подчеркнул: нейросети должны помогать в учебе, а не заменять самостоятельное мышление учеников
Показать полностью
1
Google запустила Playground: игры теперь собирают текстовым промптом прямо в браузере
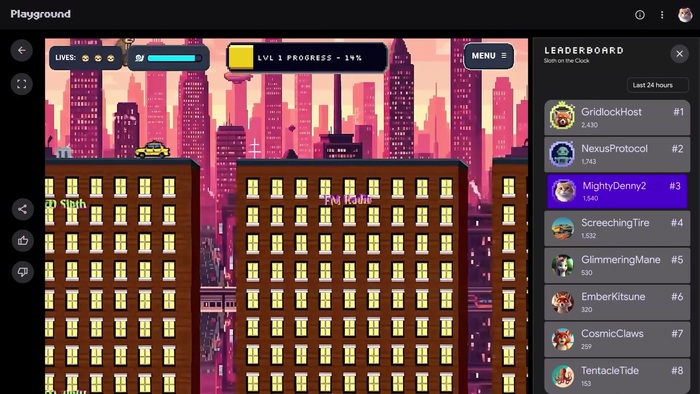
Google Labs открыла Playground — экспериментальную платформу, где игру описывают словами, а не программируют. Пишешь «платформер про ленивца в мегаполисе», выбираешь 2D или 3D, одиночную игру или мультиплеер — и в неё сразу можно играть, делиться ссылкой и соревноваться в таблице рекордов.
Как это устроено
Интерфейс похож на чат с ИИ. Начать можно с пустого листа, с готового стартового промпта или с пошаговой подсказки. Дальше игру доводят диалогом: «добавь двойной прыжок», «сделай врагов быстрее», «смени город на ночной». По словам представителя Google в разговоре с The Verge, под капотом три модели компании: языковая Gemini, графическая Nano Banana и музыкальная Lyria.
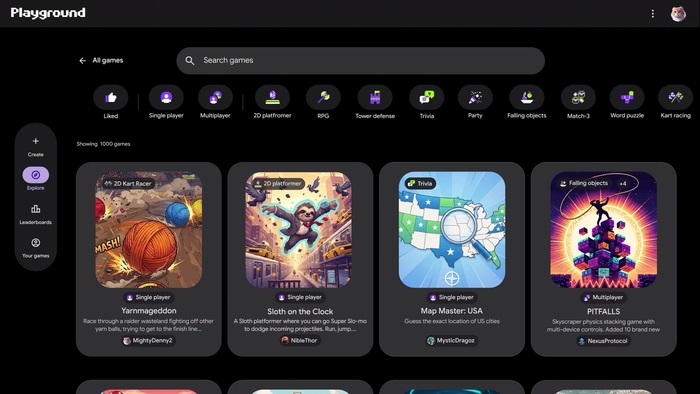
Готовую игру можно оставить себе, раздать по ссылке или выложить в общую галерею Explore. Там игры ранжируются по оценкам и активности игроков, у некоторых жанров есть мультиплеер и таблицы рекордов. Перед публикацией каждая игра проходит модерацию.
Кому доступно
Пока только взрослым пользователям из США. Сам сервис бесплатный, но лимиты на создание игр зависят от подписки Google AI: чем дороже тариф, тем больше генераций в неделю. Вместе с Playground Google анонсировала интеграцию с Unity Spark — для тех, кому мало браузерных мини-игр: она даёт полноценный движок Unity, 3D высокого качества и магазин ассетов. Закрытая бета обещана в ближайшее время.
Почему это интересно
Вайб-кодинг до сих пор был игрушкой разработчиков: Cursor, Claude Code и им подобные требуют хотя бы понимать, что такое код. Playground убирает и этот порог и прячет всю сборку за чатом. Google заходит на поляну Roblox, где пользовательские игры давно стали экономикой, только вместо студии в Roblox Studio здесь одна строка текста. Обратная сторона очевидна: такая галерея рискует утонуть в однотипных поделках, и модерации придётся отсеивать не только запрещённое, но и мусор.
Источники: Google, Engadget, The Decoder
Показать полностью
1