После атаки на Beget в ночь на 2 ноября оператор подтвердил: данные в его облаке – VPS, S3 и Kubernetes – были утрачены, вместе с ними исчезли и бинарные бэкапы VPS. Файловые копии уцелели, но пока недоступны.
Копия была. Но в той же зоне отказа, что и данные, – поэтому авария провайдера забрала обе.
Бэкап на том же хостинге хорошо спасает от собственных ошибок: удалили таблицу, сломали конфиг, откатили неудачное обновление. При недоступности самого провайдера, его панели управления или хранилища такой бэкап может исчезнуть вместе с рабочими данными – либо остаться недоступным в самый неподходящий момент.
Для бизнеса это не абстрактная «недоступность». Это остановленные продажи, сорванные SLA, потерянные заявки и восстановление за свой счёт – у некоторых счёт идёт на миллионы рублей. И особенно больно, когда владелец рассказывает: сайт, база и единственный бэкап лежали у одного провайдера и исчезли разом.
Время задать себе неудобные вопросы
Есть ли хотя бы одна копия за пределами основной площадки или облака? «Другой сервер у того же провайдера» не считается – это не резервная копия, а сосед по камере.
Можно ли до неё добраться без основной консоли – с другими учётными записями и по другому каналу связи? Если только через ту же панель, то в день аварии вы будете искать не бэкап, а вход в панель, которая как раз и лежит.
Отделены ли ключи, права и учётные записи резервных копий от ключей, прав и учётных записей продакшена? Иначе одна скомпрометированная учётка открывает и прод, и бэкапы, а потеря доступа к проду заодно отрезает вас от копий.
Защищены ли копии от удаления и перезаписи политикой хранения? Без этого бэкап – просто файл, который можно случайно перезаписать, а через N дней он ещё и сам удалится по расписанию.
И главный вопрос: команда проверяла полноценное восстановление – или только создание бэкапа? Это два разных навыка, и второй проверяется только руками.
Данные и их единственная резервная копия на одной площадке – это одна точка отказа. Резервная копия должна пережить проблему того места, где работает основная система.
Если тема заходит — выкладываю похожие истории про ИТ в телеге, ссылка в первом комменте. Кстати...
🎅 Red Hat в документации по службе каталогов рекомендует хранить бэкапы на отдельной от продуктивной файловой системе и архивировать отдельно. Бэкап LDAP-данных не стоит держать в том же контуре, что и сам каталог. Иначе вместе с каталогом можно потерять доступ к хранилищу, ключам или управляющей части.
Давайте представим онлайн-кинотеатр в пятницу вечером. Вышла новая серия сериала, который многие ждали полгода, и минут через двадцать в поддержку начинают писать: поиск думает по десять секунд, кнопка «Смотреть» крутит колесо, а у части зрителей новой серии вообще нет в каталоге.
Дежурный открывает Grafana, а там всё зелёное. Процессор базы занят на треть, диск заполнен наполовину, PostgreSQL отвечает на проверки, реплика на месте. Панелей около трёхсот, и ни одна не горит.
Графики при этом не врут. Процессор правда свободен, место правда есть. Только они отвечают на вопрос «жив ли серверр», а человеку с попкорном важно то, сколько он ждёт.
По нашему мнению, у многих команд мониторинг базы собран из того, что легко измерить, и почти не помогает решить, что делать прямо сейчас. Косвенно это подтверждает опрос NeuBird, вендора ИИ-инструментов для дежурных: в феврале 2026 года компания опросила 1039 специалистов по SRE, DevOps и эксплуатации. У 78% хотя бы раз случался инцидент, на который не сработал ни один алерт. А 57% говорят, что по делу меньше 30% их алертов. Опрос вендорский, но картина узнаваемая: уведомлений много, а главное всё равно пропускают.
Что могло сломаться, пока всё зелёное
Для такой истории есть как минимум три сценария, и ни один из них не нагружает процессор.
Первый сценарий связан с очередью блокировок. В 20:55 выкатили миграцию с ALTER TABLE, которая добавляет колонку в таблицу фильмов. Для этого ей нужна самая строгая блокировка таблицы. А по той же таблице в это время идёт аналитический отчёт на двадцать минут. Миграция встаёт ждать отчёт, а все новые запросы к таблице, включая обычные SELECT из поиска, выстраиваются за миграцией. Запросы ничего не считают, они просто ждут, поэтому процессор отдыхает.
Во втором закончились соединения в пуле. Приложение ходит в базу через PgBouncer, а все 50 серверных соединений пула заняли медленные запросы и забытые открытые транзакции. Остальные клиенты стоят в очереди ещё до PostgreSQL, и сама база при этом может быть почти пустой.
В третьем каталог читает с реплики, а реплика отстала. Ошибок нет, просто зритель не находит серию, которая вышла десять минут назад, и жмёт «Обновить» снова и снова, добавляя нагрузку.
Все три проблемы видны в PostgreSQL, если знать, куда смотреть. Спорят о другом: что из этого должно будить дежурного, а что может спокойно лежать на дашборде.
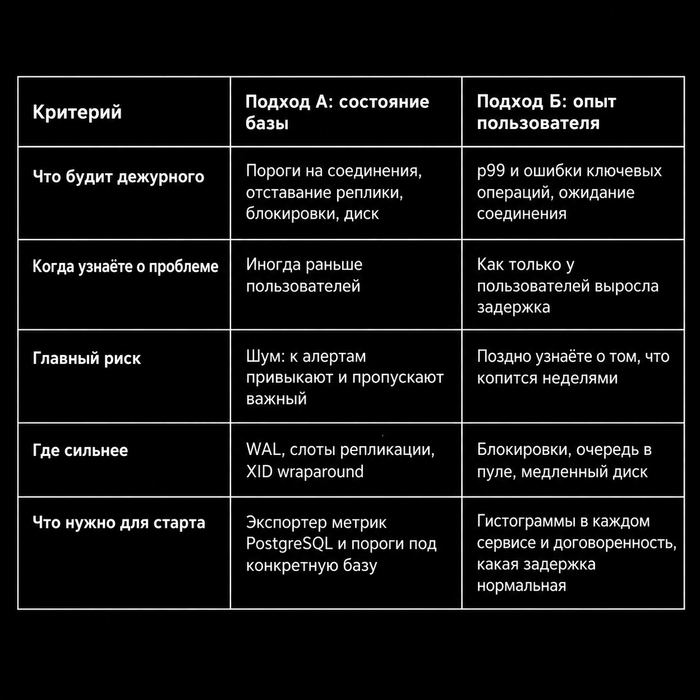
Подход A: будить по состоянию базы
Здесь исходят из того, что база почти всегда предупреждает заранее. Соединения подбираются к лимиту, реплика отстаёт всё сильнее, растёт WAL (журнал, куда PostgreSQL сначала записывает каждое изменение), транзакции висят открытыми. Если поставить пороги на эти показатели, дежурный узнает о проблеме до первой жалобы.
Подводит обычно настройка. Пороги берут из готовых наборов правил и ставят одинаковыми для всех баз: «соединений больше 80%», «реплика отстаёт больше чем на 10 секунд». Для одной базы 80% соединений означают обычный вечер, для другой аварию. Со временем такие алерты начинают пролистывать, а вместе с шумом и настоящую проблему.
На это есть ответ: шум – беда плохих порогов. Порог можно считать от обычного уровня конкретной базы или от скорости роста: «слот держит уже 40 ГБ WAL и прибавляет по 5 ГБ в час». Такой алерт сразу говорит, куда смотреть. Рост p99 сообщает только, что кому-то плохо.
Подход Б: будить по тому, что чувствует пользователь
Здесь всё идёт от книги Google по SRE. Мониторинг там отвечает на два вопроса: что сломалось и почему. «Что» – это симптомы, которые видит пользователь, «почему» – причины внутри системы. Для симптомов предлагают четыре «золотых сигнала»: задержку, трафик, ошибки и насыщение. Если на алерт можно ответить механически, звонить дежурному незачем. Из причин будить стоит только по очень явным и близким, вроде «диск базы закончится через 4 часа».
Для PostgreSQL это значит, что на пейджер, то есть с ночным звонком, идут p99 ключевых операций, доля ошибок и время ожидания соединения. Блокировки, контрольные точки и диск остаются на дашборде, их открывают после того, как сработал симптом.
Минусы у этого подхода тоже есть. Метрики придётся встроить в каждый сервис, и ночью путь от «кому-то плохо» до причины получается длиннее. А главное, некоторые проблемы копятся неделями и никак не задевают пользователя до последнего момента. Когда симптом наконец появляется, база уже отказывается принимать запись.
p95 и p99: почему среднее успокаивает
Допустим, за минуту кнопку «Смотреть» нажали 1000 раз. 980 запросов отработали за 20 мс, а 20 упёрлись в блокировку строки и ждали по 3 секунды. Среднее получается около 80 мс. Вроде бы терпимо, алерт с порогом в 200 мс промолчит. p95, то есть время, в которое укладываются 95% запросов, показывает красивые 20 мс. И только p99 показывает 3 секунды: каждый пятидесятый зритель смотрит на колесо.
Считать процентили стоит по каждой операции отдельно и рядом показывать число запросов. Если поиск и «Смотреть» смешать в одну метрику, быстрый и частый поиск утопит медленную и редкую операцию. А если за час было пять оплат подписки, p99 по ним считать бессмысленно, хватит списка из пяти строк.
И ещё одно. Из стандартной статистики PostgreSQL процентили не достать. pg_stat_statements хранит для каждого запроса число вызовов, среднее, минимальное и максимальное время и разброс, а процентилей там нет. Их считают в приложении, обычно гистограммами в Prometheus, отдельно для ожидания соединения и для выполнения SQL. Так видно, где потерялось время – в очереди к базе или в самой базе.
Блокировки: очередь, которую не видно по процессору
Вернёмся к миграции. Алерт «в базе есть блокировки» тут бесполезен, потому что блокировки есть всегда, на них держится вся конкурентная работа PostgreSQL. Полезен ответ на вопрос, кто ждёт, сколько и из-за кого. Его дают представление pg_stat_activity и функция pg_blocking_pids():
-- кто ждёт блокировку и кто её держит, -- плюс сессии, которые оставили транзакцию открытой SELECT pid, now() - xact_start AS xact_age, now() - state_change AS in_state, state, wait_event_type, pg_blocking_pids(pid) AS blocked_by, left(query, 60) AS query FROM pg_stat_activity WHERE wait_event_type = 'Lock' OR state LIKE 'idle in transaction%' ORDER BY xact_start;
Отдельно присмотритесь к статусу idle in transaction. Запрос закончился, а транзакция открыта, потому что приложение, например, ушло ждать ответа от платёжного сервиса. Такая сессия держит блокировки и мешает очистке старых версий строк. Её можно ограничить через idle_in_transaction_session_timeout, а с версии 17 есть ещё transaction_timeout на всю транзакцию. Его лучше ставить на роль приложения, иначе он оборвёт и долгие отчёты.
Для миграций есть простое лекарство, lock_timeout. Если миграция не получила блокировку за пару секунд, она завершается с ошибкой и освобождает очередь. Повторить попытку придётся самим, PostgreSQL этого не сделает, зато сервис не встанет.
-- перед миграцией: ждать блокировку не дольше 2 секунд SET lock_timeout = '2s'; ALTER TABLE titles ADD COLUMN age_rating text;
Что увидит каждый подход? A сработает на правило «самая старая транзакция старше N минут» и, если повезёт, раньше пользователей. Но ночной отчёт тоже живёт долго, и порог придётся подбирать под каждую базу. B сработает на рост p99 у «Смотреть», а дежурный откроет запрос выше и быстро найдёт виновника. Долгие ожидания блокировок можно писать в лог и сейчас через log_lock_waits, а в PostgreSQL 19 (он пока в бете) его планируют включить по умолчанию и добавить представление pg_stat_lock.
Соединения: база свободна, а очередь стоит
В самой базе обычно смотрят число подключений относительно max_connections. Учтите, что часть мест зарезервирована (superuser_reserved_connections по умолчанию держит 3 слота для суперпользователей). Обычные клиенты упрутся в лимит раньше, чем график покажет 100%.
Если перед базой стоит PgBouncer, главный показатель живёт в нём. В выводе команды SHOW POOLS есть cl_waiting (сколько клиентов отправили запрос и ещё ждут серверное соединение) и maxwait (сколько секунд ждёт самый старый из них). Документация PgBouncer прямо пишет: если maxwait начал расти, пул не успевает обрабатывать запросы.
Подход A поставит здесь алерт на «занято 80% соединений». Подход Б поставит его на время ожидания соединения в приложении или на растущий maxwait. Второй вариант точнее. 80% занятых соединений при пустой очереди означают обычную работу, а секундная очередь бьёт по зрителям, даже если база загружена наполовину.
И не спешите поднимать размер пула или max_connections. Если соединения держат медленные запросы, новые подключения, как правило, только добавят конкуренции за память и диск.
Реплика, WAL и старые транзакции: здесь прав подход A
В pg_stat_replication есть поле replay_lag, задержка применения изменений на реплике. Когда реплика всё догнала и записи нет, оно через какое-то время становится NULL, а у отвалившейся реплики строки в представлении нет вовсе, и алерт на replay_lag промолчит. Если каталог читает с реплики, надёжнее раз в несколько секунд записывать текущее время в служебную строку на основной базе и читать её с реплики (часы серверов должны совпадать). Разница и есть отставание, которое видит зритель.
С WAL всё серьёзнее. Слот репликации запоминает, какой журнал потребитель ещё не забрал, и не даёт его удалить. Если потребителя нет, например реплику выключили или про логического подписчика забыли, слот держит WAL начиная с позиции restart_lsn. Каталог pg_wal растёт, пока не займёт диск, и тогда база остановится. До этого момента пользователь не замечает ничего.
-- запускать на основном сервере: сколько WAL держит каждый слот, -- safe_wal_size: сколько WAL ещё можно записать, пока слот не потеряет -- нужные файлы (заполнен, только если задан max_slot_wal_keep_size) SELECT slot_name, active, wal_status, pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained, safe_wal_size FROM pg_replication_slots;
В PostgreSQL 18 появился idle_replication_slot_timeout. По умолчанию он выключен, а включённый помечает недействительными слоты, которые простаивают дольше заданного времени. Такой слот придётся пересоздавать.
Самое неприятное здесь – переполнение счётчика транзакций (XID wraparound). У PostgreSQL в «окне» около двух миллиардов номеров транзакций, и старые номера нужно периодически «замораживать», этим занимается autovacuum. Если он не успевает, база начинает писать предупреждения, когда до предела остаётся 40 миллионов транзакций. А когда остаётся меньше 3 миллионов, перестаёт выполнять команды, которым нужен новый номер транзакции. Проще говоря, перестаёт принимать запись.
-- возраст самого старого незамороженного XID в каждой базе, -- предел около 2 млрд, принудительную заморозку autovacuum -- по умолчанию запускает после 200 млн (autovacuum_freeze_max_age) SELECT datname, age(datfrozenxid) AS xid_age FROM pg_database ORDER BY xid_age DESC;
Так в феврале 2019 года сломался Mandrill, сервис транзакционных рассылок Mailchimp. На одном из шардов кончились номера транзакций, и сбой длился около 40 часов. Ещё в ноябре 2018-го команда заметила, что счётчик прошёл примерно полпути, и завела в бэклог задачу на дополнительный мониторинг. Первое исключение ночью утонуло среди посторонних ошибок, а алерт на wraparound появился через полчаса после восстановления. Sentry в 2015 году наступил на те же грабли и лежал большую часть рабочего дня в США.
Пока счётчик растёт, p99 идеальный, и подход Б ничего не заметит. Поэтому возраст XID, место под WAL и состояние слотов мы бы держали на пейджере в любом случае. Порог по XID можно ставить с большим запасом, например на миллиард. Примерно на этой отметке Mandrill в ноябре и завёл свою задачу в бэклог. Только задача ждёт своей очереди, а алерт будит.
Диск и контрольные точки: смотреть вместе с задержкой
Во время контрольной точки (checkpoint) база сбрасывает на диск всё, что накопилось в памяти. Из-за неё и из-за диска мы бы ночью никого не будили. С 16-й версии время чтения и записи видно в pg_stat_io, но только при включённом track_io_timing. По умолчанию он выключен, и в колонках времени тогда стоят нули. Ещё в это время попадает чтение из кеша операционной системы, поэтому сам диск проверяют и через iostat или node_exporter.
Если точки из-за заполнения WAL идут чаще раза в 30 секунд, PostgreSQL сам напишет в лог «checkpoints are occurring too frequently» и посоветует увеличить max_wal_size. Разовое сообщение документация просит не считать поводом для тревоги, а частое вместе с ростом p99 на запись стоит разобрать. Только поднимать max_wal_size вслепую не надо: WAL займёт больше места, а восстановление после сбоя может затянуться.
Сравним подходы
Как настроили бы мы
Мы за подход Б на пейджере и за короткий список исключений из подхода A. Дежурного стоит будить, когда пользователям плохо: вырос p99 ключевых операций, выросла доля ошибок, клиенты ждут соединение. И отдельно, когда кончается ресурс, о котором пользователь узнает слишком поздно. Это запас номеров транзакций, место под WAL и состояние слотов, свежесть реплики, если с неё читают. Остальное лежит на дашборде и открывается после первого алерта.
Для каждого алерта мы бы задавали один вопрос. Понятно ли, что делать, если он пришёл в три часа ночи? Если ответ «посмотреть и закрыть», ему место на дашборде.
Хорошее ночное сообщение выглядит примерно так: «„Смотреть“: p99 4,2 с при обычных 300 мс. 37 сессий стоят в очереди к titles за ALTER TABLE (pid 81234), а он ждёт отчёт (pid 80112)». Плохое: «Активных соединений 80%». Первое сразу говорит, кому плохо и куда смотреть. Со вторым дежурный идёт листать те самые триста панелей.
Подход A выигрывает, когда приложение не размечено метриками и разметить его нельзя, скажем, в старом монолите, к коду которого боятся прикасаться. Тогда пороги по базе лучше, чем ничего. Только подбирать их придётся под конкретную базу и её обычную нагрузку, готовые правила из интернета подведут.
А как устроено у вас? Какой алерт PostgreSQL последний раз действительно спас ночь, а какой мигает месяцами, и его давно никто не читает? Если вы уверены, что будить дежурного надо по состоянию базы, расскажите в комментариях, где подход Б вас подвёл.
Получите 15% кешбэка на первое пополнение только в Aéza
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2Ranykm7iYj
p99 fsync против пиковых IOPS сравнивать бессмысленно, поскольку показатели снимают в разных режимах работы накопителя. Для WAL важна хвостовая задержка fsync при подтверждённой записи, тогда как пиковые IOPS обычно получают с глубокой очередью. Вывод действует только для указанной конфигурации: устройства, файловой системы, кэша, sync-метода и нагрузки.
Почему p99 fsync полезнее пиковых IOPS?
p99 fsync показывает границу, ниже которой уложились 99% синхронизаций в прогоне. Пиковые IOPS показывают пропускную способность при заданной очереди и ничего не говорят об одном flush WAL. Но и p99 оценивают только вместе с числом операций, длительностью теста и конфигурацией конкретного хранилища.
Показать, где WAL ждёт подтверждения записи
При COMMIT процесс добавляет запись о завершении транзакции в WAL и вызывает XLogFlush до нужного LSN. PostgreSQL сбрасывает WAL-буферы в файл, затем просит ОС синхронизировать его. При synchronous_commit=on клиент получает подтверждение после локального flush. Если настроена синхронная репликация, время ответа также зависит от ожидания standby и выбранного режима.
Способ синхронизации WAL задаёт wal_sync_method. На Linux по умолчанию используется fdatasync: PostgreSQL пишет WAL через файловый кэш, затем вызывает fdatasync(). Варианты open_datasync и open_sync открывают файл с другими флагами. Семантика каждого варианта разобрана в документации PostgreSQL, а скорость проверяют на файловой системе будущего pg_wal.
Завершённый write() ещё не говорит о сохранности после потери питания, поскольку данные могли остаться в памяти ядра или энергозависимом кэше контроллера. Поэтому хвостовая задержка fsync включает работу ядра, файловой системы и контроллера, а не только запись блока. Перед тестом фиксируют устройство, LVM или RAID, mount options, политику кэша и наличие power-loss protection.
Почему пик операций не предсказывает транзакционную задержку
IOPS измеряют числом завершённых операций за секунду. Высокий результат часто получают с десятками запросов в очереди, чтобы контроллер использовал параллелизм NAND. При одиночном COMMIT это преимущество исчезает, так как транзакция ждёт конкретный flush.
Средняя latency тоже скрывает паузы. Если 9900 синхронизаций заняли 0,2 мс, а 100 заняли 20 мс, среднее составит около 0,4 мс, хотя у 1% транзакций задержка будет около 20 мс. Заявленная p99 задержка хранилища требует единиц, числа выборок и периода. Без них доля медленных операций неизвестна.
Глубину очереди меняют отдельной серией. QD=1 показывает задержку без очереди, а QD=8 или 32 проверяет параллелизм. При синхронном psync значение iodepth выше единицы не создаёт настоящую очередь, поэтому нужен асинхронный engine с direct=1. Полученную пропускную способность нельзя выдавать за задержку WAL и тем более сравнивать с рекламным read IOPS.
Читать p50, p95 и p99 как форму риска
Перцентили относятся к одному распределению. p50 делит выборку пополам, выше p95 остаются 5% операций, выше p99 остаётся 1%. Для 100 000 операций этот хвост даёт около тысячи наблюдений, а для 1000 – только десять, поэтому маленькая выборка сильнее реагирует на шум.
Как измерять fsync при реалистичной нагрузке?
Воспроизведите условия реального WAL: размер синхронной записи, конкурентность, глубину очереди, sync-метод и файловую систему. Измеряйте после прогрева устройства. Затем сохраните полное распределение, число операций и временной ряд вместе с политикой кэша. После микротеста проверьте вывод транзакционной нагрузкой при тех же гарантиях сохранности данных.
Показатели p50/p95/p99 дополняют гистограммой: по ней видно, образует ли хвост один пик или несколько режимов. На графике, где IOPS отложены против задержки, подпишите block size, queue depth, jobs и длительность. Максимум сохраняют отдельно, так как выброс мог совпасть с checkpoint, discard или работой гипервизора.
По временному ряду видно, распределены ли редкие паузы по всему тесту или хвост создал один провал. Всплески сопоставляют с выводом iostat -x 1, телеметрией NVMe и checkpoint.
Повторить размер записи, очередь и конкурентность WAL
Как правило, сначала фиксируют версию PostgreSQL, wal_sync_method, synchronous_commit, объём WAL за секунду и число одновременно завершающихся транзакций. Скорость генерации WAL считают по разнице показаний pg_stat_wal, а конкурентность берут из журналов и метрик за тот же период. Размер синхронной записи берут из реального профиля, а при его отсутствии помечают как допущение. При конкуренции PostgreSQL может подтвердить несколько транзакций одним flush, поэтому число синхронизаций окажется меньше числа COMMIT.
Сначала моделируют одиночную синхронизацию с выбранным размером блока, например 8 KiB: один job, QD=1, тот же каталог и sync-метод. Затем повышают число jobs. Асинхронный QD-тест идёт отдельно, иначе невозможно понять, что дало прирост: конкурентность приложения или внутренняя очередь устройства.
Набор данных и длительность выбирают так, чтобы тест не закончился на быстром кэше. Для виртуального диска указывают thin provisioning, репликацию и локальный кэш. Бенчмарк надёжной записи, упирающийся в RAM или короткий SLC-burst, ничего не показывает. Поэтому в отчёт вносят свободное место, заполнение и способ предварительной записи.
Согласовать pg_test_fsync, fio и транзакционный прогон
pg_test_fsync сравнивает способы синхронизации и выводит среднее время операции. По документации PostgreSQL файл размещают на той же файловой системе, где будет pg_wal. Утилита помогает выбрать wal_sync_method, но не показывает хвост распределения и не предсказывает пропускную способность базы.
В прогоне, опубликованном 27 мая 2025 года, использовались PostgreSQL 16, Samsung 990 Pro, XFS и write-back-кэш. Фрагмент сырого вывода:
На том же сервере, но на Micron 7400 с PLP среднее время fdatasync составило 24 мкс. Полный вывод и топология стенда есть в исходном отчёте, но из-за разной конфигурации это сравнение классов накопителей, а не моделей.
Чтобы получить распределение, используют fio job, в котором заданы engine, block size, QD и длительность. Укажите отдельный тестовый файл: fio перезапишет его и потребует не менее 32 GiB свободного места.
Команда fio wal-fsync.fio --output=wal-fsync.txt --output-format=normal сохраняет отчёт, а percentile_list задаёт перцентили. Для WAL смотрите раздел fsync/fdatasync/sync_file_range. Отдельная асинхронная серия покажет, как меняется задержка NVMe при разной глубине очереди. Затем подтвердите результат в pgbench с -l или прикладном сценарии при тех же гарантиях сохранности данных.
Поймать cache exhaustion, flush и фоновые паузы
Короткий запуск может закончиться до исчерпания быстрого кэша SSD. Поэтому файл предварительно заполняют, устройство прогревают, а тест ведут до устойчивого режима. По временному ряду видно, как после исчерпания SLC-кэша падает пропускная способность или растёт задержка. Там же видны фоновые паузы. Один итоговый p99 смешивает быстрый старт с установившимся режимом.
Перед серией фиксируют write cache, PLP, температуру, прошивку, заполнение, discard и фоновые операции. Что из этого списка недоступно на виртуальном диске, также отмечают в отчёте. Кэш не отключают, поскольку тест повторяет рабочую конфигурацию, а потерю питания проверяют отдельно.
Какой p99 допустим для транзакционной нагрузки?
1. Универсального порога нет: вычтите из SLO время сети, блокировок, CPU и других синхронных шагов.
2. Определите, какую часть остатка можно отдать ожиданию WAL с учётом group commit.
3. Задайте запас и долю нарушений, затем подтвердите порог транзакционным тестом.
p99 fsync 5 мс уже больше, чем весь SLO в 4 мс. При SLO 100 мс такая задержка может поместиться в бюджет только после учёта остальных ожиданий. Результат проверяют после прогрева и при рабочем заполнении диска, а критерий пересматривают при смене прошивки, миграции VM или росте нагрузки.
Связать хвост fsync с SLO транзакций
p99 fsync нельзя напрямую приравнивать к p99 транзакции. В критический путь транзакции входят блокировки, вычисления, сеть, репликация и иногда несколько flush. Group commit объединяет синхронизации, а synchronous_commit=off убирает ожидание локального диска. Поэтому перед сравнением выясняют, какие этапы идут последовательно, а какие перекрываются.
Затем сопоставляются временные ряды. Если пики commit latency совпадают с ростом времени WAL fsync, await и длины очереди, накопитель становится основной гипотезой. Если метрики хранения остаются ровными, задержку ищут в блокировках, CPU или ожидании реплики. Причину подтверждают изменением одного фактора: устройства, sync-метода или профиля нагрузки.
В SLO записывайте порог, долю нарушений, окно и минимальное число операций. Вместе с результатами транзакционного теста нужно сохранить latency histogram, указав границы бакетов и число наблюдений. Размер запаса задаётся до серии. При росте конкурентности тест лучше повторить: очередь и group commit меняют связь между одним flush и числом завершённых транзакций.
Сделать результат проверяемым на другом стенде
К job-файлу и сырому выводу обычно добавляют дату, версии fio, PostgreSQL и ядра, файловую систему и mount options, модель и прошивку диска, RAID/LVM, кэш и PLP, размер файла, block size, QD, jobs, длительность и прогрев. Для VM также указывают контроллер и неизвестные свойства хранилища.
В папку результата положите fio.job, fio.txt, вывод pg_test_fsync, журналы pgbench, iostat, NVMe log и CSV временного ряда. Рядом с графиком приведите перцентили и число операций. Без исходных файлов нельзя проверить единицы, фильтрацию и границы интервала.
У steady-state workload должен быть критерий: например, 10 минут после 5-минутного прогрева или остановка fio по условию steady state. Выбор зафиксируйте в job-файле. В краткой версии публикации оставьте график p99 и ссылку на полную методику.
Хранилище для WAL выбирают по повторяемой задержке подтверждённой записи и по тому, укладывается ли транзакция в свой SLO. Сначала проверьте sync-метод на файловой системе pg_wal, затем снимите распределение задержек в fio и подтвердите вывод транзакционным тестом. Сырой вывод нужен, чтобы не спутать смену накопителя с изменением нагрузки. После такой проверки p99 fsync против пиковых IOPS перестаёт быть выбором между двумя цифрами: для планирования берут p99, измеренный при нужных гарантиях записи и сопоставленный с SLO.
еклама. ООО «Аеза Групп», ИНН: 7813654490. erid: 2RanykUKFPq
Когда система мониторинга отправляет алерт, он редко выглядит так, как хотелось бы дежурному инженеру.
Один источник пишет critical, другой — disaster, третий передаёт severity: 5. В одном payload сервис называется checkout, в другом — payments-api, а в третьем его приходится угадывать по namespace.
Если все эти события приходят через общий Alertmanager или webhook, одной статической настройки маршрута быстро становится недостаточно.
Обычно проблему решают одним из трёх способов:
Усложняют правила на стороне каждой системы мониторинга.
Создают много почти одинаковых endpoint’ов и маршрутов.
Добавляют промежуточный сервис, который преобразует payload перед отправкой в on-call-систему.
Все три варианта работают. А потом появляется ещё одна команда, меняется схема меток, кто-то копирует правило с ошибкой — и распределённая конфигурация начинает жить собственной жизнью.
В IncidentRelay 2.0 мы добавили Event Orchestration. В этой статье разберём одну из основных частей новой функции — Global Orchestration: зачем она нужна, где находится в потоке обработки, как устроены правила и почему мы не ограничились обычным rule engine с кнопкой «Включить».
IncidentRelay Global Orchestration explain trace
Какую задачу решает Global Orchestration
Global Orchestration — это набор упорядоченных правил, принадлежащий группе IncidentRelay. Он обрабатывает нормализованное событие до того, как будет окончательно выбран сервис и запущен обычный жизненный цикл алерта.
Упрощённо поток выглядит так:
Payload интеграции ↓ Аутентификация и нормализация ↓ Global Orchestration группы ↓ Оркестрация выбранного сервиса, если он известен ↓ Обычный жизненный цикл IncidentRelay ↓ Группа алертов, дочерний алерт, эскалация и уведомления
IncidentRelay Global Orchestration
На глобальном уровне можно:
выбрать команду, маршрут и сервис;
нормализовать severity, title и другие поля события;
назначить приоритет и политики;
добавить или удалить метки;
настроить group_key и dedup_key;
подавить уведомления;
отложить создание алерта;
полностью отбросить событие;
поставить безопасный асинхронный webhook в очередь.
При этом оркестрация не заменяет маршруты, сервисы, политики эскалации или хранилище алертов. Она подготавливает событие и явно выбирает, как существующие части системы должны его обработать.
Иными словами, мы добавили не второй жизненный цикл алерта, а слой принятия решений перед ним.
Почему global и service — разные области
В IncidentRelay есть две области оркестрации:
Область
Когда запускать
Типичные задачи
global
Владелец события ещё неизвестен или правило относится к нескольким сервисам
Нормализация, выбор команды и сервиса, общие правила подавления
service
Сервис уже выбран
Политики конкретного сервиса, локальное обогащение, задержка известного сигнала, запуск диагностики
Разделение оказалось важным. Без него глобальное определение быстро превращается в огромный файл со знаниями обо всех особенностях всех сервисов.
Хорошая граница ответственности выглядит так:
Global Orchestration: Кому принадлежит событие? В какой общий формат его привести? Service Orchestration: Как именно этот сервис хочет его обработать?
Глобальное правило может выбрать сервис. После этого IncidentRelay запускает оркестрацию, прикреплённую к выбранному сервису.
Если service orchestration передаёт событие другому сервису, runtime защищает цепочку от циклов и чрезмерного количества переходов. Потому что бесконечная маршрутизация — это тоже вид мониторинга, только уже за состоянием CPU.
Так общие соглашения хранятся в одном месте, а знания о конкретном сервисе остаются рядом с самим сервисом.
Пример: один Alertmanager и несколько команд
Представим, что общий Alertmanager принимает алерты всей production-платформы.
Из payload уже понятно почти всё необходимое. Но статический маршрут не знает, какую комбинацию решений следует принять.
Глобальная оркестрация может выполнить такую последовательность:
Преобразовать fatal в каноническое значение critical.
По application=checkout выбрать команду Payments.
По component=database выбрать сервис Checkout Database.
Для критического события с customer_impacting=true задать приоритет P1.
Построить стабильные ключи группировки и дедупликации.
Остановить дальнейшие глобальные правила маршрутизации.
Передать результат в оркестрацию сервиса и обычный lifecycle.
Почему правила выполняются последовательно
Мы рассматривали вариант, при котором все правила получают один неизменяемый исходный контекст, а затем результаты как-то объединяются.
На бумаге это выглядит функционально и аккуратно. На практике быстро возникает вопрос: что делать, если два правила выбрали разные сервисы или установили разные значения priority?
В текущей модели правила выполняются сверху вниз, а действия внутри совпавшего правила — в указанном порядке. Последующие правила видят изменения предыдущих.
Например:
Правило 1: IF event.severity equals disaster THEN set_severity critical AFTER continue Правило 2: IF event.severity equals critical AND labels.customer_impacting is_true THEN set_priority P1
Второе правило уже увидит critical.
Это позволяет строить определение как понятный конвейер:
Нормализовать значения разных интеграций Добавить общие метки Выбрать владельца Выбрать priority и policies Настроить grouping и deduplication Принять решение suppress / pause / drop Поставить автоматизацию в очередь
Минус у подхода тоже есть: порядок становится частью логики.
Поэтому в execution trace сохраняются совпавшие условия, выполненные действия и значения до и после каждого изменения.
Условия: безопасные пути вместо произвольного кода
В условиях используются dotted paths к разрешённым частям контекста:
ALL ├── labels.environment equals production └── ANY ├── event.severity equals critical └── labels.priority equals p1
То есть:
production AND (critical OR p1)
Шаблоны тоже ограничены
Текстовые действия используют подстановки вида:
{{ labels.service | upper }}: {{ event.title | trim }}
Поддерживается небольшой набор детерминированных фильтров:
lower upper trim default replace truncate
Например:
{{ labels.cluster | default("unknown") | trim | lower }}
Если необязательное поле может отсутствовать, это следует явно обработать через default.
В противном случае ошибка шаблона попадёт в трассировку и будет обработана согласно on_failure действия.
У каждого действия есть одна из трёх стратегий ошибки:
Значение
Поведение
continue
Записать ошибку и перейти к следующему действию
stop_rule
Остановить действия текущего правила
stop_orchestration
Остановить всю оркестрацию
Для необязательного обогащения подходит continue.
Для выбора маршрута или разрушительного действия безопаснее остановить правило или всю оркестрацию, чем продолжать с частично изменённым событием.
Валидация выбранных сущностей
Недостаточно просто получить из правила числовой service_id. Во время выполнения IncidentRelay проверяет согласованность выбранных объектов.
Например, будут отклонены случаи, когда:
маршрут принадлежит другой группе;
route source равен sentry, а источник события — alertmanager;
выбранный сервис принадлежит другой команде, чем маршрут;
escalation policy или notification policy принадлежит другой команде;
выбранный объект был отключён или удалён после публикации версии.
Поведение после такой ошибки зависит от compatibility mode.
Два переключателя режима — и это не одно и то же
У определения есть runtime mode и compatibility mode. Поначалу их легко перепутать.
Runtime mode
Он отвечает на вопрос: влияет ли опубликованная версия на реальные события?
Режим
Что происходит
disabled
Production-события не вычисляются; доступны редактирование, validation и simulation
shadow
Опубликованная версия вычисляется и записывается, но её решения не меняют production
active
Допустимые решения применяются к реальной обработке
Для shadow и active нужна опубликованная версия.
Compatibility mode
Он отвечает на другой вопрос: как оркестрация делит ответственность с существующим lifecycle?
Режим
Что происходит
legacy
Существующая логика остаётся главным источником решений
hybrid
Явные решения оркестрации сохраняются, а старый lifecycle заполняет оставшиеся значения
orchestration
Оркестрация становится главным источником маршрутизации; требуется валидный route
Например, в hybrid:
Оркестрация явно установила priority=P1 → priority policy не заменяет это значение Оркестрация не выбрала notification policy → обычный механизм выбора policy продолжает работать
Если комбинация выбранных сущностей оказалась невалидной, hybrid может отклонить кандидата и продолжить legacy-обработку.
В режиме orchestration аналогичная ошибка блокирует дальнейшую обработку вместо fallback.
Для первого production-внедрения мы рекомендуем hybrid.
Отдельный крайний случай: конфигурация active + legacy не применяет решения оркестрации к production. Слово active здесь относится к runtime mode, но compatibility mode всё ещё оставляет старый lifecycle главным.
Название немного обманчивое, зато конфигурация безопасная. Иногда программное обеспечение шутит само, даже если разработчики не просили.
Simulator: проверить не только счастливый payload
Simulator вычисляет текущий draft изолированно.
Он не:
создаёт алерты;
отправляет уведомления;
вызывает webhooks;
меняет режим выполнения;
публикует версию;
изменяет production-данные.
Можно передать уже нормализованное событие или сырой payload поддерживаемой интеграции.
Во втором случае payload проходит через тот же зарегистрированный normalizer, который используется при production ingestion.
Для каждого важного правила стоит проверить минимум такие события:
Точное совпадение.
Почти совпадающее событие, которое не должно пройти.
Другое окружение.
Другой source.
Отсутствие необязательной метки.
Статус resolved.
Повторное событие, которое должно получить тот же dedup_key.
Результат симуляции содержит:
исходное нормализованное событие;
совпавшие правила;
condition trace;
значения до и после каждого действия;
итоговый контекст;
выбранные сущности;
disposition;
разницу между draft и active version.
Успешная симуляция доказывает, что движок смог выполнить определение. Она не доказывает, что бизнес-решение правильное.
Зелёный HTTP 200 вполне способен сообщить, что вы очень успешно направили все production-алерты команде стажёров.
Grouping и deduplication — тоже часть маршрутизации
Правильный владелец не спасает ситуацию, если каждый повтор создаёт новый алерт.
Так события с одним alert name в одном окружении попадут в общую группу, а каждый instance сохранит собственный дочерний алерт. Повторный сигнал обновит нужный child alert.
Ключи должны быть стабильными.
Временная метка в dedup_key формально допустима, но фактически означает «создавай новый алерт при каждом запросе». Очень удобно, если ваша цель — нагрузочно протестировать дежурного инженера.
suppress, pause и drop — три разных решения
Эти действия легко объединить в голове как «не уведомлять», но последствия отличаются принципиально.
Действие
Результат
suppress
Алерт создаётся и остаётся видимым, но уведомления и эскалация подавляются
pause
Событие хранится как pending и активируется после задержки, если раньше не пришёл resolve
drop
Алерт и группа вообще не создаются
suppress подходит для событий, которые нужно сохранить для поиска или корреляции.
pause полезен для кратковременных сбоев. Например, можно подождать пять минут и отменить создание алерта, если за это время пришёл совпадающий resolve.
drop следует использовать только для сигналов без операционной ценности — например, точно определённого тестового heartbeat.
Пустое условие совпадает со всеми событиями. Поэтому catch-all вместе с drop, suppress, pause или обязательной маршрутизацией требует особенно осторожной проверки.
Catch-all с drop — очень эффективное средство против alert fatigue, примерно как демонтаж пожарной сигнализации против писка разряженной батарейки.
Асинхронные webhooks вместо произвольного кода
Если после совпадения правила нужно запросить диагностику, создать тикет или вызвать внутреннюю автоматизацию, используется переиспользуемое действие enqueue_webhook.
HTTP-запрос не выполняется внутри ingestion request. IncidentRelay ставит выполнение в очередь, а scheduler доставляет его асинхронно с timeout, retry и ограничениями безопасности.
Секретные заголовки хранятся зашифрованными и не возвращаются API. URL проверяются против SSRF, redirects повторно валидируются, а private network targets запрещаются или ограничиваются allowlist согласно конфигурации.
В simulation и shadow mode webhook не отправляется.
Иначе проверка нового правила могла бы создать несколько сотен вполне настоящих задач с заголовком TEST PLEASE IGNORE.
Что получилось в итоге
Global Orchestration дала нам единое место, где разнородные факты мониторинга превращаются в объяснимое операционное решение до начала paging:
интеграции могут сохранять собственные форматы payload;
общие правила нормализации не дублируются по сервисам;
ownership выбирается по содержимому события;
локальная логика остаётся в service orchestration;
каждое решение можно проверить в trace;
draft не влияет на production;
опубликованные версии неизменяемы;
simulation и shadow mode позволяют внедрять изменения без ставки на удачу.
IncidentRelay — open-source и self-hosted. Исходный код доступен на GitHub.
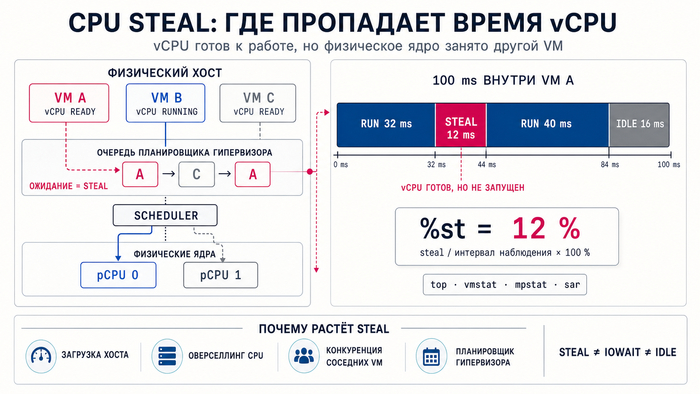
В логах пусто, CPU в норме, но приложение тормозит. Часто виновата метрика, которую игнорируют: cpu steal time, или %st. Она показывает, сколько времени VPS провёл в ожидании физического процессора.
Что такое CPU Steal и откуда он берётся?
На гипервизоре несколько VM делят физические ядра. Когда vCPU готов работать, но планировщик отдал ядро соседней машине, ожидание засчитывается в steal. Так устроен Cloud VPS с общими ресурсами: несколько виртуальных машин конкурируют за физические ядра одного хоста. Steal может расти из-за высокой загрузки гипервизора, оверселлинга, особенностей планировщика виртуализации или кратковременной конкуренции за CPU.
Для наблюдения в динамике – vmstat 1: колонка st показывает steal за каждую секунду. Разбивку по ядрам даёт mpstat -P ALL 1. Для минутного замера с усреднением – sar -u 1 60.
Какие значения считать нормой
На стабильной ноде steal обычно близок к нулю, но универсальной нормы нет: многое зависит от типа нагрузки и платформы виртуализации. Практические ориентиры:
• 0–1% – обычно не вызывает проблем
• 3–5% – повод проверить динамику и сопоставить её с задержками приложения
• >10% – часто заметно влияет на производительность, особенно у чувствительных к задержкам сервисов
Смотрите на устойчивое значение за 10–15 минут, а не на пиковый выброс.
Что делать, если steal стабильно высокий
Сначала подтвердите устойчивость: sar -u 1 600 даст картину за 10 минут. Если steal держится выше 5%, стоит обратиться в поддержку провайдера: причина может быть в конкретной ноде, тарифе или особенностях инфраструктуры. Иногда помогает миграция на другой хост, но сначала лучше подтвердить проблему вместе с поддержкой. Если ситуация повторяется, рассмотрите тарифы с выделенными CPU-ядрами или смену провайдера.
Быстрый мониторинг VPS: чек-лист
• Запустите top, найдите строку %Cpu и проверьте %st
• Понаблюдайте за vmstat 1 в течение 30–60 секунд
• Сравните пики steal с замедлениями приложения
• Если steal стабильно выше 5%, зафиксируйте замеры и передайте их в поддержку
• Рассмотрите тариф с выделенными ядрами, если проблема системная
Запустите диагностику прямо сейчас хватит одной команды. Если steal стабильно высокий и совпадает с замедлениями приложения, сначала проверьте инфраструктуру, а уже потом ищите проблему в коде.
Это open-source система для on-call дежурств и алертов, которую можно поставить у себя.
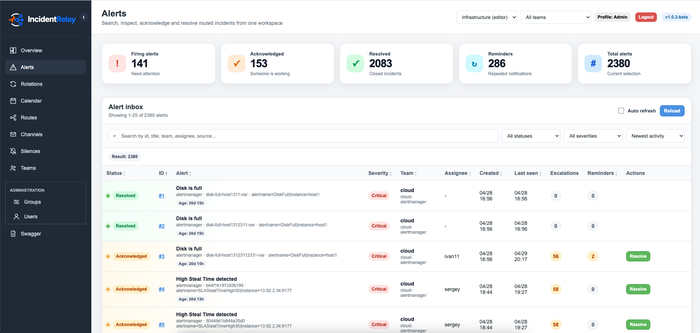
Если по-человечески: когда ночью что-то ломается, IncidentRelay помогает понять, кому звонить, куда отправлять уведомление, кто сейчас дежурный, почему алерт попал именно в эту команду, и что вообще произошло. Ну то есть занимается тем, что обычно в маленьких командах живёт в голове у одного человека, который “вроде помнит, как оно настроено”. Спойлер: он не всегда помнит.
Мы сделали IncidentRelay self-hosted, потому что не всем хочется тащить весь incident workflow во внешний SaaS. Иногда хочется просто поставить у себя, подключить Alertmanager/Grafana/Zabbix/Sentry/LibreNMS/что-нибудь-webhook, настроить команды, ротации, каналы и жить чуть спокойнее. Хотя “спокойнее” в мире on-call звучит как смелое заявление.
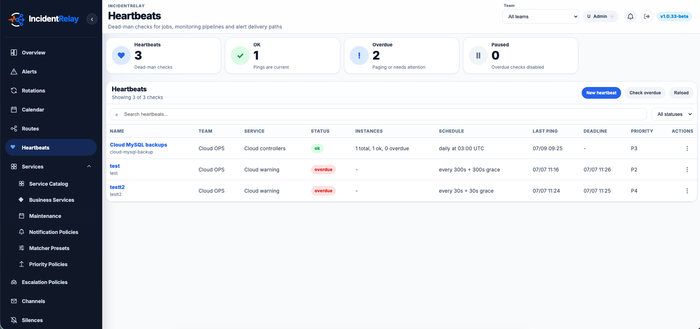
IncidentRelay Heartbeat
Что умеет:
- принимать алерты из разных систем мониторинга; - маршрутизировать их по командам и сервисам; - понимать, кто сейчас дежурит; - слать уведомления в Mattermost, Slack, Telegram, email, browser push, webhook и даже voice call; - делать ACK/Resolve; - напоминать и эскалировать; - учитывать maintenance windows; - глушить шумные алерты через silences; - показывать календарь дежурств; - делать CalDAV/ICS-подписки; - группировать похожие алерты; - показывать Explain Trace: почему система решила именно так; - отслеживать сервисы, зависимости и impact; - проверять Heartbeats, когда задача должна была прислать “я жива”, но решила уйти в молчание.
За 5 месяцев от первой версии до 1.1 проект оброс довольно большим количеством функций. Начиналось всё с базового alert flow, Telegram-действий и фильтров. Потом понеслось: ротации стали многоуровневыми, появились escalation policies, сервисный каталог, SLI/SLO, Business Services, heartbeats и отдельная логика impact.
Самым сложным неожиданно оказался не “принять webhook и отправить сообщение”. Это как раз весёлая часть. Сложным оказалось понять, как правильно считать влияние сервисов друг на друга.
Вот есть сервис A, от него зависит B, от B зависит C, у C алерт, у A degraded, у B maintenance, где-то P2, где-то critical, а бизнес-сервис сверху должен показать понятный статус. И желательно не писать пользователю “всё горит”, если на самом деле горит только маленький угол. Но и не писать “всё нормально”, если этот маленький угол держит половину продукта. Тут начинаются настоящие разговоры с графом зависимостей. Иногда граф смотрит в ответ. Осуждающе.
Отдельно пришлось повозиться с визуализацией графа. Потому что граф сервисов в UI легко превращается в тарелку лапши: линии везде, подписи пересекаются, root cause где-то спрятался, downstream impact убежал за край экрана. Пришлось продумывать расположение, уровни, подсветку и то, как показать пользователю не просто красивую картинку, а полезную информацию.
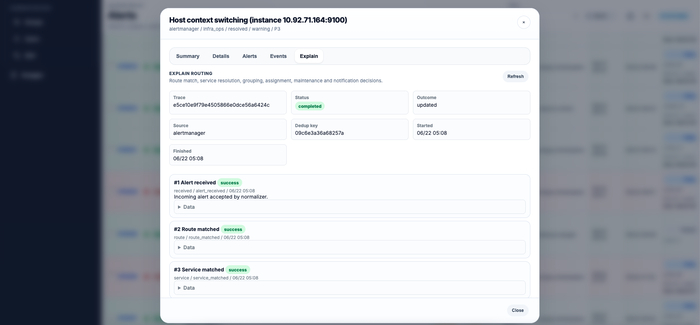
Ещё одна штука, которой мы довольны, - Explain Trace. Это когда можно открыть алерт и увидеть: какой route сработал, какие matchers совпали, почему алерт сгруппировался, почему уведомление ушло или не ушло. Очень помогает в ситуации “почему меня разбудило в 03:17”, хотя честный ответ иногда всё равно “потому что ты дежурный, прости”.
В релизе 1.1 также есть Heartbeats. Это проверки для задач, которые должны периодически сообщать “я завершилась успешно”. Backup, ETL, watchdog, агент на сервере. Если ping не пришёл - создаётся обычный алерт. Есть multi-instance режим, чтобы один живой сервер не прикрывал пятерых молча умерших товарищей.
Разворачивается через Docker Compose, RPM, systemd или Helm. Маленькие установки могут жить на SQLite, для production лучше PostgreSQL. Лицензия MIT.
С тех пор проект добрался до v1.0.21-beta. Цепочка стала длиннее, но пользоваться системой стало проще. В отличие от некоторых корпоративных процессов, здесь усложнение действительно пошло на пользу.
Не буду пересказывать весь changelog. Расскажу о нескольких изменениях, которые сильнее всего повлияли на продукт.
Дежурства стали похожи на настоящие
Простая ротация выглядит красиво: несколько инженеров по очереди дежурят сутки. Потом в неё приходят рабочие часы, выходные, отпуска, разные часовые пояса и человек, который только в пятницу вечером вспоминает, что завтра улетает.
Поэтому в IncidentRelay появились многослойные ротации. У каждого слоя могут быть свои:
участники и приоритет;
временные ограничения;
часовой пояс;
правила передачи смены.
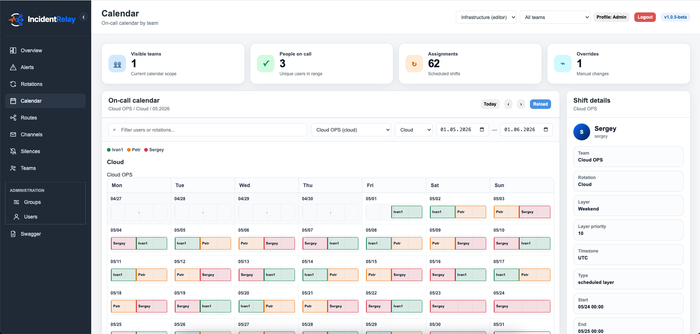
Поверх расписания работают временные замены. Календарь показывает уже итоговый результат после применения всех слоёв и overrides.
Расписание можно подключить к Google Calendar, Outlook, Apple Calendar и другим клиентам через ICS или read-only CalDAV. Пользователи также могут получать уведомления о предстоящих сменах.
Появился On-call Health. Он заранее ищет пустые слои, неактивных участников, разрывы в расписании, маршруты без получателя и проблемы с каналами уведомлений.
Лучше увидеть красный индикатор днём, чем обнаружить ночью, что единственный дежурный существует только в базе данных.
Двадцать алертов теперь могут стать одним инцидентом
Одна проблема редко присылает одно аккуратное сообщение. Обычно сначала жалуется база, потом API, затем очередь, а через минуту к обсуждению присоединяется всё, у чего есть доступ к Alertmanager.
Теперь IncidentRelay умеет группировать связанные события по сервису, окружению, кластеру, имени алерта и другим labels.
Для группы можно:
задержать первое уведомление;
настроить периодические обновления;
выполнить ACK или Resolve сразу для всей группы;
объединить несколько групп вручную;
оставить комментарии и сохранить историю расследования.
Исходные алерты при этом не теряются. Дежурный получает одну развивающуюся историю вместо серии сообщений с одинаковым смыслом и разной пунктуацией.
Появилось понимание того, что именно сломалось
Раньше IncidentRelay хорошо отвечал на вопрос «кому отправить алерт», но почти ничего не знал о самом объекте аварии.
Теперь в системе есть каталог сервисов. Для каждого сервиса можно задать владельцев, критичность, окружение, runbooks, ссылки, правила сопоставления с алертами и зависимости от других сервисов.
На основе зависимостей система показывает:
возможную первопричину;
затронутые сервисы;
путь распространения проблемы;
общий blast radius.
Также появилась аналитика: сгруппированные инциденты, объём сырых алертов, дедупликация, уровень шума и время реакции.
Это не замена observability-платформе. Задача скромнее: избавить дежурного от традиционного ритуала поиска актуального runbook среди wiki, старого чата и ссылки, которая «точно работала в прошлом квартале».
Инцидент больше не заканчивается на ACK
ACK сообщает, что алерт кто-то увидел. К сожалению, он не ремонтирует базу данных. Мы проверяли.
Поэтому в IncidentRelay появились:
приоритеты от P1 до P5;
автоматическое повышение приоритета по severity;
запрос дополнительных responders;
stakeholders и настройки их уведомлений;
комментарии и timeline;
maintenance windows.
Maintenance window можно привязать к группе, команде, сервису или маршруту. Во время работ система может отключить уведомления, не создавать новые инциденты или временно остановить эскалации.
Поддерживаются часовые пояса и повторяющиеся правила RFC 5545. Потому что любое простое окно обслуживания рано или поздно превращается в «каждый второй вторник, кроме праздников и последней недели квартала».
Теперь система объясняет свои решения
Самая заметная новая функция называется Alert Explain Trace.
Если алерт не дошёл или попал не в ту команду, больше не нужно вручную воспроизводить всю конфигурацию. IncidentRelay записывает этапы обработки входящего события.
В трассе видно:
Был ли принят payload.
Какой route совпал.
Какой service был найден.
В какую группу попал алерт.
Сработали ли silence или maintenance window.
Как выбрали дежурного.
Какие уведомления были отправлены или пропущены.
Интеграция получает trace_id, по которому результат можно открыть в UI или запросить через API.
Для self-hosted продукта прозрачность особенно важна. «Система решила именно так» звучит гораздо убедительнее, когда рядом есть список причин, а не только уверенный зелёный индикатор.
Что получилось
За месяц IncidentRelay вырос из маршрутизатора алертов в более связный workflow:
Alert -> Route -> Service -> Group -> Priority -> Escalation -> On-call -> Responders -> Notifications -> Resolution
Проект всё ещё находится в beta и активно развивается. Впереди новые интеграции, улучшение аналитики и более простая установка. Но уже сейчас система умеет не только разбудить дежурного, но и объяснить, почему выбрала именно его. В мире on-call это почти проявление вежливости.
Опубликован проект IncidentRelay, развивающий открытую систему для организации дежурств, маршрутизации оповещений и сопровождения инцидентов, запускаемую на собственном сервере (self-hosted). Проект ориентирован на SRE, DevOps и инфраструктурные команды, которым требуется локально разворачиваемая альтернатива SaaS-сервисам для управления дежурством (on-call management), применения политик эскалации и реагирования на инциденты. Код проекта написан на Python и распространяется под лицензией MIT.
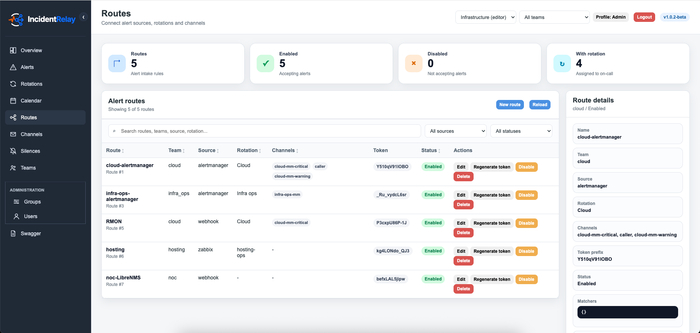
IncidentRelay принимает события из систем мониторинга, сопоставляет их с правилами маршрутизации и доставляет уведомления ответственным дежурным или командам. В системе реализованы расписания дежурств, ротации, переопределения смен, подтверждение получения инцидента, перевод инцидента в resolved, напоминания, эскалации и silences для подавления известных или плановых срабатываний.
Поддерживается приём событий из Prometheus Alertmanager, Zabbix и произвольных webhook-ов. Для отправки уведомлений предусмотрены каналы Mattermost, Telegram, email, webhook и голосовые провайдеры. В Mattermost и Telegram уведомления могут содержать действия для подтверждения и решения проблемы, что позволяет обрабатывать инцидент без перехода в отдельный интерфейс.
В IncidentRelay предусмотрена модель разделения доступа по группам и командам. Это позволяет разграничить видимость расписаний, маршрутов, каналов уведомлений и алертов между различными командами. Для автоматизации доступен HTTP API, а для интеграций используются bearer-токены и route-токены.
Проект может применяться как промежуточный слой между системами мониторинга и каналами уведомлений: Alertmanager или Zabbix отправляет событие в IncidentRelay, после чего система определяет команду, текущего дежурного, применяет правила маршрутизации и отправляет уведомление в нужный канал. Для неподтверждённых инцидентов могут выполняться повторные напоминания и эскалация на следующего участника ротации.