
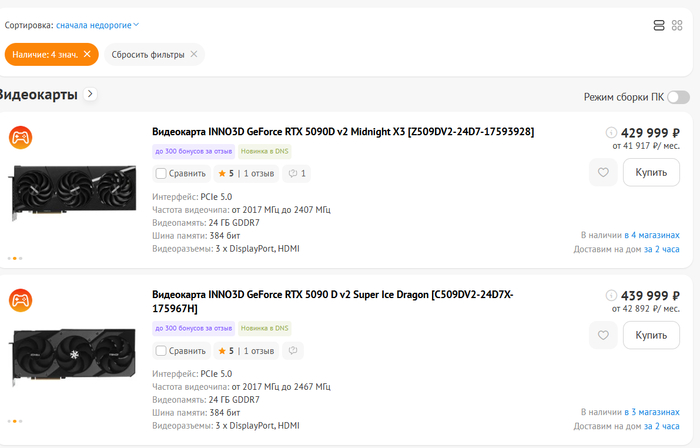
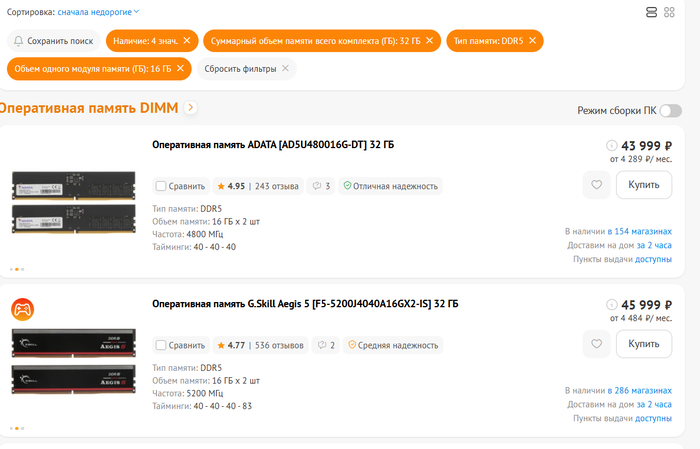
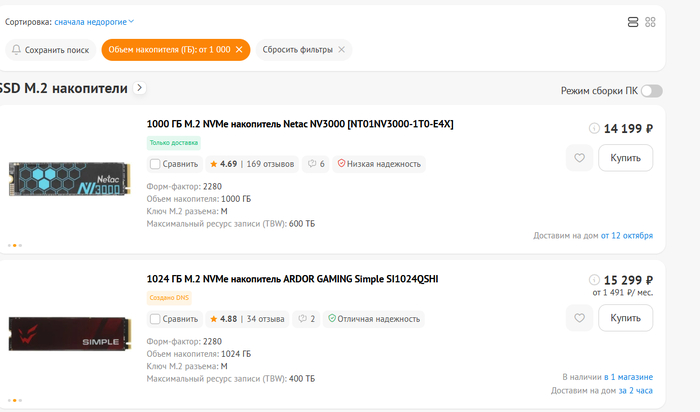
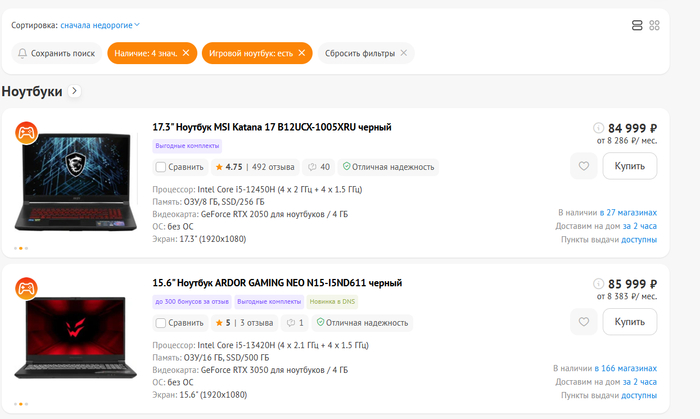
Еще один мемасик из прошлого оказался пророческим) Какие майнеры? Но есть нюанс)

Показать полностью
5
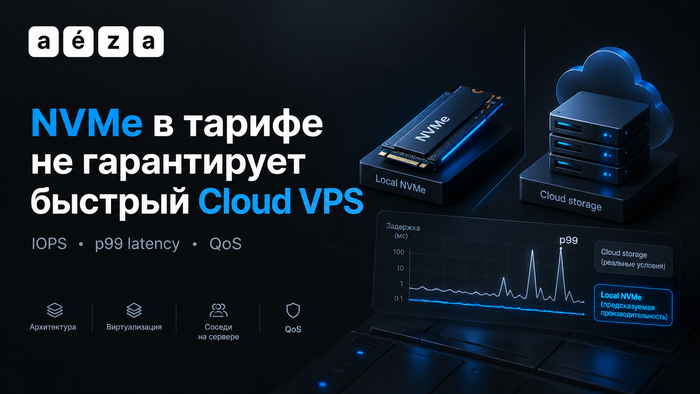
Сравнение Local NVMe и облачного хранилища в Cloud VPS: влияние IOPS, p99 latency, QoS, виртуализации и соседей по серверу на производительность диска.
Пометка NVMe в тарифе не гарантирует предсказуемых задержек для Cloud VPS. Реальные характеристики дисковой подсистемы зависят от архитектуры хранилища, QoS-политик и уровня виртуализации I/O. NVMe важен, но не решающий фактор.
Производительность VPS под дисковой нагрузкой ограничивается несколькими факторами одновременно. QoS-политика и burst-лимиты IOPS могут влиять на результат не меньше, чем тип накопителя. Виртуализация I/O через virtio добавляет небольшой накладной расход. Конкуренция соседей по хосту даёт непредсказуемость p99-задержек.
Local NVMe даёт наименьшую задержку: p99 в пределах 100–300 мкс. Сетевые решения (NVMe-oF, Ceph RBD, SDS) повышают p99 из-за сетевого round-trip, зато включают репликацию и снапшоты. Выбор NVMe VPS оправдан для stateful-нагрузок с жёсткими требованиями к fsync-задержкам.
PostgreSQL и MySQL создают смешанную дисковую нагрузку: случайное чтение небольших блоков, fsync для WAL и последовательные сканирования. В продакшен-среде на Cloud VPS p99-задержка fsync напрямую влияет на задержку коммита. Burst-лимиты могут скрывать ограничение дисковой подсистемы до тех пор, пока нагрузка не превысит гарантированный уровень IOPS.
Классическая ошибка: фиксировать средний throughput вместо p99-latency. Запускайте fio с параметрами --rw=randread --bs=4k --iodepth=32 и смотрите процентили задержки. Утилита ioping показывает задержку одиночного I/O. Для PostgreSQL используйте pgbench после нескольких прогонов на прогрев кэша.
• Гарантированные IOPS и burst-лимит вашего VPS
• Архитектура хранилища: локальный NVMe или распределённое хранилище
• Есть ли гарантии по p99-задержке
• Схема репликации и RPO при сбое диска
• Доступность снапшотов и периодичность их создания
• Наличие оверкоммита и политика изоляции I/O
Тип диска в тарифе – это отправная точка. Перед миграцией проверьте дисковую подсистему по чек-листу и прогоните собственные тесты: реальные p99-задержки и стабильность IOPS могут отличаться от описания тарифа.
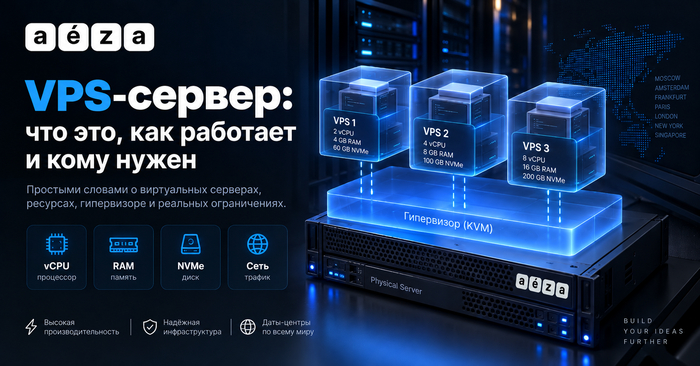
VPS-сервер даёт отдельную ОС и административный доступ без аренды целого физического узла. Такой формат подходит сервисам с постоянным адресом и предсказуемой нагрузкой. При выборе такого сервера важны технология виртуализации, ограничения CPU, памяти, диска и сети, а также то, где проходит граница ответственности. У двух тарифов с одинаковым описанием эти условия могут конкретно отличаться.
VPS это виртуальная машина с гостевой ОС, которую физический хост запускает через гипервизор. Пользователь получает административный доступ, IP-адрес, виртуальные диски и заданные лимиты ресурсов, а провайдер обслуживает физический хост и слой виртуализации. Реальная изоляция и гарантии зависят от технологии виртуализации, модели распределения и условий тарифа.
Физический сервер делят на несколько виртуальных машин, каждая из которых запускает собственное ядро ОС, хранит отдельную файловую систему и работает со своими пользователями, процессами и сетевыми настройками. Процессы одной машины не видят файлы и память другой, хотя оборудование у всех гостей общее.
Тариф VPS обычно включает vCPU, RAM, диск, IP-адрес, лимит трафика либо скорость порта. Панель провайдера управляет питанием виртуальной машины, переустановкой образа и консолью. Она не заменит вашу работу внутри ОС: веб-сервер, база данных, обновления, учётные записи и резервные копии остаются задачей администратора, если договор не обещает иное.
Административный доступ даёт свободу выбора ПО, но вместе с ней и всю ответственность за то, что внутри: ошибка в условном sshd_config, открытая база данных или удалённый файл находятся внутри гостевой системы, поэтому просто наличие гипервизора их не исправит. Перед заказом нужно проверить, кто устанавливает обновления, реагирует на инциденты и восстанавливает данные.
На Linux-хосте модуль KVM использует аппаратные расширения CPU и открывает пользовательскому пространству API для работы с виртуальными машинами. Каждая VM обычно работает как отдельный процесс QEMU. Он выполняет код гостя через KVM и предоставляет модель устройств. Слой управления, обычно libvirt, задаёт vCPU, память, диски, сетевые интерфейсы и правила запуска. Созданный таким способом VPS сервер видит виртуальное оборудование и загружает собственную ОС как отдельную машину.
Схема этих слоёв такая:
CPU, RAM, NVMe и NIC физического хоста → ядро Linux с KVM → процесс QEMU и virtio-устройства → гостевая ОС → приложение
Планировщик хоста выделяет каждой vCPU процессорное время наравне с потоками других виртуальных машин, а закрепление за физическим ядром, квоты и оверкоммит зависят от конфигурации площадки. С памятью и устройствами так же, то есть гость работает не с железом напрямую, а с тем, что даёт ему процесс QEMU. Память живёт в его адресном пространстве, дисковые и сетевые операции идут через паравиртуальные очереди virtio.
Изоляция действует на уровне виртуальной машины, а физические CPU, накопители и сеть остаются общими. Поэтому для сравнения вариантов обычно нужны правила распределения ресурсов и тест на своей нагрузке, потому что просто факта наличия гипервизора недостаточно.
Число vCPU показывает, сколько виртуальных процессоров видит гостевая ОС. Частоту, поколение CPU, квоту процессорного времени и степень конкуренции на хосте нужно выяснять отдельно. Для постоянной вычислительной нагрузки важны длительная производительность и задержка планирования. В Linux показатель %steal показывает время, когда гостевая vCPU была готова к работе, но гипервизор не дал ей процессор. Причину замедления одна эта метрика не покажет.
Объём RAM задаёт доступную гостю память. Поведение при её нехватке зависит от гарантий тарифа, ballooning, политики оверкоммита и swap на хосте. Частая выгрузка страниц увеличивает задержки, поэтому базе данных полезнее гарантированный объём с запасом под рабочий набор, чем большое номинальное число без условий.
NVMe обозначает протокол доступа к накопителю. Производительность определяют лимиты IOPS и throughput, размер блока, глубина очереди, доля чтения и записи. На результат также влияют кэширование и конкуренция. Лимит в 3000 IOPS при блоке 4 КиБ даёт примерно 11,7 МиБ/с случайного потока. Реальная цифра будет ниже из-за файловой системы и очередей, а последовательное чтение ограничит уже лимит throughput.
У сети есть несколько границ: скорость порта, трафик, пакеты в секунду, исходящий лимит и маршрут до пользователей. В тарифах Cloud VPS обычно есть API, почасовое создание ресурсов и сетевые сервисы. Но сможете ли вы быстро добавить ресурсы в пик и есть ли под это физический резерв – зависит от договора, а не от названия тарифа.
VPS даёт собственную ОС, административный доступ и лимиты ресурсов, тогда как виртуальный хостинг делит готовое окружение без полного контроля. Выделенный сервер предоставляет весь физический узел одному клиенту. Managed-тарифы и гарантии CPU, памяти или диска у разных поставщиков могут заметно различаться.
В unmanaged-тарифе провайдер обычно обслуживает физический хост, гипервизор, питание и внешнюю сеть, а пользователь управляет гостевой ОС: создаёт учётные записи, устанавливает пакеты, закрывает порты, следит за журналами и обновляет приложения. Точные границы ответственности задаёт договор, особенно для DDoS-защиты, резервных копий и аварийного доступа.
В managed-тарифе часть операций берёт на себя поставщик, но точный состав услуги всё ещё определяет договор. Базовый вариант может включать только первичную установку, а расширенный добавляет мониторинг, обновления, реакцию на алерты и восстановление. До заказа стоит проверить часы работы поддержки, допустимый стек, число обращений, способ эскалации и перечень действий при сбое.
Панель управления упрощает работу с доменами, сертификатами, почтой, базами и веб-серверами. Даже полностью настроенный VPS не становится managed-сервисом, если никто не отвечает за обновления, резервирование и ночные инциденты. Снапшоты тоже не равны полноценной резервной копии, так как они могут находиться на той же платформе и не подтверждают корректное восстановление приложения.
Проще всего свести всё это в одну таблицу и посмотреть, где не окажется владельца. В строках – ОС, firewall, приложения, мониторинг, копии и восстановление, в столбцах – кто отвечает, за какой срок реагирует и каким пунктом договора это закреплено. Ярлык managed становится проверяемым только после того, как такая таблица заполнена целиком.
Небольшие сайты, API, боты, системы мониторинга, Git-раннеры и тестовые среды часто помещаются на одной виртуальной машине. Им нужен постоянный IP-адрес, контроль пакетов и возможность запускать фоновые процессы. При умеренном рабочем наборе такой VPS сервер проще в эксплуатации, чем выделенный узел, а тариф можно сменить после измерений.
У тяжёлой базы данных постоянная загрузка vCPU, большой объём RAM и интенсивная запись, поэтому конкуренция за общие ресурсы бьёт по ней сильнее всего. Обучение и инференс упираются в ускоритель, а обычный тариф VPS его не включает. Сервису с резкими пиками может больше подойти облачная группа экземпляров.
В таблице собраны типовые варианты. Числа здесь – отправная точка для теста, проверять их всё равно нужно на своей нагрузке.
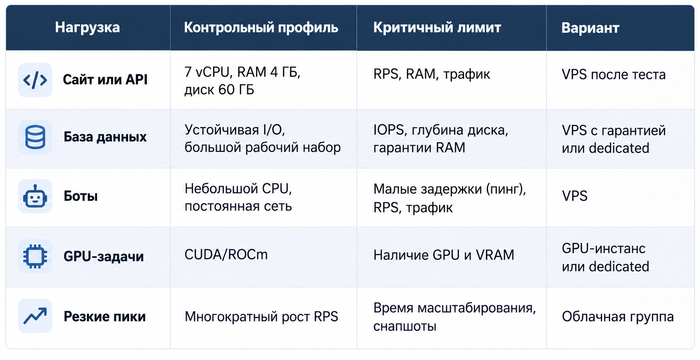
Проверять всё равно придётся прогоном, так как приложение с 2 vCPU и 4 ГиБ RAM может работать устойчиво при одном профиле запросов и упираться в память при другом. Решение обычно принимают по рабочему набору, p95/p99 задержки, очередям диска и запасу до лимитов.
Выбор начинается с измерений текущей системы. Для CPU нужны загрузка по ядрам, длительность насыщения и задержка запросов, для памяти – рабочий набор, page faults и swap. Диск оценивают по IOPS, throughput и p95/p99 latency, сеть по средней и пиковой скорости, PPS и исходящему трафику. Если исходной системы нет, начните с минимального тарифа и прогоните воспроизводимый тест. Если упрётесь в лимит, увеличьте только тот ресурс, который его создал, и повторите замер.
Например, тариф может включать 2 vCPU, 4 ГиБ RAM, 60 ГиБ диска, 3000 IOPS и порт 100 Мбит/с. Без модели CPU, квоты, типа диска, лимита throughput и правил трафика этих цифр недостаточно для оценки. VPS или VDS сервер в названии тарифа тоже ничего не говорит о способе виртуализации, поэтому смотреть нужно договор и технические параметры.
Базовый профиль после запуска составляют по данным за обычный рабочий период. В него входят загрузка CPU, %steal, свободная память, swap, дисковая задержка, ошибки файловой системы, сетевые потери и прикладные p95/p99. Переход на более крупный тариф логичен, если ресурс регулярно приближается к лимиту, а одновременно растут задержки или число ошибок. Обычный короткий пик не требует постоянной оплаты лишних ресурсов.
Расположение площадки определяет задержку до пользователей, а иногда и то, где по закону можно хранить данные. В условиях резервного копирования должны быть названы частота, срок хранения, место размещения и время восстановления. До миграции также важно узнать, как увеличивается диск, меняется тариф, выдаются адреса и выполняется перенос между регионами.
Сайты, API и небольшие базы с измеримым и относительно стабильным профилем нагрузки.
Боты, мониторинг, Git-раннеры и тестовые среды, которым нужен постоянный сетевой узел.
Сервисы с собственной ОС и административным доступом, если их лимиты подтверждены тестом.
При первом подключении SSH-отпечаток желательно сверить через доверенный канал. Затем нужно создать отдельную учётную запись, добавить публичный ключ и проверить новый вход. Парольную авторизацию и прямой вход root лучше отключить, но только при наличии рабочего ключа и резервного доступа через консоль.
Firewall открывает лишь необходимые входящие порты, пакеты ОС и приложений обновляются по выбранному графику, а сервисы работают с минимальными привилегиями. Стоит иметь в виду, что VPS изолирует машину, а не код внутри неё. Уязвимый плагин, утёкший токен или ошибочное правило доступа остаются вашей зоной ответственности.
Резервная копия должна пережить потерю виртуальной машины и учётной записи управления, поэтому данные хранят отдельно, шифруют и периодически восстанавливают в чистое окружение. Успешный статус задания подтверждает создание копии, а тест восстановления показывает её пригодность.
Система мониторинга должна сообщать о заполнении диска, остановке сервиса, росте ошибок и скором окончании сертификата до обращения пользователя. Для критичного узла нужна короткая инструкция: как попасть через консоль, где лежат копии, кто принимает решение об откате и какой результат означает восстановление.
VPS и VDS на рынке часто используются как близкие маркетинговые названия, поэтому сами буквы не указывают на то, выделены ли ядра, разрешён ли оверкоммит и какие лимиты действуют для диска. Если нужен виртуальный сервер VPS с предсказуемой производительностью, проверять следует модель CPU, квоты, гарантии памяти, IOPS, полосу сети и SLA, а не то, что написано в карточке тарифа.
Публичное облако полезно, когда инфраструктуру нужно создавать через API, распределять по зонам и связывать с балансировщиками или управляемыми сервисами. Расчёт стоимости у такой модели сложнее, а зависимость от платформы выше. Один экземпляр без резервирования остаётся точкой отказа.
Dedicated-сервер резервирует весь физический узел для одного клиента и подходит для длительной высокой загрузки, крупной локальной базы или специальных накопителей. Вместе с ресурсами владелец получает более медленное масштабирование и дополнительные задачи по отказоустойчивости. Виртуальный хостинг снимает большую часть администрирования, но не даёт ни собственного ядра, ни полного контроля сети.
Если ресурсы стабильно упираются в лимит, следующий шаг – более крупный тариф или переход на dedicated. При непредсказуемых пиках и работе в нескольких зонах выигрывает облако. Когда заниматься администрированием ОС некогда или незачем, задачу закрывает managed-платформа. Выбор определяют требования к контролю, скорости восстановления и цене простоя.
VPS-сервер будет оправдан, когда проекту нужны постоянный сетевой узел, собственная ОС и контроль конфигурации, а отдельный физический хост пока избыточен. Перед оплатой параметры тарифа нужно сверить с границей ответственности и планом восстановления. Если тест подтверждает, что нагрузка укладывается в лимиты, а по данным мониторинга остаётся запас ресурсов, виртуальная машина решает задачу без лишней инфраструктуры.

p99 fsync против пиковых IOPS сравнивать бессмысленно, поскольку показатели снимают в разных режимах работы накопителя. Для WAL важна хвостовая задержка fsync при подтверждённой записи, тогда как пиковые IOPS обычно получают с глубокой очередью. Вывод действует только для указанной конфигурации: устройства, файловой системы, кэша, sync-метода и нагрузки.
p99 fsync показывает границу, ниже которой уложились 99% синхронизаций в прогоне. Пиковые IOPS показывают пропускную способность при заданной очереди и ничего не говорят об одном flush WAL. Но и p99 оценивают только вместе с числом операций, длительностью теста и конфигурацией конкретного хранилища.
При COMMIT процесс добавляет запись о завершении транзакции в WAL и вызывает XLogFlush до нужного LSN. PostgreSQL сбрасывает WAL-буферы в файл, затем просит ОС синхронизировать его. При synchronous_commit=on клиент получает подтверждение после локального flush. Если настроена синхронная репликация, время ответа также зависит от ожидания standby и выбранного режима.
Способ синхронизации WAL задаёт wal_sync_method. На Linux по умолчанию используется fdatasync: PostgreSQL пишет WAL через файловый кэш, затем вызывает fdatasync(). Варианты open_datasync и open_sync открывают файл с другими флагами. Семантика каждого варианта разобрана в документации PostgreSQL, а скорость проверяют на файловой системе будущего pg_wal.
Завершённый write() ещё не говорит о сохранности после потери питания, поскольку данные могли остаться в памяти ядра или энергозависимом кэше контроллера. Поэтому хвостовая задержка fsync включает работу ядра, файловой системы и контроллера, а не только запись блока. Перед тестом фиксируют устройство, LVM или RAID, mount options, политику кэша и наличие power-loss protection.
IOPS измеряют числом завершённых операций за секунду. Высокий результат часто получают с десятками запросов в очереди, чтобы контроллер использовал параллелизм NAND. При одиночном COMMIT это преимущество исчезает, так как транзакция ждёт конкретный flush.
Средняя latency тоже скрывает паузы. Если 9900 синхронизаций заняли 0,2 мс, а 100 заняли 20 мс, среднее составит около 0,4 мс, хотя у 1% транзакций задержка будет около 20 мс. Заявленная p99 задержка хранилища требует единиц, числа выборок и периода. Без них доля медленных операций неизвестна.
Глубину очереди меняют отдельной серией. QD=1 показывает задержку без очереди, а QD=8 или 32 проверяет параллелизм. При синхронном psync значение iodepth выше единицы не создаёт настоящую очередь, поэтому нужен асинхронный engine с direct=1. Полученную пропускную способность нельзя выдавать за задержку WAL и тем более сравнивать с рекламным read IOPS.
Перцентили относятся к одному распределению. p50 делит выборку пополам, выше p95 остаются 5% операций, выше p99 остаётся 1%. Для 100 000 операций этот хвост даёт около тысячи наблюдений, а для 1000 – только десять, поэтому маленькая выборка сильнее реагирует на шум.
Воспроизведите условия реального WAL: размер синхронной записи, конкурентность, глубину очереди, sync-метод и файловую систему. Измеряйте после прогрева устройства. Затем сохраните полное распределение, число операций и временной ряд вместе с политикой кэша. После микротеста проверьте вывод транзакционной нагрузкой при тех же гарантиях сохранности данных.
Показатели p50/p95/p99 дополняют гистограммой: по ней видно, образует ли хвост один пик или несколько режимов. На графике, где IOPS отложены против задержки, подпишите block size, queue depth, jobs и длительность. Максимум сохраняют отдельно, так как выброс мог совпасть с checkpoint, discard или работой гипервизора.
По временному ряду видно, распределены ли редкие паузы по всему тесту или хвост создал один провал. Всплески сопоставляют с выводом iostat -x 1, телеметрией NVMe и checkpoint.
Как правило, сначала фиксируют версию PostgreSQL, wal_sync_method, synchronous_commit, объём WAL за секунду и число одновременно завершающихся транзакций. Скорость генерации WAL считают по разнице показаний pg_stat_wal, а конкурентность берут из журналов и метрик за тот же период. Размер синхронной записи берут из реального профиля, а при его отсутствии помечают как допущение. При конкуренции PostgreSQL может подтвердить несколько транзакций одним flush, поэтому число синхронизаций окажется меньше числа COMMIT.
Сначала моделируют одиночную синхронизацию с выбранным размером блока, например 8 KiB: один job, QD=1, тот же каталог и sync-метод. Затем повышают число jobs. Асинхронный QD-тест идёт отдельно, иначе невозможно понять, что дало прирост: конкурентность приложения или внутренняя очередь устройства.
Набор данных и длительность выбирают так, чтобы тест не закончился на быстром кэше. Для виртуального диска указывают thin provisioning, репликацию и локальный кэш. Бенчмарк надёжной записи, упирающийся в RAM или короткий SLC-burst, ничего не показывает. Поэтому в отчёт вносят свободное место, заполнение и способ предварительной записи.
pg_test_fsync сравнивает способы синхронизации и выводит среднее время операции. По документации PostgreSQL файл размещают на той же файловой системе, где будет pg_wal. Утилита помогает выбрать wal_sync_method, но не показывает хвост распределения и не предсказывает пропускную способность базы.
В прогоне, опубликованном 27 мая 2025 года, использовались PostgreSQL 16, Samsung 990 Pro, XFS и write-back-кэш. Фрагмент сырого вывода:
fdatasync: 608.573 ops/s, 1643 us/op
fsync: 177.431 ops/s, 5636 us/op
На том же сервере, но на Micron 7400 с PLP среднее время fdatasync составило 24 мкс. Полный вывод и топология стенда есть в исходном отчёте, но из-за разной конфигурации это сравнение классов накопителей, а не моделей.
Чтобы получить распределение, используют fio job, в котором заданы engine, block size, QD и длительность. Укажите отдельный тестовый файл: fio перезапишет его и потребует не менее 32 GiB свободного места.
[wal-fsync]
filename=/mnt/wal-test/fio.bin
size=32G
ioengine=psync
rw=write
bs=8k
direct=0
overwrite=1
fdatasync=1
iodepth=1
numjobs=1
time_based=1
runtime=600
ramp_time=60
percentile_list=50:95:99:99.9
Команда fio wal-fsync.fio --output=wal-fsync.txt --output-format=normal сохраняет отчёт, а percentile_list задаёт перцентили. Для WAL смотрите раздел fsync/fdatasync/sync_file_range. Отдельная асинхронная серия покажет, как меняется задержка NVMe при разной глубине очереди. Затем подтвердите результат в pgbench с -l или прикладном сценарии при тех же гарантиях сохранности данных.
Короткий запуск может закончиться до исчерпания быстрого кэша SSD. Поэтому файл предварительно заполняют, устройство прогревают, а тест ведут до устойчивого режима. По временному ряду видно, как после исчерпания SLC-кэша падает пропускная способность или растёт задержка. Там же видны фоновые паузы. Один итоговый p99 смешивает быстрый старт с установившимся режимом.
Перед серией фиксируют write cache, PLP, температуру, прошивку, заполнение, discard и фоновые операции. Что из этого списка недоступно на виртуальном диске, также отмечают в отчёте. Кэш не отключают, поскольку тест повторяет рабочую конфигурацию, а потерю питания проверяют отдельно.
1. Универсального порога нет: вычтите из SLO время сети, блокировок, CPU и других синхронных шагов.
2. Определите, какую часть остатка можно отдать ожиданию WAL с учётом group commit.
3. Задайте запас и долю нарушений, затем подтвердите порог транзакционным тестом.
p99 fsync 5 мс уже больше, чем весь SLO в 4 мс. При SLO 100 мс такая задержка может поместиться в бюджет только после учёта остальных ожиданий. Результат проверяют после прогрева и при рабочем заполнении диска, а критерий пересматривают при смене прошивки, миграции VM или росте нагрузки.
p99 fsync нельзя напрямую приравнивать к p99 транзакции. В критический путь транзакции входят блокировки, вычисления, сеть, репликация и иногда несколько flush. Group commit объединяет синхронизации, а synchronous_commit=off убирает ожидание локального диска. Поэтому перед сравнением выясняют, какие этапы идут последовательно, а какие перекрываются.
Затем сопоставляются временные ряды. Если пики commit latency совпадают с ростом времени WAL fsync, await и длины очереди, накопитель становится основной гипотезой. Если метрики хранения остаются ровными, задержку ищут в блокировках, CPU или ожидании реплики. Причину подтверждают изменением одного фактора: устройства, sync-метода или профиля нагрузки.
В SLO записывайте порог, долю нарушений, окно и минимальное число операций. Вместе с результатами транзакционного теста нужно сохранить latency histogram, указав границы бакетов и число наблюдений. Размер запаса задаётся до серии. При росте конкурентности тест лучше повторить: очередь и group commit меняют связь между одним flush и числом завершённых транзакций.
К job-файлу и сырому выводу обычно добавляют дату, версии fio, PostgreSQL и ядра, файловую систему и mount options, модель и прошивку диска, RAID/LVM, кэш и PLP, размер файла, block size, QD, jobs, длительность и прогрев. Для VM также указывают контроллер и неизвестные свойства хранилища.
В папку результата положите fio.job, fio.txt, вывод pg_test_fsync, журналы pgbench, iostat, NVMe log и CSV временного ряда. Рядом с графиком приведите перцентили и число операций. Без исходных файлов нельзя проверить единицы, фильтрацию и границы интервала.
У steady-state workload должен быть критерий: например, 10 минут после 5-минутного прогрева или остановка fio по условию steady state. Выбор зафиксируйте в job-файле. В краткой версии публикации оставьте график p99 и ссылку на полную методику.
Хранилище для WAL выбирают по повторяемой задержке подтверждённой записи и по тому, укладывается ли транзакция в свой SLO. Сначала проверьте sync-метод на файловой системе pg_wal, затем снимите распределение задержек в fio и подтвердите вывод транзакционным тестом. Сырой вывод нужен, чтобы не спутать смену накопителя с изменением нагрузки. После такой проверки p99 fsync против пиковых IOPS перестаёт быть выбором между двумя цифрами: для планирования берут p99, измеренный при нужных гарантиях записи и сопоставленный с SLO.
По первым тестам Silicon Power UD90 2 ТБ мало чем выдает QLC-память: больше 5.2 ГБ/с на чтении, почти 4.8 ГБ/с на записи, а файл объемом 401.6 ГБ у меня записался со средней скоростью 3.0 ГБ/с. Я ждал, что на таком объеме кэш закончится, но ошибся. Настоящий предел UD90 обнаружился дальше, примерно после 540-560 ГБ непрерывной записи. И вот там поведение SSD меняется очень сильно.


С упаковкой тут особо обсуждать нечего. Небольшая картонная основа, прозрачный блистер и сам SSD внутри. На коробке указаны привычные для него PCIe Gen4 x4, NVMe 1.4, формат M.2 2280, объем 2 ТБ и пятилетняя ограниченная гарантия. Там же находятся обещанные 5000 МБ/с на чтении и 4800 МБ/с на записи.
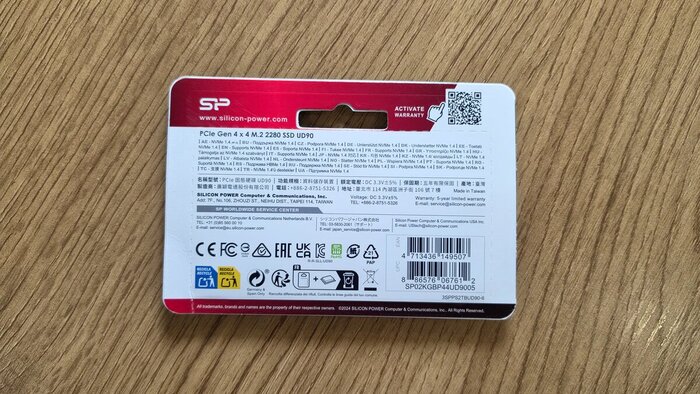

Комплект заканчивается самим накопителем. Винта нет, радиатора тоже. В моем тестовом ПК это вообще не проблема: UD90 устанавливался под радиатор материнской платы. А вот при покупке для ноутбука я бы заранее посмотрел, как там организовано охлаждение M.2.
Размеры стандартные: 22 x 80 x 3.5 мм, масса около 8 г. На лицевой стороне наклейка SP. Я ее снял, поскольку здесь как раз было интересно посмотреть на то, какая версия UD90 попалась в руки.

Монтаж у 2-терабайтной версии односторонний. Четыре корпуса NAND имеют маркировку 29F04T2ANCQ1, рядом установлен Realtek RTS5772DL. Отдельной DRAM-микросхемы я на плате не нашел. С обратной стороны компонентов нет.


Утилита Realtek расставила оставшиеся точки: контроллер RTS5772, прошивка VF001C45, HMB на 64 МБ. Память определилась как 144-слойная QLC Intel N38A с кристаллами емкостью 1024 Гбит.
То есть у меня оказался именно тот вариант UD90, к которому я изначально относился с некоторой осторожностью. QLC и отсутствие собственной DRAM сами по себе накопитель плохим не делают, но обычно заставляют внимательнее смотреть не на первые минуты записи, а на то, что происходит дальше. В данном случае это оказалось уместно.

CrystalDiskMark сначала никаких поводов придираться к UD90 не дал. В Q8T1 я получил 5279.51 МБ/с на последовательном чтении и 4761.94 МБ/с на записи. Чтение даже вышло за заявленные 5000 МБ/с, запись практически совпала с обещанными 4800 МБ/с.
Я бы на эти 279.51 МБ/с сверх спецификации большого внимания не обращал. Это приятная цифра в таблице, но именно такой прирост в работе почувствовать практически невозможно. Гораздо полезнее дальше посмотреть, насколько эти скорости сохраняются при смене нагрузки.


При Q1T1 чтение снизилось до 3863.74 МБ/с, а запись осталась на уровне 4739.21 МБ/с. Уже здесь видно, что один показатель "до 5000 МБ/с" довольно плохо описывает реальную скорость даже внутри одного бенчмарка.
С блоками 4 КБ при Q1T1 получилось 69.84 МБ/с на чтение и 183.72 МБ/с на запись, примерно 17 и 45 тысяч IOPS. При Q32T16 накопитель разогнался до 1565.89 и 2663.36 МБ/с, около 382 и 650 тысяч IOPS.
В ATTO мне было интереснее посмотреть не столько на максимум, сколько на то, когда скорость перестает расти. На крупных блоках чтение выходит примерно на 4.9 ГБ/с, запись на 4.4 ГБ/с. Начиная примерно с 512 КБ - 1 МБ дальнейшее увеличение блока уже мало что меняет.


AS SSD, как обычно, оказался менее щедрым на красивые результаты. Последовательное чтение составило 4413.43 МБ/с, запись 3600.51 МБ/с. На 4 КБ получил 54.75 и 195.07 МБ/с. Общий результат - 5013 баллов.
В его тесте копирования ISO вышло 3860.40 МБ/с, Program - 1604.54 МБ/с, Game - 3054.90 МБ/с. Мне эти три цифры нравятся больше, чем один последовательный максимум. Они хотя бы напоминают, насколько сильно скорость SSD зависит от характера данных и самой операции. Между 1604 и 3860 МБ/с разница уже такая, что говорить просто "накопитель пишет на 4.8 ГБ/с" становится бессмысленно.


Сжимаемость на результаты практически не влияла. Чтение большую часть прогона оставалось около 4.3-4.5 ГБ/с, запись - 4.2-4.4 ГБ/с. Каких-либо характерных провалов по мере изменения степени сжатия я не увидел.
На этом короткие тесты я бы уже мог закончить с выводом, что UD90 вполне соответствует заявленным скоростям. Но для QLC-накопителя такой вывод был бы слишком ранним.
Сначала прогнал весь объем на чтение в AIDA64. Среднее значение составило 5231.1 МБ/с, максимум 5348.5 МБ/с, минимум 4717.7 МБ/с. Здесь мне даже особо нечего анализировать: график практически ровный. Накопитель читает стабильно от начала до конца, и каких-то скрытых проблем этот тест не показал.

А вот линейная запись наконец объяснила, зачем UD90 нужен длинный тест.

В начале он пишет примерно на 4.5 ГБ/с. И пишет так довольно долго. Я ожидал увидеть спад раньше, потому что все-таки имеем QLC без отдельной DRAM. Но примерно до 27-28% пространства ничего неприятного не происходит. Потом скорость обваливается.
Основная часть графика после этого идет уже примерно между 250 и 450 МБ/с. Минимум составил 191.1 МБ/с. Максимум - 4549.3 МБ/с. Средняя скорость по всему объему получилась 1485.7 МБ/с.
Вот эта разница и стала главным результатом тестирования UD90. Не 5279 вместо заявленных 5000 МБ/с. Не разница между CrystalDiskMark и AS SSD. А переход от примерно 4.5 ГБ/с к нескольким сотням мегабайт после исчерпания кэша.
По графику его объем получается очень большим. Для накопителя на 2 ТБ 27-28% - это приблизительно 540-560 ГБ. Тут я как раз пересмотрел первоначальное отношение к этой модели. Да, это QLC. Да, после кэша ее скорость хорошо видна. Но производитель спрятал эту слабую сторону за настолько большим динамическим SLC-кэшем, что в обычной работе до нее еще придется добраться.
Это хорошо подтвердилось уже не синтетикой. Я взял один файл размером 401.6 ГБ и скопировал его с Silicon Power XS90 на UD90. Специально использовал такой объем, потому что рассчитывал поймать момент окончания быстрой записи уже в TeraCopy. Не поймал.


Все 401.6 ГБ скопировались за 2 минуты 15 секунд со средней скоростью 3.0 ГБ/с. На графике были небольшие кратковременные просадки, но выраженного перехода к медленной записи не произошло.
До линейного теста я бы, скорее всего, начал искать причину в особенностях TeraCopy, фоновой работе SSD или поведении прошивки. После AIDA64 все оказалось гораздо проще. Файл на 401.6 ГБ банально не заполнил кэш.
Именно здесь размер кэша из абстрактной цифры превращается в понятную практическую вещь. 540-560 ГБ за один непрерывный заход записывают далеко не каждый день. Установить большую игру, перекинуть папку с фотографиями, скопировать несколько десятков гигабайт видео - в таких задачах UD90, скорее всего, вообще не покажет свою медленную сторону.
Но я бы не стал из этого делать вывод, что тип NAND тогда не имеет значения. Стоит перейти границу кэша, и скорость меняется примерно на порядок. Если SSD используется как рабочий накопитель для регулярного перегона очень больших массивов, это уже совсем другая история.
С мелкими файлами возник другой эффект. Я записал на UD90 36 989 файлов общим объемом 10.2 ГБ. На операцию ушло 3 минуты 12 секунд, средняя скорость - 54 МБ/с.


После 3.0 ГБ/с на одном огромном файле цифра выглядит почти издевательски. Но к QLC-кэшу этот результат отношения практически не имеет. Тут SSD занят десятками тысяч отдельных операций, а последовательные мегабайты из CrystalDiskMark становятся почти бесполезными для прогнозирования времени.
В обратном направлении те же 36 989 файлов объемом 10.2 ГБ скопировались с UD90 на XS90 за 2 минуты 45 секунд. Средняя скорость составила 63 МБ/с. Разница с записью есть, но я бы не пытался делать из девяти мегабайт в секунду вывод о преимуществе чтения над записью. В таком тесте слишком многое завязано на работу с самими файлами.


Больше вопросов у меня сначала вызвало обратное копирование крупного файла. Те же 401.6 ГБ с UD90 на XS90 переносились уже 4 минуты 6 секунд, а средняя скорость упала до 1.6 ГБ/с. В первой части графика скорость была выше, потом начались регулярные колебания.

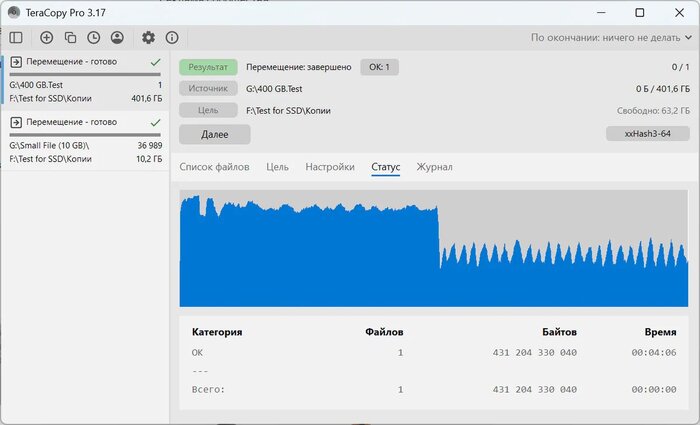
Если смотреть только на этот тест, легко решить, что UD90 плохо читает большие объемы. Но это не стыкуется с AIDA64, где среднее линейное чтение составило 5231.1 МБ/с и оставалось стабильным по всему объему.
Значит, искать ограничение только в UD90 здесь неправильно. При копировании XS90 одновременно должен принимать данные, работает его собственный кэш, вмешивается файловая система. Это уже тест пары накопителей, а не чистого чтения одного SSD. Мне как раз нравятся такие расхождения между бенчмарком и копированием. Они заставляют не переносить цифру из одной программы прямо в вывод о реальной скорости. Если SSD читает в AIDA64 5.2 ГБ/с, это вовсе не означает, что любой файл между двумя накопителями Windows будет переносить с такой же скоростью.
До теста я относился к Silicon Power UD90 2 ТБ примерно так, как обычно отношусь к QLC-моделям: короткая запись наверняка будет быстрой, а дальше посмотрим, насколько рано закончится кэш. Как раз со второй частью я ошибся. Кэш здесь закончился заметно позже, чем ожидалось. По линейной записи это примерно 540-560 ГБ. Поэтому даже мой файл объемом 401.6 ГБ накопитель принял целиком в быстром режиме, показав в TeraCopy средние 3.0 ГБ/с.
И вот для меня это главный аргумент в пользу UD90. Не 5279.51 МБ/с в CrystalDiskMark. Эти дополнительные мегабайты сверх заявленной скорости ни на что практически не влияют. А возможность записать несколько сотен гигабайт до падения производительности вполне влияет.
С другой стороны, после заполнения кэша никаких чудес уже нет. Скорость уходит в диапазон примерно 250-450 МБ/с, а минимум в моем тесте составил 191.1 МБ/с. Если такую нагрузку давать регулярно, я бы уже смотрел в сторону SSD с другой памятью и более предсказуемой длительной записью.
Для системы, игр и обычного домашнего использования эта слабая сторона находится довольно далеко. Можно пользоваться UD90 и месяцами ни разу ее не увидеть. Для переноса больших архивов, работы с объемным видео или других задач, где сотни гигабайт пишутся подряд, она рано или поздно проявится.
Поэтому после тестов UD90 я воспринимаю не как "медленный QLC SSD" и не как "почти 5-гигабайтный PCIe 4.0". Оба определения слишком грубые. Пока данные помещаются в его большой кэш, он действительно быстрый. Когда перестают помещаться, характер накопителя меняется очень резко. И перед покупкой полезнее понимать именно эту границу, чем запоминать цифру 5000 МБ/с с коробки.
У кого то лето - пора отпусков, а компьютерном классе дето - пора уборки и починки, и перебора техники. Из закромов достается оперативка, продуваются корпуса, кое где подкидывается кабель-другой, или проц )

Что то на дорогобогатом, по нынешним временам.
Поколения накопителей: подняли из тьмы веков IDE HDD, с целью выдрать фотки из него. Рядом обычная sata, и свежая относительно SSD. И две m2 NVME. И если ИДЕ-шка и уставшая SАТА (50 тыщ часов по crystal disc info, думаю, это на покой) пойдет на заслуженный отдых, то остальное в дело )

Поколения! )

Чтобы быстро проверять оперативку, не мучая платы и тестовый стенд, купил себе вот такой девайс.

Умеет проверять DDR3, DDR4, DDR5 )
Видно, где оперативка нормально себя ведет, а где - просаживаются каналы. Если один - два еле светят, можно попытаться зачистить контакты,

По яркости диодов тоже можно понять, насколько оперативка устала )

Девайс с батарейкой, в принципе можно и к компу прицепить на кабель.


Очень полезная штуковина )

А вот вторая платка - для проверки DDR3 и DDR2, но уже на материнских платах )
Mы даём максимум. Серверы, которые не проседают под нагрузкой для сайтов, ботов, игровых серверов, 1С и highload-проектов.
⚡️ AMD Ryzen 9 9950X — до 5.7 ГГц, топовый процессор
🌐 Канал до 25 Гбит/с
💾 NVMe-диски — в разы быстрее обычного SSD
🛡 DDoS-защита включена без доплат
♾ Безлимитный трафик — никаких лимитов и переплат
🌍 11 локаций (RU · EU · US) + /48 IPv6
💰 От 593 ₽/мес · активация за 2 минуты
👉 aeza.net
Здравствуйте!
Железо :
Процессор AMD Ryzen 9 9950X, частота до 5.7 ГГц
Диски NVMe (не обычный SSD)
Канал до 25 Гбит/с, трафик безлимитный
Базовая DDoS-защита включена
1 IPv4 + /48 IPv6-подсеть
Если остались вопросы — обращайтесь, всегда рады помочь!