
Пишу НФ. Публикуюсь. Цитата #14
Цитата для тех, кто не знает, как появляются современные писатели
Цитата для тех, кто не знает, как появляются современные писатели
Для такой красоты пришлось док станцию под лепестки перепилить напильником
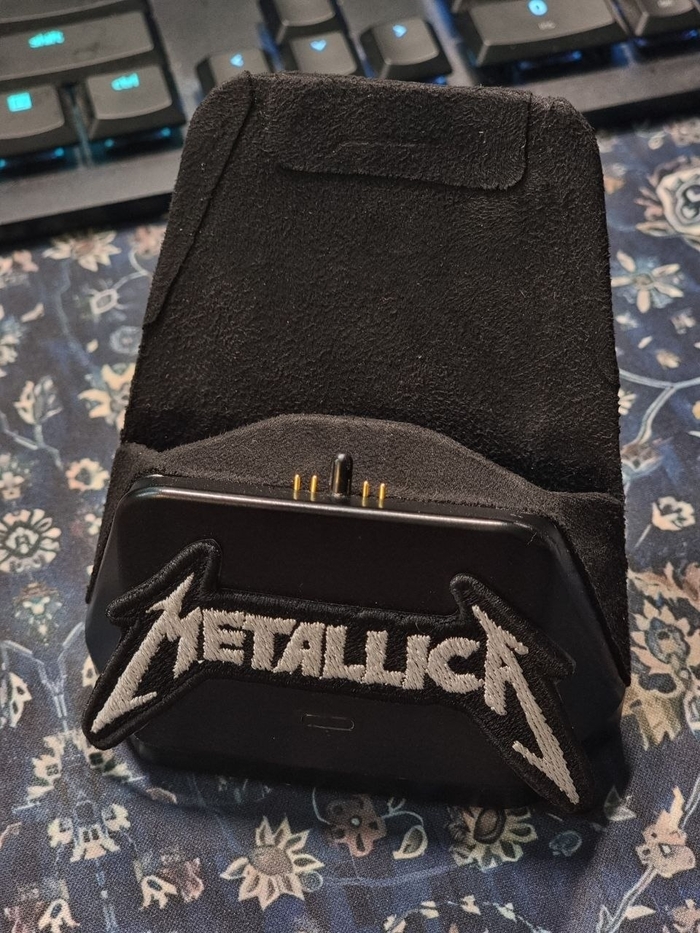
Алькантара на док-станции для максимально элитарного гейминга
Вместо мембранки кликающие микрики. Мне мембранные кнопки больше нравились, но пусть будет
За алюминиевые стики отдал безумные 160 рублей. Мало того, что красиво, еще и довольно цепкими оказались. Эти то точно не превратятся в сопливую биомассу
Сзади есть мод на клики для триггеров. Выезжают по требованию
Четыре толково задизайненных лепестка, никаких мискликов, тихое нажатие, выбор верхнего и нижнего лепестка буквально еле заметным изменением направления движения пальца
И 8 профилей с экранчиком.
Вишенка на торте - донгл из Raspberry P2 для беспроводного подключения к Винде с ПОЛНОЙ поддержкой всех фич Дуалсенса (адаптивы, хаптик, звук) без глупых программ в трее.
Только стики не перепаивал на магнитные. Ну, надеюсь, не задрифтят.
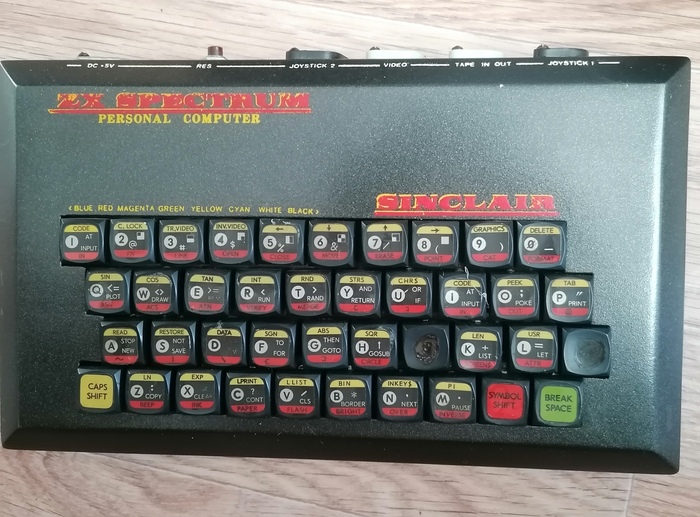
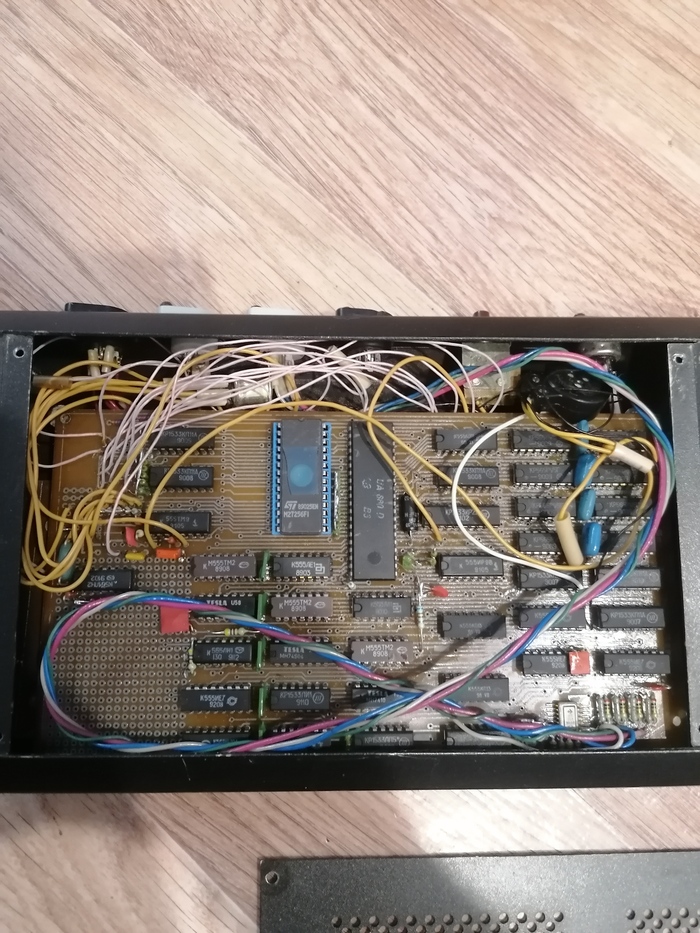
Попалась мне вот такая вещица, нужна помощь с определением, что это за клон spectruma?
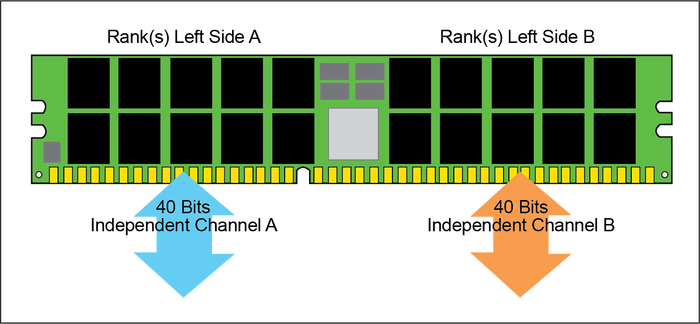
DDR5
DDR4
DDR3
Помогите,включаю компьютер,ввожу пароль и после 10 минут загрузки включается серый экран где видно лишь курсор
После GPT-5.5 особенно заметно, что развитие ИИ резко ускорилось. Новые модели выходят всё чаще, лучше пишут код, решают сложные задачи и заметно увереннее рассуждают. Возникает вопрос: что именно изменилось? Просто стало больше мощных компьютеров, нейросети начали дольше обучать или появились новые способы обучения, или это какой то "супер" алгоритм, или же дело в инвестициях.
Чтобы ответить на это, сначала нужно понять самое главное: как нейросеть вообще учится и что именно меняется внутри неё во время обучения. Начнём с самого простого примера — как почти ничего не знающая модель постепенно учится правильно продолжать фразу.
Чтобы понять работу нейросети, проще не начинать с терминов вроде «параметры» и «матрицы», а посмотреть на один простой пример.
Допустим, мы хотим научить "молодую" нейросеть продолжать фразы. Мы показываем ей:
«Земля вращается вокруг...»
Пока она ничего толком не знает и отвечает примерно с такой вероятностью:
Луны — 50% Марса — 30% Солнца — 20%
Правильный ответ — «Солнца». Значит, модель ошиблась.
Внутри нейросети находится огромное количество чисел. Можно представить их как маленькие регуляторы.
Для простоты допустим, что у нашей модели всего три таких регулятора:
A = 0,50 B = 0,50 C = 0,50
* В реальной модели их не три, а миллиарды.
Эти числа участвуют в расчёте ответа. После ошибки программа проверяет: какие настройки сильнее подтолкнули модель к неверным вариантам и какие, наоборот, помогали правильному.
Например, выясняется:
параметр A слишком за вариант «Луны»;
параметр B почти не влиял;
параметр C немного помогал варианту «Солнца».
Тогда программа делает небольшие изменения:
A: 0,50 → 0,49 B: 0,50 → 0,50 C: 0,50 → 0,51
И снова показывает ту же или похожую задачу.
Теперь результат может быть таким:
Луны — 45% Марса — 28% Солнца — 27%
Модель всё ещё ошибается, но стала чуть ближе к правильному ответу.
Например:
«Земля — третья планета от...»
Модель отвечает:
Луны — 40% Солнца — 35% Марса — 25%
Правильный ответ снова «Солнца».
Параметры снова немного меняются.
Потом:
«Планеты Солнечной системы движутся вокруг...»
И снова корректировка.
Потом:
«Солнце находится в центре Солнечной...»
И ещё одна корректировка.
После тысяч похожих примеров модель уже гораздо увереннее связывает понятия Земля, планета, Солнце, Солнечная система.
Теперь на фразу:
«Земля вращается вокруг...»
она может ответить:
Солнца — 97% Луны — 2% остальное — 1%
Никто не писал ей отдельное правило:
«Запомни, что Земля вращается вокруг Солнца».
Она пришла к этому через множество примеров и исправлений.
Возьмём другой пример.
Модель видит много предложений:
Собака лает. Кошка мяукает. Собака — животное. Кошка — животное. Щенок — молодая собака. Котёнок — молодая кошка.
Постепенно модель замечает, что слова «собака» и «кошка» часто встречаются в похожих ситуациях.
Если ей дать:
«Собака живёт в...»
она уже ожидает что-то вроде «доме», «будке», «семье», а не «таблице умножения».
Никто заранее не создавал для неё категорию «животные». Она сама пришла к тому, что такие слова связаны между собой, потому что это помогает лучше угадывать продолжение текста.
Допустим, модель видит:
«Петя выше Васи. Вася выше Коли. Кто самый высокий?»
Необученная модель может просто угадывать.
Но если во время обучения она видит тысячи похожих задач:
А выше Б. Б выше В. Кто выше всех? Маша старше Оли. Оля старше Лены. Кто старше? Красный ящик тяжелее синего. Синий тяжелее зелёного. Какой самый тяжёлый?
то параметры постепенно настраиваются так, что модель начинает замечать сам принцип:
если А выше Б, а Б выше В, значит, А выше В.
То есть нейросеть учит не только отдельные ответы. При достаточном количестве похожих примеров она может начать улавливать общую закономерность.
Можно подумать, что где-то внутри модели есть отдельная настройка:
«Земля вращается вокруг Солнца = 0,873»
Но так нейросеть не устроена.
Возьмём лицо человека. Мы узнаём его не по одному признаку. Важны глаза, нос, форма головы, расстояние между чертами и их сочетание.
Примерно так же работает и нейросеть. Знание о Земле и Солнце создаётся не одним числом, а совместной работой огромного количества параметров.
Причём эти же параметры одновременно участвуют и в других знаниях.
Представим, что мы показали ей только:
«Земля вращается вокруг Солнца».
Она может просто слишком сильно подстроиться именно под эту фразу.
Но если показать множество вариантов:
«Земля обращается вокруг Солнца». «Наша планета движется по орбите вокруг Солнца». «За сколько Земля совершает оборот вокруг Солнца?» «Что находится в центре земной орбиты?»
тогда модель должна уловить уже не конкретную фразу, а саму связь между понятиями.
Чем разнообразнее примеры, тем меньше модель просто запоминает форму предложения и тем больше учится общей закономерности.
Обучение нейросети можно представить так:
показали пример → модель попыталась ответить → сравнили с правильным ответом → немного изменили внутренние настройки → дали следующий пример.
И так миллионы и миллиарды раз.
В начале модель почти случайно угадывает слова. Потом начинает замечать простые связи. Затем более сложные закономерности.
И отсюда возникает следующий вопрос: если нейросеть в основном училась угадывать продолжение текста, почему в какой-то момент она научилась решать задачи, писать код и рассуждать?
Об этом — во второй части.
P.S. особенно интересно, могут ли они в итоге в своём обучении обойтись вообще без участия человека.. об этом попробуем задуматься в конце...
Мой канал «В мире много интересного»:
https://dzen.ru/v_mire_mnogo_interesnogo
P.S. Уточнение для внимательных: в посте представлены нейро-концепты, сгенерированные по нашей 3D-модели. Кому интересно увидеть реальные фото уже готовой детали — переходите по ссылке в профиле
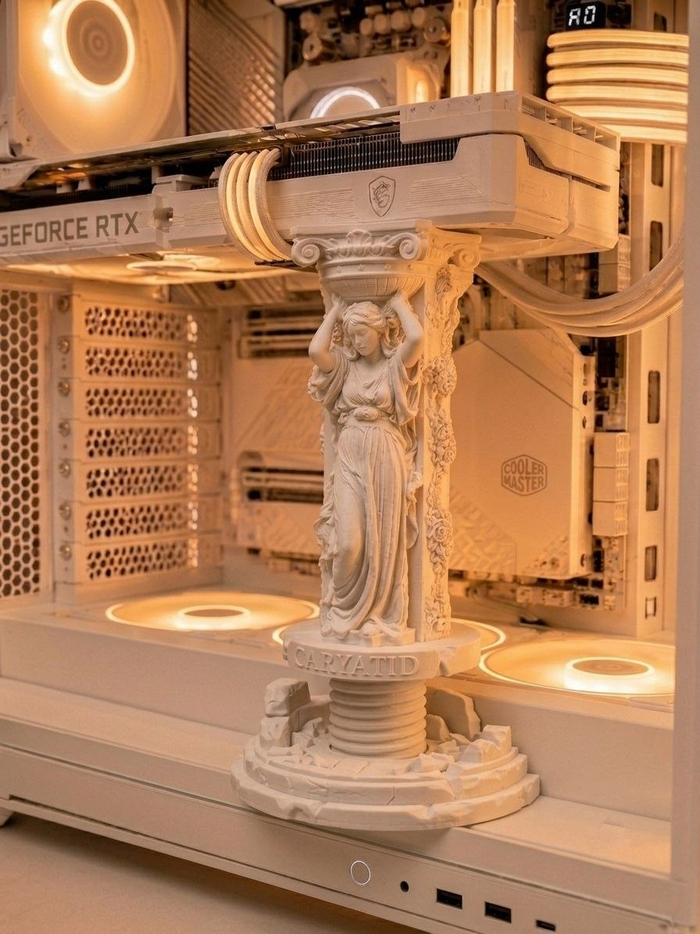
Всем привет! Некоторое время назад я делился здесь своими проектами — кастомными подставками под тяжелые видеокарты в виде Атланта и классической античной колонны. В комментариях тогда многие справедливо заметили, что модельный ряд неполный и эстетика требует женского силуэта. Вы просили, советовали, критиковали — а я взял паузу, засел за моделирование и сделал. Встречайте новое пополнение: Кариатида.
Современные видеокарты давно превратились в увесистые кирпичи, которые безжалостно выламывают PCI-E слоты материнских плат. Стандартные металлические костыли-подпорки часто выглядят скучно и ломают весь визуальный стиль тщательно собранного железа. Мне же хотелось объединить утилитарную функцию с искусством. Как видно на живом фото из системника (файл 1000001055.jpg), античная статуэтка невероятно органично вписывается в светлые кастомные сборки, бережно поддерживая массивный кожух охлаждения и убирая любое провисание текстолита.
Учитывая прошлый опыт и ваши прямые рекомендации, я доработал эргономику резьбового механизма. Системные блоки и толщина кулеров у всех разные, поэтому теперь подпорка спроектирована сразу в трех рабочих диапазонах высоты. На рендерах наглядно показан этот разброс:
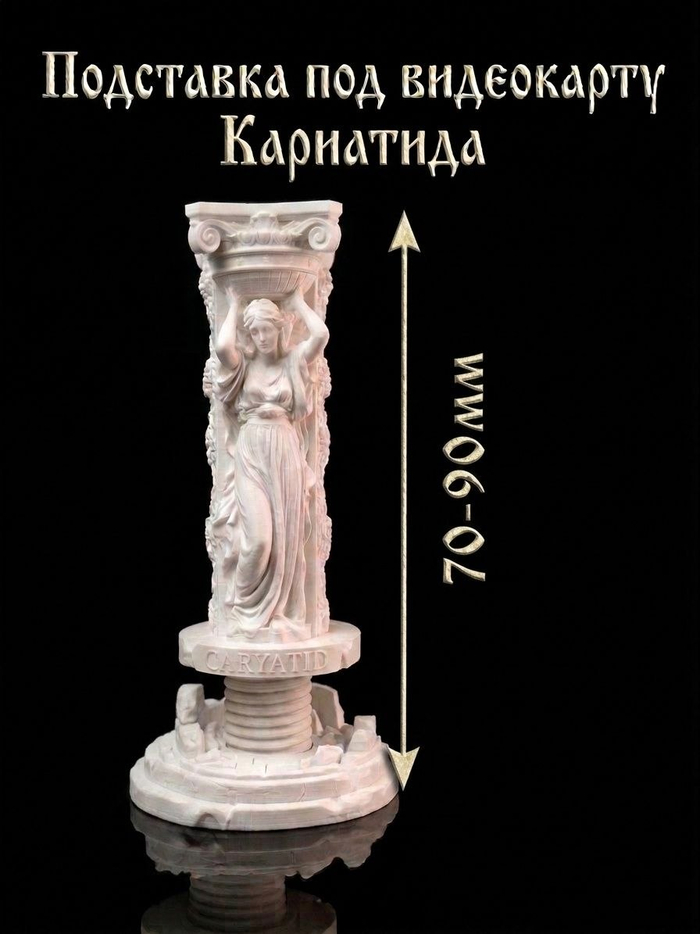
Компактная версия для зазора 70-90 мм
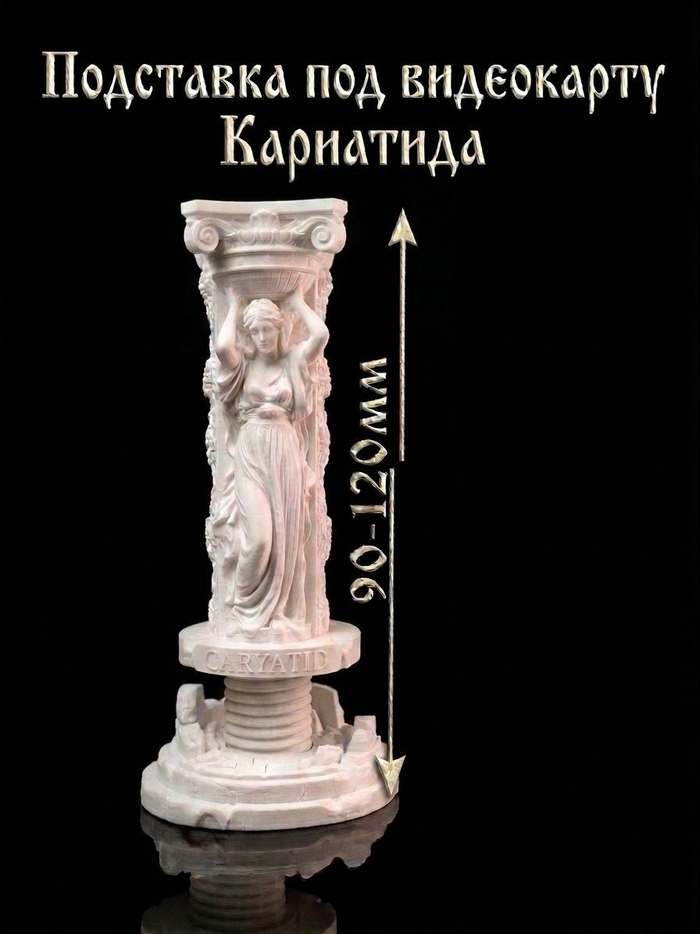
Средняя база на 90-120 мм
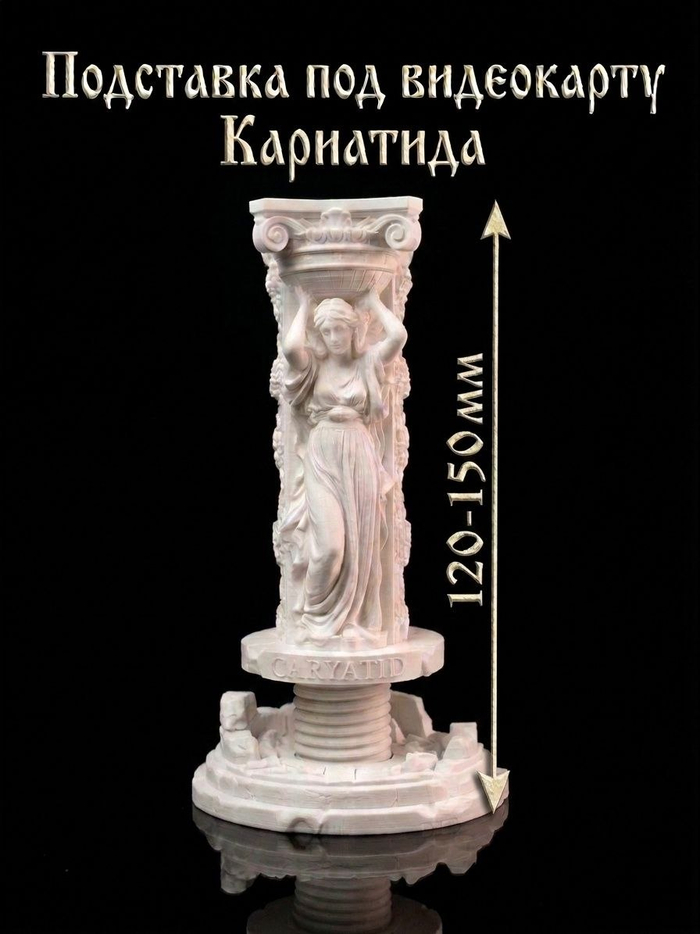
Самая высокая колонна, перекрывающая расстояние от 120 до 150 мм
Резьба ходит плавно, высоту можно выверить буквально до доли миллиметра, так что карточка будет лежать в идеальном горизонте.
Детализация складок одежды и архитектурных элементов прорабатывалась с расчетом на беспроблемную 3D-печать. Модель отлично получается как на FDM-принтерах из привычного PETG или PLA, так и на фотополимерниках, где смола дает ту самую идеальную гладкость настоящего мрамора. Я прогнал несколько тестов на своих станках, чтобы убедиться в прочности конструкции и отсутствии слабых мест на нависающих элементах.
Прямой рекламы и агрессивных ссылок в посте не будет, правила Пикабу я уважаю. Но если у вас дома гудит свой принтер и есть желание добавить немного эстетики в системный блок — файлы для самостоятельной печати (STL) уже доступны. Найти их и поддержать мой проект PLASTIC LOVE можно по ссылке в моем профиле.
Буду рад вашей критике и мыслям в комментариях! Как вам такая альтернатива заводским стойкам? Какую тематику для ПК-моддинга стоит затронуть следующей — может, уйти в мрачную готику или сделать упор на любимых персонажей из поп-культуры?