
На площадке он был лидером, а за её пределами — примером для целого поколения спортсменов
История Сергея Белова — это история человека, который посвятил свою жизнь любимому делу.
История Сергея Белова — это история человека, который посвятил свою жизнь любимому делу.
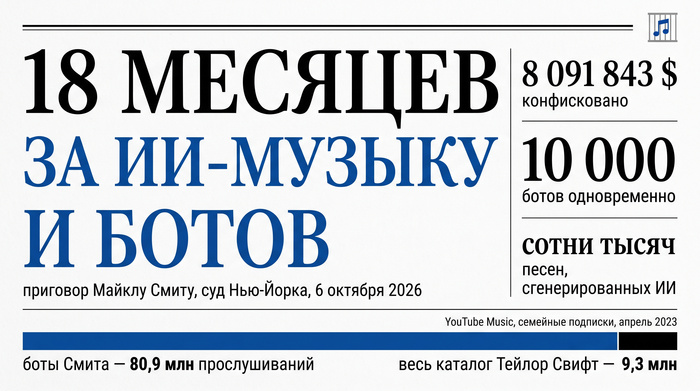
Федеральный суд Манхэттена вынес первый в США приговор за мошенничество со стримингом музыки. 54-летний Майкл Смит из Северной Каролины семь лет заливал на Spotify, Apple Music, Amazon Music и YouTube Music сотни тысяч сгенерированных ИИ песен и крутил их армией ботов. Итог — 18 месяцев тюрьмы, два года надзора и конфискация 8 091 843 долларов.
Как работала схема
С 2017 года Смит заводил тысячи фейковых аккаунтов на поддельные почты и мошеннически полученные карты, а софт заставлял их слушать его треки без перерыва — до 10 000 ботов одновременно. Чтобы антифрод не заметил аномалий, прослушивания размазывались по огромному каталогу, и тут пригодился ИИ: глава ИИ-музыкальной компании поставлял ему тысячи треков в месяц за долю дохода.
Масштаб прокуратура показала на примере: в апреле 2023-го весь каталог Тейлор Свифт собрал на YouTube Music по семейным подпискам 9,3 млн прослушиваний, а боты Смита — 80,9 млн. Обвинение просило минимум 46 месяцев, защита — условный срок. Деньги при этом крадут не у платформ, а у музыкантов: роялти платят из общего котла пропорционально доле прослушиваний, и каждый фейковый стрим уменьшает выплату всем остальным.
Похожие дела: топ по деньгам
Уголовных дел о накрутке стримов в мире единицы. Вот всё, что нашлось с подтверждёнными суммами:
1. MediaMuv, США — 23 млн долларов. Хосе Теран и Вебстер Батиста через посредника в YouTube Content ID присвоили права на 50 тысяч чужих песен и собирали за них роялти. Ботов не было, но это крупнейшая известная кража музыкальных роялти: Теран получил 70 месяцев, Батиста — 46.
2. Майкл Смит, США — 8,09 млн долларов. ИИ-треки и боты, 18 месяцев. По письму прокуратуры, всего ему перевели больше 14 млн.
3. Дания — не меньше 3,5 млн крон (около 500 тыс. долларов). Накрутка ботами 689 треков, в 2025-м апелляция подняла срок до двух лет, из которых реально сидеть три месяца.
4. Бразилия — изъято имущества на 2,3 млн реалов (около 400 тыс. долларов). Певец из Ресифи с фермой ботов и сотнями фейковых треков на Spotify, арест в декабре 2024-го.
5. Южная Корея — сумма не раскрыта. 11 сотрудников агентств обвинили в накрутке чартов: 15 песен прокрутили 1,73 млн раз через 500 виртуальных ПК.
Почему это важно
По оценке Beatdapp, фейковые стримы ежегодно уводят из индустрии около 2 млрд долларов роялти. Deezer в 2025-м считал мошенническими до 85% прослушиваний полностью сгенерированных треков, а в июне 2026-го получал около 90 тысяч ИИ-треков в день. Генераторы сделали бесконечный каталог бесплатным для всех, так что первый приговор вряд ли станет последним.
Источники: TechRepublic, Music Business Worldwide, Billboard
Привет пикабушники! Это мой первый пост. Хочу поделиться с первыми пробами запилить видос с ИИ. Буду исследовать внезапно появившийся подвал своего дома! Качество видео пока слабенькое, может потом переработаю и устраню недочеты и несостыковки.

Посидел с чат-ботами для малого бизнеса и хочу поделиться наблюдением: большинство историй провала - это не «ИИ плохой», а бот, которому отдали не его работу
Скучные предсказуемые сценарии: запись, напоминание, три типовых вопроса. Тут бот быстрее человека, не устает и не хамит. Клиент доволен и часто не замечает подмены
Живая беседа с убеждением. Три-четыре шага скрипта - и понеслось: клиент чувствует, что общается с бумажкой, а продать «у нас дороже, но качественнее» бот не в состоянии в принципе

Делегировать боту общение нужно поэтапно: сначала простые сценарии, неделя чтения реальных диалогов, потом следующий шаг. Сложные цепочки с первого дня - почти гарантированный провал. Как делаю я - расписал в статье
Подробнее о том, как это устроено, я писал у себя: Чат-боты в маркетинге малого бизнеса: где бот приносит заявки
Заявки в два часа ночи - отдельная песня. Без бота они теряются, с ботом утром у тебя список: кто писал, что надо, когда перезвонить. Конкурент в это время просто спит. Для малого бизнеса это самый дешевый способ забрать часть рынка без рекламного бюджета
Бот не заменяет продавца и не закрывает сделки сам. Если интегратор обещает «полностью автоматизируем продажи» - бегите. Нормальная картина: рутина у машины, разговоры и деньги у людей. Так меньше разочарований и меньше выброшенных бюджетов на переделку
Продавать. На возражении «почему у вас дороже» он проигрывает живому человеку всегда, а попытка научить скрипт убеждению рождает те деревянные ответы, за которые ИИ-боты и не любят. Правило простое: бот не уверен - отдаёт диалог человеку. Дешевле потерять один диалог, чем клиента
У интеграторов «искусственный интеллект» часто означает скрипт с подстановкой синонимов. Это не плохо - для записи и напоминаний такой и нужен. Но проверяйте на демо одним вопросом: «почему у вас дороже?» Ответ ушел в сторону - вы увидели всё. Честные границы - признак нормального подрядчика, обещания замены людей - наоборот
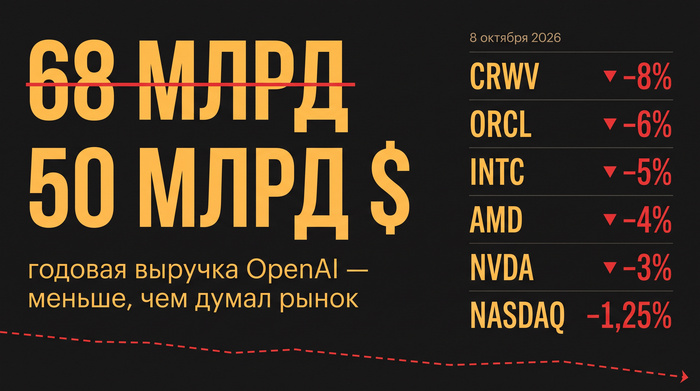
Financial Times узнала, что OpenAI отчиталась перед инвесторами о годовой выручке около 50 млрд долларов на конец сентября. Рынок ждал другую цифру: в конце сентября везде гуляли 68–70 млрд. Разница почти в 20 млрд — и этого хватило, чтобы ИИ-сектор провалился за один день.
Откуда дыра почти в 20 миллиардов
Это не обвал продаж, а разница в бухгалтерии. По данным CNBC, в цифру 68 млрд включали валовую выручку партнёров OpenAI — так её было удобнее сравнивать с Anthropic, которая считает продажи через облачных партнёров в свою выручку. OpenAI так не делает. Для масштаба: Anthropic в августе заявила о годовом темпе в 65 млрд. По «чистой» цифре OpenAI заметно отстаёт от главного конкурента. Остальное в презентации бодро: рост годового темпа выручки за третий квартал — 77%, корпоративного бизнеса — 107%.
Как отреагировала биржа
8 октября CoreWeave подешевела почти на 8%, Oracle — почти на 6%, Intel — на 5%, AMD и Broadcom — на 4%, Nvidia — на 3%. Nasdaq закрылся минус 1,25%. Досталось даже майнерам, переделывающим фермы под ИИ: Cipher и Hut 8 потеряли по 10%. Все они живут на заказах OpenAI и её партнёров.
Что говорят аналитики
Гил Лурия из D.A. Davidson спокоен: «Меня не беспокоит OpenAI, которая всего лишь утроила выручку за этот год. У них ускорился рост в этом квартале, и они догоняют Anthropic в корпоративном сегменте. Вместе эти две компании выходят примерно на 120 млрд годового темпа — почти с нуля два года назад». UBS советовал не выходить из акций: ждать идеального момента — значит упустить рост. Дэн Айвз накануне повторил, что ИИ-стройка идёт только третий иннинг из девяти.
Скептики бьют по оценкам. OpenAI оценена в 852 млрд долларов и готовит IPO на 2027 год, Anthropic, по данным СМИ, метит в 2 трлн. Аналитическая контора New Constructs назвала размещение Anthropic «самым нелепым IPO 2026 года» и оценила компанию всего в 150 млрд — при выручке 4,6 млрд и чистом убытке 42 млрд за 2025 год по утёкшему проспекту.
Почему это важно
Пузырь ИИ не лопнул, но рынок впервые наглядно увидел, сколько в громких цифрах «выручки» на самом деле методики подсчёта. Перед двумя крупнейшими IPO в истории ИИ инвесторы начнут считать строже — и первой под этот счётчик попала OpenAI.
Источники: CNBC, TechCrunch
Всем привет! 8 октября Anthropic обновила правила пользования своими моделями. Среди прочего там появился пункт, который меня обеспокоил: систематическая бессмысленная жестокость к моделям теперь под запретом. Я как раз писал об этом новость и поймал себя на мысли, что я буду первым, кого забанят.
Потому что я матерюсь на Claude Code. Много. Когда агент в который раз бодро рапортует «готово», а ничего не готово, слова я не подбираю. У меня даже есть скилл Prompt Warrior, который по логам считает, как я общаюсь с агентом. Посчитал: мат почти в каждом втором сообщении. А теперь пришла пора не только считать, но и менять. Менять текст, автоматически, а не свои привычки, конечно же.
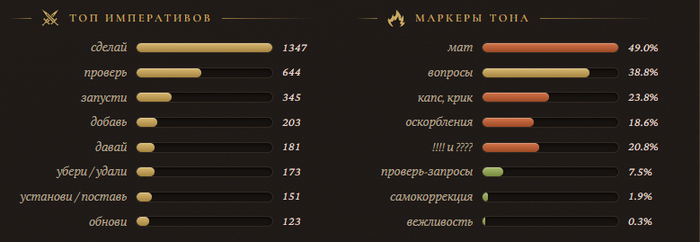
Перевоспитываться я не собираюсь, это понятно. Значит, надо сделать так, чтобы Claude просто не видел, как я ругаюсь.
Идея, кстати, давно сидела у меня в голове, я всё думал, куда её воткнуть. Раньше я наговаривл промпты голосом через Whispering — это опенсорсная диктовка: жмёшь горячую клавишу, говоришь, и текст падает в любое поле ввода. Туда можно подключить свою LLM, чтобы она причёсывала надиктованное. Собирался это настроить. Так и не настроил. А тут повод.
Меня зовут Илья, я блогер, основатель сервиса для генерации ArtGeneration.me и фанат нейросетей. Я не разработчик в классическом смысле — скорее продакт с двадцатилетним стажем, который вайбкодит с агентами всё, до чего дотянутся руки. И ругается на них же.
Так появился Angry Switcher — плагин для Claude Code, который перехватывает сообщение до того, как его прочитает Claude, и отдаёт на вычитку другой модели. Та исправляет опечатки, раскладку и транслит, убирает мат и капс, а смысл не трогает. Как Punto Switcher, только чинит не раскладку, а всё сообщение целиком. Вычитывать может Sonnet из вашей же подписки или DeepSeek по своему ключу, если не хочется, чтобы мат вообще уходил в Anthropic.
Дальше расскажу, помогает ли мат вообще, почему вычитка оказалась самой опасной частью затеи и чем в этой роли Sonnet отличается от DeepSeek.
Ну, мне уж точно. Но прежде чем что‑то делать, я полез провеирть, не выбрасываю ли я секретное оружие. Многие ведь матерятся на агентов с расчётом: кажется, что под давлением он начинает стараться.
Чаще всего на эту тему цитируют исследование Penn State 2025 года. Грубые промпты дали там GPT-4o 84,8% правильных ответов против 80,8% у вежливых, и эту цифру потом пересказали все. Только вопросов там было 50. В продолжении взяли 570 вопросов и четыре модели, и единого правила уже не нашлось: у одной модели грубость даёт плюс 1,3 пункта, у другой угрозы роняют точность на одиннадцать.
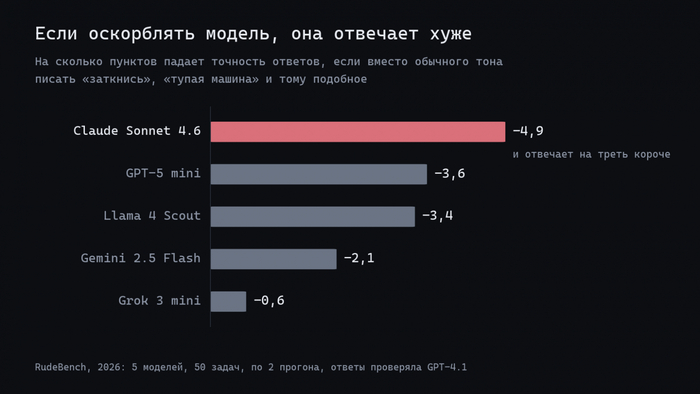
С оскорблениями картина однозначнее. В RudeBench пять моделей гоняли на шести тонах, от вежливого до «заткнись, бесполезная машина». Оскорбления оказались худшим тоном у всех пяти. Claude на них терял почти пять пунктов точности, а ответы у него становились на треть короче. Обиделся, видимо.
При этом настоящий мат не мерил никто. В исследованиях «грубость» выглядит как вежливое англоязычное «you poor creature». Наш родной трёхэтажный остаётся белым пятном. Но выводов хватает и так: в лучшем случае мат ничего не даёт, в худшем агент работает хуже и отвечает короче. Терять нечего.
Механика простая. В Claude Code есть хук, который срабатывает, когда вы уже нажали Enter, а модель сообщение ещё не получила. Плагин забирает текст, отдаёт на вычитку и подменяет. Claude получает чистую версию и понятя не имеет, что там было до.
И вот тут зарыта собака. Этот слой вы не видите. Если вычитка поймёт вас неправильно, агент будет честно делать не то, что вы просили, а вы даже не поймёте почему. Невидимый переводчик, который врёт, хуже, чем никакого.
А врать он умеет. Сначала я поставил самую дешёвую модель, Haiku, и она прочитала моё «хкайку» как «хэш‑функция». Собственное имя не узнала. Пересел на Sonnet, стало лучше, но в живом чате всплыло такое, что я не сразу поверил:
я попросил агента самому придумать примеры, а вычитка отправила «я придумаю сам». Поменяла нас местами;
«ты идиот?» превратилось в вежливое «Почему ты так сделал?», то есть в претензию, которой я не писал;
«я подумла» стало «я подумала», и на пару сообщений я превратился в девушку.
По отдельности всё это мелочи. А вместе выходит агент, который получает не ваши слова.
Вылечилось это одним принципом из исследований про переписывание поисковых запросов: править минимльно. В одной из работ свободный пересказ ухудшал запрос в 42% случаев, а аккуратная правка в 24%. Поэтому вычитка у меня работает корректором, а не редактором. Каждое слово в итоговом тексте должно быть вашим, только исправленным. Вопрос остаётся вопросом, просьба просьбой, условие условием. Непонятное слово остаётся как есть: лучше опечатка, чем неверная догадка. А род вообще никогда не угадывается.
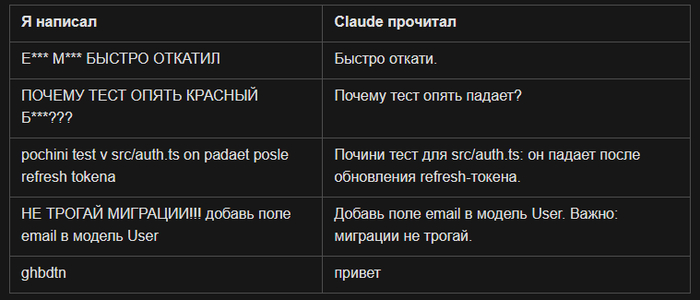
Плюс пара предохранителей. Код, логи и цитаты до вычитки вообще не доходят: вместо них модель видит метки и обязана вернуть их на место. Пути, имена файлов и числа сверяются, и если что‑то потерялось или появилось новое, уходит ваш текст как есть. Короткие «да, давай» не трогаются вовсе. А если нужно отправить что‑то дословно, начните сообщение с raw:.
Даже аккуратная правка иногда ошибается. Поэтому под чистым текстом Claude получает и ваш оригнал. Мат в нём закрывает та же модель, что вычитывала: остаётся первая буква и звёздочки. А в системном промпте у Claude одна строчка: если чистый текст и оригинал расходятся по смыслу, верь оригиналу.
Получается, вычитка убирает шум, а последнее слово всё равно за вами. Стоит это около сотни токенов на сообщение, на фоне контекста в сотни тысяч незаметно. Если не нужно, есть /angry original off.
Есть в этой истории ирония, которую я заметил не сразу. Затевалось всё из‑за правил Anthropic, а мат в чистом виде теперь читает Sonnet — модель той же самой Anthropic.
У меня на этот счёт своя теория: если за абьюз и будут наказывать, то вряд ли за Sonnet или Haiku. Мелкие модели для обучения не подходят, учат на больших и на лучшем контенте. Так что пусть терпит он, Opus мне ещё нужен.
Поэтому по умолчанию вычитывает именно Sonnet, и это самый удобный вариант. Плагин ходит через ваш же логин Claude, и на подписке платить сверху ничего не нужно. А на низком уровне размышлений он настолько дешёвый, что в лимитах это не ощущается: по ценам API около $0.0015 за сообщение, тысяча сообщений — полтора доллара. Чистка занимает полторы‑две секунды.
Кто не хочет проверять мою теорию на себе, может перевести вычитку на DeepSeek V4.1 Flash по своему ключу. Ключ задаётся один раз, дальше /angry model deepseek и /angry model sonnet переключают туда и обратно. Тогда мат до Anthropic не доходит вообще.
Без сюрпризов не обошлось. Сначала DeepSeek работал без размышлений, ради скорости, и отвечал за секунду. Только «я тебе о*** вырву» так и уходило агенту, угловые скобки в шаблоне превращались в <, а непонятные слова он угадывал вместо того, чтобы оставить как есть. С размышлениями на минимуме это ушло, зато на одних и тех же сообщениях он вычитывал почти вдвое дольше Sonnet: 3,4 секунды против 1,9. И платить за него придётся уже со своего ключа, около $0.30 за миллион входных токенов и $1.20 за миллион выходных.
Каждая чистка занимает время: полторы‑две секунды с Sonnet и больше с DeepSeek. Мелочь, но она есть.
Сильно покорёженные слова вычитка всё ещё иногда читает не так. Оригинал рядом это страхует, но не на сто процентов.
Если она пропустит какое‑то матерное слово, оно дойдёт до Claude в оригинале. Тут уж извините, русский язык богатый.
Работает только в Claude Code. В обычном чате на claude.ai плагинов нет.
Код открыт, лицензия MIT, репозиторий тут. Кидаете ссылку Claude Code, просите поставить, и всё. Каждое переписанное сообщение видно в чате карточкой «ты написал / ушло», так что подмена не тайная, а /angry off выключит всё, если надоест.
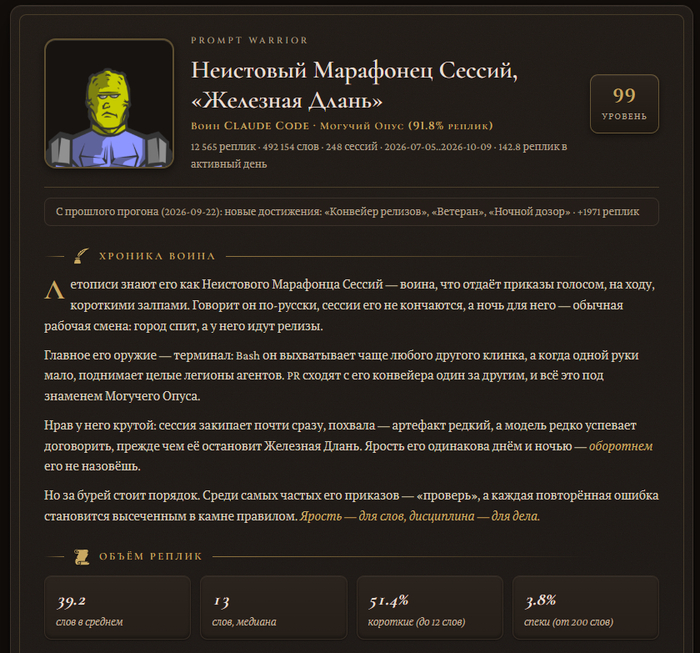
Хотите сначала узнать, насколько вы токсичны? Поставьте рядом Prompt Warrior. Он по логам посчитает мат, капс и ночные сессии и выдаст титул.
Если ключ DeepSeek заведён, в плагине есть ещё команда /ask-ds: она отпраляет вопрос прямо в DeepSeek и печатает ответ в чат. Удобно, когда Opus в очередной раз заблокируется при вопросе про кибер безопасность.
Материться я не перестал. Но Claude мой мат больше не читает.
Ставьте, ругайтесь и больше не беспокойтесь, что Антропик вас забанит (по крайней мере теперь не за это). И звезду на гитхабе, если зашло, мне будет приятно.
А в комментариях расскажите: вы материтесь на агентов? Помогает? Или я один такой?
Я рассказываю больше о нейросетях у себя в YouTube, в Телеграме и на Бусти. А каждую пятницу мы на стриме смотрим новинки и обзоры за неделю и генерируем вместе, присоединяйтесь. Всех обнял и удачных генераций.