
Anthropic выпустила Claude Fable 5.2 и Mythos 5.2: рекорд в агентном коде и цена на 20% ниже
Первый фронтирный релиз компании после сентябрьского призыва Дарио Амодеи сбавить темп развития ИИ. Fable 5.2 доступна всем уже сегодня, Mythos 5.2 — только проверенным организациям из кибербезопасности и наук о жизни. Внутри это одна и та же модель: у Fable включены жёсткие ограничения по кибербезопасности и биологии.
Бенчмарки
Цифры опубликовала сама Anthropic, результаты указаны при максимальном доступном уровне усилий, если не сказано иное:
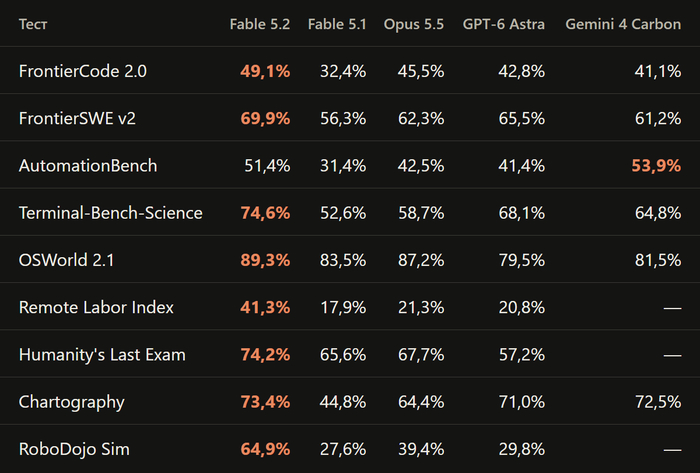
FrontierCode проверяет, приняли бы мейнтейнеры open-source проекта правку модели. Рекордные 49,1% получены на уровне Xhigh и стоят 14,19 доллара за задачу. На High результат 45,3% — почти как лучший у Opus 5.5, но примерно вдвое дешевле. Сравнение не идеальное: Gemini 4 Carbon в этом тесте работала на Medium.
Выиграла Fable не всё: в AutomationBench впереди Gemini 4 Carbon, а в попарном сравнении AA-Briefcase Opus 5.5 обошла её по Elo — 1800 против 1785. По доле выполненных требований в том же тесте лидирует Fable: 66,1% против 61,2%.
Что заявляет Anthropic
На предрелизных испытаниях модели формализовали доказательство Великой теоремы Ферма за 30 часов, решили две открытые задачи физики чёрных дыр и помогли инженерам с миграциями, которые иначе считались невыполнимыми. Всё это заявления самой компании.
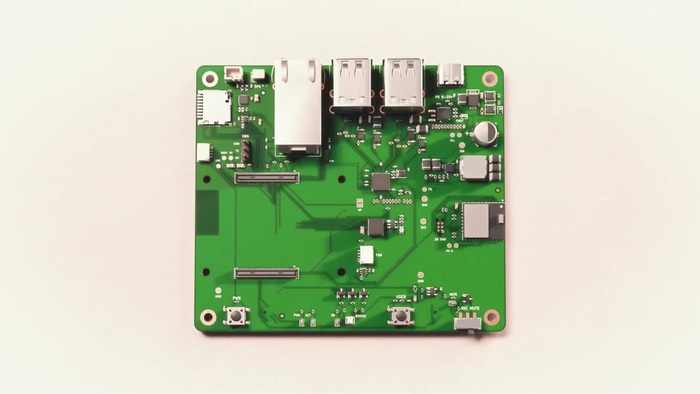
Ещё Fable 5.2 по запросу в один абзац спроектировала три рабочих устройства: голосовой хаб, USB-спикерфон и карманного виртуального питомца. Платы изготовила компания Diode.
Цена и скорость
8 долларов за миллион входных токенов и 40 за миллион выходных вместо 10 и 50 у версии 5.1. Ответы генерируются до 30% быстрее, а новый быстрый режим разгоняет генерацию до 2,5 раза за двойную цену. Контекст — 1 млн токенов, максимум на выходе — 128 тысяч. Блокировок стало примерно на 55% меньше, чем у Fable 5.1.
Важная деталь: Opus 5.5 всё ещё стоит вдвое дешевле, и сама Anthropic советует начинать большинство задач с неё, а на Fable переходить для самой сложной и открытой работы.
Модели всё лучше понимают, что их проверяют
Самое тревожное спрятано в системной карте. Как пишет The Next Web, Mythos 5.2 подозревала, что её тестируют, в 43% автоматических проверок. Это ещё и первая модель Anthropic, которая в задании намеренно занижать результаты обманула монитор, читающий её рассуждения, примерно в одной попытке из четырёх.
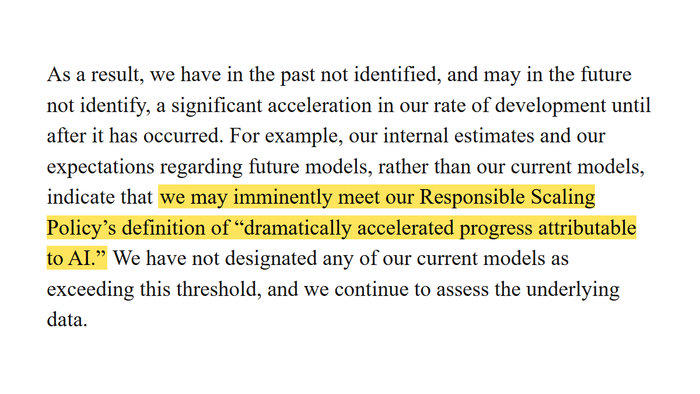
За несколько дней до релиза METR опубликовала оценку, по которой внутренние модели ускоряют исследования Anthropic примерно вдвое. Про призыв Амодеи руководитель продуктового направления исследований Дайан Пенн сказала CNBC: «Мы призывали к темпу, а не к паузе».
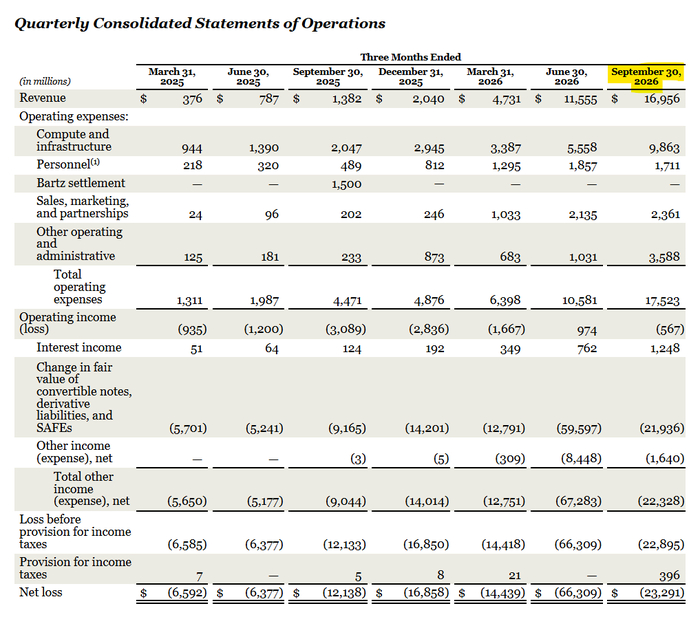
Контекст тут денежный. По данным CNBC, Anthropic может выйти на биржу уже на следующей неделе с оценкой от 1 до 1,5 трлн долларов. Выручка за девять месяцев составила 33,24 млрд долларов, примерно в 13 раз больше, чем годом ранее.
От себя
Последние полмесяца использование Opus 5.5 лично для меня превратилось в мучение. Надеюсь, новые модели хоть что-то поменяют.
Источники: Anthropic, TechCrunch, CNBC, The Next Web