Сообщество - Нейро-Музыка

Нейро-Музыка

456 постов • 231 подписчик

Популярные теги в сообществе:

240

YuE2 Studio: бесплатная замена Suno, нейросеть сначала пишет ноты, потом поёт песню — теперь локально на своей видеокарте⁠⁠

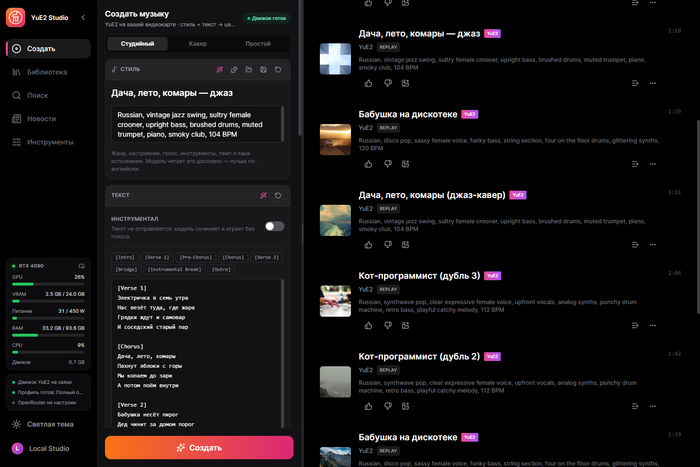
Собрал десктопную студию для YuE2 — новой открытой модели генерации песен от команды M-A-P (Multimodal Art Projection). Пишете стиль и текст, получаете полноценную песню с вокалом и аккомпанементом в 48 кГц стерео. Всё считается на вашей видеокарте: без облака, подписок, очередей и без установки Python.

Что за модель YuE2

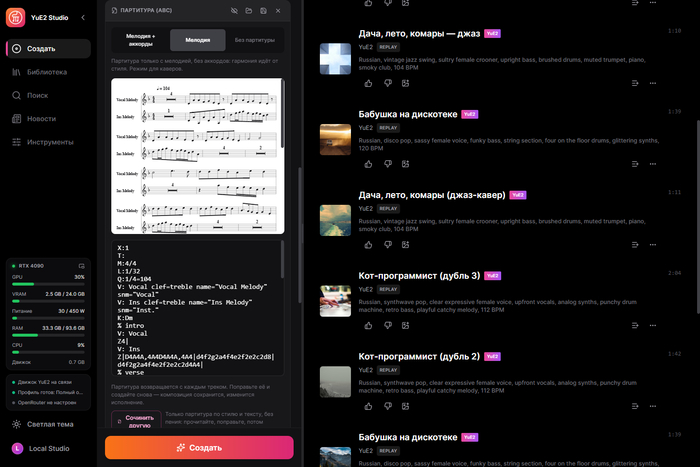
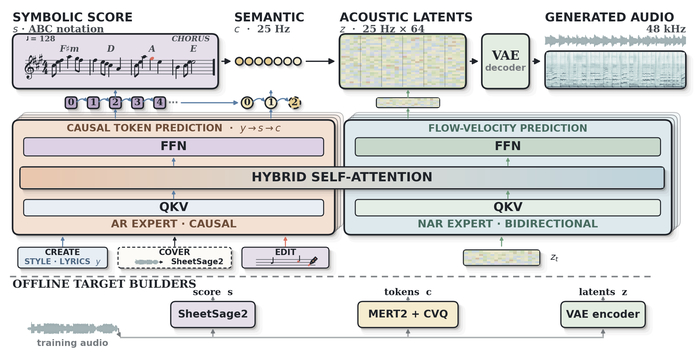
YuE2 — вторая версия открытой модели YuE. Её главная идея — символьное планирование: прежде чем петь, модель пишет композицию нотами в формате ABC — мелодию вокала, инструментальную тему и аккорды — и только потом по этой партитуре генерирует звук. У закрытых сервисов вроде Suno партитуры нет: песня выходит такой, какой вышла, и одну ноту в ней не поправишь. Здесь можно открыть ноты, поменять мелодию, аккорды, темп или тональность и перепеть ту же композицию.

Внутри один трансформер примерно на 3,6 млрд параметров, собранный из двух «экспертов» с общим вниманием (Mixture-of-Transformers):

  • AR-эксперт (причинный, токен за токеном) читает стиль и текст, пишет партитуру, а по ней — семантические токены музыки, 25 штук в секунду;

  • NAR-эксперт (двунаправленный) методом flow matching превращает эти токены в акустические латенты;

  • VAE-декодер собирает из латентов готовое стерео 48 кГц.

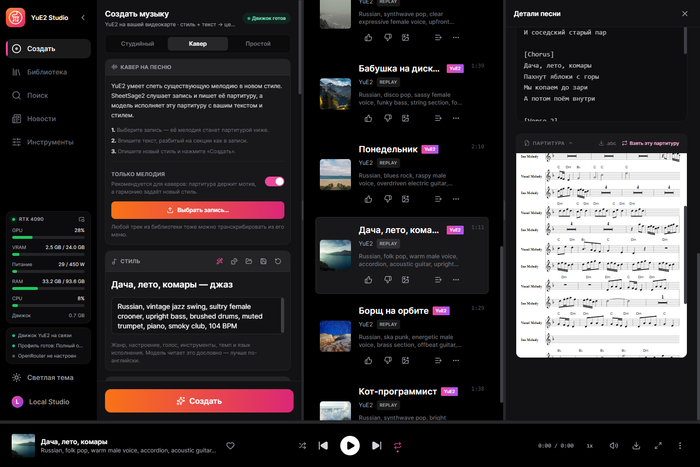
Для каверов в ту же схему встраивается SheetSage2: он слушает запись и снимает с неё мелодию в такую же партитуру, которую YuE2 потом поёт в новом стиле. Схема из официальной карточки модели на Hugging Face:
Насколько хорошо она поёт

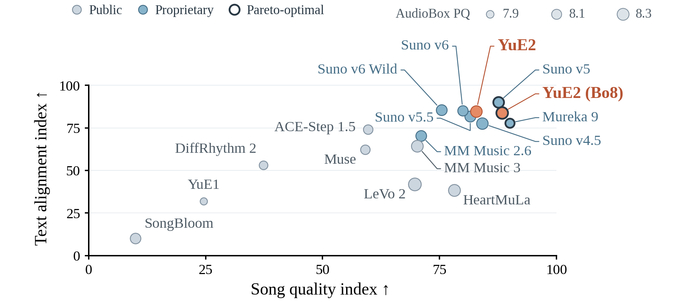
Авторы прогнали модель через WildSongBench — 192 промпта и 17 систем, включая свежий Suno v6. По среднему баллу SongBench YuE2 в режиме best-of-8 (лучший из восьми вариантов) набрала 6,96 — это выше Suno v5 (6,87), Mureka 9 (6,94) и Suno v6 (6,56). В обычном режиме, где выбирается лучший из двух, — 6,73. Это цифры самих авторов, но и на слух модель действительно выдаёт цельные песни с понятной дикцией.

Партитура решает и в каверах. На тесте SHS100K YuE2 с полной партитурой сохраняет мелодию так, что кавер узнаётся как та же песня в 71% случаев — у открытой ACE-Step 1.5 на этом же тесте 2,4%. На графике ниже по горизонтали качество песни, по вертикали — насколько точно модель следует тексту и описанию:
Зачем понадобилась студия

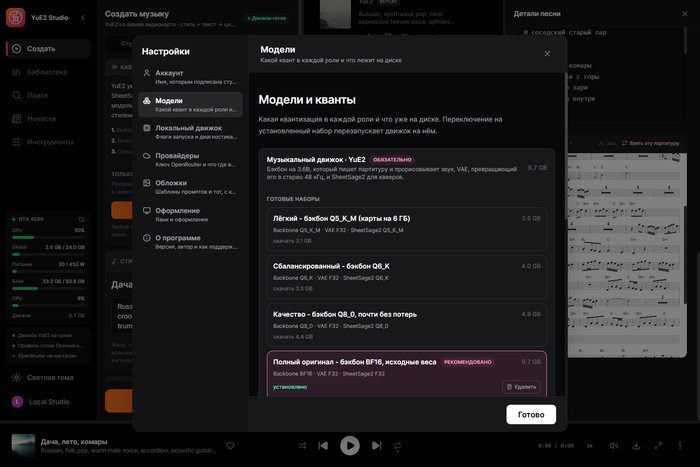
Официально YuE2 запускается из Python-кода через PyTorch, а для полной точности нужна карта на 24 ГБ. Я собрал YuE2 Studio на нативном движке yue2.cpp (C++/CUDA с квантованными весами GGUF): один exe для Windows, без Python и зависимостей, работает от 6 ГБ видеопамяти. Внутри — всё, что умеет модель, и ещё немного сверху:

  • Полные песни до шести минут по стилю и тексту. На RTX 4090 трек длиной 3:38 рендерится примерно за 46 секунд

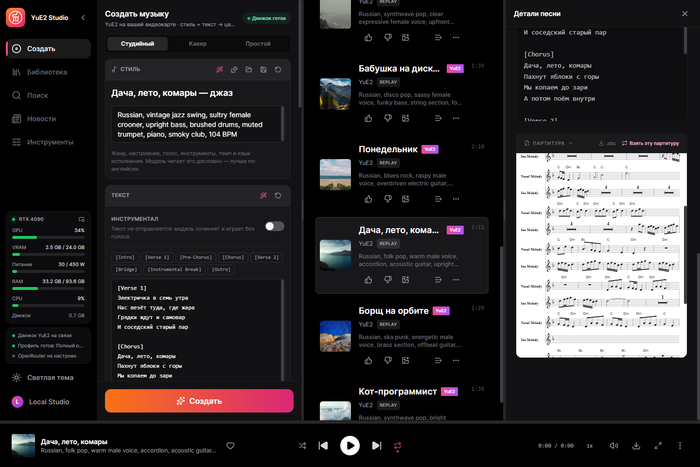
  • Редактируемая партитура — композиция приходит нотным станом и текстом ABC. Поменяли ноты, темп или тональность — композиция та же, исполнение новое. Режимы «мелодия с аккордами», «только мелодия» и «без партитуры»

  • Сначала только ноты — партитура за секунды, без пения: прочитать, поправить и уже потом петь

  • Каверы — SheetSage2 снимает мелодию с записи, YuE2 поёт её в вашем стиле. Слова должны ложиться на эту мелодию: оригинальный текст или новый с тем же числом слогов в каждой строке и ударениями на тех же нотах

  • Точный перерендер — каждый трек хранит запрос и аудиокоды: его можно отрисовать заново бит в бит или с другими шагами, сидом звука и форматом, не сочиняя заново

  • Ассистент-соавтор — локальная Gemma или OpenRouter пишет стиль и текст по идее в одну строку и правит партитуру по просьбе

  • Караоке по словам — тайминг каждого слова через Parakeet или Whisper, а встроенный видеоредактор собирает из трека клип с караоке прямо на видеокарте

  • Разбор песни на дорожки — трек раскладывается на шесть стемов: барабаны, бас, вокал, гитару, пианино и всё остальное. Можно вытащить минус или чистый вокал

  • 110 готовых примеров из yue2.cpp в один клик и доступ ко всем настройкам движка: сэмплинг, шаги, гайденс, сиды, MP3 или WAV 16/24/32 бит

  • Библиотека — поиск, плейлисты, обложки по шаблонам, MP3 с названием, текстом и обложкой в тегах

  • Всё рядом с exe — модели, песни, настройки и временные файлы лежат в папке студии, установленная версия обновляется сама. Интерфейс на русском, английском, китайском, японском и корейском

Что нужно для запуска

  • Система: Windows 10/11 x64

  • Видеокарта: NVIDIA от 6 ГБ VRAM (GTX 16 / RTX 20 и новее); AMD и Intel через Vulkan — экспериментально

  • Место на диске: от ~4 ГБ с лёгким набором моделей до ~34 ГБ со всеми самыми тяжёлыми

  • Лицензия: студия — MIT, веса YuE2 — CC BY-NC 4.0, то есть песни только для некоммерческого использования

Установка

1. Скачайте с GitHub установщик (обновляется сам) или портативный архив — его можно распаковать куда угодно.
2. Запустите YuE2-Studio.exe: студия определит видеокарту и предложит подходящий набор моделей от 3,6 до 10,4 ГБ.
3. Нажмите «Скачать» — загрузка идёт в несколько потоков, с докачкой и проверкой контрольных сумм.
4. Напишите стиль и текст или откройте пример и нажмите «Создать» — движок запустится сам.

Песни, сделанные в студии, на русском, английском, испанском, китайском и японском, можно послушать на странице проекта. А выше — клипы с караоке, собранные встроенным видеоредактором.

⭐️ Поставить звезду на GitHub

📦 Скачать релиз, портативку или установщик

А больше удобных репаков полезных нейросетей в моем телеграм канале НейроСофт
Показать полностью 7 4
5

Google выпустила Gemini 3.8 Flash TTS: голос для озвучки теперь описывают словами⁠⁠

Google представила две модели синтеза речи: Gemini 3.8 Flash TTS и облегчённую Flash-Lite TTS. Главная фишка — дизайн голоса. Диктора больше не выбирают из каталога: пишешь, кого хочешь услышать (роль, акцент, тембр), и модель собирает новый голос с нуля. В примерах Google — диджей из Мельбурна, монотонный робот и японский дракон.

Что умеет

Больше 100 языков и диалектов, а библиотека готовых голосов выросла с 30 до 2000 с лишним, включая региональные варианты вроде мексиканского испанского и квебекского французского. Модель играет по ремаркам: к каждой реплике можно дописать, как её произнести, вставить смех, вздох или поддакивание «угу», развести диалог на два голоса. Google обещает, что голос не «плывёт» даже на часах непрерывного аудио, а это критично для аудиокниг и подкастов.

Клонировать можно и собственный голос: нужны 30 секунд записи и отдельно записанное согласие, причём голос в согласии должен совпасть с образцом. Во всё сгенерированное вшивается неслышимая метка SynthID.

Цена и качество

До конца 2026 года миллион токенов звука стоит 9 долларов у Flash и 6 у Flash-Lite, с 2027-го — вдвое дороже. Секунда аудио — 25 токенов, так что час озвучки на Flash обходится примерно в 80 центов. Модели уже доступны в Gemini API и Google AI Studio без листа ожидания, открытых весов нет.

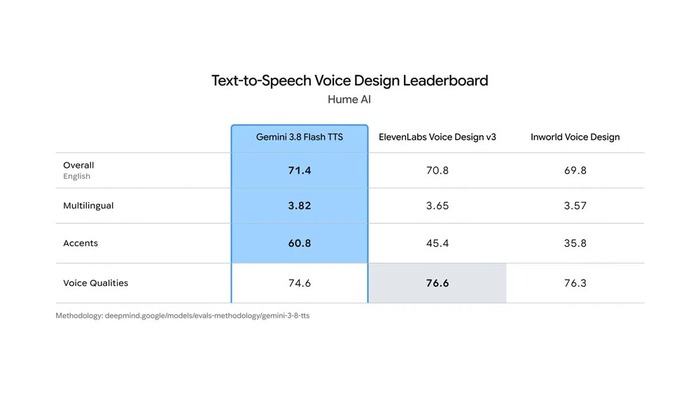
В бенчмарке дизайна голоса от Hume AI Flash TTS первая с 71,4 балла, но от ElevenLabs Voice Design v3 (70,8) её отделяют доли балла, а по естественности тембра ElevenLabs всё ещё впереди. Заметно Google обходит конкурентов только в акцентах: 60,8 против 45,4.

Дизайн голоса по описанию до сих пор был козырем ElevenLabs. Теперь Google отдаёт то же самое через API, на сотне языков и дешевле доллара за час, и для озвучки игр, дубляжа и аудиокниг голос персонажа становится вопросом одной строки текста, а не кастинга.

Источники: MarkTechPost · The Decoder · Google

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью 1
6

ElevenLabs выпустила Music v2.5 — генератор музыки с lossless на бесплатном тарифе и ставкой на «чистые» данные⁠⁠

ElevenLabs выпустила Music v2.5 — генератор музыки с lossless на бесплатном тарифе и ставкой на «чистые» данные

ElevenLabs обновила свой генератор музыки до версии 2.5 и называет её лучшей на сегодня. Главное тут не только в качестве звучания, но и в том, на чём модель обучена и что тебе разрешают делать с готовым треком.

Что изменилось в звуке

По словам компании, треки стали полнее и естественнее: больше слоёв, живее инструменты, композиция лучше держится от начала до конца. В слепом тесте на 47 885 парах (один трек старой v2 и один новой v2.5 на один и тот же промпт) слушатели чаще выбирали v2.5 — особенно в вокальных и «живых» жанрах: R&B, соул, хип-хоп, рок, метал, оркестровая и кинематографическая музыка.

v2.5 теперь стоит по умолчанию для генерации по промпту и по референсу, но старая v2 остаётся доступной. Модель работает не только в приложении ElevenMusic, но и в инструментах ElevenCreative, Studio, Flows и через API — то есть её можно встроить в свой продукт. Вокал — на нескольких языках, включая английский, испанский, немецкий и японский.

Права и тарифы

Ключевое для авторов: права на созданный трек остаются у тебя на любом тарифе, включая бесплатный, и закрепляются в момент создания — отмена или даунгрейд подписки этого не отменяют. Бесплатный план даёт 5 lossless-загрузок в день (но с обязательной подписью «Made with ElevenMusic»), Pro — 400 в месяц и без атрибуции, с правом выкладывать на стриминги. Треки, которые ссылаются на чужие песни, скачать нельзя, имитировать конкретных музыкантов запрещено.

Почему это важно

ElevenLabs подчёркивает, что обучала модель на лицензированных стемах и музыке (без раскрытия деталей датасета). Это прямой укол в сторону Suno, которого судят за обучение на копирайтном контенте без согласия правообладателей — и который, кстати, на этой неделе тоже обновил свои модели. Отдельная многолетняя сделка ElevenLabs с Universal Music Group к v2.5 отношения не имеет: она про будущие продукты с ремиксами и персонализированным вокалом. Похоже, в гонке ИИ-музыки чистота обучающих данных превращается из юридической мелочи в главный коммерческий козырь.

Источник: блог ElevenMusic · The Decoder

Больше про генерацию музыки и звуков — в нашем канале: НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью
2

Suno выпустила v6 — впервые на лицензионной музыке Warner, BMG и Believe⁠⁠

Suno выпустила v6 — впервые на лицензионной музыке Warner, BMG и Believe

Suno выкатила шестое поколение моделей и одновременно списала все предыдущие. Главное здесь не качество звука: v6, по словам компании, обучена не на тех данных, что прежние версии. Соразработчиками названы Warner Music Group, BMG и Believe — сервис, который два года таскают по судам за музыку, скачанную из интернета, впервые выпустил модель, за обучающий материал которой заплатил.

Что вышло

Моделей три. Базовая v6 для подписчиков Pro и Premier — «надёжная, точная, стабильно выдаёт отполированную музыку в любом жанре». v6-wild — экспериментальная, «менее предсказуемая и более разнообразная». v6-mini — быстрая и бесплатная для всех. Ввод стал мультимодальным: текст, аудио, картинка, видео. Отдельные куски трека теперь правятся текстовой командой, без перегенерации песни целиком. Все старые версии выводятся из обращения, включая v5.5 с клонированием голоса (март 2026) и v5, вышедшую ровно год назад.

Как пираты стали лицензиатами

Разворот готовился почти два года. В июне 2024 RIAA подала скоординированный иск от лица мейджоров. Warner первым пошёл на мировую в ноябре 2025, и условием сделки была не разовая выплата, а «лицензированные модели-преемники» — обязательство переучить сам продукт. BMG подписался в августе 2026, Believe — в начале сентября. Между этими датами, в июле, мюнхенский суд признал Suno виновной в нарушении копирайта в версиях 3.5 и 4.

С новой моделью Suno будет платить лейблам и издателям за копирайт музыки, на которой она обучается.

Так директор по продукту Джек Броди описал схему в разговоре с Bloomberg. Финансовые условия, по его же словам, ещё не определены — как и детали программы, по которой артисты смогут добровольно пускать свои треки в ремиксы за долю выручки.

Что остаётся за кадром

Universal и Sony продолжают судиться, иск музыканта Джейсона Исбелла в силе, отдельно тянется дело об утечке пользовательских данных. Накануне анонса компания признала, что прежние модели учились в том числе на видео с YouTube. При этом Suno отказалась назвать, какие именно каталоги вошли в обучение v6 и в каком объёме: проверить «чистоту» данных снаружи невозможно — остаётся верить на слово компании с сотней миллионов пользователей, двумя миллионами платных подписок, выручкой около 300 млн долларов в год и оценкой в 5,4 млрд.

Проверка тут будет простая и быстрая: если модель, обученная по контракту, зазвучит не хуже той, что училась на скачанном, у индустрии генеративного аудио исчезнет главный аргумент — что «иначе никак».

Источники: The Decoder, TechCrunch

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью
3

Google завёл музыку прямо в Gemini: Lyria 3.5 пишет целые песни по одному запросу⁠⁠

Google завёл музыку прямо в Gemini: Lyria 3.5 пишет целые песни по одному запросу

Генерация музыки перестала быть отдельным сервисом, ради которого надо куда-то идти. 4 сентября Google открыл модель Lyria 3.5 всем пользователям Gemini — в вебе и в мобильном приложении, по всему миру. Песня теперь появляется там же, где вы спрашиваете про погоду.

Что именно она делает

Ключевое отличие от прошлых версий — модель собирает не зацикленный мелодический фрагмент, а песню целиком: с куплетами, припевами и бриджем, в стерео высокой точности, длиной до трёх минут. В приложении можно выбрать короткий трек или длинный, задать жанр словами или взять готовый шаблон, включить вокал или оставить чистый инструментал.

По сравнению с предшественницей Google обещает более выразительный вокал и более богатые аранжировки: мелодические структуры сложнее, следование запросу точнее, голос звучит эмоционально достовернее. Одновременно модель уехала в Gemini API, Google AI Studio, Flow Music и Vids — то есть доступна и разработчикам, и внутри рабочих инструментов компании.

Два пункта, которые важнее самой модели

Первый: Google утверждает, что Lyria обучена только на лицензионном материале — правда, не раскрывая конкретных источников. На фоне того, что почти все крупные музыкальные ИИ-сервисы сейчас так или иначе объясняются с правообладателями, это заявленное отличие, а не техническая деталь.

Второй: каждый трек получает незаметную метку SynthID, по которой слушатели и площадки могут определить, что музыка создана или отредактирована ИИ. Стриминги как раз сейчас выстраивают политику по ИИ-контенту — наличие метки на выходе делает такую музыку опознаваемой по умолчанию.

Почему это важно

Suno и Udio выигрывали не только качеством, но и тем, что были единственным местом, куда шёл человек за ИИ-песней. Google этот аргумент обнуляет: он не делает продукт лучше конкурентов, он делает его ближе — в приложении, которое у пользователя уже открыто. Дистрибуция против качества, и по этой части у Google карты сильнее.

Источники: Android Authority, The Decoder

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью
7

Bulka: бесплатный редактор музыки, где код за тебя пишет AI-агент. Теперь десктоп-приложение с управлением по MCP⁠⁠

Bulka: бесплатный редактор музыки, где код за тебя пишет AI-агент. Теперь десктоп-приложение с управлением по MCP

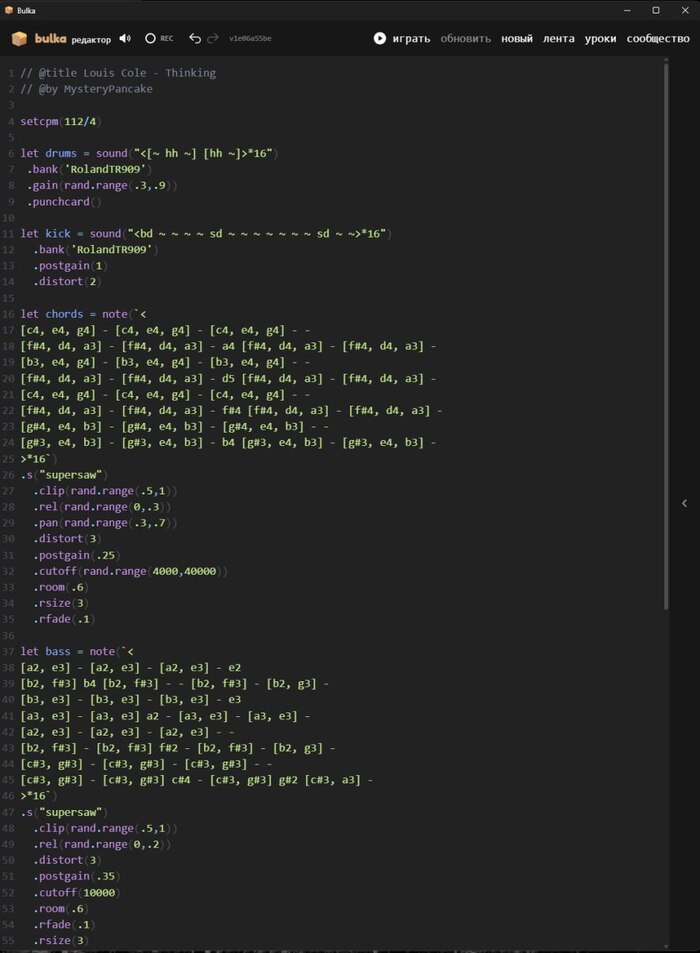
Bulka — редактор, где музыку пишут не мышкой в дорожках, а кодом: пара строк — и играет бит, бас, мелодия. Под капотом движок Strudel (лайв-кодинг музыки), а сверху встроенный AI-агент: описываешь словами, что хочешь услышать, а он сам подбирает звуки, пишет код и запускает трек вживую.

За последние сутки прилетело большое обновление: Bulka из веб-странички превратилась в полноценное десктоп-приложение, научилась работать с локальными моделями и получила управление по MCP. Ниже — по порядку, с видео.

Главное: теперь это десктоп-приложение

Раньше Bulka жила только в браузере. Теперь есть нормальное приложение под Windows: установщик .exe (ставится как обычная программа и дальше обновляется сам) и портативная версия (распаковал — запустил). Работает офлайн, все ключи и настройки хранятся локально, ничего не уходит в облако.

Локальные модели — генерация без ключей и интернета

Добавили провайдер «Локально (LM Studio / Ollama)»: запускаешь у себя любую модель — и Bulka пишет музыку полностью офлайн, без ключей и токенов, со своими настройками (температура, лимит токенов, уровень reasoning). А кто вообще не хочет ничего настраивать — есть бесплатный режим без ключа (через OVHcloud): открыл и пользуешься.

Провайдеры с реальными параметрами

Нужны топовые модели — подключаются OpenRouter (сотни моделей, и у каждой Bulka подтягивает её настоящие параметры и настройки reasoning, а не догадки), а также OpenAI, Anthropic, Gemini и Z.AI. И теперь видно, как модель рассуждает: reasoning показывается вживую у всех моделей, а не только у отдельных.

Управление по MCP — Bulka как инструмент для внешнего агента

Самое вкусное для гиков. У Bulka теперь встроенный MCP-сервер: подключаешь её к Claude Desktop, Cursor или ChatGPT — и внешний агент сам читает и пишет код в редакторе, запускает музыку, записывает результат и ищет по документации. Доступно 15 инструментов — ровно те же, что у встроенного агента Bulka. Чат двусторонний: агент отвечает прямо в окно Bulka.

Что ещё завезли

Запись в WAV — прямо из кода методом .record() или кнопкой. Можно записать хоть весь трек, хоть каждую партию отдельно: ставишь маркер вокруг секции — дошла музыка до неё, она и записалась как звучит. Индикатор записи горит, даже когда пишет агент по MCP.

Ещё: подтянут свежий движок Strudel (обновления оригинала за январь–август 2026, русифицированы), визуализация каждой секции (осциллоскоп и Hydra), автосохранение (код не теряется при перезагрузке), рабочие undo/redo и кнопка «Стоп», которая реально отменяет генерацию, а не только гасит её на экране.

Как поставить

Скачать установщик .exe с GitHub и запустить (дальше обновляется сам) — или взять портативный zip и распаковать в путь без кириллицы и пробелов. Ключи вбиваются в настройках, либо сразу включаешь бесплатный режим. Для локальных моделей — запустить LM Studio или Ollama и указать адрес.

GitHub

Скачать под Windows

Веб-версия: bulka.app

Сообщество Bulka (треки, вопросы)

Репаки и портативки полезных нейросетей — канал НЕЙРОСОФТ

Показать полностью 1 3
10

Австралия первой в мире выкинула ИИ-музыку из чартов⁠⁠

Австралия первой в мире выкинула ИИ-музыку из чартов

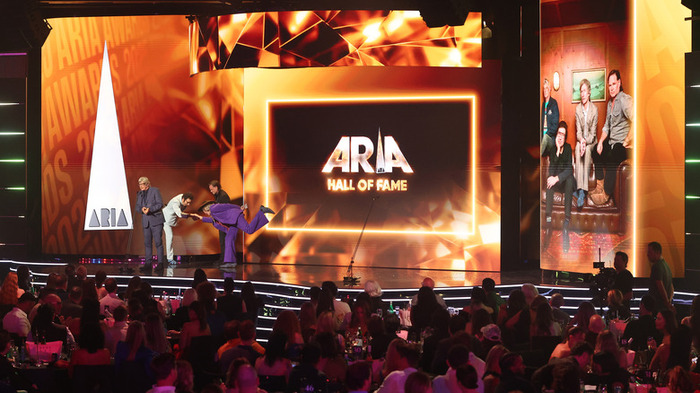
Австралийская ассоциация звукозаписи ARIA обновила чартовый кодекс: треки, целиком сгенерированные нейросетью, больше не имеют права попадать в национальный чарт. Правило действует с чарта, датированного 31 августа — публикуют его уже в пятницу, 28-го. ARIA стала первой национальной чартовой организацией в мире, которая довела июльские разговоры индустрии до реального регламента.

Что именно запрещено

Разделение — то самое, что RIAA и IFPI ввели ярлыками 10 июля: AI-Generated, когда нейросеть создала всю или основную творческую часть записи, и AI-Assisted, когда основную работу сделал человек, а ИИ помог с деталями. Первые из чарта вылетают, вторые остаются в игре. Чтобы остаться, запись должна быть «преимущественно созданной человеком», использовать легальный и авторизованный ИИ-сервис и не вызывать подозрений в накрутке стримов.

У правил есть зубы

Это не декларация о намерениях. ARIA может не принять релиз на учёт, снять его с чарта — в том числе задним числом, — пересчитать позиции, отозвать сертификации и даже отобрать награду ARIA No. 1. Трек, признанный неподходящим, автоматически теряет право и на премию ARIA Awards. Артистам оставили процедуру оспаривания: можно принести доказательства, что человек в записи всё-таки был.

Кто довёл до греха

Триггером стала конкретная история. Диджей и продюсер из Квинсленда Джош Фаваз выпустил кавер «Like a Prayer» Мадонны — в июле это была самая играемая песня на австралийском радио, а в двух чартах ARIA она добралась до 4-го места. Фаваз настаивал, что ИИ был «просто инструментом», но затем обновил данные трека в Spotify: вокал и барабаны сгенерированы. Представитель ARIA сказал ABC, что по новым правилам такой трек в чарт бы уже не прошёл — сгенерированный лид-вокал и ключевые инструментальные партии как раз дисквалифицируют.

«Артисты и так используют ИИ-инструменты, чарты могут и должны оставлять для этого место. Но музыка, созданная целиком сервисами, обученными на записях артистов, — совсем другое дело», — глава ARIA Аннабель Хёрд.

Почему это важно

В июле коалиция лейблов — Universal, Warner, Sony, HYBE, Believe, BMG — только просила чарты мира ввести такие правила, и формально их не принял никто: ни Billboard, ни стриминги. Австралия первой перевела просьбу в регламент со штрафными санкциями. Хёрд тут же обратилась к остальным: «Мы призываем всех, кто решает, какая музыка играет и продвигается для австралийской аудитории, — особенно радио, — поддержать человеческое творчество и внести похожие изменения в свои кодексы». По данным IFPI, к аналогичным правилам готовятся более 20 официальных чартов мира.

Показательно, что ломать сопротивление пришлось не абстрактному «ИИ-слопу», а треку, который люди реально слушали и крутили по радио весь месяц. Граница между «инструментом» и «генерацией» перестала быть философским вопросом ровно в тот момент, когда за неё зацепилась позиция в чарте.

Источники: Billboard · Reuters · ABC News

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества