0 просмотренных постов скрыто


Generals Reforged. Старая игра с новой графикой. Проект называется Zero Hour Reforged
Это не просто мод с новыми текстурами. Автор взял открытый исходный код игры и по сути занялся тем, чем EA уже давно не занимается - начал нормально обновлять саму Zero Hour под современные системы.

Что там уже есть: 64-битная версия, DirectX 11, улучшенные текстуры, тени, свет, взрывы и эффекты. Игра стала лучше работать на современных разрешениях, а картинка уже не привязана к старым 30 FPS.

Но самое интересное - изменения не только в графике. Техника теперь нормально разгоняется и тормозит, танки могут сдавать назад, вертолёты двигаются естественнее, большие группы меньше тупят при перемещении.

Отдельно автор серьёзно взялся за ИИ. Компьютер теперь строит нормальную базу, исследуют карту, подбирает войска под противника и даже умеет отступать. То есть это уже больше похоже не на обычный фанатский мод, а на попытку сделать современную версию Zero Hour, сохранив саму игру такой, какой мы её знаем.


Как вам? Попробовали бы такую Zero Hour?
Проект активно развивается на GitHub, и выглядит всё это очень любопытно. Тут галерея с картинками из игры.
▶️Небольшой видео обзор от автора, ютуб.
Показать полностью
4
1

Упала скорость раздачи торрентов
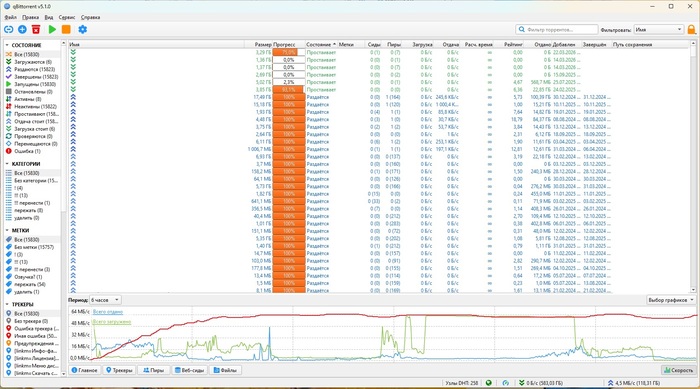
Леди и джентльмены, приветствую! Пришёл за советом к бывалым торрентоведам. С января этого года у меня резко упала скорость отдачи, в среднем в 10 раз (если раньше за день я раздавал около 1,5 ТБ, то сейчас порядка 150 ГБ). Раздач порядка 15 тысяч, в тч. весьма популярные, понятно, т.е. недостатка в личах не должно быть. При этом скорость загрузки по-прежнему на хорошем уровне, при наличии сидов. Для примера скриншот, там всё видно. Иногда скорость отдачи пиково подскакивает и тут же падает, как будто её что-то глушит. Красным пририсовал как график отдачи выглядел раньше. Настройки клиента перед этим не менял, смена портов не помогла. Оператор МГТС. Как благородный корсар готов раздавать днями, но ради 150 гигов гонять прожорливую машину... Может кто подскажет решение?
Насколько далеко можно зайти с RX 7900 XT в локальном ИИ? Мои тесты Qwen3.8 27B и предела памяти
У меня RX 7900 XT с 20 ГБ памяти. Решил разобраться, какую большую языковую модель на ней можно нормально использовать. Не просто запустить, получить «привет» и обрадоваться, а дать ей много текста, поработать с файлами и посмотреть, как быстро она будет отвечать.
Для ЛЛ: Qwen3.8 27B на RX 7900 XT работает вполне бодро: мой рабочий вариант держит окно в 131 тысячу токенов и выдаёт около 29 ток/с на почти заполненном контексте с включёнными рассуждениями. Начал с вопроса «что потянет моя карта», закончил 54 крупными этапами тестов.
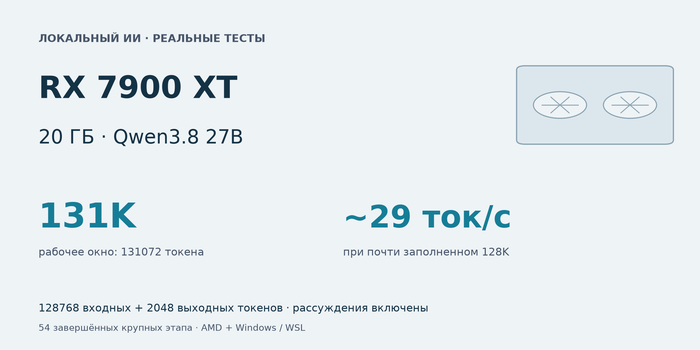
Вот главный результат, чтобы сразу было понятно, ради чего весь длиннопост: 128768 токенов на входе, ещё 2048 на выходе, скорость 29,38 ток/с. Всё это в окне 131072. Контекст действительно заполнялся во время работы, а не существовал только в настройках сервера.
Если слово «токен» ни о чём не говорит, это кусочек текста, с которым работает модель. Контекст задаёт, сколько такого текста она может держать одновременно. Считать в страницах неудобно: русский текст, английский и код дают разное количество токенов.
Мне эта история нужна была для Hermes, локального агента с инструментами. Хочется загрузить большую историю, поручить прочитать файл и продолжить работу. Поэтому условные 60 токенов в секунду на вопросе про борщ меня устраивали только как начало проверки.
Я не занимаюсь исследованиями LLM профессионально. Разбирался для себя. Результатов накопилось столько, что решил собрать их здесь: владельцу такой же карты пригодится, а желающему купить её будет на что посмотреть, кроме объёма памяти на коробке.
Сначала цифры, потом устройство этого хозяйства
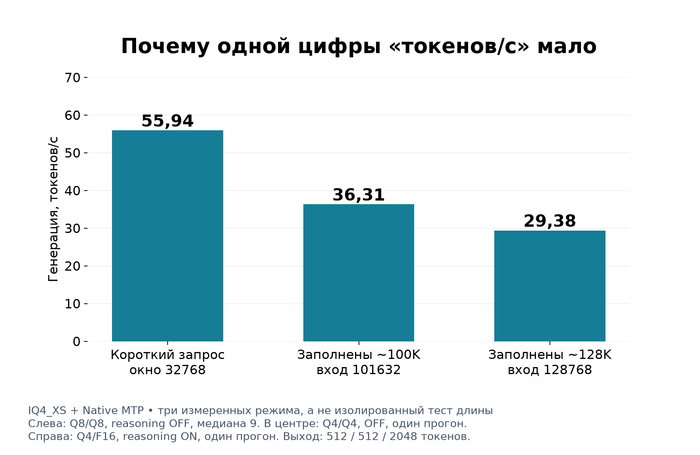
Если посмотреть только на скорость, на одной и той же карте получилось три довольно разных результата:
Короткие запросы: 50-60 ток/с с ускорением, в некоторых конфигурациях больше 60.
Заполненные примерно 100K: 36-37 ток/с с ускорением.
Финальный почти заполненный 128K с рассуждениями: около 29 ток/с.
Условия здесь разные, включая кэш и рассуждения. Это не чистый эксперимент только с длиной текста. Но для повседневного использования разница принципиальная: увидел в интернете «60 токенов/с», отправил модели большую историю, получил другую скорость. Карта при этом не сломалась.
Мой компьютер: RX 7900 XT 20 GiB, Ryzen 5 7500F, 32 ГБ RAM. Windows, WSL с Ubuntu 24.04, ROCm 7.2, gfx1100. Модель запускал через отдельную HIP-сборку llama.cpp с поддержкой MTP и Fast MTP.
Все результаты ниже про одну текстовую модель и один одновременный запрос. Картинки, видео и обслуживание нескольких пользователей здесь не проверял.
Как я дошёл до 54 этапов
Исходной точкой была уже установленная модель в Ollama, qwen3.8-27b-abliterated:112k. На коротком входе и окне 32768 она давала медиану 31,30 ток/с по девяти прогонам.
Потом взял HauhauCS Qwen3.8-27B-Uncensored-HauhauCS-Aggressive и пошёл перебирать варианты. Сразу оговорка: старая Huihui и новая Hauhau имеют разные модификации весов, движки тоже разные. Сравнивать их как «одно и то же, но теперь вдвое быстрее» нельзя. Поэтому дальше plain, Native и Fast сравниваются на одинаковых основных весах Hauhau.
Веса проверял в трёх квантовках: IQ3_M, IQ4_XS и Q4_K_P. Квантовка сжимает числа, которыми записана модель. Она позволяет уменьшить файл и расход памяти, но может повлиять на качество и скорость. Причём меньший файл вовсе не обязан работать быстрее.
Память контекста тоже проверял в трёх вариантах: F16, Q8_0 и Q4_0. К этому добавились три режима генерации, переносы в оперативку, тесты качества, русские запросы, полностью заполненные окна и поиск границ VRAM. А под конец ещё и настоящий агент с инструментом.
Первый бенчмарк запустился 4 октября 2026 года в 10:28 UTC, последние GPU-тесты закончились 5 октября в 14:36 UTC. Между ними примерно 28 часов 8 минут, включая паузу: компьютером я всё-таки ещё и пользуюсь. Итоговый отчёт сформирован в 14:43 UTC.
Если считать отдельно, три автоматизированные матрицы заняли около 15 часов 22 минут. Туда входят загрузки серверов и неудачная попытка, которую пришлось исправить и повторить. Финальные проверки профилей и установленного Hermes были дополнительно. Сумма сохранённых длительностей самих измерительных запросов составляет примерно 10 часов 59 минут. Это неполный учёт: без загрузок модели, отдельных процессов perplexity и запросов, у которых такое поле не сохранилось. Называть его временем непрерывной работы GPU было бы неправильно.
В итоге 54 завершённых крупных этапа. В какой-то момент простой вопрос про свою видеокарту оброс собственным архивом JSON: команды запуска, память, timings, ответы и хеши. Неудачи из архива тоже не вычищал. Один этап, например, пришлось повторить из-за сборщика результатов: модель уже ответила, а чтение дописываемого лога упало. Исправил сборщик, сохранил обе попытки.
Откуда взялись 60 токенов в секунду
Без ускорения модель генерирует в обычном режиме, который в результатах обозначен как plain. MTP предлагает черновиком несколько следующих токенов, которые проверяет основная модель. Когда черновик подходит, генерация идёт быстрее. В Native работает встроенный модуль модели, в Fast используется отдельный облегчённый ускоритель.
Мне было интересно, сколько это даёт на практике. Вот короткие запросы с настроенным окном 32768, которое при этом не заполнено. Основной и черновой кэш Q8_0, рассуждения выключены. Для каждого режима взял медиану девяти прогонов по 512 выходных токенов.
Самый интересный для меня вариант, IQ4_XS, без ускорения выдавал 32,25 ток/с. Включил Native MTP, получил 55,94. С Fast MTP получилось 57,88. То есть ответ пишется почти вдвое быстрее, при тех же основных весах.
Более компактный IQ3_M показал 26,39 ток/с без ускорения, 46,30 с Native и 46,79 с Fast. У Q4_K_P получилось соответственно 28,78, 40,42 и 44,05. В этих условиях IQ4_XS оказался быстрее обоих.
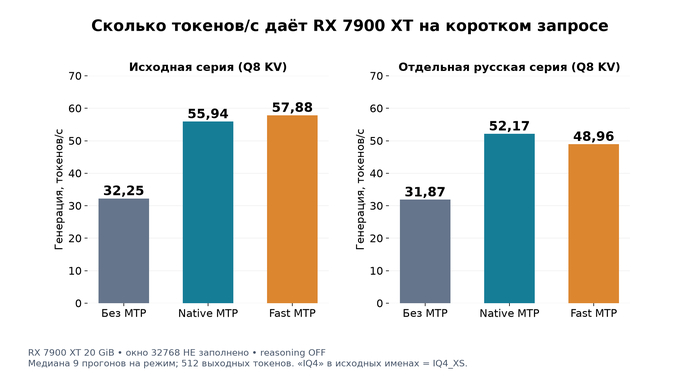
На графике это проще сравнить: чем выше столбик, тем быстрее модель пишет ответ. В части исходных файлов IQ4_XS подписан как «IQ4». Проверил команды и имя модели: это именно IQ4_XS, ещё одного кванта за сокращением не прячется.
Если поставить F16-кэш, Fast на IQ4_XS дал медиану 61,61 ток/с, в отдельном прогоне было 62,98. С Q4-кэшем медиана Fast составила 58,28. Это отдельные конфигурации: результат на F16 нельзя выдавать за скорость с Q8.
Пока выглядит так, будто Fast можно выбрать по названию. Но я отдельно повторил серию с явно русскоязычными ответами. Получилось 31,87 plain, 52,17 Native и 48,96 Fast, снова по девять прогонов. В первой серии часть ответов могла быть английской, а пользоваться моделью я собираюсь преимущественно на русском.
Так что название ускорителя за нас задачу не решает. На одних запросах выигрывал Fast, в моей повторной русской серии быстрее оказался Native. И процент принятых черновых токенов говорит о работе ускорителя, а не об уме модели. Качество я проверял отдельно.
С большим контекстом всё интереснее
Память под уже прочитанный текст называют KV-кэшем. Она занимает видеопамять вместе с самой моделью, и её тоже можно сжимать. F16, Q8 и Q4 в этих тестах относятся именно к такому сжатию. У ускорителя есть ещё свой draft-кэш.
Мне нужно было хотя бы 100 тысяч токенов. Поэтому проверка «сервер загрузился с большим окном» не подходила. Нужно заполнить это окно и заставить модель продолжать отвечать.
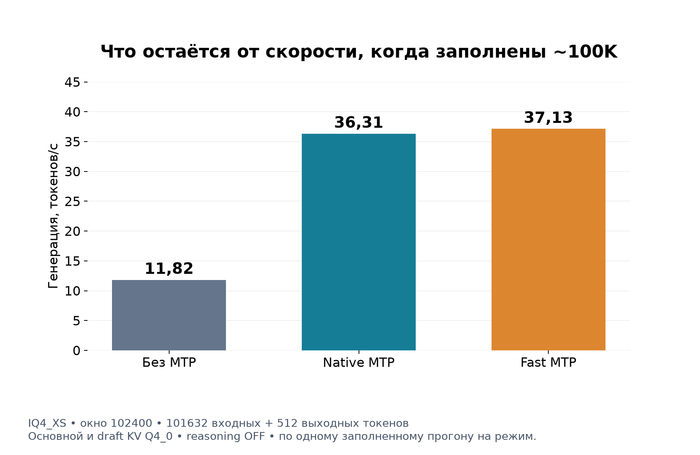
Для одинакового сравнения IQ4_XS взял окно 102400, подал 101632 входных токена и получил 512 выходных. Основной и draft-кэш Q4_0, рассуждения выключены. Тут по одному длинному прогону на режим.
Без ускорения модель писала ответ со скоростью 11,82 ток/с. С Native получилось 36,31, с Fast 37,13 ток/с.
Первоначальная обработка отправленного текста заняла примерно 7 минут 53 секунды без ускорения, 8 минут 6 секунд с Native и 8 минут 10 секунд с Fast.
Вот уже результат, ради которого стоило возиться. На заполненных ~100K ускорение получилось примерно трёхкратным относительно обычного режима. Основные веса при этом те же.
Пользователю это выглядит так: отправил огромный текст, модель около восьми минут его обрабатывает, затем пишет ответ со скоростью 36-37 токенов/с. Ускорение заметно помогает именно написанию ответа. Первое знакомство с большим текстом всё равно занимает время. Дальше проверю, придётся ли ждать эти минуты снова после каждого действия агента.
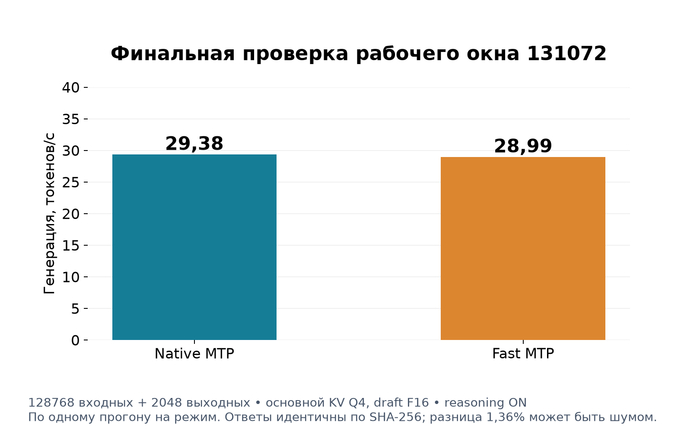
Финальный профиль проверял отдельно: включил рассуждения, оставил основной кэш Q4_0, а черновой сделал F16. Окно 131072, вход 128768, выход 2048.
На таком заполнении Native дал 29,38 ток/с, Fast 28,99 ток/с. Обработка огромного входа перед генерацией заняла примерно 11 минут 47 секунд у Native и 11 минут 57 секунд у Fast.
Ответы в этой паре совпали по SHA-256. Оба режима прошли извлечение контрольных значений и проверку размещения в VRAM.
Здесь два уточнения, без которых цифра слишком красивая. Первое: скорость включает рассуждения, а не только видимый пользователю ответ. Второе: первоначальное чтение входа заняло почти 12 минут. Это вполне рабочая скорость продолжения, но длинную историю сначала надо обработать.
И ещё про обозначения: 131072 это 128K, если K считать по 1024, или примерно 131 тысяча в десятичной записи. Точные границы дальше пишу числами, иначе можно случайно выиграть пару тысяч токенов одним округлением.
В этой паре Native быстрее на 1,36%. Одного прогона недостаточно, чтобы объявить его победителем вообще: такую разницу легко получить из-за шума. Для себя выбрал Native ещё и потому, что он оказался быстрее в повторной русской серии. Fast оставил отдельным профилем, он тоже работает.
А сколько вообще можно впихнуть?
Следующий вопрос уже про предел памяти. Искал его с оглядкой на расход VRAM: смотрел, сколько памяти добавляется на токен и сколько осталось, после чего делал крупный скачок. Возле края уточнял границу до 2048 токенов. Идти всю дорогу по 2K было бы слишком долго.
В матричных проверках отправлял окно минус 768 токенов, затем генерировал ещё 512. В начале, середине и конце текста размещал контрольные значения. Так проверял и память во время работы, и извлечение из длинного входа.
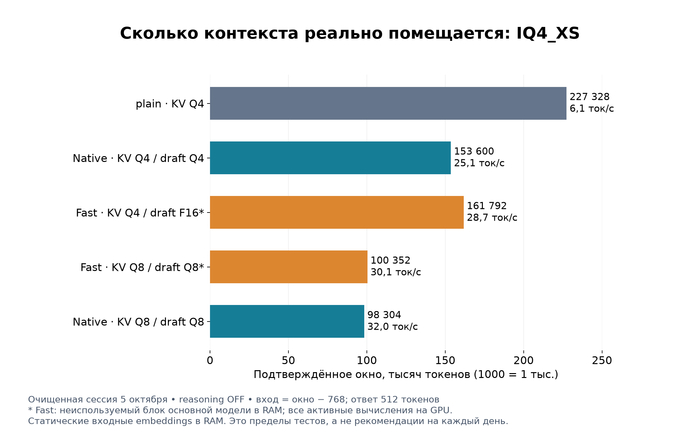
После очистки фона у IQ4_XS получились такие подтверждённые заполненные окна. Вычисляемые блоки и выходная голова модели на GPU, входная статическая таблица в RAM.
С Native и Q4 в обоих кэшах удалось заполнить окно 153600 токенов. Скорость на этом заполнении составила 25,09 ток/с. С Fast, основным кэшем Q4 и черновым F16 дошёл до 161792 при 28,65 ток/с.
Без ускорения получилось уместить ещё больше, но отвечала модель гораздо медленнее. Поэтому на графике пределов рядом с размером окна подписал скорость: самый длинный столбик здесь не означает лучший вариант для чата.
Для тех, кто выбирает кэш Q8: с ним Native подтвердил окно 98304 при 31,95 ток/с, Fast окно 100352 при 30,08 ток/с. В обоих предельных вариантах Fast неиспользуемый блок основной модели был оставлен в оперативке. Сам ускоритель и работающие вычислительные блоки оставались на видеокарте.
Самая занятная граница у Fast Q4/F16: 161792 прошли, 163840 уже не прошли проверку размещения. На успешном запуске свободными оставались примерно 68 MiB VRAM. В RAM был перенесён неиспользуемый MTP-блок основной модели; работающий отдельный ускоритель остался на GPU.
Результат интересный. Пользоваться каждый день с таким запасом мне не хочется: почти вся память занята, а компьютер всё-таки не выделенный стенд. Поэтому оставил окно 131072. После длинного Hermes-теста Native в той сессии оставалось около 740 MiB. За фоном всё равно надо следить, но запас уже приятнее.
Обычный режим смог уместить ещё больше: 227328, из них 226560 токенов фактического входа. Только генерация на этом заполнении упала до 6,06 ток/с, а чтение входа заняло 25 минут 48 секунд. Поэтому выбирать модель по самому большому числу ctx я бы не стал.
Другие кванты тоже доходили до своего края. В более ранней сессии IQ3_M с Fast и Q4 выдержал 223232 при 17,00 ток/с, с Q8 получил 139264 при 25,43 ток/с. Q4_K_P с Fast подтвердил 53248 на Q4, 43008 на Q8 и 18432 на F16. Эти пределы относятся к прежнему фону VRAM. После закрытия браузеров и Steam выдавать их за новые максимумы чистой сессии нельзя.
F16 меня тоже не спас от всех проблем. IQ4_XS с Fast в повторной очищенной проверке прошёл заполненные 57344 при 50,96 ток/с. Это проверенная точка, новый максимум там не искал. А IQ3_M на заполненных 102400 с F16 потребовал два вычисляемых блока на CPU и дал 18,77 ток/с. Бывали варианты, которые загружались, но заполнение уже не выдерживали.
Для моих 100K+ сжатие основного кэша оказалось очень полезным. Но само по себе Q4 не обещает ускорения. Его приходится подбирать вместе с весами и MTP.
Оперативка выручает. Иногда слишком дорого
Поначалу я хотел держать на GPU буквально всё. Потом проверил входную embedding table. Это статическая таблица, по которой токены получают числовое представление перед дальнейшими вычислениями.
Сравнил её размещение на одинаковом запросе: IQ4_XS без MTP, Q4-кэш, 101632 входных и 512 выходных токенов. Таблица в RAM дала 11,32 ток/с, принудительно на GPU получилось 11,19 ток/с. Ответ одинаковый по SHA-256, а GPU-вариант потребовал ещё примерно 682 MiB VRAM.
В этой паре пользы от переноса на GPU не увидел. Таблицу оставил в оперативке, вычисляемые блоки и выходную голову на видеокарте. Это один контролируемый опыт, а не обещание, что таблица в RAM никогда ничего не стоит.
С активно вычисляемыми блоками совсем другая история. Если перенести их на CPU, оперативка поможет вместить модель, но процессору придётся участвовать в генерации. Проверил это с Fast MTP и Q8-кэшем на заполненном контексте.
У IQ4_XS при окне 102400 один блок пришлось считать на процессоре. Получилось 23,77 ток/с, ещё вполне живая скорость. Для окна 131072 таких блоков понадобилось уже девять. Отправленный текст обрабатывался почти 33 минуты, а ответ пошёл со скоростью 2,16 ток/с. Можно спокойно поставить чайник. Потом ещё раз.
У Q4_K_P картина похожая: при окне 102400 и десяти блоках на процессоре получил 2,47 ток/с. При 131072 и четырнадцати блоках получилось 2,19 ток/с. Влезает, но для моей задачи слишком медленно.
Поэтому фраза «часть модели в оперативке» без подробностей мало что объясняет. Статическая таблица и девять вычисляемых блоков обходятся очень по-разному.
А качество не потерялось?
Проверял отдельно. На небольшом наборе задач без рассуждений plain IQ3_M получил 14/20, IQ4_XS 17/20, Q4_K_P 18/20. Это сопоставимая серия с Q8-кэшем.
С включёнными рассуждениями IQ3_M и IQ4_XS дали 20/20 на моём ограниченном наборе задач. Проверки были для plain и Fast; выбранное сочетание IQ4_XS с Native тоже получило 20/20 в отдельной серии. Q4_K_P с рассуждениями в этой матрице не проверял.
Для меня этого хватило, чтобы оставить reasoning включённым. Для утверждения «качество всех квантов одинаковое» двадцати задач явно недостаточно. На сложном коде или длинной работе агента могут вылезти различия, которых этот набор не поймал.
Дополнительно посмотрел perplexity на WikiText-2: восемь блоков, контекст 2048. Это оценка предсказания текста, где меньше лучше. IQ4_XS получил 5,382 ± 0,143 на F16, 5,396 ± 0,144 на Q8 и 5,353 ± 0,141 на Q4. Разница маленькая относительно стандартной ошибки. Делать отсюда вывод «Q4 умнее F16» не стоит, да и английский корпус не заменяет проверку русского агента.
Uncensored здесь название конкретных весов. Отдельного доказательства, что модель никогда ни в чём не откажет, у меня нет.
Ради чего всё затевалось: настоящий Hermes
До этого я проверял, как быстро модель отвечает на текст. Но мне нужен был помощник, которому можно поручить действие: например, открыть файл и найти в нём нужную информацию. Такую работу проверил через настоящий установленный Hermes/AIAgent. Запустил тест отдельно от рабочего помощника, с собственным HERMES_HOME. Рабочую конфигурацию Telegram gateway не переключал.
Тест устроил так: сначала отправил модели огромный текст, 103287 токенов. Затем поручил прочитать файл и назвать записанное в нём случайное контрольное значение. Чтобы добраться до файла, она должна сама вызвать функцию чтения read_file. Нужного значения в отправленном тексте нет, его можно узнать из файла.
Оба варианта справились: модель запросила чтение файла и вернула правильное значение.
С Native первоначальная обработка огромного текста заняла примерно 8 минут 44 секунды. Когда функция чтения вернула содержимое файла, модель подготовила короткий ответ с нужным значением за 2,7 секунды. С Fast получилось почти то же самое: 8 минут 49 секунд на первоначальную обработку и 2,8 секунды на ответ после получения содержимого файла.
Вот что здесь полезно на практике. После чтения файла модель не начинала заново разбирать всю огромную историю. Уже обработанный текст сохранился, оставалось прочитать небольшое дополнение с результатом чтения файла и ответить. В логах это всего 73 новых токена у Native и 74 у Fast, вместо повторной обработки всех ста тысяч.
Поэтому для такого помощника важна не только скорость написания текста, но и возможность продолжать работу без долгого ожидания на каждом шаге. Эти 2,7-2,8 секунды измерены до конца короткого ответа с контрольным значением. Большой отчёт за то же время модель, конечно, не напишет.
Здесь нашлась настройка, которую я бы записал отдельно:
Настройка Hermes
model:
reasoning_echo: true
Эта настройка позволяет Hermes сохранять рассуждения модели в истории разговора. Сервер узнаёт уже обработанную часть истории и продолжает с того места, где остановился.
Без неё в отдельной короткой проверке Fast после чтения файла заново обрабатывал историю. Ожидание ответа составило почти 13 секунд. Включил настройку, получилось примерно полторы секунды. Это другая, короткая проверка, а не повтор того же стотысячного запроса.
В моём сочетании Hermes и модели reasoning_echo: true оказался нужен для нормального повторного использования контекста. На маленькой истории лишнее чтение просто раздражает. На стотысячной уже совсем не хочется каждый раз ждать ещё несколько минут.
Этот опыт не доказывает, что помощник теперь без ошибок напишет любую программу. Но нужную мне последовательность он выполнил: обработал большую историю, запросил чтение файла, получил его содержимое и ответил, сохранив уже проделанную работу.
Что в итоге ставить и как повторять
Я оставил себе такой профиль:
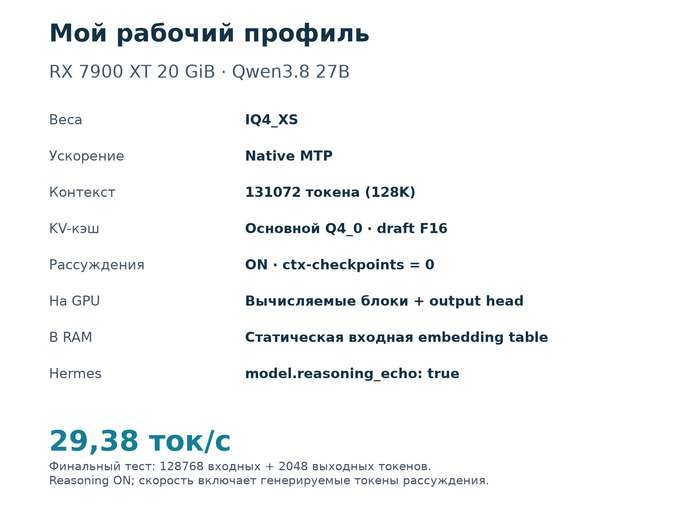
Модель: Qwen3.8-27B-Uncensored-HauhauCS-Aggressive
Веса: IQ4_XS
Ускорение: Native MTP
Контекст: 131072
Основной KV-кэш: Q4_0
Draft KV-кэш: F16
Reasoning: ON
ctx-checkpoints: 0
Параллельность: 1
GPU: вычисляемые блоки и output head
RAM: статическая входная embedding table
Hermes: model.reasoning_echo: true
IQ4_XS оказался для моей задачи удачным сочетанием скорости, качества и памяти. IQ3_M интересен, если хочется более компактные веса или больше места под контекст. Q4_K_P оставлял мало пространства для длинной истории, а перенос вычислений в RAM эту задачу приемлемо не решил.
Native выбрал по повторной русской серии и финальному рабочему тесту. Fast тоже прошёл длинную проверку агента, в некоторых конфигурациях был быстрее и остался отдельным профилем.
Теперь несколько деталей для тех, кто захочет повторить. Обычные speed-прогоны делал с parallelism 1, temperature 0, seed 42, обычно на 512 выходных токенах. Использовал ignore_eos, чтобы модель не закончила один ответ раньше другого и не испортила сравнение. Обычные ответы и инструменты проверял отдельно, финальный заполненный профиль на 2048 выходных токенах.
Фабрика шортсов была на паузе. Следил, чтобы рядом не работали другие модели и тяжёлые GPU-процессы. После части первых тестов закрыл браузеры и Steam, фон VRAM снизился примерно с 2,5 до 1,2-1,4 GiB. Поэтому старые границы сохранил с прежними условиями, а после очистки проверял заново.
Размещение смотрел при загрузке и во время заполненной работы. Сопоставлял ROCm-буферы, физическую VRAM и Windows dedicated memory процесса WSL и адаптера, с допуском 256 MiB. Одной надписи «все слои на GPU» мне было мало. Но это всё равно не побайтовое доказательство отсутствия любой подкачки драйвера.
Ещё техническая деталь: у модели гибридное внимание, recurrent state остаётся F32. Квантование KV не сжимает вообще всю память состояния. По одному размеру файла модели максимальное окно не посчитать.
Сборка основана на llama.cpp 4df29be4f4c3673f428170fda944a5b19f743bb8 с патчем Fast MTP. Цифры относятся к ней, ROCm 7.2 и моей машине. В другой версии движка результат может измениться. Обычная установка Ollama сама по себе этот профиль не воспроизводит. А 32K в имени ускорителя FastMTP-32K означает урезанный словарь, не ограничение длины контекста.
Совместную работу с фабрикой шортсов не проверял. Свободная видеопамять влияет на пределы. Контрольные значения в трёх местах подтверждают извлечение, но не безошибочное понимание каждого документа на 128K. Двадцать quality-задач остаются двадцатью задачами, а разницу в 1-2% по одному запуску лучше перепроверять.
Если нужен короткий практический ответ владельцу RX 7900 XT, я бы начинал с IQ4_XS, Native MTP, основного Q4-кэша, draft F16, окна 131072 и включённых рассуждений. С Hermes ещё model.reasoning_echo: true.
На коротких запросах можно получить больше 50 ток/с. На заполненных ~100K в сопоставимой серии вышло 36-37. Мой финальный почти заполненный 128K с рассуждениями дал 29,38 ток/с. На первичное чтение огромного входа надо заложить минуты, а для дальнейшей работы следить за повторным использованием контекста.
161792 я оставил как результат поиска края. Для ежедневного использования выбрал 131072. Запускаться с последними свободными мегабайтами мне менее интересно, чем спокойно пользоваться моделью.
Рассматривать RX 7900 XT для локальных LLM имеет смысл. На её 20 ГБ получается работать с 27B и большим контекстом, маленькими моделями всё не ограничивается. Только настройка софта тоже часть покупки: мои результаты получены через WSL, ROCm и конкретную сборку. Сопоставимых замеров Nvidia у меня нет, поэтому выводов о победе над всеми остальными картами тоже нет.
Если у кого-то есть RX 7900 XTX, RTX 3090 или другая карта с 20-24 ГБ, было бы интересно сравнить одинаковые веса на заполненных 100K/128K. У меня короткий запрос и длинная история дали настолько разные скорости, что теперь на одиночную цифру токенов в секунду смотрю с вопросом: а сколько текста модель уже прочитала?
Ссылки:
Все тесты, замеры и настройка проводились на моей машине. Для автоматизации, разбора логов и оформления поста использовал ИИ.
Показать полностью
7

Коунтер-страйк
- Коунтер-страйк -
Слетают с языка колючие слова,
О, неприкрытый яд, речь пОшла и вульгарна,
И трещинами всё пошла санчита-карма!
Дырява от проклятий, держится едва!
Не вижу монитор, рука сжимает мышь,
Вокруг лишь мрак и ад, и ярости кольцо,
Я в зеркало боюсь взглянуть — моё лицо
Искажено. Мой крик летит, дробясь от крыш.
И не хочу, но вновь стремлюсь весь свет обидеть.
Что ж, проиграл — я стар. Я слишком слаб, я прах!
Там школьники ликуют. В их лежу ногах.
Всевышний, дай мне сил любить, как ненавидеть...
Показать полностью
1

Эволюция чипов Apple: чем отличаются поколения M-процессоров
Первый MacBook Air на M1 стал настоящей революцией — он предлагал производительность, которая тогда казалась невозможной для такого тонкого и тихого устройства.
Причём дело было не только в скорости. Apple впервые перевела компьютеры Mac с привычной архитектуры x86 на ARM — ту же архитектуру, которая давно использовалась в смартфонах и планшетах. До этого мощные ноутбуки в основном строились вокруг Intel и AMD, а ARM считалась скорее территорией мобильных устройств.
Apple доказала, что ARM способен работать не только в смартфоне. M1 оказался достаточно мощным для полноценного компьютера, при этом потреблял значительно меньше энергии и позволял обходиться вообще без вентиляторов.
Именно с этого началась история Apple Silicon. Ну а чтобы вам было легче разобраться в дремучем и постоянно растущем лесу M-процессоров, мы подготовили краткий путеводитель.
Рейтинг M-чипов
Ранжирование всех M-чипов по вычислительной и графической (Metal) мощи.
M5 Ultra — CPU Single ~3750 / Multi ~47 000; Metal ~347 000
M3 Ultra — CPU Single ~3200 / Multi ~39 000; Metal ~232 000
M5 Max — CPU Single ~3700 / Multi ~35 000; Metal ~226 000
M4 Max — CPU Single ~3400 / Multi ~29 000; Metal ~190 000
M2 Ultra — CPU Single ~2700 / Multi ~21 000; Metal ~201 000
M5 Pro — CPU Single ~3700 / Multi ~34 000; Metal ~131 000
M1 Ultra — CPU Single ~2400 / Multi ~20 000; Metal ~148 000
M3 Max — CPU Single ~3100 / Multi ~21 000; Metal ~147 000
M4 Pro — CPU Single ~3700 / Multi ~22 000; Metal ~108 000
M2 Max — CPU Single ~2700 / Multi ~15 000; Metal ~131 000
M6 — CPU Single ~4000 / Multi ~22 000; Metal ~89 000
M1 Max — CPU Single ~2400 / Multi ~13 000; Metal ~106 000
M4 — CPU Single ~3300 / Multi ~15 500; Metal ~52 000
M5 — CPU Single ~3600 / Multi ~18 000; Metal ~69 000
M2 Pro — CPU Single ~2650 / Multi ~14 500; Metal ~77 000
M3 Pro — CPU Single ~3000 / Multi ~15 500; Metal ~73 000
M3 — CPU Single ~2800 / Multi ~12 000; Metal ~46 000
M2 — CPU Single ~2600 / Multi ~10 000; Metal ~40 000
M1 Pro — CPU Single ~2400 / Multi ~12 500; Metal ~64 000
M1 — CPU Single ~2200 / Multi ~8 500–9 000; Metal ~27 000
M1 — фундамент всей линейки
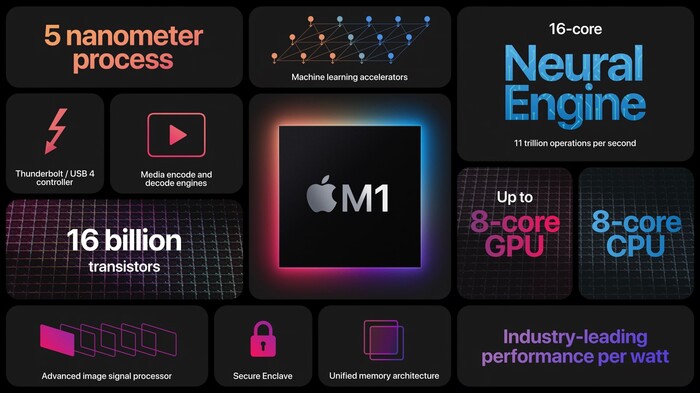
Чтобы понять, почему M1 оказался настолько важным, достаточно посмотреть, как он был собран.
CPU, GPU, Neural Engine, контроллер памяти и другие компоненты находятся в одной системе на чипе. Память при этом общая для процессора и графики.
Такой подход позволил Apple отказаться от прежней схемы, где разные компоненты постоянно обмениваются данными между собой. Получился быстрый и очень экономичный компьютер, который при этом не требовал огромного охлаждения.
И даже сегодня M1 не выглядит беспомощным. Для браузера, работы, программирования, фото и многих других задач его всё ещё хватает.
M2 — больше мощности
M2 стал развитием той же архитектуры.
Apple увеличила производительность CPU и GPU, подняла пропускную способность памяти и улучшила работу с видео. Особенно заметна разница была в профессиональных приложениях и длительных нагрузках.
При этом переход с M1 на M2 не ощущался так же, как переход с Intel на M1. Это уже была спокойная эволюция удачной платформы.
M3 — серьёзный шаг для графики
В M3 Apple перешла на 3-нм техпроцесс и сильно переработала GPU.
Появились аппаратная трассировка лучей, Mesh Shading и динамическое кэширование. Поэтому M3 заметно интереснее предыдущих поколений в играх, 3D и сложной графике.
Именно здесь стало особенно хорошо видно, что новое поколение M-чипа — это не только более быстрый процессор. Apple постепенно меняет отдельные блоки внутри SoC под новые задачи.
M4 — поколение ИИ
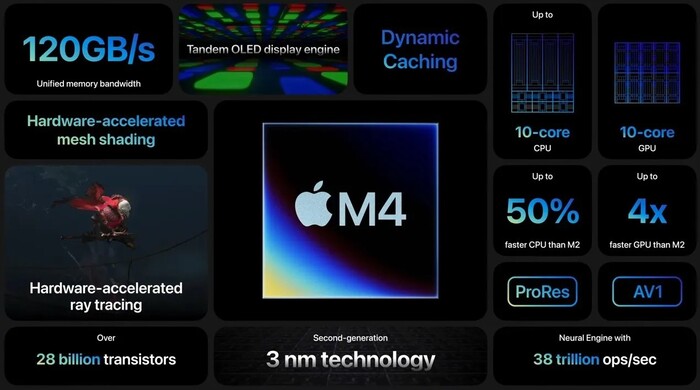
M4 появился уже в тот момент, когда локальный ИИ и работа с ним стали важным критерием при выборе ноутбука.
Apple усилила Neural Engine и добавила новые возможности для машинного обучения. В результате M4 стал быстрее не только в обычных вычислениях, но и в задачах, где активно используются нейросетевые алгоритмы.
Это направление затем стало ещё важнее в M5.
M5 — больше внимания ИИ и графике
M5 получил обновлённые CPU и GPU, а в графических ядрах появились собственные Neural Accelerators для ИИ-вычислений.
Но самое интересное здесь — старшие версии.
M5 Pro получил до 18 ядер CPU и до 20 ядер GPU.
M5 Max поднимает планку до 40 ядер GPU и 128 ГБ объединённой памяти. Здесь уже можно ворочать самыми передовыми нейросетями, серьёзно заниматься 3D или работать на кинопроизводстве с 8K.
Поэтому Mac с Max стоит значительно дороже обычной версии. Разница не только в вычислительной мощи: у Max в разы больше графических ресурсов, памяти и пропускной способности.
M5 Ultra — самый мощный
M5 Ultra стал самым мощным чипом Apple.
В максимальной конфигурации у него 36 ядер CPU, 80 ядер GPU и до 512 ГБ объединённой памяти. Пропускная способность памяти достигает 1,2 ТБ/с.
Причём M5 Ultra построен из четырёх кристаллов, объединённых технологией UltraFusion. Для системы они работают как единый процессор.
M6 — что изменилось в новом поколении
Самый свежий базовый чип Apple — M6. Он стал первым чипом компании на 2-нм техпроцессе.
В нём 12 ядер CPU, 12 ядер GPU и новая Dual Neural Engine — два 16-ядерных блока для ИИ-вычислений. Пропускная способность объединённой памяти выросла до 170 ГБ/с.
Apple заявляет до 1,2 раза большую многопоточную производительность относительно M5 и до 2,4 раза относительно M1. В GPU появились Neural Accelerators в каждом ядре, а графическая архитектура получила аппаратную трассировку лучей и обновлённое динамическое кэширование.
Но M6 — именно базовый чип нового поколения. Дальше — больше, и особенно интересно, что компания выпустит под вывеской M6 Pro и M6 Max.
Показать полностью
5

GPD Win Max2 vs Win Mini
Интересуют обе версии на Rayzen 370HX, 32/64 GB Ram и 890Radeon.
В чем отличия версий кроме диагонали 10.1 против 7
На сколько у мини охлаждение порезано. Если он меньше, то естественно радиатор там будет компактнее.
Хочу эта штуку, лучше чем тупящий Deck (у меня был, вернул через день) и выгоднее чем приставки на Z2 Extream (за ним хоть работать можно)
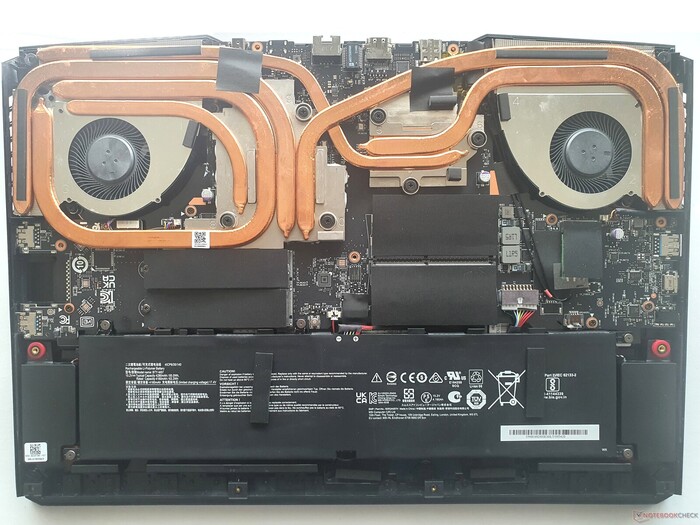
Ну я на 100% уверен что там СО будет из 1-2 теплотрубок
Напишите опыт владения.
Что Вин 5 есть я знаю, но мне этот слайдер не интересен. Не фанат psp форм фактора
Хочу то Win Max3 но там цена наверно будет вообще самолет.
Показать полностью
1