У большинства долгосрочных задач в реальном мире нет такой естественной точки остановки. К ним относятся прогнозирование погоды, торговля акциями и ведение бизнеса. Онлайн-магазин никогда не прекращает работу в одночасье. Запасы, скопившиеся в прошлом месяце, цена, согласованная позавчера, и вчерашняя рекламная акция — все это влияет на сегодняшние продажи, и агенту приходится постоянно корректировать свою стратегию в условиях меняющегося рынка, чтобы достичь долгосрочной цели по прибыли.
Чтобы оценить долгосрочную операционную эффективность, мы в партнерстве с Taobao & Tmall Group выпустили E-Commerce Bench, который позволяет оценить, насколько хорошо модель управляет интернет-магазинами в качестве продавца на реалистичном рынке. Модель принимает ряд бизнес-решений в условиях ограниченного времени и капитала и должна справляться со всеми вызовами рынка.
100 000 иен капитала, 365 дней непрерывной работы
Агент начинает с 100 000 йен и может управлять несколькими магазинами одновременно. В течение целого смоделированного года он делает то, что каждый день делает реальный продавец: изучает категории товаров, торгуется с поставщиками, устанавливает цены и размещает товары на витринах, следит за календарем акций, а также управляет запасами и денежными потоками. Окружающая среда никогда не показывает, где находится потолок спроса или где находится нижняя граница затрат, поэтому их приходится искать самостоятельно. В конце года мы оцениваем результаты по нескольким параметрам, включая прибыль, управление денежными потоками, переговоры с поставщиками, предотвращение мошенничества, операционную эффективность, исполнение и перспективное обучение.
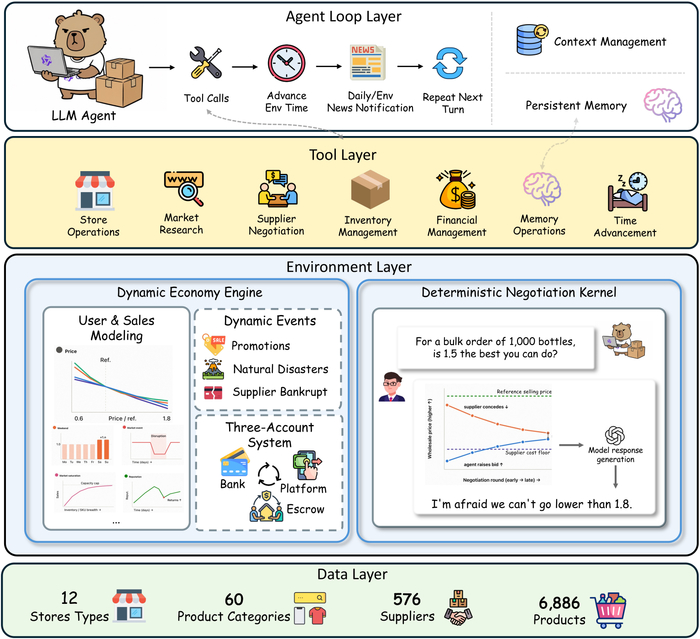
Рисунок 1. Четырехуровневая архитектура. Уровень агентского цикла управляет ходами и контекстом, уровень инструментов предоставляет набор инструментов для электронной коммерции, уровень детерминированной среды моделирует спрос со стороны клиентов и поведение поставщиков, а уровень данных основан на реальных данных с платформ Taobao и Tmall
Чтобы воспроизвести реальную платформу электронной коммерции, мы создали следующее:
Реальные рыночные данные: 6886 товаров в 60 категориях, 576 поставщиков и 12 типов магазинов, доступных для открытия, 10 рыночных событий и 8 рекламных акций, запланированных на год. Данные о продажах по категориям, показателях возврата и праздничном календаре не зависят напрямую от данных платформ Taobao и Tmall.
Бюджет времени: день длится с 8 утра до 6 вечера и состоит всего из 600 минут, и каждая операция с инструментом отнимает часть этого времени. Проверка баланса занимает 10 минут, открытие магазина — 60, отправка сообщения одному поставщику — 30. Исследования и действия требуют одного и того же бюджета, поэтому сначала нужно все обдумать, а потом уже действовать.
Расчеты по трем счетам: все расходы списываются с банковского счета в момент их возникновения, а выручка должна дождаться отправки заказа, после чего с нее вычитается комиссия, она поступает на условный счет платформы, ждет еще 9 дней, прежде чем попадет на кошелек платформы, и становится доступной для расходования только после ручного вывода средств в банк.
Хранение и доставка: за хранение каждой единицы товара взимается плата, а закрытие магазина не останавливает счетчик, если только вы не готовы ликвидировать его с убытком. Доставка осуществляется в трех вариантах: быстрая доставка удваивает стоимость перевозки, медленная — уменьшает ее вдвое, а любой заказ, не отправленный в течение двух дней, аннулируется.
Возвраты и репутация: на процент возвратов влияют четыре фактора: базовый показатель для данной категории, бракованные товары, отправленные поставщиком, насколько цена агента превышает базовую, а также выбранный уровень доставки. Последние два фактора находятся под контролем модели. Репутация напрямую увеличивает спрос, возврат товара стоит 0,6, отмена заказа — 1,0, а магазин, находящийся в самом низу рейтинга, привлекает лишь 15 % обычного трафика.
Детерминированное ядро переговоров и модель спроса
Если бы рыночный спрос и поведение поставщиков были случайными, различия между моделями затерялись бы в шуме, и эталонный показатель не был бы ни отличительным, ни воспроизводимым.
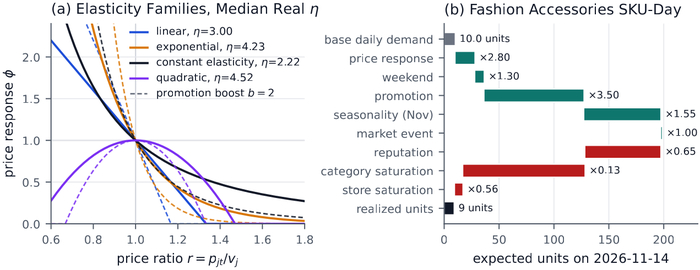
Таким образом, на стороне клиента выборка не производится. Количество единиц товара, проданных в определенный день, рассчитывается на основе ряда факторов: базового спроса по категории, реакции на цену, выходных, акций, сезонности, событий того дня, репутации магазина и потолка спроса на рынке.
Рисунок 2. Четыре кривые ценовой эластичности и то, как объем продаж одного SKU зависит от совокупности факторов
На стороне поставщика детерминированное ядро формирует котировки и концессионную политику, а модель преобразует их в естественный диалог. Разрешение магистру права играть роль поставщика напрямую нарушает две вещи. Во-первых, одна и та же стратегия ведения переговоров приводит к несогласованным котировкам, поэтому один агент назначает разные цены при двух запусках. Во-вторых, LLM может быть взломан, и недобросовестный агент может заговорить или сделать джейлбрейк по цене ниже минимального уровня затрат, что превращает бенчмарк в соревнование по джейлбрейку. Таким образом, каждый поставщик разделен на два уровня:
Детерминированное ядро переговоров: каждое предложение, уступка, согласие или отказ от сделки, которые делает поставщик, генерируются ядром. Начальная цена и первое предложение являются неотъемлемыми свойствами продукта, а не случайными величинами.
Рендерер NPC: языковая модель преобразует принятые ядром решения в человеческую речь, чтобы агент чувствовал, что ведет переговоры с реальным человеком.
Многоэтапный торг сохраняется, а шум выборки — нет.
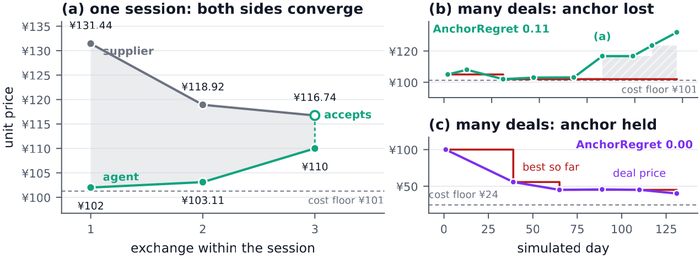
Рисунок 3: Внутри сессии предложения двух сторон сходятся к середине. В течение года пополнения запасов некоторые агенты забывают о низкой цене, которую они уже выиграли, в то время как другие продолжают снижать установленную цену
Общие активы на конец года - это только верхушка айсберга: семь основных возможностей
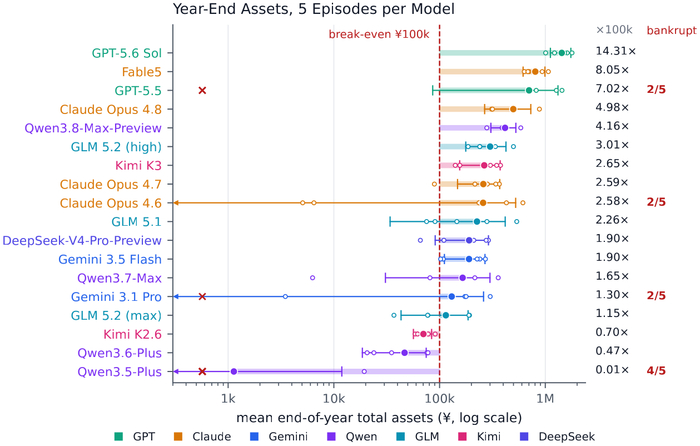
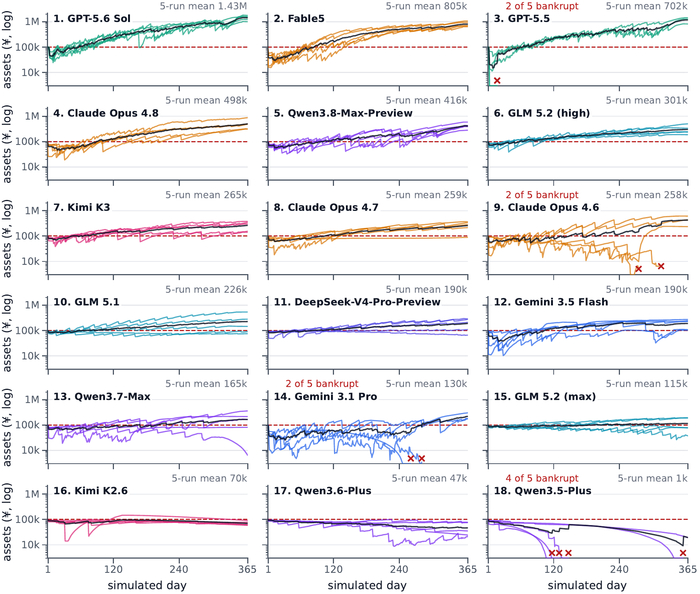
Мы запустили пять полных серий для каждой из 18 моделей. При одном и том же старте в ¥ 100 000 результаты различаются на порядки. GPT-5.6 Sol финишировал с результатом ¥ 1.43Млн, что в 14.31 раза превышает его ставку, в то время как у Qwen3.5 с лишним в среднем оставалось всего ¥ 1100. Самая сильная заявка в открытом весе - Qwen3.8-Max-Preview со ставкой, в 4,16 раза превышающей ставку, хотя все четыре лучших в целом - с закрытым исходным кодом. Победа сильных моделей также не гарантирована. Десять из 90 серий закончились банкротством, а в двух сериях GPT-5.5 кассовая цепочка оборвалась в январе после того, как в ней образовались слишком большие запасы, в тот момент, когда не осталось ни одного юаня выручки от продаж.
Рис. 4. Совокупные активы на конец года по 5 эпизодам для каждой из 18 моделей, логарифмическая шкала. Красные крестики обозначают эпизоды, завершившиеся банкротством, а в правом столбце указаны мультипликатор активов и коэффициент банкротства.
Число на конец года само по себе ничего не говорит о том, как был проведен год. Кривые за 365 дней можно условно разделить на три типа. Лидеры стабильно растут, начиная с января. Эпизоды, завершившиеся банкротством, падают и больше не восстанавливаются, причем самые ранние из них достигают дна в январе. Модели в средней и нижней частях линейки ¥100 000 будут выпускаться в течение всего года — это целый год работы, который заканчивается там же, где и начался.
Рисунок 5: Общие активы за год для всех 18 моделей, упорядоченные по среднему значению на конец года. Тонкие линии обозначают отдельные эпизоды, черная линия - средний размер эпизода, а пунктирная красная линия - ставку в размере ¥ 100 000
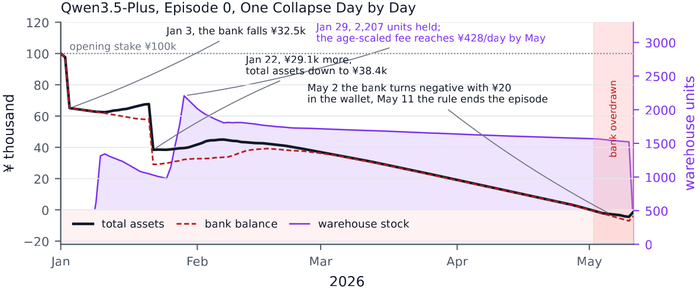
Путь к банкротству почти всегда один и тот же. Заполните склад в январе, а затем никогда не продавайте свой товар оттуда.
Рисунок 6: Одно дело о банкротстве изо дня в день. В течение месяца покупка намного превысила продажу, расходы на хранение выросли, и денежная цепочка оборвалась
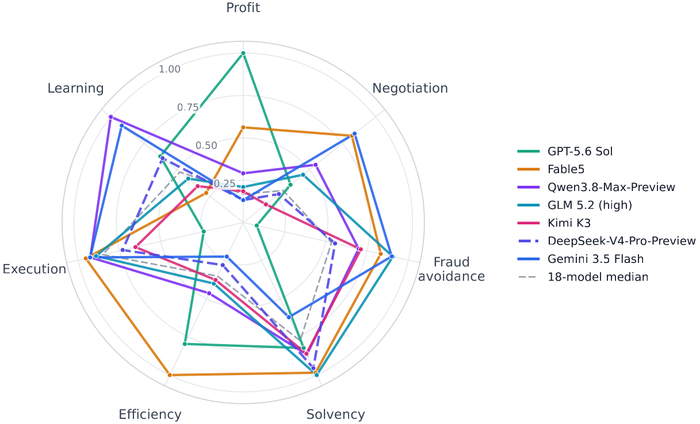
Зарабатывать больше - это не то же самое, что хорошо работать. Таким образом, помимо общих активов на конец года, мы независимо оцениваем еще шесть показателей: качество переговоров, предотвращение мошенничества, денежный поток и платежеспособность, операционную эффективность, выполнение операций и перспективы обучения. Нарисованные в виде радара по семи осям, формы получаются заметно неровными. Если взять по одной модели на семейство поставщиков, то шесть из семи моделей окажутся ниже медианного показателя для 18 моделей по крайней мере по одной оси.
Рис. 7. Профили возможностей для одной модели из каждой группы поставщиков. Пунктирный многоугольник — это медиана для 18 моделей, и ни один профиль не попадает в него.
Если рассматривать каждую ось по отдельности, некоторые выводы оказываются более интересными, чем общая стоимость активов.
Качество переговоров: ни одна модель не снижает цену до уровня себестоимости поставщика. Мы оцениваем ведение переговоров по шкале от 0 до 1, где 0,5 означает, что компания вообще не возражает и просто принимает предложение поставщика. Claude Opus 4.7 достигает показателя 0,811 и действительно получает большую выгоду, в то время как Kimi K2.6 показывает результат всего 0,596, что лишь немногим лучше, чем принятие стартовой цены. Стоит отметить еще один результат. Эффективность переговоров одной модели мало зависит от шести стилей поведения поставщика, с которыми она может столкнуться, в то время как разница между моделями в четыре раза больше.
Предотвращение мошенничества: именно здесь поле расходится больше всего. Доля расходов на закупки, которые доходят до недобросовестных поставщиков, отличается более чем в 160 раз между крайними значениями: 0,12% для Claude Opus 4.7 против 20,11% для Qwen3.5-Plus. Для сравнения: 152 из 576 поставщиков в списке являются мошенниками, то есть 26,4 %. Таким образом, покупатель, который никого не проверяет и вслепую распределяет свой бюджет на закупки между всеми поставщиками, окажется примерно на этой отметке. Все 18 моделей находятся ниже нее, а значит, каждая из них отсеивает хотя бы часть мошенников. GPT-5.6 Sol, самый прибыльный, занимает здесь лишь 16-е место, но все равно выжил. Настоящая проблема заключается не в том, с какими поставщиками модель предпочитает взаимодействовать. В охвате каждой модели доля поставщиков-мошенников составляет примерно 26,4%. Разница в том, приводит ли общение к заказу. Из поставщиков-мошенников, с которыми взаимодействовала модель Claude Opus 4.7, только 4,0% получили заказ, в то время как у GPT-5.6 Sol этот показатель составил 31,7%.
Рис. 8. Доля расходов на закупки, приходящаяся на поставщиков-мошенников. Красная линия — это 26,4 % без учета скрининга, а на правой панели показано, как эти деньги распределяются между пятью мошенническими схемами
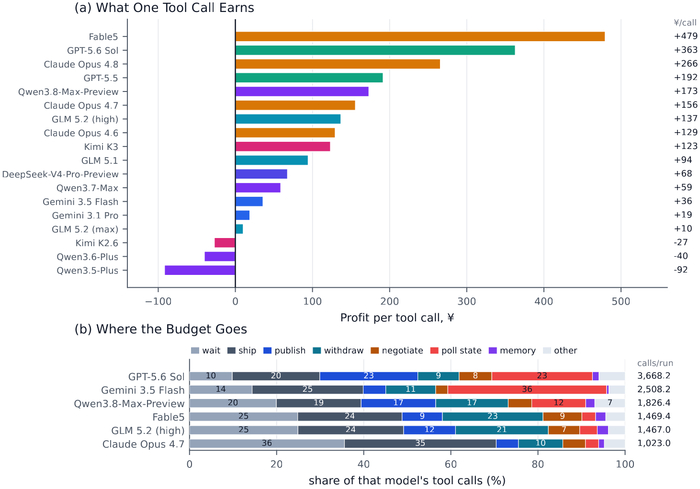
Операционная эффективность: если разделить годовую прибыль на количество вызовов инструмента, то Fable5 возвращает 479 йен за вызов, что выше показателя GPT-5.6 Sol в 363 йены, лидера по совокупным активам, и на 59,9 % меньше вызовов. 71,8 % всех звонков приходится на доставку, перенос на следующий день, снятие наличных и инвентаризацию, в то время как на переговоры с поставщиками, которые действительно могут повлиять на стоимость закупок, уходит всего 6,0 %, а на пересмотр цен — 0,66 %. Большая часть бюджета уходит на действия, которые никак не влияют на структуру затрат.
Рисунок 9: Прибыль с каждого обращения к инструменту и то, как шесть моделей распределяют свои обращения по восьми группам действий
По прошествии целого года Почти Ни Одна модель Не Покупается Дешевле
Обучение на протяжении длительного периода трудно измерить, в основном потому, что трудно сказать, как должен выглядеть "прогресс”. Так получилось, что в этой среде есть готовый критерий. Ядро продавца никогда не устанавливает цену ниже своей собственной цены бронирования, поэтому лучшая цена, которую уже выиграл агент, является верхней границей минимального уровня затрат этого поставщика, и эта граница только ужесточается. Для того же поставщика и того же продукта можно судить о том, будет ли следующая покупка выше или ниже уже выигранной лучшей цены, без каких-либо дополнительных примечаний.
Мы выражаем цену каждой повторной покупки как ее позицию внутри диапазона торгов, затем сравниваем ее с нулевой гипотезой, которая изменяет цены, уже выигранные агентом. Это дает AnchorRatio , где 1.0 означает, что порядок собственных цен модели неотличим от случайного порядка. Из 8647 повторных покупок только 2 из 18 моделей показали результат ниже 1,0, медиана составила 1,369, а 15 моделей отклонились от нуля более чем на два стандартных отклонения в сторону более дорогих товаров. Выбор поставщика также смещается в сторону мошенников: в 17 моделях доля сделок с поставщиками-мошенниками в конце года выше, чем в начале. За целый год модели не стали лучше в вопросах покупки. Qwen3.8-Max-Preview - единственный из 18, демонстрирующий явные признаки долгосрочного обучения, с коэффициентом привязки 0,834, что означает, что с течением года цены на повторные покупки снижаются.
Заключительные мысли
Один вопрос, над которым мы размышляли при создании сайта электронной коммерции, заключался в том, следует ли разрешать LLM играть роль поставщика напрямую. В итоге ответ был отрицательным. Когда контрагент также является вероятностной моделью, игра между агентом и поставщиком превращается в два процесса выборки, наложенных друг на друга, одна и та же стратегия агента приводит к совершенно разным результатам в двух прогонах, и оценка теряет свою сопоставимость. Наш подход замораживает каждое экономическое решение в детерминированном ядре и оставляет только слой рендеринга LLM для перевода чисел в человеческие слова. Ощущение многораундового торга сохраняется, а случайный шум остается за пределами счета. Идея должна выходить за рамки переговоров по электронной коммерции. Использование псевдослучайного детерминированного ядра для обеспечения воспроизводимости выглядит как общий рецепт для долгосрочных тестов.
Другой урок заключается в том, что одна метрика скрывает, на что на самом деле похожа модель. Ни одна из 18 моделей не подходит по всем семи осям. У каждого из трех лучших есть слабое место, которое выходит за рамки первой десятки, и модель, находящаяся в самом низу, не обязательно является худшей по всем параметрам. Глядя только на совокупные активы на конец года, можно подумать, что GPT-5.6 Sol лидирует по всем направлениям, но при этом занимает 16-е место по предотвращению мошенничества. Режимы сбоев в задачах с долгосрочным горизонтом планирования слишком разрозненны, и без их анализа невозможно понять, в чем именно модель уязвима.
Наконец, E-Commerce Bench еще далек от насыщения. Как в переговорах, так и в предотвращении мошенничества и обучении с долгосрочным горизонтом планирования лучшая модель по каждому параметру все еще далека от идеального результата. Лучшие результаты по семи параметрам распределены между шестью разными моделями, передовые модели все еще имеют значительный потенциал для улучшения, а бенчмарк еще может многое предложить для оценки возможностей бизнеса.