Представим учебный набор из ста сообщений. Пять требуют ручного разбора, остальные девяносто пять — нет. Алгоритм на любое сообщение отвечает «разбор не нужен». Формально он правильно классифицировал 95% примеров. Но из пяти важных сообщений не нашёл ни одного.
Это вымышленный набор для проверки метода, подготовленный с помощью ИИ. Он ничего не говорит о качестве конкретной модели или результатах реального проекта.
Посчитаем без библиотеки машинного обучения
truth = [1] * 5 + [0] * 95
predicted = [0] * 100
tp = sum(t == 1 and p == 1 for t, p in zip(truth, predicted))
fn = sum(t == 1 and p == 0 for t, p in zip(truth, predicted))
fp = sum(t == 0 and p == 1 for t, p in zip(truth, predicted))
tn = sum(t == 0 and p == 0 for t, p in zip(truth, predicted))
print((tp + tn) / len(truth))
print(tp / (tp + fn))
print([[tn, fp], [fn, tp]])
Результат — общая доля правильных ответов `0.95`, полнота по важному классу `0.0` и таблица `[[95, 0], [5, 0]]`. В последней строке видно пять пропущенных важных сообщений и ноль найденных.
Матрица ошибок показывает сочетания истинного и предсказанного класса. В документации scikit-learn (https://scikit-learn.org/stable/modules/generated/sklearn.me...) строки соответствуют истинным классам, столбцы — предсказанным. При использовании другой библиотеки порядок осей нужно проверить отдельно.
Что оценивать до внедрения
Сначала стоит определить, какое действие последует за каждым ответом. В этом примере ошибочный флаг лишь добавляет сообщение в очередь человеку. Пропуск важного сообщения оставляет его без разбора. Эти два вида ошибки имеют разные последствия, хотя общая точность смешивает их в одну цифру.
Для проверки можно заранее разметить небольшой набор: обычные сообщения, явные случаи для разбора и пограничные формулировки. Отдельно посчитать пропуски и лишние срабатывания. Не подбирать формулировку промпта по всем тем же примерам, на которых потом объявляется окончательный результат: часть примеров полезно оставить для заключительной проверки.
Пять нужных случаев — слишком маленькая основа для уверенного прогноза будущей работы. Этот набор показывает только логическую ловушку одной метрики. Для реального решения нужны репрезентативные данные, понятная разметка и согласованный уровень ошибок.
Практический вопрос к исполнителю: «Покажи, сколько важных сообщений мы нашли и сколько пропустили, а также сами ошибки». Такой запрос помогает быстрее общей фразы «повышай точность».
Фраза «давай завтра в 00:30 по Бангкоку» кажется достаточно точной. Но в календаре участника из Москвы встреча окажется вечером предыдущего дня. Если помощник переносит только цифры времени или сохраняет слово «завтра» без даты, приглашение можно получить совсем на другой момент.
Ниже — учебный пример, подготовленный с помощью ИИ. Пересчёт дат проверен кодом. Это не отчёт о сбое конкретной модели и не история о реально пропущенной встрече.
Допустим, согласована встреча на 17 октября 2026 года, 00:30, Asia/Bangkok. Тот же момент:
• в Бангкоке — 17 октября, 00:30;
• в Москве — 16 октября, 20:30;
• в UTC — 16 октября, 17:30.
Проверять здесь нужно сразу дату и время. Удобная подпись для двух участников: «16 октября, 20:30 Москва / 17 октября, 00:30 Бангкок». Она длиннее одного «завтра», зато не требует помнить, в каком городе находился автор сообщения.
Перед созданием события я бы сохранял четыре поля: исходную фразу, точную календарную дату, местное время и часовой пояс. Если дата ещё не определена, это отдельное незаполненное поле, а не повод подставить сегодняшний день компьютера.
Есть и второй случай: повторяющаяся встреча. «Каждую пятницу в 10:00 по Нью-Йорку» не означает один и тот же час в Москве круглый год. На проверенных учебных датах 30 октября и 6 ноября 2026 года получаются соответственно 17:00 и 18:00 по Москве. Между этими пятницами меняется смещение нью-йоркского времени.
Поэтому для регулярного расписания полезно хранить название зоны, например America/New_York, и правило «пятница, 10:00», а не только постоянное «UTC−4». Для разового события после уточнения исходных данных можно сохранить конкретный момент в UTC и показывать его каждому участнику в его зоне.
В этом коде исходная зона задана явно. Он не решает, что человек имел в виду под «завтра», — это нужно выяснить до вычисления. Для работы ZoneInfo нужны доступные данные часовых поясов; их источник описан в документации Python.
Короткая проверка перед отправкой приглашения:
1. Исходное сообщение и часовой пояс автора известны?
2. «Завтра» заменено точной датой и показано человеку?
3. При пересчёте проверена смена календарного дня?
4. Для повторяющейся встречи сохранены местное время и зона?
5. Участники видят итог до отправки приглашений?
Правильное вычисление не заменяет согласование времени. Если человек назвал только «вечером», помощнику всё ещё не хватает данных для конкретного события.
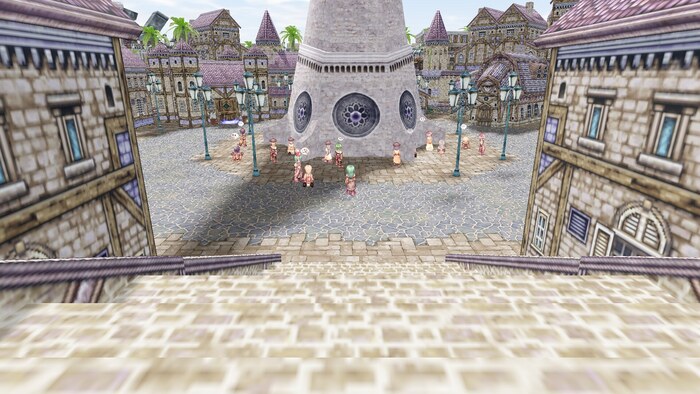
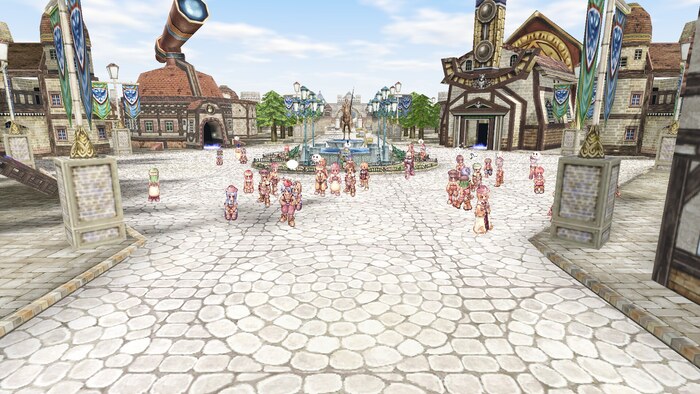
Помните Пронтеру? Фонтан посреди площади, толпа новичков в одинаковых рубашках, торговцы с тележками, кто-то орёт в чат «куплю Jellopy», а в ушах крутится та самая музыка. Для многих Ragnarok Online — это первая MMO, первые друзья в сети и первые бессонные ночи на полях за Порингами.
Я очень долго хотел сделать «свой РО». Не очередной приватный сервер на готовом движке, а игру с нуля: свой сервер, свой клиент, своя база. И вот в этом году я наконец за неё взялся — в паре с нейросетью (Claude Code). Рассказываю, что получилось, как это устроено и куда мы движемся.
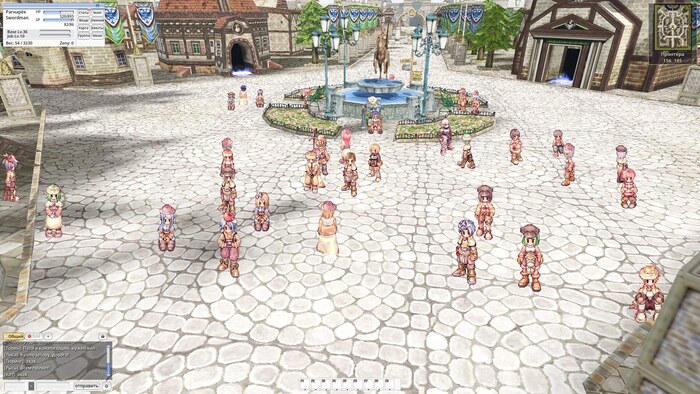
Пронтера, площадь у фонтана. Все персонажи вокруг — боты, которых нейросеть запустила для съёмки
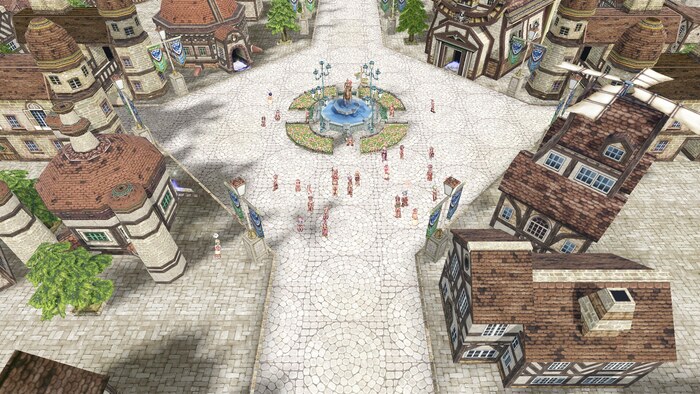
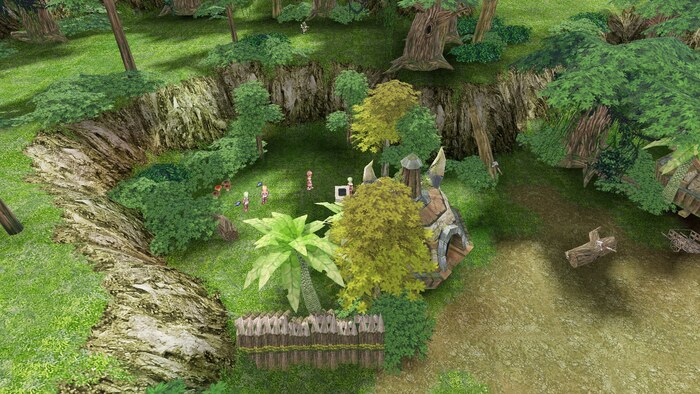
Пронтера сверху
Немного цифр для затравки
223 версии игры. Причём больше 200 из них — за последние две недели, когда проект по-настоящему разогнался.
100 локаций: Пронтера, Излюд, Альберта, Гефен, Морок, Пайон, остров новичков, академия, поля, Канализация, Лабиринт, Пайонская пещера, башня и подземелье Гефена, пирамиды, леса Пайона, пустыня Сограт, аббатство Св. Капитолины, гильдейские земли…
160 видов монстров живут на картах — от Поринга до Осириса и Эддги.
Все пять первых профессий (Мечник, Маг, Лучник, Вор, Послушник, Торговец — ладно, шесть) с экзаменами по оригинальным сценариям и навыками, включая квестовые.
~68 тысяч строк Python, ~75 тысяч строк GDScript и ~18 тысяч строк Lua.
Больше 3 300 автотестов, покрытие серверного кода — 100%. Без этого с нейросетью никак, но об этом ниже.
Из чего это сделано
Если коротко — три кита:
Сервер — Python 3.14. Асинхронный (asyncio), общается с клиентом по WebSocket. Да, Python для MMO-сервера — это немного дерзко, все ждут C++. Но для мира в духе РО, где логика «клеточная», а не физическая, его хватает с запасом (цифры будут дальше).
Клиент — Godot 4.8. Бесплатный движок с открытым кодом, на нём собирается игра под Windows, Linux, macOS и даже в браузер.
База — PostgreSQL. Персонажи, инвентарь, предметы, монстры, их дроп.
Сервер - авторитет: всё, что важно, считает он — куда ты пошёл, попал ли по монстру, что выпало, сколько у тебя зени. Клиент только рисует и плавно доводит персонажей до точки, которую сказал сервер. Так что «накрутить себе Валькирию в Cheat Engine» не выйдет.
Общаются они бинарным протоколом на MessagePack: каждое сообщение — пара байт заголовка и упакованные данные. Самые частые пакеты (шаг персонажа, выбор цели) упакованы ещё плотнее, вручную. Чтобы клиент и сервер никогда не разошлись в понимании протокола, сервер генерирует эталонные «векторы» — набор пакетов байт-в-байт, — а клиент в тестах обязан разобрать и собрать их ровно так же. Поменял пакет и забыл про клиент — тесты сразу краснеют.
А игровые данные — в Lua. NPC, их диалоги, магазины, порталы, точки спавна монстров — всё описано скриптами по картам. Захотел нового NPC в Пайоне — открыл payon.lua и дописал.
За эталон взят rAthena
Если вы когда-то поднимали приватный сервер РО, то знаете rAthena — эмулятор официального сервера с открытым кодом. Вместе с предшественниками (Athena, eAthena) сообщество пилит его больше двадцати лет. В нём собраны формулы урона, шанс попадания, дроп, спавны монстров, скрипты всех NPC.
Я решил: механика должна быть как в pre-renewal (тот самый «классический» РО до глобального ребаланса). Поэтому rAthena — наш справочник. Урон ближнего боя, HIT/FLEE, крит и Perfect Dodge, ASPD, перегруз, потеря опыта при смерти, формула Max HP — всё сверено с исходниками rAthena. Даже ID предметов и монстров — те же, что в rAthena: Поринг — 1002, Яблоко — 512. Это сильно упрощает жизнь: можно взять их базу и импортировать.
Под это у нас есть свои скрипты: import_rathena_mob.py берёт монстра из базы rAthena и делает миграцию для нашей базы — со статами, опытом и всем дропом. Аналогично с предметами.
Как мы делаем карты
Это, пожалуй, самая интересная часть.
Карты в оригинальном РО хранятся внутри огромного архива data.grf (в нашем клиенте он весит 4,8 ГБ). Каждая карта — это несколько файлов в старых корейских форматах:
GND — земля: сетка тайлов с текстурами и освещением;
RSW — «сцена»: где стоят дома, деревья, источники звука, вода;
RSM — 3D-модели этих домов и деревьев;
GAT — сетка проходимости: где можно ходить, где стена, где вода.
Мы написали свой конвертер ro_map на Python. Он открывает GRF прямо через отображение файла в память (иначе 4,8 ГБ в оперативку не впихнёшь), достаёт карту, разбирает все эти форматы и собирает из неё glTF — стандартный 3D-формат, который Godot открывает как родной. Отдельно сохраняется сетка проходимости, мини-карта, экран загрузки и фоновые звуки (журчание фонтана, ветер, птицы — а они в РО, кстати, лежат в древнем Microsoft ADPCM, пришлось и его декодировать).
Пара забавных грабель:
Земля «квадратиками». У каждого тайла земли в РО свой цвет в каждом углу. В лоб перенесёшь — и вся трава становится шахматной доской из чуть разных оттенков. Пришлось склеивать соседние тайлы так, чтобы угол был общим, а цвет в нём — средним. Пересобрали все карты — земля стала мягкой, как в оригинале.
Модели нескольких версий. RSM бывают 1.4, 1.5, 2.2, 2.3… и у каждой свои сюрпризы. Например, конвертер падал на RSM 1.5, потому что ожидал там поля из 1.6.
Монстры за краем карты. На многих картах РО по самому краю идёт «проходимая» рамка, куда игроку не попасть. В пещере Пайона я видел монстров, стоящих на чёрных клетках за стенами. Оказалось, rAthena обходит это так: случайный спавн «по всей карте» не ставит монстра ближе 15 клеток к краю. Сделали так же.
А вот NPC, порталы и спавны берутся из скриптов rAthena. Для этого есть скрипт rathena_maps.py: он читает, где на карте стоят варпы и сколько каких монстров там живёт, и генерирует наши Lua-файлы. Например, на первом поле Пайона — 10 Willow, 10 Poporing, 10 Poring, 100 Spore и россыпь Black Mushroom по конкретным клеткам. Ровно как было.
А чтобы ничего не потерялось, тот же скрипт умеет сверять: проходит по всем варпам rAthena между нашими картами и показывает, где у нас переход пропущен или ведёт не туда. После такой проверки нашёлся, например, забытый домик у причала Альберты.
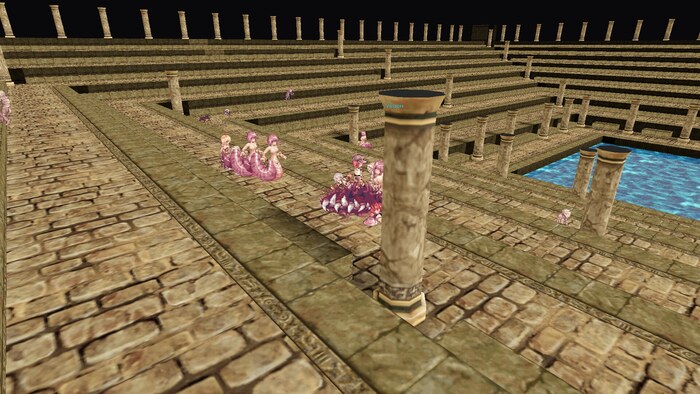
пирамида Морока, этаж с мумиями
деревня орков на полях Гефена
Гефен и его башня
Карта мира
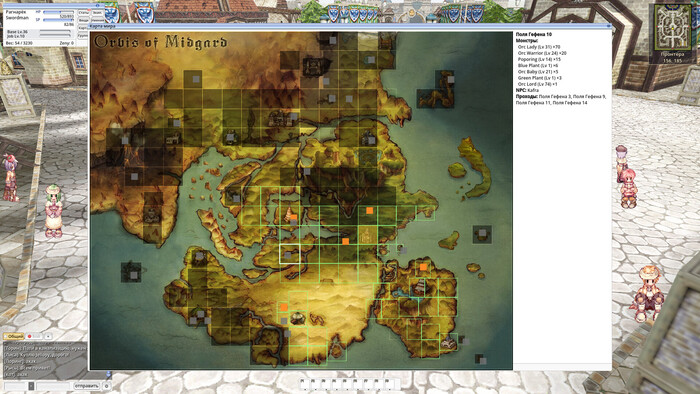
Отдельная гордость — карта мира. Помните окошко с континентом Рун-Мидгард по Ctrl+~? Оно у нас есть, и картинка та же, из клиента РО. Но разметку пришлось добывать с приключениями: в клиенте она лежит в Lua-скриптах, скомпилированных в байт-код Lua 5.1 для 32-битной программы. Скрипт world_map.py читает этот байт-код через библиотеку lupa, достаёт оттуда, где на карте какой город и какое поле, и склеивает с нашими данными.
И вот тут мы пошли дальше оригинала. В РО карта мира показывает только названия. У нас:
места, куда уже можно дойти, подсвечены, а те, что ещё не сделаны, затемнены;
подземелья отмечены метками, а твоё текущее место — жёлтым;
щёлкаешь по полю — справа появляется список: какие там монстры, какого уровня и сколько, какие NPC, есть ли Kafra и куда ведут проходы.
То есть это одновременно и карта, и маленькая энциклопедия: прежде чем идти фармить, можно посмотреть, кто там живёт. А тест на сервере следит, чтобы данные карты мира не отставали от реальных спавнов, NPC и переходов.
карта мира: выбрано поле Гефена 10 — орки, Orc Lord, Kafra и проходы
Как оживают монстры
Спрайты в РО — это пары файлов SPR (картинки) и ACT (анимации: какие кадры, в каком порядке, с какими смещениями). Второй наш конвертер, ro_sprite, превращает их в атласы для Godot. Персонаж собирается из слоёв: тело, голова, причёска, шапка, оружие в руке — как в оригинале.
Мир у нас настоящий 3D, а спрайты — плоские «картонки», всегда повёрнутые к камере. У каждой 8 направлений, и клиент сам решает, какой ракурс показать в зависимости от того, куда смотрит монстр и откуда смотрит камера.
Мелочь, которая очень важна для ощущения РО: выбор мышью попиксельный. Кликнуть по монстру можно только по его видимым пикселям, а не по прямоугольнику вокруг. Иначе в толпе Порингов начинается ад.
Поведение монстров живёт на сервере: их логика работает по таймерам, как в rAthena — агрессивные бросаются, пассивные бродят, кто-то подбирает вещи с земли. Если рядом нет ни одного игрока, монстр «засыпает» и думает в десять раз реже — это сильно экономит процессор. А на клиенте анимацию «стоит/идёт» крутят деревья поведения (плагин LimboAI для Godot).
Звуки у каждого монстра — свои, оригинальные: тот самый «плюх» Поринга никуда не делся.
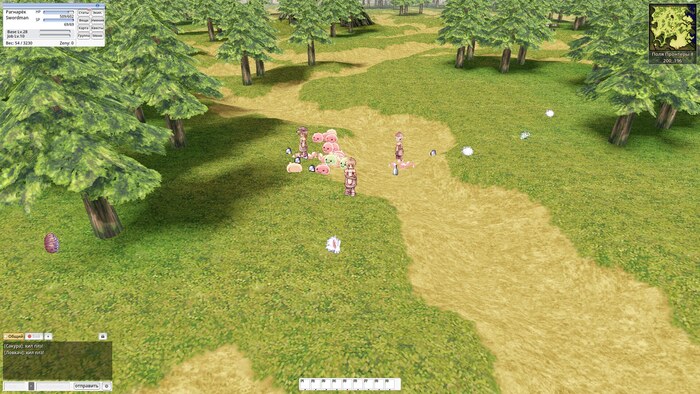
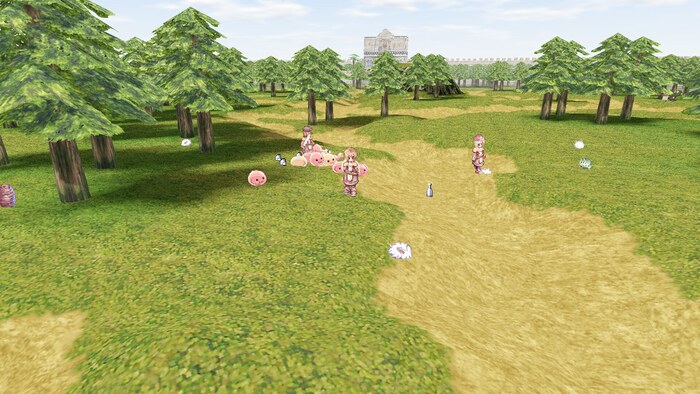
Поринги на поле Пронтеры (для съёмки подсыпали погуще)
Мечник против стайки Порингов, Drops и Lunatic
Выдержит ли Python?
Однажды я спросил: а сколько вообще выдержит сервер? Решили проверить честно — 100 игроков и 5000 монстров.
Написали нагрузочный тест: боты подключаются по тому же протоколу, что и настоящий клиент, бегают по картам, бьют монстров, подбирают дроп, пишут в чат и кидаются смайликами.
Первый результат был… отрезвляющим. Сервер должен «тикать» 60 раз в секунду, а один тик занимал почти секунду. Вход 100 игроков разом замораживал мир на 20 секунд — потому что проверка паролей (bcrypt) выполнялась прямо в игровом цикле.
Профилировщик показал, куда уходит время: сервер каждый тик рассылал позицию каждого идущего монстра каждому игроку на карте. Поправили так, как это сделано в самом РО:
сервер сообщает только куда монстр пошёл, а клиент сам ведёт его до точки;
каждый игрок видит только то, что в радиусе 40 клеток вокруг него (в rAthena по умолчанию 14), а искать соседей помогает пространственный индекс — мир поделён на «корзины», и смотрим только соседние;
пакет кодируется один раз, а не для каждого получателя;
пароли проверяются в отдельном потоке.
Итог: тик упал с 668 до 31 миллисекунды, трафик одного игрока среди 5000 монстров — с 5500 до 110 пакетов в секунду. До 2000 монстров и 100 игроков сервер держит честные 60 тиков в секунду на одном ядре. Для фанатского проекта — более чем.
Что получилось лучше, чем в оригинале
Мы стараемся быть «как в РО», но кое-где позволили себе улучшения.
Персонаж больше не ходит зигзагом. В РО (и у нас поначалу) поиск пути выдаёт «лесенку» из диагоналей и прямых. Мой отзыв из баг-трекера дословно: «Идёт… как алкоголик, шатаясь». Теперь путь сглаживается: если дорога свободна, персонаж идёт по прямой, а у стен аккуратно огибает углы.
Небо. В РО камера смотрит почти сверху, и неба там толком не видно. У нас над Пронтерой — шейдер неба: синий зенит, солнце с ореолом, медленно плывущие облака и дымка у горизонта, а за городскими стенами — поля и силуэты холмов.
небо над Пронтерой
поле Пронтеры, на горизонте замок
Камера свободнее, чем в РО: можно опустить её почти к земле и увидеть горизонт — в оригинале наклон сильно ограничен.
Питомцы с аксессуарами, которых в РО не было. Drops и Poporing — это перекраски Поринга, но рюкзачок, как у Поринга, им в оригинале не нарисовали. Мы собрали спрайт сами: тело своё, рюкзак — от Поринга. Мелочь, а приятно.
Игра под все системы. Оригинальный клиент — только Windows. У нас одна команда собирает Windows, Linux, macOS и веб-версию.
Карта мира с «энциклопедией» — монстры, NPC, Kafra и проходы по щелчку (подробнее выше).
Вход через Google — помимо обычного логина и пароля.
И при этом мы честно сохраняем то, что делает РО — РО. Иногда даже баги: в Мороке стена вокруг дворца проходима между столбами. Проверили по данным оригинала — там она тоже проходима. Пока оставили, вынесли «на подумать».
А как это — разрабатывать с нейросетью?
Мой процесс выглядит так: я играю, нахожу проблему или хочу новую фичу — и пишу как есть, человеческим языком. «В Мороке я прошёл сквозь угол здания. Кроме того, монстры появляются за пределами локации». Дальше нейросеть сама лезет в код, в исходники rAthena, в данные клиента, делает изменение, пишет тесты и обновляет документацию.
Каждое изменение попадает в журнал версий, и в каждой записи есть раздел «Запрос пользователя» — с моей дословной цитатой. Можно открыть любую из 223 версий и увидеть, с какой фразы всё началось.
Чтобы это не превратилось в хаос, есть жёсткие правила:
тесты на всё: больше двух тысяч на сервере и больше тысячи на клиенте, а сервер обязан держать 100% покрытия;
проверка типов и линтер держатся на нуле ошибок;
документация обновляется вместе с кодом — иначе нейросеть в следующий раз просто не узнает, как всё устроено;
бэклог: если что-то заметили, но не чиним сейчас — оно записывается.
Самый ценный навык в таком режиме — не писать код, а точно формулировать, чего хочешь, и играть, играть, играть, проверяя результат.
Что дальше
Ближайшие планы:
Боссы (MVP) как в РО: сейчас Осирис, Амон Ра, Фрионни и Эддга уже стоят на своих картах, но пока ведут себя как обычные монстры. Хочется настоящих MVP — со свитой, телепортами и наградой.
Торговля: лавки Vending и аукцион.
Превращения монстров: Pupa, вылупляющаяся в Creamy, яйца Thief Bug.
Гильдии, друзья и вторые профессии — Рыцари, Визарды, Хантеры и вся компания.
Новые города и континенты: Альдебаран, Гласт Хейм, Мьёльнир — переходы на них уже прописаны, ждут своих карт.
Разделение сервера на процессы по картам — как map-server в rAthena. План уже написан; браться будем, когда игроков станет больше, чем держит одно ядро.
Создание автопатчера - чтобы не перекачивать игру каждый раз, когда выходят обновления.
Аренда сервера - чтобы пустить желающих поиграть. Хотя не думаю, что их будет много.
Вместо заключения
Через двадцать с лишним лет после того, как я впервые вышел за ворота Пронтеры, я снова там. Только теперь — внутри игры, которую делаю сам.
Если интересно — напишите в комментариях, про что рассказать подробнее: про конвертацию карт, про сетевой код, про то, как устроены экзамены на профессию, или про работу в паре с нейросетью. И, конечно, делитесь своими воспоминаниями о РО: на каком сервере играли, кем, какой был ник?
Поринги передают привет. Плюх.
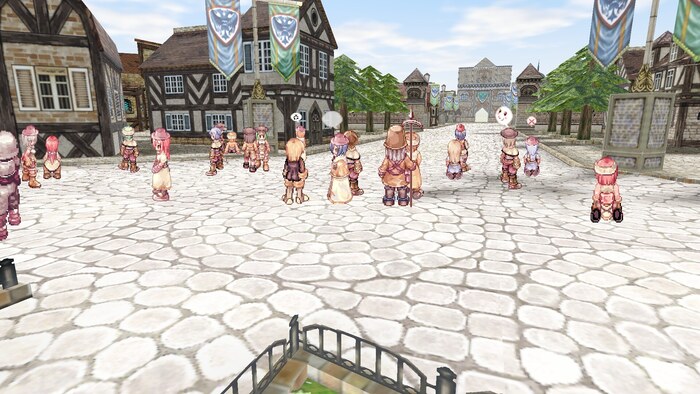
у фонтана Пронтеры
Пара слов о правах: графика, карты и звуки — из оригинального клиента РО, все права на них у Gravity. Проект некоммерческий, фанатский, и денег я на нём зарабатывать не собираюсь.
Undo — мой самодельный ИИ-агент для работы с файлами (Vibe Coding)
Всем привет!
Короче, навайбкодил свой Undo. Сразу скажу: я не программист, и этот проект — результат моего общения с ИИ. Я выложил его в открытый доступ, потому что считаю, что это может быть полезно.
Для кого это? Если вы опытный программист — это сильно облегчит вам жизнь. Если вы новичок или вообще не понимаете в коде, но у вас есть идея, которую хочется реализовать — это для вас.
Как это работает (максимально просто):
Копируете манифест (текстовый файл с описанием команд, он есть в программе).
Кидаете его в чат к любому ИИ (DeepSeek, ChatGPT, Claude, Gemini — не важно).
ИИ читает манифест и понимает, как с вами работать. Дальше он сам пишет команды, вы их копируете в Undo, а Undo выполняет их на вашем компьютере и возвращает результат в буфер.
Всё. Ни сервера, ни ключей, ни телеметрии. Работает локально. Важный нюанс: ИИ пишет команды, но запускаете и проверяете их вы. Никакой магии — только контроль.
Что можно делать (и почему это удобно):
Экономия времени и токенов. Агент делает всё сам: ищет, проверяет, редактирует и т.д. Вам не нужно копировать и вставлять целые файлы — ИИ работает с кусками кода, что экономит токены в разы (особенно актуально для платных моделей).
Программить что хочешь на минималках. Локально, без облаков.
Создавать, править, удалять файлы. Через ИИ — обычными командами.
Бэкапы. Перед каждой правкой — копия. Старые сами удаляются.
Проверка синтаксиса. Python, JSON, HTML, JS — сразу видно, если что-то не так.
Скриншоты в буфер. Одна команда — и картинка готова к вставке в чат.
Терминал внизу окна. dir, cd, python — что угодно.
Память проекта. Описание, ошибки, задачи, лог — всё сохраняется.
Жёсткая модерация. Команду копируете вы сами. Никакой «агент сам решает» — только то, что вы разрешили.
Почему я это сделал? Потому что мне было интересно. И потому что я верю: сейчас, с развитием ИИ, порог входа в разработку упал. Даже если вы не программист, вы можете собрать что-то своё. Мой проект — пример того, что это реально.
Мне пришлось учился пользоваться своим же переводчиком
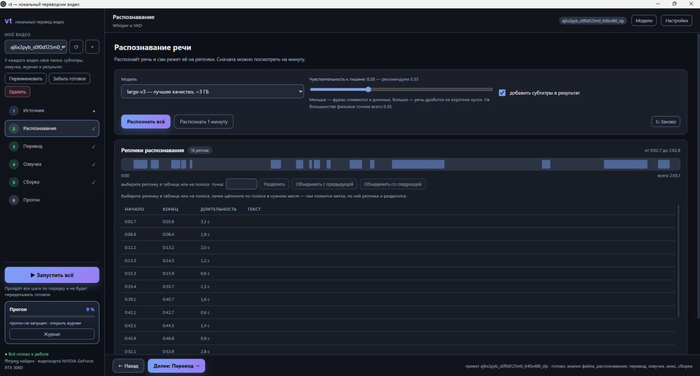
Короче из ключевых проблем что скорее всего не решиться, whisper large-3 бедолага, не смотря на всё качество определение реплики, разметить их по нему крайне непростая задача. Я добавил таймлайн, но редактор для него полноценный ещё не сделал. На сколько это будет надо, покажет желание пользователей уже. Я пока думаю что это не самое приоритетное направление.
Локальный перевод вообще практически не имеет смысла, ресурсов жрёт тонну, а выход хуже чем в googletranslate просто. Это не смотря на то, что разработан алгоритм для перевода с "контекстом", а не просто в тупую. Вот это более важное направление и я думаю его добивать.
По этой же причине пришлось добавлять озвучку без генерации субтитров. Чисто взял готовые и бросил озвучивать.
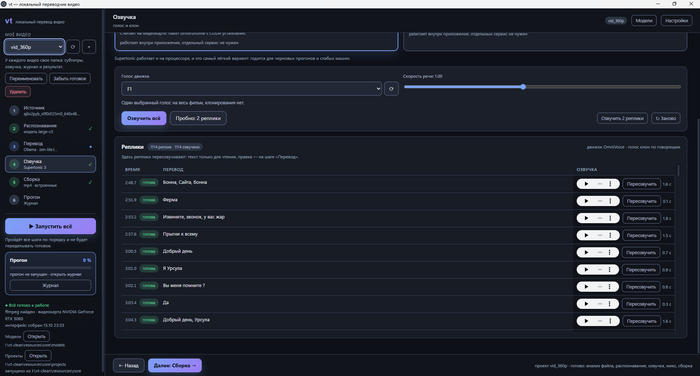
Окно озвучки
И вот озвучка и обратная сборка, работают на 10 из 10. Модель не клонирующая голос взлетела на 3060 12 гиговой и даже не вспотела. Модель с клонером это отдельная песня, она хорошо всё делает, но в фильме должно быть достаточно качественных реплик для клонирования голоса, иначе алгоритм будет озвучивать либо тем что сможет склонировать, либо озвучит стандартным своим голосом.
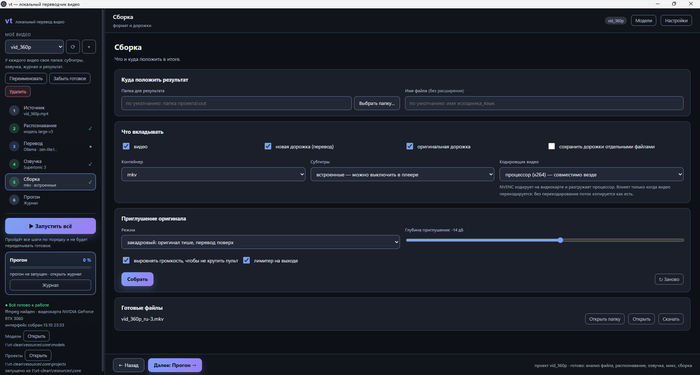
Окно сборки
Хорошо отработал алгоритм глушения реплик, так называемый "дакинг".
Короче для озвучки кино по готовым субтитрам вообще 0 проблем. А короткие ролики вполне себе можно и с авторазметкой даже делать.
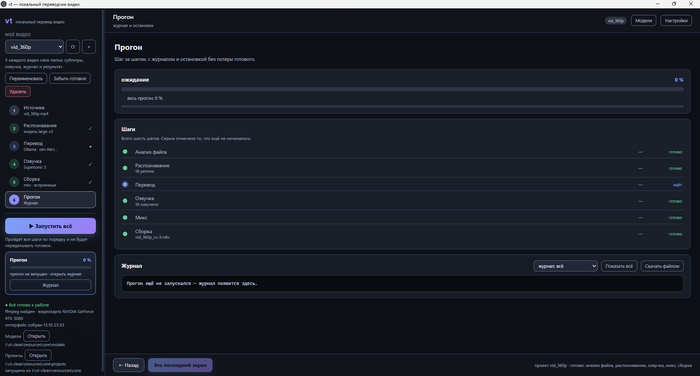
По ощущениям достигнуты цели где-то на половину. Думы думаю, стоит ли уже релизить или ещё пошлифовать бедолагу в области перевода. Потому что это по сути самое узкое место сейчас.
Сразу отвечу на вопрос зачем я это делал. Мне надо было быстро перевести видео локально, без претензии на озвучку по ролям, все что я нашел это pyvideotrans. И он мне совершенно не понравился. Вот и всё. Релиз на вот вотах, даже если не получится улучшить перевод, БЕСПЛАТНОВО, не претендую на золотые горы в этом проекте. Надо было мне, но вдруг кому ещё подойдет, у кого непритязательные взгляды в отношении озвучки :D
Покупатель кладёт на весы яблоко, камера делает снимок, и система сама определяет, что это за фрукт, и подставляет цену. Выглядит как магия. На нашем курсе вы соберёте это своими руками.
Что вы построите
ML-часть. Вы учитесь готовить данные, проверять качество и понимать, почему модель ошибается.
Backend. Модель оборачивается в сервис на FastAPI. Он принимает фото и возвращает ответ.
Frontend. Сайт, где пользователь загружает фото и видит результат.
Бизнес. Кому нужны такие весы, сколько это стоит и кто заплатит. Без этого получится красивая игрушка, а не продукт.
Почему это хороший учебный кейс
В нём есть всё, из чего состоят реальные AI-продукты: данные, модель, сервис, интерфейс, экономика. Вы видите весь путь на одной задаче и понимаете, как части связаны друг с другом.
Что в конце
Работающий проект и защита перед менторами-практиками.
Это учебный кейс нужен, чтобы пройти путь целиком. А идею для собственного проекта вы вполне можете найти по ходу курса.
Вы обучили модель, она показывает хорошие метрики, и... всё. Показать её некому: она живёт в вашем ноутбуке. Чтобы модель принесла пользу, она должна превратиться в сервис, к которому можно обратиться по сети.
Именно этому учит backend-модуль нашего бесплатного курса.
Что внутри
API простыми словами. Как приложения «договариваются» друг с другом: запросы, методы, JSON.
FastAPI. Первый рабочий сервис можно собрать за вечер. Документация создаётся автоматически, и вы сразу видите свой API как живую страницу, на которой можно попробовать запросы руками.
Проверка данных на входе (Pydantic). Сервис не должен принимать что попало.
CORS. Почему браузер блокирует запрос, когда всё запущено и адрес правильный, и как настроить доступ точно, а не «разрешить всем».
Микросервисы на практике. Вы разделяете продукт на независимые слои, затем намеренно отключаете один и смотрите, что происходит с остальным. После этого термин «микросервисная архитектура» перестаёт быть словом из слайда.
Что на выходе
Работающий сервис, в котором ваша нейросеть отвечает на запросы, и понимание того, что происходит между браузером и сервером. Это навык, который нужен везде, где есть современные веб-продукты.