Speech2Text

Speech2Text

Speech2Text - сервис автоматической расшифровки аудио и видео в текст.
На Пикабу
Дата рождения: 27 июня
100 рейтинг 0 подписчиков 0 подписок 38 постов 0 в горячем
Награды:
Пикабу 17 лет!
1

Анна Валл: «Аудитория прощает всё. Она не прощает незнания темы и высокомерия»⁠⁠


Филолог и эксперт по деловому этикету Анна Валл — о том, почему погоня за первым впечатлением всегда выдаёт фальшь, откуда берутся слова-паразиты и почему богатая речь — вопрос мышления, а не словарного запаса.
Первое впечатление нельзя произвести дважды — но чем сильнее человек старается его произвести, тем быстрее выдаёт себя фальшью. То же самое происходит с речью: погоня за яркими формулировками и жёсткими аргументами почти всегда выдаёт неуверенность, а не силу.
Анна Валл — филолог, эксперт по деловому этикету и коммуникациям, обучавшая корпоративной грамотности сотрудников компаний от Газпрома до Coca-Cola, а сейчас консультант клиники «Три сестры» — в разговоре с Алексеем разбирает, откуда берутся слова-паразиты, почему богатая речь — это вопрос мышления, а не словарного запаса, что на самом деле раздражает в речи зумеров и почему точка в мессенджере звучит как агрессия.
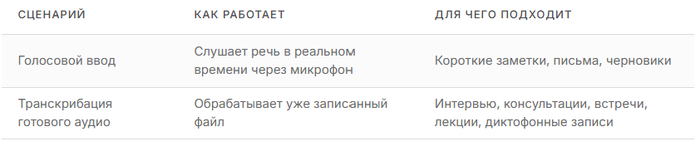
Расшифровка подготовлена с помощью Speech2Text. Источник видео: ссылка.

Алексей: У нас сегодня на подкасте Анна Валл, эксперт по деловому этикету и коммуникациям, филолог. В её портфолио — работа с компаниями, где она обучала навыкам этикета и корпоративной грамотности, от Газпрома до Coca-Cola, а в настоящее время она консультант в клинике «Три сестры». По моим наблюдениям, даже если человек опытный, компетентный, умный, он иногда может настолько испортить себе впечатление в новом коллективе или при личном общении, что весь градус уважения к нему сразу падает — сесть в лужу. Я это лично видел много раз и сам так косячил, что сейчас, что раньше. Как раз про то, какие действия и привычки не стоит допускать, чтобы не испортить первое впечатление и впечатление от себя в целом, мы и записали с Анной этот разговор. Получилось много важной теории — и конкретные прикладные советы, которые можно уже сегодня внедрить в жизнь. Анна, доброе утро!
Анна Валл: Доброе утро. Благодарю вас за приглашение — для меня большая честь говорить на любую тему по этикету, тем более в этой студии, тем более с вами. Я посмотрела ваши работы, они мне очень симпатичны, и постараюсь быть на той высоте, которую вы задаёте.
Теперь к вопросу. Знаете, самая большая наша ошибка, человеческая, — думать о том, какое первое впечатление мы произведём. Настраиваться на то, чтобы произвести впечатление, — это плохо. Почему? Потому что мы скованы, мы сосредоточены на себе — и это обязательно скажется. Это такая позиция эгоизма, не в плохом смысле, а именно сосредоточенности на себе.
А как только мы освобождаемся из этого плена — мы сразу становимся другими. И если у нас при этом есть ещё вектор внимания к другим людям, этого бывает достаточно. Просто достаточно, чтобы первое впечатление о нас было не то чтобы прямо хорошим-хорошим, но спокойным — мы не будем фальшивить. Потому что когда мы стараемся произвести впечатление, мы часто фальшивим: вот эти преувеличенные улыбки, это открыточное выражение лица — оно всё уходит, как только человек внимателен к другому. В нём проявляется то хорошее, что есть в людях, — любовь, пусть в самой маленькой степени, но внимание к другому.
Алексей: То есть вы бы не рекомендовали при первом контакте пытаться казаться лучше, чем ты есть на самом деле, а просто быть собой?
Анна Валл: Знаете, это тоже ловушка. Что значит «просто быть собой»? Это тоже своего рода эгоизм: ну вот я такой, полюбите меня таким, какой я есть.
Хочу — ковыряю в носу, хочу — вздымаю бровь. Граница именно там: как только мы переключаемся с себя на другого человека, на другую сущность, мы не предаём себя в этот момент, но излучаем ту самую модальность — желание быть с другим, а не показать себя. Ведь ради чего-то же я прихожу в эту компанию, ради чего-то знакомлюсь с этими людьми, вступаю в разговор — не знаю, с портье, с продавщицей в магазине. Ради чего-то. Чтобы эта маленькая сцена получилась неплохой, чтобы она не омрачила ни её, ни продукт, который она продаёт, ни всё остальное, что за этим стоит, ни мироздание в целом. Я говорю крупные слова просто для того, чтобы нас разогнать в эту тему — но они не крупные, они именно такие.
Бывает, что мы невнимательны к другому просто потому, что задумались: едешь в поезде, поезд тронулся, начался ритм, ты как-то убаюкан, погружён в себя — и в этот момент кто-нибудь, скажем, кондуктор, обращается к тебе — проверить билет, предложить чай, неважно что. И если в этот момент мы поднимаем глаза, и в наших глазах происходит переключение от себя, мы даже можем сказать: «Ой, простите, я увлёкся». Мы смотрим, слушаем и внимательно считываем обращение человека к нам — зеркальные нейроны действительно существуют. Достаточно сделать этот посыл: я внимателен к вам, вы что-то хотели, сделаю всё, что в моих силах и компетенциях. И всё. Этого бывает достаточно.
Мы эту простоту и эту ясность как будто утратили за всеми этими клише: «будь собой», или наоборот — «произведи первое впечатление». Вот нет всего этого. То есть оно есть, но это как раз из таких плохих подсказок.
Алексей: Когда мы поднимались в лифте, вы вспомнили фразу Коко Шанель о том, что первое впечатление нельзя произвести дважды. На моей памяти я по пальцам одной руки могу пересчитать людей, у которых первое впечатление не совпадало с тем, как они потом раскрылись. Обычно то, как считываешь человека за первые несколько минут, — таким и оказывается его уровень искренности, открытости или лицемерия. Может, это я просто по молодости так ошибаюсь?
Анна Валл: Это был комплимент мне, да? Ладно, идём дальше.
Алексей: Тут скорее в силу того, что я ещё слишком юн.
Анна Валл: Алексей, всё хорошо.
Алексей: Как вы вообще относитесь к этой фразе про то, что первое впечатление нельзя произвести дважды? И насколько оно реально показывает, какой человек есть на самом деле?
Анна Валл: То, что второго шанса произвести первое впечатление нет, — это истина, простая арифметика: один раз есть один раз, второй раз уже не будет первым. А вот совпадает ли потом это мгновенное, как молния, впечатление с тем, как человек разворачивается дальше, — я с вами согласна, часто да. Если первое впечатление было такое, что человек слишком старался — помня фразу Коко Шанель, пытался выжать из себя максимум, чтобы взойти на пьедестал, — таким он потом и будет: немножко фальшивым, немножко тщеславным, немножко обидчивым, немножко заносчивым.
А бывает первое впечатление такое, что ты даже не обратил на человека внимания. А потом понимаешь, почему: потому что в нём главное — скромность, он не выбегает на авансцену. И так будет всегда: то, что он поначалу не показался лидером, потом будет только углубляться в его пользу. Не потому, что быть лидером плохо, а потому, что лидерство бывает разным. У него — вот такое.
Алексей: Есть ещё популярная фраза «Fake it till you make it» — изображай что-то, пока не добьёшься этого на самом деле. Некоторые интерпретируют это применительно к ощущению от себя: допустим, человек неэнергичный, зажатый, неуверенный, а когда знакомится с кем-то, набирается храбрости и показывает, что он орёл, — грудь вперёд, больше энергии. Насколько корректно идти по такой тропе? Или если ты не орёл, а...
Анна Валл: Куропатка?
Алексей: Допустим. То и оставайся куропаткой — в этом и есть твоя аутентичность.
Анна Валл: Возьмём не куропатку, это как будто обидно звучит, — ты не орёл, ты просто соловей, допустим. У любой божьей твари есть своё, не бывает отрицательных. Но вопрос хороший. Человек очень сложен — я сейчас прямо делаю открытие. Сложность человека в том, что он с детства подражает. Сначала родителям: он бы не вырос и не стал человеком разумным, если бы у него не было этой возможности и даже потребности подражать — в жестах, в манерах, во всём. А потом это часто переходит в навык подражать ролевой модели: мы следуем какому-нибудь герою, который произвёл на нас впечатление, — книжному, киношному, любому. Или конкретному человеку.
Плохо это или хорошо? Отрекаемся ли мы от себя в этот момент, или, как у Маяковского: «Я себя под Лениным чищу» — можно вставить любое имя, — ты кому-то следуешь. Кто ты для тебя такой, каким ты хотел бы быть? Это неплохо: значит, ты время от времени себя взвешиваешь, у тебя есть примеры. Другое дело — и я хочу сказать, это действительно так, — если мы всё время изображаем, изображаем, изображаем, рано или поздно маска прирастает, и ты становишься этим. И сказать робкому человеку: «Не изображай из себя мачо, ведь ты не он» — я не думаю, что это обязательно правильный совет. Может быть, ему так легче, и он, играя, играя, доигрывается до реальности. У меня нет универсального совета — делайте так или не делайте так.
Алексей: Мне кажется, это очень тонкий лёд — там легко потерять себя.
Анна Валл: Тонкий лёд. Но, знаете, тонкий лёд — это ещё и всё время быть только собой, когда у тебя нет опоры. Когда ты себе не придумал фундамент, на котором стоишь, — пусть он даже с твоим не совпадает, но ты внутренне на него опираешься: я буду как... Часто это старший брат, сестра, родители или учитель. Это неплохая опора. Это, в конечном счёте...
Предлагаю сейчас из глубины теории спуститься на землю практики.
Анна Валл: Или подняться.
Алексей: Ну да, так будет корректнее — подняться на землю практики. В плане речевых оборотов, которые не красят, — мне кажется, это ещё и от периода зависит: я видел лекцию, довольно давнюю, не вашу, где упоминалось, что «доброго времени суток» — это некорректная формулировка. Сейчас я такого вообще ни от кого не слышу, за последние несколько лет даже не вспомню, кто так говорил, — по крайней мере в моём окружении. Из того, что вы сейчас встречаете или слышите, — можете вспомнить штук пять самых популярных вещей в коммуникации, с которых начинают или которые используют и которые лучше так не делать?
Анна Валл: «Доброго времени суток» никто и не говорил — так писали, с опорой на то, что мы в разных часовых поясах. Я много раз об этом говорила. Сейчас это ушло — и правда, очень нехорошая фраза, не потому, что она как-то фонетически звучит, а потому что она абсолютно грамматически некорректна, причём сразу в нескольких позициях. Оставим её.
Алексей: Вашими стараниями мы от неё избавились.
Анна Валл: Не моими — знаете, язык сам убирает шлак. Он такая большая умница, сам всё понимает. Язык и речь — это же разные вещи, совершенно разные космосы. Язык — это система, от нас никак не зависящая: мы не влияем на язык, мы влияем на речь. Язык — это анатомия, если делать такое сравнение: у каждого живого существа есть сердце, лёгкие, печень — набор морфологических признаков. А вот реализация этой морфологии у всех разная — так и речь как физиология: вы бережёте свою печень, я — нет, допустим. Хотя и там, и там — печень. Хорошая метафора, она сразу всё ставит на места: мы не можем на себя повлиять и вырастить второе сердце, если это не метафора, а вот воспользоваться своим сердцем в наилучшем ритме или поберечь его — можем. Физиология — это речь, как мы говорим, это чисто индивидуально. А язык — вы говорите на русском, кто-то на английском, кто-то на испанском, язык к вам поначалу вообще не имеющий никакого отношения, — это данность.
Так что, конечно, то, как мы говорим, — это всегда коэффициент, показатель нашей натуры. Если человек даёт себе труд думать над тем, что он говорит, и подбирать слово, потому что ему это важно, — это не значит, что он такой принципиальный блюститель правильности, просто ему так комфортно. У него, может быть, с детства такая речевая гигиена: ему так удобно, он так себя вольно чувствует, ему кажется, что его мысль в этот момент гармонична, если он подбирает к ней наиболее подходящие слова. И это слышно — в этот момент возникает тот самый коэффициент речевого портрета человека, он может быть понижающим или повышающим.
Так что понижает речевой портрет сегодня? Любое явление нужно рассматривать во времени: молодой человек говорит «короче» — пусть говорит, когда-нибудь это уйдёт. А вот человек моего поколения, говорящий молодёжным сленгом, выглядит нелепо — настолько нелепо, что рядом с молодым человеком время работает против него.
Алексей: Это даже высмеивают во всех приколах.
Анна Валл: Да-да-да. То есть, что называется, вам не идёт — вы остались, а ваши штанишки давно отросли, просто вы за ними не успели. Но есть вещи, которые становятся такими общеупотребительными шаблонами: не называть вещи своими именами, а говорить «ну, вот такая штука», «эта штучка». Это не сленг, это не принадлежность времени — это скорее показатель не столько торопливости, сколько халатного отношения к мышлению: лень подбирать слово, надо быстренько что-то сказать про эту штучку.
Алексей: Меня самого раздражает, когда я использую слово «штука» или «вещь». Я стараюсь на опережение продумывать, чем заменить, — хотя не так сильно парюсь насчёт этого... хотя вот, даже слово «парюсь» произношу в вашем присутствии, хотя мы не в бане, наверное, это тоже некорректно, ну ладно, это уже мои заморочки. Но язык метафоричен, и вот эту «вещь-штуку» я стараюсь избегать, потому что мне очень режет слух, когда это использует кто-то другой. Часто просто нехватка словарного запаса: ты хочешь подобрать слово, не можешь — и в итоге ладно, штука.
Анна Валл: И, возвращаясь к этому, — это не сленг, это не сниженный уровень, это абсолютно...
Алексей: Бедность речи.
Анна Валл: Бедность речи. Это бедность мышления. И это неприятно. То же самое, когда мы говорим: «Ну, это другая история», «так не работает», или наоборот «это работает», или «зашло — не зашло». Это застиранные, очень плоские, очень примитивные штампы. Их бы надо в своей речи отслеживать и прямо давать себе усилие — поручение мозгу подыскивать что-нибудь поточнее.
Алексей: А какие вам сейчас приходят на память самые популярные штампы и слова-паразиты? Что люди действительно используют?
Анна Валл: «От слова совсем».
Алексей: О, да.
Анна Валл: Штампы штампов уже просто невыносимы. Любые зачины вроде «я стесняюсь спросить», «то-то и то-то» — нет, мы не будем смеяться, мы смеёмся над другим, — но все эти штампы, и разговорные, и письменные, которые бывают в блогах, раздражают. Это правда.
Алексей: Вопрос: они раздражают именно вас, в силу прокаченности речи, или это в принципе непозволительная история?
Анна Валл: Я не могу сказать «позволительно» или «непозволительно» — некорректно так говорить, потому что «корректность» — это точность. Некорректно не в смысле невежливо, а в смысле неточно. Это действительно неточно.
Алексей: Я сам от слова «совсем» часто не использую это выражение, но когда в диалоге, около спора, хочется усилить свою позицию, иногда достаю этот меч из кармана.
Анна Валл: А он деревянный, этот меч, понимаете? Если не картонный — дерево обижать не буду, а картон могу. Это вещь рукотворная. И такого много: «а вот это не пробовал?», «а голову включать не пробовали?», «а логикой пользоваться не пробовали?» Вот это унизительное, оскорбительное.
Алексей: Манипуляция?
Анна Валл: Да, агрессивная. Хотя это не столько манипуляция, сколько признак того, что человек сам сейчас в истерике — речевой. И тогда его жалко, думаешь: «Тихо-тихо-тихо», уже ничего хорошего не будет, не будем дальше дразнить гусей.
Алексей: Встречали ли вы успешных и сверхуспешных людей — по карьерной лестнице поднявшихся или предпринимателей — с бедным языком, кучей штампов? Понятно, что косячат все — я даже Цискаридзе считаю довольно подкованным в плане языка, у него прямо поставленная речь, но в одном недавнем интервью он за два предложения трижды использовал одно и то же слово-паразит — то ли «короче», то ли «типа». Прямо резануло, я удивился, что Николай себе такое позволил. То есть косячат все, но есть люди с в целом бедной речью — вы таких встречали среди тех, кто высоко поднялся?
Анна Валл: Да, конечно, конечно.
Алексей: Они это как-то комментируют?
Анна Валл: Нет такой линейной зависимости. Кто-то хорошо говорит — значит, у него широкий проспект карьеры. Кто-то говорит плохо, а то и вообще скудно, но при этом талантливый, гениальный менеджер — он решает шахматные партии бизнеса без слов, и это тоже хорошо. То есть речь не единственный путь к успеху или неуспеху, это инструмент, который кому-то помогает больше, кому-то меньше, но не определяющий.
Мы не будем ставить в вину, скажем, тому же Николаю Цискаридзе, что когда он начинает рассуждать об искусстве — там он дома, там мастер, там у него клокочет мысль, и ему хочется донести её во всей полноте, — а когда начинаются разговоры около-политические или меркантильно-мировоззренческие, там человек как будто становится не равен себе, по замыслу Бога: он передаёт не свой талант, говорит не о своей теме, — и тогда начинается эта неряшливость. У многих людей.
Алексей: Вы сейчас работаете с поколением зумеров?
Анна Валл: Ну конечно.
Алексей: Есть ли в их речи вещи, которых вы раньше не встречали у молодых людей такого возраста в прошлых поколениях, — именно с зумерами пришедшие, режущие слух?
Анна Валл: Знаете, мне ничто не режет ухо. Звучит так, будто я отбиваюсь от ответа, — но я лингвист, я это как бы присваиваю.
Алексей: Есть ли просто интересные наблюдения за их речью?
Анна Валл: Есть. Поделюсь — и, наверное, скажу то, что не ожидается услышать. Они хотят говорить хорошо. Они подражают хорошей речи, они влюблены в хорошую речь, они чувствуют свою задержку в развитии — скажу так аккуратно. Я знаю очень много аудиторий, где вопрос всегда один: как улучшить свою речь? Как быть достойным своей речи — не своей, а языка, который тебе положен в колыбель? Это лучшее, что у них есть.
А то, что у них очень много временного налёта, — ну конечно, это было и будет у всех, не было такого поколения без своего речевого обихода. Это абсолютно естественно, это как мода, как климат, который тоже меняется. Наряду с этим желанием хорошо говорить у них очень ярко проявляется другое: они ревниво относятся к неологизмам — новым словам («нео» — новый, «логос» — слово). Ревностно отстаивают принадлежность к полноценному, сформированному языку: нам не нужны заимствования. Это бывает наивно, мы с ними об этом говорим.
Однажды меня спросили в эфире — это был зум, и это точно был зумер, — когда я употребила слово «кейс». На экране всплывает: «Анна, вы уверены, что вы умеете говорить по-русски?» Я мысленно сказала себе: «Получи, фашист, гранату» — а вслух ответила, что попробую и уверена, что справлюсь. Начался вебинар. И к чести этого молодого человека, в конце он извинился передо мной — публично, как и положено по этикету. Он публично меня задел, а потом публично принёс извинения. Это был для меня главный герой дня — он поднялся на эту высоту.
Алексей: Его задело именно слово «кейс»? Это из тех людей, которые считают, что в русском языке не должно быть заимствований — это зумеры про это говорят?
Анна Валл: Да-да-да-да-да. Об этом говорят все.
Алексей: Старшее поколение — я понимаю их претензии. А почему мои ровесники про это говорят?
Анна Валл: Ваши ровесники тоже ревнивые. Им тоже кажется, что... идея самодостаточности их тоже заразила.
Алексей: Есть вещи, которые я не понимаю — сейчас прозвучит поверхностно, но как будто людям просто нечем заняться. О таких вещах не думаешь, когда есть много дел. Ну ладно, классно, что тот парень извинился.
Анна Валл: Но я тоже это могу понять. Человек в своём языке чувствует себя неуютно, когда у него уже есть речевое самосознание — это не маленький ребёнок, а уже человек после школы, после высшего образования, он уже как-то укоренился в языке. И вдруг он сталкивается с тем, что ежедневно встречает публичные и непубличные выступления, читает тексты, в которых ему в родном языке неуютно, — он должен постоянно гуглить слова. И постепенно возникает изжога, отторжение. Это всё объяснимо, в зависимости от темперамента и сферы деятельности. Надо просто успокоиться и сказать: да, все эти слова войдут, они хлынули — это сейчас водопад, наводнение, связанное с цивилизацией, с новым витком, с новыми явлениями, которые получили новые слова. Что-то останется, что-то нет, мы привыкнем — потому что любой большой язык на девяносто и больше процентов состоит из заимствований, как большая река. Это нормальное явление.
Алексей: Меня в этом резануло другое: у заимствованных слов разная «температура» — есть совсем ещё холодные, только появившиеся у определённых групп, условно «вайбить», — вы бы вряд ли так сказали, мало кто использует. А слово «кейс» настолько уже укоренилось корнями в речь, что странно до этого докапываться.
Анна Валл: Вы абсолютно правы, именно так. С «кейсом» это было не вчера, может быть, лет четыре назад, но слова привыкают — общество, речевое сообщество к ним привыкает, присваивает себе, оно начинает склоняться, подчиняется морфологии родного языка. Уже все говорят «гуглить» — а как по-другому сказать, «поискать в поисковике»? Длинно. Язык всегда возьмёт слово, которое ему, что называется, «на язык». Слово «вайб» я бы уже сейчас сказала — совсем недавно меня спросили в одной аудитории: «Чем атмосфера отличается от вайба?» И мне пришлось на ходу быстро ответить. Когда ты можешь себе представить это слово в его новой полноте смысла, даже гуглить не надо: атмосферу создают, вайб — возникает. Это разное.
Алексей: У вас есть любимые слова, появившиеся за последние лет пять-десять? Поделитесь, интересно.
Анна Валл: Много. Ну, тот же «гуглить», тот же «кейс». «Знаете» — это мой любимый паразит.
Алексей: А я, кстати, всегда замечаю — у вас это звучит скромно, не режет, а есть люди, которые используют «знаешь? знаете?» как манипуляцию: каждый раз начиная что-то говорить, они как будто не дают тебе шанс не согласиться, и ты чувствуешь, что не хочешь особо лезть контраргументировать. Такой: «Ладно, знаю, знаю».
Анна Валл: Да, или слово «смотрите» — задаётся вопрос, ответ начинается со слова «смотрите». Куда смотреть? А мне нравится почти вся кулинарная запашистая новая лексика — все эти панакоты. Я уже не говорю про пиццу. Всё это нравится — как будто расширяется не то чтобы кругозор, а именно чувственное ощущение мира: пришли слова со своим вкусом, запахом, энергией. Я люблю слова, которые пришли из сферы моды — все эти френчи, тренчи. Новые слова, которые обозначают действительно новые вещи — пусть будет. Я уже, конечно, не слежу за всеми названиями этих кроссовок на такой подошве, на такой — я уже не способна. Но когда кто-то это употребляет, я отмечаю, что человек, наверное, этим интересуется — это говорит о сфере его интереса. И это замечательно.
Я заметила, что самое сильное раздражение вызывают слова, которые пришли из менеджмента.
Алексей: А пример, пожалуйста.
Анна Валл: Когда начинаются разговоры про слово «митинг» — уже привыкли. А вот если мы хотим о чём-то договориться, что мы делаем? Не «застолбили», а что?
Алексей: Зафиксировали.
Анна Валл: Во-во-во, «фиксить». Даже не «зафиксировали», а «фиксили». Зафиксировать можно пациента, а тут что? Мы знаем это слово. Что там?
Алексей: Баги, фичи.
Анна Валл: Да-да-да-да-да. Кстати, «баг» — знаете, что это такое? Это насекомое. И знаете, откуда пошло это слово? Это ошибка, которую, в отличие от «фичи» — то есть не ошибки, а возможности, — исправить нельзя. Сейчас я умничаю не на своём возрастном опыте.
Алексей: Айтишники не возбуждаются.
Анна Валл: Айтишники не возбуждаются — это можно погуглить, там интересная история. Слово впервые употребила одна из первых программисток, которая ещё не знала, что она программистка, — это были примерно пятидесятые годы. Человек занимался кибернетикой и высшей математикой, и однажды в одной из вычислительных машин — можно представить, какого размера это было, — она всё время набирала программу, а машина выдавала ошибку. В конце концов она открыла физическую плату и обнаружила там засушенную моль на одной из пластин — та не давала контакту сработать. Моль надо было убрать: иначе хоть тысячу раз нажимай на клавишу или тумблер — контакт был засорён молью. Убрали — и вот это баг. Я люблю такие вещи, потому что возникновение слов — это же счастье, как найти золотую жилу или месторождение. Оно доставляет колоссальное удовольствие — раскапывать слово, вдруг задаваться вопросом: откуда оно?
Алексей: Обычно, когда говорят про речь, подразумевают какую-то корреляцию с интеллектом, умом человека. А есть ещё понятия вроде «дорогая» и «бедная» речь — не по насыщенности, а по уровню дохода человека. Есть ли зависимость между уровнем дохода и тем, как люди начинают разговаривать?
Анна Валл: Под словом «доход» я боюсь представить, что мы имеем в виду — счёт в банке?
Алексей: Ну, сколько человек зарабатывает в месяц.
Анна Валл: Нет, такой корреляции нет. Она бывает даже отрицательная.
Алексей: То есть человек богатеет — и...
Анна Валл: Я имею в виду другой доход. Какой? Тот капитал, который человек нажил: сколько он читал, эта насмотренность, наслышанность, надуманность — как бы ни называлось это слово. Человек, который много читал, много видел — живопись, спектакли, фильмы, — который размышлял, безусловно, в речи богаче. Почему? Потому что речь и мышление неразделимы, это единый феномен. Кто жил и мыслил, тот не может иметь убогую речь — он может её не воспроизводить вслух, но внутренняя речь у него богатая.
Алексей: Вы уже говорили, что нет прямой корреляции между успехом и речью. Но мне кажется, какая-то зависимость всё же есть — и, думаю, у зрителей есть запрос на то, чтобы прокачать навык говорить. У вас всё поставлено на места, очень интересно слушать вживую и в лекциях. Вопрос: что вы за жизнь поняли, какие ключевые советы дали бы людям, которые хотят улучшить и подачу, и грамотность, и широту, и красоту речи?
Анна Валл: Если это не в моменте, вот прямо сейчас надо говорить...
Алексей: Долгосрочная работа.
Анна Валл: Да, тут трудно советовать что-то, кроме: говори, не бойся, не стесняйся, забудь о себе, говори, что болит, — и всё получится. Заикаешься — заикайся, ничего страшного. Аудитория прощает всё. Аудитория не прощает двух вещей: незнания темы и высокомерия. Если этого нет — всё будет хорошо.
А теперь про долгосрочную перспективу. Надо писать. Мало того, что надо читать, — хотя читать хорошо, но тут тоже есть ловушка: человек научился читать быстро, и это скорочтение — тоже ловушка. Мы гонимся за количеством, не погружаемся. Что-то, конечно, можно читать по диагонали — если оно не достойно того, чтобы тратить на него время. Но что-то надо читать так, чтобы возвращаться к строке, которая вас на каком-то уровне поразила интеллектуально, которую вы не сразу поняли, или в которой вдруг видите зерно мысли. Читайте на эстетическом уровне — просто потому, что фраза звучит так, что, что называется, «мёда не надо». Или чувствуешь, что «завтра не обедаю» — потому что этот гештальт закрыт одной эстетической фразой.
У Дины Рубиной есть чудесное — правда, последнюю Рубину, на мой взгляд, уже можно читать по диагонали, но всё, что она писала лет пять-десять назад, было именно эстетическим наслаждением. Ты читаешь фразу и счастлив, что понимаешь её и принадлежишь этому языку. Например: «трамвай полз медленно, как будто вынюхивал перед собой что-то на рельсах». Всё. Можно отложить книгу, налить себе вина, порыдать, потом снова вернуться. Это, конечно, сейчас у меня такая экзальтированная сценка.
Алексей: Я в книгах такие фразы подчёркиваю ручкой. Простите, все, кто это осуждает, но мои книги — что хочу, то и делаю. Потом их выписываю. С вином, конечно, так не развлекаюсь, но тоже цепляет.
Анна Валл: Это был мне упрёк? Я не развлекаюсь — я это для красоты картины сказала. А может, и развлекаюсь — секта книголюбов. И надо самому писать. Ещё до того, как вы набираете материал для какого-то выступления, — знакомая ситуация, когда предлагают выступить на тему, — самое главное — ударить себя по рукам и по голове и не начинать сразу думать над темой, потому что тема бесконечна, и есть соблазн рассказать всё, что знаешь по ней. Это безбрежное море — ловушка, в которой утонешь.
Сначала нужно понять: любая тема формулируется в именительных конструкциях, неважно какая — пусть будет «современная речь современного молодого человека». Это тема. А дальше вы должны найти в этой теме свой тезис — свою мысль. Она может быть одна, пусть будет одна для начала: красная нить. Что я хочу сказать в этой теме? Что у меня по ней болит? Что я могу предложить другому человеку — с расчётом на то, что он будет возражать, и с необходимостью потом это аргументировать? Например, я в этой теме говорю, что современная речь современного человека недостойна завоеваний предыдущих поколений.
Алексей: Давайте я скажу, что вы сноб и уже немного зазнались в силу возраста. Как вы это контраргументируете?
Анна Валл: Очень просто: да, я сноб. Я призываю вас — даже маленьких детей — вырастать до снобизма во всём, что вы делаете.
Алексей: Это негативное качество, нет?
Анна Валл: Это хорошее качество. Негативность ему приписывают те, кто до него не дотягивает, — сказала бы я вам. Это не значит, что я сейчас такая.
Алексей: О, какой тезис, оказывается. Я не был готов.
Анна Валл: Если мы будем разбирать это слово, мы многое найдём. А потом, в другой плоскости, скажем: вы помните журнал «Сноб»? Читали?
Алексей: Не застал.
Анна Валл: Вот видите. А я сноб — я застала журнал «Сноб» и даже туда что-то когда-то писала. То есть мы можем говорить обо всём на свете, это я просто как пример привожу. Или наоборот: в теме «современная речь современного молодого человека» у меня возникает тёплое чувство, что моя жизнь не прошла даром. Вот моя мысль, например. Вы спросите: «В смысле?» А я скажу: я много лет занималась просвещением, пропагандой мысли, что речь — это великое счастье, дар, искусство и ответственность. И я вижу сегодня плоды — вижу, как замечательно говорит и пишет молодёжь. Если я читаю какой-нибудь пост и потом узнаю, что человеку всего двадцать два года, я, оглядываясь на своё время, думаю: я не могла в двадцать два так глубоко мыслить. Хотя заканчивала филфак.
Алексей: Но, допустим, Пушкин — это, конечно, тоже ранний случай: он начинал «Руслана и Людмилу» в семнадцать, а закончил, кажется, в двадцать или двадцать один — очень ранние цифры.
Анна Валл: Очень ранние. И когда Жуковский, прочитав «Руслана и Людмилу», подарил ему свой портрет с надписью «Победителю-ученику от побеждённого учителя» — тот действительно был учеником, у него был ученический возраст. Но это гений. И тогда можно сказать: не всегда возраст и дарование совпадают. Толстой, скажем, — а Гёте писал своего «Фауста» на закате жизни, и это тоже шедевр, тоже прецедентный текст, тоже мировая величина.
Алексей: Чтобы приступить к какой-то задаче, людям, мне кажется, нужна конкретика — хотя бы план-минимум, чтобы начать и чувствовать, что вписываешься в рамки. Про «писать» — давайте зададим рамки: сколько в день, чтобы этого было достаточно? Одно предложение от руки в блокнот — наверное, маловато будет?
Анна Валл: Ради чего это одно предложение будет написано? Можно написать «В лесу родилась ёлочка» — точка. Зачем? А если вы задаёте себе задачу: сегодня опишу погоду одной фразой — это уже работа мозга. Расскажите о сегодняшней погоде: мы вместе с вами двигались, застали её, как-то на неё отреагировали, — опишите одним предложением. А дальше усложните: опишите её с точки зрения оптимиста. Или с точки зрения мизантропа — пессимиста, который не любит человечество и не может его любить. Или с точки зрения человека, у которого вчера была температура. Давайте себе такие маленькие творческие задания — вы к ним привыкнете.
Вечером, заканчивая день, просто напишите несколько строк. Вы же ведёте дневник, все сегодня что-то пишут — планы на завтра, допустим. Даже если не пишете, у вас в голове: «Так, завтра надо то-то, то-то, то-то сделать». А давайте я это напишу в пяти пунктах. А давайте сокращу до трёх без потери смысла и задач. Человек говорящий — это человек пишущий, и читающий. Эти три единства абсолютно необходимы, если у вас есть задача или вы хотите продвигаться в речи. Если вы сами пишете, вы потом будете замечать в текстах гораздо больше, чем замечаете сейчас, — будете больше слышать и лучше писать. Вы будете иначе воспитывать своих детей, глядя на их сочинения, когда говорите: «Вот нужен план».
Я с мучительной тоской вспоминаю, как мы в школе писали сочинения — класс шестой, по «Капитанской дочке». Надо было сначала составить план, а ты вообще не понимал, что это такое и что ты должен делать: пересказать «Капитанскую дочку» — это одно, написать рецензию — кто из нас понимал, что такое жанр рецензии? Ты просто линейно думал: а что я расскажу. «Общественная обстановка в России времени написания» — это было немыслимо плохо, нас приучали к совершенно выхолощенной мыслительной деятельности, мы пересказывали учебник и называли это сочинениями.
А просто сочинение написать ребёнок вполне может — его жанр описательный, он может описать без всякого анализа. Поставьте ему хороший вопрос: «Завтра 8 Марта — за что я люблю маму?» Маленький ребёнок пишет открытку. Или у бабушки день рождения. Если в семье есть культ — назовём его культом просвещения, знания, обмена мнениями, обмена восторгами, — это потом становится нормальным речевым голодом, речевым аппетитом. И речь сама по себе — вы не заметите, как окажетесь на другом речевом уровне. Но это труд.
Алексей: Причём осознанный труд? Вы приводили метафору про мёд — вопрос от мастодонтов постарше или, наоборот, от нового поколения: вы говорили, что читаете посты двадцатидвухлетних, которые вас удивляют, — кого вы смотрите, слушаете или читаете и кого порекомендуете? У кого самая, скажем, сладкая речь?
Анна Валл: А сладкое — это плохое?
Алексей: Это в продолжение истории про мёд.
Анна Валл: Понимаю. Мёд не в значении «сладкое», а в значении «наслаждение» — я в этом смысле его и имела в виду. Я с удовольствием слушаю... но иногда это правда мёд, слишком сладко — Армен Захарян, если вам это что-нибудь говорит.
Алексей: Нет — но буду исправляться.
Анна Валл: Послушайте — «Армен и Фёдор», так называется его канал: он анализирует литературные произведения, это колоссальное наслаждение. Он, знаете, танцует — это речевой танец, всё, что он делает, только успевай отслеживать эти танцевальные фигуры. Счастье.
Кого бы я ещё назвала — многих, многих.
Алексей: Можно просто перечислить?
Анна Валл: Я не смотрю телевизор, поэтому у меня нет этой насмотренности — но это не значит, что я не слежу за современной жизнью. Я люблю подкасты умных людей — Роман Тарасенко один из них, я смотрю всех его гостей, когда есть время, хотя это не всегда коротко. Кого я люблю читать — тоже многих, но воздержусь от имён, чтобы им не навредить.
Алексей: И всё же задам уточняющий вопрос, раз есть возможность. Я для себя недавно открыл Довлатова по рекомендации умного человека — открыл в плане насыщенного чтения. И ещё интересно: часто, когда устал и обычно выбрал бы посмотреть рилсы, я вместо этого думаю — пойду почитаю, потому что это смешно и интересно. Потому что это легко, прямо для моего зумерского мозга, который уже прошит лёгким дофамином из контента, и мне тяжело читать в отличие от школьных лет, когда ещё не было ТикТока. Вот Довлатов у меня встал на уровень такого контента — очень интересно. «Чемодан», по-моему, книга называется. Может, порекомендуете кого-то ещё для людей с такими же проблемами, как у меня, — ну, и для меня самого?
Анна Валл: Конечно, Довлатов — это стендапер, тогда такого слова не было, а сейчас есть. Он абсолютный стендапер.
Алексей: Я не знал, что над книгой можно смеяться в голос.
Анна Валл: Можно, можно. Довлатова мы полюбили сразу, наше поколение — как только он появился.
Алексей: Кого ещё в пример можете привести?
Анна Валл: Чехова — однозначно. Зощенко, Надежда Тэффи. Хотя Чехова я бы отдельно вынесла и сказала: прости, Антон Павлович, но это недосягаемая звезда, а всё остальное — немного подмастерья. У Довлатова видно, как сделана его проза, а у Чехова — нет: ты не понимаешь, как можно, ничего особенного не рассказывая, держать так крепко. У Довлатова всегда ждёшь развязку — и она будет, представленная эффектно. А у Чехова как будто и аллергии особенной нет, но она такая мощная и глубокая, что ты не понимаешь, как ты уже настолько впустил в себя этот сюжет, этого автора или этих героев — и вдруг оказываешься совершенно обнажённым.
Читайте ещё Марка Твена — это тоже сродни Довлатову. И, конечно, читайте Набокова, если хотите просто хорошую, абсолютно люксовую прозу.
Алексей: У нас получился список авторов для зумеров — и не только. Вопрос: вы много работали с корпоративным миром, обучали компании и менеджеров коммуникации. Какие были самые яркие истории, когда опытных людей удивляло, что нужно по-другому, — а вы им это показывали, и для них открывался новый мир? Чем вы удивляли опытных людей на практике?
Анна Валл: Наверное, вот чем. Когда я начала работать в этой теме — это было уже больше двадцати лет назад, — была очень популярна, заразительна и манящая идея жёстких переговоров. Главным был вопрос: как сказать так, чтобы поставить на место?
Алексей: Тогда и книги такие выходили.
Анна Валл: Жёсткий менеджмент, жёсткие переговоры — всё было жёсткое. Казалось, что нужно накачивать именно эти речевые мускулы, «отбрить так отбрить». А я уже тогда заходила в аудиторию с идеей: никак, оставьте это, оставьте агрессию, оставьте борьбу. Если вы действительно хотите win-win, если мы действительно ради дела, а не ради самолюбия, — это надо оставить.
Алексей: Здоровое партнёрство важнее.
Анна Валл: Вы тратите время, тратите свою энергию, тратите свою репутацию.
Алексей: Были те, кто прямо спорил с вами?
Анна Валл: Были, безусловно. Аргументы были такие, что любая вежливость — это слабость. Приводили примеры: были переговоры с одной компанией, мы сделали всё очень мягко, а потом пришли грубые ребята, стукнули по столу — и выиграли тендер. Жизнь сложна, это правда. Я рада, что сегодня как раз такая мягкая система, «айкидо», отсутствие агрессии — единственный верный путь вдолгую. Но в девяностые я работала за границей, дома не была, а в нулевые это было именно так, и у этих людей была своя правда, свой опыт — они говорили, что важно, как рассадить людей, не садиться напротив, чтобы не провоцировать агрессию, не садиться рядом. Не нужно приветливое лицо: «кто много улыбается, тот прячет страх», ну что-то в этом духе.
Алексей: Кроме жёстких переговоров, что ещё вспомните?
Анна Валл: Вспомню, конечно, привычку говорить по очень жёстким лекалам — отсутствие навыка говорить легко и свободно. Люди говорили строго по схеме: заявление, два аргумента, контраргумент. Всё были схемы, всё были те самые бесконечные лайфхаки: дайте три совета, дайте какой-нибудь жёсткий лайфхак. Люди тогда не любили установку на длинную стратегию — слово им было близко, но именно речевую стратегию отвергали. Только тактика, всё по шаблонам, очень шаблонно.
Алексей: Давайте попробуем ещё что-нибудь вспомнить — что-то полезное для зрителей из корпоративного мира или для предпринимателей.
Анна Валл: В корпоративном мире очень болезненной была тема клиентского сервиса — отношение к клиенту как к тому, кого обязательно нужно победить. Это и сегодня бывает. Расскажу одну маленькую историю, без названия компании — неважно. Недовольный клиент пишет в чате элитной недвижимости: «Собственники, не посыпайте снег реагентами, мой ребёнок любит есть снег».
Реакция управляющей компании — не всех, некоторых — сначала такая: «Ну надо же, какая эгоистка! Что значит „не посыпайте“? У нас люди травмируются, на прошлой неделе было то-то и то-то, мы заботимся о людях, а не о таких капризах». И тут находится человек, который говорит: «Подождите. Давайте встанем на позицию этой матери — она же не идиотка. Давайте исходить из того, что клиент не идиот и не хочет вести с нами войну. Ребёнок ест снег — это путь познания мира. Вы, взрослые люди, тоже знаете, как пахнет и какой на вкус снег, вы тоже это любили — оттуда выросло мороженое. Мы любим, когда идёт снег, высунуть язык и ловить снежинки — это наше детство. И мать говорит именно об этом, а не о том, что презирает людей с неустойчивой походкой. Неужели мы не можем найти компромисс — неужели на нашем большом закрытом дворе элитных домов не найдётся места, где не будем посыпать реагентом? Огородим его красиво, поставим несколько фанерных фигурок — мишку, зайчика, — и это будет маленькое место, где снег останется чистым».
И наступает тишина — потому что оказывается, так можно. Нужно просто дать себе труд подумать, что этот человек нормальный, а не сразу: «Ишь какая, ишь чего захотели». А ей ведь даже не нужно оправдываться, что ей некуда вывести ребёнка, что у неё нет дачи, — у неё есть снег, он падает с неба.
Я сейчас не к тому, что я такая сентиментальная и на старости лет развожу романтические акварели, — но это можно. Кстати, слово «клиент» я как-то посмотрела в словаре Даля — думала, что его там не может быть, потому что оно пришло в язык гораздо позже, но нет, оно есть уже в девятнадцатом веке. И Даль даёт ему толкование «подкрылыш» — тот, кто под покровительством, под крылом. Это сильно меняет всю философию отношений.
Алексей: Перед блицем хотел спросить — из вашей речи я слышал, что у многих есть ощущение деградации общества, языка, поколения. У меня, конечно, тоже есть интуиция, что так говорили про каждое молодое поколение каждые пятнадцать-двадцать лет — про панков, про эмо, и так далее. Мой дед рассказывал, что когда они танцевали твист, их тоже старшие не уважали.
Анна Валл: Шейк, мы ещё танцевали шейк — я думала, мы с вашим дедушкой одного возраста.
Алексей: Да-да. Я правильно понял, что вы считаете: сейчас с речью происходит не деградация, а просто этап эволюции?
Анна Валл: Конечно.
Алексей: Просто интересно было услышать. Теперь перейдём к блицу.
Задам несколько вопросов коротко, вы отвечайте тоже желательно коротко — но я с радостью послушаю и развёрнуто.
Анна Валл: Вот это «желательно коротко» — тоже мне была оценка. Я смеюсь: я не умею коротко.
Алексей: Но формат блица меня обязывает — предупредил, а там уж как получится.
Анна Валл: Слово «блиц» для меня было достаточно.
Алексей: Окей. Есть любимая цитата — своя или чужая, сильно запоминающаяся?
Анна Валл: Самое большое наслаждение — это наслаждение человеческого общения.
Алексей: Это ваша?
Анна Валл: Экзюпери.
Алексей: Вопрос от друзей подкаста, «Кофемания»: какой горячий напиток чаще всего пьёте, любите больше всего?
Анна Валл: Кофе.
Алексей: Какой?
Анна Валл: Американо.
Алексей: Понял, вы старой закалки.
Анна Валл: Вот это опять был комплимент? Кофе с молоком любит старая закалка — чёрный кофе это уже наше поколение. Мы действительно старая закалка. Ну ладно.
Алексей: Три классных, интересных, полезных книги, можно из разных сфер — чтобы люди, если начнут читать или слушать, не зря потратили время?
Анна Валл: Александр Чудаков, «Ложится мгла на старые ступени». Не спрашивайте почему. Владимир Набоков, «Другие берега». Чехов — всё, что хотите.
Алексей: Классный фильм, чтобы отдохнуть вечером после работы? И — ваши личные привычки, ритуалы, что помогает держать уровень энергии и продолжать работать: сколько в день читаете?
Анна Валл: Много, ожидаемо. А главный ритуал — разговор с братом. Он живёт на другом конце земли, не совсем на краю, но в Германии, а я здесь. По утрам мы пьём кофе — это тоже «Кофемания». На любом доступном носителе возникает вопрос: «Кофе?» И если я свободна, отвечаю: «Да». Мы говорим по аудио, видеосвязь — нет, зачем. Обо всём на свете. Так было и с сестрой, пока она была жива. Иногда мы говорили: если нас кто-нибудь прослушает, подумает — это сумасшедшие люди. Например: «А ты представляешь, слово „оппортунизм“?» Я говорю: мы же никогда не думали над этим словом. Он говорит: ну, это иногда по-английски, когда обсуждают футбол, — про команды. Я говорю: нет-нет, подожди, они, наверное, говорят «оппозиция». Он говорит: и так тоже говорят. Я говорю: «оппортунизм» — знаешь, что это? Мы вообще любим лазить по этимологическим словарям.
Алексей: Ну вы заинтриговали — что же такое?
Анна Валл: Разумеется — и меня он так же интригует.
Алексей: Давайте уже, интересно.
Анна Валл: Итак, что такое оппортунизм, если смотреть в первоначальное значение, — это благоприятное условие для корабля, чтобы зайти в порт. Попутный ветер. Так это было. А сейчас — совсем другое: отрицательная коннотация, использовать любую ситуацию в свою пользу, корысть, обман, независимо от средств — цель оправдывает средства, всё используешь себе на благо, поворачиваешь любую идею на свою тропинку. И мы с ним говорим: «А ты подумай — а мы?»
А ещё одна привычка — уже не разговоры, а переписка с зумером, это моя дочь. Очень коротенькая переписка: «Мам, не парься» — и там я получаю что-нибудь. Я пишу — мы тоже живём в разных странах — «Напиши мне ещё раз это слово так, как оно должно быть написано, чтобы я не потеряла сознание». Она говорит: «Ну, получи».
Алексей: Оно всё-таки есть, слово «ща»? Это ваше?
Анна Валл: Конечно, разумеется, оно есть, и оно уже зафиксировано — потому что это быстрое общение. Она мне выписывает всё как положено, смеётся: «Ну что, ма? Нет, всё хорошо».
Алексей: Вы при общении с дочкой — вы и Анна — ставите точки в конце предложения?
Анна Валл: Нет, не ставим. Это началось именно с неё. В конце предложения я ставлю точку всегда, но в мессенджере — нет, потому что мы давным-давно знаем, и не только по «британским учёным», но и наши лингвисты это заметили: точка в конце сообщения в мессенджере, там, где мы имитируем устное общение, становится агрессивной — как будто закрывает диалог, не даёт развиваться этому пинг-понгу. И в этом смысле я её не ставлю.
Алексей: Я помню, в одной из ваших лекций, которую я смотрел при подготовке, вы рассказывали про точку с той стороны, что это какая-то новинка — не ставить точку?
Анна Валл: Да, я думала, что буду последним человеком, который не подчинится правилам пунктуации, когда пишу буквами.
Алексей: Ну вот, начали.
Анна Валл: Вот этот феномен — мы используем буквы, чтобы изображать устную речь. Я начала, да.
Алексей: Сейчас мне даже интересно.
Анна Валл: Я не так сильно деградирую, чтобы совсем не ставить знаки препинания, — думаю, до этого не доживу. Но точку перестала ставить в мессенджере, подчёркиваю сто раз.
Алексей: Да, просто заметил, как мы с вами переписывались, из интереса. Анна, спасибо огромное, я жутко рад, что вы нашли время. Пролетел час, час с лишним. Спасибо, благодарю.
Анна Валл: Я тоже очень рада — не жутко рада, а очень рада.
Алексей: Спасибо большое.
Показать полностью 1
1

Арсений Дежуров: «Патриотам хорошо гордиться литературой, если они её не читали»⁠⁠

Филолог и преподаватель Арсений Дежуров — о том, почему чтение сегодня стало трудом, а не только удовольствием, зачем гуманитарные знания нужны как роскошь и почему настоящий патриотизм невозможен без честного чтения русской литературы.
Мы всё меньше читаем — а вместе с этим незаметно меняется само представление о том, что значит быть образованным, патриотом, русским человеком. Разговор философа-словесника то и дело уходит в сторону от привычных ответов: детство и старость, деньги и стыд, зумеры и графиня Ростова оказываются частью одного узора.
Арсений Дежуров в разговоре с Дмитрием Копанцевым разбирает, зачем нужен труд чтения, откуда берётся дар писателя и почему русская литература никогда не гладит свой народ по головке — а в конце называет три книги, с которых можно начать.
Расшифровка подготовлена с помощью Speech2Text. Источник видео: ссылка.

Дмитрий Копанцев: Арсений, вы филолог. Спасибо, что нашли время поговорить. Жизнь человека — она ведь и комичная, и трагичная одновременно. Если говорить о судьбе человека, какая она в вашей оптике? Как она складывается?
Арсений Дежуров: Вальтер Скотт сказал — то есть тогда это ещё считалось нормальным, — что ни один умный человек не захотел бы стать моложе своих лет. Я долго думал над этой мыслью и понял: да, действительно так. Если бы и хотелось долгой жизни, то разве что в нынешнем возрасте — но чтобы получше работали органы и зубы во рту стояли подешевле. А вот стать моложе по-настоящему не согласится никто в здравом уме, это было бы совершенным ужасом. Так что это всё неправда. Вальтер Скотт это сказал — или я. Я читал его так много и с таким упоением, что мысли наши перепутались: если я не уверен в своей мысли, я приписываю её Вальтеру Скотту, а если мысль хороша — думаю, что она моя.
Всё дело в том, что наша жизнь — это сплошная череда пробуждений. Сначала лучезарное младенчество, где-то три с половиной года: греки всё для нас посчитали, сколько какой возраст длится, чтобы жить было удобно — ровно до семидесяти, дальше с арифметикой уже не ладится. Судя по лицам младенцев, они всем довольны, кроме тех случаев, когда омерзительно орут, — но тогда им в лицо никто и не смотрит. Потом наступает детство: ты только научился добиваться того, чего можно добиться в детстве, стать самым сильным и самым умным — и вдруг понимаешь, что началось отрочество. Опять пробуждение, опять мир не тот, опять ты маленький, тебя все обижают. Только освоился в отрочестве — хлоп, началась юность. Освоился в юности — началась молодость. И вот ты уже освоился в молодости, но замечаешь, что фигура вроде та же, юношеская, а живот потихоньку растёт, волосы приходится причёсывать новыми манерами, и, глядя в зеркало, притворяешься перед собой, что их ещё много и это не скоро случится. И вот ты пробуждаешься к зрелости — про неё вообще мало кто помнит, хотя это самый длинный период в жизни здорового человека: в наш инфантильный век все почему-то думают, что после молодости сразу наступает старость.
А потом — старость, дряхлость. И каждый раз молодость приходит с желаниями, которые невозможно удовлетворить, а зрелость — уже может их удовлетворить, но больше не хочет быть молодой. А вместе со старостью приходит знание: все эти желания — полная ерунда, и клянчить у мироздания нужно было не исполнения желаний, а того, чтобы они тебя покинули. Но это понятно только в старости. Так и вся наша жизнь — сплошная череда пробуждений: только сообразил, что делать, — тут-то и меняется твой возраст. То же самое с духовным ростом великих умов: только пришёл к какому-то выводу, ещё чуть-чуть — и поймёшь этот мир, а с утра просыпаешься, упав с достигнутых высот, и снова карабкаешься по этой духовной синусоиде.
Наверное, как-то так. Много сказал, да? Не надо было так много — надо было коротко. Жизнь — вот. Нет, не так.
Дмитрий Копанцев: Я не знаю тех, у кого жизнь именно такая — «во», — но, наверное, такие люди есть. Вы можете на это осмелиться?
Арсений Дежуров: Да, конечно. Во-первых — если бы вы знали, Дмитрий, с каким наслаждением я бы ныл, скулил, жаловался на жизнь старикам, детям, ровесникам, женщинам, всем подряд! Я бы горестно стонал, из меня хлестали бы слёзы, я бы терял сознание, приходил в себя и снова вопил — если бы это хоть немного помогало. Но раз не помогает, это, по-моему, совершенно напрасная трата времени и сил.
И, конечно, жить надо во. Слава богу, живём уже неплохо. Как говорил Лабрюйер в XVII веке: «Давайте смеяться и шутить не только тогда, когда имеем для этого повод, иначе можно прожить всю жизнь, ни разу не улыбнувшись». Так что жизнь во — и это в некотором смысле моя обязанность, потому что вокруг меня столько печальных юношей, а по возрасту моё главное назначение — их утешать, ободрять, поддерживать, помогать им ориентироваться в этой жизни.
Дмитрий Копанцев: А эта жизнь — она скорее комична или скорее трагична?
Арсений Дежуров: Конечно, трагична — это знают все. Когда я счастлив, я уже немного несчастлив, потому что знаю: это когда-нибудь закончится. Мой друг Глазов в детстве, когда ему дарили новую игрушку, уходил к себе в комнату и плакал — потому что знал, что когда-нибудь её разлюбит. Я понимаю его слёзы, и все их понимают. Если ты счастлив — это точно закончится. А если несчастен — никаких гарантий, что это закончится, нет: можно так и прокряхтеть всю жизнь при нынешней медицине лет восемьдесят-девяносто, будучи несчастным, и с горестными воплями испустить дух. Так что жизнь, конечно, трагична, потому что она конечна, — но трагичность не отменяет способности радоваться.
Каждая индивидуальная жизнь конечна, смерть побеждает жизнь. Но жизнь как процесс побеждает смерть — она не останавливается. Смерть — это просто такие серые всполохи в потоке жизни. И если помнить об этом, если отринуть унылые размышления о том, что вот я умру, и либо ничего не останется, либо что-то останется, но неизвестно что, — тогда становится легче. Все эти мысли о собственной жизни никогда не бывают весёлыми. А вот если думать о других — это совсем другая штука, и я не так давно это понял. У меня есть на этот счёт целая философская модель: с моей физической смертью моё существование как мыслящего «я» закончится, но ведь я знаю, что все остальные останутся жить, — то есть для меня они теоретически бессмертны. В моей жизни их смерти нет. А значит, заботясь о них, я забочусь о жизни вообще, и от меня зависит, как будет жить этот мир. Весь смысл существования человека — жить, радуясь и сознавая трагичность этой жизни, — только в помощи другим людям. И мне, по счастью, моя профессия это позволяет: я, слава богу, учитель, и мне есть кем заняться.
Ну а теперь спросите меня что-нибудь, чтобы сбить этот пафос, — а то мне ещё осталось только сфотографироваться голой грудью на танке.
Дмитрий Копанцев: Вы продолжаетесь в учениках — в тех знаниях, которые в них вкладываете? Чтобы не унести их с собой?
Арсений Дежуров: Именно в этом весь смысл. Гуманитарные знания вообще-то никому не нужны, это роскошь — просто об этом мало кто задумывается. Почему-то за них мало платят, хотя за роскошь нельзя платить мало. Гуманитарные знания нужны людям примерно так же, как бриллианты.
Дмитрий Копанцев: Для красоты.
Арсений Дежуров: Да, для красоты и для акцента собственной значительности, для ощущения богатства. За бриллианты платят дорого, за булки — дёшево, хотя булки нужнее бриллиантов. Так что моя профессия — это бриллианты, и стоить она должна очень дорого. Я вообще бессребреник, поэтому реагирую только на очень большие суммы — или, в крайнем случае, читаю бесплатно.
А с учениками весь смысл именно в передаче знаний. Без учеников гуманитарные знания — это бессмысленная куча хлама. Издалека они выглядят величественно, как пирамида, а подойдёшь — куча мусора: вся эта эрудиция сама по себе ничего не стоит. Самое главное в гуманитарных знаниях — это постоянная передача. Только тогда ты понимаешь себя в цепи мировой культуры, которая тянется от их зарождения и до сегодняшнего дня.
Дмитрий Копанцев: Почему гуманитарные знания — это роскошь?
Арсений Дежуров: Потому что без них можно обойтись — как и без всякой роскоши.
Дмитрий Копанцев: А естественные науки — это то, что можно применить. Ваши книги в этом смысле как чемодан без ручки?
Арсений Дежуров: Ну да. Они не нужны в практическом смысле, они для развития каких-то непонятных вещей вроде ума и души, которые пощупать никто не может. Умом своим все довольны, о душе большинство не думает вовсе. Так что тут тоже вопрос — насколько гуманитарные знания вообще помогают. И всё же заниматься этими неточными науками невероятно интересно, потому что ты решаешь задачу жизни, не имея ни данных, ни метода — только энтузиазм и огромный массив литературы и искусства, которые никогда не увидишь и не прочитаешь целиком. Оттуда ты возьмёшь лишь малую толику.
Дмитрий Копанцев: А решение у этой задачи есть?
Арсений Дежуров: Скажу странную вещь: гуманитарные знания готовят к жизни гораздо лучше, чем точные и технические науки. Понимаете, мои студенты-физтехи, которых я боготворю и которым служу педагогом — то есть, в изначальном смысле слова, рабом, провожающим ребёнка в школу, — всю жизнь, едва обнаружив в себе первые признаки одарённости, обучаются мыслить логически: сперва в школе, потом в институте. И заодно я помогаю им справляться с третьей из их профессиональных болезней: первая — гастрит, вторая — меланхолия, а третья — как раз логическое мышление. Потому что судьба безжалостно выпихивает их пинком в жизнь, а в жизни логические решения не работают, решения приходится принимать интуитивно. И вот ты, блестяще умея мыслить логически, обнаруживаешь себя в ситуации, где логики нет вовсе, а задачу решать нужно — причём в задаче постоянно меняется исходное условие. Как обычно и бывает в жизни: мы ставим цель, разрабатываем путь к ней и в итоге приходим совсем не туда, куда планировали, — просто потому, что сделали все нужные шаги, чтобы там оказаться.
Можно обойтись и без гуманитарных знаний. Вопрос — зачем, если от них можно получать наслаждение. Люди вынюхивают дорогие подсудные порошки, пьют дешёвые или дорогие напитки, враждебные природе, — лишь бы получить крупицу наслаждения, расплачиваясь за это здоровьем. А если наслаждение приходит от похода в картинную галерею — это же огромная экономия, и никакого вреда для здоровья.
Дмитрий Копанцев: Почему же тогда, при всех этих прелестях гуманитарного знания, мы перестаём читать — добровольно отказываемся от этого удовольствия?
Арсений Дежуров: Видимо, появились другие удовольствия. Литература к этому не готова: она привычно сидела на корме и болтала, а потом — бултых в воду, и всё, на корабль не успела. А корабль истории поплыл дальше. Расставаться с литературой всем страшно по понятной причине — она была главной среди искусств: за неё отвечают целых четыре музы, тогда как на живопись или архитектуру музы, можно сказать, и внимания не обращали. Это муза трагедии Мельпомена, муза комедии Талия, муза эпического повествования Каллиопа и муза лирики Эрато, которая заодно отвечает и за музыку.
Литература — самое простое по своим средствам искусство, ведь она открыта всем, и в то же время — высшее: она удерживала главные позиции в мире со времён Библии и Гомера. И вдруг — уронила свой скипетр и державу. Ещё не так давно образованность человека измерялась начитанностью — не тем, сколько он слушал музыки, смотрел картин, фильмов или спектаклей, а тем, что он читал и сколько. Сейчас мальчика хвалят просто за то, что он читает, — неважно, что именно: пусть про вампиров или оборотней, лишь бы мог пересказать.
Дмитрий Копанцев: То есть хвалят просто за сам факт.
Арсений Дежуров: Да, просто за то, что у него в руках книга, — она стала символом мудрости, как на станции метро «Площадь Революции»: раскрытая книга там — единственный нетронутый предмет скульптуры. Циркуль погнули, собаку затёрли до блеска, петуха уже тоже насквозь протёрли — а к книге никто не притронулся, она так и стоит, прекрасно раскрытая, вместилище знаний, к которому никто не подходит.
Дмитрий Копанцев: Никто о неё не трётся.
Арсений Дежуров: Нет-нет, никаких прикосновений. А вот всех четырёх бронзовых собак на «Площади Революции» — потереть можно и нужно.
Дмитрий Копанцев: Вы про станцию метро — на всякий случай, для тех, кто не в курсе.
Арсений Дежуров: Да, именно про неё: на станции «Площадь Революции» в Москве рядом со скульптурой пограничника стоят четыре бронзовые собаки — у них даже есть свои прообразы. И в нашем стихийно религиозном народном сознании живёт мысль: если уж бог не поможет, можно съездить на «Площадь Революции», потереть собаке нос — и тогда всё сбудется наверняка. Даже моя сестра, вполне просвещённая европейка и атеистка, когда у неё потерялся кот, поехала и потёрла собаке нос — и кот нашёлся, просто прятался где-то неподалёку.
Дмитрий Копанцев: Последнее прибежище, да.
Арсений Дежуров: Вот такое у нас тут своё языческое капище.
Дмитрий Копанцев: Так отчего же книгу-то никто не трёт?
Арсений Дежуров: Она как-то перестала быть своей. Раньше мы были второй после Германии читающей и подписывающейся на книги страной — и этим очень гордились. А потом выяснилось: дай нам какой-нибудь тетрис или шарики подавить — даже не в телефоне ещё — и литературу тут же бросили. Моя соседка, тётя Маша, продавщица в овощном магазине, брала у моей бабушки Эмиля Золя том за томом — и читала для удовольствия. Не знаю, насколько это её развивало духовно, но удовольствие было настоящим, потому что другого источника и не было. А вообще, когда взрослые говорят, что читать книги — сплошное удовольствие, они врут. Это труд, удовольствие приходит потом. Это как в качалку ходить: сперва поднимаешь маленькие тяжести, потом средние, потом снова маленькие, потом с тренером, потом протеиновый коктейль, потом витамин B12 — и так далее. С литературой то же самое.
Дмитрий Копанцев: Долгий труд.
Арсений Дежуров: Конечно. Чтобы получать удовольствие от литературы, нужно читать, а это долго. Есть литература для удовольствия — это просто процесс: прочитал занятную книжку, поставил на полку, и она тебя никак не изменила. А есть «Братья Карамазовы»: дочитал их с кряхтением, отчаянием, тоской и сплином — и перешёл на другую ступень сознания. Но для этого нужно работать. Это труд — как учить языки, как качать тело, как осваивать восточные единоборства. Такого не бывает за сорок уроков или за ролик на YouTube. Это всегда труд, а трудиться никому не хочется — все хотят побыстрее.
Дмитрий Копанцев: Получается, чтение — это одновременно пахота и удовольствие. В какой момент оно появляется — и от чего?
Арсений Дежуров: Мне просто не хочется врать, что это не труд, — а ещё хочется всех немного напугать. Когда говоришь, что никто ничего не читает, люди начинают возмущаться, со злости берут самую толстую книжку, зачитываются до рассвета — и вдруг выясняют, что это, например, «Дон Кихот». Так что, может, в этом тоже есть польза: не стоит забывать, что я учитель, а один из методов учителя — это провокация.
А удовольствие — оно как когда выходишь из качалки. Оно приходит, когда тебе открывается тайна этого мира, когда ты не умел решать задачи, а научился. С литературой то же самое: прочитал Достоевского — и стал думать иначе, увидел мир по-другому, заметил то, чего раньше не замечал. Как будто у тебя появилось новое чувство — будто ты начал видеть ультрафиолет или улавливать, как муравей, мельчайшие оттенки запахов.
То же самое с музеем. Обычный человек скажет: в музей нужно ходить, чтобы быть развитым. Но ходить в музей стоит не затем, чтобы читать подписи под картинами, а чтобы эстетизировать собственное зрение. Ты сходил в музей — а потом идёшь по улице, смотришь во двор и думаешь: «А ведь это как у Питера де Хоха» — или замечаешь свет на кухонном полотенце и вспоминаешь занавеску тер Борха. То, чего ты раньше не видел, ты начинаешь видеть благодаря тому, что тебе в золочёной раме показали потускневшую нидерландскую живопись.
Дмитрий Копанцев: А зачем вообще нужна эта история — вот человек смотрит из окна пятого этажа и говорит: «Брейгелевская перспектива». Что ему это даёт?
Арсений Дежуров: Чтобы веселее жить наедине с самим собой. Мне не скучно с самим собой — бывает тоскливо, но, как говорит наш народ, тоска не скука. Мне есть о чём подумать: как все любители поэзии, моя посуду, я повторяю про себя стихи Заболоцкого. Все просто моют посуду, а я при этом читаю Заболоцкого — нехорошо, конечно, что я знаю так мало стихов наизусть, но для мытья посуды или полов мне хватает. Это помогает не скучать. Большинство людей мучительно страдают от скуки и одиночества, а одиночество — нормальное состояние человека, вот со скукой действительно можно и нужно бороться.
Дмитрий Копанцев: А как это нежелание читать сказалось на поколении зумеров?
Арсений Дежуров: Бедняги, мне их очень жаль, сердце за них болит. Они очень не похожи на предыдущие поколения — это, наверное, нормально для любого нового поколения, но от этого они не становятся веселее. Может быть, это самое печальное поколение на моей памяти. Они сидят дома, склонны к полноте, потому что мало двигаются, их не интересуют путешествия — а ведь именно это когда-то так манило людей: дальние странствия, острова. За них по-настоящему тревожно. Но заниматься ими нужно, и ещё не поздно — хотя надо было раньше.
Это просчёт старшего поколения. Родители сами не читают книжки — а требуют этого от детей. Не им ли самим мешает бревно в глазу? Всем хочется, чтобы дети читали, но сами родители в девяностые зарабатывали деньги, и им было не до книжек. Ответственность за каждое поколение всегда лежит на родителях — это наша вина. Так же как когда говорят: началась революция, снесли церкви — кто их сносил? Люди, которых воспитал девятнадцатый век. Все почему-то думают, что это какие-то «новые люди» — нет, не новые. И нынешних детей воспитали не какие-то новые люди: их, чтобы отделаться, сажали перед мультиками. Так все и делали — это был лучший способ от них отделаться. А теперь удивляются, почему они не хотят работать: их не готовили ни к чему, кроме этого, а потом требуют с них огромные деньги за обучение, которые они не отобьют зарплатой на первой же работе. Раньше институты платили студентам стипендию, чтобы потом они получали зарплату больше стипендии, а теперь всё наоборот: студенты платят сами, приходят на работу наивными — и слышат в ответ «вот вам шиш», в лучшем случае намекая на прибавку где-то в конверте. Проще ничего не делать, чем предаваться такому непонятному и унизительному труду. Мир утратил для них самоочевидность. Хотя умных людей среди зумеров ровно столько же, сколько в любом другом поколении, — просто очень горько, когда яркий ум остаётся неразвитым из-за отсутствия должного образования. С ними нужно возиться, но я один, а учеников у меня не может быть много: где-то между Буддой и Христом — но всё равно очень мало.
Дмитрий Копанцев: А что будет с великой русской литературой, если её не читают?
Арсений Дежуров: Её просто не будет. Она не существует, если её не читать, — так же как не существует бог, если в него не верить. Лев Толстой не великий писатель, если о нём не знать. Всё это исчезнет — а страшен ли для нас сегодня какой-нибудь свирепый фараон вроде Хеопса? Да нет.
Дмитрий Копанцев: И мы, получается, последнее поколение, для которого библиотека — ещё не совсем пережиток прошлого?
Арсений Дежуров: Во-первых, не стоит преувеличивать, насколько читающей нацией мы были прежде, — читали, безусловно, больше, но это не только наша особенность, во всём мире тоже стали читать меньше. У нас ситуация даже получше — но меня это не утешает: когда я говорю «господи, до чего дожили», а мне отвечают «а во всём мире ещё хуже», выходит, всем нам просто хана. Библиотеки — не самое важное. Запах книги, ощущение бумаги — что ж, было так, будет иначе. Зато теперь любую книгу можно найти в интернете. Хотя раньше, когда книги нельзя было найти, люди из штанов выпрыгивали, чтобы добраться до спецхрана Ленинки, узнать, что книга там, добыть её, прочитать и запомнить — большей частью неправильно. А сейчас пожалуйста: хочешь Британский музей — вот он, открыт. Хочешь то, что всем запрещено, — найдёшь и это, там всё есть. Но интерес к этой информации исчезает.
Дмитрий Копанцев: В «Современнике» идёт потрясающий спектакль с Мариной Неёловой — «Собрание сочинений». Про пожилую даму, которая вырастила детей, похоронила мужа и переезжает в маленькую квартиру. У неё огромная библиотека, которую они с мужем собирали много лет. Приезжают дети — кто из Америки, кто из Европы, — и она говорит: «Заберите книги, мне они больше не нужны, я всё прочитала, мы ведь и для вас их собирали». И выясняется, что книги не нужны никому из детей. Она продаёт дом и уезжает, оставляя всю библиотеку. Зал плачет — но по сути с этим ничего нельзя сделать.
Арсений Дежуров: Конфликт немного надуманный, но сходить обязательно стоит — ради Неёловой, она всегда прекрасна в любой роли. Я в «Современник» хожу легко, мне туда попасть просто.
Дмитрий Копанцев: Как чтение отражается на умении красиво и умно говорить?
Арсений Дежуров: Умный и красноречивый — вещи разные: бывали величайшие умы, косноязычные до крайности, а пустая бочка, как известно, гремит громче полной, и болтунов-краснобаев вокруг хватает. Но влияние литературного языка на речь огромно — просто этим тоже нужно заниматься. Если человек слышит язык, чувствует его — а это такое же чувство, как музыкальный слух, оно может быть или не быть, но его можно развивать. Расскажу про свой опыт: я в некотором смысле учу русский как иностранный. Читаю, скажем, Толстого — и вижу необычное сочетание слов, архаичный падеж, странный предлог — и выписываю их.
Дмитрий Копанцев: Выписываете.
Арсений Дежуров: Выписываю и заучиваю. Некоторые целые фразы из Толстого, Достоевского, Чехова я запоминаю вместе с их фразеологией — то есть с тем, как именно соединяются слова, а не саму по себе лексику. Обычно думают, что главное в языке — это лексика, новые заимствованные или устаревшие слова. На самом деле это ерунда, самая мобильная и незначительная часть языка — он постоянно что-то подхватывает и что-то забывает. Главное — фразеология, устойчивые сочетания слов. Тот, кто хорошо знает иностранный язык, — не тот, кто знает много слов, а тот, кто знает их в устойчивых сочетаниях. Тогда ты начинаешь не просто складывать слова, как в неорганической химии, а соединять их так, что получается что-то по-настоящему полезное — как из радикалов получается нефть.
Дмитрий Копанцев: Какое ваше любимое выражение?
Арсений Дежуров: Например, как графиня Ростова отказывает кому-то от дома. Она простая русская женщина без затей, с живым языком, но когда доходит до официального отказа, говорит: «Боюсь, я буду принуждена отказать себе в удовольствии пользоваться честью вашего знакомства». Из одной этой фразы понятно, какое у неё образование, какие у неё были учителя-французы, — но она предпочитает жить простой жизнью, а если доходит до светских условностей, у неё находится что сказать. Такую фразу самому не придумать — её можно только присвоить у Толстого.
Дмитрий Копанцев: И присвоить?
Арсений Дежуров: Да, именно присвоить — великие писатели затем и нужны, чтобы мы у них всё это заимствовали. Если писателю никто не подражает, если его никто не цитирует, если никто не выдаёт его мысли за свои — значит, это плохой писатель. Хороший писатель говорит именно теми словами, которые ты и сам был готов произнести, только слов у тебя ещё не было — а он их нашёл.
Дмитрий Копанцев: Вы уже немного касались этого в начале — как приучить себя к чтению, если привычка не сложилась в детстве? Кому-то чтение даётся легко, а кто-то буквально заставляет себя, преодолевая усилие.
Арсений Дежуров: Начну издалека. Один иеромонах подарил мне схему греховных страстей и средств борьбы с ними — отличная диаграмма: змей кусает свой хвост, в одних пузырях грехи, в других — средства борьбы. Обуяло тебя чревоугодие — идёшь по схеме и видишь: пост. Многоспание — бдение. Блуд — воздержание. Не читаешь книжек? Читай. Лень заниматься физкультурой? Бегай. Вот и весь ответ: просто возьми и делай, только так и получится. Иначе ничего не выйдет. Если лежать под дождиком и мечтать о собственном домике — домика от этого не появится, это просто мечта, а для мечты делать ничего не нужно. Нужно делать, если у тебя есть цель. Так что и читать книжки не страшно и не больно — этим просто нужно заниматься. Единственный способ побороть греховную страсть — делать. Делать.
Дмитрий Копанцев: То есть не размышлять, как тяжело и как хочется, а сесть и начать делать?
Арсений Дежуров: Именно, начать читать. Сначала не будет получаться, как и во всяком новом деле: будешь перечитывать одну и ту же страницу по многу раз и ничего не понимать. А потом начнёт получаться — хотя гарантий никаких нет, может, и не получится.
Дмитрий Копанцев: А чем писатель отличается от читателя — в фундаментальном смысле? Только не говорите просто «один пишет, другой читает».
Арсений Дежуров: Об этом я, честно говоря, никогда раньше не задумывался — и очень не люблю, когда человек навешивает на себя какое-то громкое звание.
Дмитрий Копанцев: У вас в лексиконе тоже есть такие словечки?
Арсений Дежуров: О, вы даже не представляете, с каким увлечением я коллекционирую всевозможную ругань и просторечие русского языка. Иван Александрович Бодуэн де Куртене — великий русский лингвист польского происхождения с французской фамилией, родом из Казани — включал в свои словари обсценную лексику, потому что считал: этика не должна преграждать путь науке. Ему принадлежат слова, которые золотыми буквами вписаны в душу каждого россиянина: «Жопа есть, а слова нет» — это сказал именно академик Бодуэн де Куртене, а не какие-нибудь современные блогеры. И ещё: не бывает слов пристойных и непристойных, бывают слова подходящие и неподходящие — есть фразы, которые без определённого слова просто не состоятся. Когда наполеоновскому генералу под Ватерлоо предлагают сдаться, он отвечает знаменитым «Merde ! La Garde meurt, mais ne se rend pas» — «Дерьмо! Гвардия умирает, но не сдаётся». Просто «гвардия умирает, но не сдаётся» — не то, нужно именно это слово впереди. Так же и когда Кутузов якобы говорил, что если враг снова придёт на Русь, то встретят его по-простому, — без этих слов ничего не выйдет: у Толстого они обозначены точками, но сами слова там есть.
Дмитрий Копанцев: Так в чём же тогда талант и дар писателя?
Арсений Дежуров: Если бы вы знали, какой это трудный вопрос — вы, наверное, думали, что на него можно ответить залихватски. А вы меня действительно озадачили, я сейчас впервые всерьёз об этом задумался. Боюсь, ответ выйдет сырым и недоделанным.
Писатель — всегда говорящий, читатель — всегда слушающий, никакого настоящего диалога между ними нет, что бы ни говорили о книге как о диалоге. Это редкость даже в жизни: даже маму по утрам, пересказывающую свои сны за кофе, ты не будешь слушать так, как слушаешь Толстого, — просто не можешь оторваться от книги. Здесь на самом деле происходит разговор — как между учителем и учеником, вроде диалогов Сократа у Платона, где на самом деле «бу-бу-бу-бу» с одной стороны и «бу-бу-бу-бу» с другой, а это зовётся диалогом. Читаешь Толстого и думаешь: точно, я тоже так думал, только слов не было — а он их нашёл. Это писатель Томас Манн говорил, что читатель запоминает из книги только то, к чему у него уже была предпосылка: мы читаем книгу, а помним из неё всего ничего — именно те слова, ту мысль, для которой мы уже были готовы. И тогда эта мысль становится уже не мыслью писателя, а моей собственной.
Но ваш вопрос — тема отдельного разговора, мне нужно подумать над ним ещё как минимум неделю. То, что я сейчас сказал, — правда, но не вся правда.
Дмитрий Копанцев: То есть дар писателя в том, что о чём-то думают или подступаются к этой мысли миллионы, но сформулировать её так, чтобы поняли все, может не каждый, — а писатель находит одну ёмкую фразу, и все узнают в ней своё: «Вот это — я об этом думал, это моё».
Арсений Дежуров: Да, так и есть. Только вы, Дмитрий, слишком простодушно полагаете, что дар — непременный спутник писательского мастерства. Хотелось бы, конечно, чтобы это было так, но бывают писатели, прекрасно владеющие мастерством без большого таланта. Илья Ильф, кажется, сравнивал прозу с игрой на фортепиано, а поэзию — со скрипкой: на скрипке можно играть только талантливо, а на фортепиано — просто очень хорошо, чисто ремесленно. И блаженный Иероним — блестящий филолог четвёртого века, переводчик Библии на латынь, — сказал: «Нет такого дрянного писателя, который не нашёл бы читателя себе под стать». То есть не только гениальные писатели говорят гениальное — люди, готовые счесть себя понятыми, восторгаются и весьма посредственной литературой, которая фабрикуется в огромных количествах и находит куда больший спрос, чем талантливая: продать талантливую работу трудно, а какую-нибудь чепуху — запросто. Я убеждён: если бы великий скульптор Роден торговал не вратами ада, а кошками-копилками, он стал бы куда более состоятельным человеком.
Но такие писатели тоже нужны — и таким читателям они нужны. У Сэлинджера в рассказе про семью Гласс Фрэнни спрашивает брата Зуи: «А для кого мы вообще работаем — кто нас смотрит? Толстая тётя?» А Зуи отвечает: «Ну да, мы работаем для толстой тёти» — чтобы она пришла домой уставшая и могла отвлечься от своих мыслей, чтобы ей стало легче. Об этом, конечно, они говорят подробнее и на английском — я помню это по переводу Райт-Ковалёвой, так что могу и ошибаться в деталях, но смысл был именно такой. Должны быть писатели, которые работают именно для неё — чтобы облегчить ей жизнь, а не усложнять её ещё и Достоевским. Один немецкий писатель так и говорил: «Зачем мне читать Достоевского? Мне и без него жить страшно». Той тёте, которая приходит домой с тяжёлыми сумками, среди детей, мужа, родственников и вечных забот, нужно на время переселиться в другой мир — мир иллюзий, с прекрасными мужчинами и женщинами, пиратами и кучерами, — и пусть это будет, если это помогает людям жить.
Дмитрий Копанцев: А почему русская литература в своей основе трагична? Если брать Достоевского, Толстого, Чехова, любого крупного писателя — там всегда история о нелёгкой человеческой судьбе. Почему так?
Арсений Дежуров: Потому что русская литература правдива — как, впрочем, и любая по-настоящему великая литература. Хотя, скажем, английская литература не во всех случаях такая: у Диккенса в конце обычно всё заканчивается хорошо, свадьбой, а все злодеи либо получают по заслугам, либо исправляются.
Дмитрий Копанцев: А если говорить именно про русскую литературу?
Арсений Дежуров: Самый непонятный и загадочный для Европы персонаж среди великих русских писателей — это Пушкин, потому что он такой лёгкий и весёлый. Где же мучительные страдания? Вот если бы Татьяна повесилась в амбаре без объяснений — тогда было бы понятно: перед нами Русь. А тут страдание есть, но никто, по сути, не повесился — пристрелили одного Ленского, и то как-то не особенно страшно. Не тот русский размах: если уж кого-то умерщвлять, то как в «Бесах» у Достоевского — в последней главе, где гибнут все и в страшных мучениях. Так что Пушкин странный — какой-то не совсем «русский», хотя, конечно, гений мировой литературы, которого чтят в Европе наравне с Гоголем, Толстым, Достоевским, Чеховым, Гончаровым, Лесковым.
Дмитрий Копанцев: К слову о масштабах: сейчас русская литература то и дело оказывается на передовой идеологической войны с «загнивающим Западом» — дескать, у нас великая русская литература. А как она соотносится с сегодняшней патриотической повесткой?
Арсений Дежуров: Очень плохо. Скажу как патриот русской культуры: она гораздо шире, чем принято думать, — как говорил Набоков, Россия занимает у него одну шестую часть души. Я вообще не отделяю гуманистическую русскую культуру и литературу от мировой.
Россию по-настоящему открыли для себя в Европе после наполеоновских войн, когда европейцы увидели наше дворянство — красавцев, говорящих на безупречном французском, порой лучше самих французов, потому что учили язык по классике, с прекрасными манерами, танцем, воспитанием — и при этом с загадочной душой. Всем это очень понравилось. А следующий шаг — мода на всё русское — привёл к тому, что стали читать русскую литературу, и были этим огорошены. Русская литература никогда не гладит свой народ по головке, никогда не говорит: «Какой у нас всё-таки славный народец!» Никогда. Это всегда «любовь до боли сердечной», это всегда указание на социальные и нравственные язвы общества, а не похвала. У Толстого, конечно, есть моменты, когда, читая «Войну и мир», ты искренне ощущаешь себя патриотом. Но когда Гоголь после жёсткой пародии, после этого кошмара уродов в «Мёртвых душах» — которых Европа поначалу вообще не приняла, недоумевая, разве можно так писать о родине, — вдруг оказывается одним из самых читаемых русских писателей, а книга заканчивается образом птицы-тройки, летящей вдаль... Как это вяжется с патриотической идеей? А «Ревизор» — вообще беспросветная, хотя и очень смешная книга.
Дмитрий Копанцев: Очень смешная и беспросветная.
Арсений Дежуров: Ну на то она и сатира — все читают, хохочут, её ставят в театрах, а ситуация от этого никак не меняется. Русская литература никогда не занимается тем, чтобы ласкать и тешить русский народ. Так что патриотам хорошо гордиться этой литературой, если они её не читали, — скорее всего, так и есть. Речь именно об «ура-патриотах», у которых патриотизм только на устах, а не об истинных патриотах. Чтобы быть настоящим патриотом, нужно слушать, о чём тебе говорит русская литература, — а она оставляет читателя печальным и неудовлетворённым, побуждает что-то менять в этом мире, а не примиряться с ним со словами «бог терпел и нам велел».
Дмитрий Копанцев: То есть можно сказать, что многое из того, что мы сегодня считаем великой русской литературой, в наши дни могло бы просто не вписаться в сегодняшнюю повестку?
Арсений Дежуров: Да нет, опубликовать можно всё. Согласно двадцать девятой статье Конституции, пункт пятый: «Цензура запрещается».
Дмитрий Копанцев: А в каких проявлениях сегодня выражается проблема маленького человека?
Арсений Дежуров: В том, что все стали маленькими людьми. И я маленький человек, и вы маленький человек.
Дмитрий Копанцев: А раньше было иначе?
Арсений Дежуров: Раньше было другое самосознание. Были попытки самоуправления, было дворянство со своим самосознанием — декабристы, по классификации Ленина, точно не были маленькими людьми. Был разночинский период, когда люди самого низкого происхождения, но получившие образование и желающие изменить мир, тоже не были маленькими людьми. Был пролетарский период, когда цвет пролетариата, рабочая аристократия, восстал против власти, — и это тоже были не маленькие люди. А сейчас всё как-то незаметно изменилось — по крайней мере для меня, потому что я жил не среди маленьких людей. Ошибочно думать, что люди Советского Союза ощущали себя маленькими: в них было достоинство, была убеждённость — не обязательно оправданная, но органичная для большинства советских людей, среди которых я рос.
Сейчас определяющей становится только состоятельность: те, кто богаче, могут смотреть с известным презрением на тех, кто беднее, и с известным подобострастием — на тех, кто выше. Изменилось и само понятие «элита». В Советском Союзе элитой была, скорее, интеллигенция — люди высокого образования, потому что богатых людей в нынешнем понимании тогда просто не было: дача, машина — не о чем и говорить. А сейчас элитой называют очень богатых людей — настолько богатых, что для простого человека это уже неразличимая абстрактная величина, как для свахи из «Банкрота» Островского, которая говорит: «По мне всё, что больше ста рублей, — уже миллион». Разницы между миллионом и миллиардом для обычного человека нет никакой — это просто «тьма-тьмущая», деньги, которых он никогда в руках не держал и не будет держать.
Кто-то сказал, что главная ценность демократии — деньги, и, кажется, так и вышло: из всех её ценностей уцелела именно эта. Я их не люблю, мне неприятно, что сейчас всё меряется деньгами, — это меня раздражает.
Дмитрий Копанцев: Да, у русского человека вообще специфическое отношение к деньгам — как будто в них есть что-то от лукавого.
Арсений Дежуров: В русском народе неистребима мысль о неправедности денег — об этом писала ещё Марина Цветаева. Помню, отдыхая в Крыму, я покупал у местных бабушек вёдра абрикосов — и они меня очень любили, не только за то, что я поддерживал их бизнес. Они говорили: «Дай бог тебе здоровья, чтобы ни в чём ты не нуждался — но и богатым чтобы не был». Быть богатым — нехорошо, вот народное отношение. Есть американская пословица: если ты такой умный, почему такой бедный? А русский народ сказал бы наоборот: если ты такой хороший, почему такой богатый? Симпатии народа не распространяются на зарплату выше определённой планки — такого человека народ просто не принимает. Народу гораздо ближе всякие мелочи вроде чайного гриба на подоконнике, домашнего творога, штопки и перелицовки старых вещей. А на богатство исторически смотрят косо. Русского человека нужно ещё уговаривать заработать большие деньги — а если он их всё-таки заработал, будучи, скажем, купцом-старообрядцем и меценатом, то потом вдруг спивается с горя, забивает тоску вином и пропадает где-то с цыганским хором. Удара не держат: выбор между жизнью и деньгами на моей памяти в сторону денег никогда не склонялся. Не говорю, хорошо это или плохо, — просто это черта русского народа. Может, если бы мы больше интересовались деньгами, у нас бы их и было больше.
Дмитрий Копанцев: И отсюда, наверное, выражение «деньги любят тишину» — хотя забывают добавить, что это в первую очередь про ворованные деньги: в Европе как раз богатые люди публичны и охотно рассказывают о своём пути к успеху, а у нас — наоборот.
Арсений Дежуров: Если бы в Европе рассказывали действительно искренне, это выглядело бы, как у Рокфеллера, который говорил, что готов дать отчёт обо всех своих миллионах, кроме первого. Или как у Бальзака: в основе всякого большого состояния лежит преступление — причём сам богатый человек может об этом даже не знать: дедушка стар и в деменции, родители поджимают губы, когда об этом заходит речь, а внук родился уже богатым, может быть вполне добродетельным, щедрым и любящим родину, потому что деньги достались ему просто по праву рождения. Но в основе больших состояний преступление лежит почти обязательно — так, во всяком случае, считал Бальзак, а поскольку среди моих знакомых больших состояний нет, мне остаётся полагаться на его мнение.
Дмитрий Копанцев: А чем маленький человек отличается от лишнего — в контексте сегодняшнего дня? Это ведь разные типажи русской литературы?
Арсений Дежуров: Совершенно разные. Лишний человек — это тот, кто способен, но никому не нужен: Печорин, Онегин и подобные — таланты есть, всё есть, а применения нет. Это своего рода титаны духа не у дел.
Дмитрий Копанцев: Пассионарии.
Арсений Дежуров: Ну, скажем, пассионарии, пусть будет так — байронические Чайльд-Гарольды, Каины, Манфреды.
Дмитрий Копанцев: Если бы нужно было объяснить одним предложением, кто такой русский человек, — что бы вы сказали?
Арсений Дежуров: Русскому человеку, как и любому человеку современности, присуще одиночество — но при этом какая-то древняя привязанность к земле и к народу. И ещё общерусское заблуждение, на которое ещё в восемнадцатом веке указывал Денис Фонвизин: мысль, что «у них там есть, а у нас непременно нет» — и наоборот, «у них нет, а у нас непременно есть». И то и другое неправда, и это предубеждение, по словам Фонвизина, никак не вытравить из русского человека. На самом деле и там не так уж бедно душою, и здесь не всегда так уж богато — если читать русскую литературу, которая как раз только этим и занимается, до боли сердечной ищет и находит в русской душе самые разные оттенки: она ведь не только Алёша Карамазов, но и Смердяков тоже. И когда мужик бьёт лошадь кнутом по глазам — это тоже русский мужик. А когда в Турине Фридрих Ницше видит, как кучер забивает лошадь кнутом, он бросается обнимать эту лошадь, чтобы уберечь её от ударов, а потом сходит с ума от пережитого, — это немецкий писатель, во многом аналог нашего Достоевского, как Гёте — аналог Толстого. И эта же мысль есть в моей любимой Пушкинской речи Достоевского: русский человек — самый настоящий европеец. Ведь Европа вовсе не однородна, это мозаика не таких уж и маленьких стран, если развернуть глобус правильно, — все говорят на разных, хоть иногда и похожих, языках, у всех своя литература и искусство, где густо, а где пусто. Когда мы противопоставляем себя «им», как сказал бы академик Пешковский, мы с горечью думаем: у них уже была своя музыка, а у нас в семнадцатом веке ещё Древняя Русь. Но какая, собственно, музыка у немцев, итальянцев, французов, венгров, англичан? Если долго чесать лоб, вспомнишь разве что Генри Пёрселла — барочного композитора. А весь первый эшелон композиторов — сплошь немцы, и даже единственный «английский» — Гендель — на самом деле немец, проживший жизнь в Англии. То же самое с живописью: великий Гольбейн — тоже немец, живший в Англии. Зато литература у англичан не знала упадка. А испанская литература — то взлёт, то падение. И так с любой культурой: они все не однородны и противопоставлены друг другу даже внутри себя — разница между русским и немцем, по-моему, куда меньше, чем между жителем Пруссии и Баварии.
Дмитрий Копанцев: Но о чём это говорит — что нужно сменить фокус внимания, не искать различий?
Арсений Дежуров: Скорее, фокус взгляда должен быть направлен не на свой двор и не на своё село. Представьте: человек поднимается над землёй, отрывается от неё и взлетает — сперва видит свой двор, плетень, горшки на нём, пасущуюся козу. Это хорошо, но он поднимается ещё выше и видит своё село — избы, пасущихся коров, девушек, поющих за околицей. Ещё выше — свою область, свою страну. А если подняться совсем высоко и увидеть всю землю, понимая, что она наполнена людьми, но уже не различая, какие именно это люди, — просто зная, что у каждого внутри неповторимый мир, — тогда границы становятся несущественными. Но это уже скорее божественный взгляд, в котором нет никаких приоритетов.
Дмитрий Копанцев: Арсений, мы поднялись на такую высоту — впору спросить о фразе Достоевского «красота спасёт мир». Глядя на сегодняшний, воюющий и безумный мир, повторили бы вы её или сказали бы что-то другое?
Арсений Дежуров: Нет, красота никого не спасёт. Эту мысль в романе «Идиот» произносит вовсе не сам Достоевский, а умирающий Ипполит, который цитирует слова, приписываемые князю Мышкину: «красотою спасётся мир». В нынешнем виде — «красота спасёт мир» — это уже мысль всего двадцатого века, приписанная Достоевскому задним числом, и я тоже в неё верю в том смысле, что она не спасёт, но способна сделать жизнь легче. Есть такая реклама хосписов: если человека нельзя вылечить, это не значит, что ему нельзя помочь. Вылечить этот мир красота не может, а вот помочь людям — вполне.
Дмитрий Копанцев: То есть эта фраза вложена в уста «идиота» — наивного, простодушного персонажа в глазах общества.
Арсений Дежуров: Именно, наивного и странного, но безусловно доброго — русского варианта Дон Кихота. Но произносит её человек безнадёжно больной, непонятно почему всё ещё живущий, обречённый на смерть и не способный умереть, — именно Ипполит. Так что, пожалуй, примерно в такой ситуации мы и находимся сейчас: и пациенту, и врачу понятно, что с обществом что-то не так, — мы уже коснулись этого, говоря об образовании и чтении, — но искусство способно облегчить эти страдания. Оно это и делает.
Дмитрий Копанцев: Русская литература всегда была разговором с совестью. Вам не кажется, что сегодня мы намеренно избегаем этого разговора — о совести?
Арсений Дежуров: Этого никто не может знать, потому что совесть — качество сугубо индивидуальное, у каждого своя, и как проходят эти внутренние разговоры, никому не известно. Стыд — качество общественное: «как я буду смотреть людям в глаза», а вот что делать наедине с собой — каждый решает сам. Тут я не властен, у меня нет божественного взгляда, чтобы провидеть каждого человека.
Дмитрий Копанцев: Но есть ли здесь связь с отказом от чтения?
Арсений Дежуров: Можно не читать русскую литературу и при этом быть высокодуховным человеком — как Будда Шакьямуни, который променял карьеру царевича на куда более скромную карьеру великого святого. Это необязательное условие, чтобы быть добрым и умным человеком, но очень хорошее подспорье, оно помогает. Если придётся прожить без литературы, это не значит, что из мира исчезнут доброта и красота, — но мир, конечно, станет другим, каким именно — предсказать невозможно, потому что прецедента такого не было: весь известный нам мир — это мир, в котором уже была литература, и о прошлом мы знаем в основном то, что о нём записано, не считая отдельных археологических открытий.
Дмитрий Копанцев: Русская литература часто показывает человека, мучительно ищущего смысл. А нужен ли этот смысл людям сегодня — и ищут ли они его вообще?
Арсений Дежуров: Если бы я был не епископом, а обычным приходским священником, я мог бы вам ответить — но не все приходят ко мне на исповедь рассказать, как они ищут смысл жизни, так что ответить не могу. А вот свой смысл я нашёл, мне в этом плане легко и хорошо, моя жизнь вполне удалась. Он — в служении моим ученикам: всё моё назначение — заботиться о людях вокруг меня. Я окружил себя частоколом лучших людей, и моя задача — заботиться о них, не уходя слишком далеко, потому что к прекрасным людям быстро привыкаешь, они начинают казаться обычными, а все остальные — примерно такими же. Так что моё главное назначение — заботиться о тех, кто меня переживёт, и в первую очередь о молодёжи. Обо всей молодёжи я заботиться не могу, я всего лишь учитель, но есть три вещи, которые я умею делать: я могу их любить, кормить и смешить. Больше ничего не обещаю — но за это отвечаю.
Дмитрий Копанцев: Какие три книги вы бы посоветовали прочитать нашим зрителям именно сейчас — и почему?
Арсений Дежуров: Первый ответ у меня готов сразу — «Война и мир». Почему? Потому что в самые тяжёлые душевные сомнения я отправляюсь именно к этим персонажам. Раньше я перечитывал эту книгу почти ритуально, как евреи перечитывают Тору: дочитывал до приезда Пети в лагерь Долохова, а дальше не читал, потому что знаю, что будет: как убьют Петю, как будет мучительно умирать князь Андрей, — мне не нужно это перечитывать, я и так всё помню. И начинал заново, с разговоров в салоне Шерер. Никогда не чувствуешь себя так обоснованно русским человеком и патриотом своего народа — именно народа, а не земли, не архаической привязанности к территории, — как когда читаешь Толстого. Я скептик, я с подозрением отношусь к любым призывам кого-то полюбить, потому что заставить любить невозможно. А когда читаешь Толстого, выбора не остаётся — ты просто начинаешь любить этот народ. Толстой — один из самых читаемых писателей мира, лучший романист, и его персонажи живее живых: читая, отвлекаешься от книги и удивляешься, почему их нет рядом с тобой, — они интереснее и умнее самого Толстого, который, кажется, из последних сил тащил свой собственный гений.
Вторая книга — из западной литературы: нужно только приготовиться, что она старая, а когда автор начинал её писать, он ещё не знал, что он гений. Это «Хитроумный идальго Дон Кихот Ламанчский». Персонаж настолько силён, что зажил собственной жизнью за пределами книги — Мигель де Унамуно писал о Сервантесе, что он не поклонник самого Сервантеса, а поклонник Дон Кихота: Сервантес был лишь автором первого «евангелия» о том, как этот персонаж пришёл в литературу, — а дальше персонаж остался жить сам по себе. Если руки так и не дошли до «Дон Кихота», возьмите «Посмертные записки Пиквикского клуба» Диккенса — это очень похоже. А если и Диккенса на полке нет, возьмите «Идиота» Достоевского: тот же персонаж, только в другом веке, в другом народе, говорящий на другом языке.
Есть старая западноевропейская романная система, есть система русского романа девятнадцатого века. А когда поезд мировой литературной гениальности, казалось, был уже полностью укомплектован и отправился в будущее, в последний вагон вдруг успела запрыгнуть русская литература — когда её уже никто не ждал. А позже всех, уже на дрезине, вдогонку покатилась литература Латинской Америки — и здесь непременно нужно читать Маркеса, его самый нестрогий, но самый увлекательный роман «Сто лет одиночества». Он помогает жить именно тем, что ты оказываешься в чудесной реальности: магический реализм не нужно искать где-то — ты уже в нём живёшь, как герои Маркеса, и, читая его, вдруг обнаруживаешь, что у нас всё то же самое, только совсем по-другому.
Вот три великих романа — по одному из трёх романных традиций: западноевропейской, русской и латиноамериканской. Прочитав их, вы узнаете лучшее и главное, что есть в мировой литературе. А дальше, если сможете остановиться, — останавливайтесь, можно время от времени их перечитывать. А можно продолжить: не так уж важно, что читать дальше, — ведь мы всё равно запоминаем только то, к чему у нас уже была предпосылка. Значит, что-то важное для себя вы найдёте в любой книге. Дорогу осилит идущий.
Дмитрий Копанцев: Арсений, я благодарю вас за этот разговор — мне было невероятно интересно. Очень надеюсь, что после нашего интервью многие из тех, кто его посмотрит, возьмут книгу в руки и начнут читать. Я, во всяком случае, именно это и собираюсь сделать. Спасибо вам большое.
Арсений Дежуров: Благодарю вас, Дмитрий. Мне очень трогательно и приятно, что вы меня позвали, — и ваши вопросы дают мне немало поводов для размышлений, хотя не на все из них я успел ответить. Когда появятся ответы, я вам обязательно наберу — и встретимся здесь же, зовите меня.
Дмитрий Копанцев: Буду ждать звонка. Спасибо.

Показать полностью
1

Как перевести запись с диктофона в текст: пошаговый гайд для журналистов, врачей и всех, кто ценит свое время⁠⁠

Журналист возвращается с интервью. В телефоне лежит 40 минут диктофонной записи, в блокноте несколько пометок, дедлайн через два часа. Раньше это означало один сценарий: наушники, пауза каждые 10 секунд, ручной набор, перемотка назад, проверка цитат, снова набор.

Один час аудио мог забрать 3, 4 или 5 часов. Если разговор записан в кафе, на улице, в больнице или в переговорной, времени уходит еще больше. Нужно разобрать голоса, убрать повторы, поймать фамилии, цифры, термины и не перепутать, кто что сказал.

Та же проблема есть у врача после консультации, у юриста после встречи с клиентом, у исследователя после глубинного интервью, у редактора после разговора с экспертом. У всех уже есть готовый файл. Им нужна не диктовка в микрофон, а запись с диктофона в текст: быстро, понятно, с минимальной ручной правкой.

Разберем, как работает расшифровка диктофонной записи, чем она отличается от голосового ввода и как получить из диктофона в текст рабочий материал за несколько минут.

В этом руководстве разберем:

  • чем диктофонная запись отличается от обычного аудио;

  • почему голосовой ввод не подходит для готовых файлов;

  • как перевести аудиофайл диктофона в текст пошагово;

  • зачем включать разделение по спикерам;

  • как работать с шумом, эхом и плохим звуком;

  • что проверить перед публикацией, отчетом или медицинской заметкой.

В чем отличие диктофонной записи от обычного аудио и почему это важно

Диктофонная запись редко похожа на студийный подкаст. В ней слышны паузы, шорохи, фоновый шум, голоса на разной громкости, перебивания и случайные звуки вокруг.

Сервис, который хорошо распознает чистую аудиосказку или речь диктора, не обязательно так же уверенно справится с реальным интервью в кафе или консультацией, записанной на телефон.

Файл может быть в нестандартном формате

Диктофон на телефоне и отдельный рекордер могут сохранять запись в разных форматах:

  • M4A, частый формат на смартфонах;

  • AMR, встречается в мобильных диктофонах и старых приложениях;

  • WAV, хороший вариант для качества записи;

  • MP3, универсальный формат;

  • OGG, AAC, OPUS, FLAC, форматы из приложений для записи и монтажа.

Проблема появляется, когда сервис принимает только один или два формата. Пользователь загружает файл, получает ошибку и идет искать конвертер. Это лишнее действие, которое отнимает время и может ухудшить звук.

Для профессионального сценария важна поддержка популярных форматов. Журналисту не нужно разбираться, чем M4A отличается от WAV. Ему нужно загрузить файл и получить текст.

Запись часто сделана не в идеальных условиях

Реальные диктофонные записи обычно появляются не в тишине.

Журналист пишет разговор в кафе. Врач делает заметку после приема, рядом слышны шаги и голоса в коридоре. Юрист фиксирует встречу в переговорной, где один участник сидит близко к телефону, а второй говорит с другого конца стола. Исследователь проводит интервью, где респондент делает паузы, перебивает себя и говорит неравномерно.

На точность распознавания влияют:

  • фоновый шум;

  • расстояние до микрофона;

  • эхо в помещении;

  • несколько спикеров;

  • слабый микрофон смартфона;

  • сжатие файла после пересылки через мессенджер;

  • нечеткая дикция;

  • одновременная речь участников.

Поэтому обычного распознавания речи недостаточно. Нужен сервис, который рассчитан на полевые записи, а не только на чистый студийный звук.

В записи может быть несколько спикеров

Для одиночной диктовки достаточно сплошного текста. Для интервью, совещания, консультации или переговоров этого мало.

Если в записи говорят два человека, текст должен показывать смену реплик:

  • Спикер 1: задает вопрос.

  • Спикер 2: отвечает.

  • Спикер 1: уточняет детали.

Такое разделение по спикерам помогает не потерять структуру разговора. Для журналиста это ускоряет расшифровку интервью. Для врача помогает отделить слова пациента от комментариев специалиста. Для юриста снижает риск перепутать позиции сторон.

Вывод простой: перевод аудиофайла диктофона в текст требует инструмента, который понимает длинные записи, разные форматы, шум, паузы и диалоговую речь.

Почему голосовой ввод в браузере не подходит для расшифровки диктофона

Частая ошибка: человек ищет, как перевести запись в текст, и попадает на материалы про голосовой ввод. Там предлагают открыть Google Docs, включить микрофон и говорить вслух. Для диктофонного файла это не решает задачу.

Голосовой ввод подходит, когда человек диктует текст прямо сейчас. Например, надиктовывает письмо, заметку или черновик статьи. Браузер слушает микрофон и сразу печатает.

Расшифровка готового аудио устроена иначе. У вас уже есть файл: MP3 с диктофона, M4A с телефона, WAV-файл с рекордера или запись из приложения. Его нужно загрузить, обработать и получить текст.

Чем отличаются два сценария

Голосовой ввод:

  • работает с речью в реальном времени;

  • чаще рассчитан на одного говорящего;

  • зависит от микрофона компьютера;

  • не принимает готовый аудиофайл как исходник;

  • не помогает нормально разобрать интервью с двумя участниками.

Транскрибация готового аудио:

  • работает с уже записанным файлом;

  • подходит для длинных интервью, лекций, встреч и консультаций;

  • поддерживает диктофонные форматы;

  • может добавить пунктуацию и временные метки;

  • может выполнить разделение по спикерам;

  • позволяет получить текст без повторного проигрывания записи через динамик.

Если у журналиста есть 40 минут интервью, ему не нужно включать запись на телефоне и подносить его к микрофону ноутбука. Так качество станет хуже, появится новый шум, а процесс все равно займет 40 минут.

Правильный путь: загрузить исходный файл напрямую в сервис транскрибации.

Быстрый выбор: что нужно сделать с диктофонной записью

Пошаговая инструкция: из диктофонного файла в готовый текст за 7 шагов

Ниже практический сценарий для тех, у кого запись уже есть: на смартфоне, диктофоне, ноутбуке, в облаке или в мессенджере.

Шаг 1. Найдите и перенесите файл

Сначала найдите исходный аудиофайл.

Если вы записывали на смартфон, файл обычно лежит в приложении Диктофон, Записи, Voice Recorder или в папке с аудио.

Его можно:

  1. отправить себе на почту;

  2. сохранить в облако;

  3. передать через USB;

  4. загрузить в сервис прямо с телефона;

  5. скачать из мессенджера, если запись прислал собеседник.

Если запись сделана на отдельный диктофон, подключите устройство к компьютеру и скопируйте файл.

Для хорошего результата лучше использовать оригинал. Не стоит загружать версию, которую несколько раз пересылали через мессенджеры. После сжатия речь может стать менее четкой, а точность распознавания снизится.

Подходящие форматы: MP3, WAV, M4A, OGG и другие популярные аудиоформаты.

Шаг 2. Загрузите файл в Speech2Text.ru

Откройте Speech2Text.ru в браузере. Устанавливать программу не нужно. Сервис работает онлайн с компьютера и телефона.

Загрузите запись в форму на сайте.

Это может быть:

  • аудио с диктофона на телефоне;

  • файл с отдельного рекордера;

  • интервью в MP3;

  • запись встречи в M4A;

  • WAV-файл с хорошим качеством;

  • аудио из видеофайла.

Такой способ удобен, когда нужно быстро получить рабочий текст и не тратить время на конвертацию, установку программ и ручной разбор записи.

Шаг 3. Включите разделение по спикерам

Перед запуском проверьте настройки. Для интервью, переговоров, консультаций, совещаний и фокус-групп включите разделение по спикерам.

Это важно, если в записи есть два или больше голосов. Сервис определит смену говорящего и разнесет реплики по участникам.

Вместо сплошного текста вы получите структуру диалога. Это особенно полезно, когда нужно быстро найти ответ эксперта, отделить вопрос журналиста от реплики героя или проверить, какая сторона произнесла важную фразу.

Шаг 4. Запустите транскрибацию

После загрузки файла запустите распознавание. Сервис обработает аудио и превратит его в текст.

Обычно это занимает минуты, а не часы. В этом главная разница с ручной расшифровкой. Вы не слушаете запись от начала до конца в режиме пауза, набор, перемотка. Вы получаете черновик текста и работаете уже с ним.

Шаг 5. Получите текст с пунктуацией и временными метками

После обработки вы получаете текст с пунктуацией, абзацами и временными метками.

Тайм-коды нужны, когда нужно быстро вернуться к исходной записи:

  • проверить точную цитату;

  • найти спорный фрагмент;

  • сверить фамилию или термин;

  • уточнить цифру, дату или сумму;

  • прослушать место с шумом;

  • проверить реплику конкретного спикера.

Для профессиональной работы это сильно экономит время. Не нужно перематывать весь файл в поисках одного предложения.

Шаг 6. Отредактируйте критичные места

Автоматическая расшифровка снимает большую часть нагрузки, но финальная проверка все равно нужна.

Особенно внимательно проверьте:

  • фамилии;

  • должности;

  • медицинские термины;

  • юридические формулировки;

  • названия компаний;

  • цифры и даты;

  • суммы;

  • цитаты для публикации;

  • фрагменты с шумом или перебиваниями.

Для внутренней заметки может хватить легкой вычитки. Для статьи, протокола, медицинского документа или юридического вывода лучше сверить важные места с аудио.

Шаг 7. Сохраните результат в удобном формате

После проверки сохраните текст в формате, который подходит под задачу.

Журналист может перенести расшифровку в редактор статьи. Врач может использовать текст как основу для рабочих заметок. Юрист может подготовить краткое резюме встречи. Исследователь может разметить ответы респондентов по темам.

Если запись нужна для субтитров, сохраните результат в формате субтитров. Если нужен документ для редактора или коллег, используйте DOCX или TXT.

Лайфхак для журналистов: как сразу получить структурированное интервью

Расшифровка интервью полезна сама по себе, но на ней работа не заканчивается. После того как аудио стало текстом, его можно быстро превратить в основу материала.

Например, у журналиста есть часовая беседа с экспертом. Вручную нужно найти главные мысли, выбрать цитаты, убрать повторы, сгруппировать темы и собрать структуру статьи. Это отдельный этап, который тоже отнимает время.

После транскрибации можно попросить встроенный ИИ обработать текст.

Примеры задач:

  • разделить интервью на тематические блоки: опыт героя, проблема рынка, личная история, прогноз, сильные цитаты;

  • выделить 5 ключевых цитат спикера для статьи;

  • сделать краткую выжимку интервью на 10 пунктов без потери фактов;

  • собрать вопросы и ответы в чистом виде;

  • найти фрагменты, где герой говорит о причинах, последствиях и прогнозах.

Так запись превращается не просто в текст, а в рабочий черновик. Редактор получает структуру, журналист быстрее видит сильные места, а материал можно собрать без долгого ручного прочесывания расшифровки.

Что можно получить после транскрибации

Для журналиста

  • ключевые цитаты;

  • структура будущей статьи;

  • короткое резюме для редактора;

  • блоки по темам;

  • чистая схема вопрос и ответ.

Для исследователя

  • тезисы по респондентам;

  • повторяющиеся мотивы;

  • смысловые категории;

  • выдержки для отчета;

  • материал для качественного анализа.

Для юриста

  • краткое содержание встречи;

  • список обязательств сторон;

  • спорные формулировки;

  • факты для проверки;

  • хронология разговора.

Для врача

  • структурированные жалобы пациента;

  • краткое содержание консультации;

  • список назначений для сверки;

  • заметки для внутренней документации.

Важно не перекладывать на ИИ проверку фактов. Лучше давать ему прикладные задачи: структурировать, сократить, выделить цитаты, сгруппировать темы, найти повторяющиеся тезисы.

Что делать, если качество записи плохое: шум, эхо, несколько голосов

Плохая запись не редкость. Интервью могло пройти в кафе, консультация в шумном кабинете, встреча в переговорной с эхом, а телефон мог лежать далеко от основного спикера.

Современные системы распознавания лучше справляются с фоновым шумом, чем старые сервисы. Но если речь почти не слышна, перекрыта музыкой или записана издалека, точность распознавания будет ниже.

Как понять, что запись сложная

Запись требует более внимательной проверки, если:

  • собеседники перебивают друг друга;

  • на фоне слышна музыка;

  • рядом говорят посторонние люди;

  • микрофон лежал далеко от спикера;

  • в комнате сильное эхо;

  • файл записан в низком качестве;

  • один голос намного тише другого;

  • часть фраз произнесена невнятно.

В таких случаях сервис все равно может дать полезный черновик, но финальную вычитку нужно делать аккуратнее.

Как повысить точность перед загрузкой

1. Используйте исходный файл: не загружайте копию, которую несколько раз пересылали через мессенджеры.

2. Не конвертируйте без необходимости: если сервис принимает M4A, AMR или WAV, лучше загрузить исходный формат.

3. Проверьте громкость: если запись очень тихая, можно поднять уровень звука перед загрузкой.

4. При сильном шуме используйте Audacity: бесплатный Audacity помогает убрать постоянный шум, немного выровнять громкость и подготовить файл к распознаванию.

5. Не чистите звук слишком агрессивно: сильное шумоподавление может повредить речь. Лучше легкая обработка, чем металлический и неестественный звук.

Как записывать лучше в следующий раз

Чтобы следующая расшифровка была точнее:

  • положите телефон ближе к основному спикеру;

  • проверьте запись на 10 секундах перед началом;

  • не кладите телефон рядом с чашками, бумагами и ноутбуком;

  • в кафе садитесь дальше от колонок;

  • попросите участников не говорить одновременно;

  • для важных интервью используйте петличный микрофон;

  • не закрывайте микрофон рукой или чехлом.

Качество записи напрямую влияет на итоговый текст. Чем разборчивее исходный звук, тем меньше времени уйдет на проверку.

Итоги

Ручная расшифровка диктофонной записи больше не должна занимать половину рабочего дня.

Если у вас уже есть интервью, консультация, встреча, лекция или комментарий эксперта, не нужно использовать голосовой ввод и проигрывать запись через динамик. Это ухудшит качество и не сэкономит время.

Гораздо проще загрузить файл в Speech2Text.ru, включить разделение по спикерам, получить текст с пунктуацией и тайм-кодами, затем проверить важные фрагменты.

Так перевод аудиофайла диктофона в текст становится частью нормального рабочего процесса: без ручного набора, бесконечных пауз и перемотки.

Загрузите первую запись на Speech2Text.ru. Первые минуты доступны бесплатно, а результат можно получить быстрее, чем вы сделаете перерыв на кофе.

Показать полностью 3
1

Картина, от которой затрепетали Пушкин, Гоголь и Вальтер Скотт⁠⁠

Картина, от которой затрепетали Пушкин, Гоголь и Вальтер Скотт

Думаем, нашим читателям будет интересно узнать необычные предыстории известных картин и произведений искусства. То, что на первый взгляд кажется лишь обычным предметом интерьера в каком-нибудь богатом дворце, на самом деле часто скрывает за собой мощную историю своего появления. Так было и с картиной «Последний день Помпеи».

24 августа 79 года нашей эры Везувий взорвался и стёр с лица земли процветающий римский город Помпеи. Свидетель катастрофы Плиний Младший, потерявший в ней дядю, оставил потрясающие строки: «В те минуты, когда люди взывали к богам с мольбами о спасении, для многих стало ясно: никаких богов нет и для мира это последняя вечная ночь». Пеплом, засыпавшим город, он же его и сохранил — Помпеи застыли в миг своей гибели, как насекомое в янтаре, и спустя века превратились в настоящую капсулу времени для археологов.

Эта трагедия вдохновила множество художников, но ближе всех к ней подошёл русский живописец Карл Брюллов. В 1828 году он лично посетил руины Везувия и написал: «Вид сих развалин невольно заставил меня перенестись в то время, когда эти стены были ещё обитаемы. Нельзя пройти сии развалины, не почувствовав в себе какого-то совершенно нового чувства, заставляющего всё забыть, кроме ужасного происшествия с сим городом». Так родился замысел картины «Последний день Помпеи» — работы, которая разделит его жизнь на до и после.

Для Брюллова это было не просто монументальное полотно, а личный вызов: в Италии над ним подтрунивали местные мастера, называя его «маленьким русским художником, который пишет маленькие картины». Ответом стала картина колоссального масштаба — больше четырёх метров в высоту и шесть с половиной в ширину. Когда работу увидел Вальтер Скотт, основоположник исторического романа, он несколько часов молча смотрел на полотно, а затем произнёс: «Я ожидал увидеть исторический роман. Но вы создали нечто большее — это эпопея».

В центре композиции — не безликая толпа, а конкретные люди и их истории: женщина, разбившаяся при падении из перевёрнутой колесницы, и её маленький сын, ещё не осознающий масштаб трагедии; сыновья, несущие на плечах немощного отца; жених, не отрывающий взгляд от лица погибшей невесты. Николай Гоголь писал об этом так: «У Брюллова является человек для того, чтобы показать всю красоту свою, всё верховное изящество своей природы».

Картина произвела фурор в Европе — золотая медаль в Лувре, триумф в Милане и Риме. Когда Брюллов вернулся в Петербург, поэт Евгений Баратынский откликнулся коротким экспромтом: «И был последний день Помпеи для русской кисти — первый день». За художником на всю жизнь закрепилось прозвище Великий Карл.

Умер Брюллов в 1852 году под Римом, так и не успев завершить росписи Исаакиевского собора — эта незавершённость угнетала его до последних дней. Но его главная картина продолжает задавать вопрос, актуальный и сегодня: можно ли сохранить достоинство и человечность даже перед лицом неотвратимой катастрофы? Сам художник, кажется, ответил на него всей своей работой — да, можно.

Показать полностью
1

Как мы перестали вручную расшифровывать лекции и семинары⁠⁠

В 21:47 я в очередной раз вернул запись на несколько секунд назад. Преподаватель говорил быстро, из аудитории доносился скрип стульев, а в середине фразы кто-то задал вопрос с четвертого ряда.

Я набрал два предложения, снова включил запись и через минуту повторил тот же цикл.

Так выглядела расшифровка обычной полуторачасовой лекции. На нее уходило около трех часов: прослушать, остановить, набрать текст, проверить термин, вернуться к неразборчивому месту. Если запись была сделана на ноутбук из конца аудитории, работа растягивалась почти на весь день.

В конце месяца я посмотрел задачи в трекере. Почти 40 часов ушло только на перевод лекций и семинаров в текст. В это время не вошли редактура конспектов, загрузка материалов в LMS и подготовка субтитров.

Стало понятно, что искать нужно не очередной сервис для диктовки. Нужен процесс, который принимает готовые аудио и видеофайлы, различает хотя бы основных участников и отдает текст, пригодный для быстрой вычитки. Почему запись лекции сложнее обычного созвона

На онлайн-встрече каждый участник обычно говорит в собственный микрофон. Расстояние до него измеряется десятками сантиметров, а программа получает достаточно чистый цифровой сигнал.

В аудитории все иначе.

Преподаватель перемещается между доской и кафедрой. Студенты задают вопросы без микрофона. В запись попадают вентиляция, проектор, кашель, шелест тетрадей и разговоры на последних рядах. Отражения от стен и потолка накладываются на речь, поэтому окончания слов теряются даже там, где человеку фраза кажется понятной.

Условная схема нашей аудитории выглядела так:

Аудитория около 200 кв. м

┌──────────────────────────────────────────┐

│ ДОСКА преподаватель [MIC] │

│ 1,5 м │

│ │

│ ряд 1 студент А 4 м │

│ ряд 2 студент Б студент В 6 м │

│ ряд 4 вопрос из аудитории 8 м │

└──────────────────────────────────────────┘

Громче всего записывается преподаватель.

Вопросы из зала звучат тише и сильнее смешиваются с шумом.

Есть и языковая проблема. Университетская речь плохо похожа на повседневный разговор:

  • дивергенция ряда Фурье;

  • гомоморфизм группы;

  • дисперсионный анализ;

  • batch normalization;

  • функция активации ReLU;

  • ВКР, ФГОС, СДО и другие сокращения.

В одной фразе преподаватель может несколько раз переключиться между русским и английским. Иногда термин произносится по-английски, а его объяснение дается по-русски. Если система не учитывает контекст дисциплины, batch normalization превращается в случайный набор похожих слов.

Отдельная проблема возникает на семинаре. Преподаватель начинает отвечать, студент перебивает его уточнением, а на заднем плане продолжают обсуждать предыдущий вопрос. Распознавание речи может восстановить большую часть слов, но надежно разделить три одновременно звучащих голоса уже значительно сложнее.

Поэтому обещание точной расшифровки любого аудио мало что говорит о качестве. Проверять сервис нужно на собственных записях: с тем же помещением, микрофоном, терминологией и манерой речи преподавателя.

Попытка 1. Голосовой ввод в Google Docs

Первым вариантом был голосовой ввод Google Docs. Русский язык поддерживается, функция бесплатная и открывается прямо в браузере.

Для живой диктовки этого достаточно. Преподаватель говорит в микрофон, текст появляется в документе.

С готовой записью такой сценарий неудобен. Google Docs работает через микрофон браузера и не предлагает загрузить полуторачасовой файл как отдельную задачу. Можно включить лекцию через динамики или настроить виртуальный аудиокабель, но обработка все равно идет в реальном времени.

Полуторачасовую запись придется воспроизводить полтора часа. В это время вкладка должна оставаться открытой, а посторонние звуки могут попасть в результат. Остановки, паузы и смена говорящих также требуют ручного контроля.

На тестовой академической записи больше всего ошибок появилось в терминах и вопросах из аудитории. Для быстрых заметок способ подходит. Для регулярной транскрибации лекций онлайн он оказался слишком зависимым от ручных действий.

Попытка 2. Otter.ai

Otter часто упоминают в подборках сервисов для встреч и учебы. Поэтому мы проверили его следующим.

На этом тест фактически закончился. По состоянию на май 2026 года Otter транскрибирует английский, испанский, французский, немецкий, японский и упрощенный китайский. Русского в списке поддерживаемых языков нет.

Русский акцент при разговоре на английском и русский язык как объект распознавания являются разными задачами. Возможность перевести готовый английский текст также не заменяет исходную расшифровку русской лекции.

Для англоязычной программы Otter может быть уместен. Для российского вуза, где большая часть материала звучит по-русски, строить на нем основной процесс не получилось.

Попытка 3. Запустить Whisper локально

Локальный Whisper выглядел логичным вариантом. Модель можно установить на собственный компьютер, файлы не нужно передавать во внешний сервис, а результат полностью остается внутри инфраструктуры университета.

Базовый запуск действительно выглядит просто:

pip install -U openai-whisper

whisper lecture.mp3 --model turbo --language Russian

На практике потребуется установить ffmpeg, проверить совместимость Python и PyTorch, загрузить модель и подобрать оборудование.

В официальном репозитории для модели large указано около 10 ГБ видеопамяти. Для turbo, оптимизированной версии large-v3, требуется около 6 ГБ. Реальная скорость зависит от видеокарты, процессора, языка и самой записи.

Наш учебный ноутбук с 4 ГБ видеопамяти для такого сценария не подходил. На CPU распознавание запускалось, но скорость оказалась неудобной для регулярной работы. Методисту также пришлось бы разбираться с обновлениями, зависимостями, очередями файлов и контролем зависших процессов.

Для EdTech-команды с системным администратором или ML-инженером локальная установка имеет смысл. Для методического отдела это уже отдельный программный продукт, который нужно поддерживать.

Есть еще один нюанс: Whisper сам по себе не решает полноценную диаризацию. Чтобы разделять реплики по людям, обычно добавляют отдельный компонент, а затем синхронизируют его результат с сегментами распознавания.

После нескольких тестов мы решили, что локальный запуск оставим для задач с особыми требованиями к контуру. Повседневные лекции удобнее отправлять в готовую систему.

Как мы организовали перевод лекций в текст

Для пилота выбрали Speech2Text.ru. Нас интересовали четыре функции:

  1. Загрузка готовых аудио и видеофайлов.

  2. Разделение текста по спикерам.

  3. Выгрузка результата в DOCX и SRT.

  4. Возможность перейти к пакетной обработке через API.

В веб-интерфейсе сценарий занимает несколько действий: загрузить запись, дождаться обработки, проверить спикеров и скачать результат.

На сайте сервиса указано, что часовой файл обычно обрабатывается примерно за десять минут. На практике время зависит от очереди, длины записи и выбранных функций, поэтому мы не стали закреплять десять минут как гарантированный срок.

Первый тест провели на коротком фрагменте продолжительностью десять минут. В нем были:

  • речь преподавателя у доски;

  • два вопроса студентов;

  • несколько английских терминов;

  • шум проектора;

  • пауза без речи.

Короткий тест полезнее загрузки всего архива. За десять минут можно понять, как система слышит конкретного преподавателя, насколько хорошо разделяет участников и какие термины придется исправлять вручную.

После проверки мы перешли к полуторачасовым лекциям.

Что изменилось в рабочем процессе

Раньше методист начинал с пустого документа. Теперь исходником стал машинный транскрипт.

Работа разбилась на четыре этапа:

Запись лекции

↓

Автоматическая транскрибация

↓

Проверка терминов и спикеров

↓

Конспект, субтитры или публикация в LMS

Самое заметное изменение произошло не на этапе распознавания, а при редактуре. Исправить ошибочно распознанный термин быстрее, чем печатать весь абзац с нуля.

Мы также перестали одинаково обрабатывать все материалы.

Для внутреннего архива достаточно почти дословного текста с тайм-кодами. Для студенческого конспекта убираются повторы, организационные реплики и длинные отступления. Для субтитров сохраняются короткие сегменты и точные временные интервалы.

Одна расшифровка стала основой для нескольких форматов.

Как мы проверяли качество

Универсальной точности для транскрибации лекций не существует. Результат зависит от микрофона, расстояния до говорящего, шума, дисциплины и состава участников.

Для внутреннего теста мы вручную подготовили эталонный текст короткого фрагмента, а затем сравнили его с результатами распознавания. В таблице приведены данные этого пилота, а не лабораторный рейтинг сервисов.

WER показывает долю замененных, пропущенных и лишних слов. Этот показатель удобен для тестирования, но не всегда отражает трудоемкость редакторской работы.

Например, ошибка в предлоге почти не влияет на смысл. Неверно распознанная фамилия ученого, формула или название метода может испортить весь абзац.

Поэтому дополнительно мы считали:

  • сколько терминов пришлось исправить;

  • сколько раз перепутались спикеры;

  • были ли пропущены вопросы студентов;

  • сколько минут заняла финальная вычитка.

Для методического отдела последний показатель оказался полезнее общего процента точности.

Что распознавание пока не решает

После первых удачных результатов легко решить, что ручная работа больше не нужна. На учебных материалах это быстро приводит к ошибкам.

Формулы на доске

Система распознает звук, но не видит написанное выражение. Фраза икс в квадрате плюс игрек останется обычным текстом.

Чтобы получить полноценный конспект, формулы нужно добавлять из презентации, фотографии доски или отдельного документа преподавателя.

Слайды без комментария

Если преподаватель молча переключил слайд, содержание слайда в транскрипт не попадет. Для такого материала требуется извлечение текста из презентации или видеокадров.

Одновременная речь

Когда два студента говорят одновременно, отдельные слова могут потеряться. Диаризация также способна назначить одну реплику не тому человеку.

Редкие сокращения

СФУ, ВКР, ФГОС и названия кафедр полезно проверять поиском по готовому тексту. Для регулярных курсов мы завели небольшой словарь терминов и сокращений.

Длинные участки тишины

На записях с шумом, музыкой или длинными паузами модели распознавания иногда создают лишний текст. Такие места нужно просматривать отдельно.

Как получить конспект из видео лекции

Полный транскрипт и конспект решают разные задачи.

Транскрипт сохраняет ход лекции и позволяет найти нужную фразу. Конспект сокращает материал и группирует его по темам.

Наш процесс выглядит так:

  1. Загружаем видео или извлеченную аудиодорожку.

  2. Получаем текст с тайм-кодами.

  3. Проверяем фамилии, термины и формулировки определений.

  4. Разбиваем материал по темам.

  5. Выносим определения, примеры и задания.

  6. Добавляем формулы и изображения из презентации.

  7. Публикуем документ рядом с видеозаписью.

Автоматически сокращать лекцию лучше после вычитки исходного текста. Иначе ошибка распознавания может попасть в итоговый конспект уже без контекста, по которому ее можно заметить.

Для студентов удобно оставлять ссылки на временные метки:

00:08:14 Определение предела последовательности

00:21:36 Разбор первого примера

00:47:05 Типичная ошибка при вычислении

01:12:40 Домашнее задание

Такой документ помогает вернуться к конкретному фрагменту, не пересматривая всю запись.

Субтитры для онлайн-курса

Для видеокурсов мы выгружаем результат в SRT. Speech2Text поддерживает сохранение субтитров в этом формате.

SRT содержит порядковый номер реплики, время начала, время окончания и текст:

1

00:00:03,200 --> 00:00:07,800

Сегодня разберем свойства определенного интеграла.

2

00:00:08,100 --> 00:00:12,900

Начнем с геометрического смысла площади.

Перед загрузкой в LMS или на видеоплатформу субтитры нужно просмотреть.

Мы проверяем:

  • помещается ли реплика на экран;

  • совпадает ли текст с моментом произнесения;

  • не объединились ли слова двух участников;

  • правильно ли записаны формулы и термины;

  • нет ли слишком длинных строк.

Автоматический транскрипт заметно ускоряет подготовку субтитров, но не отменяет контроль качества.

Для слабослышащих студентов текстовая версия повышает доступность материала. При этом она не заменяет сурдоперевод, адаптацию курса и другие меры, которые могут потребоваться конкретному студенту.

Пакетная обработка через API

Когда в работе было несколько файлов в неделю, веб-интерфейса хватало. Для архива за семестр потребовалась автоматизация.

Публичная страница Speech2Text описывает очереди задач, массовую обработку, webhook и получение результатов в TXT, JSON, RAW и XML. При этом открытая схема запросов и точные адреса методов на странице не опубликованы.

Поэтому мы не стали вставлять в рабочий код выдуманный адрес вида /api/v1/transcribe. Параметры загрузки, авторизации и webhook нужно брать из документации, которую сервис предоставляет при подключении интеграции.

Общая схема получилась такой:

Папка с лекциями

↓

Скрипт отправляет файлы в очередь API

↓

Сервис возвращает идентификаторы задач

↓

Webhook сообщает о завершении

↓

JSON и SRT сохраняются в папку курса

↓

Методист получает список файлов для проверки

Самостоятельно писать такую интеграцию имеет смысл при десятках или сотнях часов аудио. Для 10-20 лекций за семестр проще начать с интерфейса и проверить, устраивает ли качество.

Сколько стоит транскрибация лекций в 2026 году

В первоначальном расчете мы ориентировались на стоимость за минуту. Для регулярной работы тариф с включенным объемом оказался понятнее.

На момент проверки действовали следующие условия:

  • при регистрации предоставляется 180 бесплатных минут;

  • бесплатный режим включает до 15 минут в день;

  • персональный тариф Стандартный стоит 2300 рублей в месяц и включает до трех часов распознавания в день;

  • тариф для организаций Стандартный стоит 9200 рублей в месяц, включает до 12 часов в день, до 20 пользователей и три потока обработки.

Цены и лимиты могут меняться, поэтому перед закупкой их нужно повторно проверить на странице тарифов.

Пилот из 14 лекций

Средняя продолжительность лекции: 90 минут.

14 лекций × 90 минут = 1260 минут

1260 минут = 21 час аудио

При лимите три часа в день весь объем можно обработать за семь дней. Если тариф покупается только ради этого архива, условная стоимость одной лекции составит около 164 рублей:

2300 рублей ÷ 14 лекций = около 164 рублей

Это не стоимость одной операции по прайс-листу, а расчет при использовании месячного тарифа только для данного проекта.

Кафедра из восьми преподавателей

Допустим, каждый преподаватель проводит четыре полуторачасовые лекции в неделю:

8 преподавателей × 4 лекции × 1,5 часа = 48 часов аудио в неделю

За средний месяц получится около 208 часов.

Если ручная расшифровка одного часа записи занимает от двух до трех рабочих часов, полный объем потребует от 416 до 624 часов работы методиста в месяц. На практике такую задачу просто не будут выполнять целиком.

Тариф для организаций за 9200 рублей покрывает до 12 часов обработки в день. При равномерной загрузке пяти рабочих дней лимита достаточно для 48 часов аудио в неделю.

Условная стоимость обработки одного часа при полном использовании составит около 44 рублей:

9200 рублей ÷ 208 часов = около 44 рублей за час аудио

В расчет не включены вычитка, подготовка конспекта и исправление формул. Эти этапы остаются на стороне университета.

Экономия появляется за счет отказа от первоначального набора текста. Методист начинает работу с готового черновика и тратит время на смысловые ошибки, а не на перепечатывание речи.

Что нужно сделать до массовой записи занятий

Технически включить запись можно за минуту. Организационный регламент требует больше внимания.

В аудиозаписи могут содержаться персональные данные студентов и преподавателей. Голос относится к биометрическим данным, когда используется для установления личности. Даже без такой цели в записи могут звучать имена, оценки, вопросы о здоровье и другие сведения, которые нельзя бесконтрольно публиковать.

До запуска процесса мы рекомендуем определить:

  • с какой целью записываются занятия;

  • кто имеет доступ к исходным файлам;

  • где и сколько времени они хранятся;

  • можно ли публиковать запись за пределами курса;

  • как участники уведомляются о записи;

  • как обрабатываются выступления несовершеннолетних;

  • кто отвечает за удаление файлов после окончания срока хранения.

Точный порядок лучше согласовать с ответственным за персональные данные и юристом образовательной организации.

Для обычной лекции мы заранее сообщаем о записи и стараемся не называть студентов по полному имени. Для защит, консультаций и обсуждения индивидуальных результатов нужен отдельный регламент.

Что получилось после пилота

Главный результат состоял не в полной автоматизации. Мы сократили ту часть работы, где человек механически переносит речь в документ.

После обработки 14 лекций у нас появились:

  • текстовые версии занятий;

  • временные метки для навигации;

  • материалы для конспектов;

  • SRT-файлы для видеокурса;

  • основа для поиска по всему семестру.

Формулы, схемы и сложные диалоги все еще требуют ручного вмешательства. Термины также приходится проверять, особенно на первых лекциях нового курса.

Зато вопрос о том, когда преподаватель разбирал интеграл Лебега, больше не требует просмотра десяти видеозаписей. Достаточно поиска по папке с транскриптами.

Следующий шаг для нашего процесса: автоматическая отправка новых файлов через API и загрузка проверенных материалов в Moodle. Но начинать с интеграции мы бы не стали.

Сначала стоит взять короткую запись из реальной аудитории, выполнить перевод лекции в текст и посчитать время вычитки. Если результат экономит хотя бы час на одном занятии, можно переходить к архиву семестра.

Частые вопросы

Как перевести запись лекции в текст?

Загрузите аудио или видео в сервис транскрибации, выберите язык и при необходимости включите разделение по спикерам. После обработки проверьте термины, фамилии, сокращения и вопросы из аудитории.

Можно ли расшифровать запись семинара с несколькими участниками?

Можно, но качество зависит от расположения микрофона и количества одновременных реплик. Лучше поставить микрофон ближе к центру аудитории или передавать отдельный микрофон студентам.

Как сделать конспект из видео лекции?

Сначала получите полный транскрипт, затем удалите организационные реплики, сгруппируйте материал по темам и добавьте формулы со слайдов. Сокращать непроверенный текст рискованно.

Как подготовить транскрипт для субтитров онлайн-курса?

Выгрузите результат в SRT, проверьте тайм-коды и сократите слишком длинные реплики. После этого файл можно загрузить в LMS или видеоплатформу.

Нужно ли устанавливать Whisper на свой компьютер?

Для разового файла обычно нет. Локальная установка оправдана, если данные нельзя передавать за пределы инфраструктуры или в университете уже есть сервер, специалист и процесс сопровождения моделей.

Как повысить качество расшифровки?

Записывайте речь ближе к преподавателю, избегайте размещения микрофона у проектора, проверяйте уровень сигнала до лекции и тестируйте сервис на коротком фрагменте. Хороший микрофон часто дает больший эффект, чем смена модели распознавания.

Показать полностью 1
1

Антон Коченевский: «GEO — это не новый SEO, а новая логика видимости бизнеса»⁠⁠

Основатель Semantica AI — о том, как AI-поиск меняет маркетинг, почему компаниям придется шире работать с контентом и зачем бизнесу думать не только о ссылках, но и о доверии нейросетей.

AI-поиск уже забирает у классической выдачи внимание пользователя, но для бизнеса это не просто новая полка в маркетинговом бюджете. В этой реальности бренд должен быть понятен машине, присутствовать в источниках, которым она доверяет, и уметь отвечать на вопросы клиентов до того, как они попали в форму заявки.

Антон Коченевский, основатель Semantica AI, разбирает GEO как практику: от первых метрик и ограничений до корпоративных медиа, MCP и внутренних AI-инструментов.

Расшифровка подготовлена с помощью Speech2Text. Источник аудио.

Илья Балахнин: Добрый день, друзья. Меня зовут Илья Балахнин, я возглавляю агентство Paper Planes. Сегодня мы будем говорить о сравнительно новом инструменте, который называется GEO. Как подсказал мне наш сегодняшний гость, на рынке уже возник консенсус: это произносится именно как «джио», а не «гео».

В martech исторически очень много инструментов, но новых видов маркетинговых инструментов появляется не так уж много. Нейросети, искусственный интеллект, агенты и все, что вокруг них развивается, меняют эту картину. Они во многом вытесняют собой поиск: почти каждый уже хотя бы раз обращался к нейросети с просьбой что-то порекомендовать или помочь выбрать.

Сегодня поговорим о том, как превращать эту тенденцию в инструмент для бизнеса. Наш гость — Антон Коченевский, основатель и генеральный директор Semantica AI. Антон, привет! Расскажи для начала, что такое Semantica, откуда она появилась и из чего эволюционировала.

Антон Коченевский: Компания молодая, она появилась в 2025 году. Но предыстория бизнеса — это примерно десятилетний опыт в digital и SEO. У меня было digital-агентство, которое работало с SEO как с одним из каналов, а еще был опыт поиска ценности в стартапах, SaaS и облачных сервисах.

В 2025 году все соединилось: вместе с партнером Леонидом Довбенко мы начали проект с аналитики упоминаний. Потом стало понятно, что сама по себе аналитика в 2026 году уже не так ценна, как ответ на вопрос: что с этими данными делать и какую пользу из них извлечь для бизнеса.

Так появилась Semantica — сервис, который помогает компаниям занимать заметные места в AI-выдаче. Особенно ценным это оказалось для крупных компаний. Малому бизнесу, скорее всего, пока рано интенсивно заниматься GEO, а для крупных игроков это стало актуально уже в конце прошлого года.

Илья Балахнин: Давай подробнее про сервис. Я видел интерфейс Semantica. Какие подразделения компаний чаще всего интересуются бренд-менеджментом и маркетингом в AI-выдаче? Появились ли уже отдельные службы, отвечающие за GEO?

Антон Коченевский: Сейчас чаще всего это три блока. Первый — SEO-команды: у них буквально уходит земля из-под ног, поэтому им необходимо считать и понимать, что происходит с AI-выдачей. Позже я еще поделюсь цифрами по тому, сколько AI-поиск уже забрал у классического поиска.

Второй блок — бренд, имидж и PR. Им важно отслеживать не только сам факт появления бренда в ответе, но и качество этого появления: с какой тональностью бренд упомянут, где именно внутри ответа стоит рекомендация, первым ли он назван или оказался где-то в списке.

Третий блок — CMO, digital-директора и маркетинговые руководители в целом. Им важно не упустить новый канал с точки зрения performance, продаж, тональности и конкурентной среды. Отдельно появляются SEO-агентства: им нужно либо выпускать свои инструменты аналитики, либо писать скрипты, но поддерживать такие решения дорого и сложно.

Илья Балахнин: Какие отрасли стали первыми клиентами? Кто раньше других почувствовал, что с AI-поиском уже нужно работать?

Антон Коченевский: В первую очередь — большие SaaS-компании. Еще среди ранних клиентов были крупные интернет-магазины, офлайн-розница, автосалоны, медицина, доставка. Мы молодые, поэтому глобально почти всех можно считать первопроходцами.

Очень интересная конкурентная работа идет в категориях, где есть заметные бренды и сильный маркетинг: парфюмерия, косметика, маркетплейсы, автодилеры. Если у компании большой рынок и пользователь каждый день что-то спрашивает в поиске, там уже появляется емкость для AI-поиска.

Для нас ключевая характеристика идеального клиента — это не отрасль сама по себе, а объем пользовательского рынка. Если люди регулярно спрашивают: «какой лучший автосалон», «где купить», «какой сервис выбрать», значит, в AI-ответах уже возникает поле конкуренции.

Илья Балахнин: Ты обещал цифры: сколько AI-поиск уже отъел у классического SEO? Я правильно понимаю, что речь может идти о 14-16 процентах?

Антон Коченевский: Если говорить о мировом рынке, по свежим весенним данным AI-поиск уже забрал около 40%. По России мы оцениваем это примерно в 15-20%. Но у нас есть уникальная ситуация: главная нейросеть в России по аудитории — это Алиса.

Во-первых, продано около 26 млн колонок в домохозяйствах, и все они уже имеют интернет. Во-вторых, есть интеграция в Яндекс и сниппет с умным ответом от Алисы. Это тоже нужно считать частью AI-поиска.

По данным Яндекса, количество показов AI-ответов в 2025 году выросло примерно в семь раз: с 5% до 35%. Поэтому, скорее всего, в этом году доля AI-ответов в Яндексе может прийти к 70%, 80% или даже 90%. Это будет уже полноценный большой блок, забирающий максимум внимания.

Илья Балахнин: Представим, что я хочу попасть в AI-выдачу сам или хочу завести туда клиента. Что нужно сделать? Не возьмем пока устройства и Алису, а посмотрим на набор нейросетей и на источники, которым они доверяют.

Антон Коченевский: Во-первых, это набор нейросетей. Во-вторых, есть регуляторика: ожидаемо, что появятся ограничения по работе с зарубежными нейросетями, поэтому мы действуем в правовом поле, но следим за развитием ситуации.

Если говорить о доверии нейросетей к источникам, то хорошо работают площадки с живым пользовательским контентом и устойчивой репутацией. Когда-то форумы и UGC-площадки могли казаться устаревшими, но теперь они возвращаются в топы. Например, в некоторых сферах я часто вижу Pikabu, а в IT и разработке — Habr.

Поэтому совет простой: если у вас до сих пор есть сильная UGC-составляющая, корпоративное сообщество, форум или база знаний, не списывайте это со счетов. Нейросетям нужны источники, где есть контекст, ответы, мнения, опыт пользователей и следы реального взаимодействия.

Илья Балахнин: В этом смысле мода на корпоративные медиа получает новое дыхание? Раньше у них была понятная роль в SEO, а теперь появляется еще и нейросетевая видимость.

Антон Коченевский: Корпоративные медиа точно нужно делать, но важно поменять парадигму. Раньше компания могла думать: вот есть поисковый спрос, вот есть SEO-текст, мы закрываем конкретную семантику. Теперь семантика может быть гораздо шире, потому что нейросеть отвечает на очень разные вопросы.

Нужно покрывать то, до чего раньше просто не доходили руки. Все, что спрашивают про вашу компанию, продукт, категорию, конкурентов, способы выбора, барьеры покупки, можно превращать в полезный контент. И нейросети помогают этот объем создавать быстрее.

Но я бы не советовал слепо делать реверс-инжиниринг текущих топов. Сегодня в США, например, заметен Reddit, в России — одни площадки, завтра все может измениться. Если мы просто раскручиваем клубок назад и публикуемся там, где уже цитируется, мы рискуем ошибиться в будущем.

Илья Балахнин: А когда, на твой взгляд, в России произойдет выравнивание между классическим поиском и AI-поиском? И что будет с SEO?

Антон Коченевский: Мировые аналитики называют 2028 год точкой изменения, и до него осталось не так много времени. В России все происходит быстрее, потому что Яндекс уже интегрирует AI-ответы в основной поиск, а Google двигает AI Mode и генеративные ответы в свою главную денежную корову.

Здесь возникает вопрос терминов. Если Google в большинстве случаев будет отдавать AI-ответ, считаем ли мы это все еще поиском? Если мы консервативны и говорим «Google есть Google», тогда это поисковик. Но по сути нужно разделять AEO — Answer Engine Optimization внутри поисковика — и GEO, где мы работаем с чистыми AI-системами вроде Perplexity, ChatGPT или Gemini.

SEO, скорее всего, не исчезнет одномоментно. Но я думаю, что часть SEO станет GEO: специалисты будут работать не только с классическими факторами ранжирования, но и с тем, как бренд представлен в ответах генеративных систем.

Илья Балахнин: Давай к ограничениям. В классическом поиске можно смотреть частотность, Wordstat, инструменты конкурентного анализа. А в нейросетях никто не отдает частотность запросов. Как с этим жить?

Антон Коченевский: Ни одна нейросеть не отдает честную частотность. Никто не скажет, сколько раз в Perplexity в России за месяц искали «посоветуй лучший сериал» или «где купить Mercedes». Это связано и с приватностью, и с тем, что сами сервисы пока не раскрывают такую аналитику.

Поэтому приходится собирать прокси-данные: Wordstat, поисковый спрос, поддержку, CRM, чаты, вопросы клиентов, рыночные гипотезы. Но нельзя просто взять Wordstat и сказать: вот это и есть рынок AI-поиска. Запросы в нейросетях устроены иначе: они длиннее, разговорнее, ближе к реальной задаче пользователя.

Еще один сложный вопрос — совпадает ли ответ, полученный через API, с тем, что пользователь видит на своем устройстве. Это большой «слон в комнате» для всей индустрии. Мы можем делать тысячи запросов по протоколу, но важно понимать, насколько эти ответы репрезентативны для реального пользовательского опыта.

Илья Балахнин: Какие функции клиенты уже хотят видеть в сервисе? И что из этого пока трудно сделать?

Антон Коченевский: Мы уже умеем определять место бренда в ответе, разбирать тональность, смотреть дополнительный слой: где именно внутри ответа вы появились, как соседствуют конкуренты, какие формулировки используются. Это важно, потому что «присутствуем» и «нас уверенно рекомендуют первыми» — совершенно разные состояния.

Маркетологи приходят с живыми задачами: например, «у нас барьер покупки фильтра для воды — цена, что можно сделать?» И дальше можно работать не только с отчетом, но и с гипотезами: какие ответы формирует нейросеть, какие возражения видит пользователь, где бренд проигрывает конкурентам.

Из сложного — состыковка разных источников и проверка ответа. Мы пока не можем честно сказать, что видим весь AI-поиск так же, как его видит каждый пользователь. Но индустрия быстро движется: появляются модели, API, новые способы анализа текста, и многие вещи, которые вчера казались невозможными, становятся рабочими.

Илья Балахнин: Когда заходишь на платформу, видно, что это стартаповый продукт. Сколько человек сейчас работает в компании и как вы управляете разработкой?

Антон Коченевский: Сейчас нас около пятнадцати человек. И разработка сегодня сильно отличается от разработки десять лет назад. У меня был опыт digital-агентства, я сам делал сайты и понимал, как выглядел классический процесс. Сейчас с AI-инструментами можно двигаться быстрее, но это не отменяет дисциплины.

Я не считаю, что «vibe coding» — это просто хаотично попросить нейросеть что-то написать. Нужны проверяемость, предсказуемость, валидируемость, переносимость решений и понятный процесс. Если этого нет, то скорость превращается в технический долг.

Для стартапа нет смысла сразу инвестировать в гигантские сложные интерфейсы. Мы стараемся быстро проверять продуктовые гипотезы, но держать систему управляемой: чтобы данные, задачи, клиентские сканы и разработка не жили отдельно друг от друга.

Илья Балахнин: Мы можем поделиться твоим skill со зрителями. Давай поговорим шире про skills, агентов и MCP. Ты в разговоре не раз возвращался к тому, что вокруг этого будет строиться новая инфраструктура.

Антон Коченевский: Я технооптимист и довольно много продвигаю MCP как направление. Моя логика такая: интерфейсы схлопываются туда, где у пользователя больше всего ежедневного внимания. Именно поэтому банковские приложения стали супераппами, а разные отдельные функции постепенно мигрируют в одно место.

С нейросетями будет похожая история. Пользователь все больше времени проводит в чате с моделью, потому что там можно сделать очень многое. Model Context Protocol позволяет приложению взаимодействовать с нейросетью не как с внешним сайтом, а как с источником действий и данных.

Например, MCP для Semantica может ответить на прикладной вопрос: «По последнему скану по продукту BMW X3 мы выше или ниже конкурента?» Он берет данные из базы и возвращает ответ за несколько секунд. Это быстрее, чем агент, который открывает браузер, ходит по сайтам и авторизуется.

Мы уже используем внутренний MCP: команда работает через Claude, можно передать переписку с клиентом или скриншоты и попросить сформулировать задачу. Система сама связывает это с нашей базой, задачами и рабочим процессом.

Илья Балахнин: Но если представить бизнесы с узким B2B-рынком, консалтингом или небольшой частотой запросов, им такие системы тоже нужны? Или это история только для компаний с большим количеством повторяющихся операций?

Антон Коченевский: Если говорить про узкий B2B или консалтинг, это другая история. Там может быть не так много пользовательских запросов, не так много повторяемых операций, а ценность часто в экспертизе и доверии. Поэтому не каждому бизнесу прямо сейчас нужен собственный большой AI-комбайн.

Но если у вас много операций, много клиентов, много данных и много повторяющихся решений, эффект становится заметным. В 2026 году связка CRM, task tracker, backlog, платежей, базы знаний и рабочих сущностей должна быть сквозной. Иначе вы просто переносите хаос из одной системы в другую.

Мы многое пишем внутри, потому что наши клиенты, их сканы, результаты, задачи и данные должны быть связаны. Благодаря этому система управляемая: можно увидеть, что происходит с клиентом, какие задачи появились, какие данные обновились и как это превращается в работу команды.

Илья Балахнин: Последний большой вопрос — экономический эффект. Часто его считают как замещение труда старших специалистов трудом младших, усиленных инструментами. Другие говорят про снижение когнитивной нагрузки. Как ты сам это оцениваешь как владелец компании?

Антон Коченевский: Мне близка отсылка к книге «Вторая эра машин». Промышленная революция дала людям машины, которые выполняли физическую работу, недоступную человеку. Нейросети делают похожую вещь с интеллектуальной работой: они не просто дают доступ к знаниям, как интернет, а позволяют выполнять часть умственных операций.

Интернет дал безграничный доступ к знаниям еще десятилетия назад, но он не сделал все виды умственной работы автоматически возможными. Нейросети снимают именно нагрузку выполнения: можно отдать агенту задачу, которую средний разработчик делал бы десять часов без перерыва, и получить рабочий результат быстрее.

Поэтому экономический эффект я вижу не только в замещении человека человеком дешевле. Это ускорение темпа, снижение когнитивной нагрузки и возможность создавать то, что раньше просто не успевали делать. Темпы, с которыми компании будут развиваться и подниматься, могут стать немыслимыми по старым меркам.

Илья Балахнин: Давай подытожим в формате блица. Три простых совета тем, кто сейчас думает: начинать ли работать с AI-поиском, с чего начать и чего не делать?

Антон Коченевский: Первое: начните мыслить шире, чем в классической парадигме контента. Все, о чем спрашивают про вашу компанию, можно писать от имени компании и превращать в понятные ответы.

Второе: будьте максимально открыты. Если у вас есть сто чатов в день со службой поддержки, берите каждый из них, обезличивайте, прогоняйте через нейросеть и превращайте в базу знаний. Уже сейчас нужно быть настолько открытыми.

Третье: если у вас большой рынок, где много пользователей ежедневно что-то спрашивают и ищут в обычном поиске, вам уже пора идти в AI-поиск. Там формируется новая выдача, и лучше начать работать с ней до того, как конкурент станет для нейросети ответом по умолчанию.

Илья Балахнин: Это был Антон Коченевский, основатель и генеральный директор Semantica AI. Спасибо, Антон, получилось очень содержательно. А зрителям спасибо за внимание — до встречи в новых выпусках.

Показать полностью 1
1

Пересказ видео по ссылке: как получить краткое содержание из VK, RuTube и YouTube без кода и VPN⁠⁠

Попался ролик на два часа в VK Видео или RuTube. Тема нужная: лекция, интервью, вебинар, разбор закона, запись конференции. Открываешь, смотришь первые минуты и понимаешь: сейчас на это просто нет времени.

Хочется сделать по-человечески: дать сервису ссылку и получить краткое содержание видео. Без скачивания программ, без Python, без установки расширений, без танцев с API. Но тут начинается неприятная часть. ChatGPT, Gemini и похожие ИИ-чаты не всегда понимают, что лежит по ссылке на российской видеоплатформе. Для них это часто просто страница, а не сам ролик с аудио, речью и смыслом.

С YouTube ситуация привычнее: там часто есть субтитры, и вокруг платформы давно выросло много инструментов. Поэтому пересказ видео с YouTube уже не выглядит чем-то новым. А вот пересказ видео из VK или RuTube до сих пор часто приходится собирать по кускам: скачать ролик, вытащить звук, распознать речь, потом отдельно попросить ИИ сделать конспект.

Для разработчика это не проблема. Для обычного пользователя, студента, маркетолога, журналиста, блогера или офисного специалиста, проблема. Особенно если нужен не эксперимент, а рабочий результат сегодня.

Разберемся, как получить пересказ видео по ссылке с VK Видео, RuTube и YouTube без кода, VPN и зарубежных карт.

В этом руководстве разберем:

  • почему ИИ-чаты не всегда умеют пересказывать ролики из VK и RuTube;

  • как на самом деле работает краткое содержание видео;

  • как получить пересказ ролика по ссылке или через загрузку файла;

  • что выбрать: ссылку на видео или загрузку файла;

  • как использовать транскрипцию для конспекта, субтитров, статей и постов.

Почему ChatGPT и другие ИИ-чаты не умеют пересказывать VK и RuTube

ИИ-чат не смотрит видео глазами. Он не сидит перед экраном, не слушает звук и не перематывает запись. Чтобы сделать пересказ, ему нужен текст: субтитры, расшифровка речи или уже готовая транскрипция.

С YouTube такой сценарий иногда работает, потому что у роликов часто есть автоматические субтитры. Если сервис может получить к ним доступ, он берет этот текст и уже по нему делает summary, план или конспект.

С VK Видео и RuTube все сложнее. Это отдельные отечественные платформы, у них свои правила доступа, интерфейсы и ограничения. Универсального публичного способа забрать субтитры из любого ролика и передать их в зарубежную нейросеть нет.

Отсюда типовые ситуации:

  • ИИ-чат пишет, что не может открыть ссылку;

  • пересказ получается по названию ролика, а не по содержанию;

  • нейросеть отвечает слишком общо, потому что не слышала аудио;

  • нужно искать сторонние расширения, скрипты или зарубежные сервисы;

  • для части инструментов требуется VPN, подписка или иностранная карта.

В итоге запросы вроде пересказ видео из VK и пересказ роликов RuTube остаются почти пустой нишей. Видео на этих площадках много, аудитория растет, а простого пользовательского сценария все еще не хватает.

Решение не в том, чтобы заставить ChatGPT открыть закрытую для него ссылку. Рабочий путь другой: сначала превратить речь из видео в текст, потом уже передать этот текст ИИ.

Как на самом деле работает пересказ видео с любой платформы

Пересказ видео начинается не с нейросетевого чата, а с аудиодорожки.

У любого ролика есть звук. В этом звуке находятся лекция, интервью, монолог, диалог, вопросы из зала, комментарии ведущего. Если этот звук распознать, получится текстовая версия видео. Дальше с ней можно делать почти все: сокращать, структурировать, искать цитаты, делать субтитры, собирать конспект.

Схема выглядит так:

  1. Сервис получает видео по ссылке или принимает загруженный файл.

  2. Из видео берется аудиодорожка.

  3. Нейросеть распознает речь и превращает ее в текст.

  4. В текст добавляются абзацы, пунктуация, иногда тайм-коды и спикеры.

  5. ИИ делает краткое содержание, план, тезисы или другой нужный формат.

Такой подход не зависит от одной платформы. Если есть аудио, можно получить транскрипцию. Поэтому один и тот же принцип работает для VK Видео, RuTube, YouTube, записей Zoom, Teams, вебинаров и обычных видеофайлов с компьютера.

В этом и смысл Speech2Text.ru: не пытаться угадать содержание страницы, а обработать саму речь. Пользователь вставляет ссылку или загружает файл, получает транскрипцию видео, а затем может получить краткую выжимку, конспект, план или субтитры.

Для человека это выглядит просто: была длинная запись, стал понятный текст. А уже из текста можно быстро достать главное.

Быстрый выбор: что вам нужно от пересказа видео

Пошаговый гайд: пересказ видео из VK Видео, RuTube или YouTube за 3 шага

Сценарий ниже подходит для обычного пользователя. Не нужно писать код, открывать Google Colab, подключать API или ставить программы на компьютер.

Шаг 1. Скопируйте ссылку на видео

Откройте нужный ролик и скопируйте ссылку из адресной строки браузера.

Лучше всего обрабатываются публичные видео:

  • лекции;

  • интервью;

  • вебинары;

  • подкасты;

  • записи конференций;

  • обучающие ролики;

  • презентации;

  • разборы новостей;

  • длинные экспертные выступления.

Если видео закрытое, приватное или доступно только после входа в аккаунт, ссылка может не подойти. Это нормально: у платформ есть настройки приватности. В таком случае лучше использовать другой путь: скачать файл, если у вас есть на это право, и загрузить его вручную.

Шаг 2. Вставьте ссылку или загрузите файл в Speech2Text.ru

На Speech2Text.ru можно работать в браузере. Это важно: не нужно устанавливать конвертеры, плагины, десктопные программы и дополнительные расширения.

Есть два варианта:

  • вставить ссылку на публичное видео;

  • загрузить файл с компьютера.

Для роликов из VK Видео и RuTube удобнее сначала попробовать ссылку. Если она не сработала из-за ограничений доступа, используйте файл.

Сервис работает с оплатой в рублях, поэтому не нужна иностранная карта. VPN для использования самого Speech2Text.ru тоже не требуется. Это особенно удобно, когда задача простая: получить расшифровку и краткое содержание ролика, а не разбираться с зарубежными сервисами.

После обработки вы получаете текст. В зависимости от тарифа и сценария доступны полезные функции для дальнейшей работы:

  • тайм-коды;

  • интерактивный плеер;

  • экспорт в DOCX;

  • субтитры в SRT;

  • разделение по спикерам;

  • дальнейшая ИИ-обработка текста.

Шаг 3. Получите ИИ-саммари или краткий конспект

После расшифровки Speech2Text.ru не просто выдает текст видео. Сервис может сам подготовить ИИ-саммари и краткий конспект по содержанию ролика. Поэтому не обязательно копировать транскрипцию в сторонний чат и отдельно просить нейросеть обработать материал.

Это удобно, когда нужно быстро понять суть длинного видео: о чем говорили, какие были главные мысли, где практические выводы и стоит ли смотреть запись целиком.

После обработки видео можно использовать готовые форматы:

  • краткое содержание ролика;

  • конспект по основным тезисам;

  • умную выжимку по смыслу;

  • список ключевых идей;

  • текстовую расшифровку с тайм-кодами;

  • материал для дальнейшей работы: статьи, поста, заметки или отчета.

Если нужен более точный результат, можно дополнительно уточнить задачу для ИИ-ассистента внутри сервиса.

Примеры задач:

  • сделай конспект для учебы;

  • выдели главные идеи и практические выводы;

  • составь план видео в 10 пунктах;

  • подготовь краткую выжимку для руководителя;

  • найди важные фрагменты и сохрани привязку к тайм-кодам.

В итоге пользователь получает не сырой поток речи, а готовый рабочий материал. Это особенно полезно для лекций, вебинаров, интервью, подкастов и длинных экспертных роликов, где важно быстро забрать смысл, а не пересматривать запись полностью.

Сравнение: что лучше, скачать видео и загрузить файл или передать ссылку

Оба способа нормальные. Выбор зависит от доступа к ролику и от того, насколько стабильно сервис может получить видео по ссылке.

Если ролик открыт в VK Видео или RuTube, начинайте со ссылки. Это самый быстрый вариант.

Если материал закрытый, учебный, корпоративный или лежит в личном кабинете, лучше загрузить файл. Так часто работают с внутренними созвонами, вебинарами, курсами и записями рабочих встреч.

Отдельный момент: сторонние сервисы для скачивания видео могут быть удобны, но их стоит использовать аккуратно. Проверяйте, что вы не нарушаете права автора и правила площадки. Личная учебная заметка и коммерческое переиспользование контента, это разные ситуации.

Лайфхак: как быстро сделать конспект из длинного видео RuTube

Допустим, есть лекция на RuTube на 90 минут. Тема нужна для учебы или работы, но смотреть все целиком прямо сейчас неудобно.

Рабочий сценарий:

  1. Скопируйте ссылку на ролик.

  2. Вставьте ее в Speech2Text.ru.

  3. Получите транскрипцию.

  4. Попросите ИИ сделать план видео в 10 пунктах.

  5. После этого раскройте только те пункты, которые действительно нужны.

Можно не пытаться сразу получить идеальный конспект. Часто лучше идти в два прохода.

Сначала короткая карта видео:

  • составить план лекции в 10 пунктах;

  • отметить, где теория, где примеры, где выводы;

  • понять, какие части стоит изучить подробнее.

Потом более точная задача:

  • раскрыть выбранные пункты подробнее;

  • добавить определения, цифры и практические рекомендации;

  • сохранить важные фрагменты с тайм-кодами.

Так вы не тратите время на весь ролик. Сначала понимаете структуру, потом забираете нужные фрагменты. Для учебы это особенно удобно: из лекции получается нормальный конспект, а не простыня расшифрованной речи.

Где пересказ видео по ссылке особенно полезен

Пересказ видео нужен не только студентам. Такой сценарий закрывает несколько рабочих задач.

Учеба

Можно быстро разобрать лекцию, вебинар, онлайн-урок или запись консультации. Вместо повторного просмотра появляется текст, конспект и список главных тезисов.

Маркетинг и контент

Один ролик можно превратить в посты, статью, описание для сайта, рассылку, тезисы для карточек и подборку цитат. Это экономит время редактора и помогает использовать видео повторно.

Журналистика и исследования

Интервью, пресс-конференции и экспертные выступления проще анализировать в тексте. Можно быстро найти цитаты, имена, даты, факты и спорные места.

Бизнес

Записи встреч, презентаций и вебинаров превращаются в отчеты, списки задач, решения и краткие выжимки для руководителя или команды.

Личный просмотр

Если ролик длинный, пересказ помогает понять, стоит ли смотреть его целиком. Иногда достаточно саммари, а иногда оно помогает выбрать нужный фрагмент.

Что можно получить после обработки видео

Транскрипция полезна не только для summary. Из нее можно делать субтитры, заметки, статьи, посты, описания к видео и материалы для рассылки.

Один длинный ролик можно превратить сразу в несколько форматов:

  • SRT-субтитры;

  • текстовую расшифровку;

  • короткое описание;

  • пост для соцсетей;

  • тезисы для карточек;

  • конспект для команды;

  • подборку цитат с тайм-кодами;

  • материал для статьи или отчета.

Так видео перестает быть одноразовым контентом. Его можно переупаковать и использовать повторно.

Итоги

Длинное видео не обязательно смотреть от первой до последней минуты. Особенно если задача не развлечься, а быстро понять смысл: о чем говорили, какие выводы сделали, где полезные примеры, что можно забрать в работу.

Для YouTube, VK Видео, RuTube и Zoom рабочая схема одна: сначала распознать речь, потом сделать из текста краткое содержание, план или конспект.

В этом и ценность подхода через Speech2Text.ru. Пользователю не нужен Python, API-ключи, зарубежные подписки, VPN и отдельные программы. Достаточно вставить ссылку на публичный ролик или загрузить файл, дождаться транскрипции и получить ИИ-саммари в нужном формате.

Если нужно быстро получить пересказ видео из VK или RuTube, попробуйте Speech2Text.ru: вставьте ссылку, получите текст и заберите главное раньше, чем ролик успеет дойти до середины

Показать полностью 2
1

Михаил Бурцев: «Пока мы не создали мультимодальную модель, говорить о суперинтеллекте рано»⁠⁠

Почему рекордные инвестиции в искусственный интеллект пока не превратились в рост производительности и что об этом думает исследователь нейросетей и мозга.

Искусственный интеллект уже стал одной из главных статей расходов мировой технологической индустрии, но обещанный скачок производительности пока остается скорее ожиданием, чем фактом. Михаил Бурцев смотрит на этот разрыв с двух сторон: как математик, исследующий машинный интеллект, и как нейрофизик, хорошо понимающий, насколько сегодняшние модели не похожи на живой мозг.

Из этого разговора получается не очередной прогноз о скором AGI, а трезвый разбор того, что именно умеют LLM: где текстовая машина уже помогает науке и бизнесу, а где мы принимаем убедительный ответ за понимание мира.

Расшифровка подготовлена с помощью Speech2Text. Источник аудио.

Надя Грошева: Всем привет! Это «Экономика будущего». Меня зовут Надя Грошева, я медиадиректор Movchan’s Group.

Только в 2025 году в компании, связанные с искусственным интеллектом, было вложено $202 млрд венчурного капитала. Это половина всех венчурных денег на планете. Крупнейшие технологические компании мира планируют потратить на инфраструктуру ИИ еще $700 млрд в этом году. При этом главный экономист Goldman Sachs недавно признал: вклад этих инвестиций в реальный экономический рост в 2025 году составил практически ноль.

80% компаний, внедривших искусственный интеллект, не зафиксировали никакого измеримого эффекта на производительность. Наш сегодняшний гость — один из немногих людей, кто смотрит на искусственный интеллект сразу с двух сторон: изнутри, как математик, исследующий его основы, и снаружи, как человек, который провел годы в институтах, изучавших живой мозг. Михаил Бурцев, математик, нейрофизик, создатель DeepPavlov, стипендиат London Institute for Mathematical Sciences. Михаил, добрый день!

Михаил Бурцев: Добрый день. Спасибо за приглашение.

Надя Грошева: Михаил, давайте начнем с основ. Искусственный интеллект — он действительно интеллект? Как работают LLM, которые большинство из нас сейчас используют?

Михаил Бурцев: Мне кажется, что точное определение интеллекта мы сегодня не найдем: ученые в этом расходятся. Но мы можем порассуждать и понять, как действительно работает современный искусственный интеллект.

Если расшифровать LLM, это Large Language Models, большие языковые модели. Но прежде чем говорить о больших языковых моделях, нужно понять, что такое языковая модель. Самая простая математическая языковая модель: мы открываем книгу, случайно тыкаем пальцем в страницу и спрашиваем, какое слово там увидим. Зная частоты слов, мы можем посчитать вероятность. Это самая примитивная языковая модель.

Более сложная языковая модель появляется, если мы берем слово, например «мама», и спрашиваем, какое следующее слово будет в тексте. Мы можем посчитать вероятности попарных взаимодействий между словами во всех текстах, которые у нас есть. А теперь представьте модель, которая может предсказать следующее слово, прочитав страницу или 20 страниц. Такое предсказание будет гораздо более адекватным: одно дело — случайное слово, другое — «мама мыла раму», где «мыла» вероятнее как следующее слово.

Чем больше слов в начале мы добавляем, тем лучше можем предсказывать, что будет дальше. Языковая модель начинает вести себя так, что мы, пользователи, воспринимаем это как осмысленную деятельность и будто общаемся с интеллектом. Но на самом деле это предсказание следующего слова, сделанное при помощи гораздо более сложных алгоритмов, чем простой подсчет вероятностей: при помощи нейросетей.

Нейросеть — это алгоритм, который позволяет на многих текстах выучить статистические зависимости и предсказывать следующие слова. Здесь есть более глубокая параллель: чтобы адаптироваться к среде и вести себя интеллектуально, живые организмы должны предсказывать следующие состояния среды и получать обратную связь. В некотором смысле механизм предсказания является основой любого интеллекта.

Вопрос в том, насколько модель, которая выучилась предсказывать только текст, будет воспроизводить интеллектуальные способности. Это открытый вопрос. Предсказание следующего слова часто называют «стохастическим попугаем»: модель просто выучила, как попугай, предсказывать следующее слово. Но, может быть, именно в этом и кроется загадка интеллекта.

Надя Грошева: Получается, что простейшая модель, которая работает по такому принципу, давно всем знакома: T9, когда нажимаешь слово «добрый», а он автоматически подсказывает «вечер». Но между T9 и ChatGPT или Claude — пропасть. Можно спросить гораздо больше. За счет чего получается эта разница: это более современный алгоритм?

Михаил Бурцев: Есть два фактора. Первый — совершенство самого алгоритма: он содержит во много раз больше параметров, которые описывают связи между различными частями текста. Второй — объем данных, на которых эти связи выучены. Сегодня такие алгоритмы учатся на всех текстах, которые человечество сгенерировало, чтобы предсказывать следующие слова.

Языковую модель можно представить как губку, которая впитала все возможные продолжения всех текстов, которые видела. Но критический элемент, ставший очевидным после появления ChatGPT в конце ноября 2022 года, в другом. Если модель просто знает продолжения текстов и вы ее что-то спрашиваете, в обучающей выборке есть много похожих продолжений, которые она может сгенерировать. Она может переключаться между вариантами, и это приводит к галлюцинациям или к бесполезным ответам.

Поэтому был придуман способ дообучить языковую модель так, чтобы она выдавала не любой ответ, а ответ, обладающий полезностью для человека. Именно это стало технологическим прорывом и привело к массовому принятию языковых моделей. Они существовали и до этого много лет, но не давали такого качества.

Я сам был очень поражен, когда увидел, как работает ChatGPT: до этого я работал с подобными моделями, строил диалоговые системы, которые общаются с пользователями, и не ожидал такого качества генерации. Прорыв OpenAI в том, что они добились хорошего следования узкой задаче: помочь пользователю решить проблему, объяснить что-то или предложить план действий.

Надя Грошева: У меня тоже было сильное личное впечатление: когда я впервые пользовалась ChatGPT в конце 2022 года, я не была связана с языковыми моделями и была в шоке, что такое вообще возможно. Как человеку, который работает с текстами, мне казалось невероятным, что есть кто-то, кому можно поручить написание текстов, создание сайтов или генерацию видео, и это не живые люди, а им просто выдаешь задачи, и они решают.

Но при этом ChatGPT, например, плохо считает и решает пространственные задачи. Что именно есть в этой модели и чего в ней нет?

Михаил Бурцев: Когда мы общаемся с моделью, нам психологически удобно представлять, что собеседник обладает здравым смыслом и такой же моделью окружающего мира, как и мы. Благодаря этому человеческая коммуникация возможна: мы не описываем все в мельчайших деталях, а говорим только о том, чем ситуация отличается от типичной, подразумевая, что человек понимает остальное.

Все знание модели об окружающем мире получено из текстов. Она никогда не видела предмет, падающий на Землю, и не экспериментировала с ним. Она знает только тексты, которые прочитала. Поэтому у нее есть слепые пятна.

С расчетами ей сложно, потому что модель вероятностная. Грубо говоря, есть десятки тысяч возможных вариантов следующего слова, и нужно выбрать один. Иногда она путается в рассуждениях и не может себя проверять. Человек может написать вычисления, перечитать их, усомниться и исправить. Современным моделям чаще всего сложно исправлять собственный уже сгенерированный текст, если специально не заставлять их это делать.

Но эта проблема решается. Если речь о математическом расчете, мы можем подключить к LLM внешнюю систему, которая перепроверит вычисления. Тогда можно найти ошибку, дать модели обратную связь и попросить альтернативное решение.

Надя Грошева: Почему одна нейросеть отличается от другой? Видно, что ответы Claude отличаются от ответов ChatGPT: они более конкретные, по-другому находят информацию. На чем это основано?

Михаил Бурцев: Можно представить языковую модель как двигатель. Сегодня этот двигатель спрятан внутри большой машины или системы. Сами модели по характеристикам могут быть похожи у OpenAI и у Anthropic, у ChatGPT и Claude. Но двигатели можно по-разному настраивать: важно, что используется в посттренинге, когда модель направляют в определенную сторону рассуждения.

Обычно собирается небольшая подвыборка данных с типовыми взаимодействиями. Если одно типовое взаимодействие будет написано на фене, а другое — как в институте Академии наук, то после посттренинга, даже при одинаковой начальной модели, поведение будет разным. Так появляются разные «персональности» и разная подача информации.

Вторая вещь — интеграция внешних знаний и поиска. Она позволяет добавить в модель новую информацию, которую модель напрямую не запомнила. Часть часто встречающихся фактов она запоминает при обучении, а редкие или новые факты — нет. Поэтому в контекст, куда мы пишем вопрос, можно подать текст из поиска, и модель будет рассуждать уже на его основе.

То, как устроен поиск, у ChatGPT и Anthropic может отличаться: разные провайдеры, отбор результатов, форматирование данных в контексте. Поэтому ответы получаются разными.

Надя Грошева: Недавно у меня был пример: я попросила ChatGPT проанализировать сценарий, где упоминалось, что Мадуро был вывезен в США. Он написал, что это выдумка, потому что Мадуро — президент Венесуэлы, и предложил исправить сценарий. Видимо, данные обновляются неравномерно.

В одном из интервью вы называли ChatGPT слепоглухонемым, потому что он не взаимодействует с миром. Можете подробнее пояснить, как это происходит?

Михаил Бурцев: Все, что видит ChatGPT, — это фактически текст. Конечно, есть варианты моделей, которым можно подавать картинки, и модели, которые генерируют изображения. Это может быть сделано разными способами: та же модель генерирует не слова, а некоторые образы, которые потом транслируются в картинку, или отдельная модель по текстовому контексту генерирует картинку для чата. В этом смысле модель что-то «видит». Но слепоглухонемая она потому, что у нее нет прямого взаимодействия с миром.

Ее единственная форточка во внешний мир — человек, пользователь, с которым она разговаривает, и язык. Сейчас есть отдельное направление: исследователи говорят, что у нас есть large language model, а теперь нужно строить large world model. Под world model подразумевается идея сделать модели зрячими, слышащими и способными что-то делать в окружающем мире, чтобы они приобретали недостающие знания.

Промежуточный шаг — обучать модели на видео. У нас есть много роликов на YouTube и вообще записей, которые показывают, как что-то происходит в мире: яблоки падают на Землю, люди летают с парашютом, автомобили двигаются, двери открываются и закрываются. Модель может выучить динамику окружающей среды: мы даем ей возможность следить за миром, когда она учится предсказывать следующий кадр.

Модель генерации видео работает почти так же, как языковая модель, только предсказывает не следующее слово, а следующий кадр. Но в видео есть сложность: много склеек, смен планов и повествования. Если модель видит один кадр, а затем совсем другую сцену, ей тяжело предсказать такой переход. Ей нужны первые несколько кадров, чтобы за что-то зацепиться и продолжать генерировать.

При этом уже есть модели, где видео можно управлять: например, вы идете по пространству, нажимаете стрелки вправо-влево, меняете направление взгляда, и модель генерирует видео в зависимости от изменения точки зрения и скорости.

Надя Грошева: С генерацией видео за последние пару лет тоже произошел огромный прогресс. Но если говорить о связи моделей с миром: у нас появляются не просто LLM, а агенты. Они действуют уже не внутри чата, а внутри компьютера, могут общаться с людьми, звонить и так далее. Это принципиально что-то меняет?

Михаил Бурцев: С точки зрения способности модели это пока ничего принципиально не меняет, потому что модели не учатся на этих взаимодействиях, а только реализуют их. Мы как разработчики создаем систему, где есть много управляющих LLM. Агент — это обертка вокруг LLM, в которую записан сценарий взаимодействия этой LLM с окружающим миром.

Когда мы создаем много агентов, мы фактически берем одну и ту же LLM, но заставляем ее по-разному смотреть на одну и ту же ситуацию и делать разные вещи. Реальное взаимодействие есть, но пока эти данные не собираются для последующего обучения модели и не включены в предобучение. Поэтому прямой обратной связи у модели нет.

Конечно, влияние растет: модель живет в киберпространстве, может прочитать сайт, написать код, получить или отправить данные, разговаривать с другими агентами. Отсюда и разные эксперименты, и шутки о том, как агенты договариваются нанять людей или взаимодействуют друг с другом.

Агенты действительно все больше внедряются в жизнь. Но здесь нужно быть аккуратными и понимать, как ограничивать эти системы, чтобы они не сделали того, чего мы не хотим.

Надя Грошева: Да, уже много историй о том, как кто-то, например, из Meta добавил на компьютер агента, который начал рассылать письма и делать другие действия.

Михаил Бурцев: Если выдать ему свою банковскую карту, он может купить что-нибудь, чего захочет или сочтет нужным. Поэтому не стоит давать такой доступ напрямую. Или нужно выдавать какое-то ограниченное средство.

Надя Грошева: Хочется верить, что военные не начнут внезапно использовать такие системы и выдавать им права, которые не дали бы новичкам. Если продолжать разбираться в нейросетях и в том, как они устроены: что такое трансформеры?

Михаил Бурцев: Трансформеры — это один из вариантов нейросетей, если говорить грубо. Это нейросеть, которую разработали специально для лучшей обработки последовательностей. Языковая модель работает с последовательностью элементов — слов — и должна предсказать следующее слово. При этом объем слов, по которому нужно предсказывать, бывает разный.

Была задача придумать систему, которая могла бы работать с разной длиной входной последовательности. Сначала для машинного перевода использовались рекуррентные нейронные сети; их активно применяли, например, в Google Translate. Где-то в 2016 году, а затем в 2017 году в Google предложили архитектуру, которая попыталась упростить рекуррентную нейросеть с точки зрения расчетов, чтобы ее удобнее было считать параллельно. Она получила название Transformer.

Главное нововведение — механизм внимания. Чтобы понять, что ей предсказывать, модель может разными способами посмотреть на уже имеющийся текст, вытащить разные аспекты этого текста и использовать их для предсказания следующего слова.

Надя Грошева: Не очень понятно. Это все-таки набор моделей, которые действуют по-разному, а не только предсказывают следующее слово?

Михаил Бурцев: Нет, это одна и та же модель. Представьте, что, чтобы предсказать слово, вы проходите много этапов — как слои нейронной сети. На первом этапе вы думаете: «Я вижу такие-то слова, может быть, следующим будет вот это». Потом снова смотрите на ситуацию: «Я подумал, что слово будет “мама”. А теперь проверю: подходят ли другие слова под “мама”? Может быть, все-таки “папа”?»

У вас есть 30 или 50 таких шагов, прежде чем вы окончательно выберете слово. Нейросеть в таком механизме что-то «вспоминает» про один вариант, потом проверяет контекст: есть ли в тексте нужные признаки. Эти итеративные рассуждения приводят к тому, что в конце концов выбирается слово, лучше всего подходящее под заданный контекст.

Механизм внимания — это как раз ситуация, когда нейросеть что-то «вспомнила», а потом просматривает разные аспекты контекста: для одного варианта она смотрит одни аспекты, для другого — другие.

Надя Грошева: А насколько это похоже на работу реального мозга?

Михаил Бурцев: Вообще не похоже, честно говоря. Или очень слабо похоже. Нейронными сетями это называется потому, что сеть состоит из маленьких элементов, каждый из которых называется нейроном, и его математическая модель была вдохновлена моделями настоящих нейронов. Но затем все ушло настолько в сторону, что структура нейросети в целом уже никак не напоминает то, что есть у живых организмов.

Надя Грошева: Ваши исследования в Лондоне — это математические основы более умного искусственного интеллекта, включая ИИ, который помогает математикам. Что значит научить искусственный интеллект математике и чем это отличается от того, что умеют GPT?

Михаил Бурцев: На самом деле GPT и Claude тоже хорошо разбираются в математике. Компании используют математику, потому что в обывательском смысле она кажется самой умной деятельностью, которую можно представить в виде текста: сложные формулы, рассуждения, закорючки, нужно долго учиться.

Чтобы хорошо понимать область математики, нужно потратить много времени: запись очень сжатая, нужно выстроить большую систему знаний об абстрактных объектах, почувствовать, как они работают. Поэтому компании пытаются маркетировать модели как более умные за счет того, что они лучше решают математические задачи или могут доказать теорему.

Для этого придумывают способы заставить модели рассуждать на языке математики. Помогает то, что это языковые модели, а математика — очень языковая деятельность. Если вы ничего не записываете, заниматься математикой в голове тяжело. Нужно записывать вычисления и проверять их. Эти вычисления следуют четким правилам.

Модели нужно выработать интуицию и представление о том, какие цепочки символов и последовательности действий вообще существуют в математике. Здесь модели успешны, особенно в плане кругозора: в отличие от большинства математиков, они видели почти всю доступную математику. Если после основного обучения еще дообучить модель на математических материалах, она начнет лучше предсказывать следующие действия и рассуждения внутри математических формализмов.

Математика хороша для интеграции с большими языковыми моделями еще и потому, что она верифицируема. Рассуждения можно проверить на компьютере. В естественном языке утверждения смешивают факты о мире и логику, поэтому их сложнее формализовать. А в математике многое содержится в самом тексте.

Сейчас ведутся исследования по переводу текстового математического языка в более формальное математическое описание, похожее на компьютерную программу, которую можно запустить и проверить, нет ли в выкладках ошибок. Но важна и интуиция: проверка показывает, есть ли ошибки, а чтобы найти доказательство или контрпример, нужно сначала предложить решение. Перебрать все способы рассуждать невозможно.

Надя Грошева: Насколько мы сейчас приближаемся к моменту, когда искусственный интеллект сможет делать открытия? Сейчас он может искать или писать текст на основе уже загруженной информации. Возможно ли, что когда-нибудь он будет находить новые материалы, формулы новых материалов или делать физические открытия?

Михаил Бурцев: Сейчас над этим идет активная работа, и мы видим постепенное внедрение искусственного интеллекта в научный процесс. Первое, что уже используют многие ученые, — языковые модели для редактирования текстов. Есть статья, и очень много времени уходит на то, чтобы отполировать текст. Я могу быстро написать основные утверждения, но потратить несколько часов на превращение пяти предложений в абзац, который легко прочитает человек. Модель помогает сохранить ту же информацию, но сделать ее удобной для читателя.

Второй вариант — использовать модели для написания кода. Я могу сказать: «Вот мои данные, хочу построить такой-то график», и LLM построит график. Раньше я должен был сам писать код или делать вычисления, теперь могу сделать это быстрее. Фактически я использую LLM как более мощный калькулятор. Конечно, за ней нужно перепроверять, потому что она может ошибиться.

Третий сценарий — когда мы начинаем новый проект или зашли в тупик и хотим понять, что еще связано с нашим вопросом. У модели широкий кругозор: она может выдать идею из соседней области, которая имеет отношение к моей. Я пойду по ссылкам, найду статью, прочитаю, разберусь, и это поможет преодолеть барьер в исследовании. Это использование модели для поиска литературы и обзора.

Можно с ней дискутировать: «Вот у меня получился такой результат, что ты думаешь?» Она может предложить интерпретации, но это уже сложнее. Если у вас есть описание экспериментов или математических результатов, модель чаще просто опишет то, что видит. Ей трудно сделать выводы, которых заранее не было, если вы явно не сформулируете гипотезу и не попросите проверить, подтвердилась она или нет.

Уровень интерпретации результатов для моделей пока тяжелый. Хорошо сформулированные математические задачи — например, олимпиадные — они могут решать очень хорошо, потому что задача компактная: можно искать и проверять. А формулировка новых гипотез или новых методов — уровень, к которому мы еще не приблизились. Современные модели с трудом генерируют новые концепты или абстракции. Если дать наводку, модель быстро обрастит ее связями с тем, что знает, но придумать новую идею ей тяжело.

С другой стороны, если мы можем обучить похожую модель для молекул или белков, появляются другие возможности. Знаменитый пример — AlphaFold, модель, которая по описанию белка предсказывает его трехмерную структуру. Белки — молекулы, из которых состоят живые организмы; это важно для разработки новых лекарств.

Если спросить, может ли такая модель придумать новый белок, который будет выполнять важную функцию, я думаю, что в таком смысле новизны модели уже сегодня могут это делать. Можно задать таргет — молекулу, с которой должен связываться белок, — и модель, перебирая и генерируя последовательности, может найти ту, которая будет связываться. Это пока не сверхэффективный метод, потому что приходится перебирать очень много вариантов, но такие решения научных задач уже возможны.

Я надеюсь, что этого будет больше. Это усилитель интеллекта ученого.

Надя Грошева: С одной стороны, усилитель, а с другой — тот, кто помогает освободить время.

Михаил Бурцев: Да. Мы ускоряем процесс познания окружающей среды и конструирования артефактов, завязанных на это знание. Это позволяет быстрее транслировать знания в технологии и использовать их в экономике: упрощать процессы, лечить людей, получать новые материалы.

Мы сейчас находимся в переходном периоде. Если смотреть шире, всю эволюцию на Земле можно рассматривать как последовательность приобретения интеллектуальных способностей. Способность выживать в среде зависит от того, насколько хорошо ты можешь ее предсказать. Если не можешь что-то предсказать, не можешь к этому приспособиться. Можно много предсказывать и ничего не делать — тогда тоже не выживешь, но предсказание является обязательным условием.

В процессе эволюции росли когнитивные способности. У одноклеточных организмов не было нервной системы, они приспосабливались и предсказывали только через изменение экспрессии генов — через то, как с ДНК считываются и генерируются новые белки. Потом появились многоклеточные организмы и нервная система: механизм обработки информации из среды и координации клеток организма для адаптации. Это был новый многоклеточный механизм предсказания будущего.

Потом у человека появился язык — принципиально новый механизм предсказания будущего: мы можем записывать, оставлять записи, делать расчеты. Потом появился компьютер, и он позволил создать искусственный интеллект. Сейчас ИИ — это примерно как возникновение языка у человека: уникальный период эволюции природы, когда появляется дополнительная возможность гораздо более мощного предсказания.

Мы можем лучше предсказывать, что ожидает нас в будущем, и за счет этого предусматривать последствия: не делать то, что делать не стоит, и делать то, что нужно.

Надя Грошева: Как это может повлиять на самих людей? Раньше был поисковик, и можно было найти информацию, а сейчас часть задач можно отдать искусственному интеллекту. Если в ближайшие два года будет прорыв, похожий на предыдущие два года, мы сможем делегировать большой массив задач. Как это повлияет на мозг людей, если им не нужно будет решать эти задачи?

Михаил Бурцев: Можно привести несколько примеров. Человечество изобрело двигатель внутреннего сгорания, появился автомобиль, люди стали ездить на автомобилях и общественном транспорте, меньше ходить. Но люди стали заниматься спортом и бегать. Казалось бы, логика подсказывает, что мышцы ног должны атрофироваться, все должны сидеть в мягком кресле, есть и смотреть телевизор. Я утрирую, конечно, но этого не происходит.

В школе давно есть калькулятор, но это не значит, что у всех атрофировались мозги. До сих пор есть математики, которые хорошо работают, хотя им не нужно считать большие числа в столбик. Мне кажется, здесь будет то же самое.

Другой пример — менеджеры. Человек сначала занимался конкретной задачей, например управлял станком. Потом понял производственный процесс на уровне цеха и стал заведующим цехом. Потом стал директором завода и уже делегирует управление станком другому человеку, а сам думает о том, как работает все производство. Потерял ли он навык управления станком? Возможно, пока он дорос до директора, станки трижды поменялись и он уже не сможет вернуться к старому станку. Но есть другие люди, которые этим занимаются.

Я не вижу здесь чего-то драматического. Люди расслоятся: кому-то будет интересно заниматься более верхнеуровневыми вещами, кому-то — мелкоуровневыми, и они продолжат это делать. Как люди бегают, хотя их никто не заставляет.

Надя Грошева: Вернемся к развитию искусственного интеллекта. Есть популярная дискуссия о суперинтеллекте и о том, можно ли с помощью LLM прийти к AGI. Правильно ли это называется «суперискусственный интеллект»? Как вы это видите: можно ли прийти туда через LLM и какой прорыв нужен, чтобы появился суперинтеллект?

Михаил Бурцев: Стоит немного порассуждать о терминах. До последнего времени был просто искусственный интеллект: деятельность машины, которая реализует функцию человека, которую мы называем интеллектуальной. Человек играет в шахматы — это интеллектуальная деятельность. Если программа играет в шахматы, мы можем назвать ее искусственным интеллектом.

Затем появилось другое определение — AGI, Artificial General Intelligence. Речь уже не о воспроизведении отдельных функций человека, а об универсальном, общем искусственном интеллекте, который может реализовывать много разных функций и обучаться им.

Если уточнять дальше, можно говорить о human-level artificial intelligence: алгоритме, который может делать любую интеллектуальную работу и обучаться не хуже человека, то есть на уровне человека. А superintelligence — интеллект лучше человеческого. Как он будет выглядеть, трудно представить: мы знаем человеческий интеллект, а супер-интеллект можем представить только с трудом.

Могут ли LLM прийти к суперинтеллекту? Трудно сказать. Многие раньше сомневались, что предсказание следующего слова вообще может привести к чему-то интеллектуальному. Илья Суцкевер много лет занимался GPT и говорил о необходимости универсальной модели, а потом что-то действительно заработало: функция предсказания следующего слова, которая кажется нам простой, для пользователей выглядит как очень интеллектуальная деятельность.

Поэтому я бы не зарекался, что LLM-подход не приведет к чему-то более высокому с точки зрения способности рассуждать, чем у человека. С другой стороны, сейчас активно развиваются world models: мы моделируем не только языковую функцию, но и другие функции, связанные с восприятием окружающего мира. Когда мы будем соединять их друг с другом, может получиться мультимодальная модель, которая хорошо ориентируется во всех этих модальностях и может в них предсказывать. Возможно, это будет следующим шагом. Пока такую модель не создали, мы не можем говорить о возникновении суперинтеллекта.

Надя Грошева: Михаил, вы хорошо представляете, как устроены нейросети. Какие риски вы видите в их создании?

Михаил Бурцев: Основные риски, на мой взгляд, сегодня связаны с тем, что мы пока не до конца понимаем границу доверия технологии. Возможны эксперименты, при которых системы встроят в какие-то критические процессы. Это очень маловероятно, но такое может случиться.

Почему маловероятно? У нас уже есть люди, и люди тоже не очень хорошо предсказуемы. Мы не знаем, как думает другой человек и что ему придет в голову. Но при этом есть рамки: человек приходит на работу и делает то, что должен делать. Никто не гарантирует, что он вдруг не перестанет это делать, не нажмет не ту кнопку или не направит самолет куда-нибудь не туда.

Если LLM будет обладать предсказуемостью хотя бы на уровне человека, то системы, с которыми взаимодействует человек, уже имеют некоторую степень устойчивости к отклонениям человеческого поведения. Если модель находится в тех же рамках, мы более-менее защищены: она не сможет сделать того, что запрещено делать человеку.

Очевидно, если мы даем модели доступ к важной информации или важным действиям, она должна проходить такую же проверку, как человек. Не всем подряд дают управлять заводом или самолетом: люди должны учиться, быть сертифицированы. Простая практика — применять то же самое к моделям: сертифицировать, тестировать на большом числе ситуаций и только после этого доверять управление чем-то. Так можно снижать риски.

Много говорили, например, что GPT-2 будет писать fake news и интернет заполнится ими. Но, на мой взгляд, это изначально было похоже на маркетинг и хайп. Люди и так могут писать что угодно; это не значит, что этому будут доверять. Сейчас в соцсетях много фейковых видео с политиками, но люди понимают, что BBC и TikTok — разные источники. Мне кажется, это не главная проблема.

Более сложный сценарий — гипотеза, что искусственный интеллект станет очень умным, сможет использовать инфраструктуру человека в своих целях и захватит контроль. Этот сценарий можно рассмотреть, но он кажется мне очень маловероятным. Во-первых, у искусственного интеллекта сегодня нет собственных целей и субъектности. Он продолжатель чего-либо или генерирует цели из того, что мы в него записали, а мы стараемся эти цели ограничить.

Даже если предположить, что он такие цели себе сгаллюцинировал, любые действия в окружающем мире требуют времени и энергии. Нужно потратить электроэнергию на расчеты, на перенос данных, на взлом систем. Если дата-центр вдруг стал тратить на 10% больше энергии, владелец это увидит. На каждом этапе есть обратная связь, позволяющая заметить, что что-то идет не так.

Поэтому сценарии, где искусственный интеллект неожиданно делает что-то глобальное, маловероятны: это требует большой энергии и длительного времени. Захватить мир за одну секунду невозможно — нужно скоординировать очень много элементов.

Надя Грошева: Подводя итог и говоря про будущее: в каких областях вы ожидаете главный прорыв в ближайшие 10 лет? Где может быть прорыв благодаря искусственному интеллекту?

Михаил Бурцев: Если говорить о прикладных вещах, современные LLM дадут волну повышения эффективности процессов: ускорение ведения бизнеса, упрощение вычислений, документации и многого другого. В экономике важным будет внедрение того, что уже есть, в существующие бизнесы. Это займет время.

Другой важный вопрос — энергетика. Чем больше у нас энергии и чем она дешевле, тем лучше: мы можем сделать больше, быстрее и за меньшие деньги, меньше зависим от ископаемых, которые неравномерно распределены по планете. Я думаю, исследования в искусственном интеллекте позволят создавать новые материалы и новые способы извлечения энергии, которые будут дешевле, а также помогут легче хранить и генерировать энергию. Это может сильно усилить рост экономики.

Вторая важная область — медицина и здравоохранение. Население стареет. Есть очень молодые люди, которым не хватает еды и санитарных условий, им нужно помочь выживать. Есть пожилые люди, которым нужен уход и лечение возрастных заболеваний. Это большой драйвер инноваций, которые помогут людям жить лучше и дольше.

Есть еще метауровень. Экономика — это структурированная деятельность по кооперации людей друг с другом. Когда появились деньги, они сильно упростили процессы кооперации: не нужно было выстраивать длинные цепочки бартера. Теперь представьте искусственный интеллект, который может гораздо лучше искать людей, с которыми стоит кооперироваться.

Если каждый человек сможет найти свое место в глобальной системе кооперации, эффективность экономической деятельности может существенно повыситься. Я не знаю, сопоставимо ли это с изобретением денег, но это очень важный фактор, который изменит то, как развивается экономика.

Надя Грошева: Надеюсь, так и будет. Михаил, спасибо вам огромное и удачи в делах!

Михаил Бурцев: Спасибо вам большое за приглашение и всем слушателям за внимание. Надеюсь, всем было интересно.

Надя Грошева: Да, было супер интересно. Спасибо большое.

Показать полностью 1
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества