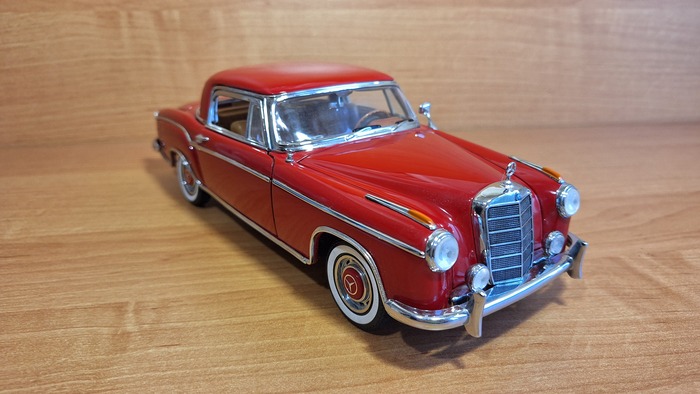
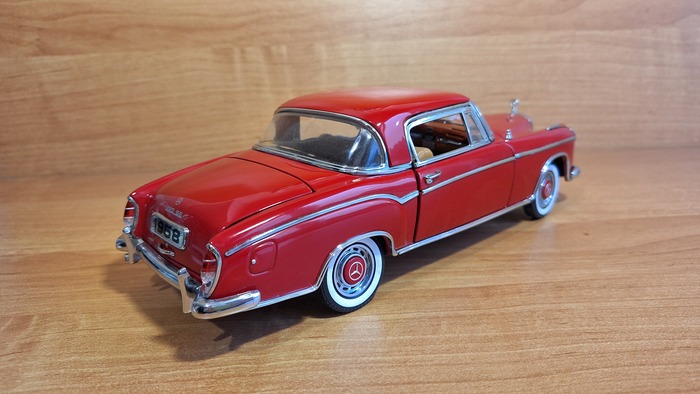
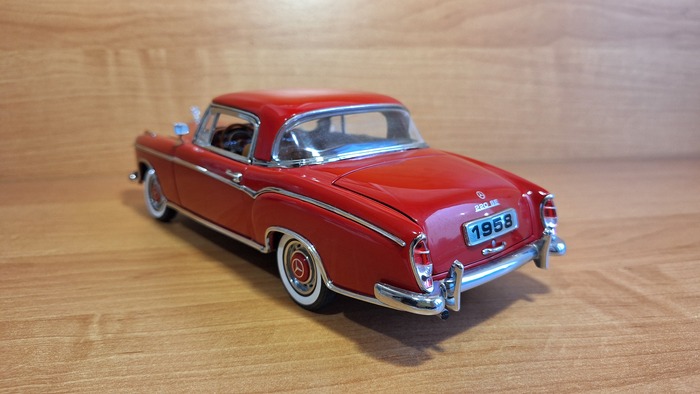
Mercedes-Benz 220 SE Coupe W128 1:18
Показать полностью
3
Первый серийный трактор СХТЗ-НАТИ сошёл с конвейера Сталинградского завода 11 июля 1937 года, а 17 сентября 1937 года — Харьковского.
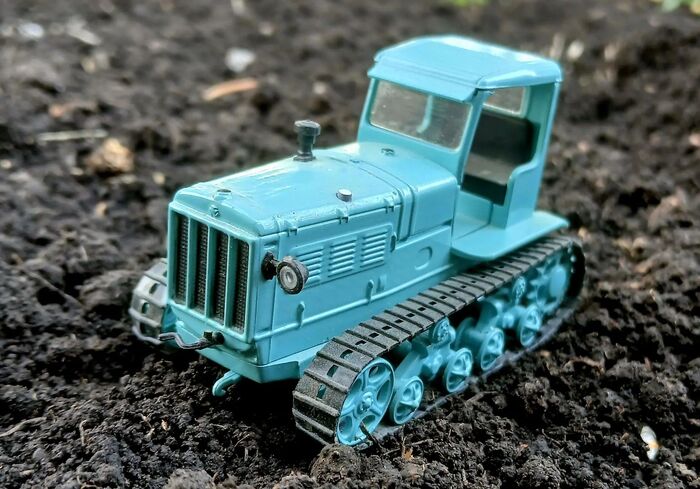
В годы Великой Отечественной войны Харьковский завод был эвакуирован в Рубцовск Алтайского края, где производство началось на создававшемся в военные годы Алтайском тракторном заводе. Первые тракторы вышли из цехов Алтайского завода в августе 1942 года. На Алтайском тракторном заводе производство продолжалось до 1952 года, после чего его сменили тракторы ДТ-54.
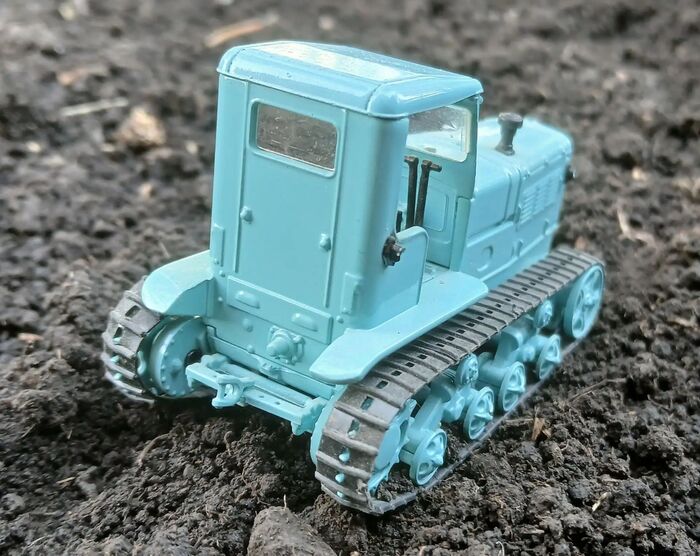
Разработка велась совместно Сталинградским тракторным заводом (СТЗ) и Научно-исследовательским тракторным институтом (НАТИ). В 1929 году специалисты НАТИ сформулировали технические требования к отечественным тракторам, которые позже легли в основу модели.
В 1938 году на Всемирной промышленной выставке в Париже трактор получил Большую Золотую медаль и диплом Гран-при.
Трактор был унифицирован как сельскохозяйственный и транспортный. Помимо сельского хозяйства, он должен был отвечать требованиям Наркомата обороны для использования в качестве артиллерийского тягача. В таком качестве СХТЗ-НАТИ применялся в Советско-финляндской войне 1939–1940 годов. В начале 1941 года они составляли почти пятую часть от общего парка механической тяги артиллерии Красной Армии. Использовались для буксировки орудий весом до четырёх тонн, главным образом в артиллерийских полках стрелковых дивизий.
Масштаб 1/43
На этой неделе меня шокировала новость о смерти Пресли Гербера - сына супермодели Синди Кроуфорд.
27 лет. Молодой, красивый, известная семья, модельная карьера, деньги, связи, Голливуд буквально под боком…казалось бы, у человека же есть всё для счастливой жизни.
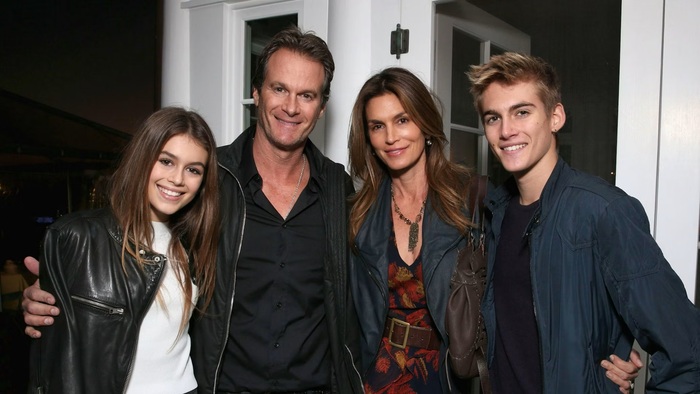
Но психическое здоровье не работает по принципу «чем больше у тебя денег, тем меньше тебе можно быть несчастным».
Пресли умер 20 сентября в реабилитационном центре в Санта-Монике. Официальная причина смерти пока не установлена: медицинский эксперт округа Лос-Анджелес сообщил, что нужны дополнительные исследования, а полиция расследует смерть как предполагаемую передозировку.
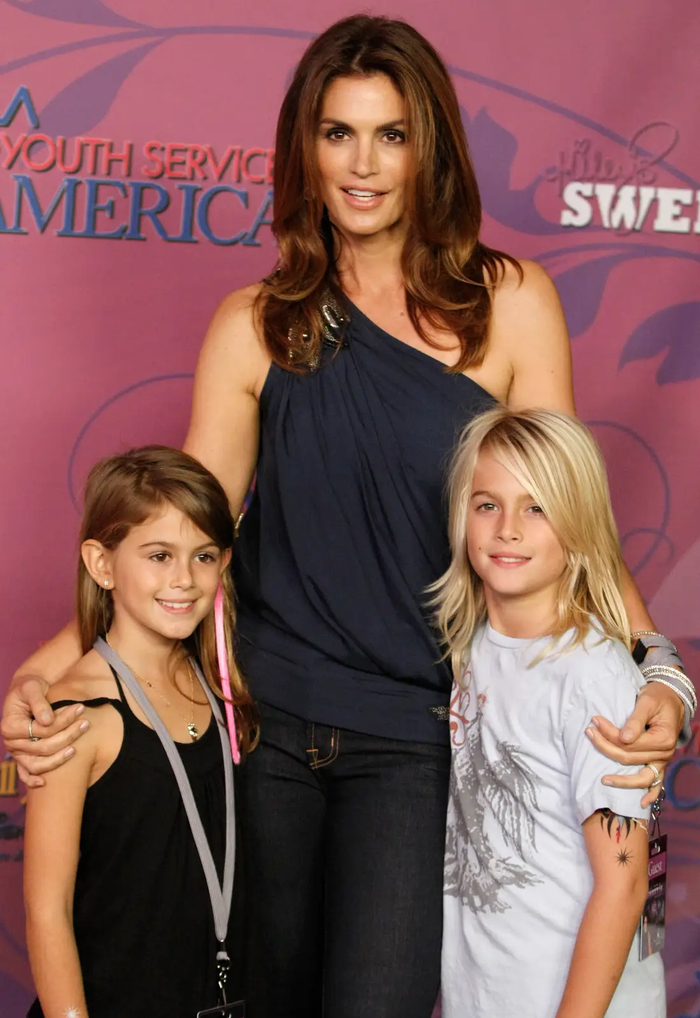
Пресли родился в 1999 году в Калифорнии в семье Синди Кроуфорд и Рэнди Гербера. Если Синди Кроуфорд знают практически все, кто хоть раз открывал глянцевый журнал, то Рэнди Гербер известен несколько в другой сфере. Он построил бизнес в индустрии ресторанов, баров и ночных клубов, а в 2013 году вместе с Джорджем Клуни и Майком Мелдманом основал бренд текилы Casamigos. В 2017 году компанию продали Diageo почти за миллиард долларов.
Но дети пары пошли именно в моду. Пресли начал модельную карьеру подростком (в 15 лет), а его младшая сестра Кайя Гербер заключила контракт в 13 лет. Довольно рано на мой взгляд. Хотя я понимаю, что в модельном бизнесе это вполне нормальный возраст. Но блин, 15 лет, это самый рассвет гормонов, бунтарства, те последние годы, когда заканчивается детство и нужно насладиться им по полной. Да и в целом зачем отдавать ребёнка в модельный бизнес в этом возрасте, когда благодаря родителям Пресли мог бы попасть туда во сколько угодно лет. Ну это знаете мои рассуждения, ни в коем случае не хочу винить в чем то родителей. Просто именно этот момент спорный для меня.
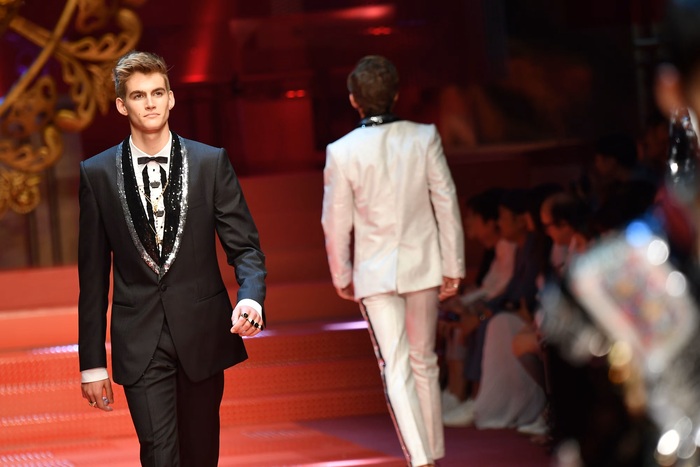
Но у Пресли действительно была довольно успешная карьера. Он работал с Dolce & Gabbana, Moschino, Tommy Hilfiger, Calvin Klein, Omega и другими брендами, а вместе с матерью снялся в рекламе Pepsi для Super Bowl 2018 года. Казалось бы - жизнь складывается идеально. Но уже в 19 лет у него появились серьёзные проблемы.
В 2018 году Пресли арестовали за вождение в нетрезвом виде. Он не стал оспаривать обвинение и получил три года испытательного срока, общественные работы и обязанность пройти программу, связанную с алкоголем.
А в 2020 году он ещё сильнее удивил публику, сделав татуировку на лице со словом misunderstood - «непонятый». Для модели это, мягко говоря, довольно смелое решение. Потому что одно дело - набить огромную татуировку на руке. А другое - буквально поставить её себе под глазом, когда твоё лицо является твоим рабочим инструментом.
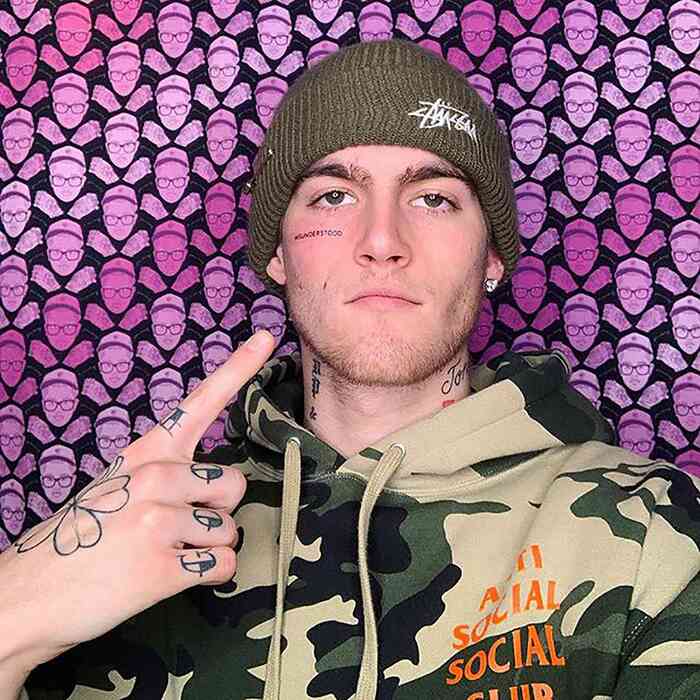
Позже Пресли всё-таки удалил татуировку. Но постепенно становилось понятно, что дело вообще не в моделинге. За внешне красивой жизнью происходили гораздо более серьёзные вещи.
В 2023 году Пресли открыто рассказал о своей депрессии и проблемах с психическим здоровьем в подкасте Studio 22.
А в конце 2025 года он опубликовал ещё более откровенное видео. Пресли рассказал о панических атаках, зависимости и сложном опыте лечения. По его словам, он обращался примерно к 15 психиатрам и всё равно чувствовал, что у него нет достаточно понятного плана в лечении. Он говорил, что разные специалисты предлагали разные варианты медикаментозной терапии, и ему было страшно от того, насколько сложно самостоятельно разобраться во всём этом.
Мы не знаем медицинской истории Пресли полностью. Мы не знаем всех его диагнозов, назначений, обстоятельств лечения и того, почему предыдущие методы не сработали.
Зато мы точно знаем, что сам Пресли чувствовал растерянность и продолжал искать способ выбраться из своего состояния.
В 2026 году он также рассказывал о лечении с использованием ибогаина в Мексике - альтернативном подходе, который он рассматривал в рамках борьбы с зависимостью.
И поэтому особенно тяжело видеть финал этой истории. Это история о том, насколько обманчиво может выглядеть благополучие...
С результатами Data Science мы сталкиваемся каждый день, даже если сами никогда не работали с данными и не обучали ни одной модели.
Вы открываете YouTube или Rutube — сервис решает, какие ролики показать вам следующими. Интернет-магазин предлагает товары, которые могут вас заинтересовать. Почта пытается отличить обычное письмо от спама. Банк оценивает риск при выдаче кредита. Такси рассчитывает, сколько займёт поездка. Антифрод-система определяет, похожа ли операция по карте на обычную или на мошенническую.
Во всех этих случаях есть одна общая идея: у нас есть данные о том, что уже известно, и мы хотим на их основе получить ответ на вопрос, которого в этих данных напрямую нет, например:
какое видео заинтересует пользователя;
сколько будет стоить квартира;
вернёт ли клиент кредит;
окажется ли автомобиль проблемным;
похожа ли банковская операция на мошенничество;
что человек с большей вероятностью купит в следующий раз.
Грубо говоря, Data Science занимается тем, чтобы находить в данных закономерности, проверять их и использовать для решения таких задач. Но когда смотришь на эту область со стороны, всё кажется несколько проще, чем оказывается на практике.
До того как я начал обучение, моё представление об этой работе было примерно таким:
данные + модель = предсказание.
В каком-то смысле так оно и есть. Допустим, у нас есть данные о десятках тысяч подержанных автомобилей: марка, модель, год выпуска, пробег, мощность двигателя, комплектация, регион продажи и другие характеристики.
С этими данными можно решать совершенно разные задачи.
Например, можно попытаться определить справедливую рыночную цену автомобиля. Мы показываем модели множество машин с уже известными ценами, а затем передаём характеристики нового объявления. На выходе получаем ориентировочную стоимость: условно, такая машина при таких параметрах должна стоить около 2,5 миллиона рублей.
Именно что-то подобное мы уже видим на площадках по продаже автомобилей. Вы выставляете машину за 2,3 миллиона, а сервис показывает, что цена ниже средней по рынку и предложение выглядит выгодным. Или наоборот — что автомобиль заметно дороже похожих вариантов. За простой надписью вроде «хорошая цена» уже стоит работа с большим количеством накопленных данных.
Но на тех же данных можно поставить и другой вопрос. Например: насколько велика вероятность, что автомобиль окажется проблемным? Тогда нас интересует уже не конкретная цена, а категория или вероятность: условно, этот автомобиль похож на нормальные машины, а у этого сочетание возраста, пробега, цены и других характеристик чаще встречалось у проблемных экземпляров.
Получается, данные могут быть почти теми же, а вопрос к ним — совершенно другим. В одном случае мы хотим получить число, в другом — определить категорию или вероятность события.
И самое интересное, что непосредственно запустить обучение такой модели технически может быть довольно просто. Иногда это действительно несколько строк кода. Основная работа начинается вокруг них.
Слово «модель» звучит сложнее, чем сама базовая идея. В самом простом представлении модель — это математическая зависимость, которая получает набор значений и на их основе выдаёт результат.
Допустим, мы хотим оценить стоимость квартиры. У неё есть площадь, количество комнат, этаж, расстояние до центра, возраст дома и множество других характеристик.
Очень упрощённо это можно представить так:
цена = базовое значение + площадь × коэффициент + комнаты × коэффициент + ...
Переменных может быть пять, пятьдесят или значительно больше. У каждой из них есть свой коэффициент, влияющий на итоговый результат. Подставили характеристики одной квартиры — получили, например, 5 миллионов. Подставили другую площадь, другой этаж и другое количество комнат — получили 10 миллионов.
Конечно, реальные модели могут быть намного сложнее такой формулы. Но основная идея сохраняется: мы передаём модели некоторый набор данных, а она по определённому математическому правилу рассчитывает результат.
При этом коэффициенты внутри модели нам необязательно придумывать самим. Можно взять тысячи квартир, для которых цена уже известна, и подобрать такие коэффициенты, при которых расчёт модели будет как можно ближе к реальным ценам.
Это и есть обучение модели.
Мы не говорим ей заранее, сколько именно должна добавлять к цене дополнительная комната или один квадратный метр. Мы показываем множество примеров и подбираем параметры так, чтобы модель как можно меньше ошибалась.
И вот здесь возникает более важный вопрос: какие именно данные мы передали модели и насколько им вообще можно доверять?
Представим, что мы хотим определять стоимость квартиры. Можно собрать таблицу из нескольких десятков тысяч объявлений и сразу начать обучение, но сначала придётся ответить на гораздо менее эффектные вопросы.
Откуда взялись эти данные? Есть ли в них ошибки? Что делать с пропущенными значениями? Почему одна квартира стоит 200 тысяч, а другая — 200 миллионов? Является ли такая цена реальной или это ошибка в объявлении?
Дальше возникают вопросы уже не про качество самой таблицы, а про то, что именно мы хотим дать модели:
какие характеристики квартиры действительно имеют значение;
как представить район;
что делать с текстовым описанием;
нужно ли учитывать дату публикации;
какие данные будут доступны в тот момент, когда модель начнут использовать в реальной работе.
Если подготовить данные плохо, модель совершенно честно научится на плохо подготовленных данных. Она не знает, что мы ошиблись.
Здесь хорошо вспоминается выражение про «ложь, наглую ложь и статистику». Проблема не в том, что статистика врёт. Компьютер как раз очень добросовестно посчитает то, что мы ему поручили.
Проблема в другом: правильный ли вопрос мы задали и правильные ли данные использовали для ответа на него.
После обучения нужно понять, насколько хорошо модель работает. Для этого используются различные показатели качества — метрики.
И здесь снова возникает ловушка: получить красивое число довольно легко. Гораздо важнее понять, что именно оно означает.
Представим, что банк анализирует операции по картам. Из каждой тысячи операций только десять являются мошенническими. Можно сделать простейшую систему, которая всегда отвечает: «Любая операция нормальная».
В 990 случаях из 1000 она окажется права. Получается 99% правильных ответов.
На первый взгляд — почти идеальный результат. Только система не обнаружила ни одной мошеннической операции.
Поэтому в Data Science нет одного универсального числа, которое всегда позволяет сказать: эта модель хорошая, а эта плохая.
Есть метрики, которые оценивают модель сложнее, чем простой подсчёт правильных ответов. Например, AUC.
Само название сейчас не так важно. Важнее понять смысл.
Во многих задачах модель сначала не говорит жёстко «да» или «нет». Она выдаёт некоторую оценку. Например, для банковской операции это может выглядеть как вероятность:
почти точно нормальная — 0,03;
уже выглядит подозрительнее — 0,42;
очень похожа на мошенничество — 0,91.
После этого мы сами решаем, начиная с какого значения считать операцию подозрительной.
AUC позволяет оценить, насколько хорошо модель в целом умеет располагать подозрительные операции выше обычных. Если взять одну мошенническую операцию и одну нормальную, хорошая модель должна чаще присваивать мошеннической более высокий уровень риска.
Это полезный показатель, но он всё равно не принимает решение за нас. Можно построить модель, которая хорошо расставляет операции по степени риска, а затем выбрать настолько высокий порог, что ни одна операция не будет признана мошеннической.
Способность модели различать объекты при этом может оцениваться хорошо, а работающая система не поймает ни одного нужного случая.
Поэтому мало получить хорошую цифру. Нужно понимать, что именно она показывает и соответствует ли это реальной задаче.
Если для нас особенно опасно пропустить мошенничество, важно понимать, сколько настоящих мошеннических операций мы обнаруживаем. Если же каждая ошибка приводит к ручной проверке и дополнительным расходам, нужно учитывать и количество ложных тревог.
Одна и та же модель может хорошо выглядеть по одному показателю и плохо — по другому.
Есть ещё одна проблема. Представим школьника, которому дали десять задач, а потом по этим же десяти задачам провели экзамен.
Он может просто запомнить ответы. Результат будет великолепным, но мы так и не узнаем, научился ли он решать новые задачи.
С моделями происходит примерно то же самое. Если проверять качество на тех же данных, на которых модель обучалась, можно получить красивый результат, который ничего не скажет о её способности работать с новыми данными.
Поэтому данные разделяют. Одну часть используют для обучения, другую — для проверки, а часть стараются вообще не трогать до самого конца.
Но даже простого разделения иногда недостаточно. Если мы пытаемся прогнозировать будущее, нельзя обучить модель на октябрьских данных, а потом проверять её на августовских. Если данные относятся к одним и тем же людям, компаниям или устройствам, может быть важно не допустить ситуацию, когда информация об одном объекте попала сразу и в обучение, и в проверку.
Иначе модель получит подсказку, которой у неё не будет в реальной работе.
Получается ещё одна большая часть работы специалиста по данным: не просто построить модель, а придумать способ честно проверить, действительно ли она чему-то научилась.
Допустим, данные подготовлены, модель обучена и первая проверка проведена. Работа всё равно не закончена.
Можно попробовать другие данные, убрать бесполезные характеристики, добавить новые, сравнить несколько моделей, изменить параметры обучения. Потом посмотреть, на каких примерах модель ошибается, и проверить, не начала ли она просто запоминать обучающие данные вместо поиска общей закономерности.
После этого можно провести финальную проверку на данных, которых модель раньше вообще не видела.
И иногда после всех улучшений оказывается, что новая версия работает хуже старой. Или прекрасно показывает себя на промежуточной проверке, но значительно хуже — на данных из другого периода. Или сложная модель практически ничего не выигрывает у простой.
Это не обязательно означает, что кто-то всё сделал неправильно. Это и есть нормальная работа с данными: выдвинуть предположение, проверить его, посмотреть на результат и попытаться понять, почему получилось именно так.
Наверное, именно это сильнее всего изменилось в моём представлении о Data Science после первых учебных проектов.
Со стороны кажется, что основная работа заключается в самой модели: выбрать правильный алгоритм, запустить обучение и получить результат. Но непосредственно обучение зачастую оказывается одной из самых коротких частей процесса.
Полная цепочка выглядит скорее так:
получить данные
понять их
очистить
подготовить
выбрать нужные характеристики
правильно разделить данные
обучить модель
выбрать способ оценки
проверить
разобраться в ошибках
изменить подход
проверить снова.
И только где-то посередине находится непосредственно обучение.
Можно условно сказать, что большая часть работы специалиста по данным остаётся за кадром. Пользователь YouTube видит рекомендацию следующего ролика, клиент банка — решение по кредиту, водитель такси — рассчитанное время поездки, покупатель интернет-магазина — список рекомендуемых товаров.
Но они не видят все решения, которые были приняты до того, как система смогла показать этот результат.
Модель — только один из инструментов. До неё находятся данные, постановка задачи и подготовка. После неё — проверка, оценка качества и интерпретация результата.
И именно здесь возникает большая часть интересных вопросов:
почему модель прекрасно работает на обучающих данных, но ошибается на новых;
почему 99% правильных ответов иногда означают совершенно бесполезную систему;
почему более сложная модель может работать хуже простой;
как модель может случайно получить информацию, которой у неё не должно быть;
что происходит, когда она запоминает данные вместо того, чтобы находить закономерность.
По мере обучения я хочу разбирать такие вещи отдельно — не как набор определений из учебника, а на конкретных экспериментах, где результат сначала выглядел одним образом, а затем приходилось разбираться, что произошло на самом деле.
Оформление специального ИП для российского подразделения design19studio уже завершено, а значит, скоро запустится и обновлённый сайт, появятся специальная группа ВК и канал в Максе, и всякое другое

А пока просто немного внутренней кухни для тех, кому интересно
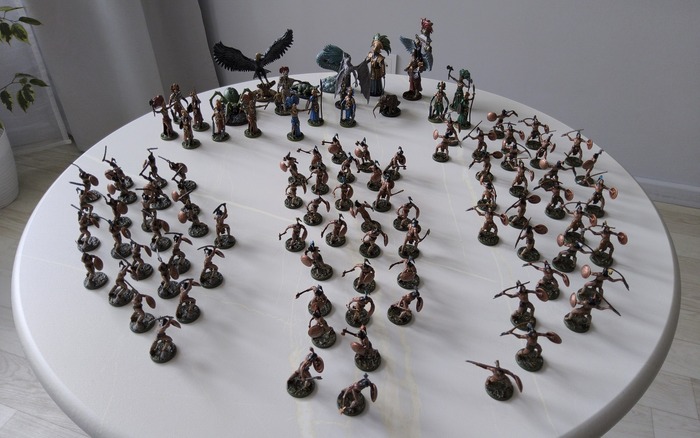
На картинке выше комплект покрашенных миниатюр из настольной игры Юкатан расставлен на столе в одном из помещений студии
Перед окончательной упаковкой все покрашенные модели проходят дополнительную проверку - модели тщательно осматриваются со всех сторон на предмет наличия возможных дефектов
А ну как коготь вон того дракона забыли заполировать? Всякое бывает
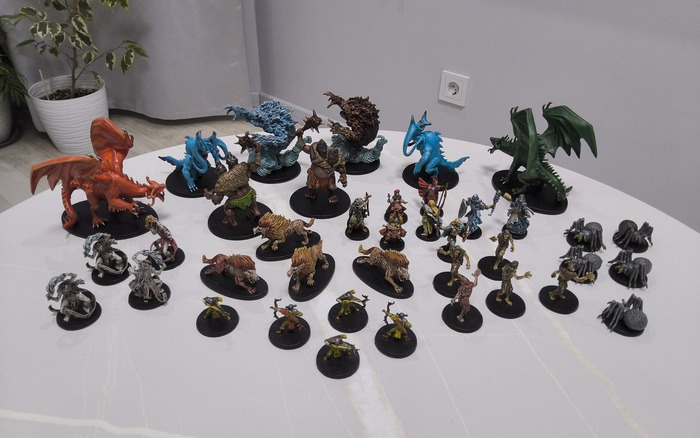
Комплект миниатюр из Descent Вторая Редакция
Затем специальным скребком с нижней стороны подставок счищается попавшая на них краска - модели из настолок не должны царапать игровое поле
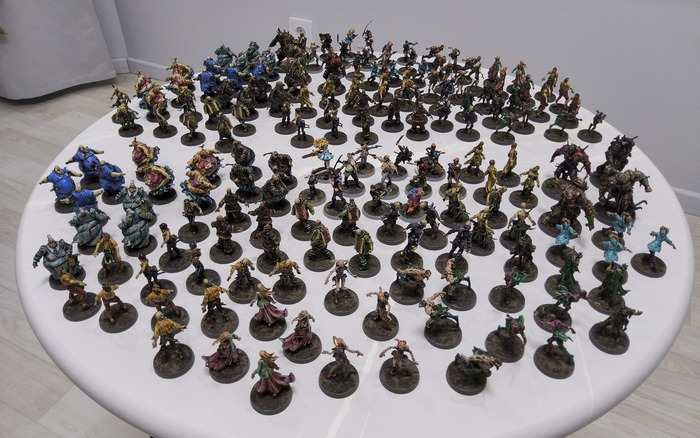
Два комплекта из второй редакции Зомбицида - это очень популярная игра, студия сделала десятки покрасов различных вариантов настолки
Затем модели отправляются на лакировку
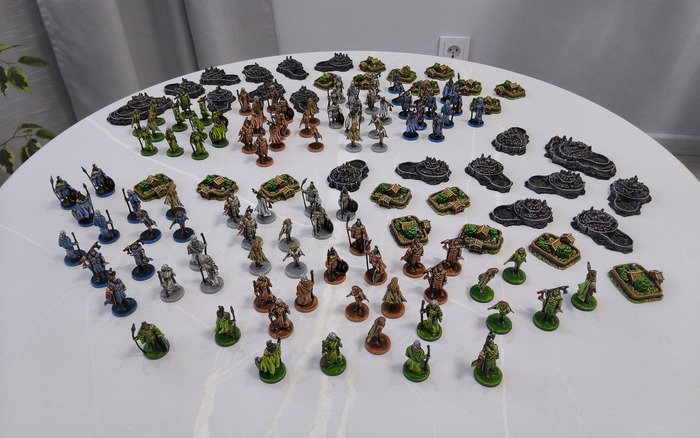
Два комплекта Иниш - пасмурная Ирландия, как она есть
Лакировка приглушает ненужный блеск и придаёт защиту от истирания. Лучший лак из протестированных на данный момент - матовый Mr. Hobby
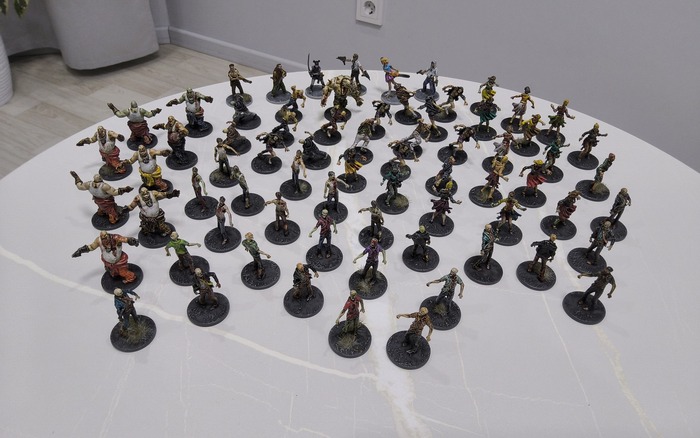
А вот и ещё один Зомбицид
Проработанная и последовательная система финального этапа работы над моделями не даёт сбоёв. Всё делается быстро и качественно
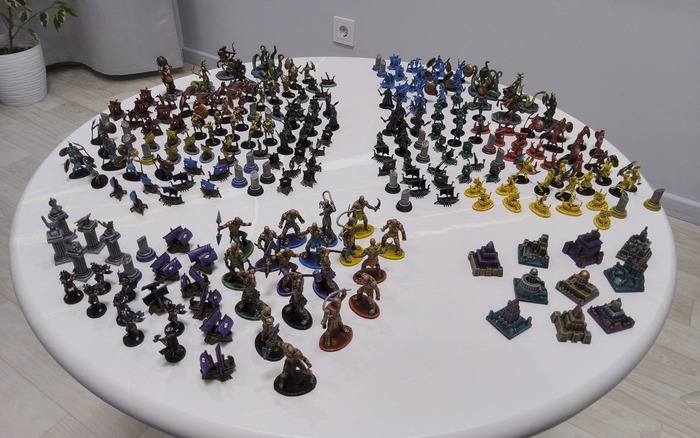
Несколько комплектов древне-греко-мифологических Киклад - база, база в монохроме, дополнения...
После лакировки модели какое-то время сушатся - лак должен полностью высохнуть перед тем, как начнётся упаковка
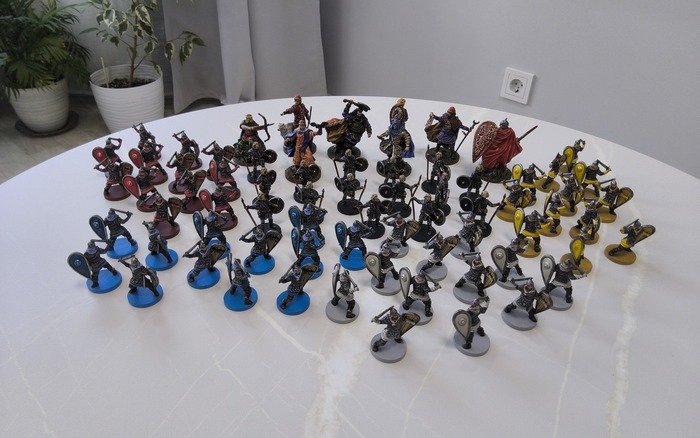
Комплект из стратегии Рюрик
Если погоды нонче стоят влажные - 100% высыхание может занять сутки или больше. Нам не жалко, мы подождём. Главное - гарантия завершённости процесса
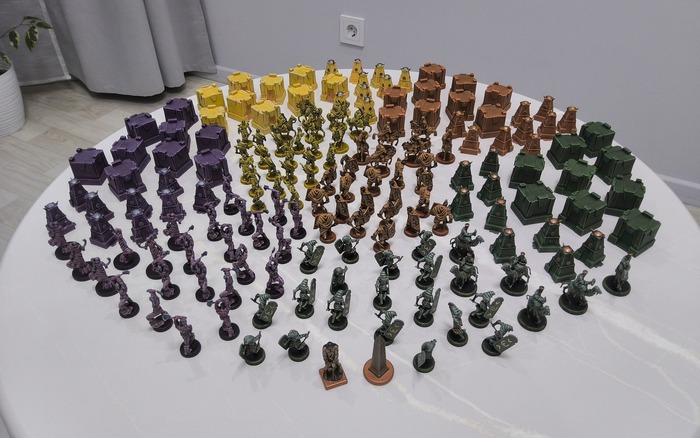
Армии из монохромной Эры Конана
После высыхания модели упаковываются в прочные новенькие зип-пакетики - по одному на каждую миниатюру
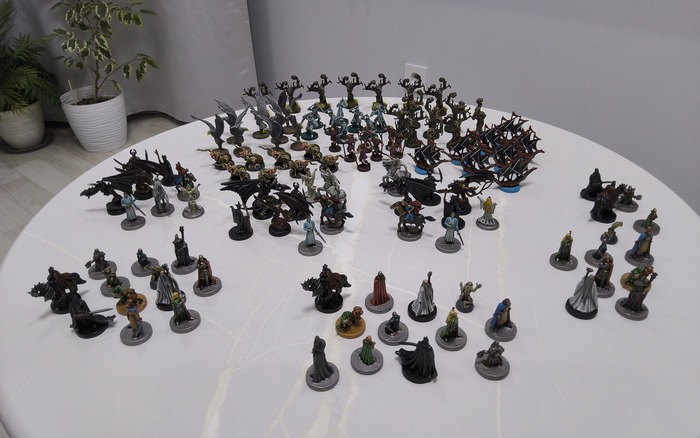
Дополнения к Войне Кольца и несколько отдельных наборов героев - для тех, кому нужен не покрас всего большого комплекта, а только именные персонажи
Миниатюры не должны соприкасаться друг с другом во время транспортировки, даже несмотря на защитный лак - поэтому, если в игре сто миниатюр, значит, надо подготовить сотню зип-пакетиков
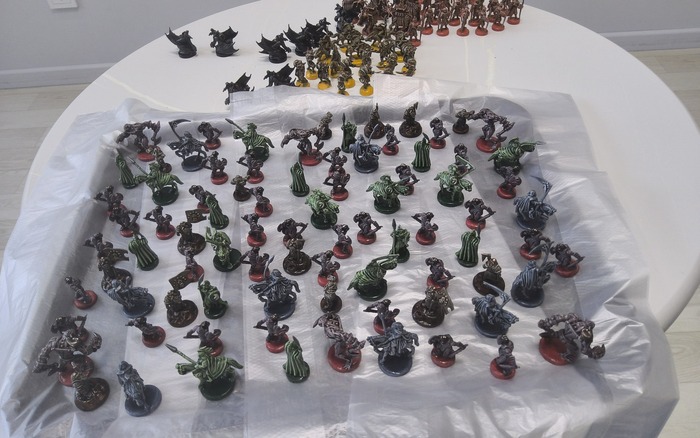
Расстановка на лакировочном подносе. Рост этих моделей небольшой - значит, можно поставить поплотнее. Лак точно попадёт на все поверхности
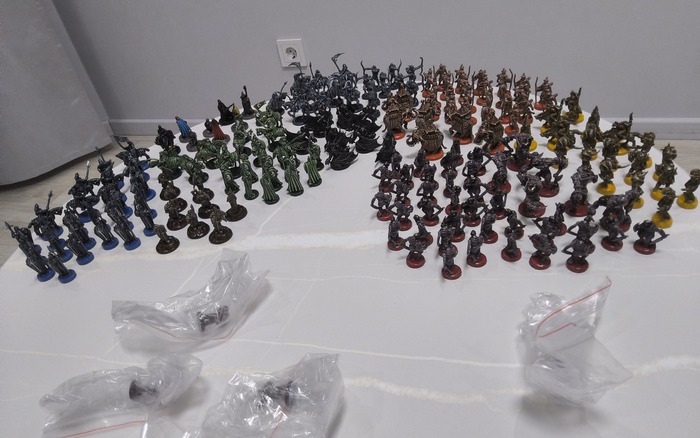
Упаковка в зип-пакетики. Процесс занимает время, но он необходим
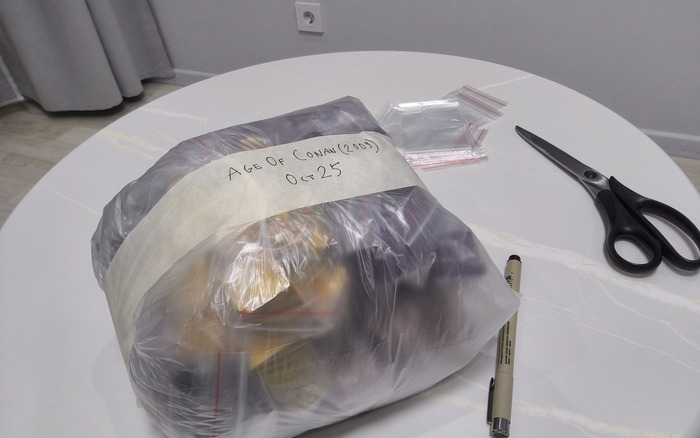
Наборы, которые покрашены не под спец-заказ, а на продажу, пакуются в кульки, которые едут на склад
А вот так выглядят покрашенные комплекты на студийных фотосессиях -


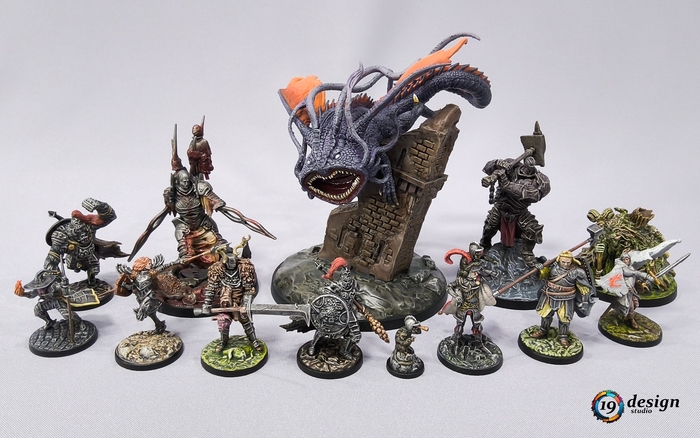
Но design19studio - это не только настолки, а ещё и покрашенные 3D-печатные модели -
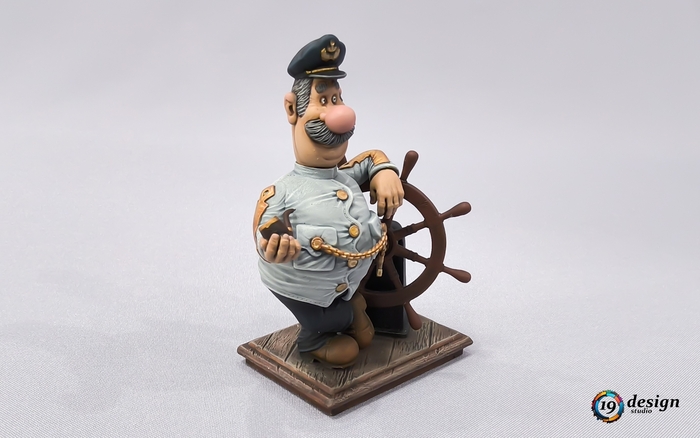
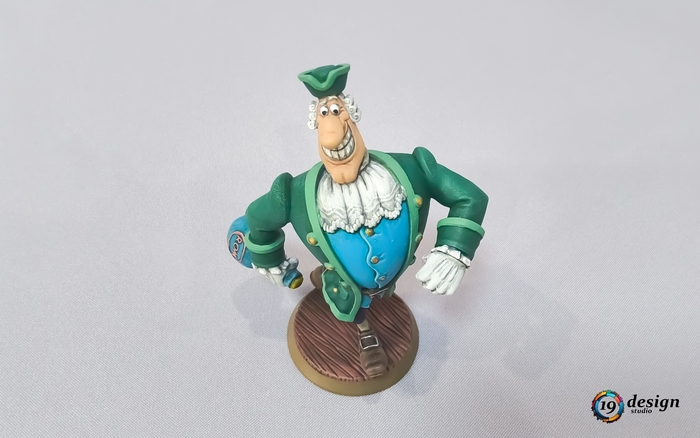
Если кто спросит "а когда начнётся публикация ДМБ 40.000 и курса Как Красить Игровые Миниатюры 3.0" - так уже на следующей неделе
А вот художественные рассказы про берсеркера Кьятве - только после набора 5.000 подписчиков у этого профиля. Осталось 1.536 1.532
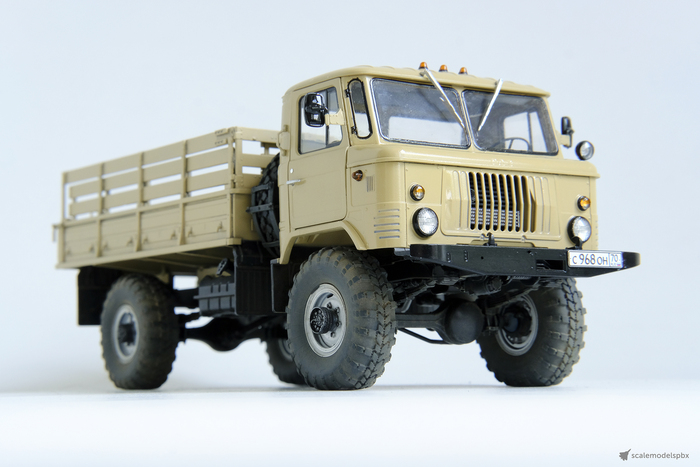
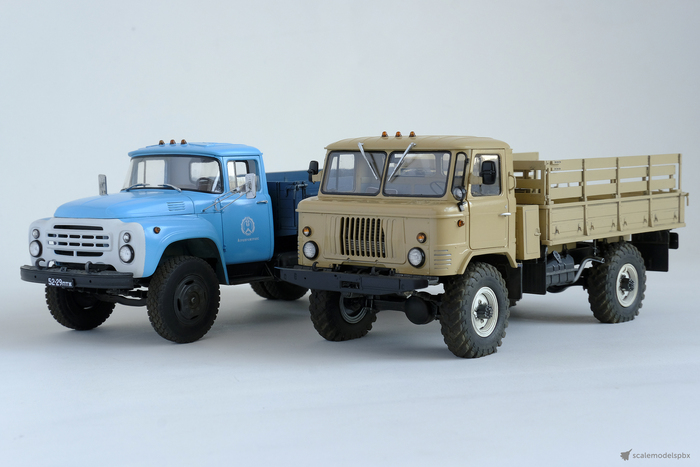
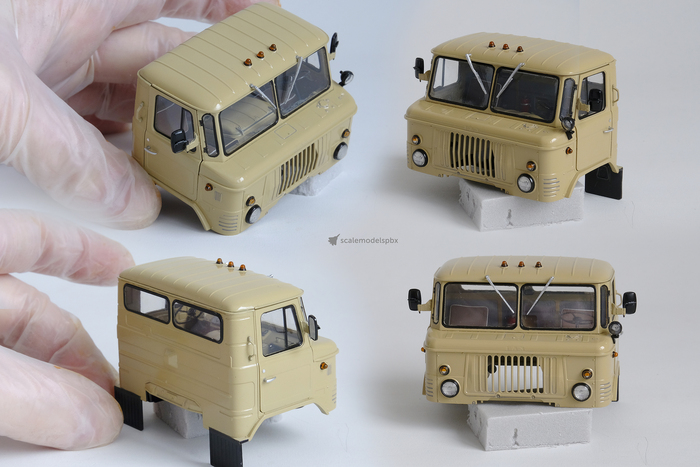
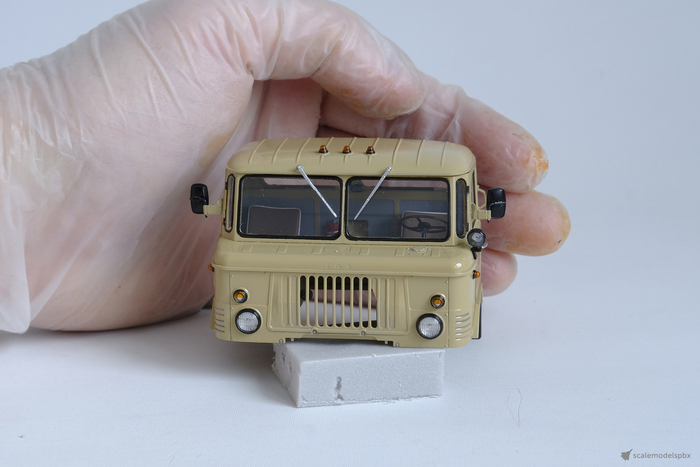
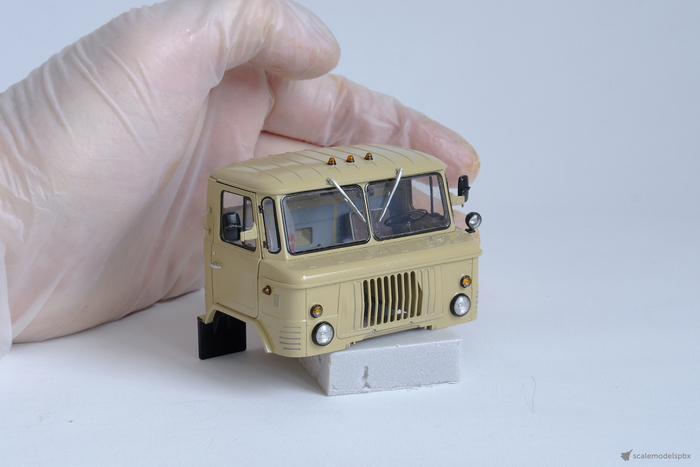
Масштабная модель ГАЗ-66, Звезда + Embase + Э.В.М., 1:35
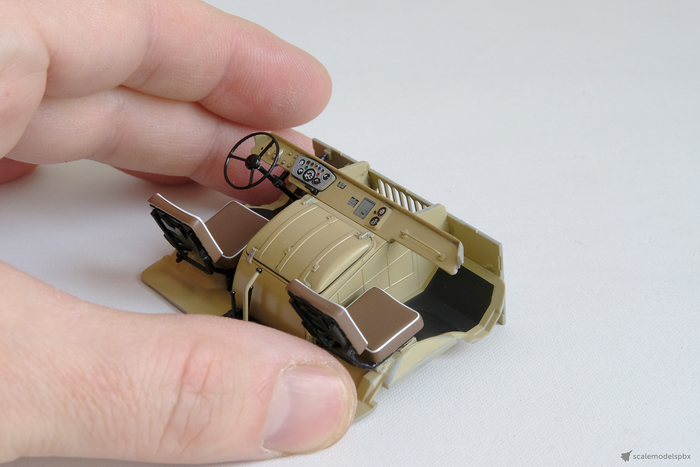
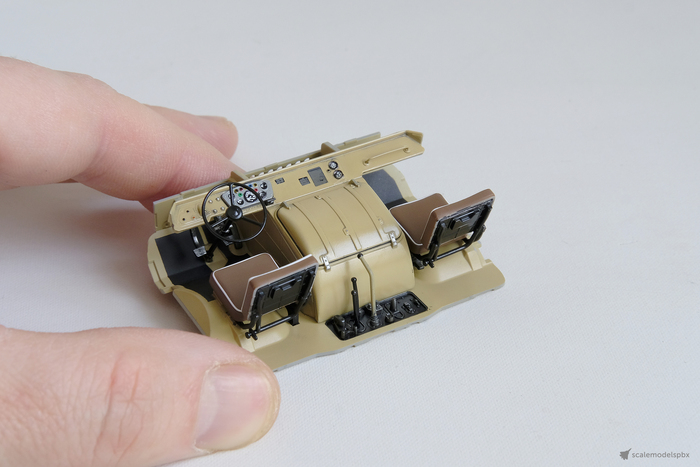
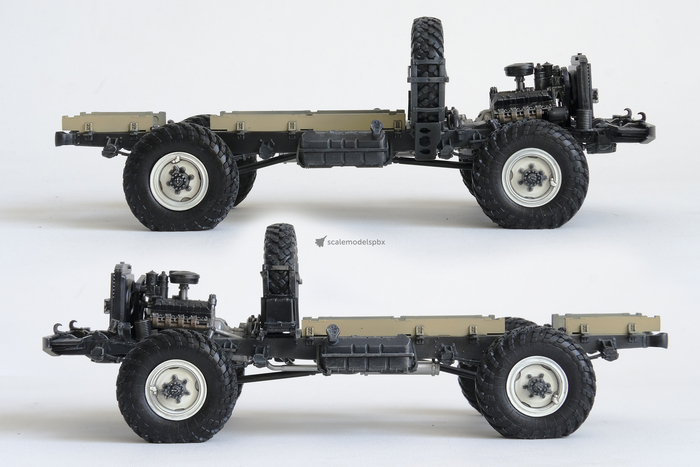
Всем привет! Отличная коробка, но действовать нужно очень внимательно и аккуратно. Предположу, что малейшая ошибка может привести к цепочке нестыковок, очень насыщенна большим количеством деталей, тут будет сложнее в сравнении с ЗИЛ-130. Модель собрана без проблем, получился отдых от авиации. Большое количество ажурных, с тонким литьем деталей. Единственное, что пришлось сделать тоньше это традиционно дворники и боковые ручки, подложка для оптики - аллюминиевый скотч. Краску мешал самостоятельно из GSI и Тамии (С321 + С316 + XF59), лаки GX100 и GX 113. Баланс между глянцевыми, полуматовыми и матовыми поверхностями. Тонировал при помощи смывок от Тамии, масло Невская палитра (серый, коричневый, черный), пылил пастельными мелками (микс рыжего, серого, белого).
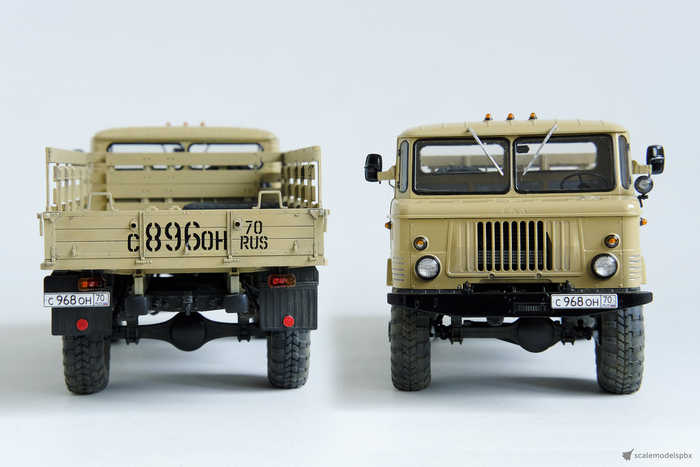
Масштабная модель ГАЗ-66, Звезда + Embase + Э.В.М., 1:35
Долгое время не давали мне покоя вероломно подпиленные штатные резиновые колеса на моем ГАЗ-66, поэтому решил поменять их на 3D печатные из смолы от компании Э.В.М. Колеса мне очень понравились качеством, высокая детализация рисунка и очень точная подгонка деталей. И они без лишних танцев устанавливаются на штатные места модели. Еще я добавил номерные знаки от Embase, теперь на этом можно и успокоиться, поставить на полку.
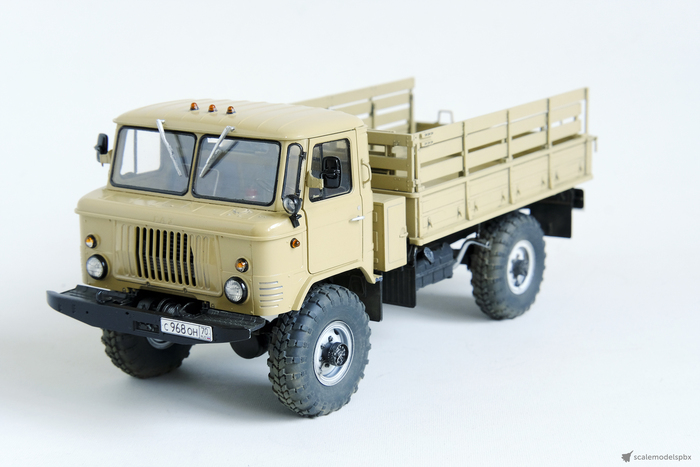
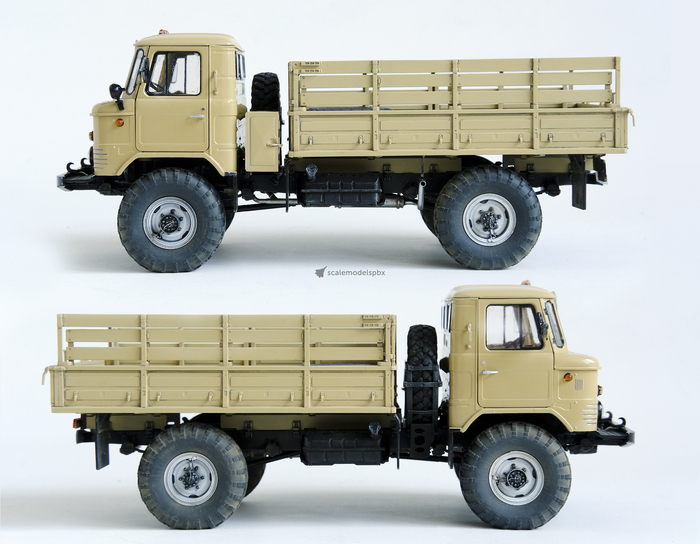
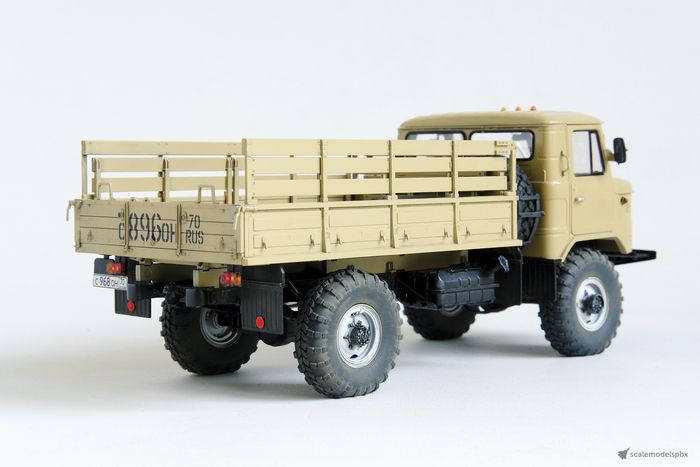
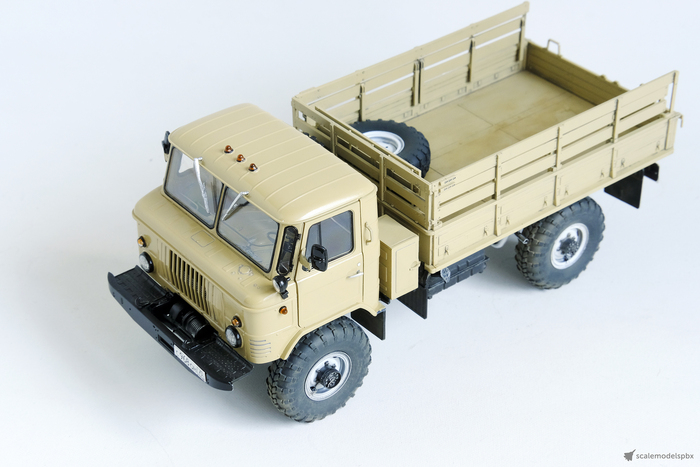
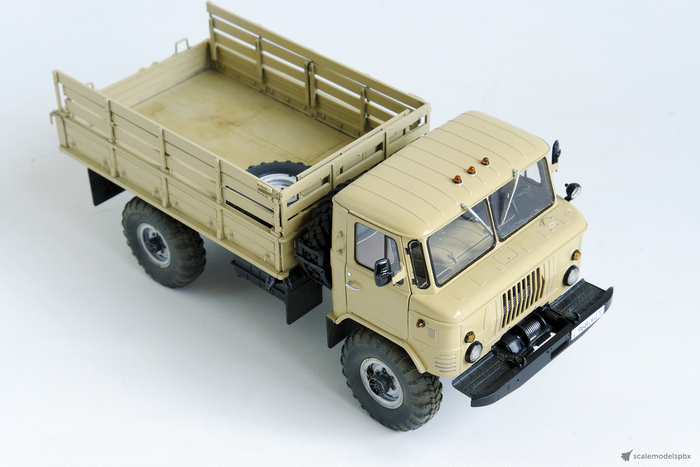

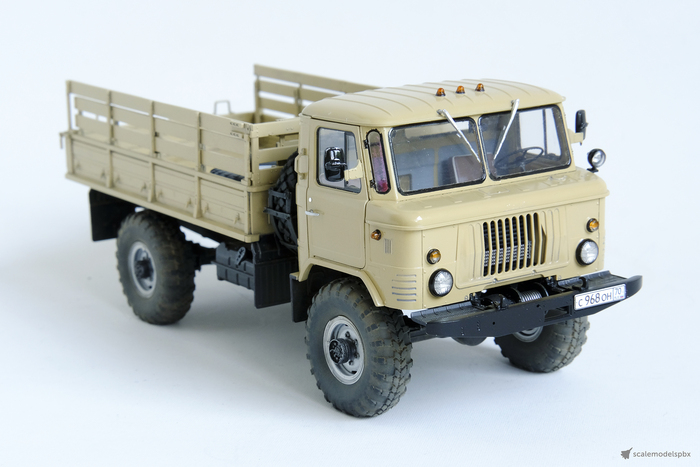
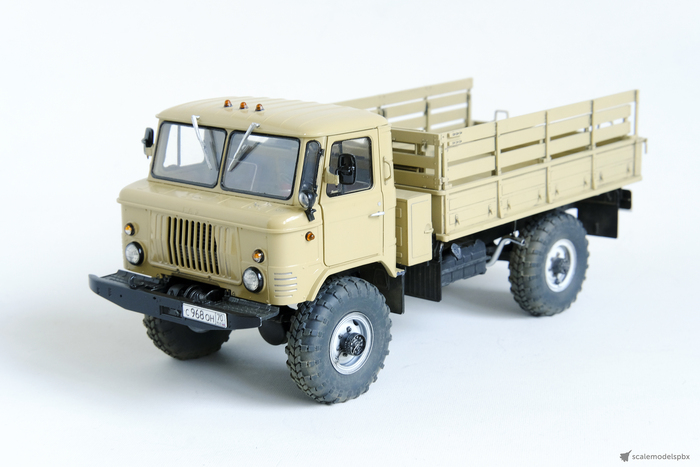
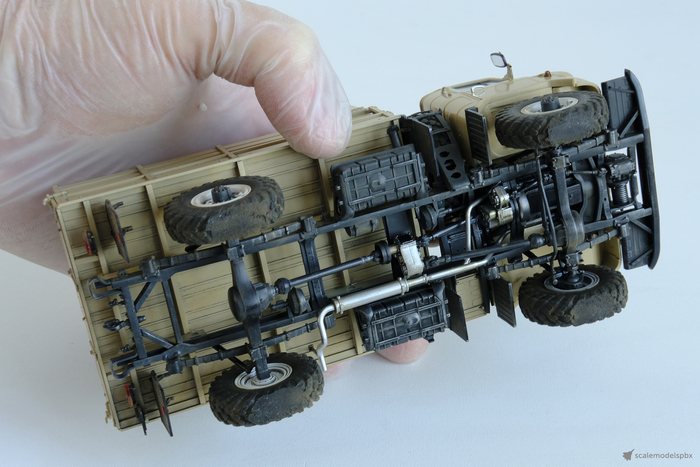

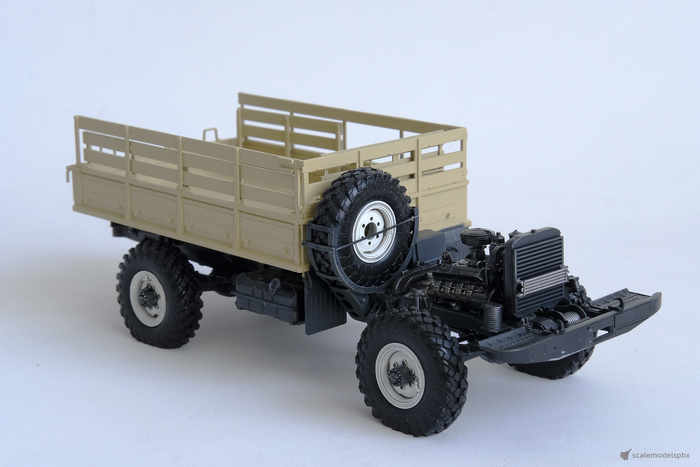
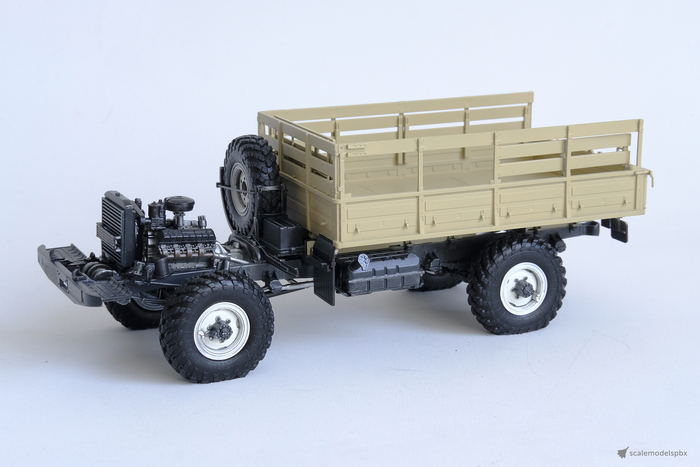
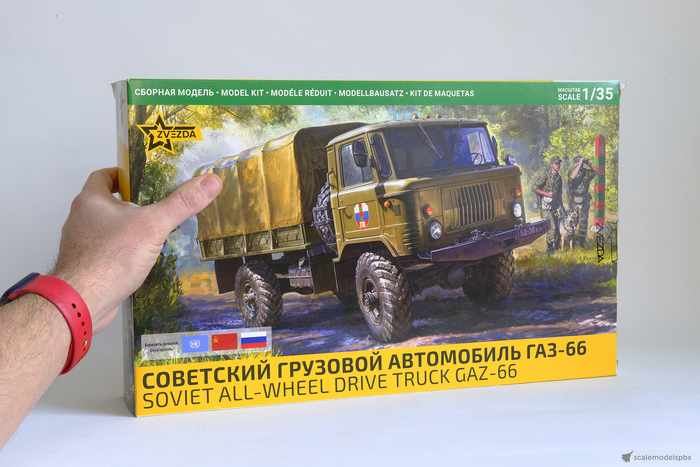
Масштабная модель ГАЗ-66, Звезда + Embase + Э.В.М., 1:35