
Data Science
2 поста
2 поста
1 пост
По запросам постоянных читателей
С результатами Data Science мы сталкиваемся каждый день, даже если сами никогда не работали с данными и не обучали ни одной модели.
Вы открываете YouTube или Rutube — сервис решает, какие ролики показать вам следующими. Интернет-магазин предлагает товары, которые могут вас заинтересовать. Почта пытается отличить обычное письмо от спама. Банк оценивает риск при выдаче кредита. Такси рассчитывает, сколько займёт поездка. Антифрод-система определяет, похожа ли операция по карте на обычную или на мошенническую.
Во всех этих случаях есть одна общая идея: у нас есть данные о том, что уже известно, и мы хотим на их основе получить ответ на вопрос, которого в этих данных напрямую нет, например:
какое видео заинтересует пользователя;
сколько будет стоить квартира;
вернёт ли клиент кредит;
окажется ли автомобиль проблемным;
похожа ли банковская операция на мошенничество;
что человек с большей вероятностью купит в следующий раз.
Грубо говоря, Data Science занимается тем, чтобы находить в данных закономерности, проверять их и использовать для решения таких задач. Но когда смотришь на эту область со стороны, всё кажется несколько проще, чем оказывается на практике.
До того как я начал обучение, моё представление об этой работе было примерно таким:
данные + модель = предсказание.
В каком-то смысле так оно и есть. Допустим, у нас есть данные о десятках тысяч подержанных автомобилей: марка, модель, год выпуска, пробег, мощность двигателя, комплектация, регион продажи и другие характеристики.
С этими данными можно решать совершенно разные задачи.
Например, можно попытаться определить справедливую рыночную цену автомобиля. Мы показываем модели множество машин с уже известными ценами, а затем передаём характеристики нового объявления. На выходе получаем ориентировочную стоимость: условно, такая машина при таких параметрах должна стоить около 2,5 миллиона рублей.
Именно что-то подобное мы уже видим на площадках по продаже автомобилей. Вы выставляете машину за 2,3 миллиона, а сервис показывает, что цена ниже средней по рынку и предложение выглядит выгодным. Или наоборот — что автомобиль заметно дороже похожих вариантов. За простой надписью вроде «хорошая цена» уже стоит работа с большим количеством накопленных данных.
Но на тех же данных можно поставить и другой вопрос. Например: насколько велика вероятность, что автомобиль окажется проблемным? Тогда нас интересует уже не конкретная цена, а категория или вероятность: условно, этот автомобиль похож на нормальные машины, а у этого сочетание возраста, пробега, цены и других характеристик чаще встречалось у проблемных экземпляров.
Получается, данные могут быть почти теми же, а вопрос к ним — совершенно другим. В одном случае мы хотим получить число, в другом — определить категорию или вероятность события.
И самое интересное, что непосредственно запустить обучение такой модели технически может быть довольно просто. Иногда это действительно несколько строк кода. Основная работа начинается вокруг них.
Слово «модель» звучит сложнее, чем сама базовая идея. В самом простом представлении модель — это математическая зависимость, которая получает набор значений и на их основе выдаёт результат.
Допустим, мы хотим оценить стоимость квартиры. У неё есть площадь, количество комнат, этаж, расстояние до центра, возраст дома и множество других характеристик.
Очень упрощённо это можно представить так:
цена = базовое значение + площадь × коэффициент + комнаты × коэффициент + ...
Переменных может быть пять, пятьдесят или значительно больше. У каждой из них есть свой коэффициент, влияющий на итоговый результат. Подставили характеристики одной квартиры — получили, например, 5 миллионов. Подставили другую площадь, другой этаж и другое количество комнат — получили 10 миллионов.
Конечно, реальные модели могут быть намного сложнее такой формулы. Но основная идея сохраняется: мы передаём модели некоторый набор данных, а она по определённому математическому правилу рассчитывает результат.
При этом коэффициенты внутри модели нам необязательно придумывать самим. Можно взять тысячи квартир, для которых цена уже известна, и подобрать такие коэффициенты, при которых расчёт модели будет как можно ближе к реальным ценам.
Это и есть обучение модели.
Мы не говорим ей заранее, сколько именно должна добавлять к цене дополнительная комната или один квадратный метр. Мы показываем множество примеров и подбираем параметры так, чтобы модель как можно меньше ошибалась.
И вот здесь возникает более важный вопрос: какие именно данные мы передали модели и насколько им вообще можно доверять?
Представим, что мы хотим определять стоимость квартиры. Можно собрать таблицу из нескольких десятков тысяч объявлений и сразу начать обучение, но сначала придётся ответить на гораздо менее эффектные вопросы.
Откуда взялись эти данные? Есть ли в них ошибки? Что делать с пропущенными значениями? Почему одна квартира стоит 200 тысяч, а другая — 200 миллионов? Является ли такая цена реальной или это ошибка в объявлении?
Дальше возникают вопросы уже не про качество самой таблицы, а про то, что именно мы хотим дать модели:
какие характеристики квартиры действительно имеют значение;
как представить район;
что делать с текстовым описанием;
нужно ли учитывать дату публикации;
какие данные будут доступны в тот момент, когда модель начнут использовать в реальной работе.
Если подготовить данные плохо, модель совершенно честно научится на плохо подготовленных данных. Она не знает, что мы ошиблись.
Здесь хорошо вспоминается выражение про «ложь, наглую ложь и статистику». Проблема не в том, что статистика врёт. Компьютер как раз очень добросовестно посчитает то, что мы ему поручили.
Проблема в другом: правильный ли вопрос мы задали и правильные ли данные использовали для ответа на него.
После обучения нужно понять, насколько хорошо модель работает. Для этого используются различные показатели качества — метрики.
И здесь снова возникает ловушка: получить красивое число довольно легко. Гораздо важнее понять, что именно оно означает.
Представим, что банк анализирует операции по картам. Из каждой тысячи операций только десять являются мошенническими. Можно сделать простейшую систему, которая всегда отвечает: «Любая операция нормальная».
В 990 случаях из 1000 она окажется права. Получается 99% правильных ответов.
На первый взгляд — почти идеальный результат. Только система не обнаружила ни одной мошеннической операции.
Поэтому в Data Science нет одного универсального числа, которое всегда позволяет сказать: эта модель хорошая, а эта плохая.
Есть метрики, которые оценивают модель сложнее, чем простой подсчёт правильных ответов. Например, AUC.
Само название сейчас не так важно. Важнее понять смысл.
Во многих задачах модель сначала не говорит жёстко «да» или «нет». Она выдаёт некоторую оценку. Например, для банковской операции это может выглядеть как вероятность:
почти точно нормальная — 0,03;
уже выглядит подозрительнее — 0,42;
очень похожа на мошенничество — 0,91.
После этого мы сами решаем, начиная с какого значения считать операцию подозрительной.
AUC позволяет оценить, насколько хорошо модель в целом умеет располагать подозрительные операции выше обычных. Если взять одну мошенническую операцию и одну нормальную, хорошая модель должна чаще присваивать мошеннической более высокий уровень риска.
Это полезный показатель, но он всё равно не принимает решение за нас. Можно построить модель, которая хорошо расставляет операции по степени риска, а затем выбрать настолько высокий порог, что ни одна операция не будет признана мошеннической.
Способность модели различать объекты при этом может оцениваться хорошо, а работающая система не поймает ни одного нужного случая.
Поэтому мало получить хорошую цифру. Нужно понимать, что именно она показывает и соответствует ли это реальной задаче.
Если для нас особенно опасно пропустить мошенничество, важно понимать, сколько настоящих мошеннических операций мы обнаруживаем. Если же каждая ошибка приводит к ручной проверке и дополнительным расходам, нужно учитывать и количество ложных тревог.
Одна и та же модель может хорошо выглядеть по одному показателю и плохо — по другому.
Есть ещё одна проблема. Представим школьника, которому дали десять задач, а потом по этим же десяти задачам провели экзамен.
Он может просто запомнить ответы. Результат будет великолепным, но мы так и не узнаем, научился ли он решать новые задачи.
С моделями происходит примерно то же самое. Если проверять качество на тех же данных, на которых модель обучалась, можно получить красивый результат, который ничего не скажет о её способности работать с новыми данными.
Поэтому данные разделяют. Одну часть используют для обучения, другую — для проверки, а часть стараются вообще не трогать до самого конца.
Но даже простого разделения иногда недостаточно. Если мы пытаемся прогнозировать будущее, нельзя обучить модель на октябрьских данных, а потом проверять её на августовских. Если данные относятся к одним и тем же людям, компаниям или устройствам, может быть важно не допустить ситуацию, когда информация об одном объекте попала сразу и в обучение, и в проверку.
Иначе модель получит подсказку, которой у неё не будет в реальной работе.
Получается ещё одна большая часть работы специалиста по данным: не просто построить модель, а придумать способ честно проверить, действительно ли она чему-то научилась.
Допустим, данные подготовлены, модель обучена и первая проверка проведена. Работа всё равно не закончена.
Можно попробовать другие данные, убрать бесполезные характеристики, добавить новые, сравнить несколько моделей, изменить параметры обучения. Потом посмотреть, на каких примерах модель ошибается, и проверить, не начала ли она просто запоминать обучающие данные вместо поиска общей закономерности.
После этого можно провести финальную проверку на данных, которых модель раньше вообще не видела.
И иногда после всех улучшений оказывается, что новая версия работает хуже старой. Или прекрасно показывает себя на промежуточной проверке, но значительно хуже — на данных из другого периода. Или сложная модель практически ничего не выигрывает у простой.
Это не обязательно означает, что кто-то всё сделал неправильно. Это и есть нормальная работа с данными: выдвинуть предположение, проверить его, посмотреть на результат и попытаться понять, почему получилось именно так.
Наверное, именно это сильнее всего изменилось в моём представлении о Data Science после первых учебных проектов.
Со стороны кажется, что основная работа заключается в самой модели: выбрать правильный алгоритм, запустить обучение и получить результат. Но непосредственно обучение зачастую оказывается одной из самых коротких частей процесса.
Полная цепочка выглядит скорее так:
получить данные
понять их
очистить
подготовить
выбрать нужные характеристики
правильно разделить данные
обучить модель
выбрать способ оценки
проверить
разобраться в ошибках
изменить подход
проверить снова.
И только где-то посередине находится непосредственно обучение.
Можно условно сказать, что большая часть работы специалиста по данным остаётся за кадром. Пользователь YouTube видит рекомендацию следующего ролика, клиент банка — решение по кредиту, водитель такси — рассчитанное время поездки, покупатель интернет-магазина — список рекомендуемых товаров.
Но они не видят все решения, которые были приняты до того, как система смогла показать этот результат.
Модель — только один из инструментов. До неё находятся данные, постановка задачи и подготовка. После неё — проверка, оценка качества и интерпретация результата.
И именно здесь возникает большая часть интересных вопросов:
почему модель прекрасно работает на обучающих данных, но ошибается на новых;
почему 99% правильных ответов иногда означают совершенно бесполезную систему;
почему более сложная модель может работать хуже простой;
как модель может случайно получить информацию, которой у неё не должно быть;
что происходит, когда она запоминает данные вместо того, чтобы находить закономерность.
По мере обучения я хочу разбирать такие вещи отдельно — не как набор определений из учебника, а на конкретных экспериментах, где результат сначала выглядел одним образом, а затем приходилось разбираться, что произошло на самом деле.
Отзывы участников интенсива
Этот текст я публикую второй раз.
Первую версию заблокировали за рекламу. Что именно там рекламировалось, я так до конца и не понял, поэтому в этот раз никаких названий образовательных учреждений не будет. На всякий случай не буду даже слишком подробно рассказывать, чем зарабатываю на жизнь. Скажем так, больше 15 лет работаю в IT, и этого для дальнейшей истории вполне достаточно.
Я уже почти год учусь в одном неназываемом образовательном учреждении и хочу сделать небольшой цикл текстов об этом опыте. Рассказать про вступительный интенсив, потом про основное обучение и отдельно про то, чему в итоге научился.
Начну с интенсива. Во многом именно он оказался самой яркой частью всей истории.
На объявление об обучении я наткнулся случайно. В тот момент как раз заканчивал другой большой курс и совершенно не собирался снова куда-то поступать. Но программа выглядела достаточно серьёзно, чтобы хотя бы попробовать пройти отбор.
Несмотря на техническое образование и много лет работы в IT, у меня всегда оставалось ощущение пробела именно в фундаменте программирования. Практические задачи решать умеешь, проекты как-то работают, деньги за это даже платят, но где-то внутри периодически возникает мысль: а нормальной-то программистской базы у тебя нет.
Хотелось этот вопрос наконец закрыть.
Первым этапом отбора была трёхчасовая игра на логику и алгоритмы. Нужно было управлять роботом с помощью движения вперёд, поворотов и циклов. Всего десять заданий, которые постепенно становились сложнее.
Я видел, что некоторые проходили игру за час-полтора, поэтому тоже рассчитывал закончить быстро. Первые задания пошли бодро, но просто пройти уровень оказалось мало. Хотелось каждый раз найти максимально короткое решение, за него давали больше баллов.
В итоге вместо предполагаемых полутора часов просидел почти все три.
Это, как выяснилось позже, довольно точно описывало мою будущую проблему на интенсиве.
После игры пришло приглашение на следующий этап.
Как именно всё будет устроено, заранее толком не изучал. Знал только, что впереди двухнедельный интенсив, после которого часть участников сможет продолжить обучение.
Уже на месте выяснилось, что раньше примерно тот же объём проходили за четыре недели, а нам всё упаковали в две.
Основные задания были на Си, с которым до этого я вообще никогда не работал. С Unix было немного проще, отдельные команды вроде grep были знакомы, но постоянно жить в терминале раньше не приходилось.
В первые же дни выяснилось, что 15 лет опыта в IT не дают большого преимущества на незнакомом стеке. Общий технический кругозор помогает быстрее понять, куда смотреть, но с Си, указателями, памятью и компиляцией всё равно приходится разбираться практически с нуля.
Проекты открывались один за другим. Утром появляется задание, через 36 часов закрывается, но следующим утром уже доступно новое. Если долго возишься с предыдущим, автоматически тратишь время следующего.
Обычный день начинался часов в восемь утра. Сначала чай и разговоры, кто куда дошёл, где застрял и кто уже понял, как подойти к сегодняшней задаче. Потом все расходились по компьютерам.
Дальше примерно так: пишешь код, что-то ломается, ищешь причину, снова пробуешь, спрашиваешь других. Через какое-то время уже кто-нибудь приходит с вопросом к тебе. В десять-одиннадцать вечера едешь домой, спишь и утром возвращаешься обратно.
И так почти две недели.
Готового учебного материала практически не было. Сначала получаешь задачу, которую ещё не умеешь решать, а потом уже под неё собираешь необходимые знания. Читаешь документацию, ищешь информацию, спрашиваешь людей вокруг.
Нейросети тоже хорошо помогали, но скорее как наставник. Можно было попросить объяснить указатели, работу с памятью или конкретную ошибку. Теоретически никто не мешал отправить условие целиком и попросить написать программу, но среди тех, с кем я общался, так почти никто не делал.
Чаще схема была другой: «объясни, чего я здесь не понимаю».
И очень быстро начинаешь много общаться с окружающими. Кто-то уже разобрался в теме и может подсказать направление. Иногда одной фразы хватает, чтобы понять, куда смотреть дальше. Через несколько часов уже сам объясняешь то же самое следующему человеку.
Для меня это было непривычно. Большую часть профессиональной жизни работаю самостоятельно. Если чего-то не знаю, обычно иду искать и разбираюсь. Здесь постоянно приходилось спрашивать, обсуждать решения и просить помощи.
Кроме проверок другими участниками проекты проходили автоматическую проверку.
Довольно быстро выяснилось, что успешные проверки людьми ещё ничего не гарантируют.
Первый раз я вообще не понял, что произошло. Проверки прошёл, отправил проект дальше, а получил ноль.
Потом началась отдельная история с форматированием. Где-то не запустил clang-format, где-то проблемным оказался один файл, ещё в одном проекте код был отформатирован, но не с той конфигурацией, которая требовалась.
Одна формальная ошибка, весь проект уходит в ноль.
Ещё я пропустил первое групповое задание. Нужно было заранее записаться в команду, а сделать это вовремя не успел. Когда разобрался, присоединяться уже было поздно.
Зато внезапно появился единственный практически свободный день за весь интенсив. Предыдущее задание закончено, следующее ещё не открылось, остальные заняты групповым проектом.
Получилось остаться дома, спокойно почитать теорию и немного восстановить силы.
К концу первой недели из шести результатов зелёными были три. Два первых и самых простых проекта плюс экзамен, который написал на 89%. Два индивидуальных проекта обнулила автоматическая проверка, групповое задание было пропущено.
А впереди ещё целая неделя.
В какой-то момент всерьёз подумал, может, хватит.
Поговорил с женой. Она поддержала и сказала, что раз уж я в это ввязался, надо выложиться до конца, а дальше будь что будет.
После этого отношение к происходящему поменялось.
До этого хотелось каждый проект сделать максимально хорошо. В некоторых заданиях были дополнительные части, и вместо 100% можно было получить, например, 120%.
Но если полтора дня доводить один проект до идеала, а потом автоматическая проверка обнулит его из-за какого-нибудь файла или настройки форматирования, теряешь не только этот результат. За это время уже начался следующий проект, который теперь можешь не успеть сделать даже на проходной балл.
Поэтому на второй неделе стратегия стала другой. Закончить проект достаточно хорошо, отправить на проверку и двигаться дальше.
Больше полноценных попыток, больше шансов получить зелёный результат.
Получалось примерно то же самое, что ещё на отборочной игре. Можно долго искать идеальное решение, только дополнительного времени от этого не появляется.
Результаты всё равно были неровными. Ещё два индивидуальных проекта обнулила автоматическая проверка, один набрал только 12%, второй экзамен закончился на 24%. Зато второй групповой проект прошёл на 91%.
Всего за интенсив получилось одиннадцать результатов, четыре зелёных и семь красных.
Красивой победной статистики здесь не будет.
Для проверок использовалась внутренняя валюта. Проверяешь чужую работу, получаешь несколько единиц. Хочешь отправить свою на проверку, тратишь.
Параллельно начислялись баллы за активность, в том числе за проверки и проведение мероприятий. В какой-то момент я тоже подумал, что можно сделать побольше проверок и набрать баллов, но при подсчёте обнаружилась небольшая проблема.
Внутренняя валюта начинала концентрироваться у людей, которые много проверяли чужие проекты. Потратить такое количество на собственные работы они физически не могли. При этом на групповых заданиях часть валюты вообще уходила из оборота.
Если этим одновременно увлечётся несколько человек, остальным в какой-то момент может просто не хватить валюты для проверок.
Одну из своих обучающих лекций я посвятил как раз этой механике. Поговорили, почему собирать всю местную валюту у нескольких особенно активных капиталистов не очень полезно для общества.
Экономический кризис в отдельно взятом интенсиве в итоге не случился.
Кроме этого постоянно проходили небольшие мероприятия. Нужно было собрать хотя бы пять человек и рассказать или показать что-нибудь интересное.
Люди рассказывали про музыку, прыжки с парашютом, показывали упражнения с элементами танцев.
Мне было проще заниматься техническим просвещением. Рассказывал про нейросети, программирование микроконтроллеров и 3D-печать. Однажды даже привёз собственный 3D-принтер и печатал что-то прямо на месте.
За две недели вообще получилось довольно много активности. Проверки, лекции, помощь другим, обсуждения.
А ближе к концу нужно было выбрать трёх героев и трёх антигероев интенсива.
Насколько это влияло на итоговый отбор, я не знаю. Но сама механика хорошо показывала, что одним кодом всё не ограничивается.
Если две недели сидеть в углу, ни с кем не разговаривать и никому не помогать, другим людям будет довольно сложно вспомнить тебя при выборе героя. Зато антигероем при определённых талантах стать, вероятно, проще.
При четырёх зелёных результатах из одиннадцати я до сих пор допускаю, что активность внутри группы могла сыграть какую-то роль в итоговом решении. Но точные критерии нам не сообщали, поэтому это только предположение.
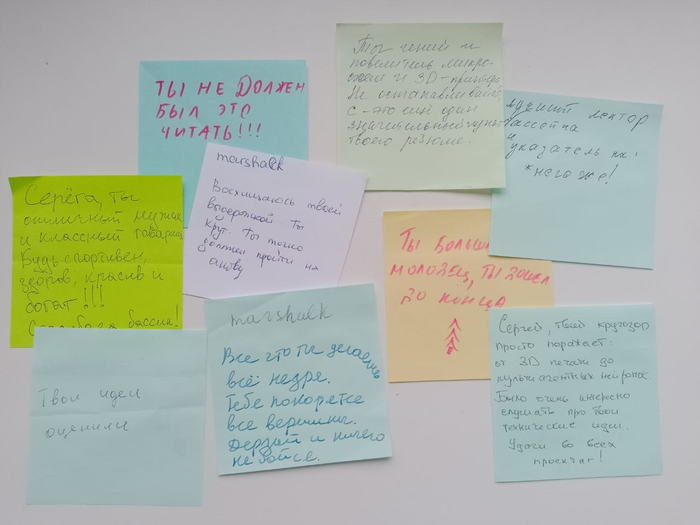
Под конец кураторы устроили ещё обмен отзывами. У каждого был конверт с ником. Можно было написать другим несколько слов на стикере и положить записку в их конверт.
Потом открываешь свой и читаешь всё, что тебе написали за две недели.
И вот это запомнилось очень хорошо.
Если сейчас вспоминать интенсив, сильнее всего вспоминаются даже не задачи и не Си, а люди.
Все очень разные по возрасту, опыту и своим историям, но при этом как будто на одной волне. Не случайная компания, которую посадили в одну аудиторию, а люди, которым действительно интересно разбираться, учиться и что-то делать.
Мы две недели практически жили вместе. Утром встречались за чаем, потом разбегались по компьютерам, снова собирались, обсуждали, у кого что получилось и что опять не работает. Кто-то объяснял, кто-то просил помощи, кто-то рассказывал очередную историю.
Я давно так не смеялся.
Все одновременно куда-то несутся, пытаются успеть, друг друга подхватывают, и тебя очень быстро затягивает внутрь.
Когда интенсив закончился, оставался один вопрос, поступил я вообще или нет.
С четырьмя зелёными результатами из одиннадцати особой уверенности не было. Свои шансы оценивал примерно как 50 на 50.
Через несколько дней пришло сообщение.
Поступил.Примерно через месяц началось основное обучение. Там уже нужно было постепенно определяться с направлением. Мне были интересны Python и Data Science, в итоге сразу начал двигаться в сторону Data Science, потому что там к Python добавлялись данные, машинное обучение и нейросети.
Но это уже следующая история, если её, конечно, тоже не признают рекламой.
Второй раз добровольно проходить такой интенсив я бы, скорее всего, не стал. Для фрилансера две недели такого режима означают почти две недели без нормальной работы и дохода. Плюс дома семья тебя практически не видит.
Но тут есть странное противоречие.
Если предложить просто ещё раз пройти его, то нет, спасибо.
А если бы можно было вернуться именно в те две недели, к тем же людям, снова утром приехать, пойти пить чай, потом весь день разбираться с очередной непонятной задачей, смеяться, спорить, кому-то помогать и самому постоянно что-то спрашивать, туда я бы вернулся с удовольствием.
Потому что шёл туда за базой по программированию.
А запомнились в итоге люди.
