0 просмотренных постов скрыто


Google выпустила Gemini 3.8 Flash TTS: голос для озвучки теперь описывают словами
Google представила две модели синтеза речи: Gemini 3.8 Flash TTS и облегчённую Flash-Lite TTS. Главная фишка — дизайн голоса. Диктора больше не выбирают из каталога: пишешь, кого хочешь услышать (роль, акцент, тембр), и модель собирает новый голос с нуля. В примерах Google — диджей из Мельбурна, монотонный робот и японский дракон.
Что умеет
Больше 100 языков и диалектов, а библиотека готовых голосов выросла с 30 до 2000 с лишним, включая региональные варианты вроде мексиканского испанского и квебекского французского. Модель играет по ремаркам: к каждой реплике можно дописать, как её произнести, вставить смех, вздох или поддакивание «угу», развести диалог на два голоса. Google обещает, что голос не «плывёт» даже на часах непрерывного аудио, а это критично для аудиокниг и подкастов.
Клонировать можно и собственный голос: нужны 30 секунд записи и отдельно записанное согласие, причём голос в согласии должен совпасть с образцом. Во всё сгенерированное вшивается неслышимая метка SynthID.
Цена и качество
До конца 2026 года миллион токенов звука стоит 9 долларов у Flash и 6 у Flash-Lite, с 2027-го — вдвое дороже. Секунда аудио — 25 токенов, так что час озвучки на Flash обходится примерно в 80 центов. Модели уже доступны в Gemini API и Google AI Studio без листа ожидания, открытых весов нет.
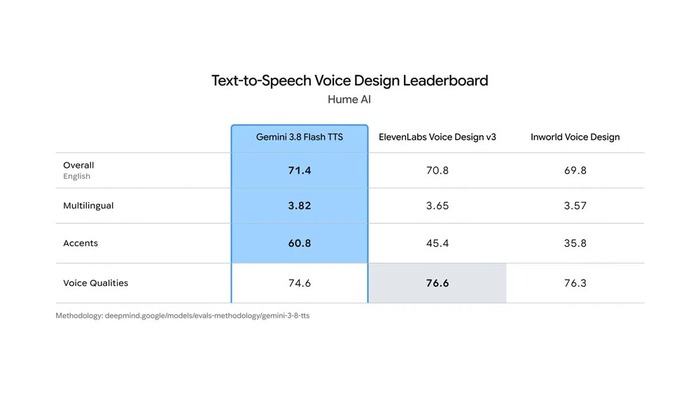
В бенчмарке дизайна голоса от Hume AI Flash TTS первая с 71,4 балла, но от ElevenLabs Voice Design v3 (70,8) её отделяют доли балла, а по естественности тембра ElevenLabs всё ещё впереди. Заметно Google обходит конкурентов только в акцентах: 60,8 против 45,4.
Дизайн голоса по описанию до сих пор был козырем ElevenLabs. Теперь Google отдаёт то же самое через API, на сотне языков и дешевле доллара за час, и для озвучки игр, дубляжа и аудиокниг голос персонажа становится вопросом одной строки текста, а не кастинга.
Источники: MarkTechPost · The Decoder · Google
Показать полностью
1

Вышла новая модель для синтеза речи Breeze TTS 2
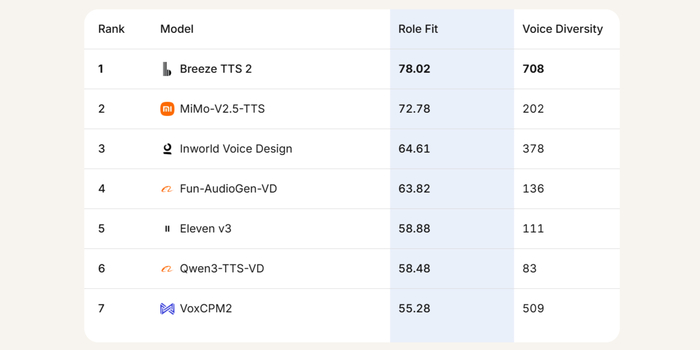
Сделана новая модель Breeze TTS 2 (https://huggingface.co/BreezeBlue/Breeze-TTS-2), объединяющая дизайн голоса, голосовое управление и стриминг с низкой задержкой, вместе с открытыми бенчмарками.
Парадигма переходит от создания статичного контента к интерактивному голосовому ИИ в реальном времени (игры, агенты) с новыми требованиями по разнообразию, управляемости и низкой задержке.
Дизайн голоса управляет созданием уникальных голосов под персонажа по текстовому описанию, занимая первое место в бенчмарке Role Fit и Diversity.
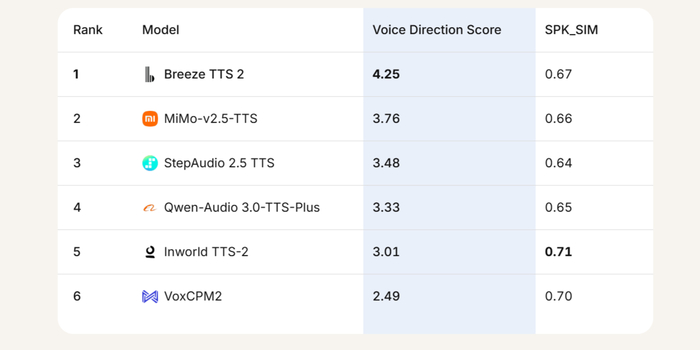
Управление голосом позволяет изменять эмоции и интонации на лету с сохранением персонажа, беря первое место в бенчмарке Voice Direction Score.
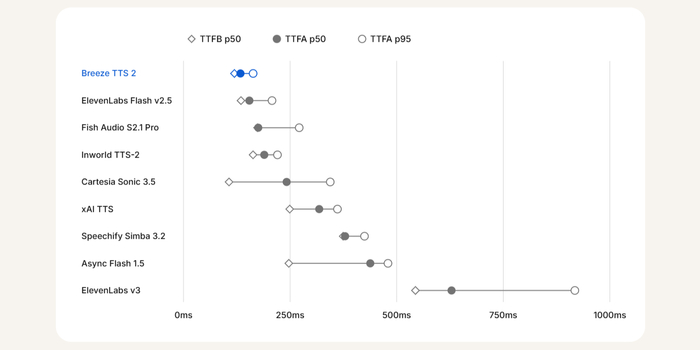
Выдача аудио с поддержкой Realtime API (WebSocket) самая быстрая (TTFB и TTFA) для живого диалога.
В результате поддерживаются 50 языков с контролем акцента.
Показать полностью
2
Вышла новая модель для синтеза речи Raon-OpenTTS
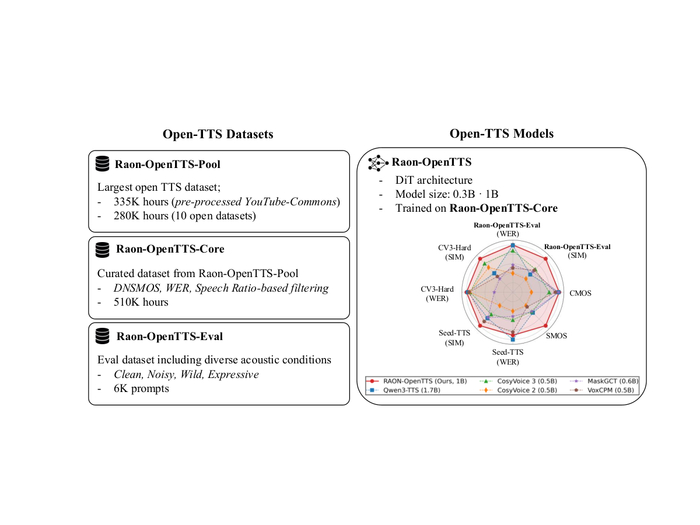
Загружены новые открытые модели Raon-OpenTTS-0.3B (https://huggingface.co/KRAFTON/Raon-OpenTTS-0.3B) и Raon-OpenTTS-1B (https://huggingface.co/KRAFTON/Raon-OpenTTS-1B) с данными для устойчивого синтеза речи, обученные на Raon-OpenTTS-Core и работающие с аудио в виде мел-спектрограмм (16 кГц), текстом на уровне символов и вокодером HiFi-GAN.
Ориентировались на создание полностью воспроизводимой TTS-системы (открытые данные, код, веса), сопоставимой с проприетарными аналогами.
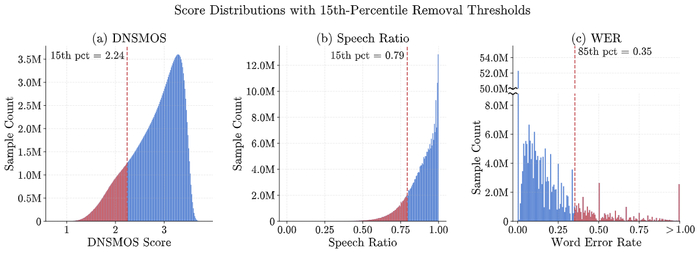
Raon-OpenTTS-Pool, крупнейший открытый мультиисточниковый набор для TTS, включает 615K часов английской речи и 240M сегментов (из 10 открытых датасетов и обработанного YouTube Commons). Подмножество Raon-OpenTTS-Core (510K часов, 194M сегментов) отфильтровали по WER (ошибка транскрипции), DNSMOS (качество звука) и Speech Ratio (доля речи), удаляя нижний 15-й процентиль по комбинированному рангу. Бенчмарк устойчивости Raon-OpenTTS-Eval (6K пар промт-текст) из 12 датасетов разбит на 4 акустических режима, таких как Clean (чистая речь), Noisy (шумная), Wild (спонтанная и реальная) и Expressive (эмоциональная).
Фильтрация (15% комбинированная) дала наилучший средний ранг по сравнению с отсутствием фильтрации или агрессивной (50%), при этом мультиисточниковый пул при равном объёме (47K ч) превосходит одиночный Emilia по WER и SIM, а добавление YouTube-Commons улучшает WER и SIM в большинстве режимов, кроме Noisy.
Вклад состоит из крупнейшего открытого мультиисточникового речевого корпуса (615K ч), эффективного пайплайна фильтрации для TTS, бенчмарка устойчивости Raon-OpenTTS-Eval и открытых весов с кодом конкурентоспособных TTS-моделей.
В результате Raon-OpenTTS-1B достиг WER 1.78% (2-е место среди открытых моделей) и SIM 0.749 (1-е место) на Seed-TTS-Eval, превосходя все открытые аналоги, уступая лишь Qwen3-TTS и CosyVoice 3. Кроме того, Raon-OpenTTS-1B показал лучшую разборчивость и схожесть на сложном подмножестве с WER 6.15% (1-е) и SIM 0.775 (1-е). Также на Raon-OpenTTS-Eval у Raon-OpenTTS-1B лучший средний WER (2.81) и SIM (0.695) по всем режимам, однако он особенно силён в Wild (5.61 WER против 136.03 у F5-TTS). По субъективным оценкам Raon-OpenTTS-1B владеет лучшим общим CMOS (предпочтение по натуральности) и лучшим SMOS (схожесть с диктором), составляющий 3.70.
Показать полностью
2
Вышла новая модель для синтеза речи IndexTTS 2.5
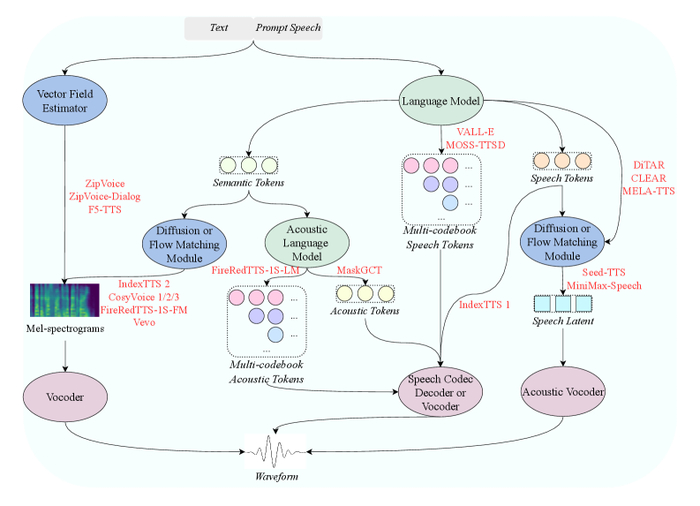
Обнародована новая модель IndexTTS 2.5 (https://huggingface.co/IndexTeam/IndexTTS-2.5) для многоязычного zero-shot эмоционального TTS как развитие IndexTTS 2.
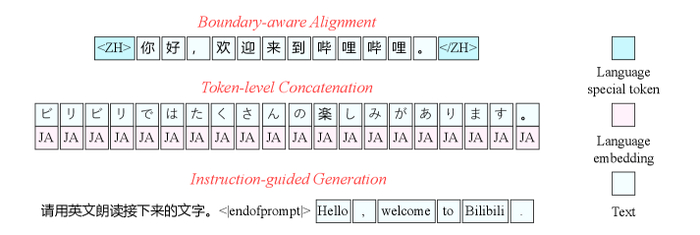
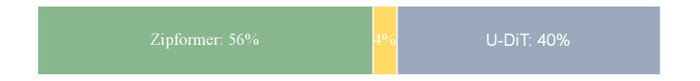
Путём сжатия семантического кодека частоту кадров уменьшили с 50 до 25 Гц, последовательности сократили вдвое, удешевив обучение и вывод. В архитектуре S2M заменили U-DiT на требующий меньше параметров и быстрее генерирующий мел-спектрограммы Zipformer. Многоязычную поддержку китайского, английского, японского, испанского и арабского воплотили тремя стратегиями, опираясь на выравнивание с учётом границ, конкатенацию на уровне токенов и генерацию на основе инструкций. RL оптимизировали посредством GRPO для пост-обучения T2S с наградой по WER (ASR) и сходству диктора, что привело к улучшенному произношению и естественности.
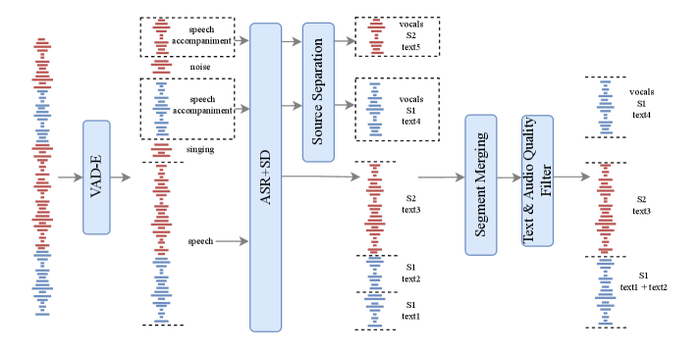
Данные извлекли из примерно 100 тыс. часов речи (zh 30k, en 25k, ja 42k, es 22.9k, ar 20k) и 135 ч эмоциональных данных.
В результате на zero-shot средний WER 6.75 и SS 73.18, но WER после RL уже 6.00 и SS 73.63. Межъязыковые (китайский промт) способности добиваются среднего WER 6.22 и SS 68.62, но после RL уже 6.17 и 70.20. По сходству эмоций и MOS на ja/es/ar она выше CosyVoice 3 с zero-shot точностью эмоций zh 0.713 (против 0.467) и en 0.673 (против 0.567) на CV3. На RTF T2S скорость равняется 0.119 (было 0.232) и S2M 0.017, что суммарно в 2.28 раза быстрее IndexTTS 2.
Показать полностью
4
Higgs Ultimate — сделал русскую портативную версию Higgs Audio v3 Studio, пользуюсь сам
Higgs Ultimate — русская портативная нейросеть для синтеза и клонирования речи на движке Higgs Audio v3. Работает на CUDA (NVIDIA), полностью офлайн, без Python-окружения.
На днях показывал в канале Higgs Audio v3 Studio — нативный десктоп на Rust+Tauri, который гоняет TTS-движок Higgs Audio v3 напрямую через CUDA-DLL, без единого питон-окружения. Мне понравилась настолько, что я не просто поставил её себе, а разобрал на запчасти и пересобрал под себя: сделал полностью русскую и по-настоящему портативную версию — Higgs Ultimate. Всё (модели, голоса, движок, настройки) лежит рядом с .exe: удалил папку — не осталось ни следа в системе, никаких записей в профиле пользователя. Заодно поправил то, что мешало в оригинале, и дотащил несколько фич, которых там не было. Пользуюсь теперь этой сборкой вместо оригинала.
Чем отличается от оригинала (Saganaki22):
• Полностью портативная — оригинал пишет в профиль пользователя, здесь всё живёт рядом с .exe
• Русский интерфейс с переключением на лету (плюс английский)
• Распознавание речи заменено с Whisper на Parakeet (NVIDIA parakeet-tdt-0.6b-v3) — мультиязычный, сам определяет язык, включая русский, крутится на CPU
• Запись голоса с микрофона прямо в приложении — выбор устройства, индикатор уровня, Parakeet сразу расшифровывает запись
• Пакетный режим — генерация пачки клипов из списка строк или .txt-файлов
• Нормализация громкости в мультиспикере — реплики разных дублей приводятся к единому уровню (LUFS/EBU R128)
• Стартовый войспак голосов в один клик
• Плюс все возможности оригинала: клонирование голоса по референсу, продолжение речи, мультиспикерные диалоги, локальный API
Ниже — короткие демки основных режимов: обычный TTS, клонирование голоса, продолжение речи и мультиспикер.
Установка: скачать портативную сборку из Releases → распаковать в папку без кириллицы → запустить Higgs Ultimate.exe → нажать «Скачать DLL движка», затем скачать модель TTS. Перед первым запуском нужно поставить в систему свежий драйвер NVIDIA, CUDA Toolkit 13.x и Visual C++ Redistributable x64 — без них движок падает с ошибкой о недостающих DLL.
Показать полностью
3
Нашёл локальный TTS с клонированием голоса в одном .exe — работает на видеокарте, без Python и облака
Нативное Windows/Linux-приложение на Rust + Tauri 2, которое гоняет портированный C++/CUDA-движок модели Higgs TTS 3 (Boson AI) напрямую — без единого Python-окружения под капотом. Большинство локальных TTS-тулз тянут за собой conda/venv и кучу зависимостей, здесь же Tauri UI напрямую дёргает Rust-команды, а Rust через libloading грузит нативную DLL с движком (ggml + whisper.cpp внутри).
Что умеет: обычный TTS, zero-shot клонирование голоса по референсу, продолжение существующей речи (Continue Speech) и мультиспикерные диалоги — с live-стримингом аудио прямо во время генерации, авто-транскрипцией референсов через Whisper и Speaker Gallery для переиспользуемых голосов с ZIP-экспортом/импортом.
Есть встроенный локальный OpenAI-совместимый API со стримингом NDJSON — можно дёргать генерацию скриптами. Полный контроль параметров: temperature, top-k/top-p, seed, emotion, style, speed, pitch. Экспорт в WAV/MP3, телеметрия видеокарты в реальном времени.
Требования: NVIDIA GPU с CUDA 13, от 8 ГБ VRAM (Q4_K_M) до 16 ГБ (BF16). AMD, Mac и CPU-only — мимо. Готовые сборки под Windows (.exe/.msi) и Linux (.deb/AppImage).
🔗 GitHub: Saganaki22/Higgs-Audio-v3-Studio
Показать полностью
Вышла новая модель для синтеза речи с синхронизированной 3D-анимацией лица Ex-Omni

Существует новая открытая омни-модальная модель Ex-Omni (https://huggingface.co/tencent/Ex-Omni), объединяющая понимание речи/текста и генерацию речи с синхронизированной 3D-анимацией лица (ARKit blendshape).
Несоответствие разреженных семантических представлений LLM и плотной временной динамики мимики вызывает проблему.
Решением оказался двухэтапный подход, при котором используется генератор речевых единиц, осведомлённый о шаблонах мимики, и декодер шаблонов мимики, где дискретные речевые юниты служат временным каркасом, а скрытые состояния несут лицевые признаки.
Механизм TQGF асимметрично совершает вливание семантики через управляемое перекрёстное внимание (токены речи как запрос).
База данных InstructS2SF‑1200K содержит 1000 K синтетических пар "текст в речь и лицо" и 200 K диалоговых "речь в речь и лицо", полученные с помощью псевдо-разметки лица от Audio2Face‑3D.
Обучение прошло в три этапа, начиная с выравнивания речи, продолжаясь совместным предобучением речи и шаблонов мимики и завершаясь диалоговой адаптацией.
В результате качество ответов (VoiceBench) на уровне Qwen2.5‑Omni, лучшая аудиовизуальная синхронизация (SyncNet, низкие значения Sync-D и высокие Sync-C) и меньшая задержка генерации лица, чем у каскадных связок (EmoTalk, UniTalker), причём TQGF критичен для синхронизации.

Показать полностью
2