
Ножки
Показать полностью
1
Intel, похоже, готовит необычную версию настольного Nova Lake-S, в которой встроенной графике будет уделено почти столько же внимания, сколько самому процессору.
По данным инсайдера Jaykihn, одна из конфигураций будущих Core Ultra 400 получит сразу 12 графических ядер Xe3P и сможет выделять на встроенную графику до 40 Вт мощности в режиме PL2. Для iGPU настольного процессора это очень серьёзный показатель.
Сам процессор, согласно утечке, будет состоять из 4 производительных P-ядер, 8 E-ядер и ещё 4 LP-E-ядер, то есть суммарно получит 16 физических ядер.
Базовый лимит мощности процессора ожидается на уровне 65 Вт, а максимальный PL2 — около 154 Вт. При этом одна только графическая часть сможет получать до 40 Вт, а её продолжительный лимит оценивается примерно в 15–25 Вт.
Из-за этого Intel якобы потребует от материнских плат две отдельные фазы питания VCCGT для встроенного GPU. Это означает, что производительность будущей Xe3P может зависеть не только от процессора, но и от системы питания конкретной платы.
Ещё одна интересная характеристика — кеш.
Для 12-ядерной Xe3P приписывают 20 МБ L2, тогда как 12-ядерная Xe3 в Panther Lake располагает 16 МБ. Для встроенной графики дополнительный кеш особенно важен, потому что iGPU использует обычную системную память и не имеет собственной быстрой GDDR.
В теории такая архитектура должна позволить Intel серьёзнее конкурировать с мощными встроенными Radeon в процессорах AMD Ryzen.
Именно здесь Nova Lake становится особенно интересным: Intel может попытаться превратить обычный настольный процессор в полноценный APU-класс продукт, способный запускать современные игры без отдельной видеокарты.
Однако пока это всё ещё утечки, а не финальные характеристики Intel. Частоты Xe3P, реальная производительность, поддерживаемые форматы памяти и конкретные модели процессоров пока официально не раскрыты.
Если информация подтвердится, рынок бюджетных видеокарт может получить неожиданного конкурента прямо внутри центрального процессора.
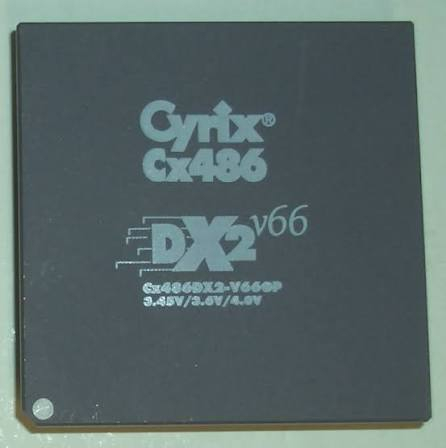
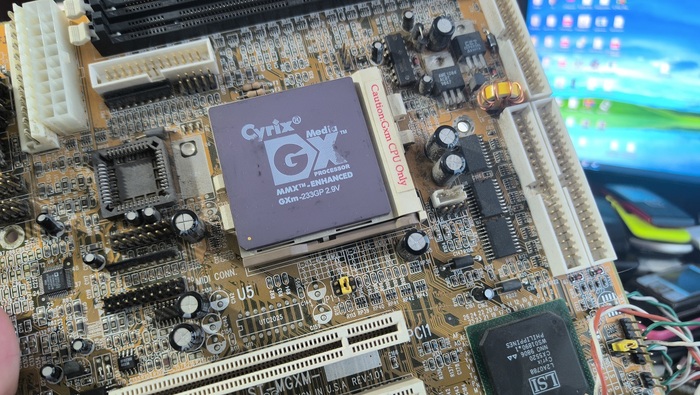
Недавно я рассказывал вам об уникальном процессоре из 1997 года — Cyrix MediaGX. На первый взгляд может показаться что это самый обычный бюджетный Cyrix без какой либо фишки, однако на практике это был самый первый в мире APU — процессор, который совмещал в себе, собственно, процессорное ядро, «GPU», контроллер памяти и даже PCI! Однако в прошлой статье мы с вами так и не запустили MediaGX и не узнали на что он способен на практике — пришло время это исправить.
В сегодняшней статье мы с вами не только попытаемся запустить плату с оригинальным MediaGX, но также и посмотрим во что он превратился после покупки AMD на примере тонкого клиента и каким образом этот процессор дожил до 2020 года... Интересно? Жду вас под катом!
Чипы от Cyrix всегда вызывали у меня неподдельное восхищение. Ребята активно поддерживали компьютеры на старых сокетах выпуском новых, достаточно шустрых процессоров, которые зачастую могли посоревноваться с более старшими конкурентами от Intel. Несмотря на мелкие аппаратные баги, эти процессоры пользовались большим спросом и помогли заметно уронить цену на сборку домашнего ПК в середине 90-х годов.
Однако последний процессор компании — MediaGX и его кровного собрата в виде AMD Geode чаще всего обходят стороной, почему-то практически не вспоминая о них. А зря — инженеры обогнали мировые тенденции в архитектуре десктопных процессоров более чем на 10 лет вперед — и это одна из причин, почему Geode на все том же 5x86 ядре родом из 1995 года прожил вплоть до 2020 года...
Конечно современному читателю, который вырос на процессорах выпущенных после 2010 года, подобное восхищение может показаться странным. Мол, ну да, видеоядро в процессоре, контроллер памяти и PCI — всё это давным-давно стало стандартом. Но чтобы понимать, почему MediaGX был уникальным на момент выхода в 1997 году, давайте взглянем на принципиальную схему любого ноутбука конца 90-х годов- на Pentium III:
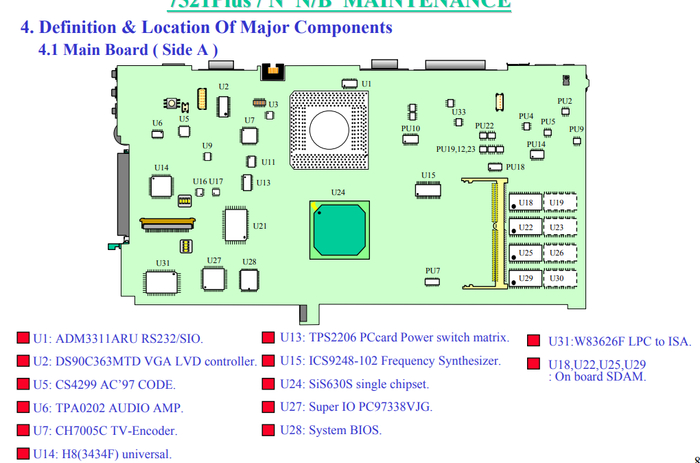
Тут было бы уместнее разместить схему на ноут с P I/P II, но их в открытом доступе я не нашел.
Для работы девайсу на Intel'овской платформе требовался как минимум сам процессор, северный мост, южный мост, видеочип в лице 2D-ускорителя типа NeoMagic или 3D типа ATI 3D Rage, RAMDAC, мультиконтроллер, PLL-контроллер (клок), который формировал тактовую частоту процессора, FSB и периферии, ШИМ-контроллер, который управлял фазами питания процессора, а также отдельный аудиокодек, LVDS-контроллер (не всегда) и сетевой контроллер с PHY-уровнем. И это очень сокращенный список чипов — на практике их могло быть ещё больше, а это был чуть ли не пиковый уровень интеграции по меркам Intel'овской платформы (посмотрите сколько чипов и разной логики в оригинальном IBM PC до появления первых мостов — удивитесь). С MediaGX, список чипов сокращался до пяти:
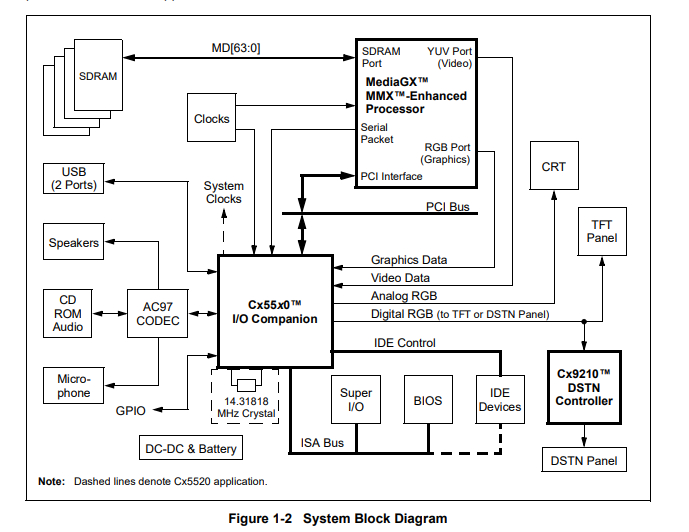
Сам процессор. Интегрировал в себя VGA-адаптер, PCI-контроллер, контроллер SDRAM и PLL для формирования тактовой частоты всей системы. При этом MediaGX был построен на базе не самого кислого ядра 5x86 с поддержкой SIMD-инструкций MMX и относительно неплохим (но не игровым) FPU.
Хаб. Совмещал функционал RAMDAC для вывода картинки на матрицы ноутбуков/мониторы, AC97-аудиопорт, ISA, USB, IDE и даже декодер MPEG1.
Мультиконтроллер. Отвечает за управление состоянияем питания ПК + обработку клавиатуры и шины LPC.
Микросхема AC-97 аудиокодека в паре с усилителем.
LAN-контроллер с тем самым PHY-уровнем.
Всё! Это уже готовый компьютер или ноутбук, кроме обвязки по питанию, оперативки и HDD больше вообще ничего не было нужно. При этом ноутбуки на Pentium III стоили не менее 2.000$, в то время как лэптопы типа Casio Fiva MPC-102 стоили значительно дешевле — около 1.700$.
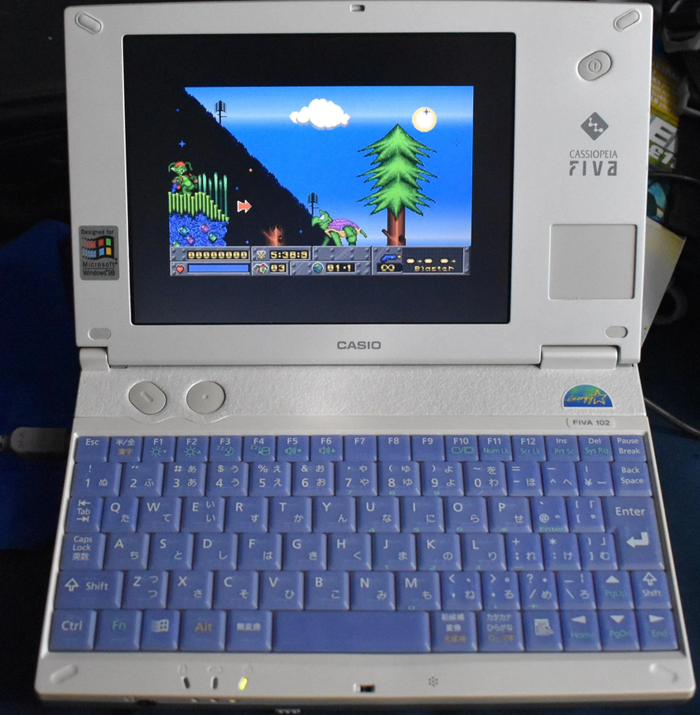
Фото @CyberPaul, взято из статьи на Хабре.
Однако на десктопном рынке MediaGX не прижился из-за некоторых аппаратных багов и более низкой производительности, чем у тех же Pentium III. Более того, MediaGX не поддерживал AGP-видеокарты — что автоматически не позволяло собрать гейминг-машину для 3D-игр (софтрендеры он тянул не очень из-за медленного FPU, а PCI видеокарты были не особо производительными), но даже если использовать компьютер только для 2D DDraw-игр — всё равно нас ждёт облом из-за некоторой несовместимости игр с драйвером DD MediaGX!
Зато, как бы это странно не прозвучало, MediaGX очень даже прижился в промышленной электронике. PC104-платы, тонкие клиенты, узкоспециализированные Windows-планшеты — во многих этих устройствах можно было найти MediaGX или AMD Geode. При этом AMD в середине нулевых провела основательную работу над оригинальным детищем Cyrix, выпустив Geode LX800:
Архитектура всё также осталась двухчиповой: процессор + хаб. Весьма интересно то, что хаб CS5536 всё также был подключен к процессору через общую с другими устройствами шину PCI, никакого FSB и всяких GTL.
Процессор разогнали до солидных 500МГц, накинули дополнительного L1-кэша (64КБ инструкции/64КБ данные в противовес 16КБ в оригинальном MediaGX) и добавили 128КБ L2. Контроллер памяти научился работать на частоте до 200МГц, а вместо SDRAM теперь работал с более шустрой DDR. В сумме это давало более низкие задержки благодаря тому, что контроллер DRAM находился прямо в процессоре и максимально близко к ОЗУ.
Хабу прикрутили поддержку GPIO, USB 2.0, а также возможность загрузки с NAND/NOR-памяти в обход обычных IDE'шных DiskOnChip.
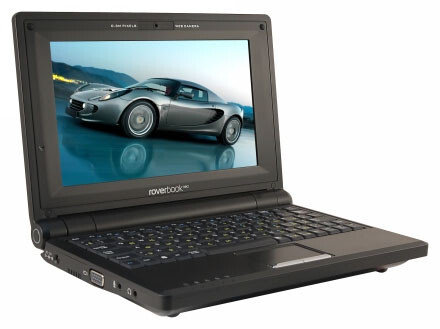
Вполне современно. Помимо этого, AMD Geode ставили в несколько интересных моделей ноутбуков. Первым был RoverBook Neo U800 — «отечественный» ответ на Asus EEEPC 701:
А также в ноутбук за 100$ для бедных африканских стран: OLPC XO-1.
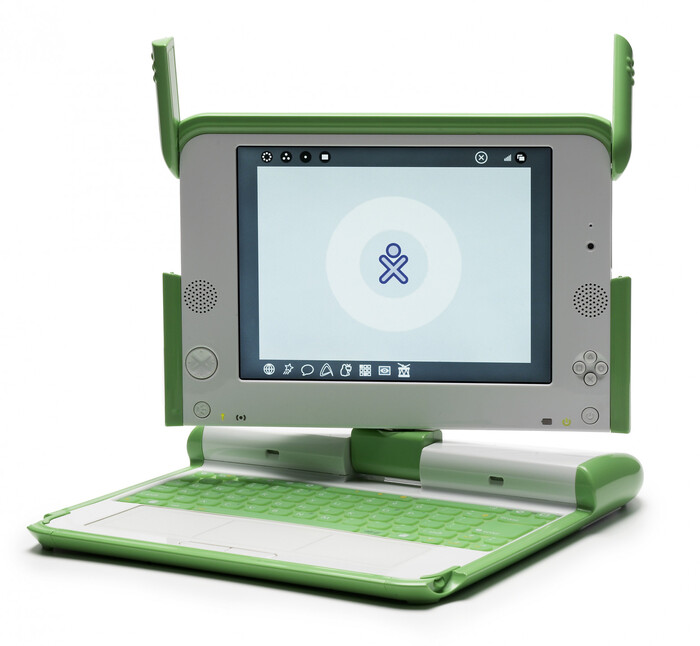
Рендер из Вики. Как ни крути, очень классный девайс по своей концепции.
По правде сказать, я давно хотел пощупать MediaGX/Geode на практике и не так давно у меня появилась возможность это сделать...
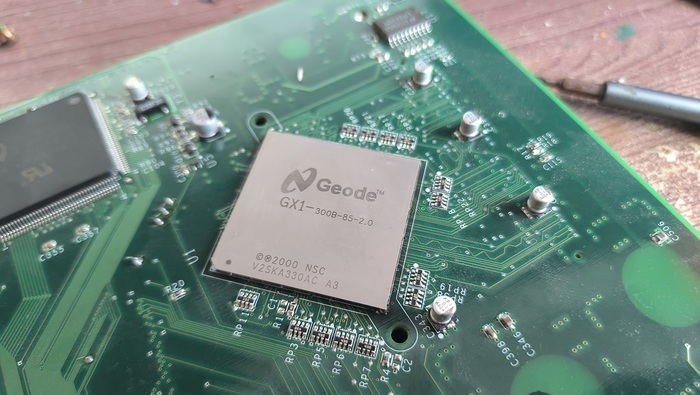
Первой возможностью пощупать MediaGX стал тонкий клиент Compaq T30, который я купил в 2023 году за ~500 рублей на Авито. Аппарат вышел в 2002 году, был построен на базе National Semi Geode GX1 (практически идентичный процессор) и использовался как минимум до 2010 года, после чего был списан в утиль. Девайс сразу привлек мое внимание своими компактными размерами (по меркам полноценного IBM-PC) и простотой разборки.
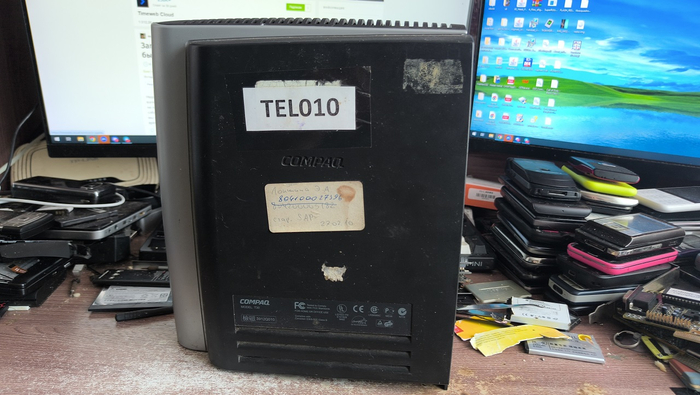
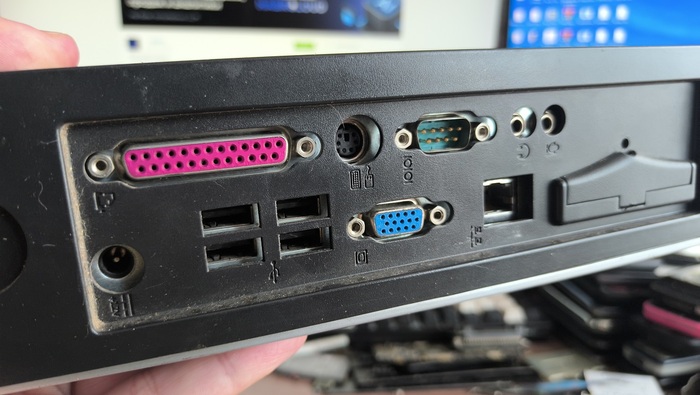
Вообще, тонкий клиент — это обычно вполне себе полноценный x86-компьютер, который, однако, редко работает на базе полноценной версии Windows. Чаще всего там можно встретить Linux или Windows CE (да, прямо с КПК из нулевых) с кастомной оболочкой, которая препятствует полноценному доступу к родной ОС. При этом у такого ПК есть всё необходимое: например T30 хоть и является младшей моделью, у него есть 4 USB, PS/2, COM-порт (для подключения тача), LPT, VGA, RJ-45 и даже 3.5мм разъемы для микрофона и наушников. Вместо PCI/ISA, функционал предлагается расширять аддонами PC-Card, под которые слоты спрятан чуть правее.
Разбирается девайс несложно: достаточно сдвинуть верхнюю пластиковую крышку, открутить несколько винтов и вот мы уже видим окошко на материнскую плату. Справа можно увидеть ключ активации Windows CE 4.0 .Net.
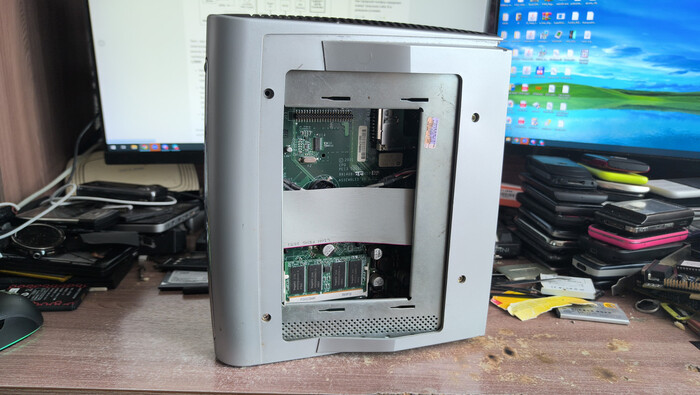
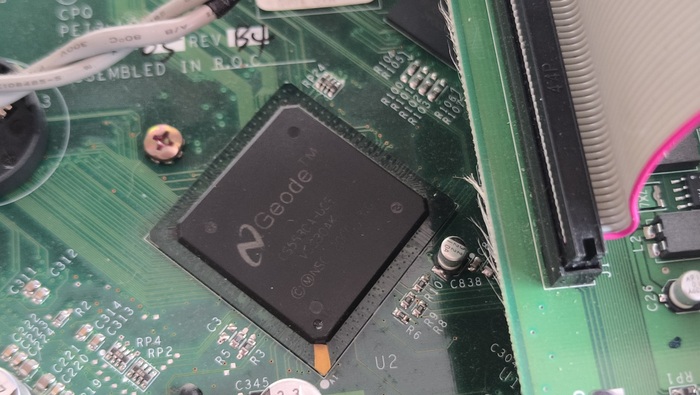
После разборки нас встречает очень компактная и простая, по меркам ПК тех лет, плата. И в первую очередь в глаза бросается здоровый чип National Semi с припиской Geode CS5530A, который является хабом и наследником Cx5520. При этом невооруженным взглядом отличия между ними найти сложно — оба предоставляют ISA, USB, PC AT-совместимую логику типа таймеров и работают как RAMDAC'и.
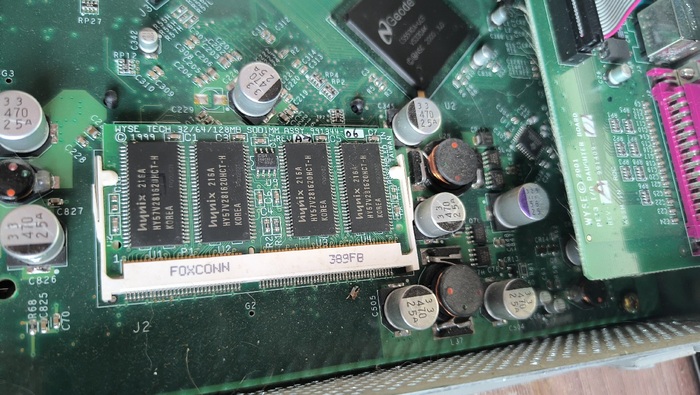
Чуть правее расположились 64МБ оперативной памяти типа SDRAM. К слову это вполне неплохой объем по меркам 2002 года: хотя для WinXP этого было маловато, Win98 бегала очень шустро и во многих домашних ПК все еще было именно столько памяти.
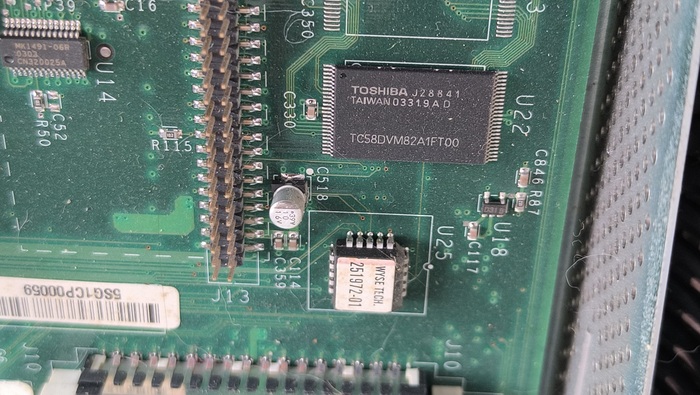
Роль накопителя выполняет всего одна-единственная NAND-флэшка объемом в 32МБ. Для справки: даже в коммуникаторы и КПК HTC на той же WinCE ставили больше (около 64МБ NOR). Зато SSD!
Рядом с флэшкой расположился стандартный разъём IDE, однако с ним есть нюанс.
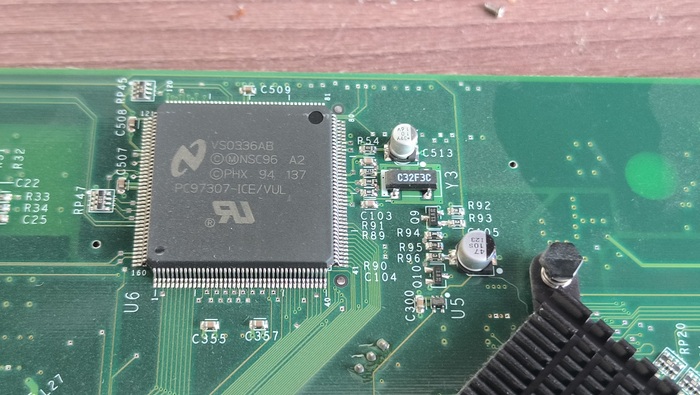
С обратной стороны платы расположился неизвестный мультиконтроллер разработки National Semi...
...и сам процессор. Собственно, это почти такой же MediaGX, только способный работать на несколько более высокой частоте — до 333МГц вместо 300МГц, а также переведенный на уменьшенный техпроцесс — всего 180нм! Он всё также крут, как и его батя в лице MediaGX :)
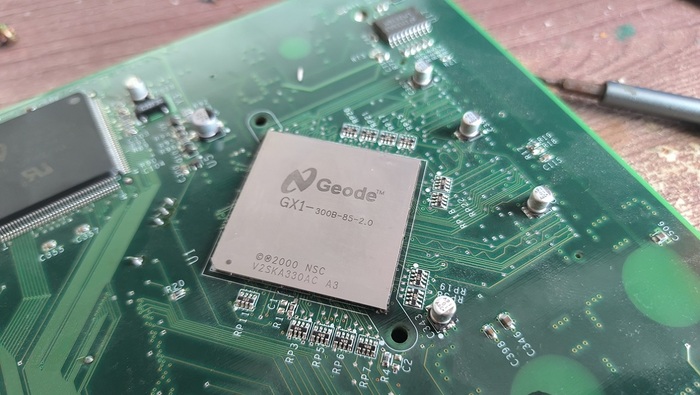
Питается девайс от обычного ноутбучного блока питания на 12В. Вот только есть загвоздка: в T30 поставили очень урезанный и специально пропатченный BIOS, из которого выбросили возможность загрузки с IDE-накопителей и меню настройки, но добавили возможность грузится с NAND-флэшек. Как итог — нужно искать флэшку BIOS и прошивать её дампом от старшей модели.
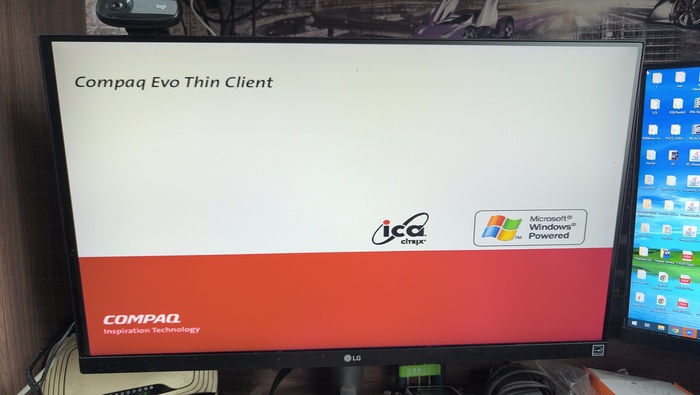
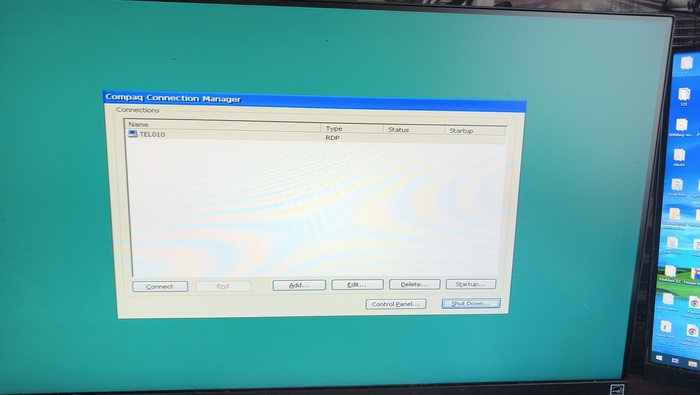
Стандартная прошивка ничего не умеет кроме подключения к RDP. Ни проводника нет, ни блокнота — вообще ничего. Ситуация очень похожа на Sun Ray, где функционал крутого процессора (SPARC) задушены закрытым софтом :(
Однако помимо T30, у меня также был промышленный планшет DT366 2005 года выпуска. Он работает уже на более современном Geode GX2 и развивает клок аж в 400МГц, а также имеет 512МБ DiskOnChip IDE модуль в качестве накопителя (снова SSD!) и солидные 256МБ оперативной памяти. Планшет мог работать как на Windows XP Embedded, так и на Windows CE. Нехило.
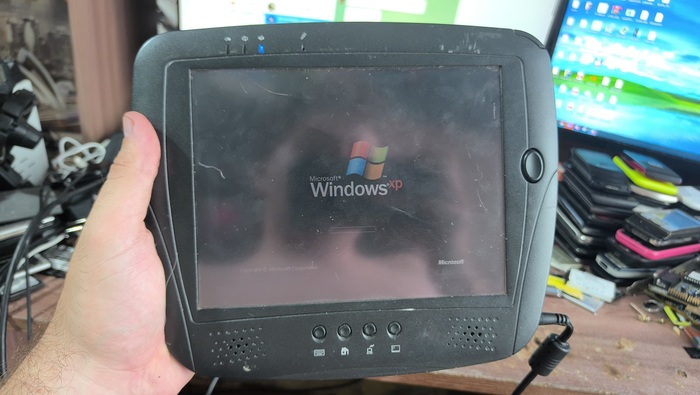
Промышленный предок iPad. Всё ещё мечтаю о планшете на WinXP с Pentium M/Celeron M.
Мой подписчик уже установил сюда обычную WinXP и отключил все визуальные эффекты, дабы ускорить работу систему. Но даже несмотря на присутствие SSD, ОС все равно загружается около 3х минут. Но... в чем причина?
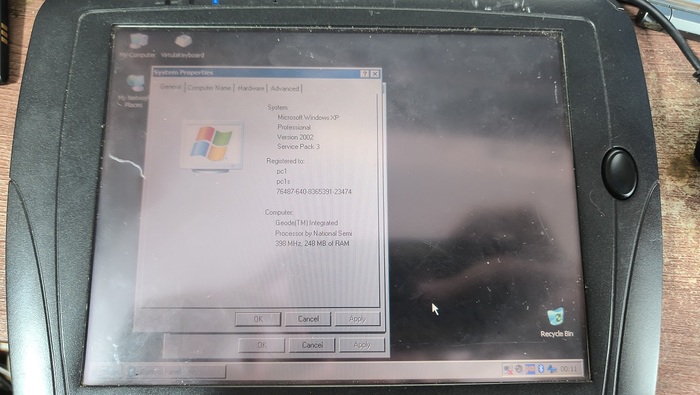
За поиском ответа я запустил AIDA64. Во вкладке «видеоадаптер» не было ничего, а dxdiag показал что в качестве видеодрайвера используется vga.sys. Во вкладке информации о процессоре было только то, что у него всего 32КБ L1-кэша, а также поддерживается MMX и, внезапно, 3DNow!
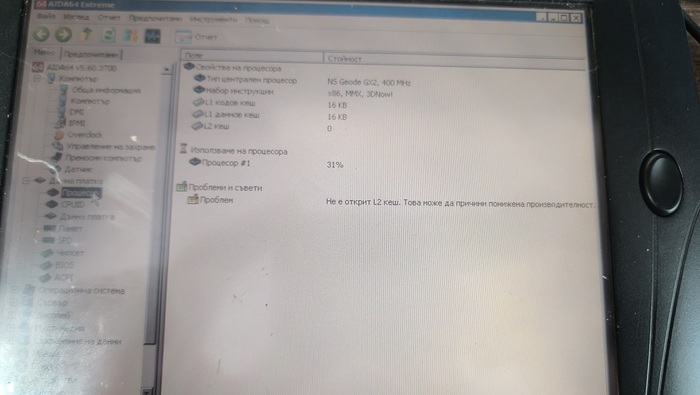
Насколько мне известно, в 2005 3DNow! уже давно был легаси
Но может бенчмарки покажут, в чем причина лагов? Все таки процессор явно должен быть не хуже машинок на P II... И тест CPU Queen помещает наш процессор практически в самый низ с 255 попугаями. Процессор мощнее чем AMD K5 166 и Pentium 166, но слабее чем Celeron на ядре Covington без L2-кэша! Чего уж говорить, он набирает в два раза меньше очков, чем VIA C3 из тех же тонких клиентов!
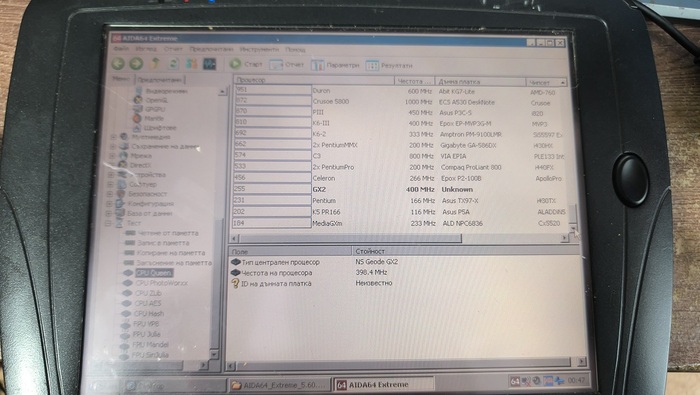
В тесте ZLib процессор держит паритет и все также обгоняем Pentium 166 и K5 166, уступая безкэшевому селерону. Оригинальный MediaGX сидит в самом низу, с производительностью уровня Pentium 133.
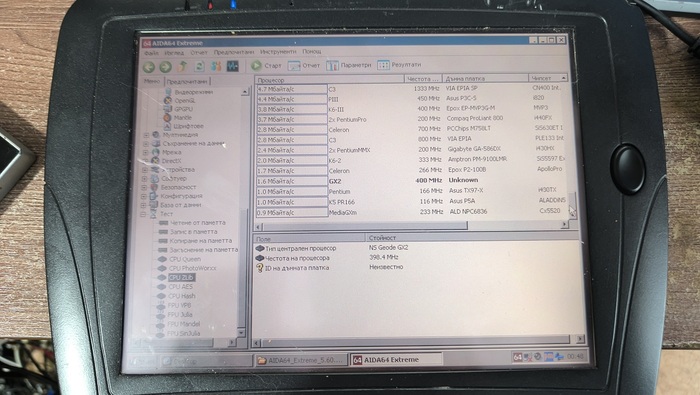
А вот в тесте FPU, MediaGX показывает себя во всей красе. Помните я в первой части рассказывал о том, что Cyrix сделали себе имя на FPU-сопроцессорах для 386/486, которые были мощнее чем такие же сопроцессоры от Intel и AMD? В 5x86 микроархитектуре, инженеры Cyrix забили на оптимизацию FPU и упали на последнее место в бенчмарках, даже ниже чем Penitum 66! Так что да, MediaGX вообще не подходил для игр с софтрендером из-за медленного FPU, да и с видеокартой все равно производительность была бы низкой — ведь аппаратного T&L тогда ещё не придумали...
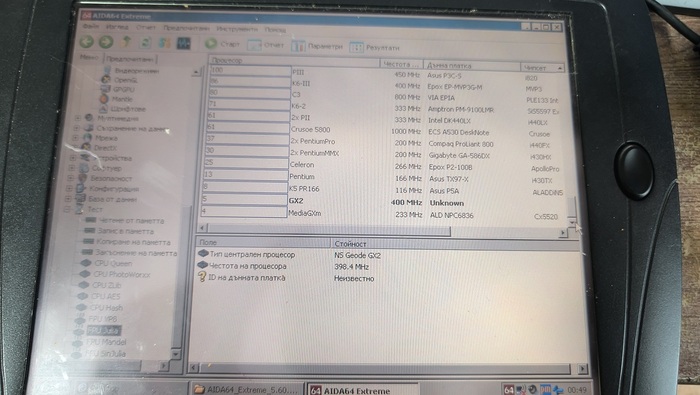
...но казалось бы, как процессор, уходящий корнями в 1997 год, который по чистой производительности уступал всем конкурентам, смог прожить целых 23 года практически без изменений? А всё дело в промышленных устройствах — там быстрые FPU, огромные частоты и жесткое распараллеливание с SIMD чаще всего вообще не нужны. И поэтому AMD производила эти процессоры до 2020 года, развивая их вместе с родственными GXm (на базе ядер Jaguar) и LX (на базе ядер Athlon).
К слову, мне было бы интересно пощупать что-то ещё из семейства тонкоклиентных и AMD'шныхю. Если у кого-то есть всякие интересные тонкие клиенты или ноутбуки на прикольном железе, или что-то AMD'шное времен 939/462 — пишите в ЛС, обязательно сделаю контент!
Ну а я надеюсь, что вам было интересно. Подписывайтесь на блог, чтобы не пропускать новые статьи каждую неделю! А если вам интересна тематика ремонта, моддинга и программирования для гаджетов прошлых лет — подписывайтесь на мой Telegram‑канал «Клуб фанатов балдежа„, куда я выкладываю бэкстейджи статей, ссылки на новые статьи и видео, а также иногда выкладываю полезные посты. А ролики (не всегда дублирующие статьи) можно найти на моём YouTube канале.“»
А если вы хотите что‑нибудь подарить из железа и увидеть о нём статью — пишите мне в Telegram. Меня очень интересуют самые разные гаджеты: начиная от игровых консолей и любых связанных с геймингом устройств, телефонов, смартфонов, КПК, заканчивая ретро‑компьютерами и ноутбуками. Кто знает, может героем следующей подобной статьи окажется ноутбук из 90-х?:‑)
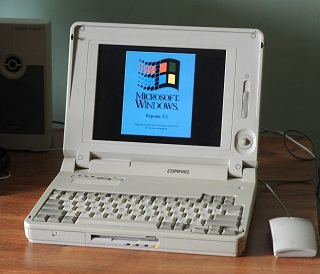
Особенно сильно я люблю ковыряться в ноутбуках из начала 90-х. Источник
После обзоров устройства не продаются, а остаются в моей коллекции. Когда‑нибудь я хочу сделать музей, где к каждому устройству можно будет приложить QR и почитать мою статью. Кто знает, вдруг на следующей неделе я также подробно расскажу про девайс из вашей юности?:)
Кстати, у меня есть GameBoy Advance SP, под который я очень хочу написать игру. Однако мой экземпляр был залит водой и кофе. Может у кого‑то есть донор с дохлой платой, откуда я смог бы взять контроллер питания? У меня AGS-101.
TSMC вместе с National Yang Ming Chiao Tung University и Academia Sinica продемонстрировала новый подход к созданию транзисторов на однослойном дисульфиде молибдена MoS₂ — двумерном полупроводнике, толщина которого составляет всего около 0,7 нм.
Главная проблема таких материалов заключается не только в самом канале, а в затворном диэлектрике. Поверхность MoS₂ практически не имеет свободных химических связей, поэтому обычные методы нанесения изолятора могут формировать неоднородный слой, увеличивать рассеяние носителей и ухудшать управление транзистором.
Исследователи решили изменить именно интерфейс.
На поверхность однослойного MoS₂ сначала нанесли ультратонкий эпитаксиальный слой алюминия, а затем окислили его. В результате сформировался слой Al₂O₃ толщиной примерно 0,42 нм, который стал атомарно тонким буфером между каналом и основным high-k диэлектриком из HfO₂.
Такой интерфейс позволяет HfO₂ формироваться значительно более равномерно, снижает дефекты и ослабляет нежелательное рассеяние электронов.
Полученные top-gate транзисторы достигли эквивалентной толщины оксида около 1 нм, пиковой крутизны примерно 0,45 мС/мкм при длине затвора около 100 нм и сохранили очень низкие токи утечки и стабильную работу.
Почему это важно?
Современные FinFET и GAAFET нельзя уменьшать бесконечно. При сильном масштабировании кремниевого канала управление током ухудшается, растут утечки и проявляются короткоканальные эффекты.
Двумерные материалы вроде MoS₂ позволяют сделать канал буквально толщиной в несколько атомов, сохранив при этом полупроводниковые свойства. Именно поэтому их рассматривают как один из возможных путей развития логики после современных кремниевых транзисторов.
Но важно: исследование не означает, что TSMC уже создала серийный техпроцесс менее 1 нм. Это экспериментальная технология интерфейса для будущих 2D-транзисторов, и до массовых процессоров ещё предстоит решить вопросы производства, контактов, масштабирования и интеграции миллиардов таких устройств.
Тем не менее один из ключевых барьеров атомарно тонкой электроники стал заметно меньше.
Возможно, следующий большой скачок в процессорах произойдёт уже не за счёт уменьшения кремния, а за счёт его замены на материалы толщиной буквально в один атомный слой.
Intel официально раскрыла подробности серверных процессоров следующего поколения Xeon 7 Diamond Rapids — и характеристики оказались ещё масштабнее, чем предполагали ранние утечки.
На конференции Hot Chips 2026 компания подтвердила конфигурации до 256 новых производительных ядер, огромный кеш последнего уровня объёмом 1,28 ГБ, 16 каналов оперативной памяти со скоростью до 12 800 MT/s, а также 128 линий PCI Express 6.0 и поддержку CXL 3.0.
Это особенно интересно на фоне нынешнего Granite Rapids. Максимальные Xeon 6900P предлагают до 128 P-ядер, поэтому новое поколение фактически удваивает верхний предел количества производительных ядер.
Diamond Rapids строится на новом техпроцессе Intel 18A-P и использует масштабируемую чиплетную архитектуру с отдельными вычислительными блоками, унифицированной системой памяти и высокоскоростными межсоединениями UCIe-S. Intel также применяет технологию упаковки Foveros Direct 3D.
Но главное противостояние — с AMD.
Будущие серверные процессоры EPYC Venice на архитектуре Zen 6 также достигают отметки в 256 ядер. Таким образом, впервые за долгое время Intel и AMD смогут напрямую столкнуться в классе серверных CPU с более чем двумя сотнями вычислительных ядер.
Причём Intel делает ставку именно на производительные P-ядра, а не на большое количество компактных энергоэффективных ядер.
Одним количеством ядер гонка, конечно, не заканчивается. Важнейшую роль играют пропускная способность памяти, энергопотребление, производительность на ядро, межсоединения и работа процессора вместе с GPU и специализированными ИИ-ускорителями.
Поэтому Diamond Rapids получает значительно усиленную подсистему памяти, новые Advanced Performance Extensions — APX, улучшенные Advanced Matrix Extensions — AMX и платформу, рассчитанную на современные корпоративные и Agentic AI-нагрузки.
Появление 256-ядерного Xeon особенно важно сейчас, когда серверный рынок меняется из-за бума искусственного интеллекта. Intel приходится конкурировать уже не только с AMD EPYC, но и с Nvidia Vera, Arm-серверами и специализированными вычислительными платформами крупнейших облачных компаний.
Diamond Rapids должен выйти в 2027 году и станет одним из главных тестов способности Intel вернуть позиции в наиболее производительном сегменте серверных процессоров.
Что выбрали бы для огромного сервера: 256 ядер Intel или 256 ядер AMD Zen 6?
Alibaba представила ускоритель Zhenwu V900 — по словам гендиректора Эдди У, самый мощный ИИ-чип, сделанный в Китае. Акции компании подскочили. Разбираем два практических вопроса: когда это можно получить и насколько оно лучше того, что есть.
Когда
Массовое производство и коммерческий запуск запланированы на первый квартал 2027 года. То есть прямо сейчас это анонс, а не товар.
Причём «купить» здесь в принципе неверное слово. Zhenwu не продаётся в рознице и не встанет в домашний компьютер: это серверный ускоритель, который едет либо в собственные дата-центры Alibaba Cloud, либо к корпоративным клиентам. Доступ к нему обычный человек получает так же, как к любому облачному GPU, — арендуя вычисления. Суммарно чипов линейки Zhenwu отгружено уже 560 тысяч штук более чем четырёмстам клиентам в двух десятках отраслей.
Насколько лучше
Главная заявленная цифра — втрое выше производительность, чем у предшественника M890, который вышел всего в мае. Из характеристик называют 216 ГБ памяти на ускоритель, 1200 ГБ/с межчиповой пропускной способности, нативную поддержку форматов FP8 и FP4 и возможность собирать кластеры до 500 тысяч чипов.
А вот честный ответ на «лучше ли, чем у Nvidia»: прямых сравнений с актуальными флагманами Nvidia никто не приводит. Ориентир, который упоминают, — что предыдущий M890 по общей производительности был сопоставим с H20. Стоит помнить, что H20 — это не топовая Nvidia, а специально урезанная версия, которую делали под экспортные ограничения для Китая. Так что рост втрое — это рост относительно довольно скромной базовой планки, а не обгон Blackwell.
Зачем это Alibaba
Чип нужен под конкретную задачу: компания собирается обучать модель на 5–10 триллионов параметров. Для сравнения, нынешний флагманский Qwen работает примерно на 2,4 триллиона — то есть речь о скачке в два-четыре раза. Обучать такое на чужом железе Китаю попросту не на чем: американские экспортные ограничения отрезали и топовые ускорители Nvidia, и доступ к TSMC. Zhenwu Alibaba называет отечественным, а разрабатывает его собственное подразделение T-Head.
Под это подписаны и деньги: более 53 миллиардов долларов в ИИ за три года и цель выйти на 20 гигаватт дата-центровых мощностей к 2032 году.
Что может пойти не так
Два узких места, и оба вне контроля Alibaba. Первое — производство: отечественные фабрики должны вытянуть нужный объём с приемлемым выходом годных, и если не вытянут, сроки поедут. Второе назвал сам Эдди У: глобальный дефицит по всей цепочке поставок для ИИ-дата-центров ограничивает скорость расширения. Памяти, стоек и питания сегодня не хватает всем, включая тех, у кого с чипами проблем нет.
Так что пока это заявка, а не факт на складе. Проверять её будем в начале 2027-го.
Источники: CNBC, Investing.com, CryptoBriefing
Компания Anthropic, разработчик семейства моделей Claude, формирует собственную команду по разработке специализированных процессоров для искусственного интеллекта.
Компания уже нанимает инженеров, которые должны совместно оптимизировать аппаратное обеспечение и ИИ-модели. Цель — повысить производительность Claude, снизить стоимость вычислений и эффективнее масштабировать инфраструктуру по мере роста моделей и числа пользователей. Reuters подтверждает, что речь идёт именно о формировании внутренней команды по проектированию кастомных ИИ-чипов.
Однако это не означает, что Anthropic завтра откажется от Nvidia.
Компания уже использует сразу несколько аппаратных платформ. Claude обучается и работает на AWS Trainium и Nvidia GPU, а Amazon остаётся основным облачным и тренировочным партнёром Anthropic. Такой подход позволяет распределять разные нагрузки между архитектурами, наиболее подходящими для конкретных задач.
Масштаб инфраструктуры уже огромен. Anthropic сообщала об использовании более миллиона AWS Trainium2, а новое соглашение с Amazon предусматривает до 5 ГВт дополнительных вычислительных мощностей. Параллельно компания расширяет сотрудничество с Google и другими поставщиками инфраструктуры.
Собственный процессор может дать Anthropic ещё одно преимущество: оптимизировать архитектуру непосредственно под особенности Claude, вместо того чтобы адаптировать модель к универсальным ускорителям.
И компания явно рассматривает аппаратное направление всерьёз. В августе Reuters сообщил, что Anthropic обсуждала приобретение стартапа MatX, основанного бывшими инженерами Google TPU. Возможная стоимость сделки оценивалась примерно в $7 млрд, хотя впоследствии обсуждение сместилось в сторону партнёрства.
Разработка передового ИИ-чипа — чрезвычайно дорогой проект. По отраслевым оценкам, только создание современного специализированного процессора может потребовать порядка $500 млн, ещё до масштабного производства и строительства соответствующей программной экосистемы.
Но для крупнейших разработчиков искусственного интеллекта собственное железо становится всё более привлекательным. Google давно развивает TPU, Amazon — Trainium, а OpenAI также работает над собственной аппаратной стратегией.
Теперь к этой гонке присоединяется Anthropic.
Если компания действительно создаст процессор, глубоко оптимизированный под Claude, следующая битва между разработчиками ИИ будет идти уже не только между моделями — Claude, ChatGPT и Gemini будут конкурировать целыми вертикальными вычислительными платформами.