Cheatsheet
1 пост

1 пост
7 постов
Коллега уже публиковал инфо про это обновление, но как-то без огонька. Хотя оно заслуживает куда больше внимания и отдельного рассказа.
В общем дело было так.
Сентябрь шёл относительно спокойно, пока на прошлой неделе не добрался до Patch Tuesday. В Редмонде закрыли очередную пачку дыр, а взамен раздали три подарка: мёртвый RDP, пропавший звук и Excel без вставки.
Microsoft официально признала все три проблемы, так что спорить не с кем. Разбираем подарки.
Первый подарок: RDP.
Соединение устанавливается и живёт несколько минут. Через несколько минут обрыв. Сервер в это время висит на «Please wait for the Remote Desktop Configuration» и не уточняет, сколько ждать.
Следом перестают отвечать MMC, RDS Licensing Diagnoser и Проводник. Страница Windows Update крутит индикатор бесконечно, так что откатиться через настройки сходу не выйдет. Зоопарк пострадавших широкий: от Windows 11 26H1 до Windows Server 2012.
Есть версии, кто виноват. Самая правдоподобная — накопительное обновление KB5124008: его называют на форумах. Официального подтверждения номера нет.
Обходной путь официально один, зато надёжный: виртуалку надо остановить, деаллоцировать и запустить заново. Выключить и включить. Древнейший из известных ритуалов системного администрирования.
У Windows Server 2012 свой сюжет: 13 октября он выходит из программы расширенных обновлений. Уходит на пенсию. С восхитительным прощальным подарком.
Следом пропал звук.
На Windows 11 24H2, 25H2 и 26H1 отваливается поддержка части устройств USB Audio Class 1.0. Это стандарт конца девяностых. Он пережил три десятилетия прогресса и не пережил один вторник.
Симптомы: звук пропадает целиком, настройки звука и ползунки громкости ломаются, многоканальный режим глючит.
Некоторым помогло принудительное переключение в двухканальный режим. Звук возвращается в сокращённом составе.
Фикс обещают. Сроков не называют (в Редмонде любят интригу).
И король сезона: Excel.
Патч закрывал уязвимости удалённого выполнения кода и раскрытия информации в Excel 2016, 2019, 2021 и 2024. Заодно закрыл Ctrl+V.
Теперь вставка может не сработать. Источник остаётся выделенным, приёмник не меняется, сообщений об ошибке нет. Формулировка Microsoft достойна цитатника: «The paste operation might fail silently».
Любимое слово в цитате — «might». Вставка не падает и не ругается. Она может просто не сработать, молча. Обнаружится это, когда будет поздно.
Обходного пути нет. На форумах лечатся переустановкой Office или сносом самого обновления.
Со сносом обновления тоже есть нюанс: вместе с ним уходят и закрывавшиеся им дыры. Придётся выбирать между потерей данных и открытыми уязвимостями.
У кого автообновления включены, тем выбирать не пришлось: патч уже стоит.
Фон у истории богатый.
Весь год Microsoft рассказывает, что качество обновлений — приоритет. В феврале Наделла лично постановил: компании нужен «царь качества». Судя по сентябрьскому списку известных проблем, царь пока знакомится с территорией.
На Hacker News под новостью набралось 236 пунктов и 151 комментарий. Спрашивают, сколько человек написали LGTM на том security-патче. Советуют выдерживать патчи месяц, прежде чем ставить. И шутят: корпорация не устаёт хвастаться, будто код у неё теперь пишет ИИ.
Не так давно наткнулся на статью Red Hat про разблокировку LUKS-шифрования по SSH. Суть там простая: сервер с зашифрованным корнем перезагружается, замирает в initramfs и ждёт парольную фразу на консоли, за которой никто не сидит. Решение у редхатовцев выглядит довольно простым: поставить пакет dracut-sshd, включить модуль NetworkManager в initramfs, дописать параметры ядра. Несколько команд, и застрявшая машина открывается по SSH с вашего дивана.
И стало мне интересно: а как та же задача решается, если у меня на серваках крутится не RHEL, а Альт? Копировать редхатовский рецепт вслепую смысла нет: у Альта собственная система сборки initramfs и свои механизмы ранней загрузки. Тем любопытнее посмотреть, как всё устроено здесь.
TL;DR. Сделать можно. Проверил это на живой виртуалке. Рецепт в итоге вышел на удивление прямолинейный, но с двумя-тремя особенностями, о которых лучше узнать из статьи.
Сначала два слова о проблеме, чтобы не тащить за собой тех, кто уже в теме. LUKS — это формат шифрования блочных устройств в Linux: корневая файловая система лежит внутри зашифрованного контейнера, и пока контейнер не открыт, ранней загрузке нечего монтировать. Разумная практика для сервера, который стоит где-нибудь в чужом дата-центре: вынули диски — получили криптографический мусор вместо базы клиентов.
Обратная сторона фичи: при каждой перезагрузке кто-то обязан вручную ввести фразу. Клавиатура, монитор, поездка в дата-центр (или BMC-консоль, если повезло с железом). Сервер перезагрузился ночью после обновления, и всё: он ждёт вас. Физически.
Идея разблокировки по сети существует столько же, сколько удалённые серверы: положить в initramfs сетевой стек и маленький SSH-сервер, подключиться к машине, пока она стоит на паузе, и вручить ей парольную фразу издалека. Red Hat делает это средствами dracut, своего генератора initramfs, и честно хвастается, что весь рецепт — пакет, строчка конфига и пара параметров ядра (на RHEL пакет тянется из EPEL, на Fedora он в основных репозиториях).
А теперь посмотрим, что для этого есть у альтоводов.
В ALT Linux свой генератор initramfs, называется make-initrd. Это самостоятельная разработка, которую Альт использует с незапамятных времён. Устроен он концептуально иначе: образ собирается из «фич» (features), каждая фича — набор скриптов и файлов в /usr/share/make-initrd/features/. Нужна сеть в initramfs — есть фича network. Нужен SSH — есть фича dropbear. Нужен LUKS — есть фича luks.
Поддержка LUKS в make-initrd вынесена в отдельный пакет make-initrd-luks. При установке с шифрованием установщик сам ставит этот пакет, сам включает фичу luks в /etc/initrd.mk и сам записывает /etc/crypttab, а make-initrd исправно кладёт этот crypttab в образ.
Если пакета нет, указание отсутствующей фичи не вызывает ошибки — такое поведение задокументировано. Образ соберётся, но внутри не окажется ни cryptsetup, ни обработчика шифрованных разделов. Поэтому после установки пакета и каждой пересборки стоит внимательно смотреть на строку Used features: среди использованных фич должна быть luks.
Чтобы не экспериментировать на боевых машинах, я поднял в своём Proxmox виртуалку с Альт Сервер 11.1. В итоговой разметке получились отдельный /boot без шифрования (grub и initramfs должны читаться до ввода пароля), отдельный swap и корень внутри LUKS2-контейнера с aes-xts. Проще говоря, типовой сервер, только с шифрованием из коробки.
Первая же загрузка такой машины выглядит так. В initramfs работает событийная кухня: udev обнаруживает устройства, а демон ueventd передаёт их обработчикам. Обработчик 085-luks видит LUKS-раздел, заглядывает в скопированный в образ /etc/crypttab, не находит файла-ключа и запрашивает парольную фразу на консоли:
udev: session=5: @85-luks: Trying to ask the user for a password.
Enter passphrase for /dev/sda3:
И стоит. Загрузка дальше не идёт, потому что корень физически недоступен. Вот эту сцену мы и будем лечить.
Шаг первый — пакеты. Как я уже говорил, на системе, изначально установленной с LUKS-корнем, make-initrd-luks уже стоит, а фича luks уже включена в /etc/initrd.mk. Остаётся поставить dropbear — маленький SSH-сервер (сама фича dropbear уже есть в базовом пакете make-initrd, но бинарник надо откуда-то взять) — и sysklogd: фича dropbear требует фичу syslog, а syslog без бинарников klogd/syslogd в образ не собирается:
$ apt-get install dropbear sysklogd
Теперь важная строчка в /etc/crypttab. Установщик пишет туда запись с именем вида luks-; мы дописываем опцию headless в четвёртую колонку:
luks-ВАШ-UUID UUID=ВАШ-UUID none luks,headless
Этот флаг разбирает штатный обработчик 085-luks. Без headless он занимает консоль и запускает собственный cryptsetup, а потом наш второй cryptsetup по SSH начинает с ним толкаться локтями. С headless обработчик не спрашивает фразу на консоли и освобождает дорогу удалённой разблокировке. Цена очевидна: обычного запроса фразы на локальной консоли в этой загрузке тоже не будет, поэтому резервный вариант загрузки следует проверить заранее.
Шаг второй — отдельный ключ для разблокировки. Заводим его заранее и не смешиваем с основным:
$ ssh-keygen -t ed25519 -f ~/.ssh/unlock_key -N ''
$ scp ~/.ssh/unlock_key.pub user@сервер:/tmp/unlock_key.pub
$ ssh user@сервер "sudo -S sh -c 'mkdir -p /root/.ssh; cat /tmp/unlock_key.pub >> /root/.ssh/authorized_keys; chmod 700 /root/.ssh; chmod 600 /root/.ssh/authorized_keys'; rm /tmp/unlock_key.pub"
Шаг третий — конфиг /etc/initrd.mk. Эти строки добавляются к существующему файлу, не заменяют его. Строку про luks добавлять не нужно: на установке с шифрованием она там уже есть (если вы шифровали корень уже после установки — добавьте и её, вместе с пакетом make-initrd-luks):
FEATURES += network syslog dropbear
PUT_FILES += /etc/passwd /etc/shells /root/.ssh/authorized_keys
PUT_FILES += /etc/dropbear/dropbear_rsa_host_key /etc/dropbear/dropbear_ecdsa_host_key
Про сеть вопросов быть не должно, как и про /etc/passwd с /etc/shells по идее тоже. SSH-серверу нужно знать, под кем пускать.
Шаг четвёртый — host-ключи dropbear. Без них dropbear сгенерирует новые при каждой загрузке, и ваш ssh будет каждый раз истерить про смену ключа хоста:
mkdir -p /etc/dropbear
dropbearkey -t rsa -f /etc/dropbear/dropbear_rsa_host_key
dropbearkey -t ecdsa -f /etc/dropbear/dropbear_ecdsa_host_key
Шаг пятый — маленькая самодельная служба, без которой не будет интерактивного входа. В штатном образе make-initrd нет каталога /dev/pts, поэтому dropbear не может выдать PTY, и ssh -t отваливается с «PTY allocation request failed». Забавно, что rc-скрипт фичи dropbear уже пытается смонтировать devpts, но монтировать некуда: каталога-то нет. Лечится одним скриптом.
Свои каталоги для админских настроек make-initrd пока не завёз, но у него есть переменная PUT_DIRS: каталоги из неё копируются в образ целиком, вместе с деревом. Создаём нашу службу в /etc:
mkdir -p /etc/make-initrd/devpts/etc/rc.d/init.d
Файл /etc/make-initrd/devpts/etc/rc.d/init.d/devpts:
#!/bin/bash
### BEGIN INIT INFO
# Provides: devpts
# Required-Start: cmdline
# Default-Start: 3 4 5
### END INIT INFO
[ "$1" = start ] || exit 0
. /.initrd/initenv
. /etc/init.d/functions
mount_devpts()
{
mkdir -p /dev/pts
mount -t devpts devpts /dev/pts -o mode=0620
}
action_shell 'Mounting devpts:' mount_devpts
Не забудьте chmod +x и допишите в /etc/initrd.mk строку:
PUT_DIRS += /etc/make-initrd/devpts
Шаг шестой — сеть и таймер. Фича network настраивается параметром ядра ip=dhcp. И сразу же, той же строкой, добавьте rootdelay=600 (может пригодится): оба параметра — в переменную GRUB_CMDLINE_LINUX_DEFAULT файла /etc/sysconfig/grub2.
Шаг седьмой — пересборка всего, что зависит от конфигов:
make-initrd
update-grub
В выводе make-initrd появится строка Used features — проверьте глазами, что там есть luks, network, syslog и dropbear. Дальше можно перезагружаться и смотреть.
Перезагружаемся и ждём какое-то время: в initramfs поднимаются сеть (DHCP) и dropbear. Подключаемся самым обычным образом:
ssh -t -o HostKeyAlias=server-initramfs -i ~/.ssh/unlock_key root@сервер
Благодаря службе из пятого шага получаем живое приглашение (initramfs)$ — полноценный интерактивный сеанс. Открываем контейнер:
cryptsetup open /dev/disk/by-uuid/ВАШ-LUKS-UUID ИМЯ-ИЗ-CRYPTTAB
UUID — из второй колонки crypttab, имя (у установщика оно вида luks-) — из первой. cryptsetup сам спросит парольную фразу и отключит эхо; по пути ввод шифрует SSH. Оговорка для параноиков: root на клиенте или в initramfs остаётся доверенной стороной, и от уже подменённого initramfs это не спасает.
Дальше всё происходит само: обработчики прогоняют fsck, монтируют корень, прощаются с dropbear — и наша SSH-сессия обрывается, а система грузится как ни в чём не бывало.
А теперь про rootdelay=600, который может пригодиться. По умолчанию initramfs ждёт корень 180 секунд. Не успели разблокировать — загрузка валится в аварийную оболочку, и дёшево это не лечится: rootdelayd намертво захватывает консольную блокировку, остальные обработчики виснут на ней же, и даже правильно введённая после дедлайна фраза уже ничего не оживит — только перезагрузка и новая попытка. Заодно по консоли в этом состоянии сыплются сообщения «085-luks: unable to activate LUKS (rc=1)» — при headless это нормальный шум, обработчик лишь рапортует, что спрашивать фразу ему запретили. В принципе 180 секунд вполне достаточно чтобы успеть ввести парольную фразу, но для надёжности интервал проще увеличить до rootdelay=600 (на общее время загрузки это всё равно не повлияет).
Проверяем после загрузки: findmnt -n -o SOURCE / отдаёт /dev/mapper/luks-ВАШ-UUID, cryptsetup status показывает активный LUKS2. Сервер поднялся, что не может не радовать.
Список оговорок, идущий в комплекте с любым рецептом «SSH в раннюю загрузку».
Ваш публичный ключ и host-ключи лежат в initramfs, который лежит в /boot, который не шифруется. Кто-то с физическим доступом к диску получит и ключ, и возможность подменить загрузочную среду. От угрозы «диск вынули и унесли» это спасает; от угрозы «диск подменили и подслушивают фразу» — нет, тут нужны другие механизмы, от Secure Boot до выноса /boot на съёмном носителе.
Отдельный ключ для разблокировки — не волшебная защита: запись в authorized_keys без принудительной команды даёт полноценный root в среде initramfs. Ограничение через forced command в dropbear я на стенде не проверял, поэтому вслух обещать не буду.
В known_hosts у машины появится два разных ключа: initramfs-dropbear и системный openssh. Два SSH-сервера — два ключа, всё честно. ssh при встрече второго устроит сцену про man-in-the-middle — не поддавайтесь: у ранней загрузки свой HostKeyAlias (в командах выше он уже прописан), а отпечаток при первом знакомстве сверяем по консоли. Строгую проверку не выключаем: лучше один раз посмотреть отпечаток глазами, чем потом гадать, кто это у нас там разблокировал сервер.
Соберём в одну кучу. Два пакета, три штатные фичи, один самодельный скрипт с открытку, словечко headless в crypttab, rootdelay в параметрах ядра, отдельный ключ, вшитые passwd с shells и host-ключи, пересборка образа с загрузчиком. После перезагрузки вас встречает ssh -t со знакомым запросом фразы, дальше сервер справляется сам. Ручной работы вышло примерно как у редхатовцев; разница в том, что их последнюю милю за них уже написал пакет, а свою мы бахнули сами. Всего-лишь несколько строчек, между прочим (честно говоря на старте я думал, что решение будет куда сложнее).
И напоследок. DHCP в ранней загрузке иногда капризничает, headless запрещает серверу спросить вас на консоли, а таймер тикает при любых раскладах. Так что это, конечно, удобно, но не должно быть единственным ключом от машины. Так что резервный доступ (IPMI, консоль хостера, второй интерфейс со статикой) должен жить отдельно, а всю связку сначала гоняем на сервере, до которого можно дотянуться рукой.

Пакет приезжает в сервер. Миллисекунды на счету. А ядро процессора в этот момент — в глубоком сне, и его сначала надо разбудить.
Кто виноват? Энергосбережение.
Linux из коробки умеет экономить энергию и не держит процессор постоянно в режиме максимальной производительности.
За производительность отвечает CPUFreq: governor задаёт политику, а драйвер и сам процессор выбирают подходящий P-state. В результате частота может гулять вверх-вниз.
За сон — отдельная история: простаивающее ядро уходит в C-state.
Для обычного веб-хостинга это разумно. Для высокочастотного трейдинга, VoIP и других систем, чувствительных к задержкам, это уже может стать проблемой. Выход из глубокого C-state занимает микросекунды. Микросекунды складываются в джиттер, лаги и потерянные тики.
Сначала — как устроен сон процессора. Есть несколько состояний, и это почти как на работе:
C0 — работает. Исполняет инструкции, кофе, всё такое.
C1/C1E — задремал на стуле. Исполнение остановлено, но просыпается быстро.
C3/C6 и глубже — уехал домой. Всё больше блоков процессора переводится в энергосберегающий режим.
Экономия растёт с глубиной сна. Но вместе с ней обычно растёт и время выхода из idle.
Правило простое: чем глубже уснул, тем дороже просыпаться.

Ядро без работы, тихо сваливающее в C6.
Теперь лечение. Понадобятся две утилиты: cpupower — смотреть и крутить параметры CPU, и tuned — применять готовые профили настройки системы.
Ubuntu/Debian:
sudo apt update
sudo apt install linux-tools-common linux-tools-generic tuned -y
CentOS/RHEL:
sudo dnf install kernel-tools tuned -y
И запускаем демон, чтобы настройки переживали перезагрузку:
sudo systemctl enable --now tuned
Сначала — политика управления частотой:
cpupower frequency-info
В выводе ищем блок current policy: минимальную и максимальную частоты, активный governor и используемый scaling driver.
Для наглядности можно посмотреть и на частоты из /proc/cpuinfo:
watch -n 1 "grep 'cpu MHz' /proc/cpuinfo"
Но воспринимать это как точный осциллограф не стоит: на современных CPU реальная частота может меняться быстрее, чем успевает обновляться такой вывод.
Теперь смотрим idle-состояния:
cpupower idle-info
А если хочется увидеть, сколько времени CPU действительно проводит в разных состояниях:
sudo cpupower monitor -i 1
Вот это уже интереснее. Мы можем не только что-то настроить, но и потом проверить, действительно ли процессор перестал проводить время в глубоких C-states.

Смотрим, как частоты и idle-состояния живут своей жизнью.
Дальше — профиль. Вместо ручной крутилки десятков параметров у TuneD есть готовые профили. Для систем, чувствительных к задержкам, нас интересует latency-performance.
tuned-adm list
sudo tuned-adm profile latency-performance
tuned-adm active
Профиль переводит CPU в режим, ориентированный на производительность: включает performance, поднимает минимально запрашиваемый уровень производительности и отключает часть энергосберегающих оптимизаций.
Процессор перестаёт экономить на каждом удобном случае.
Но физическая частота всё ещё может меняться. Причины: Turbo, аппаратное управление производительностью, ограничения по температуре и мощности. Поэтому правильнее говорить не «частота прибита гвоздями», а «система больше не пытается агрессивно её занижать».
Для сетевых задач у TuneD есть родственный профиль network-latency, но сегодня мы говорим именно про latency-performance.
Но есть нюанс: частота — это P-states. Глубокий сон — C-states.
Сам Governor запретить ядрам уезжать домой не может.

Нельзя просто взять и запретить процессору спать через Governor.
Но мы включили не просто Governor, а профиль TuneD.
latency-performance знает про эту проблему и ограничивает допустимую задержку выхода из idle через PM QoS. В результате CPUIdle перестаёт выбирать слишком глубокие C-states с большой exit latency.
То есть в большинстве случаев на этом уже можно остановиться.
Проверяем:
tuned-adm verify
sudo cpupower monitor -i 1
Если профиль применён корректно, в мониторинге должно быть видно, что процессор перестал надолго проваливаться в глубокие idle-состояния.
Иногда хочется не попросить CPUIdle избегать глубоких состояний, а вообще не давать драйверу их использовать.
Тогда можно ограничить C-states через параметры ядра.
Но сначала нужно понять, какой CPUIdle-драйвер работает:
cat /sys/devices/system/cpu/cpuidle/current_driver
Если используется intel_idle, можно ограничить его, например:
intel_idle.max_cstate=1
Если используется acpi_idle:
processor.max_cstate=1
Ориентироваться только на логотип Intel или AMD здесь не стоит. Важен именно активный CPUIdle-драйвер.
На Ubuntu/Debian параметры обычно добавляют в /etc/default/grub в строку:
GRUB_CMDLINE_LINUX_DEFAULT="..."
После чего:
sudo update-grub
И перезагрузка.
На RHEL/CentOS удобнее использовать grubby, например:
sudo grubby --update-kernel=ALL --args="intel_idle.max_cstate=1"
Для acpi_idle соответственно:
sudo grubby --update-kernel=ALL --args="processor.max_cstate=1"
После перезагрузки проверяем ещё раз:
cpupower idle-info
sudo cpupower monitor -i 1
Теперь глубокие idle-состояния должны быть недоступны или практически не использоваться — в зависимости от выбранного способа настройки.
Итог: сервер стал прожорливее и горячее (а счета за электричество весомее), зато ядрам больше не дают проваливаться в глубокий сон.
Пакет приехал — разбудить процессор можно гораздо быстрее.
Если процессор не уходит в глубокий сон, из латентности исчезает ещё один источник непредсказуемости.
Для трейдинга, VoIP и других систем, чувствительных к задержкам, это как раз тот случай, когда микросекунды действительно имеют значение.
Вы наверняка сталкивались с этим эффектом: монтируете sshfs, rclone mount или gocryptfs — и после этого файловый менеджер, редактор, архиватор и бэкапилка работают с появившимся каталогом так, будто перед ними самая обычная файловая система. Хотя байты могут жить на сервере, в S3, внутри шифрованного каталога или вообще рождаться на лету.
Как программа из userspace умудряется встать между open() и данными так, чтобы остальная система ничего особенного не заметила? Сегодня разберёмся. Заваривайте чай покрепче (ядро любит крепкий), устраивайтесь поудобнее — поговорим про FUSE.
Сразу одна оговорка, чтобы не заложить мину в фундамент статьи: не всякая «сетевая папка» или подключённый телефон в файловом менеджере — это FUSE. GNOME GVfs, KDE KIO и MTP умеют показывать похожую картину на уровне приложений. FUSE идёт глубже: он подключается к файловому стеку ядра, поэтому смонтированное дерево видят обычные программы через привычные open(2), read(2), stat(2) и компанию.
Обычные Linux-файловые системы вроде ext4, XFS и btrfs работают в ядре. Но причина не совсем в том, что «только ядро умеет трогать диск». Процесс с достаточными правами вполне может открыть блочное устройство и читать его напрямую.
Главное другое.
Главное — не доступ к блочному устройству, а единый слой, через который приложения вообще видят файлы.
В Linux эта задача была решена задолго до появления FUSE. Между программой и конкретной файловой системой находится VFS — Virtual File System: общий слой ядра, который позволяет ext4, XFS, NFS, tmpfs и десяткам других файловых систем выглядеть для приложений одинаково.
Программа говорит open("/home/user/file"), а VFS разбирается, какой mount находится под этим путём и какой конкретной файловой системе передать операцию.
И вот спустя годы разработчики FUSE посмотрели на уже существующую архитектуру и задались интересным вопросом: а обязательно ли реализация, которой VFS передаёт эти операции, должна целиком жить в ядре?
А теперь представьте, что вы придумали супер-файловую систему. Например, хотите показывать почтовый ящик как каталог: письмо — файл, папка IMAP — директория, вложения — ещё файлы. Или хотите сделать файловый интерфейс к архивам, облаку, базе данных, удалённому серверу — да хоть к API кофеварки.
Путь первый — модуль ядра.
А это уже kernel-space: C, никаких привычных libc-шных удобств, аккуратная работа с памятью и блокировками, внутренние API ядра, которые для внешних модулей не обязаны вечно оставаться стабильными, и возможность превратить обычную ошибку в kernel oops или panic.
Знаете, как называется человек, который добровольно так делает?
Правильно: разработчик файловых систем ядра.
Их мало, и теперь вы возможно понимаете почему.
Обычная рабочая обстановка разработчика kernel space
Но хотелось другого: чтобы файловую логику можно было написать обычной программой в userspace, отлаживать как обычную программу и при этом подключить к VFS так, чтобы остальная система видела нормальный mount.
Вот для этого и появился FUSE.
История FUSE связана с венгерским разработчиком Миклошем Середи (Miklos Szeredi) и проектом AVFS — Virtual File System, который позволял обращаться к архивам и другим необычным источникам данных как к каталогам.
AVFS сначала экспериментировал с трюками вроде LD_PRELOAD, затем использовал интерфейс Coda. Но у обоих подходов были ограничения. В какой-то момент Середи решил, что нужен отдельный универсальный мост между VFS ядра и файловой системой в пользовательском процессе.
Так появился FUSE — Filesystem in Userspace.
Публичное объявление FUSE датируется 12 ноября 2001 года. Стабильный FUSE 1.0 вышел 20 февраля 2003-го. А 27 октября 2005 года FUSE вошёл в основное ядро Linux 2.6.14.
Это важная последовательность: FUSE не возник внезапно в момент попадания в mainline. К тому времени проект уже несколько лет жил отдельно, развивался и доказывал, что идея вообще работает. Ну знаете, как та история как когда bcachefs выпиздили из mainline, но только наоборот.
Идея была довольно дерзкая: оставить в ядре универсальную часть, необходимую для связи с VFS, а специфическую логику конкретной файловой системы вынести в обычный процесс.
То есть не «вытащить файловые системы из ядра вообще», а провести новую границу ответственности.
С этого момента экзотическую файловую систему стало возможно разрабатывать без собственного kernel-модуля. А обычный пользователь при подходящей конфигурации системы мог монтировать FUSE-файловые системы без полноценного root-доступа.
И вот тут начинается самое интересное.
Упростим путь одного чтения файла.
Допустим, программа делает:
open("/mnt/cloud/photo.jpg", ...)
read(fd, buf, 4096)
Если /mnt/cloud — FUSE-mount, схема примерно такая:
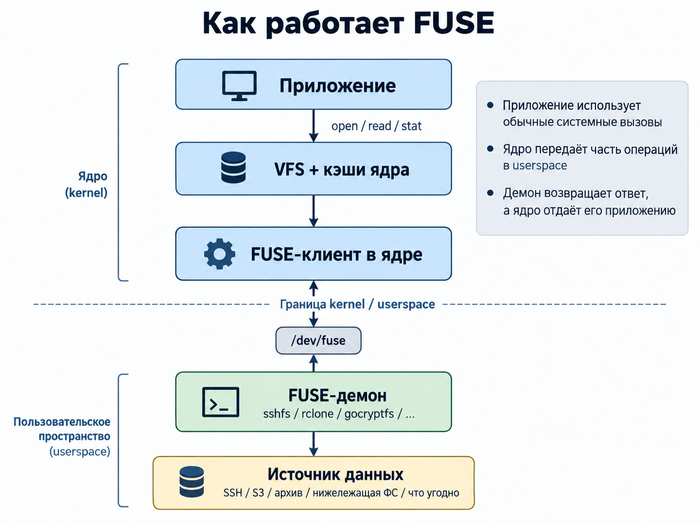
Происходит следующее.
Программа вызывает обычный системный вызов. Никакого специального FUSE API она не знает.
VFS определяет, к какому mount относится путь. Часть работы ядро вообще может выполнить без обращения к демону — например, если нужные данные или метаданные уже есть в кэше.
Если для операции нужен userspace, FUSE-клиент в ядре формирует запрос. Он помещается в очередь соединения FUSE и становится доступен через специальное символьное устройство /dev/fuse.
FUSE-демон читает запрос из /dev/fuse. Например: «прочитай такой-то файл с такого-то смещения». Дальше ядру всё равно, откуда демон возьмёт результат. Он может прочитать локальный файл, сходить по SSH, запросить объект из S3, расшифровать блок или сгенерировать содержимое на лету.
Демон записывает ответ обратно в /dev/fuse. Ядро принимает его, обновляет своё состояние и завершает системный вызов приложения.
Получается почти МФЦ файловых систем.
Приложение приносит заявление ядру. Ядро понимает, что вопрос не по его ведомству, выдаёт талончик FUSE-демону, тот бегает по нужным инстанциям и возвращает официальный ответ. А заявитель на выходе получает обычные байты и вообще может не знать, что половина учреждения сидела в userspace.
Важно только не воспринимать метафору слишком буквально: не каждый read() обязательно превращается в отдельный поход через /dev/fuse. VFS, page cache, attribute cache и собственные механизмы FUSE умеют часть обращений обслуживать без нового round trip.
Именно поэтому точнее говорить не «FUSE пересылает в userspace каждый файловый вызов», а «FUSE пересылает туда те операции, для которых ядру нужен ответ файлового сервера».
Вот здесь у userspace есть огромный практический плюс.
Если ошибка происходит в файловой системе внутри ядра, радиус поражения потенциально велик: повреждение памяти, oops, deadlock, panic — спектр развлечений широкий.
Если падает FUSE-демон, ядро обычно продолжает жить.
Но есть важное «но»: сам mount после этого здоровее не становится. Процессы, которые обращаются к нему, могут получать ошибки, а некоторые незавершённые запросы способны зависнуть до разрыва/abort соединения.
То есть FUSE не превращает плохой код в безопасный. Он прежде всего изолирует значительную часть файловой логики от kernel-space. Ошибка теперь чаще ломает конкретную файловую систему и её клиентов, а не всю ОС.
Это всё ещё намного приятнее, чем отлаживать свежий kernel-модуль на машине, на которой вы параллельно пишете статью о преимуществах userspace.
Сам системный вызов mount(2) — привилегированная операция. Поэтому в классической схеме libfuse есть небольшой помощник fusermount, а в современных версиях — fusermount3.
Обычно он устанавливается setuid-root и выполняет строго ограниченную привилегированную часть операции: проверяет условия, открывает нужное FUSE-соединение и помогает создать mount от имени пользователя. Сама файловая система после этого работает обычным процессом с обычными пользовательскими правами.
Отсюда же ещё одна деталь безопасности.
По умолчанию FUSE-mount пользователя не должен внезапно становиться ловушкой для всех соседей по машине. Чтобы разрешить доступ другим пользователям, файловую систему монтируют с опцией:
-o allow_other
А чтобы не-root пользователь вообще имел право запросить allow_other, администратор должен разрешить это в /etc/fuse.conf:
user_allow_other
То есть user_allow_other сам по себе никому mount не «расшаривает». Он только разрешает обычным пользователям применять опцию allow_other.
Маленькая деталь, но именно на таких деталях обычно и живёт безопасность многопользовательской системы.
А дальше случилось то, что обычно случается с хорошей абстракцией: люди начали запихивать в неё всё подряд.
SSHFS появился в 2004 году и сделал почти неприлично простой следующую вещь: берём SFTP и показываем удалённый сервер как локальный каталог. Никакого отдельного сетевого файлового протокола для приложения — оно просто читает файлы.
NTFS-3G в июле 2006-го вышел как beta, а 21 февраля 2007 года получил стабильный релиз 1.0. Для Linux-пользователей эпохи dual boot это было почти бытовой магией: полноценная запись на NTFS без внедрения самой реализации NTFS-3G в ядро. Сегодня в Linux есть и отдельный in-kernel драйвер ntfs3, поэтому NTFS-3G интересен здесь прежде всего как исторически важный пример возможностей FUSE.
Есть EncFS и gocryptfs, которые показывают расшифрованное представление данных поверх зашифрованного каталога.
Есть s3fs и rclone mount, превращающие объектные и облачные хранилища в дерево файлов — иногда с теми семантическими компромиссами, которые неизбежны, когда API вида «положить объект по ключу» заставляют притворяться POSIX-файловой системой.
Есть GlusterFS. У CephFS есть и kernel-клиент, и userspace-вариант ceph-fuse, так что говорить «CephFS работает через FUSE» целиком было бы неверно — FUSE там один из способов подключения.
А в 2009 году появился ещё один родственник — CUSE, Character device in Userspace. Он вошёл в Linux 2.6.31 и применил ту же идею уже к символьным устройствам: kernel-side прокладка, а логика устройства — в userspace. Один из ранних показательных примеров, OSS Proxy, создавал через CUSE привычные /dev/dsp, /dev/adsp и /dev/mixer, а дальше пересылал звук в userspace-аудиостек.
То есть кто-то посмотрел на FUSE и сказал:
— А файловыми системами ограничиваться обязательно?
Конечно нет.
С Android легко написать эффектную фразу и почти гарантированно соврать.
История shared/external storage там несколько раз менялась. В старых версиях Android использовался FUSE-слой, который в том числе помогал реализовывать нужную модель доступа к общему хранилищу. В Android 8 ради производительности появился SDCardFS — реализация в ядре. Затем архитектура снова изменилась: в Android 11 SDCardFS для современных устройств был выведен из игры, а эмуляция shared storage вернулась к обновлённому FUSE-подходу вместе с MediaProvider и scoped storage.
В Android 12 появился ещё и Android-специфичный FUSE passthrough для некоторых веток ядер 5.4/5.10.
И это отдельная причина не писать, что «FUSE passthrough появился в Linux 5.15». В Android похожая технология жила в своих kernel-ветках раньше, чем её вариант попал в mainline Linux.
А если вы просто открыли телефон по MTP в Nautilus или Dolphin — это вообще может быть GVfs/KIO, а не FUSE-mount. Внешне похоже, этаж абстракции другой.
В конце 2010-х появился virtiofs — файловая система для быстрого совместного доступа виртуальной машины к дереву каталогов на хосте. Поддержка virtiofs есть в mainline начиная с Linux 5.4 (2019).
Тут особенно интересно, что virtiofs использует протокол FUSE, но классическая схема меняется: вместо обычного обмена guest-демона с ядром через /dev/fuse запросы идут между гостем и хостом через virtio/virtqueues.
То есть FUSE к этому моменту оказался уже не только удобным способом написать userspace-файловуху. Его протокол стал строительным блоком для других архитектур.
Неплохо для идеи, выросшей из желания нормально лазить по архивам.
А вот здесь наступает момент, когда за удобную абстракцию приходит счёт.
Если операция не обслужилась из кэша, классический FUSE-путь требует передать запрос из ядра в userspace, разбудить демон, обработать запрос и передать ответ обратно. Добавьте переключения контекста, копирование/маппинг данных, очереди, планировщик — и на большом количестве мелких операций накладные расходы становятся заметны.
Отсюда многолетняя репутация FUSE как «удобно, но медленно».
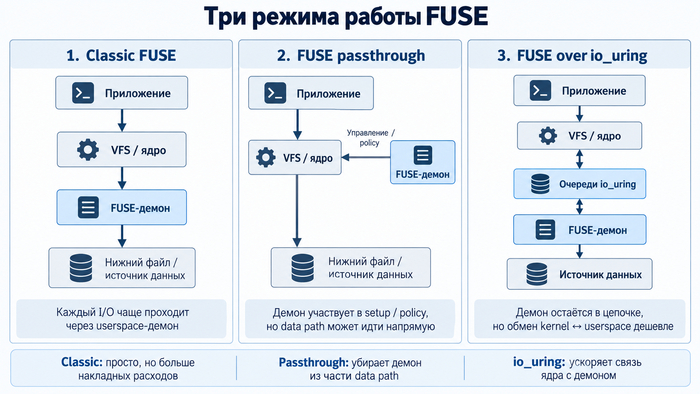
За последние годы в ядре появилось как минимум два важных ответа на эту проблему. И они решают разные задачи.
В Linux 6.9, вышедшем в мае 2024 года, в mainline появился FUSE passthrough для обычного файлового I/O.
Идея такая: иногда userspace-демон нужен, чтобы решить, какому реальному файлу соответствует FUSE-файл, проверить политику или подготовить отображение. Но после этого нет особого смысла гонять через демон каждый read() и write(), если данные в итоге всё равно лежат в обычном backing file на нижележащей файловой системе.
Демон регистрирует backing file и при открытии говорит ядру примерно: «вот этому FUSE-файлу соответствует вот этот нижний файл». После этого поддерживаемые операции чтения/записи и mmap ядро может направлять непосредственно в backing filesystem.
Это очень мощная оптимизация, но не волшебная кнопка «ускорить любой FUSE».
Если ваши данные на самом деле синтезируются демоном, лежат в S3 или прилетают с другого конца SSH-соединения, реального локального backing file может просто не быть. Пропускать демон тогда некуда.
Кроме того, нынешняя upstream-реализация накладывает ограничения на создание passthrough-отображений: это не механизм, который произвольный непривилегированный FUSE-сервер автоматически получает бесплатно.
Так что правильнее думать о passthrough как об ускоренном маршруте для определённого класса FUSE-файловых систем.
В Linux 6.14, вышедшем 24 марта 2025 года, появилась другая оптимизация: FUSE over io_uring. Основную серию патчей для нового транспорта вёл Бернд Шуберт (Bernd Schubert).
Здесь никто не пытается убрать userspace-демон из схемы. Вместо этого меняется транспорт между ядром и демоном.
Классический /dev/fuse-интерфейс исторически означает много отдельных операций чтения и записи запросов. io_uring позволяет организовать очереди эффективнее: обрабатывать несколько запросов с меньшим syscall overhead, совмещать возврат ответа на старый запрос с получением нового и лучше сохранять CPU/NUMA locality.
Условно:
Classic:
kernel -> request -> daemon
kernel <- reply <- daemon
kernel -> request -> daemon
kernel <- reply <- daemon
io_uring:
kernel <==== queues / batches / commit+fetch ====> daemon
На микробенчмарках ранних patch series результаты местами были очень впечатляющими: отдельные сценарии показывали ускорения в два-три раза, а некоторые direct-I/O тесты — ещё больше. Но разброс между workload'ами огромный: другие тесты были близки к прежней скорости, а в одном из более поздних наборов измерений выигрыш составлял около 25%.
Поэтому фраза «в Linux 6.14 FUSE стал в несколько раз быстрее» была бы отличным заголовком и плохим техническим утверждением.
Корректнее так: FUSE-over-io_uring заметно снижает накладные расходы связи kernel -userspace и на подходящих нагрузках способен дать большой выигрыш, но величина ускорения сильно зависит от конкретной нагрузки.
И есть ещё одна важная деталь: поддержка io_uring-пути развивалась постепенно, и не все типы FUSE-запросов обязаны проходить через него — часть служебного обмена по-прежнему может использовать /dev/fuse.
Вот это различие стоит запомнить:
passthrough пытается не ходить к демону там, где данные можно отдать напрямую из backing file;
io_uring оставляет демон в цепочке, но делает сам обмен с ним дешевле.
Две оптимизации, две разные причины тормозов.
FUSE не доказал, что «файловые системы не нужны в ядре», и в целом не преследовал такую цель.
В ядре по-прежнему остаются VFS, mount namespace, кэши, проверки доступа, FUSE-клиент и куча другой работы. Из kernel-space вынесли то, что особенно удобно выносить: специфическую логику конкретной файловой системы.
И в этом, пожалуй, главное достижение FUSE.
Без него все перечисленные вещи не были бы физически невозможны — существовали и существуют kernel-модули, сетевые файловые протоколы, Coda, NFS, GVfs/KIO и другие способы решать похожие задачи.
Но FUSE сделал одну конкретную штуку почти рутинной:
обычный процесс может выставить произвольный источник данных в общий файловый namespace так, чтобы обычные программы работали с ним через привычные файловые системные вызовы.
Хотите файловую систему поверх SSH — пожалуйста.
Поверх шифрованного каталога — пожалуйста.
Поверх S3 — с оговорками, но пожалуйста.
Хотите протокол FUSE между виртуалкой и хостом — и до этого дошли.
А началось всё с вопроса: обязательно ли вся специфическая логика файловой системы должна жить в ядре?
Оказалось — нет.
И ядро с этим вполне ужилось: оставило себе контроль над границей, а userspace выдало окошко для приёма заявлений — почти как в МФЦ.
Нажимаем Ctrl+Alt+F3, получаем чёрный экран с приглашением login: и обычно называем всё это «консолью» или «TTY».
Кто рисует буквы? Кто читает клавиатуру? Где здесь getty, а где terminal emulator? Почему kitty и Alacritty живут в userspace, а системная Linux-консоль исторически устроена иначе?
В статье я разбираю этот стек на работающем kmscon (преимущественно конечно потому, что мне очень интересно было посмотреть, как организован перенос консоли в userspace). Программа здесь нужна как стенд: её можно запустить на одном VT, посмотреть файловые дескрипторы и журнал, и увидеть границу между kernel VT, PTY, эмулятором терминала и DRM.
Упрощённо классический путь выглядит так:
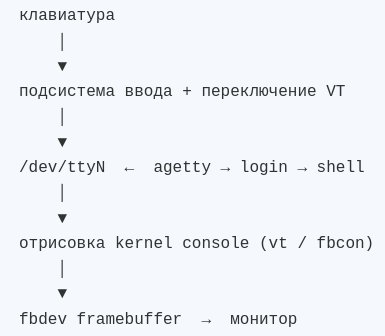
/dev/tty3 здесь не bash и не эмулятор. Это виртуальная консоль ядра. agetty печатает /etc/issue, выставляет скорость линии (на VT это формальность) и запускает login. Shell читает и пишет байты. Escape-последовательности вроде ESC[31m кто-то должен интерпретировать: в классической Linux console значительная часть этой работы исторически сидит в ядре. fbcon рисует в framebuffer; на современных GPU этот framebuffer часто даёт fbdev-эмуляция DRM-драйвера, но сама kernel console не ходит в KMS так, как это делает kmscon.
Короткий словарь, без которого дальше легко запутаться:
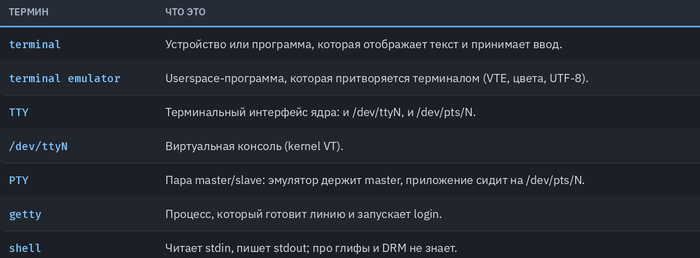
kmscon остаётся системной консолью: на обычном seat0 он привязан к конкретному kernel VT, например tty3, чтобы ядро переключало его вместе с остальными консолями. Эмуляция терминала, шрифты, клавиатура и отрисовка идут уже в userspace; на монитор картинка уходит через DRM/KMS или fbdev.

Это не схема исходников один в один, но она совпадает с устройством объекта terminal в v10.0.3:
struct kmscon_terminal {
struct tsm_screen *console;
struct tsm_vte *vte;
struct kmscon_pty *pty;
struct kmscon_font *font;
/* ... */
};
В одном процессе собраны state machine терминала (libtsm), PTY, шрифт и вывод. Видеоподсистема в этой сборке умеет drm2d, drm3d и fbdev; среди renderer'ов есть software bbulk и OpenGL ES gltex.
Оговорка, без которой легко написать лишнее: kmscon на seat0 не «удаляет kernel VT». Он занимает один VT как слот переключения и рисует уже своим renderer'ом. Соседние консоли могут по-прежнему быть обычным fbcon.
Первый запуск лучше делать не на tty1 (как минимум потому что некоторые дистрибутивы любят занимать его для запуска графического сервера) . Unit kmsconvt@.service занимает конкретный VT и конфликтует с getty на том же номере:
Conflicts=getty@%i.service
OnFailure=getty@%i.service
ExecStart=kmscon --vt=%I --no-switchvt
--no-switchvt не перехватывает активную консоль: процесс садится на tty3 и ждёт, пока этот VT станет передним. Conflicts при старте остановит getty@tty3, поэтому перед командой стоит глянуть, что там никого нет.
who
fgconsole
systemctl is-active getty@tty3.service
sudo systemctl start kmsconvt@tty3.service
Сразу после старта в журнале есть VT и шрифт, но ещё нет DRM:
NOTICE: using tty /dev/tty3
NOTICE: font_freetype: Using font Hack Regular
NOTICE: font_freetype: Using font Hack Bold
В /proc/$pid/fd то же самое: открыт /dev/tty3, /dev/dri/card0 нет. kmscon не забирает GPU, пока его VT неактивен.
После chvt 3 появляется строка, которая уже описывает реальный путь отрисовки:
NOTICE: terminal: Display [...] with backend [drm2d] text renderer
[bbulk] font engine [freetype]
Software-путь: DRM без 3D (drm2d), renderer bbulk, глифы через FreeType. chvt 1 вернул графический сеанс на место.
На рабочей машине я бы несколько дней пожил с kmscon только на дополнительном VT и только потом решал, нужен ли он на всех консолях. Это кусок recovery path.
Пока VT активен:
kmscon --vt=tty3 --no-switchvt
`- login -p
agetty в дереве нет. С 10.0.2 kmscon сам разбирает /etc/issue и запускает login.
Дескрипторы процесса kmscon после активации VT:
/dev/tty3
/dev/dri/card0
/dev/ptmx
/dev/input/event* # клавиатура и мышь
У login stdin/stdout/stderr смотрят в /dev/pts/2. Внутри сессии то же устройство:
/dev/pts/2
COLORTERM=truecolor
Shell сидит на PTY slave. /dev/tty3 держит kmscon как слот kernel VT. Байты от shell идут в PTY master, libtsm разбирает escape-последовательности, FreeType рисует глифы, bbulk кладёт их в DRM.
--reset-env по умолчанию включён, поэтому дочернему процессу kmscon отдаёт короткое окружение. COLORTERM=truecolor он выставляет сам.
printf 'English: Hello world\n'
printf 'Русский: Привет, мир\n'
printf 'CJK: 日本語 中文\n'
printf '\e[31mRED\e[0m \e[32mGREEN\e[0m \e[34mBLUE\e[0m\n'
Байты ушли в PTY. Корректная обработка UTF-8 и наличие глифа в выбранном шрифте это разные вещи.
С --hwaccel тот же VT идёт другим путём:
Display [...] with backend [drm3d] text renderer [gltex] font engine [freetype]
Консоль поднялась. Насколько gltex быстрее bbulk, без своего бенчмарка я цифр не ставлю. Man page обещает заметный выигрыш на новом железе.
setfont меняет шрифт kernel console. kmscon рисует сам, поэтому setfont ему безразличен. loadkeys тоже: раскладка идёт через libxkbcommon. Оба отличия прямо описаны в README.
Zoom (Ctrl++ / Ctrl+-) и scrollback (Shift+PageUp) в man заданы как штатные grab'ы: это уже поведение userspace-renderer'а, а не fbcon.
По умолчанию kmscon выставляет TERM=kmscon, а проект поставляет собственное описание terminfo.
$TERM едет на удалённую машину вместе с SSH PTY. Описание возможностей нужно уже там.
Если записи нет, приложения это видят сразу:
REMOTE_TERM=kmscon
infocmp: error: no match in terminfo database for terminal type
"kmscon"
tput: unknown terminal "kmscon" # exit 3
Тот же SSH с TERM=xterm-256color:
REMOTE_TERM=xterm-256color
tput colors
256
$TERM не имя бинарника, в котором запущена shell. Это идентификатор набора terminal capabilities. Приложение смотрит его через terminfo. Лечится установкой описания kmscon на удалённой стороне. Подменять тип терминала вручную на каждой SSH-сессии хуже: приложениям сообщают чужой набор возможностей.
То же чинят в разделе troubleshooting ArchWiki.
Доступ к modesetting через primary DRM node и к сырым input devices нужно координировать: кто-то должен решить, какой сеанс сейчас активен, кому разрешено работать с GPU и клавиатурой и когда эти устройства нужно отдать другому сеансу.
Нужно понимать, какой процесс сейчас на переднем плане seat, когда он должен отпустить карту, и когда может взять её обратно.
kmscon умеет ходить в libseat (systemd-logind, elogind или seatd). Сборка с libseat опциональна, meson default false. Без неё остаётся собственная работа с VT. На практике это выглядит так:
старт с --no-switchvt на неактивном tty3: процесс есть, /dev/dri/card0 ещё не открыт;
chvt 3: у kmscon появляются /dev/dri/card0 и /dev/input/event*;
chvt 1: графический сеанс снова на месте.
Открытый /dev/dri/card0 показывает, что на активном VT kmscon получает доступ к DRM-устройству. Сам по себе этот fd ещё не доказывает статус DRM master. Но переключение обратно на vt1 показывает, что управление display path корректно возвращается графической сессии.
OnFailure=getty@%i.service срабатывает. Если instance kmscon падает, systemd поднимает обычный getty на том же VT:
/sbin/agetty --noreset --noclear --issue-file=... - linux
systemctl enable kmsconvt@ делает autovt@.service alias на этот шаблон: автоматически создаваемые VT пойдут в kmscon. Сервисы, которые явно зависят от getty@.service, не изменятся. На машине, где tty1 это recovery, я бы так не делал с первого дня.
Где от kmscon мало прока:
headless, только SSH;
serial console;
облачная VM без GPU, на которую вы всё равно не смотрите.
Пока его VT активен, kmscon использует DRM/KMS display path и должен координировать доступ к primary DRM device с графической сессией. README предупреждает: второй display server/compositor не сможет просто независимо забрать KMS-управление той же картой. Для передачи карты есть kmscon-launch-gui; связка с современным Wayland/libseat это уже отдельная история.