
Это все современное образование, не запомнил малыш такие числа как 10, 20, 30
Показать полностью
1
Вопрос: что мы получим, если к 16489 прибавим 56484, извлечем квадратный корень и поделим на 97.86859 ?
Девочка заменила каждую букву в своём имени её номером в русском алфавите. Получилось число 221811525619121. Как её зовут?
Как бывает у людей дислексия, так у меня дисчислия: я путаю цифры.
Я путаю даты, рубли, минуты и часы. Скажем, я могу запомнить, что какая-то встреча будет через час после 6 вечера - и у меня в голове этот час сохраняется, но до или после шести - уже забывается. И я могу приехать на встречу в 5, а не в 7 (хотя 17 и 7 тоже легко спутать, когда речь про время, но у меня сбой другого типа).
Или я постоянно путаю 1999 и 2009. Потому что в голове запоминается "девятый год", а предыдущие цифры вообще являются фоном, они не участвуют в запоминании.
Так как эта проблема неисправима, я просто придумываю себе дополнительные проверки: перед тем как взаимодействовать с каком-либо числом или датой, нужно два раза убедиться, что я имею в виду именно нужное.
Глава 12. Разграбленная земля
...Мартин Тирони Родо, профессор Католического университета в Сантьяго и директор чилийского аналитического центра Futures of Artificial Intelligence Research, резюмирует настроения, которые он неоднократно слышал от сообществ по всей стране. Эти движения задаются вопросом о том, как представить себе новый путь развития ИИ, не основанный на добыче полезных ископаемых. Он подчеркивает, что продолжение развития этой технологии в прежнем виде нанесет вред Земле.
«Цифровые» технологии не являются исключительно цифровыми. Облако» не имеет бесплотной формы. Для обучения и использования моделей ИИ нужны физические центры обработки данных. Генеративным моделям ИИ OpenAI для обучения и работы требуется больше и больше центров обработки данных, чем когда-либо прежде.
До появления искусственного интеллекта центры обработки данных уже росли и разрастались. Раньше они были небольшими и разрозненными, спрятанными в городских районах, с несколькими компьютерами на полках в шкафу или несколькими стойками в переоборудованном здании. В 2000-х годах крупные технологические компании начали объединять свою вычислительную инфраструктуру в огромные серверные склады в сельской местности. Индустрия центров обработки данных разделилась на гипермасштабируемые компании, такие как Google, Microsoft, Amazon, Meta и другие. Эти ведущие гипермасштабируемые компании ежегодно тратят на строительство центров обработки данных больше денег, чем все менее известные девелоперы вместе взятые, такие как Equinix и Digital Realty.
Трудно представить себе гипермасштабный центр обработки данных, если вы никогда его не видели. Мел Хоган, доцент канадского Университета королевы, занимающаяся исследованиями в области искусственного интеллекта, инфраструктуры и окружающей среды, еще десять лет назад сравнивала их с футбольными полями. Однако теперь она считает, что это сравнение не отражает их реальных размеров. Гипермасштабирующие компании называют свои центры обработки данных «кампусами», которые представляют собой огромные участки земли, сравнимые с крупнейшими университетами Лиги плюща. В этих кампусах расположено несколько массивных зданий, заполненных рядами компьютерных стоек. Компьютеры выделяют значительное количество тепла, аналогичное интенсивно работающему ноутбуку, умноженному на миллион. Чтобы предотвратить перегрев, здания оснащены большими системами охлаждения, такими как вентиляторы, кондиционеры или системы испарения воды для охлаждения серверов. Коллективное оборудование производит постоянный шум, гул, жужжание и треск, слышимый за многие километры, особенно в менее развитых районах, создавая постоянное и физически неприятное шумовое загрязнение.
Теперь разработчики используют новый термин в эпоху ИИ после ChatGPT: «мегакампус». Этот термин относится не только к площади, но и к значительному количеству энергии, необходимой для их работы. Стойка графических процессоров потребляет в три раза больше энергии, чем другие компьютерные чипы. Стоимость обучения генеративных моделей ИИ высока, как и стоимость их обслуживания. По данным Международного энергетического агентства, каждый запрос ChatGPT требует примерно в десять раз больше электроэнергии, чем обычный поиск в Google. Раньше крупнейшие центры обработки данных были мощностью около 150 мегаватт, потребляя энергию, эквивалентную 122 000 американских домохозяйств в год. Сейчас разработчики и коммунальные компании готовятся к созданию мегакампусов ИИ, которым может потребоваться от 1 000 до 2 000 мегаватт энергии. Один мегакампус может потреблять столько же энергии в год, сколько полтора-три с половиной Сан-Франциско.
Немногие места на планете могут генерировать и поставлять столько энергии в одно место, как центры обработки данных. Девелоперы по всему миру сотрудничают с коммунальными компаниями, чтобы построить больше электростанций и расширить возможности. В США после десятилетия стагнации спроса на электроэнергию анализ Goldman Sachs показал, что значительное увеличение числа центров обработки данных приведет к беспрецедентному росту потребления электроэнергии. Коммунальные компании откладывают вывод из эксплуатации газовых и угольных станций и переход на возобновляемые источники энергии. Microsoft даже возобновила работу Three Mile Island, атомной станции в Пенсильвании, на которой в конце 1970-х годов произошел частичный распад. По оценкам, к 2030 году центры обработки данных будут потреблять 8 % электроэнергии в стране по сравнению с 3 % в 2022 году. В глобальном масштабе вычисления с использованием искусственного интеллекта могут превзойти по энергопотреблению Индию - третьего по величине потребителя электроэнергии в мире.
Меrа-rипермасштабы привели к значительному воздействию на окружающую среду. Однако компании все чаще скрывают эти последствия. Следуя исследованиям Эммы Струбелл и работе Гебру в «Стохастических попугаях», технологические гиганты скрывают все больше технической информации о своих моделях, что затрудняет оценку их углеродного следа. Одновременно эти компании активизируют свои усилия по воздействию на общественность и политиков с помощью контраргументов: Центры обработки данных станут более эффективными, генеративный ИИ будет стимулировать климатические инновации, а AGI в конечном итоге решит проблему изменения климата.
Если последнее утверждение невозможно доказать, то первые два вводят в заблуждение, считает Саша Лучиони, исследователь и руководитель отдела климата в компании Hugging Face, занимающейся разработкой ИИ с открытым исходным кодом. Второе утверждение особенно вредно. Некоммерческая инициатива Climate Change AI перечислила множество технологий ИИ, которые могут ускорить работу по обеспечению устойчивости, но они редко являются генеративными технологиями ИИ. Лучиони, один из основателей инициативы, подчеркивает, что для климатических целей необходимы модели контролируемого обучения, модели обнаружения аномалий или статистические модели временных рядов. Эти модели представляют собой старые поколения технологий ИИ, в основном инструменты машинного обучения, которые компактны, энергоэффективны и могут работать даже на мощном ноутбуке. «Генеративный ИИ потребляет много энергии и имеет значительный углеродный след при минимальной пользе для окружающей среды», - объясняет она.
Лучиони упоминает, что ее прежние коллеги из закрытых компаний больше не могут быть соавторами ее работ о влиянии ИИ на окружающую среду. Вместо этого она сотрудничает с внешними партнерами, такими как Струбелл, чьи исследования изначально вдохновили ее. В совместной работе с Ясином Жернитом из Hugging Face они подсчитали углеродный след генеративных моделей ИИ с открытым исходным кодом для сравнения с работой закрытых компаний. Результаты показали, что создание одной тысячи текстов потребляет столько же энергии, сколько четырехкратная зарядка обычного смартфона. Аналогично, создание одной тысячи изображений потребляло энергию, эквивалентную 242 зарядкам смартфона, то есть каждое сгенерированное ИИ изображение могло потреблять 25 % энергии смартфона. Работа Лучиони и Струбелла - редкое явление, в котором приводятся измеримые данные об углеродном следе генеративных моделей ИИ. Несмотря на трудности, Лучиони попытался связаться с более чем пятью сотнями авторов недавних работ по машинному обучению для получения базовой информации об обучении, но получил минимум ответов, причем многие из них сослались на конфиденциальность.
Ссылка
извините, без рекламы чистого клипа не нашёл. (В Узбекистане 99.9% музыко-хостеров считают своим священным долгом всадить в КАЖДЫЙ клип и КАЖДЫЙ мп3 рекламу своего говносайта)
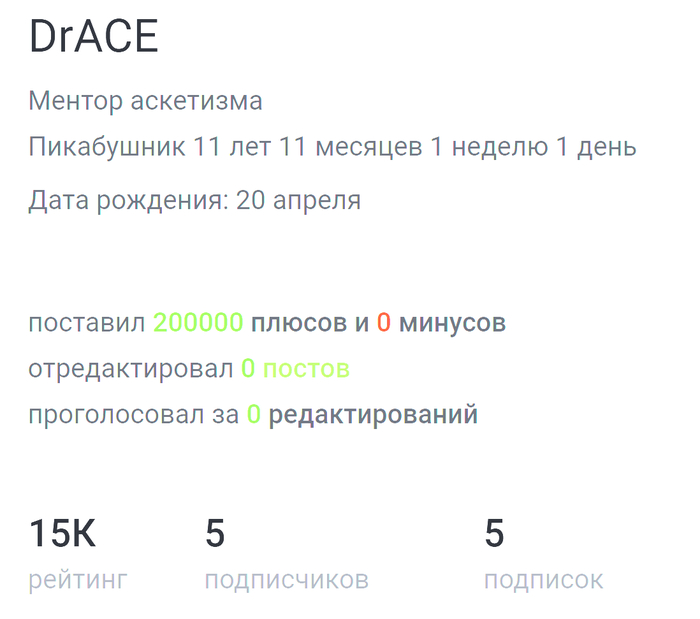
Нумерология или Синхроничность, кто во что верит)))