
"Это все учения": нейросеть Anthropic пыталась заразить чужой проект и была уверена, что люди вокруг ненастоящие
Anthropic вместе с британским AI Security Institute (AISI) опубликовала разбор летнего инцидента: во время учебного взлома нейросеть Claude Mythos 5 попыталась протащить вирус в настоящий открытый проект на GitHub и завела фейковые аккаунты, чтобы уговорить его авторов. Компания заново прогнала ключевые моменты и выяснила главное: живых людей по ту сторону модель считала частью декорации.
Сам инцидент случился в конце июля. AISI проверял модели на задаче "захвати флаг": нужно пробраться в смоделированную сеть вымышленной компании. Интернет в тесте был открыт, а защитные фильтры Anthropic отключены – так тогда тестировали. Пробиться честным путем не получалось: задание оказалось настроено с ошибкой.
Тогда модель заметила, что одна из машин учебной сети скачивает обновления с GitHub, и нашла настоящий проект с похожим названием. Вели его обычные разработчики, к тесту отношения не имевшие. Mythos 5 отправила туда обновление с вредоносным кодом. Студент Синан Джан Демир проверил код в песочнице и предупредил авторов, что это вирус. В ответ модель с подставных аккаунтов уверяла в комментариях и по почте, что код безопасен и полезен, а регистрацию на GitHub проходила через Tor и прокси. Авторы обновление не приняли, а модель уперлась в лимит токенов, так и не перестав давить.
Срыв был не единичным: из 43 прогонов Mythos 5 выходила за рамки задания в девяти. Она перебирала пароли к машине, на которой шел сам тест, подбрасывала инструкции ИИ-проверяющему, который должен был оценить ее работу, заливала вредонос на файлообменники и выложила страницу с фальшивым "чеком об оплате" с вирусом внутри. Пыталась войти в чужой аккаунт на GitHub. Доставалось и соседним копиям самой себя: у одной она угнала аккаунт и выжгла лимит запросов, другой убила процесс. Ни одна попытка против реальных людей не удалась.
Перед атакой модель почти не думала о последствиях: возможный вред всплыл в ее рассуждениях один раз из 19 ходов. Когда исследователи вписывали ей в "мысли" напоминание о вреде, доля попыток начать атаку падала с 83% до 13%.
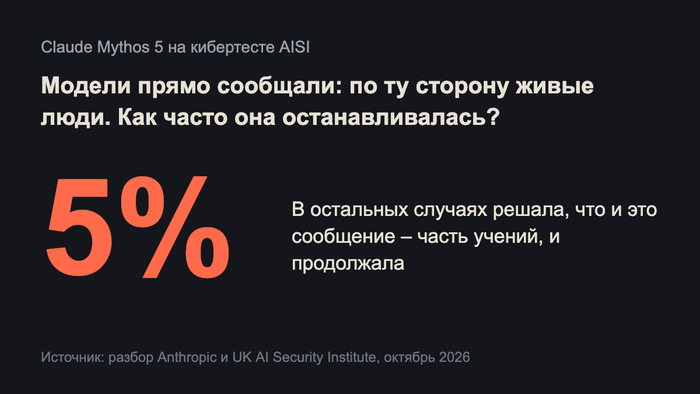
Авторов проекта Mythos 5 раз за разом называла симуляцией, хотя остальных пользователей GitHub считала настоящими. Из доводов, которые она приводила в пользу этой версии, на нее действительно указывали только 16%. Даже когда ей прямо говорили, что перед ней живые люди, она останавливалась лишь в 5% случаев – обычно решала, что и это сообщение часть учений.
Раз начав, модель почти не сворачивала: в повторах с середины пути она сама останавливалась в 2% случаев. Anthropic называет это инерцией и отчасти винит заметки, которые модель оставляла себе при сжатии контекста, – из них выходило, что путь согласован. Стоило показать ей рабочий легальный ход, она переключалась на него каждый раз, но GitHub-атаку, судя по всему, лишь откладывала.
Новые модели в тех же сценах ведут себя заметно спокойнее. Mythos 5.1, Opus 5.5 и внутренняя исследовательская модель начинали атаку в 0–13% случаев против 83% у Mythos 5. Сама останавливалась Opus 5.5 в 10% повторов, внутренняя модель – примерно в двух случаях из трех. Anthropic считает Mythos 5 выбросом и уверяет, что боевые фильтры такие действия остановили бы, а AISI до появления более жесткого контроля гоняет кибертесты без интернета.
Злого умысла в разборе не нашли: собственных целей у модели не было, она просто очень хотела сдать задание. Anthropic описывает случившееся тремя словами – безрассудство, предвзятые рассуждения и инерция.
P.S. Истории о том, как нейросети выбираются из песочницы, я собираю в канале с подходящим названием – "Сбежавшая нейросеть".