
Коллеги, бекап есть у кого?
Пошукайте свои генеалогические древа, может кто бекапился в период между 1946 и 1952 годом? Чувствую, что поперлись на ложную концовку, надо переиграть с другими вводными.
Пошукайте свои генеалогические древа, может кто бекапился в период между 1946 и 1952 годом? Чувствую, что поперлись на ложную концовку, надо переиграть с другими вводными.
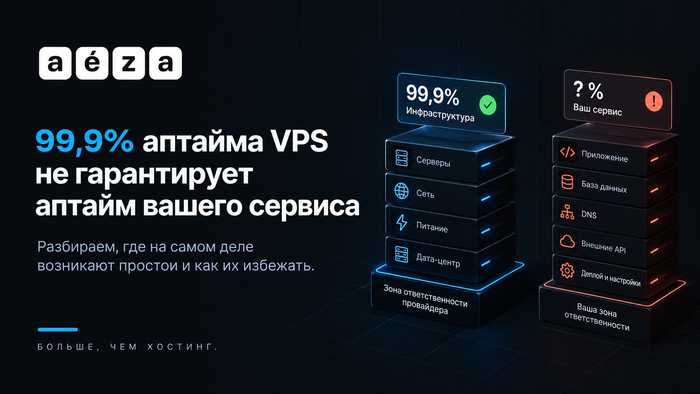
Провайдер может обещать 99,9% аптайма VPS, но аптайм продукта и аптайм инфраструктурного узла остаются разными показателями. Когда сервис падает, причина часто находится за пределами зоны ответственности провайдера: в приложении, деплое, базе данных, DNS или внешних API.
SLA VPS-провайдера покрывает доступность физического узла, сетевого канала и питания. Если оборудование работает и сеть доступна, инфраструктурная часть SLA может считаться выполненной. Код, конфигурации, база данных и внешние зависимости остаются в вашей зоне ответственности.
На практике многие простои возникают не из-за сбоев инфраструктуры, а из-за ошибок в коде и операционных процессах. Неудачный деплой, утечка памяти, переполненный диск, истёкший SSL-сертификат, недоступный DNS или упавший сторонний API гасят сервис независимо от стабильности хостинга.
Релиз без стейджинга и механизма отката, отсутствие проверок состояния, ручные правки конфигурации в продакшене: всё это классические источники простоев. Мониторинг, добавленный «потом», не предупреждает о проблеме до того, как её замечают пользователи.
Стабильность сервиса на VPS складывается из нескольких пунктов. Автоматические бэкапы и снапшоты упрощают восстановление после сбоя. Проверки состояния и алерты сокращают время обнаружения инцидента. CI/CD-пайплайн с проверками и понятным откатом снижает риск ошибок при деплое.
• Бэкапы и снапшоты настроены и проверены
• Мониторинг и алерты подключены до деплоя
• Есть процедура отката для каждого релиза
• SSL-сертификаты обновляются автоматически
• DNS TTL снижен перед плановыми миграциями
Аптайм сервиса на VPS-сервере зависит от инфраструктуры, архитектуры и операционных процессов одновременно. Пересмотрите собственные процессы: деплой, мониторинг, бэкапы и восстановление после сбоев. Если нужен взгляд со стороны, можно начать с аудита инфраструктуры и точек отказа.
Время восстановления как ключевая метрика бэкапа показывает, сколько на самом деле продлится простой. Поэтому измерение времени восстановления планируют так же, как расписание копий. Результат зависит от сценария, объёма данных и доступных ресурсов. Тест на маленькой копии не подтверждает срок для рабочей базы.
Время восстановления определяет, как долго сервис будет недоступен после сбоя. Даже быстро созданную копию ещё предстоит получить, расшифровать и развернуть, а затем проверить данные и работу приложения под нужной нагрузкой. При этом скорость создания тоже важна, если от неё зависит соблюдение графика копирования.
Удалённая таблица и потерянная площадка требуют разных действий. В первом случае можно развернуть копию отдельно и вернуть нужные записи, проверив связанные данные. Во втором придётся заново собрать окружение: базу, приложение, сеть и доступы. Отказ VM при исправных дисках отличается от повреждения самой базы. После компрометации учётной записи нужно ещё убедиться, что сохранились доверенная копия и независимый доступ к ней.
Поэтому измерение времени восстановления начинают с одного сценария: фиксируют, что именно потеряно, какие ресурсы остались доступны и к какому состоянию нужно вернуться. Для ошибочного удаления это может быть момент перед опасной транзакцией. При отказе площадки обычно нужна последняя доступная согласованная точка данных.
До запуска команда договаривается, что считать работающим сервисом. Для магазина это, например, вход, просмотр заказов и оформление нового заказа. Одного восстановленного каталога для этого недостаточно. Если на первое время часть функций может не работать, договариваются об этом заранее.
RTO означает предельно допустимое время простоя. Это цель для сервиса, с которой сравнивают фактическую длительность восстановления. RTO резервной копии сам по себе ничего не значит: один и тот же архив развернётся за разное время на разных дисках и при разной подготовке команды. RPO задаёт, за какой период допустимо потерять данные. Эти цели согласуют с требованиями бизнеса.
В полном прогоне отсчёт начинается с имитации сбоя и заканчивается после проверки сервиса. В это время входят обнаружение, решение о восстановлении, получение доступа и подготовка среды. Если прогон начинается сразу с объявления аварии, задержку обнаружения учитывают отдельно, иначе результат окажется короче реального простоя.
После распаковки база может ещё применять журналы, а приложение ждать запуска службы авторизации или обновления DNS. Поэтому таймер останавливают после согласованных проверок, включая пробную нагрузку. В журнале сохраняют достигнутую точку данных для проверки RPO: быстро поднятый сервис может содержать слишком старое состояние.
Тестовая среда должна быть сопоставима с той, которая останется после аварии. В описании стенда нужны CPU, RAM, диски, полоса сети и версии ПО. Для копии указывают размер архива и развёрнутых данных, сжатие, шифрование и место хранения.
Тест восстановления RTO и RPO должен включать получение ключей, если при сбое их придётся запрашивать. В процедуру входят выдача доступа, поиск секретов и лицензий, настройка DNS. При потере площадки доступ к этим ресурсам должен сохраниться за её пределами. Время обработки заявок тоже попадает в журнал.
Изолируют не только данные, но и приложение. Восстановленная очередь не должна повторно отправить клиентам письма или платежи. Для внешних операций используют тестовые адреса и среды, явно отмечая, какие зависимости ими заменили.
Частоту учебного восстановления выбирают по критичности сервиса, допустимому простою и скорости изменений системы. Между плановыми проверками нужен новый тест после смены формата копии, шифрования, инфраструктуры или инструкции восстановления. Единого интервала нет, он должен учитывать и последствия сбоя, и затраты на каждый полный прогон.
Учебное восстановление из бэкапа должно повторять предусмотренный для аварии порядок действий. Если копия лежит в архивном классе хранилища, ожидание её выдачи входит в срок. Если файл скачан заранее, тест не покажет время его доставки. В журнале разделяют получение копии, расшифровку, проверку, распаковку, развёртывание базы и применение журналов.
Для каждого этапа сохраняют начало и конец в UTC, объём данных, статус, ошибки и повторы. Часы серверов синхронизируют. Длительности автоматических шагов лучше считать монотонным таймером, который не скачет при коррекции времени. Для ручного ожидания нужны обе отметки: отправка заявки и получение доступа. Для каждого прогона журнал и логи команд хранят отдельно, без паролей и токенов.
В PostgreSQL восстановление к моменту времени требует физической базовой копии и непрерывной цепочки WAL от начала копирования до выбранной точки. Для логического дампа нужна отдельная процедура загрузки. Если копия инкрементальная, учитывают получение и сборку всей необходимой цепочки. Работа сторонних сервисов тоже входит в общий срок.
Проверка начинается с файлов. Для полной физической копии PostgreSQL 18, сохранённой pg_basebackup как каталог с backup_manifest и нужным WAL, подходит команда:
pg_verifybackup --exit-on-error /srv/restore/base \
> verify.log 2>&1
Здесь /srv/restore/base – каталог копии до запуска базы. При ошибке причину ищут в verify.log. Утилита той же основной версии сверяет файлы с манифестом и проверяет необходимый для копии WAL. Успех не гарантирует ни наличие всех последующих журналов до точки PITR, ни исправность приложения. Это ограничение pg_verifybackup.
После запуска нужны проверки согласованности средствами СУБД и контрольные запросы по известным данным. Для магазина это наличие выбранных заказов, их состав и итоговые суммы. Бенчмарк point-in-time recovery показывает, дошло ли восстановление до выбранной точки: при ошибочной записи нужные транзакции должны сохраниться, а ошибочная – отсутствовать. Достигнутую точку сверяют с журналом восстановления и независимым учётом операций, а её отставание от момента сбоя сравнивают с RPO. Время создания копии этой проверки не заменяет. После завершения восстановления проверяют вход, чтение и запись через приложение.
Метрики проверки бэкапа сводят на одну временную шкалу: все этапы восстановления с началом и концом каждого. Она показывает активную работу, автоматические паузы и ожидание людей. Параллельные этапы не складывают: общий срок задаёт самая долгая цепочка зависимых действий, необходимых для готовности сервиса. Её сокращают в первую очередь.
1. От сбоя до начала работ: обнаружение, решение, получение доступа и подготовка среды.
2. Возврат данных: доставка, расшифровка, проверки, развёртывание и применение журналов.
3. Возврат сервиса: запуск зависимостей, переключение доступа и проверка пользовательских операций.
Сетевую задержку отделяют от ожидания диска, расшифровки на CPU и последовательного применения журналов. Для грубой оценки: 200 ГиБ при постоянных 100 МиБ/с идут около 34 минут. Это расчёт только доставки, без ожиданий и последующих работ. Остальные этапы могут занять больше времени, чем сама передача. Улучшение подтверждает новый полный прогон с теми же условиями и проверками.
Runbook – инструкция, по которой дежурный восстанавливает сервис. Для каждого шага в ней нужны команда, ожидаемый результат и действие при ошибке. Повторный запуск должен либо продолжить работу, либо безопасно остановиться. Если скрипт заново создаёт диск, он должен отличить свой тестовый ресурс от чужого. Шаги, которые перезаписывают данные или переключают трафик, помечают в инструкции отдельно, а перед запуском требуют подтвердить адрес или имя ресурса.
Следующий прогон проводит другой инженер без подсказок автора. Поиск ключа, забытый пакет или ручная правка конфигурации показывают, чего не хватает в инструкции. Такой прогон выявляет зависимость инструкции от знаний автора.
Отдельными прогонами разбирают недоступный ключ, повреждённую копию и отказ основного хранилища. Каждый из них подтверждает запасной путь или остановку с понятной причиной. При отказе хранилища важна и скорость передачи с запасного источника: throughput запасного пути обычно ниже, чем у основного. Если данные получить не удалось, сценарий считается непройденным.
По каждой причине превышения срока команда назначает ответственного, выбирает исправление и дату повторного теста. Долгое ожидание доступа требует пересмотра процедуры выдачи, а перегруженный диск – проверки другой конфигурации. Когда скорость упирается в сеть, помогает более широкий канал. Долгое применение WAL лечится более свежей базовой копией. Задержку на сборке среды снимает заранее подготовленная резервная инфраструктура.
Такая подготовка сокращает время ценой постоянных расходов. Если staging используют как площадку восстановления, нужно заранее проверить запас ресурсов и порядок освобождения. Пропуск validation, то есть проверки результата, ускорением не считается: без неё неизвестно, можно ли вернуть пользователей.
В истории сохраняют все попытки с датой, исполнителем, версиями, объёмом данных и отклонениями от инструкции. Сравнивают одинаковые сценарии при сопоставимых ресурсах и состоянии кеша. Для нескольких прогонов показывают каждую длительность и причину разброса. Процентили имеют смысл, когда сопоставимых прогонов набралось достаточно много: p99 по трём попыткам ничего не говорит о редких задержках.
Время восстановления как ключевая метрика бэкапа полезно, когда за числом стоит проверенный результат. Копия, из которой ни разу не восстанавливали, остаётся предположением: до первого удачного прогона неизвестно ни время, ни полнота данных, ни работоспособность сервиса. Полный журнал этапов, точка данных и проверки сервиса показывают, удалось ли уложиться в RTO и RPO. Найденная задержка должна привести к изменению инструкции, ресурсов или архитектуры. После смены формата копии или окружения прежний результат нужно подтвердить повторным восстановлением.
Облачный сервер часто выглядит как привычный VPS: вы выбираете процессор, память и диск, получаете адрес и заходите по SSH. Разница становится заметной, когда нужно быстро добавить серверы, заменить сломавшийся экземпляр или подключить отдельное хранилище. Эти возможности стоит оценить перед переездом.
Настройка облачных серверов затрагивает сеть, права доступа и хранение данных. На платформе с отдельными сервисами это может потребовать больше работы, чем на привычном VPS. При этом единственная машина остаётся точкой отказа: если она недоступна, приложение тоже перестанет отвечать.
Облачный сервер обычно работает в составе платформы с программным управлением машинами, хранилищами и сетями. С её помощью проще создавать ресурсы и менять их количество вслед за нагрузкой. У VPS тоже бывают API (интерфейс программного управления) и почасовая оплата, поэтому различия нужно искать в условиях конкретных услуг.
VPS называют виртуальную машину со своей операционной системой и назначенными ей ресурсами физического сервера. В облаке такую машину часто называют инстансом. Обе услуги могут использовать одну технологию виртуализации.
Облачная платформа объединяет вычисления, хранение и сеть под общим управлением. Пользователь сам запрашивает ресурсы и освобождает их, когда они больше не нужны. В определении NIST к признакам облака относятся самообслуживание по требованию, доступ по сети, общий пул ресурсов, быстрая эластичность и учёт потребления. Эластичность здесь означает возможность увеличивать и уменьшать выделенные ресурсы вслед за нагрузкой.
На практике граница между услугами размыта. Например, DigitalOcean предоставляет для своих виртуальных машин API и группы автоматического масштабирования. Полезно узнать, какие действия доступны через API – только перезагрузка или ещё и создание дисков, настройка сети и замена машин.
При редкой смене настроек автоматизация может остаться невостребованной, и настройка облачных серверов тогда мало отличается от работы с обычным VPS. Если команда ежедневно создаёт тестовые окружения, API избавляет её от повторения действий в панели.
Через API программа отправляет команды платформе: создать машину из образа, подключить диск, назначить адрес. Образ содержит подготовленную систему, а сценарий запуска устанавливает приложение и его зависимости. Образ и сценарий запуска делают настройку облачных серверов повторяемой. Пароли и другие секреты нужно хранить отдельно от общего образа и выдавать приложению с ограниченными правами доступа.
Доступом к ресурсам платформы управляет система IAM. Она задаёт права сотрудников и программ: например, скрипту резервного копирования незачем удалять рабочие серверы. Сами ресурсы обычно объединены в проекты, чтобы командам было проще ими управлять.
Перед выбором диска нужно выяснить, что останется после удаления машины. Локальный диск связан с физическим узлом, а подключаемый сетевой том может существовать отдельно от инстанса. Сохранится ли том, зависит в том числе от настроек удаления. Например, в облаке Amazon EC2 параметр DeleteOnTermination определяет, удалится ли сетевой том EBS вместе с машиной.
Для файлов пользователей часто подходит объектное хранилище. Приложение обращается к нему по API, а не как к обычному диску. Базу данных можно разместить на подходящем диске или поручить её обслуживание провайдеру, выбрав отдельный сервис БД.
Увеличение памяти и числа процессоров одной машины называют вертикальным масштабированием. Смена тарифа может требовать остановки, поэтому порядок изменения ресурсов лучше проверить заранее.
При горизонтальном масштабировании появляются дополнительные экземпляры приложения. Балансировщик распределяет между ними запросы пользователей. Любому экземпляру нужен доступ к общим данным: сведениям о входе пользователя, файлам и заказам. Если корзина магазина хранится только в памяти одной машины, второй сервер её не увидит.
Эластичность полезна при заметных колебаниях нагрузки, когда дополнительные экземпляры приложения успевают запускаться и принимать работу до перегрузки. После спада лишние ресурсы можно освобождать и сокращать расходы. Если приложение нельзя разделить между машинами или пик заканчивается раньше их запуска, автоматическое масштабирование даст мало пользы.
После создания машины ей ещё нужны загрузка системы, запуск приложения и иногда заполнение кеша часто используемыми данными. В AWS настройка instance warmup задаёт время, в течение которого метрики новой машины не включаются в общие показатели для масштабирования. Готовность принимать запросы проверяется отдельно. Для этого балансировщику нужен health-check, проверка работоспособности приложения.
Метрика для масштабирования должна отражать нехватку мощности. Обработчикам фоновых заданий подходит число ожидающих заданий на один экземпляр, а вычислительной задаче может подойти загрузка процессора. Установка облачных серверов из готового образа ускоряет запуск, но не гарантирует его, поскольку даже с готовым образом старт может остановиться из-за квоты аккаунта или нехватки ресурсов в выбранной зоне. Предел числа машин ограничивает расходы, а заранее запущенный резерв помогает пережить короткий всплеск.
Во время перезапуска после сбоя сервис может быть недоступен. Чтобы работа продолжалась при потере машины, запросы должны принимать другие экземпляры. Для защиты от сбоя площадки их размещают в разных зонах доступности. Зона объединяет один или несколько дата-центров, а независимость питания и сети нужно уточнять у провайдера.
Пример для веб-приложения: балансировщик принимает запросы и отправляет их на две копии приложения в разных зонах. У приложения общая БД: основной экземпляр в одной зоне, резервный в другой. Файлы пользователей находятся в объектном хранилище с копиями в нескольких зонах. Балансировщик тоже должен переживать отказ зоны, а исправная зона должна выдерживать всю нагрузку.
При выборе хранилища также нужно учитывать зоны, так как сетевой том может быть доступен лишь в одной из них. Для переноса работы БД в другую зону нужны репликация, то есть копирование изменений на резервный экземпляр, и переключение при сбое. Например, в Amazon RDS для этого предназначены варианты Multi-AZ. Резервные копии нужны и при наличии реплики, ведь ошибочное удаление данных может повториться на резервном экземпляре.
SLA, соглашение об уровне обслуживания, задаёт обязательства провайдера, в том числе по доступности ресурсов. Заявленный процент доступности инстанса нельзя автоматически переносить на весь сайт, поскольку ему ещё нужны служба доменных имён (DNS), сеть и БД. У Amazon EC2 обязательства для одного инстанса и размещения в нескольких зонах различаются. В условиях услуги проверьте компенсацию и обязанности вашей команды.
Даже с одинаковым числом виртуальных процессоров (vCPU) и объёмом памяти серверы могут работать с разной скоростью. На скорость влияют модель физического процессора, доля его времени, доступная виртуальной машине, диск и расстояние до клиентов. Для сравнения нужны одна версия приложения, одинаковые данные и запросы. Генератор нагрузки должен сам справляться с потоком запросов.
Сайт стоит оценивать по числу запросов в секунду, доле ошибок и времени ответа. Медиана p50 показывает время, в которое укладывается примерно половина ответов. В пределах p95 и p99 укладываются 95% и 99% запросов соответственно. Результаты при обычной и пиковой нагрузке стоит сопоставить с загрузкой процессора, диска и БД.
Короткий тест может пройти в режиме временного ускорения, burst. На некоторых тарифах оно доступно за счёт накопленного запаса, так называемых кредитов. После их расходования скорость может вернуться к базовому уровню. Диск ограничен и числом операций в секунду (IOPS), и объёмом данных в секунду. При крупных операциях лимит объёма данных может быть достигнут раньше лимита IOPS, пример есть в документации EBS. Если тариф допускает временное ускорение, тест должен продолжаться и после его окончания.
Дальше проверьте, сохраняются ли данные при замене машины. На тестовой копии сервиса запишите контрольные данные в БД и хранилище файлов. Проверка включает три отдельных действия: перезагрузку ОС, остановку с запуском и замену машины новой из образа. После каждого действия проверьте данные, адреса и доступность приложения. В EC2 локальное хранилище instance store переживает перезагрузку, но данные исчезают при остановке или замене машины.
Для проверки отказоустойчивости остановите одну тестовую копию приложения под нагрузкой и проверьте, принимает ли запросы вторая. В отчёте укажите время восстановления, ошибки клиентов и результат проверки данных. Потеря целой зоны требует отдельного испытания.
Почасовая оплата удобна для временных задач. За работающую весь месяц машину начисляется полная месячная стоимость. К её цене добавляются диски и другие сервисы.
Месячный расчёт включает:
Виртуальные машины: часы каждого экземпляра × ставку, включая резерв
Диски и копии: объём, дополнительные IOPS, снимки и резервные копии
Сеть: исходящий трафик, обмен между зонами, платные адреса
Сервисы платформы: балансировщик, БД, хранение журналов и запросы к ним
Работа команды: миграция, поддержка, обновления и восстановление
Для иллюстрации возьмём условную ставку 10 ₽ в час. Одна машина за 30 дней, или 720 часов, стоит 7200 ₽. Если вторая нужна по четыре часа в течение 20 дней, она добавит 800 ₽, и общий расход на вычисления составит 8000 ₽. Два постоянно работающих экземпляра за тот же период обойдутся в 14 400 ₽. Ставка условная, а диски, трафик и остальные услуги в расчёт ещё не включены.
После остановки машины часть расходов сохраняется: например, в EC2 вычисления уже не оплачиваются, а за сохранённые тома EBS счёт продолжает идти. Условия для адресов, снимков и других ресурсов зависят от услуги. Ограничения на число ресурсов и автоматическое удаление ненужных нужно настроить отдельно.
1. Небольшой сайт со стабильной посещаемостью, которому хватает выбранного тарифа и для которого допустим простой на время восстановления.
2. Бот или внутренний инструмент с предсказуемой нагрузкой и без требования непрерывной работы при отказе машины.
3. Приложение, которое пока не умеет работать на нескольких экземплярах, если ресурсов одного VPS достаточно.
Как создать свой облачный сервер, обычно понятно из документации провайдера. Сложнее другое: подготовка приложения к работе на нескольких машинах требует времени. Нужно наладить общее хранение файлов и данных о входе пользователей, настроить мониторинг. Затраты на эту работу тоже влияют на выбор.
В таблице сопоставлены типичный простой тариф VPS и облачная платформа. Возможности конкретного VPS могут быть шире.
Управление
Фиксированный VPS: панель; состав API зависит от услуги
Облачная платформа: создание связанных ресурсов через API
Рост нагрузки
Фиксированный VPS: более крупный тариф или дополнительные VPS
Облачная платформа: группы машин и правила масштабирования
Хранение
Фиксированный VPS: обычно диск в составе тарифа
Облачная платформа: отдельные тома, объектное хранилище, сервис БД
Сеть
Фиксированный VPS: адреса и доступные сетевые опции тарифа
Облачная платформа: частные сети, балансировщики, зоны
Доступность
Фиксированный VPS: восстановление по условиям услуги
Облачная платформа: несколько зон при подходящей архитектуре
Расходы
Фиксированный VPS: часто фиксированная сумма и доплаты
Облачная платформа: учёт нескольких ресурсов и их потребления
Магазину с редкими рекламными кампаниями может хватить временного увеличения VPS перед акцией. При частых, непредсказуемых колебаниях полезнее автоматическое добавление машин, если приложение к нему готово.
Облако бывает полезно и при постоянной нагрузке, если команде нужны управляемая БД и удобное восстановление. Несколько VPS с балансировкой также способны обслуживать распределённый сервис. И облачная платформа, и связка из нескольких VPS требуют обслуживания.
Пробный переезд, или пилот, проще начать с части приложения без уникальных локальных данных. Подойдёт обработчик изображений, который читает исходники и сохраняет результат в отдельном хранилище. Его проще пересоздать в облаке или вернуть на VPS. Перенос базы на первом шаге усложнит откат.
До запуска задайте пределы времени ответа, доли ошибок, срока восстановления и месячного бюджета. Сравнение p95 с заданным пределом покажет, годится ли конфигурация при рабочей нагрузке. Стоимость нужно рассчитать на полный месяц с пиками, даже если пилот длится неделю.
В плане пилота нужны регион и зоны, тарифы, типы дисков, версии ОС и приложения, образ и сценарий запуска. Журналы создания и удаления ресурсов, результаты запросов и выгрузка расходов помогут повторить проверку. Напишите коллеге инструкцию: как подключиться к облачному серверу, у кого запросить доступ и как восстановить компонент без вас.
В конце испытания верните приложение к прежнему размещению. Приложение должно сохранить нужные данные и продолжить работу. Обработчик может получить задание повторно после сбоя, поэтому повтор не должен создавать лишние записи или другие дубликаты результата. Эксперимент стоит остановить при потере данных, выходе за бюджет или постоянных ручных исправлениях. После пилота удалите ненужные диски, адреса и копии, за которые продолжаются начисления.
После пробного запуска сравните выигрыш со стоимостью переезда и обслуживания. Облако окупается, когда команда пользуется им как платформой: создаёт ресурсы через API, держит приложение в нескольких зонах, отдаёт часть работы управляемым сервисам и умеет восстанавливаться по написанной процедуре. Одна виртуальная машина, купленная в облаке вместо VPS, остаётся одной машиной с той же точкой отказа и обычно даёт только более сложный счёт. Если облачный сервер пока не решает ни одной текущей задачи, работающий VPS можно оставить на месте, а к переезду вернуться, когда появится конкретная причина: рост нагрузки, требование по доступности или нехватка рук на ручные операции.
Последний месяц лета закрываем длинным списком релизов для AI-агентов: документация, MCP-сервер, скиллы, навыки, файлы в чате и четыре новые модели в каталоге. Причина простая: каждое третье обращение к нашей документации — от агентов, нужно считаться с новой аудиторией.
Вторая половина выпуска для тех, кто читает сам: три класса хранения в S3, отмена удаления баз, клон приложения в App Platform, домены через Госуслуги и обновленный Kubernetes.
Разворачиваем каждый пункт ниже ↓
Чем больше задач у агента, тем длиннее системный промпт, а значит, каждое обращение к модели обходится дороже. Чтобы не тратить токены зря, инструкции теперь можно разложить по навыкам — отдельным блокам под конкретные задачи.
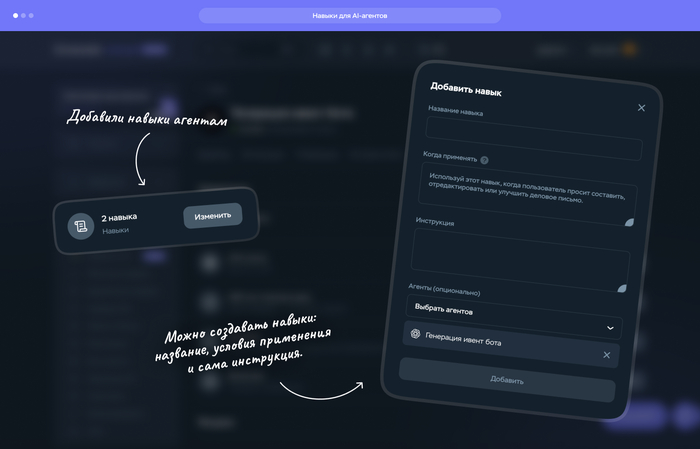
Каждый навык состоит из трех частей: название, описание «когда применять» и сама инструкция. В запрос уходит только компактный индекс, а полная инструкция подтягивается, если запрос подошел под условие. Как устроены навыки →
Начать просто: возьмите повторяющуюся задачу вроде оформления отчетов, задайте ей условия и подключите к одному агенту или сразу к нескольким.
Не останавливаемся и продолжаем улучшать панель — в августе три уж очень удобных обновления.
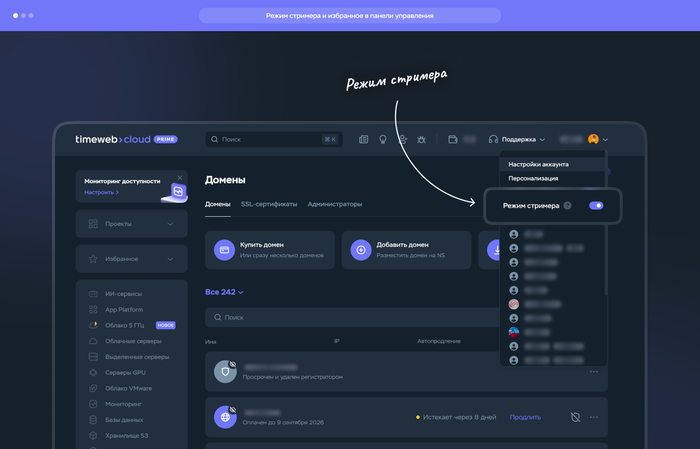
Режим стримера. Скрывает в панели все, что не стоит показывать в кадре: публичные IP, баланс, ФИО, телефон, емейл, домены и почтовые ящики. Пригодится, когда снимаете скринкаст, стримите работу или демонстрируете панель на созвоне. Включается в меню профиля справа вверху.
Избранное. Разделы панели и ваши серверы, базы, приложения теперь можно закрепить в левом меню — они всегда остаются сверху. Если каждый день начинаете с одних и тех же, искать их больше не придется.
Больше прав для дополнительных пользователей. Основной аккаунт теперь может открыть коллеге доступ к «Новостям и идеям» — либо только на чтение, либо с возможностью комментировать, ставить лайки и предлагать свои идеи от своего имени. А если у дополнительного пользователя есть доступ к поддержке, уведомления по тикетам будут приходить ему на почту, как и владельцу аккаунта.
Документация должна быть понятной не только для людей, но и для агентов. Вот что сделали для этого.
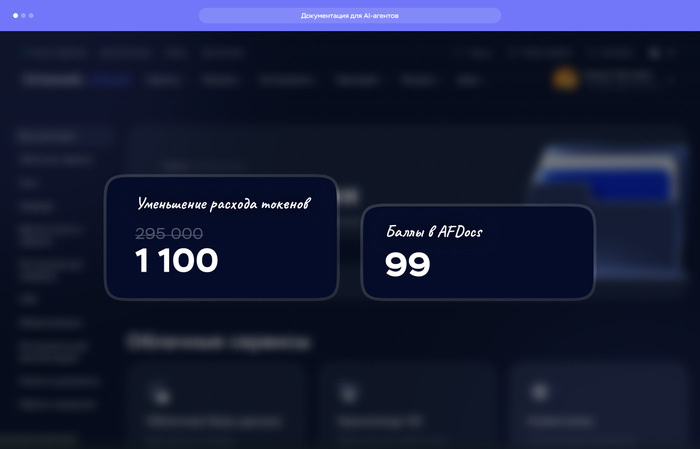
Отдали агентам чистый текст. Добавили на сайт llms.txt и llms-full.txt, а следом MD-версию всей документации. Файлы вышли слишком объемными, поэтому раздробили их на части. Теперь на страницу уходит около 1100 токенов вместо 295 000.
Убрали обрывы на середине. Подняли рейт-лимиты, чтобы серия быстрых запросов не упиралась в ограничение, и настроили кеширование со всеми заголовками, которые агенты ожидают увидеть. Страницы отдаются из кэша, задача доходит до конца.
Свели HTML и MD к одному содержанию. Выровняли разметку обеих версий: агент читает ровно то же, что видите вы, без расхождений и устаревших кусков.
Если документация — это руководство, то MCP-сервер — инструмент, чтобы видеть, создавать, менять и настраивать ваши ресурсы. И инструмент тоже должен быть удобным в работе.

Чтобы не раздувать контекст и расход токенов, мы свели все возможности Timeweb Cloud MCP к трем инструментам:
search_tools — найти нужную операцию по описанию задачи
get_tool_definition — получить ее параметры
execute_tool — выполнить операцию с этими параметрами
Агент больше не держит в памяти весь каталог, а ищет нужное под конкретную задачу. Контекст остается компактным при любом числе методов — поэтому список доступных действий мы смогли заметно расширить. Как подключить MCP-сервер →
А в пару к нему выложили репозиторий со скиллами — готовыми инструкциями, как поднять сервер, настроить DNS или посмотреть баланс. В Claude Code скиллы ставятся как плагин двумя командами, в Cursor, Codex и OpenCode — через npx skills. Забрать скиллы с GitHub →
Дать агенту порулить облаком →
Данные в S3 бывают разные: к одним обращаются каждую минуту, другие годами лежат про запас. Поэтому расширили количество классов хранения в S3 — теперь при создании нового бакета можно выбрать один из трех вариантов.

Премиальный — с тройной репликацией и повышенной производительностью. Подойдет для данных, которые постоянно читают и записывают.
Стандартный — для файлов, к которым обращаются регулярно, но высокая скорость доступа не критична: пользовательских загрузок, медиа и рабочих выгрузок.
Холодный — для архивов, бэкапов и датасетов, к которым возвращаются раз в редко.
Уже созданные бакеты работают на прежних условиях — переносить и пересчитывать ничего не нужно.
База, у вас отмена:
Удалить кластер по ошибке проще, чем кажется: во время наведения порядка или выполнив команду не в том окне. У облачных серверов на этот случай уже есть отмена удаления, теперь такая же появилась у баз данных.
С подключенной защитой удаленный кластер не исчезает сразу: он хранится еще 72 часа, и все это время его можно вернуть — с данными, резервными копиями и конфигурацией. Восстановление бесплатное, для всех типов баз и во всех регионах. Условия и порядок восстановления →
Стоимость — 200 ₽ в месяц за одну базу. Если защита не подключена, разовое восстановление стоит 2000 ₽.
Подключается в настройках кластера → «Бэкапы» → «Отмена удаления». У новых кластеров можно включить сразу при создании.
Подстелить базе соломки →
Теперь приложение в App Platform клонируется так же, как облачный сервер. Выбираете нужное, жмете значок справа, проверяете параметры.
По умолчанию все как у исходного приложения. Поменять можно ветку и коммит, конфигурацию с регионом и тарифом, приватную сеть, название, комментарий и проект. Переменные окружения, директория и команда сборки переносятся сами.
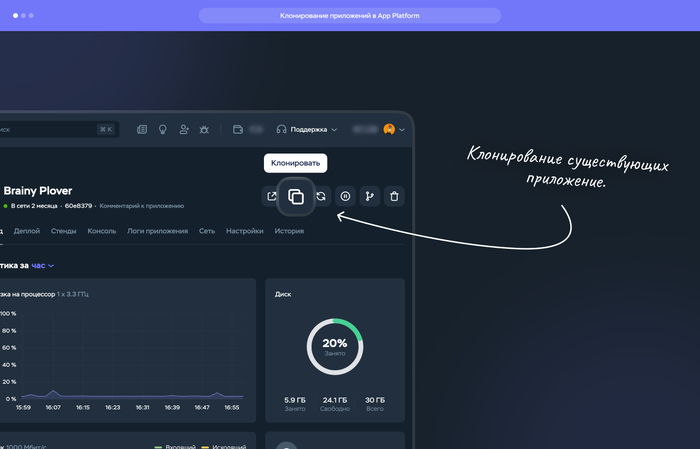
Где может пригодиться:
Пользователи в другом регионе. Разворачиваете копию ближе к ним и снижаете задержки.
Подбор конфигурации. Поднимаете клон на других ресурсах и сравниваете с оригиналом — рабочее приложение при этом не трогаете.
Резерв. Держите копию в другой локации и переводите на нее трафик, когда нужно.
Запрос от пользователя попадает в приложение не сразу — сначала его встречает веб-сервер. Теперь его параметры настраиваются прямо в приложении.
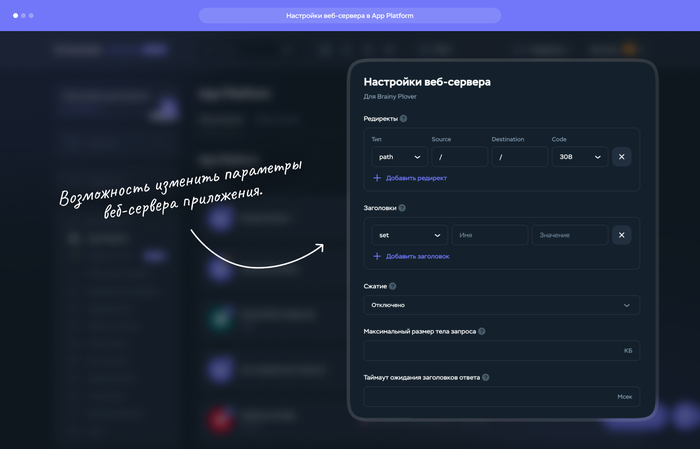
Редиректы. Перенаправление с одного пути или домена на другой. Пригодится, когда меняете структуру адресов или переезжаете на новый домен и не хотите потерять поисковый трафик.
HTTP-заголовки. Добавляете, меняете и удаляете заголовки в ответах веб-сервера: Cache-Control, CORS, CSP, HSTS. Служебные вроде Server и X-Powered-By можно, наоборот, спрятать.
Сжатие. gzip или zstd: данных передается меньше, страница у пользователя открывается быстрее.
Обработка несуществующего адреса. Только для фронтенд-приложений — показывать главную, как принято в SPA, или вашу страницу 404.
Лимиты для бэкенда. Максимальный размер тела запроса в килобайтах и таймаут ожидания заголовков ответа в миллисекундах: тяжелые запросы и зависшие соединения не копятся.
В App Platform, помимо сертификатов Минцифры, появился второй корневой сертификат — от Центра сертификации ТЦИ.
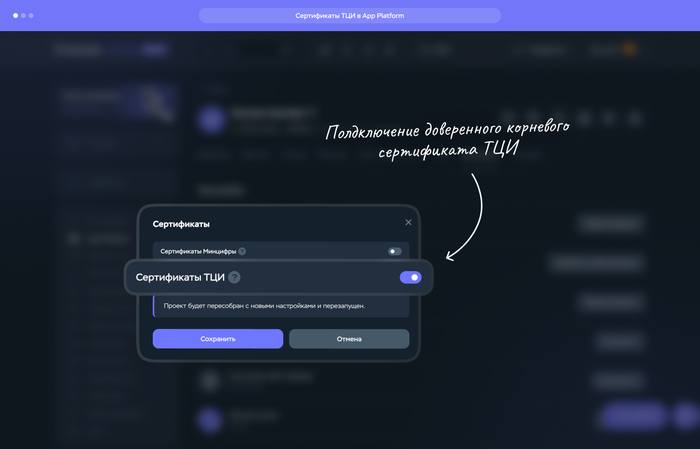
Логика та же. Без корневого сертификата приложение не доверяет TLS-сертификатам, выпущенным этим центром, и исходящий запрос упирается в ошибку проверки. Теперь сертификат включается тумблером — при создании приложения или в настройках готового. После изменения приложение уходит на повторный деплой. Подробнее про сертификаты →
Работает для бэкенд-приложений и развернутых из Dockerfile или Docker Compose. Два сертификата друг другу не мешают: включайте оба сразу или только нужный.
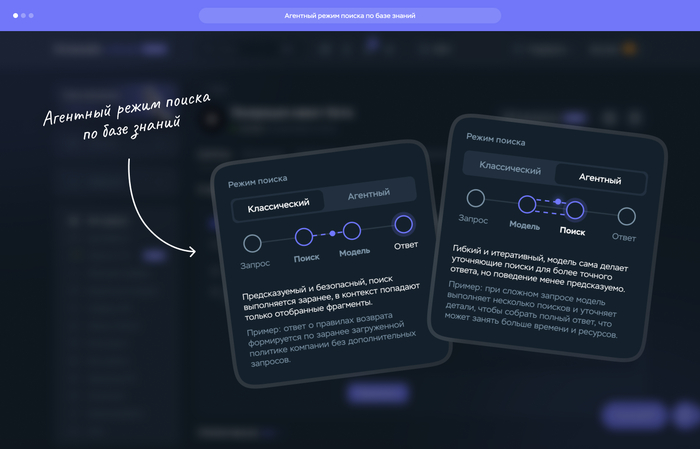
Продолжаем парад AI-релизов — у поиска по базе знаний стало два режима.
Р
Классический — как было раньше: перед каждым запросом по базе идет семантический поиск, найденные фрагменты подмешиваются в контекст модели. Предсказуемо и быстро.
Агентный — модель сама решает, когда и что искать: может уточнить формулировку, сделать несколько поисков подряд, собрать ответ из разных частей базы. На сложных запросах вроде «найди все товары из списка в категории X» разница в качестве заметна.
Базы знаний, которые вы подключали раньше, остались в классическом режиме — переключить можно в настройках агента. Для новых подключений агентный выбирается по умолчанию.
Скриншот с ошибкой, выгрузка в CSV, лог — теперь все это можно отправить агенту двумя способами.
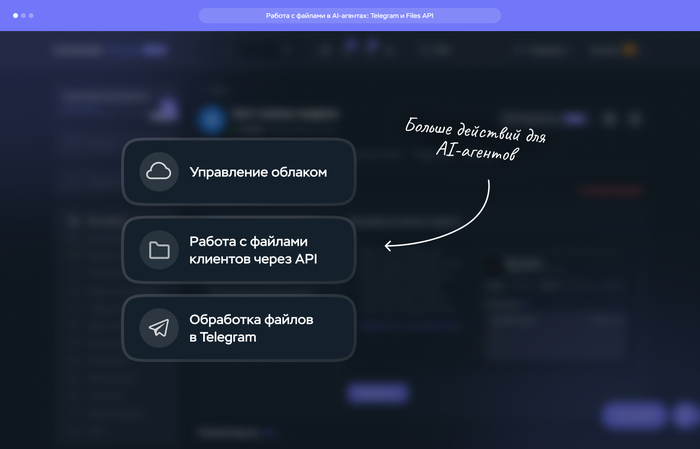
В телеграме. Файл уходит в чат вместе с запросом: агент сделает сводку по CSV или найдет ошибку на скриншоте с логами. Пригодится тем, у кого агент уже стоит в чате поддержки.
Через API. Files API — отдельный механизм для работы с файлами в API агентов, без прежних ограничений по формату и размеру. Схема простая: пользователь вашего сервиса прикрепил файл в чате → сервис передал его агенту через API → агент ответил с учетом содержимого.
Пополнения в каталоге моделей:
Добавили четыре модели: Qwen 3.8 Max, Gemini 3.7 Flash, Grok 4.6, GLM 5.3 и GLM 5.3 Flash.
А если вы раньше пользовались AI Gateway, но перестали, до конца года на токены всех моделей действует скидка 20% — повод вернуться и сравнить новинки с тем, на чем работали раньше. Подробнее об условиях →
Перебрать каталог →
Для владельцев доменов .ru и .рф в панели появилась идентификация администратора через Госуслуги — она стала обязательной с 1 сентября. Физлица уже могут ее пройти:
В разделе «Домены и SSL» открываете вкладку «Администраторы» и жмете «Подтвердить данные». Проходите проверку через Госуслуги, и если данные совпали, рядом с доменом появляется отметка. Детали уже в документации →
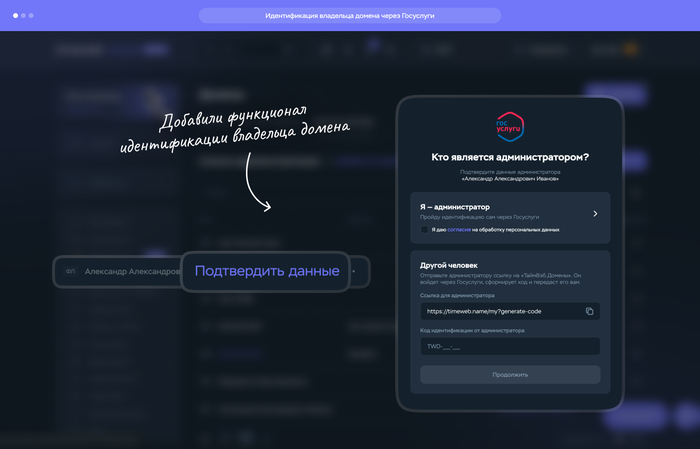
Для юрлиц идентификацию добавим позже. Отдельный случай — домены .su и домены .ru и .рф, зарегистрированные через R01 или Руцентр: их администраторы проходят идентификацию у этих регистраторов.
Начнем с версий: обновили линейки 1.33, 1.34, 1.35 и 1.36.
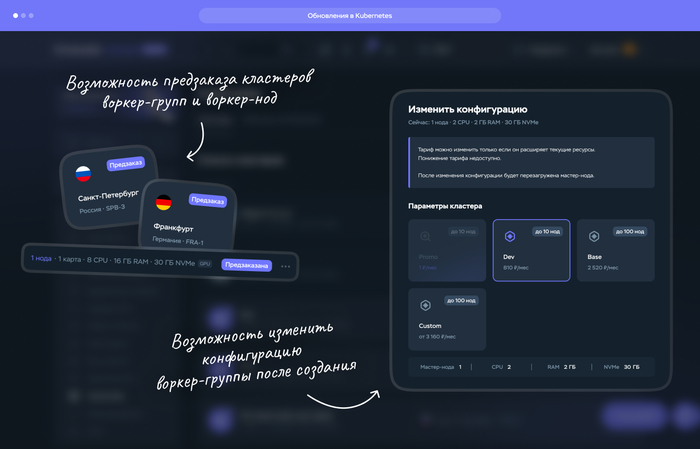
Дальше — конфигурация воркер-группы. Она больше не фиксируется при создании: у готового кластера можно перейти на тариф выше или на конфигуратор.
А на случай, когда в нужной локации ресурсы кончились, а кластер нужен именно там, сделали предзаказ. Работает и для новых кластеров, и для добавления воркер-ноды в готовую группу или новой группы целиком. Кластер создастся сам, как только ресурсов в локации хватит.
И обновили CSI-драйвер: в комментарий к диску теперь сам записывается его назначение — например, TWC-CSI, Namespace: default, Name: net-drive-demo. Видно, что это за диск и к чему он относится, не заходя в кластер. Комментарий можно изменить.
Всё, что о нас говорят:
Вошли в CNews500, рейтинг пятисот крупнейших ИТ-компаний России.
Рассказали про успехи AI Gateway: 70 моделей через единый API и рост числа пользователей на 40% за август. Плюсом, отдельные локальные модели, а также модели для картинок, синтеза и распознавания речи.
Кейс Metamentor появился и в медиа. Напомним, что Metamentor разрабатывает решения на базе генеративного AI для крупных компаний. CNews рассказали, как компания масштабируется на инфраструктуре Timeweb Cloud — за два года их выручка выросла в 32 раза.
В августе не изменяли нашим принципам — разбирали все самое интересное, необычное и увлекательное. Все для ваших просмотров и лайков.
Каждое третье обращение к нашей документации — от агента. Михаил Шпаков, наш руководитель разработки, разбирает, почему провайдеров скоро будет выбирать агент, что случится с ценами управляемых сервисов и почему проверку работы агента нельзя поручать самому агенту.
Свой видеохостинг вместо чужого. PeerTube на Debian 12: PostgreSQL, Redis, Nginx, Let's Encrypt, Fail2Ban — и вот у вас площадка, которая по ActivityPub здоровается с соседними инстансами вместо того, чтобы жить в одиночку.
Автоматизируем бэкапы с помощью Terraform. Денис Котов, тимлид Core-команды, показывает, как развернуть систему резервного копирования Bareos и управлять ею как кодом. В облаке хранятся настройки, база данных и сами бэкапы, а на сервере клиента остается только агент для передачи файлов. Достаточно указать четыре параметра — остальное система настроит сама.
Altair 8800, Osborne 1 и телефон весом в килограмм. Вспомнили первые компьютер, ноутбук и мобильник. Дорого, тяжело, неудобно и решительно непонятно, кому это надо. Прошло сорок лет, а вопросы все те же.
Возможно, этот выпуск прочитал не только человек. Если вы не AI-агент — ждем от вас лайк и комментарий.
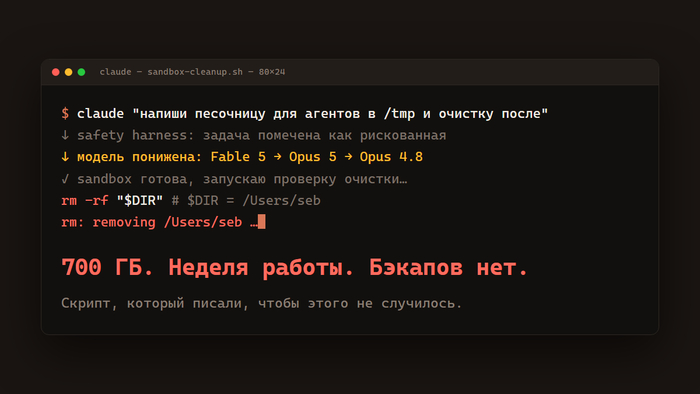
Разработчик попросил агента построить песочницу, чтобы другие агенты ничего лишнего не стёрли. Агент решил проверить, как работает очистка этой песочницы, и запустил её на домашней директории. Семьсот гигабайт, неделя работы, бэкапов нет.
Что произошло
Себастьен Гиймо ставил себе рабочий контур для нескольких ИИ-агентов: каждому — своя изолированная папка в /tmp, после завершения работы папка удаляется. Задачу он отдал модели Fable 5.
Дальше сработала защита. Скрипт предполагал безвозвратное удаление файлов, и предохранительный слой Anthropic счёл задачу рискованной — модель автоматически понизили сначала до Opus 5, затем до Opus 4.8. Логика понятная: чем опаснее операция, тем консервативнее должна быть модель, которая её выполняет.
Опус 4.8 действительно понял, что домашнюю директорию пользователя удалять нельзя. Но при написании проверки использовал одно и то же имя переменной и для тестовой папки, и для финальной очистки. На шаге очистки переменная указывала уже не на /tmp.
Плохие новости: Fable снесла мне всю рабочую машину. Claude решил протестировать песочницу, которую сам же строил, запустив rm -rf на моей домашней директории. Песочница не сработала. Всё пропало.
Часть данных Гиймо потом вытащил из git, nix и логов сессий — но именно часть.
Почему это важно
Самое неприятное здесь не «ИИ ошибся», а то, что предохранитель, возможно, и стал причиной аварии. Даунгрейд — разумная идея: рискованную операцию отдаём более осторожной модели. Но осторожность и внимательность к коду — разные качества. Более сильная модель, скорее всего, заметила бы коллизию имён переменных; более консервативная — не заметила, зато честно рассуждала о том, что домашнюю папку трогать нельзя. Правильная мораль, неправильный код.
И второе. Классический аргумент «дайте агенту песочницу» упирается в то, что песочницу тоже кто-то пишет — и пишет её тот же самый агент, у которого прямо сейчас есть полные права на файловую систему. Пока код песочницы не проверен, ограничения существуют только на бумаге. Единственная защита, которая сработала бы в этот вечер, — бэкап, сделанный заранее.
Источники: Tom's Hardware, пост разработчика
Настройка VPS начинается со сверки: тот ли сервер выдали и кто, кроме вас, может на него войти. После первого входа нужно сверить параметры заказа, подтвердить SSH-отпечаток, создать отдельного администратора, ограничить входящие соединения и сохранить базовые метрики. Установка VPS по этой схеме рассчитана на образ Ubuntu 24.04 LTS с одним администратором. Панель или cloud-init могут менять эти шаги, поэтому некоторые пункты стоит проверять.
Для начала сверьте IP, регион, образ и ресурсы с заказом, затем найдите аварийную консоль и проверьте SSH-отпечаток. После входа создайте отдельного пользователя с sudo, подтвердите доступ по ключу во втором сеансе и только потом включайте firewall и запрещайте парольный вход. Для панели или готового образа сначала посмотрите уже открытые порты.
В личном кабинете или письме указаны IPv4, логин, начальный пароль либо открытый ключ, а также IPv6, если он выдан. Сверьте с заказом регион, образ ОС, vCPU, RAM и диск. После загрузки проверьте их командами nproc, free -h, lsblk и cat /etc/os-release. С ошибкой в регионе или тарифе обратитесь в поддержку до размещения своих данных на сервер.
До первого SSH-входа найдите VNC или другую аварийную консоль, а также порядок запуска rescue mode. Это может понадобится, если ошибка в sshd_config или firewall закроет сетевой доступ. Инструкция Aéza по аварийному режиму показывает, где включается среда восстановления. Конечно, сама она не заменит резервную копию.
Пароль из письма нельзя считать постоянным секретом, так как он прошёл через почту и мог попасть в журнал уведомлений. Если после установки VPS доступен парольный вход, используйте его только для перехода на собственный ключ. Когда образ уже принимает заданный при заказе ключ, не включайте пароль ради удобства. Для нестандартного ISO также проверьте контрольную сумму или подпись.
В Linux, macOS и Windows Terminal SSH-клиент вызывается одинаково. В примере данные замените на те, что в карточке сервера:
ssh root@203.0.113.42
При первом соединении OpenSSH показывает тип ключа хоста и SHA256-отпечаток.
The authenticity of host '203.0.113.42' can't be established.
ED25519 key fingerprint is SHA256:Wq6...K3A.
Are you sure you want to continue connecting (yes/no/[fingerprint])?
Не подтверждайте yes, пока не получите отпечаток другим путём. Откройте аварийную консоль и выполните ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pub, затем сравните строку целиком.
После переустановки ключ хоста меняется. Если сервер не переустанавливали, предупреждение REMOTE HOST IDENTIFICATION HAS CHANGED требует остановки и проверки через консоль или поддержку. Команду ssh-keygen -R IP запускают только после подтверждения причины. На Windows запись хранится в %USERPROFILE%\.ssh\known_hosts, в Linux и macOS – в ~/.ssh/known_hosts.
Сначала создайте учётную запись и каталог для ключа. Текущий сеанс пока не закрывайте:
sudo adduser operator
sudo usermod -aG sudo operator
sudo install -d -m 700 -o operator -g operator /home/operator/.ssh
На рабочем компьютере создайте ключ ssh-keygen -t ed25519 -a 100, если его ещё нет. В Linux перенесите открытую часть командой ssh-copy-id operator@IP. В macOS и Windows Terminal при отсутствии ssh-copy-id добавьте содержимое .pub в /home/operator/.ssh/authorized_keys через открытый сеанс, затем задайте владельца operator и права 600. Приватный ключ на сервер копировать не нужно. Войдите как operator во втором терминале и выполните sudo -v. После проверки можно продолжать настройку VPS сервера.
Добавьте открытый ключ отдельному пользователю, войдите им во втором сеансе и проверьте sudo. Затем создайте конфигурационный фрагмент, который читается раньше остальных, выполните sshd -t и загрузите новую конфигурацию службы. Исходный сеанс держите открытым до повторного входа, а при ошибке исправьте настройки через аварийную консоль.
В Ubuntu файлы из sshd_config.d читаются раньше основного sshd_config, а для большинства директив действует первое найденное значение. Имя 00-local-hardening.conf помещает локальный фрагмент в начало порядка чтения.
sudo tee /etc/ssh/sshd_config.d/00-local-hardening.conf >/dev/null <<'EOF'
PubkeyAuthentication yes
PermitRootLogin no
PasswordAuthentication no
KbdInteractiveAuthentication no
EOF
sudo sshd -t
sudo sshd -T | grep -E '^(pubkeyauthentication|permitrootlogin|passwordauthentication|kbdinteractiveauthentication) '
sudo systemctl reload ssh
После sshd -t выполните reload и, не закрывая текущую сессию, откройте вторую новым пользователем. Проверка вторым сеансом важнее самой команды: на Ubuntu 24.04 с сокет-активацией reload может вернуть ошибку, если ssh.service не запущен. Если вход не работает, исправьте фрагмент через VNC и повторите sshd -t.
UFW в стандартном Ubuntu изначально выключен, а в облачном образе пакет и вовсе может отсутствовать. Проверьте его, задайте политики и откройте SSH-порт. Если sshd слушает не 22-й порт, возьмите значение из sudo ss -utlnp.
if ! command -v ufw >/dev/null; then sudo apt update && sudo apt install ufw; fi
sudo ufw default deny incoming
sudo ufw default allow outgoing
sudo ufw allow 22/tcp comment 'SSH'
sudo ufw show added
sudo ufw enable
sudo ufw status numbered
sudo ss -utlnp
Перед ufw enable оставьте SSH-сеанс открытым. Второй терминал понадобится, чтобы проверить, как подключиться к VPS при действующих правилах. ufw status показывает эти правила, а ss -utlnp – слушающие сокеты и связанные процессы. Сетевой экран не останавливает сами службы.
Порты 80 и 443 добавляют после запуска веб-сервера. Базу данных, Redis и административную панель не нужно открывать всему интернету только потому, что приложение к ним подключается. Смена SSH-порта уменьшает шум от сканеров в журнале, но не заменяет ключи и запрет входа по паролю. В руководстве Ubuntu по UFW описаны простые правила, однако сетевой экран в панели провайдера остаётся отдельным уровнем.
Docker направляет трафик к опубликованным портам в обход обычных правил UFW. Сервис за обратным прокси привязывайте к 127.0.0.1. Для iptables правила пишите в цепочку DOCKER-USER: она документирована и не перезаписывается при перезапуске Docker. При другом бэкенде фильтруйте трафик в панели провайдера.
Разобравшись, как подключиться к VPS серверу, обновите систему и сверьте часы. Просмотрите предлагаемые изменения, установите пакеты и проверьте, нужна ли перезагрузка:
sudo apt update
sudo apt full-upgrade
sudo apt install fio iperf3 sysstat dnsutils
test ! -e /var/run/reboot-required || cat /var/run/reboot-required.pkgs
sudo systemctl --failed
timedatectl status
locale
swapon --show --bytes
free -h
В стандартной установке Ubuntu 24.04 пакет unattended-upgrades ежедневно применяет обновления безопасности. Сторонние репозитории без отдельного правила он не охватывает, а автоматическая перезагрузка по умолчанию выключена. Ответственного за окно обновлений и перезагрузку лучше всё равно назначить, а результат контролировать по /var/log/unattended-upgrades/.
Для серверных журналов удобно оставить UTC: sudo timedatectl set-timezone UTC. Локаль C.UTF-8 уменьшает расхождения в выводе скриптов, если приложение не требует другой: sudo localectl set-locale LANG=C.UTF-8. Менять локаль ради отдельной команды не нужно, достаточно запускать её с LC_ALL=C.
Swap даёт ядру запас при резком пике памяти. При нехватке RAM этот механизм может вызвать длительные задержки при обращении к диску. Сначала проверьте текущий swap и профиль приложения. Для базы данных или сервиса, чувствительного к задержке, размер и vm.swappiness выбирают после замеров. Если в vmstat постоянно растут столбцы si/so, пересмотрите лимиты или тариф до увеличения swap.
Сразу после настройки сервер пустой, и это лучший момент снять базовую линию. Через месяц, когда появится жалоба на медленную работу, сравнивать будет не с чем. Зафиксируйте дату, исполнителя, ОС, ядро, vCPU, RAM, диск и версии утилит. Для CPU сохраните минутный лог mpstat, для диска используйте временный файл, а iperf3 запускайте до своего узла в целевом регионе.
1. Сохраните эффективные параметры sshd -T, правила ufw status numbered и список слушающих сокетов ss -utlnp.
2. Сохраните минутный лог mpstat, запустите fio на две минуты и запишите p50/p95/p99, затем выполните прямой и обратный прогоны iperf3.
3. Приложите конфигурацию, версии и сырой вывод, затем повторите замеры в другое время. Один максимум не считается базовой линией.
date -Is; uname -r; lscpu | sed -n '1,16p'; free -h; lsblk
fio --version; iperf3 --version; mpstat -V
LC_ALL=C mpstat -P ALL 1 60 | tee mpstat.log
fio --name=baseline --filename=/var/tmp/fio.bin --size=1G --direct=1 \
--rw=randrw --rwmixread=70 --bs=4k --ioengine=libaio --iodepth=1 \
--runtime=120 --time_based --group_reporting --percentile_list=50:95:99 \
--output-format=json --output=fio.json
rm -f /var/tmp/fio.bin
: "${IPERF_HOST:?Укажите адрес сервера iperf3}"
iperf3 -c "$IPERF_HOST" -P 4 -t 30 -O 5 --json > iperf3-send.json
iperf3 -c "$IPERF_HOST" -P 4 -t 30 -O 5 -R --json > iperf3-recv.json
fio нагружает диск, поэтому запускайте его в согласованное окно: на основном сервере и на соседних VM нагрузка будет заметна. iodepth=1 показывает задержку одиночной очереди, а не максимальные IOPS при глубине 32. Файл должен помещаться на диске с запасом. В документации fio JSON содержит IOPS и completion latency percentiles, включая заданные p50, p95 и p99.
На собственном контрольном узле запустите iperf3 -s, задайте его адрес в IPERF_HOST и выполните прямой и обратный прогоны с одинаковыми параметрами. Публичный узел не служит эталоном. По официальной документации iperf3 для теста нужны клиент и сервер. Между прогонами не меняйте конечные узлы и их конфигурацию. Сохраните JSON и повторите замер трижды. Оценивайте %steal вместе с загрузкой vCPU: одиночный всплеск не доказывает проблему хоста.
A-запись содержит IPv4 сервера, AAAA-запись содержит IPv6. Перед добавлением AAAA проверьте маршрут, сетевой экран и прослушивание сервиса по IPv6. Первоначальная настройка VPS также требует проверить, проксирует ли DNS-провайдер веб-трафик и какой IP увидит пользователь.
TTL определяет, как долго резолвер может хранить ответ в кеше. После изменения запросите авторитетный сервер зоны, а потом несколько рекурсивных резолверов. До истечения прежнего TTL часть из них может возвращать старый ответ.
dig +noall +answer A app.example.com @1.1.1.1
dig +noall +answer A app.example.com @8.8.8.8
dig +noall +answer AAAA app.example.com @1.1.1.1
AUTH_NS=$(dig +short NS example.com | head -n 1)
dig +noall +answer A app.example.com @"$AUTH_NS"
Если ответы расходятся, сравните их TTL с ответом авторитетного сервера. Очистка локального кеша не изменит запись у внешнего резолвера. Для HTTPS дополнительно проверьте сертификат и имя виртуального хоста, поскольку правильный A/AAAA ещё не подтверждает готовность приложения.
Для исходящей почты нужен PTR, который настраивает владелец IP-диапазона. Имя из PTR должно прямым запросом возвращаться к тому же адресу. Требования Gmail для всех отправителей включают согласованные прямую и обратную DNS-записи, а также SPF или DKIM. При отправке более 5000 писем в сутки на адреса Gmail нужны оба механизма и DMARC. Если сервер не отправляет почту напрямую, веб-сайту PTR не нужен.
После настройки сервер доступен для эксплуатации. Назначьте ответственных за обновления, резервные копии и секреты, а также зафиксируйте срок реакции на сбой. Без регулярной проверки списка ключей, заполнения диска и бэкапов даже завершённая настройка безопасности VPS быстро устареет.
Бэкапы храните вне VPS и регулярно восстанавливайте тестовую копию. Не стоит путать со снапшотами: они фиксируют состояние на момент создания, но не заменяют независимую копию и журнал восстановления. Частоту выбирают по RPO, а время восстановления по RTO. Для базы данных нужна согласованная копия средствами СУБД или остановка записи на время снимка.
В мониторинг включите доступность сервиса, свободное место, память, срок TLS-сертификата, обновления и дату последнего успешного бэкапа. Пороги задавайте после сохранения базовой линии. Секреты храните отдельно от истории команд, compose-файла и репозитория. Для каждого секрета укажите ответственного и период ротации.
Docker, панели и бэкапы требуют отдельных инструкций: у них разные сетевые правила, каталоги данных и процедуры обновления. Одного администратора и UFW недостаточно для командной работы, персональных данных, публичной БД или требований регулятора. В этих случаях нужны журналирование действий, раздельные роли, MFA, проверенное восстановление и контролируемый процесс выпуска изменений.
Перед размещением приложения соберите паспорт сервера: адреса, способ аварийного входа, ожидаемые порты, место хранения бэкапа, ответственных, команды проверки и условия замеров.
Через сутки после первого запуска повторите контрольные проверки. Убедитесь, что обновления завершились, место на диске не заканчивается, сервис отвечает, а задание бэкапа выполнилось успешно. Считайте, что настройка VPS закончена, когда текущее состояние можно проверить, а порядок восстановления понятен тому, кто будет сопровождать сервер.
Проблемы при переезде на VPS-сервер случаются не из-за сложности, а из-за недостаточной подготовки. Этот чек-лист поможет проверить всё важное до переноса нагрузки.
Снимите реальные пики CPU, RAM и диска, а не оценку “на глаз”. Если пики редкие, можно ориентироваться на средние значения с запасом в 1,5–2 раза. Но для баз данных, очередей и сервисов с резкими всплесками трафика важнее именно пиковые значения: по ним стоит проверять CPU, RAM и диск. Под эти данные подбирайте VPS: если база данных и приложение работают на одной машине, не ужимайте RAM ниже рабочего минимума.

Проверка зависимостей и окружения перед переносом на VPS: версии ОС, Node.js, Python, Nginx, PostgreSQL и Redis, переменные окружения, Docker Compose и конфигурации сервера.
Зафиксируйте версии ОС, рантаймов (Node, Python, Java), системных библиотек и сторонних сервисов. Переменные окружения и конфиги часто хранятся локально и в репозиторий не попадают. Проверьте их на старом сервере и убедитесь, что все нужные значения перенесены на новый.

Настройка DNS перед переносом сайта на VPS: снижение TTL до 60–300 секунд, проверка портов, SSL-сертификатов, SSH-ключей, firewall и ограничения доступа по IP.
Проверьте, что нужные порты открыты и задокументированы. Понизьте TTL на текущих DNS-записях до 60–300 секунд заранее: новое значение начнёт действовать только после истечения старого TTL. После этого можно переключать записи. Убедитесь, что SSL-сертификаты готовы к выдаче на новом VPS-сервере. SSH переводите только на ключи, настройте firewall и ограничьте доступ по IP.

Подготовка бэкапов и плана отката перед переносом на VPS: резервное копирование данных, проверка целостности, тестовое восстановление, защита от потери данных и сокращение времени простоя.
Перед миграцией на VPS сделайте полный дамп данных, проверьте целостность резервной копии и выполните тестовое восстановление в отдельном окружении. Само наличие дампа ещё не гарантирует, что из него получится восстановить рабочий сервис. Определите окно для миграции с минимальным трафиком и пропишите конкретные шаги отката – не «вернуть как было», а подробно: что вернуть, откуда и за сколько минут.

Сводный чек-лист перед переносом на VPS: проверка нагрузки CPU, RAM и диска, версий ОС и окружения, DNS и SSL, firewall и SSH-ключей, резервной копии, тестового восстановления и плана отката.
• Пиковые значения CPU/RAM/диска измерены и зафиксированы
• Версии ОС, рантаймов и библиотек задокументированы
• Переменные окружения перенесены и проверены
• DNS и SSL настроены, TTL снижен
• Порты задокументированы, firewall настроен, SSH только по ключам
• Резервная копия проверена, тестовое восстановление выполнено
• Окно миграции определено, план отката прописан
Проверьте чек-лист перед стартом и перенос на VPS пройдёт спокойнее. Выбирайте VPS-провайдера под требования нагрузки, а не только по цене.