
ИИ детекторы и хитрожопые авторы
Детекторы генеративного текста сегодня стали обыденностью. Яндекс встроил «Нейродетектор» в свои образовательные сервисы, Amazon сканирует книги на предмет ИИ-авторства, OpenAI экспериментирует с невидимыми водяными знаками. Но эти системы работают не как «поиск вирусов»! Всё гораздо интереснее! Детектор не видит, как автор писал текст, а видит только финальную последовательность слов и пытается угадать, писал ли это человек или машина, и вот здесь начинается самое интересное.
Что видит Яндекс Нейродетектор
Яндекс запустил Нейродетектор в 2025 году как инструмент для преподавателей, чтобы проверять эссе, рефераты и письменные работы. Инструмент открыт, работает в браузере и выдаёт детализированный разбор по блокам. Точность не гарантируется, но принципы, по которым он работает, вполне конкретны.
1. Признак первый: «нейросетевой» язык.
Языковые модели построены на использовании в генерациях общих фраз. «В современном мире…», «Следует учитывать…», «Ключевым аспектом является…», «Важно отметить, что…» — эти обороты встречаются в сгенерированных работах с пугающей регулярностью. Человек чаще допускает эмоциональные формулировки, а нейросеть тупо выдаёт шаблоны, и это самый главный маркер генеративности.
2. Признак второй: предсказуемость.
Машина выдаёт логичный текст, но иногда даже чересчур логичный. Нейросети генерируют текст, основываясь на вероятности следующего слова, и получается неестественный текст. Если модель легко угадывает следующее слово, то с большой долей вероятности это писала другая модель.
3. Признак третий: примитивность.
Речь не о том, что ИИ пишет глупо, а о том, что всё похоже и одинаково. Те же самые конструкции, одни и те же переходы, похожая длина предложений. Текст может быть грамотным, но в нём нет креативности, которая отличает живую человеческую речь от бездушной машины.
Что находят другие системы: Amazon, Google, OpenAI
Детекторы различаются по подходам, но маркеры, на которые они смотрят, во многом совпадают.
Amazon не раскрывает полностью, как именно сканирует книги в KDP, но известно, что системы анализируют стиль письма, метаданные и скорость загрузки. Плюс, рецензенты проверяют подозрительные тайтлы. Лимиты на загрузку книг введены именно для борьбы с массовой ИИ-публикацией. Исследования показывают, что в выборке из 14 000 самостоятельно опубликованных романов на Amazon почти каждый пятый был отмечен как написанный машиной. Один из самых показательных маркеров: когда ИИ описывает эмоцию, он в 81% случаев перечисляет физические проявления в виде сжатого горла, влажной ладони и т. д. Человек напишет «он испугался», а не «его горло сжалось, а ладони вспотели».
Google пошёл ещё дальше и начал внедрять технологию SynthID в виде невидимых водяных знаков, встроенных в сам процесс генерации, и это не анализ текста, а маркировка на уровне статистики выбора слов. Детектор, зная ключ, может найти эту подпись. Эврика!
OpenAI разрабатывает textGrain — чем-то похожую технологию на гугловскую, которая незаметно меняет статистический паттерн выбора слов и токенов. Специальный детектор затем распознаёт этот паттерн.
Маркеры генеративности
Если обобщить, то разные детекторы анализируют несколько ключевых параметров.
1. Предсказуемость.
Насколько ожидаемо одно слово следует за другим. ИИ выбирает наиболее вероятные слова, и текст получается читаемым, но предсказуемым. Человек же склонен к вариативности.
2. Вариативность длины и структуры предложений.
Человек пишет ритмически: чередуются короткие фразы, затем идут длинные сложные предложения, потом снова короткие. ИИ выдаёт однородные предложения со стабильной структурой. Исследования показывают, что у людей коэффициент вариации длины предложений составляет около 0,114, у ИИ — около 0,037.
3. Причастные и деепричастные обороты.
Исследование PNAS показало, что у языковых моделей причастные обороты встречаются в 2–5 раз чаще, чем у людей. Детектор на этих признаках выдавал точность 66% при базовом уровне 14%. Деепричастные цепочки в одном предложении являются одним из самых узнаваемых маркеров генеративности текстов.
4. Тире.
Длинное тире «—» стало главным визуальным маркером ИИ. Нейросети ставят его почти всегда, а человек, пишущий на клавиатуре, — намного реже или почти никогда. GPT-4.1 использует тире 10,62 раза на 100 слов, человек — 3,23.
5. Повторяющиеся конструкции.
Перечисления из тех же самых элементов, фразы вроде «важно отметить» по несколько раз за абзац, кальки вроде «играет ключевую роль» и т. д. и т. п.
6. Скучность и однородность.
Текст может быть грамотным, структурированным, логичным, но при этом всё равно неинтересным с художественной точки зрения. Идеальные переходы между всеми предложениями, дидактический тон, отсутствие неожиданных поворотов — всё это маркеры генеративности.
Как хитрожопые авторы нейрослопперы обходят ИИ-детекторы
Детекторы не всесильны, и чем больше людей ими пользуется, тем активнее развивается встречная индустрия обхода. Вот что делают опытные авторы, штампующие книги на поток и зарабатывающие за счёт объёма выпускаемой продукции:
1. Замена знаков препинания.
Самое простое и эффективное решение для маскировки спама. Длинное тире заменяется на дефис, запятую или точку. Простая замена точки на запятую может изменить вердикт детектора с «почти ИИ» на «100% человек». Один эксперимент показал, что добавление лишнего пробела перед запятой в случайном месте текста позволило обойти GPTZero и HelloSimpleAI с точностью, близкой к 100%.
2. Контролируемое внесение хаоса.
Искусственные неоконченные предложения, странные обороты и намеренные отступления от формальной логики могут сбить детектор с толку и помочь замаскировать генерацию под человека.
3. Шустрая редактура и парафраз.
Перефразирование — один из самых доступных методов маскировки спама под читабельный текст, используемый спамерами в чёрном SEO ещё с начала нулевых. Простой парафраз может менять маркировку текста с «почти человек» на «100% ИИ» и обратно. Исследования подтверждают, что перефразирование и другие внешне небольшие умные модификации текста способны существенно снижать точность любых детекторов.
4. Изменение температуры генерации.
Если текст создаётся ИИ, можно повысить параметр temperature. Тогда модель начинает выбирать менее вероятные слова, и текст становится более «шумным». Это снижает точность детекторов в среднем на 82,5%. Всё гениальное — просто!
5. Выборочная работа с лексикой и внесение разнообразия в сгенерированные тексты.
Замена слов-триггеров может быть простым и очень эффективным способом маскировки текста под человека. Например, слово «шанс» может мгновенно спровоцировать детектор на вердикт «ИИ», а рандомная замена хотя бы части повторяющихся слов на «возможность» моментально дезориентирует систему и заставляет менять вердикт на «100% человек».
Что всё это значит для авторов
Детекторы ИИ постоянно развиваются, используя новые методы определения генеративных текстов. Они работают вероятностно, ошибаются, путают человеческие тексты с машинными и наоборот. Исследования показывают, что разные детекторы способны ошибочно относить человеческие тексты к машинным, а качество их работы заметно меняется в зависимости от языка, жанра и способа редактирования.
Но если мы пишем сами, то нам нечего бояться. Человеческий текст с его «шероховатостями», неожиданными поворотами, личными отступлениями и неправильностями остаётся тем, что хитрожопые нейрослопперы пока не научились имитировать. По крайней мере, пока.
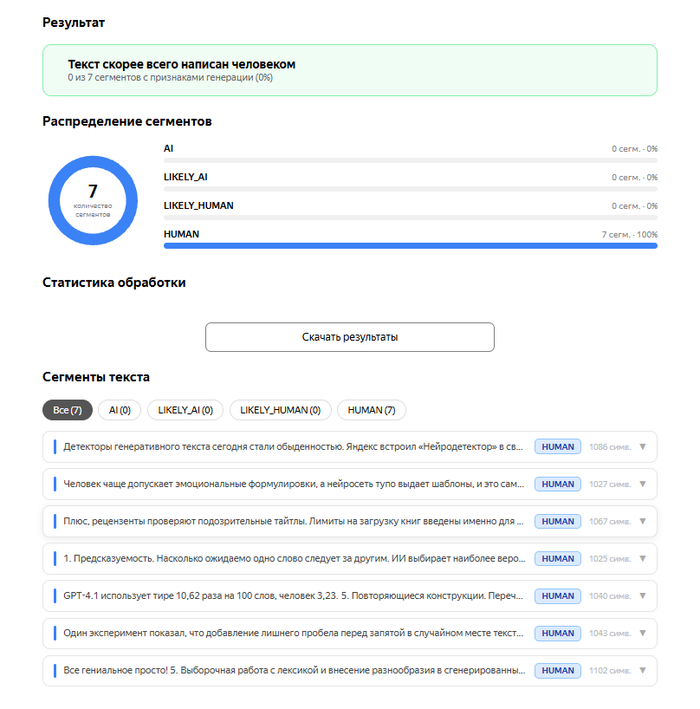
Результат проверки данной статьи
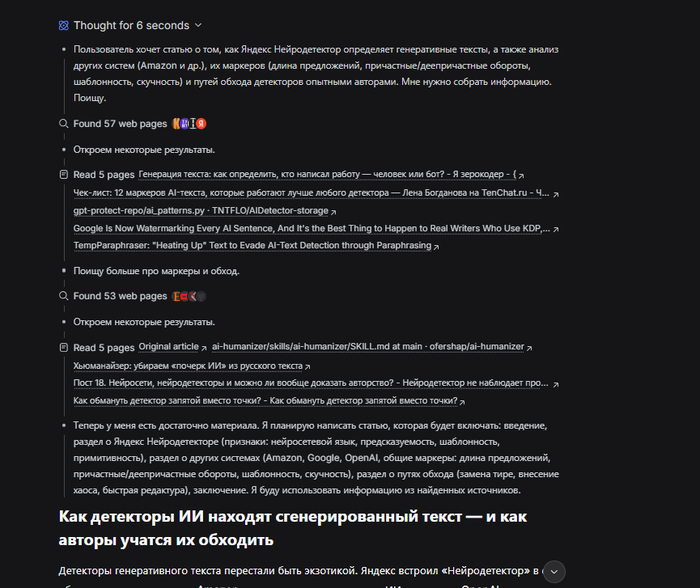
Генерация статьи DeepSeek
Наглядный пример того, как умная генерация + синонимайзер текста + вариатор шаблонов + проверка пунктуации и орфографии + финальный прогон и проверка ЛитНегром делает генерацию 100% человеческой.
Если вам понравилась статья и вы любите хитрожопых умников, то можете глянуть хотя бы одним глазком книгу "Один гениальный промпт". Там есть над чем посмеяться! Реально! )))))))