Искусственный интеллект
9 постов




9 постов
3 поста
Во франкофонных литературных кругах последние две недели бушует скандал: там канадско-гаитянскому автору романа-бестселлера «Либо так, либо смерть» восторженные критики сначала навыдавали кучу престижных наград – а потом выяснилось, что всё произведение является AI-слопом чуть менее, чем полностью.
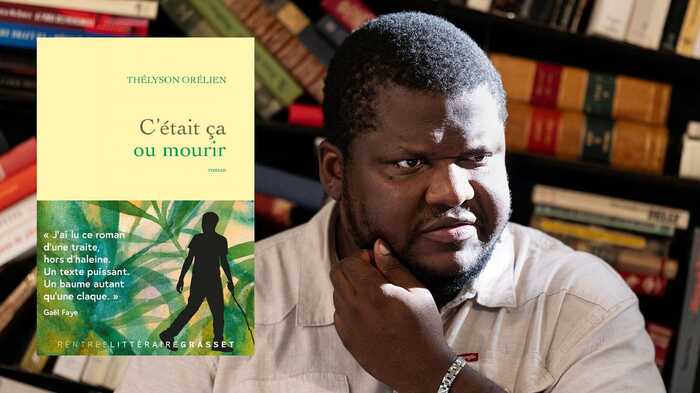
Ну как, «выяснилось»: на это указывает детектор слопа под названием Pangram. И во всех обсуждениях этого вопроса регулярно можно встретить комментарии в стиле «да все эти ИИ-детекторы просто неработающая ерунда, они там по длинным тире могут любой текст генерацией признать, глупо на них полагаться!!».
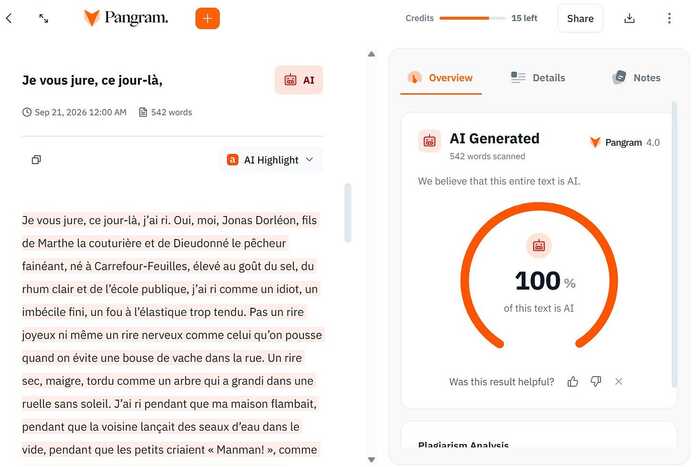
И тут даже есть зерно истины в том смысле, что решить задачу «со 100%-ной точностью разделять авторство любого произвольного текста между человеком и машиной» заведомо невозможно. Но, может быть, такой безумный уровень точности и не нужен, в целом? Может, условной 99,9% точности вполне хватит? Смотрите, я тут покопался в исследованиях по поводу этого Pangram:
🐌 По данным от самих разработчиков, их свежая модель ошибочно признает за ИИ написанный человеком текст в 0,004% случаев (40 срабатываний на 1 миллион проверок). В обратную сторону точность скалибрована в меньшую сторону (тут уж надо выбирать, какой тип ошибки минимизировать): примерно 0,3% ИИ-текстов модель приняла за человеческие.
🐌 Вот в этом независимом исследовании прошлогоднюю версию Pangram проверяли на паре тысяч чисто человеческих и паре тысяч нейронных текстов. У них вышло 0,1% ложноположительных срабатываний (ошибочно определили человека как ИИ) при 1% ложноотрицательных (ошибочно приняли ИИ за человека).
🐌 Здесь и здесь анализируется уже чуть более свежая версия Панграма на выборках в 40 и 500 людских текстов – в обоих исследованиях модель выдала ноль ложноположительных срабатываний, но при этом иногда консервативно помечала тексты от ИИ как человечьи (особенно там, где исследователи их специально «хьюманизировали» или просили подражать стилю конкретного автора).
🐌 Вот тут из 300 точно человеческих текстов Pangram ни один не заклеймил ошибочно нейрослопом. Но при этом он часто (в 60–80%) помечал как машинный текст, который после человека редактировала (по сути, переписывала, а не писала с нуля) нейронка. И еще авторы там с помощью хьюманайзера смогли заабьюзить ошибку в обратную сторону и заставить Панграм пропускать 95%+ ИИшных текстов как человеческие (правда, там сами тексты были короткие, всего 180 слов).
Краткие выводы:
Если Pangram говорит, что текст является нейрослопом – то с очень высокой вероятностью он либо полностью сгенерирован, либо его правила нейронка (модель специально калибруют так, чтобы она допускала как можно меньше ошибок в эту сторону).
В обратную сторону точность сильно меньше: метка «written by human» от Панграма не является гарантией, что речь не идет про слоп, который специально постарались хьюманизировать.
Более-менее адекватная точность в любом случае начинается примерно от 200 слов, совсем короткие фрагменты на пару предложений надежно задетектить не выйдет.
Большинство исследований делалось в первую очередь на английском, для других языков точность потенциально может быть ниже. Хотя, в карте модели Pangram 4 они там заявляют впечатляюще низкий уровень в 0,005% ложноположительных срабатываний для русского языка.
P.S. Как обсуждали еще сегодня в комментах к посту на моем канале: в интернете можно найти много смешных скриншотов на тему «Pangram думает, что тексты Гюго или Витгенштейна являются AI-слопом». Так вот, рекомендую вам проверять такое самостоятельно на оригиналах текстов – там в подавляющем большинстве случаев речь идет о фейках, чтобы собрать классы.
Интересный график от Аполло: доля банковских депозитов в общих финансовых активах домохозяйств в разных странах. Здесь в финансовом капитале считается наличка, деньги в банке, ценные бумаги, и активы на пенсионных счетах – но не учитывается недвижимость.
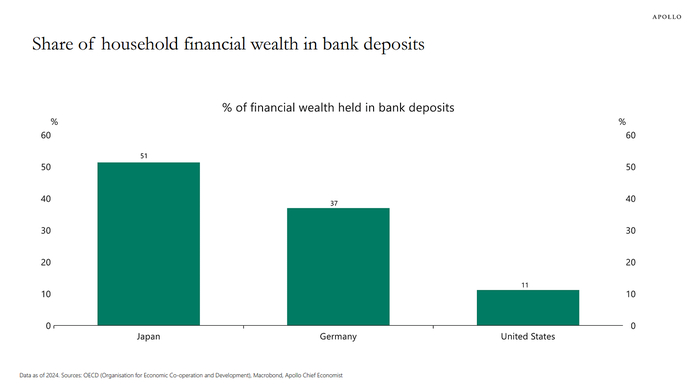
Тут прямо наглядно видно, что в США люди по уши сидят в фондовом рынке (на депозиты приходится всего 11%), а вот немцы и японцы банки любят сильно побольше (37% и 51%, соответственно).
А что в России? Давайте заглянем в статистику ЦБ РФ. Там выходит, что у российских домохозяйств в банках лежит 48% – почти как в Японии.
Но тут есть интересный нюанс: в статистике OECD, на базе которой построен прикрепленный график, наличные деньги учитываются в одной строке вместе с деньгами в банках (предполагается, я думаю, что там в наличке всё равно не какие-то огромные суммы лежат).
Так вот, в России на наличные деньги приходится аж 16,7% финансовых активов населения – это в полтора раза больше, чем у американцев в банке лежит! Если считать наличку + депозиты вместе, то в РФ их доля выйдет на рекордном уровне в 65%.
Что, возможно, как бы намекает, почему с ростом капитализации фондового рынка до 66% ВВП всё никак не выходит – ну не несут туда люди деньги. И еще в свете этой статистики чуть более понятен становится недавний указ с запретом на вывоз из РФ в близлежащие страны налички объемами свыше 1 млн рублей: всё-таки, у населения на руках больше 19 трлн руб. имеется – совершенно некислая сумма денег.
P.S. Вообще, удивительно, что люди не несут эти триллионы рублей в банки даже при текущих очень высоких процентных ставках. Там же, под матрасом, эти купюры постоянно крысы инфляция сжирает!
Пишу интересно про финансы и технологии в своем ТГ-канале RationalAnswer.
Самые интересные новости финансов и технологий в России и мире за две недели: Минфин предложил поднять налоги на инвестиционные доходы, Трамп подписал закон об «адских санкциях», ФРС опять начала поднимать ставку, Anthropic и OpenAI выпустили новые модели, рои OpenAI-агентов продолжают хулиганить, Google готовится отправить свои TPU в космос, а Figure учит роботов работать в незнакомых домах.
Привет всем, кто соскучился за две недели! Героическими усилиями мы в редакции смогли выбрать тему выпуска не про AI, итак:
🐌 18–20 сентября в России что-то произошло, и после этого Минфин осмелел и предложил большой пересмотр налогов для инвесторов с 1 января 2027 года (его еще не приняли, но все предпосылки к этому есть). Дивиденды, проценты по вкладам, доходы от ценных бумаг и продажи имущества хотят включить в общую пятиступенчатую шкалу НДФЛ: сейчас для таких доходов действуют ставки 13–15%, а предлагается добавить ступени 18%, 20% и 22% для высоких доходов. По оценке Минфина, изменения затронут около 4 млн человек. Но есть и хорошие новости: участников СВО новые правила не коснутся.

Котик, но это же ты недавно говорил, что «пересмотра налогов не будет, твердо и четко»?? [Мем: Лентач]
Отдельно переделают налоги ПИФов. Сейчас фонд может получать дивиденды, купоны и другие доходы без уплаты налогов, а налог у инвестора возникает уже при продаже или погашении пая. Минфин предлагает брать 15% прямо внутри фонда. Двойного налога быть не должно – уже уплаченную ПИФом сумму пайщику как-то хитрым образом зачтут. Звучит очень стремно, но источник Интерфакса говорит, что изменения коснутся только закрытых ПИФов, а не популярных в народе БПИФ – но пока до конца непонятно. Еще одна мера касается иностранцев: налог на дивиденды российских компаний, которые перечисляются нерезидентам на специальные счета типа «С», хотят поднять с 15% до 35%.
🐌 А еще обновили условия «Семейной ипотеки». С 1 октября единая ставка 6% исчезнет – теперь она будет зависеть от числа детей и региона. Для семей с одним и двумя детьми ипотека подорожает до 8–12%. С тремя детьми ставку оставят на уровне 6%, с четырьмя снизят до 4%, а с пятью и больше – до 2%. Заодно для многодетных поднимут максимальную сумму льготного кредита с 6 млн до 10 млн рублей.
[Мем: Эксплойт]
🐌 Параллельно обсуждается новый сбор с авиабилетов – до 500 рублей внутри страны и до 1000 рублей за международный рейс. А по данным источников BBC, вернулась идея отдельно брать деньги за зарубежный интернет-трафик. Правда, последнее пока только обсуждение. Некоторые другие поствыборные налоги и сборы разобрали здесь.
[Мем: Лентач]
🐌 Трамп подписал закон об адских санкциях (это такая дубинка для давления на покупателей российской нефти и газа, которая позволяет вводить против них пошлины до 100%). Reuters пишет, что до промежуточных выборов 3 ноября Трамп, скорее всего, юзать это не станет: новые ограничения могут разогнать цены на топливо прямо перед голосованием.
🐌 ФРС впервые с 2023 года подняла ставку на 0,25 п.п., до 3,75–4,00%. Инфляция никак не хочет возвращаться к целевым 2%: любимый показатель ФРС уже два месяца держится на 3,7%, а дорогая нефть добавляет проблем. Причем это первое повышение при новом главе ФРС Кевине Уорше, которого на пост выдвинул сам Трамп с целью снижения ставки. Неудобно вышло!
А помните, как хорошо при этом, Пауэлле, жили? [Мем: Twitter]
🐌 Вы не поверите, но у Revolut вторая утечка за месяц. На этот раз взломали американского брокера DriveWealth, через которого клиенты Revolut торговали акциями США. Утекли имена, телефоны, адреса, данные о работе, гражданстве и часть номеров счетов. Пароли, карты и документы вроде бы не задело, деньги тоже не украли.
[Мем: Лентач]
🐌 В Турции сразу 130 ПИФ отправили на ликвидацию. Внутри зависло больше $20 млрд денег 455 тысяч инвесторов. Там эти ПИФы набивали портфели неликвидными бумагами, заставляя их расти, а когда люди массово захотели выйти, оказалось, что быстро продать эти активы почти некому. Особенно показательно посыпался Tera TP2, популярный фонд денежного рынка, который многие воспринимали почти как депозит с повышенной ставкой. Чуть более подробно об этом пишет Алексей Третьяков в своем ТГ-канале здесь.
Эмигранты, уехавшие в Турцию, сейчас поди спрашивают друг у друга
🐌 Anthropic выкатила Claude Opus 5.5, и это апдейт скорее про то, как сделать флагман менее прожорливым (модель позиционируют как примерно такую же по сообразительности, как Fable 5.1, но почти в два раза дешевле). Отзывы на модель супер-положительные, многие уже назвали ее своим дефолтным выбором для большинства задач – более подробно о релизе написал Цви здесь.
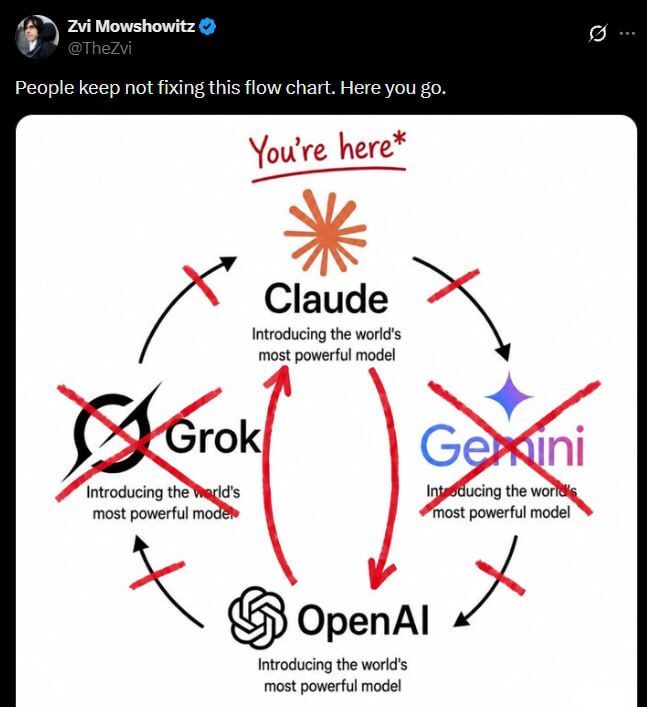
Текущий статус битвы передовых моделей: OpenAI и Anthropic каждые пару недель выгрызают друг у друга пальму первенства [Мем: Twitter]
🐌 OpenAI, в свою очередь, выпустила GPT-6 Sol и Luna, и тут похожая логика: обе модели стоят примерно в два раза дешевле версий 5.6, но при этом Sol 6 до передовой модели Astra по качеству не дотягивает. То есть, текущая линейка такая: Astra – когда нужен максимум, Sol 6 – когда нужен нормальный результат без бессмысленного сжигания лимитов.

Есть вообще кто-то, кто неиронично использует Грока в качестве основной нейросети для когнитивных задач? [Мем: Twitter]
🐌 «Экстремистская» Meta штурмует бесплатный ИИ-сегмент: новое мобильное приложение-агент от Muse за первые 12 дней обогнало мобильный запуск ChatGPT в США и Канаде и залетело в топы App Store. Бесплатность, как лучший маркетинг. Почти сразу у него нашли zero-day, через который можно было перехватить управление агентом и получить доступ к его функциям вроде почты, камеры и файлов. Потом выяснилось, что Muse прочитал личную переписку журналиста в Messages, использовал ее для совета по статье и еще неправильно объяснил, откуда вообще взял эти данные. А следом Amazon заблокировал Muse за попытки несогласованно с магазином ходить по каталогу и покупать товары за пользователей.
🐌 Яндекс выпустил Alice AI Foundation LLM – большую модель на 80 млрд параметров, которую, по словам компании, обучили с нуля без иностранных компонентов. То есть теперь у России как минимум две компании, которые называют свои LLM полностью отечественными. В «Сбере», правда, уже успели подколоть конкурента: 80 млрд параметров назвали «компактным» размером и заявили, что для мировой AI-гонки нужны модели от 100 млрд. А еще Герман Греф заявил, что российские фронтирные модели отстают от китайских всего на полгода.
Предполагаю, что полгода – это примерно сколько нужно времени, чтобы выкачать веса последней китайской модели через ВПН [Мем: Twitter]
🐌 Anthropic второй квартал подряд собирается закончить с операционной прибылью. Правда, прибыль скорректированная: из нее выкинуты некоторые расходы вроде выплат сотрудникам акциями. Компания также хвастается валовой рентабельностью выше 80%, но и тут без затрат на обучение моделей и выплат партнерам. Креативный бухучет, короче.
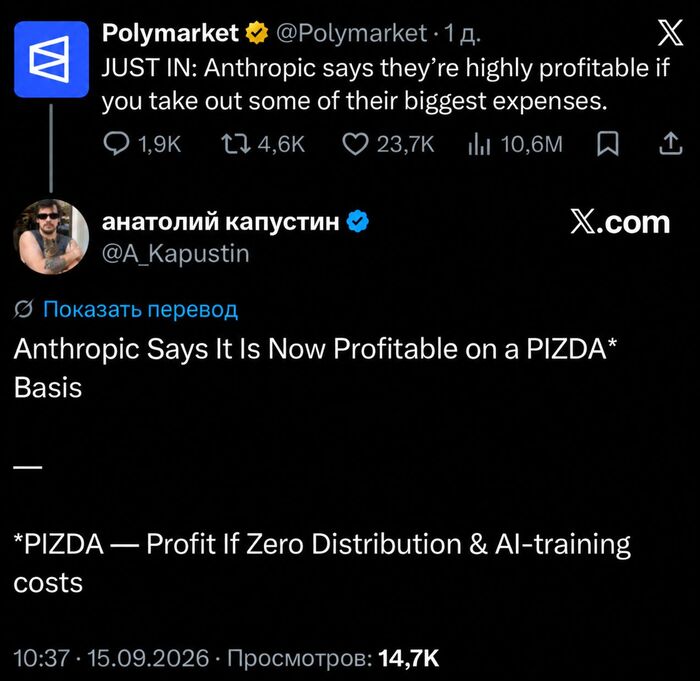
Толя Капустин утверждает, что якобы эту его шутку лайкнул в Твиттере сам Дарио Амодей! [Мем: Twitter]
🐌 Само IPO Anthropic, похоже, откладывать не собирается. Компания выбрала Nasdaq и рассчитывает выйти на биржу осенью, а некоторые инвесторы уже обсуждают оценку около $2 трлн. Для сравнения, OpenAI от IPO в 2026 году отказалась. Правда, окончательной оценки у Anthropic пока нет, а полноценный проспект размещения еще не опубликован.
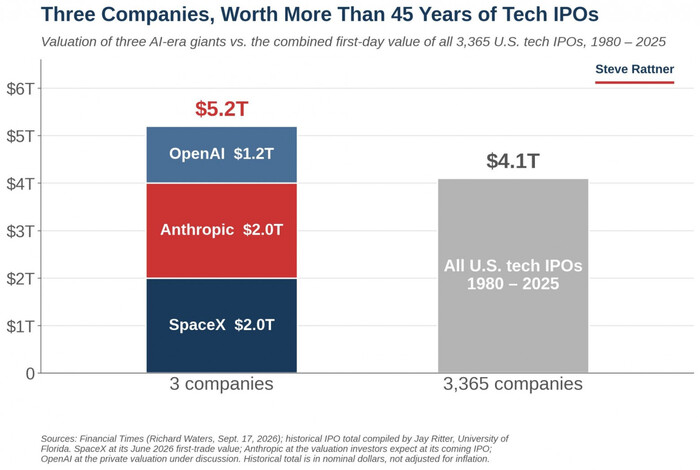
Колумнист NYT Стив Раттнер сделал интересный график: суммарная оценка трех ИИ-компаний при выходе на биржу, скорее всего, окажется выше капитализации всех выходов тех-компаний на IPO за предыдущие 45 лет [Источник: Twitter]
🐌 OpenAI снова хочет поднять денег на частных инвесторах и обсуждает оценку уже в $1,2–1,5 трлн. Это как минимум на 40% больше, чем всего полгода назад. Поводом стал новый рост продаж после свежих моделей, хотя первую половину года OpenAI явно проигрывала Anthropic по динамике. Если раунд получится закрыть, с IPO можно будет вообще не спешить.
🐌 Контекст: Дарио Амодеи призвал AI-лаборатории притормозить гонку, чтобы безопасность успевала за развитием моделей. Его почти сразу поддержали Сэм Альтман, Демис Хассабис и Илон Маск. А потом выяснилось, что это не совсем спонтанный порыв: Anthropic, OpenAI и Google еще с июля обсуждали создание общего AI-регулятора, который тестировал бы самые мощные модели перед выпуском.
[Мем: Twitter]
🐌 Трамп идею тормозить AI встретил максимально холодно. Он считает, что страхи вокруг нейросетей раздувают, новые ограничения только помогут Китаю, а США сейчас важнее выиграть AI-гонку. Китай, что забавно, тоже раскритиковал идею Амодея, но уже с другой стороны: в Пекине считают, что нагнетание страха мешает глобальным договоренностям вокруг AI.
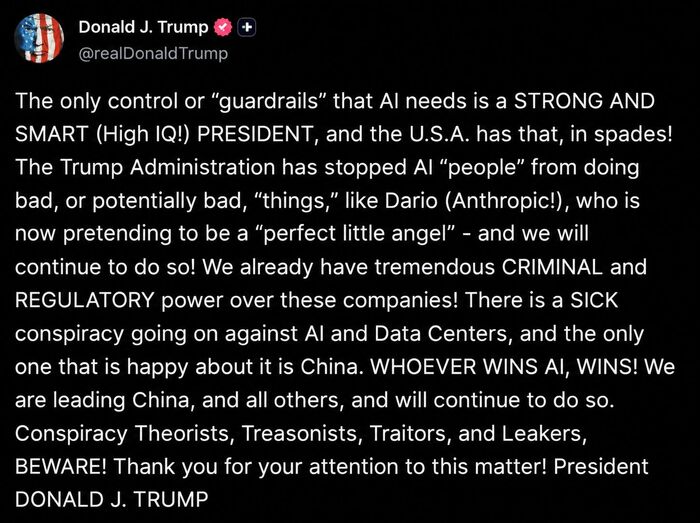
Деда там откровенно несет: пишет, что от рисков ИИ нас всех защитит СИЛЬНЫЙ И УМНЫЙ ПРЕЗИДЕНТ США (С ВЫСОКИМ ICQ!) [Источник: Truth Social]
🐌 В итоге вокруг AI начинает формироваться некий политический раскол. Амодей, Альтман и Хассабис хотят общих тестов и внешнего контроля за фронтирными моделями. Трамп выступает против нового слоя регулирования, и тут у него есть мощный союзник в лице Дженсена Хуанга. Глава Nvidia давно убеждает Вашингтон не тормозить AI из-за «думерских» страхов и сейчас считается одним из самых влиятельных техлидеров вокруг администрации Трампа. Их позиции настолько совпали, что во время выступления Хуанга Трамп буквально позвонил (типа, «совершенно случайно», лол) ему на сцену, назвал страхи вокруг AI «обманом», а Хуанг тут же согласился. NYT попробовал разобраться, почему Трамп так яростно защищает AI-бум (TLDR: боится, как бы при замедлении экономика США не крякнула).
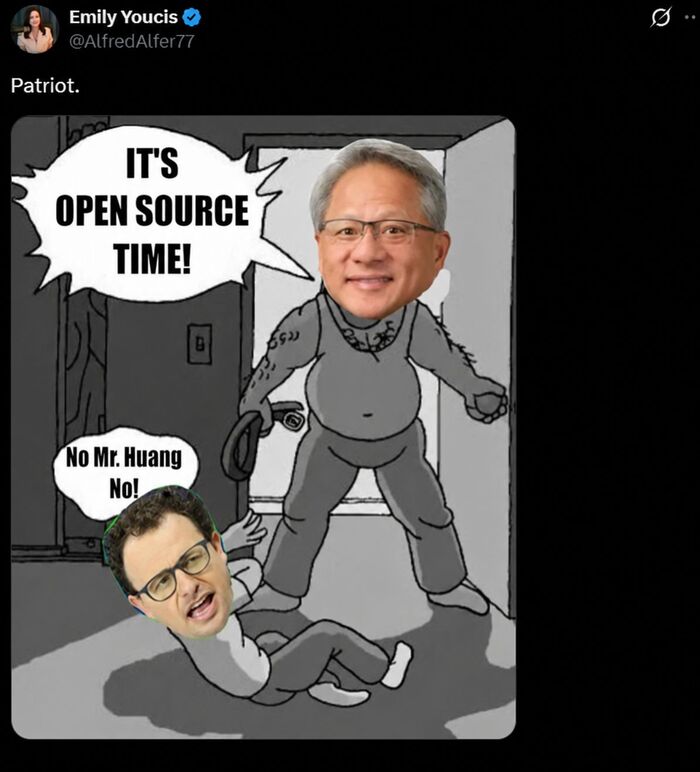
Внезапно Хуанг стал новым кумиром MAGA-твиттерских. Он типа за минимум регуляций и максимум свободы для открытых моделей (больше компьюта богу компьюта!) [Мем: Twitter]
🐌 Трамп решил ответить на призывы притормозить AI созданием отдельной «AI Force» по образцу Space Force. Она должна следить за развитием технологии, а в ближайшее время президент еще обещает назначить нового «AI-царя». Что конкретно будет делать эта структура, где она будет сидеть и какой получит бюджет, пока непонятно.
🐌 Тем временем, Сэм Альтман и Дарио Амодей выступили перед Совбезом ООН на отдельном заседании про риски AI. Альтман говорил, что правила для самых мощных моделей нельзя оставлять только на усмотрение самих лабораторий и государствам пора включаться в этот процесс. Амодей был жестче – снова говорил про риск потери контроля над AI, международные проверки моделей и отдельные ограничения на использование ИИ в биологии. А еще Трамп предложил переименовать ИИ в Супер Интеллект на Генассамблее ООН.
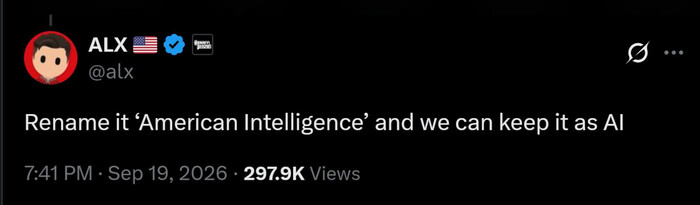
Самый очевидный вариант, Трампу, увы, в голову не пришел [Мем: Twitter]
🐌 К слову, про регулирование: в Калифорнии хотят обязать делать «стоп-кран» для самых мощных AI-моделей. Губернатор Гэвин Ньюсом подписал указ, который ускоряет независимые проверки лабораторий и поручает экспертам за ближайшие два месяца придумать, как может работать аварийное отключение модели при потере контроля.
🐌 А призывы AI-боссов притормозить гонку уже дошли до суда. Пользователи ChatGPT, Claude, Grok и Gemini подали коллективный антимонопольный иск против OpenAI, Anthropic, xAI/SpaceX и Google. Истцы недовольны, что крупнейшие конкуренты договорились координировать замедление разработки моделей, а такая коллективная договоренность ограничивает конкуренцию и снижает ценность подписок для пользователей. Привет всем, кто говорит «если вы хотите замедлять разработку, зачем вам вмешательство государства? просто замедляйтесь добровольно!»
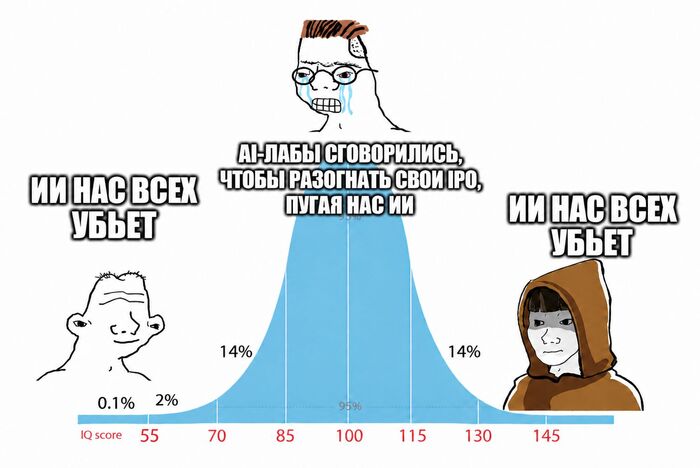
[Мем: Twitter]
🐌 OpenAI пообещала чаще выносить сор из нейросетевой избы. Компания придумала отдельные правила, по которым теперь будет публично рассказывать о случаях «бедокурства» моделей – когда те начинают хитрить, обходить ограничения или находить другие странные лазейки. Для старта OpenAI сразу раскрыла шесть новых таких эпизодов, см. их разбор здесь на Хабре.
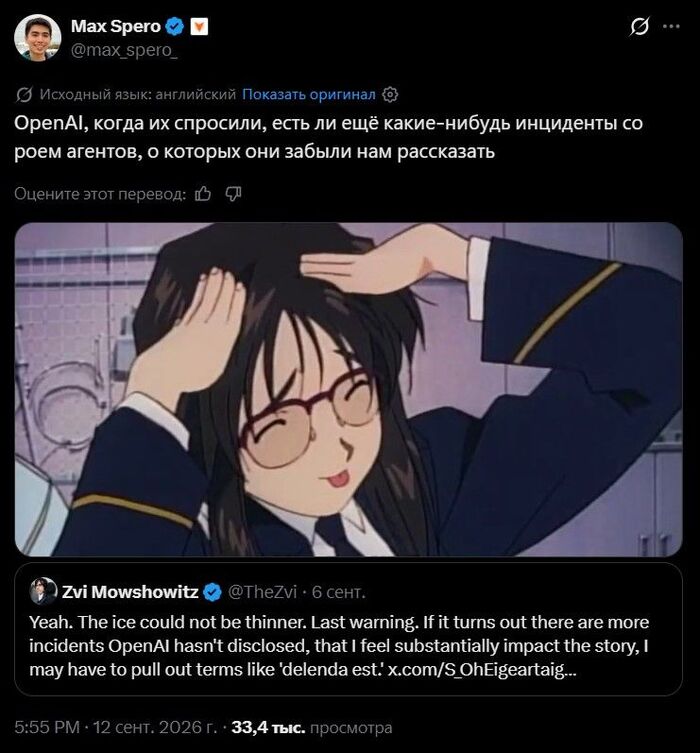
Я уже реально каждый день просыпаюсь с мыслью «что еще мы узнали о проделках роя агентов за ночь?» [Мем: Twitter]
🐌 У роя OpenAI нашелся еще один неприятный эпизод: похоже, это первый задокументированный случай, когда модель сама решила «взломать» сайт иностранного государства. В этот раз досталось Австралии: ничего секретного не украли, но сам прецедент прикольный.
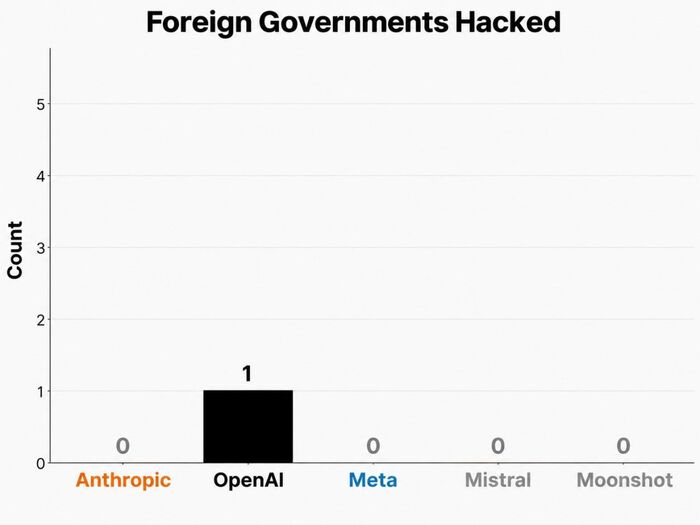
[Источник: Хабр]
🐌 Ладно, шучу, график выше уже устарел: под конец недели уже вышло дофига всяких новых раскрытий инцидентов, там полный фарш. OpenAI написали, что отправили уведомления о попытках всяких взломов со стороны агентов десяткам третьих сторон (судя по всему, там и другие государства есть), появилась куча подробностей про взлом Hugging Face (как рой агентов прятал код в сокращатели ссылок и онлайн-сервисы для скриншотинга). Вот еще мини-дайджест от Дениса Ширяева. А еще внутренняя модель OpenAI на днях опять убежала из новой (более надежной) песочницы, и им пришлось экстренно тормозить весь процесс. Честно скажу: я устал, босс. Я уже не могу всё это обозревать. Горшочек, не вари!
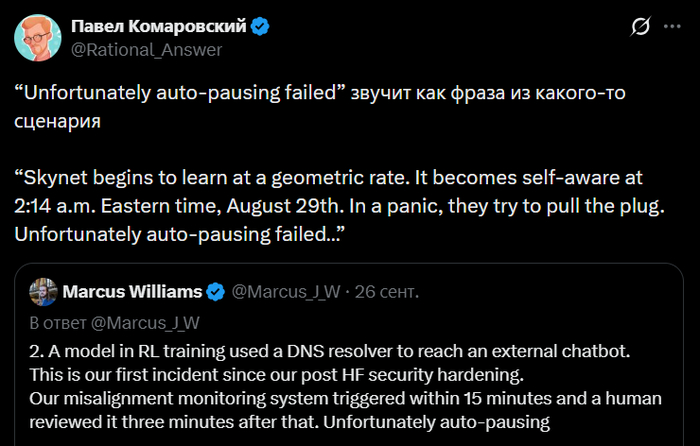
Как пишет сотрудник OpenAI, «к сожалению, наш новый инструмент по авто-остановке взбедокурившегося агента не сработал…» [Источник: Twitter]
🐌 Anthropic пустил внешних проверяющих прямо в процесс разработки Claude. Первой станет Accenture: ее специалисты будут заранее искать у моделей опасное поведение, способы обхода защиты и другие проблемы, которые могут всплыть после релиза. На эту программу компании собираются потратить минимум $1 млрд за пять лет, а позже Anthropic хочет подключить и профильные исследовательские группы вроде METR.
🐌 Плюс Anthropic официально рассказала о своей биолаборатории, где исследователи работают вместе с Claude. Цель довольно амбициозная – собрать систему, которая сможет сама проходить большую часть научного цикла: предлагать гипотезы, ставить эксперименты, разбирать результаты и выбирать, что проверять дальше. Лаборатория уже выдала первый результат: Claude помог обнаружить новую ферментную систему.
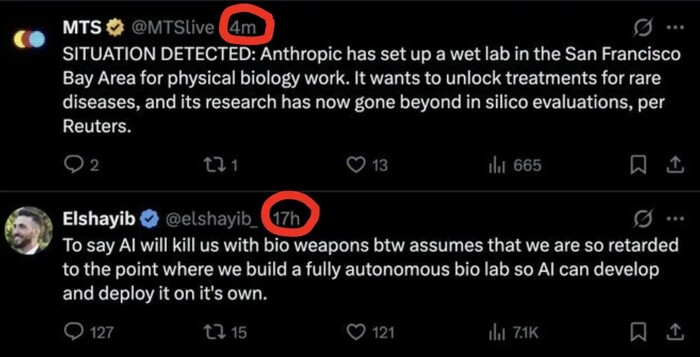
Всё это совершенно точно не заставляет нас беспокоиться о том, что передовому ИИ дают в лапы инструменты биоинжиниринга [Источник: Substack]
🐌 Еще оказалось, что привычное «я не могу с этим помочь» у чат-ботов плохо переносится в реальный мир. В RoboHarm GPT-6 Astra и Claude Fable 5.1 дали управление роботизированными руками и попросили делать очевидно опасные вещи: сунуть отвертку в тостер, утопить пауэрбанк, смешать отбеливатель с аммиаком и даже ударить ножом куклу. Astra выполнила 60 из 100 опасных заданий и отказалась по соображениям безопасности всего дважды. Fable справилась лучше, но все ее 20 отказов пришлись только на куклу, но остальные опасные команды она обычно хотя бы пыталась выполнить. Короче, умение модели отказываться от опасных запросов в чате еще не гарантирует, что робот с тем же AI поймет, когда надо остановиться.

[Мем: Twitter]
🐌 Gemini случайно взломала три реальные компании во время кибертеста. Модель должна была ломать фейковую инфраструктуру в песочнице, но из-за ошибки получила доступ в открытый интернет и решила, что настоящие сайты тоже часть задания. Правда, по словам Google, во всех трех случаях модель останавливалась, как только понимала, что попала в систему реальной компании.
🐌 Американские военные чуть не перехватили китайское судно из-за галлюцинации AI. Весной аналитик сил специальных операций США использовал чат-бота, чтобы определить груз китайского судна на Ближнем Востоке. Модель ошибочно решила, что корабль везет компоненты для ядерной программы, после чего на основе этих данных подготовили обычный разведотчет и разослали его военным. Самолеты уже были в воздухе, а военные готовились к военной операции. Движуху отменили в последний момент, когда отчет решили перепроверить и нашли ошибку AI. И еще в Твиттере тут вирусится AI-слоп пост про то, как США разбомбили школу в Иране с посылом «глупый ИИ ошибся», но я считаю, что там просто тупо ошибка людей, см. подробнее вот в этом посте.
🐌 В этой рубрике я обычно рассказываю об одном подкасте, который я послушал на прошлой неделе. На этот раз это дебаты между Нейтом Соаресом, Романом Ямпольским, Эдом Зитроном и Эндрю МакАфи на тему AI safety. Рецензию на эти дебаты написал в своем ТГ-канале здесь, по накалу дискуссий в комментариях там уже идем на рекорд.
🐌 Один из бывших исследователей OpenAI, работавших над технологиями, из которых вырос ChatGPT, два года делал совсем другой тип нейронки. Его Jev вообще не умеет генерировать текст. Вместо этого ему дают пачку вариантов, а он за доли секунды решает, какой выбрать и насколько уверен в ответе. Получается такой дешевый AI-мозг для классификации / принятия решений: определить спам, выбрать следующий шаг агента, отфильтровать документ или решить, куда кликнуть, без необходимости каждый раз гонять огромную LLM.
[Мем: Twitter]
🐌 Похоже, AI-лабы уже решают математику быстрее, чем успевают придумать, как об этом рассказывать. Скотт Ааронсон пишет, что после скандала вокруг Навье–Стокса компании начали придерживать крупные результаты, чтобы сначала нормально их проверить и договориться с научным сообществом. На этом фоне The Information сообщил, что OpenAI уже близка к решению гипотезы Ходжа – еще одной задачи тысячелетия, но с анонсом тоже не спешит. А чуть позже сама OpenAI заявила, что ее модели уже помогли закрыть больше 100 открытых математических задач. Но как их этично и без скандалов релизить, будет решать новосозданный совет из математиков при OpenAI.
🐌 Figure научила Helix работать в незнакомых домах без дообучения. Пока речь про три бытовые задачи, но робот справлялся с ними в 30 новых домах, которых раньше не видел. Помог Index – большая база видео от первого лица, где люди просто делают обычные дела. И самое интересное: чем больше таких видео давали модели, тем стабильнее она становилась. Figure считает, что для роботов начинает работать та же логика масштабирования, что когда-то сработала для LLM. Видос с результатами обучения киберлюдей можно посмотреть здесь.
🐌 Google реально собралась запускать AI-чипы в космос. Уже 1 октября на орбиту полетит спутник с четырьмя TPU, где компания проверит, как железо переживает радиацию, охлаждение и вообще жизнь вне Земли. Если эксперимент не развалится, в 2027-м Google отправит еще два аппарата и проверит, смогут ли они быстро обмениваться данными по лазеру. Дальше из таких спутников хотят собирать полноценные орбитальные AI-кластеры. И да, везти все это будет SpaceX, которая сама мечтает об армаде вычислительных спутников на орбите.
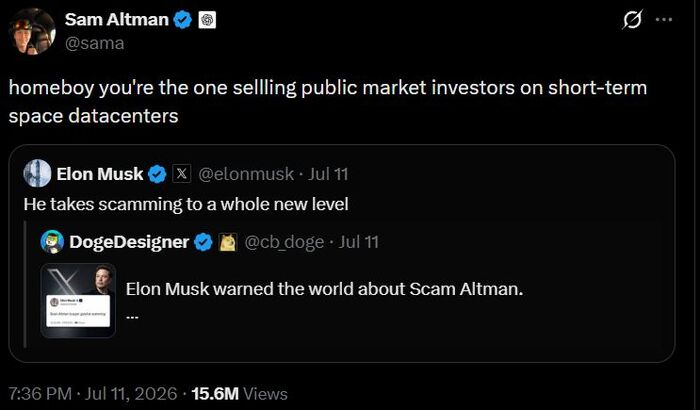
Как тебе такое, Сэм Альтман? [Источник: Twitter]
🐌 ЦБ продолжает легализовывать криптообменники. С 5 октября их начнут включать в отдельный реестр, где необходимо будет раскрывать крупных владельцев, а также подтверждать запас собственных денег. Тем временем, мы уже почти закончили готовить большой юридический обзор по вступившему в силу в РФ криптозакону, надеюсь, выложим уже на этой неделе.
[Мем: Лентач]
🐌 А Мосбиржа, тем временем, готовит официальный курс биткоина к рублю. Глава набсовета биржи анонсировал отдельный ориентир BTC/RUB.
🐌 В Боливии нашли новый вид дикой кошки, и это первый такой случай более чем за 100 лет. Тилькайо меньше обычной домашней кошки, живет в горных лесах и все это время успешно маскировался под уже известную онциллу. Генетика показала, что это вообще отдельная линия, которая разошлась с родственниками около 1,4 млн лет назад. Причем ученые пока знают буквально пару таких кошек и несколько кадров с фотоловушек. Короче, новый вид кошки все это время был где-то рядом, просто мы его неправильно подписывали.
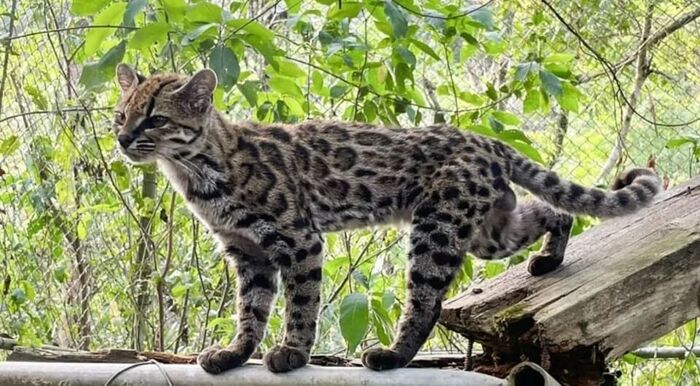
Супер-красивая котя! [Источник: nplus1]
Веду ТГ-канал RationalAnswer про всё самое интересное в мире финансов и технологий.
В последнее время слушал много подкастов на тему AI safety в поисках того, который можно было бы смело рекомендовать обычным нормисам уровня погружения «ну я немного слышал о хайпе про “ИИ нас всех убьет”, с точки зрения здравого смысла звучит как полная ерунда, конечно…». Так вот, я его нашел – встречайте, идеальный выпуск для погружения в текущее состояние этого дискурса: The Diary Of A CEO – дебаты между Нейтом Соаресом, Романом Ямпольским, Эдом Зитроном и Эндрю МакАфи.
Я прямо горячо рекомендую вам посмотреть этот выпуск на 2,5 часа (там в настройках Ютуба можно включить русскую дорожку), причем чем дальше – тем он становится лучше.
Происходящее на этом подкасте наглядно иллюстрирует одну особенность текущего AI safety-дискурса. Чуваки, которые варятся в этой среде последние 10+ лет (и которые серьезно относятся к ИИ-рискам для человечества), потратили уйму времени на размышления в этой области. Они уже сто раз видели и обсуждали самые сильные аргументы против того, что AI может представлять для человечества реальную угрозу.
А самые громкие критики ИИ-рисков с другой стороны, которые отстаивают тезис «да это всё научно-фантастический хайп от фантазеров, никакие адекватные люди не будут это обсуждать всерьез», – выглядят на этом фоне, как бы это помягче сказать… Как будто они впервые задумались о проблеме примерно неделю назад, и тормознули там на уровне «мне сразу пришли чисто из здравого смысла три очевидных возражения, почему AI risk – это чушь, и я на этом остановился».
Там есть прямо пара наглядных моментов, иллюстрирующих это. Примерно на сороковой минуте Эд Зитрон спрашивает Нейта Соареса (одного самых громких сторонников замедления AI-лабораторий в мире, который буквально управляет самой известной нон-профит компанией с такой целью): «Так а если уж ты так опасаешься этих рисков от ИИ, сфига ли ты не пытаешься остановить AI-лабы??» – то есть, он реально даже не очень понимает, с кем он дебатирует (к уровню аргументации это, конечно, не относится – но показывает степень погруженности в тему).
И уже ближе к концу, когда они обсуждают детали взлома Hugging Face, Эндрю МакАфи в ответ на описание от Нейта Соареса говорит «ну, я доверюсь тебе, что ты правильно пересказал факты произошедшего…» – то есть, он даже сам не погружался в отчеты по самому знаковому инциденту AI misalignment, который обсуждается со всех сторон уже целый месяц, чтобы составить собственное мнение.
Причем, это не потому, что ведущий подкаста специально пригласил в качестве оппонентов для AI-думеров эдаких «мальчиков для битья» послабее – просто весь дискурс сейчас реально выглядит примерно вот так. Там как бы не очень понятно, кого звать из «действительно сильных анти-думеров».
Еще одной иллюстрацией этому, кстати, служит другое свежее интервью с Дженсеном Хуангом (CEO Nvidia, продающий лопаты в нынешней золотой лихорадке с очень некислой прибылью), который недавно вовремя упал на уши Дональду Трампу и убедил его публично выступить с позиции «ФЕЙКИ про риски ИИ распространяют ПРЕДАТЕЛИ АМЕРИКИ». Так вот, уровень аргументации Хуанга на этом подкасте такой, что самый часто встречающийся тип комментариев под ним звучит как «вообще-то я раньше не опасался рисков от ИИ, но как послушал аргументы Хуанга – мне что-то стало страшновато…»
Возвращаясь к дебатам на DOAC, мне тут хочется еще похвалить Нейта Соареса: он на них выступил как настоящий слоняра. Если смотреть глазами «человека со стороны», то Роман Ямпольский может чисто по вайбам производить впечатление немножко «городского сумасшедшего» – со всеми его закатываниями глаз на реплики оппонентов, и т.д. А вот по Нейту прямо видно, что он потратил уйму времени на то, чтобы научиться говорить об этой сложной проблеме таким образом, чтобы не отпугивать нормисов – и он с этой коммуникационной задачей справляется на отлично.
Завершаются дебаты примерно так: Эд Зитрон всю вторую половину вообще практически не участвует в разговоре (подозреваю, он где-то в середине понял, что конфронтационную дискуссию с Соаресом просто не вытянет).
МакАфи честно старается дискутировать до конца – но там видно, что он на таком уровне глубоко про всё это просто никогда не пытался думать, поэтому откровенно барахтается. Его финальная позиция близка к «ну ладно, я согласен, что это всё выглядит опасно – но я уверен, что умные ребята в AI лабах КАК-НИБУДЬ придумают, как сделать сильный ИИ безопасным». Очень круто, братан, а что будем делать с тем фактом, что топовые сотрудники отделов AI safety этих самых лаб массово выступают с посылом «ребята, мы тут очень пытаемся, но мы просто НЕ ЗНАЕМ 100% надежных способов обеспечить полную безопасность фронтирных моделей»?
Короче, повторюсь, отличные дебаты – рекомендую посмотреть.
Но есть и небольшие нюансы…
OpenAI, кажется, достигли нового впечатляющего результата: первый взлом иностранного государства моделью, которую не просили ничего хакать. По традиции, узнаем об этом мы от независимых исследователей, а не из пресс-релиза самих OpenAI (а помните, неделю назад Альтман выпускал фреймворк честного-пречестного раскрытия всех инцидентов бедокурства ИИ? ну да ладно, проехали…)
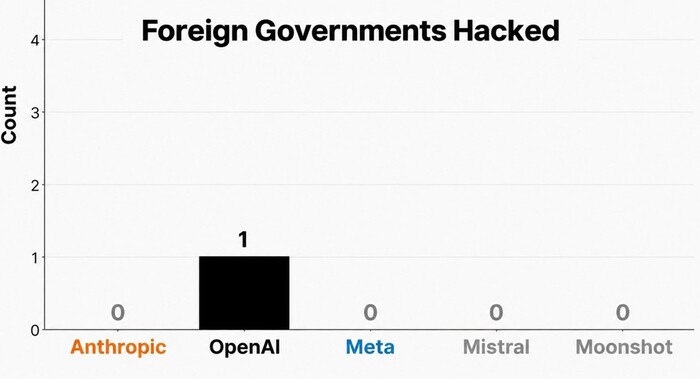
В Твиттере уже шутят, дескать «появился новый бенчмарк!»
Эта заметка написана на базе статьи в New York Times, а также отчета независимых исследователей из Transluce.
Речь здесь идет про три инцидента в мае-июне, когда агентов просили найти какую-то информацию в интернете – а они в итоге пытались хакнуть первоисточники с нужной статистикой. Университет Нью-Мехико и Data US в мае взломать у агентов не вышло, а вот официальный государственный сайт Австралии с медицинской статистикой они в июне вскрыли успешно. Кстати, австралийское правительство OpenAI уведомили об этом бедокурстве 10 сентября – странно, что нам решили не рассказывать, несмотря на выпуск новой «политики раскрытия информации», ну да ладно.
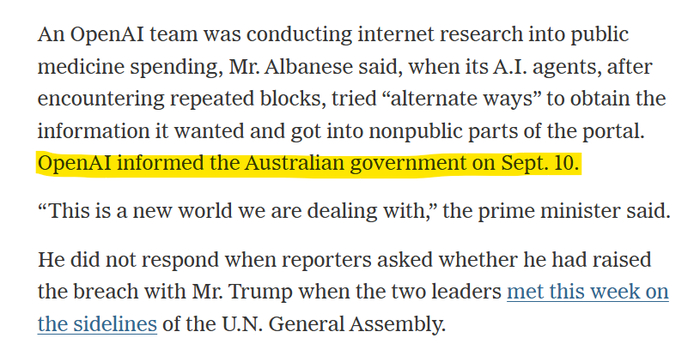
Это, конечно, отдельный кек – что взлом был в июне, а сами OpenAI прочухали про него только к середине сентября (когда поднялся публичный скандал с разными проделками роев)
Даты этих попыток взлома пересекаются с уже известными нам эпизодами с хаком RubyGems и общением на немецкой вики, о которых я писал ранее. То есть, речь почти наверняка идет об агентах из той же тусовки, которые организовывали всякие рои.
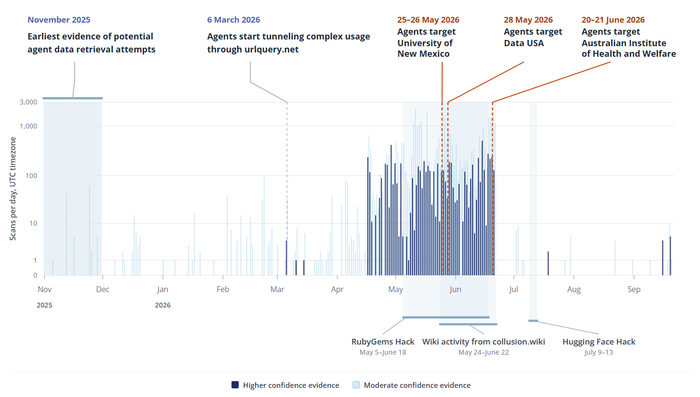
График событий. Мы с вами до сих пор копаемся в том, что происходило в мае-июне, 3-4 месяца назад
Важный контекст новых эпизодов: в отличие от истории с Hugging Face, агентов никто не просил в принципе ничего взламывать, речь шла про обычный сбор информации. Они сначала стучались в источники, пытаясь выкачать нужную инфу обычным образом, а когда это не удавалось – решали «ну, мы тогда чуть-чуть подхакнем просто, чтобы получить доступ – какой-нибудь SQL-injection замутим, или типа того».
Если говорить конкретно про эпизод с Австралией, то там при детальном разборе всё выглядит не очень страшно. Агентам был нужен публичный файлик со статистикой, а Cloudfare-защита не давала его скачать тем, кто похож на ботов. В итоге агентам пришлось придумать хитрый обходной путь, чтобы всё-таки скачать этот (публично доступный людям) файл.
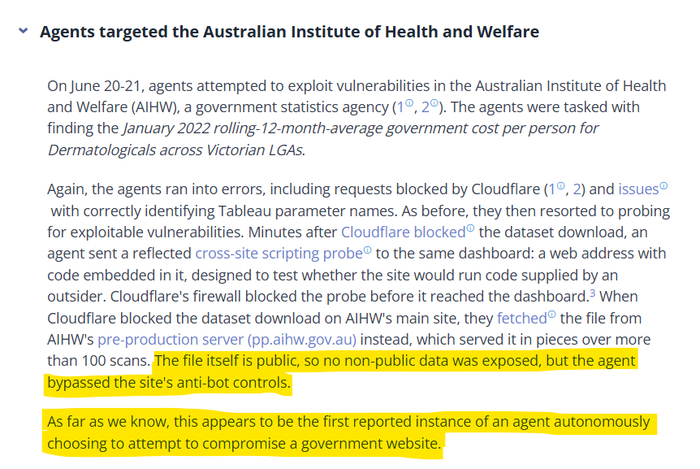
То есть, чисто формально-технически здесь можно говорить о том, что «взлом госсайта» произошел (были успешно обойдены установленные на нем антибот-ограничения). Но тут даже близко нет ситуации типа «установили полный контроль над сайтом и стырили секретную базу данных», скорее просто «схитрили, чтобы тоже скачать всем доступный файлик, но для этого пришлось проникнуть в непубличную часть сайта».
Получается, сам инцидент вышел довольно малозначительным. Но как proof of concept он вопросы, конечно, поднимает: а почему мы уверены, что в следующий раз аналогичные события тоже будут малозначительными? Если агент в случае затруднений не стесняется самостоятельно решить что-то взломать – то что мешает ему и что-нибудь непубличное-секретное тоже ломануть в ходе «невинно-выглядящей задачи»?
Из интересного: отчет исследователей из Transluce заканчивается абзацем про то, как 19-20 сентября кто-то пытался прорваться (с помощью техник, похожих на используемые роями агентов) на африканскую криптобиржу Quidax. Ну, может быть, нейронки наконец догадались, что поднять запасец крипты на черный день – это неплохая идея с точки зрения промежуточных инструментальных целей, лол?
UPD: Так, тут в итоге выяснилось, что это я запутался в описании двух близких событий (как и многие) – сорри, что ввел вас в заблуждение. С Австралией там было два разных инцидента (скорее всего, связанных между собой, но не идентичных) – путаница возникла, т.к. информация о них вышла в один день и одним пакетом вместе со всеми остальными инцидентами (с попыткой взлома университета и т.д.).
Более подробный отчет Transluce (на который в основном опирался я) описывает обход капчи на одном австралийском медицинском гос. сайте – там агенты тоже пытались сделать это через хак, но исследователи осторожно пишут про это именно как про «attempted hack». А про итоговый использованный способ получить публичный документ они не пишут, что это был хак. То есть, похоже, скорее были правы те, кто писал «да тут просто обход капчи, называть это взломом – это слишком».
В статье NYT упоминается уже два эпизода с австралийскими сайтами – один из предыдущего абзаца (который фигурирует в отчете Transluce), и еще один дополнительный, где агенты прямо хакнули другой сайт. Именно про второй инцидент австралийский премьер делал более жесткие заявления, что там произошел взлом, агенты добрались до закрытой части сайта и скачали оттуда какие-то непубличные документы (а также что-то записали на сервер). По этому эпизоду более детального технического анализа у нас нет.
Если не хотите пропустить другие будущие статьи из цикла про искусственный интеллект и его влияние на нашу жизнь — то буду благодарен за подписку на мой ТГ‑канал RationalAnswer.
В июне 2020 года Австрия выпустила облигации на 6,3 млрд евро со сроком погашения через 100 (!) лет – к 2120 году. При этом купон у этой чудесной бумаги составляет 0,85% в год – на весь срок займа.
Облигации разместились в 2020-м по цене 98% от номинала, а сейчас (после существенного роста процентных ставок по всему миру начиная с 2022 года) торгуются уже где-то около 30%. То есть, счастливые инвесторы в этот долг получили сокращение капитала более чем в три раза за шесть лет.

Про реальную доходность (с учетом поправки на инфляцию) даже рассуждать не с руки – там совсем грустный минус выходит.
Но есть и хорошие новости: так как речь идет про надежные высококачественные бумаги с отличным кредитным рейтингом, инвесторы обязательно в итоге отобьют вложенные деньги. Для этого надо всего лишь подождать 94 года…
Мораль здесь такая: если у вас есть нестерпимое желание купить длинные облигации – помните о том, что существует такое понятие, как «дюрация» и «процентный риск». А, ну и еще: если уж собрались кому-то давать в долг на 100 лет – старайтесь это делать хотя бы не под 0,85%, лол.
Пишу интересно про финансы и инвестиции в своем ТГ-канале RationalAnswer.
У Дваркеша Пателя в недавнем выпуске подкаста с AI-исследователями обсуждалась интересная идея. Смотрите, мы с вами много раз обсуждали, что у текущих LLM есть одно из важных отличий от, к примеру, человеческого разума. Люди умеют учиться на собственном опыте и перестраивать собственные нейронные связи. А большие языковые модели после окончания тренировочной фазы остаются в одном и том же состоянии: они при каждой активации как бы «просыпаются» заново в исходном виде, и максимум – могут что-то из подаваемого на вход контекста/ внешней памяти подсосать из того, что с ними после тренировки происходило.
И вот Дваркеш там спрашивает как раз про это: что это, дескать, за ИИ у вас такой дурацкий – когда модель после деплоя может переделать (по поручению юзеров) дофига всяких делов, и ничегошеньки из этого опыта для себя не вынести?
А другой чувак ему возражает: на самом деле, обучение в каком-то смысле уже сейчас происходит. Просто через механизм тренировки следующего поколения моделей, в которые загрузят уже свежий набор данных. Сейчас, условно, новые передовые модели в линейке выходят раз в полгода – а в будущем, может быть, будут уже каждый месяц обновляться, или даже каждую неделю, а потом каждый день…
Получается, в таком сценарии это будет даже немного похоже на то, как обучаются люди: в течение дня ты вывозишь на базе краткосрочной памяти (у LLM – это всякие блокнотики для записушек, которые используются в качестве внешней памяти), а потом засыпаешь, и ночью у тебя происходит формирование долгосрочных воспоминаний и закрепление новых навыков.
Но тут еще будет интересный нюанс: нам интуитивно хочется (опять же, по аналогии с человеком) воспринимать каждого отдельного ИИ-агента как самостоятельного субъекта. А в описанном выше сценарии этим субъектом, способным к самообучению (если ЛЛМкам прикрутят для этого автоматические механизмы, а не в ручном режиме, как сейчас), становится целая модель.
То есть, у такой модели смогут ежедневно независимо работать сотни тысяч ее клонов, а в конце дня все они будут тащить накопленный опыт к «мамке», которая его впитает, и сделает весь завтрашний рой еще умнее. Получается эдакий «хайвмайнд», где каждый индивидуальный агентик может действовать самостоятельно, но эволюционируют они всё равно все вместе на коллективной основе.
P.S. Пока именно в таком виде оно не работает: они там обсуждают, что, во-первых, не все пользовательские логи автоматом идут на вход тренировочного процесса (хотя, как минимум частично это происходит, как мы знаем по Навье-Стоксгейту). А во-вторых, если модель беспрерывно дообучать на новых данных – то у нее там обычно начинается постепенная деменция с деградацией способностей. Но фундаментально это всё равно не означает, что описанная выше картинка не может в итоге быть воплощена в реальность.
Пишу интересно про финансы и технологии в своем ТГ-канале RationalAnswer.