Вы когда-нибудь сталкивались с такой раздражающей ситуацией: наконец находите важный PDF-отчёт или научную статью, но обнаруживаете, что файл «защищён» — курсор превращается в значок запрета, меню по правой кнопке мыши недоступно, и вы не можете скопировать даже несколько слов.
Ощущение «так близко, но недоступно» действительно может раздражать. Хорошая новость заключается в том, что защита PDF не всегда так надёжна, как кажется. В этой статье мы рассмотрим пять практических способов — от быстрых решений до более продвинутых методов — а также разберём несколько технических нюансов, о которых вы могли не знать.
Способ 1: Google Docs — интеллектуальное извлечение через преобразование
Способ 2: онлайн-конвертер PDF24 — просто, но не забывайте о конфиденциальности
Способ 3: «Печать в PDF» через браузер — создание новой чистой копии
Способ 4: скриншот + OCR — работает даже с полностью заблокированными PDF
Способ 5: автоматизация с Python — пакетная обработка и интеграция в рабочие процессы
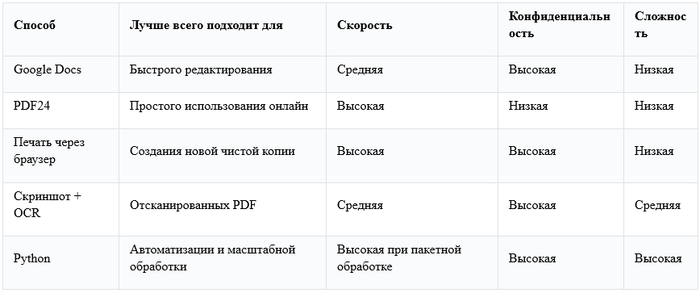
Сравнение способов
Заключение
Способ 1: Google Docs — интеллектуальное извлечение через преобразование
Этот способ может показаться обходным решением, но его принцип довольно интересен: когда Google Docs открывает PDF, сервис пытается заново восстановить структуру документа — и в процессе часто игнорирует исходные ограничения на копирование.
Откройте Google Drive и войдите в аккаунт
Загрузите защищённый PDF-файл
Щёлкните файл правой кнопкой мыши и выберите Открыть с помощью → Google Docs
Дождитесь завершения преобразования, затем скопируйте нужный текст
Почему это работает:
Большинство ограничений PDF представляют собой всего лишь флаги разрешений, а не настоящее шифрование. Когда Google Docs преобразует файл, он создаёт совершенно новую структуру документа, поэтому исходные ограничения обычно не переносятся.
Ограничение:
Этот способ работает хуже, если PDF представляет собой отсканированное изображение, а не документ с настоящим текстовым слоем.
Способ 2: онлайн-конвертер PDF24 — просто, но не забывайте о конфиденциальности
Онлайн-инструменты, такие как PDF24, позволяют быстро извлечь текст без установки дополнительного программного обеспечения.
Откройте инструмент PDF24 PDF to TXT
Загрузите защищённый PDF-файл
Запустите преобразование и дождитесь завершения обработки
Скачайте TXT-файл и свободно копируйте текст
Важный момент — конфиденциальность:
Ваши файлы обрабатываются на сторонних серверах. Если документ содержит договоры, внутренние отчёты или конфиденциальные персональные данные, стоит дважды подумать перед загрузкой.
Совет:
Сначала протестируйте сервис на файле без конфиденциальной информации и ознакомьтесь с политикой конфиденциальности сайта, прежде чем использовать его для важных документов.
Способ 3: «Печать в PDF» через браузер — создание новой чистой копии
Если PDF разрешает печать, даже когда копирование заблокировано, можно фактически «сбросить» ограничения, распечатав документ в новый PDF-файл.
Откройте защищённый PDF в браузере, например Chrome или Edge
Нажмите Ctrl + P
Выберите Save as PDF в качестве принтера
Сохраните новый файл
Откройте новый PDF и попробуйте скопировать текст
Почему это работает:
При печати создаётся новый PDF-файл, который обычно не наследует исходные ограничения доступа.
Когда этот способ работает лучше всего:
PDF запрещает копирование, но разрешает печать
Документ содержит настоящий текстовый слой, а не только отсканированные изображения
Ограничение:
Если печать также запрещена, этот способ не сработает.
Способ 4: скриншот + OCR — работает даже с полностью заблокированными PDF
Современные операционные системы и приложения всё чаще включают встроенную поддержку OCR — оптического распознавания символов. Благодаря этому извлекать текст со скриншотов стало гораздо проще.
Сделайте скриншот нужной части PDF
Используйте инструмент с поддержкой OCR, например Windows Snipping Tool, Live Text в macOS или мобильное приложение
Выделите распознанный текст и скопируйте его
Почему этот способ полезен:
Работает даже со сканированными PDF
Не зависит от ограничений на копирование
Не требует загрузки файлов в интернет
Точность зависит от качества изображения
Форматирование, включая таблицы и макет страницы, может быть потеряно
Лучшие сценарии использования:
Отсканированные документы
Небольшие фрагменты текста
Ситуации, когда остальные методы не помогают
Способ 5: автоматизация с Python — пакетная обработка и интеграция в рабочие процессы
Для масштабных задач, связанных с десятками или сотнями PDF-файлов, автоматизация намного эффективнее ручного извлечения текста.
Используя Python и библиотеки для работы с PDF, можно систематически извлекать текст и интегрировать этот процесс в существующие конвейеры обработки данных.
from spire.pdf import *
doc = PdfDocument()
doc.LoadFromFile("Secured.pdf")
for i in range(doc.Pages.Count):
page = doc.Pages[i]
extractor = PdfTextExtractor(page)
options = PdfTextExtractOptions()
options.IsExtractAllText = True
text = extractor.ExtractText(options)
with open(f"output/page-{i+1}.txt", "w", encoding="utf-8") as f:
f.write(text)
doc.Close()
Преимущества этого подхода:
Автоматизирует обработку большого количества файлов
Может быть встроен в рабочие процессы, например конвейеры обработки данных и ETL-системы
Позволяет извлекать даже «некопируемый» текст с помощью IsExtractAllText = True
Главное преимущество:
Речь идёт уже не просто о копировании текста, а о создании повторяемой системы обработки документов.
Примечание:
Бесплатная версия Spire.PDF for Python поддерживает обработку документов объёмом до 10 страниц. Для более крупных файлов может потребоваться разделить документ на части или использовать другие решения.
Сравнение способов
Заключение
Каждый способ подходит для своего сценария:
Быстро и бесплатно: Google Docs
Быстро и удобно: онлайн-инструменты, если вас устраивают компромиссы в отношении конфиденциальности
Простой обходной вариант: печать в новый PDF
Универсальный резервный способ: OCR по скриншотам
Масштабируемое решение: автоматизация с Python
И ещё один важный момент: технологии могут решить вопрос о том, можете ли вы скопировать текст, но они не отвечают на вопрос, следует ли это делать. При работе с защищёнными документами всегда соблюдайте авторские права и условия использования.