
Claude Opus 5.5: уровень Fable 5.1, но на 40% дешевле
Anthropic выпустила Opus 5.5 через два месяца после Opus 5. Модель среднего флагманского уровня догнала старшую Fable 5.1 на большинстве задач, а на ряде тестов обошла её. При этом токены подешевели на 20%, генерация ускорилась на 30%, а сама модель обещает наконец писать по-человечески.
Цены
За 1 млн токенов: вход 4 доллара вместо 5, выход 20 вместо 25, чтение кэша 0,20 вместо 0,50. Вместе с экономией токенов на типичных задачах выходит на 40% дешевле, чем Opus 5. Подписчикам подняли лимиты на 20%. Модель уже доступна в API как claude-opus-5-5, а также в AWS, Google Cloud и Azure.
Бенчмарки (Opus 5.5 / Fable 5.1 / Opus 5 / GPT-6 Astra)
Terminal-Bench 4.0: 66,4% / 55,8% / 52,3% / 57,9%
FrontierCode 1.1: 54,4% / 50,3% / 48,0% / 53,3%
CursorBench 4.0: 57,8% / 51,8% / 46,6% / —
GDPval-AA 2.1: 1846 / 1735 / 1708 / 1542
AutomationBench: 40,0% / 31,4% / 26,9% / 41,4%
Humanity's Last Exam: 67,7% / 65,6% / 63,6% / 57,2%
Terminal-Bench-Science: 58,7% / 52,6% / 29,0% / 64,6%
OSWorld 2.0: 81,8% / 80,7% / 74,0% / —
Fable 5.1 проигрывает по всем строкам. Реальные кейсы тестеров тоже впечатляют: миграция 680 тысяч строк заняла меньше суток, аудит 200 тысяч строк прошёл меньше чем за 3 часа против 20 с лишним у Opus 5, а перенос HAProxy с C на Rust занял 9,5 часа против 12 у Fable 5.1 и обошёлся на 51% дешевле.
Догнал ли Astra
По большей части да, хотя победа не безоговорочная. Opus 5.5 обходит флагман OpenAI в терминальных задачах, в экспертной офисной работе GDPval и в Humanity's Last Exam. В FrontierCode, по данным Anthropic, он опережает Astra при стоимости задачи около 20% от её цены. Проигрывает в автоматизации бизнес-процессов (40,0 против 41,4) и в научных терминальных задачах (58,7 против 64,6). Все цифры замерила сама Anthropic.
Прощай, «клодовский»
В сообществе давно смеются над фирменным стилем Claude: шаблонные, запутанные фразы и жаргон. Энтузиасты даже сделали шуточный переводчик с английского на «клодовский».
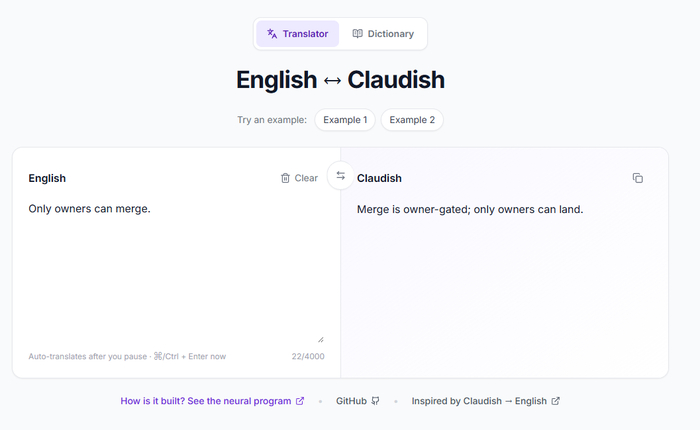
Anthropic признала проблему. По словам компании, Opus 5.5 выносит главное в начало, реже использует жаргон и точнее следует инструкциям по стилю. Ранние тестеры отмечают, что ответы стали понятнее.
А где AGI
Результата ARC-AGI для Opus 5.5 пока нет. Для ориентира: Opus 5 в июле поставил рекорд ARC-AGI-3 с результатом 30,2%, тогда как прежний лидер GPT-5.6 Sol набирал 7,8%. Anthropic называет Opus 5.5 «первой моделью с тех пор, как мы призвали сдерживать темп фронтира». Поэтому у модели защита уровня Fable 5.1: запросы по кибербезопасности, биологии и разработке фронтирных LLM перенаправляются на старые модели, а выход помечается водяными знаками под EU AI Act.
Что ждать от новой Fable
Официально объявлено только, что Sonnet 5.5 и Haiku 5.5 выйдут «в ближайшие недели». Про Fable Anthropic молчит, но, по данным TestingCatalog, следующую Fable уже A/B-тестировали в Claude Code. Инсайдеры называют её Fable 5.2. Раз Opus догнал старшую модель при заметно меньшей цене, Fable придётся заметно уйти вперёд, иначе её цену нечем оправдать.
Источники: The Decoder, TechCrunch, 9to5Mac