Внимание: не забудьте проголосовать за следующую песню рубрики "10 Каверов" в конце поста!!!
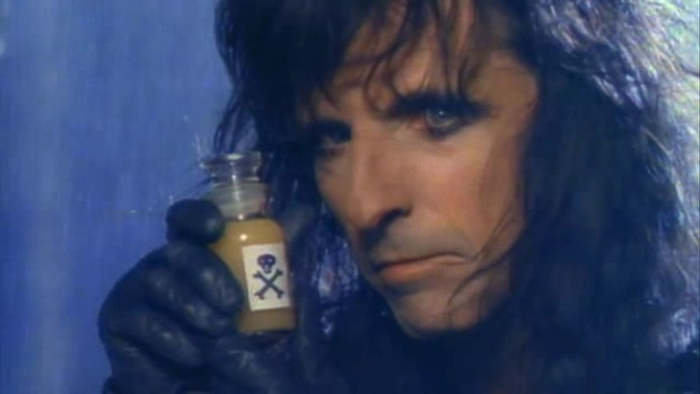
А в предыдущем голосовании с небольшим отрывом победила песня 'Poison' от короля шок-рока Элиса Купера
Песня 'Poison', выпущенная в 1989— один из главных хитов американского рок-музыканта и автора Элиса Купера. Текст песни строится вокруг образа притягательной, но разрушительной силы: лирический герой осознаёт опасность, но не может устоять перед соблазном, что отлично ложится на бунтарский имидж самого Купера.
В США 'Poison' поднялась до 7‑го места в чарте Billboard Hot 100, а в Великобритании добралась до 2‑й строчки — это был серьёзный коммерческий прорыв для артиста, чья популярность к концу 80‑х заметно снизилась.
Видеоклип на песню запомнился провокационной эстетикой и театральностью — в духе фирменного «шок‑рока» Купера, где хоррор и поп‑культура намеренно смешиваются. Так же клип стал первым у Элиса Купера, получившим активную ротацию на MTV, и заново познакомил с ним молодую аудиторию.
Сегодня 'Poison' остаётся визитной карточкой позднего периода Купера и примером удачного синтеза тяжёлого звука и поп‑хитовости — песня до сих пор звучит на концертах и входит в подборки лучших рок‑синглов 80‑х. Влияние песни прослеживается в десятках отсылок в массовой культуре: трек регулярно используют в фильмах, сериалах и рекламе, а его ритм мгновенно узнаётся даже вне рок‑сообщества.
По традиции, перед каверами обновим в памяти оригинал...
Не смотря на сравнительно небольшое количество каверов на 'Poison', жанры каверов достаточно разнообразны - и "тяжеленные" блэк-металловые версии, и танцевальные варианты и лаунджевые романтические каверы. Я, как обычно постарался выбрать вашему вниманию наиболее разнообразную десятку. Надеюсь, получилось....
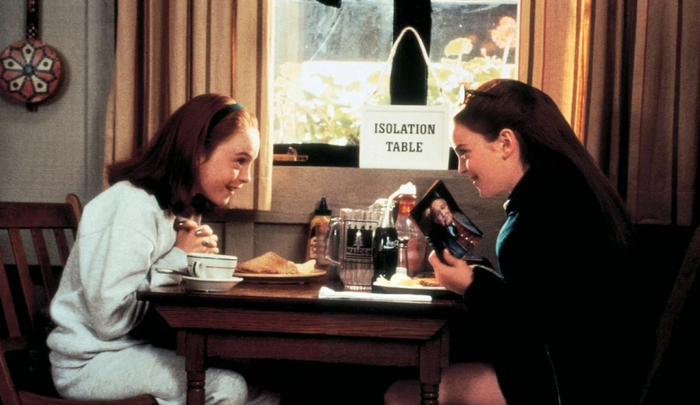
Фильм старый, смутно помню его из детства, и он часто встречается в подборках: как осеннего ностальгического кино, так и кино про сводные семьи.
Сюжет в разрезе темы повторных браков и детей — настоящий абсурд (хотя жизнь и не такое иногда выкидывает). Пара рожает двойняшек, ссорится из-за фигни, с треском разводится, делит девочек-грудничков между собой и дальше в течение 11 лет не общается вовсе. Дети не знают о существовании друг друга, но случайно встречаются в лагере, меняются местами и замышляют воссоединить отца и мать.
А чтобы сюжет не был уж очень пресным, сценаристы добавляют отцу молодую невесту, которая в лучших традициях любит только его деньги и ведет себя за его спиной как мегера. Мачехи в комедиях из 90-х почти всегда такие: худые, красивые, блондинистые и невероятно злые (ну прям как я, хах).
Естественно, что девочки хотят сжить мачеху со свету и помешать свадьбе отца с ней, поэтому обращаются с ней отвратительно, строят козни и устраивают приколы: то камней в рюкзак накидают, чтобы ей в походе по горам было «веселее», то ящерицу в волосы подкинут, то отправят спящую в плавание по озеру на надувном матрасе из палатки. Примеряю такую «месть» на себя и понимаю, что никогда бы не смогла такое вынести, как бы ни любила отца таких детей. А ведь в жизни такая конфронтация сплошь и рядом — недавно услышала историю о том, как дети смыли бриллианты мачехи в унитаз.
Понятное дело, что по закону жанра отец прозревает, что всё это время любил мать, семья воссоединяется, мачеха самоликвидируется (крича «или я, или они!», и батя выбирает детей), и наступает хеппи-энд.
Но случись нечто подобное в реальной жизни, это была бы настоящая драма. Особенно, если бы мачеха была нормальной, отец уже успел ее полюбить и не планировал бы возвращаться к матери, но дети каким-то образом познакомились и уже не хотят жить отдельно друг от друга. Но такого кинематограф нам еще не предложил, поэтому — смотрим и ностальгируем. И чуть-чуть жалеем мачеху, какой бы стервой она там ни была :)
Приложение интересное. Из плюсов: нет необходимости делать какие-то мэтчи, переписываться с кем-то, сталкиваться с игнором в переписке, придумывать первое сообщение, листать длинные анкеты — всего вот этого. Нет. Интерфейс приложения предельно простой: тебе показывают фотки всяких красивых девочек и мальчиков, и ты можешь выбрать любого из них, выбрать определённое время, дату, конкретное место, куда вы идёте.
Плюс в том, что приложение даёт возможность искать не только любовь всей жизни противоположного пола, но и человека своего пола для дружбы, каких-то деловых отношений — в общем, по настроению. Возможностей много, в отличие от других приложений.
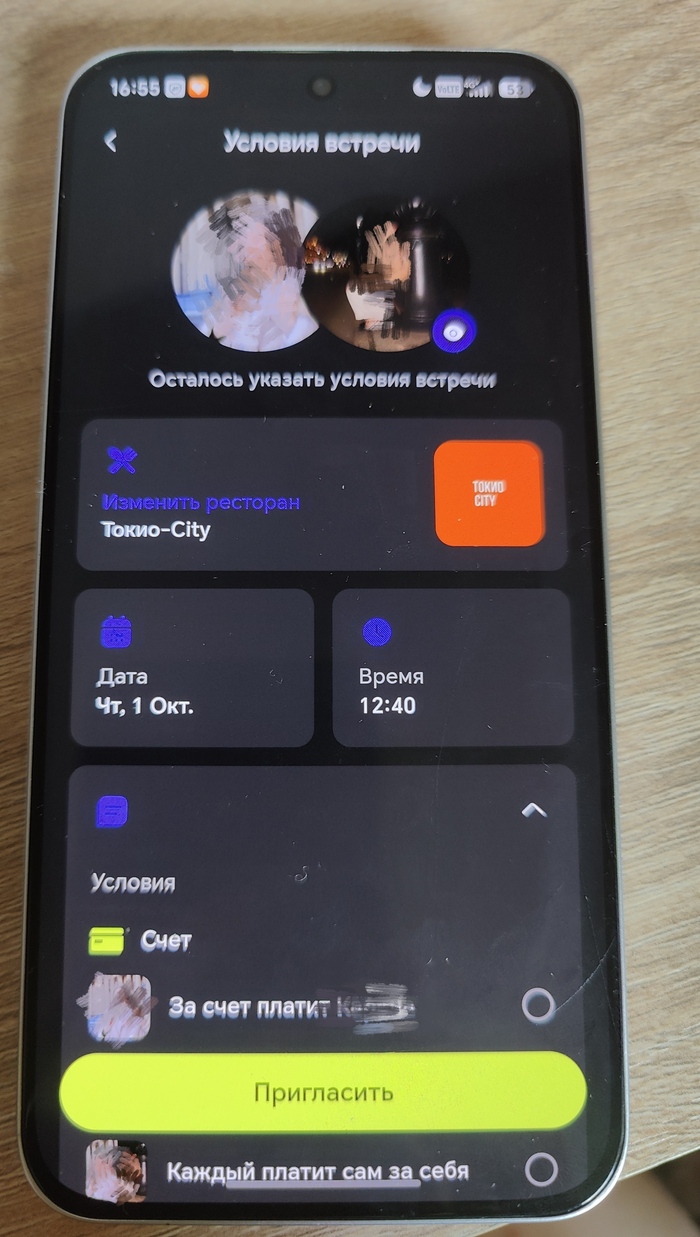
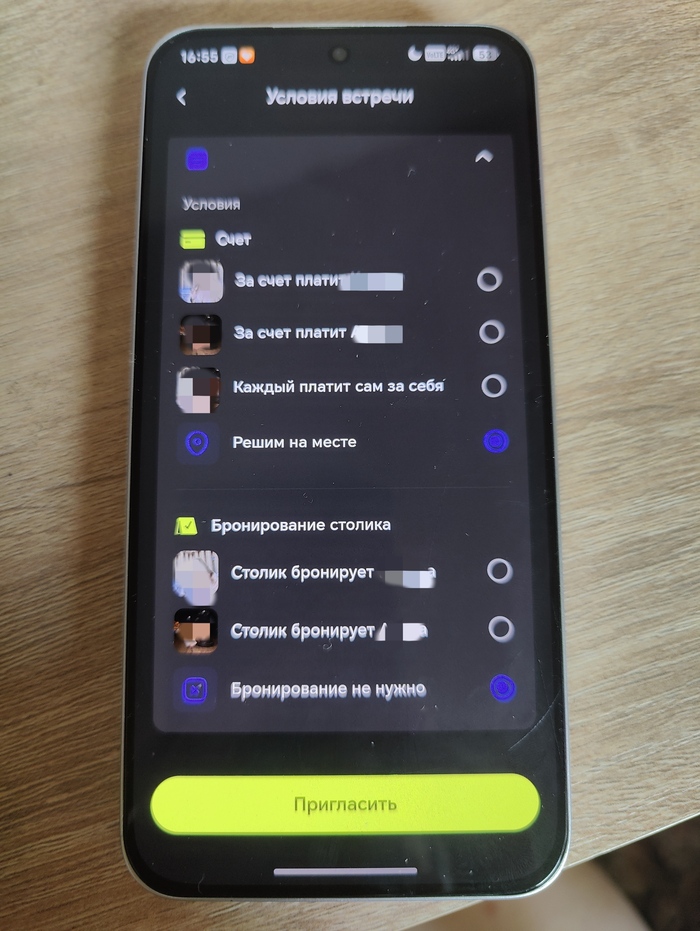
Есть возможность указать, кто платит. Это тоже важно. Можно, чтобы каждый сам за себя платил, можно ты платишь за двоих, можно второй участник — всё без привязки к полу. А можно написать, что решите на месте. Опций много — было бы желание.
Вот фото шаблона приглашения в ресторан. Приложение не даёт возможность сделать скриншот, поэтому фоткала на второй телефон.
1/2
Ещё из плюсов: есть видео-верификация. То есть все профили, которые там есть, по идее верифицированы по видео, и фейков самый минимум. Так что те, кому надоело общаться с мошенницами-проститутками, можете зарегистрироваться — по крайней мере, вы будете вживую видеть реальных людей, которые соответствуют фото и которые доходят на свидание, а не пытаются виртуально разводить вас на оплату какого-то кинотеатра.
Теперь о минусах. Нужно каждый раз выбирать заведение, а не просто выставить свои любимые, чтобы программа автоматически подставляла. Нужно каждый раз выбирать время, а не просто автоматически выставить, когда у тебя свободные слоты, и чтобы программа сама на них ставила.
И минус ещё: если ты кого-то приглашаешь, программа автоматически бронирует это время под этого человека, даже пока он приглашение не принял. И ты на это время уже никого другого позвать не можешь. Что не очень удобно, потому что, грубо говоря, 9 из 10 девушек тебе отказывают. И соответственно, у тебя в принципе не так много свободного времени, а назначать свидание можно не чаще, чем раз в три часа. То есть условно, если ты в субботу на 12 утра позвал, то ты с 9 до 12 и с 12 до 3 уже никого звать не можешь. Вот такая вот интересная штука.
Я уже сходила на одно свидание дружескую встречу с девушкой. Если вам интересно, то напишу обзор как это было...
Или могу про новостей ТвинБи написать. Чего интереснее?
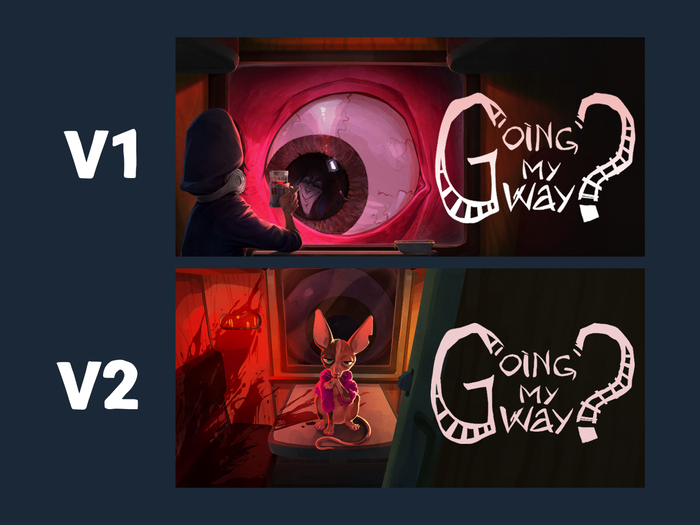
Коротко об игре: — Психологический хоррор с элементами социальной дедукции; — Работай проводником, рассаживай пассажиров, угощай их вкусным чаем и слушай их истории; — Выбирай, кто станет следующей жертвой поезда; — Попытайся понять, кто из них человек, а кто Скиталец.
В современном мире нейронки очень помогают в решении различных ситуаций во всех областях. Часто обращаюсь, чтобы грамотно составить запросы или уведомления со ссылками на кодексы, ГОСТы, СНиПы и тд. Реально очень выручает. Перед составление любого письма стараюсь максимально подробно описать сложившуюся ситуацию и ставлю конкретные вопросы. Часто в запросах много цифр и дат. И перечитывая один из его ответов увидел, что он просто в одном месте перепутал последовательность дат. Но опираясь на ошибочные данные, все равно подогнал ответ под мои требования)))) как только указал ему на ошибку, он сразу все исправил и стала прослеживаться логика в тексте
Цифровой интеллект тоже ошибается...пока ошибается))
Скоро выборы, разные телеграмм каналы уже активизировалась, и то тут, то там всплывает доказательства фальсификации выборов по Шпилькину... И этот метод прекрасная иллюстрация того, что бывает, когда люди не понимают статистику и не умеют в неё. Дисклеймер: моя критика метода не означает ничего, кроме критики метода
Метода Шпилькина (и его продолжателей) заключается в том, чтобы построить распределение числа избирательный участков от явки на них /доли голосов отданных за того или иного кандидата и пристально на этот график посмотреть. Далее проверяется верность следующих утверждений: 1) Форма кривой распределения должна быть близка к нормальной и формы кривых полученных для разных кандидатов должны совпадать; 2) Кривая должна быть гладка, без каких-то пиков в особых местах; 3) Должна отсутствовать корреляция между долей голосов отданных за кандидате/партию и явкой на участках. Всё выглядит разумно и даже банально, так в чём проблема?
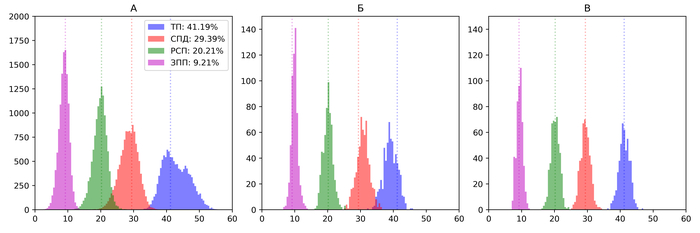
Часть 1. Нормальность распределения А давайте сразу перейдём к делу и промоделируем эти самые кривые, которые строит Шпилькин могут выглядеть. Представим себе, что у нас есть страна, Примерия. В этой стране проходит избирательная компания, в которой за места в парламенте бьются четыре партии: Трушная Примерия (ТП - партия власти), Революционный Союз Примерии (РСП - крупнейшая оппозиционная партия), Союз Победы и Демократии (СПиД - популисты-недооппозиция) и Замечательная Прекрасная Примерия (ЗПП - маргинальные оппозиционеры). Кроме этого, Примерия делится на три региона, которые отличаются друг от друга по социально-экономическим, культурным, этническим и другим характеристиками: - Праверия, богатый регион с к крупными промышленными городами, 3000 избирательных участков по 1600 человек в среднем, ТП: 41% РСП: 29% СПиД: 21% ЗПП: 9% - Леверия, не очень богатый регион, с крупными и средними городами, 3000 избирательных участков по 1600 человек в среднем, ТП: 39% РСП: 31% СПиД: 20% ЗПП: 10% - Глухиния, удалённый от городов аграрный регион с консервативным сельским населением, 6000 избирательных участков по 400 человек в среднем, П: 46% РСП: 27% СПиД: 19% ЗПП: 8% Для каждого избирательного участка я смоделировал его размер, явку (в первой модели - 100%) и голос каждого человека пришедшего или не пришедшего на выборы. Далее, помня, что "главное, не кто как голосует, а кто как считает", я тремя разными способами обсчитал распределение голосов отданных за ту или иную партию избирателями. Результаты манипуляций с голосами показаны ниже, на Графике 1.
График 1. Распределение "участков" по уровню поддержки партии. Пунктирная линия отражает "итоги выборов".
При рисовании одного из графиков я сфальсифицировал результаты. На каком?
Правильный ответ фальсификация на графике Б На Графике 1А построены результаты голосования по методу Шпилькина. Мы получаем стрёмные графики, но не из-за того, что я "вбрасывал голоса", а из-за того, что у нас есть три региона с разными электоральным предпочтения. Каждая кривулина - это сумма трёх почти-нормальных распределений, но для партии ТП разница между регионами достаточно велика, что приводит к заметной аномалии в форме кривулины. Кроме этого вклад региона Глухиния на таком графике выглядит в несколько раз значимее, чем он есть на самом деле, так как численность избирателей на каждом участке в Глухинии в несколько раз меньше, чем в других регионах,а число участков - такое же. На Графике 1Б показаны экзит-поллы. Результаты опросов построены по методу Шпилькина, но агентство, которое этим занималось послало 540 репортёров на участки в Леверии, 60 на участки в Праверии и ни одного в Глухинию (ехать в эту глушь стрёмно). Как следствие, результаты заметно отличаются от итогов голосования, зато кривулины похожи на нормальное распределение. На Графике 1В показаны результаты опросов: 500 независимых агентств независимо опросило 1000 совершенно случайных людей, результаты для каждого отдельного опроса нанесли на график. Так как опросы проведены методологически правильно, то мы получили распределение близкое к нормальному и не отличающееся от результатов выборов. Вывод 1: сложная форма кривой говорит только о том, что данные имеют сложную структуру. Чем эта сложность обусловлена - фальсификацией выборов или сложной и неоднородной структурой общества - не известно. Сложная кривая может быть получена по итогам честных выборов, а красивое нормальное распределение - следствием манипуляции с результатами. При анализе методом Шпилькина нарушается один из базовых принципов статистического анализа: при формировании подвыборок, каждая группа должна быть представлена пропорционально числу элементов в группе, а не числу групп. Как следствие, распределение может принимать какую угодно форму.
Часть 2. Корреляция явки-голоса Но это была модель без учёта явки, но учитывать просто так явку не интересно, так как это приведёт к уменьшению числа людей и не повлияет на распределение голосов. Поэтому... Представим себе, что власть пропагандирует необходимость участия в выборах, из каждого провластного утюга рассказывается о необходимости прийти на выборы, что это важно, что это определить будущее Примерии и даже используется админ.ресурс, чтобы заставить людей на выборы прийти и проголосовать. В тоже время сторонники оппозиционных партий рассказывают, что выборы сфальсифицированы, что результаты голосования будут нарисованы какие надо, а некоторые призывают в знак протеста приходить и портить бюллетени. Я не знаю, повлияет ли пропаганда на явку избирателей разных политических взглядов, поэтому промоделировал и вариант когда пропаганда влияет и когда не влияет, и заполировал сверху это всё разными способами фальсификации.
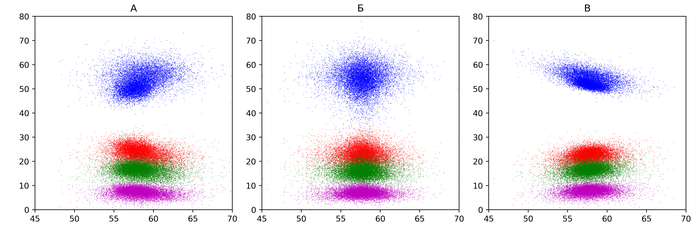
График 2. Распределение доли голосов отданных за ту или иную партию на участке (ось Y) по явке (ось Х)
На каком из этих графиков нет фальсификаций?
Правильный ответ честный только А
На Графике 2А показаны результаты моделирования при котором пропаганда влияет на желание избирателя прийти на выборы. Сторонники ТП приходят в 72% случаев, а сторонники остальных партий - в 48% случаев. Средняя явка выходи около 58%. Корреляция между долей голосов за ТП и явкой отражает большую активность сторонников партии ТП. На Графике 2Б показаны результаты, когда независимо от политических взглядов явка составляет 58%. Но на каждом избирательном участке к партии ТП добавили около 25% (если много голосов - меньше, если мало - больше) бюллетеней от того числа, которые у неё уже есть, а для остальных партий бюллетени в равном количестве выкинули, равномерно их размазав. Соответственно, явка от этого не изменилась, но ТП получила в среднем 25% больше голосов, чем должна была. Корреляции между долей голосов и явкой нет. На Графике 2В показаны тоже сфальсифицированные результаты, с той лишь разницей, что настоящая явка 33%, независимо от политических взглядов, а настоящая поддержка партии ТП на 25 процентных пункта ниже (14% вместо 39% для Леверии и т.д.), а для остальных партий соответственно выше. Но на каждом участке партии ТП докинули ещё по 25% бюллетеней от числа зарегистрированных избирателей. Явка выросла на 25%, до 58%. Как можно заметить, корреляция между явкой и долей голосов за ТП внезапно стала отрицательной. Ниже графики распределения голосов по участкам для этих моделей
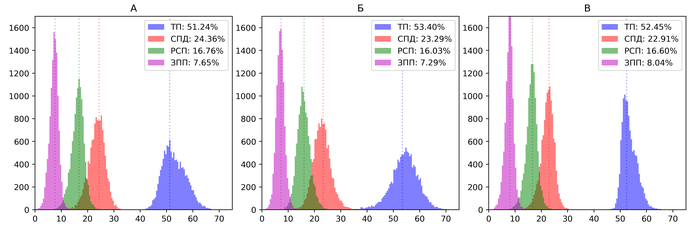
График 3.Распределение "участков" по уровню поддержки партии. Пунктирная линия отражает "итоги выборов" при разных моделях. А. Честные выборы (График 2А). Б. Перераспределение бюллетеней (График 2Б). В. Вбросы (График 2В).
Кстати, как можно заметить, и на моделях с фальсификациями получились вполне "нормальные" кривулины.
Вывод 2. Наличие корреляции числа голосов от явки на участках знак корреляции или её полное отсутствие не значит равным счётом ничего. При анализе корреляций по методу Шпилькина нарушается базовых принципов статистического анализа: наличие корреляции не означает зависимости и, если зависимость есть, не указывает на причинно-следственную связь (А следствие от Б или Б следствие от А).
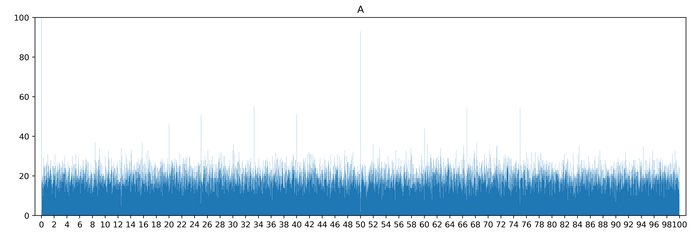
Часть 3. Пила на вкусных процентах Давайте представим себе, что на некоторый избирательный участок пришло 100 человек и какая-то часть из них проголосовала за ТП. Может ли ТП на этом конкретном участке получить 50% голосов? Да, может, если за неё проголосует 50 человек. А может ли она получить 51% голосов? Да, если проголосует 51 человек. А 50.5%? Нет, не может, так как 50 с половиной людей проголосовать не может. А вот если на участок 101 человек пришёл, может ли получиться 50%? Нет, не может, но зато может получиться 50.5% (51/101 = 50.495 с учётом округления до двух знаков). Думаю, логика понятна: в зависимости от того, сколько людей пришло, будут какие-то "предпочтительные" проценты, а какие-то "невозможные" проценты. Но, ведь у нас много разных избирательных участков, разного размера, если это всё объединить, что получится? Моделируем: 100 тысяч раз возьмём случайное число от 30 до 3000, сопоставляем ему ещё одно случайное натуральное число, меньшее выбранного, затем делим второе на первое и строем распределение частоты встречаемости процентов.
Будут ли "предпочтительные" и "запрещённые" проценты (объединённые с шагом 0.02) на такой выборке?
График 4. Встречаемость разных процентных групп (с шагом 0.02) в описанной выше выборке
На Графике 4 очень хорошо виден пик на 50%, 25%, 75%, 40% и т.д. Откуда они берутся? Для себя я объясняю это так (возможно есть строгое математическое доказательство). На ограниченном отрезке у нас половина чисел будет кратна 2, соответственно есть некая вероятность случайно попадать ровно в 50%. На этом же отрезке треть чисел будет кратна 3, соответственно, вероятность попасть в 33,33% и 66,67% есть, но будет меньше. Ещё меньше вероятность попасть в 20%, 40%, 60% и 80%, так как чисел кратных 5 у нас только пятая часть. Но, это всё равно значительно более высокая вероятность, чем попасть в 9/17 или 169/233.
Вывод 3. На выборке из случайных чисел ожидаемое более частая встречаемость "красивых" процентов. Впрочем, это касается только случайных чисел. На не случайных может быть что угодно.
Общий Вывод. Метод не рабочий. При его использовании нарушаются базовые принципы статистического анализа. Его автор и последователи (и противники) даже не подумали хоть как-то систематически проверить верность выдвинутых утверждений. Любой "признак фальсификации по Шпилькину" может быть методикой по-Шпилькина обоснован и как "признак честности". Наличие или отсутствие этих признаков ничего не говорит о свойствах выборки и причинах их появление. По моему частному мнению автором "методики" грубо нарушена научная этика, так как расхождение результатов анализа с ожиданиями трактовались в удобном для автора ключе, а альтернативные гипотезы не были рассмотрены. По моему частному мнению, последователи Шпилькина демонстрируют банальную некомпетентность и некритичность.