

Метод Шпилькина
Скоро выборы, разные телеграмм каналы уже активизировалась, и то тут, то там всплывает доказательства фальсификации выборов по Шпилькину... И этот метод прекрасная иллюстрация того, что бывает, когда люди не понимают статистику и не умеют в неё.
Дисклеймер: моя критика метода не означает ничего, кроме критики метода
Метода Шпилькина (и его продолжателей) заключается в том, чтобы построить распределение числа избирательный участков от явки на них /доли голосов отданных за того или иного кандидата и пристально на этот график посмотреть. Далее проверяется верность следующих утверждений:
1) Форма кривой распределения должна быть близка к нормальной и формы кривых полученных для разных кандидатов должны совпадать;
2) Кривая должна быть гладка, без каких-то пиков в особых местах;
3) Должна отсутствовать корреляция между долей голосов отданных за кандидате/партию и явкой на участках.
Всё выглядит разумно и даже банально, так в чём проблема?
Часть 1. Нормальность распределения
А давайте сразу перейдём к делу и промоделируем эти самые кривые, которые строит Шпилькин могут выглядеть. Представим себе, что у нас есть страна, Примерия. В этой стране проходит избирательная компания, в которой за места в парламенте бьются четыре партии: Трушная Примерия (ТП - партия власти), Революционный Союз Примерии (РСП - крупнейшая оппозиционная партия), Союз Победы и Демократии (СПиД - популисты-недооппозиция) и Замечательная Прекрасная Примерия (ЗПП - маргинальные оппозиционеры). Кроме этого, Примерия делится на три региона, которые отличаются друг от друга по социально-экономическим, культурным, этническим и другим характеристиками:
- Праверия, богатый регион с к крупными промышленными городами, 3000 избирательных участков по 1600 человек в среднем, ТП: 41% РСП: 29% СПиД: 21% ЗПП: 9%
- Леверия, не очень богатый регион, с крупными и средними городами, 3000 избирательных участков по 1600 человек в среднем, ТП: 39% РСП: 31% СПиД: 20% ЗПП: 10%
- Глухиния, удалённый от городов аграрный регион с консервативным сельским населением, 6000 избирательных участков по 400 человек в среднем, П: 46% РСП: 27% СПиД: 19% ЗПП: 8%
Для каждого избирательного участка я смоделировал его размер, явку (в первой модели - 100%) и голос каждого человека пришедшего или не пришедшего на выборы.
Далее, помня, что "главное, не кто как голосует, а кто как считает", я тремя разными способами обсчитал распределение голосов отданных за ту или иную партию избирателями. Результаты манипуляций с голосами показаны ниже, на Графике 1.
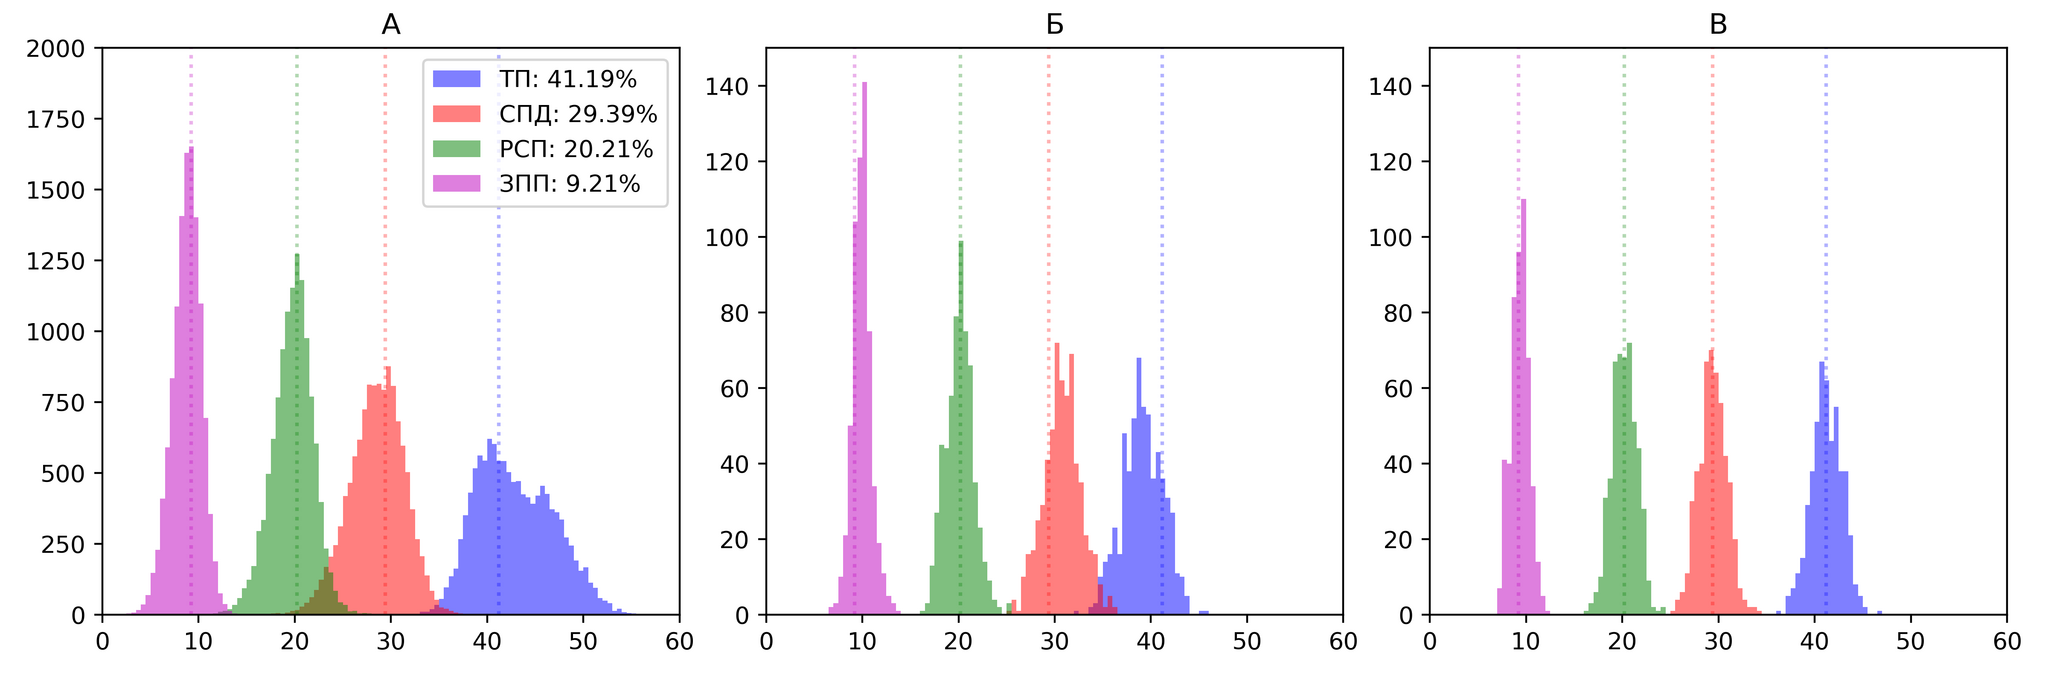
График 1. Распределение "участков" по уровню поддержки партии. Пунктирная линия отражает "итоги выборов".
Правильный ответ фальсификация на графике Б
На Графике 1А построены результаты голосования по методу Шпилькина. Мы получаем стрёмные графики, но не из-за того, что я "вбрасывал голоса", а из-за того, что у нас есть три региона с разными электоральным предпочтения. Каждая кривулина - это сумма трёх почти-нормальных распределений, но для партии ТП разница между регионами достаточно велика, что приводит к заметной аномалии в форме кривулины. Кроме этого вклад региона Глухиния на таком графике выглядит в несколько раз значимее, чем он есть на самом деле, так как численность избирателей на каждом участке в Глухинии в несколько раз меньше, чем в других регионах,а число участков - такое же.
На Графике 1Б показаны экзит-поллы. Результаты опросов построены по методу Шпилькина, но агентство, которое этим занималось послало 540 репортёров на участки в Леверии, 60 на участки в Праверии и ни одного в Глухинию (ехать в эту глушь стрёмно). Как следствие, результаты заметно отличаются от итогов голосования, зато кривулины похожи на нормальное распределение.
На Графике 1В показаны результаты опросов: 500 независимых агентств независимо опросило 1000 совершенно случайных людей, результаты для каждого отдельного опроса нанесли на график. Так как опросы проведены методологически правильно, то мы получили распределение близкое к нормальному и не отличающееся от результатов выборов.
Вывод 1: сложная форма кривой говорит только о том, что данные имеют сложную структуру. Чем эта сложность обусловлена - фальсификацией выборов или сложной и неоднородной структурой общества - не известно. Сложная кривая может быть получена по итогам честных выборов, а красивое нормальное распределение - следствием манипуляции с результатами. При анализе методом Шпилькина нарушается один из базовых принципов статистического анализа: при формировании подвыборок, каждая группа должна быть представлена пропорционально числу элементов в группе, а не числу групп. Как следствие, распределение может принимать какую угодно форму.
Часть 2. Корреляция явки-голоса
Но это была модель без учёта явки, но учитывать просто так явку не интересно, так как это приведёт к уменьшению числа людей и не повлияет на распределение голосов. Поэтому...
Представим себе, что власть пропагандирует необходимость участия в выборах, из каждого провластного утюга рассказывается о необходимости прийти на выборы, что это важно, что это определить будущее Примерии и даже используется админ.ресурс, чтобы заставить людей на выборы прийти и проголосовать. В тоже время сторонники оппозиционных партий рассказывают, что выборы сфальсифицированы, что результаты голосования будут нарисованы какие надо, а некоторые призывают в знак протеста приходить и портить бюллетени. Я не знаю, повлияет ли пропаганда на явку избирателей разных политических взглядов, поэтому промоделировал и вариант когда пропаганда влияет и когда не влияет, и заполировал сверху это всё разными способами фальсификации.
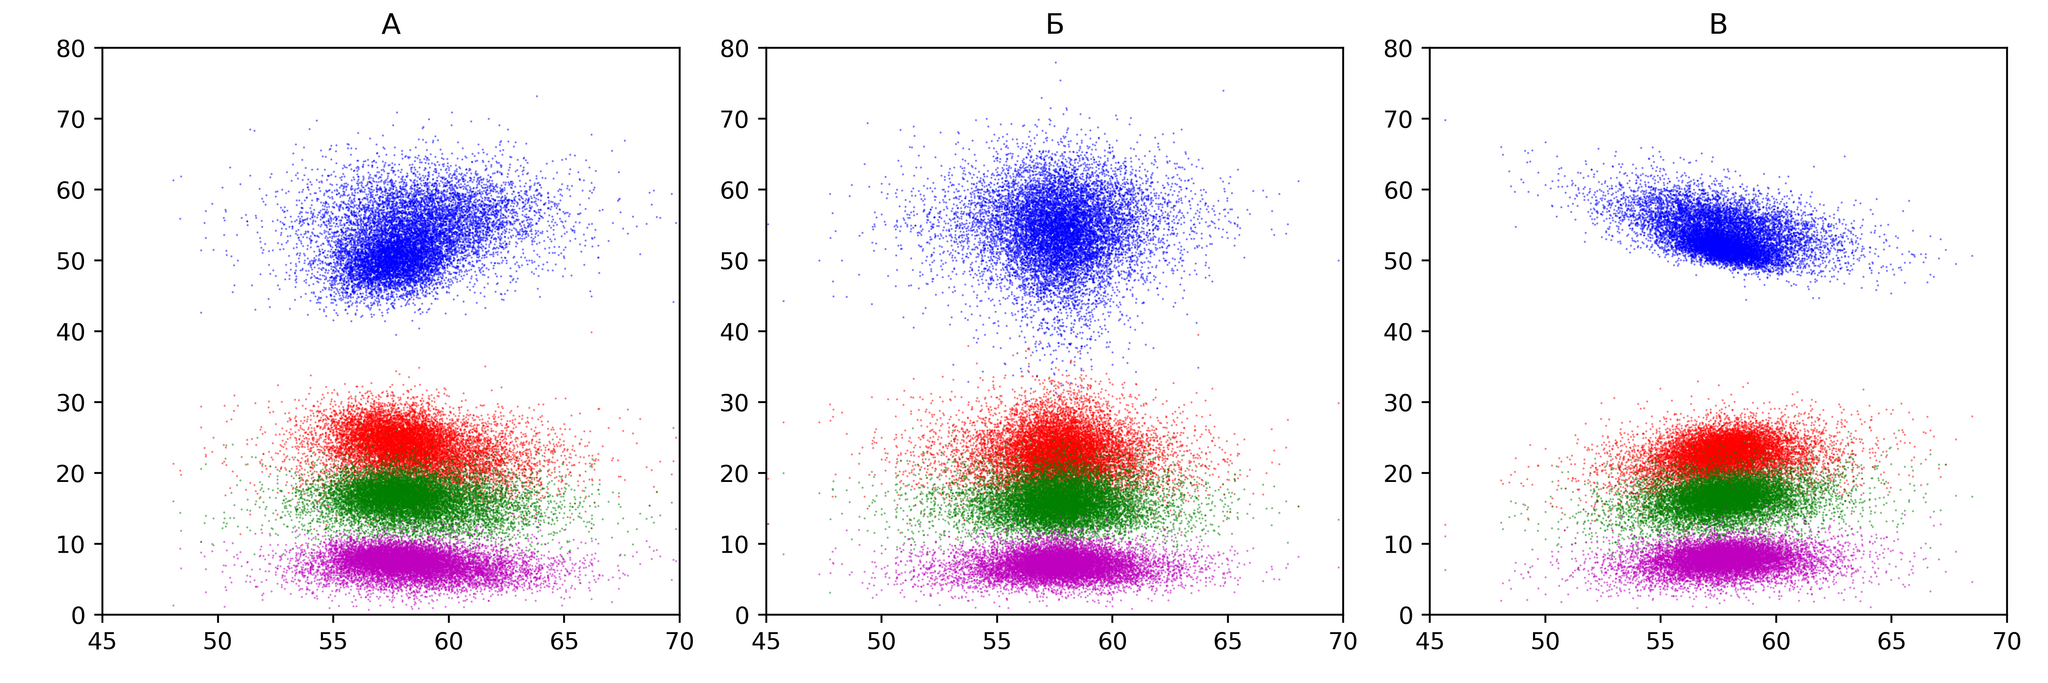
График 2. Распределение доли голосов отданных за ту или иную партию на участке (ось Y) по явке (ось Х)
Правильный ответ честный только А
На Графике 2А показаны результаты моделирования при котором пропаганда влияет на желание избирателя прийти на выборы. Сторонники ТП приходят в 72% случаев, а сторонники остальных партий - в 48% случаев. Средняя явка выходи около 58%. Корреляция между долей голосов за ТП и явкой отражает большую активность сторонников партии ТП.
На Графике 2Б показаны результаты, когда независимо от политических взглядов явка составляет 58%. Но на каждом избирательном участке к партии ТП добавили около 25% (если много голосов - меньше, если мало - больше) бюллетеней от того числа, которые у неё уже есть, а для остальных партий бюллетени в равном количестве выкинули, равномерно их размазав. Соответственно, явка от этого не изменилась, но ТП получила в среднем 25% больше голосов, чем должна была. Корреляции между долей голосов и явкой нет.
На Графике 2В показаны тоже сфальсифицированные результаты, с той лишь разницей, что настоящая явка 33%, независимо от политических взглядов, а настоящая поддержка партии ТП на 25 процентных пункта ниже (14% вместо 39% для Леверии и т.д.), а для остальных партий соответственно выше. Но на каждом участке партии ТП докинули ещё по 25% бюллетеней от числа зарегистрированных избирателей. Явка выросла на 25%, до 58%. Как можно заметить, корреляция между явкой и долей голосов за ТП внезапно стала отрицательной.
Ниже графики распределения голосов по участкам для этих моделей
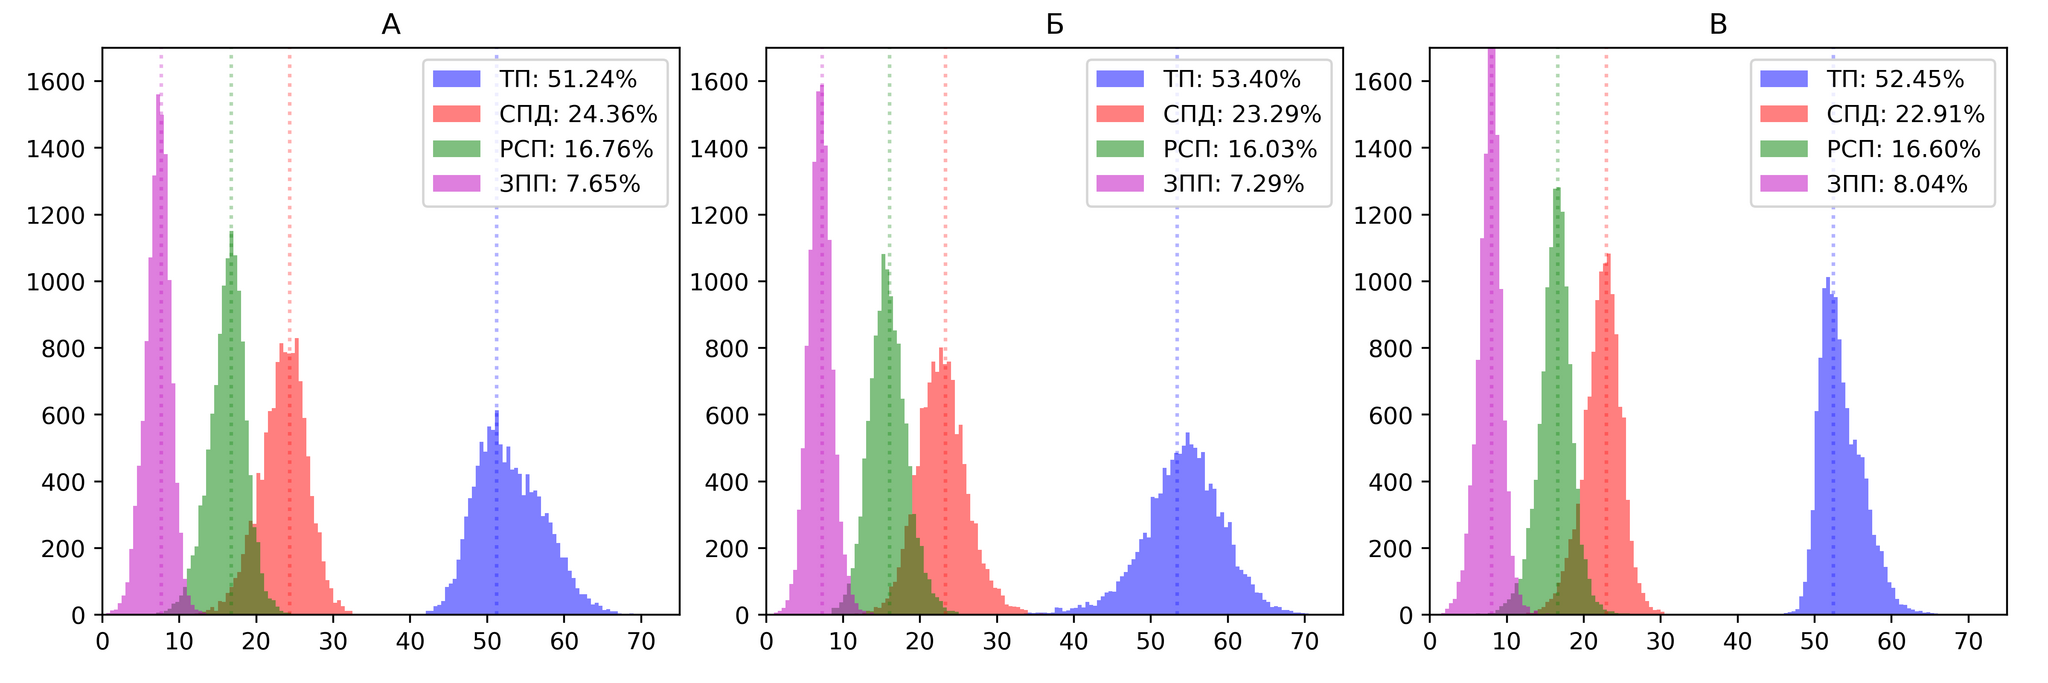
График 3.Распределение "участков" по уровню поддержки партии. Пунктирная линия отражает "итоги выборов" при разных моделях. А. Честные выборы (График 2А). Б. Перераспределение бюллетеней (График 2Б). В. Вбросы (График 2В).
Кстати, как можно заметить, и на моделях с фальсификациями получились вполне "нормальные" кривулины.
Вывод 2. Наличие корреляции числа голосов от явки на участках знак корреляции или её полное отсутствие не значит равным счётом ничего. При анализе корреляций по методу Шпилькина нарушается базовых принципов статистического анализа: наличие корреляции не означает зависимости и, если зависимость есть, не указывает на причинно-следственную связь (А следствие от Б или Б следствие от А).
Часть 3. Пила на вкусных процентах
Давайте представим себе, что на некоторый избирательный участок пришло 100 человек и какая-то часть из них проголосовала за ТП. Может ли ТП на этом конкретном участке получить 50% голосов? Да, может, если за неё проголосует 50 человек. А может ли она получить 51% голосов? Да, если проголосует 51 человек. А 50.5%? Нет, не может, так как 50 с половиной людей проголосовать не может. А вот если на участок 101 человек пришёл, может ли получиться 50%? Нет, не может, но зато может получиться 50.5% (51/101 = 50.495 с учётом округления до двух знаков). Думаю, логика понятна: в зависимости от того, сколько людей пришло, будут какие-то "предпочтительные" проценты, а какие-то "невозможные" проценты. Но, ведь у нас много разных избирательных участков, разного размера, если это всё объединить, что получится? Моделируем: 100 тысяч раз возьмём случайное число от 30 до 3000, сопоставляем ему ещё одно случайное натуральное число, меньшее выбранного, затем делим второе на первое и строем распределение частоты встречаемости процентов.
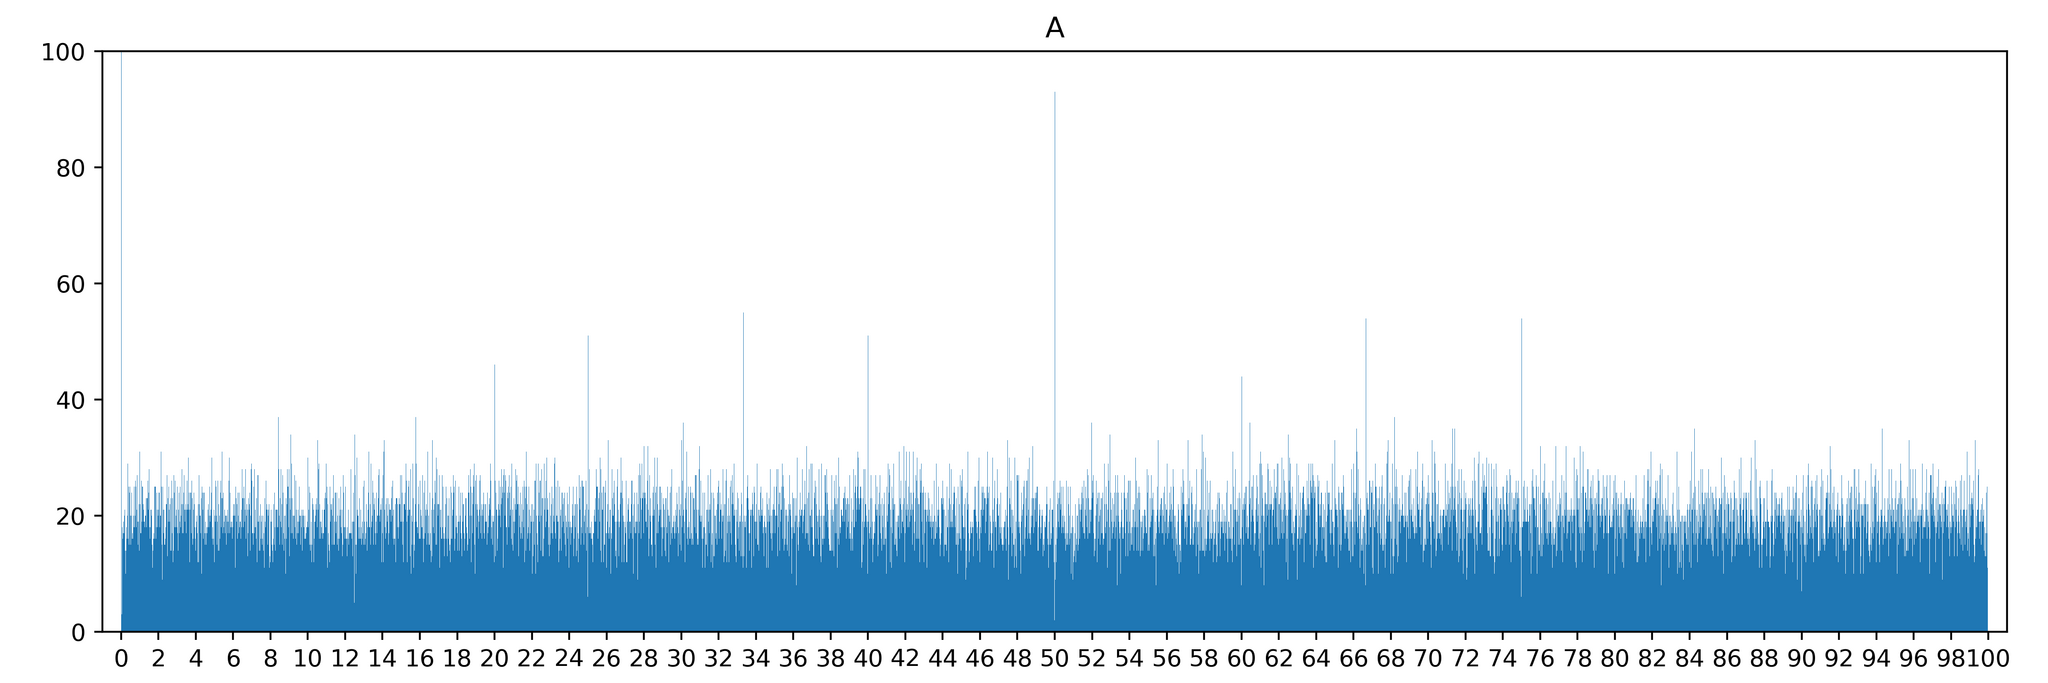
График 4. Встречаемость разных процентных групп (с шагом 0.02) в описанной выше выборке
На Графике 4 очень хорошо виден пик на 50%, 25%, 75%, 40% и т.д. Откуда они берутся? Для себя я объясняю это так (возможно есть строгое математическое доказательство). На ограниченном отрезке у нас половина чисел будет кратна 2, соответственно есть некая вероятность случайно попадать ровно в 50%. На этом же отрезке треть чисел будет кратна 3, соответственно, вероятность попасть в 33,33% и 66,67% есть, но будет меньше. Ещё меньше вероятность попасть в 20%, 40%, 60% и 80%, так как чисел кратных 5 у нас только пятая часть. Но, это всё равно значительно более высокая вероятность, чем попасть в 9/17 или 169/233.
Вывод 3. На выборке из случайных чисел ожидаемое более частая встречаемость "красивых" процентов. Впрочем, это касается только случайных чисел. На не случайных может быть что угодно.
Общий Вывод. Метод не рабочий. При его использовании нарушаются базовые принципы статистического анализа. Его автор и последователи (и противники) даже не подумали хоть как-то систематически проверить верность выдвинутых утверждений. Любой "признак фальсификации по Шпилькину" может быть методикой по-Шпилькина обоснован и как "признак честности". Наличие или отсутствие этих признаков ничего не говорит о свойствах выборки и причинах их появление. По моему частному мнению автором "методики" грубо нарушена научная этика, так как расхождение результатов анализа с ожиданиями трактовались в удобном для автора ключе, а альтернативные гипотезы не были рассмотрены. По моему частному мнению, последователи Шпилькина демонстрируют банальную некомпетентность и некритичность.
P.S.: реализовано питоном с помощью numpy, https://disk.yandex.ru/d/4YbijzXGs7nPjg
Когда с первых слов уже понятно всё.