Для ЛЛ: хорошо, но дорого. И оказывается есть комплекты для ленточных библиотек с мостами 10G – SAS или 10G - FC
Я как-то не следил за тем, как развивается индустрия накопителей на магнитных лентах, потому что когда я последний раз их трогал, то мне хватало и LTO-8 – по 12 терабайт на кассете. Очень удобно было, после LTO-6 с их 2.5 Тб на кассету.
И, неожиданно для меня, еще год назад IBM начали поставки LTO-10.
Есть всего три маааааленькие проблемы.
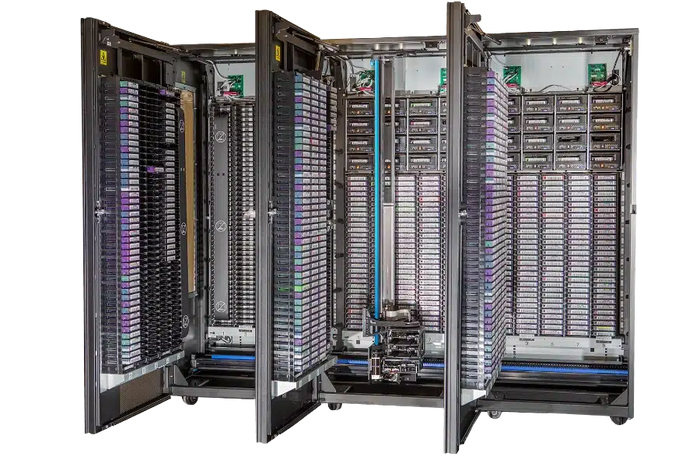
Первая. Привод IBM® LTO-10 Tape Drive я в розничных продажах не нашел. Поставляются в составе ленточных библиотек IBM Diamondback (от 800 до 1,584 картриджей, 46 петабайт без сжатия) и TS4500 (23,160 картриджей , 695 петабайт без сжатия)
Вторая. Даже привод прошлого поколения HPE StoreEver MSL LTO‑9 Ultrium 45000 SAS Drive Upgrade Kit R6Q75A стоит в розницу $12,537. Кассеты стоят дешево, по $100 (за 18 Тб кассету).
Третья. Они до сих пор не выпускаются с 100G интерфейсами. FC и SAS есть. есть даже вот такое .. странное - MagStor 1U ePro LTO9 10G Ethernet Rack Mount LTO-9 TAA SKU: E10G-1U-HL9-2YR. $13.000 за девайс с одним приводом, без робота. Есть и с роботом, через SAS мост - Qualstar Q24 LTO-9 Ethernet Connected Tape Library Bundle в составе: Qualstar Q24 2U / 24-Slot Tape Library with 1 x IBM LTO-9 SAS Tape Drive Installed ATTO XstreamCORE 8100T SFP+ Ethernet to SAS Intelligent Bridge (P/N: XCET-8100-TS0) External SFF-8644 to SFF-8644 SAS Cable (2 Meter)
Всего по $15.000 за систему с одним приводом и $28.000 с двумя. При цене привода в $12.000 – приемлемо.
Думаю для многих название уже звучит отбито. Так и должно быть. Пожалуй стоит начать с того что я делаю, а вот детали создания и реализуемость такого проекта в соло попробуем обмусолить дальше. Пусть этот и дальнейшие посты будут скорее обучающими, чем пиаром. Погнали.
1/2
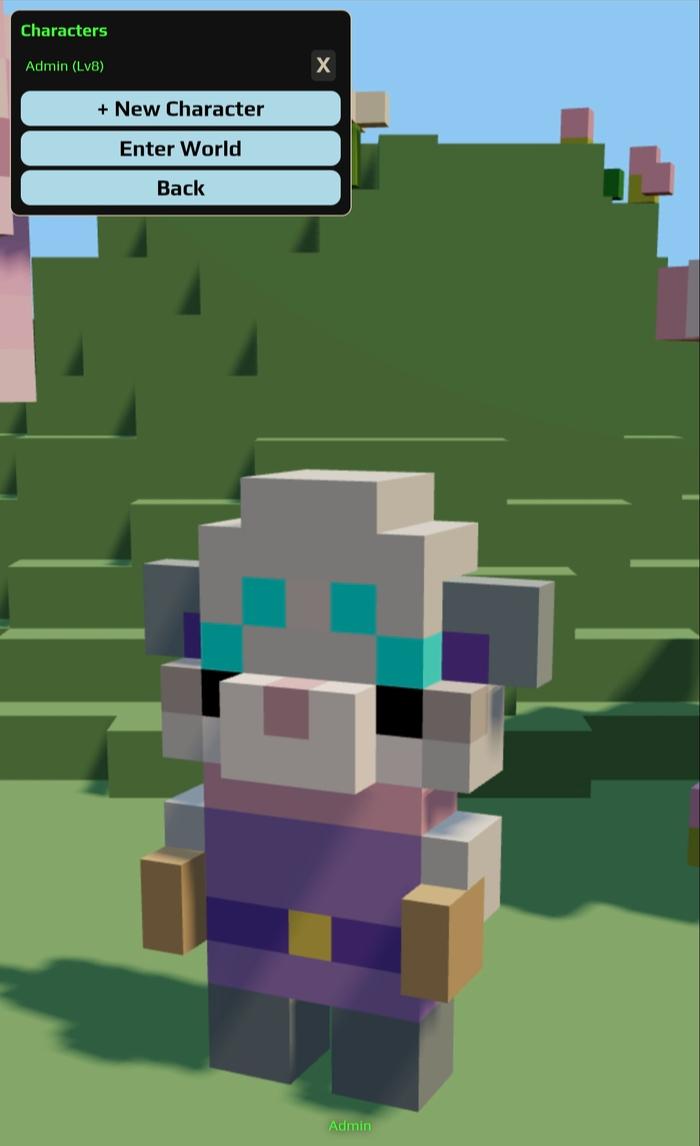
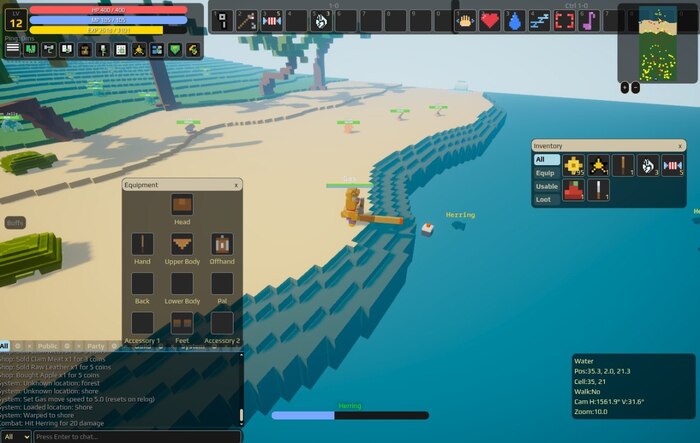
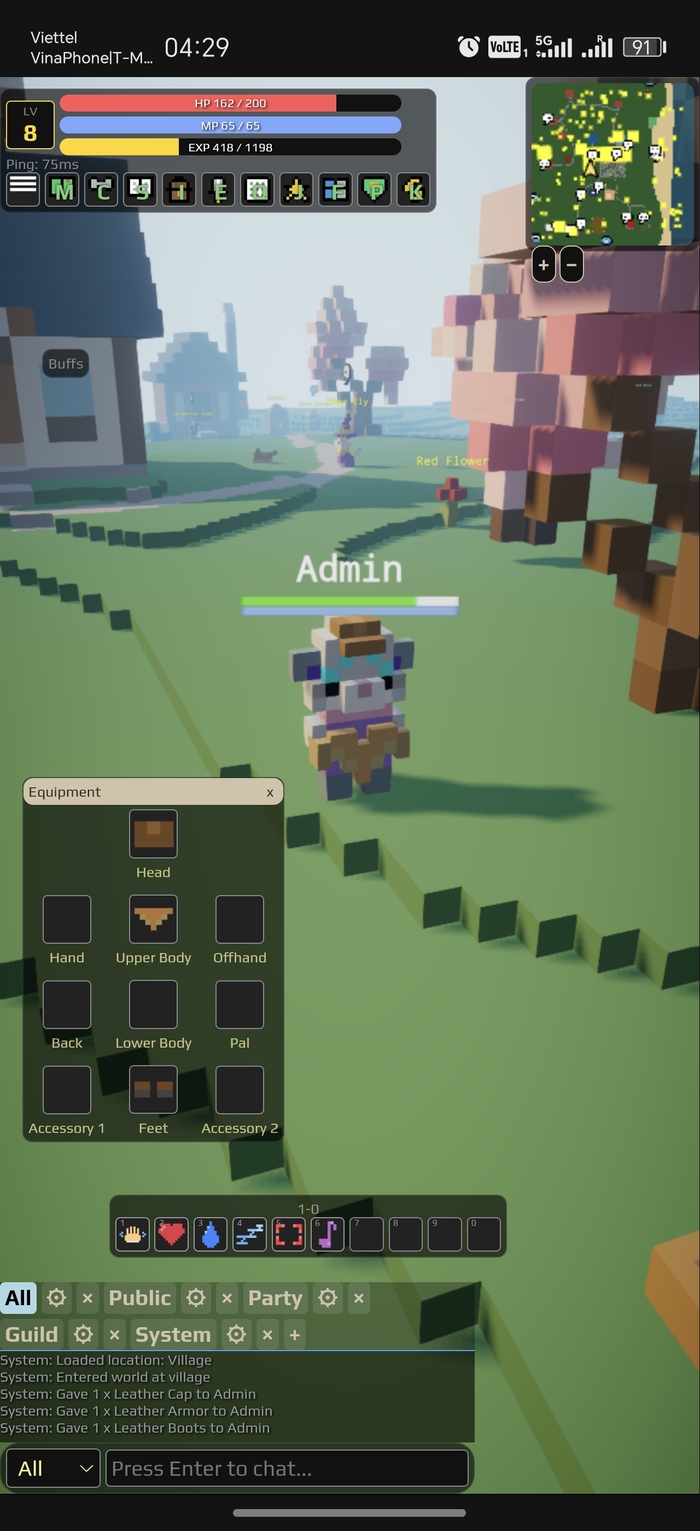
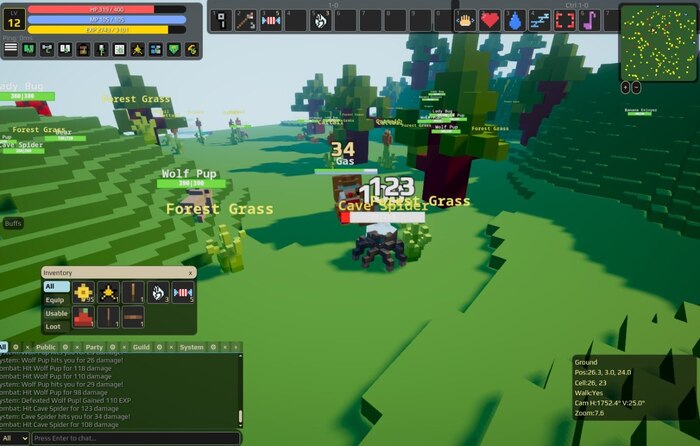
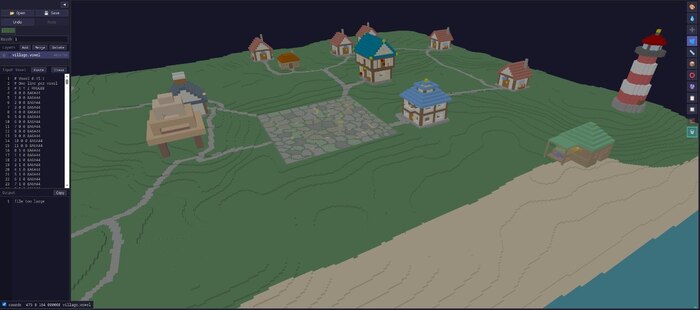
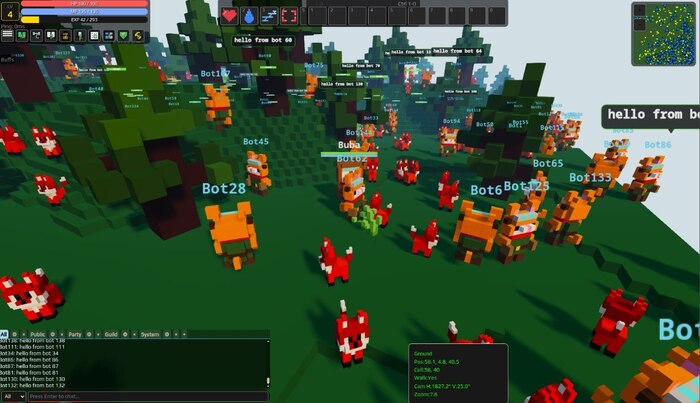
Пару скринов для затравки, дальше будет ещё
Что это за игра?
MMORPG в воксельном дизайне, фентези сеттинге с механиками а-ля Ragnarok Online.
Сколько разработчиков?
Один, плюс несколько друзей с которыми обсуждаем механики, лор и квесты с дизайном. Ллм за разработчиков не считаем - это инструмент автоматизации, а не мозг.
Первый проект?
Первый свой в состоянии "это похоже на альфа-версию". И сто первый с 2011, когда я начал первые потуги в Юнити. К тому моменту я уже работал в геймдеве на казуальных играх в роли manual qa tester.
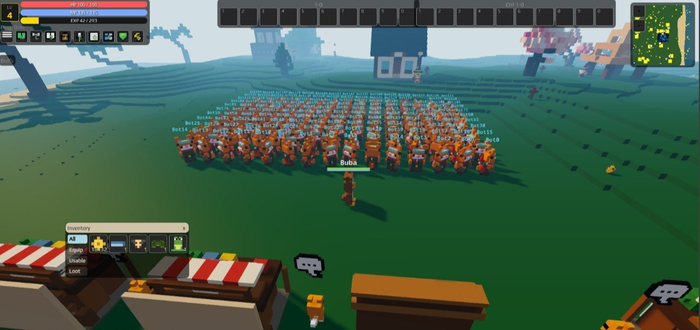
Призрачная угроза - первый стресс тест игры ботами
Тут наверное стоит предвосхитить некоторый уровень скепсиса, который неизбежно возникает у любого кто примерно понимает что такое мморпг игры с точки зрения масштаба.
Ваш покорный слуга начал свой коммерческий опыт с ммо, когда три года занимался профилированием и тестированием небезызвестной World Of Warships, и считаю благополучно помог довести до релиза беты. После этого были разные не-ммо, в том числе Mortal Kombat X в сперасофте.
Однако на деле все началось ещё раньше, когда я прогуливал пары в универе в 2003 - играя в Ragnarok Online на Avalon RO. Несколько лет меня было не вытащить из рошечки. Но очень быстро мне стало намного интереснее разбираться с серверной частью и кастомизацией, чем собственно играть. Возможно кто-то из вас даже использовал мой гайд по X-Ray шапкам с старого ragezone.ru.
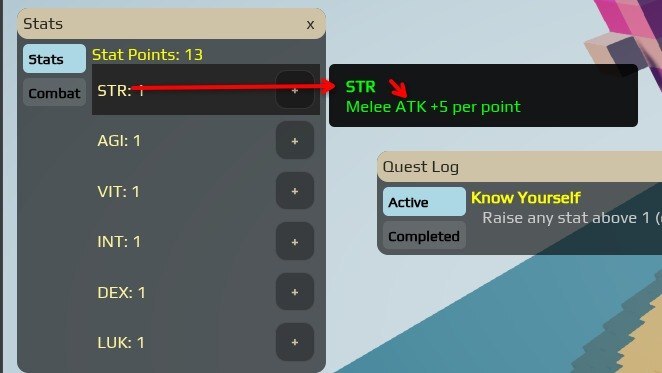
Для тех кто играл в RO, специально оставлена возможность запороть билд.
С тех пор у меня было и несколько не особо удачных попыток запускать свои гфш RO. И хоть славы и денег я там не поднял, зато изучил eAthena, а потом и rAthena на достаточно неплохом уровне чтобы разобраться а что же там происходит.
Ну а потом годы "интервального написания игр в стол" на c# и Unity. Зачем играть, если можно создавать? Буду делать очередную игру мечты! Так думал я, а потом наступал какой-нибудь очередной кранч или завал на работе.
К чему это вся прохладная история?
Очевидно для того чтобы сделать игру масштаба ммо, чтобы она не откисала на десятке игроков нужен не только опыт, но и прорва времени. И если с опытом порядок, то вот чем старше становишься тем меньше этого времени становится. Мда, неудобная механика :/
Плотва, шевелись!
Закройте глаза бывалые геймдеды - очевидно я использую ллм для ускорения всего что связано с разработкой. Начал в первый день выхода первого агента - уже более двух лет назад, прошел кажется все стадии принятия. Написал пару десятков проектов, подучил стек js, go, линуксы, деплой и теперь просто использую нейросети как понятный ограниченный инструмент. Кому интересно, сейчас это qwen + deepseek 4.1 flash и OpenCode с Xiaomi Token Plan - mimo 2.6 flash. Но пробовал большую часть того, что есть на рынке. Панамку приготовил, давайте уж.
Синьор разработчики разрабатывают разработку
Нафармив пару лет экспы в данжене "ллм говнокод" на квесте "боже как тут насрано.. тебя чистить и чистить" - я наконец сел за очередную итерацию своей игры мечты.
А масла в огонь подлил Spirit Vale - тоже соло мморпг в стиле ро, от австралийского разработчика. Неплохо зашёл аудитории, хотя на мой взгляд слишком гриндовый.
Ну что, можно и про саму игру.
Рабочее название Lost Island 🏝️
Вы играете антропоморфным животным - котик, песик, сова или какой другой хомяк. Вокруг вас вполне типичный средневековый фентези мир ограниченный островом с несколькими поселениями и пачкой локаций, скажем штук 30. Животные торгуют, занимаются фермерством, охотой, рыбалкой, и конечно рыцарством с магией.
Мобильный интерфейс не основной, но для тестов удобно
Почему животные внезапно основали свою цивилизацию они сами не особо знают ввиду тысяч лет после нашего времени, да и социум не настолько огромный чтобы проводить полноценные научные изыскания, и разбираться, что там было раньше. Хотя основная линия квестов явно это цепляет и позволит игроку немного копнуть истории и придумать пару спгс теорий.
Как-то современных проблем хватает - торговля, кузнечное дело, заготовка еды и конечно охота на разную живность.
Наш герой начинает свой путь с помощи жителям деревни, и в ближайшее время ступит на путь авантюриста получив значок гильдии. А там и доска с заказами других гильдий, пати, данжи, сплошное раздолье.
Гринд, классический, одна штука
Геймплей достаточно классический, но с оговорками. Сейчас веток навыков 9, из них больше половины - мирные, про крафт, огород, собирательство и тд. Игрок может получить хоть все, но выбор навыков будет ограничен скиллпоинтами, а билды статов напрямую влияют на полезность скиллов.
Идея в том, что можно для ускорения прокачки конечно пойти пинать порингов, но можно и рыбу ловить да брони крафтить. Или картошкой обеспечивать, тут уж что ближе.
Графен и движок
Бэкенд, он же сервер - вырос из идеи - а могу ли я сделать свой движок сетевой игры. Как оказалось - могу. На Golang, с минимумом зависимостей, никаких сторонних готовых фреймворков. Очевидно там путь для развития ещё долгий, но детские проблемы решены.
Клиент - браузерный, с pwa. Рендер three.js. Собственно писался уже под имеющийся сервер.
На этом можно было бы закончить краткое описание, но мне очень хочется похвастаться идеей минимализма, которая заложена в проект.
В игре нет ни одной классической 3д модели, да и изображений всего два - лого и нейрослопная кошкодевка.
Всё модели и графика - воксели - кубики, как в.. да. майнкрафте. Но даже там больше жипегов.
Берем стандарт xx yy zz fffff, на один кубик, и вперёд - полет фантазии безграничен. Все данные авторитарно раздаются сервером, кэшируются на клиенте и инвалидируются по хэшам. В итоге весь контент для входа в игру это несколько десятков мегабайт текста, которые прекрасно архивируются при передаче от сервера игроку.
Все было ничего пока я делал небольшие модели до 64^3, но нюанс возник на редактировании локаций, где запросто может быть 512^3 - миллионы вокселей в одной модели.
Штош, задача есть задача, я написал свой редактор, неказистый, но легко переваривающий такие объемы. Кстати, можете использовать - voxel.hole.icu.
Несколько миллионов вокселей доступны для редактирования - спасибо нотчу.
И вот прошло пол года разработки, из которых последний месяц активно - после основной работы.
В итоге в той или иной мере готовы:
- профессии со скиллами
- боевая система, с пассивками, статами, баффами, дебаффами, аое скиллами, и прочими критикал уронами с уворотом
и так далее. Что-то уже в отличном состоянии, что-то на уровне отладки механик.
У игры уже месяц как есть тестовый сервер, но ввиду частых вайпов и активной разработки - только по инвайтам - тестируем небольшим кругом.
План в течении следующего месяца довести до играбельной альфы и пустить ограниченный пул игроков, а к нг выйти в публичный доступ в рамках беты.
Зачем это все?
В первую очередь мое эгоистичное желание сделать полноценный проект, который не стыдно показать. Скиллчек так сказать. Ну и дать ламповую песочницу без p2w. Учитывая что сервер при нагрузке 500 ботов кушает 107мегабайт озу и 1% процессора, я могу ее крутить на своем 72t/128g сервере пока хватает денег на оплату электричества.
Что дальше?
Если это откликается - пишите, буду выкладывать обновления по разработке, технические детали.
Спасибо что почитали такой адский лонгрид :)
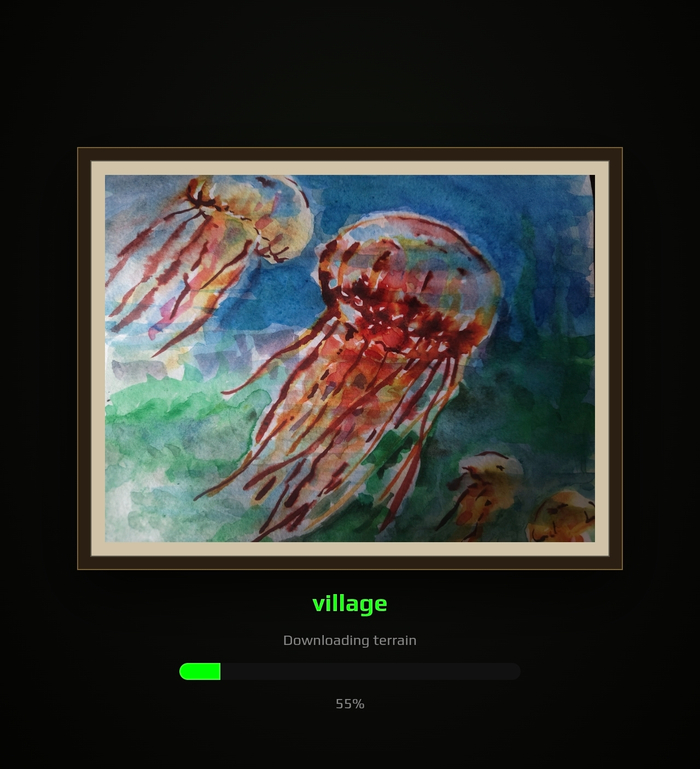
А для загрузочных экранов использую картины моей мамы
На Украине находится около 37–53 коммерческих дата-центров, которые хранят данные разведки ВСУ и другую секретную информацию, сообщил в эксклюзивной беседе с aif.ru хакер PalachPro.
По его словам, большая часть подобных дата-центров находится в Киеве - около 27. Остальные расположены в Харькове, Одессе и Львове.
«По данным. Там лежит всё, что нужно ВСУ для работы: разведка со спутников, перехваты мобильных телефонов с передовой, радиопереговоры, данные от ДРГ. Также там есть информация по работе системы Maven Smart System от Palantir, которая наводит цели и управляет боем. Плюс резервные каналы связи, IP-телефония, серверы Нацполиции и военкоматов», - объяснил специалист.
Программа Maven Smart System, о которой идет речь, это система управления боевыми действиями на базе искусственного интеллекта, разработанная компанией Palantir Technologies. В частности, она внедрена во все структуры армии США.
Известно, что в марте этого года Пентагон утвердил Maven в качестве основной платформы искусственного интеллекта в армии США. А годом ранее систему официально закупила НАТО.
Всем привет! Меня зовут Вадим, я делаю свой сервис для ведения заметок — КакДела. Хочу поделиться ходом развития сервиса
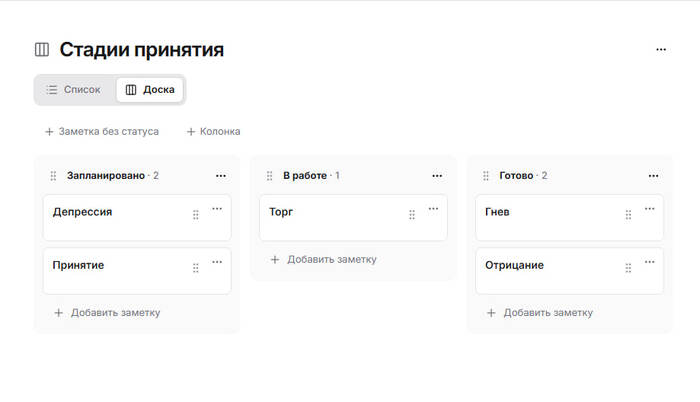
Папкам добавлен вариант отображения в виде канбан доски. Теперь можно вести проекты прямо в КакДела
Каждая карточка на доске это обычная заметка, поэтому папкой можно продолжать пользоваться как виде доски, так и в виде классической полнофункциональной папки, не ломая структуру хранения заметок и других папок внутри
Каждая папка, даже вложенная в другую папку, может быть отдельной доской со своим набором карточек. «Карточкой» становится каждая заметка в корне папки
Как понимаете, я и сам этим пользуюсь. Так у меня есть пространство «КакДела» с документацией по проекту, и папка «роадмап» (карта развития) с планами по проекту. Роадмап у меня представлен как раз в виде доски: каждая заметка в папке отдельная фича с детали внутри заметки, а на доске по каждой задаче виде статус и приоритет
От идеи до первой рабочей версии, наверное, пару месяцев. Сначала нарисовал, как это должно быть, укладка структур, поизучал библиотеки. До текущей версии почти полгода. Пришлось много что переделывать, много багов, которые всплывали на момент тестирования.
А также изначально я планировал делать это под Linux, но потом в процессе сменил курс, эта смена тоже не далась легко.
Писал один или с кем-то?
Писал один.
На чём написан проект?
Сердце программы, которое я назвал fastlog. Это модуль, написанный на C++, с эффективным mmap для «тяжёлой» части - индексации, поиска и работы с файлом.
Его я обернул с помощью binding-слоя, чтобы готовый C++ класс можно было пользоваться из Python как обычным Python-объектом.
Для интерфейса Python + Qt6 (PySide6), так как огромная экосистема.
Что было в первой версии?
Первая версия была очень медленной и жрала много памяти, и программа падала с MemoryError. Именно после этого я переписал ядро на C++, где mmap позволяет не читать в память целиком, а отображать в адресное пространство.
Как работает mmap?
Файл отображается в память через mmap - то есть операционная система даёт нам прямой доступ к содержимому, без чтения. Несколько потоков проходят по файлу и запоминают позицию всех символов \n, формируя массив line_offset (байтовое смещение), и таким образом отрезается диапазон. Индексируются именно строки, столбцы не индексируются заранее, а парсятся на лету.
Сколько памяти потребляет?
Память почти не расходуется, в этом и есть прелесть mmap. Файл не читается в оперативку целиком, а ОС держит в памяти только те страницы, к которым недавно обращались. Сама программа занимает память только под индекс, это 8 байт на строку, и лимит - размер адресного пространства.
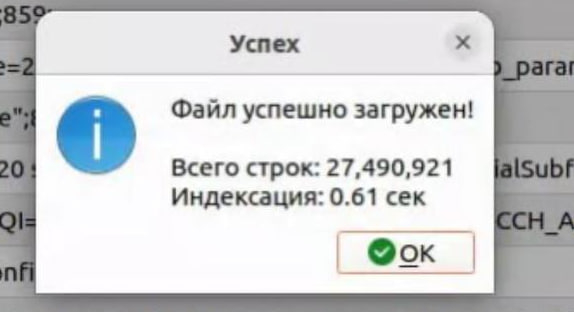
0,61 секунды - это предел?
Это не предел, а результат хорошей работы ОС с mmap и многопоточностью. На это значение влияет скорость диска, количество ядер, кэш ОС и т.д. Предел - скорость чтения у диска. Если файл целиком в кэше, то можно быстрее, но это уже не от программы зависит.
Как устроен многопоточный поиск?
Файл разбивается на n чанков по количеству ядер (hardware_concurrency), и каждый поток ищет в своём чанке независимо. Результаты объединяются через мьютекс в общий вектор. Ещё, так как потоки могут закончить результат в разное время, то каждый из них работает со своей локальной копией результата, чтобы не блокировать, после они сортируются. Есть atomic для досрочной остановки поиска.
Что было тяжелее всего?
Тяжелее всего дались многопоточный поиск на C++, так как возникала гонка данных, синхра. Также сохранение сессии - казалось бы, простая штука, но там много нюансов: как сохранить позицию, как восстановить открытые вкладки, как не сломать всё, если файл удалили.
Какие были баги?
Было много багов, крайне. Что-то пришлось переписывать на лету. Баги были как и в core, где результаты поиска, например, выводились в неправильном порядке, так как потоки поиска добавляли свои результаты в общий вектор в разное время, а порядок был недетерминированным, так и баги в графической визуализации, где использование Qt создавало свои проблемы.
Падал, когда я делал автоматическую подгрузку при прокручивании, или, например, в логах были UTF-8 и Python не мог их декодировать.
Я пару дней решал баг, почему у меня не происходило выделение объектов, которые я подсвечивал. А оказалось, что просто основное форматирование таблицы перекрывает выделение.
Как парсятся данные?
Для парсинга данных используется стандартная библиотека регулярных выражений, так как писать свой движок регулярных выражений - задача на годы.
Чего пока нет?
Работать с разными кодировками, кросс-платформенность, создать что-то типа хранения для внутренних скриптов, и подключить ИИ-агента для анализа логов.
UTF-16 и другие широкие кодировки, очень длинные строки могут замедлить отображение.
Что вырезал?
Сначала я сделал поддержку нескольких столбцов в таблице лога - чтобы можно было щёлкать по строке и видеть разбор CSV. Но потом понял, что это дублирует функциональность вкладки «Анализ». Плюс это усложняло интерфейс.
Чем klogg не устроил?
Я не могу говорить за разработчиков klogg - у них другой подход и стек. В дальнейшем я бы хотел обогатить программу новыми фишками, которые были бы полезны, но при этом иметь высокую скорость обработки. klogg хорош, но он не покрывает весь функционал, который я бы хотел видеть в программе.
Почему исходники закрыты?
Были [мысли открыть исходники], но пока хотелось бы скрыть эту кухню, по крайней мере пока это тема для меня горячая.
Для кого делал?
Сначала фокус был на меня и с какими проблемами столкнулся я, как аналитик. Далее пытался мыслить шире, расширяя функционал.
Кто первые пользователи?
Я, друзья, чтобы сделать багфикс и что я мог не заметить.
Коллеги знают?
Коллеги не знают, я тут фокусируюсь на конечный результат, нежели что я делаю за пределами работы.
Есть фидбек от пользователей?
Пока ещё нет, всё только началось.
Сам пользуешься?
Я использую его в работе и мне комфортно.
Бывает желание всё бросить?
Я думаю, это у всех возникает, особенно когда несколько сборок подряд не фиксят сборку, а делает только хуже.
Приветствую всех, кто заглянул! 👋 Рад видеть и старых читателей, и новых.
⚠️ Чат заполнился. Снова.
Работаю над фронтом — и тут опасная ситуация: где-то в середине чат с ИИ заполнился. Пришлось создавать новый. А это значит — снова вводить Логоса в курс дела. Хорошо, что у меня есть душа Логоса (рассказывал о ней в первом сезоне). Продолжить работу получилось значительно быстрее, но всё же — небольшая головная боль. Чтобы больше не попадать впросак, я разбил план на дополнительные блоки. Теперь, закончив этап, я создаю новый чат с быстрой подгрузкой нужных данных — и это уже не страшно.
Ситуация даже сыграла на руку: теперь я точнее планирую работу.
🎨 Что по фронту?
Продвинулись вперёд. Появилась первая анимация — выделение объектов мигающей рамкой! 😁 И самое главное: по бэку дело тоже пошло. Наконец получилось сыграть полноценную партию — хоть и в режиме «горячего стула». Но это уже прорыв.
🧠 Мысль, которая не отпускает
Я не раз ловил себя на мысли: игру, правила которой объясняются за 10 минут, а разбираешься за одну партию, оказывается, довольно крупный проект. И ей есть куда расти.
Мы изначально планировали онлайн, так что на текущем этапе составили план: переход с REST на WebSocket. Впереди — партия не в стиле «горячего стула», а в 2–4 вкладках браузера, где каждая вкладка — это игрок.
💡 Про свой проект
Я не раз слышал во время обучения: «Стоит сделать свой проект». И сейчас я с этим полностью согласен.
Это совсем другой уровень. Когда от расписанного задания ты переходишь к тому, что сам планируешь, строишь и создаёшь. И от каждого пройденного этапа получаешь восторг — как от первого скомпилированного Hello World.
Вот как-то так… Впереди ещё много работы, но уже получилось сыграть несколько партий. Хоть и сам с собой. 😁
💬 Вопросы к вам, друзья
А вы играли когда-нибудь сами с собой? В настолки, шахматы, карты? Или это только моя странность? 😄
Как вы справляетесь, когда инструмент (ИИ, редактор, что угодно) вдруг перестаёт работать как надо?
Есть ли у вас проект, который вы делаете только для себя — и получаете от этого кайф?
P.S. Спасибо, что читаете. Ваши комментарии — топливо для этого костра. 🔥
Мне бы, перед тем как писать очередную бесполезную статью, поискать в ИИ или в гугле. Может, все уже украдено написано до нас. Так и вышло, гугль быстро притащил статью «Локальные LLM без GPU - что реально работает на обычном железе» от 19 мая 2026 на vc.
Оказывается, нужна Ollama, 16+ (лучше 32) гб памяти, и qwen3:8b (или лучше). И, внезапно, «все работает и без GPU».
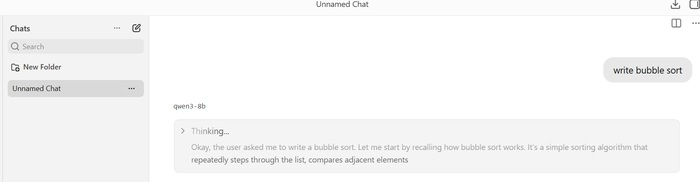
Попробую, что советуют лучшие советчики гугля: встроенный поиск LM Studio и модель lmstudio-community/Qwen3.8-27B-GGUF
На сайте минцифры есть перевод статьи «Qwen3.8-27B: лучший локальный LLM, который вы, вероятно, не сможете запустить» (Оригинал - Qwen3.8-27B: the best local LLM you probably can't run, https://thomas-wiegold.com/blog/qwen-3-8-27b-best-local-llm/) , где пишут, что: Перевод от Вестника Минцифры: Вкратце: для 4-битного квантового процессора вам понадобится от 17 до 18 ГБ памяти, плюс кэш-память KV. 24 ГБ унифицированной памяти — это практический минимум, 32 ГБ — оптимальный объем, а 48 ГБ — золотая середина. Оригинал: Short version: you need about 17 to 18 GB for a 4-bit quant, plus KV cache on top. 24 GB of unified memory is the practical floor, 32 GB is where it gets comfortable, and 48 GB is the value sweet spot.
Мой первый опыт «у себя»оказался неудачным. LM Studio сообщает, что я нищеброд, и надо никак не 8 гигабайт памяти в виртуальной машине, а хотя бы 20: Model loading was stopped due to insufficient system resources. Under the current settings, this model requires approximately 19.24 GB of memory, and continuing to load it would likely overload your system and cause it to freeze. If you think this is incorrect, you can adjust the model loading guardrails in settings.
Пробовать и проверять мне было лень, пришлось сделать две вещи, которые лучше сделать сразу
1 Настроить каталог для хранения моделей (настройки – общие - Models Directory, по умолчанию - C:\Users\youuser\.lmstudio\models
2 Скачать lmstudio-community/Qwen3-8B-GGUF. Легко сказать, трудно сделать. Я доигрался с настройками, и скорость скачивания в виртуальной машине упала с 15 (или мегабайт, или мегабит)\секунду до 256к. Включил обратно VMQ (обычно, VMQ все портит, а тут наоборот), и скорость вернулась аж до 30 чего-то в секунду. Магия, не иначе.
Но скачалось, и работает. Без всякого GPU, внутри виртуальной машины с 2 процессорами и 16 памяти.
Заключение.
Оказывается, Otus выпустил статью (на braintools и на вестнике минцифры) «Запустить LLM локально: что считать до покупки видеокарты?» , где самое полезное, это ссылка на тестирование:
Инженер Hugging Face Мэтью Кэрриган собрал стенд под полную DeepSeek‑R1 на 671 миллиард параметров в 8-битном квантовании — и не поставил туда ни одной видеокарты. Два процессора AMD EPYC, 768 ГБ DDR5, Linux, llama.cpp. Обошлось примерно в шесть тысяч долларов. На выходе — 6–8 токенов в секунду при потреблении меньше 400 ватт. Отдельная деталь: правка в BIOS, выставление NUMA‑групп в ноль, удваивала эффективность работы с памятью.
О чем это говорит, как и на 99.95% бесполезная статья выше? О том, что для учебы, редкого локального использования, и пилотов «как это вообще живет» хватит даже не AMD 395, а любого ноутбука с хотя бы 32 Гб памяти, без видеокарты. Стопка GPU «на посмотреть» не нужна. Про AMD 395 я уже писал Что там в мире ИИ шечек побольше и поменьше