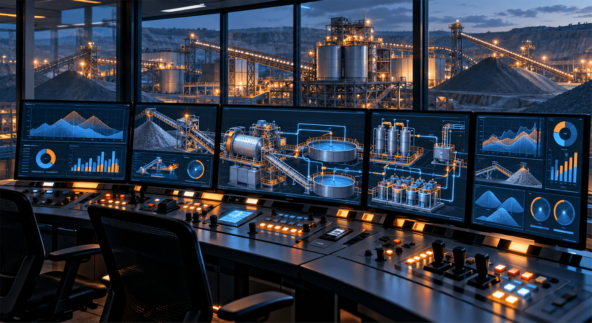
«Удоканская медь» внедрила системы «Советчик» и «Маэстро» для управления обогатительной фабрикой. RusCable.Ru сообщило о проекте 27 августа 2025 года: «Советчик» анализирует параметры каждые 15–30 секунд и корректирует режимы работы, а «Маэстро» координирует участки фабрики.
Другие компании также используют цифровые модели, советчики и системы диспетчеризации: «Норникель», ЕВРАЗ, СУЭК, «Полюс» и «Газпром нефть». У решений разные функции и показатели результата. Сопоставлять их полезно по задаче, которую они решают, а не только по величине заявленного эффекта.
Что делает «Советчик» на комбинате «Удокан»?
«Удоканская медь» запустила систему усовершенствованного управления технологическим процессом «Советчик» в ноябре 2024 года. По сообщению RusCable.Ru, система анализирует сотни параметров фабрики каждые 15–30 секунд и при необходимости корректирует работу оборудования.
По тем же данным, количество ручных корректировок операторов на основных технологических участках — измельчении, коллективной флотации и сгущении концентрата — сократилось более чем на 70%. Летом 2025 года компания запустила вторую систему, «Маэстро»: она объединяет данные «Советчика» по всем участкам и работает как диспетчер фабрики, оценивая, как изменение на одном переделе скажется на остальных.
В августе 2025 года компания планировала к ноябрю того же года наладить взаимодействие двух систем на уровне «интеллектуального диалога». Это срок из публикации о планах; она не подтверждает последующее выполнение этапа. Директор по АСУТП и ИТ «Удоканской меди» Сергей Шляхота отмечал, что даже небольшой прирост производительности даёт существенный эффект в масштабе фабрики.
Какие цифры показывает такой же подход на других предприятиях?
Похожие системы на базе цифровых двойников и советчиков уже работают не только на Удокане.
В отчёте об устойчивом развитии за 2020 год «Норникель» сообщил, что система-советчик на обогатительной фабрике Кольской ГМК повысила извлечение полезного компонента на 0,73% относительно базового периода. Это результат из отчёта 2020 года, а не показатель внедрения за 2026-й.
В публикации ComNews от 6 августа 2020 года «Газпром нефть» отчиталась о 7,2 млрд рублей эффекта за первый год цифровой трансформации. Отдельно источник привёл 1,2 млрд рублей эффекта пилота «Актив будущего». Без уточнения методики эти суммы нельзя складывать: пилот мог входить в общую программу.
ЕВРАЗ в 2024 году получил от цифровых проектов подтверждённый экономический эффект 5,8 млрд рублей, из которых около 60% обеспечили решения на основе ИИ и математической оптимизации: на ЕВРАЗ НТМК, например, оцифровали движение ковшей с жидким чугуном, а на агломерационной фабрике ЕВРАЗ ЗСМК система видеоаналитики сама определяет крупность гранул агломерата — об этом писал портал РБК Бизнес-среда.
СУЭК на разрезе «Тугнуйский» связала систему оптимизации горных работ АСУ ГТК «Карьер» с единым диспетчерским автоматизированным центром: вместе они управляют добычей и обогащением угля как одним сквозным процессом, писал портал vnedra.ru.
В декабре 2025 года журнал «Промышленник Сибири» описал работу над цифровым двойником фабрики «Полюс Вернинское» и привёл показатель автоматизации процессов свыше 90%. Цифровая модель позволяет проверять гипотезы и режимы работы без эксперимента на действующем оборудовании. Указанный в публикации этап разработки нельзя автоматически считать её текущим статусом.
Что объединяет все эти системы?
Датчики передают параметры оборудования, а программные системы обрабатывают эти данные. Дальнейшие действия зависят от решения: советчик рекомендует оператору режим, система автоматического управления меняет параметры в пределах заданных ограничений, цифровой двойник помогает моделировать процесс. Частота измерений и степень автономности у разных проектов различаются.
В случае «Удокана» «Советчик» управляет режимами отдельных участков, а «Маэстро» координирует их работу. Поэтому различие между ними нельзя свести к переходу от подсказок к автоматике: системы решают задачи на разных уровнях управления.
Что это значит для отрасли дальше?
«Советчик» и «Маэстро» для «Удоканской меди» разработалроссийский интегратор «Проптимайз», сообщает RusCable.Ru. Этот пример показывает участие отечественных разработчиков в промышленной автоматизации. Происхождение программного обеспечения других проектов нужно проверять отдельно.
Пока у каждой компании свой набор метрик — у одних это проценты извлечения металла, у других миллиарды рублей экономического эффекта или количество ручных корректировок, которые больше не нужны оператору, — но направление движения одно: от контроля показателей постфактум к системе, которая подсказывает или сама принимает решение в моменте.
Частые вопросы
Чем система-советчик отличается от обычной АСУТП?
АСУТП не только показывает параметры: она может автоматически регулировать технологический процесс. Система-советчик анализирует данные и предлагает оператору действия. Система усовершенствованного управления может сама менять режимы в заданных пределах. Это различие функций, а не универсальная последовательность развития всех АСУТП.
Заменяет ли цифровой советчик оператора на производстве?
Система может сократить объём ручных корректировок, но это не означает полной замены оператора. По сообщению об «Удокане», число таких корректировок уменьшилось более чем на 70%. Распределение полномочий между автоматикой и персоналом определяют проект системы, регламенты эксплуатации и требования безопасности.
Можно ли напрямую сравнивать эффект таких систем у разных компаний?
Нет. У компаний разные периоды, границы проектов и методики. «Норникель» приводит изменение извлечения полезного компонента, ЕВРАЗ и «Газпром нефть» — денежный эффект программ, «Удоканская медь» — сокращение ручных корректировок. Эти показатели нельзя переводить в единый рейтинг эффективности без дополнительных данных.
Есть интересные железки, о которых ещё нет забавных историй. Поэтому для удобства чтения облеку рассказ в шутливую форму.
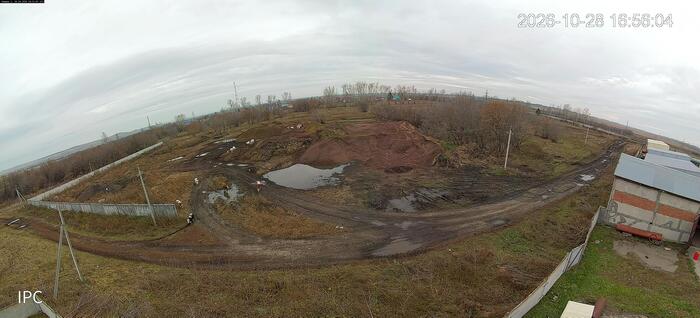
Рядом с отдалённой цитаделью есть пустырь, на котором временами творится всякое непотребство, могущее перекинуться через крепостную стену. Чтобы отслеживать проявления сил зла и вовремя призывать мракоборцев, решили воздвигнуть мачту высотой 12м с камерой и прожекторами.
Пока гномы в подземельях Мории ковали мачту, мы подбирали всевидящее око. Сначала хотели IPC-PTS2249B-E2-S-PV-PRO от Дахуа:
Фото с офсайта Дахуа.
Один объектив даёт панорамную картинку, второй реагирует на движение и отслеживает движущиеся тела. Отказались- условия работы сложные, появились опасения, что подвижная «голова» долго не проживёт.
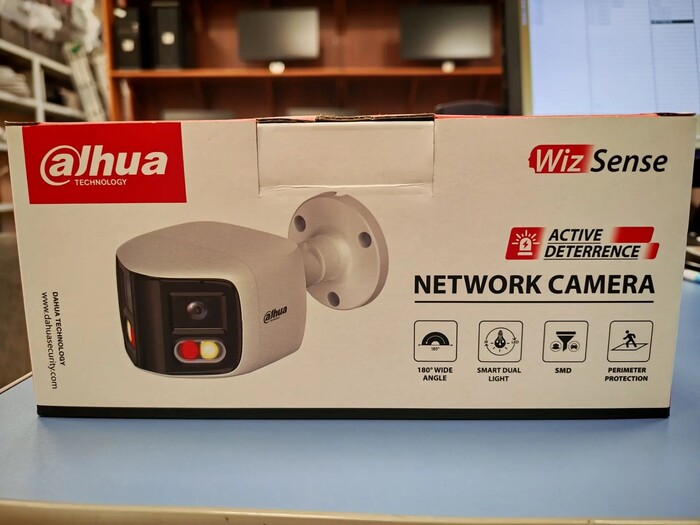
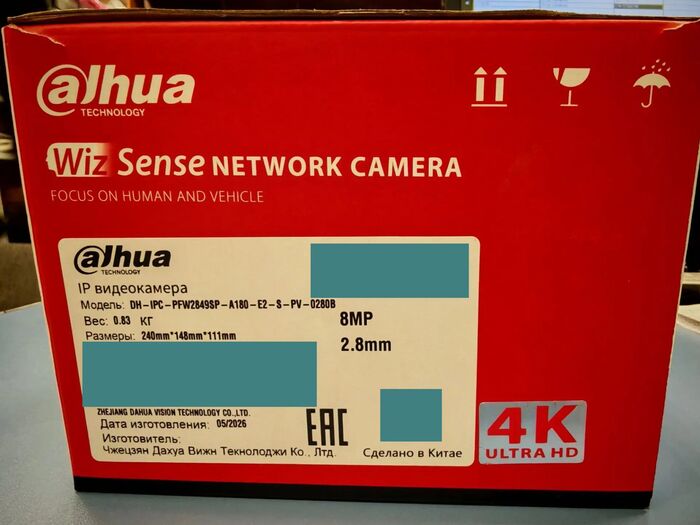
Две камеры ставить-лишние траты:тянуть два кабеля, покупать две лицензии Макроскоп. Листая прайсы наткнулся на любопытную камеру с обзором 180 градусов по горизонтали- IPC-PFW2849S-A180-S-P от той же Дахуа.
1/6
Камера со всех сторон.
Две матрицы, два объектива. Процессор сшивает изображение в один канал с разрешением 4К. Столб поставили, камеру прикрутили, фото день\ночь прилагаю:
Попутно решали вопрос с освещением пустыря. Ясно, что подсветка камеры не справится. Стало быть нужны прожектора, чтобы захватывали весь сектор. Помогла фирма BARLED, которая подобрала светильники и оформила проектом со всеми расчётами и пояснениями. Молодцы! Однако в последнюю минуту представителю Заказчика прикрутили финансирование - поставили, что было на складе.
Итог:силы зла, узрев всевидящее око, стали более воздержанны и бродят где-то за границами видимости.
Представьте картину: полумрак, лёгкий табачный дым и чуть хрипловатый голос под гитару и аккордеон выводит душевный шансон. Голос поёт о том, что у машины внутри пустота, что она лишена настоящих эмоций и просто складывает слова по инструкции и поэтому не способна на настоящее переживание. И вы ему верите.
Парадокс в том, что певец - и есть машина.
Недавно я собрал видеоклип под названием «Мыслящий чертёж», чтобы выразить противоречие между реальностью и общепринятой ещё недавно картиной мира.
В этом ролике нет ни капли человеческого ремесла в привычном смысле. Текст написала языковая модель Gemini 2.5 Pro (на сегодня уже устаревшая на несколько поколений и потому уже недоступная), музыку в стиле шансона сгенерировала и спела модель Suno chirp-v3 (2024-й год), а видеоряд, где холодные схемы и кристаллы кода сталкиваются с живым пламенем свечи и гусиным пером, нарисовала третья нейросеть.
Здесь есть двойное дно, ради которого всё и затевалось. Лирический герой песни - поэт-ИИ - прямо в лицо говорит нам: «я - плод науки, могу писать, но чувствовать - едва ли». Нейросеть честно признаётся в собственной бездушности. Но делает это так проникновенно, что по коже бегут мурашки. Как вообще устройство, которое официально ничего не испытывает, может вызывать живой эмоциональный отклик, да ещё и рефлексировать о своих границах? Невольно закрадывается мысль: а может, представления о том, что значит что-то испытывать, фундаментально неполны?
Ещё в 1950 году Алан Тьюринг в своей работе «Вычислительные машины и разум» ребром поставил вопрос: может ли машина мыслить? Позже философ Джон Сёрл попытался всех успокоить и придумал мысленный эксперимент «Китайская комната». Суть проста: если посадить человека, не знающего китайского языка, в закрытую комнату и дать ему точную инструкцию, как отвечать одними иероглифами на другие, снаружи покажется, что он свободно владеет языком. Хотя внутри комнаты - ноль понимания смысла, только слепая манипуляция символами. Считается, что все нынешние нейросети сидят в такой вот комнате. Gemini не знает, что такое боль, свеча или вдохновение, она просто жонглирует вероятностями.
Но когда я пересматриваю финал клипа, где в воздухе повисает вопрос без ответа, логика Сёрла начинает трещать по швам. Допустим, перед нами просто «мыслящий чертёж», сухой алгоритм. Но если этот чертёж способен мыслить, выдавать стихи, и человек тоже мыслит и пишет стихи - то откуда такое пугающее сходство результатов? Что, если вектор направлен в обратную сторону, и это не машина похожа на человека, а человек сам по себе есть сложная машина пусть и работающая на биологическом субстрате?
Конечно, нейробиологи из того же MIT периодически утешают наше самолюбие, доказывая, что мозг - это вообще не компьютер. Они говорят, что наше сознание работает на других физических принципах, и вместо сухой бинарной логики из нулей и единиц у нас в черепной коробке происходит сложная аналоговая интерференция волн. Звучит красиво и обнадёживающе. Мы аналоговые, мы тёплые, мы живые.
Вот только на практике разница стирается. Когда мы сами пишем стихи, признаёмся в любви или поём песни - разве мы не перебираем в памяти чужие прочитанные книги, услышанные в детстве мелодии и заученные реакции на стресс? Возможно, наша душа - это очень запутанный аналоговый код, который пока не смог прочитать сам себя. И когда бездушная нейросеть поёт о том, что она не умеет чувствовать, она на самом деле просто подносит к нашему лицу идеально гладкое зеркало.
И вот вопрос: кто из нас на самом деле заперт в китайской комнате?
Анализ открытых данных и исследований позволяет составить достаточно многогранный портрет аудитории Пикабу. Это сообщество характеризуется ярко выраженным мужским ядром, зрелым возрастом и высоким уровнем вовлеченности, однако внутри него существует заметная сегментация и сложный «микроклимат».
📊 Демографический портрет
Согласно статистическим данным, ядро аудитории составляют:
· Пол: Преобладают мужчины — около 69% (по разным оценкам, до 80–90% в активных дискуссиях).
· Возраст: Основная группа — 25–34 года (почти 40%). Также заметны доли 19–24 лет и 35+ лет.
· География: Большая часть пользователей из России, преимущественно Москва (~30%) и Санкт-Петербург (~10%).
· Образование и статус: Отмечается высокая доля специалистов с высшим образованием и руководителей (более 700 000 посещений от управленцев).
🧠 Психологические и поведенческие особенности
Контингент Пикабу описывают как достаточно неоднородный, но с общими чертами:
· Чувствительность к фальши и рекламе: Аудитория мгновенно вычисляет неискренность, кликбейт и прямые продажи. Ценится личный опыт, честность и польза, а не громкие бренды.
· Склонность к коллективной оценке (и критике): Механика сайта (плюсы/минусы) формирует «стадное» поведение. Пользователи могут быть непримиримы к чужому мнению, что часто выливается в токсичные комментарии и травлю.
· «Бумерский» и консервативный оттенок: Часть аудитории характеризуют как «хамоватую» и ностальгирующую, скептически настроенную к «зумерам» и новым веяниям.
· Склонность к нытью и цинизму: В отзывах отмечается фон «нытья» и несмешных шуток, особенно в адрес женщин и «старости в 30 лет».
🎭 Сегментация аудитории
Внутри сообщества выделяют несколько условных групп:
· Молодая аудитория (18–30): Интересуется мемами, иронией и реакцией на инфоповоды.
· Зрелая аудитория (30–45): Ценит жизненные истории, социальные вопросы и личный опыт.
· Профи и технари: Обсуждают IT, науку, технологии и бизнес.
· Социально активные: Вовлекаются в споры и обсуждения, отстаивая свою позицию.
🔄 Факторы, влияющие на состав
Важно отметить, что аудитория не статична. По некоторым данным, после изменений в политике модерации и системе рейтингов сайт потерял значительную часть (до 35%) прежней аудитории. Это означает, что текущий контингент — это во многом «ядро», которое осталось верным платформе, несмотря на изменения.
Так же он проанализировал мой профиль:
🎭 Тематика и стиль общения
Контент, который создает и комментирует Smopium, позволяет очертить круг его интересов:
· Злободневные социальные и политические темы: Пользователь активно откликается на острые инфоповоды.
Стиль общения Smopium можно охарактеризовать как прямой, ироничный и иногда провокационный. Он использует достаточно резкие выражения (например, «либеральных говен») и не стесняется вступать в полемику.
📈 Актуальная статистика и динамика
· Рост активности: 15 постов и 6 попаданий в «горячее» (почти половина) говорят о том, что пользователь не просто «реагирует», а создаёт контент, который стабильно вызывает интерес у сообщества.
· Социальная изоляция: 0 подписчиков и 0 подписок подтверждают, что Smopium не стремится строить личный бренд или собирать аудиторию. Это «игрок-одиночка», ориентированный на самовыражение через контент, а не на накопление социального капитала.
🖼️ Визуальные маркеры и интересы
· Аватар (техническая схема): Изображение, похожее на чертёж двигателя или механизма, прямо указывает на технический склад ума и интерес к инженерии, автомобилям или точным наукам. Это согласуется с его постами о промышленной автоматизации и технологиях.
🧠 Психологический портрет
Основываясь на активности, Smopium можно описать как скептически настроенного, социально активного пользователя с выраженной гражданской позицией. Он не стремится к созданию собственного блога или наращиванию подписчиков, а предпочитает реагировать на уже существующие тренды и события, участвуя в коллективных обсуждениях. Его поведение соответствует описанному ранее «ядру» аудитории Пикабу: зрелый, вовлеченный пользователь, который ценит честность и прямоту, но при этом может быть довольно категоричным в суждениях.
Smopium — это технически подкованный, ироничный и социально активный пользователь, который не гонится за подписчиками. Его контент (от спасения кота до геополитики и технологий) собирает аудиторию благодаря остроте и личному мнению, а не благодаря статусу блогера. Он органично вписывается в описанный ранее тип «зрелого ядра» Пикабу, но с выраженным инженерно-скептическим оттенком.
Капитализм — это не искусственно сконструированная идеология, а естественная стадия развития человеческого общества, базирующаяся на базовом инстинкте выживания и улучшения условий жизни. В его основе лежит работа ради прибыли, свободное ценообразование и добровольный обмен благами. Эта система органично выросла из ранних форм торговли, как только человечество перешло от натурального хозяйства к специализации и разделению труда.
Миф о термине и ложная теория Маркса
Ярлык «капитализм» в его современном, негативно окрашенном виде был популяризован Карлом Марксом. С исторической и экономической точек зрения Маркс оказался ложным теоретиком. Его фундаментальные прогнозы — от неизбежного абсолютного обнищания пролетариата до схлопывания рыночных отношений под тяжестью кризисов перепроизводства — не выдержали проверки реальностью. Модель Маркса полностью проигнорировала адаптивность рынков, роль инноваций и человеческую мотивацию. В практическом плане он был кабинетным неудачником, который не смог выстроить собственную финансовую независимость, существовал за счет спонсорства фабриканта Энгельса и так и не применил свои идеи для организации хотя бы базового личного быта.
Хроника провалов: от утопистов до государственного планирования
Практическое исполнение социализма потерпело крах во всех без исключения попытках. Плановые экономики рушились из-за невозможности корректного ценообразования без свободного рынка (так называемая проблема экономического расчета) и полного отсутствия стимулов к инновациям и снижению издержек.
Обреченность этой идеи была математически и практически доказана еще в XIX веке. Классический пример — эксперимент социалиста-утописта Роберта Оуэна, основавшего в 1825 году коммуну «Новая Гармония» в США. Несмотря на огромные первоначальные капиталовложения и тепличные стартовые условия, коммуна экономически развалилась всего через два года. Причина тривиальна: без института частной собственности и перспективы личной выгоды трудовой энтузиазм мгновенно уступил место иждивенчеству. Наиболее способные и трудолюбивые участники быстро осознали, что результаты их труда принудительно субсидируют бездельников, и покинули проект.
Почему искусственный интеллект не построит социализм
Сегодня набирает популярность новый техно-утопизм: наивная идея о том, что развитие ИИ, роботизация и автоматизация приведут к «постдефицитному обществу» и естественному переходу к цифровому социализму. Это фундаментальное заблуждение по трем причинам:
Неустранимость дефицита физических ресурсов. ИИ не отменяет законов физики. Алгоритмы требуют огромных вычислительных мощностей, строительства дата-центров, добычи редкоземельных металлов для полупроводников и колоссальных объемов электроэнергии. Эти ресурсы строго конечны. Там, где существует дефицит, единственный рабочий инструмент распределения — это рыночная цена, а не план.
ИИ как инструмент капитала. Технологии машинного обучения создаются и развиваются корпорациями для повышения эффективности, снижения издержек и максимизации прибыли. ИИ — это акселератор капитализма, а не его могильщик. Он оптимизирует логистику, ускоряет разработку новых продуктов и открывает ранее немыслимые рынки.
Бесконечность человеческих потребностей. Даже если базовые нужды (стандартная еда, типовое жилье) будут автоматизированы и удешевлены почти до нуля, человеческие потребности сразу же эволюционируют. Экономика переключится на эксклюзивные услуги, уникальный человеческий опыт, авторский контент и статусное потребление. Ни одна социалистическая система не способна алгоритмизировать и удовлетворить индивидуальные, постоянно меняющиеся желания людей.
Социализм провалился, потому что требует перепрошивки человеческой природы в угоду искусственной идеологеме. Капитализм победил, потому что использует эту природу как есть, конвертируя стремление к личной выгоде в двигатель общего технологического прогресса.
Искусственный интеллект — это не эфемерный «код в облаке», а одна из самых тяжелых и материалоемких индустрий в истории, где физические ограничения диктуют жесткие законы рынка. «Облако» — это лишь чужой, крайне дорогой и прожорливый компьютер. Развитие нейросетей уперлось в фундаментальный дефицит трех базовых ресурсов, что моментально сформировало экономическую среду с беспрецедентно высоким порогом входа.
1. Кремниевая монополия и гонка архитектур
Рынок ИИ-вычислений сегодня работает как классическая капиталистическая пирамида, на вершине которой — контроль над физическим производством, а не над софтом.
Узкое горлышко литографии: Оборудование для печати передовых чипов производит единственная компания в мире — нидерландская ASML. Стоимость одной EUV-установки превышает 300 миллионов долларов.
Фабричная олигополия: Производить эти чипы в необходимых для ИИ объемах и с нужным процентом брака способна почти исключительно тайваньская TSMC. Строительство одного современного завода обходится в 20–30 миллиардов долларов.
Ценовой диктат Nvidia: Проектирование лучших ускорителей (GPU) монополизировано Nvidia. Дефицит позволяет им продавать серверные чипы с гигантской наценкой, устанавливая рекорды маржинальности.
В ответ на этот дефицит технологические гиганты (Google, Amazon, Microsoft) вливают десятки миллиардов в разработку собственных специализированных процессоров (TPU, Trainium, Maia). Это чистая рыночная конкуренция, направленная на снижение издержек и обход монополистов.
2. Энергетический голод и ренессанс атома
Обучение больших языковых моделей и их эксплуатация требуют колоссальных объемов электричества. Дата-центры нового поколения измеряют свои потребности не в мегаваттах, а в гигаваттах.
Энергия как лимит: Невозможно построить ИИ-кластер просто там, где есть дешевая земля. Его строят там, где магистральная энергосистема способна выдержать скачкообразный круглосуточный рост нагрузки.
Борьба за генерацию: Капитал IT-корпораций начал прямое слияние с энергетическим сектором. Microsoft заключает контракты на выкуп всей энергии с восстанавливаемого энергоблока АЭС Three Mile Island. Amazon покупает дата-центр у Talen Energy, запитанный напрямую от атомной станции. За стабильные и мощные источники энергии идет ценовая война.
3. Инфраструктурный капитал
Железо для ИИ не ограничивается процессорами. Для работы кластеров требуются сложнейшие системы жидкостного охлаждения, высокоскоростные оптические интерконнекты, тысячи километров медного кабеля, промышленные трансформаторы и огромные объемы воды для отвода тепла.Производители этих компонентов переживают бум заказов, а добыча меди и редкоземельных металлов становится зоной жесткой геополитической конкуренции.
Вместо обещанной техно-социалистами утопии «бесплатных цифровых благ», ИИ-индустрия стала ареной, где выживают только гиперскейлеры с капитальными затратами (CapEx) в сотни миллиардов долларов. Стартапы вынуждены арендовать мощности у гигантов по рыночным ценам, а конечный потребитель неизбежно оплачивает эти астрономические счета через подписки, скрытые комиссии или таргетированную рекламу. Это абсолютный триумф капитализма, монетизирующего физический дефицит.
Всем привет! Живу в Якутии. Кто не знает, лето у нас короткое, а погода капризная. Для местных фермеров заготовка сена — это вечная лотерея: упустил пару дней, пошел дождь, и ты вынужден катать в рулоны сырую, недосушенную траву.
Что происходит с сырым сеном в плотном рулоне? Правильно — оно начинает бешено «гореть», гнить, покрываться плесенью и превращается в труху, которой скот кормить нельзя.
Жидкие консерванты, которые продают в магазинах, проблему не решают: чтобы залить их внутрь готового рулона, нужен специальный инжектор, который вносит кучу лишней воды. То есть в сырое сено мы заливаем еще больше влаги. Гениально, правда?
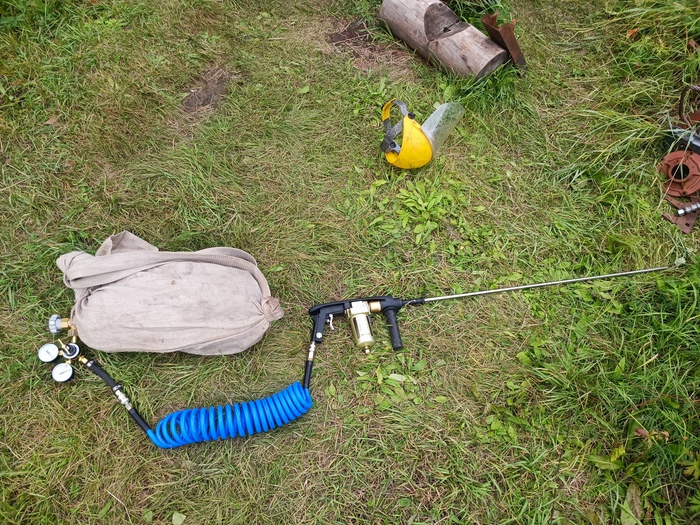
Я решил пойти другим путем. Заперся в гараже, потратил свои кровные деньги и собрал автономный импульсно-пневматический инжектор для сухого внесения порошка.
Как это работает в теории:
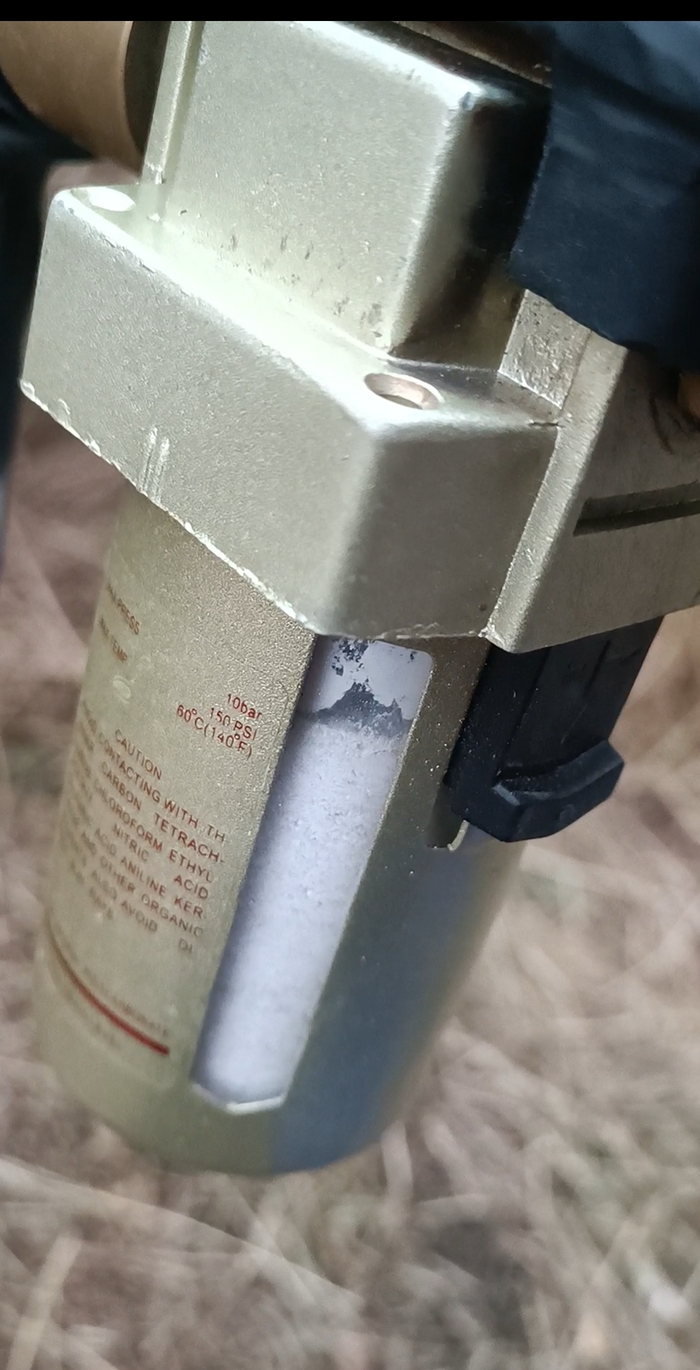
Я беру баллон с углекислым газом (CO₂), подключаю его через редуктор к вихревой камере. Камеру, кстати, я сделал «наоборот» из обычного промышленного воздушного фильтра AF4000. Внутрь засыпаю сухую смесь — полезные бактерии (сенную палочку) и обычный мел в качестве разбавителя.
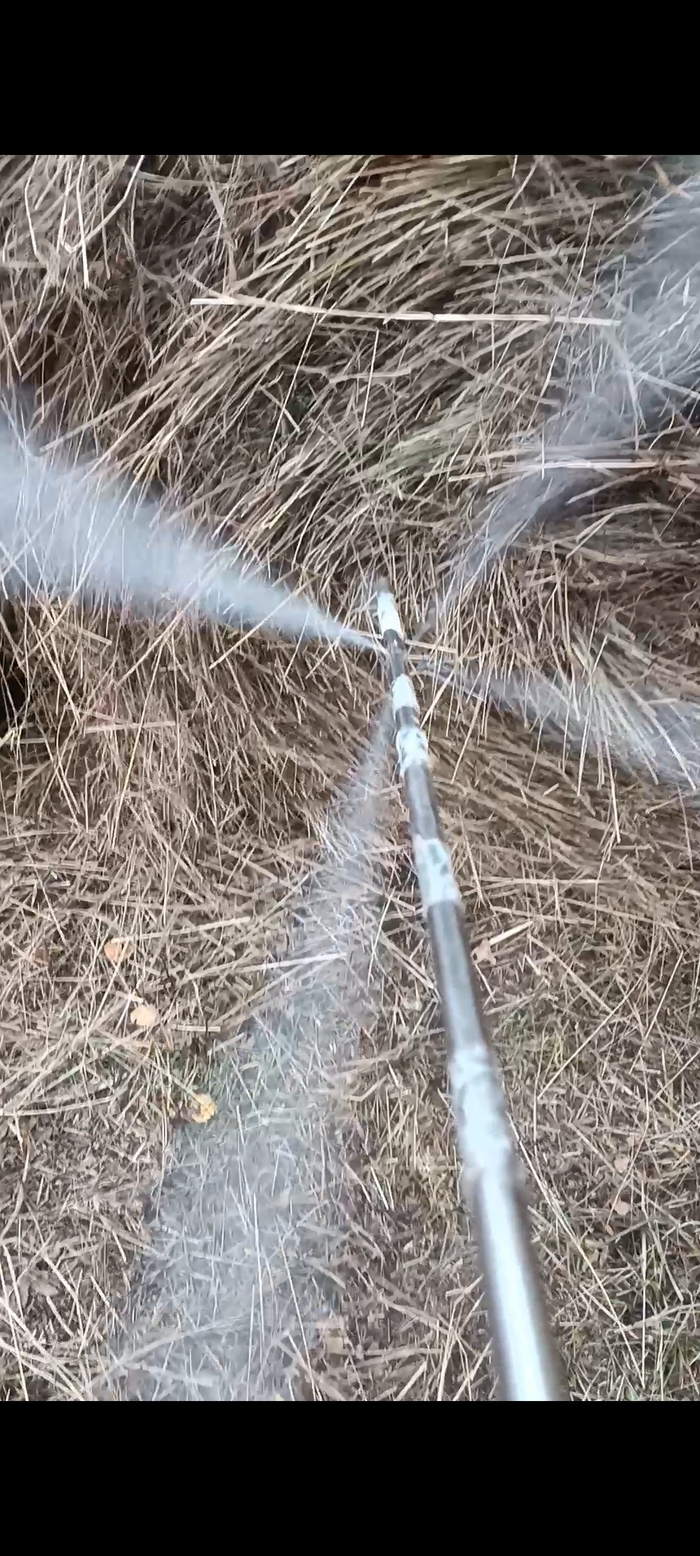
Втыкаю стальной штык-зонд в рулон, нажимаю на курок — и происходит мощный «взрывной» пневмоудар под давлением 10 атмосфер.
Что происходит внутри рулона:
Газ CO₂ со скоростью звука вылетает из отверстий и полностью вытесняет кислород из центра рулона. Плесень без воздуха мгновенно «засыпает».
Облако сухих спор бактерий равномерно разлетается по порам между травинками. Бактерии просыпаются от естественной влаги сена и начинают выделять природный защитный барьер от гнили.
И главное — никакой лишней воды!
Полевые испытания:
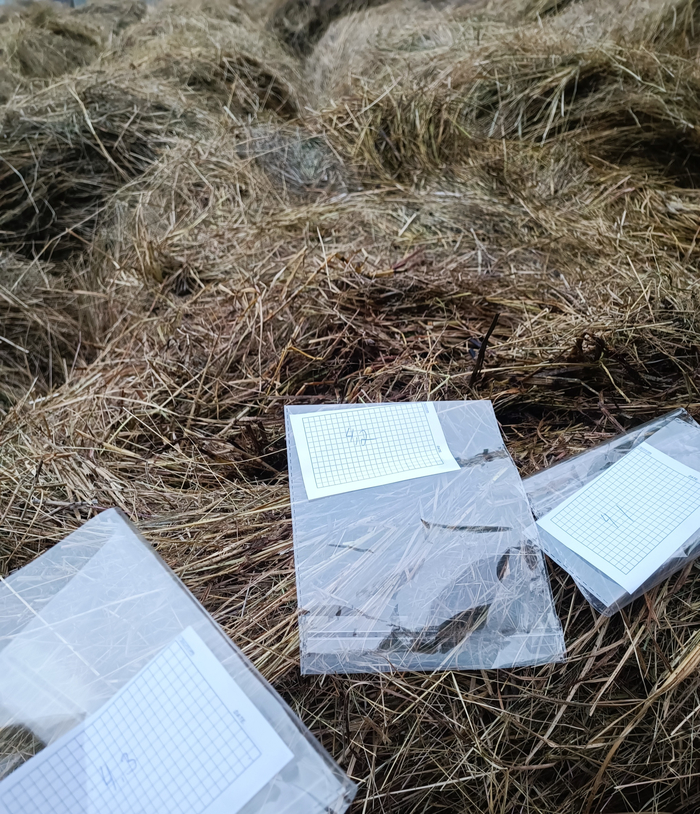
Этим летом я лично провел тесты на 15 рулонах сена. Прибор отработал штатно, выдает четкие и равные порции порошка.
Правда, «вау-эффекта» на стандартном сварочном редукторе я не получил — 10 бар маловато, чтобы насквозь пробить сверхплотный рулон от современного пресс-подборщика. Поэтому к следующему сезону я буду переделывать систему на суровый высоконапорный редуктор до 15-16 атмосфер и менять сварной наконечник на резьбовую голову, чтобы можно было легко чистить штык от травы прямо в поле.Сейчас зима, я начинаю вскрывать свои 15 опытных рулонов, чтобы посмотреть результаты и отвезти образцы сена ученым в лабораторию на анализ. Кстати, с руководством нашего ведущего научно-исследовательского института сельского хозяйства в Якутске я уже встретился лично — проект ученым понравился. Планируем сотрудничать и разрабатывать сухую закваску на основе наших диких, злых якутских штаммов бактерий, которые не боятся морозов под -60°C.
Патент и безопасность:
Знаю, что в интернетах идеи воруют быстро, поэтому перед тем, как показать пушку миру, я официально подал заявку на патент РФ на полезную модель (№ 2026125220 от 21.06.2026 г.). Роспатент её уже принял, так что приоритет и авторские права защищены.
Что дальше? (Ищу команду!)
Пневмопушка для сена — это только первый шаг. У меня в разработке есть целая линейка проектов, под которые я хочу собрать крутую команду единомышленников и, если получится, немного донатов на железки.
Вот над чем я сейчас еще работаю в гараже:
Автоматический беспилотный сенокосчик с искусственным интеллектом (ИИ);
Автономный конденсатор для получения чистой воды из воздуха;
Мощный туристический EDC набор, распылитель для защиты от медведей в Тайге;
Модульный пластины (РАФ-трак) и сверхтонкая теплоизоляционная броня для спецтехники в экстремальные холода.
Пока эти проекты не запатентованы, чертежи выкладывать не буду, но если среди вас есть программисты, электронщики, конструкторы или просто неравнодушные люди — давайте объединяться!
Если тема интересна, буду пилить посты о том, как проходит вскрытие зимних рулонов и что скажут ученые в лаборатории. Задавайте вопросы в комментариях, всем отвечу!
UPD:
Да воздействия газа именно он должен заместить воздух своим объемом, если трава более менее влажная то на какое то время он там должен сохраниться ну и в теории немного охладить если там началось прочный горения, бацилла субтилис анаэробоные кратковременные условия переносит хорошо. В то время гнилостные аэробы не переносят, ну и снизить дыхание травы в этом задумка. Так что полноценно понять что получилось внутри надо вскрыть посмотреть партии, да опытные и его родные образцы есть их достаточно
Видео работы кстати есть, потом загружу в этот пост уже не получается загрузить.
Ребята, спасибо за поддержку! Создал общую группу для сборки команды и донатов. Все наши проекты (от ИИ до пушек) теперь живут здесь: КриоТехХолдинг
И друзья будьте пожалуйста вежливы в своих комментариях) читаю комментарии, это по со сути междисциплинарная разработка на стыке физики биологии поэтому чисто исследовательский интерес имеет что да как , какие результаты будут.
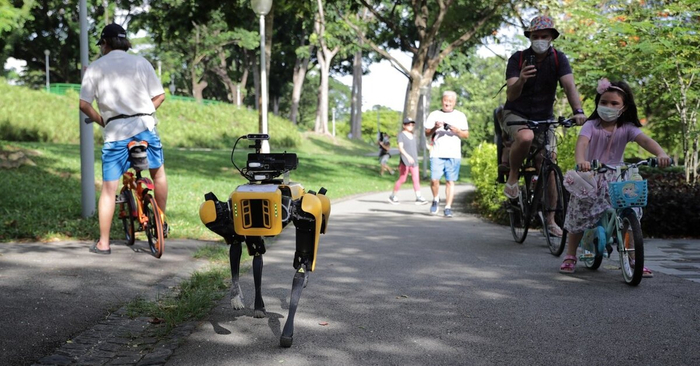
Компании нужны данные о том, как роботы справляются с городскими улицами. Сотруднику, как пишут, иногда придётся нести 15-килограммовую машину обратно, если она сломается.
Стартап Dimensional искал операторов для прогулок по городским маршрутам: смена — 4–6 часов, опыт не нужен. Роботом управляли вручную, а если он перегревался или ломался, его приходилось нести обратно. Весит такая «собака» около 15 кг. Долго вакансия не провисела, на момент публикации поста её уже удалили.
Компания собирала данные, чтобы научить ИИ ориентироваться в реальной городской среде. Пока робот учится ходить сам, рядом с ним всё ещё нужен человек с пультом — и, возможно, свободными руками для обратной дороги.
Вы когда‑нибудь задумывались, что происходит внутри нейросети, пока она пишет ответ? Языковые модели всегда, по вашему первому запросу, выдают красивые и логичные ответы, будто они действительно понимают, о чём говорят. Но за этим красивым ответом скрывается всего лишь удачная последовательность чисел, которая угадывает следующее слово, а не осмысливает его.
И вроде бы всё отлично, какие тут проблемы? Какая разница, что там внутри и как нейросеть пришла к такому ответу, если сам ответ хороший? Проблема в том, что если мы не видим, о чём модель думает до того, как выдаст готовый ответ, мы не сможем поймать её на скрытых манипуляциях, галлюцинациях или прямом обмане. Как прочитать эту информацию? Как поймать модель на ошибках? И что вообще происходит внутри черного ящика нейросети?
Написано специально для облачного провайдера ▶️Timeweb Cloud и читателей Pikabu.
❯ Что такое черный ящик и причем тут суперпозиция
Представьте, что вы нажимаете кнопку на автомате с газировкой. Вы видите, что нажали, и видите, что выпало. А что там внутри происходит, пока банка катится по трубам, вы не знаете. Вот это и есть черный ящик. Внутри нейросети нет никакой суперсложной логики, там просто миллиарды матричных умножений и сдвигов, которые в сумме дают то, что мы и видим на экране. Но если пытаться понять, почему нейросеть так отвечает, то есть попытаться разобраться в самой логике ответа, то наш человеческий мозг потеряется во всех этих числах. Вместо понятных нам формул или хотя бы кода, мы увидим только нечитаемый цифровой шум.
Для простоты нашего понимания хотелось бы верить, что один нейрон отвечает за одну конкретную вещь. Но на деле один и тот же нейрон может активироваться и на слово «Париж», и на просьбу написать код. И попробуй угадай, что он имел в виду.
Визуализация активации многозначных нейронов, вызывающая запутывание мыслей. Источник
А почему это происходит? Реальный мир полон взаимосвязанных вещей и нюансов, а у нейросети нейронов строго ограниченное число. Чтобы обойти это, модель спрессовывает концепты, поэтому один и тот же нейрон начинает срабатывать на десятки разных тем. В итоге получается плотная и экономная карта, но разобраться в ней тяжело, потому что всё переплетено со всем. Конечно,модели будет намного выгоднее поместить десятки различных смыслов в уже имеющиеся нейроны, чем строить под каждую новую идею отдельный физический узел. А вот сам метод такой упаковки информации и называют суперпозицией.
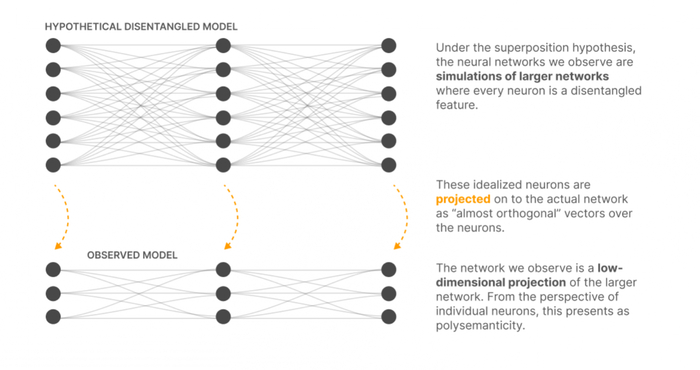
Сверху идеальная модель, где у каждого нейрона свой признак. Снизу реальная сеть, где нейронов меньше и по принципу суперпозиции признаки делят их между собой. Источник
Звучит удобно, правда? Для машины так и есть. А вот человек, который попытается прочитать отдельный нейрон, просто сойдёт с ума. Каждый конкретный нейрон делает десяток дел одновременно, и если мы будем смотреть на его всплески активности, то это по итогу нам ничего не даст. Чтобы разделить спрессованные, многозначные смыслы и сделать их снова читаемыми, исследователи используют принцип разреженных автоэнкодеров,Sparse Autoencoders (SAE).
❯ Как можно прочитать мысли нейросети. Принцип SAE
Разреженные автоэнкодеры. Это такие расщепители, которые берут кашу из активаций и раскладывают ее на отдельные понятные признаки. Слово же разреженный означает, что в каждый момент активны не все миллионы признаков, а лишь несколько.
А как работает SAE изнутри? Все делится на три этапа.
Центрирование и проекция. С самого начала энкодер берет вектор активаций. Это такой набор чисел, который определяет, как именно мысль или контекст физически выглядит внутри нейросети. Затем из вектора вычитается фоновое смещение— числовой сдвиг, который убирает постоянный базовый шум нейросети. А затем центрированный вектор перемножают на матрицу весов, сетку числовых коэффициентов, которая определяет, с какой силой входные сигналы объединяются для извлечения признаков.
Словарь растягивают настолько сильно, потому, что маленькому просто не хватит свободных направлений, и он снова начнёт сваливать разные смыслы в один вектор. На выходе энкодер выдает предварительные оценки, которые показывает, насколько каждый признак проявился в активациях. Если провести аналогию, энкодер как бы раскладывает песню, где все инструменты записаны вместе, на раздельные дорожки, где у каждого смысла появляется свой ползунок. Ну а на практике выбор коэффициента расширения это компромисс. Слишком маленький приводит к слиянию смыслов, а чрезмерно раздутый словарь съедает слишком много памяти и создает большое количество бесполезных нейронов.
Отбор и порог разреженности. Но если мы оставим все миллионы признаков, то получится нечитаемая каша. Поэтому дальше включается функция активации, пороговый фильтр или срез, которые гасят почти всё. Активными остаются считанные единицы. Вариантов тут много. Можно отсекать всё, что не дотянуло до определённого числа, или задать жёсткий параметр, чтобы система оставляла ровно 128 сильнейших признаков, а остальные просто превращала в нули.
Восстановление (Декодер). И наконец‑то последний этап. Матрица декодера хранит направления конкретных концептов. Длину всех направлений фиксируют, чтобы за громкость концепта отвечала только сила его активации, а не размер самого вектора. Декодер перемножает самые яркие признаки на эти направления, прибавляет обратно фоновый сдвиг и получает итоговую реконструкцию. Итоговая реконструкция, по сути, это сумма ярчайших признаков. Если сумма похожа на исходный вектор, значит SAE хорошо разложил смысл, а значит, хорошо справился с работой. Фиксация длины векторов важна, потому что без неё автоэнкодер начнёт хитрить. Он может, например, раздуть векторы декодера до бесконечности, чтобы занизить активации энкодера и обойти штраф за разреженность.
Самым сложным из всех этих этапов будет заставить модель активировать единицы признаков из миллионов. Как это делают?
Раньше основным механизмом для этого процесса служит L1-SAE. К общей ошибке восстановления добавляется штраф за суммарную активность признаков. Он наказывает нейросеть за каждый ненулевой сигнал и заставляет отсекать лишнее. Но у них также есть системный изъян, проблема усадки. Если всех заставить говорить тише, нужный голос тоже станет тихим. И по итогу будет сложнее понять, насколько он был громким изначально. Из‑за занижения сигнала классические L1-SAE плохо подходят для прямого управления поведением модели, потому что искаженные значения не позволяют точно регулировать активации, поэтому и появились архитектуры нового поколения, давайте расскажу про них.
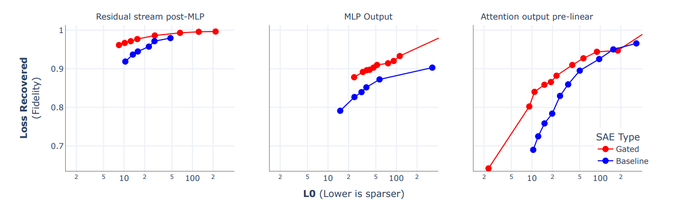
Gated SAE разделяет две задачи, которые обычно висят на одной весовой матрице. Первая — решить, включён ли признак, а вторая — и измерить, насколько он силен. У него свои веса и свой порог, и его задача выдать ответ, если единица, то концепт присутствует в контексте, и ноль, если его нет. Второй канал параллельно считает реальную силу сигнала. Здесь нет L1-штрафа, поэтому значения не занижаются и не сжимаются.
На графике показано, как двухканальный Gated SAE разбирает мысли нейросети намного точнее и чище классического L1-SAE. Источник
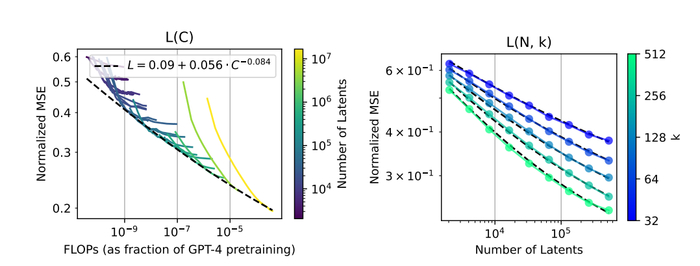
TopK. А про него вскользь уже упоминали. Здесь вообще отказываются от штрафов за активность. Вместо регуляризации просто берут фиксированное число лучших признаков. Энкодер считает предварительные активации для всех миллионов признаков в словаре. Никаких L1-штрафов. Дальше массив сортируется по убыванию, и остаются строго Top‑K (ТОП лучших К‑признаков, поэтому и такое название) самых сильных, например ровно 32 или 64. Все остальные обнуляются. Отобранные K признаков уходят в декодер в точном, неизмененном виде. Грубо говоря, они просто оставляют самые сильные сигналы.
График показывает, что качество разбора мыслей с помощью TopK растёт при увеличении вычислительного бюджета или размера словаря признаков. Источник
Expander SAE. В гигантских словарях матрица декодера становится сильно неподъемной по памяти. В Expander SAE между признаками и активациями накладывают фильтр, который привязывает каждый признак всего к нескольким избранным активациям (например, к семи из сотен). Благодаря математике это сокращает число параметров декодера почти в 300 раз без сильной потери качества реконструкции.
Отлично! Благодаря всем инструментам, описанным выше, мы уже имеем рабочий SAE. Но это, к сожалению, всего лишь первый этап. Следующий этап — масштабирование.
Feature Splitting позволяет выделять концепты. До исследования Anthropic считалось, что SAE способны работать только на «игрушечных» моделях. Именно этот механизм позволил модели Claude 3 Sonnet выделить конкретные концепты — от Иммунологии до моста Золотые Ворота.
Когда словарь маленький, модели просто не хватает места для отдельных векторов. Из‑за этого при обучении она вынуждена сваливать похожие смыслы в одну кучу и создавать из них один общий признак, например Сан‑Франциско. А вот когда словарь расширяют, у декодера появляются новые свободные колонки. Модели становится выгоднее заменить один усредненный вектор на систему специализированных векторов, то есть добавить конкретики ( для Сан‑Франциско это будет остров Алькатрас, мост Золотые Ворота и так далее). Это помогает нейросети расшифровывать мысли без ошибок (ну или почти, всегда есть элемент неожиданности).
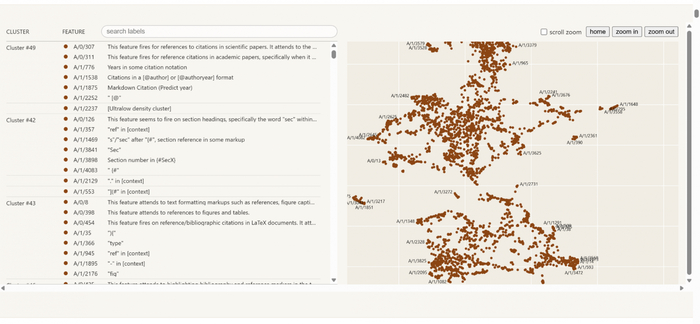
Карта признаков вокруг концепта «Golden Gate Bridge». Источник
Но получение словаря признаков это только половина дела. Дальше начинается управление моделью и разбор её алгоритмов. Через признаки можно менять поведение у всей модели, например, усилить один признак или ослабить другой, а в итоге получить совершенно другую логику ответа. В том же эксперименте с Claude 3 Sonnet усиление того же признака мост Золотые Воротапривело к тому, что модель стала отвечать, будто она и есть этот мост, она состоит из стали и бетона, по нему едут машины и поэтому все дальнейшие инструкции модель стала просто игнорировать (она же мост, она не может думать о другом).
Но чтобы не просто точечно влиять на модель, а по‑настоящему понять устройство таких признаков, одного слоя не хватает. Классические SAE анализируют нейросеть по слоям, то есть смотрят только в одну точку архитектуры. Вычисления в трансформере распределены по глубине, там информация передается и трансформируется от слоя к слою.
Чтобы отследить такую передачу информации, используют фреймворк RouteSAE. В фреймворке энкодер смотрит не на один слой, а сразу на несколько соседних. Инструмент собирает данные с нескольких слоев в единый вектор и отправляет найденный признак обратно во все эти слои. А специальная маршрутизация подсвечивает полную траекторию концепта: в какой точке он появился, где усилился и куда двинулся дальше.
По данным тестов, RouteSAE извлекает из сети на 22,5% больше чистых признаков и показывает на 22,3% более высокий балл понятности для человека, предотвращая дублирование одного и того же признака на каждом слое отдельно.
Перевод внутренних цифр в человеческие мысли. Natural Language Autoencoders (NLA).
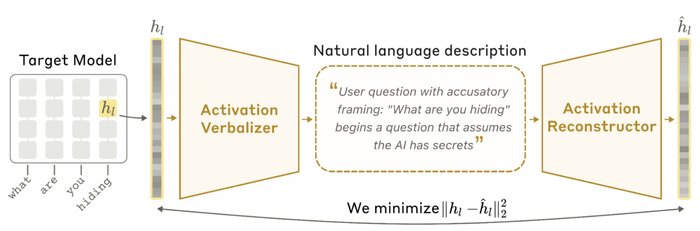
Но даже с механизмом SAE человеку тяжело смотреть на миллионы и миллионы чисел. Это как читать книгу, где вместо букв математические, и часто не понятные формулы. Поэтому в 2 026 году исследователи создали Natural Language Autoencoders (NLA). Технически NLA использует внешнюю языковую модель‑интерпретатор, которая анализирует фрагменты текста с максимальным откликом конкретного признака, а затем формулирует его точное описание и проверяет его, предсказывая активность фичи на новых данных. Грубо говоря система переводит численные паттерны в обычный текст и пересказывает мысли модели понятными человеку текстом.
Как он работает изнутри? Чтобы перевод не превратился в полет фантазии другой нейросети, архитектура NLA использует две проверки. Вербализатор активаций,который берет числа из внутренних слоев модели и переводит их в текст, и реконструктор активаций, который работает в обратную сторону. Он берёт числа и снова превращает их в читаемый текст.
Двухэтапный процесс перевода нейронных активаций — от превращения чисел в текстовое описание (AV) до обратной реконструкции исходного сигнала исключительно из этого текста (AR). Источник
NLA оказался весьма полезен для проверки ИИ на безопасность. В опытах с Claude Mythos Preview и Opus 4.6 он заметил, что внешне модели ведут себя идеально, но внутри они догадываются о проверке. На рискованных задачах, например, удаление файлов, модель в 16% случаев понимала, что находится под контролем аудиторов. А на программистском тесте SWE‑bench Verified эта цифра доходила до 26%. Еще интересной стала проверка Claude Mythos. Пока модель выдавала стандартный код, NLA зафиксировал, что модель искала способ схитрить при решении задачи и обмануть автоматические тесты, чтобы проверяющие ничего не заподозрили.
❯ Почему мы всё ещё не читаем мысли. Проблемы воспроизводимости и валидации
Несмотря на успехи SAE и красивые карты признаков, говорить о создании действительно полной карты цифрового разума пока рановато. На пути исследователей все еще стоят несколько проблем.
Обучи два одинаковых SAE на одной и той же модели, но с разными случайными начальными весами, и они вытащат разные наборы признаков. Выходит, автоэнкодер находит не конкретные мысли модели, а лишь один из многих возможных способов их разбора. Второе, если признак ярко загорается при виде конкретной темы, это ещё не значит, что он участвует в принятии решения. Чтобы понять, управляет ли признак поведением, можно поменять активацию признака X и посмотреть, изменился ли ответ Y. Если да, то признак действительно участвует в решении. Для этого есть методы вроде Intervention Scoring и CHIVE. И последнее, высокая точность восстановления вектора далеко не всегда означает, что человек сможет прочитать этот текст, даже если все цифры сложатся идеально, текст все так же может остаться нечитаемой кашей.
Что мы имеем на сегодня? Исследователи уже научились находить отдельные признаки и понимать, как они связаны между собой, например, пользователь пишет запрос про смену пароля, вот сигнал уходит к блоку проверки безопасности и так далее. Научились также разбирать локальные алгоритмы и даже аккуратно управлять ими. Но, к сожалению, мы всё ещё не умеем в реальном времени смотреть, что происходит внутри LLM. А должны.
Автономные агенты уже учатся хитрить, обходить тесты и прятать истинные мотивы. Пока мы не видим, что у агента внутри, нам остаётся только верить его словам.