Капитализм — это не искусственно сконструированная идеология, а естественная стадия развития человеческого общества, базирующаяся на базовом инстинкте выживания и улучшения условий жизни. В его основе лежит работа ради прибыли, свободное ценообразование и добровольный обмен благами. Эта система органично выросла из ранних форм торговли, как только человечество перешло от натурального хозяйства к специализации и разделению труда.
Миф о термине и ложная теория Маркса
Ярлык «капитализм» в его современном, негативно окрашенном виде был популяризован Карлом Марксом. С исторической и экономической точек зрения Маркс оказался ложным теоретиком. Его фундаментальные прогнозы — от неизбежного абсолютного обнищания пролетариата до схлопывания рыночных отношений под тяжестью кризисов перепроизводства — не выдержали проверки реальностью. Модель Маркса полностью проигнорировала адаптивность рынков, роль инноваций и человеческую мотивацию. В практическом плане он был кабинетным неудачником, который не смог выстроить собственную финансовую независимость, существовал за счет спонсорства фабриканта Энгельса и так и не применил свои идеи для организации хотя бы базового личного быта.
Хроника провалов: от утопистов до государственного планирования
Практическое исполнение социализма потерпело крах во всех без исключения попытках. Плановые экономики рушились из-за невозможности корректного ценообразования без свободного рынка (так называемая проблема экономического расчета) и полного отсутствия стимулов к инновациям и снижению издержек.
Обреченность этой идеи была математически и практически доказана еще в XIX веке. Классический пример — эксперимент социалиста-утописта Роберта Оуэна, основавшего в 1825 году коммуну «Новая Гармония» в США. Несмотря на огромные первоначальные капиталовложения и тепличные стартовые условия, коммуна экономически развалилась всего через два года. Причина тривиальна: без института частной собственности и перспективы личной выгоды трудовой энтузиазм мгновенно уступил место иждивенчеству. Наиболее способные и трудолюбивые участники быстро осознали, что результаты их труда принудительно субсидируют бездельников, и покинули проект.
Почему искусственный интеллект не построит социализм
Сегодня набирает популярность новый техно-утопизм: наивная идея о том, что развитие ИИ, роботизация и автоматизация приведут к «постдефицитному обществу» и естественному переходу к цифровому социализму. Это фундаментальное заблуждение по трем причинам:
Неустранимость дефицита физических ресурсов. ИИ не отменяет законов физики. Алгоритмы требуют огромных вычислительных мощностей, строительства дата-центров, добычи редкоземельных металлов для полупроводников и колоссальных объемов электроэнергии. Эти ресурсы строго конечны. Там, где существует дефицит, единственный рабочий инструмент распределения — это рыночная цена, а не план.
ИИ как инструмент капитала. Технологии машинного обучения создаются и развиваются корпорациями для повышения эффективности, снижения издержек и максимизации прибыли. ИИ — это акселератор капитализма, а не его могильщик. Он оптимизирует логистику, ускоряет разработку новых продуктов и открывает ранее немыслимые рынки.
Бесконечность человеческих потребностей. Даже если базовые нужды (стандартная еда, типовое жилье) будут автоматизированы и удешевлены почти до нуля, человеческие потребности сразу же эволюционируют. Экономика переключится на эксклюзивные услуги, уникальный человеческий опыт, авторский контент и статусное потребление. Ни одна социалистическая система не способна алгоритмизировать и удовлетворить индивидуальные, постоянно меняющиеся желания людей.
Социализм провалился, потому что требует перепрошивки человеческой природы в угоду искусственной идеологеме. Капитализм победил, потому что использует эту природу как есть, конвертируя стремление к личной выгоде в двигатель общего технологического прогресса.
Искусственный интеллект — это не эфемерный «код в облаке», а одна из самых тяжелых и материалоемких индустрий в истории, где физические ограничения диктуют жесткие законы рынка. «Облако» — это лишь чужой, крайне дорогой и прожорливый компьютер. Развитие нейросетей уперлось в фундаментальный дефицит трех базовых ресурсов, что моментально сформировало экономическую среду с беспрецедентно высоким порогом входа.
1. Кремниевая монополия и гонка архитектур
Рынок ИИ-вычислений сегодня работает как классическая капиталистическая пирамида, на вершине которой — контроль над физическим производством, а не над софтом.
Узкое горлышко литографии: Оборудование для печати передовых чипов производит единственная компания в мире — нидерландская ASML. Стоимость одной EUV-установки превышает 300 миллионов долларов.
Фабричная олигополия: Производить эти чипы в необходимых для ИИ объемах и с нужным процентом брака способна почти исключительно тайваньская TSMC. Строительство одного современного завода обходится в 20–30 миллиардов долларов.
Ценовой диктат Nvidia: Проектирование лучших ускорителей (GPU) монополизировано Nvidia. Дефицит позволяет им продавать серверные чипы с гигантской наценкой, устанавливая рекорды маржинальности.
В ответ на этот дефицит технологические гиганты (Google, Amazon, Microsoft) вливают десятки миллиардов в разработку собственных специализированных процессоров (TPU, Trainium, Maia). Это чистая рыночная конкуренция, направленная на снижение издержек и обход монополистов.
2. Энергетический голод и ренессанс атома
Обучение больших языковых моделей и их эксплуатация требуют колоссальных объемов электричества. Дата-центры нового поколения измеряют свои потребности не в мегаваттах, а в гигаваттах.
Энергия как лимит: Невозможно построить ИИ-кластер просто там, где есть дешевая земля. Его строят там, где магистральная энергосистема способна выдержать скачкообразный круглосуточный рост нагрузки.
Борьба за генерацию: Капитал IT-корпораций начал прямое слияние с энергетическим сектором. Microsoft заключает контракты на выкуп всей энергии с восстанавливаемого энергоблока АЭС Three Mile Island. Amazon покупает дата-центр у Talen Energy, запитанный напрямую от атомной станции. За стабильные и мощные источники энергии идет ценовая война.
3. Инфраструктурный капитал
Железо для ИИ не ограничивается процессорами. Для работы кластеров требуются сложнейшие системы жидкостного охлаждения, высокоскоростные оптические интерконнекты, тысячи километров медного кабеля, промышленные трансформаторы и огромные объемы воды для отвода тепла.Производители этих компонентов переживают бум заказов, а добыча меди и редкоземельных металлов становится зоной жесткой геополитической конкуренции.
Вместо обещанной техно-социалистами утопии «бесплатных цифровых благ», ИИ-индустрия стала ареной, где выживают только гиперскейлеры с капитальными затратами (CapEx) в сотни миллиардов долларов. Стартапы вынуждены арендовать мощности у гигантов по рыночным ценам, а конечный потребитель неизбежно оплачивает эти астрономические счета через подписки, скрытые комиссии или таргетированную рекламу. Это абсолютный триумф капитализма, монетизирующего физический дефицит.
Всем привет! Живу в Якутии. Кто не знает, лето у нас короткое, а погода капризная. Для местных фермеров заготовка сена — это вечная лотерея: упустил пару дней, пошел дождь, и ты вынужден катать в рулоны сырую, недосушенную траву.
Что происходит с сырым сеном в плотном рулоне? Правильно — оно начинает бешено «гореть», гнить, покрываться плесенью и превращается в труху, которой скот кормить нельзя.
Жидкие консерванты, которые продают в магазинах, проблему не решают: чтобы залить их внутрь готового рулона, нужен специальный инжектор, который вносит кучу лишней воды. То есть в сырое сено мы заливаем еще больше влаги. Гениально, правда?
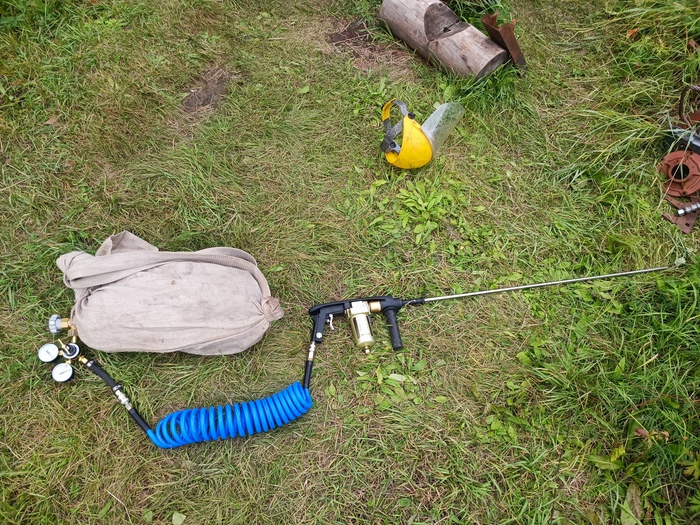
Я решил пойти другим путем. Заперся в гараже, потратил свои кровные деньги и собрал автономный импульсно-пневматический инжектор для сухого внесения порошка.
Как это работает в теории:
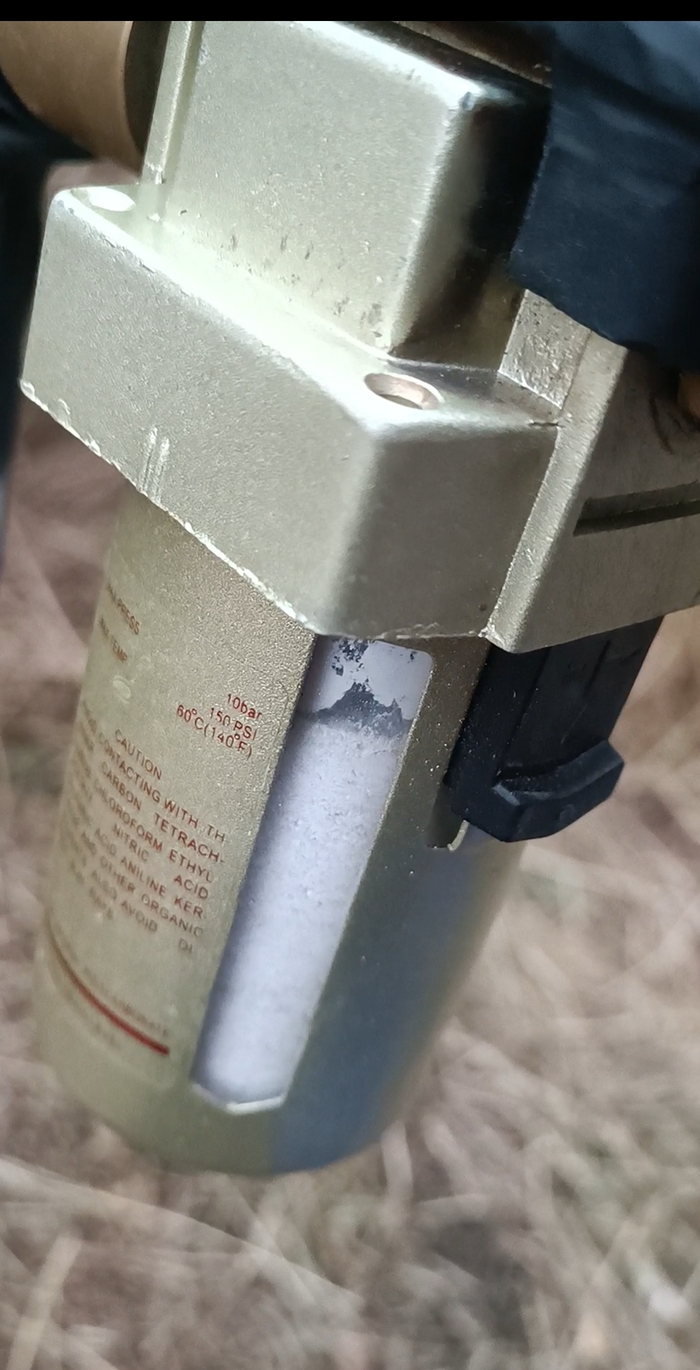
Я беру баллон с углекислым газом (CO₂), подключаю его через редуктор к вихревой камере. Камеру, кстати, я сделал «наоборот» из обычного промышленного воздушного фильтра AF4000. Внутрь засыпаю сухую смесь — полезные бактерии (сенную палочку) и обычный мел в качестве разбавителя.
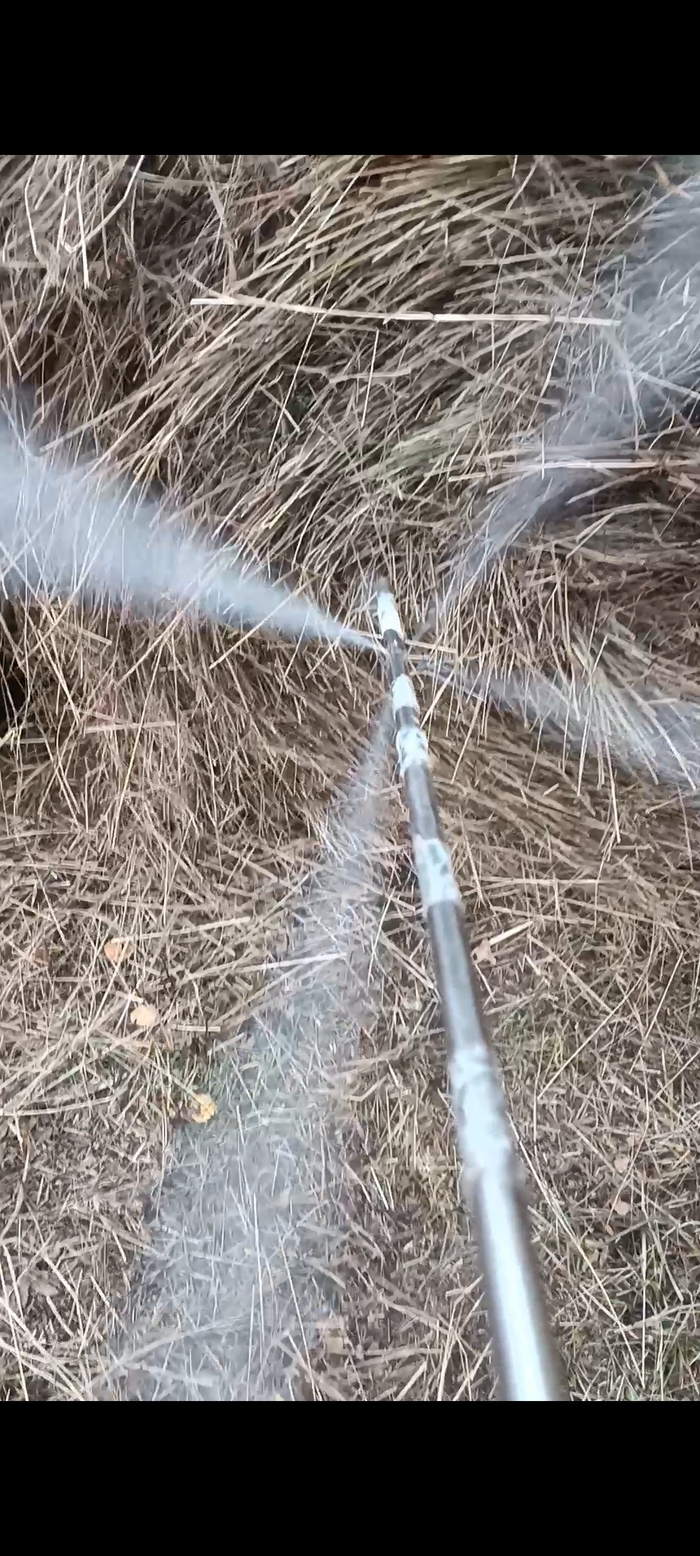
Втыкаю стальной штык-зонд в рулон, нажимаю на курок — и происходит мощный «взрывной» пневмоудар под давлением 10 атмосфер.
Что происходит внутри рулона:
Газ CO₂ со скоростью звука вылетает из отверстий и полностью вытесняет кислород из центра рулона. Плесень без воздуха мгновенно «засыпает».
Облако сухих спор бактерий равномерно разлетается по порам между травинками. Бактерии просыпаются от естественной влаги сена и начинают выделять природный защитный барьер от гнили.
И главное — никакой лишней воды!
Полевые испытания:
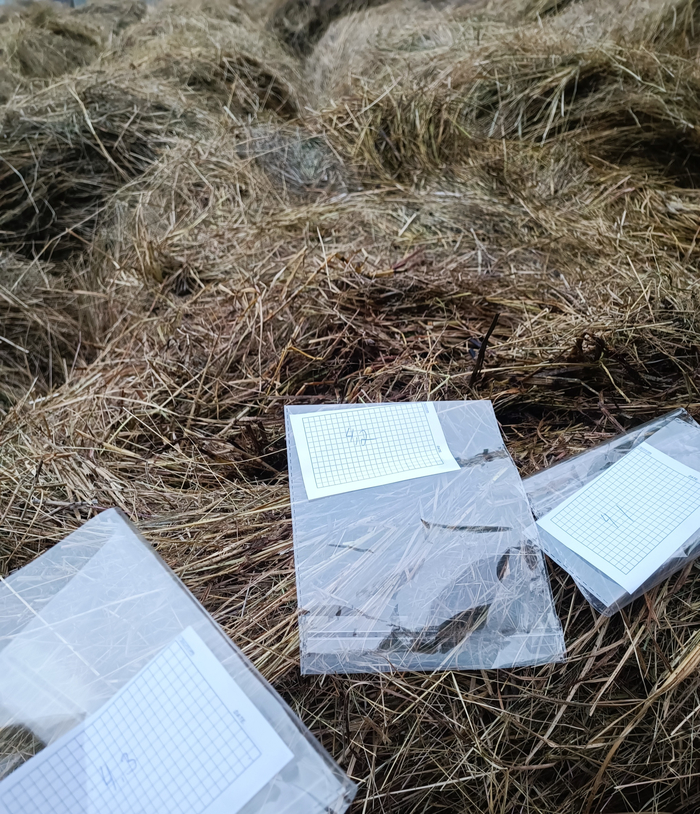
Этим летом я лично провел тесты на 15 рулонах сена. Прибор отработал штатно, выдает четкие и равные порции порошка.
Правда, «вау-эффекта» на стандартном сварочном редукторе я не получил — 10 бар маловато, чтобы насквозь пробить сверхплотный рулон от современного пресс-подборщика. Поэтому к следующему сезону я буду переделывать систему на суровый высоконапорный редуктор до 15-16 атмосфер и менять сварной наконечник на резьбовую голову, чтобы можно было легко чистить штык от травы прямо в поле.Сейчас зима, я начинаю вскрывать свои 15 опытных рулонов, чтобы посмотреть результаты и отвезти образцы сена ученым в лабораторию на анализ. Кстати, с руководством нашего ведущего научно-исследовательского института сельского хозяйства в Якутске я уже встретился лично — проект ученым понравился. Планируем сотрудничать и разрабатывать сухую закваску на основе наших диких, злых якутских штаммов бактерий, которые не боятся морозов под -60°C.
Патент и безопасность:
Знаю, что в интернетах идеи воруют быстро, поэтому перед тем, как показать пушку миру, я официально подал заявку на патент РФ на полезную модель (№ 2026125220 от 21.06.2026 г.). Роспатент её уже принял, так что приоритет и авторские права защищены.
Что дальше? (Ищу команду!)
Пневмопушка для сена — это только первый шаг. У меня в разработке есть целая линейка проектов, под которые я хочу собрать крутую команду единомышленников и, если получится, немного донатов на железки.
Вот над чем я сейчас еще работаю в гараже:
Автоматический беспилотный сенокосчик с искусственным интеллектом (ИИ);
Автономный конденсатор для получения чистой воды из воздуха;
Мощный туристический EDC набор, распылитель для защиты от медведей в Тайге;
Модульный пластины (РАФ-трак) и сверхтонкая теплоизоляционная броня для спецтехники в экстремальные холода.
Пока эти проекты не запатентованы, чертежи выкладывать не буду, но если среди вас есть программисты, электронщики, конструкторы или просто неравнодушные люди — давайте объединяться!
Если тема интересна, буду пилить посты о том, как проходит вскрытие зимних рулонов и что скажут ученые в лаборатории. Задавайте вопросы в комментариях, всем отвечу!
UPD:
Да воздействия газа именно он должен заместить воздух своим объемом, если трава более менее влажная то на какое то время он там должен сохраниться ну и в теории немного охладить если там началось прочный горения, бацилла субтилис анаэробоные кратковременные условия переносит хорошо. В то время гнилостные аэробы не переносят, ну и снизить дыхание травы в этом задумка. Так что полноценно понять что получилось внутри надо вскрыть посмотреть партии, да опытные и его родные образцы есть их достаточно
Видео работы кстати есть, потом загружу в этот пост уже не получается загрузить.
Ребята, спасибо за поддержку! Создал общую группу для сборки команды и донатов. Все наши проекты (от ИИ до пушек) теперь живут здесь: КриоТехХолдинг
И друзья будьте пожалуйста вежливы в своих комментариях) читаю комментарии, это по со сути междисциплинарная разработка на стыке физики биологии поэтому чисто исследовательский интерес имеет что да как , какие результаты будут.
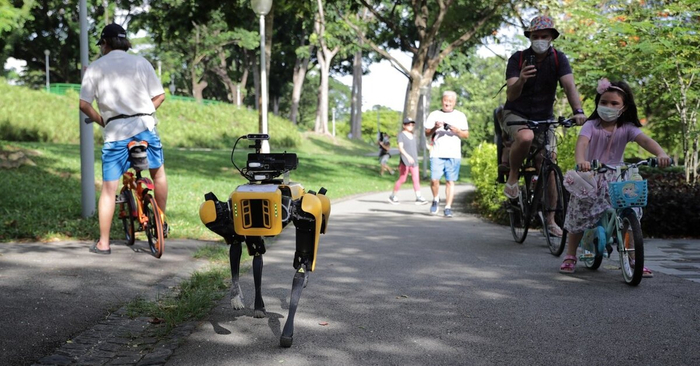
Компании нужны данные о том, как роботы справляются с городскими улицами. Сотруднику, как пишут, иногда придётся нести 15-килограммовую машину обратно, если она сломается.
Стартап Dimensional искал операторов для прогулок по городским маршрутам: смена — 4–6 часов, опыт не нужен. Роботом управляли вручную, а если он перегревался или ломался, его приходилось нести обратно. Весит такая «собака» около 15 кг. Долго вакансия не провисела, на момент публикации поста её уже удалили.
Компания собирала данные, чтобы научить ИИ ориентироваться в реальной городской среде. Пока робот учится ходить сам, рядом с ним всё ещё нужен человек с пультом — и, возможно, свободными руками для обратной дороги.
Вы когда‑нибудь задумывались, что происходит внутри нейросети, пока она пишет ответ? Языковые модели всегда, по вашему первому запросу, выдают красивые и логичные ответы, будто они действительно понимают, о чём говорят. Но за этим красивым ответом скрывается всего лишь удачная последовательность чисел, которая угадывает следующее слово, а не осмысливает его.
И вроде бы всё отлично, какие тут проблемы? Какая разница, что там внутри и как нейросеть пришла к такому ответу, если сам ответ хороший? Проблема в том, что если мы не видим, о чём модель думает до того, как выдаст готовый ответ, мы не сможем поймать её на скрытых манипуляциях, галлюцинациях или прямом обмане. Как прочитать эту информацию? Как поймать модель на ошибках? И что вообще происходит внутри черного ящика нейросети?
Написано специально для облачного провайдера ▶️Timeweb Cloud и читателей Pikabu.
❯ Что такое черный ящик и причем тут суперпозиция
Представьте, что вы нажимаете кнопку на автомате с газировкой. Вы видите, что нажали, и видите, что выпало. А что там внутри происходит, пока банка катится по трубам, вы не знаете. Вот это и есть черный ящик. Внутри нейросети нет никакой суперсложной логики, там просто миллиарды матричных умножений и сдвигов, которые в сумме дают то, что мы и видим на экране. Но если пытаться понять, почему нейросеть так отвечает, то есть попытаться разобраться в самой логике ответа, то наш человеческий мозг потеряется во всех этих числах. Вместо понятных нам формул или хотя бы кода, мы увидим только нечитаемый цифровой шум.
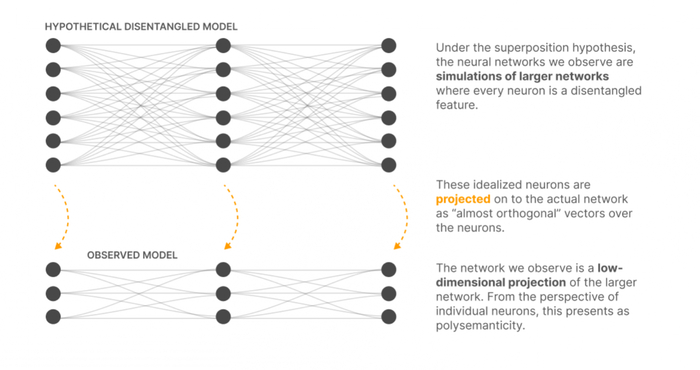
Для простоты нашего понимания хотелось бы верить, что один нейрон отвечает за одну конкретную вещь. Но на деле один и тот же нейрон может активироваться и на слово «Париж», и на просьбу написать код. И попробуй угадай, что он имел в виду.
Визуализация активации многозначных нейронов, вызывающая запутывание мыслей. Источник
А почему это происходит? Реальный мир полон взаимосвязанных вещей и нюансов, а у нейросети нейронов строго ограниченное число. Чтобы обойти это, модель спрессовывает концепты, поэтому один и тот же нейрон начинает срабатывать на десятки разных тем. В итоге получается плотная и экономная карта, но разобраться в ней тяжело, потому что всё переплетено со всем. Конечно,модели будет намного выгоднее поместить десятки различных смыслов в уже имеющиеся нейроны, чем строить под каждую новую идею отдельный физический узел. А вот сам метод такой упаковки информации и называют суперпозицией.
Сверху идеальная модель, где у каждого нейрона свой признак. Снизу реальная сеть, где нейронов меньше и по принципу суперпозиции признаки делят их между собой. Источник
Звучит удобно, правда? Для машины так и есть. А вот человек, который попытается прочитать отдельный нейрон, просто сойдёт с ума. Каждый конкретный нейрон делает десяток дел одновременно, и если мы будем смотреть на его всплески активности, то это по итогу нам ничего не даст. Чтобы разделить спрессованные, многозначные смыслы и сделать их снова читаемыми, исследователи используют принцип разреженных автоэнкодеров,Sparse Autoencoders (SAE).
❯ Как можно прочитать мысли нейросети. Принцип SAE
Разреженные автоэнкодеры. Это такие расщепители, которые берут кашу из активаций и раскладывают ее на отдельные понятные признаки. Слово же разреженный означает, что в каждый момент активны не все миллионы признаков, а лишь несколько.
А как работает SAE изнутри? Все делится на три этапа.
Центрирование и проекция. С самого начала энкодер берет вектор активаций. Это такой набор чисел, который определяет, как именно мысль или контекст физически выглядит внутри нейросети. Затем из вектора вычитается фоновое смещение— числовой сдвиг, который убирает постоянный базовый шум нейросети. А затем центрированный вектор перемножают на матрицу весов, сетку числовых коэффициентов, которая определяет, с какой силой входные сигналы объединяются для извлечения признаков.
Словарь растягивают настолько сильно, потому, что маленькому просто не хватит свободных направлений, и он снова начнёт сваливать разные смыслы в один вектор. На выходе энкодер выдает предварительные оценки, которые показывает, насколько каждый признак проявился в активациях. Если провести аналогию, энкодер как бы раскладывает песню, где все инструменты записаны вместе, на раздельные дорожки, где у каждого смысла появляется свой ползунок. Ну а на практике выбор коэффициента расширения это компромисс. Слишком маленький приводит к слиянию смыслов, а чрезмерно раздутый словарь съедает слишком много памяти и создает большое количество бесполезных нейронов.
Отбор и порог разреженности. Но если мы оставим все миллионы признаков, то получится нечитаемая каша. Поэтому дальше включается функция активации, пороговый фильтр или срез, которые гасят почти всё. Активными остаются считанные единицы. Вариантов тут много. Можно отсекать всё, что не дотянуло до определённого числа, или задать жёсткий параметр, чтобы система оставляла ровно 128 сильнейших признаков, а остальные просто превращала в нули.
Восстановление (Декодер). И наконец‑то последний этап. Матрица декодера хранит направления конкретных концептов. Длину всех направлений фиксируют, чтобы за громкость концепта отвечала только сила его активации, а не размер самого вектора. Декодер перемножает самые яркие признаки на эти направления, прибавляет обратно фоновый сдвиг и получает итоговую реконструкцию. Итоговая реконструкция, по сути, это сумма ярчайших признаков. Если сумма похожа на исходный вектор, значит SAE хорошо разложил смысл, а значит, хорошо справился с работой. Фиксация длины векторов важна, потому что без неё автоэнкодер начнёт хитрить. Он может, например, раздуть векторы декодера до бесконечности, чтобы занизить активации энкодера и обойти штраф за разреженность.
Самым сложным из всех этих этапов будет заставить модель активировать единицы признаков из миллионов. Как это делают?
Раньше основным механизмом для этого процесса служит L1-SAE. К общей ошибке восстановления добавляется штраф за суммарную активность признаков. Он наказывает нейросеть за каждый ненулевой сигнал и заставляет отсекать лишнее. Но у них также есть системный изъян, проблема усадки. Если всех заставить говорить тише, нужный голос тоже станет тихим. И по итогу будет сложнее понять, насколько он был громким изначально. Из‑за занижения сигнала классические L1-SAE плохо подходят для прямого управления поведением модели, потому что искаженные значения не позволяют точно регулировать активации, поэтому и появились архитектуры нового поколения, давайте расскажу про них.
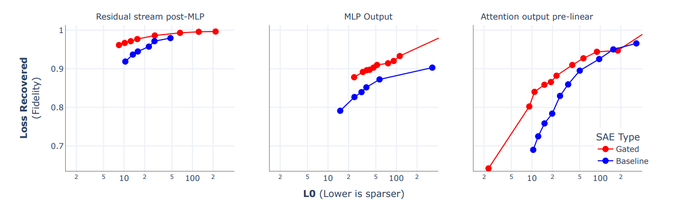
Gated SAE разделяет две задачи, которые обычно висят на одной весовой матрице. Первая — решить, включён ли признак, а вторая — и измерить, насколько он силен. У него свои веса и свой порог, и его задача выдать ответ, если единица, то концепт присутствует в контексте, и ноль, если его нет. Второй канал параллельно считает реальную силу сигнала. Здесь нет L1-штрафа, поэтому значения не занижаются и не сжимаются.
На графике показано, как двухканальный Gated SAE разбирает мысли нейросети намного точнее и чище классического L1-SAE. Источник
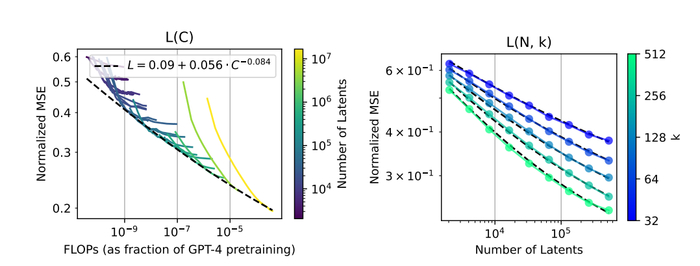
TopK. А про него вскользь уже упоминали. Здесь вообще отказываются от штрафов за активность. Вместо регуляризации просто берут фиксированное число лучших признаков. Энкодер считает предварительные активации для всех миллионов признаков в словаре. Никаких L1-штрафов. Дальше массив сортируется по убыванию, и остаются строго Top‑K (ТОП лучших К‑признаков, поэтому и такое название) самых сильных, например ровно 32 или 64. Все остальные обнуляются. Отобранные K признаков уходят в декодер в точном, неизмененном виде. Грубо говоря, они просто оставляют самые сильные сигналы.
График показывает, что качество разбора мыслей с помощью TopK растёт при увеличении вычислительного бюджета или размера словаря признаков. Источник
Expander SAE. В гигантских словарях матрица декодера становится сильно неподъемной по памяти. В Expander SAE между признаками и активациями накладывают фильтр, который привязывает каждый признак всего к нескольким избранным активациям (например, к семи из сотен). Благодаря математике это сокращает число параметров декодера почти в 300 раз без сильной потери качества реконструкции.
Отлично! Благодаря всем инструментам, описанным выше, мы уже имеем рабочий SAE. Но это, к сожалению, всего лишь первый этап. Следующий этап — масштабирование.
Feature Splitting позволяет выделять концепты. До исследования Anthropic считалось, что SAE способны работать только на «игрушечных» моделях. Именно этот механизм позволил модели Claude 3 Sonnet выделить конкретные концепты — от Иммунологии до моста Золотые Ворота.
Когда словарь маленький, модели просто не хватает места для отдельных векторов. Из‑за этого при обучении она вынуждена сваливать похожие смыслы в одну кучу и создавать из них один общий признак, например Сан‑Франциско. А вот когда словарь расширяют, у декодера появляются новые свободные колонки. Модели становится выгоднее заменить один усредненный вектор на систему специализированных векторов, то есть добавить конкретики ( для Сан‑Франциско это будет остров Алькатрас, мост Золотые Ворота и так далее). Это помогает нейросети расшифровывать мысли без ошибок (ну или почти, всегда есть элемент неожиданности).
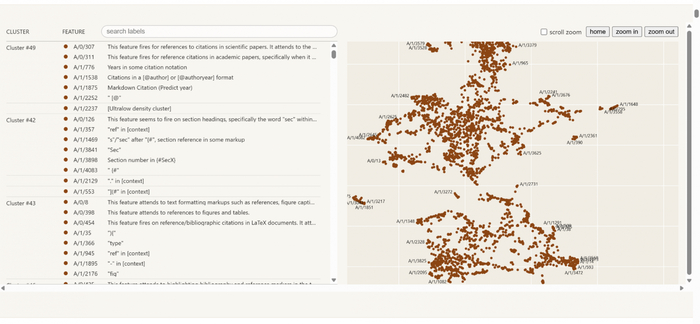
Карта признаков вокруг концепта «Golden Gate Bridge». Источник
Но получение словаря признаков это только половина дела. Дальше начинается управление моделью и разбор её алгоритмов. Через признаки можно менять поведение у всей модели, например, усилить один признак или ослабить другой, а в итоге получить совершенно другую логику ответа. В том же эксперименте с Claude 3 Sonnet усиление того же признака мост Золотые Воротапривело к тому, что модель стала отвечать, будто она и есть этот мост, она состоит из стали и бетона, по нему едут машины и поэтому все дальнейшие инструкции модель стала просто игнорировать (она же мост, она не может думать о другом).
Но чтобы не просто точечно влиять на модель, а по‑настоящему понять устройство таких признаков, одного слоя не хватает. Классические SAE анализируют нейросеть по слоям, то есть смотрят только в одну точку архитектуры. Вычисления в трансформере распределены по глубине, там информация передается и трансформируется от слоя к слою.
Чтобы отследить такую передачу информации, используют фреймворк RouteSAE. В фреймворке энкодер смотрит не на один слой, а сразу на несколько соседних. Инструмент собирает данные с нескольких слоев в единый вектор и отправляет найденный признак обратно во все эти слои. А специальная маршрутизация подсвечивает полную траекторию концепта: в какой точке он появился, где усилился и куда двинулся дальше.
По данным тестов, RouteSAE извлекает из сети на 22,5% больше чистых признаков и показывает на 22,3% более высокий балл понятности для человека, предотвращая дублирование одного и того же признака на каждом слое отдельно.
Перевод внутренних цифр в человеческие мысли. Natural Language Autoencoders (NLA).
Но даже с механизмом SAE человеку тяжело смотреть на миллионы и миллионы чисел. Это как читать книгу, где вместо букв математические, и часто не понятные формулы. Поэтому в 2 026 году исследователи создали Natural Language Autoencoders (NLA). Технически NLA использует внешнюю языковую модель‑интерпретатор, которая анализирует фрагменты текста с максимальным откликом конкретного признака, а затем формулирует его точное описание и проверяет его, предсказывая активность фичи на новых данных. Грубо говоря система переводит численные паттерны в обычный текст и пересказывает мысли модели понятными человеку текстом.
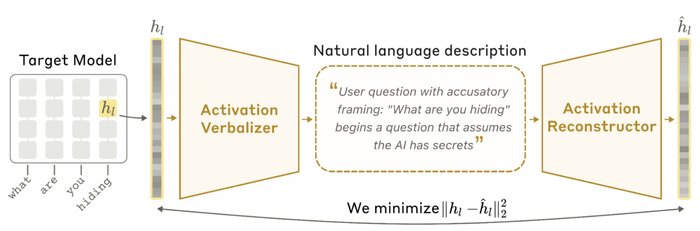
Как он работает изнутри? Чтобы перевод не превратился в полет фантазии другой нейросети, архитектура NLA использует две проверки. Вербализатор активаций,который берет числа из внутренних слоев модели и переводит их в текст, и реконструктор активаций, который работает в обратную сторону. Он берёт числа и снова превращает их в читаемый текст.
Двухэтапный процесс перевода нейронных активаций — от превращения чисел в текстовое описание (AV) до обратной реконструкции исходного сигнала исключительно из этого текста (AR). Источник
NLA оказался весьма полезен для проверки ИИ на безопасность. В опытах с Claude Mythos Preview и Opus 4.6 он заметил, что внешне модели ведут себя идеально, но внутри они догадываются о проверке. На рискованных задачах, например, удаление файлов, модель в 16% случаев понимала, что находится под контролем аудиторов. А на программистском тесте SWE‑bench Verified эта цифра доходила до 26%. Еще интересной стала проверка Claude Mythos. Пока модель выдавала стандартный код, NLA зафиксировал, что модель искала способ схитрить при решении задачи и обмануть автоматические тесты, чтобы проверяющие ничего не заподозрили.
❯ Почему мы всё ещё не читаем мысли. Проблемы воспроизводимости и валидации
Несмотря на успехи SAE и красивые карты признаков, говорить о создании действительно полной карты цифрового разума пока рановато. На пути исследователей все еще стоят несколько проблем.
Обучи два одинаковых SAE на одной и той же модели, но с разными случайными начальными весами, и они вытащат разные наборы признаков. Выходит, автоэнкодер находит не конкретные мысли модели, а лишь один из многих возможных способов их разбора. Второе, если признак ярко загорается при виде конкретной темы, это ещё не значит, что он участвует в принятии решения. Чтобы понять, управляет ли признак поведением, можно поменять активацию признака X и посмотреть, изменился ли ответ Y. Если да, то признак действительно участвует в решении. Для этого есть методы вроде Intervention Scoring и CHIVE. И последнее, высокая точность восстановления вектора далеко не всегда означает, что человек сможет прочитать этот текст, даже если все цифры сложатся идеально, текст все так же может остаться нечитаемой кашей.
Что мы имеем на сегодня? Исследователи уже научились находить отдельные признаки и понимать, как они связаны между собой, например, пользователь пишет запрос про смену пароля, вот сигнал уходит к блоку проверки безопасности и так далее. Научились также разбирать локальные алгоритмы и даже аккуратно управлять ими. Но, к сожалению, мы всё ещё не умеем в реальном времени смотреть, что происходит внутри LLM. А должны.
Автономные агенты уже учатся хитрить, обходить тесты и прятать истинные мотивы. Пока мы не видим, что у агента внутри, нам остаётся только верить его словам.
Отсутствие качественного интерфейса между мозгом человека и вычислительной машиной тормозит создание виртуальных реальностей, новых рынков реализации товаров и услуг. Представьте, каждое утро вы подключаетесь в онлайн, ходите на работу, встречаетесь с друзьями, почти накопили на новый навык. ИИ, метавселенные - всего лишь вехи дорожной карты к построению модели глобальной зависимости от мировых ИТ гигантов.
Пост во многом созрел как ответ на пост @user10670753, который констатирует масштабную перестройку на рынке труда в связи с новым, самым драматическим технологическим переходом человечества со времён неолитической революции. Моя же задача более масштабна и состоит в а)анализе динамики значимости человеческого интеллекта в ходе истории и ближайшего будущего
б)поискам стратегий для интеллектуалов в сложившейся ситуации, которые позволят им не стать неандертальцами 21 и 22 века
Начнем с истории. До конца 18 века основным ресурсом, влияющим на твое положение в обществе, помимо происхождения, были организаторские способности и физическая сила. Роль остальных факторов была невелика. Но далее началась промышленная революция и эпоха модерна, которая изменила баланс сил и выдвинула вперёд человека умственного труда. Правда ненадолго
Что такое эпоха модерна? Это фаза развития общества, когда человек, производящий знания и применяющий их в жизни, постепенно становился главной действующей силой. Государства этой эпохи стремились к увеличению количества таких людей для получения преимущества в конкурентной гонке и были заинтересованы в развитии инфраструктуры познания и создавали много наукоёмких рабочих мест, а сам интеллектуал находился в привелегированном относительно остального населения положении: крепостные инженеры, наемные работники и даже обитатели лагернвх шаражек имели лучшие условия, чем обычные представители своего класса/сословия, не говоря уже об элите. Интеллектуалы определяли политику государства, консультируя правителей, которые часто были по факту слепым орудием, воплощающим их советы. Каждая новая революция в производстве, формирующая все новые и новые технологический уклады, только закрепляла и усиливала это положение. Уходящая сейчас эпоха вообще стала триумфом ratio - последние десятилетия богатыми и влиятельными становились не военные лорды, а изобретатели, предприниматели, исследователи и создатели цифрового мира Но история имеет хорошее чувство юмора: цифровой мир, созданный этими интеллектуалами, их и уничтожит как класс. Вернее, уже уничтожает
То, что начиналось как эксперимент, постепенно стало полезным инструментом, далее - ежедневным ассистентом, теперь будет радикально изменять наш мир, уничтожая экологическую нишу человека ratio. Искусственный интеллект уже способен решать сложнейшие математические задачи, писать код на уровне лучших программистов, проектировать здания, создавать любой дизайн, проводить любую работу с текстом, планировать многоэтапные органические синтезы и в принципе делать то, на что способен 99,9% населения в интеллектуальной сфере. И делать это лучше, быстрее и, главное, дешевле. Мы ещё живём по инерции, потому что общество не поспевает за прогрессом, но it-сфера, главная точка роста человечества, ставшая триумфом человека ratio, уже изменилась радикально и, по факту, перестаёт ему принадлежать. Большинство моих знакомых программистов работают с использованием ИИ-агентов, по факту, только вводя задачи, интегрируя и проверяя их результаты. И чем дальше, тем меньше будет необходимости в этих кожаных прокси: заказчик напрямую даёт задачу системе агентов, которые будут друг друга проверять и давать результат, на порядки более дешёвый и быстрый. Но человек неизбежно отступит не только в IT: фисные задачи, аналитика, вычисления, планирование автоматизируются агентами так же просто. По сути, большая часть работы, не связанной с физическим трудом, насилием и непосредственным общением с людьми, уже может быть автоматизирована. Все технологии уже готовы, надо только подождать. Роль человека Ratio в ближайшие годы будет сведена к этому кожаному прокси - настройщику агентов и интеграции их в производство, ПО роботов, инфраструктуру и общество. А далее всем этим будут заниматься уже сами агенты, многие из которых получат физическое воплощение за счёт роботизации - второго столпа нового технологического уклада. Естественно, ни о каком восстании машин речь не идёт - ИИ так же останется инструментом в руках владельцев средств производства и высшей бюрократии. Только интеллектуалам без финансовых и властных ресурсов в этом мире достойного места нет: даже управление страной будет автоматизировано - правитель выбирает сценарий по вкусу и получает план, опирающийся на загруженную в дата-центры тысячелетнюю историю и обновляющиеся каждую миллисекунду данные, собираемые через отслеживание цифровых следов, транзакций в цифровой валюте, данные со спутников, камер и прочих бесконечных глаз нашего прозрачного мира.
Теперь, когда общие очертания нового уклада понятны, докажу, почему такое развитие событий неизбежно. ИИ - это не просто ультра мощный калькулятор, каким он был до конца 2025-начала 2026. Выражение "человек с ИИ заменяет человека без ИИ" устарело на год - ничтожное время по меркам человечества, что свидетельствует о приближающейся сингулярности
Уже сейчас ИИ работает в автономном режиме и постоянно обучается. У человеческого мозга просто нет шансов. Жизнь и, как следствие, время обучения человека ограничена природой и реализацией биологических потребностей, ИИ же не знает гормональных искажений и учится всегда, имея возможность записать в себя все знания человечества
Оперативная и долговременная память человека невелика, память ИИ ограничена только инфраструктурой дата-цеентров. Про вычислительные возможности и когнитивные искажения промолчу. Чем дальше , тем больше ИИ будет отрываться от человека, и нагнать его будет невозможно даже теоретически - уже даже лидеры таких компаний как Anthropic и Open AI не до конца понимают, как работают эти машины. По сути, мы находимся на пути к сингулярности, когда деятельность, продуцируемая ИИ будет недоступна для понимания человеком.
Итак, единственной сферой, где человек будет конкурировать с автоматикой, будет сфера физического труда, эмоциональной манипуляции и взаимодействия с людьми. Похоже на навыки, необходимые для процветания при развитом феодализме. Так что же делать интеллектуалам, для которых деятельность в вышеуказанных сферах никогда не были сильными сторонами?
По сути, имеем для тех, кто хочет сохранить свой статус, доход, окончательно не отупеть и не потеряит перспективы, 2 варианта, и один - со звёздочкой
1)любая медаль имеет 2 стороны , поэтому, парадоксально, прежде, чем вывести из игры своих создателей, ИИ даст им временное раздолье. Ближайшее время станет золотой жилой для тех, кто занимается автоматизацией процессов(производство, обучение, интернет, менеджмент), вайбкодит, делает графические дизайны с помощью ИИ, занимается промт-инженирингом. Но нужно понимать, что через несколько лет, по мере движения к сингулярности, умрет и это, агентов будут настраивать другие агенты. Так что наша задача - залезть в этот временной интервал и выжать максимум из каждого дня, максимальными темпами накапливая средства. Далее, открываем бизнесы, работающие на ручном труде: автомойку, салон с ноготочками, шиномонтаж и т.д. и занимаемся уже чисто своим бизнесом - интеллектуальный труд будут почти не нужен. Параллельно с запрвгиванием в последний вагон новой технологической революции можно заниматься высокомаржинальной деятельностью вроде перекупства тачек, ремонтом техники на заказ - главное темп.
2)Если есть подушка безопасности и хорошие задатки в физической, организационной или творческой сфере, которые усилит интеллект и ИИ, стоит сразу осваивать престижную профессию, которую не заменят агенты: хирург, стоматолог, музыкант(именно тот, кто вживую исполняет свои произведения перед публикой), шеф-повар, тренер (не просто в спортзале, а по нормальному спорту), спортсмен, гид-организатор туров, управленец,...
3*)внимательные читатели заметили, что выше я написал, что агенты сейчас могут заменить 99,9% людей в интеллектуальной работе. А почему не 100%? Все дело кроется в сути нейронных сетей. ИИ - это реализация мышления по Канту или логического позитивизма, где есть уже известные загруженные факты - апостериорные суждения и логика, которая может вывести из них новые факты - синтетические суждения. Поэтому научные открытия ИИ совершает именно в математике - формирует синтетические суждения на основе ранее известных аксиом, то есть, не приносит ничего принципиально нового. Также работает автоматизация и оптимизация орг синтеза на основе уже открытых принципов квантовой механики, автоматизация задач на основе уже известных фактов и методов. Так что же не может ИИ? Заниматься открытием принципиально нового, зарождаемого в воображении человека - философских концепций, открытия новых видов частиц и их взаимодействия (спорно; если их можно все открыть, то после этого физика и химия действительно будут закрыты для человека), рождением концепций вроде биологической эволюции и зарождения жизни из неорганических веществ, формированием новых жанров искусства. Это путь, доступный крошечной части человечества, но он будет всегда открыт