Форматирование целой папки документов Word кажется простой задачей: изменить несколько стилей, сохранить каждый файл — и готово. На практике документы разных авторов часто сочетают стили абзацев, вручную заданное форматирование и отдельные определения нумерации списков. Изменения одного лишь стиля может оказаться недостаточно: часть текста сохранит прежний вид.
В этом руководстве показано, как с помощью python-docx задать единые шрифт, размер и цвет для выбранных стилей абзацев в нескольких файлах .docx. Сначала мы рассмотрим четыре подводных камня, влияющих на результат, а затем объединим решения в одном скрипте пакетной обработки.
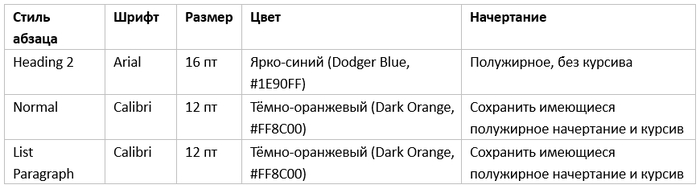
В примере используются следующие правила:
Контрастные цвета позволяют легко заметить изменения. Перед использованием скрипта в рабочем процессе замените их цветами, принятыми в ваших документах.
1. Подводный камень: изменение стиля не всегда меняет существующий текст
Естественный первый шаг — изменить стиль абзаца:
h2 = doc.styles['Heading 2']
h2.font.name = 'Arial'
h2.font.size = Pt(16)
h2.font.color.rgb = RGBColor.from_string('1E90FF')
Этот код изменяет определение стиля. Текст, наследующий эти свойства от данного стиля, сможет использовать новые настройки. Однако фрагмент текста (run), для которого явно задан шрифт или размер, может сохранить собственные настройки.
Например, абзац может иметь стиль Heading 2, а его текст — вручную заданный шрифт Times New Roman размером 11 пт. Изменение Heading 2 не удаляет автоматически такие переопределения на уровне фрагментов текста. На внешний вид также могут влиять символьные стили и другие наследуемые свойства.
Если после выделения текста в Word и нажатия на его стиль абзаца появляется новое форматирование, это полезный признак того, что существующее форматирование стоит изучить внимательнее. Однако это не доказывает, что документу требуется отдельное «обновление стиля» или что повторное назначение того же стиля в Python воспроизведёт поведение Word.
В данном рабочем процессе скрипт изменяет и определение стиля, и сам текст в соответствующих абзацах. Он явно задаёт шрифт, размер и цвет для каждого фрагмента текста, чтобы эти свойства не зависели исключительно от наследования.
Вспомогательная функция настройки шрифта также задаёт XML-атрибуты шрифтов для ASCII, других символов, охватываемых hAnsi, восточноазиатского текста и сложных систем письма, а также удаляет соответствующие ссылки на шрифты темы на том же уровне. Так нужная гарнитура задаётся явно; это не означает, что стили заголовков в принципе игнорируют font.name.
Указание имени шрифта не устанавливает его и не гарантирует наличия всех необходимых символов. При необходимости Word по-прежнему может подставить другой шрифт.
2. Подводный камень: очистка форматирования может изменить больше, чем нужно
Распространённый обходной путь — сбросить свойства шрифта у всех фрагментов текста в документе. Это может удалить значимые выделения и изменить текст за пределами нужной области обработки.
Вместо этого скрипт обрабатывает только абзацы, которым действительно назначен стиль Heading 2, Normal или List Paragraph. Он задаёт свойства, предусмотренные стандартом оформления, и не затрагивает остальные.
Для Heading 2 полужирное начертание явно включается, а курсив отключается. Для Normal и List Paragraph сохраняются существующие настройки полужирного начертания и курсива. Скрипт также сохраняет текст, гиперссылки, интервалы абзацев и другие свойства, которые он явно не изменяет. Текст гиперссылки внутри подходящего абзаца получает заданные шрифт, размер и цвет, при этом сама ссылка сохраняется.
Это различие важно и для заголовков, оформленных вручную. Абзац, который выглядит как заголовок, но использует Normal, обрабатывается как Normal. Скрипт не определяет структуру документа по размеру шрифта или полужирному начертанию. Таким заголовкам нужно заранее назначить правильный стиль либо обработать их на отдельном этапе классификации.
В python-docx к встроенным стилям следует обращаться по английским именам, даже если интерфейс Word отображает их локализованные названия. Для пользовательских стилей используются их фактические имена, сохранённые в документе. Если в ваших документах применяются пользовательские стили основного текста или заголовков, добавьте их в правила, не предполагая, что они соответствуют встроенным стилям.
3. Подводный камень: абзацы основного текста не включают текст таблиц
Перебор doc.paragraphs не охватывает абзацы внутри ячеек таблиц. Поэтому скрипт может изменить основной текст документа, оставив текст таблиц с исходным форматированием на уровне фрагментов.
Решение — обходить и абзацы, и таблицы. Для каждой таблицы нужно посетить её ячейки и рекурсивно обработать вложенные таблицы. Скрипт отслеживает уже посещённые элементы ячеек, поскольку объединённые ячейки могут встречаться несколько раз при обращении к таблице через строки и ячейки.
Каждый подходящий абзац внутри ячейки получает такое же форматирование фрагментов текста, как и подходящий абзац в основном тексте. Например, абзац Normal с явно заданным размером шрифта 8 пт будет изменён на 12 пт.
Обход охватывает основную часть документа и её таблицы. Он не обрабатывает верхние и нижние колонтитулы, текстовые поля, обычные и концевые сноски. Абзацы и фрагменты текста внутри отслеживаемых исправлений также не входят в поддерживаемую область этого рабочего процесса.
4. Подводный камень: у номеров списка есть собственные свойства шрифта
Нумерованный список содержит два отдельных объекта форматирования: текст абзаца и автоматически создаваемый номер, например 1., 2. или 3..
Изменение List Paragraph или его фрагментов текста не обязательно меняет номер. Определения нумерации могут задавать собственные свойства шрифта для каждого уровня списка.
Скрипт определяет идентификатор нумерации абзаца (numId) и его уровень (ilvl), включая значения, унаследованные по цепочке стилей абзаца. Затем он изменяет свойства фрагмента текста уровня нумерации через переопределение уровня конкретного списка в numbering.xml.
Если переопределение уровня отсутствует, скрипт копирует соответствующий абстрактный уровень в конкретный список, прежде чем изменить свойства шрифта. Это сохраняет формат номера, его шаблон, отступы и другие существующие настройки уровня. Имеющиеся переопределения начального значения нумерации также сохраняются.
В обычных нумерованных списках номер получает те же шрифт, размер и цвет, что и текст абзаца. Для символьных маркеров сохраняется исходная гарнитура: замена шрифта Symbol или Wingdings может изменить символ либо привести к появлению квадрата вместо отсутствующего символа. Размер и цвет маркера при этом обновляются.
Следует учитывать два ограничения:
Один уровень конкретной нумерации используется всеми абзацами с одинаковыми numId и ilvl. Поэтому изменение его форматирования может повлиять на другие абзацы, использующие этот уровень, в том числе на абзацы со стилями, не выбранными для обработки.
Скрипт отклоняет маркеры в виде изображений, косвенные ссылки на стили нумерации и конфликтующие правила форматирования для одного общего уровня. Вместо сохранения частично отформатированного результата он сообщает об ошибке обработки файла.
Эти ограничения позволяют сохранить пример достаточно простым. Документам с более сложной структурой нумерации потребуется дополнительная обработка.
Полный скрипт пакетного форматирования
pip install "python-docx>=1.2.0"
Сохраните следующий код в файле word_batch_formatting.py. Скрипт читает документы из E:\Documents\input и сохраняет их в E:\Documents\output, создавая папку вывода при необходимости. Каждый выходной файл сохраняет исходное имя. Словарь RULES содержит шрифт, размер и цвет для каждого целевого стиля.
from pathlib import Path
from copy import deepcopy
from docx import Document
from docx.oxml import OxmlElement
from docx.oxml.ns import qn
from docx.shared import Pt, RGBColor
from docx.text.run import Run
INPUT_FOLDER = Path(r'E:\Documents\input')
OUTPUT_FOLDER = Path(r'E:\Documents\output')
RULES = {
'Heading 2': ('Arial', 16, '1E90FF'),
'Normal': ('Calibri', 12, 'FF8C00'),
'List Paragraph': ('Calibri', 12, 'FF8C00'),
}
def set_font(obj, rule, heading=False, bullet=False):
name, size, color = rule
obj.font.size = Pt(size)
obj.font.color.rgb = RGBColor.from_string(color)
if heading:
obj.font.bold, obj.font.italic = True, False
if not bullet:
obj.font.name = name
fonts = obj._element.get_or_add_rPr().get_or_add_rFonts()
for slot in ('ascii', 'hAnsi', 'eastAsia', 'cs'):
fonts.set(qn('w:' + slot), name)
fonts.attrib.pop(qn('w:' + slot + 'Theme'), None)
clr = obj._element.get_or_add_rPr().find(qn('w:color'))
for key in ('themeColor', 'themeTint', 'themeShade'):
clr.attrib.pop(qn('w:' + key), None)
def paragraphs(container, seen=None):
seen = set() if seen is None else seen
for p in container.paragraphs:
yield p
for table in container.tables:
for row in table.rows:
for cell in row.cells:
if cell._tc not in seen:
seen.add(cell._tc)
yield from paragraphs(cell, seen)
def numbering(p):
num_id = level = None
sources, style, seen = [p._p.pPr], p.style, set()
while style is not None and style.style_id not in seen:
seen.add(style.style_id)
sources.append(style.element.pPr)
style = style.base_style
for prop in sources:
if prop is None or prop.numPr is None:
continue
np = prop.numPr
if num_id is None and np.numId is not None:
num_id = np.numId.val
if level is None and np.ilvl is not None:
level = np.ilvl.val
return num_id, level, seen
def format_number(root, p, rule, changed):
num_id, level, styles = numbering(p)
if num_id in (None, 0):
return
num = root.find(f"w:num[@w:numId='{num_id}']", root.nsmap)
abstract_id = num.find(qn('w:abstractNumId')).get(qn('w:val'))
abstract = root.find(f"w:abstractNum[@w:abstractNumId='{abstract_id}']", root.nsmap)
if abstract.find(qn('w:numStyleLink')) is not None:
raise ValueError('Косвенные стили нумерации не поддерживаются')
if level is None:
matches = [x for x in abstract.findall(qn('w:lvl'))
if x.find(qn('w:pStyle')) is not None
and x.find(qn('w:pStyle')).get(qn('w:val')) in styles]
level = int(matches[0].get(qn('w:ilvl'))) if matches else 0
key = (num_id, level)
if key in changed:
if changed[key] != rule:
raise ValueError('Для одного уровня нумерации заданы конфликтующие правила форматирования')
return
override = num.find(f"w:lvlOverride[@w:ilvl='{level}']", root.nsmap)
if override is None:
override = OxmlElement('w:lvlOverride')
override.set(qn('w:ilvl'), str(level))
num.append(override)
lvl = override.find(qn('w:lvl'))
if lvl is None:
lvl = deepcopy(abstract.find(f"w:lvl[@w:ilvl='{level}']", root.nsmap))
override.append(lvl)
fmt = lvl.find(qn('w:numFmt')).get(qn('w:val'))
if lvl.find(qn('w:lvlPicBulletId')) is not None:
raise ValueError('Маркеры в виде изображений не поддерживаются')
old = lvl.find(qn('w:rPr'))
run = Run(OxmlElement('w:r'), None)
if old is not None:
run._r.append(deepcopy(old))
set_font(run, rule, p.style.name == 'Heading 2', bullet=fmt == 'bullet')
if old is not None:
lvl.remove(old)
lvl.append(run._r.rPr)
changed[key] = rule
def format_document(src, dest):
doc = Document(src)
for name, rule in RULES.items():
if name in doc.styles:
set_font(doc.styles[name], rule, name == 'Heading 2')
changed = {}
for p in paragraphs(doc):
if p.style.name not in RULES:
continue
rule = RULES[p.style.name]
for item in p.iter_inner_content():
for run in ([item] if isinstance(item, Run) else item.runs):
set_font(run, rule, p.style.name == 'Heading 2')
format_number(doc.part.numbering_part.element, p, rule, changed)
doc.save(dest)
if __name__ == '__main__':
if not INPUT_FOLDER.is_dir():
raise SystemExit(f'Папка входных файлов не существует: {INPUT_FOLDER}')
OUTPUT_FOLDER.mkdir(parents=True, exist_ok=True)
for src in sorted(INPUT_FOLDER.glob('*.docx')):
if src.name.startswith('~$'):
continue
dest = OUTPUT_FOLDER / src.name
if dest.exists():
print(f'Пропущено: {dest.name}')
continue
try:
format_document(src, dest)
print(f'Сохранено: {dest.name}')
except Exception as error:
print(f'Ошибка: {src.name}: {error}')
Запустите скрипт командой:
Например, из E:\Documents\input\report.docx будет создан E:\Documents\output\report.docx. Исходный файл останется доступным для сравнения. Поскольку скрипт просматривает только папку входных файлов, созданные документы не обрабатываются повторно. Пути к этим двум папкам должны различаться.
Временные файлы блокировки Word и уже существующие выходные файлы пропускаются. Чтобы повторно создать документ после изменения правил, удалите его предыдущую копию из папки вывода. Ошибки сообщаются отдельно для каждого файла, после чего скрипт продолжает обработку остальных файлов.
Если папка входных файлов отсутствует, скрипт сообщает об этом до начала обработки. Если в ней нет подходящих файлов, выходные файлы не создаются. Целевые стили, отсутствующие в документе, также пропускаются, а не создаются заново. Перед запуском пакетной обработки проверьте папку и имена стилей.
Результат форматирования:
На сравнении ниже показан документ до и после форматирования. Текст Heading 2 использует Arial размером 16 пт и синий цвет, а основной текст, содержимое таблиц и текст нумерованных списков — Calibri размером 12 пт и оранжевый цвет. Номера списка оформлены так же, как его текст.
Проверьте результаты перед обработкой всей папки
Начните с нескольких документов, отражающих разнообразие файлов в вашей папке. Проверьте абзац Heading 2 с вручную переопределённым шрифтом, абзац основного текста с полужирным или курсивным выделением, ячейку таблицы и нумерованный список.
Ожидаемый результат — единые шрифт, размер и цвет для трёх целевых стилей и их текста; Heading 2 при этом становится полужирным, без курсива. Фрагменты текста в абзацах других стилей напрямую не изменяются, хотя стили, основанные на изменённом целевом стиле, могут унаследовать его изменения. Числовые маркеры списков используют заданный шрифт, а символьные маркеры сохраняют исходную гарнитуру.
Этот подход намеренно записывает свойства шрифта непосредственно в подходящие фрагменты текста. Так текущее форматирование задаётся явно, но последующие изменения стилей могут не проявиться из-за новых настроек на уровне фрагментов. Если дальнейшее оформление должно полностью управляться стилями, используйте отдельную стратегию очистки, которая удаляет только соответствующие переопределения и проверяет оставшееся наследование.
Скрипт использует низкоуровневый доступ к XML для работы со шрифтами и нумерацией, поэтому сохраняйте исходные файлы и проверяйте результат после обновления библиотеки. Он предлагает практический рабочий процесс для поддерживаемых структур документов, а не полноценный механизм форматирования для всех возможностей Word.
Источники