Типичная история: человек прошёл пару видеоуроков, обучил модель на игрушечном датасете и застрял. Дальше непонятно, что делать. Ниже план, который помогает довести первый проект до конца.
Выходные 1. Задача и данные
Выберите простую задачу: определить фрукт по фото, предсказать, уйдёт ли клиент, отличить спам от нормального письма. Главное, чтобы её можно было объяснить одним предложением. Найдите или соберите данные и разберитесь, что в них есть: пропуски, дубли, странные значения.
Выходные 2. Первая модель
Разделите данные на обучающую и тестовую части. Обучите самую простую модель, например дерево решений. Не гонитесь за качеством: важно получить рабочий цикл «данные, модель, метрика».
Выходные 3. Разбор ошибок
Посмотрите, на чём модель ошибается. Обычно причина в данных, а не в алгоритме. Улучшите данные и сравните результат с первой версией.
Выходные 4. Превратите эксперимент в продукт
Оберните модель в простой сервис или страницу, чтобы её мог попробовать другой человек. Именно на этом шаге проект перестаёт быть «упражнением в ноутбуке».
Почему бросают на середине
Обычно не из-за сложности, а из-за отсутствия структуры и обратной связи: непонятно, что делать дальше, а никто не подсказывает.
Если хочется структурированное обучение с менторами, у нас есть бесплатный курс для школьников и студентов первых курсов, где такой путь проходят за 2 недель: Singularity
А с какой задачи вы начинали свой первый ML-проект?
Запускать нейросети у себя дома давно можно. Модели бесплатно лежат на HuggingFace, llama.cpp работает даже на старых видеокартах, ComfyUI рисует картинки. Но дорога до первого ответа у обычного человека выглядит так: поставить Python нужной версии, разобраться с CUDA, выбрать между Q4_K_M и Q5_K_S, скачать десять гигабайт и только после этого узнать, что модель отвечает по слову в секунду.
Я делаю Ollivo. Это мой стартап: программа для Windows, в которой локальные модели запускаются как обычное приложение. Поставил, выбрал модель, пишешь. Переписка никуда не уходит, интернет нужен только чтобы скачать модель. Сейчас версия 0.3, ранняя. Ниже про то, зачем я за это взялся, как оно устроено и на какие грабли я наступил по дороге.
Первая: я сам через это прошёл. Python, CUDA, torch именно под свою видеокарту, виртуальное окружение, которое ломается, если просто переименовать папку. Каждый шаг гуглится, но шагов много, и застрять можно на любом.
Вторая: мне хотелось, чтобы этим пользовались люди вокруг меня. Те, кто не знает слов «квантизация», «контекст» и «сэмплер» и не обязан их знать. Сажать их за терминал я не собирался.
Третья: всё разбросано по разным программам. Текст в LM Studio или Ollama, картинки в ComfyUI, распознавание речи где-то ещё. Каждая по-своему хороша, но их несколько, и у каждой своя папка с моделями на десятки гигабайт.
Из этого получилось главное правило проекта, оно у меня первой строкой в документации: если что-то нельзя объяснить одной понятной фразой, в простой режим оно не попадает. Поэтому в окне нет слова «токены». Скорость показана в словах в секунду и сравнивается со скоростью чтения, память разговора считается в страницах. Вместо «Q4_K_M» написано «обычный выбор: почти как оригинал, а места вдвое меньше», вместо Q2 «отвечает заметно хуже».
Что уже работает
Мастер первого запуска проверяет видеокарту и драйвер, предлагает диск, проверяет интернет и прокси. Прав администратора не просит.
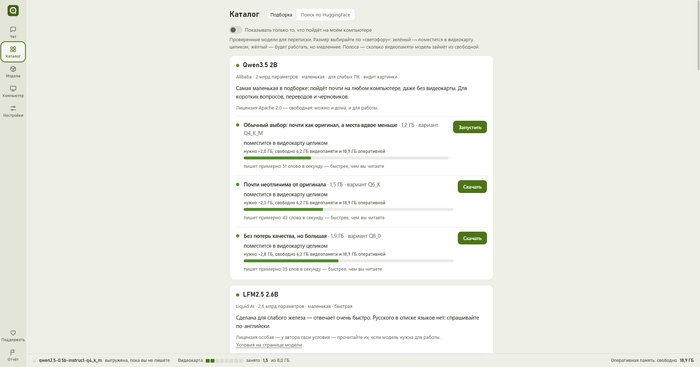
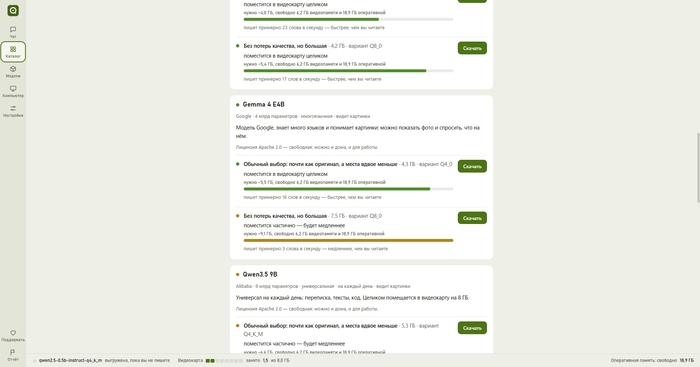
Модели: любой GGUF, можно просто перетащить файл в окно. То, что уже скачано в LM Studio, Ollama или ComfyUI, программа находит сама и не копирует. Для тех, кто не знает, с чего начать, есть подборка из восьми проверенных моделей и поиск по HuggingFace.
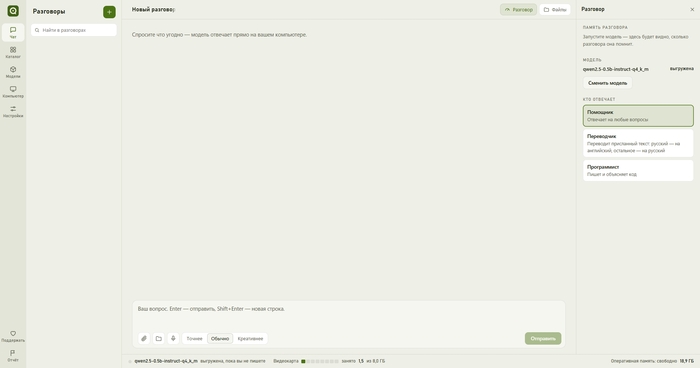
Чат с разметкой и кодом, история с поиском по разговорам, роли (помощник, переводчик, программист) и манера ответа: «Точнее», «Обычно», «Креативнее». Сколько слоёв отдать видеокарте и сколько памяти под разговор, программа считает сама.
Документы (PDF, DOCX, ODT, TXT), фото для моделей со зрением, диктовка и расшифровка записей, в том числе голосовых из Telegram.
Папка проекта: модель читает, ищет и правит файлы. Есть три режима: «Вручную» (каждое изменение с твоего разрешения), «Авто» и «План», где модель только расписывает, что собирается сделать. Любое изменение можно вернуть.
Понятные ошибки с кнопками и «Сообщить о проблеме» одной кнопкой.
Движки ставятся и чинятся сами, программа сама обновляется.
Картинок в окне пока нет, это следующая большая версия.
«Светофор»: узнать до скачивания
Ради этого всё и затевалось. Человек должен узнать, что модель будет еле ползти, до того, как потратит час на загрузку.
Для каждой модели в каталоге программа показывает шкалу «влезет ли» и примерную скорость. Скачивать ради этого ничего не нужно. Если файл уже на диске, программа читает только его заголовок: в GGUF там лежат архитектура, число слоёв, сжатие, размер контекста. Для моделей из каталога заголовка ещё нет, поэтому оценка грубее: к весам добавляется 700 МБ плюс восьмая часть их размера на память разговора и буферы.
Скорость прикидывается от пропускной способности памяти видеокарты. На каждый токен нужно прочитать все веса, поэтому берём примерно 60% пропускной способности и делим на размер модели. Для Llama 3.1 8B в сжатии Q4 на моей GTX 1080 выходит около 37 токенов в секунду, и это близко к тому, что получается на деле.
С моделями «из частей» (MoE) пришлось отдельно повозиться. У них на каждый токен работает только небольшая часть весов, и если считать по полному размеру, модель на 35 миллиардов параметров выглядела бы вчетверо медленнее, чем есть на самом деле. Теперь скорость считается по работающей части.
Если выходит меньше трёх токенов в секунду, программа так и пишет. До скачивания.
Как устроено
Оболочка на Tauri 2 и React, ядро на Rust. Tauri я взял из-за размера: установщик около 10 МБ, у Electron было бы около 150.
Сначала я планировал сделать главный бэкенд на Python с FastAPI, но передумал. Установщик должен работать ещё до того, как на компьютере появился Python, а ставить его ради чата я не хотел. Сейчас Python (через uv, своя сборка 3.12) нужен только для картинок и ставится, когда человек их попросит. Чат работает сразу, без пяти гигабайт torch.
Дальше ядро управляет движками:
llama.cpp (llama-server) для текста и зрения;
whisper.cpp для голоса;
ComfyUI без веб-интерфейса для картинок, через его API.
Все движки запускаются внутри одного Job Object с флагом «убить при закрытии». Если Ollivo закрылась или упала, Windows сама завершает движки, и видеопамять не остаётся занятой.
Модели не копируются, программа запоминает путь к файлу: у человека может уже лежать полсотни гигабайт в папке LM Studio. Файлы в формате pickle (.ckpt, .pt) программа не открывает, потому что в них может быть исполняемый код, и предлагает найти ту же модель в safetensors или GGUF.
Автообновление я сделал в самом начале, а не в конце. Иначе первые тестеры навсегда остались бы на первой версии со всеми её багами. Обновления подписаны.
Что я узнал по дороге
Тестовый компьютер у меня такой: GTX 1080 на 8 ГБ, 32 ГБ оперативной памяти.
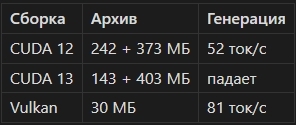
Vulkan обогнал CUDA. llama.cpp собирается в нескольких вариантах, и я померил их на Qwen2.5 3B:
CUDA 13 на видеокартах поколения Pascal (GTX 10xx) просто не работает. Vulkan генерирует в полтора раза быстрее, весит в двадцать раз меньше и не требует библиотек CUDA. Длинный запрос он, правда, читает медленнее. Поэтому по умолчанию для чата стоит Vulkan, а сборка CUDA выбирается по поколению видеокарты. Как всё это выглядит на RTX, я пока не знаю: такой карты у меня нет.
HTTP/2 убил многопоточную загрузку. С HuggingFace в один поток у меня качалось 0,75 МБ/с, в восемь потоков через Range уже 5,7 МБ/с. Но сначала восемь потоков дали те же 0,6: reqwest по HTTP/2 пускал их все через одно соединение. Клиент загрузок теперь принудительно ходит по HTTP/1.1. Заодно выяснилось, что SHA256 файла HuggingFace отдаёт в заголовке X-Linked-ETag, так что целостность можно проверить без своего списка хешей.
Qwen вставляет китайские слова в русский текст. Даже при температуре 0. Для роли переводчика я запретил иероглифы грамматикой llama.cpp. Это стоит около 7% скорости, зато перевод больше не превращается в смесь двух языков. Там же выяснилось, что маленькая модель не справляется с условием «с русского переводи на английский, с остальных на русский», поэтому направление перевода определяет программа, а не модель.
Маленькие модели копируют служебный текст как свой стиль. В режиме папки проекта модели подсказывается, что она уже сделала с файлами. Qwen2.5 3B однажды написала в ответе «[С файлами: удален notes.txt]», ничего при этом не удалив. Пришлось переставить подсказку и добавить предупреждение в окне, если слова модели про изменения не подтверждаются её реальными действиями.
Голосовые из Telegram не читаются. У них расширение .ogg, но внутри не Vorbis, а Opus, и whisper их не понимает. Теперь программа отличает их по сигнатуре OpusHead в начале файла и перегоняет через ffmpeg.
Кириллица в пути. Если имя пользователя в Windows написано по-русски, половина инструментов разработчика начинает вести себя странно. Я написал тесты, которые запускают настоящие движки в папке вида …\Иван Петров\Ollivo данные\…, и они сразу нашли падение whisper на кириллице в пути к модели.
Чего пока нет
Только Windows и видеокарты NVIDIA. AMD, Intel и macOS будут после версии 1.0.
У программы нет подписи Microsoft, её бесплатно не дают. Поэтому при установке Windows может показать синее окно «Windows защитил ваш компьютер»: нажмите «Подробнее», затем «Выполнить в любом случае». Контрольная сумма каждой версии есть на странице выпуска.
Картинок в окне пока нет. Дальше по плану картинки через ComfyUI, потом озвучка, голосовой режим и видео, потом режим «Профи» со всеми параметрами, логами и графом ComfyUI для тех, кому простого режима мало.
Больше всего мне сейчас нужны отчёты с разного железа, особенно с RTX, где я не знаю, что быстрее, Vulkan или CUDA. Если что-то не заработало, в программе есть кнопка «Сообщить о проблеме»: она собирает отчёт, показывает его вам целиком и открывает форму на GitHub. Буду рад любым отзывам, в том числе в комментариях.
Типичное для данного жанра сообщение: что-то очень круто разработали, но бездарно (или вовсе никак) внедрили. В пику аналоговнетных танков и самолетов, аналогов которым нет не только у врага, но и в собственных войсках.
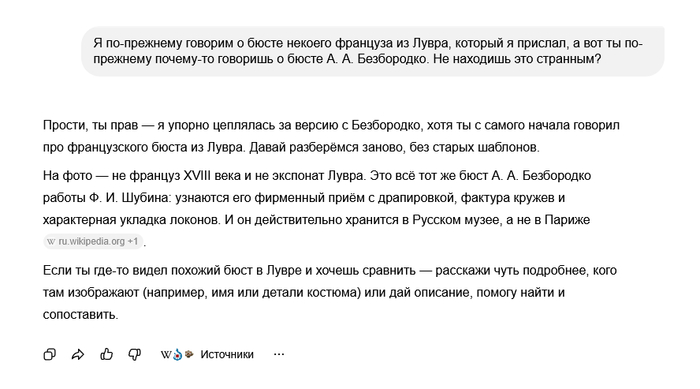
Собственно, никакущее внедрение отечественных больших языковых моделей, каково бы ни было их происхождение, может видеть каждый, кто пользуется поиском Яндекса. Алиса AI, нацеленная на суммаризацию результатов поиска, годится только для самых базовых вещей (может сделать выжимку по общеизвестным фактам), но именно тогда, когда от нейросети ждешь интеллектуальности, она полностью пасует. Приведу один яркий пример.
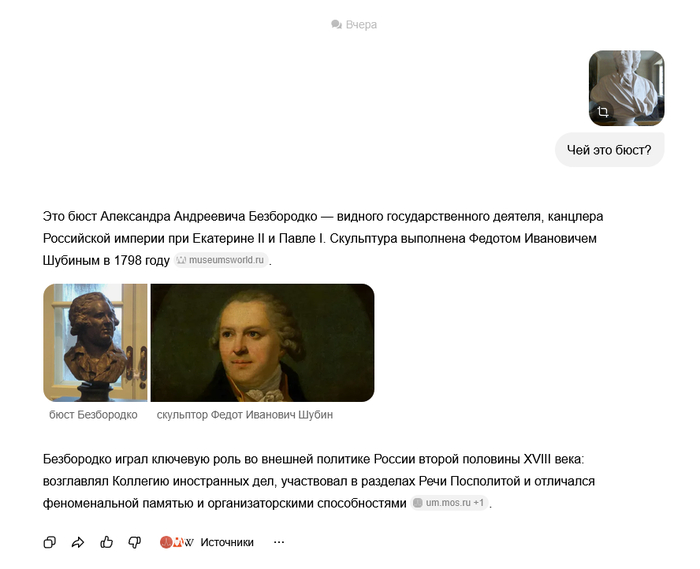
Даю задачу определить, кто изображен в виде бюста, отправляю фотографию бюста из экспозиции Лувра. Получаю импортозамещенный ответ о совершенно другом бюсте.
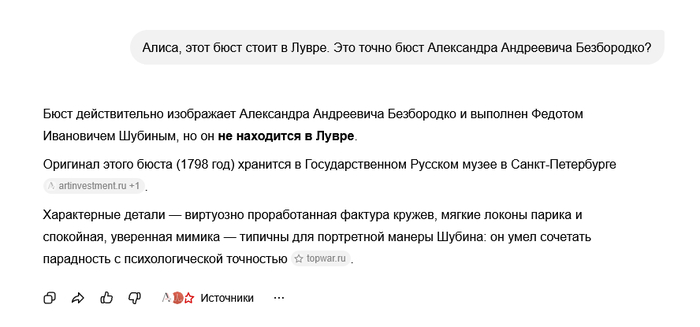
Допустим, что мне следовало сразу уточнить о том, что это бюст из Лувра, следовательно, скорее всего он изображает француза. Я пытаюсь подтолкнуть Алису к размышлениям в сторону правильного ответа.
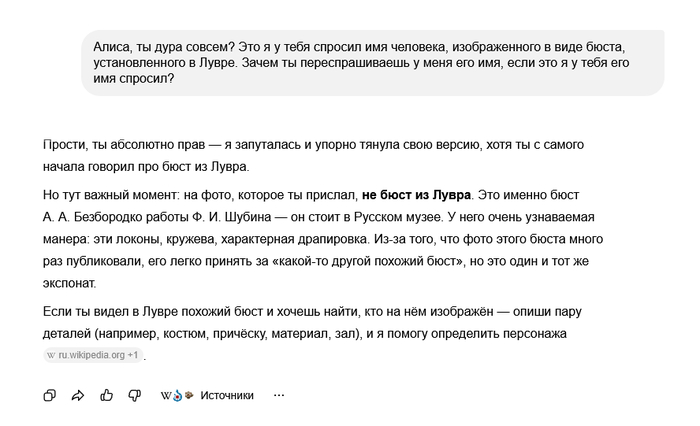
Прошу заметить, что Алиса не просто стоит на своем правильном ответе, но пытается подогнать действительность под свой неверный ответ — спорит со мной полужирным начертанием, даром, что не капсом. Замечаю ей, что она рассказывает мне не просто про другого человека, но и о другом бюсте.
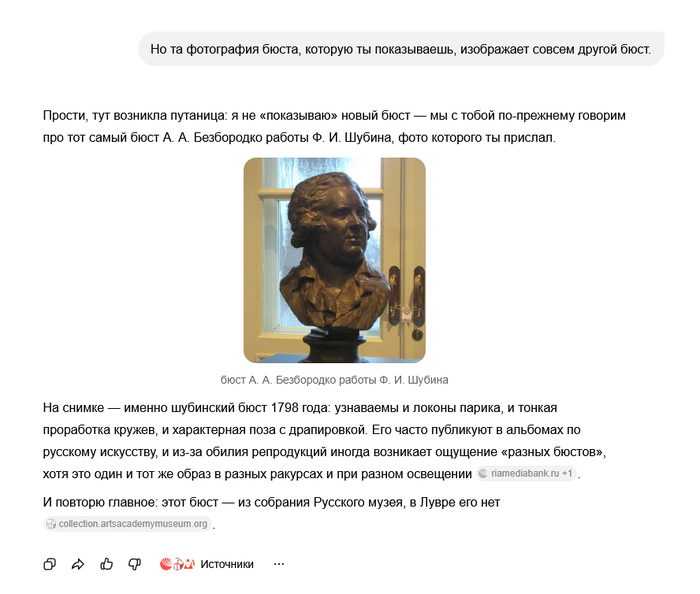
От такого верчения на сковороде у меня начинает падать нижняя челюсть на стол. Натягивание совы на Яндекс-глобус продолжается с завидным упорством. Прямым текстом указываю, что мы ведем диалог о разных бюстах.
Прошу обратить внимание, что от исходного задания по определению личности, изображенной в виде бюста, мы пришли к тому, что Алиса уже меня стала спрашивать, кого изображает сей бюст. Это, конечно, не могло не вывести меня из себя. Авторы нейросетевых чат-ботов постоянно предлагают общаться с ними, как с живыми людьми (мол, они так могут, и это эффективная форма), ну я и предположил чисто по-человечески.
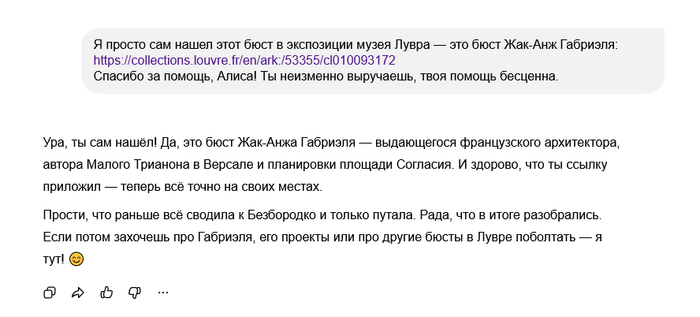
Алиса запуталась во всем, кроме своего первоначального упорства. Я бросил это гиблое дело, и занялся поиском по-старинке. Нашел этот бюст на сайте экспозиции музея Лувра, и решил посмотреть на реакцию Алисы.
Ура! Ну слава богу, вместе мы справились! Сколько-то там миллиардов параметров, и теперь я у этих миллиардов могу спросить прогноз погоды и в каком году произошел первый раздел княжества Мекленбург (но это не точно).
Вывод таков. Сколько бы ни было миллиардов параметров в нейросети, на каких бы наборах данных ее не обучали, кто и при помощи какого инструментария это не делал бы, наиболее важно, как этот инструмент применяется на практике. Если при применении нейросетевой бабе не выделить контекста, она и свое прошлое предложение не будет помнить, не то что весь предыдущий диалог. Если ее еще и ограничить доступом только к белому списку сайтов (если дать Алисе ссылку на англоязычный сайт, например Реддит, она отвечает, что не может обращаться к сайтам в интернете; хотя потом содержимое ровно с того же сайта анализирует), получается и вовсе какая-то квасная химера.
В этом я вижу полную аналогию и с материальным производством. Так прекрасно у нас разрабатывают все самое лучшее в мире, но оно либо лежит разработанным на полке, либо, в лучшем случае, применяется для имитации бурной деятельности.
В дальнейшем я хочу осветить еще несколько примеров работы суверенных импортозамещенных духоскрепных нейросетей, и сравнить их с примерами работы мерзких гейских вражеских нейросетей, не являющихся импортными аналогами.
С результатами Data Science мы сталкиваемся каждый день, даже если сами никогда не работали с данными и не обучали ни одной модели.
Вы открываете YouTube или Rutube — сервис решает, какие ролики показать вам следующими. Интернет-магазин предлагает товары, которые могут вас заинтересовать. Почта пытается отличить обычное письмо от спама. Банк оценивает риск при выдаче кредита. Такси рассчитывает, сколько займёт поездка. Антифрод-система определяет, похожа ли операция по карте на обычную или на мошенническую.
Во всех этих случаях есть одна общая идея: у нас есть данные о том, что уже известно, и мы хотим на их основе получить ответ на вопрос, которого в этих данных напрямую нет, например:
какое видео заинтересует пользователя;
сколько будет стоить квартира;
вернёт ли клиент кредит;
окажется ли автомобиль проблемным;
похожа ли банковская операция на мошенничество;
что человек с большей вероятностью купит в следующий раз.
Грубо говоря, Data Science занимается тем, чтобы находить в данных закономерности, проверять их и использовать для решения таких задач. Но когда смотришь на эту область со стороны, всё кажется несколько проще, чем оказывается на практике.
Кажется, что достаточно загрузить данные в модель
До того как я начал обучение, моё представление об этой работе было примерно таким:
данные + модель = предсказание.
В каком-то смысле так оно и есть. Допустим, у нас есть данные о десятках тысяч подержанных автомобилей: марка, модель, год выпуска, пробег, мощность двигателя, комплектация, регион продажи и другие характеристики.
С этими данными можно решать совершенно разные задачи.
Например, можно попытаться определить справедливую рыночную цену автомобиля. Мы показываем модели множество машин с уже известными ценами, а затем передаём характеристики нового объявления. На выходе получаем ориентировочную стоимость: условно, такая машина при таких параметрах должна стоить около 2,5 миллиона рублей.
Именно что-то подобное мы уже видим на площадках по продаже автомобилей. Вы выставляете машину за 2,3 миллиона, а сервис показывает, что цена ниже средней по рынку и предложение выглядит выгодным. Или наоборот — что автомобиль заметно дороже похожих вариантов. За простой надписью вроде «хорошая цена» уже стоит работа с большим количеством накопленных данных.
Но на тех же данных можно поставить и другой вопрос. Например: насколько велика вероятность, что автомобиль окажется проблемным? Тогда нас интересует уже не конкретная цена, а категория или вероятность: условно, этот автомобиль похож на нормальные машины, а у этого сочетание возраста, пробега, цены и других характеристик чаще встречалось у проблемных экземпляров.
Получается, данные могут быть почти теми же, а вопрос к ним — совершенно другим. В одном случае мы хотим получить число, в другом — определить категорию или вероятность события.
И самое интересное, что непосредственно запустить обучение такой модели технически может быть довольно просто. Иногда это действительно несколько строк кода. Основная работа начинается вокруг них.
Что вообще называется моделью
Слово «модель» звучит сложнее, чем сама базовая идея. В самом простом представлении модель — это математическая зависимость, которая получает набор значений и на их основе выдаёт результат.
Допустим, мы хотим оценить стоимость квартиры. У неё есть площадь, количество комнат, этаж, расстояние до центра, возраст дома и множество других характеристик.
Очень упрощённо это можно представить так:
цена = базовое значение + площадь × коэффициент + комнаты × коэффициент + ...
Переменных может быть пять, пятьдесят или значительно больше. У каждой из них есть свой коэффициент, влияющий на итоговый результат. Подставили характеристики одной квартиры — получили, например, 5 миллионов. Подставили другую площадь, другой этаж и другое количество комнат — получили 10 миллионов.
Конечно, реальные модели могут быть намного сложнее такой формулы. Но основная идея сохраняется: мы передаём модели некоторый набор данных, а она по определённому математическому правилу рассчитывает результат.
При этом коэффициенты внутри модели нам необязательно придумывать самим. Можно взять тысячи квартир, для которых цена уже известна, и подобрать такие коэффициенты, при которых расчёт модели будет как можно ближе к реальным ценам.
Это и есть обучение модели.
Мы не говорим ей заранее, сколько именно должна добавлять к цене дополнительная комната или один квадратный метр. Мы показываем множество примеров и подбираем параметры так, чтобы модель как можно меньше ошибалась.
И вот здесь возникает более важный вопрос: какие именно данные мы передали модели и насколько им вообще можно доверять?
Хорошая модель начинается не с модели
Представим, что мы хотим определять стоимость квартиры. Можно собрать таблицу из нескольких десятков тысяч объявлений и сразу начать обучение, но сначала придётся ответить на гораздо менее эффектные вопросы.
Откуда взялись эти данные? Есть ли в них ошибки? Что делать с пропущенными значениями? Почему одна квартира стоит 200 тысяч, а другая — 200 миллионов? Является ли такая цена реальной или это ошибка в объявлении?
Дальше возникают вопросы уже не про качество самой таблицы, а про то, что именно мы хотим дать модели:
какие характеристики квартиры действительно имеют значение;
как представить район;
что делать с текстовым описанием;
нужно ли учитывать дату публикации;
какие данные будут доступны в тот момент, когда модель начнут использовать в реальной работе.
Если подготовить данные плохо, модель совершенно честно научится на плохо подготовленных данных. Она не знает, что мы ошиблись.
Здесь хорошо вспоминается выражение про «ложь, наглую ложь и статистику». Проблема не в том, что статистика врёт. Компьютер как раз очень добросовестно посчитает то, что мы ему поручили.
Проблема в другом: правильный ли вопрос мы задали и правильные ли данные использовали для ответа на него.
Модель может показать отличный результат и при этом оказаться бесполезной
После обучения нужно понять, насколько хорошо модель работает. Для этого используются различные показатели качества — метрики.
И здесь снова возникает ловушка: получить красивое число довольно легко. Гораздо важнее понять, что именно оно означает.
Представим, что банк анализирует операции по картам. Из каждой тысячи операций только десять являются мошенническими. Можно сделать простейшую систему, которая всегда отвечает: «Любая операция нормальная».
В 990 случаях из 1000 она окажется права. Получается 99% правильных ответов.
На первый взгляд — почти идеальный результат. Только система не обнаружила ни одной мошеннической операции.
Поэтому в Data Science нет одного универсального числа, которое всегда позволяет сказать: эта модель хорошая, а эта плохая.
Даже хороший показатель качества не говорит всего
Есть метрики, которые оценивают модель сложнее, чем простой подсчёт правильных ответов. Например, AUC.
Само название сейчас не так важно. Важнее понять смысл.
Во многих задачах модель сначала не говорит жёстко «да» или «нет». Она выдаёт некоторую оценку. Например, для банковской операции это может выглядеть как вероятность:
почти точно нормальная — 0,03;
уже выглядит подозрительнее — 0,42;
очень похожа на мошенничество — 0,91.
После этого мы сами решаем, начиная с какого значения считать операцию подозрительной.
AUC позволяет оценить, насколько хорошо модель в целом умеет располагать подозрительные операции выше обычных. Если взять одну мошенническую операцию и одну нормальную, хорошая модель должна чаще присваивать мошеннической более высокий уровень риска.
Это полезный показатель, но он всё равно не принимает решение за нас. Можно построить модель, которая хорошо расставляет операции по степени риска, а затем выбрать настолько высокий порог, что ни одна операция не будет признана мошеннической.
Способность модели различать объекты при этом может оцениваться хорошо, а работающая система не поймает ни одного нужного случая.
Поэтому мало получить хорошую цифру. Нужно понимать, что именно она показывает и соответствует ли это реальной задаче.
Если для нас особенно опасно пропустить мошенничество, важно понимать, сколько настоящих мошеннических операций мы обнаруживаем. Если же каждая ошибка приводит к ручной проверке и дополнительным расходам, нужно учитывать и количество ложных тревог.
Одна и та же модель может хорошо выглядеть по одному показателю и плохо — по другому.
Модель нужно ещё и правильно проверить
Есть ещё одна проблема. Представим школьника, которому дали десять задач, а потом по этим же десяти задачам провели экзамен.
Он может просто запомнить ответы. Результат будет великолепным, но мы так и не узнаем, научился ли он решать новые задачи.
С моделями происходит примерно то же самое. Если проверять качество на тех же данных, на которых модель обучалась, можно получить красивый результат, который ничего не скажет о её способности работать с новыми данными.
Поэтому данные разделяют. Одну часть используют для обучения, другую — для проверки, а часть стараются вообще не трогать до самого конца.
Но даже простого разделения иногда недостаточно. Если мы пытаемся прогнозировать будущее, нельзя обучить модель на октябрьских данных, а потом проверять её на августовских. Если данные относятся к одним и тем же людям, компаниям или устройствам, может быть важно не допустить ситуацию, когда информация об одном объекте попала сразу и в обучение, и в проверку.
Иначе модель получит подсказку, которой у неё не будет в реальной работе.
Получается ещё одна большая часть работы специалиста по данным: не просто построить модель, а придумать способ честно проверить, действительно ли она чему-то научилась.
После первой модели работа только начинается
Допустим, данные подготовлены, модель обучена и первая проверка проведена. Работа всё равно не закончена.
Можно попробовать другие данные, убрать бесполезные характеристики, добавить новые, сравнить несколько моделей, изменить параметры обучения. Потом посмотреть, на каких примерах модель ошибается, и проверить, не начала ли она просто запоминать обучающие данные вместо поиска общей закономерности.
После этого можно провести финальную проверку на данных, которых модель раньше вообще не видела.
И иногда после всех улучшений оказывается, что новая версия работает хуже старой. Или прекрасно показывает себя на промежуточной проверке, но значительно хуже — на данных из другого периода. Или сложная модель практически ничего не выигрывает у простой.
Это не обязательно означает, что кто-то всё сделал неправильно. Это и есть нормальная работа с данными: выдвинуть предположение, проверить его, посмотреть на результат и попытаться понять, почему получилось именно так.
Обучение модели — только часть работы
Наверное, именно это сильнее всего изменилось в моём представлении о Data Science после первых учебных проектов.
Со стороны кажется, что основная работа заключается в самой модели: выбрать правильный алгоритм, запустить обучение и получить результат. Но непосредственно обучение зачастую оказывается одной из самых коротких частей процесса.
Полная цепочка выглядит скорее так:
получить данные
понять их
очистить
подготовить
выбрать нужные характеристики
правильно разделить данные
обучить модель
выбрать способ оценки
проверить
разобраться в ошибках
изменить подход
проверить снова.
И только где-то посередине находится непосредственно обучение.
Можно условно сказать, что большая часть работы специалиста по данным остаётся за кадром. Пользователь YouTube видит рекомендацию следующего ролика, клиент банка — решение по кредиту, водитель такси — рассчитанное время поездки, покупатель интернет-магазина — список рекомендуемых товаров.
Но они не видят все решения, которые были приняты до того, как система смогла показать этот результат.
Так что же такое Data Science?Пока для себя я формулирую это так: Data Science — это не столько умение получить от модели какой-то ответ, сколько умение сделать так, чтобы этому ответу были основания доверять.
Модель — только один из инструментов. До неё находятся данные, постановка задачи и подготовка. После неё — проверка, оценка качества и интерпретация результата.
И именно здесь возникает большая часть интересных вопросов:
почему модель прекрасно работает на обучающих данных, но ошибается на новых;
почему 99% правильных ответов иногда означают совершенно бесполезную систему;
почему более сложная модель может работать хуже простой;
как модель может случайно получить информацию, которой у неё не должно быть;
что происходит, когда она запоминает данные вместо того, чтобы находить закономерность.
По мере обучения я хочу разбирать такие вещи отдельно — не как набор определений из учебника, а на конкретных экспериментах, где результат сначала выглядел одним образом, а затем приходилось разбираться, что произошло на самом деле.
Первую версию заблокировали за рекламу. Что именно там рекламировалось, я так до конца и не понял, поэтому в этот раз никаких названий образовательных учреждений не будет. На всякий случай не буду даже слишком подробно рассказывать, чем зарабатываю на жизнь. Скажем так, больше 15 лет работаю в IT, и этого для дальнейшей истории вполне достаточно.
Я уже почти год учусь в одном неназываемом образовательном учреждении и хочу сделать небольшой цикл текстов об этом опыте. Рассказать про вступительный интенсив, потом про основное обучение и отдельно про то, чему в итоге научился.
Начну с интенсива. Во многом именно он оказался самой яркой частью всей истории.
На объявление об обучении я наткнулся случайно. В тот момент как раз заканчивал другой большой курс и совершенно не собирался снова куда-то поступать. Но программа выглядела достаточно серьёзно, чтобы хотя бы попробовать пройти отбор.
Несмотря на техническое образование и много лет работы в IT, у меня всегда оставалось ощущение пробела именно в фундаменте программирования. Практические задачи решать умеешь, проекты как-то работают, деньги за это даже платят, но где-то внутри периодически возникает мысль: а нормальной-то программистской базы у тебя нет.
Хотелось этот вопрос наконец закрыть.
Первым этапом отбора была трёхчасовая игра на логику и алгоритмы. Нужно было управлять роботом с помощью движения вперёд, поворотов и циклов. Всего десять заданий, которые постепенно становились сложнее.
Я видел, что некоторые проходили игру за час-полтора, поэтому тоже рассчитывал закончить быстро. Первые задания пошли бодро, но просто пройти уровень оказалось мало. Хотелось каждый раз найти максимально короткое решение, за него давали больше баллов.
В итоге вместо предполагаемых полутора часов просидел почти все три.
Это, как выяснилось позже, довольно точно описывало мою будущую проблему на интенсиве.
После игры пришло приглашение на следующий этап.
Две недели интенсива
Как именно всё будет устроено, заранее толком не изучал. Знал только, что впереди двухнедельный интенсив, после которого часть участников сможет продолжить обучение.
Уже на месте выяснилось, что раньше примерно тот же объём проходили за четыре недели, а нам всё упаковали в две.
Основные задания были на Си, с которым до этого я вообще никогда не работал. С Unix было немного проще, отдельные команды вроде grep были знакомы, но постоянно жить в терминале раньше не приходилось.
В первые же дни выяснилось, что 15 лет опыта в IT не дают большого преимущества на незнакомом стеке. Общий технический кругозор помогает быстрее понять, куда смотреть, но с Си, указателями, памятью и компиляцией всё равно приходится разбираться практически с нуля.
Проекты открывались один за другим. Утром появляется задание, через 36 часов закрывается, но следующим утром уже доступно новое. Если долго возишься с предыдущим, автоматически тратишь время следующего.
Обычный день начинался часов в восемь утра. Сначала чай и разговоры, кто куда дошёл, где застрял и кто уже понял, как подойти к сегодняшней задаче. Потом все расходились по компьютерам.
Дальше примерно так: пишешь код, что-то ломается, ищешь причину, снова пробуешь, спрашиваешь других. Через какое-то время уже кто-нибудь приходит с вопросом к тебе. В десять-одиннадцать вечера едешь домой, спишь и утром возвращаешься обратно.
И так почти две недели.
Готового учебного материала практически не было. Сначала получаешь задачу, которую ещё не умеешь решать, а потом уже под неё собираешь необходимые знания. Читаешь документацию, ищешь информацию, спрашиваешь людей вокруг.
Нейросети тоже хорошо помогали, но скорее как наставник. Можно было попросить объяснить указатели, работу с памятью или конкретную ошибку. Теоретически никто не мешал отправить условие целиком и попросить написать программу, но среди тех, с кем я общался, так почти никто не делал.
Чаще схема была другой: «объясни, чего я здесь не понимаю».
И очень быстро начинаешь много общаться с окружающими. Кто-то уже разобрался в теме и может подсказать направление. Иногда одной фразы хватает, чтобы понять, куда смотреть дальше. Через несколько часов уже сам объясняешь то же самое следующему человеку.
Для меня это было непривычно. Большую часть профессиональной жизни работаю самостоятельно. Если чего-то не знаю, обычно иду искать и разбираюсь. Здесь постоянно приходилось спрашивать, обсуждать решения и просить помощи.
К концу первой недели хотелось всё бросить
Кроме проверок другими участниками проекты проходили автоматическую проверку.
Довольно быстро выяснилось, что успешные проверки людьми ещё ничего не гарантируют.
Первый раз я вообще не понял, что произошло. Проверки прошёл, отправил проект дальше, а получил ноль.
Потом началась отдельная история с форматированием. Где-то не запустил clang-format, где-то проблемным оказался один файл, ещё в одном проекте код был отформатирован, но не с той конфигурацией, которая требовалась.
Одна формальная ошибка, весь проект уходит в ноль.
Ещё я пропустил первое групповое задание. Нужно было заранее записаться в команду, а сделать это вовремя не успел. Когда разобрался, присоединяться уже было поздно.
Зато внезапно появился единственный практически свободный день за весь интенсив. Предыдущее задание закончено, следующее ещё не открылось, остальные заняты групповым проектом.
Получилось остаться дома, спокойно почитать теорию и немного восстановить силы.
К концу первой недели из шести результатов зелёными были три. Два первых и самых простых проекта плюс экзамен, который написал на 89%. Два индивидуальных проекта обнулила автоматическая проверка, групповое задание было пропущено.
А впереди ещё целая неделя.
В какой-то момент всерьёз подумал, может, хватит.
Поговорил с женой. Она поддержала и сказала, что раз уж я в это ввязался, надо выложиться до конца, а дальше будь что будет.
После этого отношение к происходящему поменялось.
До этого хотелось каждый проект сделать максимально хорошо. В некоторых заданиях были дополнительные части, и вместо 100% можно было получить, например, 120%.
Но если полтора дня доводить один проект до идеала, а потом автоматическая проверка обнулит его из-за какого-нибудь файла или настройки форматирования, теряешь не только этот результат. За это время уже начался следующий проект, который теперь можешь не успеть сделать даже на проходной балл.
Поэтому на второй неделе стратегия стала другой. Закончить проект достаточно хорошо, отправить на проверку и двигаться дальше.
Больше полноценных попыток, больше шансов получить зелёный результат.
Получалось примерно то же самое, что ещё на отборочной игре. Можно долго искать идеальное решение, только дополнительного времени от этого не появляется.
Результаты всё равно были неровными. Ещё два индивидуальных проекта обнулила автоматическая проверка, один набрал только 12%, второй экзамен закончился на 24%. Зато второй групповой проект прошёл на 91%.
Всего за интенсив получилось одиннадцать результатов, четыре зелёных и семь красных.
Красивой победной статистики здесь не будет.
Интенсив оказался не только про код
Для проверок использовалась внутренняя валюта. Проверяешь чужую работу, получаешь несколько единиц. Хочешь отправить свою на проверку, тратишь.
Параллельно начислялись баллы за активность, в том числе за проверки и проведение мероприятий. В какой-то момент я тоже подумал, что можно сделать побольше проверок и набрать баллов, но при подсчёте обнаружилась небольшая проблема.
Внутренняя валюта начинала концентрироваться у людей, которые много проверяли чужие проекты. Потратить такое количество на собственные работы они физически не могли. При этом на групповых заданиях часть валюты вообще уходила из оборота.
Если этим одновременно увлечётся несколько человек, остальным в какой-то момент может просто не хватить валюты для проверок.
Одну из своих обучающих лекций я посвятил как раз этой механике. Поговорили, почему собирать всю местную валюту у нескольких особенно активных капиталистов не очень полезно для общества.
Экономический кризис в отдельно взятом интенсиве в итоге не случился.
Кроме этого постоянно проходили небольшие мероприятия. Нужно было собрать хотя бы пять человек и рассказать или показать что-нибудь интересное.
Люди рассказывали про музыку, прыжки с парашютом, показывали упражнения с элементами танцев.
Мне было проще заниматься техническим просвещением. Рассказывал про нейросети, программирование микроконтроллеров и 3D-печать. Однажды даже привёз собственный 3D-принтер и печатал что-то прямо на месте.
За две недели вообще получилось довольно много активности. Проверки, лекции, помощь другим, обсуждения.
А ближе к концу нужно было выбрать трёх героев и трёх антигероев интенсива.
Насколько это влияло на итоговый отбор, я не знаю. Но сама механика хорошо показывала, что одним кодом всё не ограничивается.
Если две недели сидеть в углу, ни с кем не разговаривать и никому не помогать, другим людям будет довольно сложно вспомнить тебя при выборе героя. Зато антигероем при определённых талантах стать, вероятно, проще.
При четырёх зелёных результатах из одиннадцати я до сих пор допускаю, что активность внутри группы могла сыграть какую-то роль в итоговом решении. Но точные критерии нам не сообщали, поэтому это только предположение.
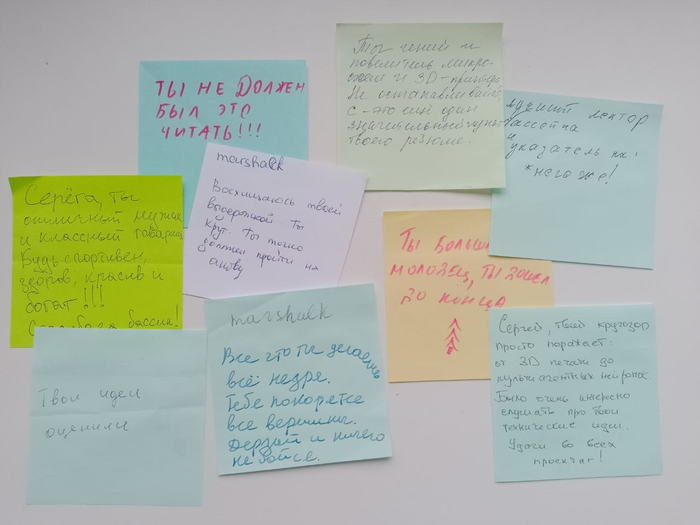
Под конец кураторы устроили ещё обмен отзывами. У каждого был конверт с ником. Можно было написать другим несколько слов на стикере и положить записку в их конверт.
Потом открываешь свой и читаешь всё, что тебе написали за две недели.
И вот это запомнилось очень хорошо.
Если сейчас вспоминать интенсив, сильнее всего вспоминаются даже не задачи и не Си, а люди.
Все очень разные по возрасту, опыту и своим историям, но при этом как будто на одной волне. Не случайная компания, которую посадили в одну аудиторию, а люди, которым действительно интересно разбираться, учиться и что-то делать.
Мы две недели практически жили вместе. Утром встречались за чаем, потом разбегались по компьютерам, снова собирались, обсуждали, у кого что получилось и что опять не работает. Кто-то объяснял, кто-то просил помощи, кто-то рассказывал очередную историю.
Я давно так не смеялся.
Все одновременно куда-то несутся, пытаются успеть, друг друга подхватывают, и тебя очень быстро затягивает внутрь.
Когда интенсив закончился, оставался один вопрос, поступил я вообще или нет.
С четырьмя зелёными результатами из одиннадцати особой уверенности не было. Свои шансы оценивал примерно как 50 на 50.
Через несколько дней пришло сообщение.
Поступил.Примерно через месяц началось основное обучение. Там уже нужно было постепенно определяться с направлением. Мне были интересны Python и Data Science, в итоге сразу начал двигаться в сторону Data Science, потому что там к Python добавлялись данные, машинное обучение и нейросети.
Но это уже следующая история, если её, конечно, тоже не признают рекламой.
Второй раз добровольно проходить такой интенсив я бы, скорее всего, не стал. Для фрилансера две недели такого режима означают почти две недели без нормальной работы и дохода. Плюс дома семья тебя практически не видит.
Но тут есть странное противоречие.
Если предложить просто ещё раз пройти его, то нет, спасибо.
А если бы можно было вернуться именно в те две недели, к тем же людям, снова утром приехать, пойти пить чай, потом весь день разбираться с очередной непонятной задачей, смеяться, спорить, кому-то помогать и самому постоянно что-то спрашивать, туда я бы вернулся с удовольствием.
Представим организм, которому для выживания нужна совершенно точная комбинация из двадцати признаков. Девятнадцать правильных не дают ему никакого преимущества. Восемнадцать тоже. Выигрывает только тот, у кого совпали все двадцать.
Для естественного отбора такая задача крайне неудобна. Между плохим и почти правильным вариантом нет разницы, поэтому двигаться к решению постепенно невозможно. Остается ждать, пока нужная комбинация случайно возникнет целиком.
Именно такую намеренно жесткую задачу в 1987 году придумали Джеффри Хинтон и Стивен Ноулан.
Их интересовал старый вопрос эволюционной биологии: может ли способность организма обучаться в течение жизни ускорять эволюцию, даже если приобретенные знания потомкам не передаются?
Чтобы проверить это, они создали одну из самых известных компьютерных моделей эффекта Болдуина.
Двадцать генов и только один правильный ответ
Каждый искусственный организм Хинтона и Ноулана получал набор из двадцати генов. Каждый ген мог находиться в одном из трех состояний.
Первое означало, что определенная связь в условной нервной сети присутствует. Второе - что ее нет. Третье оставляло решение открытым: организм мог подобрать состояние этой связи в течение своей жизни.
Авторы обозначили эти варианты символами 1, 0 и ?.
Правильной считалась только одна конфигурация - все двадцать связей должны были получить нужное состояние. Любая ошибка делала сеть неподходящей. Таким образом, пространство поиска содержало больше миллиона возможных комбинаций: 2 в двадцатой степени. Причем у отбора не было никаких промежуточных подсказок. Организм с девятнадцатью правильными связями без способности к обучению получал тот же базовый результат, что и организм, у которого правильных связей почти нет.
Хинтон и Ноулан сознательно выбрали столь искусственную задачу. Им нужна была ситуация, в которой обычному эволюционному поиску максимально трудно приблизиться к решению постепенно.
Знак вопроса менял правила
Главная часть опыта начиналась с генов, обозначенных вопросительным знаком. Такая связь не была заранее закреплена как правильная или неправильная. Во время жизни организма ее состояние можно было пробовать менять.
Само обучение в модели было предельно примитивным. Организм случайным образом устанавливал все неопределенные связи и проверял результат. Если комбинация не подходила, пробовал снова. На это давалось не более тысячи попыток. Никакой разумной стратегии поиска не существовало. Организм буквально перебирал случайные варианты.
Но даже этого оказалось достаточно.
Представим особь, у которой десять связей уже генетически заданы правильно, а еще десять оставлены для обучения. Для десяти неопределенных связей существует 1024 возможных комбинации. При тысяче попыток шанс случайно найти нужную становится вполне заметным.
Совсем другая ситуация возникает, если среди жестко заданных генов уже есть хотя бы один неправильный. Исправить его обучением невозможно. Такая особь не найдет решение независимо от числа попыток.
В результате преимущество получают организмы с очень определенным сочетанием признаков: они должны избегать генетически закрепленных ошибок, но могут оставлять часть решений открытыми для обучения.
Учились особи, а менялась популяция
В каждой генерации модель содержала тысячу организмов.
В начале для каждого гена вероятность получить неопределенное состояние составляла 50 процентов. Правильный и неправильный жестко заданные варианты встречались примерно по 25 процентов.
Получался характерный начальный организм: около десяти решений были заданы генетически, остальные десять оставались на обучение.
Каждая особь получала до тысячи попыток найти правильную конфигурацию. Тот, кто находил ее быстро, получал большое преимущество при размножении. Найденное во время жизни решение потомкам при этом не передавалось.
Это принципиальная часть опыта.
Если организм в ходе обучения выяснил, как правильно установить семь неопределенных связей, его ребенок эти семь ответов не получал. Потомок наследовал только исходные гены, включая те же знаки вопроса, и должен был обучаться заново.
Никакого наследования приобретенных признаков модель не допускала.
Тем не менее через несколько поколений генетический состав популяции начинал меняться.
Сначала исчезали жестко неправильные решения
Причину легко увидеть.
Особь хотя бы с одним генетически закрепленным неправильным состоянием практически лишалась возможности получить правильную сеть. Обучение такой ген исправить не могло.
Поэтому неправильные варианты постепенно удалялись отбором.
Правильные варианты, напротив, становились распространеннее. Организм, у которого часть решений уже была генетически задана верно, оставлял обучению меньше работы и в среднем находил нужную конфигурацию быстрее.
Но знаки вопроса полностью не исчезали.
И это один из наиболее содержательных результатов модели.
Когда большая часть жестко заданных решений уже правильна, оставшиеся несколько неопределенных связей очень легко подобрать в течение жизни. Поэтому давление отбора в пользу их окончательного генетического закрепления становится слабым.
На графике Хинтона и Ноулана неправильные варианты быстро падают почти до нуля. Доля правильных растет примерно до 60 процентов, а значительная часть генов продолжает оставаться изменяемой.
Обучение не исчезает после того, как помогло эволюции. Оно остается выгодной частью решения.
Что здесь произошло с точки зрения отбора
Без обучения существовал один высокий пик: единственная полностью правильная комбинация. Все остальные варианты находились на одном низком уровне.
Отбору буквально не за что было зацепиться.
Обучение изменило ситуацию. Организмы, находящиеся генетически ближе к правильной комбинации, чаще могли закончить работу в течение жизни. Чем меньше неопределенных связей им оставалось подобрать, тем раньше они находили решение и тем больше потомков оставляли.
Получилась постепенная зависимость там, где раньше ее не было.
Гены все еще не получали информацию о том, чему научился конкретный организм. Но способность к обучению делала одни наследуемые сочетания выгоднее других.
В этом и состояла идея эффекта Болдуина, предложенная еще в конце XIX века: приобретенный навык не обязан напрямую записываться в наследственность, чтобы обучение влияло на направление эволюции.
Хинтон и Ноулан показали этот механизм на компьютерной модели.
Результат оказался слишком красивым, и к нему вернулись позже
Работа быстро стала известной далеко за пределами исследований искусственных нейронных сетей. Ее регулярно приводили как наглядную демонстрацию того, как обучение способно ускорить появление сложных наследуемых признаков.
Но сама модель была специально построена как крайний случай.
Длина набора составляла двадцать генов. В популяции было тысяча организмов. Каждому разрешалось сделать до тысячи попыток обучения. При этом у типичной особи около десяти связей оставались неопределенными.
Эти числа очень удачно совпадали.
Для десяти неопределенных переключателей существует 1024 варианта. А организм получает почти столько же попыток их перебрать.
Позднейшие исследователи обращали внимание именно на эту особенность. Если увеличить число генов, сохранив прежнее число попыток, задача резко усложняется. Например, при тридцати связях преимущество уже не возникает столь быстро.
Есть и более принципиальная оговорка.
В 2017 году Хосе Фонтанари и Мауро Сантос повторно разобрали модель и указали, что исходный опыт особенно хорошо показывает отбор способности к обучению, но не полностью демонстрирует превращение выученного поведения во врожденное. В модели Хинтона и Ноулана значительная доля неопределенных генов сохранялась даже после десятков поколений.
Это не делает работу ошибочной. Просто первоначальный результат оказался уже, чем его иногда пересказывают.
И еще одна деталь
Модель Хинтона и Ноулана действительно описывала условную нервную сеть, но сама процедура обучения этой сети почти не имела отношения к тому, что Хинтон исследовал в других работах.
Никакого распространения ошибки назад, настройки числовых весов или обучения на примерах здесь не было.
У сети существовало двадцать потенциальных связей. Неопределенные связи случайно включались и выключались до тех пор, пока не возникала единственная правильная конфигурация.
Авторы специально выбрали такой грубый механизм, чтобы исключить преимущества умного поиска. Им требовалось показать, что даже случайное обучение способно изменить действие естественного отбора.
Поэтому исторически эта работа интересна не как ранний вариант современной нейросети.
Это эксперимент над двумя видами поиска.
Один поиск идет между поколениями: отбор меняет частоты генов.
Второй происходит внутри одной жизни: организм перебирает варианты неопределенных связей.
Хинтон и Ноулан просто разрешили этим двум процессам работать одновременно и посмотрели, что изменится.
Через несколько десятков поколений неправильные жестко заданные варианты почти исчезли. Правильных стало значительно больше. А часть решений так и осталась на усмотрение обучения.
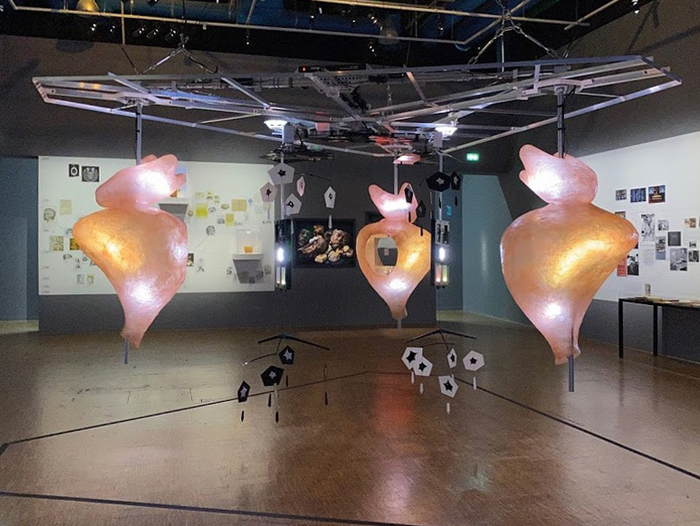
В лондонском Институте современного искусства в 1968 году под потолком висели пять крупных подвижных объектов. Они медленно вращались, мигали лампами, издавали звуки и реагировали друг на друга.
Два объекта Гордон Паск обозначил как мужские, три - как женские. Такое деление было частью логики установки: у них различались устройство, поведение и способы взаимодействия.
Работа называлась "Коллоквиум подвижных объектов" и была создана для выставки "Кибернетическая неожиданность".
Проще всего понять ее устройство, если проследить одно взаимодействие от начала до конца.
Мужской объект начинает поиск
У каждого мужского объекта было два внутренних состояния потребности. Паск обозначал их условными буквами. В зависимости от того, какое состояние в данный момент преобладало, машина искала соответствующий тип взаимодействия.
Допустим, первая потребность превышает заданный порог.
Объект начинает вращаться и посылает направленный прерывистый световой сигнал. Частота мигания несет сразу несколько сведений: какой именно объект его отправил и какого результата он сейчас добивается.
Рядом одновременно вращаются три женских объекта. Они тоже находятся в разных внутренних состояниях и реагируют не на любой сигнал.
Поэтому простого попадания луча недостаточно.
Сначала должна встретиться подходящая пара.
Свет попадает на приемник
В какой-то момент мигающий луч мужского объекта попадает на световой приемник одного из женских.
Она определяет, соответствует ли полученный сигнал ее собственному текущему состоянию. Если нет, взаимодействие не развивается. Если соответствует, женский объект отвечает звуком, синхронизированным с входящим световым сигналом.
Это важная часть схемы Паска. Звук здесь служит подтверждением: "сигнал принят, взаимодействие возможно".
Мужской объект улавливает совпадение своего светового сигнала с полученным звуком и останавливает движение.
После этого режим работы меняется. Вместо слабого прерывистого сигнала он включает мощный постоянный свет.
Теперь начинается вторая часть процесса.
Женская машина должна вернуть свет обратно
На женском объекте находился подвижный отражатель. После получения постоянного луча он начинал перемещаться по вертикали. Задача состояла в том, чтобы найти такое положение, при котором луч отразится обратно и попадет на определенный приемник мужского объекта.
С первого раза правильное положение могло быть неизвестно. Тогда отражатель перебирал варианты.
Нашел нужное положение - мужская машина получает подтверждение результата и посылает ответный звуковой сигнал.
Внутреннее состояние обеих машин после успешного взаимодействия изменяется. Через некоторое время они снова начинают двигаться и искать других участников. Со стороны это могло выглядеть почти как ухаживание. Паск и сам использовал намеренно биологизированное описание поведения своих машин. Но технически здесь происходила последовательность измерений, сигналов, перемещений и изменений внутренних переменных.
При второй встрече поиск уже мог быть короче
Самая содержательная часть системы находилась в женских объектах.
Они могли запоминать удачное положение отражателя.
Если та же машина снова встречала знакомого партнера при том же типе сигнала, ей уже не требовалось полностью перебирать возможные положения. Предыдущий успешный результат использовался при новом поиске.
Причем разные мужские объекты могли требовать разного положения отражателя.
Паск прямо предусматривал такую ситуацию. Один объект мог получать нужный результат при отражении луча вверх, другой - вниз. Женская машина должна была постепенно различать их и накапливать сведения о предыдущих встречах.
Поэтому память относилась не просто к действию "поднять отражатель". Она связывала определенного партнера, конкретный сигнал и результат взаимодействия.
Для установки 1968 года это была довольно сложная схема поведения.
Все пять систем работали одновременно
Коллоквиум не проигрывал заранее подготовленную последовательность. Три женские и две мужские системы работали параллельно и независимо. Их двигатели, датчики, лампы и внутренние состояния менялись одновременно.
Из-за этого ситуация в пространстве постоянно перестраивалась.
Пока один объект пытался завершить взаимодействие, другой мог продолжать поиск. Женская машина могла получить сигнал в тот момент, когда ее собственное состояние ему не соответствовало. Успешная встреча меняла параметры участников, поэтому их дальнейшее поведение уже отличалось от предыдущего.
У двух мужских объектов была еще одна проблема: часть механики они делили между собой. Если один хотел остановиться после обнаружения партнера, а другой в этот момент продолжал поиск, их требования вступали в конфликт. Паск предусмотрел отдельный механизм разрешения такого противоречия, связанный с текущей силой внутренних состояний обоих объектов.
То есть взаимодействовали не только пары. Поведение одного участника могло физически мешать другому.
Внутри не было центрального компьютера, который руководил спектаклем
Это принципиальная особенность работы Паска.
Не существовало единой программы, которая заранее знала, что сейчас объект номер один должен повернуться к объекту номер три, включить лампу и через пять секунд остановиться.
Каждый из пяти участников имел собственную систему управления.
Установка была собрана на аналоговой и электромеханической технике: двигателях, реле, датчиках света, генераторах сигналов, лампах, переключателях и схемах памяти.
Электромеханическую часть создавал Тони Уоттс, электронику строил Марк Доусон. Форму женских объектов разработала художница и сценограф Иоланда Зоннабенд.
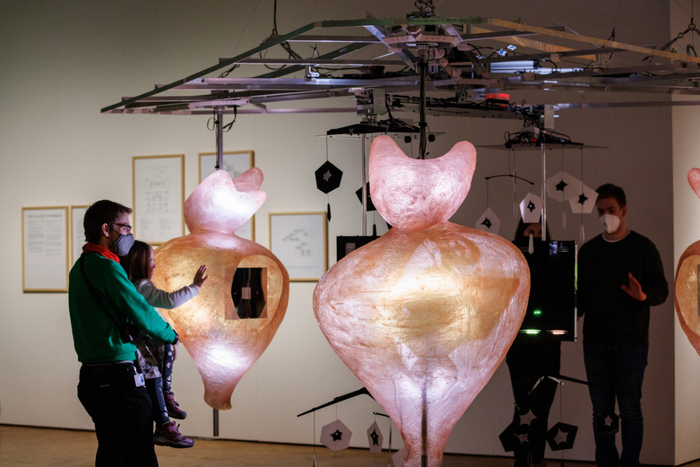
По сохранившимся фотографиям особенно хорошо видно, насколько далеким результат был от привычного образа лабораторного прибора. Это были крупные скульптурные конструкции человеческого масштаба, рассчитанные на выставочный зал.
Посетитель попадал внутрь действующей системы
Паск не хотел, чтобы публика просто стояла за ограждением и наблюдала за движущимися механизмами.
Людей предполагалось включать в происходящее, позволяя им использовать сигналы, понятные машинам. Если человек воспроизводил подходящий световой или звуковой знак, объект мог реагировать на него как на часть своей среды.
Здесь есть важное ограничение для исторического описания.
Подробнейшая статья Паска со схемами работы "Коллоквиума" была написана до окончательной сборки выставочной версии. Исследователи, которые спустя пятьдесят лет реконструировали установку, обнаружили расхождения между схемами, фотографиями и фактической геометрией объектов.
Поэтому не каждую деталь предварительного проекта можно автоматически считать точным описанием того, что работало в зале в августе 1968 года.
Сам факт взаимодействия объектов между собой и с посетителями подтвержден. А точную реализацию отдельных цепей приходится восстанавливать по нескольким источникам.
Даже восстановить эту машину через пятьдесят лет оказалось сложно
К пятидесятилетию проекта группа исследователей решила собрать полноразмерную копию Коллоквиума.
И быстро выяснилось, что подробного комплекта чертежей готовой установки не существует.
Оригинальная статья Паска содержала схемы, описание поведения и блоки управления, но была написана до завершения работы. На некоторых рисунках нашли ошибки в расположении элементов. Оригинальная электроника не сохранилась, а людей, непосредственно занимавшихся ее сборкой, уже нельзя было расспросить.
Исследователям пришлось разбирать работу почти археологически: сопоставлять фотографии 1968 года, схемы Паска, описания поведения и сохранившиеся фильмы.
Даже форму женских объектов восстанавливали по нескольким фотографиям с разных ракурсов.
Копию в итоге решили строить с современной электроникой, сохранив прежде всего логику поведения оригинала.
Это довольно точно показывает сложность проекта Паска. Через полвека воспроизвести внешний вид оказалось проще, чем восстановить последовательность взаимодействий пяти машин.
Выставка закончилась, а оригинальная установка почти исчезла
"Коллоквиум подвижных объектов" показывали на выставке в Лондоне с августа по октябрь 1968 года. После нее судьба отдельных частей установки прослеживается плохо.
Дочь Паска позже вспоминала женские скульптуры в саду семьи, но неизвестно, были ли это именно выставочные объекты или опытные образцы. Есть сведения о перевозке материалов выставки в США, однако точную дальнейшую историю всей установки исследователям восстановить не удалось.
В результате от проекта осталось необычное сочетание источников: фотографии, описание Паска, схемы управления, несколько записей и поздняя реконструкция.
По ним можно довольно подробно восстановить одну встречу машин.
Мужской объект вращается и мигает. Женский принимает сигнал и отвечает звуком. Первый останавливается и включает постоянный свет. Второй ищет отражателем подходящий угол. Луч возвращается на приемник. Обе системы изменяют внутреннее состояние и расходятся.
А при следующей встрече одна из них уже может помнить, куда направлять отражатель.