Neyroskuf

Neyroskuf

Авторский блог Андрея Калашникова. Пишу про нейросети и ИИ. Подписывайтесь на мой ТГ-канал https://t.me/neyroskuf
На Пикабу
в топе авторов на 723 месте
111 рейтинг 1 подписчик 1 подписка 18 постов 0 в горячем
0

Зарубежные нейросети для транскрибации аудио⁠⁠

Зарубежные нейросети для транскрибации аудио
Итак, наша основная задача такая - быстро забрать буквы из звука и получить внятный текст. Желательно адекватного качества и без разорительных поминутных тарифов.

Сразу подчеркнем. Это не топ, не рейтинг и не раздача медалей. Никого не рекламируем, ничего не навязываем и не выбираем, какой сервис лучше. Девяносто процентов рынка - это одинаковые обертки над Whisper с наценкой за красивые кнопки. Лучший сервис для себя вы выберете сами.

Но руками расшифровывать многочасовые записи в 2026 году будут только мазохисты. А задачи у всех разные. Студенту нужна запись лекции в текст онлайн, чтобы сделать конспект. Журналисту требуется быстро преобразовать интервью в черновик. Монтажеру важно вычистить шум или извлечь текст из песни, отделив музыку от вокала. Автору контента нужно перегнать сырые голосовые сообщения в текст, а инженеру нужен просто API и все.

Да, качественное преобразование звука и точная транскрипция на русском языке (да и на многих других) работают из коробки. Но идеальный преобразователь под каждый каприз не существует, будь то запись по нажатию красной кнопки на диктофоне или созвон.

Ниже - краткая подборка из восьмидесяти зарубежных инструментов с реальными ценами и лимитами на осень 2026 года, проверенными на сайте каждого сервиса.

Облачные платформы для файлов и субтитров

Универсальные комбайны для тех, кому лень возиться с кодом или скриптами. Забирают файл или внешнюю ссылку, позволяют быстро преобразовать аудио в текст с помощью нейросетей, расставляют таймкоды и выгружают готовый документ.

1. HypeScribe - международная веб-платформа с оплатой за готовые файлы вместо минутного счетчика. Один токен равен одному файлу или ссылке произвольной длительности с переносом неизрасходованного остатка. Напрямую вытягивает звук из YouTube, TikTok, Instagram, X, Loom, Vimeo и Google Drive, имеет бота для Zoom, Meet и Teams, а также встроенный чат с ChatGPT и Claude. Бесплатно дает 3 файла до 1 часа, подписка стоит от $6.99 за 30 файлов до $12.99 за 300 файлов.

2. Rev - американский сервис с возможностью выбора между нейросетью и ручной работой. Автоматика выдает черновой текст за 5 минут за $0.25 в минуту с точностью около 95 процентов, а профессиональные стенографисты обеспечивают 99 процентов за $1.50-2.50 за минуту. Подписка стоит $29.99 в месяц за 20 часов ИИ.

3. TurboScribe - облачный сервис на движке Whisper Large v3, рассчитанный на тяжелые пакеты аудио. Без проблем принимает дорожки весом до 5 ГБ и длительностью до 10 часов в форматах MP3, M4A, WAV, MP4 и MKV на 134 языках. Бесплатно дает 3 файла в день до 30 минут, а подписка Pro открывает честный безлимит часов за $10 в месяц при годовой оплате либо $20 помесячно.

4. Transkriptor - доступный европейский сервис с веб-интерфейсом, мобильными клиентами и расширением для Chrome. Поддерживает более 100 языков, разделяет участников диалога и забирает дорожки из облачных дисков. Тариф Lite стоит $4.99 за 5 часов, Standard обходится в $9.99 за 20 часов, а Pro дает 40 часов за $14.99 в месяц.

5. Sonix - платформа для журналистов и студий видеопроизводства с жесткой привязкой текста к звуковой волне. Синхронизируется с Dropbox, Google Drive, Box и OneDrive, распознает 50+ языков и соответствует требованиям стандарта безопасности SOC 2. Разовый тариф берет $10 за час без подписки, а тариф Premium обходится в $22 в месяц плюс $5 за каждый час.

6. Notta - универсальный рабочий комбайн из веб-кабинета, расширения Chrome и мобильных приложений. Записывает звук с микрофона в реальном времени, принимает файлы до 1 ГБ на 58 языках и формирует списки задач. Бесплатно дает 120 минут по 3 минуты на запись, платные тарифы стоят от $8.25 до $13.99 в месяц за 1 800 минут.

7. Cockatoo - скоростной минималистичный сервис без перегруженного интерфейса для быстрой конвертации аудио и видео в текст. Распознает более 90 языков с качественной пунктуацией и выгружает результат в PDF, DOCX, TXT и SRT. Бесплатный тариф пробный, безлимитный Pro стоит $9.99 в месяц при годовой оплате либо $15 помесячно.

8. Trint - корпоративная платформа для крупных новостных редакций уровня BBC и Washington Post. Заточена под параллельную совместную работу репортеров над текстом в реальном времени с защитой по стандарту ISO 27001. Тариф Starter стоит $52 за пользователя в месяц, план Advanced обойдется в $60 в месяц за безлимит.

9. Happy Scribe - европейская платформа из Барселоны со строгим соблюдением стандартов защиты данных GDPR. Предлагает выбор между быстрым ИИ-распознаванием и профессиональной вычиткой людьми с экспортом в субтитры STL, SRT и VTT. Автоматический тариф стоит от $10 в месяц за 120 минут, вычитка людьми обойдется от $1.75 за минуту.

10. Temi - бюджетный скоростной сервис от компании Rev для быстрого получения чернового текста без переплат. Проглатывает чистые дорожки за считанные минуты, расставляя таймкоды и спикеров с точностью до 90 процентов без скрытых условий. Стоимость зафиксирована на уровне $0.25 за минуту.

11. Amberscript - голландский сервис с акцентом на академический сектор, европейские медицинские клиники и госучреждения. Обеспечивает строгую изоляцию данных на серверах в ЕС и поддерживает 39 языков. Автоматическая обработка стоит от $10 за час, ручная стенография стартует от $1.90 за минуту.

12. Veed.io - браузерный видеоредактор с удобным модулем генерации субтитров для создателей контента. Распознает сотню языков, вырезает паузы нажатием одной кнопки и накладывает стилизованные титры. Бесплатный тариф накладывает водяной знак, платные тарифы Basic и Pro начинаются от $12 до $24 в месяц.

13. GoTranscript - международная фабрика расшифровки с распределенным штатом живых специалистов. Справляется с тяжелыми записями с сильным фоновым шумом, эхом и жесткими акцентами, предлагая перевод на 60 языков. Автоматический тариф стоит от $0.20 за минуту, ручная расшифровка начинается от $0.80 за минуту.

14. Scribie - проверенный временем американский сервис транскрибации с многоступенчатой проверкой качества. Автоматический режим на базе нейросетей справляется с дорожками за пару минут, а вычитка редакторами дает гарантию 99 процентов. Автоматика стоит $0.10 за минуту, ручная стенография обойдется от $0.80 за минуту.

15. Flixier - облачный редактор видео, выполняющий транскрибацию непосредственно на серверах без нагрузки на процессор компьютера. Распознает дорожки менее чем за минуту и поддерживает прямой экспорт на YouTube и в облачные хранилища. Базовый тариф бесплатен, подписка Pro стоит от $14 в месяц.

16. Maestra AI - комплекс для создания мультиязычного контента, объединяющий транскрибацию, генерацию субтитров и голосовой дубляж на 125 языках. Умеет клонировать тембр спикера и накладывать озвучку с синхронизацией по времени. Разовые часы стоят от $10 за час, подписка обойдется от $19 в месяц.

17. EasySub - онлайн-генератор субтитров с автоматическим переводом на 150 языков. Заточен под динамичные вертикальные ролики для TikTok и Shorts с гибким выбором шрифтов и стилей анимации титров. Короткие видео обрабатываются бесплатно, тариф Pro стоит от $9.90 в месяц.

18. Simon Says - специализированный модуль для монтажных пакетов Adobe Premiere, Final Cut Pro и DaVinci Resolve. Синхронизирует готовую расшифровку непосредственно с монтажным столом проекта на 100 языках с поддержкой многоканального звука. Тарифы начинаются от $15 в месяц либо от $0.25 за минуту.

19. Audext - простой веб-сервис для быстрой расшифровки подкастов и обучающих записей без лишних настроек. Автоматически определяет собеседников и подсвечивает спорные слова, встроенный плеер позволяет замедлять воспроизведение. Час обработки стоит $12 либо $30 по ежемесячной подписке.

20. Kukarella - сервис двойного назначения, объединяющий распознавание речи в текст и генерацию новой озвучки из каталога дикторских голосов. Позволяет расшифровать интервью и сразу озвучить материал другим тембром. Поддерживает MP3, WAV и M4A, тарифы начинаются от $9 в месяц.

21. Gglot - доступный конвертер речи в текст для переводчиков и авторов онлайн-курсов. Очищает звук от низкочастотных помех, генерирует субтитры на 60 языках и поддерживает экспорт в YouTube, Word и SRT. Бесплатный тариф тестовый, платные пакеты начинаются от $10 в месяц.

22. ScriptMe - скандинавская облачная платформа для телепроизводства, медиа-агентств и студий локализации. Поддерживает защищенную совместную работу, распределение ролей в команде и экспорт таймкодов для монтажных пакетов. Подписка стоит от $29 в месяц за базовый пакет часов.

23. Alrite - европейское облачное решение с поддержкой аудиофайлов, видео и внешних потоковых ссылок. Обеспечивает высокую точность распознавания европейских языков, разделяет спикеров и хранит данные с соблюдением требований GDPR. Пробный доступ бесплатный, подписка стартует от $10 в месяц.

24. Ebby.co - проверенный веб-сервис для создания субтитров и стенограмм с покадровой точностью. Расставляет таймкоды, экспортирует форматы SRT, VTT, DOCX и позволяет вносить правки во встроенном редакторе. Стоимость составляет от $6 за час без оформления обязательной подписки.

Медиа-редакторы с монтажом через текст

Инструменты для подкастеров и авторов видео. Позволяют кромсать видеоряд прямо через редактирование букв, удаляя эканье, паузы и слова-паразиты в один клик.

25. Riverside.fm - студийная платформа для записи удаленных подкастов и интервью с сохранением несжатого звука WAV и 4K-видео локально у каждого участника. Встроенный транскрибатор на базе Whisper с точностью свыше 95 процентов позволяет монтировать выпуск прямо по тексту. Тарифы составляют от $15 до $24 в месяц.

26. Descript - отраслевой стандарт видеомонтажа, превративший работу со звуком в редактирование текстового документа. Стираете фразу в тексте, и она вырезается из дорожки. Включает студийную чистку Studio Sound, удаление пауз и клонирование голоса Overdub. Бесплатно дает 1 час в месяц, тарифы стоят от $12 до $24 в месяц.

27. Opus Clip - скоростная платформа для нарезки длинных горизонтальных видео на вертикальные вирусные клипы для TikTok и Shorts. Анализирует расшифровку речи, находит яркие моменты и собирает короткие ролики с динамическими субтитрами. Бесплатно дают 60 минут, подписка Pro стоит от $9 в месяц.

28. Castmagic - маркетинговый сервис для авторов подкастов и экспертных блогов. Загруженная аудиозапись автоматически превращается в статьи для блогов, треды в X, посты для LinkedIn и темы email-рассылок по настраиваемым инструкциям. Стоимость тарифов начинается от $23 в месяц.

29. CapCut - массовый видеоредактор от ByteDance с высокоточной встроенной функцией создания автоматических субтитров. Быстро распознает речь на десятках языков, генерирует синхронный текст и предлагает стили анимации титров. Полностью бесплатен для большинства базовых задач монтажа.

30. Podcastle - браузерная цифровая студия для авторов разговорных шоу и подкастов. Предлагает удаленную многоканальную запись, чистку шума нейросетью Magic Dust, автоматическую расшифровку речи и синтез дикторских голосов. Базовый план бесплатен, тариф Storyteller стоит от $11.99 в месяц.

31. Submagic - генератор стильных динамических субтитров для коротких вертикальных видеороликов. Распознает речь на 50 языках, расставляет акцентные цвета на ключевых словах, добавляет подходящие эмодзи и звуковые эффекты. Стоимость подписки начинается от $16 в месяц.

32. Vizard.ai - специализированный видеоредактор для маркетологов, перерабатывающий вебинары и лекции в короткие клипы по тексту на 30 языках. Предоставляет готовые шаблоны оформления под фирменный стиль компаний, платные тарифы начинаются от $16 в месяц.

33. Adobe Premiere Pro Speech-to-Text - профессиональная нативная технология распознавания речи, встроенная непосредственно в монтажный пакет Premiere Pro. Позволяет расшифровывать диалоги на таймлайне и искать нужные фразы в материале без дополнительных внешних платежей.

34. Kapwing - облачный видеоредактор с функцией генерации автоматических субтитров на 70 языках. Позволяет редактировать текст на монтажном столе и переводить титры для международной аудитории. Базовый тариф бесплатный, подписка Pro стоит от $16 в месяц.

35. DaVinci Resolve Studio - встроенный модуль распознавания речи в профессиональном видеоредакторе от компании Blackmagic Design. Работает локально на движке DaVinci Neural Engine, создавая субтитры на монтажном столе без интернета в рамках бессрочной лицензии.

36. Deciphr AI - платформа автоматизации финальной обработки для авторов разговорных шоу. За пару минут превращает аудиофайл в полную стенограмму с таймкодами, краткое содержание выпуска и подборку цитат для обложек. Бесплатный план включает базовые часы, платные тарифы стартуют от $19 в месяц.

37. Munch - платформа извлечения самых вовлекающих фрагментов длинных видео на основе комплексного анализа речи и трендов соцсетей. Транскрибирует дорожку, вычисляет потенциал вирусности отрывка и нарезает ролики с субтитрами. Профессиональная подписка стоит от $49 в месяц.

Офлайн и локальные утилиты

Выбор тех, у кого есть стойкое желание работать на своем собственном железе. Эти решения для транскрибации аудио в текст крутят открытые модели на вашей собственной видеокарте без отправки звука в чужие облака.

38. Whisper Desktop - легковесная скоростная утилита для Windows с открытым исходным кодом на базе DirectCompute. Задействует видеокарты Nvidia и AMD для быстрой локальной расшифровки аудиофайлов любых форматов абсолютно бесплатно.

39. MacWhisper - лидер среди локальных программ для компьютеров Apple на чипах M1-M4. Задействует библиотеку Whisper.cpp и графическое ускорение Metal для расшифровки звука прямо на компьютере без интернета. Базовая версия бесплатна, вечная лицензия Pro за 29 евро открывает модель Whisper Large v3.

40. Aiko - полностью бесплатная программа для iOS и macOS с открытым исходным кодом от независимого разработчика Sindre Sorhus. Запускает модель Whisper Large v3 прямо на процессоре устройства без интернета, рекламы, ограничений по длине дорожки и телеметрии.

41. Subtitle Edit - профессиональный редактор субтитров с открытым исходным кодом со встроенными движками локального нейросетевого распознавания Whisper, Vosk и Purfview. Пользователи могут генерировать субтитры на мощностях видеокарты полностью бесплатно.

42. Buzz - кроссплатформенная программа с открытым исходным кодом для Windows, macOS и Linux для транскрибации речи с микрофона и готовых файлов. Поддерживает выбор между локальными моделями Whisper и внешними API, экспортируя результат в SRT, VTT и TXT.

43. Vibe - компактный кроссплатформенный офлайн-транскрибатор для Windows, macOS и Linux на базе архитектуры whisper.cpp. Отличается предельно простым интерфейсом, минимальным потреблением оперативной памяти и поддержкой аппаратного ускорения без рекламы.

44. Whispering - минималистичный инструмент для локальной диктовки текста на компьютере с открытым исходным кодом. Позволяет нажатием горячей клавиши надиктовать мысль в микрофон, перевести ее в текст через встроенный движок Whisper и вставить в активное окно программы.

ИИ-ассистенты и боты для созвонов

Для тех, чей рабочий день забит бесконечными созвонами в Zoom или Google Meet. Сюда входят виртуальные помощники и боты в Телеграмм, которые слушают звонок и фиксируют договоренности.

45. Fathom - любимый инструмент фрилансеров с полностью бесплатным базовым тарифом без ограничений по длительности созвонов. Бот аккуратно подключается к Zoom, Google Meet и Teams, формируя структурированный конспект сразу после завершения звонка. Командная версия стоит от $19 за пользователя в месяц.

46. Fireflies.ai - популярный корпоративный ассистент для отделов продаж и проектных офисов. Бот Fred слушает Zoom, Meet, Teams и Webex на 69 языках, анализирует соотношение речи спикеров и отправляет заметки в Salesforce, HubSpot и Slack. Память на 800 минут доступна бесплатно, подписка Pro стоит от $10 за пользователя в месяц.

47. Tactiq - браузерное расширение для Google Chrome, перехватывающее субтитры встреч в Google Meet, Teams и Zoom напрямую из веб-интерфейса без видимых ботов. Сохраняет историю разговоров и формирует сводки через модели OpenAI. Бесплатно дает 10 созвонов в месяц, тариф Pro стоит от $8 в месяц.

48. tl;dv - сервис записи видеовстреч в Google Meet и Zoom для продуктовых команд и дизайнеров. Сохраняет видео, формирует текст с таймкодами и позволяет нарезать цитаты клиентов на короткие видеоклипы для отправки в Slack. Базовый тариф бесплатен, расширенная версия Pro стоит от $18 за пользователя в месяц.

49. Otter.ai - флагманский американский сервис с функцией OtterPilot, которая во время звонка делает снимки экрана с презентацией и вшивает слайды в стенограмму. Оптимизирован строго под английский язык, бесплатный тариф дает 300 минут в месяц с лимитом 30 минут на звонок, платная подписка Pro стоит от $10 в месяц.

50. Krisp - приложение шумоподавления для микрофона со встроенным фоновым секретарем. Убирает посторонние шумы в реальном времени, параллельно формируя стенограмму звонка без запуска внешних ботов. Базовое шумоподавление бесплатно, пакет с транскрибацией стоит от $8 в месяц.

51. Supernormal - корпоративный генератор официальных управленческих протоколов и отчетов для руководства. Заходит в Google Meet, Zoom и Teams, раскладывая встречу по специализированным корпоративным шаблонам с рассылкой отчетов участникам. Базовый тариф бесплатен, Pro стоит от $15 в месяц.

52. Jamie - европейский ассистент представительского класса для топ-руководителей. Работает нативно на macOS и Windows без ботов, захватывая системный звук с аудиокарты с сохранением приватности по законам GDPR в Германии. Генерирует сводки решений на десятках языков, подписка стоит от 24 евро в месяц.

53. MeetGeek - облачный ассистент, создающий структурированную базу корпоративных знаний на основе записанных встреч. Записывает видео, распознает речь, тегирует важные моменты и синхронизирует задачи с Trello, Asana и Notion. Бесплатный тариф включает 5 часов в месяц, тариф Pro стоит от $15 в месяц.

54. Bluedot - легкое расширение для Chrome, записывающее встречи в Google Meet без добавления сторонних ботов. Захватывает экран в высоком разрешении, генерирует точную расшифровку и составляет шаблоны писем с договоренностями. Стоимость подписки составляет от $18 в месяц.

55. Grain - специализированный помощник для исследователей пользовательского опыта и специалистов поддержки. Пишет созвоны в Zoom и Google Meet, помогая быстро размечать ключевые мысли клиентов и собирать нарезки видеоцитат с выгрузкой в CRM. Базовый тариф бесплатный, подписка начинается от $15 в месяц.

56. Avoma - комбайн для отделов продаж, объединяющий повестку встреч, расшифровку звонков и обучение менеджеров. Анализирует речь сотрудников, проверяет соблюдение сценариев разговора и оценивает шансы на закрытие сделок с автозаполнением CRM. Подписка стартует от $19 за пользователя в месяц.

57. Fellow.app - платформа для планирования повесток совещаний, ежедневных летучек и созвонов один на один. Встроенный ИИ-помощник протоколирует ход беседы, фиксирует договоренности и распределяет задачи внутри команды. Интегрирован со Slack и Jira по цене от $7 за пользователя в месяц.

58. Sembly AI - умный секретарь, умеющий прийти на созвон вместо вас в Zoom, Meet, Teams или Webex и прислать конспект с решениями. Разделяет спикеров, подсвечивает риски и формирует списки поручений для отсутствовавших коллег. Базовый тариф бесплатен, тариф Pro стоит от $10 в месяц.

59. Colibri.ai - система распознавания речи в реальном времени для сотрудников кол-центров и телефонных продаж. Транслирует текст разговора прямо на экран оператора, подсказывая аргументы против возражений клиентов и сверяя данные с базой. Тарифы начинаются от $16 за пользователя в месяц.

60. Cogram - корпоративный ассистент с банковским уровнем шифрования данных для компаний со строгими требованиями к безопасности. Протоколирует встречи, интегрируется с системами ERP и гарантирует полную изоляцию данных созвонов. Тарифы рассчитываются персонально для корпоративных заказчиков.

61. Read AI - аналитический комбайн, измеряющий вовлеченность участников встречи параллельно с транскрибацией речи. Оценивает эмоциональный фон беседы, скорость речи, баланс времени спикеров и формирует стенограмму с таймкодами. Базовый тариф бесплатный, подписка Pro стоит от $15 в месяц.

62. Circleback - персональный секретарь для руководителей проектов и консультантов. Превращает разговор в четкий список задач и черновик вежливого письма с итогами созвона, позволяя задавать вопросы по содержанию прошлых планерок через чат. Подписка стоит около $25 в месяц.

Голосовые заметки и персональная продуктивность

Решения для тех, кто думает вслух на ходу. Превращают сумбурный поток сознания в структурированные заметки, списки задач и черновики писем без ручной правки.

63. Voicenotes.com - умный диктофон с веб-кабинетом и мобильными клиентами, превращающий надиктованные мысли в персональную базу знаний. Расшифровывает звук с высокой точностью, делает краткую выжимку и позволяет вести диалог со своими записями через ИИ-чат по подписке около $10 в месяц.

64. AudioPen - инструмент для продуктивности, который переписывает хаотичный поток голосовых заметок в структурированный текст. Наговаривайте мысли сбивчиво, а языковая модель вычистит словесный мусор и перепишет монолог в связное эссе. Подписка Prime стоит $15 в месяц либо $75 в год.

65. Wispr Flow - интеллектуальная система голосовой диктовки для компьютеров под macOS и Windows, заменяющая ручной набор текста. Позволяет надиктовывать фразы прямо в любое активное окно программы со скоростью втрое выше клавиатуры по подписке от $12 в месяц.

66. Letterly - мобильное приложение для смартфонов, мгновенно перерабатывающее разговорную речь в грамотные посты, заметки и деловые письма. Наговариваете черновик на бегу, и приложение выдает чистый результат без ошибок. Подписка обойдется от $9.99 в месяц.

67. TalkNotes - голосовой органайзер, переводящий наговоренные идеи в статьи, протоколы встреч или списки покупок на 50 языках. Полученные тексты легко систематизировать по папкам и тегам, стоимость годовой подписки составляет от $8 в месяц.

68. Coconote - студенческое мобильное приложение для записи лекций с мгновенной автоматической транскрибацией речи преподавателя. Выделяет главное из лекции, формирует структурированный конспект и генерирует проверочные карточки по подписке от $7.99 в месяц.

Облачные API и фундаментальные движки

Тяжелая артиллерия для разработчиков, которым не нужны чужие красивые кнопки. ИИ для транскрибации аудио в текст с доступом по API, минимальной задержкой и копеечной ценой за минуту.

69. Groq Audio API - сверхбыстрый облачный доступ к модели Whisper Large v3 на процессорах собственной архитектуры LPU. Платформа переваривает часовую аудиодорожку за 4-8 секунд, предлагая рекордную скорость инференса на рынке по цене $0.0005 за минуту аудиозаписи.

70. Deepgram - признанный мировой рекордсмен по скорости потокового распознавания речи на базе моделей семейства Nova-2 и Nova-3. Задержка обработки составляет менее 300 миллисекунд, стоимость составляет от $0.0043 за минуту готового файла и около $0.0059 за минуту потока.

71. OpenAI Whisper API - официальный облачный интерфейс модели whisper-1 от создателей архитектуры. Показывает высокую точность на десятках мировых языков, легко интегрируется через стандартные REST-запросы по цене $0.006 за минуту аудио любого формата.

72. AssemblyAI - продвинутый облачный API для разработчиков на базе моделей Universal-1 со встроенной аналитикой речи Speech Intelligence. Умеет автоматически разбивать разговор на главы, определять тональность и маскировать персональные данные от $0.0065 за минуту.

73. Gladia.io - высокопроизводительный мультиязычный API-движок реального времени на базе оптимизированной архитектуры Whisper. Решает классическую проблему галлюцинаций Whisper на тишине с задержкой около 300 миллисекунд по цене от $0.006 за минуту.

74. Speechmatics - британская платформа на базе движка Ursa Engine, признанная эталоном понимания тяжелых акцентов, диалектов и зашумленных треков. Обеспечивает высочайшую точность на 50 языках в сложных акустических условиях по цене около $0.01 за минуту записи.

75. Rev AI - программный доступ к нейросетевым моделям распознавания речи платформы Rev, обученным на миллионах часов транскрибированного вручную контента. Отличается высокой устойчивостью к шуму и поддержкой словарей по цене от $0.0033 за минуту для разработчиков.

76. Google Cloud Speech-to-Text - промышленный движок распознавания речи от компании Google на базе мультимодальных моделей линейки Chirp 2. Оптимизирован для инфраструктуры Google Cloud, поддерживает 125 языков и потоковое распознавание по тарифам от $0.016 за минуту.

77. Amazon Transcribe - корпоративный сервис от AWS с поддержкой пользовательских словарей терминологии и отраслевых профилей. Включает медицинский движок Transcribe Medical, сертифицированный для обработки врачебных записей по тарифам от $0.024 за минуту.

78. Microsoft Azure AI Speech - мощный инфраструктурный сервис распознавания речи от компании Microsoft, обеспечивающий субтитры в Teams, Office 365 и Copilot. Поддерживает перевод речи в реальном времени и синтез персональных голосов по тарифам от $0.016 за минуту.

79. Fal.ai Whisper Endpoints - специализированная бессерверная платформа для разработчиков, предлагающая мгновенный запуск открытых моделей Whisper с посекундной оплатой. Оптимизирована под микросервисные архитектуры с высокой пропускной способностью и низкой стоимостью обработки.

80. IBM Watson Speech to Text - классическая корпоративная платформа, поддерживающая развертывание в изолированных частных облаках и на локальных серверах заказчика. Широко применяется банками и телекомами для анализа звонков в защищенном контуре.

Идеальных инструментов под все задачи не существует

К сожалению, главная иллюзия - надежда найти одну волшебную кнопку на все случаи жизни. Ее нет.

Рынок речевых технологий - это вечный размен одного компромисса на другой. Удобные облачные комбайны с красивым интерфейсом сжигают сотни долларов на поминутных тарифах. Платформы с фиксированной оплатой за файл экономят бюджет, но могут тупить на сложном перебивании спикеров. Локальные утилиты гарантируют железную приватность, но требуют нормального железа. А дешевые API требуют умения писать код.

Мы никого не выделяем и не собираемся продавать вам чужие подписки. Смотрите на форматы своих файлов, тестируйте бесплатные лимиты на собственном звуке и выбирайте то, что решает вашу задачу.

Показать полностью

Обзор российской нейросети для презентаций Сократик 2.0⁠⁠

Никто в здравом уме в 2026 году уже не открывает древний офисный софт, чтобы собирать слайды вручную. Эта эпоха благополучно сдохла. Все давно сидят в нейронках и всякого рода веб-генераторах. Казалось бы, наступило светлое будущее, где нажал одну кнопку и пошел пить кофе.

Но вместо экономии времени мы получили, собственно, как и ожидалось - стерильное изделие, которое нужно еще некоторое время кастомизировать. И, получается, ручную верстку мы никуда не убрали, но еще и добавили параноидальный фактчекинг за поплывшими мозгами языковых моделей.

Любой доступный и бесплатный современный генератор презентаций охотно нарисует вам потрясающий футуристичный визуал для красивого выступления на митапе. Но попробуйте скормить ему реальные рабочие данные. Вы заливаете выгрузку расходов, сервис бодро выкатывает лощеные карточки, а внутри половина цифр высосана из пальца.

Ну вот решила нейросеть, что круглое число смотрится эстетичнее, а динамику прибыли можно и досочинить для красивого графика. За такой фокус на созвоне с клиентом или руководством - могут и сильно огорчиться по итогу.

Главным эталоном тут всегда была западная Gamma. Будем честны, Сократик по своей сути во многом аккуратно повторяет ее логику и интерфейс, стараясь быть отечественной альтернативой. Но у оригинала есть критический тупик в корпоративном сегменте. Оплатить зарубежный сервис из России сегодня - это квест. А главное, бухгалтерии безналичный счет с закрывающими актами туда не пришьешь ни при каких обстоятельствах. А бизнес - это, скажем так, именно та ЦА, которой и нужны 100500 презентаций в год.

Пример работы с презентацией в редакторе Gamma.

Пример работы с презентацией в редакторе Gamma.

Отечественный рынок тоже радует изобилием.

Slider AI просит 1 600 рублей в месяц за 20 токенов. Студия Лебедева в Фокусе дает сделать одну попытку и сажает на подписку за 990 рублей ежемесячно. SlidePoint продает доступ на три дня за 99 рублей с лимитом в десять слайдов, а PresentSimple держит планку в районе 690 рублей. Функционал у всех схож, но вот упор скорее на разовую красивость, а не на объемные исходные данные.

В конце сентября выкатили Сократик 2.0. Ребята заявили, что забили на пустую гонку за секундной генерацией картинок и сфокусировались на утилитарной задаче. А именно на точном переносе данных из файлов без галлюцинаций. Да, еще активно поработали над фидбеком. Так что - продукт вышел с УТП "ИИ, который делает вашу презентацию, а не свою". Интересно, давайте проверим.

И мы сразу решили нагрузить систему тем, от чего стандартные модели обычно гарантированно съезжают с катушек. Загнали сорокастраничный Excel с реальными строками затрат, прикрепили тридцатистраничный PDF регламента техподдержки, черновик стратегии и тяжелый массив SEO-запросов.

План был простой - поймать алгоритм на вранье.

Сервис всеяден и переваривает документы до пятидесяти страниц в форматах .xlsx, .pdf, .docx и .pptx, ссылки и обычный текст. Пустые запросы в строку писать нет никакого смысла, на выходе получится очень водянистая компиляция. Вся фишка раскрывается, когда падает именно тяжелый исходник.

Движок сначала вычитывает документ, вытаскивает из него смысловые слои и собирает черновой скелет на 10-35 слайдов. На этом этапе генерация еще не запущена. Вы выбираете язык и один из трех десятков готовых шаблонов оформления, заточенных под разные задачи от отчетов до питчей. Если файл слишком кривой или данных объективно мало, система задает несколько уточняющих вопросов прямо в интерфейсе.

Тут важно не щелкать клювом.

Перед финальной сборкой идет короткий брифинг черновика. Потратьте эти три минуты. На этом экране вы сами распределяете базовые паттерны презентации по каждому слайду. Закрепляете таблицу под расходы, выделяете место под график динамики, а свои очень умные выводы собираете отдельным списком.

Дальше запускаем генерацию.

Открываем результат, лезем в цифры и ловим тот самый разрыв шаблона. Математика сошлась копейка в копейку. Расходы по статьям, проценты выполнения планов и даты легли строго по ячейкам без единого округления. Никаких придуманных показателей. Это живой векторный файл в форматах .pptx и .pdf, где текст остается текстом, а таблицы таблицами. Все легко дорабатывается в обычном PowerPoint, Keynote или Google Slides, ничего не сплющилось в скриншоты.

С 20 сентября разработчики официально перевели сервис на балансовую систему токенов. Старые неудобные счетчики попыток убрали, теперь вы сами решаете, куда расходовать баланс. Токены списываются строго за действия нейросетей, то есть за промпты в ИИ-чате для ужимания текста или за генерацию картинок через подключенные модели GPT-Image и Nano Banana. Ручная работа и базовое создание слайдов баланс не трогают совсем.

В веб-редакторе живут два параллельных режима.

С одной стороны работает точечный ИИ-чат, где можно текстом попросить разбить тезисы на две колонки, убрать лишнюю воду или ужать выводы в три пункта.

С другой стороны включен мощный мануальный режим, куда в сентябре завезли кучу удобств. Там можно вручную менять цвет любых SVG-элементов, удалять лишние плашки, вставлять собственные фото, менять глобальные палитры всей колоды в один клик и выделять блоки рамкой, чтобы перемещать их пачкой и менять размер прямо как в графических редакторах.

А вот где платформа раскрывается на полную мощность, так это в командном и корпоративном контуре.

Здесь наконец-то решили вечную головную боль отделов, когда десять человек пересылают друг другу файлы в Telegram с названиями вроде финальный_отчет_v12_исправленный. В Сократик встроили полноценное комментирование прямо на слайдах в духе Figma. Любой согласующий кликает на спорный график, открывает тред, вешает замечание исполнителю, а после правок закрывает задачу кнопкой решения. При этом в сайдбаре висят удобные фильтры по авторам, слайдам и статусу решения, так что ни одна правка руководства не потеряется.

Для распределения ролей администратор в один клик задает уровни доступа. Кому-то дается только просмотр, клиенту можно открыть режим комментирования, а аналитикам выдать полное редактирование.

Но главное спасение для бизнеса - в юридической и финансовой чистоте. Сервис работает от официального юрлица ООО "Сократик", все серверы физически находятся в РФ, а персональные данные и коммерческая тайна защищены нашими законами, так что у службы безопасности не возникает вопросов при согласовании. Оплата для компаний и ИП идет по безналичному расчету по выставленному счету с получением всех актов и закрывающей первички для бухгалтерии.

Под команду выделяется единый корпоративный баланс токенов, так что сотрудникам не приходится побираться с личными картами. Пул пополняется централизованно, а внутри отдела маркетологи, аналитики и сейлы спокойно тратят его под свои задачи.

База уже перевалила за 3 миллиона аккаунтов и 15 тысяч компаний при почти полумиллионе активных пользователей в месяц. Авторизацию оставили строго по почте через одноразовый код, потому что вход через Google и Discord вырезали по закону.

Нооо... илюзий строить не надо, минусы на месте.

Бренд-кита с автоподстановкой логотипов компании во все углы здесь нет, их придется натягивать руками после экспорта. Мобильного приложения, единого входа SSO и общих библиотек корпоративных шаблонов тоже нет, сидим строго в десктопном браузере. Картинки от нейросетей на платных тарифах для строгих отчетов не нужны, свои скриншоты кабинетов надежнее в разы.

По деньгам модель выстроена вполне прагматично. Сама сборка структуры и ручная правка в браузере не стоят ничего. Платным является чистый экспорт без водяного знака и пополнение токенов для ИИ-редактора. Разовый файл обойдется в 189 рублей, месячный доступ стоит 469 рублей, а годовой тариф отдают за 2 490 рублей. Если вы готовите отчеты регулярно, годовая подписка отбивается всего за пять месяцев по сравнению с помесячной оплатой.

В итоге перед нами крепенький такой прикладной инструмент. Превратить сорок страниц сырых таблиц в аккуратные слайды к созвону и не сгореть со стыда из-за фантомных цифр - Сократик 2.0 эту задачу закрывает на ура.

Показать полностью 7
5

В 1987 году Хинтон запустил эволюцию искусственных организмов и разрешил им учиться⁠⁠

Представим организм, которому для выживания нужна совершенно точная комбинация из двадцати признаков. Девятнадцать правильных не дают ему никакого преимущества. Восемнадцать тоже. Выигрывает только тот, у кого совпали все двадцать.

В 1987 году Хинтон запустил эволюцию искусственных организмов и разрешил им учиться

Для естественного отбора такая задача крайне неудобна. Между плохим и почти правильным вариантом нет разницы, поэтому двигаться к решению постепенно невозможно. Остается ждать, пока нужная комбинация случайно возникнет целиком.

Именно такую намеренно жесткую задачу в 1987 году придумали Джеффри Хинтон и Стивен Ноулан.

Их интересовал старый вопрос эволюционной биологии: может ли способность организма обучаться в течение жизни ускорять эволюцию, даже если приобретенные знания потомкам не передаются?

Чтобы проверить это, они создали одну из самых известных компьютерных моделей эффекта Болдуина.

Двадцать генов и только один правильный ответ

Каждый искусственный организм Хинтона и Ноулана получал набор из двадцати генов. Каждый ген мог находиться в одном из трех состояний.

Первое означало, что определенная связь в условной нервной сети присутствует. Второе - что ее нет. Третье оставляло решение открытым: организм мог подобрать состояние этой связи в течение своей жизни.

Авторы обозначили эти варианты символами 1, 0 и ?.

Правильной считалась только одна конфигурация - все двадцать связей должны были получить нужное состояние. Любая ошибка делала сеть неподходящей. Таким образом, пространство поиска содержало больше миллиона возможных комбинаций: 2 в двадцатой степени. Причем у отбора не было никаких промежуточных подсказок. Организм с девятнадцатью правильными связями без способности к обучению получал тот же базовый результат, что и организм, у которого правильных связей почти нет.

Хинтон и Ноулан сознательно выбрали столь искусственную задачу. Им нужна была ситуация, в которой обычному эволюционному поиску максимально трудно приблизиться к решению постепенно.

Знак вопроса менял правила

Главная часть опыта начиналась с генов, обозначенных вопросительным знаком. Такая связь не была заранее закреплена как правильная или неправильная. Во время жизни организма ее состояние можно было пробовать менять.

Само обучение в модели было предельно примитивным. Организм случайным образом устанавливал все неопределенные связи и проверял результат. Если комбинация не подходила, пробовал снова. На это давалось не более тысячи попыток. Никакой разумной стратегии поиска не существовало. Организм буквально перебирал случайные варианты.

Но даже этого оказалось достаточно.

Представим особь, у которой десять связей уже генетически заданы правильно, а еще десять оставлены для обучения. Для десяти неопределенных связей существует 1024 возможных комбинации. При тысяче попыток шанс случайно найти нужную становится вполне заметным.

Совсем другая ситуация возникает, если среди жестко заданных генов уже есть хотя бы один неправильный. Исправить его обучением невозможно. Такая особь не найдет решение независимо от числа попыток.

В результате преимущество получают организмы с очень определенным сочетанием признаков: они должны избегать генетически закрепленных ошибок, но могут оставлять часть решений открытыми для обучения.

Учились особи, а менялась популяция

В каждой генерации модель содержала тысячу организмов.

В начале для каждого гена вероятность получить неопределенное состояние составляла 50 процентов. Правильный и неправильный жестко заданные варианты встречались примерно по 25 процентов.

Получался характерный начальный организм: около десяти решений были заданы генетически, остальные десять оставались на обучение.

Каждая особь получала до тысячи попыток найти правильную конфигурацию. Тот, кто находил ее быстро, получал большое преимущество при размножении. Найденное во время жизни решение потомкам при этом не передавалось.

Это принципиальная часть опыта.

Если организм в ходе обучения выяснил, как правильно установить семь неопределенных связей, его ребенок эти семь ответов не получал. Потомок наследовал только исходные гены, включая те же знаки вопроса, и должен был обучаться заново.

Никакого наследования приобретенных признаков модель не допускала.

Тем не менее через несколько поколений генетический состав популяции начинал меняться.

Сначала исчезали жестко неправильные решения

Причину легко увидеть.

Особь хотя бы с одним генетически закрепленным неправильным состоянием практически лишалась возможности получить правильную сеть. Обучение такой ген исправить не могло.

Поэтому неправильные варианты постепенно удалялись отбором.

Правильные варианты, напротив, становились распространеннее. Организм, у которого часть решений уже была генетически задана верно, оставлял обучению меньше работы и в среднем находил нужную конфигурацию быстрее.

Но знаки вопроса полностью не исчезали.

И это один из наиболее содержательных результатов модели.

Когда большая часть жестко заданных решений уже правильна, оставшиеся несколько неопределенных связей очень легко подобрать в течение жизни. Поэтому давление отбора в пользу их окончательного генетического закрепления становится слабым.

На графике Хинтона и Ноулана неправильные варианты быстро падают почти до нуля. Доля правильных растет примерно до 60 процентов, а значительная часть генов продолжает оставаться изменяемой.

Обучение не исчезает после того, как помогло эволюции. Оно остается выгодной частью решения.

Что здесь произошло с точки зрения отбора

Без обучения существовал один высокий пик: единственная полностью правильная комбинация. Все остальные варианты находились на одном низком уровне.

Отбору буквально не за что было зацепиться.

Обучение изменило ситуацию. Организмы, находящиеся генетически ближе к правильной комбинации, чаще могли закончить работу в течение жизни. Чем меньше неопределенных связей им оставалось подобрать, тем раньше они находили решение и тем больше потомков оставляли.

Получилась постепенная зависимость там, где раньше ее не было.

Гены все еще не получали информацию о том, чему научился конкретный организм. Но способность к обучению делала одни наследуемые сочетания выгоднее других.

В этом и состояла идея эффекта Болдуина, предложенная еще в конце XIX века: приобретенный навык не обязан напрямую записываться в наследственность, чтобы обучение влияло на направление эволюции.

Хинтон и Ноулан показали этот механизм на компьютерной модели.

Результат оказался слишком красивым, и к нему вернулись позже

Работа быстро стала известной далеко за пределами исследований искусственных нейронных сетей. Ее регулярно приводили как наглядную демонстрацию того, как обучение способно ускорить появление сложных наследуемых признаков.

Но сама модель была специально построена как крайний случай.

Длина набора составляла двадцать генов. В популяции было тысяча организмов. Каждому разрешалось сделать до тысячи попыток обучения. При этом у типичной особи около десяти связей оставались неопределенными.

Эти числа очень удачно совпадали.

Для десяти неопределенных переключателей существует 1024 варианта. А организм получает почти столько же попыток их перебрать.

Позднейшие исследователи обращали внимание именно на эту особенность. Если увеличить число генов, сохранив прежнее число попыток, задача резко усложняется. Например, при тридцати связях преимущество уже не возникает столь быстро.

Есть и более принципиальная оговорка.

В 2017 году Хосе Фонтанари и Мауро Сантос повторно разобрали модель и указали, что исходный опыт особенно хорошо показывает отбор способности к обучению, но не полностью демонстрирует превращение выученного поведения во врожденное. В модели Хинтона и Ноулана значительная доля неопределенных генов сохранялась даже после десятков поколений.

Это не делает работу ошибочной. Просто первоначальный результат оказался уже, чем его иногда пересказывают.

И еще одна деталь

Модель Хинтона и Ноулана действительно описывала условную нервную сеть, но сама процедура обучения этой сети почти не имела отношения к тому, что Хинтон исследовал в других работах.

Никакого распространения ошибки назад, настройки числовых весов или обучения на примерах здесь не было.

У сети существовало двадцать потенциальных связей. Неопределенные связи случайно включались и выключались до тех пор, пока не возникала единственная правильная конфигурация.

Авторы специально выбрали такой грубый механизм, чтобы исключить преимущества умного поиска. Им требовалось показать, что даже случайное обучение способно изменить действие естественного отбора.

Поэтому исторически эта работа интересна не как ранний вариант современной нейросети.

Это эксперимент над двумя видами поиска.

Один поиск идет между поколениями: отбор меняет частоты генов.

Второй происходит внутри одной жизни: организм перебирает варианты неопределенных связей.

Хинтон и Ноулан просто разрешили этим двум процессам работать одновременно и посмотрели, что изменится.

Через несколько десятков поколений неправильные жестко заданные варианты почти исчезли. Правильных стало значительно больше. А часть решений так и осталась на усмотрение обучения.

Показать полностью
6

В 1968 году пять машин на выставке искали друг друга с помощью света и звука⁠⁠

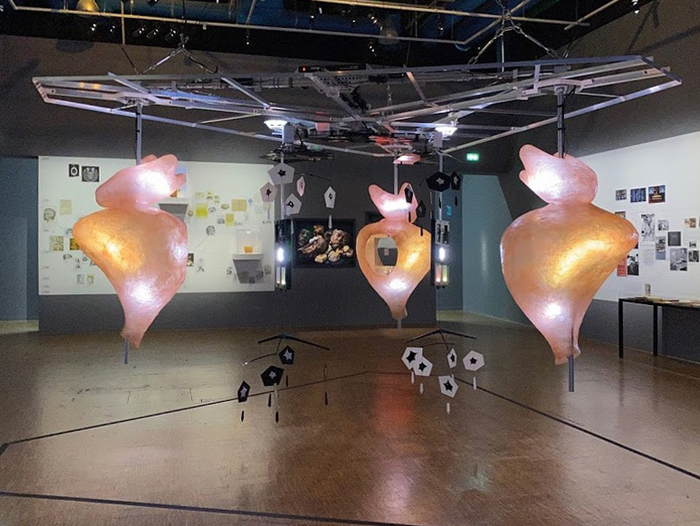
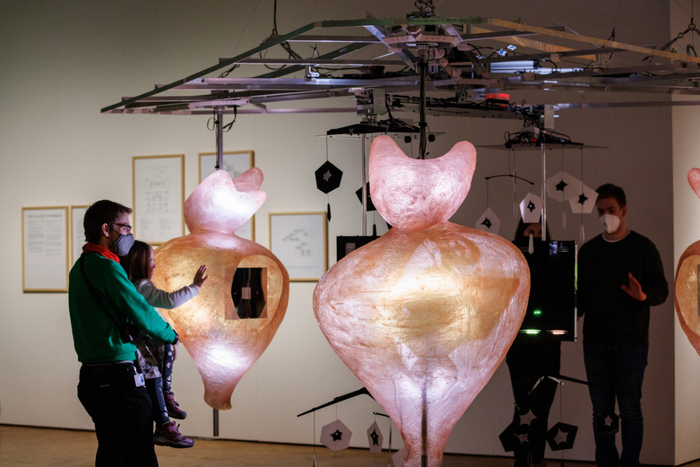
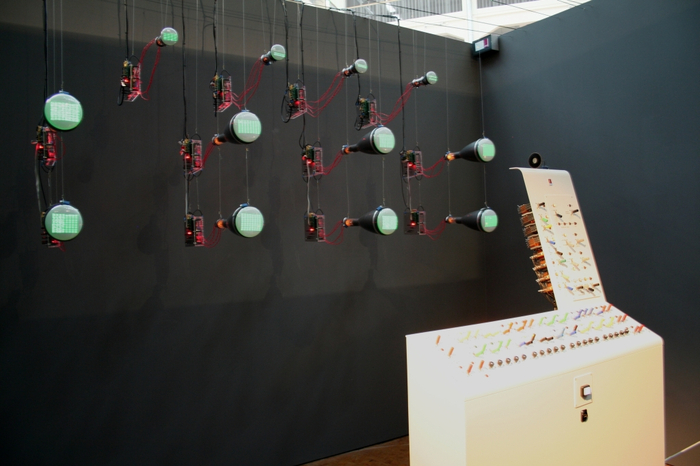
В лондонском Институте современного искусства в 1968 году под потолком висели пять крупных подвижных объектов. Они медленно вращались, мигали лампами, издавали звуки и реагировали друг на друга.

Два объекта Гордон Паск обозначил как мужские, три - как женские. Такое деление было частью логики установки: у них различались устройство, поведение и способы взаимодействия.

Работа называлась "Коллоквиум подвижных объектов" и была создана для выставки "Кибернетическая неожиданность".

Проще всего понять ее устройство, если проследить одно взаимодействие от начала до конца.

Мужской объект начинает поиск

У каждого мужского объекта было два внутренних состояния потребности. Паск обозначал их условными буквами. В зависимости от того, какое состояние в данный момент преобладало, машина искала соответствующий тип взаимодействия.

Допустим, первая потребность превышает заданный порог.

Объект начинает вращаться и посылает направленный прерывистый световой сигнал. Частота мигания несет сразу несколько сведений: какой именно объект его отправил и какого результата он сейчас добивается.

Рядом одновременно вращаются три женских объекта. Они тоже находятся в разных внутренних состояниях и реагируют не на любой сигнал.

Поэтому простого попадания луча недостаточно.

Сначала должна встретиться подходящая пара.

Свет попадает на приемник

В какой-то момент мигающий луч мужского объекта попадает на световой приемник одного из женских.

Она определяет, соответствует ли полученный сигнал ее собственному текущему состоянию. Если нет, взаимодействие не развивается. Если соответствует, женский объект отвечает звуком, синхронизированным с входящим световым сигналом.

Это важная часть схемы Паска. Звук здесь служит подтверждением: "сигнал принят, взаимодействие возможно".

Мужской объект улавливает совпадение своего светового сигнала с полученным звуком и останавливает движение.

После этого режим работы меняется. Вместо слабого прерывистого сигнала он включает мощный постоянный свет.

Теперь начинается вторая часть процесса.

Женская машина должна вернуть свет обратно

На женском объекте находился подвижный отражатель. После получения постоянного луча он начинал перемещаться по вертикали. Задача состояла в том, чтобы найти такое положение, при котором луч отразится обратно и попадет на определенный приемник мужского объекта.

С первого раза правильное положение могло быть неизвестно. Тогда отражатель перебирал варианты.

Нашел нужное положение - мужская машина получает подтверждение результата и посылает ответный звуковой сигнал.

Внутреннее состояние обеих машин после успешного взаимодействия изменяется. Через некоторое время они снова начинают двигаться и искать других участников. Со стороны это могло выглядеть почти как ухаживание. Паск и сам использовал намеренно биологизированное описание поведения своих машин. Но технически здесь происходила последовательность измерений, сигналов, перемещений и изменений внутренних переменных.

При второй встрече поиск уже мог быть короче

Самая содержательная часть системы находилась в женских объектах.

Они могли запоминать удачное положение отражателя.

Если та же машина снова встречала знакомого партнера при том же типе сигнала, ей уже не требовалось полностью перебирать возможные положения. Предыдущий успешный результат использовался при новом поиске.

Причем разные мужские объекты могли требовать разного положения отражателя.

Паск прямо предусматривал такую ситуацию. Один объект мог получать нужный результат при отражении луча вверх, другой - вниз. Женская машина должна была постепенно различать их и накапливать сведения о предыдущих встречах.

Поэтому память относилась не просто к действию "поднять отражатель". Она связывала определенного партнера, конкретный сигнал и результат взаимодействия.

Для установки 1968 года это была довольно сложная схема поведения.

Все пять систем работали одновременно

Коллоквиум не проигрывал заранее подготовленную последовательность. Три женские и две мужские системы работали параллельно и независимо. Их двигатели, датчики, лампы и внутренние состояния менялись одновременно.

Из-за этого ситуация в пространстве постоянно перестраивалась.

Пока один объект пытался завершить взаимодействие, другой мог продолжать поиск. Женская машина могла получить сигнал в тот момент, когда ее собственное состояние ему не соответствовало. Успешная встреча меняла параметры участников, поэтому их дальнейшее поведение уже отличалось от предыдущего.

У двух мужских объектов была еще одна проблема: часть механики они делили между собой. Если один хотел остановиться после обнаружения партнера, а другой в этот момент продолжал поиск, их требования вступали в конфликт. Паск предусмотрел отдельный механизм разрешения такого противоречия, связанный с текущей силой внутренних состояний обоих объектов.

То есть взаимодействовали не только пары. Поведение одного участника могло физически мешать другому.

Внутри не было центрального компьютера, который руководил спектаклем

Это принципиальная особенность работы Паска.

Не существовало единой программы, которая заранее знала, что сейчас объект номер один должен повернуться к объекту номер три, включить лампу и через пять секунд остановиться.

Каждый из пяти участников имел собственную систему управления.

Установка была собрана на аналоговой и электромеханической технике: двигателях, реле, датчиках света, генераторах сигналов, лампах, переключателях и схемах памяти.

Электромеханическую часть создавал Тони Уоттс, электронику строил Марк Доусон. Форму женских объектов разработала художница и сценограф Иоланда Зоннабенд.

По сохранившимся фотографиям особенно хорошо видно, насколько далеким результат был от привычного образа лабораторного прибора. Это были крупные скульптурные конструкции человеческого масштаба, рассчитанные на выставочный зал.

Посетитель попадал внутрь действующей системы

Паск не хотел, чтобы публика просто стояла за ограждением и наблюдала за движущимися механизмами.

Людей предполагалось включать в происходящее, позволяя им использовать сигналы, понятные машинам. Если человек воспроизводил подходящий световой или звуковой знак, объект мог реагировать на него как на часть своей среды.

Здесь есть важное ограничение для исторического описания.

Подробнейшая статья Паска со схемами работы "Коллоквиума" была написана до окончательной сборки выставочной версии. Исследователи, которые спустя пятьдесят лет реконструировали установку, обнаружили расхождения между схемами, фотографиями и фактической геометрией объектов.

Поэтому не каждую деталь предварительного проекта можно автоматически считать точным описанием того, что работало в зале в августе 1968 года.

Сам факт взаимодействия объектов между собой и с посетителями подтвержден. А точную реализацию отдельных цепей приходится восстанавливать по нескольким источникам.

Даже восстановить эту машину через пятьдесят лет оказалось сложно

К пятидесятилетию проекта группа исследователей решила собрать полноразмерную копию Коллоквиума.

И быстро выяснилось, что подробного комплекта чертежей готовой установки не существует.

Оригинальная статья Паска содержала схемы, описание поведения и блоки управления, но была написана до завершения работы. На некоторых рисунках нашли ошибки в расположении элементов. Оригинальная электроника не сохранилась, а людей, непосредственно занимавшихся ее сборкой, уже нельзя было расспросить.

Исследователям пришлось разбирать работу почти археологически: сопоставлять фотографии 1968 года, схемы Паска, описания поведения и сохранившиеся фильмы.

Даже форму женских объектов восстанавливали по нескольким фотографиям с разных ракурсов.

Копию в итоге решили строить с современной электроникой, сохранив прежде всего логику поведения оригинала.

Это довольно точно показывает сложность проекта Паска. Через полвека воспроизвести внешний вид оказалось проще, чем восстановить последовательность взаимодействий пяти машин.

Выставка закончилась, а оригинальная установка почти исчезла

"Коллоквиум подвижных объектов" показывали на выставке в Лондоне с августа по октябрь 1968 года. После нее судьба отдельных частей установки прослеживается плохо.

Дочь Паска позже вспоминала женские скульптуры в саду семьи, но неизвестно, были ли это именно выставочные объекты или опытные образцы. Есть сведения о перевозке материалов выставки в США, однако точную дальнейшую историю всей установки исследователям восстановить не удалось.

В результате от проекта осталось необычное сочетание источников: фотографии, описание Паска, схемы управления, несколько записей и поздняя реконструкция.

По ним можно довольно подробно восстановить одну встречу машин.

Мужской объект вращается и мигает. Женский принимает сигнал и отвечает звуком. Первый останавливается и включает постоянный свет. Второй ищет отражателем подходящий угол. Луч возвращается на приемник. Обе системы изменяют внутреннее состояние и расходятся.

А при следующей встрече одна из них уже может помнить, куда направлять отражатель.

Показать полностью 2
4

В 1939 году речь научились играть руками на машине⁠⁠

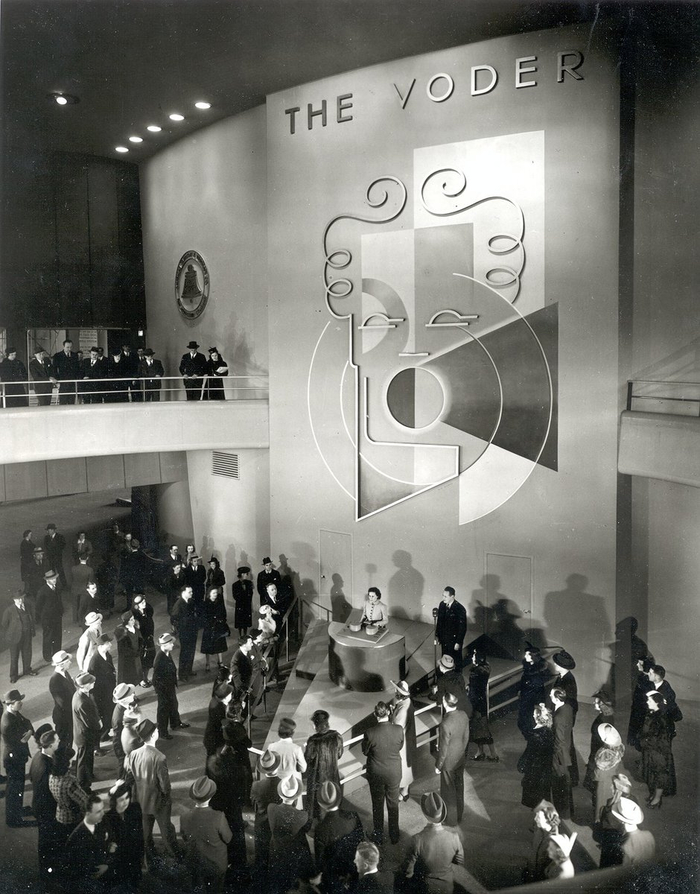
В январе 1939 года в Институте Франклина в Филадельфии публике показали аппарат, способный произносить целые фразы человеческим голосом. Через несколько месяцев его демонстрировали уже тысячам посетителей Всемирных выставок в Нью-Йорке и Сан-Франциско.

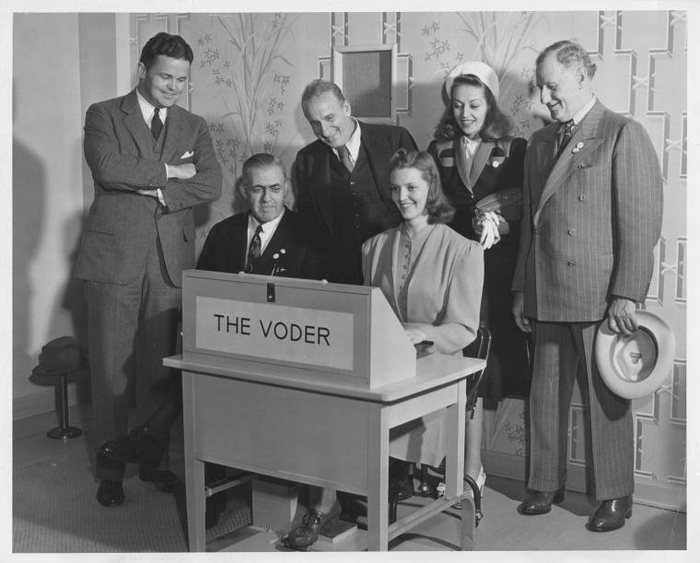
Аппарат назывался Водер. Его разработали в Лабораториях Белла под руководством инженера Гомера Дадли.

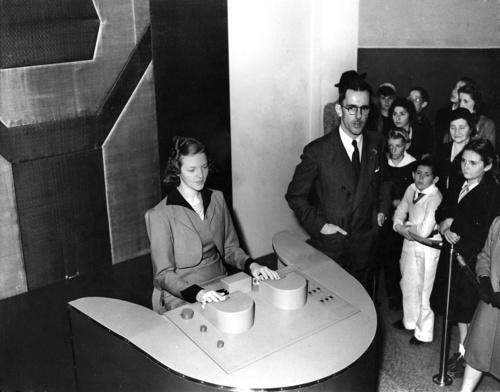
На сцене сидела женщина за пультом с клавишами. Перед ней не было микрофона, в который кто-то незаметно говорил. Водер действительно создавал речь электронным способом.

Но самостоятельно он не произносил ни слова.

Каждый звук собирала оператор.

Фразу приходилось буквально исполнять

Управление Водером больше напоминало музыкальный инструмент, чем пишущую машинку.

Перед оператором находились десять основных клавиш. Каждая управляла определенной полосой частот. Нажимая несколько клавиш одновременно с разной силой, можно было менять спектр звука и получать гласные и часть согласных.

Правой рукой оператор управляла еще тремя клавишами для коротких согласных звуков вроде "п", "б", "т", "д", "к" и "г".

Запястье переключало два основных источника звука.

Первый создавал периодическое гудение. Оно имитировало работу голосовых связок и использовалось для звонких звуков и гласных.

Второй создавал шум. Он был нужен для глухих согласных вроде "с" и "ш".

Под ногой находилась педаль, которая управляла высотой голоса.

Чтобы Водер произнес слово, оператор должна была за доли секунды выбрать нужный источник, нажать правильную комбинацию клавиш, изменить их положение, вовремя переключить согласные и одновременно ногой провести нужную интонацию.

Обычное "нажать букву" здесь не работало.

Машина вообще не знала букв

Это, пожалуй, самое непривычное свойство Водера.

Для него не существовало буквы "а", слова "привет" или предложения "как ваши дела". Аппарат работал только со звуковыми составляющими речи.

Если нужно было произнести "мама", оператор не вводила четыре символа. Она вручную формировала последовательность акустических состояний, которые человеческое ухо воспринимало как это слово.

Гомер Дадли исходил из довольно точного наблюдения: речь можно описать не как набор записанных звуков, а через работу источника колебаний и изменение его спектра речевым трактом человека.

В человеческом голосе источник создают голосовые связки или поток воздуха. Язык, губы, зубы, рот и глотка изменяют получившийся звук.

В Водере голосовые связки заменял электронный генератор, поток воздуха - источник шума, а речевой тракт - набор электрических фильтров.

Оператор управляла этими искусственными органами вручную.

На обучение уходил год

Со стороны пульт Водера выглядел не слишком пугающе. Клавиш меньше, чем на фортепиано.

Научиться говорить на нем было гораздо сложнее.

Перед выставками Лаборатории Белла отобрали около 300 кандидаток из числа телефонных операторов. После отбора осталось 24 женщины. Их примерно год обучали управлению аппаратом.

Даже после обучения требовалась постоянная практика по несколько часов.

Причина проста: оператору нужно было выучить не написание слов, а движения, соответствующие звукам человеческой речи. Ошибка во времени на небольшую долю секунды могла превратить понятный слог в шум или совершенно другой звук.

Особенно трудным оказался звук "л". На одной из демонстраций посетители попросили Водер произнести название телефонной компании. Получившаяся фраза звучала заметно хуже обычной человеческой речи именно из-за этого звука.

Зато опытная оператор могла менять интонацию, высоту и характер голоса. Одно предложение можно было превратить из утверждения в вопрос только движением педали.

Водер мог изображать мужской, женский и более высокий детский голос.

Самая сложная часть аппарата сидела перед ним

Фотографии демонстраций Водера легко прочитать неправильно.

На них большая электронная установка, пульт и женщина за клавиатурой. Возникает впечатление, что оператор просто вводит команды, а машина выполняет основную работу.

Все было наоборот.

Электроника создавала исходные сигналы и пропускала их через фильтры. Но решение о том, какой звук нужен сейчас, сколько он должен длиться, какой будет его высота и как перейти к следующему звуку, принимала оператор.

Поэтому качество речи очень сильно зависело от ее мастерства.

В подписи к одной из фотографий Всемирной выставки 1939 года Лаборатории Белла прямо обращали внимание на искусство пальцев оператора, благодаря которому голос Водера звучал настолько хорошо.

Фактически человек выполнял ту часть работы, которую позднее научились автоматизировать вычислительные системы.

Почему Лаборатории Белла вообще занялись искусственным голосом

Водер не возник как попытка сделать механического собеседника.

Исследование началось с проблем телефонной связи.

Передавать человеческую речь дорого с точки зрения полосы частот. Обычный телефонный сигнал содержит намного больше данных, чем телеграфное сообщение. Инженеров интересовало, можно ли разобрать речь на основные параметры, передать только их, а на другой стороне снова собрать понятный голос.

Дадли работал над этой задачей с конца 1920-х.

Так появился аппарат, который анализировал человеческую речь, выделял ее основные характеристики и позволял затем восстановить звук.

Водер представлял другую половину этого процесса.

Анализатор из него убрали. Вместо электрической схемы, автоматически определяющей характеристики входящего голоса, поставили человека.

Оператор сама задавала машине все параметры речи.

Именно поэтому Водер был особенно удобен для демонстраций. Посетителю не нужно было объяснять сложную систему передачи телефонного сигнала. Достаточно было посадить человека за клавиатуру и заставить электронный шкаф разговаривать.

На выставке машина могла не только говорить

Создаваемый Водером звук зависел от тех же параметров, которыми описывается человеческая речь. Но никто не обязывал оператора использовать их только реалистично.

Меняя высоту, спектр и источник сигнала, можно было получать непривычные тембры, свисты и шумы.

Во время демонстраций аппарат использовали для подражания голосам и некоторым другим звукам. Возможности специально показывали шире обычной речи, чтобы посетители услышали, насколько сильно можно менять электронно созданный сигнал.

Для публики 1939 года сама идея была непривычной.

До этого звук машины обычно означал записанный человеческий голос, воспроизведенный через громкоговоритель.

Здесь записи не было.

Каждая фраза возникала в момент выступления.

Водер и вокодер - разные аппараты

Названия постоянно путают даже сейчас.

Вокодер анализировал настоящую человеческую речь. Его задача состояла в том, чтобы выделить основные характеристики голоса и передать их в более компактном виде.

Водер ничего не анализировал. Исходного человеческого голоса у него вообще не было.

Все управляющие сигналы задавал человек.

Можно представить разницу довольно просто. В одном случае машина сначала слушает человека и получает описание его речи. В другом это описание сразу вводит оператор.

Поэтому фотографии женщины за странной клавиатурой относятся именно к Водеру.

В 1939 году главным ограничением была не электроника

Сам аппарат уже умел создавать достаточно широкий набор звуков, чтобы из них получалась понятная речь.

Проблемой было управление.

Десять основных клавиш, дополнительные кнопки, переключатель под запястьем и педаль требовали очень точной координации. Человек должен был контролировать несколько параметров одновременно и выполнять последовательность движений быстрее, чем успевал задумываться над каждым отдельным звуком.

Обученные операторки справлялись.

Обычный посетитель выставки - нет.

И поэтому Водер не мог превратиться в устройство, на котором любой человек набирает предложение и сразу слышит голос.

Машина умела создавать речь.

Она еще не умела сама определять, как именно ее создать.

Спустя много лет сотрудник Лабораторий Белла Джеймс Флэнаган вспоминал, как для выхода Гомера Дадли на пенсию нашли один из старых Водеров, восстановили его и пригласили женщину, которая когда-то работала на демонстрациях.

Ее спросили, сможет ли она спустя годы заставить аппарат сказать простую фразу.

Она села за пульт и смогла.

Навык управления говорящей машиной оказался навыком в самом буквальном смысле - его носителем все это время оставался человек.

Показать полностью 3
2

Мышь Шеннона запоминала лабиринт с первого прохода, а вот мозг находился не в мыши⁠⁠

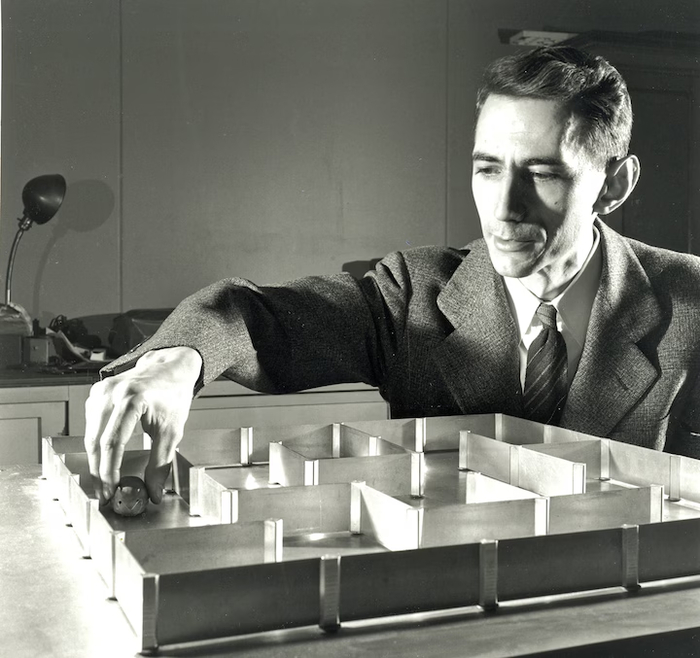
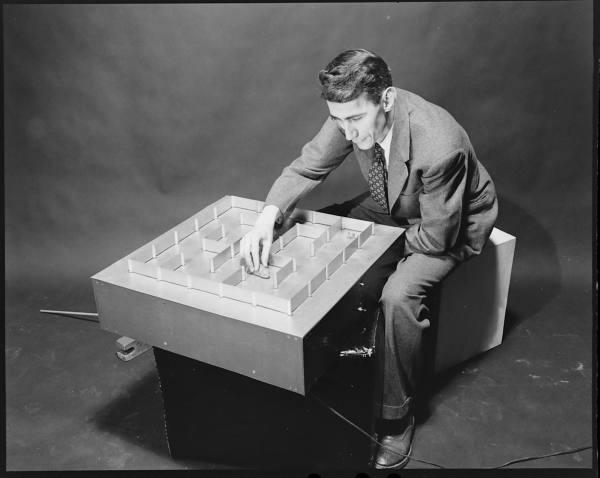
На первом проходе Тесей вел себя довольно беспомощно. Маленькая мышь двигалась по металлическому лабиринту, упиралась медными усиками в перегородки, отступала, поворачивала и пробовала другой коридор. Так продолжалось, пока она не находила цель.

Затем Клод Шеннон возвращал мышь в исходную точку.

Второй проход выглядел совсем иначе. Тесей больше не проверял тупики и не касался стен. Он сразу двигался по найденному маршруту и примерно за 12-15 секунд добирался до цели.

В начале 1950-х Шеннон построил одну из самых известных своих экспериментальных машин. Он занимался теорией информации и системами связи в Лабораториях Белла, но любил проверять идеи на вполне физических устройствах. Тесей был как раз таким случаем: задача с поиском пути, памятью и изменением поведения после первого опыта была собрана из реле, электродвигателей, магнитов и металлических перегородок.

Сама мышь почти ничего не делала

Внешность Тесея немного обманчива. Можно решить, что перед нами маленький самостоятельный робот, который каким-то образом ориентируется внутри лабиринта.

На самом деле внутри мыши не находился вычислительный механизм.

Корпус двигался на трех небольших колесах, спереди располагались медные усики для контакта со стенами, а главным элементом внутри был постоянный магнит. Под металлическим полом лабиринта находился подвижный электромагнит. Он перемещался в двух направлениях и тянул мышь за собой.

Вся управляющая система тоже была спрятана под столом.

Шеннон использовал примерно сотню электромеханических реле того же типа, который применялся в телефонной технике. Часть отвечала за управление движением, часть хранила сведения о пройденных участках.

Поэтому фраза "мышь запоминала лабиринт" удобна, но технически неточна. Запоминала его установка под лабиринтом.

Первый проход был исследованием

Перегородки можно было переставлять, каждый раз создавая новый маршрут. В конструкции было около сорока мест для установки алюминиевых стенок.

После изменения лабиринта Тесей не получал его схему заранее. Ему приходилось находить дорогу непосредственно во время движения.

Когда впереди оказывалась стена, усики мыши касались ее, система фиксировала препятствие и выбирала другое направление. Пройденные участки при этом записывались состояниями реле.

Постепенно машина исследовала сеть коридоров и в конце концов находила цель - электрический контакт, который в газетных и журнальных публикациях того времени называли сыром. При касании раздавался звонок.

На этом первый проход заканчивался.

Но накопленные состояния реле оставались.

Именно поэтому следующий запуск уже не был новым поиском.

Второй проход показывал, что система действительно сохранила маршрут

Шеннон снова помещал Тесея в лабиринт, и мышь двигалась непосредственно к цели.

В этом и состояла основная демонстрация. Машина не просто однажды случайно выбиралась из лабиринта. Она использовала информацию, полученную во время предыдущего поиска.

Можно было провести более интересный опыт.

Мышь помещали не в начальную точку, а в другое место, которое она уже посещала во время первого исследования. Тесей оттуда тоже шел к цели без нового перебора вариантов.

Значит, система запоминала не единственную последовательность команд вида "вперед, вправо, влево". В памяти сохранялась информация, связанная с отдельными участками лабиринта.

Был и третий вариант.

Тесея ставили в область, которой он раньше не посещал. Сначала машина снова начинала исследовать коридоры. Но как только попадала на знакомый участок, дальнейший маршрут уже не искала и переходила к сохраненному пути.

При этом новая часть пути добавлялась к уже накопленной информации.

Для демонстрационной машины начала 1950-х это было намного интереснее простого прохождения одного заранее заданного лабиринта.

Лабиринт можно было сломать после обучения

Шеннон специально предусмотрел изменение задачи.

После того как Тесей запоминал маршрут, одну или несколько перегородок можно было переставить. Старое решение становилось частично неправильным.

Машина сохраняла те участки маршрута, которые по-прежнему работали, и исследовала изменившуюся часть.

Но здесь возникала неприятная техническая проблема.

Старая память могла заставить систему многократно возвращаться к маршруту, которого больше не существовало. В определенных конфигурациях Тесей рисковал зациклиться: старое правило снова вело его к препятствию, затем система пыталась исправиться и возвращалась к тому же состоянию.

Шеннон предусмотрел защиту и от этого.

Если мышь несколько раз повторяла одну и ту же неудачную последовательность, специальная цепь заставляла машину отказаться от привычного поведения и снова начать исследование.

Сам Шеннон называл ее "антиневротической цепью".

Термин был шутливым, схема - вполне инженерной. Машине требовался механизм, который позволял перестать доверять собственной памяти, если окружающая обстановка изменилась.

Тесей не искал маршрут так, как мы рисуем его глазами

Человек, увидев лабиринт сверху, сразу получает большое преимущество: вся схема перед ним. Можно мысленно проследить несколько коридоров и найти удобный путь.

Тесей всей карты не видел.

Система получала информацию локально - здесь можно двигаться, здесь стоит стена. Следующее решение принималось на основе текущего положения и накопленной памяти.

Из-за этого первый проход мог выглядеть довольно неуклюже. Машина исследовала пути последовательно и иногда двигалась туда, где человек сразу увидел бы бесперспективный участок.

Зато после нахождения цели в памяти оставалось достаточно информации, чтобы повторный проход уже не требовал такого исследования.

Эта разница хорошо видна на сохранившихся фотографиях с длинной выдержкой. На первом снимке путь мыши выглядит как спутанный набор поворотов и возвратов. На втором - короткая линия непосредственно к цели.

Это, пожалуй, лучший способ показать работу Тесея вообще без схем и формул.

В 1952 году мышь стала небольшой знаменитостью

К этому времени Шеннон уже был известен далеко за пределами Лабораторий Белла. Его работа 1948 года по математической теории связи заложила основу современной теории информации.

А для широкой публики металлическая мышь была гораздо понятнее математических выкладок.

В мае 1952 года журнал Time выпустил заметку "Мышь с памятью". В июле фотографии Тесея появились в Life. Осенью Шеннон публично демонстрировал устройство инженерам и рассказывал о решении задач методом проб и ошибок, запоминании решения и изменении памяти после перестройки лабиринта.

Само название тоже хорошо подходило для газет.

Тесей в греческом мифе входит в лабиринт Минотавра и находит обратную дорогу благодаря нити Ариадны. У мыши Шеннона никакой нити не было. Маршрут сохраняли реле.

За игрушкой стояла вполне прикладная задача

Тесей часто попадает в подборки забавных машин Шеннона вместе с его жонглирующими автоматами, устройством для игры в шахматы и другими конструкциями.

Но лабиринт имел прямую связь с его работой в Лабораториях Белла.

Телефонная сеть того времени во многом представляла собой огромную систему переключателей. Чтобы соединить два аппарата, сигналу требовалось пройти через последовательность узлов и найти доступный маршрут.

Шеннона интересовали системы, способные искать решение, сохранять найденную информацию и использовать ее при следующей похожей задаче.

Для этого не обязательно было строить еще одну телефонную станцию.

Можно было построить лабиринт.

И пустить по нему мышь.

У Тесея есть еще один автор

Большинство историй о машине заканчиваются фамилией Шеннона, хотя в изготовлении устройства заметно участвовала его жена Бетти Шеннон.

Она была математиком и регулярно помогала Клоду с его работами и техническими проектами. По воспоминаниям семьи, именно Бетти закончила соединение проводов в Тесее. Более того, подаренный ею Клоду набор деталей для конструирования стал одним из толчков к серии домашних механических экспериментов Шеннона.

Сам Тесей сохранился.

Сегодня мышь и лабиринт находятся в коллекции музея Массачусетского технологического института. Сохранились и фотографии начала 1950-х, на которых Шеннон демонстрирует устройство, и снимки траекторий первого и повторного прохода.

Показать полностью 2
2

Как компьютер писал любовные письма еще в 1952 году⁠⁠

В начале 1950-х на доске объявлений вычислительной лаборатории Манчестерского университета стали появляться странные любовные письма. Они были короткими, немного нелепыми и очень настойчивыми: признания, желания, нежность, ревность, преданность. Внизу стояла подпись M.U.C. - компьютер Манчестерского университета.

Никакого тайного поклонника не существовало. Тексты печатал Ферранти Марк I - один из первых серийных компьютеров общего назначения.

Программу написал британский математик и программист Кристофер Стрэчи. Схема сохранилась до наших дней, причем в буквальном смысле: это лист бумаги с написанными от руки блоками, стрелками и условиями перехода.

Он датируется июнем 1952 года.

Письмо сначала разобрали на детали

Стрэчи не пытался научить компьютер писать свободный текст. Он поступил гораздо проще: выделил несколько частей, из которых обычно состоит любовное признание, подготовил набор подходящих слов и задал правила их соединения.

Сначала программа составляла обращение. Затем несколько раз выбирала один из двух типов предложения.

Первый был коротким: адресат объявлялся чьей-то нежностью, страстью, симпатией или другим объектом чувств.

Второй строился сложнее. В нем сочетались существительные, прилагательные, наречия и глаголы: одно чувство могло "нежно желать" другое, привязанность - "страстно обожать", а симпатия соединялась со случайно выбранным определением.

После нескольких предложений программа добавляла заключительную формулу и подпись.

Слова были заранее написаны человеком. Но конкретного письма заранее не существовало.

Компьютер создавал его во время выполнения программы.

Случайность была главным механизмом

Большое количество вариантов возникало не из огромного словаря, а из случайного выбора.

В нужный момент программа получала случайное число и по нему решала, какую конструкцию взять и какое слово поставить в свободное место.

Из нескольких десятков элементов можно было получить огромное количество сочетаний.

Исследователь истории вычислительной техники Дэвид Линк позже восстановил работу программы и подсчитал, что число возможных писем превышало 318 миллиардов.

Хранить их, конечно, было негде.

Основная быстрая память Ферранти Марк I была ничтожной по современным меркам. Поэтому Стрэчи хранил не готовые тексты, а правила их построения.

Это принципиальная разница. Компьютер не выбирал письмо из каталога. Он собирал его заново.

Грамматику машина соблюдала лучше, чем смысл

Чтобы текст хотя бы внешне напоминал нормальную речь, слова были разделены по назначению.

Прилагательные подставлялись туда, где требовалось прилагательное, существительные - на место существительных, глаголы - в соответствующую часть предложения.

Поэтому большинство фраз сохраняло грамматическую форму.

Со смыслом было хуже.

Программа не знала значения слов и не проверяла, насколько естественно они сочетаются. Из-за этого возникали странные комбинации: грамматически узнаваемые, но стилистически чрезмерные или просто нелепые.

Именно поэтому письма Стрэчи производят такое своеобразное впечатление. Некоторые фразы вполне можно принять за намеренно напыщенное признание. Другие сразу выдают механическую сборку текста.

Причем Стрэчи заметил еще одну проблему: случайность сама по себе быстро начинает повторяться.

Если одна и та же короткая конструкция выбиралась два раза подряд, программа могла изменить второй вариант, чтобы одинаковые предложения не стояли рядом в полной форме.

Небольшая деталь, но показательная. Уже в 1952 году автор автоматического текста столкнулся с проблемой однообразной структуры.

Сам компьютер занимал целую комнату

Ферранти Марк I появился в Манчестерском университете в 1951 году. Это была коммерческая версия экспериментальной манчестерской вычислительной машины, на которой несколькими годами раньше отрабатывались основные принципы компьютеров с хранимой программой.

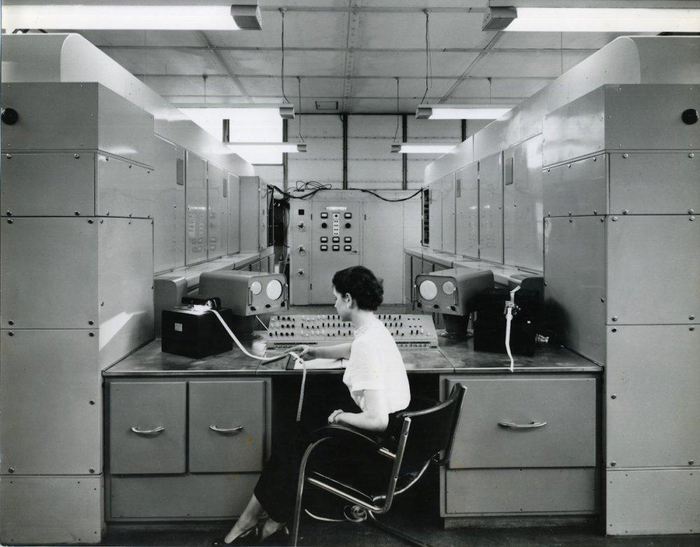
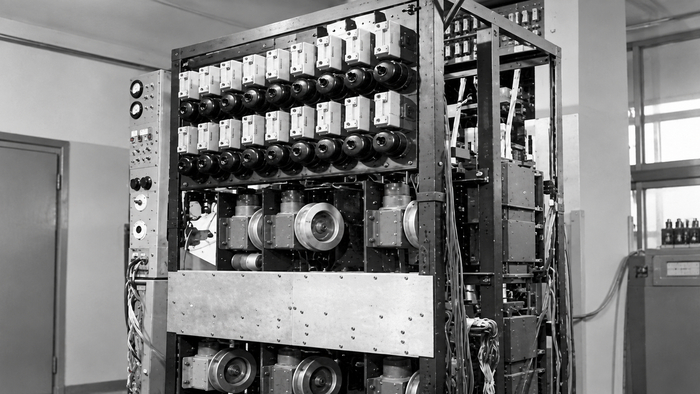
Машина состояла из шкафов с электроникой, электронно-лучевых трубок, магнитного барабана и большого пульта управления. Программы вводились совсем не так, как сегодня: программисту приходилось работать с системой команд, в которой даже обозначения были тесно связаны с устройством самой машины.

На этом оборудовании решали серьезные вычислительные задачи.

Стрэчи использовал его еще и для экспериментов с тем, что тогда вообще считалось подходящей работой для компьютера.

До любовных писем он уже написал программу для игры в шашки. Для начала 1950-х она была огромной - более тысячи команд.

Причем программировать манчестерскую машину Стрэчи помогал Алан Тьюринг, с которым он был знаком лично. Тьюринг передал ему руководство по программированию и участвовал в работе манчестерской группы.

В генераторе любовных писем Стрэчи использовал и механизм получения случайных чисел, реализованный на этой машине.

Автором программы при этом был именно Стрэчи.

Почему любовные письма вообще появились

Точного объяснения, зачем Стрэчи понадобился именно любовный текст, он не оставил.

Но выбор задачи хорошо соответствует его интересам того периода. Его занимали программы, результат которых нельзя полностью определить заранее.

Шашечная программа должна была выбирать ход в зависимости от состояния игры. Генератор писем использовал случайный выбор и создавал комбинации, которых программист заранее не выписывал.

Любовное письмо оказалось удобным материалом: его легко разбить на повторяемые языковые конструкции, а небольшая странность результата даже работает в пользу жанра. Чрезмерное количество слов о страсти и нежности здесь выглядит менее подозрительно, чем, например, в деловом письме.

В 1953-1954 годах полученные тексты действительно вывешивали на доске объявлений лаборатории.

Сотрудники прекрасно знали, кто такой M.U.C.

Шутка работала именно потому, что за сентиментальными признаниями стояла машина размером с комнату.

Рукописная схема оказалась интереснее самих писем

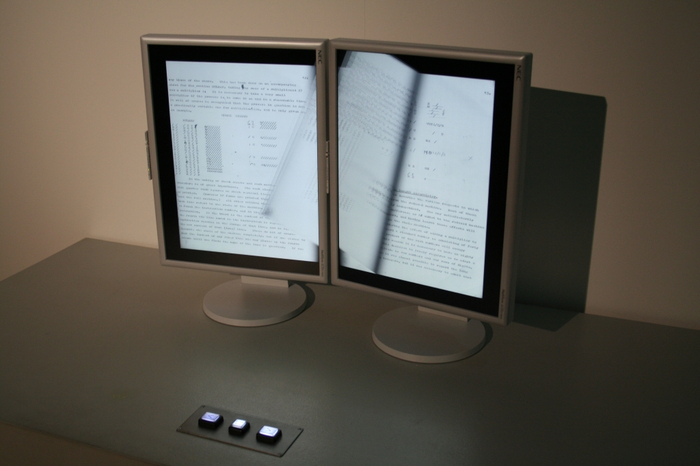
Сегодня можно посмотреть не только созданные тексты, но и первоначальную схему Стрэчи.

На ней хорошо видно, насколько небольшой была основная идея программы. Выбрать обращение. Несколько раз сформировать предложение. В каждом месте сделать случайный выбор из допустимых слов. Проверить некоторые повторения. Напечатать финальную строку.

Никакой скрытой сложности за этим нет.

И именно поэтому схема так хороша.

Перед нами один из самых ранних сохранившихся примеров программы, которая использовала компьютер не для вычисления заранее определенного численного результата, а для создания текста, конкретный вариант которого не знал даже ее автор.

Показать полностью 3
4

Musicolour - машина, которая переставала реагировать, если музыкант повторялся⁠⁠

У Мьюзиколор было свойство, которое для сценического оборудования выглядит почти неправильным. Если музыкант слишком долго повторял один и тот же прием, система могла перестать давать привычную реакцию.

Гордон Паск называл это скукой. Термин, конечно, условный. Технический смысл был вполне конкретным: повторяющийся сигнал постепенно терял приоритет, а система начинала сильнее реагировать на другие характеристики музыки.

Первую версию Паск и Робин Маккиннон-Вуд построили в Кембридже в 1953 году.

Изначальная задача была гораздо проще. Они хотели преобразовывать музыку в визуальные эффекты.

Фиксированная светомузыка быстро оказалась тупиком

Самый очевидный вариант - связать частоту звука с определенным цветом или формой. Низкий тон включает один канал, высокий - другой, громкий звук увеличивает яркость.

Для демонстрации этого достаточно.

Но Паска интересовало взаимодействие с живым исполнителем. При постоянной таблице соответствий система быстро становилась предсказуемой: музыкант находил несколько приемов, которые давали эффектный результат, и дальше мог просто повторять их.

Поэтому соответствия сделали изменяемыми.

Мьюзиколор должна была учитывать не только текущий звук, но и то, что происходило перед ним. Если определенная характеристика появлялась слишком часто, чувствительность системы к ней могла измениться.

Так проект перестал быть обычным преобразователем звука в изображение.

Что находилось между микрофоном и прожекторами

В одной из подробно описанных версий входящий сигнал разделялся на пять каналов анализа.

Три работали с различными частотными областями примерно от 50 до 7500 Гц. Еще один канал фиксировал резкие изменения звука. Пятый анализировал ритмическую последовательность и пытался определить момент следующего импульса.

Сами анализаторы тоже не были статичными. Их параметры могли перестраиваться.

Паск формулировал задачу довольно точно: система должна была научиться выбирать, что именно ей слушать.

Результат анализа поступал на сценическое оборудование. Мьюзиколор управляла регуляторами яркости, проекторами, цветными и узорными дисками, отражателями и приводами. В некоторых вариантах к системе подключали движущиеся трехмерные элементы.

Но важнее оборудования был сам порядок взаимодействия.

Музыкант видел результат своих действий. Он мог заметить, что определенный ритм вызывает конкретный световой эффект, и попытаться вызвать его снова. Система получала повторяющийся сигнал и постепенно меняла собственную реакцию. Исполнитель видел изменение и корректировал игру.

Это продолжалось все выступление.

У системы нельзя было выучить одну правильную кнопку

Представим, что музыкант обнаружил: определенный акцент стабильно вызывает яркую проекцию.

У обычной светомузыкальной установки это становится приемом, которым можно пользоваться сколько угодно. У Мьюзиколор повторение постепенно меняло ситуацию.

Система могла уменьшить реакцию на уже привычный признак и переключить чувствительность на другой параметр. Тот же музыкальный жест переставал давать прежний результат.

Исполнитель был вынужден пробовать что-то еще.

Паск называл такие сознательные попытки музыканта управлять поведением системы ходами. Человек фактически проверял гипотезы: если сыграть так, получится ли снова нужная реакция?

Иногда получалось. Затем соответствие снова менялось.

Поэтому музыкант не просто управлял Мьюзиколор. Он постоянно пытался понять ее текущее поведение, а система одновременно перестраивалась под его игру.

В 1955 году все это попытались встроить в спектакль

Через два года Мьюзиколор использовали в постановке "Лунная музыка" в лондонском театре Болтонс.

Проект был технически тяжелым. Помимо музыки и света, в спектакле участвовали марионетки и механические персонажи, а часть сценических элементов была включена в систему управления.

Премьера закончилась серией отказов.

У одного механического персонажа из-за неисправности системы обратной связи начала разрушаться конструкция, и части попали в зрительный зал. У другого отвалилась часть корпуса. Нити марионеток запутались в оборудовании.

Через неделю постановку закрыли.

Но помещение оставалось оплачено примерно на месяц, и команда продолжила работать уже без необходимости поддерживать спектакль.

Этот период оказался полезнее самой премьеры.

После провала исследовали уже не свет, а связь между человеком и системой

Гордон Паск

Гордон Паск

Музыкальный руководитель Джоун Парри продолжала проводить сеансы с Мьюзиколор. Исполнители играли достаточно долго, чтобы привыкнуть к ее поведению и начать прогнозировать реакции.

После этого исследователи стали намеренно нарушать обратную связь.

В систему вводили случайные изменения, о которых музыкант не знал. Реакция Мьюзиколор начинала отклоняться от той, к которой исполнитель успел привыкнуть.

Музыканты замечали нарушение довольно быстро.

Сильное вмешательство разрушало взаимодействие и вызывало раздражение. Но после длительной совместной работы с системой исполнители могли справляться с более существенными изменениями.

Паска интересовало уже не качество светового представления. Он наблюдал, как человек формирует ожидания относительно поведения машины и что происходит, когда эти ожидания нарушаются.

Есть и более странное наблюдение. Один исполнитель работал с системой с десяти вечера примерно до пяти утра, а после завершения оценил продолжительность сеанса приблизительно в час.

Это единичное наблюдение, а не серьезный психологический эксперимент. Паск описывал похожие случаи и у других исполнителей, но больших выводов из таких данных делать нельзя.

Зато хорошо видно направление работы: к середине 1950-х Мьюзиколор уже использовали скорее как экспериментальную среду для изучения взаимодействия человека и изменяющейся системы.

А сама установка тем временем разрослась до двух фургонов

Ранний лабораторный аппарат довольно быстро перестал соответствовать масштабу публичных выступлений.

Паск вспоминал, что для заметного сценического эффекта требовалось управление освещением общей мощностью порядка 35-50 кВт. Оборудование перевозили в двух фургонах, а для монтажа на площадке была нужна команда из нескольких человек.

Поэтому фотографии Мьюзиколор могут немного вводить в заблуждение. Отдельный шкаф с электроникой - только часть системы.

В полном варианте она включала анализаторы сигнала, память, переключатели, силовое управление, приводы, проекторы, световые приборы и механические элементы сцены.

Это была большая аналоговая кибернетическая установка.

Ее параметры действительно менялись в зависимости от предыдущих событий, а последующая реакция зависела от накопленной истории взаимодействия.

Паск начинал проект с попытки определить, какой цвет соответствует какому звуку.

Через несколько лет этот вопрос его почти перестал интересовать. В собственном описании Мьюзиколор он уже подробно разбирает пороги, изменение чувствительности, действия исполнителя и устойчивость обратной связи.

Первоначальная идея о соответствии музыки и цвета остается где-то на заднем плане.

К этому моменту Мьюзиколор уже была не светомузыкальной установкой, а системой, поведение которой менялось вместе с поведением человека перед ней.

Показать полностью 2
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества