
Вышла новая модель для автономного вождения Qwen-Drive-1.0
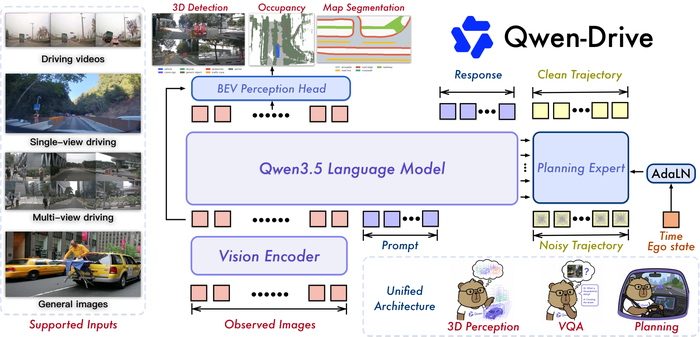
Презентована новая модель Qwen-Drive-1.0 (https://huggingface.co/Qwen/Qwen-Drive-1.0-4B), делающая первый шаг к единой визуально-языковой базовой модели для автономного вождения, объединяющей 3D-восприятие, визуальные ответы на вопросы (VQA) и планирование движения без изменения архитектуры предобученной VLM.
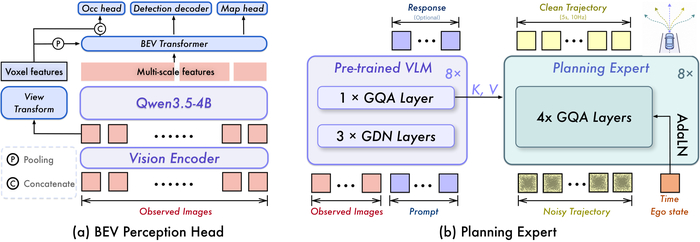
Архитектура использует предобученную мультимодальную модель Qwen3.5-4B (общий визуальный энкодер и VLM) с добавленными двумя внешними модулями. BEV-голова восприятия выполняет 3D-детекцию, предсказание семантической занятости и сегментацию BEV-карты, работая "зондом" для извлечения 3D-информации из общих представлений. Эксперт по планированию генерирует будущую траекторию эго-агента через сопоставление потоков, используя кэшированные ключи и значения VLM.
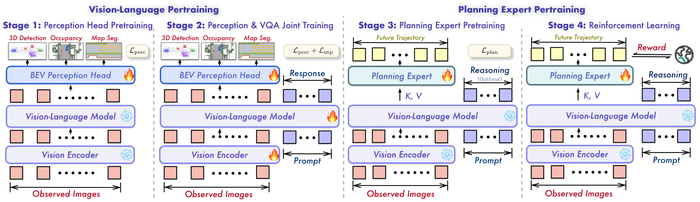
Четыре этапа обучения стартовали с предобучения BEV-головы (заморожены VLM и энкодер, обучается только голова), после чего перешли к совместному обучению восприятия и VQA, обновляющему энкодер, VLM и BEV-голову, смешивая данные вождения и общие визуально-языковые данные для сохранения базовых возможностей. Затем предобучили эксперта по планированию, заморозив VLM и энкодер, обучая его только генерации траектории (сопоставление потоков) с опциональным текстовым рассуждением. Под конец провели обучение с подкреплением (RL), оптимизируя эксперта по планированию на целевых метриках (PDMS, RFS, ADE) с групповым относительным преимуществом.
Данные меток для восприятия унифицировали (nuScenes и OpenScene), приведя их к общим классам (7 для детекции, 10 для занятости, 6 для карты), дополняя метки офлайн и сохраняя нативные сетки. Визуально-языковые данные взяли из 24 открытых датасетов (перезапись, фильтрация консистентности, получили 3.09M), прибавив собственные данные (планирование-рассуждение, порядок камер, QA по восприятию). При планировании обратились к NAVSIM, OpenScene, WOD-E2E и PAI-AV (около 2.83M примеров) с единым форматом 50 точек (5 с, 10 Гц).
Вклад содержит первую (по заявлению) VLM-модель для вождения, объединяющую восприятие, VQA и планирование без архитектурных изменений. Также дан явный BEV-зонд для 3D-восприятия и изложен рецепт этапного обучения и унификации данных, смягчающий катастрофическое забывание. Помимо того, предоставлен эксперт по планированию на сопоставлении потоков с совместным обучением на нескольких датасетах и RL-оптимизацией.
Ограничения связаны с нестабильностью причинного рассуждения при множественных причинах, неполным соответствием траектории текстовому обоснованию и разными входными форматами задач, ограничивающими перенос.
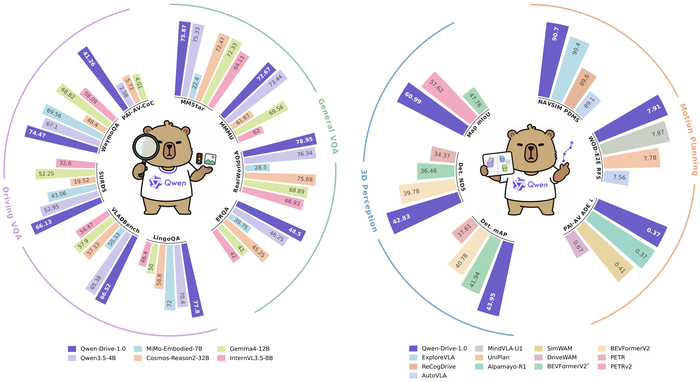
В результате восприятие превосходит специализированные детекторы по mAP или mIoU на nuScenes и OpenScene, при этом добавление 3D-надзора улучшает общие VLM-представления. У VQA присутствует значительное улучшение по метрикам вождения (77.8 на LingoQA, 66.13 на SURDS, 7.78 на Ego3D RMSE) и сильный прирост в причинных рассуждениях (в целом 41.26 на PAI-AV-CoC) с сохранением общих способностей (среднее общее VQA 66.41 против 67.40 у Qwen3.5-4B). В навыках планирования отмечены 90.7 на PDMS (NAVSIM), 7.91 на RFS (тест WOD-E2E) и снижение частоты съезда с дороги в AlpaSim с 24% до 12% после RL, а рассуждение дало небольшой прирост.