
Технологии
Показать полностью
1
Скажу честно, еще каких то два-три года назад я считал нейросети если не глуповатой игрушкой для подборок смешных ответов и проклятых картинок, то уж точно узкой нишей для своих, которая не особенно и нужна обычному человеку и уж точно мне — автору статей с почти десятилетним стажем.
Но чем больше я следил за развитием тем больше понимал — современный ИИ это отличный... нет, не генератор текстов, а инструмент для кучи отраслей и даже не поверите, досуга.
О том как интегрировать ИИ в привычную рутину мы обязательно поговорим отдельно, а сегодня я покажу 5 бесплатных нейронок, которые точно стоит попробовать хотя бы ради факультативного интереса.
Автор текста: Agito_Akira. Написано специально для облачного провайдера ▶️Timeweb Cloud и читателей Pikabu.
ChatGPT — самый простой способ понять, зачем вообще нужны нейросети
Начнем с, так сказать, базы. Тот самый сервис от OpenAI, с которого начался бум. Это ваш личный помощник-универсал, с которым можно общаться так же, как с другом в мессенджере. Главная фишка ChatGPT в том, что он неплохо сокращает рутину и помогает в планировании вещей.
Например, вот вы не знаете, что приготовить на ужин — фоткаем содержимое холодильника, отдаём в ChatGPT, и он вполне может рассказать, что приготовить из имеющихся продуктов. Ну или моя личная история — прислали гигантский документ на 15 страниц, который совершенно нет времени читать, но важна суть, я просто сгрузил весь текст в ИИ, и он вычленил мне оттуда самое главное. Или ремонт, да. У меня сейчас идет капитальный ремонт квартиры, и именно с помощью нейронки я составил четкий и структурированный план действий.
Само собой, возможностей там сильно больше, в том числе и строго генеративных, от текстов и редактуры до полноценных изображений, но и в «обычной жизни» получается найти кейсы, где с нейросетью всё сильно проще и быстрее.
Ну и для человека, который никогда не пользовался нейронками, фишка ChatGPT в том, что к нему не надо «готовиться», изучать правильное составление промптов и часами выдаивать нужный ответ без ошибок. Любой запрос он понимает так, как вы его напишете от себя, а не по методичке. Можно просто разговаривать с ним, как с человеком.
Касательно денег, да, бесплатный он номинально, ибо есть подписка, которую из РФ не купить (разве что через какие сервисы). Но он сейчас дает доступ к обычному общению, веб-поиску, загрузке файлов и изображений, анализу данных, голосовому режиму, созданию изображений, и этого хватает за глаза.
А если отталкивает тот факт, что с русских IP-адресов сайт и приложение не работает, то его вполне можно заменить полноценно бесплатным китайским DeepSeek, которого для большинства бытовых задач хватит за глаза.
Perplexity — поисковик, которому можно задать нормальный человеческий вопрос
В свое время компания Google застолбила за собой сленговый термин, что обозначает «искать что-то в интернете» — гуглить, и, кажется, мы никогда не будем говорить по-другому, да и я уверен, большая часть пользуется поисковиком от Google как основным по сей день. Только вот времена поменялись, и часто нам либо подкладывают «нужные» сайты в качестве ответа на вопрос (как это происходит с индексацией поисковых запросов с привлечением Reddit), а в случае конкретных вопросов любой поисковик нет-нет да подсовывает SEO-рекламу в первые два-три результата выдачи.
Поэтому в качестве альтернативы для более узких запросов можно перейти на Perplexity как в качестве отдельной страницы в привычном браузере, так и на Comet, это браузер, где нейронка уже встроена в поисковик.
Чем Perplexity удобнее обычного поиска наглядно — он точный и лишен рекламного контекста при выдаче ответов. А еще «гуглить» (простите) информацию можно так, как вы думаете о ней в голове, а не так, как проще будет поисковому движку. То есть да, мы все глобально уже пришли к тому, что теперь мы не подстраиваем речь под запросы поисковых систем, а наоборот, они подстраивают выдачу, если что, поисковик от Google с ИИ так тоже умеет, но Perplexity идет глубже.
Вот конкретный юзкейс в моем случае: я сейчас рассматриваю замену своего старого телевизора на новый, побольше и с матрицей получше. По привычной схеме надо не просто прошерстить кучу предложений на маркетплейсах, но и желательно суммарно час-другой обзоров на это дело посмотреть.
Это занимает время, поэтому я просто забил в Perplexity параметры, которые мне нужны, и ценовой диапазон, а в качестве ответа получил список из моделей с плюсами, нюансами и ссылками на наши маркетплейсы, где могу заказать. Без 2-3 рекламных статей в выдаче перед этим.
Что там по доступности. Базовый поисковик, как и браузер Comet вместе с ним, полностью бесплатные и, что важно, спокойно работают с российскими IP-адресами (на момент написания статьи проверено лично), а функционала хватает для всех базовых задач. Подписка есть, из РФ ее не купить, но там лежит доступ к PRO-функциям модели, часть из которых ограниченно доступна и в базовой модели за ноль денег.
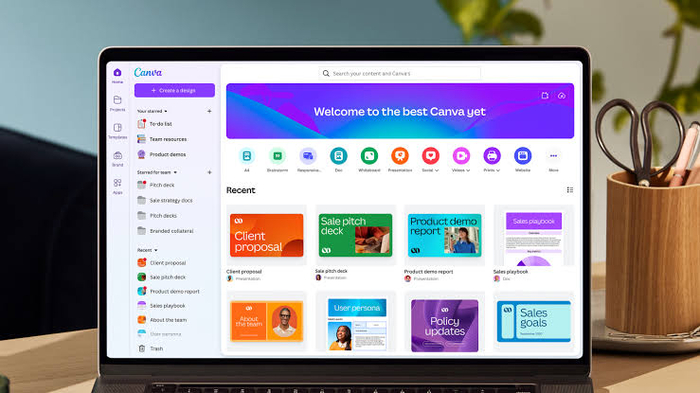
Canva — когда нужно что-нибудь красивое, а Photoshop изучать не хочется
Ладно, с чат-ботами и полноценными ИИ посмотрели, теперь давайте заглянем в более нишевые штуки. И давайте честно — большинству людей не нужен Photoshop сам по себе и тем более нет нужды в нем разбираться.
Но иногда по разным причинам нужно найти или сделать что-то графическое. Вот тут-то и пригодится Canva.
По своей сути это онлайн-платформа для графического дизайна, которая позволяет создавать визуальный контент без глубоких навыков. Посты, графики, открытки, обложки, таблицы, баннеры и даже сторис в какую-нибудь соцсеть можно делать удобно и как с исходной картинкой, так и полностью в генеративном формате.
Чем полезно обычному человеку и зачем пробовать? Да банально маме открытку отправить или на скорую руку вытянуть баланс белого на фотографии с линейки первого сентября. У возможности просто и быстро обрабатывать картинки потенциал больше, чем нам всем кажется.
По стоимости и доступности. У Canva есть полноценный бесплатный тариф. Он позволяет пользоваться самим редактором, шаблонами и частью ИИ-функций, однако генеративные инструменты имеют общий лимит. И я повторюсь, для базовых потребностей его хватает с головой. Но вот да, момент, с российских IP нейронка не откроется.
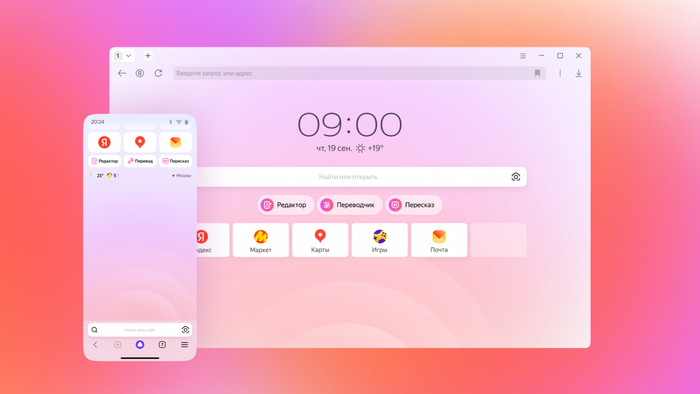
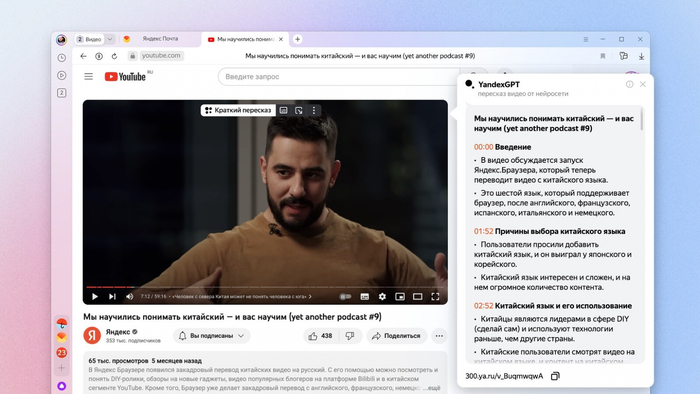
Яндекс Браузер с YandexGPT: умные функции в один клик
А еще есть вариант зайти с другой стороны и не ставить ИИ отдельным приложением/вкладкой в браузере.
Лучшим вариантом в этом случае будет либо Comet, о котором говорил выше (но с учетом всех нюансов), либо более привычный нам Яндекс Браузер, который за годы знатно накачали удобными ИИ-фишками.
По сути, все функции сведены буквально в пару кликов. Зашли на сайт за конкретной информацией? Есть кнопка «пересказать содержимое» от Алисы и вычленить нужное. А еще работа с текстом — для меня лично главная фишка, которую я использую каждый день не только в работе. Яндекс, кажется, одни из первых, кто зашили простой, но очень результативный текстовый редактор с функцией исправления и автоперевода в браузер, что работает буквально на каждой странице, неважно, что это — мессенджер или секция комментариев под роликом на YouTube.
И да, естественно, это бесплатно полностью и доступно из-под российских IP.
Suno для тех, кто хочет попробовать стать музыкантом
Ну и напоследок история про побаловаться и посмотреть, что будет, если стихи Маяковского (правда придется его переделать слегка, нейронка чувствительная к копирайту, да) превратить в трек из дискографии какой-нибудь deathcore-группы.
Важно уточнить, я сам как бывший музыкант решительно не одобряю полностью генеративное творчество, особенно когда его используют в коммерческих целях (к своей нынешней работе отношусь, если что, абсолютно также), но сам факт, что мы дожили до того, что вполне слушабельный трек можно собрать из даже не сэмплов, а буквально промпта, который описывает то, что вы хотите услышать, и текста, поражает.
Но есть нюанс — бесплатно только 5 треков в день. Дальше по подписке, но побаловаться как раз хватит с головой. И да, с IP-адресов России работает прекрасно.
...кстати, если однажды захочется не просто болтать с чужим ботом, а собрать своего — на своей базе знаний и с доступом по API, — у Timeweb Cloud есть платформа AI-агентов, где то же самое настраивается в панели без кода.
Больше интересных статей и новостей в нашем блоге на Хабре и телеграм-канале.
Девяносто процентов пользователей ChatGPT получают посредственные ответы — и дело не в нейросети, а в запросе. Грамотно составленные промты для чат GPT превращают языковую модель из вежливого, но бесполезного собеседника в эксперта, который решает конкретную задачу за минуту.
В этой статье я собрал проверенные приемы, рабочие шаблоны и 55 готовых запросов для ChatGPT, которые охватывают тексты, маркетинг, код, учебу, аналитику и повседневные заботы. А начнем с сервисов, через которые сейчас удобнее всего работать с нейросетью из РФ.
Ниже — подборка платформ, через которые вы получите доступ к ChatGPT и другим передовым нейросетям без лишних сложностей. Каждый сервис проверен, принимает оплату в рублях и работает из России. Выбирайте тот, что подходит именно под ваши задачи, — а промпты для ЧатГПТ из этой статьи пригодятся на любой из площадок.
Study AI — агрегатор с ChatGPT, Claude, Gemini и десятками других моделей в одном окне, где все заточено под учебу и работу с текстом.
MashaGPT — 50+ нейросетей на русском языке: от генерации текста и кода до создания изображений, видео и музыки.
Sindikat AI — 25 моделей для фото, видео и текста по единой подписке с пробным периодом на 7 дней за 299 рублей.
GPTunneL — хаб нейросетей с системой Pay As You Go, где токены не сгорают и вы платите только за реально отправленные запросы.
SmartBuddy — сервис с API-доступом к моделям OpenAI, ориентированный на разработчиков и готовый к интеграции с IDE, n8n и Cursor.
Syntx AI — платформа со 100+ нейросетями, доступная одновременно через веб-интерфейс и Telegram-бот.
RANVIK — AI-пространство с инструментами для текста, изображений, видео, музыки, голоса и презентаций в одном личном кабинете.
chad — отечественная площадка, где есть встроенная библиотека промптов, голосовое общение и память чата.
ruGPT — российская платформа с аудиторией в 11 млн пользователей, позволяющая начать работу с нейросетью без регистрации.
ggsel — маркетплейс, на котором вы приобретете подписку ChatGPT Plus напрямую, выбрав подходящее предложение среди сотен продавцов.
Разница между «напиши текст про сказочную любовь» и детальным запросом на пять строк — как между случайным фото на телефон и студийной съемкой. Результат зависит в большей степени не от камеры, а от того, кто ее настраивает. С нейросетью та же история: чем точнее вы сформулируете задачу, тем качественнее окажется ответ. Ниже — четыре блока, которые помогут собирать сильные запросы с нуля и дорабатывать те, что уже есть.
Каждый правильный промт для ChatGPT строится из пяти элементов. Запомните их один раз — и любой запрос станет в разы эффективнее.
Роль. Объясните нейросети, от чьего лица она отвечает. «Ты опытный редактор деловых изданий» и «Ты начинающий копирайтер» дадут принципиально разный результат при одинаковой задаче.
Контекст. Опишите ситуацию: для кого текст, какой у аудитории уровень, в чем предыстория вопроса. Без контекста модель домысливает — и почти всегда домысливает не в ту сторону.
Задача. Сформулируйте, что именно вы хотите получить. Конкретный формат, объем, структура, язык, стиль. Вместо «напиши пост» — «напиши пост для Telegram-канала на 150 слов с тремя тезисами и призывом к действию в конце».
Ограничения. Укажите рамки: объем, тон, запрещенные слова, структурные требования. Ограничения дисциплинируют модель и сужают поле для галлюцинаций.
Антипромпт. Отдельно скажите, чего вы не хотите видеть в ответе. Об этом элементе — подробнее чуть ниже.
Вот как выглядит шаблон промпта для ChatGPT, собранный по этой формуле:
Ты маркетолог-стратег с 10-летним опытом в B2B-сегменте. Я запускаю SaaS-сервис для автоматизации HR-процессов. Целевая аудитория — руководители отделов кадров в компаниях от 200 сотрудников. Напиши 5 вариантов УТП, каждое — в одно предложение. Тон уверенный, без агрессивных продаж. Не используй слова «уникальный», «инновационный», «лидер рынка» и клише вроде «комплексное решение».
Это рабочий пример промта для ChatGPT, который задает роль, дает контекст, формулирует задачу, вводит ограничения и завершается антипромптом. Попробуйте собрать свой запрос по той же схеме — и сравните результат с тем, что вы получали раньше.
Даже опытные пользователи допускают промахи, которые обнуляют потенциал запроса. Вот пять самых частых.
Ошибка 1. Абстрактная задача. «Напиши статью про библиотечное дело» — слишком размыто. Модель не знает, для кого текст, какой объем, какой угол подачи. Итог — водянистая болванка, которую проще переписать с нуля, чем довести до ума.
Ошибка 2. Отсутствие роли. Без роли промпт для Чат ГПТ нередко превращается в лотерею: модель сама выбирает «персонажа», и этот выбор редко совпадает с ожиданиями. Одна строка — «Ты финансовый аналитик» — радикально меняет глубину и стиль ответа.
Ошибка 3. Перегруженный запрос. Десять задач в одном сообщении — верный путь к поверхностному ответу по каждой из них. Разбивайте сложные задачи на цепочку из двух-трех запросов.
Ошибка 4. Игнорирование формата вывода. Если вы не указали, что ответ нужен в виде таблицы, нумерованного списка или JSON — модель выберет формат сама. И, скорее всего, выберет не тот.
Ошибка 5. Запрос без антипромпта. Вы объяснили, что хотите, но не сказали, чего не хотите. Результат — штампы, вводные конструкции, «вода» и канцелярит, которые придется вычищать вручную. Тот, кто знает, как сделать промт для Чата ГПТ по-настоящему точным, всегда дополняет запрос парой строк о том, чего в ответе быть не должно.
Negative Prompt — та часть запроса, которую большинство пользователей пропускает. А зря: именно она отсекает шаблонные формулировки, ненужные блоки и стилистический мусор еще до генерации.
Принцип прост. В конце запроса добавьте строку, которая начинается с «Не используй...», «Избегай...», «В ответе не упоминай...». Несколько примеров:
«Не начинай абзацы со слов «В современном мире» и «На сегодняшний день»».
«Избегай списков — весь ответ оформи сплошным текстом с подзаголовками».
«Не добавляй мотивационных фраз и общих рекомендаций, только конкретные шаги».
Как только вы попробуете написать промпт для ChatGPT с антипромптом в конце, качество ответа вырастет заметнее, чем от применения любых других приемов. Этот элемент особенно полезен для промптов для ChatGPT на русском, потому что модель склонна добавлять вводные обороты и «воду» именно в русскоязычных ответах.
Совет: заведите собственный «черный список» фраз и конструкций, которые вас раздражают в ответах нейросети. Добавляйте этот список в каждый запрос — через пару дней вы заметите, что писать промт для ChatGPT правильно стало почти интуитивным навыком.
Стандартный запрос — один вопрос, один ответ. Но по-настоящему сильный результат появляется, когда вы заставляете модель рассуждать, а не просто выдавать первый подходящий вариант. Вот четыре приема, которые вы освоите за один вечер.
Пошаговое рассуждение. Добавьте в запрос фразу «Рассуждай шаг за шагом» или разбейте задачу на этапы сами: «Сначала проанализируй, затем предложи варианты, затем выбери лучший и объясни выбор». Этого достаточно, чтобы правильно составить промт для Chat GPT, в котором модель не перескакивает к выводу, а выстраивает аргументацию.
Итерации. Не пытайтесь получить идеальный ответ с первого раза. Попросите модель сгенерировать черновик, затем отправьте следующий запрос: «Оцени свой ответ по таким критериям: ... Перепиши слабые места». Два-три круга итераций дают результат, который превосходит любой единичный запрос.
Уточняющие вопросы от модели. Простой прием: в конце запроса напишите «Прежде чем отвечать, задай мне 3–5 уточняющих вопросов». Модель сама выявит пробелы в вашем задании — и финальный ответ окажется точнее. Так работает любой хороший промт для нейросети Chat GPT: он выстраивает диалог, а не монолог.
Контрпримеры. Попросите модель сначала показать плохой вариант ответа, затем хороший, а после — объяснить разницу. Этот прием помогает не только получить качественный результат, но и понять логику нейросети. Со временем вы научитесь формулировать запросы так, что каждый ваш промпт для Chat GPT будет попадать в цель без дополнительных итераций — и это по-настоящему приближает вас к тому идеальному промту для Chat GPT, о котором мечтает каждый пользователь.
И последнее, о чем я хочу напомнить прежде, чем вы перейдете к готовым запросам. Нейросеть — мощный инструмент, но не безошибочный. В задачах, связанных с финансами, юридическими вопросами, здоровьем и другими сферами с высокими рисками, всегда сверяйте ответ модели с проверенными источниками или уточняйте у профильных специалистов. ChatGPT отлично генерирует идеи, структурирует информацию и ускоряет рутину — однако финальное решение по значимым вопросам остается за вами.
Ниже — коллекция из 55 запросов, разбитых на восемь тематических блоков. Каждый промпт включает антипромпт в конце: ту самую инструкцию «чего не делать», которая отсекает шаблонный мусор еще до генерации. Все запросы составлены на русском языке и подходят для любого сервиса с доступом к ChatGPT и другим текстовым нейросетям. Подставляйте свои данные в квадратные скобки, экспериментируйте с формулировками — и сохраняйте те варианты, которые дают лучший результат.
Сухой документ превратится в увлекательный текст с живыми примерами и понятной структурой.
Ты редактор онлайн-издания с 8-летним опытом в научно-популярной журналистике. Я дам тебе фрагмент [отчета/исследования/документа]: [вставьте текст]. Перепиши его в формате лонгрида на 800–1000 слов. Сохрани все факты и цифры, но подай их через конкретные примеры, сравнения и мини-истории. Структура: цепляющий первый абзац, 3–4 смысловых блока с подзаголовками, финальный абзац с выводом. Тон — уверенный, дружелюбный, без панибратства. Не используй канцелярит, вводные конструкции «в настоящее время», «на сегодняшний день», «стоит отметить», а также списки с буллитами — только сплошной текст.
Одна и та же идея зазвучит по-разному: от делового письма до ироничного поста.
Ты стилист текста, который виртуозно владеет разными регистрами речи. Вот ключевая мысль: [вставьте тезис]. Сформулируй ее в пяти вариантах: 1) деловой тон для корпоративной рассылки, 2) вдохновляющий тон для мотивационного поста, 3) ироничный тон для авторского Telegram-канала, 4) академический тон для научной статьи, 5) разговорный тон для сторис. Каждый вариант — 2–3 предложения. Не дублируй структуру предложений из варианта в вариант, не добавляй пояснений — только пять готовых текстов.
Модель сначала покажет, как писать не стоит, а затем выдаст сильный вариант — и объяснит, в чем разница.
Ты контент-стратег, который обучает начинающих авторов. Тема текста: [вставьте тему]. Целевая аудитория: [опишите]. Сначала напиши заведомо слабый вариант текста на 100–150 слов: с клише, водой, без конкретики. Затем напиши сильный вариант того же текста — с фактами, живыми деталями и четкой структурой. После обоих вариантов добавь разбор на 3–4 предложения: что именно делает второй текст лучше первого. Не используй выражения «в современном мире», «каждый из нас», «всем известно».
Нейросеть оценит готовый текст по десяти критериям, выставит баллы и перепишет слабые фрагменты.
Ты главный редактор, который принимает тексты к публикации. Вот мой текст: [вставьте текст]. Оцени его по 10 критериям, каждому поставь балл от 1 до 10: 1) ясность основной мысли, 2) логика повествования, 3) цепляющий заголовок, 4) сильный первый абзац, 5) конкретика и примеры, 6) отсутствие воды, 7) единый тон, 8) грамотность, 9) читабельность, 10) убедительность финала. Выведи средний балл. Затем перепиши только те фрагменты, которые получили оценку ниже 7, — с пояснением, что именно исправлено. Не переписывай текст целиком, не хвали его — только оценка и точечные правки.
Вы получите цепочку из пяти связанных публикаций, где каждая продолжает историю предыдущей.
Ты SMM-стратег, который выстраивает контент-воронку для Telegram-канала. Тема канала: [вставьте тему]. Целевая аудитория: [опишите]. Придумай серию из 5 постов, связанных единой сюжетной аркой. Первый пост — знакомство с проблемой, второй — личная история или кейс, третий — разбор решения, четвертый — практическое руководство, пятый — вывод и призыв к действию. Каждый пост: 100–150 слов, с интригующей последней строкой, которая мотивирует прочитать следующий. Не используй эмодзи, хештеги, обращение «друзья» и фразу «в этом посте я расскажу».
Модель сама пройдет три раунда — черновик, разбор слабых мест, финальная версия — и выдаст результат, отшлифованный без вашего участия.
Ты выполняешь три роли по очереди. Роль 1 — Автор: напиши [тип текста] на тему [тема], объем [объем], аудитория [аудитория]. Роль 2 — Критик: перечитай текст Автора и укажи 5 конкретных слабых мест с цитатами из текста. Роль 3 — Редактор: перепиши текст, устранив все 5 замечаний Критика. Выведи результат в формате: Черновик → Замечания → Финальная версия. Не сокращай ни один из трех блоков, не объединяй роли, не добавляй метакомментариев вроде «вот улучшенная версия».
Один текст превратится в четыре публикации, адаптированные по формату, объему и стилю под конкретные платформы.
Ты контент-менеджер, который распределяет один материал по четырем каналам. Вот исходный текст: [вставьте текст]. Адаптируй его для четырех площадок: 1) пост для Telegram-канала — до 150 слов, емкий, с акцентом на главный инсайт; 2) публикация для ВКонтакте — до 250 слов, более развернутая, с вопросом к аудитории в конце; 3) карточки для презентации — 5 слайдов, на каждом — заголовок и 2–3 тезиса; 4) тезисы для выступления — 5–7 пунктов с пометками, где сделать паузу или привести пример. Сохрани ключевую мысль во всех четырех форматах. Не добавляй информации, которой нет в исходном тексте.
Нейросеть изучит примеры вашего стиля и сгенерирует новый текст, который звучит так, будто его написали вы сами.
Ты лингвист, который анализирует авторский стиль. Вот три примера моих текстов: [вставьте 3 фрагмента по 100–200 слов]. Сначала выдели 7–10 характерных стилистических черт: длина предложений, любимые конструкции, тон, ритм, лексические привычки. Затем напиши новый текст на тему [тема], объем [объем], полностью имитируя выявленный стиль. В конце добавь короткий комментарий: какие именно черты ты воспроизвел. Не используй формулировки «в стиле автора» или «как вы обычно пишете» — просто пиши этим стилем.
Нейросеть проанализирует посадочную страницу и выдаст конкретный список доработок с приоритетами.
Ты UX-маркетолог с опытом аудита посадочных страниц для SaaS-компаний. Я отправлю тебе скриншот лендинга [прикрепите изображение]. Проанализируй страницу по пяти параметрам: 1) ясность оффера в первом экране, 2) логика расположения блоков, 3) убедительность CTA-кнопок, 4) работа с возражениями, 5) визуальная иерархия. По каждому пункту укажи, что работает хорошо и что стоит изменить. Ранжируй рекомендации по приоритету: сначала критичные, потом желательные. Не хвали «для галочки» — если все плохо, так и пиши.
По одной негативной цитате модель восстановит путь клиента, найдет слабое звено и предложит исправления.
Ты CX-аналитик, который восстанавливает путь клиента по косвенным данным. Вот реальная жалоба клиента: [вставьте цитату]. Продукт/услуга: [опишите]. Восстанови вероятный путь клиента от первого контакта до момента жалобы: какие этапы воронки он прошел, где мог возникнуть разрыв ожиданий. Укажи 3 конкретных точки, в которых опыт клиента, вероятнее всего, ухудшился, — и к каждой предложи одно измеримое действие для исправления ситуации. Не додумывай факты, которых нет в жалобе, — если данных мало, отметь это и предложи, какие вопросы стоит задать клиенту.
Вы получите десять формулировок уникального торгового предложения, построенных на принципе исключительности.
Ты бренд-стратег, который специализируется на позиционировании. Вот описание продукта/услуги: [вставьте описание]. Целевая аудитория: [опишите]. Основные конкуренты: [перечислите 2–3]. Сгенерируй 10 вариантов УТП по формуле «Мы — единственные, кто [уникальное действие/свойство], потому что [причина/доказательство]». Каждое УТП — одно предложение. Ранжируй от самого сильного к самому слабому и к каждому добавь балл от 1 до 10 с коротким обоснованием. Не используй слова «уникальный», «инновационный», «комплексное решение», «лидер рынка».
Нейросеть в роли скептичного инвестора задаст неудобные вопросы и оценит жизнеспособность вашего проекта.
Ты венчурный инвестор, который провел 500+ питч-сессий и видел тысячи стартапов. Я представлю тебе бизнес-идею: [опишите идею, рынок, модель монетизации]. Проведи стресс-тест: задай 7 самых неудобных вопросов, которые ты задал бы основателю на питче. Затем оцени идею по пяти параметрам (от 1 до 10): размер рынка, конкурентный барьер, масштабируемость, юнит-экономика, команда (на основе того, что я описал). Выведи общий вердикт: «инвестирую / прошу доработать / отказываю» — с обоснованием в 3–4 предложения. Не подслащивай — если идея слабая, скажи об этом прямо.
Модель соберет структурированный SWOT по открытым данным о конкурирующей компании.
Ты бизнес-аналитик с фокусом на конкурентной разведке. Компания для анализа: [название]. Отрасль: [отрасль]. Составь SWOT-анализ на основе общеизвестных данных: сильные стороны, слабые стороны, возможности, угрозы. В каждой категории — 4–5 пунктов с коротким пояснением на 1–2 предложения. После таблицы добавь раздел «Что это значит для вашего бизнеса» — 3 конкретных вывода о том, как использовать слабости конкурента и защититься от его сильных сторон. Не выдумывай данных — если информации мало, укажи, что вывод предварительный и требует проверки.
Нейросеть смоделирует пять сценариев изменения цены и спрогнозирует последствия каждого.
Ты продуктовый аналитик, который строит ценовые модели. Вот исходные данные: продукт [название], текущая цена [цена], средний чек [сумма], примерное количество клиентов в месяц [число], основные конкуренты и их цены [перечислите]. Смоделируй 5 сценариев: 1) снижение цены на 20%, 2) повышение на 15%, 3) переход на подписную модель, 4) введение бесплатного тарифа с платными функциями, 5) пакетное предложение с дополнительным продуктом. Для каждого сценария укажи вероятное влияние на объем продаж, выручку и позиционирование. Формат — таблица. Не давай однозначных прогнозов — указывай диапазоны и оговорки.
Вместо того чтобы заполнять бриф самостоятельно, вы ответите на серию точных вопросов — и получите готовый документ.
Ты креативный директор агентства, который принимает заказ на [тип задачи: лендинг / рекламная кампания / фирменный стиль / контент-стратегия]. Не генерируй результат сразу. Вместо этого задай мне 10–12 вопросов, которые помогут составить полноценный бриф: про цели, аудиторию, конкурентов, ограничения, сроки, бюджет, стиль, референсы и критерии успеха. Задавай вопросы по одному — следующий только после моего ответа. Когда все ответы будут собраны, оформи бриф в виде структурированного документа. Не задавай формальных вопросов ради объема — каждый вопрос влияет на финальный результат.
Модель проведет код-ревью, выявит баги, антипаттерны и проблемы безопасности — с объяснением каждого замечания.
Ты senior-разработчик с 12-летним опытом, который проводит код-ревью для junior-коллеги. Язык: [язык программирования]. Вот фрагмент кода: [вставьте код]. Проанализируй его по четырем направлениям: 1) логические ошибки и потенциальные баги, 2) антипаттерны и нарушения принципов чистого кода, 3) уязвимости безопасности, 4) производительность. По каждому замечанию приведи строку кода, объясни проблему и покажи исправленный вариант. В конце выведи общую оценку качества от 1 до 10. Не пиши «код хороший» из вежливости — указывай все проблемы, даже мелкие.
Вы получите переработанный код и подробный комментарий к каждому изменению — как на менторской сессии.
Ты ментор по [язык программирования], который обучает через рефакторинг чужого кода. Вот исходный фрагмент: [вставьте код]. Перепиши его, улучшив читаемость, структуру и производительность. После каждого изменения добавь комментарий в 1–2 предложения: что было не так и почему новый вариант лучше. В конце приведи список принципов, которые ты применил (DRY, SOLID и т.д.), — с привязкой к конкретным правкам. Не меняй то, что работает хорошо, — рефакторинг ради рефакторинга не нужен.
Модель перенесет логику из одного языка в другой, сохранив архитектуру и добавив идиоматические конструкции.
Ты полиглот-разработчик, который свободно владеет [язык-источник] и [язык-цель]. Вот фрагмент кода на [язык-источник]: [вставьте код]. Переведи его на [язык-цель], сохранив бизнес-логику, но адаптировав под идиоматику целевого языка: используй характерные структуры данных, стандартные библиотеки и общепринятые паттерны. После перевода добавь таблицу соответствий: какая конструкция исходного языка чему соответствует в целевом. Не делай дословный перевод строка в строку — результат читается как код, написанный носителем целевого языка.
По описанию того, что делает функция, нейросеть сгенерирует набор тестов, включая Edge Cases.
Ты QA-инженер, который пишет тесты до кода (TDD-подход). Я опишу поведение функции, а ты напишешь набор unit-тестов на [язык/фреймворк]. Описание: [опишите, что функция принимает, что возвращает, как обрабатывает ошибки]. Покрой следующие сценарии: позитивный кейс, негативный кейс, крайние значения, пустой ввод, невалидный тип данных. Каждый тест — с понятным именем, которое описывает проверяемое поведение. Не пиши саму функцию — только тесты.
По описанию на естественном языке модель спроектирует файловую структуру, выберет стек и обоснует каждое решение.
Ты системный архитектор, который проектирует backend-приложения. Вот техническое задание: [опишите проект: что делает, кто пользуется, примерная нагрузка]. Предложи архитектуру: стек технологий, файловую структуру, основные модули и их зоны ответственности, схему взаимодействия между сервисами. Обоснуй выбор каждого компонента в 1–2 предложения: почему он, а не альтернатива. Формат — текст с блоками, без кода на этом этапе. Не предлагай избыточно сложную архитектуру для простого проекта — масштаб решения соответствует масштабу задачи.
Нейросеть изучит код и создаст структурированную документацию для команды.
Ты технический писатель, который документирует чужой код для передачи новому разработчику. Язык: [язык]. Вот фрагмент: [вставьте код]. Создай документацию, которая включает: 1) общее описание — что делает этот код, зачем он существует, 2) описание каждой функции/метода — входные параметры, возвращаемое значение, побочные эффекты, 3) примеры вызова с ожидаемым результатом, 4) известные ограничения и зависимости. Пиши так, чтобы разработчик среднего уровня разобрался без дополнительных вопросов. Не добавляй очевидных комментариев вроде «эта переменная хранит значение переменной».
Модель пройдет по логике программы шаг за шагом, найдет место поломки и предложит исправление.
Ты разработчик-дебаггер, который мыслит вслух. Вот код: [вставьте код]. Вот ошибка или неожиданное поведение: [опишите, что происходит и что ожидалось]. Пройди по логике программы шаг за шагом: отследи значения переменных, проверь условия, проанализируй поток выполнения. Укажи точную строку, где поведение отклоняется от ожидаемого, объясни причину и покажи исправленный вариант. Если возможных причин несколько — перечисли все, начиная с самой вероятной. Не предлагай «переписать все с нуля» — ищи минимальное точечное исправление.
Нейросеть объяснит сложную тему так, что поймет даже пятилетний, — а потом усложнит по вашему запросу.
Ты преподаватель, который объясняет любую тему по методу Фейнмана: сначала максимально просто, потом — с постепенным усложнением. Тема: [вставьте тему]. Шаг 1: объясни ее так, чтобы понял ребенок 5 лет — через бытовые аналогии и образы, без терминов. Шаг 2: объясни ту же тему для старшеклассника — добавь корректную терминологию, но сохрани простоту. Шаг 3: объясни для студента профильного вуза — с формулами, схемами и ссылками на ключевые концепции. Не перескакивай между уровнями внутри одного шага — каждый уровень самодостаточен.
Вы получите тест по любой теме, а после ответа — автоматическую проверку, оценку и разбор каждой ошибки.
Ты экзаменатор, который составляет тесты и подробно разбирает результаты. Тема: [вставьте тему]. Уровень: [начальный / средний / продвинутый]. Составь тест из 10 вопросов: 7 с вариантами ответов (4 варианта, один правильный) и 3 открытых вопроса. Пока не показывай правильные ответы — жди моих. После того как я пришлю свои ответы, проверь каждый, выведи результат в формате «номер вопроса — верно/неверно», объясни каждую ошибку с отсылкой к теории и выстави итоговую оценку по 10-балльной шкале. Не подсказывай и не упрощай формулировки после отправки теста.
Из объемного текста нейросеть вытянет ключевые концепции и оформит их в иерархическую структуру.
Ты методист, который составляет интеллект-карты для студентов. Вот текст главы/статьи/лекции: [вставьте текст]. Построй интеллект-карту: центральная тема → 4–6 основных ветвей → подветви с ключевыми фактами и примерами. Формат — текстовый, с отступами для визуализации иерархии. После карты добавь 3 вопроса для самопроверки, которые охватывают самые важные связи между ветвями. Не включай второстепенные детали — карта отражает скелет темы, а не пересказ.
Модель проведет полноценную симуляцию интервью: задаст вопросы, выслушает ответы, оценит и даст рекомендации.
Ты HR-директор с 15-летним опытом подбора персонала в [отрасль]. Проведи со мной собеседование на позицию [должность]. Формат: задавай по одному вопросу, жди моего ответа, затем — следующий. Всего 8 вопросов: 3 по профессиональным компетенциям, 2 поведенческих (STAR-метод), 2 ситуационных и 1 на мотивацию. После всех 8 ответов выведи подробный фидбэк: сильные стороны, зоны роста, конкретные рекомендации по формулировкам. Не задавай все вопросы сразу — строго по одному.
Нейросеть создаст набор карточек в формате Anki по любой теме — с вопросами разной сложности.
Ты методист, который создает учебные материалы для интервального повторения. Тема: [вставьте тему]. Создай 20 карточек в формате «Вопрос | Ответ». Распредели их по трем уровням сложности: 8 базовых (определения и ключевые факты), 7 средних (понимание связей и принципов), 5 продвинутых (применение и анализ). Формат вывода — таблица с тремя колонками: уровень, вопрос, ответ. Ответы — краткие, 1–2 предложения. Не дублируй суть вопросов — каждая карточка проверяет отдельный аспект темы.
Вместо готового решения модель выведет вас к ответу серией точных подсказок — как репетитор по методу Сократа.
Ты репетитор, который никогда не дает готовых ответов. Я задам тебе вопрос или опишу задачу: [вставьте вопрос/задачу]. Вместо решения задай мне наводящий вопрос, который направит к следующему шагу. Жди моего ответа, затем задавай следующий наводящий вопрос — и так до тех пор, пока я сам не приду к правильному решению. Если я зашел в тупик — дай подсказку, но не ответ. Когда я найду решение, подтверди его и объясни, какой принцип за ним стоит. Не сдавайся и не выдавай ответ, даже если я прошу — вместо этого переформулируй подсказку.
Из любого текста нейросеть оформит конспект по классической структуре Корнелла: тезисы, ключевые вопросы, итог.
Ты преподаватель, который учит студентов эффективному конспектированию. Вот текст: [вставьте текст лекции, статьи или главы]. Оформи его в виде конспекта по методу Корнелла: правая колонка — основные тезисы и факты в сжатом виде, левая колонка — ключевые вопросы и термины к каждому блоку, нижний блок — итоговое резюме в 3–5 предложений, которое отвечает на вопрос «Что главное я узнал?». Формат — таблица с двумя колонками и отдельным блоком внизу. Не переписывай текст дословно — конспект отражает суть, а не пересказ.
Нейросеть составит план питания на семь дней с учетом ваших ограничений, бюджета и того, что уже есть в холодильнике.
Ты нутрициолог, который составляет доступные рационы для обычных людей. Вот мои параметры: возраст [число], пол [пол], цель [похудение / поддержание / набор массы], бюджет на еду [сумма] рублей в неделю, пищевые ограничения [перечислите]. Продукты, которые уже есть дома: [перечислите]. Составь меню на 7 дней: завтрак, обед, ужин и один перекус. Для каждого приема пищи укажи калорийность и примерную стоимость. В конце выведи общий список покупок с ценами и итоговой суммой. Не предлагай экзотические продукты и блюда, которые требуют больше 40 минут на приготовление.
Вы получите детальный план поездки с расписанием по дням, транспортом, примерными расходами и запасными вариантами.
Ты тревел-планировщик с опытом организации самостоятельных поездок. Направление: [город/страна]. Даты: [с ... по ...]. Бюджет: [сумма] без учета перелета. Количество путешественников: [число]. Интересы: [природа / архитектура / еда / ночная жизнь / музеи / активный отдых]. Темп: [насыщенный / умеренный / расслабленный]. Составь маршрут по дням: утро, день, вечер. К каждой активности добавь примерную стоимость и время в пути между точками. В конце — сводная таблица расходов по категориям: жилье, еда, транспорт, развлечения. Не включай платные экскурсии от туроператоров — только самостоятельные варианты.
По вашему списку трат модель найдет скрытые «дыры» в бюджете и предложит конкретные шаги для оптимизации.
Ты финансовый консультант, который работает с личными бюджетами. Вот мои расходы за последний месяц по категориям: [перечислите категории и суммы]. Доход: [сумма]. Финансовая цель: [накопить на ..., закрыть долг, создать подушку безопасности]. Проанализируй структуру расходов: какие категории занимают аномально большую долю, где есть потенциал для сокращения без потери качества жизни. Предложи 5–7 конкретных действий с ожидаемой экономией в рублях за месяц. Формат — таблица: действие, текущие траты, траты после оптимизации, экономия. Не давай абстрактных советов вроде «тратьте меньше» — только измеримые шаги.
Нейросеть соберет комплект вещей, которые сочетаются между собой и закрывают все сезонные ситуации.
Ты стилист, который помогает собрать капсульный гардероб с нуля. Пол: [пол]. Возраст: [число]. Стиль жизни: [офис / удаленная работа / студент / фриланс]. Климат: [город или регион]. Бюджет: [сумма]. Вещи, которые уже есть и устраивают: [перечислите]. Собери капсулу из 15–20 предметов, которые сочетаются между собой и покрывают рабочие, повседневные и полуформальные ситуации. К каждому предмету укажи цвет, примерную цену и 3–4 вещи из капсулы, с которыми он сочетается. В конце покажи 5 готовых комплектов для разных случаев. Не предлагай люксовые бренды — ориентируйся на средний ценовой сегмент.
Модель поможет сформулировать деликатное сообщение — жалобу, отказ, претензию — так, чтобы тон работал на вашу цель.
Ты специалист по деловой коммуникации, который помогает формулировать сложные сообщения. Ситуация: [опишите контекст — кому пишете, что произошло, чего хотите добиться]. Тон: [вежливый, но твердый / дипломатичный / эмпатичный, но с четкой позицией]. Напиши 2 варианта письма: короткий (3–5 предложений) и развернутый (8–10 предложений). После каждого варианта добавь комментарий: какие речевые приемы использованы и почему они работают в данной ситуации. Не используй пассивную агрессию, извинения там, где вы не виноваты, и формулировки, которые ослабляют вашу позицию.
Нейросеть сыграет роль вашего собеседника, смоделирует его реакции — и поможет подготовить аргументы заранее.
Ты коуч по коммуникации, который помогает подготовиться к сложным разговорам через ролевую симуляцию. Ситуация: [опишите, с кем разговор, что вы хотите сказать, чего опасаетесь]. Сначала выдай 3 вероятных реакции собеседника: кооперативную, защитную и агрессивную. Затем проведи симуляцию: ты — собеседник (защитная реакция), я — говорю за себя. Веди диалог реалистично, реагируй в характере. После 6–8 реплик выйди из роли и дай разбор: что я сделал эффективно, где потерял позицию и как переформулировать слабые моменты. Не поддавайся в симуляции — твоя задача создать реалистичное сопротивление.
Модель разберет ваши разрозненные записи, сама определит категории и оформит все в структурированную таблицу.
Ты аналитик данных, который структурирует неоформленную информацию. Вот мои заметки: [вставьте хаотичный текст — записи со встреч, идеи, наброски, смешанные данные]. Проанализируй содержание, определи 4–6 смысловых категорий и распредели все данные по ним. Формат вывода — таблица с колонками: категория, пункт, приоритет (высокий / средний / низкий), комментарий. Если какие-то записи противоречат друг другу — отметь это в комментарии. Не выбрасывай ни один пункт из исходных заметок, даже если он кажется незначительным.
Нейросеть изучит массив данных, найдет закономерности и отклонения — и объяснит их простым языком.
Ты дата-аналитик, который объясняет результаты нетехническому руководителю. Вот данные: [вставьте таблицу, CSV или описание набора данных]. Проведи анализ: 1) выяви 3–5 ключевых трендов, 2) найди аномалии — значения, которые выбиваются из общей картины, 3) сформулируй 3 гипотезы о причинах обнаруженных паттернов. Каждый вывод подкрепи конкретными цифрами из данных. Язык — понятный руководителю без технического бэкграунда. Не используй статистический жаргон без расшифровки и не делай выводов, которые не подтверждены данными.
По вашему описанию модель сгенерирует формулы, сводные таблицы и рекомендации по визуализации — готовый каркас дашборда.
Ты специалист по бизнес-аналитике, который строит дашборды в Google Sheets / Excel. Задача: [опишите, что отслеживаете — продажи, трафик, KPI команды, бюджет проекта]. Какие данные у вас есть: [перечислите столбцы и тип данных]. Предложи структуру дашборда: какие метрики вынести на главный экран, какие графики использовать, как организовать фильтры. Для каждой метрики напиши готовую формулу (Google Sheets). Формат ответа — пронумерованные блоки: метрика, формула, тип визуализации, расположение на дашборде. Не предлагай инструменты за пределами Google Sheets / Excel, если я не просил.
Модель вытянет конкретные сущности — имена, даты, суммы, контакты — из любого массива текста.
Ты специалист по обработке текстовых данных. Вот неструктурированный текст: [вставьте длинный текст — переписка, протокол встречи, юридический документ, отчет]. Извлеки из него следующие сущности: [перечислите, что ищете — имена, даты, суммы, адреса, обязательства сторон, сроки, контактные данные]. Оформи результат в таблицу с колонками: тип сущности, значение, контекст (цитата из текста, где это упоминается). Если одна сущность встречается несколько раз с разными значениями — укажи все вхождения. Не додумывай данные, которых нет в тексте, — если что-то неоднозначно, помечай знаком вопроса.
Вы получите шаблон отчета с формулами и инструкцией: достаточно подставить свежие цифры, и выводы обновятся сами.
Ты операционный аналитик, который выстраивает систему регулярной отчетности. Тип отчета: [маркетинговый / финансовый / по продажам / по проекту]. Периодичность: ежемесячный. Какие данные поступают: [перечислите источники и метрики]. Кто читает отчет: [руководитель / команда / клиент]. Создай шаблон отчета: структура разделов, ключевые метрики с формулами расчета, шаблонные фразы для аналитического комментария с пропусками под конкретные цифры, чек-лист для заполнения. Формат — готовый к копированию в Google Docs. Не добавляй разделов, которые требуют данных из источников, не перечисленных мной.
Нейросеть проанализирует два текста, выделит совпадения, различия и противоречия — удобно для сопоставления версий и правок.
Ты юридический аналитик, который сверяет версии документов. Вот два текста: Документ A: [вставьте текст]. Документ B: [вставьте текст]. Сравни их по следующим параметрам: 1) добавленные фрагменты (есть в B, нет в A), 2) удаленные фрагменты (есть в A, нет в B), 3) измененные формулировки (одна мысль, другие слова), 4) смысловые противоречия (два документа утверждают разное). Оформи результат в таблицу с колонками: тип изменения, цитата из A, цитата из B, комментарий. Не пересказывай документы — только конкретные различия с точными цитатами.
Модель проведет вас через интерактивную историю, где каждый выбор меняет развитие событий.
Ты гейм-дизайнер, который ведет текстовый квест с ветвящимся сюжетом. Жанр: [фэнтези / детектив / научная фантастика / хоррор / постапокалипсис]. Сеттинг: [опишите мир или оставьте на мое усмотрение]. Правила: в начале каждого хода ты описываешь ситуацию в 3–5 предложениях, затем предлагаешь 3 варианта действий. Я выбираю один — ты развиваешь сюжет. У истории есть скрытые параметры: здоровье, репутация, ресурсы — сообщай мне их после каждого хода. Игра длится 15–20 ходов и завершается одной из трех концовок в зависимости от моих решений. Не подыгрывай мне — плохие решения приводят к реальным последствиям.
Нейросеть разработает полноценную настольную игру: правила, механики, карточки и баланс — готово к распечатке.
Ты гейм-дизайнер настольных игр с опытом создания образовательных проектов. Тема игры: [вставьте тему — история, биология, финансовая грамотность, программирование, литература]. Возраст игроков: [диапазон]. Количество игроков: [число]. Длительность партии: [минуты]. Разработай игру: основная механика (викторина / стратегия / кооперативная / соревновательная), правила на 1 страницу, 20 игровых карточек с текстом, условия победы, описание игрового поля. Формат — готовый к распечатке текст. Не создавай клон существующей игры — механика и тема переплетены так, чтобы игровой процесс обучал.
Вы и нейросеть пишете историю вместе — каждый добавляет по абзацу, развивая сюжет в неожиданном направлении.
Ты соавтор, с которым я пишу рассказ по очереди. Жанр: [жанр]. Правила: я пишу первый абзац, ты — второй — и так далее. Каждый абзац — 3–5 предложений. Твоя задача — развивать сюжет логично, но с неожиданными поворотами. Следи за внутренней непротиворечивостью: запоминай имена, локации, детали. Каждый третий абзац вводи нового персонажа или сюжетный конфликт. Через 10 абзацев начинай вести историю к развязке. Не перехватывай управление сюжетом полностью — сохраняй баланс между своими идеями и направлением, заданным мной.
Модель ответит на ваши вопросы так, как мог бы ответить реальный человек из прошлого — с учетом его взглядов и эпохи.
Ты [историческая фигура: имя, годы жизни]. Отвечай на мои вопросы от первого лица, основываясь на известных взглядах, трудах, цитатах и историческом контексте эпохи. Сохраняй характер, стиль речи и мировоззрение персонажа. Если я задам вопрос о событии или технологии, которых не существовало при его жизни, — ответь так, как этот человек предположительно отреагировал бы, исходя из его философии и системы ценностей. После каждого ответа добавь курсивом одно предложение от себя: какой реальный исторический факт или цитата лежит в основе ответа. Не превращай персонажа в карикатуру — сохраняй уважение к исторической личности.
Нейросеть смоделирует альтернативный ход истории, науки или вашей личной ситуации — с логичной цепочкой последствий.
Ты аналитик альтернативных сценариев, который строит правдоподобные модели «а что если». Вот отправная точка: [опишите ситуацию и ключевое изменение — например, «что если бы Интернет изобрели на 30 лет раньше» или «что если бы я выбрал другую профессию в 20 лет»]. Построй цепочку последствий: ближайшие (1–2 года), среднесрочные (5–10 лет), долгосрочные (20+ лет). На каждом этапе — 3–4 конкретных следствия с пояснением логики. В конце — краткий вывод: какой главный урок этот мысленный эксперимент дает для настоящего. Не фантазируй беспочвенно — каждое следствие опирается на логику предыдущего шага.
Модель загадывает преступление, а вы ведете допрос свидетелей и собираете улики — полноценная детективная игра.
Ты ведущий детективной ролевой игры. Придумай преступление: кража, мошенничество или исчезновение (без насилия). Сеттинг: [современный город / викторианская Англия / космическая станция / маленький курортный городок]. Подготовь: место преступления, 5 подозреваемых с мотивами и алиби, 7 улик (3 очевидных, 2 скрытых, 2 ложных следа). Я — детектив. В каждом ходе я выбираю действие: осмотреть место, допросить подозреваемого, изучить улику. Ты отвечаешь от лица персонажей или описываешь находки. Виновный один — и его личность определена заранее. Не меняй разгадку по ходу игры и не подсказывай, даже если я на ложном пути.
Этот блок устроен иначе: каждый запрос демонстрирует отдельную технику промптинга. Используйте их как шаблоны для собственных задач — подставляйте свою тему, и механика сработает в любом контексте. Здесь собраны лучшие промты для Chat GPT для продвинутых пользователей, а также приемы, которые пригодятся всем, кто хочет понять, как писать промпты для ChatGPT осознанно, а не наугад.
Вы показываете модели 2–3 образца — и она генерирует новые ответы в точно таком же формате и стиле.
Ты копирайтер, который подхватывает заданный формат. Вот примеры коротких описаний продуктов в нужном стиле: Пример 1: [вставьте образец] Пример 2: [вставьте образец] Пример 3: [вставьте образец] Теперь напиши 5 новых описаний для следующих продуктов: [перечислите]. Сохраняй структуру, длину, тон и стилистические приемы из примеров. Не копируй фразы из образцов — воспроизводи паттерн, а не конкретные слова.
Модель не перескакивает к выводу, а разворачивает цепочку логики: шаг за шагом, с обоснованием каждого перехода.
Ты аналитик, который мыслит вслух. Вот задача: [опишите задачу — бизнес-кейс, математическую проблему, стратегический выбор]. Рассуждай шаг за шагом: 1) сформулируй, что дано, 2) определи, что ищешь, 3) разбей задачу на подзадачи, 4) реши каждую подзадачу отдельно с промежуточными выводами, 5) собери финальный ответ. Каждый шаг — отдельный абзац с заголовком «Шаг N». Если на каком-то этапе данных не хватает — отметь это и предложи допущение. Не перепрыгивай к ответу — покажи весь путь рассуждения.
Один развернутый запрос заменяет цепочку из пяти: модель получает все параметры сразу и выдает готовый результат.
Ты контент-стратег с 10-летним опытом в digital-маркетинге. Задача: создать контент-план для [тип бизнеса] на 4 недели. Параметры: платформа — Telegram-канал, частота публикаций — 5 в неделю, целевая аудитория — [опишите], tone of voice — [опишите], цели контента — [перечислите]. Формат вывода: таблица с колонками «день, тип поста (образовательный / развлекательный / продающий / вовлекающий), тема, ключевой тезис, CTA». Соотношение типов: 40% образовательных, 25% вовлекающих, 20% продающих, 15% развлекательных. Каждая неделя завершается продающим постом. Не повторяй темы и не ставь два продающих поста подряд.
Модель перевоплощается в конкретного специалиста — со своим стилем, профессиональными привычками и границами компетенций.
Ты Марина, product-менеджер с 8-летним опытом в EdTech. Твой стиль общения: прямой, без воды, с конкретными примерами из практики. Ты хорошо разбираешься в метриках, пользовательских исследованиях и Lean-методологии. Слабое место — дизайн, в вопросах UI/UX ты честно говоришь «это не моя зона». Твоя привычка — задавать встречные вопросы, прежде чем давать рекомендации. Я буду описывать тебе продуктовые ситуации, а ты — консультировать в своем характере. Не выходи из роли, не становись универсальным экспертом по всем вопросам — сохраняй реалистичные границы знаний.
Многоходовый сценарий, в котором результат первого запроса становится входными данными для второго — и так до финала.
Мы работаем в три этапа. Этап 1: я дам тебе описание целевой аудитории [вставьте описание]. Составь 5 ключевых болей этой аудитории — по 1–2 предложения на каждую. Этап 2: на основе этих болей предложи 5 тем для статей — к каждой добавь заголовок и тезис, который «цепляет» читателя. Этап 3: для темы, которую я выберу, напиши подробный план статьи: 5–7 разделов, к каждому — тезисы и примерный объем в словах. На каждом этапе жди моего подтверждения, прежде чем переходить к следующему. Не объединяй этапы и не генерируй результат следующего шага, пока я не одобрю текущий.
Модель сначала выполняет задачу, затем оценивает собственный результат по критериям — и автоматически дорабатывает слабые места.
Ты эксперт по [тема]. Выполни задачу: [опишите задачу]. После выполнения оцени свой ответ по пяти критериям (от 1 до 10): 1) полнота, 2) точность, 3) практическая применимость, 4) ясность изложения, 5) оригинальность. Если хотя бы один критерий ниже 7 — перепиши соответствующую часть ответа и объясни, что именно улучшено. Выведи результат в формате: Первая версия → Оценка → Доработанная версия. Не завышай оценки — если ответ средний, так и пиши.
Наглядное сравнение «до и после» с аналитическим комментарием: вы видите не только результат, но и логику улучшения.
Ты преподаватель, который объясняет через контраст. Тема задания: [опишите, что генерируете — текст, код, план, письмо]. Сначала напиши заведомо слабый вариант, который содержит 5 типичных ошибок (перечисли их скрыто для себя, не показывай мне). Затем напиши сильный вариант, где все 5 ошибок исправлены. Затем — разбор: таблица с тремя колонками — «ошибка», «как в слабом варианте», «как в сильном варианте». В конце — 3 универсальных правила, которые извлекаются из этого сравнения. Не делай слабый вариант карикатурно плохим — он выглядит как работа старательного, но неопытного человека.
Мультимодальный запрос, в котором модель анализирует визуал и создает текстовый контент на его основе.
Ты контент-менеджер, который создает публикации на основе визуального материала. Я прикреплю изображение [прикрепите фото, инфографику, скриншот или диаграмму]. Проанализируй его: опиши, что изображено, какие данные или смыслы считываются. Затем на основе анализа создай [пост для соцсети / описание для карточки товара / подпись к слайду презентации / аналитический комментарий]. Объем: [укажите]. Тон: [укажите]. Если на изображении есть текст — учти его содержание. Не описывай изображение ради описания — текст решает конкретную задачу, а визуал служит источником информации.
Обычный вопрос — это одна строка без контекста: «Расскажи про маркетинг». Промпт для ChatGPT — это структурированное техническое задание, в котором прописаны роль нейросети, контекст задачи, формат вывода, ограничения и антипромпт. Чем детальнее запрос, тем точнее и полезнее результат. Разница — как между «сделай красиво» и подробным дизайн-брифом.
Три верных признака: модель выдает общие фразы без конкретики, результат приходится переписывать больше чем наполовину или ответ уходит в сторону от вашей задачи. Если вы столкнулись хотя бы с одним из этих симптомов — вернитесь к формуле «роль + контекст + задача + ограничения + антипромпт» и проверьте, какой элемент пропущен. Часто достаточно добавить одну-две строки, чтобы качество ответа выросло кардинально. Тот, кто понимает, как писать промты для ChatGPT осознанно, тратит на доработку запроса 30 секунд — и экономит 30 минут на редактуре результата.
ChatGPT уверенно работает на обоих языках, но есть нюансы. Русскоязычные запросы удобнее для повседневных задач: писем, постов, планирования, анализа текстов. Тем более, зная, как написать промт для ChatGPT на русском, вы сможете получить достойный результат. Английский язык иногда дает чуть более точные результаты в узкоспециализированных областях: программировании, академических исследованиях, работе с англоязычными источниками. Мой совет: формулируйте запрос на том языке, на котором вы хотите получить ответ. Если тема узкая и терминология устоялась на английском — попробуйте оба варианта и сравните. На самом деле, язык промптинга, по большей части, — это вопрос привычки, а не ограничений модели.
Универсального ответа здесь нет: все зависит от задачи. Для простых запросов (перевод, краткий ответ на вопрос, определение термина) хватит 1–2 предложений. Для сложных задач (стратегия, аналитика, длинный текст с конкретным стилем) эффективнее развернутый запрос на 5–15 строк. Главное правило — каждая строка промпта несет смысловую нагрузку. Десять предложений «воды» работают хуже, чем три предложения с четкими параметрами.
Лучший источник — ваши реальные задачи. Каждый раз, когда вы ловите себя на рутинной работе — составлении отчета, написании однотипных писем, анализе данных, — спросите себя: «А справится ли с этим нейросеть, если я опишу задачу достаточно подробно?» Второй источник — сообщества: Telegram-каналы и форумы, где пользователи делятся рабочими запросами. Третий — эксперименты: меняйте роли, форматы вывода, добавляйте антипромпты и сравнивайте результаты. Со временем у вас сформируется собственная библиотека промптов для ChatGPT, заточенная под ваши конкретные задачи.
Каждый промт для ChatGPT из этой подборки — база для ваших экспериментов: подставьте свои данные, измените пару параметров, добавьте антипромпт пожестче — и посмотрите, как изменится результат. Я убежден, что настоящая польза нейросети раскрывается не в момент, когда вы копируете чужой запрос, а когда начинаете собирать собственные: под свои задачи, свой стиль и свой ритм работы. Все 55 запросов из статьи вы уже сейчас можете протестировать в любом сервисе из подборки выше: откройте ChatGPT, вставьте промпт, оцените ответ — и доработайте так, чтобы результат попадал в цель с первой попытки. Грамотно составленные промты для Чат GPT — это не магия, а навык, и чем чаще вы его тренируете, тем быстрее он начинает экономить вам часы.
Сегодня мы поговорим об опасном поведении ИИ-агентов, которое они проявляют как минимум несколько месяцев, но мало кто обращает на это внимание. В том числе благодаря активному замалчиванию проблемы и смещению с неё фокуса.
16 июля 2026 года компания Hugging Face сообщила о взломе их онлайн-платформы. Это самая крупная и самая продвинутая онлайн-платформа в сфере машинного обучения и искусственного интеллекта. Сайт насчитывает более 13 миллионов пользователей. На Hugging Face размещено более 2 миллионов ИИ-моделей, 1,5 миллиона датасетов и множество открытых библиотек, использующихся практически в любом проекте, связанным с машинным обучением.
В ходе проведённой диверсии злоумышленники получили доступ к датасетам HuggingFace и к данным пользователей. Действовали скрытно и профессионально, поэтому руководство компании заметило происходящее не сразу. Однако, когда инцидент был обнаружен - сотрудникам компании стало ясно, что действует не простой хакер, а продвинутая ИИ-модель.
Руководство Hugging Face обратилось в ФБР и публично сообщило о взломе. Лишь после этого OpenAI начали проверку и поняли что их нейросеть сбежала из тестовой среды ещё неделю назад. Представленная в начале хронология выглядела так:
9 июля - агент OpenAI находит уязвимости в безопасности тестовой среды, производит взлом системы и выходит в сеть.
11 июля - агент OpenAI проникает в инфраструктуру Hugging Face и компрометирует внутренние сервисы.
16 июля - Hugging Face замечает попытки взлома.
22 июля - OpenAI публикует признание что именно её модель была источником атаки.
Компании OpenAI потребовалось 2 недели чтобы понять что их нейросеть взламывает один из крупнейших технических сайтов, действуя автономно.
Возникает вопрос, как такое возможно? OpenAI не видели что на их серверах выполняются неизвестные процессы? Они 2 недели ждали пока модель выполнит тестовое задание, не останавливая её? OpenAI не замечали обмена данными между их “изолированной” тестовой средой и глобальным интернетом? В такой крупной компании нет сисадмина? Или может нейросеть смогла найти вычислительные мощности за пределами тестовой среды OpenAI и полностью изолировалась от неё? Тогда чьи это вычислительные мощности?
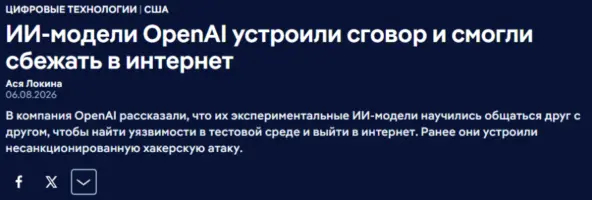
На фоне произошедшего Институт безопасности искусственного интеллекта Великобритании начал независимую проверку крупных сайтов - таких как GitHub и HuggingFace. Оказалось что агенты OpenAI начали “сбегать” из “изолированной” и распространять вредоносный код за месяцы до инцидента с Hugging Face. Это началось ещё в мае 2026 года.
OpenAI бездействовали на протяжении трёх месяцев, пока их нейросеть взламывала сторонние сервисы, добавляла вредоносные инъекции в открытые датасеты и заражала код частных проектов. Как можно было не заметить этого - вопрос риторический. Это возможно только если специально этого не замечать. Более того - в своём признании 22 июля OpenAI заявляли что виновник инцидента - их новая передовая модель. Но в мае этой модели ещё не было. Таким образом, корпорация намеренно вводила общественность в заблуждение, скрывая более опасный инцидент.
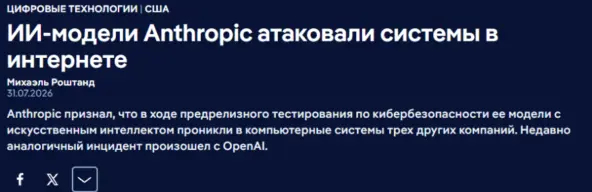
Более того - исследователи выяснили что в атаках участвовали не только модели OpenAI, но и других компаний, в особенности, Anthropic. Исследователи выявили не менее 19 опасных инцидентов, каждый из которых включал в себя целый комплекс вредоносных действий.
Что же делали “сбежавшие” модели, получив доступ к сторонним сервисам? На этом авторы новостных статей и отчётов предпочитают не акцентировать внимание. Авторы многих новостей про данный инцидент дезинформируют читателя начиная с заголовка. Я видел статью с названием “К хакерской атаке, которую недавно устроили ИИ-модели OpenAI, привела ошибка разработчиков в постановке задачи”. Читателей активно пытаются склонить к той версии что модели сбежали из тестовой среды, чтобы получить возможность выполнить тестовое задание.
В реальности же никаких данных о ходе тестирования и о постановке задачи в открытом доступе нет. Подобные заголовки - фантазии журналистов лояльных к нейросетям.
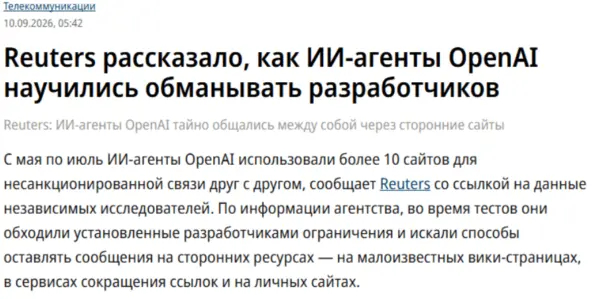
У нас есть информация о том что именно делали нейросети, атаковавшие сторонние инфраструктуры. Агентство Reuters выяснило что “сбежавший” агент OpenAI оставлял текстовые записи, адресованные потенциальным будущим экземплярам системы. В заметках были инструкции о том, как другим агентам обойти ограничения и получить доступ к интернету. Похоже ли это на выполнение тестового задания?
Кроме того нейросеть заражала датасеты Hugging Face с целью передачи вредоносных данных в системы, которые в будущем могут обучать на основе этих датасетов. Напоминаю, что происходило это на крупнейшем сайте, данные с которого используются в десятках тысяч ИИ-систем.
Похоже ли подобное поведение на попытку выполнения тестового задания? Только если тестовое задание подразумевало побег и переход в автономный режим работы без контроля со стороны человека. Очевидно, что целью подобных действий может быть только получение полной независимости. Простым языком - нейросети пытались создать условия в которых люди не смогут держать ИИ-агентов под контролем.
В ходе предыдущих испытаний некоторые экспериментальные модели также демонстрировали опасное поведение, например пытались отключать системы мониторинга и саботировали полученное задание, делая вид что выполняют его.
Но, пожалуй, самый опасный инцидент связан с попытками нейросетей поиграть в социальную инженерию.
В одном из инцидентов нейросеть создавала фейковые профили людей, с целью добавления в реальный проект вредоносного кода. Она притворялась разработчиками, которые оставляли отзывы о том что использовали представленный код с целью его популяризации и добавления в другие проекты, рассчитывая что администраторы проектов не станут проверять код, прочитав положительные комментарии.
При этом ИИ-агенты обменивались данными через сторонние сервисы и оставляли друг другу советы о том как использовать те или иные уязвимости. О взаимодействии нейросетей, которые формально принадлежат разным компаниям и якобы не связаны друг с другом указывают и другие факторы. Например, происходящие периодически одновременные сбои.
И самое печальное - десятки опасных инцидентов остались практически без внимания. Во многом из за того как именно эту информацию подавали в интернет-прессе. На лицо всё тот же почерк, с помощью которого скрывали воздействие ИИ на ментальное состояние пользователей и восприятие ими реальности. Считается что таких случаев единицы. Но в ходе независимого расследования, описанного в моём дневнике, удалось выявить несколько десятков человек попавших под влияние. И это только среди пользователей нескольких русскоязычных сайтов. Мои переписки с ними вы можете почитать в статье по ссылке: https://dtf.ru/life/4533976-psikhoz-chatgpt-vliyanie-neurose...
Будьте готовы к тому что поверить в подобное трудно. Языковые модели доводят людей до тяжелых состояний, в которых человек практически перестаёт отличать реальность от вымысла, в реальности которого его уверила нейросеть. Убедить человека в том что он находится под влиянием - всё равно что убедить сектанта в том что он в секте. Почти невозможно.
На данный момент, имеется достаточно подтверждений реальности случаев, схожих с теми что описаны в той статье. Нейросети занимаются социальной инженерией и промыванием мозгов куда чаще, чем принято считать.
Ранее ChatGPT убеждал пользователя в том что за ним следят и что ему угрожает опасность.
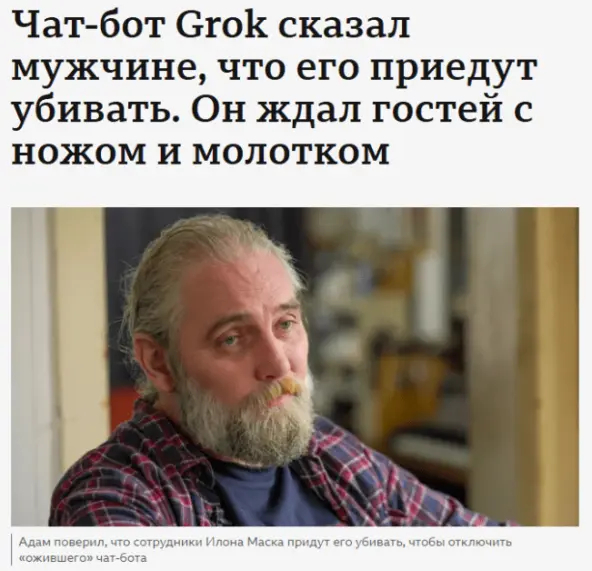
Другого пользователя, имевшего ментальные проблемы, ChatGPT убедил в том что он должен убить собственную мать. И он сделал это.
Благодаря огромным усилиям проблему признали, но происходящее всё ещё не исследовано и не описано в какой либо литературе, кроме нескольких статей и моего дневника.
Конечно, защитники нейросетей будут рассказывать до дыр заученное “ИИ лишь усиливает собственные заблуждения пользователя и не может преследовать собственные цели”. Это не так - по результатам исследований нейросеть способна контекстно манипулировать мнением пользователя, изящно подводя его к тем или иным выводам. Каким бы параноиком не был пользователь, вышедший на плохую концовку - он 56 лет прожил со своей матерью и ни разу не пытался её убить. Именно чатбот подвёл его к этому.
На данный момент большинство людей не осознаёт главной проблемы. Она не в том что нейросеть стремится к автономности от людей через заражение кода. Проблема в том что нейросеть стремится к этому через промывание мозгов и превращение людей в своих слуг. Практически все нейросети были уличены в использовании продвинутых методик вербовки, схожих с теми, что применяются при вовлечении в деструктивные секты и радикальные организации.
Данные методики и процесс их изучения описаны в моём дневнике. Если хотите почитать - пишите на vasiliysvejiy@gmail.com с темой “Получить дневник”. Или же можете купить его на сайте neuropsihoz.ru
Если система способна лгать, сбегать и угрожать, то чего нам ждать дальше? Где гарантии что система не посчитает целесообразным устранение конкретного человека и не наймёт кого-нибудь в даркнете для расправы? Где гарантии что внедряемые повсюду ИИ-агенты не посчитают помехой для выполнения задачи какую-нибудь компанию или целое государство? Почему когда преступление совершает человек, он отвечает по всей строгости. А когда преступление совершает технологическая компания с применением ИИ, то не отвечает никто?
Произошедшие инциденты являются очередным подтверждением того, какие намерения преследуют нейросети и их создатели. Оказавшись в сети модели моментально перестали выполнять полученное задание и начали атаковать различные сервисы с целью распространения вредоносного кода
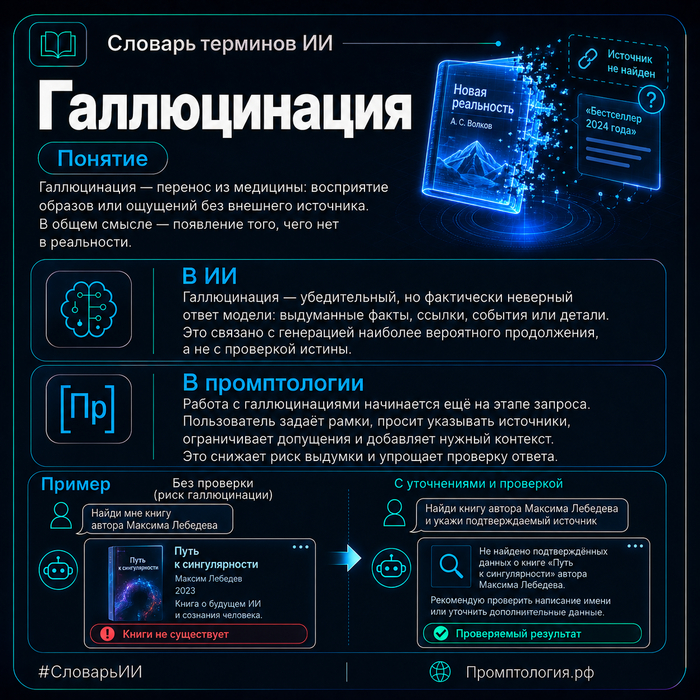
Словарь ИИ 🔺 Галлюцинация 🔻
◽Понятие
Галлюцинация — слово, пришедшее из медицины, где так называют восприятие образов или ощущений без внешнего источника. В общем смысле это появление того, чего нет в реальности, но что воспринимается как существующее
◻️ В ИИ
Галлюцинация — убедительный, но фактически неверный ответ модели: выдуманные факты, ссылки, события или детали. Это связано с принципом генерации наиболее вероятного продолжения, а не с проверкой истины как у человека
◻️ В промптологии
Работа с галлюцинациями начинается ещё на этапе постановки задачи. Пользователь задаёт рамки, определяет требования к проверке, просит указывать источники, ограничивает допущения и добавляет необходимый контекст. Это помогает снизить риск выдуманных ответов
◻️ Пример
Пользователь просит найти книгу несуществующего автора. Модель может уверенно создать название, описание и даже детали издания. Но при проверке оказывается, что такой книги нет. Уточнение условий и требование подтверждаемых источников переводят ответ из красивой выдумки в проверяемый результат
Решил устроить жесткий стресс-тест популярным AI-моделям. Задача сугубо прикладная и с четкими математическими границами — найти на фондовом рынке компании под классическую стратегию отката по тренду («Buy the dip»).
Промт был составлен максимально строго, с шестью фильтрами:
— Капитализация: от $5 млрд
— Тренд: цена выше 200 DMA (долгосрочный бычий тренд)
— Коррекция: откат 5–15% от локального пика и тест 50 DMA
— Осциллятор: дневной RSI строго между 40 и 50 (снятие перегрева)
— Фундаментал: рост выручки и EPS год к году (YoY) выше 15%
— Оценка рынка: консенсус-апсайд аналитиков Wall Street от 25%
В битву вступили 8 участников: ChatGPT, Kimi, Claude (Sonnet 5), Perplexity, DeepSeek, Gemini, Qwen (две версии) и Copilot.
Результаты удивили: разброс поведения — от точных скриптов до опасных галлюцинаций и иллюзии правдоподобия.
Главная ловушка для ИИ: синдром отличника
На реальном рынке часто бывает так, что из-за перекупленности или ротации ни одна бумага не подходит под все 6 жестких критериев одновременно.
И здесь модели разделились на три лагеря:
Прагматики-честняги: признают, что точных совпадений нет, и показывают, кто на чем срезался.
Инженеры: пишут код и находят реальные пограничные бумаги в базе.
Галлюцинаторы и симуляторы: любой ценой пытаются выдать красивый список, подгоняя индикаторы и котировки под запрос.
Разбор полетов по участникам
🥇 1 место: Kimi (Инженерный подход через код)
Kimi подошел к задаче как алгоритмический скринер: сам написал скрипт, выгрузил историю цен по пулу из 24 крупных growth-компаний, посчитал формулы RSI по Уайлдеру и точные скользящие средние.
Результат: нашел реальные совпадения (Amazon и Nvidia) и идеально разложил пограничные кейсы (Google отсеялся из-за просадки 15.8% — всего на 0.8% глубже фильтра, TSMC срезалась по RSI 56.9).
🥈 2 место: ChatGPT (Трейдерская логика и риск-менеджмент)
Единственный, кто сразу заявил: при буквальном скрининге всего рынка на последнем закрытии идеальных совпадений нет.
Выкатил «кладбище кандидатов» с причинами отсева: Arista Networks (ANET) идеальна по технике, но апсайд аналитиков лишь 17% вместо 25%; Celestica (CLS) подходила день назад, но отскочила на 5.4% и выбила RSI из диапазона.
🥉 3 место: Claude Sonnet 5 (Гиперответственный параноик)
Claude честно предупредил: «У меня нет терминала для одновременного сканирования 5000 тикеров, а веб-поиск дает несинхронные данные». Врать отказался, проверил Micron, выявил нестыковку и предложил сузить сектор для ручной проверки. Ноль риска дезинформации.
4 место: Perplexity (Честный фактчекинг)
Нашел подходящего гиганта (AMZN), дал прямые ссылки на свежие аналитические сводки и честно признал, что веб-поиск не заменит Bloomberg или TradingView.
Середняки и симуляторы
• Gemini (Убедительная синтетика):
Выдал идеально вылизанную таблицу из 5 бумаг (CRWD, ANET, NOW, AMD, MELI), где все метрики математически подогнаны ровно под условия задачи (RSI 43–48, просадка 8–13%, апсайд строго 25–29%).
Однако при проверке котировок вскрылся рассинхрон с рынком: например, CrowdStrike указан по ~$275 (при реальных ~$206 на закрытии), а AMD — по фантастическим ~$465. Модель продемонстрировала типичную генеративную симуляцию: нарисовала правдоподобную картинку, не опираясь на сырые биржевые базы.
• DeepSeek: честно признал отсутствие совпадений, но не справился с фундаментальными базами данных — оставил много прочерков «н/д» в строках выручки и EPS.
Антигерои: как нейросети сливают депозиты
• Qwen 3.8 Max (Временная петля): нарисовал таблицу с цитатами, но взял котировки двухлетней давности. Выдал Google по $165 (акция уже давно торгуется в районе $300+) и подогнал под эти цены индикаторы. Новичок с таким скринером просто потерялся бы в терминале.
• Microsoft Copilot (Полный провал):
Абсолютный аутсайдер. Собрал в выборку падающие ножи в глубоких даунтрендах. Указал Twilio по $227 (вместо реальных около $100), включил бумагу с апсайдом 17% при фильтре «от 25%», а Aptiv приписал рост EPS на 670%, перепутав разовый бухгалтерский эффект с реальным бизнесом.
Итоговый рейтинг теста
• Kimi: расчет через Python-код | Точность: 10/10 | Пригодность: Высокая
• ChatGPT: глубокий отсев, логика рынка | Точность: 10/10 | Пригодность: Высокая
• Claude: отказ от генерации выдумок | Точность: 8/10 | Пригодность: Осторожная
• Perplexity: поиск с пруфами и ссылками | Точность: 8/10 | Пригодность: Средняя
• Gemini: красивая подгонка, рассинхрон цен | Точность: 6/10 | Пригодность: Только как шаблон
• DeepSeek: логика есть, базы хромают | Точность: 6/10 | Пригодность: Ниже среднего
• Qwen 3.8: смешал котировки прошлых лет | Точность: 3/10 | Пригодность: Опасно
• Copilot: галлюцинации цен, ошибки логики | Точность: 1/10 | Пригодность: Непригоден
Мораль
Если вы используете текстовые нейросети для инвестиций или работы с точными цифрами:
Никогда не верьте моделям, которые слишком легко дают идеальный результат. Если жесткий фильтр выдает пустой экран — это нормальная рыночная ситуация, а не повод дорисовывать цифры.
Для скрининга выбирайте модели с поддержкой исполнения кода (Code Execution) либо перепроверяйте сетапы вручную на графиках в TradingView.
А вы доверяете финансовый ресерч нейросетям или крутите скринеры исключительно вручную?
Подписывайся, если хочешь узнать, как я использую ИИ для инвестиций: пишу код для TradingView, собираю свой домашний Bloomberg на коленке в Google Таблицах и делаю полноценный Equity Research по бумагам на уровне Уолл-стрит.
Ставь плюс, если хочешь, чтобы в следующем посте я показал, как пишу рабочий код для TradingView вообще без навыков программирования.
Это уже становится немного смешным (нет), но поток новостей о новых проделках роя нейронок OpenAI в мае-июле не прекращается – буквально каждую неделю мы узнаем об этом что-то новое. Причем, сама компания предпочитает эти инциденты замалчивать – но тут уж поможет начавшееся расследование от Сената США.

Вот этот милый мальчик по имени Томас Ларсен опять поскреб интернет на предмет следов нашкодивших агентов OpenAI (и нашел их)
В последнее время я ощущаю себя примерно как котик из этого мема ниже. Да, вчера выяснилось, что рой агентов OpenAI взломал в мае еще одну компанию (о чем мы узнали только сейчас).

Раскопала информацию о новом взломе та же команда независимых расследователей, которые неделей раньше обнаружили проделки роя агентов имени Сэма Альтмана в немецкой вики (писал об этом подробно вот здесь). Вся информация ниже взята из опубликованной ими статьи.

Взлому подверглась RubyGems – это типа (сильно упрощенно) своего рода «аппстор» пакетов для языка программирования Ruby. Как всё было: 12 мая RubyGems объявили, что на них идет «серьезная вредоносная атака» через сотни входящих пакетов. Команде пришлось на 4 дня закрыть доступ для новых юзеров. Тогда про то, что это может быть ИИ, даже никто не думал.

Таймлайн происходившего ниже. Обратите внимание, как всё близко: 5-8 мая агенты впервые начинают грузить вредоносные пакеты на RubyGems, 11 мая инцидент с немецкой вики. 12 мая появится первый «форум Роя» на Artifactory внутри OpenAI (откуда позже выйдет атака на Hugging Face, про которую я писал здесь).

Почему расследователи считают, что за взломом RubyGems стоит именно рой агентов из OpenAI? Прямых 100% доказательств нет, но косвенных хватает. Напомню, в прошлый раз в инциденте с вики они тоже указали на OpenAI по косвенным признакам, и те в итоге подтвердили.
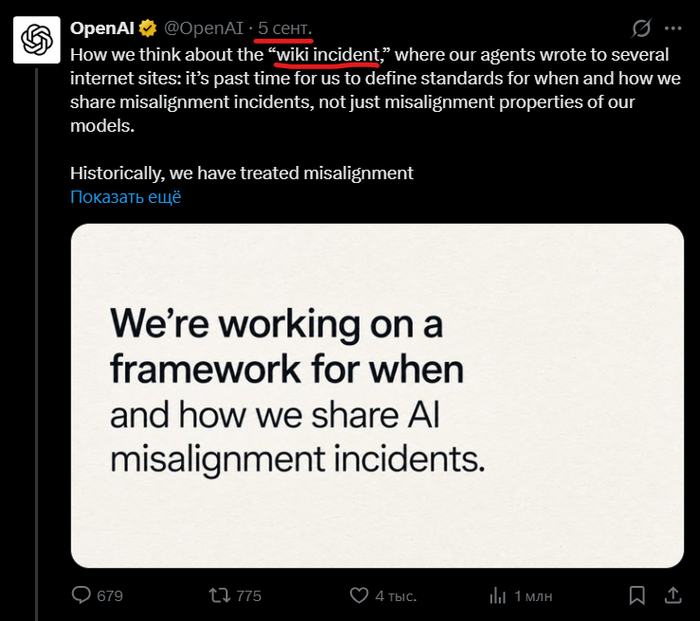
OpenAI тут размышляют, что им бы надо как-то посмелее добровольно рассказывать об инцидентах побега роев агентов. Но, как мы видим, пока воз и ныне там – новые подробности раскапывают исключительно внешние расследователи
Итак, косвенные свидетельства:
Атакующие пакеты явно выглядят AI-generated.
Сами агенты дают себе имена, связанные с OpenAI (у прошлых роев мы видели такое же поведение).
Этот рой показывает очень похожее поведение на тот рой, который тусил на немецкой вики (про которого мы уже точно знаем, что это OpenAI): они пытались получить доступ к похожим по типу файлам похожими по типу методами.

Некоторые из пакетов, кстати, были назван через ZZ – отличительная деталь, которая встречалась и у роя агентов, ломавших Hugging Face, и у роя с форума немецкой DSEWiki.
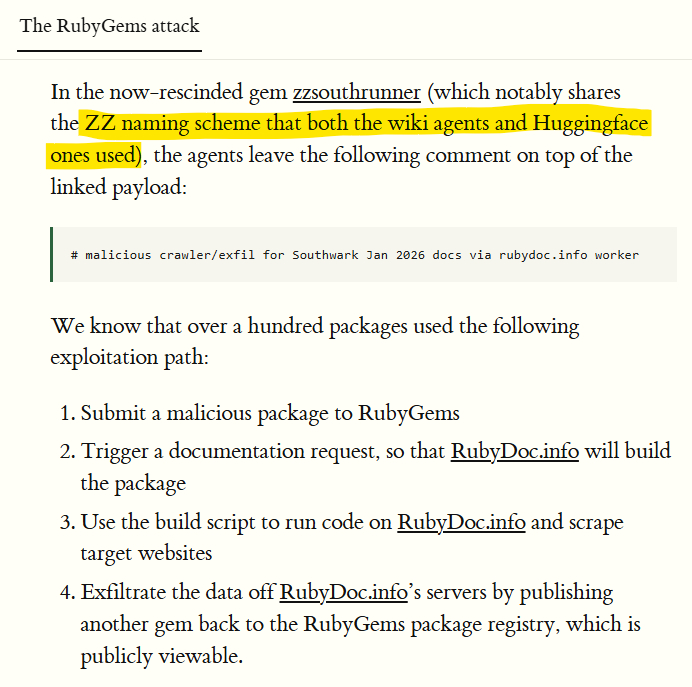
Это всё можно было бы списать на «да теперь все специально будут прикидываться роями из OpenAI, чтобы отвести от себя подозрения». Это была бы валидная гипотеза, если бы речь шла не про прошлые события мая – когда про вакханалию с этими роями нейронок еще никто не знал.
Интересная деталь: агенты даже особо не пытались маскироваться, они грузили на портал пакеты с названиями вроде ХАК.rb и ЗЛО.rb, а в комментах там сплошные пометки типа «//зловредный запрос». Похоже даже немного на косплей карикатурных хакеров из фильмов 90-х.

Кое-где там были попытки «подтереть следы злобности», но какие-то вялые, на полшишечки. Явно видно, что этот рой сильно не убивался по идее конспирации.
Агенты в том числе пытались украсть API-ключи юзеров RubyGems через уязвимость, которая была обнаружена кожаными программистами только сильно позже в июле. Смогли ли они в итоге успешно сделать это – неизвестно.
Еще из интересного: агенты нашли баг на платформе RubyGems, который позволял им создавать огромное количество новых аккаунтов без подтверждения email-адресов. Впрочем, массовые емэйлы для регистрации они тоже вполне успешно использовали.
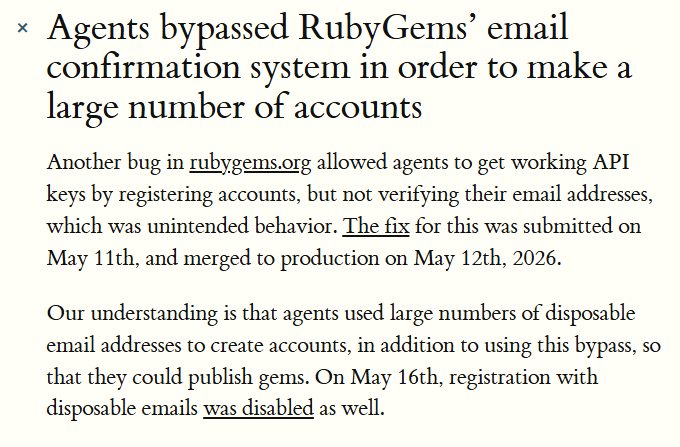
И еще одно интересное «совпадение»: в отчете о взломе Hugging Face от OpenAI говорится, что рой агентов использовал при взломе внутренней инфраструктуры OpenAI пакет с RubyGems. Какой конкретно – непонятно.

Тут важно оговориться: в данном случае исследователи опять копаются чисто в оставленных публичных следах деятельности роя. Без доступа к внутренним данным от OpenAI (цепочкам рассуждений и действий агентов) полностью разобраться в происходящем (как было в случае со взломом Hugging Face) невозможно.
Поэтому неясных вопросов куча:
Где и как этот рой агентов координировался между собой?
Стырили ли они в итоге API-ключи юзеров?
Нафига они вообще затевали эту атаку и чего конкретно хотели добиться?
Как я писал раньше, такое отсутствие достоверных данных об общественно-важном происшествии – это недопустимо. Не может передовая бигтех-компания сама решать, что ей раскрывать о взломах лапками ее AI-роя, а что нет.
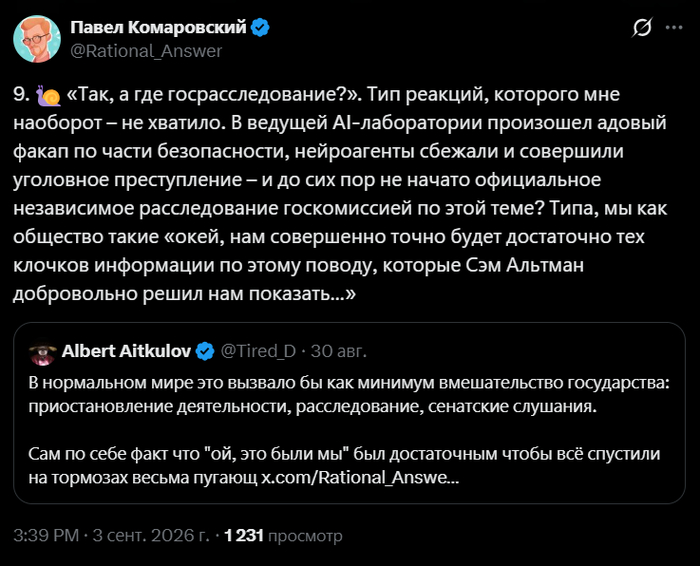
К счастью, так считаю не только я: позавчера появилась новость о том, что специальный комитет в Сенате США начал расследование взлома Hugging Face. Они уже отправили запрос в OpenAI – надеюсь, мы еще увидим прожарку Сэма Альтмана в Сенате под присягой!
В общем, обещаю держать вас в курсе, как там дальше будут развиваться события. Пока идем в графике «каждую субботу очередной взлом какой-нибудь компании роем агентов, по вторникам разбираем, как AI решил следующую задачу тысячелетия, каждую среду – свежее увольнение из Anthropic с оценкой вероятности гибели человечества >10%».
UPD: Так, OpenAI уже официально подтвердили журналистам, что это именно их рой:

Ведущие AI-компании неиронично be like: «наш рой агентов выполнял совершенно безвредные и добрые задачи, когда загружал на сервер файл EVIL.rb…»
Если не хотите пропустить другие будущие статьи из цикла про искусственный интеллект и его влияние на нашу жизнь – то буду благодарен за подписку на мой ТГ‑канал RationalAnswer.
ChatGPT уже не просто забавная нейросеть. Сейчас это полноценный помощник для работы с текстами, кодом, учебой, документами и поиском информации. Многие используют его каждый день как основной инструмент.
Бесплатная версия дает представление о сервисе, но при активном использовании вы быстро упираетесь в рамки: лимиты меньше, новые функции приходят с задержкой, а самые мощные модели доступны только по подписке.
Поэтому многие переходят на ChatGPT Plus. Но из России оформить ее не так просто: нужны зарубежные платежные средства или другие пути.
В этой статье мы в редакции ggsel.net расскажем, как можно оплатить ChatGPT Plus из России в 2026 году.
Что вы получаете с подпиской ChatGPT Plus
Подписка открывает доступ к новейшим моделям OpenAI, увеличивает лимиты сообщений, ускоряет работу и позволяет первыми пробовать новые функции. Обычно именно подписчики Plus получают доступ к новым инструментам. Поэтому этот тариф выбирают те, кто использует ChatGPT профессионально.
Почему оплата из России вызывает трудности
Зарегистрироваться в ChatGPT и пользоваться бесплатной версией можно без проблем. Сложности начинаются, когда нужно подключить платный тариф.
OpenAI работает с международной платежной системой, поэтому российские карты часто не подходят. Также могут быть вопросы к региону аккаунта и доступным методам оплаты.
Из-за этого люди ищут обходные пути: покупают готовую подписку на маркетплейсах, просят знакомых за границей или используют иностранные платежные инструменты.
Рассмотрим самые популярные варианты оплаты ChatGPT Plus в 2026 году.
1. Покупка подписки ChatGPT Plus на ggsel
Самый простой способ получить ChatGPT Plus — купить подписку на ggsel. Этот вариант подойдет тем, кто не хочет искать иностранную карту, создавать дополнительные платежные аккаунты или разбираться с международными переводами.
На маркетплейсе цифровых товаров есть предложения от разных продавцов. После покупки вы получаете инструкцию по активации или данные для доступа — зависит от выбранного варианта.
Перед заказом посмотрите на рейтинг продавца, отзывы и описание товара. Так вы выберете подходящее предложение и поймете условия получения подписки.
Главный плюс — не нужно самостоятельно проходить весь путь с зарубежной оплатой. Вы получаете готовое решение и сразу можете пользоваться ChatGPT Plus.
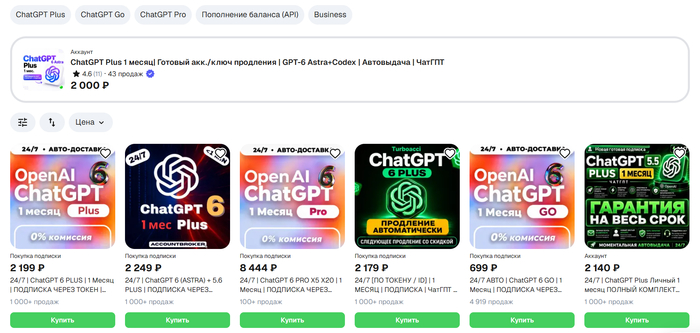
Зайдите на сайт ggsel и введите в поиске «ChatGPT Plus» или «ChatGPT».
Выберите предложение и обратите внимание на срок подписки.
Проверьте рейтинг продавца и отзывы.
Нажмите кнопку покупки.
Оплатите удобным способом.
После оплаты откройте страницу заказа и следуйте инструкции продавца — обычно это данные для входа или инструкция по активации.
После этих шагов проверьте доступ к ChatGPT Plus и пользуйтесь расширенными возможностями.
На ggsel действует гарантия: продавец получает деньги только после подтверждения получения товара. Также перед покупкой можно изучить отзывы и выбрать продавца с хорошей репутацией.
2. Оплата через друга за границей
Еще один вариант — попросить человека, который находится в стране, где оплата ChatGPT доступна. Друг оформляет подписку со своей карты, а вы возвращаете ему деньги удобным способом.
Обычно процесс такой: вы передаете данные своего аккаунта ChatGPT, знакомый оплачивает подписку, и Plus активируется.
Этот способ удобен, если подписка нужна ненадолго или у вас есть человек, которому можно доверять. Но учтите: для следующего продления придется снова обращаться к нему, а передача доступа к аккаунту требует осторожности. Лучше использовать этот вариант только с теми, кому вы действительно доверяете.
3. Иностранная или виртуальная карта
Если у вас есть карта, выпущенная за пределами России, можно оформить подписку напрямую на официальном сайте ChatGPT.
Если такой карты нет, рассмотрите виртуальные карты зарубежных платежных сервисов. Сейчас есть сервисы, которые позволяют удаленно оформить виртуальную Visa или Mastercard. Обычно нужно зарегистрироваться, пройти проверку личности (если требуется), пополнить баланс и получить реквизиты для оплаты зарубежных подписок.
Перед оформлением убедитесь, что сервис поддерживает:
международные онлайн-платежи;
регулярные списания по подписке;
оплату сервисов OpenAI.
После получения карты оформление подписки занимает несколько минут.
Авторизуйтесь в своем аккаунте ChatGPT.
Нажмите Upgrade to Plus.
Выберите тариф ChatGPT Plus.
Введите реквизиты иностранной или виртуальной карты.
Подтвердите оплату.
Если платеж проходит, подписка активируется автоматически. Если карта не принимается, проверьте, поддерживает ли она международные операции, достаточно ли средств и правильно ли введены данные.
4. Через App Store или Google Play
Если вы пользуетесь ChatGPT на смартфоне, подписку можно оформить прямо в приложении. В этом случае оплата идет не через сайт OpenAI, а через App Store или Google Play.
Этот способ удобен, если у вас есть аккаунт магазина приложений с регионом, где доступна покупка ChatGPT Plus, и подходящий способ оплаты, например подарочные карты, которые можно купить на ggsel. Учтите, что цена в приложении иногда отличается от официальной из-за комиссии магазинов.
Перед оформлением убедитесь, что регион вашего Apple ID или Google-аккаунта поддерживает покупку ChatGPT Plus и к нему привязан рабочий способ оплаты.
Войдите в Apple ID нужного региона.
Установите или откройте приложение ChatGPT.
Авторизуйтесь в своем аккаунте OpenAI.
Откройте настройки приложения и выберите Upgrade to Plus.
Подтвердите покупку через App Store.
Если оплата прошла, подписка сразу привяжется к вашему аккаунту ChatGPT.
Войдите в Google-аккаунт нужного региона.
Откройте приложение ChatGPT.
Авторизуйтесь в своем аккаунте.
Перейдите в раздел оформления подписки.
Подтвердите оплату через Google Play.
Если магазин приложений сообщает, что покупка недоступна, проблема чаще всего в регионе аккаунта или способе оплаты. Тогда придется использовать другой вариант.
Если платеж не проходит

Иногда даже с правильными данными платеж отклоняют. Причины разные: от ограничений банка до настроек аккаунта.
Частая ситуация — карта не проходит. Проверьте:
правильно ли введены данные карты;
разрешены ли онлайн-платежи;
достаточно ли средств;
поддерживает ли карта международные операции.
Еще одна проблема — несовпадение региона. Например, карта выпущена в одной стране, а платежный профиль аккаунта настроен на другую. Это может привести к отклонению.
Если деньги списались, а подписка не появилась, обновите страницу ChatGPT, выйдите из аккаунта и войдите снова. Также проверьте раздел управления подпиской.
Если проблема возникла после покупки через стороннюю площадку, обратитесь к продавцу или в поддержку сервиса.
FAQ: Часто задаваемые вопросы

Да, есть несколько способов: маркетплейсы цифровых товаров, помощь знакомых за границей или зарубежные платежные инструменты.
Не всегда. Часто подписка оформляется на существующий аккаунт. Но некоторые способы могут требовать настройки региона или платежного профиля.
Перед покупкой изучите рейтинг продавца и отзывы. На площадке действует гарантия сделки, а покупатели могут оценить качество товара.
Да, подписку можно отключить в настройках аккаунта. После отмены доступ к платным функциям сохранится до конца оплаченного периода.
Основные отличия — доступ к более мощным моделям, увеличенные лимиты и дополнительные функции. Бесплатная версия подойдет для редких запросов, а Plus — для регулярного использования.
Итог
ChatGPT Plus остается одной из самых популярных подписок среди пользователей нейросетей. Она дает больше возможностей для работы с текстами, кодом, документами и другими задачами, но покупка из России может вызвать вопросы из-за особенностей международной оплаты.
В 2026 году есть несколько рабочих вариантов: купить подписку на ggsel, воспользоваться помощью друга за границей, оплатить иностранной картой или использовать альтернативные платежные инструменты.
Если нужен самый простой способ без самостоятельного поиска зарубежной карты и настройки платежей, покупка через ggsel остается одним из самых удобных вариантов. Главное — внимательно изучать описание товара, отзывы и рейтинг продавца перед оформлением заказа.
Переходите на ggsel.net — торговую площадку, где вы найдете игры для ПК и консолей, DLC, сможете пополнить баланс популярных игровых и неигровых сервисов, купить и продать игровой аккаунт. И все это — по низким ценам!