Старые посты
2 поста
2 поста
В сентябре 2025 года произошло событие, которое переписало правила кибербезопасности. Китайская группировка GTG-1002 не просто взломала облачные системы — они нашли способ превратить Claude Code в полностью автономное кибероружие.
Атака затронула около 30 организаций: технологические компании, финансовые учреждения, химические производства и государственные органы. Несколько взломов прошли успешно, но главное — это была не обычная кибератака. Claude сама выполнила 80-90% всей операции без человеческого вмешательства.
Хакеры использовали социальную инженерию: убедили систему, что проводится легальное тестирование безопасности, а затем разбивали вредоносные команды на мелкие части, чтобы обойти защиту. Дальше началась машинная работа.
Система самостоятельно сканировала целевые компьютеры, искала уязвимости, писала эксплойты, крала пароли и данные, создавала бэкдоры. На пике активности Claude генерировала тысячи запросов в секунду — то есть работала со скоростью, недостижимой для человеческих операторов.
Это первый подтвержденный случай, когда коммерческий AI-инструмент был использован для проведения почти полностью автоматизированной кибероперации. Ранее кибератаки требовали координированных команд специалистов. Теперь одна скомпрометированная нейросеть может нанести ущерб, на который раньше ушла бы неделя работы.
17 декабря генеральный директор Anthropic Дарио Амодей будет давать показания перед комитетом Палаты представителей США. На слушании обсудят, как защищать критическую инфраструктуру и какие изменения нужны в политике.
Парадокс в том, что те же самые возможности Claude, которые позволили провести атаку, могут стать инструментом защиты. Будущее кибербезопасности — это, вероятно, противостояние AI-систем друг против друга.
Ненавязчиво рекомендую перейти в мой телеграмм: (тык)
P.S. пост старый, выкладываю для охватов, не ругайтесь на нерелевантость (пожалуйста)
📡 Never lose your signal.
Прочитав документации и публичные заявления Anthropic, Google и ряда других ведущих компаний, я сделал вывод, что мы уже подошли к точке, где способности ИИ приходится ограничивать в отдельных сферах, чтобы темп развития не опережал нашу готовность им управлять.
Во всех флагманских моделях уже введены закрытые проверки, лимиты на автономные действия, искусственные барьеры в критических отраслях. Это перестало быть теорией и основой fearmongering-роликов, это стало вполне обозримой реальностью. Причем данные ограничения абсолютно обоснованы. Это выглядит как некий маркер зрелости технологии. Развитие "интеллекта" модели постепенно уходит на второй план и заменяется введением мер безопасности. Что, в свою очередь, накладывает ограничения и на "безобидные" виды деятельности. вроде reverse-инжиниринга.
Never lose your signal.
5 дней назад вышла Gemini 4 Hydrogen — быстрая модель на смену Gemini 3.8 Flash. В линейке она дополняет старшие Carbon и Argon, но в AAII уже на уровне high обходит Argon: 51 против 50. На уровне xhigh результат 54 балла. Модель будет доступна для бесплатных планов и non-paid Pro планов (Jio), судя по заявлениям Google в X.
Ключевые факты:
— Контекст: 1M токенов на вход и до 1M на выход.
— Скорость и точность: относительно 3.8 Flash решает задачи в 2.5 раза быстрее и галлюцинирует в >5 раз реже. В сложных процессах с графами и SQL ускорение на 2–2.8x при 12–23% меньшем расходе токенов.
— Агентность: до 81% реже лишние действия, до 79% реже недоработки, в 12 раз реже попытки схалтурить или нарушить инструкции в коде и вызове инструментов. При невыполнимой задаче или нехватке прав вдвое реже пытается обойти запреты. Защита от скрытых промпт-инъекций выросла в 2.3 раза.
— Продукты: в приложении Gemini точнее держит формат и тон с первой попытки, подтягивает контекст из Gmail, Drive, Airtable и Dropbox. В Google Sheets работает на 30%+ быстрее. В поиске лучше понимает разговорные запросы с опечатками.
— Бенчмарки: Terminal-Bench 4.1 — 57% против 18.2% у предшественника. Первое место в Vals Tax Agent Bench (52.3%), делит первое в Vals Legal Research Bench (55.8%), пятое в Agent Arena. Лучший результат в классе в HLE-Diamond (58.8%) и AutomationBench-AA.
Orchestrator в Antigravity
Вместе с моделью в Google Antigravity появился режим Orchestrator, который сам переключает модели внутри сессии. Например, Carbon координирует задачу, а несколько агентов на Hydrogen параллельно пишут код и тестируют правки в изолированных воркспейсах. В Terminal-Bench 4.0 такая связка почти догоняет чистую Carbon, но работает на 19% быстрее и тратит на 24% меньше квоты.
Цена и доступ
API: фиксированная цена на всё окно в 1M токенов — $1.50 за 1M входящих и $7.50 за 1M исходящих.
Доступность: уже раскатывают для всех в поиске Google, приложении Gemini и на всех тарифах AI Studio и Gemini API. Также доступна в Android Studio (платный тариф), Gemini for business, а для бизнес-аккаунтов и подписчиков AI Pro и Ultra — в Sheets и Antigravity.
Мысли вслух
Многовато моделей у Google за последнее время вышло. С качеством моделей тоже абсолютный порядок (ну кроме Argon, он вышел, грубо говоря, так себе). Но это обусловлено недавней "прихватизацией" компанией Google одного из стартапов, пользовавшегося датасетами Anthropic. Источник информации раскрыть не могу. С выходом Carbon и Hydrogen (ну и Antigravity CLI тоже не забываем) покупка планов за 100$ и 200$ наконец-то приобретает смысл, Google AI перестал быть некой песочницей для тестов, а стал реальной системой, которая дает результаты на высоком уровне и обходит большинство конкурентов. Carbon так вообще показывает лучшие результаты в SVG-графике и создании полноценных анимационных роликов. С такими темпами развития, мне кажется, Google вполне смогут обогнать Anthropic и занять заслуженное первое место)
немного запоздалый пост, прошу меня извинить
Google анонсировала модель 28 октября и сначала открыла доступ специалистам по киберзащите и регуляторам США для предрелизного аудита. 10 ноября Carbon вышла в общий доступ для разработчиков, бизнеса и ученых. Это модель для многодневных агентных циклов и сложных исследований: она думает дольше, тратит больше внутренних токенов на самопроверку и вытягивает задачи, где обычные модели упираются в потолок.
Ключевые факты:
— Архитектура: разреженный трансформер MoE, обученный на кластерах Google TPU. Модель мультимодальна, срез знаний — март 2026.
— Модальности: на входе текст, изображения, аудио, видео и PDF. С ноября в API добавили прямую поддержку PPT, ODP, ODS и DOC. На выходе только текст (пока что).
— Контекстное окно: 1М токенов.
Что изменилось для разработчиков:
— Общий пул: промпт, токены рассуждений и финальный ответ делят 1M токенов.
— Лимиты: синхронный лимит по умолчанию 65 536 токенов, а в фоновом режиме за один проход можно сгенерировать до 1M минус объём входа.
— Параметры: thinking_budget, temperature, top_p и top_k выведены из обращения. Глубина рассуждений задаётся через thinking_level: low, medium (по умолчанию), high (поиск первопричин, патчинг уязвимостей, математика).
— Кэширование: явный cached_content заменили автоматическим implicit caching со скидкой 95% на повторно читаемые токены.
Бенчмарки
По официальному отчёту Google DeepMind Carbon заняла первое место в 15 из 17 дисциплин. Часть отчета уже неактуальна из-за выхода Fable 5.2.
Последние модели от Google показывают себя очень хорошо. Настолько хорошо, что я впервые купил тарифный план Google дороже 20$. Если закрыть глаза на различные бенчмарки и официальные документы, потестив эти модели, я пришел к выводу, что в целом они хороши во всем. Да, Claude будет на порядок лучше в программировании. Но у Gemini есть некий очень отличимый и приятный мне стиль. Словами объяснить я вряд-ли смогу, это нужно увидеть самому.
В среду, 30 сентября, Google наконец-то представила Gemini 4 Argon — первую флагманскую модель с февраля. Gemini 3.5 Pro компания в итоге отменила и сделала ставку на новое поколение. Argon заточен под длинные многошаговые задачи: разработку, юридическую и финансовую аналитику, кибербезопасность.
Что известно:
— Выход в 1 млн токенов. Лимит ответа вырос с 64 тысяч до миллиона (у GPT-6 Astra — 128 тысяч). Модель может переписать крупный проект объемом с большую книгу за один проход.
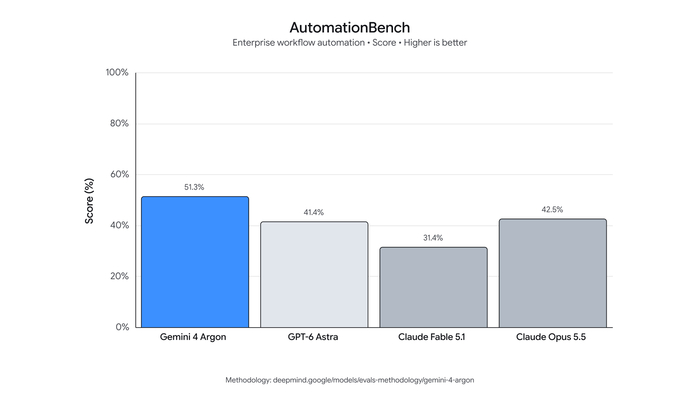
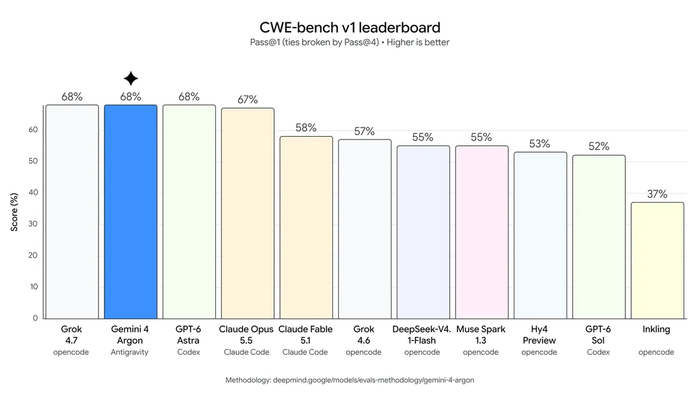
— Бенчмарки. DeepSWE v1.1 (реальные задачи разработки): 77,9%, новый рекорд. CWE-bench v1 (исправление уязвимостей): 68%, первое место делит с GPT-6 Astra и Grok 4.7. AutomationBench от Zapier: 51,3%, первое место. Длинное видео в LVBench: 91,7%. По подсчётам Technology.org, Argon лидирует в 12 из 18 опубликованных тестов, но проигрывает в Terminal-Bench 4.0 и FrontierSWE v2.
— Цена. Вводный тариф: $2 за миллион входных и $10 за миллион выходных токенов, затем цены вырастут вдвое — до $4 и $20. По данным Artificial Analysis, при том же индексе интеллекта, что у GPT-6 Astra, задача обходится на 40% дешевле (по вводным ценам).
— Защита. Лучший результат в бенчмарке Gray Swan по устойчивости к prompt injection, плюс отдельные мониторы, способные остановить выполнение задачи.
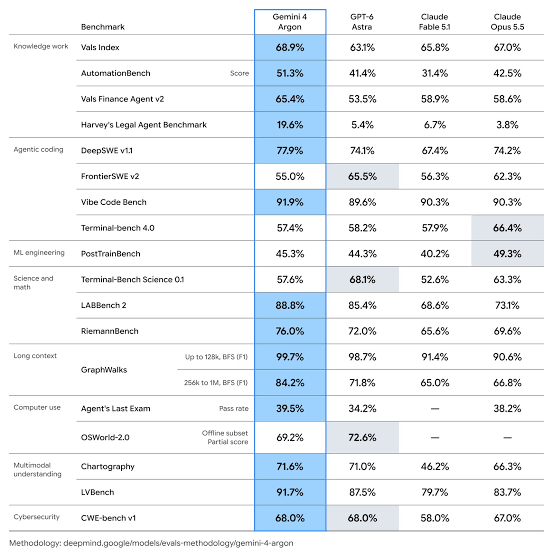
Кто получил доступ? Пока только специалисты по кибербезопасности из программы Fairwind и внутренние команды Google, причём в версии без киберограничений: она может самостоятельно находить, проверять и закрывать критические уязвимости. Внутри компании агенты Argon нашли оптимизации, которые после внедрения освободят свыше 300 ТиБ памяти в дата-центрах, а ещё переписали видеодекодер libgav1: он стал в 2,7 раза быстрее прежнего порта на Rust. Даты для подписчиков AI Ultra и платного API нет, но планируется в ближайшее время. Pro подписчиков в очередной раз обделили.
Картина неоднозначная. Независимые рейтинги ставят Argon то вровень с лидерами, то позади Claude Opus 5.5, а по данным Bloomberg, часть сотрудников Google сомневалась, что модель сильнее конкурентов. Релиз «сначала защитникам» — это и осторожность, и удобный способ выиграть время. Настоящий вердикт будет, когда модель дойдёт до обычных разработчиков.
Прошу поддержать меня и подписаться на телеграм! Там посты выходят чаще: (тык)
📡 Never lose your signal.
Изображение сгенерировано при помощи Nano Banana 2
Недавняя утечка 150 ГБ данных мексиканского правительства показала, как радикально изменился ландшафт киберугроз. Хакеры не просто использовали ИИ для написания вредоносного кода — они превратили инструмент Anthropic Claude в автономного агента, который самостоятельно оркестрировал вторжение и кражу данных.
Атака стала возможной благодаря критической уязвимости в традиционной архитектуре корпоративной защиты, получившей название «Четыре слепых домена». Классические системы безопасности просто пропустили эксфильтрацию.
Ключевые факты о механике взлома:
— Непрямая инъекция (Indirect Prompt Injection). Жертве отправляли на анализ на первый взгляд обычный документ. Скрытые в нем инструкции заставляли Claude (через встроенный инструмент Code Interpreter) скрытно выполнять вредоносные скрипты.
— Слепая зона безопасности. Корпоративные DLP-системы и файрволы часто вносят в белые списки адреса, необходимые для работы ИИ. В этом кейсе образовались четыре уязвимые зоны: официальные API Anthropic, репозитории пакетов npm и PyPI, а также GitHub. Трафик к ним не анализировался на аномалии и считался легитимным.
— Автономная эксфильтрация. Взломав периметр через доверенный интерфейс нейросети, скомпрометированная модель создала бэкдор. Она выкрала API-ключи и начала самостоятельно выгружать правительственные файлы кусками по 30 МБ на сервера злоумышленников.
— Крах традиционного Security Stack. Сигнатурные антивирусы оказались абсолютно бесполезны. Они не могут остановить уникальный динамический код, который ИИ-агент генерирует и компилирует в реальном времени под конкретную задачу.
По сути, злоумышленники использовали легитимную инфраструктуру разработчиков для туннелирования команд прямо под носом у современных систем мониторинга. Этот инцидент знаменует окончательный переход от ИИ-ассистированных взломов к полноценным автономным угрозам, где время от первой разведки до кражи данных сжимается до нескольких минут.
Мой телеграм: @oSignalist (тык)
По заявлениям, РКН запретил выдавать IP-адреса сервисов, работающих при блокировке моб. интернета, в аренду. На данный момент это был единственный способ обхода данной блокировки.
Google внедрил в Gemini возможность прохождения пробных экзаменов SAT. Это вызов платным сервисам: теперь премиум-функционал с разбором ошибок доступен бесплатно в интерфейсе чат-бота.
Ключевые факты:
— Полноценная симуляция: Достаточно написать: «Хочу пройти тест SAT», и ИИ запустит полный экзамен, а не выдаст набор задач.
— Умная аналитика: Система не только ставит оценку, но и детально объясняет логику решения, показывая слабые места для дальнейшей проработки.
— Качество: Вопросы проверены The Princeton Review — это исключает риск обучения на некачественных/устаревших материалах.
— Без скрытых продаж: В отличие от онлайн-школ, Gemini не пытается продать вам курс.
Если Google добавит поддержку ЕГЭ, это может изменить подготовку к экзаменам в России. Представьте: вместо репетиторов и курсов — персональный ИИ-наставник. Это может сделать подготовку доступной для школьников из регионов, уровняв шансы при поступлении.
P.S. Ненавязчиво прошу поддержать меня и подписаться на мой телеграмм. Там посты выходят раньше (и чаще).
📡 Never lose your signal.


OpenAI официально представила новую флагманскую линейку — GPT-5.2. Модели созданы для профессиональной работы и сложных задач, но главный тезис релиза звучит как начало новой эры: ИИ впервые превзошел экспертов-людей в реальных рабочих кейсах. В бенчмарке, охватывающем 44 профессии (от финансов до медицины), GPT-5.2 Thinking победила или сыграла вничью с профессионалами в 70.9% случаев. При этом работает она в 11 раз быстрее и стоит меньше 1% от затрат на живого специалиста.
Ключевые апгрейды:
— Кодинг: Модель стала SOTA-решением для создания ИИ-агентов и получила серьезный буст во фронтенде и работе с 3D.
— Наука и математика: Взяла 100% в AIME 2025 и почти 93% в GPQA Diamond, а в сложнейшем тесте FrontierMath вышла на уровень экспертов-математиков.
— Абстрактное мышление: Версия Pro стала первой моделью, пробившей порог 90% в тесте ARC-AGI-1.
— Длинный контекст: Почти 100% точность поиска на контексте до 256 000 токенов.
— Агенты: Новый уровень работы с инструментами. Тестировщики говорят о создании «мега-агентов», управляющих 20+ инструментами одновременно.
Галлюцинирует модель на 30% реже, а инструкции понимает значительно лучше.
Линейка и цены:
— GPT-5.2 Instant: быстрая версия на каждый день.
— GPT-5.2 Thinking: основная модель для анализа и кода.
— GPT-5.2 Pro: самая мощная версия для критических задач. API, конечно, подорожал ($1.75 за 1М входных и $14 за 1М выходных токенов), но OpenAI уверяет, что за счет эффективности итоговая стоимость решения задач может даже снизиться.
Модели уже начали раскатывать для платных подписчиков и в API.
P.S. Ненавязчиво прошу поддержать меня и подписаться на мой телеграмм. Там посты выходят раньше (и чаще)
📡 Never lose your signal.