
Старт продаж 98 винды в США, 1998 год
а ведь почти 30 лет прошло с тех пор
а ведь почти 30 лет прошло с тех пор
Если ты дизайнер, фотограф или любой другой человек, который зарабатывает креативом, ты давно знаешь эту боль. Adobe — это не просто программа. Это целый мир, в котором тебя либо нет, либо ты есть на их условиях.
Раньше было проще: купил диск, поставил, работаешь. Потом Adobe решила, что владеть — устарело, и перешла на подписку. Для кого-то это просто «ещё один платёж». А для нас, в России, это превратилось в отдельный вид спорта.
Оформить официальную подписку? Удачи. Карты не работают, аккаунты блокируются. Оплатить через посредников? Можно, но это уже не «подписка», а квест с непредсказуемым финалом: сегодня заплатил — завтра доступ отвалился, а деньги ушли в никуда.
Остаётся классика — ломаная версия. И вот тут начинается настоящая лотерея. Скачал «проверенный» билд — и надеешься, чтобы внутри не оказалось майнера, стилера или просто чего-нибудь, что превратит твой рабочий ноутбук в кирпич. Обновления не приходят, плагины отваливаются, а техподдержка — это форум, где такие же страдальцы советуют «переустановить с другого торрента».
Ты не пользователь. Ты выживаешь.
И вот на этом фоне появляются разработчики на Rust. Они, вероятно, подумали: «Adobe может это сделать, и мы можем — на языке с безопасной памятью. И бесплатно. И с открытым исходным кодом. И без всей этой возни с лицензиями, аккаунтами и блокировками». Признаюсь, смелость вызывает уважение — это как сосед-энтузиаст, который после третьей бутылки пива заявляет, что сам построит баню лучше, чем все эти «профессиональные бригады с их сметами». Абсурдно, но почему-то хочется посмотреть, что получится.
Так родился ArtCraft. Набор из семи приложений — «бесплатная замена семейству Adobe» — написанных с нуля на Rust, все бесплатные и с открытым исходным кодом. Скачал — и работаешь. Без карт, без VPN, без «кряков» и без нервов.
Семь приложений ArtCraft практически повторяют продуктовую линейку Adobe, почтительно «отдавая дань уважения» каждому продукту. Пробежимся быстро:
1. PhotoCraft — замена Photoshop
PhotoCraft: The image editor you already know how to use — так звучит официальный слоган, и это не ложь. Интерфейс, панель инструментов слева, слои справа — ты просто сменил логотип. Самое зрелое приложение в наборе, уже в Alpha, функции пока неполные, но «на каждый день хватает». Самое смешное: из 135 реальных тестовых PSD-файлов 134 после открытия и сохранения остались побитово идентичными. Слои, маски, корректирующие слои, стили слоёв, текст, векторы, кисти, поддержка RGB, CMYK, Lab, градаций серого, 8/16/32 бит, управление цветом ICC и soft proofing — всё это уже на месте.
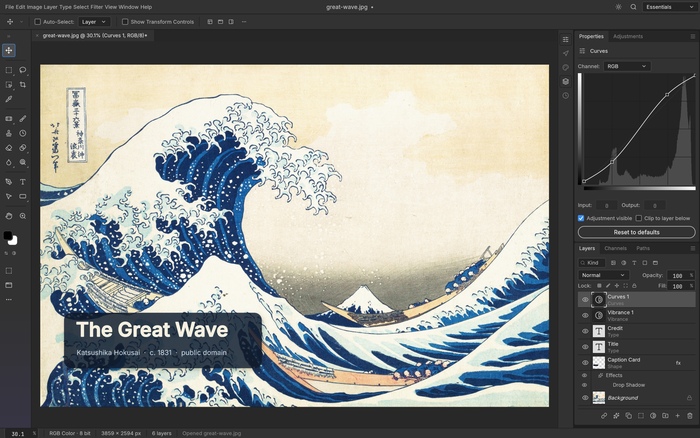
(изображение из README проекта на GitHub)
Честно о готовности: это не Photoshop, это «прошлое» Photoshop
Одну вещь нужно сказать прямо: сам PhotoCraft пишет в своём README — «early alpha», и команда честно признаёт, что он «пока не является заменой Photoshop для ежедневной профессиональной работы». Покрытие функций — примерно 50%. Список того, чего нет, займёт целую страницу: AI-генерации нет, около 20 инструментов не реализовано, работа с текстом и шрифтами поверхностная, плагины несовместимы вообще. Пользователи на Hacker News уже сообщают о куче багов: свободное трансформирование нестабильно, базовые маски и цветокоррекция работают, но до «удобно» ещё далеко.
Но.
Ты помнишь, каким был Photoshop десять лет назад?
В CS5 2010 года самой впечатляющей новой функцией были Content-Aware Fill и Puppet Warp. В CS6 2012 года — «новый инструмент кадрирования» и «улучшенный фильтр Liquify». В 2013-м началась эра CC, и Camera Shake Reduction с Perspective Warp считались большими новостями.
Другими словами: то, что десять лет назад ты покупал за несколько тысяч как «профессиональный инструмент», по сегодняшним меркам — так себе. Слои, маски, кривые, кисти — всё это устоялось ещё в Photoshop 7 2005 года. Всё, что Adobe делала последние пятнадцать лет — добавляла фильтры, добавляла AI-функции, переносила всё в облако и брала с тебя деньги ежемесячно.
PhotoCraft сейчас — это примерно уровень Photoshop CS. Не впечатляюще, но достаточно. А «достаточно» — именно то слово, которого Adobe боится больше всего.
И вот тут важный момент для нас. Если ты в России и у тебя нет ни официальной подписки, ни стабильного доступа к обновлениям, ни гарантий, что «кряк» не окажется трояном — «уровень Photoshop CS» перестаёт быть компромиссом. Это уже апгрейд. Потому что альтернатива — это либо ежемесячный квест с оплатой, либо лотерея с торрентами, либо GIMP, который всё ещё выглядит как программа из 1998 года.
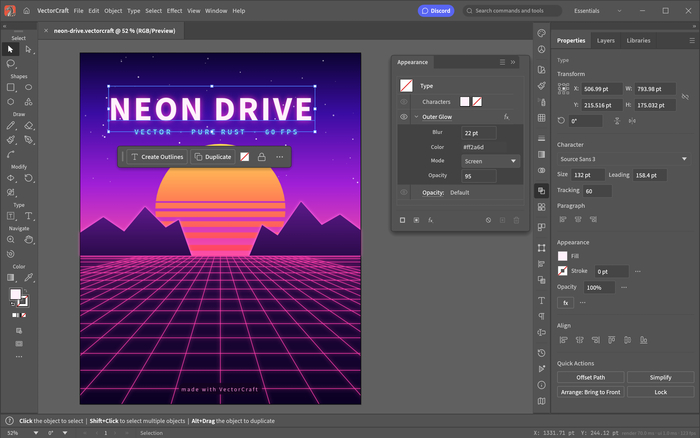
Vector illustration, reimagined in pure Rust — векторная графика, пути, опорные точки, кривые Безье, инструмент «Перо», Pathfinder, градиентные сетки, обводки. Не жди, что он откроет сложные AI-файлы — текущее позиционирование: «рисовать с нуля». Он заявляет, что рендерит 20 000 фигур за 27 миллисекунд при Retina-разрешении. Разработчики честно пишут: около 68–74% функций Illustrator уже работают, а «отличить от оригинала сможет примерно 40–55% опытных пользователей».
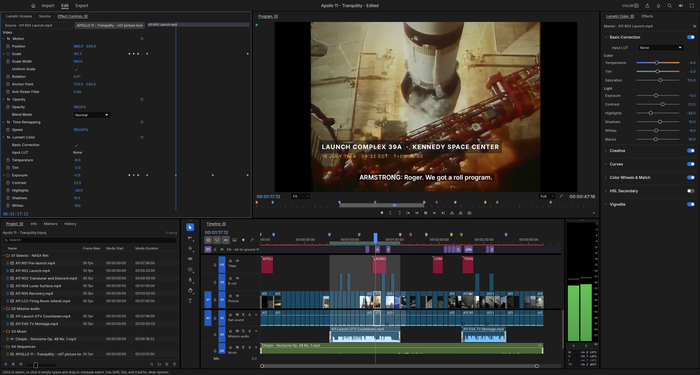
Professional video editing, rebuilt from scratch — видеомонтаж, таймлайн, дорожки, обрезка, трёхточечный монтаж, цветокоррекция через кривые, цветовые круги, HSL и LUT, HDR и Log-видео. Около 55 видеоэффектов, 30 переходов, ключевые кадры. Уникальная деталь: не полагается на FFmpeg, а реализует кодеки H.264, HEVC, ProRes, VP9, AAC и Opus самостоятельно. Разработчики честно оценивают готовность: примерно 45% на пути к Premiere Pro.
(изображение из README проекта на GitHub)
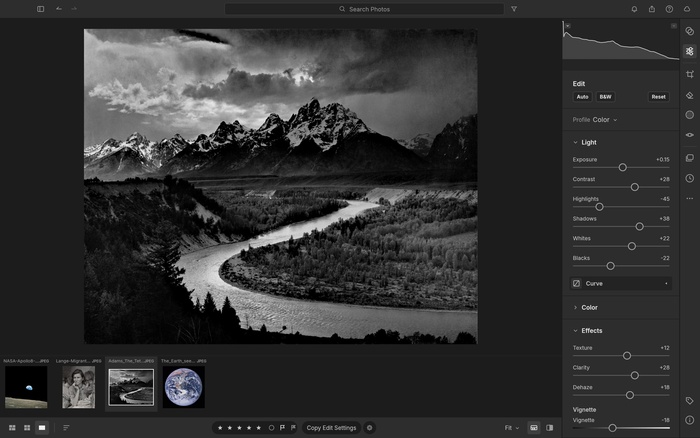
Your photos. Your pixels. Your machine — неразрушающее редактирование RAW-файлов, экспозиция, цвет, тональные кривые, 8-полосный цветовой микшер, трёхсторонняя цветокоррекция. Поддерживает DNG, CR2, ARW, NEF, RAF, RW2, PEF, ORF и другие форматы RAW через собственные Rust-декодеры. Разработчики честно оценивают: ~79% функций Lightroom присутствуют, но как «ежедневная замена» — около 60–70%. Главные пробелы: калибровка камеры для не-DNG файлов, AI-маски и шумоподавление.
(изображение из README проекта на GitHub)
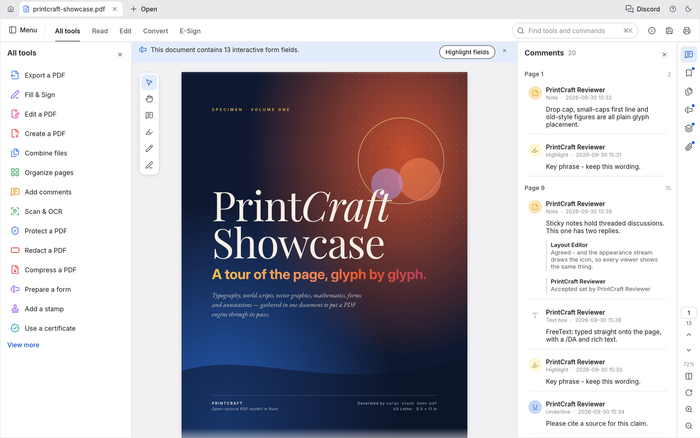
Разделить, объединить, сжать, поставить пароль, аннотировать, работать с формами. Тот инструмент, который Adobe должна была давать бесплатно. Логика PdfCraft проста: базовые операции с PDF — почему они должны быть платными? Он даже прошёл тест на 958 реальных PDF-файлах с открытием, редактированием и сохранением без сбоев. На данный момент — Early Alpha.
(изображение из README проекта на GitHub)
306 эффектов — все 298 из After Effects и даже больше. Моушн-графика, композитинг, 3D-слои, камеры, освещение, Puppet-инструменты, Render Queue, экспорт в Lottie. Технически самое сложное приложение во всём наборе, и оно, скорее всего, пока на очень ранней стадии. Если оно достигнет 10% возможностей AE — это уже будет чудом.
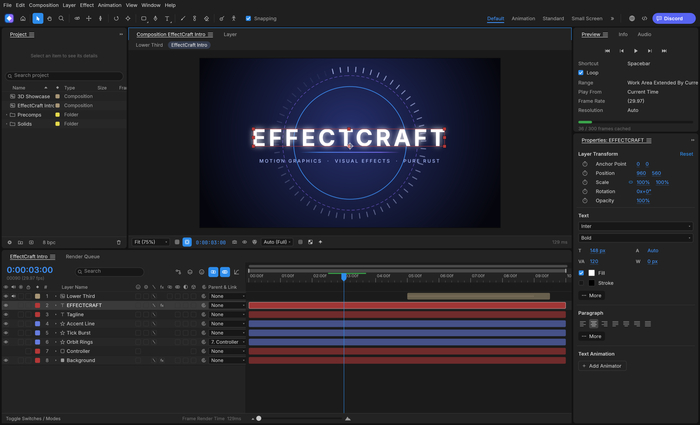
(изображение из README проекта на GitHub)
Page layout and publishing — вёрстка журналов, книг, многостраничных документов, работа с текстом, стилями, мастер-страницами, обтеканием. В этой области почти нет достойных открытых альтернатив. Scribus вроде есть, но опыт использования неописуемый. Если DesignCraft сможет достичь уровня «не вылетает» — он уже победил.
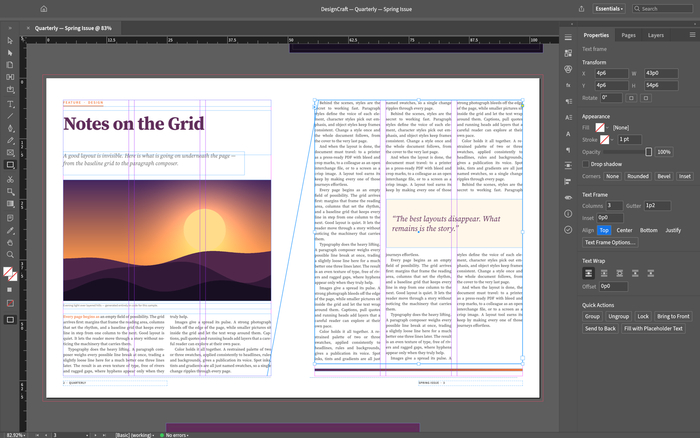
(изображение из README проекта на GitHub)
Ладно, допустим, ты не профессиональный ретушёр и не собираешься верстать обложку Vogue. Допустим, тебе от PhotoCraft нужно что-то простое. И вот тут всё становится на свои места.
Создать фотожабу или мем? Да, запросто. Вставил картинку, наложил текст, поиграл с размером и цветом — готово. Никто не отличит от «сделанного в Photoshop», потому что по сути это одно и то же.
Замазать прыщи на фото? Тоже хватит. Инструменты выделения, клонирование, размытие, корректирующие слои — базовый набор для бытовой ретуши на месте. Портрет для соцсетей, фото на документы, да хоть кота в шапку — всё это делается без бубна.
Убрать лишний объект со снимка, подправить горизонт, вытянуть тени? Пожалуйста. Именно для этого там есть слои, маски и цветокоррекция.
А вот чего не хватит? Профессиональной работы с текстом и шрифтами, плагинов, AI-функций вроде генеративного заполнения, сложного композитинга на 50 слоёв, ну и всего того, за что Adobe дерёт три шкуры.
Так что если твоя задача — «сделать смешную картинку для чата» или «привести в порядок фото для аватарки» — PhotoCraft уже сейчас справляется с этим на уровне «достаточно». А если тебе нужно верстать журнал или делать сложную рекламную графику — придётся подождать. Может, год. Может, два. Может, ребята допилят раньше, чем Adobe выпустит очередной платный апдейт.
Запомни главное: «неполная готовность» — это не приговор. Это просто честность. И если тебе нужно наклеить усы на фото кота — тебе абсолютно всё равно, что там не реализовано 20 инструментов и нет AI-генерации.
Технические решения ArtCraft интереснее его списка функций. Каждое решение этой команды выглядит как средний палец инженерной команде Adobe.
«Это написано на Rust» — теперь это символ веры
В сообществе Rust есть полушутливая поговорка: любое ПО должно быть переписано на Rust, включая твою микроволновку. Смешное в этой шутке то, что это правда. Энтузиазм Rust-разработчиков по поводу «переписать всё на Rust» сравним с заботой миссионера о язычниках.
Но если отбросить мемы, у Rust в области креативного ПО действительно есть реальное преимущество. Продукты Adobe массово используют C++, и отчёты Microsoft и Google указывают, что около 70% серьёзных уязвимостей связаны с проблемами безопасности памяти. Rust исключает эти ошибки на этапе компиляции. Когда ты обрабатываешь фотографии, видео и дизайн-файлы пользователя, «не упасть и не выполнить произвольный код из-за вредоносной картинки» — довольно убедительное преимущество. Особенно если ты годами качал «проверенные» сборки и каждый раз надеялся, что внутри нет сюрприза.
«Никакого Electron» — твоя оперативка кланяется в благодарность
Если ты одновременно держишь открытыми VS Code, Slack и Discord, твой компьютер уже кричит о помощи. Все три приложения сделаны на Electron, каждое упаковывает целый Chromium и жрёт больше 200 МБ памяти. ArtCraft пошёл другим путём: нативный скомпилированный Rust-бэкенд плюс системный WebView. Результат: приложения запускаются быстрее, потребление памяти может составлять десятую часть от Electron-приложений.
«Работает прямо в браузере» — дизайн на микроволновке становится реальностью
Благодаря технологии WebAssembly (WASM) часть приложений ArtCraft может работать прямо во вкладке браузера. Rust-модули, скомпилированные в WASM, компактны, эффективны в исполнении и полностью не зависят от сервера — твои файлы никогда не покидают твой компьютер. Ещё одна забавная деталь: у семи приложений есть общий дизайн — одна и та же команда может управляться из интерфейса, командной строки, JSON-канала управления или MCP-сервера (протокол, позволяющий AI-агентам вызывать внешние инструменты). PhotoCraft зарегистрировал более 500 команд. Весь набор с первого дня предполагает, что оператором может быть не человек.
Мультиплатформенность
Долгое время ситуация Linux-пользователя с Adobe выглядела так: не «не хочу», а «не могу».Adobe официально никогда не выпускала версию Photoshop для Linux, установщик Creative Cloud на Linux просто отказывается работать. Те, кто упорно занимался дизайном на Linux, либо держали виртуалку с Windows (и терпели падение производительности вдвое), либо использовали GIMP — а опыт GIMP, скажем так, замечательный, но его интерфейс выглядит так, будто его проектировали в 1998 году.
Конечно, были смельчаки. В начале 2026 года разработчик по имени PhialsBasement доработал слой совместимости Wine, и Photoshop 2021 и 2025 вдруг заработали на Linux. Технически — выдающееся достижение, но порог входа абсурдно высок: нужно вручную скомпилировать пропатченный Wine, а сама боль этого процесса примерно равна рисованию полноценной обложки журнала в GIMP.
А ArtCraft делает всё иначе. Семь приложений, нативная поддержка macOS, Windows и Linux. Не трансляция через Wine, не виртуалка — скомпилированные нативные бинарники. На Ubuntu запускается двойным щелчком, на Fedora тоже. А благодаря компиляции Rust в WebAssembly, большинство приложений ещё и работают прямо в браузере.
Что это значит? Это значит, что классическая насмешка — «на Linux даже Photoshop нет» — с сегодняшнего дня технически перестаёт быть правдой. Windows-пользователи, конечно, могут сказать: «У нас есть лицензионный Adobe, а у вас — open-source игрушка в alpha». Это пока ещё можно сказать. Но подумай: разница между alpha-версией с 50% функций и полным отсутствием инструмента гораздо больше, чем разница между «50%» и «100%». Есть и нет — это качественная разница.
Так что в следующий раз, когда Windows-пользователь скажет «ко-ко-ко», можешь спокойно ответить: «У меня на Linux нативные PhotoCraft, VectorCraft, FilmCraft. А у тебя — письмо от юристов Adobe».
Честно говоря: зависит от ситуации.
Если тебе прямо сейчас нужен инструмент, способный заменить Photoshop в продакшене, ArtCraft, вероятно, ещё не дотягивает. PhotoCraft — относительно самый зрелый, но большинство приложений набора всё ещё на ранних стадиях разработки или Alpha. Сам разработчик признаёт, что PhotoCraft реализует лишь 25–35% функционала, необходимого для замены Photoshop в ежедневной профессиональной работе.
Но если ты из тех, кто любит пробовать новое, или просто устал от вечной возни с оплатой, VPN и «проверенными» сборками — ArtCraft заслуживает внимания. Он представляет собой возможность: креативные инструменты не обязательно должны быть закрытыми, дорогими и раздутыми. Они могут быть управляемыми сообществом, построенными на современном языке и уважающими железо и кошелёк пользователя.
Эти ребята на Rust могут быть немного наивны. Они могут недооценивать барьеры тридцатилетних алгоритмов Adobe и совместимости форматов. Возможно, в итоге они сделают продукт, покрывающий лишь 60% потребностей.
Но 60% Photoshop, бесплатно, без карт, без аккаунтов, без блокировок, нативно на Linux — это чертовски больше, чем 0%. А если учесть, что десять лет назад «профессиональный Photoshop» умел примерно то же самое, что PhotoCraft сегодня, — перспектива становится ещё интереснее.
И вот тут возникает логичный вопрос: если эти ребята уже замахнулись на Adobe, почему бы не пойти дальше?
AutoCAD — это отдельная боль. Официальная подписка стоит как крыло от самолёта, для студентов и небольших мастерских — неподъёмно. В России ситуация ещё веселее: Autodesk ушла с рынка, официальные лицензии не купить, а «кряки» — та же лотерея, что и с Adobe, только ставки выше, потому что на кону не картинки, а реальные проекты, документация и производство. FreeCAD существует, но его интерфейс — это отдельный жанр психологического хоррора, а совместимость с DWG оставляет желать лучшего.
Так вот: если ты инженер, архитектор, конструктор или просто человек, которому нужен нормальный бесплатный CAD на Rust — напиши ребятам из ArtCraft. У них есть Discord, есть GitHub, есть Issues. Они уже доказали, что не боятся сложных задач. PhotoCraft — это Photoshop. FilmCraft — это Premiere. Почему бы не появиться CadCraft — DWG, параметрическое моделирование, 2D-чертежи, 3D-тела, всё как у взрослых, но бесплатно и с открытым кодом?
Конечно, CAD — это в разы сложнее, чем даже EffectCraft. Тридцатилетние форматы, математика поверхностей, огромные экосистемы плагинов. Но если кто-то и способен хотя бы попробовать — это команда, которая уже переписала на Rust половину Creative Cloud.
Не стесняйся. Напиши им. Хуже не будет. А вдруг — получится?
Рекомендуемый маршрут действий: загляни на getartcraft.com, присоединись к их Discord, открой Issue или поставь Star на GitHub. Даже если ты сейчас не пользуешься — дать этим людям знать, что за ними наблюдают, уже поддержка. А если тебе нужен AutoCAD — так и напиши: «Ребята, а слабо?» Кто знает, может, через год мы будем читать обзор на CadCraft и вспоминать, как всё начиналось с бесплатного Photoshop без лотереи с «кряками».
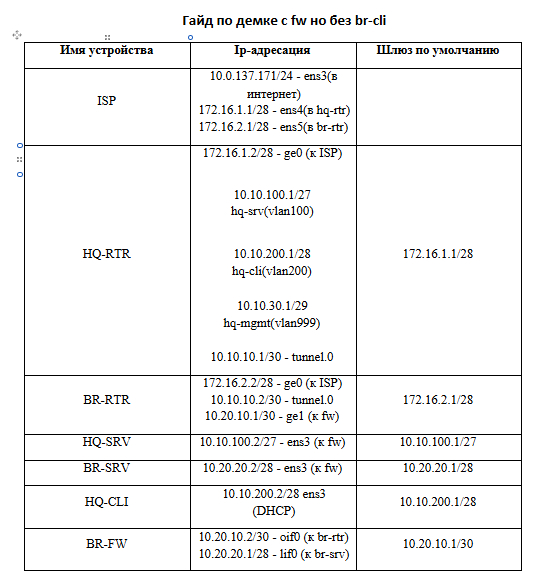
Задание 1: Базовая настройка устройств (настройка имен)
hostnamectl set-hostname isp.au-team.irpo; exec bash
mcedit /etc/sysconfig/network
HOSTNAME=isp.au-team.irpo
Задание 2: На ISP настройте динамическую сетевую трансляцию портов для доступа к сети Интернет HQ-RTR и BR-RTR.
apt-get update
apt-get install iptables
iptables -t nat -A POSTROUTING -s 172.16.1.0/28 -o ens3 -j MASQUERADE
iptables -t nat -A POSTROUTING -s 172.16.2.0/28 -o ens3 -j MASQUERADE
iptables-save > /etc/sysconfig/iptables
systemctl enable --now iptables.service
Задание 1: Базовая настройка устройств (настройка имен)
hostname hq-rtr
ip domain-name au-team.irpo
Задание 2: Настройте адресацию на интерфейсах(настроено все кроме):
ip route 0.0.0.0/0 172.16.1.1
Задание 3: Создайте пользователя netadmin на маршрутизаторах HQ-RTR и BR-RTR
(По преднастройке он уже может быть настроен)
Проверка настроен ли netadmin
При входе login: net_admin пароль: P@ssw0rd
После зайти через admin и посмотреть права через show users localdb
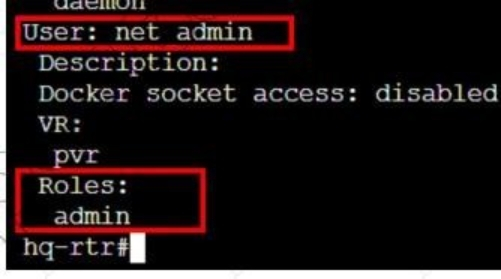
Если такого нет то:
hq-rtr(config)#username net_admin
hq-rtr(config-user)#password P@ssw0rd
hq-rtr(config-user)#role admin
hq-rtr(config-user)#exit
hq-rtr(config)#write memory
Я не нашел в каком модуле эта команда нужна, но она нужна
ip name-server 10.10.100.2
Задание 6: Между офисами HQ и BR на маршрутизаторах HQ-RTR и BR-RTR необходимо сконфигурировать IP-туннель: на выбор технологии GRE или IP in IP
GRE:
interface tunnel.0
ip address 10.10.10.1/30
ip tunnel 172.16.1.2 172.16.2.2 mode gre
Задание 7: Обеспечьте динамическую маршрутизацию на маршрутизаторах HQ-RTR и BR-RTR: сети одного офиса должны быть доступны из другого офиса и наоборот. Для обеспечения динамической маршрутизации используйте link state протокол
OSPF:
router ospf 1
ospf router-id 10.10.10.1
passive-interface default
no passive-interface tunnel.0
network 10.10.10.0/30 area 0
network 10.10.100.0/27 area 0
network 10.10.200.0/28 area 0
network 10.10.30.0/29 area 0
exit
interface tunnel.0
ip ospf authentication message-digest
ip ospf message-digest-key 1 md5 P@ssw0rd
Задание 8: Настройка динамической трансляции адресов на маршрутизаторах HQ-RTR и BR-RTR
NAT:
interface isp
ip nat outside
interface vl100
ip nat inside
interface vl200
ip nat inside
interface vl999
ip nat inside
exit
ip nat pool VLAN100 10.10.100.1-10.10.100.30
ip nat pool VLAN200 10.10.200.1-10.10.200.14
ip nat pool VLAN999 10.10.30.1-10.10.30.6
ip nat source dynamic inside-to-outside pool VLAN100 overload interface isp
ip nat source dynamic inside-to-outside pool VLAN200 overload interface isp
ip nat source dynamic inside-to-outside pool VLAN999 overload interface isp
write memory
Задание 11: Настройте часовой пояс на всех устройствах (за исключением виртуального коммутатора, в случае его использования) согласно месту проведения экзамена.
ntp timezone utc+3
Задание 1: Базовая настройка устройств (настройка имен)
hostname br-rtr
ip domain-name au-team.irpo
Я не нашел в каком модуле эта команда нужна, но она нужна
ip name-server 10.10.100.2
Задание 2: Настройте адресацию на интерфейсах(настроено все кроме):
ip route 0.0.0.0/0 172.16.2.1
Задание 6: Между офисами HQ и BR на маршрутизаторах
HQ-RTR и BR-RTR необходимо сконфигурировать IP-туннель: на выбор технологии GRE или IP in IP
GRE:
interface tunnel.0
ip address 10.10.10.2/30
ip tunnel 172.16.2.2 172.16.1.2 mode gre
Задание 7: Обеспечьте динамическую маршрутизацию на маршрутизаторах HQ-RTR и BR-RTR: сети одного офиса должны быть доступны из другого офиса и наоборот. Для обеспечения динамической маршрутизации используйте link
state протокол
OSPF:
router ospf 1
ospf router-id 10.10.10.2
passive-interface default
no passive-interface tunnel.0
no passive-interface fw
network 10.10.10.0/30 area 0
network 10.20.10.0/30 area 0
exit
interface tunnel.0
ip ospf authentication message-digest
ip ospf message-digest-key 1 md5 P@ssw0rd
interface fw
ip ospf authentication message-digest
ip ospf message-digest-key 1 md5 P@ssw0rd
Задание 8: Настройка динамической трансляции адресов на маршрутизаторах HQ-RTR и BR-RTR
NAT:
interface isp
ip nat outside
exit
interface fw
ip nat inside
ip nat pool RTR-FW 10.20.10.1-10.20.10.2
ip nat source dynamic inside-to-outside pool RTR-FW overload interface isp
Задание 11: Настройте часовой пояс на всех устройствах (за исключением виртуального коммутатора, в случае его использования) согласно месту проведения экзамена.
ntp timezone utc+3
Задание 1: Базовая настройка устройств (настройка имен)
hostnamectl set-hostname hq-srv.au-team.irpo; exec bash
mcedit /etc/sysconfig/network
HOSTNAME=hq-srv.au-team.irpo
Задание 1.2: На всех устройствах необходимо сконфигурировать IPv4
echo “10.10.100.2/27” > /etc/net/ifaces/ens3/ipv4address
echo “default via 10.10.100.1” > /etc/net/ifaces/ens3/ipv4route
echo "nameserver 10.10.100.2" > /etc/net/ifaces/ens3/resolv.conf
echo "nameserver 77.88.8.8" >> /etc/net/ifaces/ens3/resolv.conf
systemctl restart network
Задание 3: Создайте локальные учетные записи sshuser на серверах HQ-SRV и BR-SRV:
(По преднастройке он уже может быть настроен)
Проверка настроен ли sshuser:
При запуске login: sshuser пароль: P@ssw0rd
Далее вводим id и смторим uid(должен быть 2026) и пробуем написать sudo –i(если дало дайти без пароля значит он настроен)
Если не настроен то:
useradd sshuser –u 2026
usermod -aG wheel sshuser
echo «sshuser ALL=(ALL:ALL) NOPASSWD: ALL» >> /etc/sudoers
Задание 5: Настройте безопасный удаленный доступ на серверах HQ-SRV и BR-SRV:
mcedit /etc/openssh/sshd_config
-Port 2026 или 2027
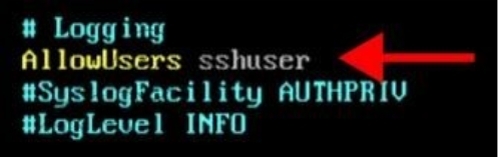
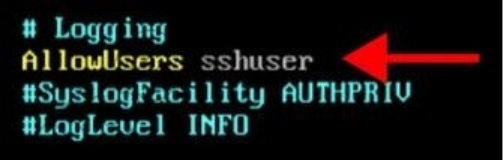
-далее где #Logging надо добавить строчку: AllowUsers sshuser
-MaxAuthTries 2
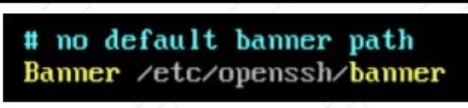
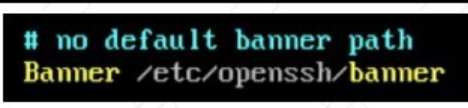
-Banner /etc/openssh/banner
echo "Authorized access only" > /etc/openssh/banner
systemctl restart sshd
Задание 10: Настройте инфраструктуру разрешения доменных имён для офисов HQ и BR:
mcedit /etc/bind/options.conf
mcedit /etc/bind/options.conf
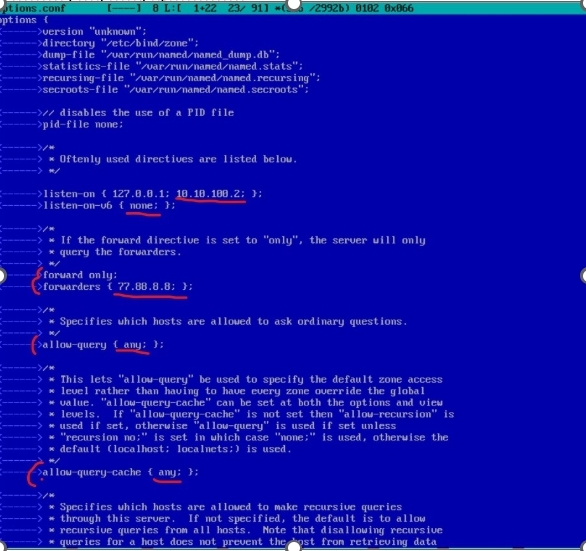
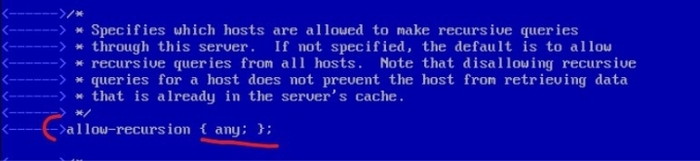
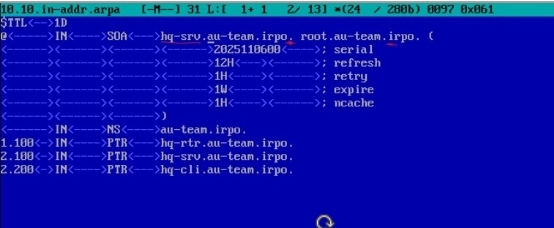
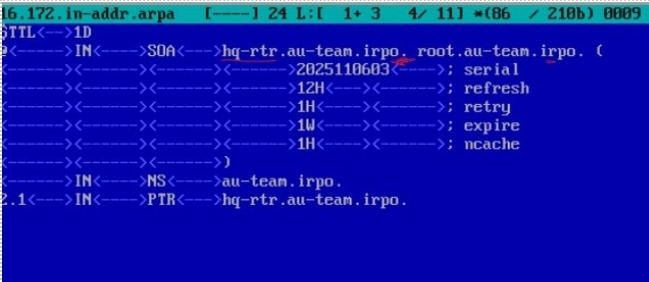
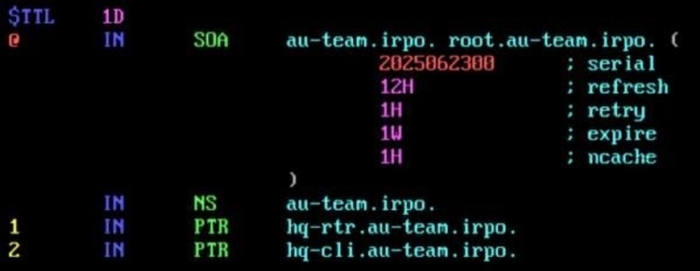
Следующие два файла почти идентичные, смотрите только верхнюю часть (поменять красные части как на скрине)
mcedit /etc/bind/zone/10.10.in-addr.arpa
mcedit /etc/bind/zone/16.172.in-addr.arpa
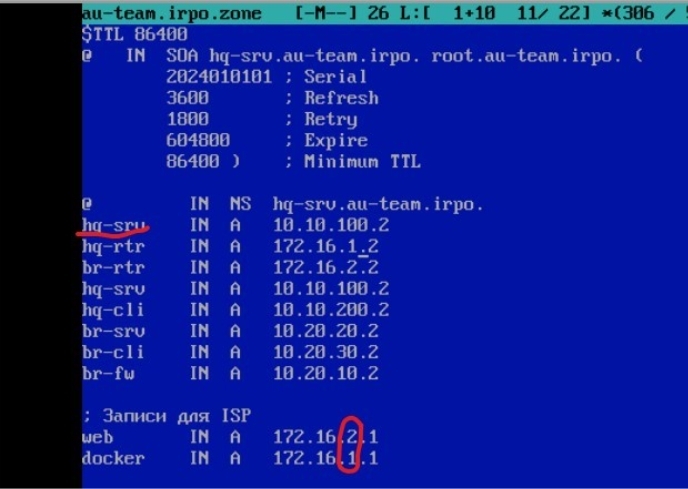
mcedit /etc/bind/zone/au-team.irpo.zone
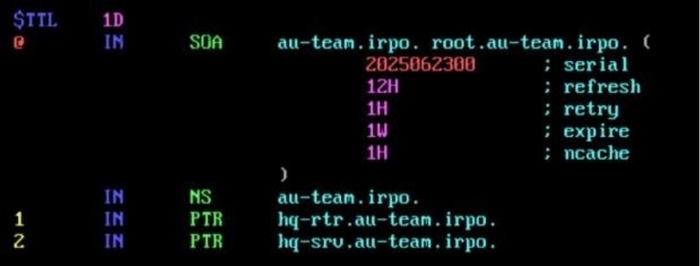
cp /var/lib/bind/etc/zone/empty /var/lib/bind/etc/zone/100.10.10.in-addr.arpa
mcedit /var/lib/bind/etc/zone/100.10.10.in-addr.arpa
cp /var/lib/bind/etc/zone/empty /var/lib/bind/etc/zone/200. 10.10.in-addr.arpa
mcedit /var/lib/bind/etc/zone/200.10.10.in-addr.arpa
systemctl enable --now bind.service
Задание 1.1: Базовая настройка устройств (настройка имен)
hostnamectl set-hostname br-srv.au-team.irpo; exec bash
mcedit /etc/sysconfig/network
HOSTNAME=br-srv.au-team.irpo
Задание 1.2: На всех устройствах необходимо сконфигурировать IPv4
echo “10.20.20.2/28” > /etc/net/ifaces/ens3/ipv4address
echo “default via 10.20.20.1” > /etc/net/ifaces/ens3/ipv4route
echo "nameserver 10.10.100.2" > /etc/net/ifaces/ens3/resolv.conf
echo "nameserver 77.88.8.8" >> /etc/net/ifaces/ens3/resolv.conf
systemctl restart network
Задание 3: Создайте локальные учетные записи sshuser на серверах HQ-SRV и BR-SRV:
(По преднастройке он уже может быть настроен)
Проверка настроен ли sshuser:
При запуске login: sshuser пароль: P@ssw0rd
Далее вводим id и смторим uid(должен быть 2026) и пробуем написать sudo –i(если дало дайти без пароля значит он настроен)
Если не настроен то:
useradd sshuser –u 2026 usermod -aG wheel sshuser
echo «sshuser ALL=(ALL:ALL) NOPASSWD: ALL» >> /etc/sudoers
Задание 5: Настройте безопасный удаленный доступ на серверах HQ-SRV и BR-SRV:
mcedit /etc/openssh/sshd_config
-Port 2026 или 2027
-далее где #Logging надо добавить строчку: AllowUsers sshuser
-MaxAuthTries 2
-Banner /etc/openssh/banner
echo "Authorized access only" > /etc/openssh/banner
systemctl restart sshd
Задание 1: Базовая настройка устройств (настройка имен)
su –
hostnamectl set-hostname hq-cli.au-team.irpo; exec bash
mcedit /etc/sysconfig/network
HOSTNAME=hq-cli.au-team.irpo
Задание 1: Базовая настройка устройств (настройка имен)
hostnamectl set-hostname hq-srw; exec bash mcedit /etc/sysconfig/network
HOSTNAME=hq-sw.au-team.irpo
Задание 4: Настройка коммутации в сегменте HQ
ovs-vsctl show
Дропы на Twitch вроде бы бесплатные, но ради них надо часами держать открытым стрим, не забыть нажать «Получить» и ещё следить, какая кампания закончится раньше. Я регулярно что-то пропускал, и награды сгорали.
Для этого есть программа TwitchDropsMiner от DevilXD. Она работает, но порядок игр в ней нужно выставлять руками, по окну трудно понять, что происходит, а ставить и обновлять её приходится с GitHub.
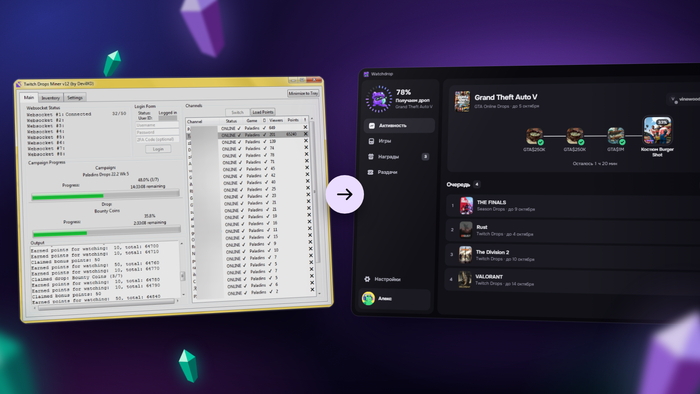
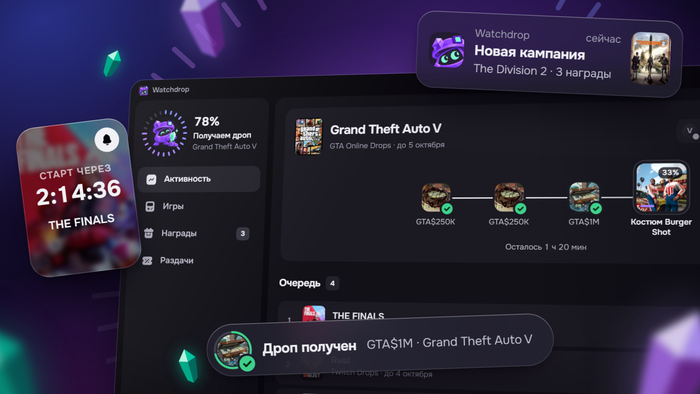
Я начал доделывать её под себя и через месяц с лишним получил отдельное приложение. Назвал WATCHDROP.
Что оно делает:
смотрит стримы в фоне и само забирает награды. Видео не скачивается, компьютер и интернет свободны
само решает, что смотреть: сначала то, что скоро закончится, потом избранные игры
меняет канал, если стример ушёл в офлайн или прогресс перестал идти
встаёт на паузу, пока вы играете
показывает бесплатные раздачи из Epic Games Store, Steam и GOG
пишет о наградах в уведомлениях Windows или в Discord
Приложение бесплатное, без подписок и платных функций. Работает на Windows 10 и 11.
Про риск. Правила Twitch ограничивают автоматизацию, так что заблокировать аккаунт могут, и обещать обратное я не буду. Приложение смотрит один стрим на аккаунт, как обычный зритель, и ничего не накручивает. Пароль оно не видит: вход идёт на сайте Twitch.
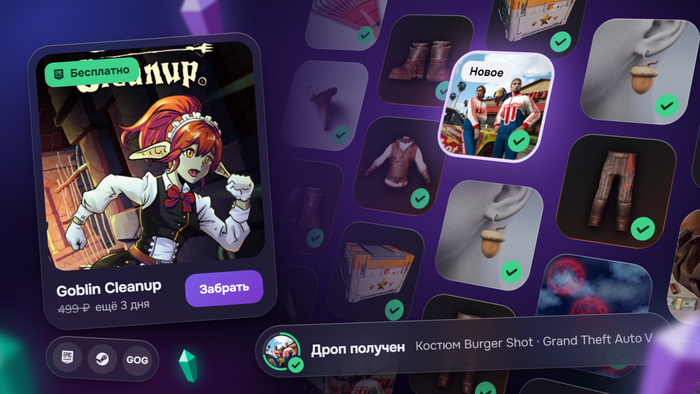
Это версия 1.0, и мне нужны люди, которые её сломают. Поставьте, оставьте на пару дней и напишите в комментариях, что не так и чего не хватает.
Скачать: watchdrop.cc
Discord: watchdrop.cc/discord
Спасибо DevilXD за исходную программу TwitchDropsMiner.
Всем здравствуйте! Нарыл тут запечатанный диск Windows Millenium с книжечкой и лицензионным ключом. Знающие люди, подскажите пожалуйста где такой можно продать? На Авито особо таких нет. Может, есть какие-нибудь форумы коллекционеров подобных раритетов?
Хочу показать свой проект - FoxGram. Это независимый клиент Telegram для Android на основе открытого кода Telegram, NagramXF и AyuGram.
Мне хотелось собрать в одном приложении функции, ради которых многие пользуются сторонними клиентами, добавить собственное оформление и развивать проект дальше.
Что уже есть
- Архив удалённых сообщений, которые приложение успело получить.
- История редактирования: можно посмотреть предыдущий текст сообщения.
- Режим призрака с настройками отметок прочтения и сигналов активности.
- Фоновая служба для получения сообщений.
- Поддержка плагинов, свои иконки и проверка обновлений FoxGram.
Сразу о границах возможностей: приложение не умеет доставать сообщения, которые вообще не пришли на устройство. Если телефон был без сети или Android остановил клиент, мгновенно удалённое сообщение может не сохраниться.
На какой стадии проект
Сейчас доступна тестовая сборка для Android 8.1+ с системой ARM64. Проверены шифрование архивов, очистка и серверные механизмы. Большой проверки на разных физических устройствах пока не было.
Буду рад отзывам, особенно от владельцев Samsung, Xiaomi и других моделей. Если найдёте ошибку, напишите модель телефона, версию Android и шаги, после которых она появилась. Личную переписку присылать не нужно.
Скачать APK, посмотреть возможности и исходники:
https://c0dy.beer/foxgram/
Проект не связан с командой Telegram. Спасибо авторам открытых проектов, на которых он основан.
У меня RX 7900 XT с 20 ГБ памяти. Решил разобраться, какую большую языковую модель на ней можно нормально использовать. Не просто запустить, получить «привет» и обрадоваться, а дать ей много текста, поработать с файлами и посмотреть, как быстро она будет отвечать.
Для ЛЛ: Qwen3.8 27B на RX 7900 XT работает вполне бодро: мой рабочий вариант держит окно в 131 тысячу токенов и выдаёт около 29 ток/с на почти заполненном контексте с включёнными рассуждениями. Начал с вопроса «что потянет моя карта», закончил 54 крупными этапами тестов.
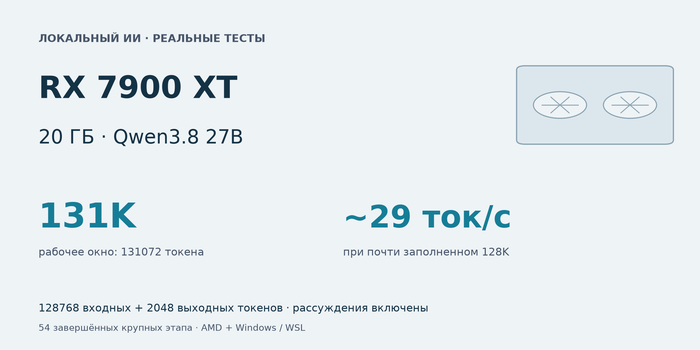
Вот главный результат, чтобы сразу было понятно, ради чего весь длиннопост: 128768 токенов на входе, ещё 2048 на выходе, скорость 29,38 ток/с. Всё это в окне 131072. Контекст действительно заполнялся во время работы, а не существовал только в настройках сервера.
Если слово «токен» ни о чём не говорит, это кусочек текста, с которым работает модель. Контекст задаёт, сколько такого текста она может держать одновременно. Считать в страницах неудобно: русский текст, английский и код дают разное количество токенов.
Мне эта история нужна была для Hermes, локального агента с инструментами. Хочется загрузить большую историю, поручить прочитать файл и продолжить работу. Поэтому условные 60 токенов в секунду на вопросе про борщ меня устраивали только как начало проверки.
Я не занимаюсь исследованиями LLM профессионально. Разбирался для себя. Результатов накопилось столько, что решил собрать их здесь: владельцу такой же карты пригодится, а желающему купить её будет на что посмотреть, кроме объёма памяти на коробке.
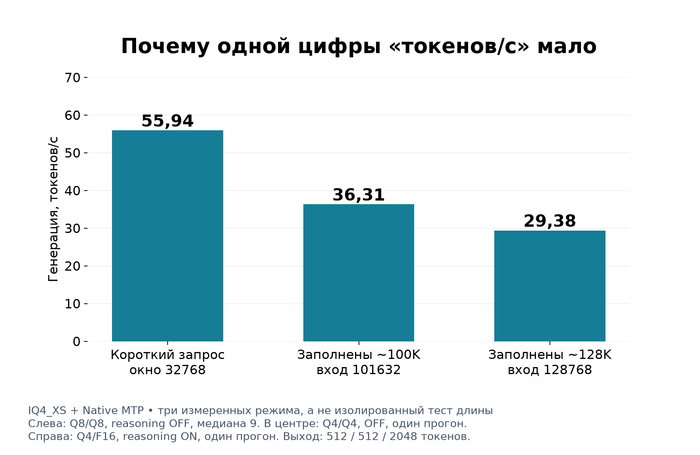
Если посмотреть только на скорость, на одной и той же карте получилось три довольно разных результата:
Короткие запросы: 50-60 ток/с с ускорением, в некоторых конфигурациях больше 60.
Заполненные примерно 100K: 36-37 ток/с с ускорением.
Финальный почти заполненный 128K с рассуждениями: около 29 ток/с.
Условия здесь разные, включая кэш и рассуждения. Это не чистый эксперимент только с длиной текста. Но для повседневного использования разница принципиальная: увидел в интернете «60 токенов/с», отправил модели большую историю, получил другую скорость. Карта при этом не сломалась.
Мой компьютер: RX 7900 XT 20 GiB, Ryzen 5 7500F, 32 ГБ RAM. Windows, WSL с Ubuntu 24.04, ROCm 7.2, gfx1100. Модель запускал через отдельную HIP-сборку llama.cpp с поддержкой MTP и Fast MTP.
Все результаты ниже про одну текстовую модель и один одновременный запрос. Картинки, видео и обслуживание нескольких пользователей здесь не проверял.
Исходной точкой была уже установленная модель в Ollama, qwen3.8-27b-abliterated:112k. На коротком входе и окне 32768 она давала медиану 31,30 ток/с по девяти прогонам.
Потом взял HauhauCS Qwen3.8-27B-Uncensored-HauhauCS-Aggressive и пошёл перебирать варианты. Сразу оговорка: старая Huihui и новая Hauhau имеют разные модификации весов, движки тоже разные. Сравнивать их как «одно и то же, но теперь вдвое быстрее» нельзя. Поэтому дальше plain, Native и Fast сравниваются на одинаковых основных весах Hauhau.
Веса проверял в трёх квантовках: IQ3_M, IQ4_XS и Q4_K_P. Квантовка сжимает числа, которыми записана модель. Она позволяет уменьшить файл и расход памяти, но может повлиять на качество и скорость. Причём меньший файл вовсе не обязан работать быстрее.
Память контекста тоже проверял в трёх вариантах: F16, Q8_0 и Q4_0. К этому добавились три режима генерации, переносы в оперативку, тесты качества, русские запросы, полностью заполненные окна и поиск границ VRAM. А под конец ещё и настоящий агент с инструментом.
Первый бенчмарк запустился 4 октября 2026 года в 10:28 UTC, последние GPU-тесты закончились 5 октября в 14:36 UTC. Между ними примерно 28 часов 8 минут, включая паузу: компьютером я всё-таки ещё и пользуюсь. Итоговый отчёт сформирован в 14:43 UTC.
Если считать отдельно, три автоматизированные матрицы заняли около 15 часов 22 минут. Туда входят загрузки серверов и неудачная попытка, которую пришлось исправить и повторить. Финальные проверки профилей и установленного Hermes были дополнительно. Сумма сохранённых длительностей самих измерительных запросов составляет примерно 10 часов 59 минут. Это неполный учёт: без загрузок модели, отдельных процессов perplexity и запросов, у которых такое поле не сохранилось. Называть его временем непрерывной работы GPU было бы неправильно.
В итоге 54 завершённых крупных этапа. В какой-то момент простой вопрос про свою видеокарту оброс собственным архивом JSON: команды запуска, память, timings, ответы и хеши. Неудачи из архива тоже не вычищал. Один этап, например, пришлось повторить из-за сборщика результатов: модель уже ответила, а чтение дописываемого лога упало. Исправил сборщик, сохранил обе попытки.
Без ускорения модель генерирует в обычном режиме, который в результатах обозначен как plain. MTP предлагает черновиком несколько следующих токенов, которые проверяет основная модель. Когда черновик подходит, генерация идёт быстрее. В Native работает встроенный модуль модели, в Fast используется отдельный облегчённый ускоритель.
Мне было интересно, сколько это даёт на практике. Вот короткие запросы с настроенным окном 32768, которое при этом не заполнено. Основной и черновой кэш Q8_0, рассуждения выключены. Для каждого режима взял медиану девяти прогонов по 512 выходных токенов.
Самый интересный для меня вариант, IQ4_XS, без ускорения выдавал 32,25 ток/с. Включил Native MTP, получил 55,94. С Fast MTP получилось 57,88. То есть ответ пишется почти вдвое быстрее, при тех же основных весах.
Более компактный IQ3_M показал 26,39 ток/с без ускорения, 46,30 с Native и 46,79 с Fast. У Q4_K_P получилось соответственно 28,78, 40,42 и 44,05. В этих условиях IQ4_XS оказался быстрее обоих.
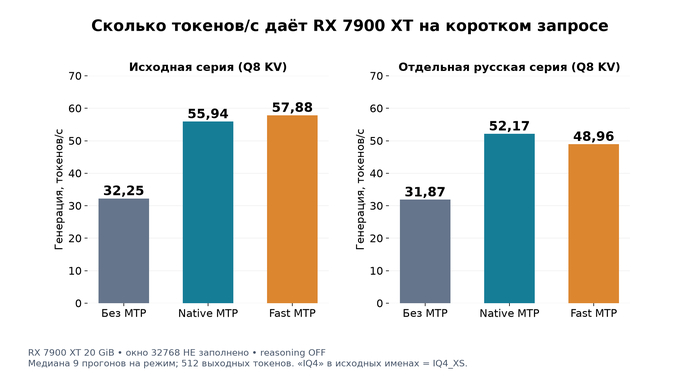
На графике это проще сравнить: чем выше столбик, тем быстрее модель пишет ответ. В части исходных файлов IQ4_XS подписан как «IQ4». Проверил команды и имя модели: это именно IQ4_XS, ещё одного кванта за сокращением не прячется.
Если поставить F16-кэш, Fast на IQ4_XS дал медиану 61,61 ток/с, в отдельном прогоне было 62,98. С Q4-кэшем медиана Fast составила 58,28. Это отдельные конфигурации: результат на F16 нельзя выдавать за скорость с Q8.
Пока выглядит так, будто Fast можно выбрать по названию. Но я отдельно повторил серию с явно русскоязычными ответами. Получилось 31,87 plain, 52,17 Native и 48,96 Fast, снова по девять прогонов. В первой серии часть ответов могла быть английской, а пользоваться моделью я собираюсь преимущественно на русском.
Так что название ускорителя за нас задачу не решает. На одних запросах выигрывал Fast, в моей повторной русской серии быстрее оказался Native. И процент принятых черновых токенов говорит о работе ускорителя, а не об уме модели. Качество я проверял отдельно.
Память под уже прочитанный текст называют KV-кэшем. Она занимает видеопамять вместе с самой моделью, и её тоже можно сжимать. F16, Q8 и Q4 в этих тестах относятся именно к такому сжатию. У ускорителя есть ещё свой draft-кэш.
Мне нужно было хотя бы 100 тысяч токенов. Поэтому проверка «сервер загрузился с большим окном» не подходила. Нужно заполнить это окно и заставить модель продолжать отвечать.
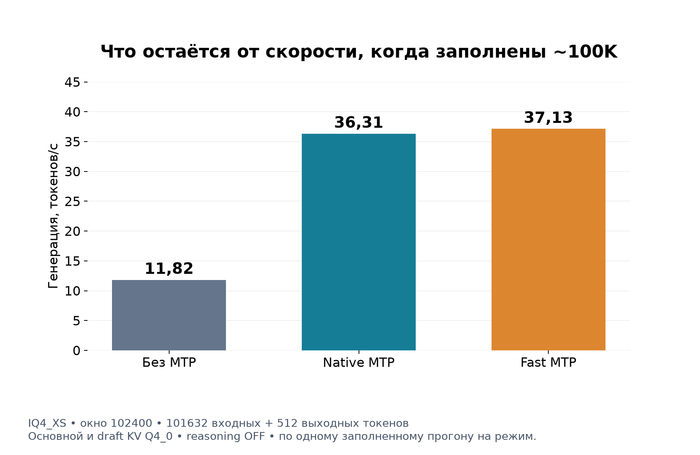
Для одинакового сравнения IQ4_XS взял окно 102400, подал 101632 входных токена и получил 512 выходных. Основной и draft-кэш Q4_0, рассуждения выключены. Тут по одному длинному прогону на режим.
Без ускорения модель писала ответ со скоростью 11,82 ток/с. С Native получилось 36,31, с Fast 37,13 ток/с.
Первоначальная обработка отправленного текста заняла примерно 7 минут 53 секунды без ускорения, 8 минут 6 секунд с Native и 8 минут 10 секунд с Fast.
Вот уже результат, ради которого стоило возиться. На заполненных ~100K ускорение получилось примерно трёхкратным относительно обычного режима. Основные веса при этом те же.
Пользователю это выглядит так: отправил огромный текст, модель около восьми минут его обрабатывает, затем пишет ответ со скоростью 36-37 токенов/с. Ускорение заметно помогает именно написанию ответа. Первое знакомство с большим текстом всё равно занимает время. Дальше проверю, придётся ли ждать эти минуты снова после каждого действия агента.
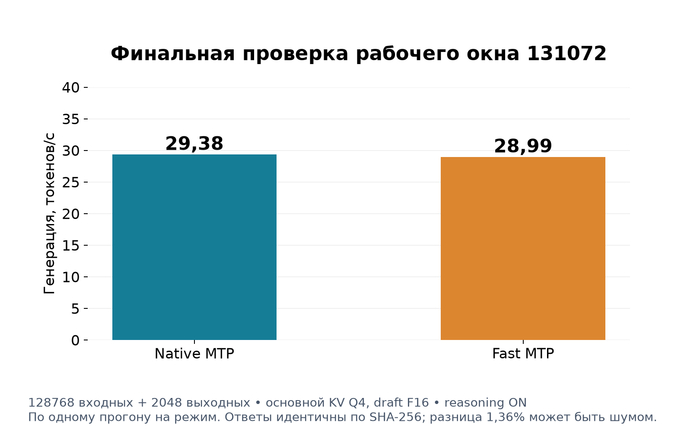
Финальный профиль проверял отдельно: включил рассуждения, оставил основной кэш Q4_0, а черновой сделал F16. Окно 131072, вход 128768, выход 2048.
На таком заполнении Native дал 29,38 ток/с, Fast 28,99 ток/с. Обработка огромного входа перед генерацией заняла примерно 11 минут 47 секунд у Native и 11 минут 57 секунд у Fast.
Ответы в этой паре совпали по SHA-256. Оба режима прошли извлечение контрольных значений и проверку размещения в VRAM.
Здесь два уточнения, без которых цифра слишком красивая. Первое: скорость включает рассуждения, а не только видимый пользователю ответ. Второе: первоначальное чтение входа заняло почти 12 минут. Это вполне рабочая скорость продолжения, но длинную историю сначала надо обработать.
И ещё про обозначения: 131072 это 128K, если K считать по 1024, или примерно 131 тысяча в десятичной записи. Точные границы дальше пишу числами, иначе можно случайно выиграть пару тысяч токенов одним округлением.
В этой паре Native быстрее на 1,36%. Одного прогона недостаточно, чтобы объявить его победителем вообще: такую разницу легко получить из-за шума. Для себя выбрал Native ещё и потому, что он оказался быстрее в повторной русской серии. Fast оставил отдельным профилем, он тоже работает.
Следующий вопрос уже про предел памяти. Искал его с оглядкой на расход VRAM: смотрел, сколько памяти добавляется на токен и сколько осталось, после чего делал крупный скачок. Возле края уточнял границу до 2048 токенов. Идти всю дорогу по 2K было бы слишком долго.
В матричных проверках отправлял окно минус 768 токенов, затем генерировал ещё 512. В начале, середине и конце текста размещал контрольные значения. Так проверял и память во время работы, и извлечение из длинного входа.
После очистки фона у IQ4_XS получились такие подтверждённые заполненные окна. Вычисляемые блоки и выходная голова модели на GPU, входная статическая таблица в RAM.
С Native и Q4 в обоих кэшах удалось заполнить окно 153600 токенов. Скорость на этом заполнении составила 25,09 ток/с. С Fast, основным кэшем Q4 и черновым F16 дошёл до 161792 при 28,65 ток/с.
Без ускорения получилось уместить ещё больше, но отвечала модель гораздо медленнее. Поэтому на графике пределов рядом с размером окна подписал скорость: самый длинный столбик здесь не означает лучший вариант для чата.
Для тех, кто выбирает кэш Q8: с ним Native подтвердил окно 98304 при 31,95 ток/с, Fast окно 100352 при 30,08 ток/с. В обоих предельных вариантах Fast неиспользуемый блок основной модели был оставлен в оперативке. Сам ускоритель и работающие вычислительные блоки оставались на видеокарте.
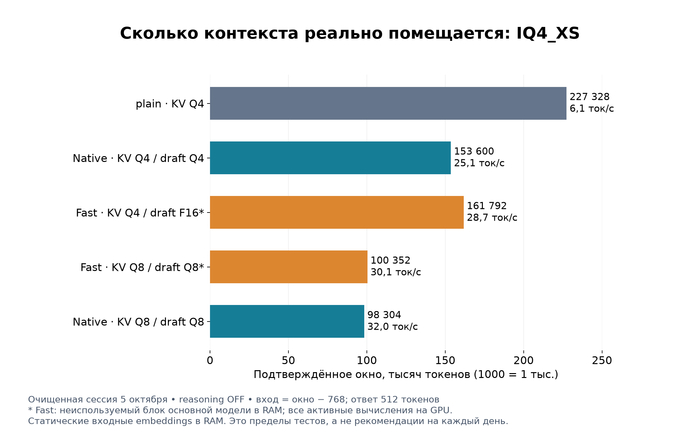
Самая занятная граница у Fast Q4/F16: 161792 прошли, 163840 уже не прошли проверку размещения. На успешном запуске свободными оставались примерно 68 MiB VRAM. В RAM был перенесён неиспользуемый MTP-блок основной модели; работающий отдельный ускоритель остался на GPU.
Результат интересный. Пользоваться каждый день с таким запасом мне не хочется: почти вся память занята, а компьютер всё-таки не выделенный стенд. Поэтому оставил окно 131072. После длинного Hermes-теста Native в той сессии оставалось около 740 MiB. За фоном всё равно надо следить, но запас уже приятнее.
Обычный режим смог уместить ещё больше: 227328, из них 226560 токенов фактического входа. Только генерация на этом заполнении упала до 6,06 ток/с, а чтение входа заняло 25 минут 48 секунд. Поэтому выбирать модель по самому большому числу ctx я бы не стал.
Другие кванты тоже доходили до своего края. В более ранней сессии IQ3_M с Fast и Q4 выдержал 223232 при 17,00 ток/с, с Q8 получил 139264 при 25,43 ток/с. Q4_K_P с Fast подтвердил 53248 на Q4, 43008 на Q8 и 18432 на F16. Эти пределы относятся к прежнему фону VRAM. После закрытия браузеров и Steam выдавать их за новые максимумы чистой сессии нельзя.
F16 меня тоже не спас от всех проблем. IQ4_XS с Fast в повторной очищенной проверке прошёл заполненные 57344 при 50,96 ток/с. Это проверенная точка, новый максимум там не искал. А IQ3_M на заполненных 102400 с F16 потребовал два вычисляемых блока на CPU и дал 18,77 ток/с. Бывали варианты, которые загружались, но заполнение уже не выдерживали.
Для моих 100K+ сжатие основного кэша оказалось очень полезным. Но само по себе Q4 не обещает ускорения. Его приходится подбирать вместе с весами и MTP.
Поначалу я хотел держать на GPU буквально всё. Потом проверил входную embedding table. Это статическая таблица, по которой токены получают числовое представление перед дальнейшими вычислениями.
Сравнил её размещение на одинаковом запросе: IQ4_XS без MTP, Q4-кэш, 101632 входных и 512 выходных токенов. Таблица в RAM дала 11,32 ток/с, принудительно на GPU получилось 11,19 ток/с. Ответ одинаковый по SHA-256, а GPU-вариант потребовал ещё примерно 682 MiB VRAM.
В этой паре пользы от переноса на GPU не увидел. Таблицу оставил в оперативке, вычисляемые блоки и выходную голову на видеокарте. Это один контролируемый опыт, а не обещание, что таблица в RAM никогда ничего не стоит.
С активно вычисляемыми блоками совсем другая история. Если перенести их на CPU, оперативка поможет вместить модель, но процессору придётся участвовать в генерации. Проверил это с Fast MTP и Q8-кэшем на заполненном контексте.
У IQ4_XS при окне 102400 один блок пришлось считать на процессоре. Получилось 23,77 ток/с, ещё вполне живая скорость. Для окна 131072 таких блоков понадобилось уже девять. Отправленный текст обрабатывался почти 33 минуты, а ответ пошёл со скоростью 2,16 ток/с. Можно спокойно поставить чайник. Потом ещё раз.
У Q4_K_P картина похожая: при окне 102400 и десяти блоках на процессоре получил 2,47 ток/с. При 131072 и четырнадцати блоках получилось 2,19 ток/с. Влезает, но для моей задачи слишком медленно.
Поэтому фраза «часть модели в оперативке» без подробностей мало что объясняет. Статическая таблица и девять вычисляемых блоков обходятся очень по-разному.
Проверял отдельно. На небольшом наборе задач без рассуждений plain IQ3_M получил 14/20, IQ4_XS 17/20, Q4_K_P 18/20. Это сопоставимая серия с Q8-кэшем.
С включёнными рассуждениями IQ3_M и IQ4_XS дали 20/20 на моём ограниченном наборе задач. Проверки были для plain и Fast; выбранное сочетание IQ4_XS с Native тоже получило 20/20 в отдельной серии. Q4_K_P с рассуждениями в этой матрице не проверял.
Для меня этого хватило, чтобы оставить reasoning включённым. Для утверждения «качество всех квантов одинаковое» двадцати задач явно недостаточно. На сложном коде или длинной работе агента могут вылезти различия, которых этот набор не поймал.
Дополнительно посмотрел perplexity на WikiText-2: восемь блоков, контекст 2048. Это оценка предсказания текста, где меньше лучше. IQ4_XS получил 5,382 ± 0,143 на F16, 5,396 ± 0,144 на Q8 и 5,353 ± 0,141 на Q4. Разница маленькая относительно стандартной ошибки. Делать отсюда вывод «Q4 умнее F16» не стоит, да и английский корпус не заменяет проверку русского агента.
Uncensored здесь название конкретных весов. Отдельного доказательства, что модель никогда ни в чём не откажет, у меня нет.
До этого я проверял, как быстро модель отвечает на текст. Но мне нужен был помощник, которому можно поручить действие: например, открыть файл и найти в нём нужную информацию. Такую работу проверил через настоящий установленный Hermes/AIAgent. Запустил тест отдельно от рабочего помощника, с собственным HERMES_HOME. Рабочую конфигурацию Telegram gateway не переключал.
Тест устроил так: сначала отправил модели огромный текст, 103287 токенов. Затем поручил прочитать файл и назвать записанное в нём случайное контрольное значение. Чтобы добраться до файла, она должна сама вызвать функцию чтения read_file. Нужного значения в отправленном тексте нет, его можно узнать из файла.
Оба варианта справились: модель запросила чтение файла и вернула правильное значение.
С Native первоначальная обработка огромного текста заняла примерно 8 минут 44 секунды. Когда функция чтения вернула содержимое файла, модель подготовила короткий ответ с нужным значением за 2,7 секунды. С Fast получилось почти то же самое: 8 минут 49 секунд на первоначальную обработку и 2,8 секунды на ответ после получения содержимого файла.
Вот что здесь полезно на практике. После чтения файла модель не начинала заново разбирать всю огромную историю. Уже обработанный текст сохранился, оставалось прочитать небольшое дополнение с результатом чтения файла и ответить. В логах это всего 73 новых токена у Native и 74 у Fast, вместо повторной обработки всех ста тысяч.
Поэтому для такого помощника важна не только скорость написания текста, но и возможность продолжать работу без долгого ожидания на каждом шаге. Эти 2,7-2,8 секунды измерены до конца короткого ответа с контрольным значением. Большой отчёт за то же время модель, конечно, не напишет.
Здесь нашлась настройка, которую я бы записал отдельно:
Настройка Hermes
model:
reasoning_echo: true
Эта настройка позволяет Hermes сохранять рассуждения модели в истории разговора. Сервер узнаёт уже обработанную часть истории и продолжает с того места, где остановился.
Без неё в отдельной короткой проверке Fast после чтения файла заново обрабатывал историю. Ожидание ответа составило почти 13 секунд. Включил настройку, получилось примерно полторы секунды. Это другая, короткая проверка, а не повтор того же стотысячного запроса.
В моём сочетании Hermes и модели reasoning_echo: true оказался нужен для нормального повторного использования контекста. На маленькой истории лишнее чтение просто раздражает. На стотысячной уже совсем не хочется каждый раз ждать ещё несколько минут.
Этот опыт не доказывает, что помощник теперь без ошибок напишет любую программу. Но нужную мне последовательность он выполнил: обработал большую историю, запросил чтение файла, получил его содержимое и ответил, сохранив уже проделанную работу.
Я оставил себе такой профиль:
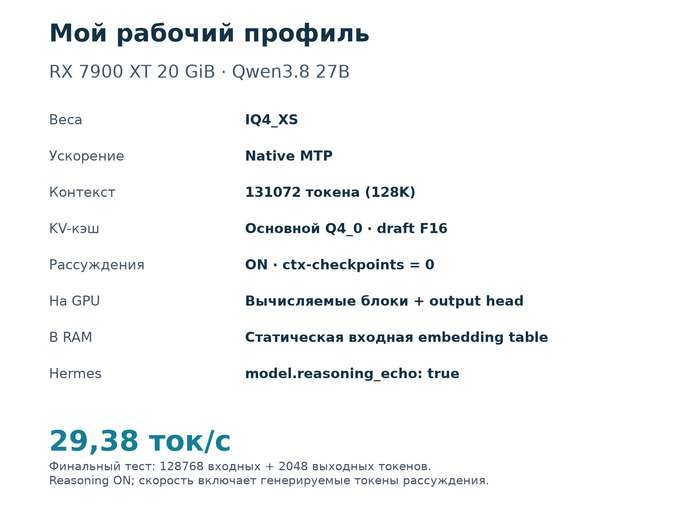
Модель: Qwen3.8-27B-Uncensored-HauhauCS-Aggressive
Веса: IQ4_XS
Ускорение: Native MTP
Контекст: 131072
Основной KV-кэш: Q4_0
Draft KV-кэш: F16
Reasoning: ON
ctx-checkpoints: 0
Параллельность: 1
GPU: вычисляемые блоки и output head
RAM: статическая входная embedding table
Hermes: model.reasoning_echo: true
IQ4_XS оказался для моей задачи удачным сочетанием скорости, качества и памяти. IQ3_M интересен, если хочется более компактные веса или больше места под контекст. Q4_K_P оставлял мало пространства для длинной истории, а перенос вычислений в RAM эту задачу приемлемо не решил.
Native выбрал по повторной русской серии и финальному рабочему тесту. Fast тоже прошёл длинную проверку агента, в некоторых конфигурациях был быстрее и остался отдельным профилем.
Теперь несколько деталей для тех, кто захочет повторить. Обычные speed-прогоны делал с parallelism 1, temperature 0, seed 42, обычно на 512 выходных токенах. Использовал ignore_eos, чтобы модель не закончила один ответ раньше другого и не испортила сравнение. Обычные ответы и инструменты проверял отдельно, финальный заполненный профиль на 2048 выходных токенах.
Фабрика шортсов была на паузе. Следил, чтобы рядом не работали другие модели и тяжёлые GPU-процессы. После части первых тестов закрыл браузеры и Steam, фон VRAM снизился примерно с 2,5 до 1,2-1,4 GiB. Поэтому старые границы сохранил с прежними условиями, а после очистки проверял заново.
Размещение смотрел при загрузке и во время заполненной работы. Сопоставлял ROCm-буферы, физическую VRAM и Windows dedicated memory процесса WSL и адаптера, с допуском 256 MiB. Одной надписи «все слои на GPU» мне было мало. Но это всё равно не побайтовое доказательство отсутствия любой подкачки драйвера.
Ещё техническая деталь: у модели гибридное внимание, recurrent state остаётся F32. Квантование KV не сжимает вообще всю память состояния. По одному размеру файла модели максимальное окно не посчитать.
Сборка основана на llama.cpp 4df29be4f4c3673f428170fda944a5b19f743bb8 с патчем Fast MTP. Цифры относятся к ней, ROCm 7.2 и моей машине. В другой версии движка результат может измениться. Обычная установка Ollama сама по себе этот профиль не воспроизводит. А 32K в имени ускорителя FastMTP-32K означает урезанный словарь, не ограничение длины контекста.
Совместную работу с фабрикой шортсов не проверял. Свободная видеопамять влияет на пределы. Контрольные значения в трёх местах подтверждают извлечение, но не безошибочное понимание каждого документа на 128K. Двадцать quality-задач остаются двадцатью задачами, а разницу в 1-2% по одному запуску лучше перепроверять.
Если нужен короткий практический ответ владельцу RX 7900 XT, я бы начинал с IQ4_XS, Native MTP, основного Q4-кэша, draft F16, окна 131072 и включённых рассуждений. С Hermes ещё model.reasoning_echo: true.
На коротких запросах можно получить больше 50 ток/с. На заполненных ~100K в сопоставимой серии вышло 36-37. Мой финальный почти заполненный 128K с рассуждениями дал 29,38 ток/с. На первичное чтение огромного входа надо заложить минуты, а для дальнейшей работы следить за повторным использованием контекста.
161792 я оставил как результат поиска края. Для ежедневного использования выбрал 131072. Запускаться с последними свободными мегабайтами мне менее интересно, чем спокойно пользоваться моделью.
Рассматривать RX 7900 XT для локальных LLM имеет смысл. На её 20 ГБ получается работать с 27B и большим контекстом, маленькими моделями всё не ограничивается. Только настройка софта тоже часть покупки: мои результаты получены через WSL, ROCm и конкретную сборку. Сопоставимых замеров Nvidia у меня нет, поэтому выводов о победе над всеми остальными картами тоже нет.
Если у кого-то есть RX 7900 XTX, RTX 3090 или другая карта с 20-24 ГБ, было бы интересно сравнить одинаковые веса на заполненных 100K/128K. У меня короткий запрос и длинная история дали настолько разные скорости, что теперь на одиночную цифру токенов в секунду смотрю с вопросом: а сколько текста модель уже прочитала?
Ссылки:
Все тесты, замеры и настройка проводились на моей машине. Для автоматизации, разбора логов и оформления поста использовал ИИ.
LogFlash - десктопное приложение для просмотра и анализа больших лог-файлов. Создано для инженеров, разработчиков и системных администраторов, которые работают с логами размером от нескольких мегабайт до десятков гигабайт.
Вкладка "Просмотр"
Главный экран программы — это таблица со всеми строками лога. При открытии файла вы сразу видите содержимое, без задержек.
Что можно делать:
Прокручивать весь лог, даже если в нём десятки миллионов строк. Программа подгружает только те строки, которые видите на экране — остальные остаются на диске.
Перейти к конкретной строке — вводите номер в поле «Перейти», нажимаете Go, и таблица прокручивается к нужному месту.
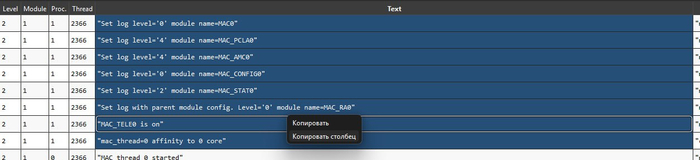
Выделять несколько строк и копировать их в буфер обмена.
Правый клик по строке открывает контекстное меню с действиями:
«Выделить строки…» — открывает окно управления подсветкой.
«Очистить всю подсветку» — убирает все цветные маркеры.
«Добавить строку в закладки» — сохраняет текущую строку в панель закладок.
«Копировать» — копирует выбранные строки.
«Выделить похожие на строку…» — быстрое создание правила подсветки на основе содержимого выбранной строки.
Поле «Содержимое строки» — это отдельная область, в которой отображается полный текст выбранной строки. Удобно, когда строка длинная и не помещается в таблицу: можно выделить мышкой нужный фрагмент и скопировать его.
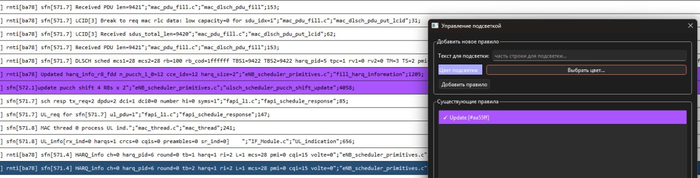
Подсветка строк:
Как работает:
Открываете окно «Управление подсветкой» через правый клик.
Добавляете правило: пишете текст для поиска (например, error или thread), выбираете цвет.
Все строки, содержащие этот текст, подсвечиваются выбранным цветом.
Что можно делать:
Включать и выключать отдельные правила.
Менять цвет двойным кликом по правилу.
Удалять ненужные правила.
Сохранять правила — они записываются в файл highlights.json и автоматически применяются при следующем запуске.
Быстрое создание правила — правый клик по строке → «Выделить похожие на строку…» → и вы уже редактируете текст правила для подсветки.
Как работает производительность: подсветка применяется только к видимым строкам и обновляется при прокрутке. Это позволяет сохранять скорость даже на логах в миллионы строк
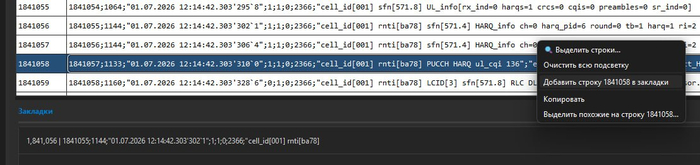
Закладки — это механизм для быстрого возврата к важным строкам.
Как работает:
Ставите закладку через правый клик по строке → «Добавить в закладки».
Открываете панель закладок кнопкой «Показать закладки» в верхней части окна.
В панели отображается список закладок с номерами строк и кратким содержимым.
Двойной клик по закладке — переход к строке в просмотре лога.
Правый клик — удаление закладки.
«Очистить все» — удаление всех закладок сразу.
Сохранение: закладки записываются в файл bookmarks.json и восстанавливаются при следующем запуске программы.
Настройка размера: панель закладок можно растягивать/сжимать мышкой за разделитель — высота сохраняется между сессиями.
Поиск по логу
Поиск работает через то же C++-ядро, что и индексация. Он многопоточный и работает по всем ядрам процессора.
Что поддерживается:
Простой поиск — вводите текст, ищется точное вхождение подстроки.
AND / OR / NOT:
error AND warning — строка должна содержать оба слова.
error OR warning — строка должна содержать хотя бы одно.
error NOT debug — строка содержит error, но не содержит debug.
Регистрозависимость — чекбокс «Aa» включает учёт регистра.
Расширенный поиск — отдельный диалог с формами для AND/OR/NOT и сложных запросов.
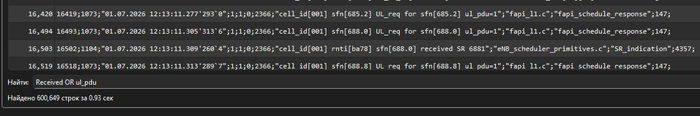
Панель поиска внизу экрана — всегда доступна, не мешает просмотру лога.
Результаты поиска — отдельная таблица, в которой отображаются все найденные строки.
Переход к строке — двойной клик по результату переключает вкладку на «Просмотр» и прокручивает к нужному месту.
Скорость: поиск «thread» на 27-миллионном логе — 0,45 секунды.
Вкладка «Анализ»
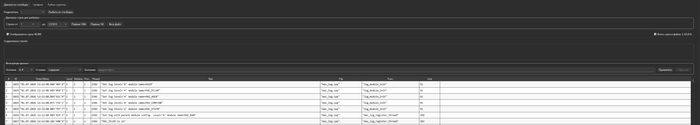
Если лог представляет собой CSV (или другой структурированный формат), можно разбить его по столбцам и анализировать данные.
Что можно делать:
Разбить по столбцам — выберите разделитель (;, ,, таб, |) и укажите диапазон строк (первые 100k, первые 1M, весь файл).
Фильтровать данные по любой колонке:
«содержит»
«равно»
«начинается с»
«заканчивается на»
«регулярное выражение»
Навигация по отфильтрованным строкам — кнопки «Предыдущая / Следующая».
Экспорт данных в CSV — можно выгрузить отфильтрованные строки и открыть их в Excel.
Просмотр содержимого — рядом с таблицей есть поле с полным текстом выбранной строки.
Двойной клик по строке — прокрутка и выделение внутри той же таблицы анализа.
Вкладка «Графики»
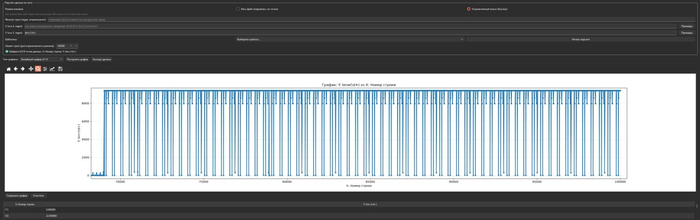
Построение графиков прямо из лога — без Python, без Excel, без скриптов.
Как работает:
Задаёте регулярное выражение для оси X (или оставляете пустым — тогда X будет номером строки).
Задаёте регулярное выражение для оси Y — например, tx=(\d+), чтобы извлечь число из строки.
Указываете фильтр по строкам (regex, опционально) — чтобы обрабатывались только нужные строки.
Нажимаете «Начать парсинг» — программа проходит по файлу и собирает данные.
Что можно построить:
Линейный график (X-Y) — классический график зависимости.
Точечная диаграмма (Scatter) — показывает разброс значений.
Гистограмма распределения Y — как часто встречаются значения.
Box plot Y — статистический график распределения (минимум, максимум, медиана, квартили).
Линии + точки — комбинированный график.
Дополнительные возможности:
Шаблоны регулярных выражений — готовые примеры для типичных логов.
Прогресс-бар — видно, сколько строк уже обработано.
Экспорт данных — сохранить собранные X и Y в CSV.
Режим «Весь файл» / «Ограниченный поиск» — можно обработать весь лог или только первые N строк.
Для чего это нужно: например, можно построить график изменения по всему логу и сразу увидеть аномалии.
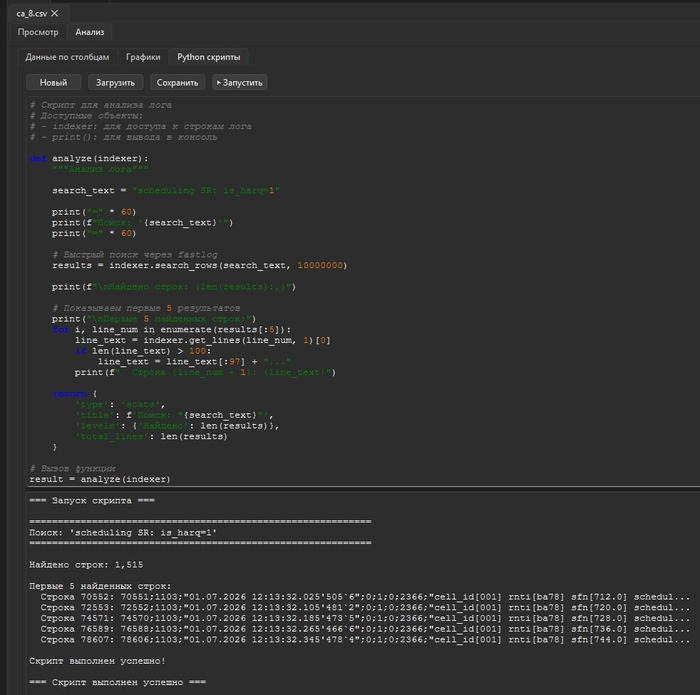
Вкладка «Python скрипты»
Встроенный редактор Python-скриптов с подсветкой синтаксиса.
Что можно делать:
Писать свои скрипты прямо в программе.
Запускать их одной кнопкой — результат выводится в том же окне.
Использовать объект indexer для доступа к логу:
indexer.get_total_lines() — количество строк.
indexer.get_lines(start, count) — получить строки.
indexer.search_rows(query, max_results) — быстрый поиск.
Пример скрипта: подсчитать, сколько строк содержат error, и построить распределение ошибок по часам.
Для чего это нужно: когда стандартных возможностей не хватает, можно написать собственный анализатор.
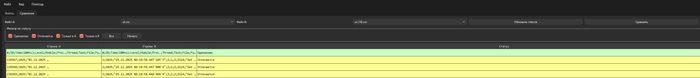
Вкладка «Сравнение»
Сравнение двух лог-файлов построчно.
Как работает:
Выбираете два файла из списка открытых вкладок (или открываете новые).
Нажимаете «Сравнить».
Программа построчно проходит оба файла и показывает результат в таблице.
Статусы строк:
🟢 Одинаково — строка в A совпадает со строкой в B.
🟡 Отличается — строка в A и строка в B различаются.
🔴 Только в A — строка есть в первом файле, но нет во втором.
🔵 Только в B — строка есть во втором файле, но нет в первом.
Фильтрация: можно отключить любой статус чекбоксом — например, показывать только отличия.
Что это даёт: при разборе тестов удобно сравнивать логи «до» и «после» фикса. Мгновенно видно, что изменилось.
Сохранение сессии
Программа запоминает состояние между запусками.
Что сохраняется:
Список открытых файлов (с полными путями).
Позиция в каждом файле — номер строки, на которой вы остановились.
Активная вкладка внутри каждого файла (просмотр или анализ).
Открыта ли панель закладок.
Размеры сплиттеров — пропорции окон.
Позиция и размеры главного окна.
Правила подсветки (в отдельном файле highlights.json).
Закладки (в отдельном файле bookmarks.json).
Как работает: закрываете программу — она сохраняет всё в файл настроек. Открываете снова — всё восстанавливается точно так, как было.