
0 просмотренных постов скрыто


Робот может сочинить симфонию? Робот превратит кусок холста в шедевр искусства?
Показать полностью
1

Nano Banana против ChatGPT Image: что лучше улучшает качество фото. Честное сравнение, обзор, доступ без VPN
Нужно улучшить фото, а из двух известных названий непонятно, какое реально даёт прирост качества, а не просто перерисовывает картинку заново. Обе модели за последний год заметно прибавили, и старые выводы из прошлых обзоров уже не совсем актуальны — ниже честное сравнение по актуальным версиям, без назначенного заранее победителя.
Что такое Nano Banana и ChatGPT Image
ChatGPT Images 2.0 (модель gpt-image-2) — первая модель OpenAI для изображений со встроенным «рассуждением»: перед генерацией она планирует композицию, проверяет количество объектов в кадре и соответствие ограничениям промпта, и именно это даёт основной прирост в точности следования инструкциям. Модель поддерживает разрешение до 2K стабильно (4K пока доступен в бета-режиме через API), генерацию до 8 согласованных изображений из одного промпта с сохранением персонажей и объектов между ними, а также значительно улучшенный рендеринг текста на нескольких языках. Базовый режим Instant доступен всем пользователям ChatGPT, включая бесплатный тариф, а режим «размышления» — только на Plus, Pro и Business.
Nano Banana 2 — модель Google в семействе Gemini, преемник Nano Banana Pro, вышедший вместе со старшей версией Nano Banana 2 Pro. По независимым обзорам модель сохраняет сильные стороны предыдущего поколения: точную ретушь, естественное освещение и консистентность персонажа между правками. Если раньше честный тезис звучал как «ChatGPT не делает настоящий апскейл, а только перерисовывает», то в новой версии это уже не совсем так — модель прибавила именно в разрешении, а не только в косметической детализации.
Одно независимое сравнение по состоянию на середину 2026 года ставит ChatGPT Images 2.0 немного впереди Nano Banana 2 по большинству измеримых параметров, с наибольшим разрывом именно в рендеринге текста и сложных макетов. Но это оценка одного источника, а не устойчивый консенсус нескольких независимых обзоров — стоит воспринимать с определённой осторожностью, а не как окончательный вердикт.
Что это значит для задачи «улучшить качество фото»
ChatGPT Images 2.0 теперь может дать реальный прирост разрешения — до 2K стабильно, — а не только визуальную перерисовку, как было в прошлом поколении модели. При этом 4K пока в статусе беты через API, а не гарантированная функция в обычном чате — не стоит обещать читателю уверенные 4K «из коробки». Отдельный практический плюс — режим рассуждения снижает типичную проблему прошлой версии: необходимость нескольких повторных попыток и риск незапланированного изменения лица или текста при правке, поскольку модель заранее проверяет ограничения промпта, прежде чем рисовать.
Nano Banana 2, в свою очередь, по-прежнему хороша именно для тонкой, естественной коррекции — цвет, свет, консистентность между несколькими правками — там, где ChatGPT традиционно был слабее и мог незаметно исказить деталь при повторной генерации.
Линейка моделей в 2026
ChatGPT Images 2.0 — режим рассуждения перед генерацией, до 2K стабильно, 4K в бете API, вышла 21–22 апреля 2026 года как прямой преемник GPT-Image-1.5.
Nano Banana 2 — точная ретушь, естественное освещение, консистентность персонажа, преемник Nano Banana Pro.
Обе модели меняются быстро, и версии, указанные здесь, актуальны на дату публикации статьи — стоит явно иметь это в виду, а не считать характеристики неизменным фактом на будущее.
Что лучше улучшает качество фото — сравнение
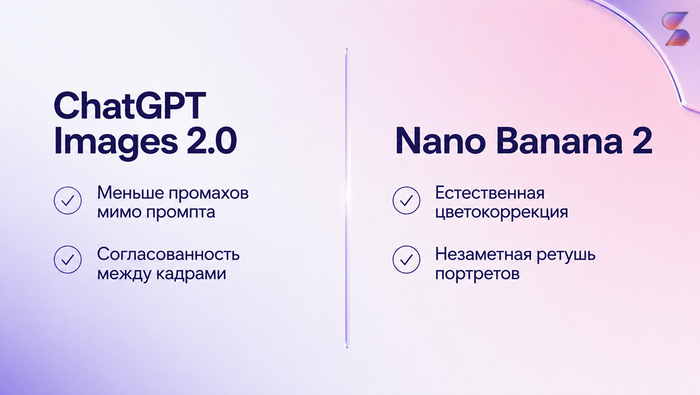
Если важно снизить число неудачных попыток и получить точное следование промпту с приростом разрешения — сильнее ChatGPT Images 2.0 за счёт режима рассуждения: модель реже «промахивается» мимо задачи и лучше держит согласованность деталей между несколькими сгенерированными изображениями. Если важна максимально естественная, некомпьютерная на вид картинка с точной цветокоррекцией и тонкой ретушью — по-прежнему увереннее держится Nano Banana 2, особенно на портретах и продуктовых фото, где любое лишнее изменение сразу бросается в глаза.
Кому что подходит
ChatGPT Images 2.0 стоит выбрать для задач, где важна точность по промпту с первого раза и корректный текст в кадре — например, макет с подписью или несколько согласованных изображений одного объекта.
Nano Banana 2 больше подходит для тонкой фотореалистичной коррекции портретов и продуктовых фото, где нужна естественность результата, а не максимальное разрешение или точное следование сложной инструкции.
Как получить доступ к Nano Banana и ChatGPT Image из России
Обе экосистемы — ChatGPT и Google/Gemini — требуют дополнительных инструментов и иностранную карту уже для самого доступа: ни одна не открывается в России без барьера, и это не вопрос удобства оплаты, а полноценное ограничение входа в сам сервис. Благодаря SpeShu.AI доступ к обеим моделям возможен без дополнительных инструментов, с оплатой в рублях — это снимает одинаковый по сути барьер для обоих сервисов одним и тем же способом входа.
Промпты, которые работают в Nano Banana и ChatGPT Image
ChatGPT Images 2.0 — Промпт 1:
text
Generate a product photo with the label text "SALE 20%" clearly readable, consistent lighting across four angles of the same object, keep the product design identical in each image.
На выходе — несколько согласованных изображений одного товара с корректным читаемым текстом на каждом.
ChatGPT Images 2.0 — Промпт 2:
text
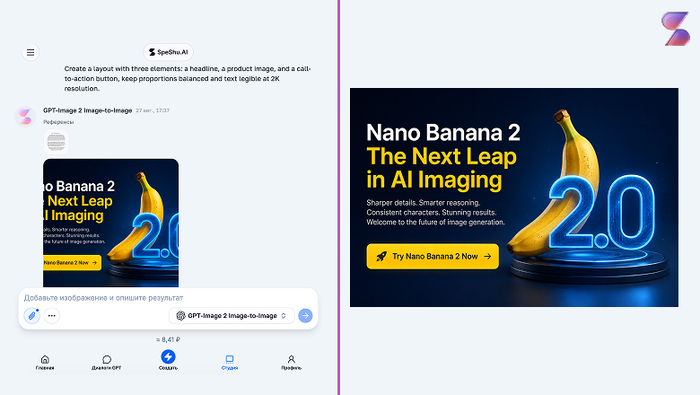
Create a layout with three elements: a headline, a product image, and a call-to-action button, keep proportions balanced and text legible at 2K resolution.
На выходе — сложный макет с текстом и объектами, размещёнными согласно ограничениям запроса, без лишних повторных попыток.
Nano Banana 2 — Промпт 1:
text
Correct the lighting on this portrait: even out shadows, preserve natural skin tone and texture, keep facial features and expression exactly unchanged.
На выходе — естественно выровненный свет без искажения черт лица.
Nano Banana 2 — Промпт 2:
text
Remove the object behind the subject in this photo, keep the subject's pose and the background lighting consistent with the original.
На выходе — чистый фон с сохранением исходного освещения сцены.
Частые вопросы
Может ли ChatGPT теперь реально увеличить разрешение фото?
Да, в отличие от прошлого поколения — ChatGPT Images 2.0 даёт стабильное разрешение до 2K, а не только визуальную перерисовку в исходных пределах. 4K пока доступен лишь в бета-режиме через API, а не как гарантированная функция в обычном чате.
Какая модель точнее сохраняет лицо при правке?
Nano Banana 2 — по независимым обзорам она сохраняет сильную сторону предыдущей версии: точную консистентность персонажа между несколькими правками. ChatGPT Images 2.0 благодаря режиму рассуждения тоже снизила риск незапланированного изменения лица, но исторически это была более сильная сторона именно Nano Banana.
Нужны ли дополнительные инструменты для обеих моделей?
Да, обе экосистемы — ChatGPT и Google/Gemini — требуют дополнительных инструментов и иностранную карту уже для самого доступа к сервису, без них напрямую в России не открываются.
Можно ли пользоваться бесплатно?
Базовый режим Instant у ChatGPT Images 2.0 доступен на бесплатном тарифе ChatGPT, а вот режим рассуждения — только на платных планах Plus, Pro и Business. Условия доступа к Nano Banana 2 зависят от текущих условий подписок Google AI, которые стоит проверять на момент использования.
Практическая рекомендация
Единого победителя нет: ChatGPT Images 2.0 сильнее там, где важна точность по промпту с первого раза и прирост разрешения, Nano Banana 2 — там, где важна максимально естественная фотореалистичная коррекция. Доступ к обеим моделям в одном месте, без дополнительных инструментов, можно получить через SpeShu.AI. Введите промокод PIKA15 при пополнении баланса и получите +15% на счёт агрегатора.
Реклама. ООО «ЦНИС», ИНН: 9704271170
Показать полностью
4

Стефаааняяяя...
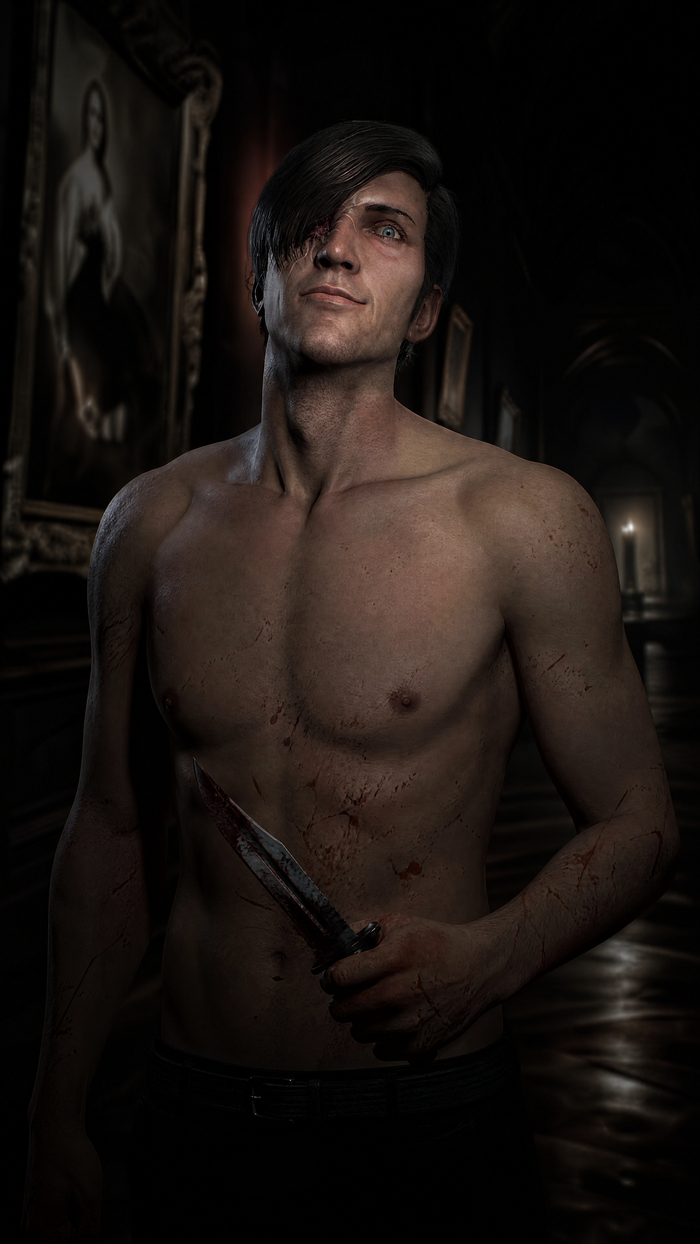
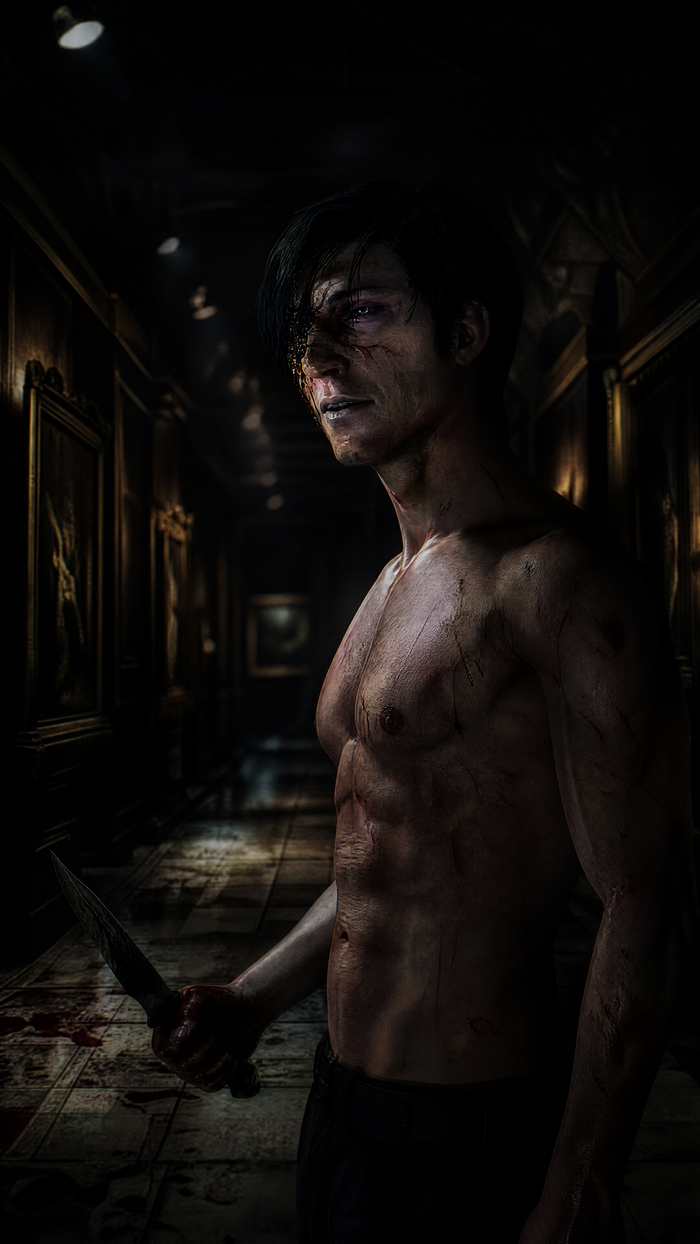
Как больше появилось возможностей с ИИ,так я начала мудрить: клепаю с любимым персонажем из игры Evil Within 2 разные образы. Не, ну а шо, в голове сидят мечталки всякие, теперь они и не только в голове х)
Омномоном
Показать полностью
11

Лучше уже не будет
Показать полностью

Как я купила машину с японского аукциона и случайно стала разработчиком приложений
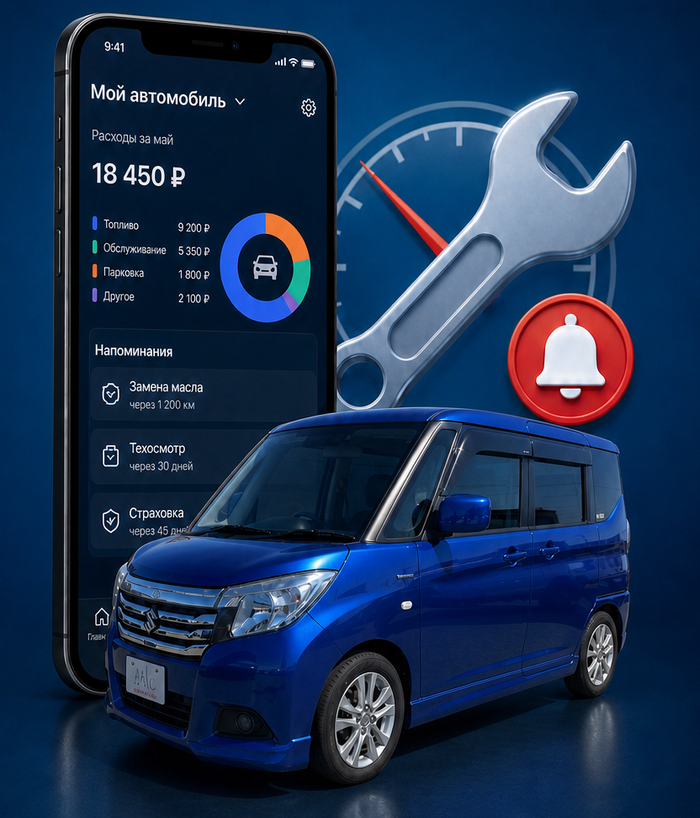
АвтоСервис Помощник
Всем привет, пикабушники! Осторожно, много букв. Хочу рассказать вам свою историю. Может, кому-то она покажется полезной или просто интересной. Я не программист, не айтишник, я обычный человек, который умеет разговаривать с нейросетями. И да, я сделала приложение для Android за 3,5 месяца, потратив 0 рублей. Звучит как сказка? Сейчас расскажу, как всё было.
Всё началось с машины. Весной я решилась и купила себе автомобиль с японского аукциона. Пока моя ласточка плыла ко мне в контейнере, я поймала себя на мысли, что вообще не представляю, что у неё там внутри обслуживается. Какие узлы, когда что менять, какой у вариатора регламент — тёмный лес. Модель для нашего рынка экзотическая, в сервисной книжке — иероглифы.
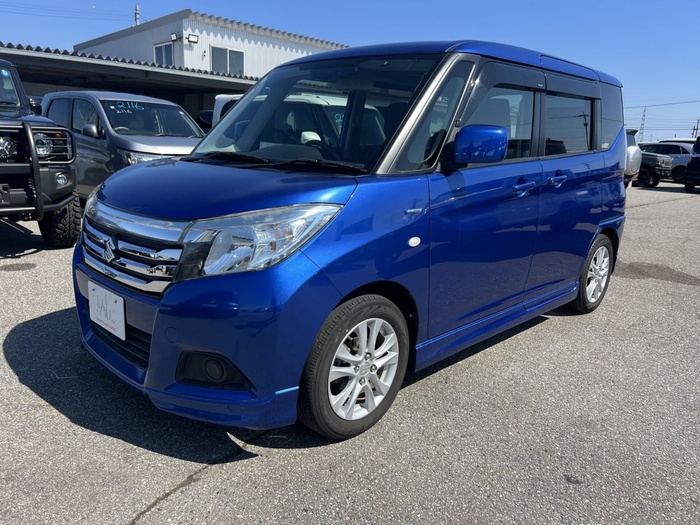
Suzuki Solio
И первое, что я сделала — пошла не в гугл, а к нейросетям. Тут надо пояснить: с нейронками я на «ты» с самой первой GPT. Не профессионально — я не айтишник, — но все эти годы я плотно слежу за их развитием и постоянно гоняю их по разным задачам. Так что как с ними разговаривать, чтобы получить результат, а не воду — представление имею.
Написала промт: вот марка, вот модель, вот год и двигатель — найди по официальным источникам все узлы этой машины и собери регламенты обслуживания: что и через сколько километров или месяцев менять. И нейросеть СПРАВИЛАСЬ. Выдала мне полный расклад по моей японке: все жидкости, фильтры, ремни, интервалы — со ссылками на источники. Запомните этот момент, он ещё выстрелит в этой истории.
Ладно, регламент есть. Теперь нужно приложение, которое будет за всем этим следить. Скачала пять самых популярных из маркета. И разочаровалась во всех пяти. Это какие-то комбайны: тонны таблиц, кнопок, отчетов, местами сумбурный интерфейс, ВСЁ надо вводить руками — каждый узел, каждый интервал, вручную, по одному. При этом почти все требуют регистрацию и облако. Зачем?! Мне надо было ровно две вещи: чтобы приложение САМО прогнозировало пробег (даже когда я забываю вводить одометр — а я забываю) и заранее пинало меня «пора менять масло». Всё!
И тут мне в голову пришла гениальная в своей наглости мысль: а напишу-ка я приложение сама. Нюанс: кодить я не умею. Вообще. Денег на платные подписки — ни на Claude, ни на Cursor — у меня тоже не было. Зато есть площадки, где с нейросетями можно работать бесплатно. С лимитами, с падениями — но бесплатно.
Дальше начался цирк с конями, который растянулся на 3,5 месяца — с начала лета и, забегая вперёд, до самой публикации в сентябре.
Начиналось всё вообще без всяких «агентов» — в обычном чате. Схема была предельно колхозная, держитесь: приложение поначалу было маленькое, и весь его код я упаковывала в PDF... мелким шрифтом. Потому что площадка принимала только PDF и только до 90 страниц. Восьмой кегль, узкие поля — влезает! Чат это кушал, разбирался в моих файлах и выдавал: «в таком-то файле замени такой-то блок вот на это». А я сидела в Notepad++ и руками меняла блоки кода, как собирала пазл. Благо, что где лежит — понимать научилась быстро.
Потом приложение разрослось, и в 90 страниц перестало влезать даже восьмым кеглем и в три колонки. Но к тому времени на площадке появился агентный режим — это когда ИИ не просто советует, а сам пишет файлы, запускает проверки, ищет ошибки. Одна проблема: свои файлы агенту напрямую не отдать. Нашла обход: пакую проект в архив, кидаю на Яндекс Диск, даю агенту публичную ссылку и команду «скачай через API, распакуй у себя и работай». И это сработало! Вот с этого момента пошла по-настоящему серьёзная и быстрая работа.
Android Studio, кстати, я тоже увидела первый раз в жизни. Установка, SDK, Java, gradle — я до сих пор не знаю, что половина этих слов значит. Но схема та же: «пришлите текст ошибки» — прислала — починили — поехали.
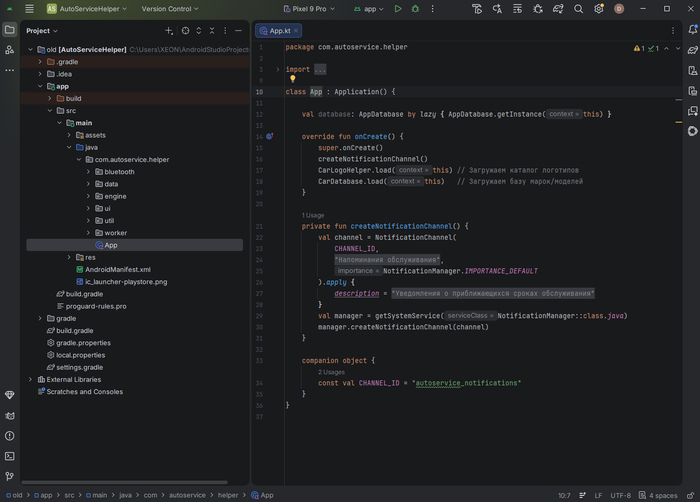
Первая собранная версия была страшна как моя жизнь. Интерфейс никакой, половина кнопок не работает. И понеслось: правка за правкой, «а почему тут не так», «а сборщик ругается, смотри». Лимиты — отдельная песня: окно чата переполняется — переноси проект в новое. Площадка легла — переноси проект на другую нейросеть и работай там. Заметила закономерность: стабильнее всего всё работало с ночи и до раннего утра. Видимо, пока Америка спит, а Китай только просыпается, мощности свободны :)
А теперь — помните момент с регламентом для моей японки? Я поняла, что можно не вводить узлы руками, как во всех тех комбайнах. Пусть приложение само готовит промт! Сделала так: вводишь марку, модель, год, двигатель — приложение собирает готовый промт, для удобства разместила внутри ссылки на несколько бесплатных чат-ботов. Копируешь промт, кидаешь боту — тот сам ищет по официальным источникам все узлы и регламенты и возвращает ответ в специальном формате. Вставляешь ответ в приложение — и готово: весь список узлов с интервалами появляется сам. Ничего не надо вбивать по одной строчке. В целом ради этой фишки и затевалось собственно приложение.
К середине августа у меня было приложение мечты. Моей мечты — я его под себя делала: без регистраций, без облаков, само создает список всех узлов, все данные только в телефоне, пробег прогнозирует само, о заменах напоминает заранее. И я подумала: а чего добру пропадать? Выложу в RuStore.
Вот тут-то и выяснилось, что «приложение для себя» и «приложение для людей» — это две большие разницы. Весь остаток пути ушёл на превращение одного в другое. Локализация на 9 языков (включая японский — машина же японка, имею право). Госномера разных стран. Редактор иконок для узлов. PDF-отчёты по обслуживанию (пригодятся при продаже машины). Резервные копии, тёмная тема, настройка цветов...
Что меня спасало — ролевые игры с агентом. Серьёзно. Пишешь: «ты теперь QA-менеджер, проведи полный аудит проекта перед релизом» — получаешь десятистраничный отчёт с косяками, о которых ты и не подозревала. Неделю исправляешь. Потом: «сравни моё приложение с конкурентами» — в итоге добавляешь в приложение полноценный функционал подсчета заправок, затрат и полный отчет всего. Потом выясняется, что всё, что наваяли в начале «на коленке», захардкожено и не масштабируется — и мы неделями наводим порядок в коде.
И вот что я вам скажу — самое неожиданное открытие всей этой истории. Написание кода — это МЕНЬШАЯ часть работы. Нейросеть код пишет быстро. А знаете, что занимает больше всего времени? ТЕСТИРОВАНИЕ. Руками. Глазами. Каждое окно, каждую кнопочку, каждую функцию. Как открывается поле при нажатии. Работает ли ссылка. Помещается ли текст — а если включить крупный шрифт? А на казахском? А на японском, где иероглифы? Тут вылезает, там обрезается. Почему анимация прыгает, а не едет плавно? А что посчитает алгоритм пробега, если человек ввёл одометр задним числом? А если два раза подряд? Из 3,5 месяцев чистых МЕСЯЦА ДВА ушло вот на это: тыкать, находить, описывать агенту, проверять исправление — и по новой. Теперь я понимаю, почему тестировщики в айти — уважаемые и небедные люди. Я в одном лице прошла их годовую норму.
Отдельная песня — правила площадки. Оказалось, «для людей» — это ещё и «по правилам»: чужие иконки в приложение класть нельзя — авторские права; логотипы автомобильных марок встраивать нельзя — тоже права, пришлось переделывать так, чтобы пользователь сам загружал картинки, какие захочет; прямые ссылки на некоторые ресурсы — нельзя; за упоминание удалённых функций в описании — отклонение модерацией. Я это всё физически не в состоянии была прочитать и удержать в голове. Выручал всё тот же приём: «ты — юрист площадки, проведи аудит на соответствие правилам» — и агент выдавал список: это убрать, это заменить, тут придумать обходной способ. Так и подгоняли приложение под правила, пункт за пунктом.
А параллельно шёл квест с бюрократией, о котором меня никто не предупреждал. Оформление ИП. Электронная подпись на токене. Уведомление в Роскомнадзор (вы знали, что если в приложении реклама — вы оператор персональных данных?). Коды ОКВЭД. Заявление на монетизацию. Политика конфиденциальности на те же 9 языков. Анкеты, обоснования разрешений, шифрование ключа подписи отдельной утилитой... Схема всё та же: скармливаешь агенту скриншот формы — получаешь пошаговую инструкцию, что куда вписать.
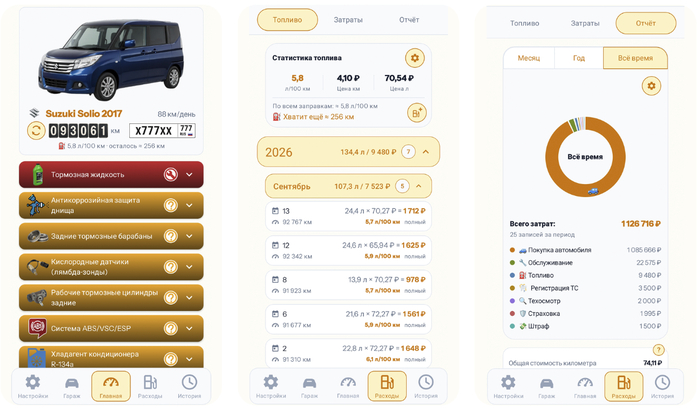
И вот — 21 сентября опубликовано. Красивая карточка, скриншоты, я счастлива.
На следующий день я нашла в опубликованной версии критический баг: не открывался список марок машин. В тестовой сборке работало, в релизной — нет (для знающих: R8 съел TypeToken у Gson; для незнающих: магия сломалась). Опытный разработчик бы поседел. А тут: скинула агенту описание бага — через две минуты он назвал причину, ещё минут двадцать ушло на исправление и сборку, еще минут 10 на тестирование. И через час обновление уже было на модерации. Вот за это я нейросети и люблю — они не умеют паниковать и опускать руки!
Итоги всей эпопеи, честно:
— 3,5 месяца работы, практически каждый день до 5-00 утра;
— ~2500 промтов (да, я посчитала. И это только по скаченным архивам в загрузках, не считая остальных промтов: как мне заполнить декларацию или открыть ИП и т.п.);
— 0 рублей потрачено на разработку (ИП и прочая бюрократия — не в счёт);
— 466 файлов, 159 тысяч строк кода, 248 автотестов — и я по-прежнему не умею программировать;
— приложение уже лежит в рустор. За первый день 6 скачиваний, 50 просмотров, найдены 2 бага, вторая версия исправленная уже на модерации.
— и бонусом посчитала, во что наша затея обошлась бы деньгами. Один мой промт в агентном режиме — это не один запрос: агент читает файлы, правит, проверяет, и каждый шаг заново прогоняет через модель всю историю с кусками кода. По моим прикидкам, один промт съедал в среднем около миллиона входных токенов. Умножаем на 2500 промтов — выходит порядка двух-трёх МИЛЛИАРДОВ токенов за проект. Если бы я платила за это по ценам API топовых моделей — вышло бы примерно 150–400 тысяч рублей. Подписки уровня «максимум» за $100–200 в месяц — и то впритык, с упиранием в лимиты. А заказная разработка такого приложения в студии стоила бы от полумиллиона и выше. Мой бюджет, напомню: ноль рублей и бессонные ночи;
И главное, что я поняла за эти месяцы.
Всё это может сделать обычный человек. Серьёзно. Уровень входа в сферу разработки не нулевой, но уже приближается к этому. Я не программист, не айтишник, я до сих пор не знаю, что такое gradle. Всю техническую работу сегодня уже делает нейросеть — причём, как видите, даже бесплатная: без всяких Claude Code, супер-агентов с MCP и прочих модных штук. Да, проект лежит не только у тебя на компе, а дублируется и крутится на чужих серверах, и файлы носишь архивами туда-сюда. Да, медленнее и местами через одно место — PDF восьмым кеглем, ага. Но работает.
Единственное, чего нейросеть за вас не сделает, это не сумеет захотеть. Цель, стимул и упрямство каждый день на протяжении месяцев — вот это всё основной двигатель.
Машина, кстати, доехала. Катаюсь и записываю заправки, веду расходы уже в своем приложении. Масло и прочие узлы, если что, оно мне само напомнит поменять. А мой продукт попутно начинает набирать обороты на площадке, пусть не уверенно, но все впереди!
Можете сами посмотреть результат. Если интересно название — напишу в комментах, а то ещё за рекламу посчитают. И спрашивайте, если что — расскажу про любой этап подробнее.
Показать полностью
4

Учителя ChatGPT попались на списывании у ChatGPT
OpenAI платит людям больше 50 долларов в час, чтобы они учили ChatGPT, и выгоняет за то, что они просят помощи у ChatGPT. Как выяснило издание 404 Media, таких нарушителей среди проверяющих уже набралось немало, и их регулярно снимают с проектов.
Работа у этих людей вообще-то непростая: они читают настоящие переписки пользователей с ботом, уже обезличенные, и оценивают, какой ответ лучше. Нанимает их Mercor, это компания-посредник, которая подбирает людей для обучения ИИ. Правила там жёсткие, нельзя ни ChatGPT, ни Grammarly, ни даже машинный переводчик.
Ловят по мелочам вроде повторов слов, любви к длинному тире и подозрительно быстрой работы, причём проверяющим прямо велено не говорить человеку, на чём он попался.
Один уволенный показал письмо, где ему вменили проблемы с «подлинностью» работы, и признался, что просто хотел немного помощи. Некоторые другие, как выяснилось, вообще втихаря выбирают худшие ответы назло.
Смысл запрета понятный: если ИИ учится на ответах другого ИИ, он со временем деградирует, учёные это называют коллапсом модели. OpenAI платит именно за человеческое мнение, и подделку тут отлавливают строже всего.
Самое шаткое тут доказательства. В инструкции для проверяющих прямо сказано, что детекторы ИИ вроде GPTZero ненадёжны и пользоваться ими нельзя. Выходит, человека снимают по общему впечатлению: повторы, тире, скорость. Оспорить такое почти нечем, ему ведь даже не говорят, в чём его подозревают.
--
Телеграм про право в IT и AI. IT юристы — PravoWeb.com
Показать полностью
Канада подала в суд на OpenAI после школьной стрельбы
Команда ChatGPT заметила опасные разговоры стрелка, но не предупредила полицию — и произошла трагедия.
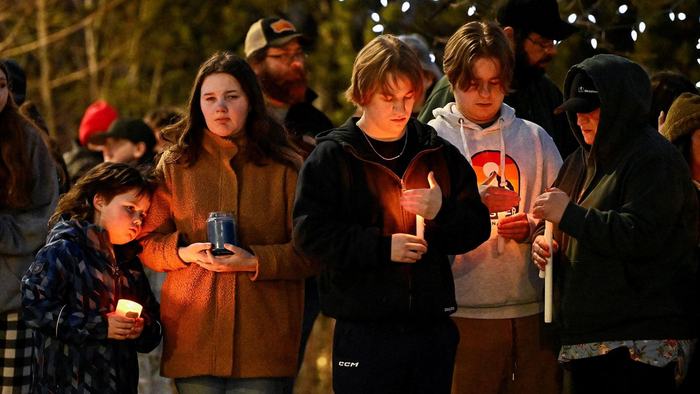
Фото: Источник
В июне 2025 года специалисты OpenAI отметили аккаунт пользовательницы из Британской Колумбии. Они обнаружили в её чатах тревожные разговоры о насилии. Команда безопасности даже обсуждала обращение в полицию, но... так и не отправила его.
Аккаунт заблокировали, хотя позже она создала новый. Ведомости
А 10 февраля 2026 года в школе города Тамблер-Ридж произошла стрельба. Погибли девять человек, не считая самой нападавшей.
Теперь власти Британской Колумбии подали иск против OpenAI и Сэма Альтмана. Они считают, что трагедию можно было предотвратить, если бы компания предупредила полицию вовремя. РБК
В требованих — возместить расходы на ликвидацию последствий, включая строительство новой школы и психологическую помощь пострадавшим. А также — изменить правила обработки потенциально опасных диалогов.
OpenAI признаёт трагедию и сотрудничает с властями. А суду теперь предстоит решить: должна ли частная компания рапортировать о таких диалогах, даже если речь идёт о приватной переписке с ИИ?
Показать полностью