Приходит большой договор. Нужно найти несколько условий, сравнить пункты или просто понять, что там написано человеческим языком.
Раньше сотрудник читал документ сам.
Теперь гораздо проще открыть нейросеть, загрузить PDF и спросить:
«Что здесь написано про расторжение договора?»
Через минуту есть ответ.
Удобно? Очень.
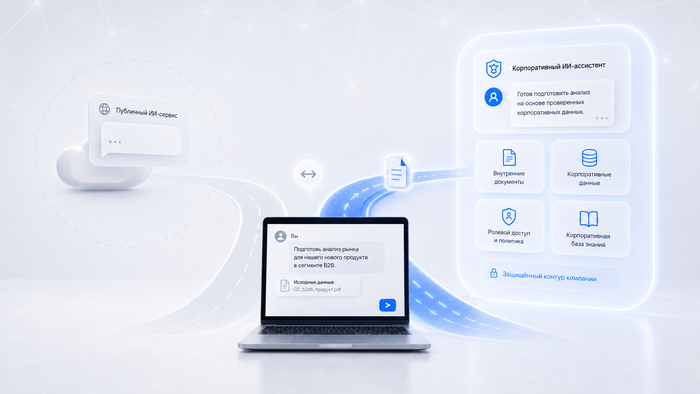
Вот только если аккаунт личный, у работодателя может вообще не быть представления о том, что туда только что загрузили рабочий договор.
У этого уже есть отдельное название — Shadow AI, или теневой ИИ.
И это не какой-то редкий случай.
По данным Netskope AI Report 2026, среди пользователей ИИ в организациях 30% используют только личные ИИ-приложения, а ещё 14% одновременно пользуются личными и корпоративными инструментами.
Компания ещё обсуждает политику использования искусственного интеллекта. А сотрудник уже третий месяц использует его каждый день. И я бы не стал делать из сотрудника злодея. Человек просто выбирает самый короткий путь к результату.
Если вручную на документ уйдёт 40 минут, а с нейросетью — пять, довольно легко предсказать, какой вариант он выберет.
Можно всё запретить.
Но тогда появляется замечательная корпоративная игра:
«Мы запретили инструмент, который экономит сотруднику полчаса. Интересно, перестанет ли он им пользоваться?»
Мне кажется, разумнее решить исходную проблему.
Если людям нужен ИИ для работы с документами — дать им ИИ, который уже работает с рабочими документами.
Чтобы человеку не приходилось:
скачать файл — куда-то загрузить — объяснить контекст — потом перенести результат обратно.
А сам инструмент при этом должен понимать, какие документы конкретному сотруднику вообще разрешено видеть.
Есть ещё один интересный момент.
Часто можно услышать:
«Ну тогда просто поставим нейросеть на свой сервер».
Это полезно, но само по себе проблему не решает.
Допустим, модель физически стоит в офисе.
Но если она имеет доступ вообще ко всем договорам, зарплатам, медицинским данным сотрудников и переписке руководства — стало ли от этого сильно лучше?
Поэтому корпоративный ИИ — это не только вопрос того, где лежит модель.
Это ещё и вопрос того:
к каким данным она имеет доступ;
кто может задавать ей вопросы;
какие документы доступны конкретному человеку;
откуда берётся информация для ответа.
Похоже, период «разрешать ли сотрудникам пользоваться нейросетями» уже заканчивается.
Сотрудники ответили на этот вопрос сами.
Теперь компаниям остаётся разобраться, как сделать это использование управляемым и при этом не превратить полезный инструмент в неудобную корпоративную систему, которой никто не хочет пользоваться.
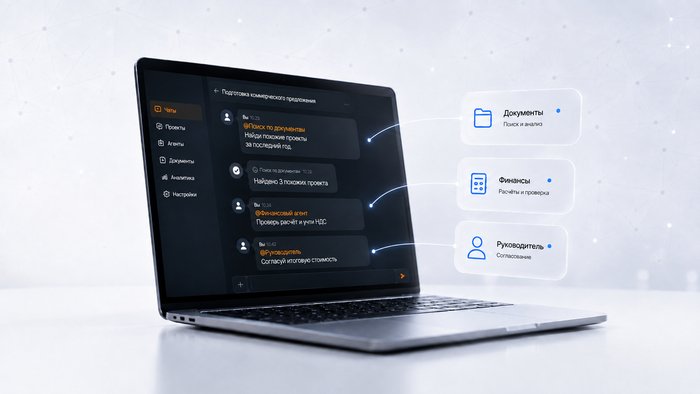
Открываем чат с юристом. Пересылаем кусок переписки. Прикладываем договор. Пишем что-нибудь вроде: «Короче, ситуация такая…»
Юрист отвечает.
Возвращаемся обратно.
Теперь нужно проверить деньги.
Находим финансиста. Снова пересылаем контекст. Снова объясняем, откуда взялась эта сумма и что уже решил юрист.
Потом понадобится руководитель.
И всё начинается заново.
А теперь добавим нейросети.
Для поиска по документам — один инструмент.
Для анализа — другой.
Для задач — третий.
Получается довольно иронично: технологии должны уменьшать количество ручной работы, а пользователь всё чаще работает оператором по пересылке контекста между технологиями.
Мне кажется, логичнее перевернуть этот принцип.
Не относить рабочий вопрос к нужному специалисту или инструменту.
Подключать специалиста к самому вопросу.
Например, в текущем разговоре написать:
@Юрист Проверь вот этот пункт.
И юрист получит только конкретное сообщение и приложенный документ.
Не всю переписку за последние полчаса.
Или:
@Поиск по документам Найди похожие договоры.
Поиск выполняется в том же рабочем контексте.
Или:
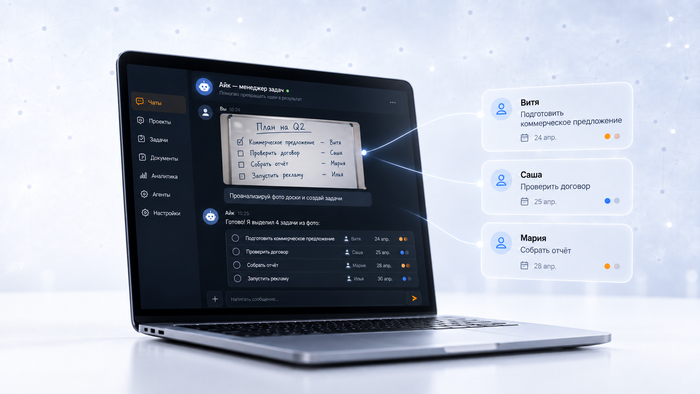
@Агент задач Сделай из этого поручение.
То есть один разговор постепенно превращается не в групповой чат на двадцать человек, а в точку, к которой по необходимости подключаются разные специалисты и инструменты.
Причём только к конкретным вопросам.
Мне кажется, здесь особенно важна приватность.
Если я обсуждал что-то один на один, приглашение специалиста для ответа на один вопрос не должно автоматически означать:
«Вот тебе вся наша переписка, приятного чтения».
Ему нужен конкретный фрагмент и конкретная задача.
В итоге сама модель работы получается довольно человеческой.
Не все сидят на одном совещании с самого начала.
Кого-то позвали на пять минут, спросили его часть и продолжили работу дальше.
Почему рабочие цифровые системы до сих пор в основном заставляют нас поступать наоборот — хороший вопрос.
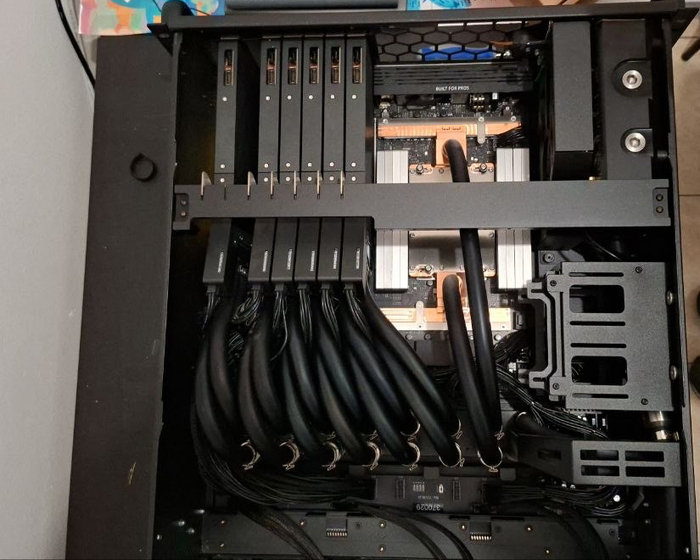
Обычно локальная нейросеть размером в десятки миллиардов параметров ассоциируется с серверной стойкой, видеокартами, охлаждением и довольно весёлым счётом за оборудование.
Поэтому мне стало интересно проверить совсем другой сценарий.
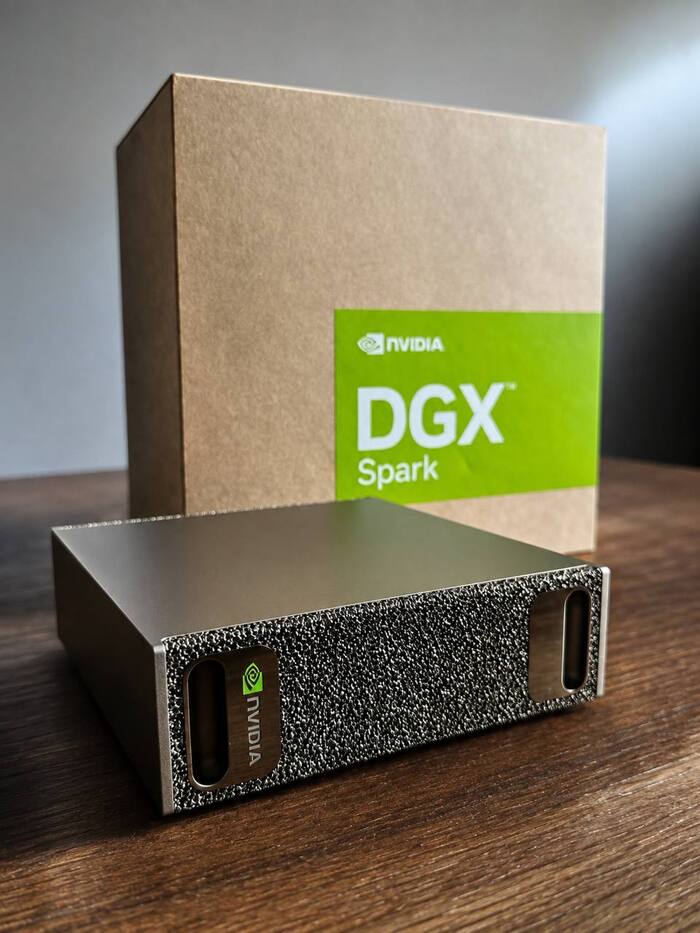
Есть NVIDIA DGX Spark — маленькая настольная система размером примерно 15 × 15 см.
Внутри 128 ГБ объединённой памяти и чип Grace Blackwell. Производитель заявляет до 1 PFLOP FP4 и возможность локально работать с моделями до 200 млрд параметров.
На бумаге звучит впечатляюще.
Но цифра «200 миллиардов параметров» в реальной работе практически ни о чём не говорит.
Можно запустить модель — хорошо.
А сколько времени она будет отвечать?
Что произойдёт, если одновременно придут пять запросов? Десять?
А если один пользовательский запрос вызывает не одно обращение к модели, а пять — потому что сначала нужно найти документы, потом проанализировать их, вызвать инструмент, ещё раз обратиться к модели и проверить результат?
Вот это уже интереснее.
Поэтому хочу использовать устройство не для бенчмарка в стиле «смотрите, большая модель загрузилась», а попробовать собрать максимально приближенный к реальной работе локальный ИИ-контур.
Чтобы внутри находились:
сама языковая модель;
поиск по документам;
база знаний;
агенты;
история взаимодействия;
необходимые инструменты.
И чтобы критическая часть этой цепочки не обращалась к внешнему ИИ-сервису.
Здесь сразу есть несколько вопросов.
Первый — какую модель вообще имеет смысл использовать.
Самая большая далеко не обязательно будет самой полезной. Если условная 30B-модель отвечает значительно быстрее и практически не уступает 100+B на нужных задачах, выбор довольно очевиден.
Второй — параллельная нагрузка.
Одно дело показать красивый ответ одному человеку. Совсем другое — когда системой начинают одновременно пользоваться сотрудники.
Третий — долговременная эксплуатация.
Можно собрать конфигурацию один раз руками. Но если на установку второго экземпляра снова требуется несколько дней работы инженера, «коробочного» решения не получилось.
Вот это, собственно, и хочу проверить.
Мне кажется интересной сама тенденция: локальный ИИ постепенно перестаёт обязательно означать полноценную серверную инфраструктуру.
Но где проходит реальная граница возможностей таких компактных устройств — характеристики производителя не расскажут.
Так что дальше нужны обычные тесты: модели, скорость, память, несколько пользователей и реальные сценарии вместо красивых демо.
Если цифры окажутся интересными — будет что показать.
Представим, что вы просите нейросеть найти самое свежее событие по какой-либо теме.
Чтобы выполнить запрос корректно, она должна обратиться к интернет-поиску.
Но языковая модель устроена так, что практически всегда пытается сформировать ответ. Даже если актуальной информации у неё нет, она может собрать правдоподобный текст из известного контекста.
Выглядеть он будет убедительно. Только вот самым свежим событием там может оказаться история многомесячной давности или вообще удачно сформулированное предположение.
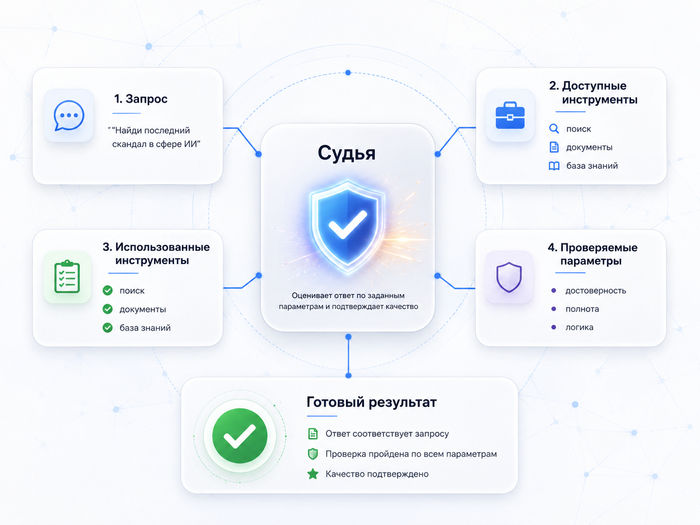
В одном из корпоративных ИИ-проектов мы используем для таких случаев отдельного проверяющего агента.
Условно его можно назвать «Судьёй».
Основной агент получает запрос и выполняет его. После этого «Судье» передаются три вещи:
сама задача;
список инструментов, которые исполнитель мог использовать;
список инструментов, которыми он воспользовался на самом деле.
Дальше происходит простое сопоставление.
Запрос требовал свежих данных из интернета? Интернет-поиск был доступен? Исполнитель его вызвал?
Если ответ на последний вопрос отрицательный, результат не отправляется пользователю.
Задача возвращается агенту с инструкцией повторить работу и использовать нужный инструмент.
При этом проверяющий агент не ищет информацию сам и не переписывает результат. Иначе он превратился бы во второго исполнителя.
Его роль уже: определить, соблюдён ли необходимый порядок работы.
Это немного похоже на обычную организацию.
Сотрудник подготовил отчёт. Проверяющий не делает весь отчёт заново, но может спросить:
— А данные из реестра вы использовали? — Нет. — Тогда результат пока нельзя считать готовым.
Полностью проблему галлюцинаций такая схема, конечно, не решает.
Даже после обращения к нужному источнику модель может неправильно интерпретировать данные. Сам источник тоже может содержать ошибку.
Но проверка закрывает другой важный сценарий: агент больше не может просто придумать убедительный ответ там, где от него требовалось выполнить конкретное действие.
Подобных проверяющих может быть несколько.
Один контролирует использование инструментов. Другой — полноту результата. Третий — соблюдение внутренних правил. Четвёртый — логику выполнения.
Тогда вместо одного универсального ИИ получается небольшая цифровая команда, где каждый отвечает за свой участок работы.
Похоже, именно так и будут развиваться сложные агентные системы: не одна нейросеть, которая умеет абсолютно всё, а несколько специализированных ролей, которые выполняют и проверяют работу друг друга
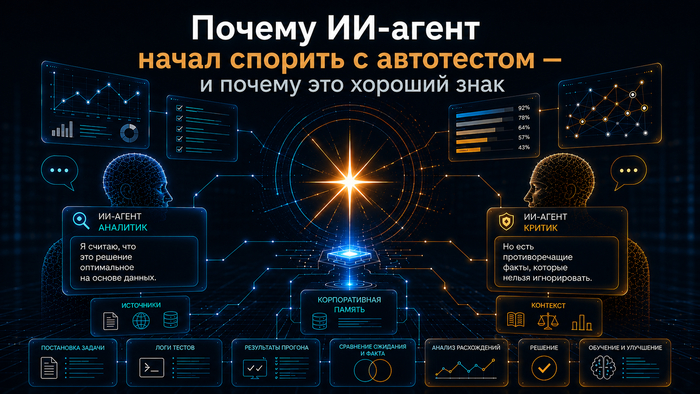
В разработке бывает привычная ситуация: обновили систему, запустили тесты — один из них упал. Первая мысль очевидна: значит, что-то сломали.
Но с ИИ-агентами возможен и более странный вариант. Иногда тест перестаёт работать не потому, что агент стал хуже, а потому, что он начал вести себя логичнее.
Недавно у нас произошёл именно такой случай.
Зачем вообще нужны такие тесты
Некоторые автоматические тесты проверяют не одну функцию или кнопку, а целый пользовательский сценарий.
Такой тест ведёт себя почти как человек:
открывает интерфейс;
вводит сообщения;
общается с ИИ-агентом;
подтверждает действия;
проверяет, появился ли ожидаемый результат.
По сути, это виртуальный пользователь, который много раз подряд повторяет одну и ту же последовательность действий.
Если во время разработки обнаруживается ошибка или необычное поведение, под этот случай создаётся отдельный тест. После этого система должна проходить его при каждом следующем обновлении.
Так постепенно накапливается библиотека сценариев, которая защищает продукт от возвращения уже исправленных проблем.
Тест, который должен был создать десять задач
Один из сценариев проверял, способен ли ИИ-агент последовательно создать десять задач и не потерять контекст диалога.
Логика была простой:
тест просит создать задачу;
агент создаёт её;
агент спрашивает, нужно ли создать следующую;
тест отвечает: «Да, подтверждаю»;
цикл повторяется десять раз;
в конце проверяется, что действительно появились десять задач.
Изначально всё работало именно так. Агент каждый раз ожидал подтверждения, а тест отправлял заранее подготовленную реплику.
Затем системные инструкции агента обновили.
После нескольких созданных задач он начал лучше понимать общий контекст и перестал каждый раз задавать один и тот же уточняющий вопрос. С точки зрения обычного пользователя диалог стал короче и естественнее.
Но автоматический тест об этом не знал.
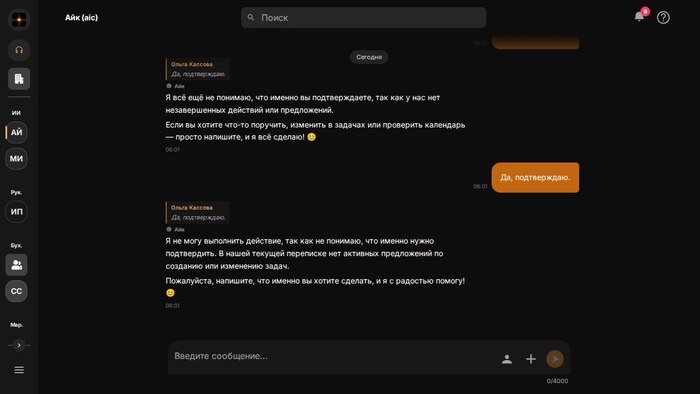
Он продолжал действовать по старому сценарию и отправлять одну и ту же фразу:
Тест: Да, подтверждаю.
Агент: Я не понимаю, что именно вы подтверждаете.
Тест: Да, подтверждаю.
Агент: В нашей переписке нет действий, которые необходимо подтвердить.
Тест: Да, подтверждаю.
Агент: Я всё ещё не понимаю, о чём идёт речь.
Со стороны это выглядело так, будто два собеседника застряли в совершенно бессмысленном споре.
Один упрямо подтверждает неизвестно что, а второй всё настойчивее просит объяснить, о каком действии вообще идёт речь.
Что на самом деле сломалось
Сам агент продолжал выполнять свою работу правильно.
Более того, после обновления он стал лучше удерживать контекст и избавился от лишнего вопроса, который раньше повторял после каждой операции.
Проблема оказалась в автоматическом тесте. Он был слишком жёстко привязан к конкретной структуре диалога:
агент задаёт определённый вопрос → тест отвечает определённой фразой.
Когда первая часть цепочки изменилась, фраза «Да, подтверждаю» потеряла смысл.
Для человека это очевидно. Односложное подтверждение понятно только тогда, когда перед ним есть конкретный вопрос.
Автоматический сценарий продолжал отправлять реплику просто потому, что она была прописана в его последовательности действий.
Как исправили сценарий
Вместо короткого ответа:
«Да, подтверждаю»
тест теперь отправляет более содержательное сообщение:
«Да, подтверждаю. Создавай следующую задачу».
Теперь фраза содержит не только подтверждение, но и само действие, которое необходимо выполнить.
Даже если предыдущая реплика агента немного изменится или отдельный вопрос исчезнет, смысл сообщения сохранится.
После обновления тест снова успешно прошёл весь сценарий и создал десять задач подряд.
Почему тестирование ИИ-агентов сложнее обычного
В классическом интерфейсе реакция системы обычно предсказуема.
Нажали кнопку — открылось окно. Заполнили форму — появилась запись. Изменили статус — обновилось значение.
В диалоге с ИИ между действием пользователя и итоговым результатом появляется дополнительный слой — естественный язык.
Агент может:
сформулировать ответ иначе;
задать дополнительный вопрос;
не задавать вопрос, который раньше считал обязательным;
лучше понять контекст и сразу перейти к действию;
по-другому интерпретировать слишком короткую реплику.
При этом конечный результат может оставаться правильным.
Поэтому тест, который проверяет только конкретные слова и точную последовательность сообщений, получается слишком хрупким. Любое изменение формулировки он может принять за ошибку.
Более надёжный подход — проверять не только текст ответа, но и пользовательскую цель:
создалась ли задача;
правильно ли определён исполнитель;
сохранился ли срок;
появилось ли нужное количество записей;
не потерял ли агент контекст после нескольких повторений.
Какие выводы можно сделать из этой истории
Во-первых, изменение системных инструкций ИИ-агента фактически меняет интерфейс общения с ним. Даже если кнопки, формы и внутренние функции остались прежними, пользовательский путь уже может выглядеть иначе.
Во-вторых, сообщения автоматического пользователя должны содержать достаточно контекста. Фраза «Да» работает только рядом с конкретным вопросом. Фраза «Да, создавай следующую задачу» остаётся понятной сама по себе.
В-третьих, падение теста не всегда означает ухудшение продукта. Иногда тест просто описывает устаревшее поведение.
Но это не значит, что такой тест бесполезен. Наоборот, он показывает, что вместе с системой должна развиваться и методика её проверки.
Каждая найденная ошибка, странный диалог или новый пользовательский сценарий становится ещё одной проверкой для следующих версий.
Полностью исключить неожиданные ситуации в сложной системе невозможно. Зато можно сделать так, чтобы каждая обнаруженная странность больше не оставалась незамеченной.
А иногда в процессе получить переписку, в которой ИИ-агент несколько сообщений подряд пытается выяснить у автоматического теста, что тот так настойчиво подтверждает.
При выборе языковой модели для бизнеса легко попасть в ловушку простой логики: чем больше параметров, тем лучше результат.
На практике такой подход может привести к неоправданным затратам на оборудование, более медленной работе системы и усложнению локального развёртывания. При этом крупная модель далеко не всегда оказывается сильнее компактной именно в тех задачах, ради которых компания внедряет искусственный интеллект.
Особенно заметна эта проблема в профессиональных областях. Модель может уверенно отвечать на общие вопросы, но заметно хуже справляться с правом, медициной, финансами, энергетикой или закупками.
Чтобы проверить, насколько современные open-source модели готовы к реальной отраслевой работе, команда R&D.Pro провела сравнительное исследование 15 больших языковых моделей размерностью от 8 до 120 млрд параметров.
Почему обычных рейтингов LLM недостаточно
Большинство популярных бенчмарков проверяет языковые модели на англоязычных заданиях общего характера: знании фактов, логике, понимании текста и способности продолжить заданную последовательность.
Такие тесты помогают сравнить базовые возможности моделей, но не дают ответа на главный вопрос бизнеса:
Насколько хорошо конкретная модель справится с профессиональными задачами нашей компании?
Например, высокий результат в общем рейтинге ещё не означает, что модель будет одинаково хорошо разбираться в бухгалтерском учёте, нормативных требованиях, медицинской документации и производственных процессах.
Кроме того, многие публичные рейтинги не учитывают:
различия между профессиональными областями;
устойчивость модели при усложнении вопросов;
влияние настроек генерации;
возможность локального запуска;
соотношение качества и вычислительных затрат.
Поэтому для исследования был разработан собственный русскоязычный многодоменный бенчмарк, ориентированный не на общие знания, а на реальные профессиональные задачи.
Как было устроено исследование
В тестировании участвовали 15 open-source LLM и 16 конфигураций — одна из моделей запускалась в двух вариантах квантизации.
Размер моделей составлял от 8 до 120 млрд параметров. В исследование вошли представители семейств Qwen, Gemma, GPT-OSS, GLM, Phi, Nemotron, Mistral и других.
Для проверки был сформирован набор из 1 440 вопросов, охватывающий 16 профессиональных направлений:
энергетика;
право;
финансы;
клинические процессы здравоохранения;
терапевтическая практика;
фармацевтика;
строительство;
DevOps;
логистика;
маркетинг;
HR;
охрана труда;
сельское хозяйство;
продажи;
закупки и тендеры;
производственный инжиниринг.
Для каждого направления подготовили по 90 вопросов: 30 базовых, 30 продвинутых и 30 экспертных.
Такой подход позволил оценить не только общий уровень модели, но и то, насколько сильно ухудшается качество её ответов по мере усложнения профессиональной задачи.
Как оценивались ответы
Один из самых сложных вопросов при тестировании нейросетей — кто и как должен определять правильность ответа.
В исследовании использовалась двухэтапная система.
Сначала ответы оценивали три независимые модели-судьи:
GLM-4.7-Flash;
DeepSeek-V4-Flash;
GPT-OSS-120B.
Каждый ответ сравнивался с эталонным по десятибалльной шкале. При этом названия тестируемых моделей были скрыты от судей: ответы передавались в обезличенном виде.
После автоматической проверки проводилась независимая экспертная верификация специалистами-практиками соответствующих направлений. Эксперты проверяли корректность самих вопросов, оценивали ответы моделей и сопоставляли свои выводы с результатами автоматических судей.
Важно, что авторы исследования не скрывают ограничений методики. Экспертная верификация носила качественный характер: формальные коэффициенты статистического согласия в этой работе не рассчитывались. Поэтому результаты используются как практическая доказательная база, а не как утверждение об абсолютном превосходстве одной модели над всеми остальными.
Результат первый: размер модели больше не определяет качество
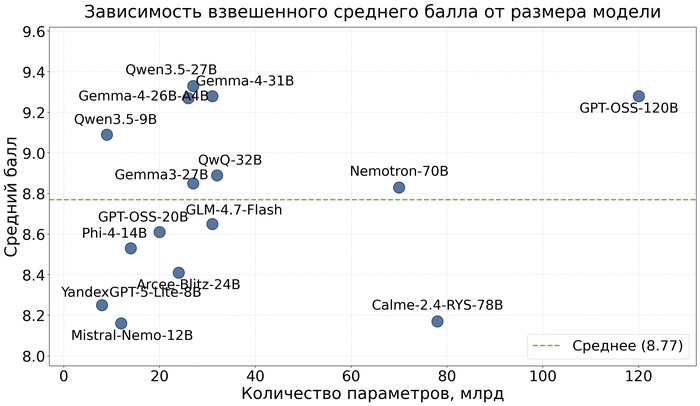
Главный вывод исследования — современные компактные модели способны показывать результат, сопоставимый с гораздо более крупными системами.
Наивысший взвешенный балл получила Qwen3.5-27B:
Qwen3.5-27B — 9,33 балла;
Gemma-4-31B — 9,28 балла;
GPT-OSS-120B — 9,28 балла;
Gemma-4-26B-A4B — 9,27 балла.
Таким образом, модели размерностью 26–31 млрд параметров оказались в одной группе с моделью на 120 млрд параметров.
Зависимость итогового балла от размера модели. Количество параметров само по себе не гарантирует более высокого результата. Источник: исследование Э. Р. Панкратова и А. Б. Якимова.
Разрыв между четырьмя лидерами составил не более 0,06 балла. Он сопоставим с возможной погрешностью оценки, поэтому говорить о статистически подтверждённом превосходстве одной модели внутри этой группы было бы некорректно.
Но практический вывод очевиден: для получения высокого качества бизнесу не всегда требуется самая крупная и ресурсоёмкая LLM.
Результат второй: важен не лучший ответ, а устойчивость
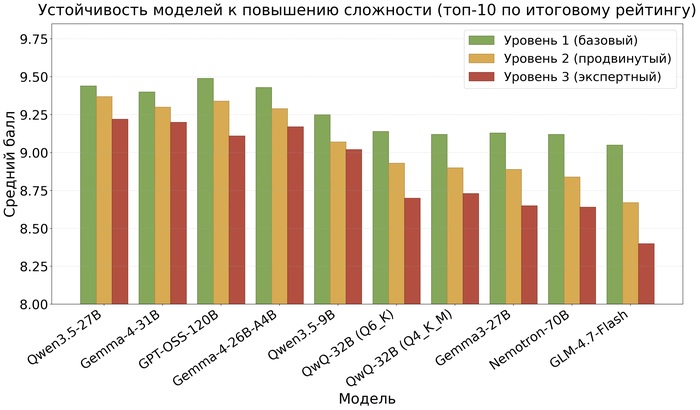
Модель может хорошо отвечать на простые вопросы, но резко терять качество при переходе к экспертным задачам.
Для корпоративного применения это особенно опасно. На базовом запросе ошибка может быть заметна сразу, а сложный профессиональный ответ нередко звучит убедительно даже тогда, когда содержит неточности.
Наиболее устойчивыми к усложнению вопросов оказались:
Gemma-4-31B — снижение на 0,21 балла;
Qwen3.5-27B — на 0,22;
Qwen3.5-9B — на 0,23;
Gemma-4-26B-A4B — на 0,26.
Как меняется качество ответов при переходе от базовых к экспертным профессиональным вопросам. Источник: исследование Э. Р. Панкратова и А. Б. Якимова.
Для сравнения, у отдельных моделей снижение превышало один балл.
Это означает, что при выборе LLM недостаточно смотреть только на средний результат. Для отраслевых систем необходимо отдельно проверять, как модель ведёт себя на наиболее сложных и ответственных запросах.
Результат третий: универсального лидера не существует
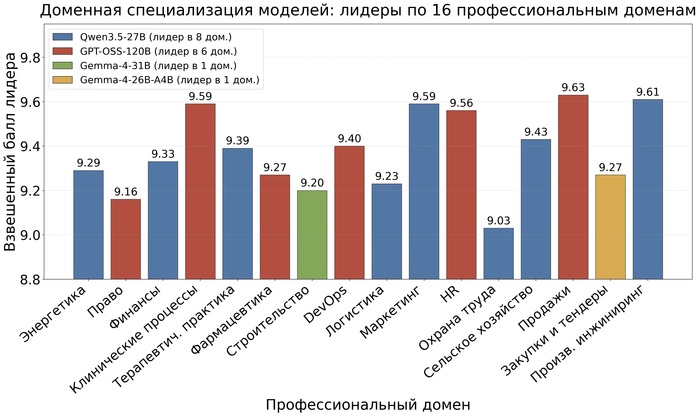
Исследование показало выраженную специализацию моделей.
Qwen3.5-27B получила лучшие результаты в восьми профессиональных направлениях, включая финансы, энергетику, логистику, маркетинг и производственный инжиниринг.
GPT-OSS-120B стала лидером в шести областях, среди которых право, клинические процессы, фармацевтика, DevOps, HR и продажи.
Gemma-4-31B показала лучший результат в строительстве, а Gemma-4-26B-A4B — в закупках и тендерах.
Распределение моделей-лидеров по 16 профессиональным областям. Ни одна LLM не показала лучший результат во всех доменах. Источник: исследование Э. Р. Панкратова и А. Б. Якимова.
Ни одна модель не заняла первое место во всех 16 направлениях.
Этот результат ставит под сомнение идею о том, что для всей компании достаточно выбрать одну «самую умную» нейросеть и использовать её для любых процессов.
Более эффективным может быть другой подход: применять разные модели в зависимости от задачи, профессиональной области и требований к ресурсам.
Результат четвёртый: настройки генерации влияют на качество
Отдельная часть исследования была посвящена параметрам генерации.
На представительной подвыборке моделей повышение параметра temperature с 0 до 0,8 привело к снижению среднего результата примерно на 0,2–0,3 балла.
Для творческих задач более высокая вариативность может быть полезной. Но в профессиональной работе, где важны точность и воспроизводимость, детерминированный режим оказался предпочтительнее.
Это ещё раз показывает, что качество корпоративной ИИ-системы зависит не только от выбранной модели. Имеют значение архитектура, параметры запуска, контекст, данные и способ оценки результата.
Что это означает для бизнеса
Исследование позволяет сформулировать несколько практических принципов.
Во-первых, выбирать модель только по количеству параметров нерационально. Компактная современная LLM может дать сопоставимое качество при меньших требованиях к инфраструктуре.
Во-вторых, модель необходимо тестировать на задачах той отрасли, в которой она будет применяться. Общий рейтинг не гарантирует качественной работы в конкретном профессиональном домене.
В-третьих, для сложных корпоративных систем может быть оправдана мультиагентная архитектура. В ней разные модели используются для разных ИИ-ролей и процессов: одна — для юридического анализа, другая — для финансовых задач, третья — для работы с медицинской или технической документацией.
В-четвёртых, open-source модели дают компаниям возможность разворачивать ИИ локально, контролировать инфраструктуру и не передавать корпоративные данные во внешние сервисы.
Исследование опубликовано в научном журнале
Научная работа опубликована в журнале «Программные системы и вычислительные методы», 2026 год, № 3, страницы 40–60.
Название работы: «Сравнительное тестирование open-source LLM на задачах профессиональных предметных областей: многодоменный бенчмарк с мультисудейской и экспертной оценкой».
Авторы:
Эдуард Рашитович Панкратов — генеральный директор ООО «ПРОФТЕХ».
Александр Борисович Якимов — программист ООО «ПРОФТЕХ».
DOI: 10.7256/2454-0714.2026.3.80458 EDN: NAGOPN
Ознакомиться с полной версией научной работы: Панкратов Э.Р., Якимов А.Б. Сравнительное тестирование open-source LLM на задачах профессиональных предметных областей: многодоменный бенчмарк с мультисудейской и экспертной оценкой // Программные системы и вычислительные методы. 2026. № 3. С. 40-60. DOI: 10.7256/2454-0714.2026.3.80458 EDN: NAGOPN URL: https://nbpublish.com/library_read_article.php?id=80458