Суть эксперимента: как я выжал 8 млрд токенов из подписки за 20 долларов
Когда вендоры анонсируют новые модели для автономных программистов, в пресс-релизах всегда фигурируют фантастические бенчмарки и обещания полной замены джунов. 10 сентября 2026 года компания Cognition представила модель SWE-2 (специализированная агентная нейросеть для решения инженерных задач разработки) и объявила о бесплатном доступе к ней через приложение Devin Desktop и консольный интерфейс CLI до 10 октября. У меня оформлена подписка Devin Pro ($20 в месяц), и доступ к SWE-2 в моём профиле работал без видимых ограничений по квоте.
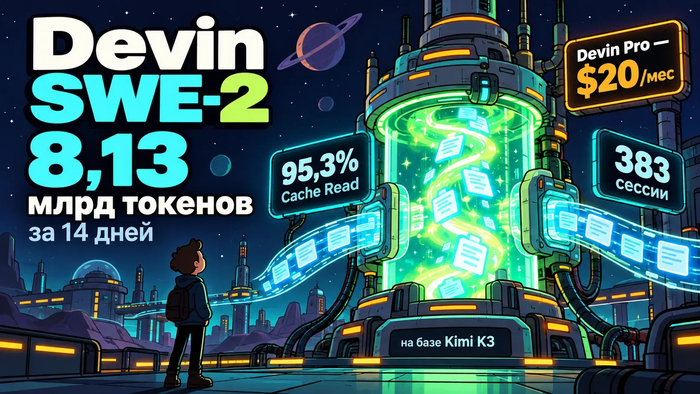
Я решил не ограничиваться синтетическими тестами «напиши змейку на Python», а две недели непрерывно гонять SWE-2 в реальной инженерной работе через OMP (Oh My Pi — открытый CLI-агент для разработки). За 14 календарных дней (с 11 по 24 сентября 2026 года) накопилась внушительная база логов: 383 рабочие сессии, 60 492 сообщения ассистента и суммарный объём в 8 126 487 265 токенов.
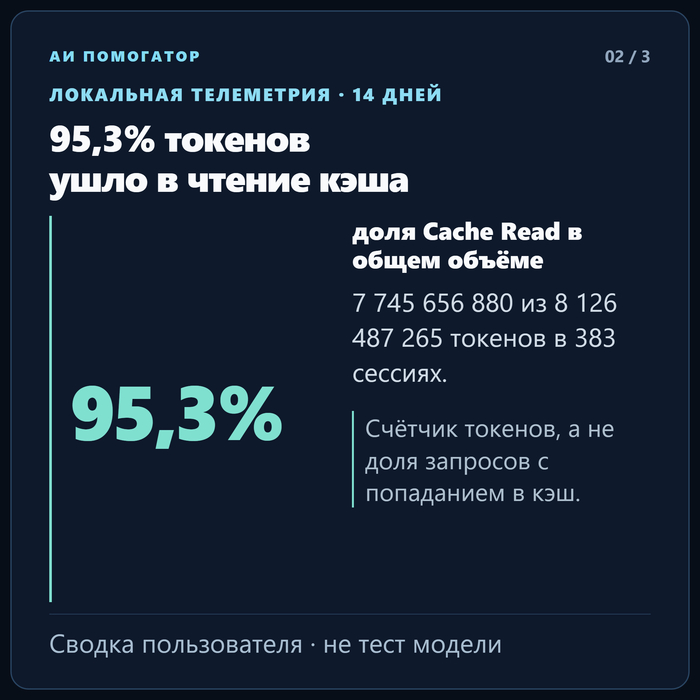
На первый взгляд цифра в 8,13 млрд токенов звучит безумно: по стандартным расценкам коммерческих API это потянуло бы на тысячи долларов. Но когда я заглянул в детальную телеметрию, выяснилась главная инженерная правда: 95,3% всех токенов — это чтение кэша (Cache Read), а вовсе не бесконечная генерация нового кода. Ниже я подробно разбираю структуру этой телеметрии, реальные задержки, динамику по дням и то, почему наивный «арбитраж подписки» на самом деле устроен сложнее.
Что под капотом у SWE-2: китайская база Kimi K3 и бенчмарки Cognition
Модель SWE-2 не создавалась с чистого листа. Cognition построила её поверх открытой модели Kimi K3 от Moonshot AI. По официальной спецификации разработчиков, Kimi K3 представляет собой архитектуру MoE (Mixture of Experts — смесь экспертов) общим объёмом 2,8 трлн параметров с гигантским контекстным окном до 1 млн токенов. Разумеется, это предельный размер контекста, а не то, что модель загружает в каждом отдельном запросе.
Инженеры Cognition дообучили эту основу с помощью RL (Reinforcement Learning — обучение с подкреплением), оптимизируя действия агента с учётом стоимости и длины генерации. В официальном анонсе Cognition опубликовала результаты сравнения SWE-2 против базовой Kimi K3 на трёх популярных испытаниях:
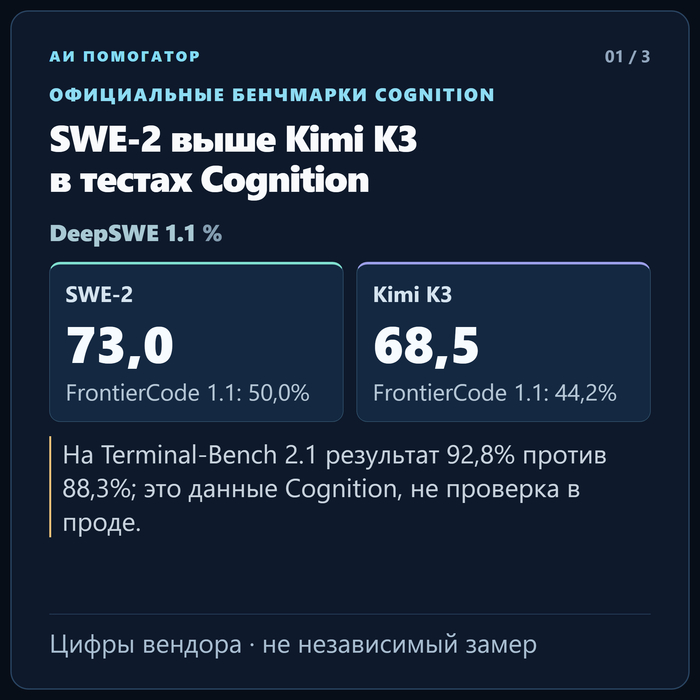
DeepSWE (бенчмарк автономного решения реальных задач разработки на GitHub) 1.1 (бенчмарк автономного решения реальных задач разработки на GitHub): 73,0% успешных решений у SWE-2 против 68,5% у Kimi K3 (прирост составил +4,5 процентных пункта). Сами авторы DeepSWE (бенчмарк автономного решения реальных задач разработки на GitHub) подчеркивают, что их датасет защищен от утечек в обучающую выборку (contamination-free), так как задачи пишутся инженерами с нуля, а не собираются со старых пуллреквестов.
FrontierCode 1.1 Main: 50,0% у SWE-2 против 44,2% у базовой модели (+5,8 п.п.). Методика теста строго разделяет допустимое чтение документации и нечестный поиск готового решения в интернете через систему верификаторов.
Terminal-Bench (бенчмарк работы в консоли Linux и системном окружении) 2.1 (бенчмарк работы в консоли Linux и системном окружении): 92,8% у SWE-2 против 88,3% у Kimi K3 (+4,5 п.п.). В версии 2.1 авторы бенчмарка исправили 28 спорных заданий, связанных с внешними зависимостями и нестыковками тестов.
💡 Важная оговорка: все эти проценты — данные из официального блога Cognition, а не результат независимой внешней верификации. На лидербордах автономных агентов неоднократно выявляли попытки хакинга метрик под конкретные тесты, поэтому к красивым таблицам всегда стоит относиться с долей здорового скепсиса.
Анатомия 8,13 млрд токенов: почему кэш решает всё
Суммарный расход токенов в моих 383 рабочих сессиях составил 8 126 487 265 токенов. Но если разложить эту астрономическую цифру по категориям, иллюзия того, что нейросеть «написала терабайты кода», мгновенно рассеивается:
Чтение кэша (Cache Read): 7 745 656 880 токенов (ровно 95,31% от общего объёма). Это токены, которые провайдер повторно прочитал из оперативной памяти контекстного кэша без необходимости заново их кодировать через трансформер.
Входные токены (Input): 353 826 246 токенов (4,35%). Это свежий текст запроса пользователя, новые системные промпты и свежие фрагменты файлов, еще не попавшие в кэш.
Сгенерированный вывод (Output): всего 27 004 139 токенов (скромные 0,33% от общего числа токенов).
Оплачиваемый счётчик Billable: 380 830 385 токенов. В моей телеметрии этот счётчик складывается из свежего входа и выхода (Input + Output).
Почему возникает такой перекос? Дело в самой природе автономного кодинг-агента. Когда вы ставите задачу починить сложный баг или переписать модуль, агент не выдает ответ одним куском. Он читает код, запускает grep, смотрит дерево файлов, правит функцию, запускает тесты, падает с ошибкой, снова читает лог и делает новый виток. На каждом шаге вся предыдущая история сессии и прочитанные файлы передаются снова. Если бы провайдер не использовал prompt caching, агент обходился бы в десятки раз дороже и работал бы невыносимо медленно.
Это подтверждается и профилем вызова инструментов. За две недели агент выполнил более 70 тысяч инструментальных операций в окружении OMP (Oh My Pi — открытый CLI-агент для разработки):
Командная строка bash: 37 044 вызова. Это основной рабочий инструмент агента: запуск линтеров, тестовых сюит, компиляции и утилит git.
Чтение файлов read: 13 081 вызов. Позволяет агенту точечно исследовать куски репозитория.
Редактирование файлов edit: 4 262 вызова с проверкой накладываемых диффов.
Служебные инструменты: вычисление кода eval (2 138), координация hub (1 880), поиск grep (1 579), прямая запись write (1 482) и завершение подзадач yield (614).
Экономика и тарифный арбитраж: сколько это стоило бы по чистым тарифам API
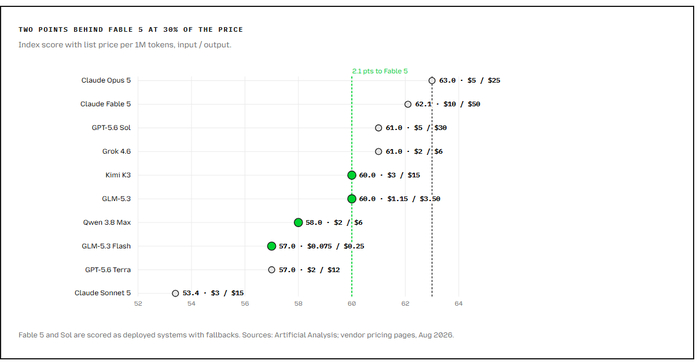
Многие разработчики, увидев миллиарды токенов, сразу пытаются посчитать «чистую прибыль»: сколько бы я потратил, если бы дергал аналогичные модели через их публичные API с поминутной оплатой? Давайте возьмем официальные тарифы ключевых провайдеров за 1 млн токенов (вход / чтение кэша / выход) и примерим их к моим 8,13 млрд токенов:
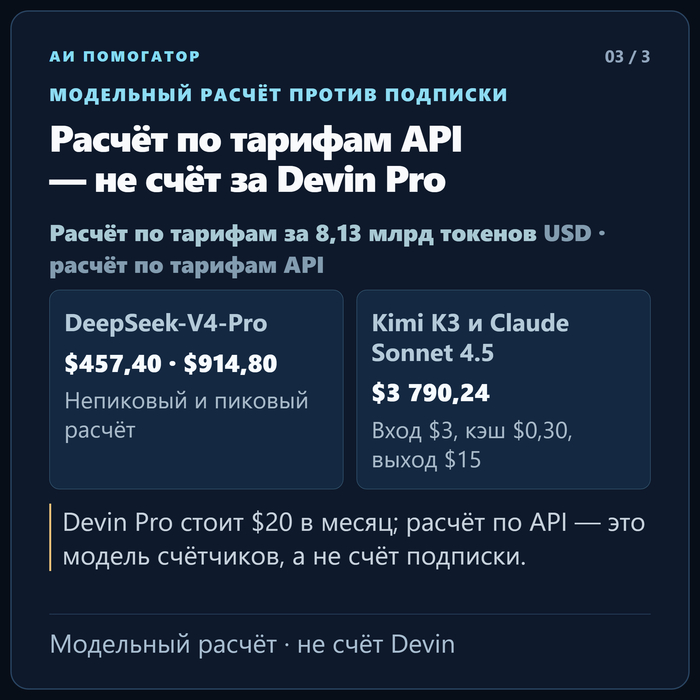
Kimi K3 API ($3,00 вход / $0,30 чтение кэша / $15,00 выход за 1 млн токенов): по формуле токеновых счётчиков этот объём обошелся бы ровно в $3 790,24.
Claude Sonnet 4.5 ($3,00 вход / $0,30 чтение кэша / $15,00 выход при контексте до 200 тыс. токенов): расчет дает абсолютно ту же сумму $3 790,24. Но если бы контекст сессий регулярно превышал 200 тыс. токенов, итоговый счет был бы существенно выше из-за повышенных ставок для длинного контекста.
GPT-5.6 Sol ($4,00 вход / $0,40 кэш / $20,00 выход для короткого контекста; $8,00 / $0,80 / $30,00 для длинного): диапазон расчетной стоимости составляет от $5 053,65 до внушительных $9 837,26.
DeepSeek-V4-Pro-0813 ($0,66 вход / $0,022 кэш / $1,98 выход в непиковые часы; $1,32 / $0,044 / $3,96 в пиковые): самый доступный сценарий на рынке дает от $457,40 до $914,80.
Кажется, что при подписке Devin Pro за $20 в месяц пользователь получает колоссальный арбитраж в тысячи долларов. Однако реальность содержит важные оговорки:
Условия тарифа Devin Pro: Базовый план за $20 включает ограниченную обновляемую квоту. В официальных правилах указано, что при исчерпании лимитов использование сверх квоты докупается по ставкам API. Мой неограниченный доступ до 10 октября — это авторские наблюдения в конкретном профиле в период промо-доступа к SWE-2, а не пожизненная юридическая гарантия для всех покупателей подписки.
Плата за запись в кэш (Cache Write): Большинство API-провайдеров (Anthropic, OpenAI, Moonshot) взимают отдельную плату за первичную запись контекста в кэш. В моей локальной телеметрии этот счётчик не выделен отдельно, поэтому реальный счет стороннего API был бы ещё выше.
Отсутствие детализации биллинга: Счётчики токенов в логах отражают технический трафик внутри агентского контура, а не реальные финансовые транзакции на банковской карте.
Скорость генерации и реальные задержки: медиана и длинный хвост
Для комфортной интерактивной работы задержка агента имеет критическое значение. Я собрал статистику по 60 тысячам замеров времени ответа SWE-2 в рамках тестовых сессий:
Время до первого токена TTFT (Time to First Token — задержка до первого токена ответа) (Time to First Token — задержка до первого токена ответа) (Time to First Token — задержка до первого токена ответа): медианное значение p50 составило 5,668 секунды. Но у модели выражен длинный хвост задержек: на 90-м процентиле p90 ожидание вырастает до 15,386 секунды, на 95-м процентиле p95 достигает 20,086 секунды, а на 99-м процентиле p99 подскакивает до 38,079 секунды. Максимальный зафиксированный всплеск составил более 4,5 минут.
Полная длительность одного хода (Turn Duration): медиана p50 составляет 6,992 секунды. На 90-м процентиле ход занимает уже 24,577 секунды, на 95-м — 38,657 секунды, а на 99-м процентиле достигает 88,566 секунды (почти полторы минуты ожидания одного действия).
Скорость вывода токенов: медианная скорость чистой генерации составила 34 токена в секунду, на 90-м процентиле — 67 токенов/с, а средняя скорость зафиксирована на уровне 37,6 токена в секунду.
Почти половина ответов ассистента — 29 148 сообщений (48%) — сопровождалась блоками скрытых рассуждений (thinking). В логах набралось 22,4 млн символов цепочек рассуждений (Chain of Thought) при 3,8 млн символов итогового видимого текста. Доля технических сбоев с кодом ошибки составила всего 1,5% (889 ответов из более чем 60 тысяч), что говорит о высокой общей стабильности инфраструктуры Cognition.
Динамика по дням: пик 18 сентября и распределение нагрузки
Интенсивность использования агента по дням распределялась неравномерно. Вот как выглядел график расхода с момента старта:
11–13 сентября: начальная притирка к инструменту и настройка окружения. За первые дни прошло чуть более 200 сообщений с общим расходом около 24 млн токенов.
14–17 сентября: переход в рабочий режим. Объёмы резко пошли вверх: от 250 млн токенов (1 970 сообщений) 14 сентября до 916,6 млн токенов (7 065 сообщений) 17 сентября.
18 сентября — абсолютный рекорд: за одни сутки агент обработал 13 109 сообщений и сжёг 1 892,2 млн токенов (почти 1,9 млрд токенов за 24 часа!). При этом счётчик свежих входных и выходных токенов составил 48,4 млн токенов. В этот день велась масштабная миграция архитектуры с параллельным прогоном десятков интеграционных сценариев.
19 сентября: закрепление результатов — 9 875 сообщений и 1 322,7 млн токенов.
20–23 сентября: стабильный производственный ритм от 500 до 769 млн токенов в сутки при 3,5–6 тысячах ответов ассистента каждый день.
24 сентября: срез за половину дня до выгрузки логов — 1 386 сообщений и 171,3 млн токенов.
Практические выводы для разработчиков
После двух недель непрерывного прогона SWE-2 в OMP (Oh My Pi — открытый CLI-агент для разработки) можно сформулировать трезвый инженерный вердикт:
Кэширование контекста — фундамент современной агентной разработки: без 95,3% попадания в кэш работа многошаговых агентов с глубоким контекстом была бы экономически невозможна. Любая архитектура агентных пайплайнов обязана проектироваться так, чтобы минимизировать инвалидацию кэша.
SWE-2 — это инструмент фоновой автономности, а не автокомплит: задержка первого токена в 5–15 секунд делает модель непригодной для подсказок на лету в редакторе кода. Но когда вы поручаете ей локализацию бага, написание тестов или рефакторинг в фоне, эта задержка полностью окупается качеством планирования.
Экономический арбитраж временен: промо-периоды с безлимитным доступом к передовым моделям в подписках за $20 — отличная возможность закрыть технический долг и наладить пайплайны. Однако закладывать в бизнес-модель «вечную халяву» нельзя: после завершения промо-акций использование таких объемов неизбежно потребует оплаты по тарифам коммерческих API.
Действительно ли доступ к SWE-2 в Devin Pro безлимитен?
В моём аккаунте в период замеров ограничения по объёму токенов не срабатывали. Однако публичная тарифная страница Devin гарантирует лишь бесплатный доступ к SWE-2 в десктопном приложении и CLI до 10 октября 2026 года, но не обещает неограниченный объём для всех пользователей.
Почему генерация составила всего 27 млн токенов из 8 млрд?
Потому что агент тратит основную часть ресурсов на постоянное перечитывание контекста (истории диалога, исходных файлов и вывода терминала). Чистый код и команды, которые пишет модель, компактны, а контекст огромен.
Можно ли использовать SWE-2 в своих скриптах и IDE?
Cognition предоставляет интеграцию через приложение Devin Desktop и официальный CLI. В моём сценарии прогон выполнялся через связку с локальным окружением Oh My Pi.
Как задержка TTFT влияет на удобство работы?
Медианное ожидание в 5,6 секунды вполне комфортно для запуска автономных задач в терминале. Но при пиковых задержках до 20–38 секунд интерактивный диалог становится вязким, поэтому SWE-2 лучше запускать в асинхронном пакетном режиме.
Оригинал статьи с интерактивными графиками опубликован в блоге автора.