0 просмотренных постов скрыто


Тюнинг сетевого стека Linux через sysctl

Тюнинг сетевого стека Linux через sysctl помогает, когда передача упирается в регулируемый им лимит. Ниже – ориентиры для TCP на VPS: что проверять в бенчмарке сетевых sysctl Linux и какие параметры дают эффект.
Какие сетевые sysctl дают измеримый прирост?
Эффект дают параметры, которые снимают подтверждённое ограничение: например, предел TCP-буфера или очереди новых соединений. Прирост нужно проверить на той же нагрузке вместе с задержками и ошибками. Если скорость ограничивает процессор, приложение или канал провайдера, увеличение сетевых лимитов само по себе эту проблему не решит.
Сначала симптом
Бенчмарк сетевых sysctl Linux должен воспроизводить проблему: медленную передачу файла или отказы при наплыве клиентов. Исходный прогон показывает скорость, число ошибок и повторных передач TCP, загрузку ядер. Для запросов приложения нужны медиана и p99 – граница времени ответа для 99% запросов.
Где задерживается пакет
В VPS с virtio-net пакет проходит через сокет, стек гостя, виртуальный адаптер и сеть хоста. Команда ss -tim показывает состояние TCP и память сокета, nstat – сетевые счётчики, tc -s qdisc – статистику очередей отправки. Sysctl для пропускной способности действует лишь на своём участке: sysctl гостя не меняет настройки хоста.
Когда нужны буферы
Настройка TCP-буферов Linux имеет смысл, если их лимит мешает передаче. Ориентир bandwidth-delay product – скорость канала, умноженная на RTT, время пути туда и обратно. При 1 Гбит/с и 50 мс это 6,25 МБ данных в пути, а не готовый размер буфера.
Максимумы tcp_rmem и tcp_wmem нужно сопоставить с ss -tim и настройками приложения. Если автоматическая настройка буферов не достигает предела, его увеличение не поможет.
Какие популярные значения являются карго-культом?
Огромные буферы и очереди без проверки их заполнения – самый частый случай копирования чужой конфигурации. Больший лимит не ускорит обработку данных приложением. При перегрузке длинная очередь может лишь увеличить ожидание, поэтому полезность изменения определяют по скорости, ошибкам и задержкам при одинаковой нагрузке, а не по самому значению.
Очередь новых соединений
Для тюнинга somaxconn и backlog важны оба ограничения: net.core.somaxconn и значение listen() приложения. Они ограничивают очередь установленных соединений, ожидающих accept(). Рост ListenOverflows и ListenDrops в nstat – повод проверить её. Число полуоткрытых соединений ограничивает tcp_max_syn_backlog.
Что проверить у BBR
Бенчмарк BBR в Linux требует одинаковых RTT, потерь и скорости канала. Алгоритм соединения виден в ss -ti. Настройки очереди отправки (qdisc) при сравнении должны совпадать. Кроме скорости, важны задержки и доля канала, оставшаяся другим потокам. Смена алгоритма не гарантирует выигрыша.
По одному изменению
Netem задаёт задержку и потери на отдельном стенде. Для TCP его размещают на входе принимающего узла. Повторный исходный прогон помогает отличить эффект настройки от колебаний сети. Без устойчивой разницы результат нейтральный, а ухудшение задержек или ошибок – причина отката.
Как провести корректный тест до и после изменений?
1. Сохранить версию ядра, значения sysctl, нагрузку и исходные метрики.
2. Изменить один параметр и повторить прогоны при тех же условиях.
3. Вернуть прежнее значение, сравнить скорость, ошибки, p99 latency и нужный счётчик.
Если предел находится на хосте
iperf3 проверяет передачу данных, но не заменяет тест приложения. Провайдер может проверить потери на адаптерах, очереди и загрузку обработки пакетов на хосте. Из гостя эти данные видны не полностью.
Как закрепить результат
Значения нужно читать и менять в network namespace – сетевом окружении нужного процесса. Пробное применение на одном сервере должно дать повторяемое улучшение до записи в /etc/sysctl.d/. Для отката нужно вернуть прежнее значение через sysctl -w и убрать постоянную настройку из файла.
Тюнинг сетевого стека Linux через sysctl стоит ограничить изменениями с подтверждённым эффектом и проверенным откатом.
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanykcF7Qw
Показать полностью
1
Измерение лага репликации PostgreSQL под нагрузкой
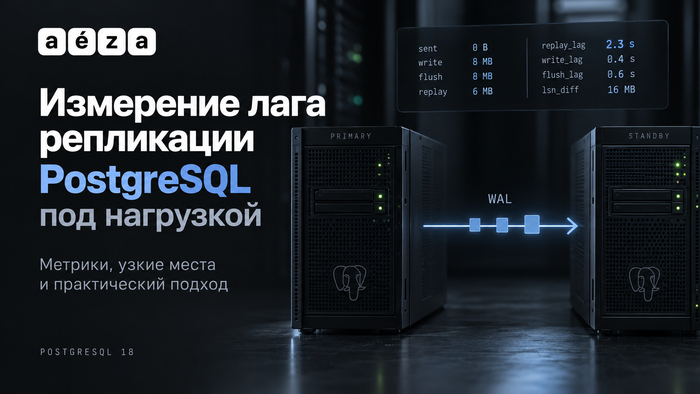
Измерение лага репликации PostgreSQL под нагрузкой помогает найти этап, где копится WAL. Разберём физическую репликацию PostgreSQL 18.
Какая метрика лага отражает задержку, видимую пользователю?
На асинхронной реплике replay_lag приближённо показывает задержку появления последних изменений. Отсчёт идёт от сохранения WAL на основном сервере до получения подтверждения его применения на реплике. Для проверки конкретной транзакции отслеживают появление её контрольной записи на реплике в новом снимке данных.
sent, write, flush и replay как разные виды отставания
Для бенчмарка лага репликации PostgreSQL нужны четыре позиции WAL: sent – отправлено, write – записано в ОС, flush – сохранено на диск, replay – применено. Основной сервер показывает их в pg_stat_replication, получая последние три от реплики. pg_wal_lsn_diff считает разрывы в байтах: текущий LSN–sent, sent–write, write–flush, flush–replay.
Топология, слоты и режим подтверждения транзакций
На лаг в pg_stat_replication влияют режим репликации и частота отчётов. Поэтому до теста фиксируют версии, число реплик, synchronous_standby_names, synchronous_commit и слоты. Удержание WAL слотами ограничивает max_slot_wal_keep_size. Лимит проверяется при checkpoint.
Одна временная шкала primary и standby
Опрос обоих серверов пишет LSN и разрывы в CSV с шагом 1 с и метками UTC. Часы узлов синхронизируют. pg_last_xact_replay_timestamp() даёт время commit/abort последней применённой транзакции с основного сервера. При простое её возраст растёт даже у догнавшей реплики, lag может стать NULL.
Как создать и измерить лаг репликации под нагрузкой?
На тестовом стенде постепенно увеличивают нагрузку записи через pgbench и регулярно снимают позиции WAL с обоих серверов. Разрывы между этапами показывают, где растёт очередь, а метрики сети, CPU и дисков помогают найти причину. Если мощности хватает, нагрузка может вообще не вызвать заметного отставания.
Рост WAL, постоянная нагрузка и прекращение записи
В CSV отмечают фазы pgbench. Для расчёта скорости WAL прирост текущего LSN делят на интервал между замерами. Лаг LSN PostgreSQL выражают в байтах. Чтобы измерить время catch-up, после остановки записи фиксируют конечный LSN и ждут, пока реплика его применит.
Когда sent–write растёт из-за сети или receiver
За этим разрывом могут стоять сеть, запись WAL или задержка отчёта реплики. Причину ищут по пропускной способности, потерям и работе walreceiver. p99 лага streaming replication считают отдельно по фазам, указав единицы и шаг опроса.
Где именно копится очередь
Оба разрыва живут на реплике, но упираются в разное: первый в диск, второй в применение WAL.
Как разделить сетевое, дисковое и replay-узкие места?
1. sent–write проверяют вместе с сетью и приёмником WAL: сам разрыв не доказывает сетевую проблему.
2. write–flush сопоставляют с задержками fsync и очередью диска реплики.
3. Для flush–replay проверяют CPU, I/O и конфликты запросов, учитывая отставание flush.
При synchronous replication synchronous_commit задаёт условие завершения COMMIT: remote_apply требует применения WAL на выбранных синхронных репликах.
Почему standby может задерживать применение WAL
Задержка replay WAL под нагрузкой возможна и при стабильном WAL generation rate: конфликт с запросом задерживает применение WAL. Увеличение max_standby_streaming_delay продлевает ожидание. Отмены запросов видны в pg_stat_database_conflicts. hot_standby_feedback уменьшает конфликты очистки ценой накопления старых версий строк на основном сервере.
Пороги, привязанные к байтам и времени восстановления
Порог потери данных задают по RPO, а отставание данных и время catch-up ограничивают отдельно. Сохранённый на диск реплики WAL применяется и после отказа основного сервера. Причину уточняют по network RTT, CPU и I/O обоих узлов.
Измерение лага репликации PostgreSQL под нагрузкой даёт основу для оповещений по этапам: важны размер очереди и скорость её роста. Оповещение по одному порогу lag в секундах такой картины не даёт.
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanyktXdb1
Показать полностью
1

Продолжение поста «Как написать DNS прокси для себя и настраивать через REST API»3
Очередное обновление сервиса DNSO v0.2.0. Для тех кто еще не знаком - это сервис для удобного управления DNS зонами и записями в локальных вычислительных сетях с удобным web интерфейсом.
Новое обновление добавляет метрики в приложение. Теперь можно к контейнеру подключить prometheus и собирать метрики, отслеживать стандартные go-метрики, некоторые кастомные метрики для понимания куда и откуда идет трафик (upstream-exchanges, localZone и т.п.)
Что нового
Локальные зоны кэшируются в DNS и поиск локальных производится по локальному кэшу вместо поиска в базе данных
Заменены все логи на структурированные
Добавлены метрики в кэш, upstream excanger и REST API
Логирование переведено на slog
Добавлен Prometheus в docker-compose (для разработки)
Конфигурация вынесена в отдельный пакет
Добавлен porometheus scrap метод (по умолчанию порт 3010, GET /metrics)
Что планируется
Работа с метриками была в новинку, поэтому будет произведена работа по устранению избыточности некоторых метрик
В конфигах заранее будут добавлены примеры дашбордов
Небольшой рефакторинг хэндлеров DNS
Будет вестись подготовка к рефакторингу (планируется разбить обработчик на 3 слоя выдачи: локальные, кэш, апстрим)
Информация
Github репозиторий: https://github.com/vesh95/dnso
Просто подборка саунда, который вдохновлял все это время: https://music.yandex.ru/playlists/a3aa20b0-8d3a-4772-b883-96...
Показать полностью


Хаос, который я сам выбрал


Показать полностью
3
Как использовать VPS после покупки: сценарии для сайтов, ботов, API и мониторинга
VPS куплен, SSH-сессия открыта. У многих здесь возникает пауза: непонятно, с чего начать и под какую задачу настраивать VPS-сервер. Разберём пять практических сценариев того, как использовать VPS: хостинг сайтов, запуск ботов, размещение API, мониторинг и автоматизация. У каждого – конкретный стек, ориентиры по ресурсам и нюансы, которые лучше знать до начала настройки, а не в процессе. Реальные требования зависят от сложности проекта, нагрузки, выбранного стека и числа одновременно работающих сервисов.
Что даёт VPS и почему его берут
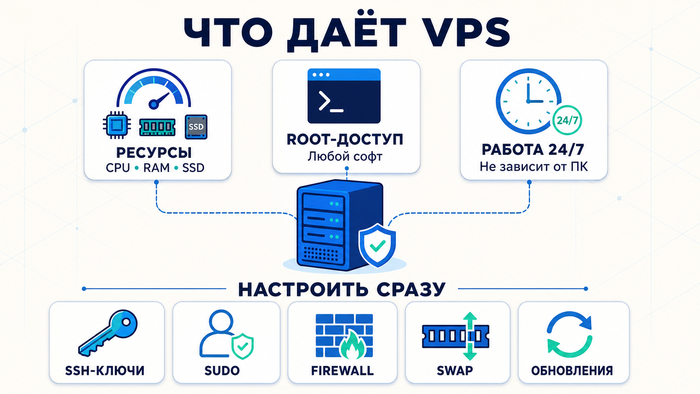
VPS-сервер отличается от shared-хостинга тремя вещами. Первое – у вас есть заявленные параметры тарифа: CPU, RAM, диск и сетевой канал. На качество работы всё ещё может влиять общая инфраструктура хоста, но изоляция здесь выше, чем на shared-хостинге. Второе – root-доступ: можно установить любой софт, выбрать версию PHP, настроить nginx под конкретную задачу. Третье – VPS-сервер работает круглосуточно без вашего участия, независимо от состояния вашего компьютера или интернета. На shared-хостинге чужая нагрузка может повлиять на соседние сайты, если провайдер плохо ограничивает ресурсы аккаунтов.
От облачных функций (AWS Lambda, Yandex Cloud Functions) VPS отличается предсказуемостью: нет cold-start задержек, нет тарификации за каждый вызов функции, нет ограничений по времени выполнения. Для задач с постоянными процессами: баз данных, ботов, мониторинга – VPS часто проще и предсказуемее, чем serverless-архитектура с оплатой за вызов. При низкой или нерегулярной нагрузке serverless может оказаться дешевле.
Базовая подготовка: что сделать сразу после покупки
Настройка VPS начинается не сразу с рабочего проекта, а с базовой конфигурации. Базовая настройка снижает риск классических проблем: открытого SSH, устаревших пакетов, лишних портов и нехватки памяти при пиковых нагрузках. Пропуск таких шагов может увеличить риск потерять сервер из-за брутфорса или случайной команды от root.
• SSH-ключи. Сгенерируйте пару через ssh-keygen, передайте публичный ключ через ssh-copy-id, отключите аутентификацию по паролю в sshd_config.
• Пользователь без root. Создайте аккаунт с правами sudo. Работа от root в продакшене – плохая практика. Одна ошибка может стоить всей системы.
• Firewall. Откройте в UFW SSH-порт, 80 и 443, если они нужны вашему сценарию. Если используется стандартный SSH-порт, это 22. Fail2ban добавит защиту от брутфорса на SSH.
• Swap. Если RAM меньше 2 ГБ, добавьте swap-файл на 1–2 ГБ. Он снижает риск OOM при пиковой нагрузке, но при активном использовании может ухудшить производительность.
• Обновления. Запустите sudo apt update && apt upgrade сразу после входа на сервер, до начала любой работы.
Сценарий 1. Хостинг сайтов и веб-проектов
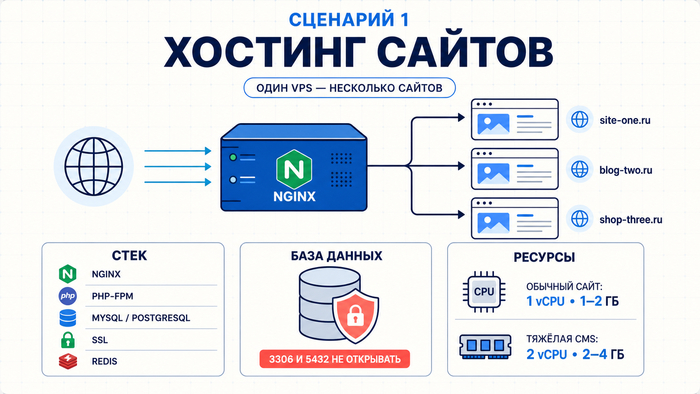
Хостинг на VPS оправдан, когда shared-хостинг перестал справляться: нет нужной версии PHP или Python, не хватает памяти, несколько доменов требуют разных настроек или нестандартного ПО. На VPS больше свободы в настройке: можно выбрать версии ПО, настроить веб-сервер, подключить нужные модули и управлять несколькими проектами независимо. Именно поэтому многие переезжают сюда с первого же конфликта с техподдержкой shared-хостинга.
Стек: Nginx как веб-сервер и reverse proxy, PHP-FPM для WordPress или других CMS, MySQL или PostgreSQL как база данных. Для статических сайтов (Hugo, Astro, Next.js SSG) Nginx работает без интерпретатора, нагрузка минимальная. SSL – Let’s Encrypt через Certbot, бесплатно и с автообновлением. Один Nginx обслуживает несколько доменов через server blocks.
Порты СУБД (3306, 5432) наружу не открывайте: приложение обращается к базе внутри сервера. Для сайта с умеренным трафиком часто хватает 1 vCPU и 1–2 ГБ RAM; для тяжёлых CMS с кешированием, большим числом плагинов или высокой посещаемостью лучше закладывать 2 vCPU и 2–4 ГБ. Добавьте Redis для кеша сессий: это может снизить нагрузку на базу данных и улучшить отклик WordPress при росте трафика.
Сценарий 2. Запуск Telegram- и Discord-ботов
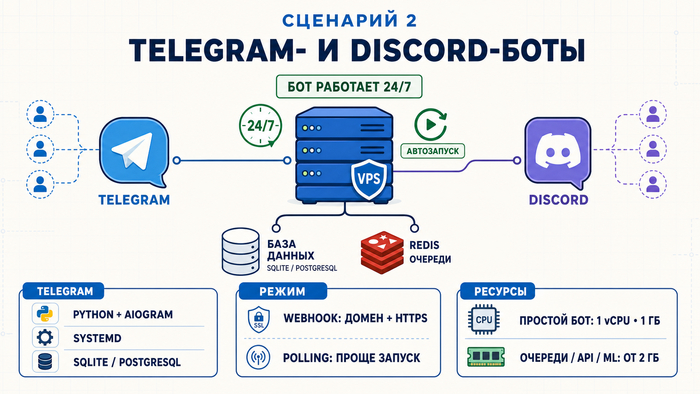
Боту часто нужно работать круглосуточно и хранить состояние: настройки пользователей, историю диалогов, очереди задач. Локальная машина для этого не подходит, а облачные функции удобны в основном для коротких команд без постоянного процесса. VPS решает обе задачи: бот постоянно запущен, а база данных может работать рядом на том же сервере.
Стек для Telegram: Python + aiogram, управление процессом через systemd, хранение состояния в SQLite или PostgreSQL. SQLite подходит для небольших ботов с умеренной нагрузкой, но при высокой конкуренции запросов или запуске нескольких экземпляров приложения лучше сразу выбирать PostgreSQL. Для Discord – Node.js + discord.js, для управления процессом удобен PM2. Redis подойдёт для быстрого хранения временных данных и очередей.
Для большинства продакшен-сценариев с Telegram-ботами удобен webhook-режим: сервер сам получает обновления, не опрашивая API Telegram. Для webhook нужен домен с HTTPS. Polling тоже остаётся корректным вариантом для небольших проектов: он проще в запуске и не требует домена с HTTPS. Простой бот без базы данных умещается на 1 vCPU и 1 ГБ RAM. Бот со сложными очередями, вызовами внешних API и ML-моделями потребует минимум 2 ГБ RAM. Через systemd настраивается автозапуск: после перезагрузки сервера бот поднимется сам.
Сценарий 3. Размещение API и бэкендов
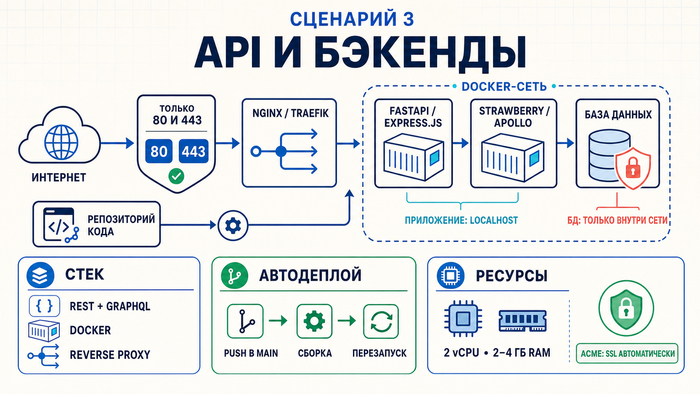
VPS-сервер даёт API постоянный адрес, свою базу данных и полный контроль над окружением, без vendor lock-in и без ограничений по времени выполнения запросов. Это важно для бэкендов с длительными операциями: обработкой файлов, парсингом, генерацией отчётов.
Стек: FastAPI (Python) или Express.js (Node.js) для REST, Docker для изоляции сервисов, Nginx или Traefik как reverse proxy. Приложение слушает на localhost, наружу открыты только 80 и 443. GraphQL – Strawberry (Python) или Apollo Server (Node.js). Для автодеплоя – GitHub Actions: пуш в main запускает пересборку и перезапуск контейнера.
Порты базы данных держите внутри Docker-сети, не открывайте наружу: бэкенд обращается к базе по имени сервиса внутри сети. Для API с базой данных начинайте с 2 vCPU и 2–4 ГБ RAM. При росте нагрузки Docker и reverse proxy позволяют масштабировать сервисы без переписывания архитектуры. Traefik автоматически получает и обновляет SSL-сертификаты через Let’s Encrypt при настроенном ACME, поэтому отдельная настройка Certbot не нужна.
Сценарий 4. Мониторинг и сбор метрик
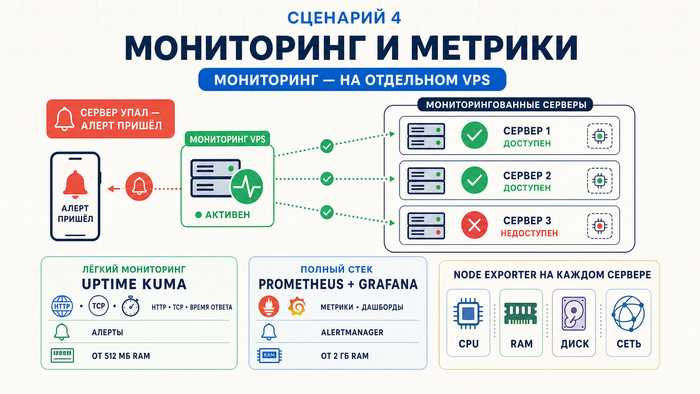
Сервер мониторинга должен работать независимо от мониторируемой инфраструктуры. Если основной сервер упал, система мониторинга должна увидеть это первой и отправить алерт, а не упасть вместе с ним. Отдельный небольшой VPS для мониторинга решает эту задачу.
Uptime Kuma – удобный инструмент с веб-интерфейсом: отслеживает HTTP-статусы, время ответа, порты TCP, отправляет алерты в Telegram, Slack и другие каналы. Разворачивается через Docker за несколько минут и обычно помещается в небольшой VPS. Для лёгкого мониторинга часто достаточно 512 МБ RAM, но потребление зависит от числа проверок и их типа.
Prometheus + Grafana – полный стек для сбора метрик, построения дашбордов и настройки алертов. Prometheus собирает данные с exporters, Grafana строит графики. Оба сервиса вместе могут потреблять примерно 600–1000 МБ RAM в покое, но фактическое потребление зависит от retention, числа targets и объёма метрик. Под этот сценарий обычно стоит закладывать не меньше 2 ГБ RAM. Node Exporter собирает системные метрики хоста – CPU, RAM, диск, сеть; добавьте его на каждый наблюдаемый сервер. Алерты в Telegram настраиваются через Alertmanager за несколько минут.
Сценарий 5. Автоматизация и рабочие процессы
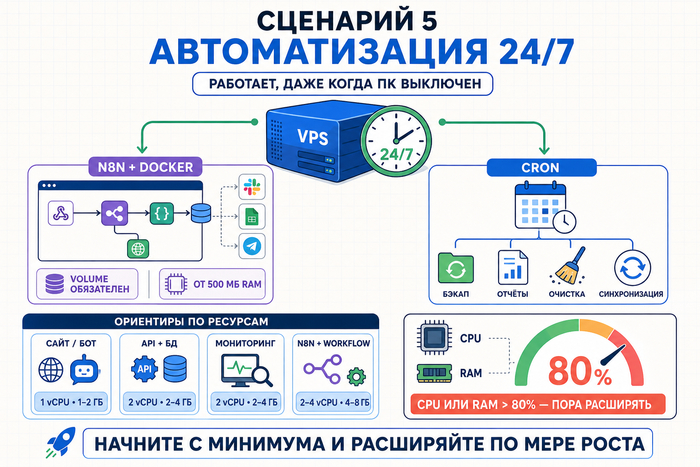
Сервер не выключается. Это главное преимущество VPS для автоматизации: cron-задачи запускаются по расписанию в любое время суток, скрипты работают столько, сколько нужно, без ограничений по времени выполнения и без зависимости от того, включён ли ваш компьютер.
n8n – self-hosted инструмент для визуальной автоматизации, аналог Zapier на вашем сервере. Разворачивается через Docker, а потребление памяти может начинаться примерно от 500 МБ RAM и расти с числом workflow, интеграций и выбранной БД. Данные о задачах хранятся в БД, поэтому volume для персистентности обязателен. Настроенный VPS с n8n заменяет подписку на облачные сервисы автоматизации и не передаёт данные третьим сторонам.
Для простых задач достаточно cron: бэкап файлов, отправка отчётов, очистка временных директорий, синхронизация данных между сервисами.
Как выбрать свой сценарий и не перегрузить сервер
Примерные ориентиры по ресурсам под основные задачи:
• Сайт или бот без тяжёлых фоновых задач: 1 vCPU, 1–2 ГБ RAM
• API с базой данных: 2 vCPU, 2–4 ГБ RAM
• Prometheus + Grafana: 2 vCPU, 2–4 ГБ RAM
• n8n плюс несколько сценариев одновременно: 2–4 vCPU, 4–8 ГБ RAM
Несколько сценариев на одном VPS совместить возможно, но требования зависят от сложности проекта, выбранного стека, объёма трафика и числа одновременно работающих сервисов. Для простого сайта, небольшого бота и лёгкого мониторинга 2 ГБ RAM могут быть достаточны, если нет тяжёлых фоновых задач. Docker упрощает совмещение: каждый сервис в своём контейнере, порты не конфликтуют, ресурсы лимитируются. Постоянная загрузка CPU или RAM выше 80% может стать сигналом для апгрейда. Начните с минимального тарифа и расширяйте по мере роста – большинство провайдеров позволяют сделать это без пересоздания сервера.
Чек-лист: что настроить на VPS под любой сценарий
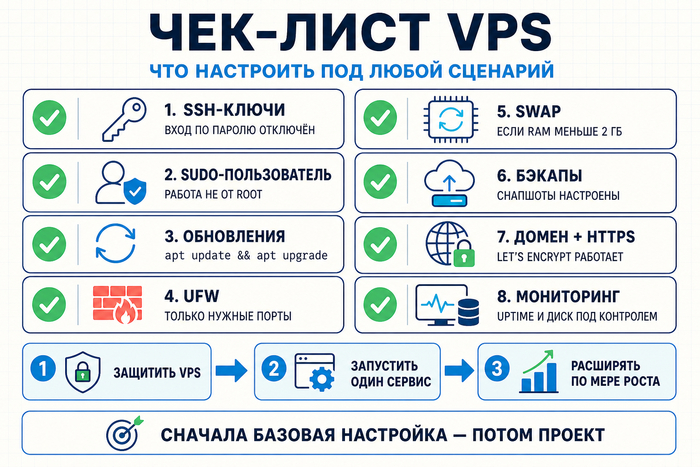
1. SSH-ключи настроены, аутентификация по паролю отключена
2. Создан sudo-пользователь, работа от root прекращена
3. Система обновлена: sudo apt update && apt upgrade
4. UFW включён: открыты только нужные входящие порты, например SSH-порт, 80 и 443 для веб-сценариев
5. Swap настроен при RAM < 2 ГБ
6. Автоматические снапшоты или бэкапы настроены
7. Домен привязан, HTTPS работает через Let’s Encrypt
8. Базовый мониторинг: uptime и диск под контролем
VPS это не готовый продукт, а платформа для разных задач: сайта, бота, API, мониторинга или автоматизации. Начните с одного сценария, не пытайтесь запускать всё сразу. Сначала закройте базовую настройку из чек-листа: SSH-ключи, firewall, обновления, бэкапы и мониторинг. После этого разверните минимальную рабочую версию сервиса и расширяйте конфигурацию по мере роста нагрузки.
Показать полностью
8

Я 15 лет в IT, и меня достало делать «кнопочки». Пошёл на hh.ru, пересчитал все вакансии и выбрал бэкенд. Спойлер: PHP ещё жив
Сергей, Ульяновск. В IT с середины 2000-х: jQuery, ExtJS, Backbone, ранний Angular. Сейчас React и TypeScript. Коммерческий фронтенд — три года. До этого — всё подряд.
Полгода назад упёрся.
Не в деньги — в развитие. Делаешь сложные формочки. Микрофронтенды. Стейт-машины на XState. А хочется понимать систему целиком. Почему API тормозит. Как данные идут в базу. Что там, под капотом.
Fullstack. Но какой бэкенд?
На YouTube — ролики «ТОП-5 ЯЗЫКОВ, ПОКА НЕ ПОЗДНО». Парень с укладкой, Hello World три месяца назад. Я пошёл на hh.ru и начал считать сам.
Вот что вышло.
---
## Как я считал
Два источника.
**hh.ru.** Только совпадения в названиях вакансий. Без поиска по описанию — там слишком много шума. Пятнадцать запросов: Python, Java, Go, PHP, Node.js, C# — плюс их комбинации с fullstack и React. Фильтр: вся РФ, зарплата любая.
**Хабр Карьера.** 43 716 анкет, июль 2026. Медианы, а не средние — чтобы пара зарплат из Яндекса не перекосила картину.
Даты: 14–20 июля 2026. Всё руками. Без скриптов.
Что нельзя гарантировать:
Поиск по заголовкам режет абсолютные цифры. Вакансия «Senior разработчик» без языка в названии — мимо выборки. Но пропорции держиЎ смещение одно и то для всех языков.
Это срез недели. Не годовой тренд.
Закрытый рынок (внутрянка, рекомендации) не виден. Совсем.
Регионы: Москва и Ульяновск — разные галактики. Мои цифры — среднее по стране, а не по столице.
И всё же. Для карьерного решения точности достаточно.
---
## Общий рынок: Python — 519. Но это ловушка
Беру все бэкенд-вакансии. Без фильтрации. Грубая масса:
> 📊 **[ВСТАВИТЬ КАРТИНКУ: horiz_bar.png]**
- Python — 519
- Java — 468
- C#/.NET — 227
- PHP — 207
- Go — 141
- Node.js — 62
- TypeScript (бэкенд) — 53
- Ruby — 15
Python вдвое опережает C#. Картинка ясная?
Нет.
Я открыл эти 519 вакансий. Добрая половина — Data Science. Нейросети. ML. Автоматизация. Python-разработчик в банке может не писать API вообще — он обучает скоринговые модели. К fullstack это имеет слабое отношение.
Сырые цифры врут. Красиво врут — но врут. Нужна другая выборка.
Теперь Node.js и TypeScript. Если считать их одним (TypeScript-бэкенд — NestJS или Next.js, технически Node.js), вместе — 115. Третье место, сразу за Python и Java. По-моему, так честнее. Но в таблицах ниже я их разделяю — для прозрачности.
Go — 141. Много для 15-летнего.
PHP — 207. Язык, который «умер» в 2012. В 2015. В 2018. В 2020. 207 вакансий. Никак не добьют.
Ruby — 15.
---
## Fullstack-срез: PHP на первом месте. Я перепроверил трижды
Дальше — фильтрую. Только вакансии, где в заголовке или первом абзаце чётко: «фронтенд + бэкенд». Пришлось вручную просмотреть около 200 штук. Некоторые заголовки врут: написано «Fullstack Developer», внутри — чистый бэкенд.
> 📊 **[ВСТАВИТЬ КАРТИНКУ: fullstack_bar.png]**
- PHP — 30
- Python — 29
- Java — 28
- C#/.NET — 21
- Node.js — 15
- TypeScript — 10
- Go — 2
- Ruby — 1
PHP.
На первом месте.
Я не поверил. Пересчитал. Ещё раз. Цифра честная.
Только вот интерпретация. PHP вырвался не потому, что это лучший язык для веба — а потому что Laravel-экосистема исторически fullstack. Фреймворк даёт бэкенд и Blade-шаблоны из коробки. В вакансиях на Laravel ищут одного человека: база, API, фронт — всё он. Это артефакт экосистемы. Не сигнал «беги учить PHP».
Node.js + TypeScript — 25. Второе место. Я ждал меньше. Думал, fullstack занят PHP и Java, а Node.js где-то в нише. Ошибся.
Go — две вакансии на всю страну.
Две.
Не случайность. Go проектировали для микросервисов, не для fullstack. Искать fullstack на Go — как спорткар с кузовом универсал. Можно, но зачем.
### Несколько цифр без прикрас
- Fullstack-вакансий в выборке: 330
- Удалёнка: 190 (58%)
- Senior: 61, Middle: 24
- hh.индекс: 8,3 — конкуренция
- Динамика: вакансий +8%, резюме −2%
61 senior, 24 middle. В 2,5 раза.
Fullstack — не входная точка в IT. Сначала стань кем-то одним. Потом расширяйся. Рынок ждёт опытных, а middle-позиции подбирает по остаточному принципу.
---
## React + бэкенд: график, ради которого я это затеял
Главный вопрос. Какие бэкенды реально ищут в паре с React? Не «упомянут где-то в глубине требований» — прямо в заголовке или первом абзаце:
> 📊 **[ВСТАВИТЬ КАРТИНКУ: react_combos.png]**
- React + Node.js — 16
- React + PHP — 9
- React + Python — 8
- React + Java — 6
- React + .NET — 5
- React + Go — 1
16 против 9. Node.js отрывается почти вдвое.
И вот что интересно. На общем рынке Node.js — скромный середняк: 62 вакансии. В fullstack-нише — третье-четвёртое место. А в связке с React — уверенное первое.
Не самый массовый бэкенд вообще. Но для React-фронтендера — самый частый выбор нанимателя.
Почему? Четыре причины, которые, по-моему, не случаются сами собой:
**Один язык.** TypeScript на клиенте и на сервере. Типы кочуют туда-сюда без переписывания. DTO описал один раз — работает везде.
**Next.js размывает границу.** API routes, Server Components, Server Actions. Разработчик на Next.js пишет бэкенд, часто не замечая.
**NestJS — когда Next.js маловато.** Модульная архитектура, DI, guards, interceptors. Enterprise-уровень на знакомом TypeScript.
**Общий тулинг.** Zod для валидации, date-fns для дат, shared-библиотеки в монорепе. Никакого дублирования.
React + PHP (9 штук) — обычно Laravel на бэке, React как админка или SPA. Работает. Особенно в e-commerce.
React + Go (1 штука).
Одна.
Кто-нибудь вообще видел такую вакансию вживую? Отпишитесь, мне правда интересно, что за проект.
---
## Деньги: где самый толстый скачок
Хабр Карьера, 43 716 анкет. Медианы.
> 📊 **[ВСТАВИТЬ КАРТИНКУ: salaries.png]**
- Intern — 66 000 ₽
- Junior — 95 000 ₽
- Middle — 177 000 ₽
- Senior — 303 000 ₽
- Lead — 378 000 ₽
Ступеньки: Junior → Middle — плюс 82 тысячи. Middle → Senior — плюс 126 тысяч. Senior → Lead — плюс 75 тысяч.
Самый крутой подъём — между middle и senior. Рынок платит за глубину. Fullstack-middle, который «всё понемногу», стоит сильно дешевле fullstack-senior, который глубоко знает оба направления.
Что за кадром:
Разброс внутри грейдов — пропасть. Senior fullstack в региональной веб-студии и senior fullstack в финтехе живут в разных финансовых измерениях.
Хабр Карьера смещена вверх. Те, кто получает мало, реже заполняют анкеты.
Зарплаты по языкам — за регистрацией. Я не знаю, получает ли PHP-senior столько же, сколько Node.js-senior. Подозреваю, что нет. Доказательств у меня нет.
---
## Удалёнка: 190 из 330
190 fullstack-вакансий из 330 — удалённые.
Я в Ульяновске. Ближайшие офисы крупных IT — Казань, Самара. С удалёнкой это не проблема: работаешь на Москву или Питер из квартиры с видом на Волгу.
Деталь: большинство удалённых fullstack-позиций — аутсорсинг и стартапы. Enterprise осторожничает. Банки. Телеком. Им всё ещё нужен офис. Хотите Java в банке — готовьтесь к гибриду как минимум.
---
## Что я выбрал
Node.js + NestJS + TypeScript.
Не «потому что модно». Пять вещей, которые перевесили:
**Язык один.** Пишу на TypeScript больше пяти лет. Декоратор `@controller()` в NestJS — продолжение того, что знаю. Не прыжок в другую вселенную.
**16 против 1.** React + Node.js — 16 вакансий, React + Go — одна. Работодатель, которому нужен fullstack на React, ждёт Node.js. Мне не надо его переубеждать.
**Потолок далеко.** Простой CRUD на NestJS — за вечер. Дальше — CQRS, event-driven, микросервисы на Kafka/NATS. Есть куда расти.
**Next.js как трамплин.** Server Actions и API Routes — это бэкенд, просто в рамках одного фреймворка. Переход к NestJS — структурирование тех же концепций.
**Одна кодовая база.** Типы, валидация, утилиты живут в одном месте. Без дублирования.
Что через год-два? Не знаю. Может, вторым языком возьму Python + FastAPI — мост в AI/ML-проекты. Может, останусь в Node.js и пойду в ширину: базы данных, инфраструктура, девопс.
Посмотрим.
---
## Если примерять к себе
Ты React/TypeScript-фронтендер? **Node.js, NestJS.** Язык знаешь, рынок подтверждает, вход плавный.
Ты в Data Science / ML? **Python, FastAPI.** Строить веб вокруг ML-моделей — редкая комбинация. Только учти: вакансий меньше, чем в чистом вебе.
Ты в enterprise или планируешь? **Java / C#.** Стабильно. Дорого. Порог входа высокий, экосистема тяжёлая.
Любишь highload и инфраструктуру? **Go.** Fullstack-позиций почти нет. Но как чистый бэкенд — мощно.
Нужна работа прямо сейчас? **PHP, Laravel.** 30 fullstack-вакансий — больше всех. Только готовься к культурной адаптации после TypeScript.
---
Четыре вещи, которые остались после подсчётов.
Node.js — не самый большой рынок. Но для React-фронтендера — точка входа с наименьшим сопротивлением. 16 против 1. Не погрешность.
Fullstack — не старт. 61 senior-вакансия, 24 middle. Сначала глубина. Потом ширина.
Один язык на клиенте и сервере — не «удобно». Это скорость. Меньше ошибок, общий тулинг, никаких «забыл обновить типы после смены API».
Цифры — не догма. Срез июля 2026. Через полгода пересчитаю — и не поручусь, что картина не изменится.
Пишите в комментариях, какой бэкенд выбрали вы. И главное — почему. Реальный опыт интереснее любых цифр.
А если кто-то видел fullstack на Go вживую — маякните. Мне правда интересно.
---
*Данные: hh.ru и Хабр Карьера, 14–20 июля 2026, РФ. Поиск по заголовкам — абсолютные цифры занижены, пропорции репрезентативны. Детальные зарплаты по языкам — за регистрацией, не включены. Региональные перекосы возможны.*
Показать полностью