
Speech Studio: бесплатная замена ElevenLabs — клонирует голос, читает книги и разговаривает с ИИ голосом, локально на своей видеокарте
Собрал десктопную студию голоса Speech Studio. Она озвучивает любой текст пятью открытыми нейросетями, клонирует голос по нескольким секундам записи, превращает запись или видео в текст, где видно, кто что сказал, а ещё с ней можно просто разговаривать: ИИ-агент отвечает голосом и слышит вас через микрофон. Всё считается на вашей видеокарте: без облака, подписок, очередей и без установки Python.
На видео — живой разговор с агентом в режиме Live: в начале он сам рассказывает, что умеет студия, дальше я по очереди переключаю ему движки и голоса и задаю вопросы.
Какие модели внутри
Голос в студии делают пять открытых моделей, и у каждой своя сильная сторона.
Fish Audio Drama 3 — новая модель Fish Audio для сцен с несколькими персонажами и длинных текстов. Внутри 35 млрд параметров, но на каждый токен работают только 3 млрд: это Mixture-of-Experts, где роутер для каждого шага выбирает нескольких «экспертов» из большого набора. Один текст может вести до 16 персонажей, а метки вроде [laughs] или [sighs] прямо в тексте заставляют голос смеяться и вздыхать. Честно скажу: на английском метки работают заметно лучше, чем на русском.
Higgs Audio v3 от Boson AI — тот же движок, что озвучивает в моей Dub Studio. Клонирует голос по короткому образцу и передаёт эмоции и звуки.
Qwen3-TTS 1.7B от Alibaba — самый быстрый на первый звук. Девять встроенных голосов, клонирование и подсказка, как читать, на каждый кусок текста. Его версия VoiceDesign делает новый голос по описанию словами.
Qwen3-TTS с русскими ударениями — та же модель с LoRA от siriusfreak, обученной на русских ударениях. Подключается на лету, отдельная модель не нужна.
Supertonic 3 — маленькая модель на 100 МБ с десятью встроенными голосами. Озвучивает в 168 раз быстрее реального времени и работает даже на процессоре.
Зачем понадобилась студия
Официально все эти модели запускаются из Python через PyTorch, у каждой свои зависимости и своё окружение, а Drama 3 разработчики запускают на серверном фреймворке SGLang-Omni и меряют на видеокартах H200. Поставить их рядом и заставить работать вместе — отдельный квест. Speech Studio выросла из моей Dub Studio и собрана целиком на нативных движках — Rust и C++/CUDA с квантованными весами GGUF и ONNX: один exe для Windows, без Python и зависимостей.
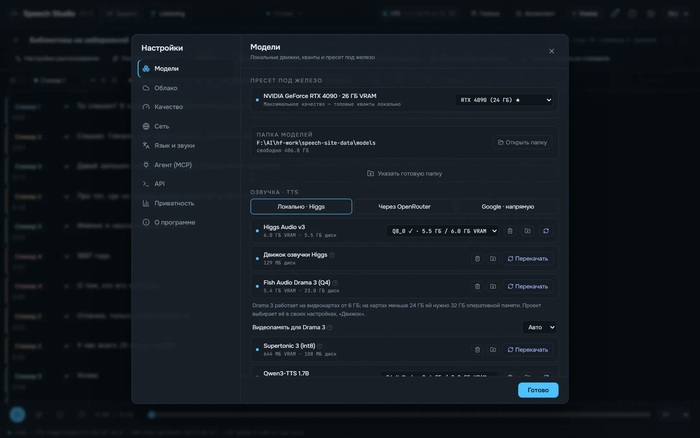
Отдельно повозился с Drama 3. Целиком в квантованном виде она занимает почти всю карту на 24 ГБ, поэтому в движке drama-rs эксперты модели (18 ГБ) переезжают в оперативную память, а на видеокарте остаётся кэш самых нужных. Так она запускается уже с 6 ГБ видеопамяти и при этом говорит бит в бит то же самое, просто медленнее. Внутри студии — всё, что умеют модели, и много сверху:
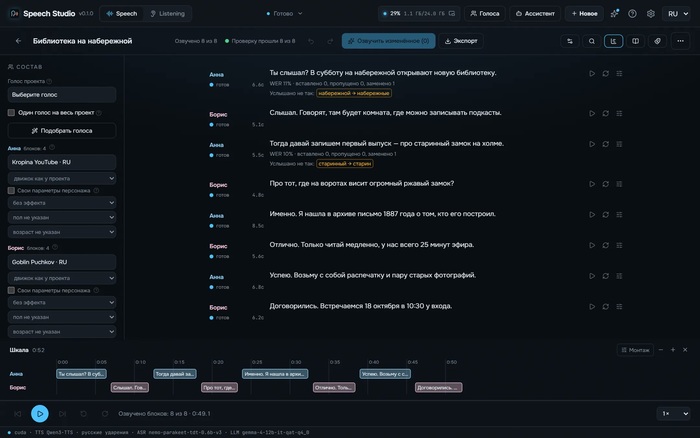
Озвучка чего угодно — фраза, диалог, где строки «Анна: …» сами становятся персонажами со своими голосами, подкаст, который режиссёр на Gemma пишет на заданную тему для двух-трёх спикеров, или закадр по субтитрам SRT точно в их тайминги
Аудиокниги — EPUB, FB2, PDF и DOCX: студия делит книгу на главы, отделяет прямую речь от авторской, раздаёт персонажам голоса и собирает M4B с главами и обложкой, с проверкой громкости ACX
Русский как надо — числа в нужном падеже и роде, даты, время, деньги и единицы словами, латинские бренды и аббревиатуры. Ударения, «ё» и омографы расставляет RUAccent: замо́к или за́мок, му́ки или муки́ он выбирает по смыслу предложения. Свои правила живут в словаре произношения, туда же импортируются словари Balabolka
Каждый дубль проверяется — студия распознаёт озвученное обратно, сверяет со словами текста и ловит клиппинг, тишину, обрыв, щелчок в конце, повтор фразы и музыку вместо речи. Брак переделывается, а из нескольких дублей можно выбрать лучший
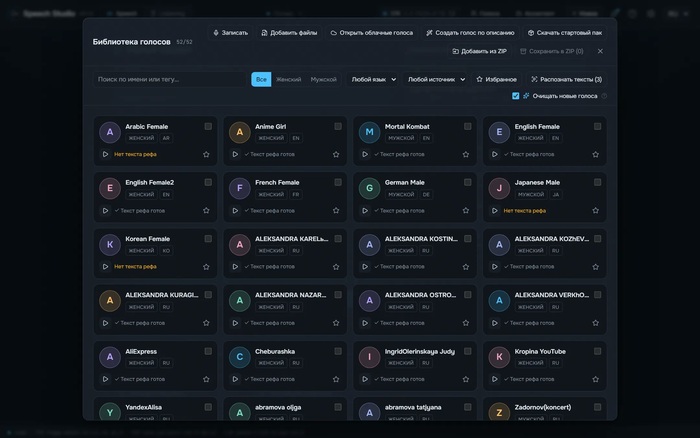
Библиотека голосов — клон по нескольким секундам записи, запись с микрофона, импорт файлов и пак голосов одной кнопкой. Mel-Band Roformer отделяет голос от музыки, DPDFNet убирает шум, а студия сама находит самый чистый кусок образца
Голос по описанию — пишете «пожилая женщина с мягким, чуть хрипловатым голосом», слушаете несколько вариантов и сохраняете лучший в библиотеку
Монтаж и экспорт — трековый редактор под текстом, музыка и звуки из файлов или песня из YuE2, MiniMax Music3 или ACE-Step Studio. Файл на главу, дорожка на персонажа, эффекты рации и телефона, громкость под видео или подкаст, WAV, FLAC, MP3, OGG и M4A
Всё в папке студии — модели, голоса и проекты лежат рядом с exe, установленная версия обновляется сама, а модель, которая уже есть в другой моей студии, берётся оттуда и не качается заново. Интерфейс на шести языках, светлая и тёмная тема
Распознавание речи
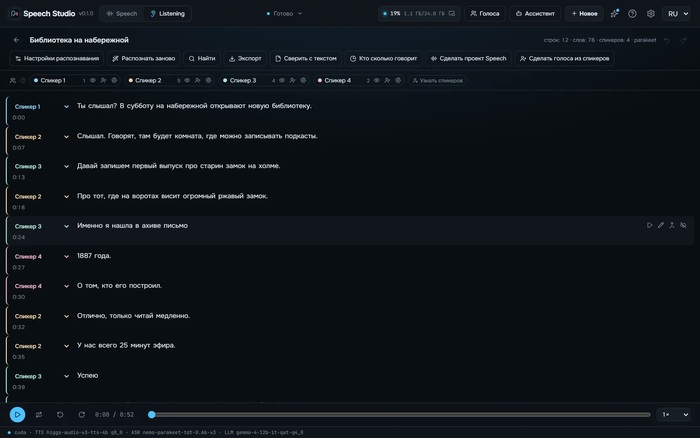
Второй режим, Listening, делает обратное: запись, видео или ссылку превращает в текст, где видно, кто что сказал и когда. Распознают Parakeet-TDT и Nemotron 3.5 от NVIDIA на движке transcribe.cpp или Whisper, говорящих — до восьми человек — размечает Nemotron 3 Diarization, длинная запись режется по паузам Silero VAD, шум убирает DPDFNet. При языке «Авто» его определяет VoxLingua107, и запись сама уходит модели, которая этот язык знает.
С текстом дальше можно работать: плеер-караоке подсвечивает слова, запись монтируется вырезанием слов прямо из текста, субтитры выгружаются по правилам Netflix и BBC в SRT, VTT или ASS. Если наложить на запись сценарий, студия покажет каждое слово, сказанное неверно или пропущенное, — так удобно проверять дубляж. А из говорящих записи можно сразу сделать голоса для библиотеки.
Разговор с агентом голосом
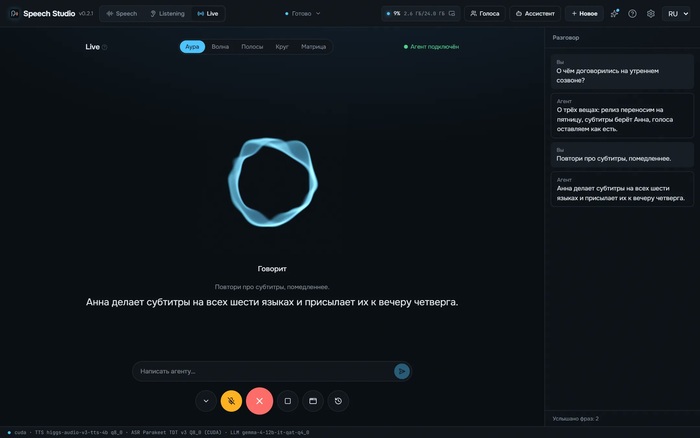
Третий режим, Live, — то, что на видео. Пока студия открыта, она работает как MCP-сервер: Claude Code, Cursor, Codex и другие агенты делают через неё всё, что умеет окно, — озвучивают, распознают, собирают проекты и аудиокниги. А в Live с агентом можно просто разговаривать. Он произносит каждую фразу, как только её написал, не дожидаясь конца ответа. Ваша фраза становится текстом через 0,64–0,74 секунды после того, как вы замолчали, а первый звук ответа приходит через 15 мс – 1 секунду после того, как агент его написал, в зависимости от движка.
Агента можно перебить фразой, и посреди разговора поменять ему голос, распознаватель или язык. Микрофон при этом включает только человек: у агента нет инструмента, который его включает, кнопки включения не принимают его клики, а если окно студии закрыто, микрофон через пять секунд выключается сам. В шапке видно, что микрофон пишет, для чего и сколько.
Программы, написанные под голосовой API OpenAI, тоже работают со студией: она отвечает на тех же запросах, а вместо голосов OpenAI отдаёт голоса вашей библиотеки.
Насколько быстро
Замерил на своей RTX 4090 одним и тем же русским текстом на 17 секунд. Supertonic 3 озвучивает в 168 раз быстрее реального времени, Qwen3-TTS — в 12 раз и выдаёт первый звук через 19 мс, версия с русскими ударениями — в 10 раз, Drama 3 — в 7 раз, Higgs Audio v3 — в 2,3 раза.
Пятиминутную русскую запись Parakeet распознаёт на видеокарте за 3,1 секунды, Nemotron 3.5 — за 4,1, Whisper large-v3-turbo — за 15,4. На процессоре Parakeet справляется за 9,2 секунды, Whisper — за 134.
Что нужно для запуска
Система: Windows 10/11 x64; Linux — экспериментально
Видеокарта: NVIDIA от 8 ГБ VRAM (GTX 16 / RTX 20 и новее); Drama 3 целиком — 24 ГБ, с 6 ГБ — с экспертами в оперативной памяти, тогда её нужно 32 ГБ
Место на диске: около 9 ГБ под модели и движки по умолчанию, Drama 3 — ещё 23 ГБ
Лицензия: студия — MIT, у каждой модели своя лицензия
Установка
Скачайте с GitHub установщик (обновляется сам) или портативный архив — его можно распаковать куда угодно.
Запустите Speech Studio и отметьте на первом экране, что нужно: голоса, распознавание, дополнения.
Нажмите «Скачать отмеченное» — модели и движки скачаются один раз и живут в папке программы.
Вставьте текст и нажмите «Создать», бросьте запись в Listening или включите микрофон в Live.
Примеры голосов всех движков, русские ударения до и после и полные таблицы замеров можно послушать и посмотреть на странице проекта.
А больше удобных репаков полезных нейросетей в моем телеграм канале НейроСофт