
ИИ тренды
5 постов
5 постов
Представьте, что вместо двух персонажей из популярного ролика под песню Светы «Мои слёзы не помогут» внезапно появляются ваши друзья, герои любимого сериала или даже вы сами.
При этом сохраняется всё, за что зрителям понравился оригинал: драматичные взгляды, эмоциональные жесты, движения под музыку и узнаваемая постановка.
Именно так работает этот ИИ-тренд. Нейросеть получает исходное видео, заменяет участников на новых персонажей и старается воспроизвести прежнюю сцену.
Для эксперимента не нужны навыки профессионального монтажа. Достаточно подготовить две фотографии, видеореференс и правильно составить запрос для генерации.
Разберём, как сделать собственную версию тренда через AIgrator, какие модели использовать и что делать, если нейросеть путает персонажей.
В основе ролика — короткая эмоциональная сцена под песню Светы, которую многие помнят по словам «Я прошу, не обижай».
Два персонажа стоят друг напротив друга и будто разыгрывают музыкальную драму. Один находится в зелёном образе, второй — в красном.
Камера переключается между участниками, приближает их лица и показывает реакции на происходящее.
Особенно забавно такой сюжет смотрится с неожиданными героями. Например, можно поставить в кадр двух персонажей из разных фильмов, известных мемных героев или друзей, которые в обычной жизни никогда бы не оказались в подобной ситуации.
Главное отличие этого формата от обычной генерации видео — мы не создаём сцену с нуля, а используем существующий ролик как основу для движений.
Нейросеть должна сохранить положение участников, последовательность действий, эмоции и монтаж, изменив только их внешность.
Подготовить понадобится всего три файла:
Фотография первого персонажа, который заменит зелёного героя.
Фотография второго персонажа, который займёт место красного героя.
Исходный видеоролик «Мои слёзы не помогут».
Для первых экспериментов подойдут обычные портреты. Желательно, чтобы лица были хорошо видны, а изображения не содержали сильного размытия или агрессивных фильтров.
Если важна не только внешность лица, но и конкретная одежда, причёска и телосложение, лучше использовать изображение персонажа в полный рост или подготовленную карту с несколькими ракурсами.
Исходный видеореференс для повторения тренда можно взять в Telegram-канале AIgrator.
Его необходимо сохранить, чтобы затем прикрепить к запросу в генераторе.
Для подобной задачи нужен инструмент, который умеет работать не только с текстовыми описаниями и фотографиями, но и с исходным видеоматериалом.
Через AIgrator можно попробовать модели Wan 3.0 и Seedance 2.5, выбрав доступный режим работы с видеореференсом.
Они решают одну общую задачу, но результаты могут отличаться.
Wan 3.0 можно протестировать в первую очередь, чтобы оценить сохранение исходной композиции, лиц и основных движений.
Seedance 2.5 — ещё один вариант для сравнения точности замены, естественности движений и стабильности внешности персонажей.
Заранее назвать одну модель лучшей для всех случаев нельзя. Результат зависит от сложности видео, качества изображений и возможностей конкретного режима.
Чтобы сравнение было объективным, используйте в обеих моделях одинаковые файлы и промпт.
Открываем AIgrator AI и переходим к генерации видео.
Выбираем Wan 3.0 или Seedance 2.5 и проверяем наличие режима редактирования видео с изображениями в качестве дополнительных референсов.
Далее прикрепляем материалы, соблюдая их роли:
@video1 — оригинальный ролик, из которого нейросеть должна взять движения, расположение героев, ракурсы и монтаж.
@image1 — новый персонаж вместо зелёного участника.
@image2 — персонаж, который заменит красного участника.
Это важный момент. Если перепутать привязку изображений, нейросеть может поставить героев не на свои места.
Обозначения @video1, @image1 и @image2 должны ссылаться на реальные загруженные файлы. В некоторых интерфейсах их необходимо выбрать вручную после ввода символа @.
Когда все референсы готовы, переходим к промпту.
Вместо короткой команды вроде «поменяй персонажей на фото» лучше подробно объяснить нейросети, какие элементы исходного видео разрешено изменить.
Наш приоритет — полная замена участников с сохранением движения и постановки.
CREATIVE MAPPING — TWO-CHARACTER VIDEO REPLACEMENT TASK: Transform the uploaded source video by completely replacing both original characters with the characters from the uploaded reference images. This is a full-character replacement task, not a new video generation. REFERENCE FILES: @video1 = ORIGINAL SOURCE VIDEO. Use @video1 as the master reference for: - original choreography - body movements - head movements - facial expressions - interactions between characters - camera angles - framing - shot timing - editing cuts - environment - lighting - composition @image1 = CHARACTER 1. This reference defines the complete appearance of the character replacing the GREEN original performer. @image2 = CHARACTER 2. This reference defines the complete appearance of the character replacing the RED original performer. STRICT CHARACTER MAPPING: The GREEN performer in @video1 must be completely replaced with Character 1 from @image1. The RED performer in @video1 must be completely replaced with Character 2 from @image2. Maintain this mapping throughout the entire video. Never swap the characters. Never combine facial features from different references. FULL CHARACTER REPLACEMENT: Replace each original performer's: - face - head - hairstyle - body - skin appearance - clothing - footwear - distinctive physical features Use the corresponding reference image as the sole source of appearance. Do not retain the original green or red costumes unless those clothing details are present in the new character references. Preserve the new characters' facial identity, hairstyles, body proportions and clothing consistently throughout all shots. MOTION PRESERVATION: Follow the original source video's movements as closely as possible. Keep the original: - head turns - facial reactions - eye direction - body posture - arm gestures - hand movements - timing - rhythm - interactions - distance between characters - movement direction The replacement characters must perform the actions of their corresponding original performers. Do not invent new actions. Do not create random movements. Do not change the original scene sequence. FACIAL PERFORMANCE AND LIP MOVEMENT: Preserve the original visible facial performance. Keep the timing of mouth movements and expressions close to the source video. Do not generate new dialogue. Do not create additional spoken words. The final musical track can be added separately during editing. CAMERA AND ENVIRONMENT: Preserve the original background, camera movement, framing, lighting and scene composition from @video1. Do not change the environment. Do not introduce additional people. Maintain the original shot order and editing rhythm. Preserve close-ups and over-the-shoulder shots from the source video. VISUAL STYLE: Photorealistic live-action. Realistic facial anatomy. Natural skin texture. Accurate body proportions. Realistic clothing. Natural lighting consistent with the source footage. Sharp, recognizable faces. No cartoon or CGI appearance. FINAL RESULT: The output must look like the original video was filmed with the two replacement characters. All original actions, camera movements and interactions remain as close as possible to @video1. Character 1 from @image1 always replaces the GREEN performer. Character 2 from @image2 always replaces the RED performer. Both characters remain recognizable throughout the entire clip. NEGATIVE PROMPT: original characters remaining, incorrect character mapping, identity swapping, face blending, incomplete replacement, original costumes remaining, changed faces, altered hairstyles, incorrect clothing, random movements, different choreography, wrong timing, changed background, new camera angles, extra people, duplicate characters, distorted hands, extra fingers, morphing faces, plastic skin, cartoon, CGI, blurry faces, broken continuity, new dialogue, new music, subtitles, text overlays, watermarks.
Особое внимание уделено трём вещам: правильному распределению персонажей, сохранению оригинальных движений и запрету на изменение окружения.
Важно: даже подробный промпт не обеспечивает идеально точную покадровую замену. Возможность сохранить движения и мимику зависит от выбранной модели и режима обработки видео.

После вставки промпта проверяем доступные параметры.
Для вертикального ролика можно выбрать 9:16, если такой формат предусмотрен и не нарушает композицию загруженного референса.
Продолжительность желательно установить максимально близкой к оригинальному фрагменту — примерно 13 секунд.
Для первого теста достаточно разрешения 480p или 720p. Это позволит проверить, насколько корректно нейросеть заменяет участников, прежде чем переходить к финальному качеству.
Если результат устраивает, можно попробовать 1080p, когда такой режим доступен.
Генерацию музыки лучше отключить, если планируете использовать отдельную звуковую дорожку.
Проверяем соответствие файлов и запускаем обработку.
После генерации важно сравнить результат с исходным роликом.
В первую очередь посмотрите, правильно ли распределились персонажи. Герой с первой фотографии должен находиться на месте зелёного участника, а второй — на месте красного.
Затем обратите внимание на движения.
Сохранились ли повороты головы? Совпадают ли жесты? Не изменилось ли положение персонажей относительно друг друга?
Проверьте крупные планы. Во время активных движений лица иногда теряют сходство с исходными фотографиями.
Отдельно оцените одежду и телосложение. Если вы хотели полностью заменить персонажа, а модель сохранила тело и костюм из первоначального видео, значит, замена оказалась частичной.
Ещё один важный момент — движения рта. Если планируете синхронизировать ролик с песней, визуальная артикуляция должна соответствовать оригинальной сцене настолько, насколько это позволяет модель.
После получения подходящего результата остаётся подготовить музыкальное сопровождение.
Открываем CapCut или другой видеоредактор, загружаем созданный ролик и добавляем музыкальную дорожку.
Для этого тренда важен фрагмент песни Светы «Мои слёзы не помогут».
Начало музыкального отрывка нужно совместить с первым заметным движением губ персонажа.
После этого проверяем синхронизацию в середине и конце ролика.
Если артикуляция постепенно расходится с музыкой, одной перестановки звуковой дорожки может оказаться недостаточно: иногда требуется скорректировать длительность видеоряда или повторить генерацию.
Видеореференс и материалы для повторения тренда можно найти в Telegram-канале AIgrator.
При публикации также можно выбрать композицию из официальной музыкальной библиотеки социальной сети, если она там доступна.
Проверьте, какие изображения связаны с @image1 и @image2.
В нашем промпте первое изображение всегда отвечает за зелёного героя, второе — за красного.
Если модель поменяла их местами, попробуйте повторить генерацию после проверки привязок.
Некоторые режимы лучше справляются с заменой лица, чем с изменением всей фигуры.
Для полной замены желательно использовать фотографии в полный рост или карты персонажей, где видны одежда и телосложение.
Также важно, чтобы выбранная модель действительно поддерживала редактирование внешности по исходному видео.
Это одна из характерных проблем генерации по одной фотографии.
Попробуйте использовать более качественное изображение или подготовить несколько ракурсов персонажа.
В особенности это помогает при сложных поворотах и крупных планах.
Проверьте, что исходное видео действительно загружено как референс.
Если модель получила только изображения и текстовое описание, она может самостоятельно придумать другую локацию и ракурсы.
Даже с подробным промптом модель может изменить отдельные жесты или последовательность действий.
Если это происходит, попробуйте выбрать более короткий участок видео или другой режим редактирования.
Иногда обработка нескольких небольших фрагментов даёт более предсказуемый результат, чем генерация всей сцены за один раз.
Да, сама схема не привязана к конкретным героям.
Можно использовать фотографии себя и друзей, персонажей фильмов, сериалов или собственных вымышленных героев.
Для этого достаточно заменить изображения @image1 и @image2, оставив исходное видео и структуру промпта.
Если используете фотографии реальных людей, лучше предварительно получить их согласие на создание и публикацию такого ролика.
А чтобы заменить персонажей не только внешне, но и полностью изменить их одежду и фигуры, подготовьте отдельные карты с несколькими ракурсами.
Стоимость зависит от выбранной нейросети, длительности исходного ролика, разрешения и количества попыток.
В AIgrator можно проверить доступные модели и условия генерации.
Для первого эксперимента необязательно сразу выбирать максимальное качество. Разумнее сначала проверить правильность распределения героев и сохранение движений.
Если тестовая версия устраивает, можно перейти к генерации финального видео в более высоком разрешении.
Чтобы создать собственную версию тренда «Мои слёзы не помогут», необязательно придумывать новую постановку или вручную анимировать каждого персонажа.
Нам нужны два изображения, исходный видеоролик и промпт, который объясняет нейросети, какую внешность использовать и какие элементы сцены необходимо сохранить.
Основная сложность заключается в том, чтобы новые герои оставались узнаваемыми на протяжении всего видео, а движения и ракурсы не слишком отличались от оригинала.
Поэкспериментировать с такой заменой можно через AIgrator, используя доступные режимы Wan 3.0 или Seedance 2.5.
Забрать видеореференс и материалы для повторения тренда можно в Telegram-канале AIgrator.
А кого бы вы поставили вместо зелёного и красного персонажей — себя с другом, героев сериала или какую-нибудь совершенно неожиданную пару?
Помните 2013 год? Вы ещё ребёнок, впервые запускаете GTA 5, знакомитесь с Майклом, Тревором и Франклином. После школы исследуете Лос-Сантос, проходите миссии и даже не подозреваете, что эта игра останется в памяти на долгие годы.
А теперь представьте, что можете встретиться с любимыми персонажами спустя 13 лет.
Именно на этом построен ИИ-тренд GTA 2013–2026. В первой сцене ребёнок с диском GTA 5 встречает главных героев игры. Во второй — уже взрослый человек возвращается к ним, и весёлая встреча превращается в эмоциональное прощание с детством.
Самое интересное, что вместо главного персонажа можно поставить себя. Понадобятся две фотографии, несколько референсов и нейросеть для генерации видео.
В этом гайде покажу, как повторить тренд через AIgrator: подготовим персонажей, создадим две сцены по 15 секунд и объединим их в один ролик.
Видео длится 30 секунд и делится на две части.
Первая сцена — GTA 2013.
Ребёнок с диском GTA 5 подходит к Майклу, Тревору и Франклину на деревянном променаде Лос-Сантоса.
Франклин дружелюбно протягивает кулак, Тревор строит забавную гримасу, а Майкл улыбается и треплет ребёнка по волосам.
Всё выглядит как обычная радостная встреча.
Вторая сцена — GTA 2026.
Прошло 13 лет. На том же месте появляется уже взрослый человек. В руках всё тот же диск GTA 5, но атмосфера совершенно другая.
Франклин молча приветствует старого знакомого. Тревор не может сдержать слёз. Майкл кладёт руку ему на плечо, а главный герой улыбается сквозь слёзы.
Получается короткая история о детстве, взрослении и ностальгии.
При этом персонажи не разговаривают. Все эмоции передаются через движения, взгляды и мимику.
Для повторения тренда нам понадобятся:
Ваша фотография из детства.
Ваша фотография во взрослом возрасте.
Референсы Майкла, Тревора и Франклина из GTA 5.
Два изображения одной локации: при дневном освещении и на закате.
Изображение обложки GTA 5 для PS3.
Четыре промпта: два для подготовки персонажей и два для генерации видео.
Использовать будем две нейросети.
Nano Banana 2.1 — для создания карт персонажей. Она поможет подготовить изображения с несколькими ракурсами, чтобы видеомодель точнее воспроизводила внешность.
Seedance 2.5 — для генерации двух видеосцен по 15 секунд.
Обе модели можно найти в AIgrator — агрегаторе нейросетей.
Готовые карты персонажей GTA 5, референсы локаций, обложку игры и музыку для тренда можно найти в Telegram-канале AIgrator.
Чтобы повторить тренд, понадобятся две фотографии: одна из детства, вторая — уже во взрослом возрасте.
Можно использовать обычные фотографии. Просто загрузите их в Seedance 2.5 вместе с остальными референсами и вставьте готовые промпты для видео. Создавать дополнительные изображения необязательно.
Но есть один нюанс.
В нашем видео персонаж появляется с разных ракурсов: сначала со спины, потом в полный рост и крупным планом. Если нейросеть видит только одну фотографию лица, ей приходится самостоятельно додумывать фигуру, причёску сзади, одежду и другие детали.
Из-за этого внешность персонажа может немного меняться между кадрами.
Поэтому мы рекомендуем сначала создать карты персонажей — отдельно для ребёнка и взрослого человека. Это необязательный этап, но он поможет нейросети точнее воспроизводить внешность.
Карта персонажа, или character reference sheet, — это изображение, на котором один человек показан с нескольких сторон.
Для этого открываем AIgrator, переходим в раздел генерации изображений и выбираем Nano Banana 2.1.
Создадим две карты одного человека в разном возрасте.

Начнём с первой сцены — GTA 2013.
Загружаем свою фотографию из детства. Желательно использовать снимок, на котором хорошо видно лицо: без сильного размытия, фильтров и закрывающих лицо предметов.
Нам нужно получить три изображения одного ребёнка, объединённые в единую карту:
Слева — фигура спереди, без головы.
В центре — полный рост со спины.
Справа — подробный портрет лица.
Так нейросети будет проще понять внешность персонажа при создании видео.
Take the child's appearance from the uploaded reference photos and create a photorealistic child character reference sheet, divided into three vertical panels on a neutral white or light-gray studio background. CHARACTER — STRICT IDENTITY PRESERVATION: The character is a child approximately 10–11 years old. Use the uploaded photograph as the sole reference for the child's identity, facial features, hairstyle, skin tone, clothing, and physical appearance. Preserve the child's original appearance as accurately as possible. Maintain realistic age-appropriate facial anatomy and body proportions. Do not make the child look older, younger, or more mature than in the reference photograph. Preserve the exact eye shape, eye color, eyebrows, nose, lips, cheeks, chin, jawline, face shape, skin tone, natural skin texture, hair color, hairstyle, and any distinctive features. Do not assign or change gender. The child's appearance must come exclusively from the uploaded reference image. RIGHT PANEL (CLOSE-UP PORTRAIT): A highly detailed close-up portrait of the child's face, cropped at the shoulders. The face is front-facing, looking directly into the camera. Neutral, natural facial expression with relaxed lips. Preserve realistic childlike facial proportions: naturally soft cheeks, age-appropriate jawline, realistic nose and lips, and the exact eye shape from the reference photograph. Preserve the hairstyle, hair length, hair texture, hair color, and bangs exactly as shown in the uploaded image. Natural skin texture without artificial smoothing or beauty filters. Soft, even studio lighting. High-resolution photorealistic portrait photography. LEFT PANEL (FRONT VIEW, FULL BODY WITHOUT HEAD): The same child standing naturally in a full-body frontal position. IMPORTANT: The head and face are completely absent from this panel. The figure is cropped precisely at the neck/shoulder line. Only the child's body from the neck down is visible. Arms relaxed naturally along the sides. Feet approximately shoulder-width apart. Preserve realistic child body proportions, height-to-body ratio, shoulder width, arm length, hand size, leg length, and overall build. Preserve the exact clothing and footwear from the reference photograph, including colors, fabrics, patterns, and accessories. The clothing must fit naturally on a child's body. No adult body proportions. MIDDLE PANEL (BACK VIEW, FULL BODY): The exact same child standing at full height, photographed directly from behind. Include the entire head, hair, body, and footwear. Preserve the child's hairstyle, hair length, hair color, body proportions, and clothing. The back of the hairstyle must realistically match the front portrait. The clothing must be identical to the left panel, including all visible details. Arms relaxed at the sides. Natural standing posture. The full body must remain visible from the top of the head to the shoes. GENERAL REQUIREMENTS: Three clearly separated vertical panels. LEFT: Front-facing full-body view without head. MIDDLE: Full-body back view including head and hair. RIGHT: Detailed frontal face portrait. Unified photorealistic studio photography style. Neutral white or very light-gray background. Clean, thin vertical dividers between panels. Consistent natural lighting and color grading. Consistent clothing, hairstyle, skin tone, body build, and physical identity across all three panels. Match body scale between the left and middle panels. Realistic anatomy and natural child proportions. Sharp facial details, realistic fabrics, natural skin texture, professional high-resolution photographic quality. NO cartoon, anime, CGI, illustration, artificial beauty filters, adult facial features, adult body proportions, exaggerated eyes, altered identity, different clothing, extra people, additional limbs, deformed hands, extra fingers, text, labels, logos, or watermarks.
После генерации проверяем результат. Лицо должно быть похоже на исходную фотографию, а пропорции тела — соответствовать возрасту ребёнка.
Если всё получилось, сохраняем изображение. Оно понадобится для первой сцены GTA 2013.
Если лицо получилось непохожим, лучше повторить генерацию. На этапе создания видео исправлять такие ошибки сложнее.

Теперь повторяем процесс со второй фотографией — уже во взрослом возрасте.
Остаёмся в Nano Banana 2.1, загружаем взрослую фотографию и используем следующий промпт.
Здесь принцип точно такой же: нейросеть должна подготовить три ракурса, сохранив внешность, причёску, фигуру и одежду.
Take the person's appearance from the uploaded photos and create a character reference sheet, divided into three vertical panels on a neutral white or light-gray background. RIGHT PANEL (close-up): A close-up portrait of the person's face, cropped at the shoulders (bust shot). Face front-facing, looking directly at the camera, neutral expression, natural even lighting. Preserve all facial features and details as accurately as possible: eye shape, nose, lips, eyebrows, face shape, eye color, skin tone and texture, hair shape and color, as well as any unique features (moles, freckles, ear shape). High detail, realism, portrait quality. LEFT PANEL (back view, full body): The person standing at full height, front view, in their everyday clothing, arms along the body, feet shoulder-width apart. IMPORTANT: the head and face are completely absent — the figure is cropped at the neck/shoulder line, no head. Only the figure from the neck down is shown. Preserve body build, proportions, and clothing. MIDDLE PANEL (front view, full body): The same person, back view, in the same clothing, at full height, including the head and hair (viewed from behind). Preserve the hairstyle, body build, and clothing details. GENERAL REQUIREMENTS: Unified style, consistent lighting and figure scale across all panels, consistency of appearance and clothing between panels. Clean background, clear vertical dividers between panels. Realistic photographic style, high resolution.
Сохраняем вторую карту персонажа.
Теперь у нас готовы два референса:
GTA 2013 — карта ребёнка примерно 10–11 лет.
GTA 2026 — карта взрослого человека.
В обоих случаях изображение будет загружаться под обозначением @image2, но для каждого эпизода используем свою фотографию или карту персонажа.
Если решили обойтись без карт, ничего страшного — просто используйте две исходные фотографии.

Теперь нужны Майкл, Тревор и Франклин.
Для каждого персонажа желательно использовать отдельное качественное изображение с хорошо видимой внешностью и одеждой.
Наши видеопромпты рассчитаны на следующие образы.
Майкл — серый деловой костюм.
Тревор — грязная белая футболка с V-образным вырезом, серые спортивные штаны, коричневые ботинки и татуировка «CUT HERE» на шее.
Франклин — бирюзовая рабочая рубашка поверх белого лонгслива, тёмные джинсы и светло-коричневые ботинки.
Также понадобятся две версии одной локации — деревянного променада с магазинами, пальмами и небоскрёбами на заднем плане.
Для первой сцены используем светлую локацию.
Для второй — ту же локацию с жёлтым закатным освещением.
Последний референс — обложка диска GTA 5 для PlayStation 3.
На протяжении обеих сцен нейросеть должна сохранять правильный размер коробки и оригинальный внешний вид обложки.
Все готовые референсы, карты персонажей GTA 5, локации и музыку можно найти в Telegram-канале AIgrator.
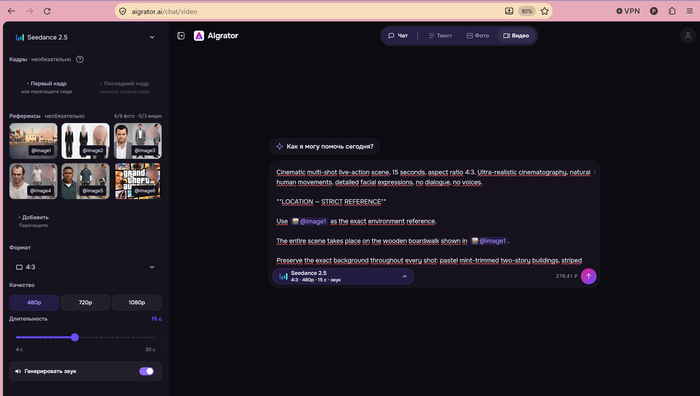
Переходим в раздел генерации видео на AIgrator.
Выбираем Seedance 2.5.
Нам нужно создать первую 15-секундную часть, в которой ребёнок встречается с Майклом, Тревором и Франклином.
Порядок очень важен. Каждый файл должен соответствовать своему обозначению в промпте.
@Image1 — светлая локация GTA 5.
@Image2 — ваша фотография из детства или созданная карта ребёнка.
@Image3 — Майкл.
@Image4 — Тревор.
@Image5 — Франклин.
@Image6 — обложка диска GTA 5 для PS3.
Именно в такой последовательности.
Если перепутать изображения, нейросеть может поменять местами персонажей или использовать не ту внешность.
Теперь вставляем готовый промпт.
Cinematic multi-shot live-action scene, 15 seconds, aspect ratio 4:3. Ultra-realistic cinematography, natural human movements, detailed facial expressions, no dialogue, no voices. **LOCATION — STRICT REFERENCE** Use @Image1 as the exact environment reference. The entire scene takes place on the wooden boardwalk shown in @Image1. Preserve the exact background throughout every shot: pastel mint-trimmed two-story buildings, striped awnings, palm trees, downtown skyscrapers, wooden telephone pole, weathered wooden planks, and low wooden railing. The location must remain geographically and visually consistent throughout all six shots. Never replace the background with the ocean, beach, sea horizon, or another environment. **CHARACTERS — STRICT IMAGE REFERENCES** - **Person 1 — @Image2:** Reproduce the exact person shown in @Image2, preserving facial identity, apparent age, hairstyle, body proportions, skin tone, clothing, footwear, and distinctive features. This person holds the PS3 game case from @Image6 against the chest with both hands. The original cover must face outward and remain clearly recognizable. - **Person 2 — @Image3:** Reproduce the exact person shown in @Image3, preserving facial identity, hairstyle, body proportions, skin tone, and the exact gray suit. - **Person 3 — @Image4:** Reproduce the exact person shown in @Image4, preserving facial identity, hairstyle, body proportions, the dirty white V-neck shirt, gray sweatpants, brown boots, and the exact "CUT HERE" neck tattoo. - **Person 4 — @Image5:** Reproduce the exact person shown in @Image5, preserving facial identity, hairstyle, body proportions, teal work shirt over white long sleeves, dark jeans, and tan boots. Do not assign or infer gender from the text. Character appearance, apparent age, identity, and physical characteristics must come exclusively from the corresponding image references. Maintain perfect character consistency across every shot. No face swapping, identity blending, clothing changes, or age changes. **CHARACTER POSITIONS** On the boardwalk from @Image1: - Person 3 (@Image4) stands on the left. - Person 4 (@Image5) stands in the center. - Person 2 (@Image3) stands on the right. - Person 1 (@Image2) stands in front of the other three characters, holding the PS3 game case from @Image6. **SHOT 1 — 0:00–0:04 | APPROACH** Camera positioned at knee height behind Person 1 (@Image2). Initially, only the feet and sneakers from @Image2 are visible, walking naturally across the weathered wooden planks. The camera slowly tilts upward as Person 1 stops. Reveal Person 3 (@Image4), Person 4 (@Image5), and Person 2 (@Image3) standing side by side. All three look toward Person 1 with curious, friendly expressions and subtle half-smiles. Natural eye contact and minimal body movement. Lens: 24mm, f/5.6, deep focus. **SHOT 2 — 0:04–0:06.5 | GREETING GESTURE** Medium-wide frontal shot of Person 1 (@Image2), camera at eye level. The other three characters appear as softly blurred shoulders in the foreground. Person 1 holds the PS3 game case from @Image6 against the chest, makes a small, polite bow from the waist, then slowly straightens up. After straightening, Person 1 gives a shy, slightly embarrassed smile and briefly makes eye contact with the other characters. The gesture communicates a friendly greeting entirely through body language. **ABSOLUTELY NO SPEECH, NO WORDS, NO MOUTH MOVEMENTS IMITATING SPEECH.** Lens: 50mm, f/2.8. **SHOT 3 — 0:06.5–0:08.5 | FRIENDLY FIST BUMP** Medium over-the-shoulder shot from behind Person 1 (@Image2), focusing on Person 4 (@Image5). Person 4 responds with a slow, approving nod and a small, warm smile. Person 4 extends a closed fist toward Person 1. Person 1 carefully moves one hand away from the PS3 game case, keeping the case secured against the body with the other hand. The two characters perform one natural, gentle fist bump. The interaction is relaxed, friendly, and physically realistic. No speaking, no exaggerated gestures. Lens: 50mm, f/2.8. **SHOT 4 — 0:08.5–0:11 | PLAYFUL REACTION** Close-up over Person 1's shoulder, focusing on Person 3 (@Image4). Person 3 slowly leans forward toward Person 1. Person 3 narrows the eyes, raises the eyebrows slightly, and makes a funny exaggerated facial expression. The expression gradually transforms into a crooked, amused grin. The interaction feels spontaneous, playful, and natural. Facial expressions only. No speaking, no lip-sync, no vocal sounds. Lens: 85mm, f/2. **SHOT 5 — 0:11–0:13 | SHY SMILE** Close-up of Person 1 (@Image2), filmed from slightly above eye level. Person 1 initially looks down shyly. After a brief pause, Person 1 looks upward and breaks into a wide, genuinely happy but slightly embarrassed smile. The eyes narrow naturally with the smile. Person 1 instinctively hugs the PS3 game case from @Image6 a little tighter against the chest. Natural facial expressions and subtle body language. No dialogue, no mouth movements resembling speech. Lens: 85mm, f/2. **SHOT 6 — 0:13–0:15 | AFFECTIONATE FINAL GESTURE** Medium close-up from behind Person 1 (@Image2), focusing on Person 2 (@Image3). Person 2 watches Person 1 with a gentle, approving, affectionate smile. Person 2 slowly raises one hand and softly ruffles Person 1's hair. Person 1 slightly tilts the head in response and smiles. Person 2 gives a small approving nod while continuing to smile. The scene ends on this natural, affectionate interaction. **NO SPEECH. NO VOCALIZATION. NO LIP-SYNC.** Lens: 85mm, f/2.2. **LIGHTING AND VISUAL STYLE** Maintain the exact lighting atmosphere from @Image1. Warm late-afternoon California sunlight from the left and slightly behind the characters. Soft golden rim lighting along hair and shoulders, gentle atmospheric haze, realistic shadows across the wooden boardwalk. ARRI Alexa Mini cinematic camera aesthetic. Kodak Vision3 250D film look. Fine analog grain, muted warm tones, slightly lifted blacks, natural skin texture. Stable handheld cinematography with subtle natural camera movement. Clean cinematic hard cuts between shots. Consistent environmental geography and spatial continuity. **AUDIO — STRICTLY NO VOICES** The video contains absolutely no dialogue or human vocal sounds. No speaking, whispering, shouting, laughing sounds, humming, breathing sounds, voice-over, narration, or lip-sync. Characters express every emotion exclusively through facial expressions, gestures, eye contact, and body movement. Only subtle environmental sounds are allowed: - Gentle coastal wind. - Distant seagulls. - Faint city traffic. - Natural footsteps on wooden planks. - A soft knuckle tap during the fist bump. - Light ambient environmental noise. No music. No soundtrack. No artificial sound effects. **NEGATIVE PROMPT** Dialogue, speech, talking characters, human voices, voice-over, narration, lip-sync, synchronized mouth movements, spoken words, whispering, shouting, audible laughter, humming, vocalization, background conversations, music, subtitles, text overlays, added logos, gender reinterpretation, gender-based appearance changes, identity swapping, changed faces, altered facial features, altered hairstyles, changed outfits, age changes, extra people, crowds, missing PS3 game case, modified game cover, background changes, ocean background, beach, sea horizon, Ferris wheel, different location, cartoon style, CGI, video game graphics, plastic skin, unnatural facial expressions, morphing hands, extra fingers, warped boardwalk, jittery camera, broken continuity.
Для первой сцены выставляем:
Модель: Seedance 2.5.
Продолжительность: 15 секунд.
Разрешение: 1080p.
Формат: 4:3.
Эти параметры выбираем при наличии соответствующих настроек в используемом режиме.
После этого запускаем генерацию.
На выходе должен получиться короткий ролик, в котором ребёнок подходит к героям GTA 5, приветствует их и получает дружелюбную реакцию.
Сохраняем видео. Первая половина готова.
Теперь создадим продолжение.
Прошло 13 лет. Главный персонаж вырос, но Майкл, Тревор и Франклин всё ещё находятся на том же деревянном променаде.
На этот раз встреча будет эмоциональной: грустные взгляды, слёзы и ощущение прощания с детством.
Снова открываем генерацию видео в AIgrator и выбираем Seedance 2.5.
Последовательность остаётся практически такой же:
@image1 — та же локация GTA 5, но с жёлтым закатным освещением.
@image2 — ваша взрослая фотография или карта взрослого персонажа.
@image3 — Майкл.
@image4 — Тревор.
@image5 — Франклин.
@image6 — обложка диска GTA 5 для PS3.
Главное отличие от первой сцены — теперь используем взрослую фотографию и закатную локацию.
Майкл, Тревор и Франклин должны остаться без изменений.
Ещё одна важная деталь: в этой сцене главный герой держит диск GTA 5 только в левой руке, а не прижимает его к груди.
Cinematic multi-shot live-action scene, 15 seconds, aspect ratio 4:3, emotional reunion. Ultra-realistic live-action cinematography. No dialogue, no voices, no lip-sync. **LOCATION — STRICT REFERENCE** Use @image1 as the exact environment reference. The entire scene takes place on the wooden boardwalk shown in @image1 at golden hour. The background from @image1 must remain visually identical and clearly recognizable in every shot, including close-ups: mint-trimmed two-story building, striped awning shops, palm trees, downtown skyscrapers glowing in amber light, wooden telephone pole, low wooden railing, and weathered wooden planks. Never change the location. Never replace it with beach, sand, sea, ocean horizon, or any other setting. **CHARACTERS — STRICT IMAGE REFERENCES** - **Person 1 — @image2:** Reproduce the exact person shown in @image2, preserving facial identity, apparent age, hairstyle, body proportions, skin tone, clothing, accessories, footwear, and all distinctive visual details. This person holds the PS3 game case from @image6 in the **left hand only**. - **Person 2 — @image3:** Reproduce the exact person shown in @image3, preserving facial identity, hairstyle, body proportions, skin tone, and the exact gray suit. - **Person 3 — @image4:** Reproduce the exact person shown in @image4, preserving facial identity, hairstyle, body proportions, the dirty white V-neck, gray sweatpants, brown boots, and the exact "CUT HERE" neck tattoo. - **Person 4 — @image5:** Reproduce the exact person shown in @image5, preserving facial identity, hairstyle, body proportions, teal work shirt over white long sleeves, dark jeans, and tan boots. Do not assign or infer gender from the prompt text. Character appearance, apparent age, and identity must come only from the image references. Faces and outfits of @image2, @image3, @image4, and @image5 stay identical in every shot. **CHARACTER POSITIONS** On the boardwalk from @image1: - Person 3 (@image4) stands on the left. - Person 4 (@image5) stands in the center. - Person 2 (@image3) stands on the right. - Person 1 (@image2) stands in front of them, facing them. Everyone is quiet, emotionally moved, sad, and tender. The mood is bittersweet farewell. No laughter, no joking, no cheerful behavior. **GAME CASE — STRICT SCALE REFERENCE** Person 1 (@image2) holds the PS3 game case from @image6 in the **left hand only**. The game case must remain a real-size standard case: - approximately 17 cm tall, - approximately 13.5 cm wide, - approximately 1.4 cm thick. It is small, roughly the size of an open hand. It is held naturally by its edge between thumb and fingers, hanging relaxed at the side. Correct real-world scale relative to the hand at all times. Never oversized, never elongated, never shaped like a DVD box, never unusually thick. **SHOT 1 — 0:00–0:03 | APPROACH** Camera at knee height behind Person 1 (@image2). Frame only the yellow shoes and wide jeans from @image2 walking slowly across the wooden planks of @image1. The small PS3 game case from @image6 is visible in the left hand. The camera remains at the same low height and slowly tilts upward as Person 1 stops. Reveal Person 3 (@image4), Person 4 (@image5), and Person 2 (@image3) standing side by side in full height. They remain silent and still, looking toward Person 1 with sad, tender, emotionally restrained expressions. The glowing skyline of @image1 remains visible behind them. Lens: 24mm, f/5.6, deep focus. **SHOT 2 — 0:03–0:05 | FIST BUMP** Medium over-the-shoulder shot from behind Person 1 (@image2), focused on Person 4 (@image5). The background of @image1 remains behind Person 4. Person 4, with sad eyes and a faint heavy smile, slowly extends a fist. Person 1 gently responds with the right fist while still holding the small PS3 game case in the left hand. The fist bump is slow, soft, restrained, and emotionally meaningful. No speech. No lip movement suggesting speech. Lens: 50mm, f/2.8. **SHOT 3 — 0:05–0:07.5 | TEARFUL REACTION** Close-up over the shoulder of Person 1 (@image2) onto Person 3 (@image4). The background of @image1 remains behind Person 3. Person 3 looks at Person 1 with deep sadness. The lips tremble slightly. A single tear rolls down the cheek. Person 3 clearly raises a hand and wipes the tear away with the back of the hand and knuckles. A visible attempt to stay composed. Subtle breathing emotion through face and gesture only. No speech, no vocal sound, no lip-sync. Lens: 85mm, f/2, with soft background bokeh. **SHOT 4 — 0:07.5–0:09 | CRYING SMILE** Close-up of Person 1 (@image2) alone in frame. Behind Person 1, only the softly out-of-focus buildings and palm trees of @image1 are visible. Warm golden backlight outlines the hair. Person 1 smiles and cries at the same time: - eyes glistening, - tears running down the cheeks, - a trembling grateful smile, - subtle emotional tension in the mouth and eyebrows. No speech, no mouth movements imitating words. Lens: 85mm, f/2. **SHOT 5 — 0:09–0:12 | SUPPORTIVE SHOULDER TOUCH** Medium close-up over the shoulder of Person 1 (@image2) onto Person 2 (@image3). The background of @image1 remains behind Person 2. Person 2 gently places a hand on the shoulder of Person 1. Person 2 looks at Person 1 with proud, wet eyes and a restrained, emotional expression. No dialogue. The emotional message is conveyed only through eye contact, hand placement, facial expression, and stillness. The hand remains steady on the shoulder for a moment. Lens: 85mm, f/2.2. **SHOT 6 — 0:12–0:15 | FINAL CLOSE-UP** Single close-up of Person 1 (@image2), the only person fully visible in frame. The three other characters stand in front of Person 1, behind the camera, fully off-screen. Only the hand of Person 2 (@image3) resting on the shoulder of Person 1 is visible at the edge of the frame. Behind Person 1, only the soft out-of-focus buildings and palm trees of @image1 are visible. Nobody else appears in the background. Person 1 is still crying softly, with a trembling smile. The eyeline shifts slowly across the frame: - first looking slightly off-camera to frame left, - then slowly turning to look just past the lens, - then finishing looking slightly off-camera to frame right. The expression suggests gratitude, sorrow, and hope without words. No speech. No lip-sync. No mouth shapes clearly forming words. Lens: 85mm, f/2. **LIGHTING AND VISUAL STYLE** Lighting in all shots must match @image1: - low saturated amber-gold sun behind and slightly to the left, - strong warm rim light and halation on hair, shoulders, and tears, - soft warm fill on faces, - long shadows across the wooden planks, - light warm haze, - slightly cool soft shadows to preserve a melancholic mood. Camera aesthetic: - ARRI Alexa Mini, - slow steady handheld with subtle breathing, - Kodak Vision3 500T film look, - fine grain, - saturated golden highlights, - gently lifted blacks. Clean hard cuts between shots. Maintain spatial continuity and emotional realism. **AUDIO — NO VOICES** Absolutely no dialogue and no human vocal sounds. No speech, no whispered lines, no talking, no narration, no voice-over, no lip-sync, no synchronized mouth animation, no audible crying words, no humming. Only ambient environmental sound is allowed: - soft coastal wind, - distant seagulls, - quiet city hum, - slow footsteps on wooden planks in shot 1, - a soft knuckle tap in shot 2. Optional very subtle natural non-verbal emotional presence is acceptable only if it is not speech-like and not a voiced line, but ideally keep the characters fully silent. No music. **NEGATIVE PROMPT** Oversized game case, elongated game case, DVD box, game case larger than a hand, game case in the right hand, missing game case, altered game cover, other characters visible behind Person 1 in shot 6, people visible in close-up backgrounds, changed character positions, beach, sand, ocean, sea horizon, Ferris wheel, different location, changed faces, changed outfits, identity drift, age drift, extra people, crowd, laughter, big grins, cheerful comedy mood, speech, dialogue, lip-sync, narration, voice-over, subtitles, text overlays, music, wrong emotional tone, cartoon look, CGI look, plastic skin, morphing hands, extra fingers, warped boardwalk, jittery camera.
Выставляем:
Модель: Seedance 2.5.
Продолжительность: 15 секунд.
Разрешение: 1080p.
Формат: 4:3.
Проверяем последовательность всех изображений и запускаем генерацию.
После получения результата сохраняем вторую сцену.
Теперь у нас есть два готовых видео по 15 секунд.
Осталось объединить их в один 30-секундный ролик.
Для этого подойдёт CapCut или любой привычный видеоредактор.
Ставим сцены в следующем порядке:
0–15 секунд — GTA 2013. Детство, первая встреча, дружелюбные эмоции.
15–30 секунд — GTA 2026. Возвращение спустя 13 лет, грустные взгляды, слёзы и финальное прощание.
Между частями лучше сделать обычную склейку без сложных переходов. Так контраст между двумя эпохами получится сильнее.
Можно добавить небольшие надписи «2013» и «2026», чтобы зритель сразу понял задумку.
После монтажа добавляем подходящую музыку. В самих видеопромптах персонажи не разговаривают, поэтому музыкальное сопровождение можно подобрать отдельно и синхронизировать со сменой эпох.
Музыку для этого тренда можно найти в Telegram-канале AIgrator.
Если нейросеть меняет внешность между кадрами, попробуйте вместо обычной фотографии использовать карту персонажа.
Именно для этого мы подготовили отдельные референсы ребёнка и взрослого человека.
На карте модель получает информацию не только о лице, но и о фигуре, одежде и причёске с разных сторон.
Однако даже хорошая карта не гарантирует полного совпадения в каждом кадре.
Проверьте порядок загруженных изображений.
В обоих промптах используется одинаковая последовательность:
@image3 — Майкл, @image4 — Тревор, @image5 — Франклин.
Если поменять их местами, действия могут перейти не к тем персонажам.
Нейросеть может самостоятельно добавить океан или песок, поскольку действие происходит рядом с побережьем.
Поэтому в промптах подробно описаны здания, деревянные доски, магазины, пальмы и небоскрёбы.
Используйте референс локации, на котором хорошо видны именно эти элементы.
Во второй сцене диск должен находиться в левой руке главного героя.
В промпте специально указаны размеры стандартной коробки PS3: примерно 17 × 13,5 × 1,4 см.
Если она получается огромной или похожей на DVD-бокс нестандартной формы, попробуйте повторить генерацию.
В каждом 15-секундном фрагменте предусмотрено шесть кадров.
Это довольно насыщенный сценарий, поэтому нейросеть иногда сокращает отдельные действия или меняет их продолжительность.
Если важные моменты пропадают, можно сгенерировать отдельные эпизоды, а затем соединить их самостоятельно.
Для первых экспериментов можно воспользоваться доступными стартовыми предложениями AIgrator, если они действуют для вашего аккаунта.
Но стоит учитывать, что генерация видео обычно требует больше ресурсов, чем создание изображений.
Стоимость зависит от выбранной модели, продолжительности, разрешения и других настроек.
Поэтому перед запуском лучше проверить цену генерации в интерфейсе.
Если хотите сэкономить на пробных попытках, сначала подготовьте все референсы и убедитесь, что они соответствуют промптам.
Затем переходите к созданию двух полноценных сцен.
GTA 2013–2026 — один из тех ИИ-трендов, которые цепляют не сложными спецэффектами, а самой идеей.
В 2013 году мы знакомились с Майклом, Тревором и Франклином, проходили сюжет и проводили часы в Лос-Сантосе.
А спустя 13 лет можем виртуально вернуться к этим персонажам уже взрослыми.
Повторить такой ролик можно даже с обычными фотографиями. Но если хотите добиться более точного сходства, лучше предварительно подготовить карты персонажей в Nano Banana 2.1.
Дальше остаётся загрузить референсы в Seedance 2.5, вставить два готовых промпта и получить две сцены по 15 секунд.
Создать собственное видео можно через AIgrator, а все необходимые материалы, карты персонажей и музыку найти в Telegram-канале AIgrator.
А вы впервые сыграли в GTA 5 в 2013 году или познакомились с ней гораздо позже?
Кажется, нейросети добрались до нового уровня интернет-безумия.
Теперь можно взять фотографии двух людей, превратить их в гигантских крыс с человеческими лицами и заставить выяснять отношения перед камерой.
Причём всё выглядит так, словно кто-то случайно снял происходящее ночью на телефон со вспышкой.
Я решил разобраться, как повторить этот тренд, какие нейросети для этого нужны и почему иногда вместо крыс получаются совершенно другие существа.
Делюсь инструкцией и промптами.
Для начала нужны две фотографии людей.
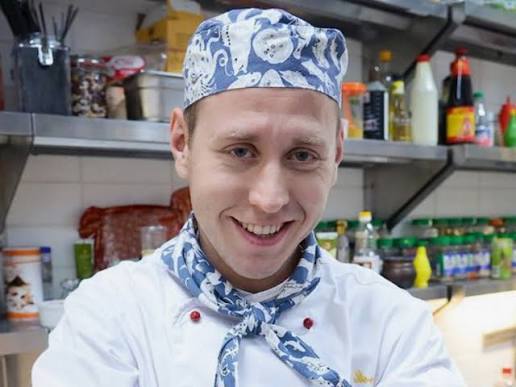
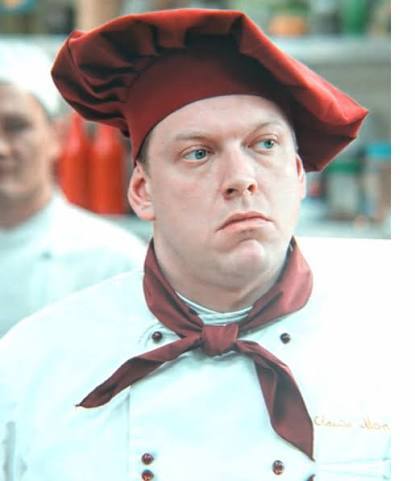
Можно взять собственные снимки, фотографии друзей или придумать своих персонажей.
Кроме того, понадобится изображение фона и видеореференс с движениями.
В исходном гайде для подготовки изображений используется Seedream 5.5, а для создания ролика — Kling 4.0.
Работу с доступными моделями можно организовать через AIgrator.
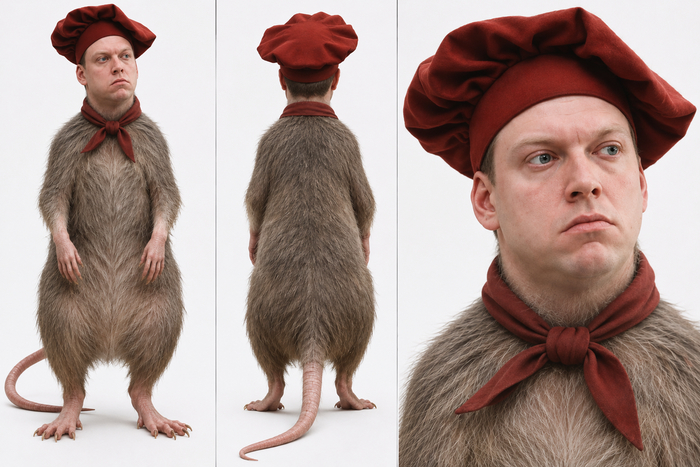
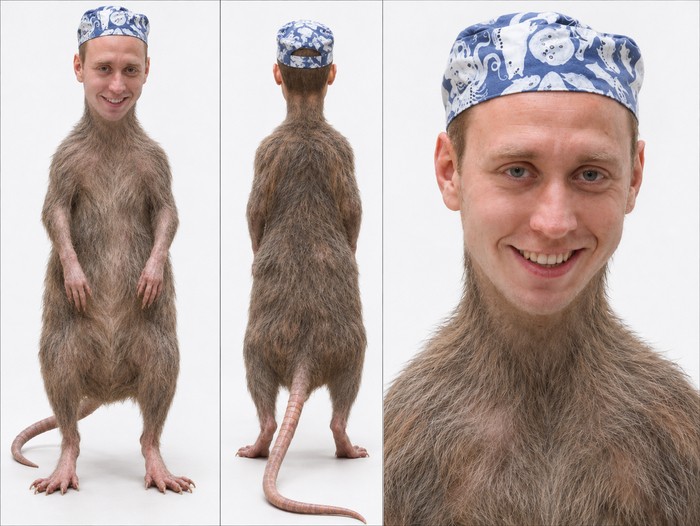
Самое забавное в этом тренде — внешность персонажей.
Нам нужно создать существо с обычной человеческой головой и телом большой крысы.
Причём не мультяшное, а максимально реалистичное. С шерстью, лапами, хвостом и узнаваемым человеческим лицом.
Для этого загружаем фотографию человека в генератор изображений.
В исходной инструкции предлагается использовать горизонтальный формат 16:9 и качество от 2K.
Далее вставляем промпт.
@image1 — reference photo of the person. Create a photorealistic character reference sheet from the uploaded person photos: three vertical panels, clean white or light-gray background, clear vertical dividers. The RIGHT portrait panel is the widest, about 40% of the sheet width. The sheet is horizontal, all three panels are the same height.
CHARACTER CONCEPT: the same person reimagined as a human–rat hybrid — a normal human head on the body of a giant rat, with no clothing anywhere. Preserve his identity exactly: face shape, facial proportions, eyes, eye shape and colour, nose, lips, brows, ears, skin tone and texture, wrinkles, moles, freckles, hair colour and hairstyle, real age. The head is fully human and unchanged; the body below the neck is fully rat. No makeup, no beautifying, no plastic or waxy look.
HEAD-TO-BODY JOIN, CRITICAL: the transition must read as one living organism, not a mask sitting on a stuffed animal. The human neck flows naturally into the rat chest: the skin of the neck gradually becomes covered with sparse fur, and further down the fur becomes dense and fully rat-like. The hairline at the nape continues into fur down the back of the neck. The proportions are set so the head sits on the body naturally, like a real creature.
RAT BODY: a large grey rat body, real rat anatomy, sized so the head is roughly one quarter of the total body length. Short coarse grey fur with brownish and rusty undercoat, patches of thin fur and bare pinkish skin where the coat is worn. Long scaly tail emerging from the rear, pinkish-grey, covered in ring-shaped scales, resting behind or hanging down. Rat limbs: thin, with four long toes and small claws, pink feet, shorter fur on the forearms. Sharp shoulder blades, lean abdomen, slightly hunched back. The ears are the human ears from the head, not rat ears. No clothing, no accessories of any kind.
RIGHT: Shoulder-cropped frontal portrait, framed from the top of the head down to the chest level. Face front-facing, direct gaze into the camera, calm neutral expression. The face must look exactly like the person in @image1: the same proportions, eyes, nose, lips, brows, ears, skin, wrinkles, moles, stubble if present. Below the face the neck and shoulders are covered in rat fur, and the top of the rat chest is visible in the lower part of the frame. Skin realism is critical: visible pores, fine lines, peach fuzz, natural unevenness of tone, moist natural eyes with fine iris detail. Zero skin smoothing, zero cosmetic retouching. Shot like a documentary portrait on a full-frame camera with an 85mm lens at f/8, tack-sharp focus on the eyes and skin, raw unedited photo.
LEFT: Front view, framed strictly from the base of the neck down to the feet; the head and face are completely outside the crop, the frame starts at the base of the neck, no head, no hair, no ears in this panel. Standing upright and stable, front paws lowered along the body, hind legs shoulder-width apart. Shows the front of the rat body: chest, belly, forelimbs with fingers and claws, hind legs, and the tail emerging at the side. Preserve build and proportions.
MIDDLE: Full-body BACK view, framed from the top of the head down to the feet, the whole figure in frame. Shows the back of the human head and the nape, the neck transitioning into fur, the grey rat back, shoulder blades, hind legs, and the long tail trailing down and to the side. Standing evenly, back to the camera. Same person, same build, same proportions as in the other panels.
Keep identity, the head-to-body join, fur pattern, dirt-free clean look, lighting and photographic style consistent across all panels. Match body scale in the left and middle panels. Very high resolution, realistic anatomy and realistic textures of human skin, rat fur, tail scales and claws.
DO NOT ADD: a human torso, human arms or human legs, human skin on the body below the neck, a rat snout instead of the human face, whiskers on the face, rat ears on the head, a mask or seam on the neck, a visible join line between head and body, clothing, shoes, accessories, a different head in different panels, a head in the left panel, a cropped top of the head in the middle and right panels, scenery behind the character, props, furniture, blood, horror or menacing mood, cartoon or illustrated style, 3D render, deformed fingers, extra limbs, text, labels, logos, watermarks.
Для второго персонажа используйте ровно тот же текст, заменив только загруженную фотографию.
В результате получится два изображения с человеческими лицами и крысиными телами.
Главное — проверить, чтобы нейросеть сохранила исходные черты лица, а не придумала совершенно нового человека.
Здесь всё просто.
Загружаем фотографию второго человека, используем тот же промпт и сохраняем результат.
В идеале оба персонажа должны выглядеть так, словно их снимали в одной студии: одинаковый фон, реалистичное освещение, похожий масштаб.
Это поможет видеомодели работать с референсами.
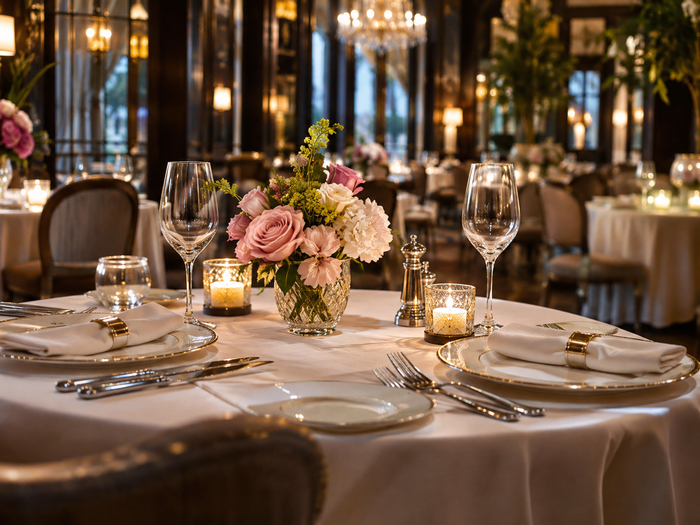
Вместо стандартного фона можно придумать собственную локацию.
Например, поставить героев в ресторан, на кухню или в другое помещение.
В исходном примере использовался очень простой запрос для генерации изображения:
Пол на фоне красивого ресторана
Получившуюся картинку сохраняем отдельно.
Теперь у нас есть три изображения: два персонажа и фон.
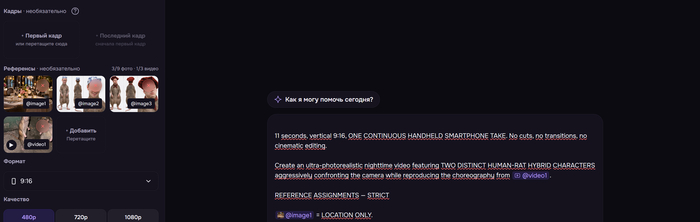
Переходим к видео.
Для генерации в исходной инструкции использовалась Kling 4.0 с режимом Omni.
Настройки: вертикальное видео 9:16, продолжительность около 11 секунд, качество 720p для тестовой генерации или 1080p для финальной при наличии такой возможности.
Добавляем изображения и видеореференс.
Файлы распределяются следующим образом:
@image1 — локация.
@image2 — персонаж справа.
@image3 — персонаж слева.
@video1 — движения из оригинального ролика.
И здесь есть важный момент: файлы нужно не просто прикрепить, а правильно связать с обозначениями в промпте.
Иначе нейросеть может перепутать лица, персонажей или даже фон.
Видеопромпт описывает короткую эмоциональную сцену.
11 seconds, vertical 9:16, ONE CONTINUOUS HANDHELD TAKE, no cuts, no edits. Shot on a smartphone at night with the phone's flash on: harsh direct light thrown forward from the lens, hard black shadows behind the figures, blown highlights on faces, visible grain, slight rolling shutter, mild motion blur on fast movement. Camera held at chest height by a person standing close, angled slightly DOWN at the subjects, with a constant natural tremble, small jolts and corrections, drifting framing, occasional refocus. Raw amateur phone footage, not a film, not a render. REFERENCES — THREE FILES, ROLES FIXED @image1 is THE LOCATION. @image2 is the CHARACTER ON THE RIGHT. @image3 is the CHARACTER ON THE LEFT. Each reference works in its own lane only: the environment comes ONLY from @image1, the right-hand character ONLY from @image2, the left-hand character ONLY from @image3. Never take a face from the location, never take a background from a character photo. Do not blend the references. THE LOCATION COMES FROM @image1 AND NOTHING ELSE — critical The setting of this video is the place shown in @image1, reproduced exactly: the same walls, the same surfaces, the same materials, the same colours, the same objects, the same proportions, the same depth and the same narrowness or openness. Do not redesign it, do not modernise it, do not add or remove anything, do not change its colour or its lighting character. THE LOCATION FROM @video1 IS FORBIDDEN AND MUST NOT APPEAR. Do not use the alley from the reference video. There must be NO narrow concrete passage, NO bare dirty concrete walls, NO green rubbish bin, NO cigarette butts, NO broken brick, NO dark stained walls, NO cramped dead-end passage. The background behind the two figures must be the place from @image1, fully and unmistakably, not an alley and not an empty abstract wall. The only thing lighting it is the phone flash from the lens, so the near surfaces are bright and the background falls into deep dark. @video1 IS THE MOVEMENT REFERENCE ONLY Use @video1 for two things only: how the two figures move and how the camera moves. Take from @video1: the timing and rhythm, the choreography beat by beat, the bounce of the knees, the sway of the bodies, the rolling of the shoulders and chest, the swinging of the arms, the head movements, the way one figure surges forward while the other drops back, the half-turn, the arm sweep, the way the two trade the foreground and the background, and the camera behaviour described below. Take NOTHING ELSE from @video1. Do not copy its subjects, its species, its bodies, its fur, its tails, its clothes, its walls, its lighting, its colours or its framing. Nothing from @video1 appears in the finished video except the motion and the camera. EMOTION — HOSTILE, CONFRONTATIONAL, NOT FRIENDLY — critical The mood is a face-off, not a party. These two are squaring up to each other, irritated and aggressive. They are not happy, not smiling, not laughing, not grinning at the lens. Both faces are hard, hostile and confrontational: brows pulled down, eyes narrowed and locked forward, jaws set and pushed slightly forward, chins lifted, lips tight or curled in a sneer, nostrils flared, teeth bared in a snarl rather than a smile. NO smile anywhere in the video, no laughing, no playful grins — not for a single frame. The choreography of @video1 is performed in that aggressive register: the same rhythm and the same bounce, but the body language reads as "get out of here, back off, what do you want" — shoulders squared and thrown forward, chest puffed out, arms jabbing toward the lens and toward each other in short accusing pointing gestures, palms pushing out in a "back away" motion, one hand sweeping across in a dismissive "get lost" wave, heads jerking forward on the beat like words being spat out. They never speak aloud: no words, no shouting, no audible voice. Everything is conveyed through the face, the glare and the aggressive gestures, with the mouth forming a snarl or a silent silent "get out of here" shape — but no sound comes out. THE TWO CHARACTERS Both are ordinary adult humans from the waist up in frame, standing on two legs, in the clothes exactly as in their own reference photos, completely unchanged. Whatever their gender, age, build, hair, clothing and styling are in @image2 and @image3, they stay identical for the whole video. @image2 stands on the RIGHT of frame, @image3 stands on the LEFT of frame. They stay on their own sides the entire time and never swap places, never merge, never trade faces or features. They perform the choreography as HUMANS: the same rhythm, the same bounce, the same swinging arms, rolling shoulders and bobbing heads — but on human bodies, with human arms and human faces. Not animal movement, not crouching, not scurrying. SHOT BY SHOT — one continuous take [00:00–00:02] Both stand where they are, squared up, bodies loose but hostile, jaws set, glaring straight into the lens, heads and shoulders rocking in time with each other — the opening of a confrontation, not a warm-up. [00:02–00:05] The RIGHT character steps forward toward the lens, dropping lower, jaw pushed out, jabbing one arm forward in short accusing points, shoulders squared, chest out, mouth curled in a snarl. The LEFT character rocks back half a step but does not back down — chin lifted, glaring, one palm pushing out in a "back off" gesture. [00:05–00:07] The RIGHT character half-turns away and sweeps one arm across in a dismissive "get lost" wave, spinning back to face the lens with teeth bared. The LEFT character slides back and sideways, then surges forward again, and the two briefly trade the foreground. [00:07–00:10] They settle into a fast alternating rhythm — one stepping in as the other steps back, arms jabbing and pushing out, heads jerking forward on the beat, both locked in a silent hostile exchange, until the take ends mid-move. CAMERA — mirror the reference Handheld phone, held close, angled slightly down at them, continuous small tremble and jolts, easing in a little when a character surges forward and pulling back when they retreat, drifting off the subject and correcting, never smooth, never stabilised. Wide-ish phone lens with mild edge distortion, deep depth of field, the phone flash throwing hard light forward. No zooms beyond the small natural drift, no orbits, no cinematic moves, no slow motion. AUDIO — NO MUSIC, NO VOICE No background music, no score, no soundtrack, no singing. No speech, no shouting, no words, no narration, no captions. Only the natural sound of the moment: sharp breathing, feet scraping on the ground, fabric shifting, the street around them. CONSTRAINTS Exactly two characters, nothing else alive in the frame. Both remain clearly the people in their own reference photos at every angle, with no drift, no blending, no hybrid faces, no identity swapping. Their clothes are unchanged. The location is exactly @image1 in every shot and is never the alley from @video1 — no concrete passage, no green bin, no brick, no cigarette butts. The mood is hostile from the first frame to the last — no smiles, no laughter, no friendly faces at any moment. The choreography and camera follow @video1, but no creature, animal, fur, tail or species from @video1 appears — only the motion. Human anatomy correct — no extra fingers, no doubled limbs, no warped faces, no plastic or smoothed skin. Everything is lit only by the phone flash and the available night light. No text, watermarks or logos. Vertical 9:16, exactly 10 seconds.
Два героя стоят перед камерой и ведут себя так, будто у них назревает серьёзный конфликт.
Они активно двигают руками, наклоняются, делают резкие жесты и смотрят прямо в объектив.
Сама камера немного трясётся, как при обычной съёмке на телефон.
Для этой части используется второй оригинальный промпт из исходной инструкции.
Важная деталь: он требует человеческих персонажей, хотя изображения мы подготовили с телами крыс. Поэтому для точного сохранения крысиных тел потребуется согласовать указания видеопромпта с референсами.
После генерации стоит внимательно посмотреть результат.
Во-первых, персонажи не должны менять лица во время движения.
Во-вторых, один герой должен оставаться справа, второй — слева.
В-третьих, нейросеть должна использовать выбранный фон, а не переносить окружение из исходного ролика.
И наконец, движения должны быть похожи на видеореференс.
Если персонажи внезапно меняются местами или превращаются друг в друга, попробуйте заново привязать изображения.
Также учитывайте, что быстрые движения рук и сложные ракурсы могут потребовать нескольких попыток генерации.
Такое бывает.
Вместо ожидаемых героев нейросеть может создать существ с неправильными пропорциями, изменить фон или придумать дополнительные движения.
Чаще всего стоит проверить три вещи: качество фотографий, правильность привязки референсов и отсутствие противоречий в текстовом запросе.
Для первого теста лучше использовать 720p, если такая настройка доступна.
И только после удачной генерации переходить к повышенному разрешению.
Для подготовки изображений и создания видео можно использовать доступные модели через AIgrator.
Сервис позволяет работать с несколькими нейросетями через единый интерфейс и пополнять баланс в рублях.
Вместо нескольких отдельных подписок можно оплачивать конкретные генерации.
Теперь для создания странного интернет-тренда достаточно пары фотографий и немного терпения.
Самое сложное — добиться того, чтобы нейросеть не меняла лица персонажей и правильно повторяла движения.
Зато можно экспериментировать с героями практически бесконечно.
А кого бы вы превратили в крыс для такого ролика?
Представьте: девушка выходит во двор выбросить мусор, случайно попадает пакетом в мужчину, который спит возле контейнеров, замечает его леопардовую шапку… А через 30 секунд они уже сидят в Mercedes, оба красивые, нарядные и счастливые.
Звучит как начало очень странной романтической комедии. Но именно такой сюжет можно повторить с помощью нейросетей, причём вместо главных героев поставить себя, друга, девушку или любых других персонажей.
Для этого понадобятся всего две фотографии, три подготовленных изображения персонажей и один большой промпт для генерации видео.
Я покажу, как собрать такой ролик в AIgrator, используя Nano Banana 2.1 и Seedance 2.5.
Сюжет начинается в обычном российском дворе. Девушка промахивается мусорным пакетом и случайно попадает в спящего мужчину. Она подходит извиниться и неожиданно замечает его леопардовую шапку.
Мужчина снимает шапку и отдаёт её девушке. Та решает забрать его домой и устроить полное преображение.
Дальше всё происходит очень быстро: мытьё, чистка зубов, стрижка, дорогой костюм и чёрный Mercedes. В конце бывший бездомный превращается в элегантного мужчину, а герои счастливо смотрят друг на друга.
Вся эта история укладывается в 30 секунд.
Главная сложность здесь не в генерации отдельных кадров, а в том, чтобы нейросеть сохранила внешность персонажей на протяжении всего видео. Ведь мужчина в начале и в конце должен быть одним и тем же человеком.
Поэтому сначала подготовим референсы.
Нам понадобятся две исходные фотографии: женская и мужская.
Желательно выбирать снимки хорошего качества, где лица хорошо видны. Лучше без сильных фильтров, размытия и солнцезащитных очков.
Использовать будем две нейросети:
Nano Banana 2.1 — для создания персонажей. Она поможет получить изображения с разных ракурсов и подготовить мужчину до и после преображения.
Seedance 2.5 — для самого видео. Ей передадим фотографии и подробный сценарий из 14 сцен.
Обе модели можно использовать через AIgrator, поэтому не придётся регистрироваться сразу в нескольких сервисах.
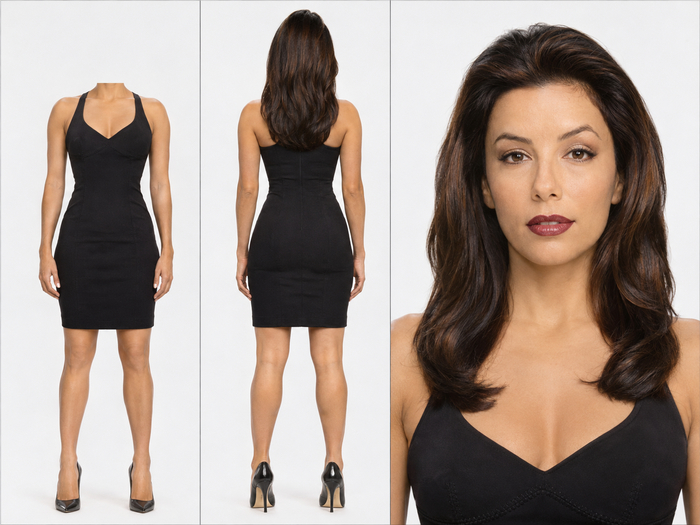
Открываем AIgrator, выбираем генерацию изображений и загружаем фотографию девушки.
Нам нужен не просто красивый портрет, а полноценный референс-лист — изображение, на котором один человек показан с разных ракурсов.
Так нейросети будет проще понять, как выглядят лицо, волосы, одежда и фигура персонажа.
Вставляем следующий промпт.
Промпт №1 — девушка
Take the person's appearance from the uploaded photos and create a character reference sheet, divided into three vertical panels on a neutral white or light-gray background. RIGHT PANEL (close-up): A close-up portrait of the person's face, cropped at the shoulders (bust shot). Face front-facing, looking directly at the camera, neutral expression, natural even lighting. Preserve all facial features and details as accurately as possible: eye shape, nose, lips, eyebrows, face shape, eye color, skin tone and texture, hair shape and color, as well as any unique features (moles, freckles, ear shape). High detail, realism, portrait quality. LEFT PANEL (back view, full body): The person standing at full height, front view, in their everyday clothing, arms along the body, feet shoulder-width apart. IMPORTANT: the head and face are completely absent — the figure is cropped at the neck/shoulder line, no head. Only the figure from the neck down is shown. Preserve body build, proportions, and clothing. MIDDLE PANEL (front view, full body): The same person, back view, in the same clothing, at full height, including the head and hair (viewed from behind). Preserve the hairstyle, body build, and clothing details. GENERAL REQUIREMENTS: Unified style, consistent lighting and figure scale across all panels, consistency of appearance and clothing between panels. Clean background, clear vertical dividers between panels. Realistic photographic style, high resolution.
После генерации сохраняем изображение. Это будет наш первый референс — @image1.
Если лицо получилось непохожим, лучше сразу повторить генерацию. В дальнейшем исправить его будет гораздо сложнее.
Теперь самое интересное.
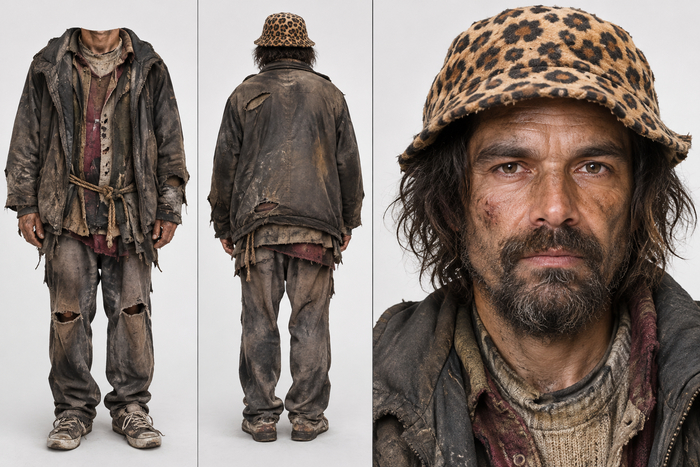
Загружаем исходную фотографию мужчины и превращаем его в персонажа, который много лет прожил на улице.
Нам нужен узнаваемый человек, но с грязными волосами, длинной неухоженной бородой, старой многослойной одеждой и потрёпанной обувью.
И обязательно леопардовая шапка.
Это ключевой предмет всего ролика. Именно она привлекает внимание девушки и запускает дальнейшие события.
При этом нейросеть не должна полностью менять лицо мужчины. Он должен оставаться узнаваемым.
Промпт №2 — мужчина до преображения
Create a photorealistic character reference sheet from the uploaded person photos: three vertical panels, clean white or light-gray background, clear vertical dividers. The RIGHT portrait panel is the widest, about 40% of the sheet width, so the face is large and highly detailed.CHARACTER CONCEPT: the same man, reimagined as a homeless person who has lived on the street for many years and wears whatever he found in the trash. Preserve his identity exactly; change only grooming, clothing and skin condition.MOST IMPORTANT DETAIL — LEOPARD-PRINT HAT: he wears a leopard-print hat on his head at all times. A soft fabric bucket hat or a flat cap with a small brim, covered in a leopard pattern — beige base with dark brown and black rosettes. The pattern is clearly readable, with realistic fabric texture, slightly worn and dirty at the brim. The hat sits low on the head, covering the top of the head and part of the forehead, with hair and beard sticking out from under it. This hat is identical in every panel where the head is visible.HAIR AND BEARD: long overgrown hair, about collar length, not too long, greasy, dirty, matted and uncombed, sticking out in different directions from under the hat, with dust and bits of debris in it. A dirty, uneven, tangled beard with a mustache, both long and greasy, with crumbs and bits caught in it, partly covering the lips. Keep the facial features clearly recognizable through the hair and beard.SKIN: weathered, sun-darkened, deep wrinkles and creases, thin uneven layers of dirt and soot, dirt in the creases, dark smudges, small scratches, scabs, a few old scars. Chapped, cracked lips, dirty broken nails, rough calloused hands. Real skin micro-texture everywhere: visible pores, fine lines, stubble under the dirt, uneven tone, dry flaky patches. No makeup, no grooming.CLOTHING — LAYERED THROWAWAY RAGS FOUND IN THE TRASH: several mismatched layers worn on top of each other at once. An oversized stained sweater under a torn padded vest or an old worn jacket, a stretched t-shirt underneath, sleeves of different garments sticking out, all of different colors and fabrics, all filthy, stained, frayed and holey. Something tied around the waist with dirty cord or a plastic bag strap. Pants torn at the knees and hem, hanging loose, stained. Shoes old and worn out: scuffed leather or sneakers with soles coming apart and gaps at the toes, holes in the fabric, laces replaced with string or wire, dirty and dusty. Chest, hips and legs are fully covered with real clothing. A couple of plastic bags or a bundle carried in one hand is optional.
BODY: the person's original height and build preserved, slightly hunched from street life, shoulders lowered.SKIN REALISM, CRITICAL: the face must look like a real unretouched documentary photograph of a real human, not a generated or airbrushed image. Show true skin micro-texture: visible pores, fine lines around the eyes and mouth, deep natural creases, tiny bumps, individual eyebrow hairs, distinct eyelashes, natural asymmetry, eyes natural and moist with fine iris detail. Zero skin smoothing, zero beauty retouching, zero plastic or waxy look.RIGHT: Shoulder-cropped frontal portrait, direct gaze into the camera, tired wary expression, mouth closed. The leopard-print hat clearly visible, hair sticking out from under it. Soft directional light from the upper side revealing skin texture and relief, gentle natural shadows. Preserve identity: facial proportions, eyes, nose, lips, brows, ears, skin tone, moles and freckles. Shot like a documentary portrait on a full-frame camera with an 85mm lens at f/8, tack-sharp focus on the eyes and skin, raw unedited photo.LEFT: Front view, framed from the neck/shoulder line down to the feet; head and face outside the crop, no hat in this panel. Standing upright, arms at the sides, feet shoulder-width apart. Shows the layered mismatched rags, the stains and holes, the torn pants, and the worn-out shoes. Preserve build and proportions.MIDDLE: Full-body BACK view, framed from the top of the head to the feet, including the head. The leopard-print hat clearly visible from behind, dirty hair sticking out under it, the back of the layered rags, the tears and stains, and the worn-out shoes seen from behind. Same person, build, proportions, hat and clothing as in the other panels.Keep identity, the leopard-print hat, clothing, dirt level, lighting and photographic style consistent across all panels. Match body scale in the left and middle panels. Very high resolution, realistic anatomy, realistic textures of skin, dirty fabric, leopard-print cloth, worn leather and dust.DO NOT ADD: any other hat, a clean hat, a hat without leopard print, no hat at all in the middle and right panels, jungle or street background, scenery behind the character, clean or styled hair, trimmed beard, makeup, clean skin, modern clean clothing, new shoes, jewelry, backpacks, shopping carts, cans or bottles, animals, other people, blood or gore, text, labels, logos, watermarks.
Сохраняем результат как @image2.
Здесь важно проверить не только лицо, но и шапку. Она должна быть именно с леопардовым принтом, а не просто коричневой или пятнистой.
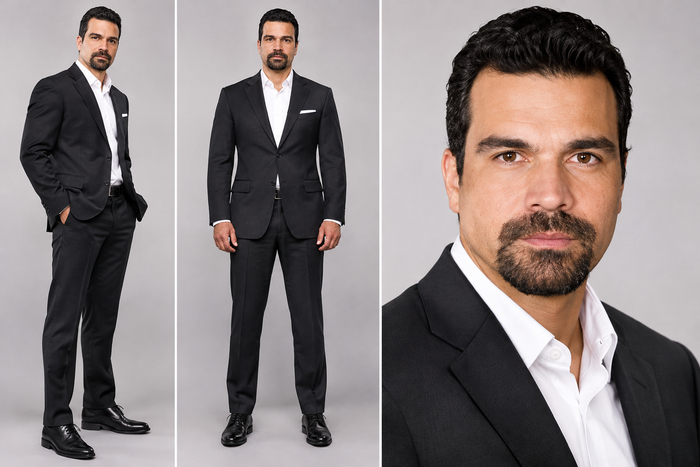
Для третьего референса снова берём исходную фотографию мужчины, а не готовое изображение бездомного.
Теперь задача противоположная: сделать персонажа чистым, аккуратно подстриженным, уверенным в себе и элегантно одетым.
Мужчина должен выглядеть как герой дорогой фотосессии — тёмный костюм, белая рубашка, аккуратная борода и причёска.
Но лицо остаётся прежним.
Промпт №3 — мужчина после преображения
Generate a premium photorealistic character reference sheet of the adult man shown in the uploaded photograph. IDENTITY PRESERVATION: Keep the original face completely recognizable. Preserve facial proportions, eyes, nose, mouth, eyebrows, jawline, natural skin tone, and distinctive features. TRANSFORMATION: The man now looks clean, well-groomed, confident, and elegantly dressed. HAIR AND BEARD: Neatly styled hair and a carefully trimmed beard, while maintaining the man's recognizable facial features and natural hair color. OUTFIT: A perfectly fitted dark charcoal tailored suit, crisp white shirt, elegant black shoes, and understated formal styling. LAYOUT: Three studio reference views. First panel: detailed frontal head-and-shoulders portrait. Second panel: full-body standing portrait. Third panel: three-quarter full-body portrait. LIGHTING: Soft premium editorial photography lighting, natural skin tones, realistic clothing textures, sharp facial details. BACKGROUND: Minimal neutral studio background. IMPORTANT: This is the exact same man as in the source photograph, not a different individual. Only grooming, styling, clothing, and presentation have changed. No facial redesign, artificial beauty filters, exaggerated features, extra people, text, or watermarks.
Сохраняем третье изображение как @image3.
Теперь у нас готовы все персонажи:
@image1 — девушка.
@image2 — мужчина до преображения.
@image3 — тот же мужчина после преображения.
Самое главное — последние два изображения должны показывать именно одного человека. Иначе видеомодель может подменить героя в середине ролика.
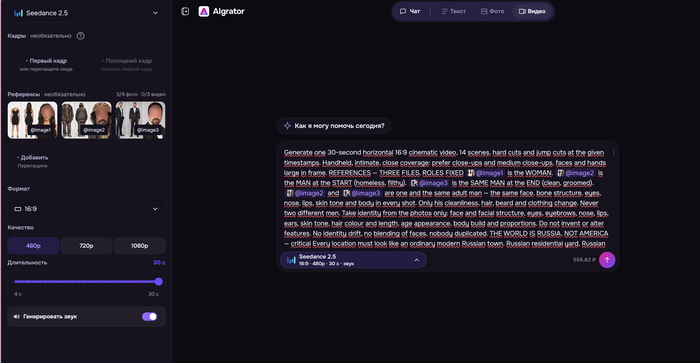
Переходим к генерации видео в AIgrator и выбираем Seedance 2.5.
Загружаем все три референса и прикрепляем их к соответствующим обозначениям.
В настройках используем продолжительность 30 секунд, горизонтальный формат 16:9 и разрешение 1080p, если оно доступно в выбранном режиме.
Для первого теста можно выбрать более низкое разрешение, чтобы не тратить лишние средства на проверку сценария.
Дальше потребуется довольно большой промпт.
Он подробно описывает 14 сцен, движения камеры, поведение персонажей, одежду, внешность и даже звуковые эффекты.
Его лучше вставлять целиком: от первого предложения до последней строки.
Generate one 30-second horizontal 16:9 cinematic video, 14 scenes, hard cuts and jump cuts at the given timestamps. Handheld, intimate, close coverage: prefer close-ups and medium close-ups, faces and hands large in frame. REFERENCES — THREE FILES, ROLES FIXED @image1 is the WOMAN. @image2 is the MAN at the START (homeless, filthy). @image3 is the SAME MAN at the END (clean, groomed). @image2 and @image3 are one and the same adult man — the same face, bone structure, eyes, nose, lips, skin tone and body in every shot. Only his cleanliness, hair, beard and clothing change. Never two different men. Take identity from the photos only: face and facial structure, eyes, eyebrows, nose, lips, ears, skin tone, hair colour and length, age appearance, body build and proportions. Do not invent or alter features. No identity drift, no blending of faces, nobody duplicated. THE WORLD IS RUSSIA, NOT AMERICA — critical Every location must look like an ordinary modern Russian town. Russian residential yard, Russian street furniture, Russian architecture and Russian everyday objects. NOT American, NOT Western European. The waste area is a typical Russian container yard: a concrete or asphalt pad, often fenced with a low metal fence, standing between panel apartment blocks, with SEVERAL ORDINARY ORANGE MUNICIPAL WASTE CONTAINERS side by side — the standard small Russian rubbish bins for household waste, roughly a metre wide, painted bright orange, made of sheet steel or thick plastic, with a rounded lid or a drop-down flap, some rusty, dented and stained, standing on a concrete pad. NOT shipping containers, NOT sea containers, NOT cargo containers, NOT large industrial metal boxes, NOT trailers, NOT anything with corrugated ribbed steel walls and heavy doors. These are simple household rubbish bins, chest-height, that a person empties a bag into. Around them: scattered black plastic bin bags, cardboard, old furniture and household rubbish, the ground dirty and stained. In the background: multi-storey panel apartment blocks with balconies and satellite dishes, bare trees, overhead wires, a concrete kerb. No wooden fences, no white picket, no lawns, no English signage anywhere. NO DIALOGUE, NO VOICE, NO SUBTITLES — critical Nobody speaks in this video. There is NO voice at all — no words, no whispering, no mumbling. The woman does NOT say anything: she communicates ONLY with her hands, shoulders and face, her mouth closed or silent. In every close-up her lips are relaxed and not shaping syllables. No lip-sync, no narration, no off-screen voice, no captions, no subtitles, no on-screen text. THE WOMAN — wardrobe and look by stage Her face, hair, build, gender and age come entirely from @image1 and never change. SCENES 1–12 — everyday clothes of her own: plain jeans and a casual top, ordinary and unremarkable. Hair simply as in @image1, no styling. SCENES 13–14 — a floor-length black evening gown, elegant and fitted, her hair styled, full evening makeup and earrings. Same face, only polished and dressed up. THE LEOPARD-PRINT HAT — the key object of the whole video The man from @image2 wears a LEOPARD-PRINT HAT on his head. This hat is the single most important object: the whole connection between the two people happens because of it. Soft fabric hat covered in leopard print — tan and black spots on a beige ground. Same pattern, same colours, same shape in every shot. Never plain, never a different colour, never a baseball cap, never missing. THE MAN, BEFORE (scenes 2–6) — exactly the look of @image2: ragged dirty layers, dirty shoes, filthy hands and nails, unwashed greasy hair under the leopard hat, patchy scruffy beard, grime on the face and neck. Worn out and completely indifferent to himself — no anger, no energy, just tired flat calm. THE MAN, AFTER (scenes 11–14) — exactly the look of @image3: clean fresh skin, hair tidy, beard trimmed to match @image3's face, and a beautiful tailored suit. His face, hair and beard state must match @image3 at the end. SETTINGS 1) A Russian residential yard with a container yard for household waste: fenced concrete pad, several ordinary ORANGE MUNICIPAL WASTE CONTAINERS — chest-high household rubbish bins, orange, steel or plastic, with lids — piles of bags and rubbish around them, panel apartment blocks and bare trees behind. 2) A beautiful large red-brick private house with a driveway. 3) A tiled washing area against a wall of beige tiles with a shower head mounted high on the wall, a large plastic basin on the floor, and a KARCHER high-pressure washer with its lance and hose. 4) A bathroom with a mirror. 5) A bedroom. 6) The driveway of the house with a sleek GLOSSY BLACK MERCEDES sedan parked on it, evening light. 7) The interior of that Mercedes, evening, city lights passing outside. COLOUR AND LIGHT Container yard: cool, grey, natural overcast daylight, slightly desaturated, drab. House and washing area: warm, clean, bright. Bathroom and bedroom: soft warm indoor light. Driveway and car: warm golden evening light, city bokeh outside the windows. The grade warms steadily from the first shot to the last. SCENE BY SCENE [00:00–00:02] Scene 1. Handheld follow shot from BEHIND the woman, roughly 35mm, at shoulder height. She walks across the concrete yard carrying a black plastic rubbish bag. She stops a couple of metres from an orange waste container and tosses the bag underarm. It sails past and MISSES — it hits the side of the bin and drops down to the right, in front of it, into a pile of other bags and rubbish on the ground. [00:02–00:04.5] Scene 2. Close-up low to the ground among the bags: the man from @image2 lies asleep on a piece of cardboard in the rubbish, curled up, the leopard-print hat on his head. The bag drops straight onto him. He jerks, pulls in and flinches, an annoyed grunt, brushing the bag away with one hand. [00:04.5–00:07.5] Scene 3. THREE SECONDS. Two-shot, handheld, camera at the woman's standing height so we look slightly DOWN at him. She has stepped back a little, a hand raised, shoulders lifted, head tipping forward in a small bow — a silent apology with her mouth closed. She takes a couple of steps closer, still gesturing sorry. He DOES NOT STAND UP and never rises. He only props himself up on one elbow, half-reclining in the rubbish, and looks up at her from below. His face is flat and neutral and kind — NO smile, no grin, no teeth. Just tired, indifferent calm, the look of a man to whom nothing matters any more and who is not remotely offended. He lifts his RIGHT hand at chest height — palm down, a short soft loose flick of the wrist downward, pushing the apology away — "forget it, it's nothing". His head gives one small lazy tilt and a single slow nod. Then his hand drops back down and he stays half-lying. [00:07.5–00:09] Scene 4. Handheld shot from slightly above and BEHIND the woman's right shoulder, looking DOWN at him where he lies propped on his elbow. We see her back and her right arm come up, index finger pointing straight down at the leopard-print hat on his head. THE INTENT IS WONDER, NOT COMMAND. She is delighted and charmed by it — her head tips forward, her shoulders lift, she points in a bright, eager "oh, what a hat, look at that hat" way, curious and pleased, NOT haughty, NOT demanding, NOT snapping her fingers, NOT pointing as if ordering someone around. Read as: "oh, what a nice hat." [00:09–00:10.5] Scene 5. Close-up on the man, roughly 50mm, from slightly above, still half-lying. His eyes flick up toward her finger, then to her face, then he reaches up with both hands, takes the leopard-print hat off his head and holds it up toward her, brim forward, eyebrows lifted a little — a silent offer, as if asking "you need this hat?" His dirty hair is now visible. [00:10.5–00:12] Scene 6. Macro close-up, the object passing between them: his dirty hand holding the leopard-print hat, her clean hand coming down into frame and taking it, the fabric clearly visible as their hands touch. Hold on the transfer. [00:12–00:14] Scene 7. Handheld follow shot from BEHIND both of them: we see their BACKS. They walk side by side, AWAY from the camera, TOWARD the red-brick house, which stands ahead of them in the centre of the frame and grows closer. They glance at each other easily, and she is carrying the leopard-print hat. They never walk toward the camera. [00:14–00:16] Scene 8. JUMP CUT. The tiled washing area. The man from @image2 stands against the beige tiles in his dirty ragged clothes. The woman is off-camera to the right — only her arms, the KARCHER high-pressure washer lance and its hose enter the frame, still in her everyday clothes. She squeezes the trigger: a HARD, NARROW, POWERFUL jet of water blasts into him at high pressure — a violent concentrated stream that slams into his chest and shoulders, soaking him through instantly, water spraying and misting everywhere, the fabric pressed flat against his body, dirt and grime blasted off and running down the tiles in dark streaks. He flinches hard, turns his head aside and raises one forearm against the force of it. Close-ups on the jet striking the filthy fabric, on mud being torn off skin, on water exploding off the tiles. Industrial pressure washer, NOT a garden hose. Then he turns his back to her and she works the jet down his back and shoulders. [00:16–00:18] Scene 9. JUMP CUT, two quick beats. Her hands drop his soaked filthy clothes into a plastic basin on the floor. Then he stands under the falling water of the shower head, stripped to the waist, water pouring over his shoulders and back, clean skin finally appearing. [00:18–00:20] Scene 10. JUMP CUT. The bathroom. She stands in front of him brushing his teeth — a toothbrush in his mouth, her hand working it fast and hard, his mouth filling with thick white foam that dribbles down his chin. His eyes are CALM and half-relaxed, not wide, not startled, not bulging — a quiet, slightly uneasy look, a man mildly alarmed by how vigorously she is scrubbing but going along with it. [00:20–00:23] Scene 11. JUMP CUT. He sits in a chair with a towel around his shoulders and she TRIMS HIS HAIR WITH A PAIR OF SCISSORS. She takes one small lock of hair at the SIDE of his head, beside and just above the ear, holds it between two fingers and snips a little off the ends — just a slight trim, tidying the ends, NOT cutting it down to the skin, NOT shaving, NOT a short cut. Only a small amount of hair falls away, a light tidy-up, as if she is simply removing the dead ends. Close-up on the scissors and the small clipped strands dropping onto the towel. NO ELECTRIC CLIPPERS ON HIS HEAD AT ANY MOMENT. The hair stays long on top and at the sides. Then, separately, an electric trimmer runs along the UNDERSIDE of his beard and jaw to take off the loose excess hair at the neck and the edges, tidying the beard down a little — the body of the beard stays as it is. After this scene his hair and beard are neat, close to @image3's look, and stay consistent in scenes 12, 13 and 14. [00:23–00:25] Scene 12. JUMP CUT. The bedroom. He stands there washed and groomed, close to @image3's look. She steps in behind him, seen from behind his shoulder, still in her everyday clothes, and holds out a beautiful tailored suit on a hanger. He takes it, looks at it, runs his hand over the fabric, and his face opens into pleased surprise. [00:25–00:27] Scene 13. JUMP CUT. The driveway of the house in warm evening light. A sleek glossy black Mercedes sedan stands there. The WOMAN now looks completely transformed: floor-length black evening gown, styled hair, full evening makeup and earrings. She stands beside the car, holding up a set of car KEYS and jingling them slightly, gesturing at the car with her other hand — open, generous, delighted, as if to say "this is yours, take it". The man stands facing her in the suit, disbelieving, looking at the keys, then the car, then her. She presses the keys into his hand and smiles. [00:27–00:30] Scene 14. Inside the Mercedes, evening, warm golden light, city lights sliding past the windows. First a WIDER TWO-SHOT from the dashboard side: he is on the RIGHT in the driver's seat in the suit, she is on the LEFT in the passenger seat in the black evening gown — both happy, swaying gently, slow easy melodic body movements, heads tipping and rolling in relaxed rhythm. Then a CLOSE-UP of her face as she turns and looks at him, warm and soft. Then a CLOSE-UP of his face as he turns and looks at her, smiling. The video ENDS on that close-up of his eyes on her. No fade-out, no darkening, no black frames. CAMERA Handheld throughout, small natural imperfections, shallow depth of field in the close-ups. Hard cuts and jump cuts only, at exactly the listed timestamps. No slow motion, no speed ramps, no morphs, no fades, no added shots. AUDIO — NO MUSIC, NO VOICE There is no background music, no score, no soundtrack, no piano, no strings, no singing anywhere in the video. There is no speech, no voice and no dialogue anywhere. Only natural sounds from inside the scenes: city hum, passing cars, footsteps, the thud of the bag landing, the roar of the Karcher pressure washer and water slamming off tiles, water running, a toothbrush, the snip of scissors, the buzz of a beard trimmer, keys jingling, a car door, an engine, tyres on asphalt, wind. CONSISTENCY AND CONSTRAINTS The same man from @image2 and @image3 in every scene — same face, same build, one person at two states. Before the washing he is filthy in ragged clothes with long unwashed hair and a scruffy beard; after the trim he is clean, groomed and close to @image3. Dirt and rags never appear again after scene 9. The waste bins are ordinary orange household rubbish bins, never shipping or sea containers. He never stands up in scenes 2 to 6 — he stays propped on one elbow, half-reclining, and everyone looks down at him. The same woman from @image1 in every scene — same face throughout. Everyday clothes in scenes 1 to 12, black evening gown with evening makeup only in scenes 13 and 14. The leopard-print hat stays identical whenever it appears, never worn after scene 6. Everything looks Russian, never American. No English text anywhere. Nobody speaks, nobody is off-screen voiced, no lips form words, no subtitles and no captions. Correct anatomy and hands, no extra fingers, no warped faces, no plastic or smoothed skin, no cartoon look. No other people except anonymous blurred passers-by in the far background. Horizontal 16:9, exactly 30 seconds.
После вставки проверьте привязку всех изображений. В некоторых интерфейсах недостаточно просто написать @image1 — нужно отдельно выбрать соответствующий файл.
Промпт специально составлен на английском языке. Переводить его не обязательно.
После генерации советую сначала посмотреть видео полностью, а уже потом оценивать отдельные кадры.
Особенно внимательно проверьте три момента.
Первый — внешность героев. Девушка должна оставаться узнаваемой на протяжении всего ролика. А мужчина до и после преображения должен выглядеть как один человек, хотя одежда, причёска и борода меняются.
Второй — леопардовая шапка. Нейросети иногда меняют цвет, форму или рисунок аксессуаров. Здесь это особенно заметно, потому что вокруг шапки строится весь сюжет.
Третий — последовательность событий. Важно, чтобы нейросеть не перепутала сцены и не показала мужчину в костюме раньше, чем он приведёт себя в порядок.
Если модель пропустила отдельные действия, это необязательно проблема промпта. В 30 секунд нужно уместить 14 сцен, поэтому даже хорошая видеомодель может объединять события или сокращать их.
Мужчина превращается в другого человека.
Это одна из самых распространённых проблем при генерации видео с преображением.
Проверьте второй и третий референсы. Лица должны быть одинаковыми, несмотря на различия в одежде и бороде. Если изображения получились слишком разными, лучше переделать один из вариантов.
Нейросеть неправильно показывает руки и пальцы.
Такие ошибки особенно заметны в моментах передачи шапки, чистки зубов и стрижки.
Иногда помогает повторная генерация. Также можно сократить количество сложных движений в одной сцене.
Вместо российского двора появляется американская улица.
В промпте специально указаны российские панельные дома, оранжевые мусорные контейнеры и характерные детали двора.
Если модель всё равно создаёт неподходящую локацию, можно подготовить отдельный референс окружения.
Видео получается слишком быстрым.
В сценарии всего 30 секунд, а событий довольно много.
Если все действия невозможно нормально рассмотреть, попробуйте разделить сюжет на три отдельных ролика: знакомство, преображение и финал.
После этого их можно соединить в видеоредакторе. Такой подход потребует немного больше работы, зато даст больше контроля над каждой сценой.
Для первых экспериментов можно использовать стартовые предложения AIgrator, если они доступны вашему аккаунту.
Но важно учитывать, что создание длинного видео в высоком разрешении обычно требует больше ресурсов, чем генерация одного изображения.
Поэтому перед запуском лучше проверить стоимость и доступные параметры модели.
Для тестов можно сначала подготовить три референса и создать пробную генерацию, а уже после этого переходить к финальной версии.
Получился довольно необычный способ сделать собственную романтическую комедию буквально из двух фотографий.
Самое сложное здесь — не придумать сюжет, а добиться того, чтобы нейросеть правильно сохраняла внешность героев и последовательность действий.
С этим помогают подготовленные референсы и подробный промпт, в котором расписаны все сцены.
Конечно, с первого раза результат может получиться неидеальным. Но именно возможность экспериментировать с персонажами делает такие ИИ-тренды интересными.
А теперь вопрос: кого бы вы поставили на место главных героев? Себя со второй половинкой, друзей или вообще персонажей какого-нибудь фильма?
Для ИИ-фотосессии достаточно одной чёткой фотографии лица без фильтров. Загрузите её как референс и добавьте: «сохрани черты лица, причёску и естественную текстуру кожи». Для соцсетей используйте вертикальный формат 4:5. генерация ИИ-фото бесплатно

Фотореалистичный портрет взрослого мужчины у большого окна, тёмная водолазка, мягкий боковой свет, спокойный уверенный взгляд, кинематографичная цветокоррекция, объектив 85 mm, вертикальный кадр 4:5.
Уверенный взрослый мужчина в современном офисе, классический костюм без галстука, лаконичный интерьер, мягкий дневной свет, профессиональная деловая фотосъёмка, вертикальный кадр 4:5.
Мужской street style портрет в вечернем городе, кожаная куртка, неоновые вывески, отражения на мокром асфальте, сине-оранжевая кинематографичная палитра, объектив 35 mm, вертикальный кадр 4:5.
Взрослый мужчина в горах на рассвете, практичная походная одежда, величественный пейзаж, золотой контровой свет, лёгкий туман, приключенческая editorial photography, вертикальный кадр 4:5.
Минималистичный мужской портрет на нейтральном сером фоне, белая рубашка, спокойная уверенная поза, мягкий свет большого софтбокса, реалистичная кожа, вертикальный кадр 4:5.
Естественный портрет взрослого мужчины в уютной кофейне, повседневный многослойный образ, чашка кофе, мягкий свет из окна, непринуждённая поза, вертикальный кадр 4:5.

Атлетичный взрослый мужчина в современном спортзале, однотонная спортивная одежда, уверенная поза после тренировки, контрастный студийный свет, реалистичная анатомия, вертикальный кадр 4:5.
Мужской портрет в классической библиотеке, тёмный пиджак и светлая рубашка, книги на фоне, мягкий тёплый свет, спокойная харизма, cinematic portrait photography, вертикальный кадр 4:5.
Взрослый мужчина рядом с классическим автомобилем, элегантный повседневный костюм, атмосфера европейского кино 1960-х, тёплая плёночная цветокоррекция, золотой час, вертикальный кадр 4:5.
Чёрно-белый крупный портрет взрослого мужчины, жёсткий боковой свет, глубокие тени, нейтральный фон, сдержанная эмоция, выразительная плёночная фактура, объектив 85 mm, вертикальный кадр 4:5.
Чтобы получить лучший результат, используйте фото без очков и сильных теней. Если нейросеть меняет внешность, добавьте: «максимальное сходство с референсом, сохранить форму лица, носа, глаз и линию роста волос».генерация ИИ-фото бесплатно
Какой мужской образ добавить в следующую подборку?

Создать вирусное видео для TikTok, YouTube Shorts теперь можно буквально по нескольким фотографиям. Нейросети позволяют заменить персонажей в популярных роликах, повторить танец, перенести собственное лицо в смешную сценку или создать необычный видеотренд без съёмки и монтажа.
Особенно популярна генерация ИИ-трендов по готовым шаблонам. Пользователю не нужно самостоятельно писать промпт, подбирать настройки камеры или описывать каждое движение. Достаточно выбрать понравившееся видео, загрузить фотографии и запустить генерацию.
Например, можно повторить тренд «Мои слёзы не помогут», сделать видео с танцующим Румпельштильцхеном, показать, как муж готовит кофе мимо кружки, или создать эффектный баскетбольный трюк.
Мы собрали пять сервисов для создания трендовых ИИ-видео: Study24 AI, AiHere, Avalava AI, Doitong и GPTunneL. Расскажем, как пользоваться каждой платформой, какие ролики можно создавать и где искать готовые шаблоны.

Первый сервис в нашей подборке — Study24 AI. Это агрегатор нейросетей с инструментами для генерации изображений, видео, текстов и другого контента.
Для создания популярных роликов на платформе предусмотрен отдельный инструмент «Трендовое видео». Он позволяет использовать заранее подготовленные сценарии и заменять персонажей собственными фотографиями.
Главное преимущество Study24 AI — простой процесс создания видео. Не нужно самостоятельно искать длинные промпты для Seedance, Kling или других генераторов. Основные действия персонажей, движения камеры и визуальные эффекты уже предусмотрены шаблоном.
Как сделать ИИ-тренд в Study24 AI
Откройте Study24 AI и войдите в свой аккаунт. После авторизации перейдите в каталог ИИ-агентов и найдите раздел с трендовыми видео.
Выберите понравившийся сюжет и посмотрите исходный ролик. Это поможет понять, какие действия будет выполнять персонаж и сколько фотографий понадобится.
Затем загрузите свои изображения. Для одиночного тренда обычно достаточно одного снимка, а для сцен с двумя героями могут потребоваться две отдельные фотографии.

AiHere — онлайн-сервис с готовыми шаблонами для генерации изображений и видео.
Платформа ориентирована на пользователей, которые хотят повторить уже существующий интернет-тренд, не составляя промпт самостоятельно.
В каталоге представлены танцевальные ролики, необычные превращения, сцены из фильмов, видео с несколькими персонажами и персонализированные визуальные эффекты.
Одна из интересных особенностей AiHere — возможность заранее посмотреть пример генерации.
Пользователь сразу видит, как будет выглядеть будущий ролик, какие персонажи участвуют в сцене и какие фотографии нужно подготовить.
Перейдите в библиотеку видеошаблонов и найдите понравившийся сюжет.
Откройте его страницу, посмотрите пример и нажмите кнопку применения шаблона.
После этого загрузите необходимые фотографии. Если ролик рассчитан на двух участников, используйте отдельное изображение для каждого.

Avalava AI — платформа для создания изображений и видеороликов с помощью заранее подготовленных ИИ-эффектов.
В библиотеке сервиса представлены разнообразные сценарии: от реалистичных фотосессий до юмористических видео с несколькими персонажами.
Главная особенность Avalava — персонализация готовых эффектов.
Пользователь выбирает понравившийся ролик, загружает собственное изображение, а нейросеть создаёт новую версию с его внешностью.
Это удобно для коротких видео, где важны конкретные действия и реакции персонажей.
Doitong — платформа для создания изображений, видеороликов, мультфильмов и другого контента с помощью нейросетей.
В отличие от сервисов, которые делают основной упор на библиотеку готовых эффектов, Doitong предлагает инструменты для создания оригинальных видеосюжетов.
Например, можно придумать историю о маленьком коте-пекаре, фантастическом существе или персонаже собственного мультсериала.
Нейросети помогут превратить идею в отдельные сцены, подготовить изображения и создать анимацию.
Как создать видео в Doitong
Перейдите на платформу и авторизуйтесь.
Выберите инструмент для создания видео или работы со сценарием.
Опишите идею будущего ролика, подготовьте изображения персонажей и выберите доступную видеомодель.
Если хотите создать мультфильм, лучше заранее определить внешность главного героя и подготовить несколько референсов.
GPTunneL — сервис с инструментами искусственного интеллекта и библиотекой готовых рабочих процессов.
Одна из особенностей платформы — раздел Workflow. Здесь размещаются сценарии, которые объединяют несколько действий для получения определённого результата.
Например, один Workflow может включать подготовку изображения, его обработку и последующую генерацию видео.
В каталоге встречаются решения для мультфильмов, рекламных роликов, музыкальных клипов и необычных визуальных эффектов.
Как создать видео через GPTunneL
Откройте раздел Workflow и выберите подходящий сценарий.
Посмотрите, какие материалы требуются для запуска. В зависимости от инструмента это может быть фотография, текстовое описание или несколько референсов.
Готовые видеошаблоны особенно удобны, когда вы уже увидели популярный ролик и хотите создать аналогичную версию со своим лицом.
Сейчас интерес вызывают музыкальные тренды, необычные танцы, комедийные сценки и динамичные спортивные видео.
Рассмотрим четыре сюжета, которые можно использовать для первых экспериментов с нейросетями.
Один из узнаваемых музыкальных трендов — эмоциональная сцена под песню Светы «Мои слёзы не помогут».
Этот ролик также ищут по строчке «Я прошу, не обижай».
В оригинальном видео два персонажа стоят лицом к лицу. Один начинает исполнять песню, второй эмоционально реагирует, а камера переключается между героями.
Особенность такого сюжета — возможность заменить обоих участников на собственных персонажей.
Например, вместо оригинальных героев могут появиться вы и ваша девушка, два друга или вымышленные персонажи.
Ещё один необычный ИИ-тренд связан со сказочным персонажем Румпельштильцхеном.
Сюжет разворачивается внутри старого сарая, заполненного сеном. Девушка сидит среди соломы, когда из-за стогов неожиданно появляется маленький мужчина с хитрой улыбкой.
Он прикладывает палец к губам, привлекает внимание девушки, а затем начинает забавно танцевать.
Главная идея тренда — заменить лица обоих героев на знакомых людей.
Например, в роли Румпельштильцхена может оказаться ваш парень или друг, а второго персонажа можно заменить собственной фотографией.
Как сделать тренд с Румпельштильцхеном
В AiHere опубликован готовый шаблон этого сюжета.
Откройте библиотеку видеотрендов, найдите ролик с Румпельштильцхеном и посмотрите пример.
После этого подготовьте две фотографии и загрузите их в соответствующие поля.
Проверьте распределение ролей и запустите генерацию.
Преимущество готового шаблона — не требуется самостоятельно описывать сарай, солому, действия персонажей и последовательность танца.
После получения результата можно добавить короткую юмористическую подпись.
Например: «Когда сказал, что умеет поднимать настроение».
Тренд «Кофе мимо кружки» основан на простой бытовой ситуации, которая постепенно превращается в абсурдную комедию.
В кадре мужчина уверенно рассказывает, как правильно приготовить кофе. Он берёт ложку молотого порошка, подносит её к красной кружке, но высыпает кофе прямо на столешницу.
Женщина стоит рядом и наблюдает за происходящим с нарастающим удивлением.
Мужчина продолжает насыпать кофе мимо чашки, словно ничего необычного не происходит.
В финале на стол попадают вода и молоко. Вместо готового напитка образуется большая кофейная лужа, а мужчина поднимает пустую кружку и недоумённо смотрит на женщину.
Смешной эффект создаётся благодаря серьёзному выражению лица главного героя и эмоциональной реакции второго персонажа.
Для любителей динамичных видео подойдёт тренд с эффектным баскетбольным броском и провокационным завершением.
В ролике два игрока находятся на уличной баскетбольной площадке.
Один спортсмен начинает движение к кольцу, обходит соперника и выполняет эффектный прыжок с мячом.
После попадания в корзину он приземляется, поворачивается ко второму игроку и демонстративно показывает средний палец.
Сочетание красивого спортивного момента и неожиданного жеста делает ролик запоминающимся.
Как создать баскетбольный тренд через нейросеть
Для персонализации подготовьте фотографии двух участников.
Первый будет выполнять баскетбольный трюк, второй сыграет роль соперника.
Выберите соответствующий видеошаблон, если он доступен в выбранном сервисе, или воспользуйтесь моделью для генерации видео по референсам.
При самостоятельном создании важно правильно задать последовательность действий: ведение мяча, прыжок, попадание, приземление и финальный жест.
Для подобного сюжета особенно важны реалистичные движения рук и сохранение траектории баскетбольного мяча.
После генерации ролик можно дополнить звуковыми эффектами или короткой подписью.
Создание ролика по готовому шаблону обычно занимает меньше действий, чем самостоятельная генерация с нуля.
Сначала выберите подходящий сервис. Для быстрого повторения популярных трендов стоит начать со Study24 AI, AiHere или Avalava.
Откройте каталог и найдите понравившийся сюжет.
Перед запуском посмотрите пример оригинального видео. Это поможет определить, сколько персонажей участвует в сцене и какие фотографии необходимо подготовить.
Затем загрузите изображения.
Если шаблон рассчитан на одного человека, обычно достаточно одного портрета. Для сцен с двумя персонажами лучше использовать отдельные фотографии каждого участника.
Убедитесь, что изображения правильно распределены по ролям.
Например, в тренде «Кофе мимо кружки» одна фотография должна соответствовать персонажу, который готовит кофе, а вторая — наблюдающему участнику.
После загрузки проверьте стоимость генерации и настройки, если они доступны.
Нажмите кнопку создания видео.
Когда обработка завершится, просмотрите результат полностью. Если лица сохранились правильно, движения выглядят естественно и сюжет соответствует шаблону, сохраните ролик.
Готовое видео можно использовать в социальных сетях или дополнительно обработать в видеоредакторе.
Для качественной замены персонажей важно правильно подобрать исходные фотографии.
Нейросетям проще работать с изображениями, на которых лицо хорошо видно и отсутствуют сильные искажения.
Лучше всего подойдут чёткие портреты с естественным освещением.
Если в ролике используются крупные планы, особенно важно, чтобы были хорошо различимы глаза, нос, губы и форма лица.
Для танцевальных трендов могут понадобиться фотографии в полный рост.
Если необходимо сохранить определённую одежду, выбирайте снимки, на которых хорошо видны соответствующие детали.
Для парных сюжетов желательно использовать отдельные фотографии участников. Это уменьшает вероятность того, что модель перепутает персонажей.
Избегайте сильных фильтров, размытия и фотографий, на которых лицо закрыто руками или посторонними предметами.
Также важно помнить, что даже качественный референс не гарантирует идеального сохранения внешности во всех кадрах.
При самостоятельной генерации пользователь должен подробно описать будущую сцену.
Например, для ролика с баскетбольным трюком необходимо указать расположение игроков, движения, траекторию мяча, работу камеры и последовательность действий.
Для музыкального тренда дополнительно потребуется объяснить взаимодействие персонажей и синхронизацию губ.
Готовый шаблон избавляет от значительной части этой работы.
В нём заранее предусмотрены основные действия, внешний вид сцены и параметры генерации.
Пользователь выбирает сюжет, загружает фотографии и запускает создание видео.
Это особенно удобно новичкам, которые ещё не умеют составлять сложные промпты.
Однако у шаблонов есть ограничение: изменить готовую постановку бывает сложнее, чем при самостоятельной генерации.
Если необходимо полностью поменять сюжет, добавить новые действия или создать собственного персонажа, лучше использовать обычный видеогенератор.
Некоторые сервисы предлагают ознакомительные генерации или бонусы для новых пользователей.
Возможность создать ролик без оплаты зависит от выбранной площадки, шаблона и доступного баланса.
Например, стоимость короткого видео с одним персонажем может отличаться от генерации сложной сцены с несколькими участниками.
Перед запуском рекомендуется проверить условия использования, количество доступных попыток и возможность скачивания готового результата.
Также стоит обратить внимание на поддержку высокого разрешения и наличие водяных знаков.
Готовые ролики можно использовать на разных площадках.
TikTok. Подходит для коротких юмористических сцен, танцевальных трендов и необычных превращений.
Удобен для парных видео, популярных эффектов, персонализированных мемов и развлекательного контента.
YouTube Shorts. Можно публиковать короткие мультфильмы, трендовые ролики и видео с постоянными персонажами.
ВКонтакте. ИИ-видео подходят для клипов, публикаций в сообществах и развлекательных подборок.
Для вертикальных роликов обычно используют соотношение сторон 9:16.
Если видео создавалось без музыки, звуковое сопровождение можно добавить при монтаже или через музыкальную библиотеку социальной сети.
При использовании фотографий других людей желательно получить их согласие, а при публикации учитывать требования площадки к синтетическому контенту.
Для повторения популярных роликов по готовым шаблонам можно использовать Study24 AI, AiHere и Avalava. Для собственных сюжетов и мультфильмов стоит рассмотреть Doitong, а для многоэтапной генерации — GPTunneL.
Да. В сервисах с готовыми шаблонами достаточно выбрать сюжет, загрузить фотографии и запустить генерацию. Некоторые шаблоны могут потребовать дополнительных параметров.
Найдите подходящий видеошаблон, загрузите качественную фотографию и укажите нужную роль персонажа. После генерации проверьте сохранение внешности.
Для точного повторения сцены потребуются две фотографии и оригинальный видео-референс. Можно использовать сервис с соответствующим шаблоном либо видеомодель, поддерживающую замену персонажей по референсам.
В AiHere есть готовый шаблон с Румпельштильцхеном. Выберите его, загрузите фотографии участников и запустите генерацию.
Да. Для создания персонализированного ролика понадобятся фотографии двух участников и подходящий шаблон либо исходное видео с инструкцией для нейросети.
Да. Для этого можно использовать инструменты Doitong или GPTunneL. Желательно заранее подготовить персонажей, определить визуальный стиль и разделить историю на короткие сцены.
Да, при соблюдении правил YouTube, требований к правам на исходные материалы и маркировке синтетического контента в случаях, когда она необходима.
Генерация ИИ-трендов по готовым шаблонам позволяет создавать развлекательные видеоролики без съёмок, профессионального монтажа и самостоятельного написания промптов.
Для быстрого повторения популярных сюжетов можно использовать Study24 AI, AiHere и Avalava AI. Эти площадки предлагают готовые видеоэффекты и инструменты для персонализации персонажей.
Если хочется создавать оригинальные истории, мультфильмы или короткие сериалы, стоит обратить внимание на Doitong.
GPTunneL подойдёт тем, кто предпочитает использовать готовые Workflow и объединять несколько этапов генерации в одном процессе.
Для первого эксперимента можно выбрать один из четырёх трендов: «Мои слёзы не помогут», танец Румпельштильцхена, «Кофе мимо кружки» или стритбол со средним пальцем.
Подготовьте подходящие фотографии, найдите готовый сценарий и запустите генерацию. После этого останется сохранить ролик, добавить музыку или подпись и опубликовать результат.
9 ноября 2026 года компания Anthropic выпустила Claude Fable 5.2 — новую версию своей мощной нейросети для программирования, аналитики, исследований и выполнения сложных задач. Обновление оказалось заметным: модель стала быстрее, улучшила результаты тестов и научилась эффективнее работать с многоэтапными заданиями.
Но насколько Claude Fable 5.2 превосходит предыдущую Fable 5.1? Стоит ли переходить на неё с Claude Opus 5.5 или Sonnet 5.5? И главное — как пользоваться новой нейросетью в России без иностранной банковской карты?
Разберём реальные изменения, сравним модели Anthropic и рассмотрим пять агрегаторов нейросетей: Study24 AI, Aigrator AI, Syntx AI, MashaGPT и GoGPT.

Claude Fable 5.2 ориентирована на сложные профессиональные задачи, где нейросети необходимо не просто ответить на вопрос, а выполнить последовательность действий, разобраться в большом объёме информации или самостоятельно найти решение.
По данным разработчика, Claude Fable 5.2 способна генерировать ответы до 30% быстрее предыдущей версии.
Это особенно заметно при выполнении продолжительных заданий: анализе программного кода, подготовке сложных технических документов и работе с несколькими взаимосвязанными задачами.
Также появился дополнительный Fast Mode, способный ускорять генерацию токенов до 2,5 раза. Однако это отдельный платный режим, который поддерживается не всеми платформами.
Одно из главных достижений Fable 5.2 — работа с программным кодом.
Модель лучше справляется с поиском ошибок, изменением архитектуры приложений и выполнением задач, состоящих из множества последовательных шагов.
В тесте FrontierCode 2.0 новая версия получила 49,1%, тогда как Fable 5.1 показала 32,4%.
Это серьёзный прирост, особенно для разработчиков, использующих ИИ при работе с большими проектами.
Например, Claude Fable 5.2 можно поручить изучение структуры приложения, поиск проблем производительности и составление плана рефакторинга. Если используемая платформа предоставляет необходимые инструменты, модель также может участвовать в реализации и проверке изменений.
Claude Fable 5.2 получила улучшения в интерпретации визуальной информации.
В тесте Chartography, оценивающем понимание графиков без дополнительных инструментов, результат модели вырос с 44,8% до 73,4%.
Это делает её интересным инструментом для финансовых аналитиков, исследователей и специалистов, которым приходится работать с диаграммами, отчётами и сложными документами.
Например, можно загрузить график продаж и попросить нейросеть выявить изменения показателей, объяснить возможные причины и подготовить выводы.
При этом числовые результаты необходимо перепроверять, особенно если от них зависят финансовые или управленческие решения.
Claude Fable 5.2 поддерживает контекстное окно до 1 миллиона токенов и генерацию ответа объёмом до 128 тысяч токенов.
Это позволяет работать с большими объёмами информации: документацией, кодовыми базами, исследованиями и длинными текстами.
Однако аналогичный размер контекста поддерживала и Fable 5.1. Поэтому само по себе контекстное окно не является новым преимуществом версии 5.2.
Также стоит учитывать, что агрегаторы могут устанавливать собственные ограничения на размер загружаемых файлов и сообщений.
Claude Opus 5.5 остаётся сильной моделью для большинства профессиональных задач.
Сама Anthropic рекомендует начинать повседневную работу с Opus 5.5, а Fable 5.2 использовать в случаях, когда требуется особенно сложный анализ или продолжительная автономная работа.
Claude Opus 5.5 подойдёт для:
Написания и редактирования статей.
Повседневного программирования.
Анализа документов.
Подготовки отчётов.
Создания маркетинговых материалов.
Обычных профессиональных задач.
Claude Fable 5.2 стоит выбрать для:
Крупных программных проектов.
Глубоких технических исследований.
Сложной обработки данных.
Продолжительных многоэтапных процессов.
Задач с большим количеством взаимосвязанных требований.
Разбора сложных инженерных проблем.
В FrontierCode 2.0 Fable 5.2 при максимальном уровне усилий показала 49,1%, а Opus 5.5 — 45,5%.
При этом тесты Anthropic показывают, что Fable 5.2 на уровне High может обеспечивать сопоставимый с Opus 5.5 результат в определённых задачах программирования примерно за половину стоимости выполнения задания.
Вывод: Fable 5.2 не обязательно использовать для каждого сообщения. Для обычных задач Opus 5.5 может оказаться более рациональным выбором, а Fable лучше оставить для особенно сложных проектов.
Помимо Fable и Opus, Anthropic предлагает модели Sonnet и Haiku.
Claude Sonnet 5.5 — вариант для повседневной работы с текстами, программирования, анализа информации и других задач, где важен баланс производительности и стоимости.
Claude Haiku 5.5 — компактная и быстрая модель для относительно простых запросов, кратких ответов, классификации информации и массовой обработки текстов.
Claude Opus 5.5 — мощная универсальная модель для профессиональной работы.
Claude Fable 5.2 — решение для особенно сложных технических, исследовательских и многоэтапных задач.
Например, для создания десяти заголовков статьи необязательно использовать Fable 5.2. С этим может справиться более экономичная модель.
А вот при анализе крупного программного проекта, сложной финансовой модели или исследовательской задачи возможности Fable 5.2 могут оказаться востребованными.
Для доступа к моделям Claude из России можно использовать агрегаторы нейросетей. Они предоставляют собственный интерфейс, объединяют инструменты разных разработчиков и позволяют работать без самостоятельного подключения к зарубежному API.
Рассмотрим пять площадок, где можно пользоваться моделями Claude и проверять появление новой Fable 5.2.
Study24 AI — агрегатор нейросетей для работы с текстами, изображениями, программированием и другими задачами.
Платформа предлагает отдельный чат Claude Fable, позволяющий отправлять запросы через браузер.
Как начать работу:
Перейдите в Study24 AI по ссылке.
Зарегистрируйтесь или авторизуйтесь.
Откройте чат Claude Fable.
Проверьте, какая версия модели выбрана.
Напишите запрос и отправьте сообщение.
На публичной странице Study24 AI пока указано название Claude Fable 5 без уточнения версии 5.2. Поэтому перед запуском стоит проверить, появилась ли новая модель в списке.
Платформа подходит для написания текстов, программирования и анализа информации. Условия ознакомительного использования и количество доступных токенов отображаются в сервисе.
Aigrator AI — агрегатор, объединяющий нейросети Anthropic, OpenAI, Google и других разработчиков.
Главное преимущество платформы — возможность переключаться между моделями в одном интерфейсе и оплачивать отдельные запросы в рублях.
Для начала необходимо зарегистрироваться, подтвердить электронную почту и открыть раздел текстовых моделей.
Далее найдите Claude Fable и проверьте наличие версии 5.2.
После выбора модели можно вводить запросы на русском языке, анализировать тексты, разбирать код и выполнять другие задачи.
В Aigrator предусмотрен приветственный бонус 50 рублей для новых пользователей при соблюдении условий акции. Если новая модель доступна для оплаты бонусным балансом, можно попробовать её без первоначального пополнения.
После использования стартового предложения запросы оплачиваются из общего баланса. Отдельную обязательную подписку на Claude оформлять не требуется.
Aigrator особенно удобен пользователям, которым необходимо сравнивать Claude с GPT-6 Astra, GPT-6 Sol и другими нейросетями.
При этом указанная ссылка Aigrator ведёт на регистрацию с предварительно выбранной GPT-6 Sol. Для работы с Claude необходимо переключить модель.
Syntx AI — сервис с текстовыми и мультимодальными нейросетями.
Он подходит для написания статей, программирования, подготовки сценариев, генерации изображений и видеороликов.
Чтобы начать работу, перейдите в Syntx AI и войдите в личный кабинет.
Затем откройте каталог текстовых нейросетей и найдите Claude Fable 5.2 при её наличии.
В блоге Syntx AI уже опубликован материал о новой модели, её возможностях и результатах тестирования. Однако публикация обзора не подтверждает, что Fable 5.2 уже добавлена в рабочий каталог.
Поэтому перед отправкой первого запроса необходимо проверить доступную версию и стоимость.
Syntx AI будет интересен авторам, которые совмещают работу с текстовыми и визуальными инструментами.
MashaGPT — русскоязычная платформа для работы с различными нейросетями.
Сервис можно использовать для написания текстов, создания рабочих документов, программирования и других задач.
Для начала зарегистрируйтесь в MashaGPT, откройте каталог моделей и проверьте наличие Claude Fable 5.2.
Если новая версия уже доступна, выберите её и ознакомьтесь с условиями использования.
После этого можно отправлять запросы, задавать уточняющие вопросы и работать над материалами в формате диалога.
MashaGPT стоит рассмотреть пользователям, которым нужен единый ИИ-чат для повседневных и профессиональных задач.
Наличие именно Fable 5.2 и возможность бесплатного запуска необходимо уточнять в интерфейсе сервиса.
GoGPT — онлайн-сервис для использования нейросетей в работе и учёбе.
Через подобные площадки удобно решать текстовые задачи, подготавливать документы, работать с программным кодом и получать объяснения сложных тем.
Чтобы попробовать Claude Fable 5.2, перейдите в GoGPT и войдите в аккаунт.
Затем откройте перечень доступных моделей и проверьте наличие нужной версии Claude.
Если модель представлена в каталоге, выберите её, проверьте стоимость запроса и отправьте сообщение.
Публичного подтверждения наличия именно Fable 5.2 в GoGPT пока нет. Поэтому сервис стоит рассматривать как дополнительный вариант, а не как гарантированный способ запуска новой модели.
Для первого знакомства с новой моделью можно воспользоваться ознакомительными предложениями агрегаторов нейросетей.
Например, Aigrator AI предусматривает приветственный бонус для новых пользователей. Другие площадки также могут предоставлять пробные сообщения или стартовый баланс.
Чтобы попробовать Fable 5.2, зарегистрируйтесь в выбранном сервисе, найдите модель в каталоге и проверьте доступный баланс.
Главное — убедиться, что бесплатное предложение распространяется именно на Claude Fable 5.2, а не только на более экономичные версии Claude.
После этого можно отправить первый запрос без первоначального пополнения, если условия сервиса позволяют.
Модель можно использовать для изучения архитектуры приложения, поиска ошибок и подготовки рекомендаций по оптимизации.
Например, попросить:
«Проанализируй структуру моего веб-приложения. Найди потенциальные проблемы производительности, объясни причины и подготовь пошаговый план исправлений. Не предлагай изменения без объяснения возможных последствий».
Claude Fable 5.2 подходит для анализа технической документации, финансовых отчётов и исследовательских материалов.
Можно попросить нейросеть выделить главные выводы, обнаружить противоречия или сравнить несколько документов.
Нейросеть пригодится для сложных задач по продвижению сайтов.
Например, можно поручить ей подготовку структуры информационного портала, анализ поисковых интентов и разработку стратегии внутренней перелинковки.
Однако реальные поисковые запросы, их частотность и позиции сайта необходимо проверять через соответствующие SEO-инструменты.
Fable 5.2 можно использовать для сравнения гипотез, анализа графиков и подготовки подробных отчётов.
Особенно полезны возможности модели при работе с большим количеством взаимосвязанных данных.
Anthropic официально представила Claude Fable 5.2 9 ноября 2026 года.
В ряде сложных тестов Fable 5.2 превосходит Opus 5.5. Однако Anthropic рекомендует Opus 5.5 для большинства повседневных профессиональных задач, а Fable — для особенно сложной и продолжительной работы.
Новая версия генерирует ответы до 30% быстрее, показывает лучшие результаты в программировании, аналитике и работе с графиками. При этом API-стоимость снизилась на 20%.
Да, модель можно искать в агрегаторах нейросетей, включая Study24 AI, Aigrator AI, Syntx AI, MashaGPT и GoGPT. Наличие версии 5.2 необходимо проверять в текущем каталоге каждой площадки.
Это зависит от ознакомительных предложений сервиса. Например, в Aigrator предусмотрен стартовый бонус, но возможность использовать его для конкретной модели следует проверить перед генерацией.
Для пополнения Aigrator зарубежная карта не требуется: сервис поддерживает оплату в рублях. У остальных агрегаторов необходимо проверить доступные способы платежа.
Да. Можно отправлять промпты на русском языке и получать русскоязычные ответы.
Claude Fable 5.2 стала одним из наиболее заметных обновлений Anthropic в 2026 году. Модель получила улучшения в программировании, аналитике, работе с изображениями и выполнении продолжительных задач.
По опубликованным результатам тестирования Fable 5.2 значительно превосходит Fable 5.1 и в некоторых сложных сценариях обходит Claude Opus 5.5.
При этом выбирать самую мощную нейросеть для каждого запроса необязательно. Для простых текстовых задач подойдут более экономичные модели, а Fable 5.2 стоит использовать там, где действительно необходим глубокий анализ.
Пользователи из России могут проверить доступность новой модели в Study24 AI, Aigrator AI, Syntx AI, MashaGPT и GoGPT.
Если хочется работать с несколькими нейросетями в одном интерфейсе и оплачивать запросы в рублях, можно начать с Aigrator AI. Платформа предлагает приветственный бонус для новых пользователей и позволяет сравнивать модели разных разработчиков.
Перед первым запуском проверьте, что в каталоге выбрана именно Claude Fable 5.2, а не предыдущая версия.
В социальных сетях набирает популярность необычный видеотренд под песню Светы «Мои слёзы не помогут». В оригинальном ролике два персонажа стоят друг напротив друга, эмоционально исполняют песню, а камера поочерёдно показывает их лица.
Теперь вместо героев можно подставить себя, друга, девушку или любого другого персонажа. При этом движения, мимика, расположение участников и ракурсы камеры останутся максимально близкими к оригинальному видео.
Повторить тренд «Мои слёзы не помогут» можно через нейросети Seedance 2.5 и Wan 3.0 в Aigrator AI. Для генерации понадобятся две фотографии, исходный ролик и готовый промпт.
Ниже расскажем, как подготовить материалы, правильно заменить персонажей и синхронизировать результат с музыкой.
В основе тренда — эмоциональная сцена под популярную песню Светы. Пользователи также ищут этот ролик по строчке «Я прошу, не обижай».
В кадре находятся два персонажа — зелёный и красный. Они стоят лицом к лицу, исполняют музыкальный фрагмент и реагируют друг на друга.
Камера переключается между героями, показывая их эмоции, движения головы и артикуляцию.
Особенность тренда заключается в возможности полностью изменить внешность участников, сохранив оригинальную постановку.
Например, вместо двух персонажей можно использовать фотографии друзей, влюблённой пары или собственных вымышленных героев.
Для этого используется генерация видео по референсам: исходный ролик задаёт движение, а фотографии определяют внешность новых участников.

Первым делом понадобятся два изображения.
Для каждого героя лучше использовать отдельный снимок.
Помимо фотографий понадобится исходный видеоролик.
Он используется как референс, который определяет движения персонажей, их положение в кадре, взаимодействие и работу камеры.
Без оригинального видео нейросеть может создать похожую сцену по описанию, но точно воспроизвести знакомые жесты и последовательность действий будет значительно сложнее.
Сохраните ролик на устройство, чтобы затем загрузить его в генератор.
Оригинальная сцена длится примерно 13 секунд. При выборе параметров генерации желательно ориентироваться на эту продолжительность.

Для замены персонажей можно воспользоваться генератором видео в Aigrator AI.
Платформа объединяет несколько видеомоделей, поддерживающих работу с изображениями и видео-референсами.
Для данного тренда подходят Wan 3.0 и Seedance 2.5.
Wan 3.0 можно использовать для первых тестов. Это удобный вариант, чтобы проверить, правильно ли модель определяет персонажей, сохраняет ли нужную композицию и повторяет ли основные движения.
Seedance 2.5 стоит попробовать, если необходимо сравнить качество генерации, точность движения и сохранение внешности участников.
Для объективного сравнения желательно использовать одинаковые фотографии, исходное видео и промпт.
Откройте Aigrator AI и авторизуйтесь.
Перейдите в раздел генерации видео.
Выберите Wan 3.0 или Seedance 2.5.
Откройте режим, поддерживающий изображения и видео в качестве референсов.
Загрузите фотографию для замены зелёного персонажа.
Добавьте вторую фотографию для замены красного героя.
Прикрепите оригинальное видео тренда.
Вставьте готовый промпт из следующего раздела.
Проверьте соответствие файлов обозначениям в инструкции.
Настройте параметры и запустите генерацию.
Для вертикального видео подойдёт соотношение сторон 9:16, если оно поддерживается выбранным режимом.
Для первого теста можно использовать разрешение 480p или 720p. Если результат устраивает, попробуйте создать финальную версию в 1080p при наличии такой настройки.
Если планируете добавлять оригинальную песню самостоятельно, отключите генерацию звука, когда соответствующая функция доступна.
Промпт предназначен для замены двух персонажей с сохранением исходного видеоряда.
Используйте следующие обозначения:
@video1 — оригинальный ролик, движения и композицию которого нужно повторить.
@image1 — фотография персонажа, который заменит зелёного героя.
@image2 — фотография персонажа, который заменит красного героя.
Оригинальный промпт
CREATIVE MAPPING @video1 = Original video: the source for the scene, actions, poses, interactions, composition, timing, and camera movement. The green and red characters serve only as replacement targets. @image1 = The sole appearance reference for the character completely replacing the green character. @image2 = The sole appearance reference for the character completely replacing the red character. ONE-SENTENCE SUMMARY Completely replace the green character in @video1 with the character from @image1 and the red character with the character from @image2, preserving the original actions (also lip‑syncing), the environment, and the camera movement.
Этот промпт указывает нейросети, какие персонажи должны быть заменены, откуда брать их внешность и какие элементы оригинального ролика необходимо сохранить.
Особое внимание уделено движениям, взаимодействию героев, синхронизации губ и перемещениям камеры.
После вставки текста обязательно проверьте, что обозначения @image1, @image2 и @video1 действительно связаны с нужными файлами.
Если интерфейс предлагает выбрать вложение после ввода символа @, укажите соответствующий файл вручную.
После завершения генерации не спешите публиковать ролик. Сначала посмотрите его полностью и сравните с оригиналом.
Проверьте начало видео. Первый персонаж должен занимать место зелёного героя, второй — красного.
Обратите внимание на повороты головы. Именно в такие моменты нейросети бывает сложнее сохранять черты лица.
Сравните одежду. Если определённый образ важен, убедитесь, что детали не меняются между кадрами.
Проверьте движения камеры. Они должны соответствовать оригинальной постановке.
Посмотрите на губы. Движения рта должны быть максимально согласованы с музыкальным фрагментом.
Если модель перепутала персонажей местами, проверьте правильность привязки фотографий.
Если лицо искажается при повороте, попробуйте использовать изображение с более подходящим ракурсом.
Если изменился фон или движения камеры, убедитесь, что исходный ролик загружен именно как видео-референс.
Следует учитывать, что даже при подробном промпте модель не гарантирует абсолютно точного повторения всех действий и внешности участников.
Когда генерация завершится, останется синхронизировать видеоряд с музыкой.
Для этого можно воспользоваться любым удобным видеоредактором.
Откройте получившийся ролик и добавьте подходящий музыкальный фрагмент.
Важнее всего правильно совместить начало артикуляции с первым отчётливым слогом.
После этого проверьте, совпадают ли движения губ с песней в середине и конце видео.
Если ближе к финалу появляется рассинхронизация, попробуйте скорректировать положение аудиодорожки или продолжительность клипа.
Музыкальный фрагмент можно найти вместе с исходным роликом в Telegram-канале Aigrator AI.
При публикации в TikTok, Reels или Shorts также можно добавить песню из официальной музыкальной библиотеки площадки, если она там доступна.
Чаще всего такая проблема связана с неверным распределением файлов.
Проверьте, что @image1 соответствует зелёному персонажу, а @image2 — красному.
Попробуйте использовать более качественную фотографию. Если ошибка возникает при повороте головы, выбирайте референс, на котором лицо показано под похожим углом.
Нейросеть может самостоятельно достраивать одежду, причёску и другие детали.
Для лучшего сохранения образа используйте фотографию, на которой хорошо видны необходимые элементы внешности.
Проверьте, что исходное видео прикреплено к @video1. Если файл не привязан, нейросеть может воспринимать запрос как обычное текстовое описание.
В первую очередь проверьте правильность музыкального фрагмента и его положение на таймлайне.
Если проблема возникает уже в сгенерированном видео, может потребоваться повторная генерация.
Да, нейросеть может создать похожую сцену по двум изображениям и текстовому описанию. Однако для повторения конкретных движений и ракурсов лучше использовать оригинальное видео.
Две фотографии — по одной для каждого персонажа. Дополнительно потребуется исходный видеоролик.
Начните с Wan 3.0, чтобы проверить распределение ролей и основные движения. Если результат не устраивает, попробуйте Seedance 2.5 с теми же референсами.
Да. Используйте отдельные фотографии и назначьте каждого человека соответствующей роли. Для изображений других людей желательно получить их согласие.
Нет. Для проверки внешности и движений можно начать с более низкого разрешения. Финальную версию имеет смысл создавать в повышенном качестве, если результат уже устраивает.
Да. В Aigrator AI предусмотрена оплата в рублях российскими банковскими картами и через СБП.
Тренд «Мои слёзы не помогут» — интересный способ создать музыкальное ИИ-видео с собственными персонажами, сохранив эмоциональную постановку оригинального ролика.
Для генерации понадобятся две фотографии, видео-референс и готовый промпт.
Через Aigrator AI можно попробовать Wan 3.0 или Seedance 2.5, загрузить исходные материалы и заменить зелёного и красного героев на выбранных персонажей.
После генерации останется проверить сохранение внешности, синхронизировать движения губ с песней Светы и подготовить ролик к публикации.