
ElevenLabs выпустила Eleven v4: голосовая модель, которая играет, а не читает
ElevenLabs представила Eleven v4 и её быструю версию v4 Turbo. Модель построена на новой архитектуре: она разбирает по тексту тон, темп, эмоцию и характер персонажа и держит голос одинаковым на всей длинной записи, даже если перегенерировать отдельную реплику. Смеётся, шепчет, всхлипывает и отыгрывает звуковые эффекты она теперь заметно стабильнее, чем v3. В ролике выше — официальное демо: всё сгенерировано по промптам на экране, без монтажа.
Что умеет
Эмоцию задают тегами прямо в тексте — вроде [excited] или [sleepy drowsy voice]. Клонирование голоса теперь работает по 10 секундам записи. Языков больше 90 (у v3 было около 70), и клонированный голос говорит на чужом языке с родным акцентом, не уплывая в другой тембр.
Цифры
В рейтинге Speech Arena от Artificial Analysis v4 вышла на первое место. В слепых парных тестах, где слушатели выбирали более выразительный вариант, она выиграла 81% пар у Cartesia Sonic 3.6 и Inworld TTS-2, 72% у Gemini 3.8 Flash-Lite TTS и 65% у Gemini 3.8 Flash TTS.
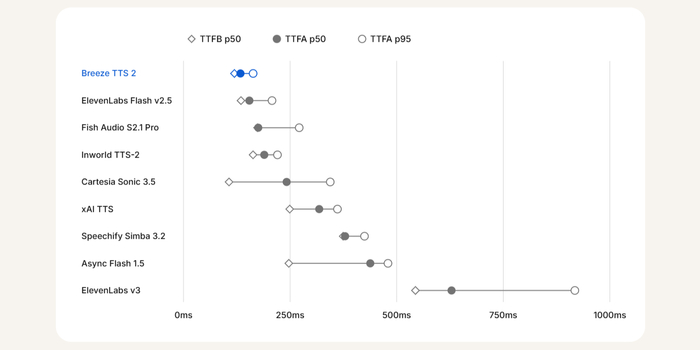
Turbo-версия для голосовых агентов выдаёт первый звук примерно через 150 мс. Обе модели уже доступны в API, ElevenCreative и ElevenAgents, в том числе на бесплатном тарифе. По данным The Decoder, v4 стоит 80 долларов за миллион символов, Turbo — 40, а до 12 октября действует скидка до 22 и 11 долларов.
Для озвучки роликов, аудиокниг и игр это заметный шаг: главная беда синтеза речи — ровная «дикторская» интонация и плывущий от реплики к реплике голос — здесь атакована напрямую.
Живые аудиопримеры (эмоции, сонный голос, оригинал против клона) — в посте на канале.
Источники: ElevenLabs, TechCrunch, The Decoder