user11421604

user11421604

На Пикабу
Дата рождения: 4 июня
в топе авторов на 85 месте
100 рейтинг 0 подписчиков 0 подписок 6 постов 0 в горячем

DeepSeek напрямую или через подписку Ollama: что выгоднее харнессу

Залез я тут в свои счета и поймал себя на мысли: вроде бы сравниваю два сервиса, DeepSeek и Ollama, а по факту сравниваю расписание. Потому что модель-то одна и та же — DeepSeek-V4-Pro, — а деньги уходят за разное. У DeepSeek платишь только за токены, у Ollama — двадцать долларов в месяц, и шестьдесят долларов расхода уже включены в эту сумму. Ну и часы работы, о которых вспоминаешь в последнюю очередь.

Сколько стоит токен

Прайс на модель у обоих одинаковый, отличие только в множителях. За миллион токенов:

  • вход, кэш попал: у DeepSeek $0,003 вне пика, у Ollama $0,022;
  • вход, кэш промахнулся: $0,15 вне пика против $0,66;
  • выход: $0,60 вне пика против $1,98;
  • подписка: у DeepSeek нет, у Ollama $20 в месяц и $60 расхода включено.

Это всё базовые ставки, не пиковые — и вне пика DeepSeek берёт ровно вдвое меньше, чем Ollama. Но «вне пика» — это и есть вся соль. У DeepSeek двойной тариф работает в окна 01:00–04:00 и 06:00–10:00 UTC по будням, всё остальное время, включая выходные, считается по половине. У Ollama двойной тариф живёт в окне 12:00–18:00 UTC по будням.

Техник у серверной стойки в дата-центре NERSC. Фото: Derrick Coetzee, CC0

Техник у серверной стойки в дата-центре NERSC. Фото: Derrick Coetzee, CC0

Что на самом деле в счёте

Цена за миллион токенов — пустой звук, если не понимаешь, каких токенов у тебя больше. У агента, который часами работает в одном репозитории, почти весь вход — это чтение кэша: инструкции, история шагов, файлы, которые модель видит при каждом следующем вызове. Нового текста в запросе мало, и он весь оседает в промахах кэша.

Проверил по журналу своих сеансов: на 75 миллионов прочитанных токенов приходится около 250 тысяч новых. Кэш — 99,7% входа, и разница в четыре раза на кэше бьёт по счёту сильнее, чем разница на выходе.

Часы решают больше, чем прайс

Перевожу окна в московское время. Пик DeepSeek — с четырёх до семи утра и с девяти до часа дня; пик Ollama — с трёх до девяти вечера. И это не мелочь: вечер — как раз то время, когда за такой текст садятся, а рабочий день у сервера уже закончился.

Выходит, что в самые рабочие часы по Москве один и тот же запрос у Ollama стоит вчетверо дороже на кэше, вдвое на несбитом кэше и вдвое на выходе. Модель ни при чём — проигрыш в расписании.

Харнесс считает расход по каждому сеансу сам: прочитанный кэш, новые входные токены, выходные. Умножаем на прайс нужного окна — и правило проступает само: длинные автономные задания, где агент долго крутит один контекст, дешевле запускать не когда удобно тебе, а когда дёшево маршруту. За месяц разница в расписании набегает ещё на одну подписку.

Считаем сеанс, а не токен

Полезная единица — не цена за миллион, а стоимость одного рабочего сеанса харнесса. Беру реальные цифры из журнала своих запусков: за один сеанс агент прочитал 75 миллионов токенов из кэша, добавил 250 тысяч новых на входе и написал 250 тысяч на выходе.

DeepSeek вне пика: 75x0,003 + 0,25x0,15 + 0,25x0,60 = $1,01

Ollama в пик: 75x0,022 + 0,25x0,66 + 0,25x1,98 = $2,43

Два доллара сорок три против одного — та же работа, та же модель. Если вечерних сеансов за месяц набирается сорок, разница выходит около 57 долларов; подписка Ollama это не отменяет, а всего лишь упаковывает: шестьдесят долларов включённого расхода входят в двадцать долларов платы.

Видеокарта GeForce RTX 3090: железо, на котором считают открытые модели. Фото: PantheraLeo1359531, CC BY 4.0

Видеокарта GeForce RTX 3090: железо, на котором считают открытые модели. Фото: PantheraLeo1359531, CC BY 4.0

Что даёт подписка, кроме токенов

Подписка Ollama — это не только DeepSeek: в тот же счёт входят Kimi, GLM, Qwen, Mistral, и расход по ним идёт из общего пула. Если харнессу нужны разные модели под разные задачи, один счёт удобнее пяти. У DeepSeek в прайсе одна семья моделей, зато без подписки и обязательств.

Ограничения тоже разные. У Ollama на плане Pro — три одновременных запроса, дальше они встают в очередь и могут быть отклонены, если она переполнена. У DeepSeek на V4-Pro заявлено 500 одновременных обращений, а на Flash — 2500. Для одного агента это незаметно, а вот для конвейера из субагентов — уже нет.

Как это ложится на харнесс

DeepSeek подключается к харнессу родным маршрутом deepseek-official: настройки усилий рассуждения, режим мышления, распознавание картинок у Flash и сжатие контекста работают из коробки. Ollama подключается вторым провайдером через pi-ai — совместимым с OpenAI интерфейсом; чтобы модель появилась в выборе, её идентификатор прописывается в настройках руками, а набор возможностей ограничен тем, что отдаёт площадка.

Проверил на своём конфиге: маршрут ollama-cloud собран, ключ стоит, но модели DeepSeek на текущем плане отвечают отказом 402 — до оплаты подписки доступны только gpt-oss, gemma и nemotron. Для сравнения это важно: подписку надо включить до того, как считать, иначе мерить нечего.

Что в итоге

Если сеансы идут по московскому дню и вечеру, прямая оплата у DeepSeek дешевле — иногда в разы, потому что двойной тариф Ollama приходится ровно на рабочие часы. Подписка Ollama выигрывает в другом: когда нужен один счёт на десяток открытых моделей и предсказуемая плата за месяц. Считать надо не прайс, а расписание — в этом споре оно весит больше, чем цена за токен.

Разложу по случаям, чтобы решать было проще:

  • один агент, работа по московскому дню и вечеру — прямая оплата DeepSeek;
  • конвейер из субагентов — DeepSeek: у Ollama на Pro всего три одновременных обращения;
  • несколько разных открытых моделей в одном счёте — подписка Ollama;
  • жёсткий потолок расходов на месяц — подписка: двадцать долларов платы и шестьдесят включённого расхода;
  • ночные и выходные прогоны — DeepSeek вне пика.

Оба маршрута живут в харнессе рядом: родной deepseek-official и второй провайдер через совместимый интерфейс. Держать оба и переключаться по часам — не хитрость, а обычная экономика: маршрут выбирается не по вкусу, а по расписанию.

А как вы решаете — платите за подписку и не думаете о часах или гоняете харнесс по ночам, чтобы влезть в полцены? Мне правда интересно.

Полная версия: https://habr.com/ru/articles/1084484/
Показать полностью 2

DeepSeek Harness: агент, который целиком собран из плагинов

DeepSeek Harness (dsh) — открытый агентский харнесс от DeepSeek AI. Снаружи это ещё одна команда для работы с моделями, внутри — конструктор: здесь плагином является всё, включая хранение сеансов, песочницу, сжатие контекста и саму модель.

Всё есть плагин

Харнесс стоит на Cordis, а его архитектура описана в работе про пространственно-временную композируемость. Идея простая: приложение не пишется кодом, а собирается из слоёв-патчей. Профиль — это список бандлов плюс ваш cordis.patch.yml, и каждый следующий слой может отменить или дополнить предыдущий. Отсюда и dsh --dump-config: он печатает собранное дерево целиком, и видно, какой бандл что добавил.

Профили вместо режимов

Одна команда умеет разное, и разница задаётся профилем, а не флагом:

  • dsh web — локальный веб-интерфейс на http://127.0.0.1:3080;
  • dsh --profile headless "задача" — один свежий сеанс, ответ в вывод и выход: удобно для CI;
  • dsh --profile sdk — JSON-RPC для внешних клиентов;
  • dsh --profile acp — тот же агент внутри редактора.

Профиль лежит в отдельной папке, а патчи перезагружаются на лету: правка плагина подхватывается без перезапуска. Свой набор ставится командой dsh plugin --profile web add.

Агенты внутри агента

Самое интересное — харнесс умеет запускать других агентов, и это не одна кнопка:

  • субагенты работают в фоне, у каждого свой контекст: родитель продолжает работу и получает результат, когда тот готов;
  • наследник контекста — субагент, который видит уже состоявшийся разговор, для задач «продолжи и проверь»;
  • workflow — JavaScript-сценарий, который сам раскидывает десятки субагентов по фазам, конвейером или с барьером: оркестрация описана кодом, а не диалогом;
  • ralph — цикл свежих агентов по одному неизменному заданию, где рабочая папка служит долговременной памятью.
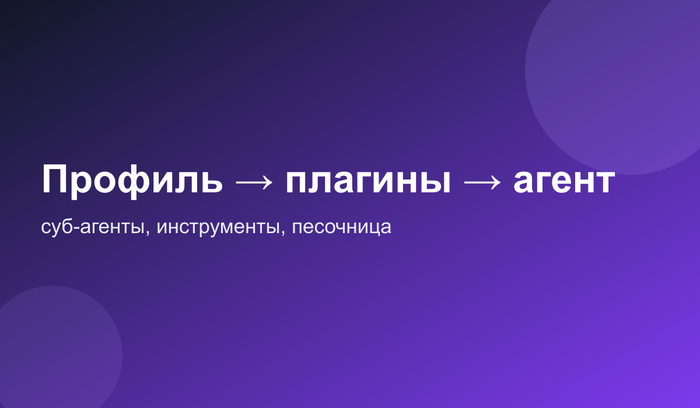
Схема: профиль, плагины, агент и суб-агенты

Схема: профиль, плагины, агент и суб-агенты

Инструменты под задачу

Базовый набор тоже собран из плагинов, и каждый можно выключить: чтение и правка файлов, поиск по репозиторию, фоновые задания, веб-поиск и загрузка страниц, подключение внешних серверов по MCP, «скиллы» — папки с инструкциями, которые агент подгружает по надобности.

Песочница и сеансы

Файловые операции ограничены песочницей: workspace-write пускает только в рабочую папку. Отказ выглядит не как падение, а как честная пометка «доступ запрещён» — её можно показать человеку и попросить прав побольше. Границу при этом называют заранее: где-то агент спрашивает на каждое опасное действие, а где-то действует сам.

История сеанса пишется в файл и переживает перезапуск: сеанс можно возобновить, сжать, посмотреть, сколько он съел токенов. Долгая цель живёт в состоянии сеанса, а не в голове модели.

Что это меняет для команд

Для небольшой команды DSH снимает вопрос «свой агент или готовый сервис»: готовые сервисы дают фиксированный набор функций, а харнесс — конструктор. Можно начать с одного профиля, а потом добавлять плагины по мере появления задач: сегодня — публикация статей, завтра — разбор конкурентов, послезавтра — автоматическая выгрузка метрик.

Отдельно стоит сказать про прозрачность. Каждый вызов инструмента, каждое изменение файла и каждый переход состояния попадают в журнал. Это не «логи для отладки», а рабочий инструмент: когда агент ошибается, видно, на каком шаге и почему. И это же делает возможной честную цену: если шаг не понадобился, его видно в журнале, а не в счёте.

Наконец, DSH не заставляет переезжать целиком. Профиль можно собрать под одну задачу и держать рядом с привычными инструментами: агент по ключу ходит в ваш сервис, забирает результат и возвращает его туда, где вы работаете.

Как это выглядит на практике

Мы собрали цепочку из четырёх плагинов:

FrameFactory: бриф и структура

FrameFactory: бриф и структура

Prompt-Polish: улучшение запроса

Prompt-Polish: улучшение запроса

Detector-Remover: снятие AI-отпечатков

Detector-Remover: снятие AI-отпечатков

  1. FrameFactory формирует бриф: темы, заголовки, план статьи и чек-лист.
  2. Prompt-Polish переписывает черновой запрос, убирая повторы и делая формулировки короче.
  3. Improve-Prompt показывает diff до отправки — важные термины и ссылки остаются нетронутыми.
  4. Detector-Remover добавляет разговорные обороты и лёгкую стилистическую неровность, чтобы текст реже срабатывал на AI-детекторах.

С чего начать

Если хочется попробовать DSH на одной задаче, порядок такой. Сначала ставится сам харнесс и запускается dsh web — этого достаточно, чтобы увидеть базовый набор плагинов. Потом добавляется один-два плагина под задачу: например, для работы с текстом — генерация брифа и полировка запроса. И только после этого имеет смысл думать про субагентов и workflow: они раскрываются там, где задач уже много и они повторяются.

Важно не пытаться собрать «идеальный профиль» заранее. Профиль — это не конфигурация на годы, а рабочий набор: сегодня он один, завтра вы добавили плагин, послезавтра убрали лишнее. Патчи перезагружаются на лету, так что цена ошибки низкая: неудачный слой можно откатить, а не переписывать всё заново.

И ещё одно: DSH не прячет модель. Если вам нужен конкретный провайдер или конкретная модель, это тоже плагин. Значит, можно сравнить два варианта на одной и той же задаче, не переписывая агента.

Зачем это нужно

DSH — не «CLI для LLM», а среда, где агент собирается под задачу: свои инструменты, свои политики, свои профили. Самое ценное здесь — не набор готовых функций, а то, что любую из них можно заменить своей: харнесс не диктует, как устроен агент, а даёт его собрать. Проект открыт под MIT и находится в developer preview — ломающие изменения обещаны прямо в README.

Код и документация: github.com/deepseek-ai/DeepSeek-Harness.

Показать полностью 4

Xiaomi MiMo: триллион параметров, из которых работает четыре процента

Сижу я, значит, листаю ленту, а там все обсуждают очередную закрытую модель. И тут натыкаюсь на новость: Xiaomi молча довела свою линейку MiMo до триллиона параметров и просто выложила веса под MIT. Полез разбираться — оказалось, там есть на что посмотреть.

MiMo — это вообще не одна модель. Это целое семейство, и зонтик над ним приличный. Под этим именем выходили рассуждающая семимиллиардная версия в мае 2025-го, зрение MiMo-VL, аудионаправление MiMo-Audio, модель для роботов и автомобилей MiMo-Embodied, а ещё разреженные MoE второго и два с половиной поколения. Общего у них — имя и команда, а не архитектура. Полтора года пути выглядели так:

  • май 2025 — MiMo-7B, 25 триллионов токенов, обучение с нуля ради рассуждений;
  • июнь 2025 — MiMo-VL-7B: картинки, видео, OCR, интерфейсы;
  • декабрь 2025 — MiMo-V2-Flash: 309 миллиардов всего, 15 миллиардов активных;
  • апрель 2026 — V2.5 и V2.5-Pro, уже под MIT;
  • июнь 2026 — UltraSpeed и больше тысячи токенов в секунду.

Когда я дошёл до этого списка, стало понятно, что ребята не тормозили ни на месяц.

Дальше — интереснее. MiMo-V2.5 умеет всё сразу: 310 миллиардов параметров всего, 15 миллиардов активных, к ним прикручен визуальный энкодер на 729 миллионов и аудиоэнкодер на 261 миллион. На вход она принимает текст, изображения, видео и звук, на выходе выдаёт текст и вызовы инструментов. Рядом живут MiMo-V2.5-ASR — распознавание речи под Apache 2.0 — и целое семейство синтеза речи: обычный TTS, голос по описанию и клонирование по короткой записи.

А теперь про тот самый флагман. MiMo-V2.5-Pro — разреженная смесь экспертов: 1,02 триллиона параметров всего, и при этом 42 млрд активных на каждый токен. Семьдесят слоёв, 384 эксперта, для одного токена выбираются восемь. Контекст — до 1 048 576 токенов, веса открыты под MIT. Звучит внушительно, но дальше я полез смотреть, как это вообще работает и почему из триллиона трудится только 4%.

Самое любопытное — как удешевили длинный контекст. 60 слоёв из 70 смотрят лишь на 128 предыдущих токенов, и только 10 слоёв — на весь контекст. Чтобы дешёвое окно не роняло качество, придумали обучаемый «сток внимания»: голова может не тратить вероятность на бесполезных соседей и сбросить её в пустоту.

Пост-тренировка тут держится на MOPD: несколько моделей-специалистов — математика, код, терминал, поиск, безопасность — дают токенные подсказки одной ученице, но не на чужих ответах, а на её собственных траекториях. Параллельно работает R3: маршрутизация экспертов, записанная на инференсе, повторяется при обучении. Без этого обучение MoE разъезжается, как телега без одной оси.

Отдельная история — скорость. В конфигурации UltraSpeed веса экспертов сжимают в MXFP4, добавляют спекулятивное декодирование DFlash и «живучие» ядра TileRT. На одном узле из восьми GPU получается больше тысячи токенов в секунду. Я прикинул: триллион весов в четыре бита — это примерно 510 ГБ, и всё это надо где-то держать и чем-то крутить.

Что из этого следует? Xiaomi показала, что открытые веса — больше не удел семимиллиардных моделей. Но тут важно сказать честно: «open-weight» точнее, чем «open source». Веса лежат, а данных и полного пайплайна обучения — нет. И ещё момент: миллион токенов в карточке не обещает одинаковой точности на всей длине. В тесте GraphWalks модель держала ненулевой результат на миллионе, а прошлое поколение там резко проседало. Хостинг V2 Xiaomi погасила 30 июня 2026 года и попросила клиентов перейти на V2.5, но скачанные веса это не отменяет.

Модель и карточка: mimo.xiaomi.com. Код и веса: github.com/XiaomiMiMo.

А вы уже пробовали запускать что-то из этого семейства, или пока только читаете и прикидываете, куда бы это пристроить?

Полная версия: https://habr.com/ru/articles/1082686/

Показать полностью

Bluetooth на хакинтоше: что купить и как подключить

Собрал я значит десктоп: i5-13600KF на Gigabyte Z690 UD DDR4, RX 5700 XT, macOS 13.4.1, OpenCore 1.0.7, SMBIOS iMacPro1,1. И вот незадача — блютуза на плате нет, как и на большинстве десктопных сборок. Пришлось идти за адаптером, и тут же выяснилось: главное не цена и не настройки, а чип. От него зависит, заработает ли штука вообще.

Всё решает чип

С Monterey блютуз переехал из ядра в пользовательскую часть. Устройство теперь выбирает демон bluetoothd через модуль bm3_usb, и список поддерживаемого зашит прямо в его бинарник.

Убедиться можно не по форумам, а замером:

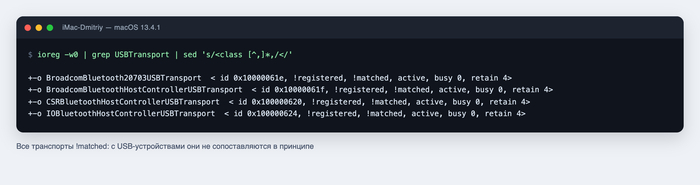
В системе висят все транспорты блютуза, и у каждого стоит !matched. Их персоналии всё объясняют:

IOResources вместо IOUSBHostDevice значит, что с USB-устройствами эти транспорты не сопоставляются вообще — что туда ни пиши. Если прочесать все кексты в /System/Library/Extensions, под блютузом найдётся всего две персоналии с USB-провайдером, и обе в IOBluetoothFamily: «Bluetooth Entitlement» с idVendor: 1452 (это Apple) и конкретный хаб из Mac Pro 6,1.

Отсюда два вывода, которые сэкономят вам вечер:

  • Советы в стиле «откройте IOBluetoothFamily.kext/…/Info.plist и впишите VID с PID» — а они до сих пор в топе поисковиков — не работают по двум причинам сразу: устройство теперь отбирает демон, а системный том с Big Sur запечатан, так что править там попросту нечего. Именно поэтому и появился BlueToolFixup — он работает с памятью, а не с файлами.
  • Неподходящий чип настроить нельзя. Он или в списке демона, или нет — третьего не дано, и карта портов тут не поможет.

Что брать

Рабочих вариантов четыре. Сразу скажу честно: своими руками я пока ни один не проверил, замена ещё едет, поэтому у каждой строки указываю источник.

  • USB-донгл ASUS USB-BT400 и клоны, чип Broadcom BCM20702A0. Ставить к нему BlueToolFixup, BrcmPatchRAM3 и BrcmFirmwareData. Bluetooth 4.0, самый массовый рабочий вариант среди хакинтошников.
  • USB-донгл Laird BT851 (04b4:f901), чип Cypress CYW20704. Нужен только BlueToolFixup, прошивка зашита в сам донгл. Знаю по отчёту на tonymacx86 за август 2022, macOS 12.5: трекпад, AirPods и Handoff работают, а AirDrop у автора не поднялся.
  • Карта M.2 Intel AX200 или AX210 через переходник, чип Intel. Ставить IntelBluetoothFirmware и IntelBTPatcher, а Wi-Fi закрывает AirportItlwm. Это по проекту OpenIntelWireless, сам не проверял.
  • Карта BCM94360CD на переходнике PCIe, чип Broadcom. Почти ничего ставить не нужно, видится как родная. С ней работают Continuity и AirDrop, но стоит она заметно дороже.

Как между ними выбирать.

Если нужны только наушники, клавиатура и мышь — берите донгл на BCM20702A0. Самый дешёвый путь к гарантированно работающему блютузу, половина сборок живёт именно на нём.

Если нужны Handoff, AirDrop и разблокировка часами — только карта Broadcom с родными идентификаторами. Донгл такого не даст никогда: Continuity требует связки Wi-Fi и блютуза с одной поддерживаемой карты, так что один блютуз проблему не решает. Это по руководству Dortania, своего замера у меня нет.

Если в сборке нет ещё и Wi-Fi — AX210 закрывает обе задачи одной картой, но ценой Continuity. Мне как раз этот вариант интереснее: в EFI уже лежит выключенный AirportItlwm.

А вот чего брать не стоит: дешёвые донглы на CSR, 0a12:0001. macOS 13 отбраковывает их прямо на этапе отбора — проверено на этой машине: демон находит донгл, читает идентификаторы и тут же сообщает, что получить их не может:

Дальше по кругу, Transport layer initialization failed и десятки перезапусков демона подряд. Ни кексты, ни карта портов, ни снятие с устройства чужих процессов тут ничего не меняют — отказ повторяется слово в слово. Вычислить такой донгл можно ещё в отзывах по фотографиям: у устройства, заявленного как Bluetooth 4.0, в свойствах стоит строка продукта BT2.0.

Три условия, без которых не заведётся

Верный чип — это только первое из трёх. Остальные два делаются руками, и без них не заработает даже правильное железо.

Кекст ****BlueToolFixup нужен всем на macOS 12 и новее. Лежит в релизах BrcmPatchRAM, кидается в EFI/OC/Kexts и прописывается в config.plist последней записью, после Lilu, с MinKernel 21.0.0. Без него сторонние контроллеры молча игнорируются — ни ошибки, ни строчки в журнале.

Прошивочные кексты по чипу. Броадкомам, которым прошивка заливается при каждом старте, нужны BrcmPatchRAM3 и BrcmFirmwareData. Интелам — IntelBluetoothFirmware и IntelBTPatcher. Cypress и родным картам Broadcom больше ничего не требуется.

Порт, помеченный внутренним. Контроллер блютуза macOS берёт только с порта, у которого в карте портов стоит UsbConnector = 255. В моём UTBMap.kext это правится одним значением: у порта HS04, куда воткнут адаптер, 3 меняется на 255. Сработало сразу — у устройства появилось Built-In: Yes, а транспорт в профайлере сменился с UART на USB. Втыкать лучше в USB 2.0: блютуз-адаптеры — устройства Full Speed, скорость им ни к чему, а на 2.0 перечисление идёт ровнее.

После правок — ocvalidate на конфиг и перезагрузка.

Проверка за пять минут

На вопрос «почему не работает» почти всегда отвечают три команды. Вот их вывод на моей машине прямо сейчас — блютуз-железа в ней нет, и по второму кадру это видно:

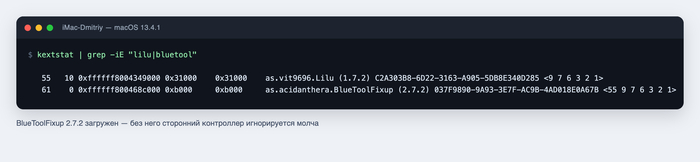
kextstat: BlueToolFixup 2.7.2 и Lilu 1.7.2 загружены

kextstat: BlueToolFixup 2.7.2 и Lilu 1.7.2 загружены

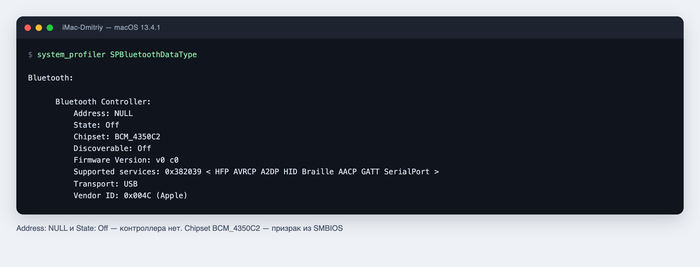
system_profiler: Address NULL, State Off, чипсет BCM_4350C2 из SMBIOS

system_profiler: Address NULL, State Off, чипсет BCM_4350C2 из SMBIOS

ioreg: четыре транспорта блютуза, все с пометкой !matched

ioreg: четыре транспорта блютуза, все с пометкой !matched

Первая — жив ли кекст. kextstat | grep -iE "lilu|bluetool": если BlueToolFixup в списке нет, идти дальше некуда, дело в конфиге, а не в железе.

Вторая — состояние контроллера, system_profiler SPBluetoothDataType. Смотреть на две строки. Работает — настоящий Address и State: On. Не работает — Address: NULL и State: Off.

А вот строка, которая многих обманывает: Chipset: BCM_4350C2. Она показывается даже тогда, когда блютуз-железа в машине нет вообще — как на кадре выше. Это чип настоящего iMac Pro, зашитый в bluetoothd, который смотрит на SMBIOS; ACPI-устройства за ней не стоит. Не радуйтесь ей и не подбирайте под неё кексты.

Третья — транспорты в ioreg. Пока у нужного стоит !matched, контроллер не взят. Заметьте: транспортов там четыре, и загружены они всегда — само их присутствие ничего не обещает.

Детали всегда в журнале демона. В zsh log — встроенная команда, звать её надо по полному пути:

Строка Found USB Device означает, что до отбора дело дошло; Transport layer initialization failed — что чип не взяли.

Чем всё закончилось

Честно: блютуза в машине пока нет, кадры выше это и показывают. Донгл, купленный наугад на маркетплейсе, оказался тем самым CSR и уехал в мусор, а карта AX210 ещё едет. Приедет — допишу, что из этого вышло.

Если у вас на Ventura или Sonoma работает USB-донгл, расскажите в комментариях, какой именно — интересны чип и идентификаторы:

Соберу из ответов список проверенного железа и вынесу в конец статьи. Такого списка мне как раз и не хватало в начале.

Показать полностью 3

Секретные функции Claude

Как-то раз я полез настраивать Claude и обнаружил, что под капотом у него скрыто гораздо больше, чем кажется на первый взгляд. Оказалось, что это не просто болтушка, а настоящий рабочий инструмент с целым арсеналом функций.

Файл CLAUDE.md в корне проекта — это постоянная память: правила оттуда действуют в каждом разговоре. Навыки подключают готовый сценарий одной командой со слэшем. Подагенты уходят искать по десяткам файлов и возвращают только вывод, не засоряя контекст. Хуки перехватывают вызовы инструментов и запускают свои проверки. А MCP-серверы дают Claude руки: браузер, базу, ваш собственный сервис. Всё это уже в коробке — достаточно открыть настройки.

Я, честно говоря, раньше даже не задумывался, что половина этих возможностей существует. А вы уже пробовали что-то из этого на практике?

HTTP 200 — это ещё не «получилось»

Есть правило, которое кажется очевидным: код 200 — значит запрос удался. На нём построены половина обёрток над HTTP и почти все туториалы. И оно неверно чаще, чем хотелось бы.

Как это выглядит

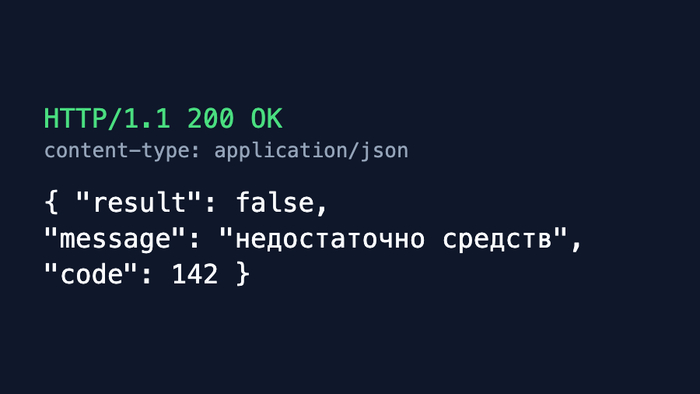
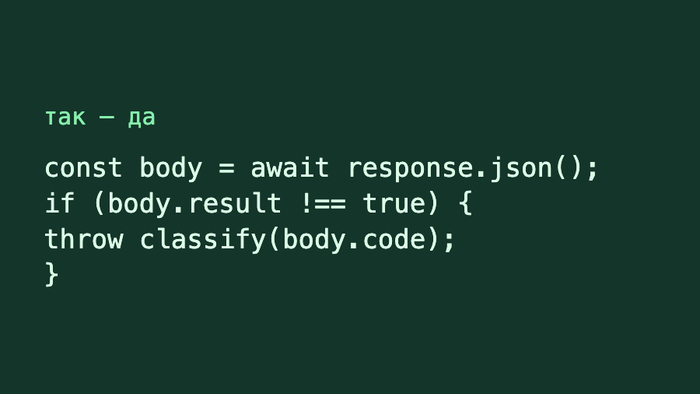
Сервис отвечает 200 OK, заголовки в порядке, тело — валидный JSON. А внутри тела написано, что ничего не произошло:

Ответ 200 OK, в теле которого написано, что запрос не выполнен

Ответ 200 OK, в теле которого написано, что запрос не выполнен

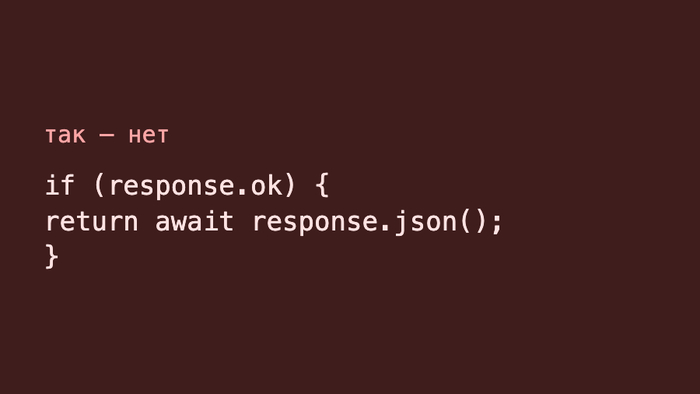
Проверка response.ok на таком ответе возвращает true. Код едет дальше с пустыми руками и узнаёт об этом через три шага — там, где причину уже не видно.

Почему так делают

Причин обычно три, и ни одна не про лень:

  • API вырос из формы на сайте: браузеру всегда отвечали страницей, а ошибку рисовали внутри неё.
  • Между вами и сервисом стоит прокси или защита от ботов, которая переписывает коды на свои.
  • «Не выполнено» для сервиса — штатный ответ, а не сбой: кончился баланс, не хватило прав, задача ещё считается.
Отдельно обидная разновидность — третья. Ответ «ещё не готово» приходит тем же кодом ошибки, что и «сломалось», и клиент бросает повторять именно тогда, когда повторить и надо было.

Что с этим делать

Не считать транспорт ответом. У HTTP свой слой: он говорит, доехал ли запрос. Успех операции живёт в теле, и разбирать его нужно отдельно — по полю, которое сервис назвал сам.

И ещё одно, из практики: заводя обёртку над чужим API, класс ошибки решайте по коду в теле, а не по тексту сообщения. Текст сервис перепишет на следующей неделе, и разбор строки сломается молча — ровно так же, как ломается вера в двухсотый код.

Показать полностью 3
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества