LLMCOD
1 пост
1 пост
LLMCOD: как превратить современный сайт с JavaScript и API в полноценный источник данных для RAG
Обычно задача «создать базу знаний из сайта» звучит просто: взять HTML, извлечь текст, разбить его на фрагменты, построить embeddings и отправить всё в RAG.
На современных сайтах этот подход всё чаще перестаёт работать.
Главная причина — сайт может практически не содержать данных в исходном HTML. Пользователь открывает страницу, браузер загружает JavaScript, JavaScript обращается к API, а уже API возвращает услуги, товары, объекты, статьи, цены и другие данные.
Именно с такой проблемой мы столкнулись при разработке новой возможности в LLMCOD.
Теперь система умеет работать не только с обычными страницами, но и с SPA-сайтами и доступными открытыми API.
В этой статье расскажу, как мы это сделали, какие проблемы встретили по дороге и почему одного vector search для такой задачи оказалось недостаточно.
У нас уже существовал механизм создания базы знаний из сайта.
Классический сценарий выглядел примерно так:
URL сайта ↓ HTTP GET ↓ HTML ↓ извлечение текста ↓ chunks ↓ embeddings ↓ RAG
Для обычного корпоративного сайта этого достаточно.
Но при проверке одного из реальных сайтов мы получили:
HTTP 200 HTML ≈ 4.7 KB текст в HTML = 0
При этом в браузере сайт был полностью заполнен:
объектами недвижимости;
услугами;
статьями;
ипотечными программами;
командами;
видео;
другими разделами.
То есть проблема была не в том, что сайт пустой.
Проблема была в том, что данные находились не в HTML.
Вместо попытки заставить старый парсер работать со SPA мы пошли другим путём.
Новая схема стала такой:
HTML ↓ определяем SPA ↓ ищем JavaScript ↓ анализируем JS ↓ находим API-маршруты ↓ проверяем API ↓ получаем JSON ↓ нормализуем данные ↓ создаём chunks ↓ embeddings ↓ RAG
При этом старую механику site-preview мы сознательно не стали переделывать.
Новый механизм был сделан отдельным контуром.
Это оказалось важным архитектурным решением: новая функция развивается независимо, а старые клиенты и существующая логика продолжают работать как раньше.
Мы добавили отдельный диагностический endpoint:
POST /api/widget-admin/clients/{client_id}/knowledge/site-analyze
Его задача — не импортировать данные, а сначала понять, что вообще находится за URL.
Система проверяет:
корректность URL;
безопасность адреса;
DNS;
возможность SSRF;
HTTP-ответ;
redirects;
тип страницы;
наличие JavaScript;
потенциальные API-маршруты;
ответы этих API;
типы содержащихся данных.
Это позволяет сначала получить картину сайта, а уже потом решать, что действительно стоит импортировать.
Как только сервер начинает самостоятельно запрашивать URL, появляется очевидная проблема безопасности.
Нельзя просто сделать:
requests.get(user_url)
и считать задачу решённой.
Пользовательский URL — это потенциальная точка для SSRF.
Поэтому в новой логике мы отдельно проверяем адрес и запрещаем запросы к внутренним ресурсам.
Дополнительно контролируем redirect, чтобы безопасный исходный URL не превратился после перенаправления во внутренний адрес.
Для нас это было обязательной частью архитектуры, а не дополнительной оптимизацией.
Тестовый сайт использовал кириллический домен.
Для браузера это выглядит нормально:
Но сетевые библиотеки и DNS на разных этапах работают с Punycode.
Поэтому мы добавили канонизацию URL и нормальную работу с IDN.
Это небольшой технический момент, который легко не заметить на тестовом сервере, но потом он превращается в очень неприятный production-баг.
После определения SPA нам нужно было понять, куда приложение ходит за данными.
Мы анализируем загруженные JavaScript-файлы и извлекаем потенциальные API-маршруты.
Для тестового сайта нашли десятки маршрутов /api/....
После проверки выяснилось, что часть из них возвращает реальные бизнес-данные, а часть является техническими, служебными или требует дополнительных условий.
Поэтому мы не импортируем всё подряд.
Это один из важных моментов нашей реализации.
После анализа сайт не отправляется автоматически целиком в базу знаний.
В админке появилась отдельная кнопка:
«🔬 Анализ сайта»
После анализа показываются найденные API.
Для каждого API система определяет:
работает ли он;
какой тип данных возвращает;
подходит ли он для RAG;
сколько объектов найдено.
Для RAG-кандидатов появились checkbox.
То есть оператор сам выбирает, что импортировать.
Это решает сразу две задачи:
не тащить в базу технические endpoint;
сохранить человеку контроль над содержимым базы знаний.
После анализа один из сайтов дал 10 пригодных источников:
/api/blog /api/complexes /api/custom-pages /api/mortgage/banks /api/mortgage/programs /api/properties /api/services /api/team /api/videos /api/workflow-steps
Всего после обработки мы получили:
163 RAG chunks 163 embeddings 10 API-источников
Но здесь началась следующая интересная часть.
API возвращает структурированные данные.
Например, объект недвижимости может содержать:
{ "id": 16458, "type": "apartment", "rooms": 3, "area": 61.9, "address": "Трнавская улица,63А", "price": 6000000 }
Для RAG нам удобнее нормализовать это в текстовый документ:
Тип: Объект недвижимости Название: 3-комн. квартира, 61.9 м², Трнавская улица,63А Тип: apartment Категория: secondary Статус: sale Город: Балаково Адрес: Трнавская улица,63А Цена: 6000000 Площадь: 61.9 Комнаты: 3 ... Источник API: /api/properties Источник URL: ...
Теперь embeddings и текстовый поиск могут работать с этим материалом значительно удобнее.
Для каждого объекта сохраняем:
source_type source_api source_id source_url
Например:
source_type = property source_api = /api/properties source_id = 16458
Это даёт несколько преимуществ.
Можно понять, откуда пришёл ответ.
Можно удалить или заменить конкретный источник.
Можно фильтровать поиск по типу данных.
Можно отличить новые API-данные от старых карточек и FAQ.
И главное — появляется нормальная модель для дальнейшего развития RAG.
Нельзя предполагать, что API всегда возвращает все данные одним запросом.
Например:
/api/blog?page=1 /api/blog?page=2 /api/blog?page=3 ...
Поэтому импортёр умеет обрабатывать pagination.
Мы поддержали:
next_page_url;
current_page;
last_page.
При этом поставили ограничения:
до 20 страниц;
до 300 объектов;
до 600 000 символов.
То есть импорт не может бесконтрольно съесть память и трафик.
Допустим, одна статья слишком длинная.
Она превращается в:
article id=100 chunk 1 article id=100 chunk 2
У обоих chunks должен оставаться один:
source_id = 100
И здесь мы поймали очень интересную ошибку.
Сначала replace-механизм удалял предыдущий объект по source_id перед вставкой следующего.
В результате:
chunk 1 ↓ insert chunk 2 ↓ delete source_id=100 ↓ insert chunk 2
и в базе оставался только последний chunk.
Исправили архитектуру.
Теперь replacement работает так:
удалить весь source один раз ↓ вставить все его chunks
После исправления тест дал:
2 chunks 1 source_id 2 embeddings 2 rows
Теперь длинный документ сохраняется правильно.
После первого импорта мы запустили RAG.
И увидели типичную проблему семантического поиска.
Запрос:
Покупка недвижимости
мог вернуть:
Выкуп недвижимости
вместо услуги:
Покупка недвижимости
Почему?
Потому что для embedding-модели это семантически очень близкие фразы.
С объектами недвижимости ситуация была ещё заметнее.
Запрос:
3-комн. квартира, 61.9 м², Трнавская улица,63А
не гарантировал, что нужный объект будет первым.
Для человека адрес и площадь практически уникальны.
Для чистого vector search — совсем не обязательно.
Мы протестировали текстовый поиск через PostgreSQL:
ts_rank_cd( to_tsvector('russian', content), plainto_tsquery('russian', query) )
И получили очень хороший результат для точных запросов.
Например:
Покупка недвижимости ↓ service id=158
Адрес:
3-комн. квартира, 61.9 м², Трнавская улица,63А ↓ property id=16458
Налоговый вычет:
Налоговый вычет при покупке недвижимости в 2026 году ↓ article id=100
То есть стало понятно:
vector search хорошо ищет по смыслу, FTS хорошо ищет точные сущности.
Следующей попыткой был Reciprocal Rank Fusion.
Идея простая:
vector rank + lexical rank = общий rank
Но появилась новая проблема.
Старые legacy FAQ-записи иногда попадали слишком высоко.
Например, вопрос:
3-комн. квартира, 61.9 м²...
мог приводить к старому FAQ про аренду квартиры.
Формально это был «релевантный по теме» текст.
Но фактически он совершенно не отвечал на вопрос про конкретный объект.
Мы добавили ещё один сигнал:
exact title
Если пользователь спрашивает:
Покупка недвижимости
и в документе есть:
Название: Покупка недвижимости
такой документ получает сильный дополнительный вес.
То же самое работает для объекта и статьи.
Для запроса:
3-комн. квартира, 61.9 м², Трнавская улица,63А
точное название сразу поднимает нужный:
property id=16458
А для:
Налоговый вычет при покупке недвижимости в 2026 году
вверх поднимается:
article id=100
Финальная схема поиска сейчас выглядит примерно так:
┌── Vector search ──┐ Query ────────────┤ ├── кандидаты └── Russian FTS ────┘ ↓ объединение ↓ анализ "Название" ↓ ранжирование ↓ topK
При этом сохраняется fallback:
если RAG падает, основной запрос не должен падать вместе с ним.
Это важная production-практика:
ошибка базы знаний не должна превращаться в ошибку самого чата.
После изменения lib/rag.ts мы сначала протестировали функцию напрямую.
Получили:
Покупка недвижимости → service 158 3-комн. квартира... → property 16458 Налоговый вычет... → article 100
После этого пересобрали Next.js без опасного prisma db push и перезапустили production.
Затем повторили тест уже через HTTP:
POST /api/internal/rag-retrieve
И production endpoint вернул те же правильные документы.
То есть мы проверяли не только код, а весь путь:
HTTP ↓ Next.js ↓ retrieveContext() ↓ PostgreSQL ↓ RAG
При работе над этой функцией мы сознательно разделили старый и новый workflow.
Старый:
site-preview
не трогали.
Новый:
site-analyze site-api-import
работает отдельно.
Это позволяет постепенно развивать новый механизм, не ломая существующих клиентов.
Сейчас архитектура выглядит так:
САЙТ │ ┌────────┴────────┐ │ │ HTML/SSR SPA │ │ │ JavaScript │ │ │ Open API │ │ └────────┬────────┘ ↓ SITE ANALYZER ↓ найденные источники ↓ выбор оператором ↓ API IMPORTER ↓ нормализация ↓ metadata ↓ chunks ↓ embeddings ↓ hybrid RAG ↓ ИИ-ответ
То есть для современного сайта теперь не обязательно, чтобы вся информация находилась непосредственно в HTML.
Для интернет-магазина это могут быть:
товары;
цены;
категории;
характеристики;
наличие;
условия доставки.
Для недвижимости:
объекты;
цены;
адреса;
площади;
количество комнат;
комплексы;
ипотечные программы.
Для сервисного бизнеса:
услуги;
тарифы;
условия;
сотрудники;
FAQ;
расписание.
Причём данные могут приходить не из видимого HTML, а из API, которое использует frontend.
Новая возможность работает только с открытыми публичными данными.
Закрытые кабинеты, административные панели и API с авторизацией не импортируются.
Это важно и с точки зрения безопасности, и с точки зрения архитектуры продукта.
Также пока нет непрерывной автоматической синхронизации.
После существенных изменений сайта базу можно обновить повторным импортом.
Следующий очевидный этап — сделать RAG ещё более aware относительно типов источников.
Например, для запроса:
какая квартира стоит 6 млн на Трнавской?
система должна понимать, что искать прежде всего нужно среди:
property
а не среди:
article service legacy FAQ
Следующий шаг — ещё лучше использовать metadata:
source_type source_api source_id address price area rooms
И отдельно развивать импорт detail endpoint для тех API, где список объектов содержит только краткие данные.
Главная проблема автоматического создания базы знаний из сайта сегодня уже не сводится к вопросу:
«Как распарсить HTML?»
Гораздо правильнее задавать вопрос:
«Откуда frontend получает реальные данные?»
Если сайт — SPA, HTML может быть практически пустым.
Но это не означает, что данные недоступны.
Часто они просто находятся на следующем уровне:
JavaScript → API → JSON
И если научить систему безопасно находить этот уровень, а затем нормализовать данные для RAG, можно превратить современное веб-приложение в полноценный источник знаний для ИИ.
Именно этот подход мы сейчас реализовали в LLMCOD.
Новая возможность уже работает, но пока не выведена отдельной кнопкой в личном кабинете для всех пользователей.
Чтобы подключить импорт данных из SPA и открытых API, нужно отправить запрос в LLMCOD:
support@llmcod.ru
В запросе достаточно указать адрес сайта и написать, что требуется:
«Импорт базы знаний из SPA / открытых API».
Подробнее:
На сайте компании часто уже есть всё, что нужно клиенту: описание услуг, цены, условия работы, способы доставки, гарантии, контакты и ответы на частые вопросы.
Но посетителю приходится самостоятельно искать нужную страницу и читать длинные тексты. Теперь эту задачу можно передать ИИ.
В LLMCOD появилась новая возможность — создание базы знаний из публичных страниц сайта для ИИ-виджета или бота в MAX.
Клиент может задать вопрос обычными словами:
— Сколько стоит подключение?
— Какие услуги вы оказываете?
— Есть ли доставка в мой город?
— Как получить консультацию оператора?
— Какие документы нужны для оформления?
ИИ найдёт подходящие материалы в базе знаний и сформирует ответ на их основе.
Посетителю не нужно изучать меню сайта, открывать несколько страниц или искать информацию через внутренний поиск.
При подключении продукта клиент указывает адрес своего сайта и подтверждает создание базы знаний.
После этого мы:
Находим доступные публичные страницы.
Извлекаем полезные материалы.
Разделяем информацию на смысловые фрагменты.
Проверяем найденные страницы и подготовленные данные.
Публикуем материалы в базе знаний клиента.
После публикации ИИ начинает использовать эту информацию при ответах.
Переустанавливать виджет или повторно подключать бота не требуется.
Технология называется RAG — генерация с поиском по базе знаний.
Модель не обучается заново на сайте и не запоминает его целиком.
Перед каждым ответом система:
Анализирует вопрос пользователя.
Ищет подходящие фрагменты в базе знаний.
Передаёт найденную информацию языковой модели.
Формирует ответ с учётом материалов компании.
Например, если посетитель спрашивает о стоимости доставки, системе не нужно передавать модели весь сайт. Она найдёт только фрагменты, связанные с доставкой, ценами и условиями.
В базу знаний могут попасть публичные страницы с информацией о:
товарах и услугах;
ценах и тарифах;
доставке и оплате;
гарантиях;
условиях подключения;
графике работы;
контактах;
частых вопросах;
правилах оказания услуг.
Используются только страницы, которые открываются без авторизации.
Личные кабинеты, административные разделы, закрытые документы и страницы, требующие входа, не обрабатываются.
База знаний из сайта может использоваться в нескольких продуктах LLMCOD.
Консультант отвечает посетителям сайта круглосуточно, помогает найти информацию и собирает заявки.
ИИ отвечает на типовые вопросы самостоятельно. Когда требуется человек, диалог передаётся оператору в MAX вместе с кратким резюме.
Интеллектуальные ответы можно добавить в уже работающего бота, сохранив его кнопки, команды и сценарии.
Сам виджет или подключение к боту создаётся автоматически.
Если клиент заказал базу знаний из сайта, администратор получает отдельное уведомление. Затем выполняются предпросмотр материалов, проверка и публикация базы.
Пока база готовится, продукт уже может работать по описанию бизнеса, системным правилам и добавленным вручную карточкам вопрос–ответ.
После публикации материалы сайта подключаются автоматически.
Постоянной автоматической синхронизации с сайтом пока нет.
Если на сайте изменились цены, услуги, условия доставки или другие важные сведения, можно запросить повторное обновление базы.
При повторном импорте материалы сайта заменяются новой версией, а вручную созданные карточки вопрос–ответ сохраняются.
Такая база знаний особенно полезна компаниям, у которых:
много страниц с услугами или товарами;
посетители часто задают одинаковые вопросы;
менеджеры тратят время на типовые консультации;
информация распределена по разным разделам сайта;
требуется круглосуточный первичный ответ;
обращения нужно передавать оператору в MAX.
ИИ не заменяет специалиста в сложных ситуациях, но может снять значительную часть повторяющихся вопросов и помочь клиенту быстрее получить нужную информацию.
Подробнее о базе знаний из сайта:
На сайте LLMCOD появился новый сервис — онлайн-чат с нейросетью Qwen 3.6. Он работает прямо в браузере и помогает искать информацию, создавать тексты, разбирать документы и решать задачи по программированию.
Устанавливать отдельную программу или использовать VPN не требуется.
Сервис подходит не только для обычного общения с нейросетью. Его можно использовать как ежедневный рабочий инструмент.
LLMCOD Chat умеет:
отвечать на вопросы на русском языке;
писать статьи, письма, инструкции и описания товаров;
находить свежую информацию в интернете;
показывать ссылки на найденные источники;
анализировать текстовые файлы;
писать и объяснять программный код;
находить ошибки в скриптах;
составлять SQL-запросы, планы и чек-листы.
Ответ появляется постепенно, поэтому не нужно ждать завершения полной генерации текста.
Обычная языковая модель может не знать о последних событиях. Поэтому в LLMCOD Chat добавлен отдельный интернет-поиск.
Пользователь может выбрать один из режимов:
поиск отключён;
автоматическое определение необходимости поиска;
постоянный поиск для каждого запроса.
Например, можно спросить:
Какие сегодня новости в Калининграде?
Чат найдёт подходящие материалы, подготовит краткий ответ и покажет список использованных источников.
Это удобно для поиска новостей, актуальных цен, расписаний, изменений в законодательстве и другой информации, которая быстро устаревает.
При этом важные сведения всё равно рекомендуется дополнительно проверять по первичным источникам.
В чат можно загружать текстовые файлы следующих форматов:
TXT;
MD;
CSV;
JSON;
LOG.
Нейросеть может:
кратко пересказать документ;
найти нужные строки и значения;
сравнить записи;
объяснить структуру данных;
проанализировать журнал ошибок;
подготовить выводы по содержимому файла.
Например, можно загрузить системный журнал и попросить найти возможную причину сбоя либо прикрепить CSV-файл и получить краткий анализ данных.
LLMCOD Chat может создавать и объяснять программный код, исправлять ошибки и предлагать варианты решения задачи.
Чат подходит для работы с Python, JavaScript, HTML, CSS, SQL, Bash и другими языками. Фрагменты кода выводятся с подсветкой синтаксиса, поэтому их удобно читать и копировать.
Сервис может помочь:
написать небольшой скрипт;
проверить существующий код;
разобраться в сообщении об ошибке;
подготовить команду для Linux;
создать SQL-запрос;
получить пример подключения к API.
Диалоги сохраняются локально в браузере пользователя. Можно создавать отдельные чаты для разных задач и возвращаться к предыдущим обсуждениям.
API-ключ также можно сохранить в браузере, чтобы не вводить его перед каждым запросом.
При работе на чужом или общем компьютере сохранять ключ не следует.
Для начала работы нужно:
Зарегистрироваться в личном кабинете LLMCOD.
Получить API-ключ.
Открыть страницу LLMCOD Chat.
Вставить ключ в боковой панели.
Написать вопрос, включить интернет-поиск или прикрепить файл.
Сервис доступен по адресу:
LLMCOD Chat может быть полезен предпринимателям, разработчикам, авторам, специалистам технической поддержки и всем, кому регулярно приходится искать информацию, работать с текстами или разбираться в документах и программном коде.
Сервис LLMCOD, который предоставляет OpenAI-совместимый API для разработчиков в России, перешёл на новую языковую модель — Qwen 3.6 27B от Alibaba Cloud.
Что было раньше
До этого на сервисе работала Qwen 3 30B Instruct — модель с 30 миллиардами параметров в архитектуре MoE (Mixture of Experts). Она активировала только часть параметров на каждый запрос, что позволяло запускать её эффективно, но накладывало ограничения на качество в некоторых задачах.
Что такое Qwen 3.6 27B
Qwen 3.6 — новое поколение моделей от Alibaba, вышедшее в апреле 2026 года. Версия 27B использует Dense-архитектуру: все 27 миллиардов параметров работают при каждом запросе. По бенчмаркам на задачах программирования и агентных сценариях она превосходит предыдущие модели той же линейки.
Ключевые характеристики модели на сервисе:
27 млрд параметров, Dense Transformer
Контекстное окно 32 768 токенов (~12 страниц текста)
Поддержка tool use / function calling
Стриминг (SSE)
Квантование Q6_K — близко к полной точности BF16
Что изменилось для пользователей
Ничего в плане подключения. API не менялся, ключи работают, эндпоинт тот же. Изменилось качество ответов — особенно заметно в коде и длинных диалогах.
Одновременно с переходом на новую модель были обновлены тарифы:
Тариф Разовый 1M токенов 199 ₽
Разовый 3M токенов 490 ₽
Разовый 10M токенов 1 490 ₽
Подписка Старт 3M/мес 390 ₽/мес
Подписка Базовый 10M/мес 1 190 ₽/мес
Подписка Профи 30M/мес 2 990 ₽/мес
Сервер расположен в Калининграде, данные не передаются зарубежным провайдерам, оплата через ЮKassa картами РФ.
Сайт: llmcod.ru
Мы запустили новый тариф — ИИ-Виджет. Это чат-виджет с настоящей нейросетью для любого сайта: вставляется одним тегом, настраивается через личный кабинет, отвечает клиентам 24/7 по вашей базе знаний.
И вместе с ним — новая функция для разработчиков и бизнесов со своей логикой: переадресация на webhook.
Рассказываем, кому что подходит и почему это важно.
Представьте: человек зашёл на сайт, нашёл что-то интересное, но не нашёл ответ на один конкретный вопрос. Не про цену, не про доставку — про что-то своё. Написать в форму обратной связи? Ждать ответа до завтра? Большинство просто закрывают вкладку.
Вопрос без ответа — это потерянная продажа. И это происходит каждый день, в рабочее и нерабочее время.
ИИ-консультант на сайте решает это в моменте: клиент спрашивает — получает ответ за секунду, не уходя со страницы.
Это чат-виджет, который работает на базе языковой модели Qwen3 30B — той же, что используют разработчики и крупные компании. Не шаблонный бот с заранее прописанными ответами, а настоящая нейросеть, которая понимает смысл вопроса и отвечает своими словами.
Что входит:
Установка одним тегом перед </body> — работает на любом сайте и конструкторе (Тильда, WordPress, Битрикс, Wix)
Личный кабинет: цвет виджета, иконка в шапке чата, положение на странице (лево/право, отступы), системный промпт, база вопросов-ответов
RAG — база знаний: добавляете пары «вопрос — ответ», ИИ находит нужный при каждом обращении клиента
Данные в России, сервер в Калининграде, соответствие 152-ФЗ
Скорость ~100 токенов/сек — ответ появляется быстрее, чем клиент дочитывает вопрос
Чего нет (и почему это плюс): Нет передачи диалога оператору в MAX. Это не урезанная версия — это отдельный продукт для тех, кому оператор не нужен. ИИ справляется сам, без мессенджеров и дополнительных подключений.
Подключение 390 ₽ разово Абонентская плата 590 ₽/мес Пробный период 7 дней бесплатно Гарантия Возврат 100% стоимости подключения, если не подошло
Для сравнения: аналогичный функционал у Jivo стоит от 12 990 ₽/мес — более чем в 20 раз дороже.
Настройка занимает 15 минут. Программист не нужен.
Это для тех, у кого уже есть своя логика — CRM, скрипты продаж, собственная модель или внешняя база данных.
Как работает: вместо того чтобы отвечать своим ИИ, виджет пересылает сообщение клиента на ваш URL (webhook). Вы обрабатываете его на своей стороне — любой логикой — и возвращаете ответ. Клиент видит его в том же чате на сайте, как будто отвечает ваш ИИ.
Кому подходит:
Разработчикам, которые хотят использовать виджет как интерфейс, а логику строить самостоятельно
Бизнесам с готовой CRM — чтобы ответы брались оттуда, а не из базы знаний
Тем, кто тестирует разные модели и хочет подключить свою
Переадресация на webhook доступна в тарифах ИИ-Виджет и ИИ-Виджет+Макс. Подключается по запросу через support@llmcod.ru.
ИИ-Виджет — если нужен простой ИИ-консультант на сайте без оператора. Быстро, дёшево, без лишнего.
ИИ-Виджет+Макс — если кроме ИИ нужна передача сложных диалогов живому оператору прямо в мессенджер MAX.
ИИ в Макс-бот — если у вас уже есть бот в MAX и вы хотите добавить в него нейросеть.
LLM API — если вы разработчик и хотите напрямую работать с моделью Qwen3 30B через OpenAI-совместимый API.
Подключить ИИ-Виджет можно на странице llmcod.ru/widget-lite.html — там же живой демо-виджет, можете задать вопрос прямо сейчас и убедиться, как это работает.

Если у вас на сайте стоит ИИ-консультант, вы наверняка сталкивались с этим: бот отвечает в целом правильно, но как только клиент спрашивает что-то конкретное — цену доставки в регион, условия возврата, есть ли в наличии определённая модель — бот начинает «плавать». Рассказываем, как это исправить без правки кода.
Когда подключают ИИ-консультанта на сайт, его обучают через системный промпт — большой текстовый блок с описанием компании, тоном общения, правилами. Это работает хорошо для общего поведения бота: как представляться, о чём говорить, куда направлять.
Но системный промпт плохо справляется с конкретикой. Причина простая: если вы вносите туда прайс из 30 позиций, условия для 5 регионов, список частых вопросов и ответы на возражения — промпт раздувается, модель начинает путаться в деталях и «галлюцинировать».
Есть более умный способ.
База знаний — это набор карточек «вопрос — ответ», которые хранятся отдельно от промпта. Когда клиент пишет сообщение, система автоматически ищет подходящие карточки и подставляет их в контекст ответа.
Это называется RAG (Retrieval-Augmented Generation) — технология, которую используют крупные корпоративные системы. Суть: модель не пытается «вспомнить» всё из промпта, а получает точную выдержку нужных данных прямо перед ответом.
Пример:
Клиент пишет: «А вы доставляете в Новосибирск?»
Без базы знаний бот ответит что-то общее или скажет «уточните у менеджера».
С базой знаний — система найдёт карточку «Доставка по России» и бот ответит точно: «Да, доставляем в Новосибирск. Срок — 5–7 дней, стоимость от 390 ₽».
В личном кабинете виджета+MAX появился раздел «База знаний». Интерфейс намеренно простой — поле «Вопрос» и поле «Ответ». Никаких технических настроек.
Что стоит туда добавить в первую очередь:
Цены и тарифы. Конкретные цифры, которые меняются и которые неудобно редактировать в промпте каждый раз.
Условия доставки и оплаты. Особенно если они отличаются по регионам, суммам заказа, способам.
Частые возражения. «Дорого» → почему цена такая. «А у конкурентов дешевле» → чем вы отличаетесь. «Долго ждать» → объяснение сроков.
Технические характеристики. Если продаёте оборудование, материалы, услуги с параметрами — размеры, составы, совместимость.
Нестандартные ситуации. Что делать если товар не подошёл, как перенести запись, можно ли оплатить частями.
Промпт — это инструкция для поведения бота. База знаний — это данные для ответов. Они решают разные задачи.
В промпте пишут: «Отвечай вежливо, не выходи за рамки темы, предлагай позвонить если вопрос сложный».
В базе знаний пишут: «Стоимость установки кондиционера — от 3 500 ₽, включает подключение и проверку».
Если смешать всё в промпт — модель получает слишком большой контекст и начинает ошибаться в деталях. База знаний решает это: конкретика хранится отдельно, поступает только когда нужна.
Интернет-магазины. Вопросы про наличие, доставку, возврат — это 80% обращений в чат. База знаний закрывает их без участия менеджера.
Услуги с прайсом. Клиники, салоны, ремонт, юристы — клиенты всегда спрашивают «сколько стоит». Вместо «оставьте заявку» бот даёт конкретный ответ.
Бизнес с частыми возражениями. Если вы знаете, что клиенты часто сомневаются по одним и тем же причинам — внесите это в базу знаний и бот будет закрывать возражения сам.
Сезонные изменения. Акция, новый продукт, изменение цен — обновляете одну карточку, а не переписываете весь промпт.
Виджет+MAX — это ИИ-консультант на сайт с передачей диалога оператору в мессенджер MAX. Стоит 490 ₽ подключение и 690 ₽/мес. Первые 7 дней бесплатно.
После подключения вы получаете доступ к личному кабинету, где можно настроить цвет виджета, системный промпт, порог подключения оператора и — теперь — базу знаний.
Подробнее и форма подключения: llmcod.ru/widget.html
Если у вас уже стоит виджет+MAX — база знаний уже доступна в личном кабинете. Зайдите и добавьте хотя бы 5–10 карточек с самыми частыми вопросами — разница в качестве ответов будет заметна сразу.
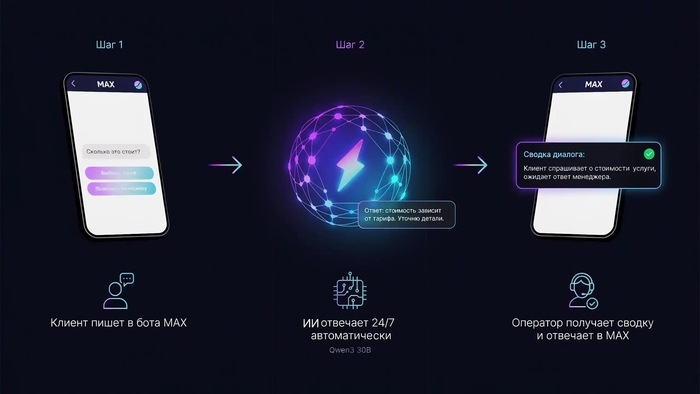
Если у вашей компании есть бот в мессенджере MAX — скорее всего, он умеет немного. Показать прайс по кнопке. Прислать адрес. Переключить на оператора. А если клиент пишет вопрос своими словами — бот молчит или присылает дежурное «не понимаю».
Это нормально: классический бот на кнопках не умеет читать и понимать текст. Раньше единственным выходом было либо нанимать оператора на круглосуточное дежурство, либо терпеть, что часть клиентов уходит, не дождавшись ответа.
Теперь у этой проблемы есть простое решение — ИИ-надстройка для уже существующего бота в MAX.
Идея в том, что ваш бот остаётся прежним — со всеми кнопками и сценариями, которые вы настраивали. Но теперь, если клиент пишет вопрос свободным текстом, а не нажимает кнопку, отвечает не молчание, а искусственный интеллект. Он отвечает своими словами, по существу, на основе информации о вашей компании — ценах, услугах, условиях, которые вы сами загружаете при подключении.
Если ИИ видит, что вопрос сложный или клиент явно просит человека — диалог передаётся живому оператору. Никакого риска, что бот «зависнет» в петле неправильных ответов на нестандартный вопрос.
Получается гибрид: кнопки — для тех, кто любит простые сценарии, ИИ — для тех, кто хочет просто написать вопрос и получить нормальный ответ. Бот работает 24/7, без выходных и обеда.
Сервис рассчитан на бизнес, у которого уже есть бот в MAX — интернет-магазины, сервисные компании, локальный бизнес с доставкой или бронированием. Подключение делается не «с нуля», а именно к существующему боту: вы не теряете то, что уже настроено, просто добавляете ИИ-слой поверх.
Особенно заметна разница там, где поток вопросов однотипный, но клиенты формулируют их по-разному: «сколько стоит», «а вы до скольки работаете», «можно с доставкой в область» — раньше на каждый такой вариант нужно было заводить отдельную кнопку или сценарий. ИИ просто понимает суть вопроса и отвечает.
Подключение стоит 990 ₽ разово, при этом первые 7 дней — бесплатное тестирование, можно убедиться, что всё работает, прежде чем платить за подписку. Дальше — абонентская плата 690 ₽ в месяц за то, что бот с ИИ работает постоянно.
Для сравнения с почасовой ставкой оператора на дежурстве вечером и в выходные разница ощутима.
Для многих компаний это отдельный пункт беспокойства: где хранятся переписки с клиентами и какая модель их обрабатывает. Сервис работает на российской инфраструктуре, без обращений к зарубежным API — то есть без рисков, связанных с блокировками или санкционными ограничениями VPN-сервисов.
Настройка занимает около 15 минут: вы указываете токен своего бота в MAX, загружаете информацию о компании (или просто описываете её своими словами), и ИИ начинает отвечать. Никакого кода, никакого технического специалиста — это сделано специально, чтобы подключить мог любой владелец бизнеса самостоятельно.
Если у вас уже есть бот в MAX и хочется посмотреть, как это работает на практике, не углубляясь в детали — у разработчиков сервиса LLMCOD есть демо-бот, где можно списаться с ИИ напрямую и оценить качество ответов до подключения к своему боту.
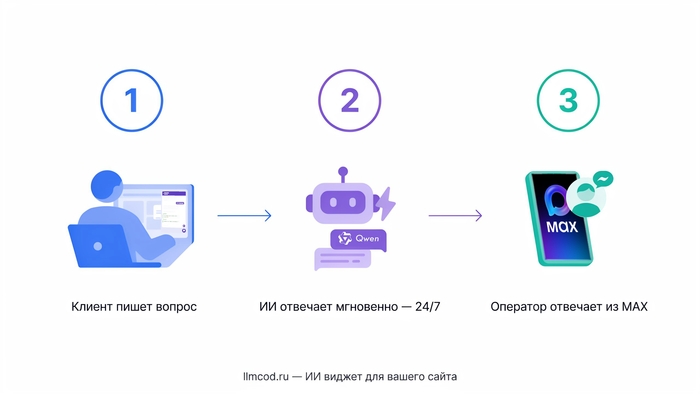
ИИ-консультант теперь для сайта с оператором — в MAX, отвечает клиенту по вашим данным и если надо переводит диалог на ваш МАХ.
✅ ИИ отвечает клиентам мгновенно — 24/7, без выходных
✅ Когда нужен живой человек — вы получаете уведомление в MAX с кратким пересказом диалога
✅ Отвечаете прямо из телефона — клиент видит это в том же чате
Клиент даже не замечает что сначала общался с ИИ — просто быстрые ответы и живой оператор когда нужно.
💻 Установка — один тег на сайт:
<script src="https://llmcod.ru/widget/ВАШ_ID.js"></script>
🔥 Снизили цену:
— Подключение: было 3 000 ₽, теперь 990 ₽ разово
— Абонентка: было 1 500 ₽/мес, теперь 690 ₽/мес
— 7 дней бесплатно после подключения
💡 ИИ-консультант + оператор в MAX — всего 690 ₽/мес. Аналогичный функционал у Jivo стоит от 12 990 ₽/мес — в 18 раз дороже.
Посмотреть живой пример и подключить → llmcod.ru/widget.html