Серия «Кудахтеры: захоронение данных»

62

Я все проспал - оказывается уже год назад вышли приводы и кассеты LTO-10⁠⁠

Серия Кудахтеры: захоронение данных

Для ЛЛ: хорошо, но дорого. И оказывается есть комплекты для ленточных библиотек с мостами 10G – SAS или 10G - FC

Я как-то не следил за тем, как развивается индустрия накопителей на магнитных лентах, потому что когда я последний раз их трогал, то мне хватало и LTO-8 – по 12 терабайт на кассете. Очень удобно было, после LTO-6 с их 2.5 Тб на кассету.

И, неожиданно для меня, еще год назад IBM начали поставки LTO-10.

Есть всего три маааааленькие проблемы.

Первая.
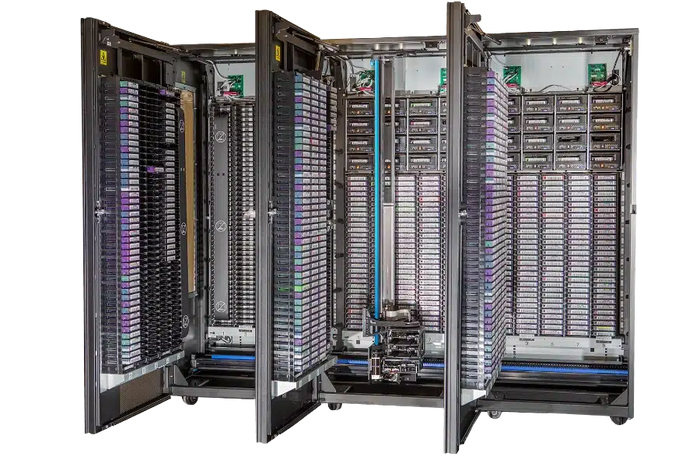
Привод IBM® LTO-10 Tape Drive я в розничных продажах не нашел. Поставляются в составе ленточных библиотек IBM Diamondback (от 800 до 1,584 картриджей, 46 петабайт без сжатия) и TS4500 (23,160 картриджей , 695 петабайт без сжатия)

Я все проспал - оказывается уже год назад вышли приводы и кассеты LTO-10

Вторая.
Даже привод прошлого поколения HPE StoreEver MSL LTO‑9 Ultrium 45000 SAS Drive Upgrade Kit R6Q75A стоит в розницу $12,537. Кассеты стоят дешево, по $100 (за 18 Тб кассету).

Третья.
Они до сих пор не выпускаются с 100G интерфейсами. FC и SAS есть.
есть даже вот такое .. странное - MagStor 1U ePro LTO9 10G Ethernet Rack Mount LTO-9 TAA SKU: E10G-1U-HL9-2YR. $13.000 за девайс с одним приводом, без робота.
Есть и с роботом, через SAS мост -
Qualstar Q24 LTO-9 Ethernet Connected Tape Library Bundle
в составе:
Qualstar Q24 2U / 24-Slot Tape Library with 1 x IBM LTO-9 SAS Tape Drive Installed
ATTO XstreamCORE 8100T SFP+ Ethernet to SAS Intelligent Bridge (P/N: XCET-8100-TS0)
External SFF-8644 to SFF-8644 SAS Cable (2 Meter)

Всего по $15.000 за систему с одним приводом и $28.000 с двумя.
При цене привода в $12.000 – приемлемо.

Показать полностью 1
5

Новые инстансы в Azure - Mbsv4 и Mbdsv4⁠⁠

Серия Кудахтеры: захоронение данных

Для ЛЛ: выкатили Mbsv4 и Mbdsv4 в превью

Microsoft вывел в превью новые варианты виртуальных машин. Интересного в них три параметра:
Скорость сетевых дисков до 780,000 IOPS
Пропускная способность 16GBps для удаленной системы хранения
Скорость локальных дисков до 3,200,000 IOPS

Большей части населения "столько" не надо, но если надо, то вот они.
Статья с деталями: Announcing public preview of new Mbv4 Virtual Machines

12

Новые SSD диски от Micron (9650) - уже почти в рознице⁠⁠

Серия Кудахтеры: захоронение данных

Для лиги лени: новые диски просто космос

Между делом Micron анонсировал новые SSD диски, серии 9650.
Скорость последовательного чтения (Sequential read) - в 2 раза выше, 28,000 MB/s против 14,000 MB/s
Скорость последовательной записи (Sequential write) - в 1.5, 14,000 MB/s против 10,000 MB/s
Random read 5.5 MIOPS (против 3.3 MIOPS)
Random write 900 KIOPS (против 720 KIOPS)

Емкость - до 30 Тб.
Источник и прочие цифры: Micron 9650 SSD, the world's first PCIe® Gen6 SSD, reaches a new shipping milestone!
Понятно, что эти показатели получены в идеальных условиях, с глубиной очереди куда-то в небо. Но прогресс идет.

PS. Не знаю, как именно их будут замедлять, для выполнения требований.
Сейчас с тем, чтобы замедлить SSD до уровня дисков на 5400 оборотов, успешно справляется импортозамещение на базе CEPH.

30

Протоколы передачи данных «внутре». Для тех, кто забыл базу⁠⁠

Серия Кудахтеры: захоронение данных

Для лиги лени: заголовок некорректный, в остальном ничего нового за 2020-2025 не появилось.

Вроде, 2025 год заканчивается, а люди до сих пор пишут то про классовое общество адресацию в TCP\IP .
АУ! Ну вы и сони. Даже ipv6 шторм вас не разбудил.
VLSM (variable-length subnet masking ) и CIDR (Classless Inter-Domain Routing) появились в 1993 году. Вы, любители рассказать про классы, откуда разморозились, из запасов сайта новостей Минцифры и тамошних комментариев про поддержку импортозамещения? Именно там регулярно всплывают такие размороженные персонажи – последний раз были на сайте в 1998 году, и вдруг решили рассказать, что раньше жили в грехе, а теперь открыли для себя KVM и третий глаз, и теперь только классы, только хардкор.

Другие .. комментаторы записывают iSCSI в устаревшие. Что тоже удивительно.

Теперь, удивившись, перейду к теме.
Сетевые протоколы передачи данных, и вот это все.
Примечание. Беспроводные протоколы, начиная от 4G-5G, и до 6G и Zigbee, в рассмотрение не попадают. Как и протоколы “передачи слова «нейтрино» азбукой Морзе по потоку нейтрино»”.

На почти самом низу (почти) живут три больших семейства протоколов.

Первый, и самый большой, это все семейство Ethernet. Начиная с до сих пор встречающегося по домам Ethernet 100 мбит (а то и 10, для умных счетчиков), и заканчивая Ethernet 800G. К июлю 2026 обещают стандарт 1600G - 802.3dj.
Примечание для любителей импортозамещения. 100G коммутаторы только-только заявлены у Ядро, и, может быть, через пару лет будут у Eltex – когда китайские производители будут массово производить 100G чипы. Или, можете вместе Mellanox (хотя бы SN2700) импортозаместиться на Huawei CloudEngine 8800. Если денег хватит.
Чтобы было понятнее, речь идет о покупке Mellanox SN2700-CS2F 100GbE 100G Ethernet Switch 32 QSFP28 Ports. На ебей такой стоит $3300. В РФ привезут за месяц, и тысяч за 300 рублей.

Второй, все умирающий, но никак не могущий умереть, это Fibre Channel Protocol (FCP). Который повсеместно называют просто FC. Месяц назад Broadcom показал новое поколение FCP коммутаторов, Gen8, с коммутаторами Brocade G820 , на 128G. У окружения на FC (FCP) есть один большой плюс – туда не суют свои кривые руки так называемые сетевые инженеры. Особенно те, у которых до сих пор классы используются.
Есть один большой минус – в мире остался один поставщик коммутаторов (пропустим раздел про директоры), и это безобразно алчные капиталисты из Broadcom. Полтора поставщика, если считать остатки этого направления у Cisco. Коммутаторы у Broadcom дорогие, лицензии дорогие, итд. Кто знает и плачет над согласованием бюджетов, тому я, не очень искренне, сочувствую.

Третий, пожалуй, Infiniband. Встречаться – встречается, и коммутаторы уже дошли до 800G, например NVIDIA Quantum-X800 InfiniBand. Но не так часто и встречается. Многие купили 40G коммутаторов, с до сих пор списать не могут.

Замыкает список мутант без номера, Fibre Channel over Ethernet (FCoE). Существовал в основном в телеком секторе, но где-то в 2015 - 2020 Broadcom свернул это направление. Сейчас, может, где-то и доживает свое. Он был, он работал, через коммутаторы с отдельным FC gateway чипом.

Отдельно можно вспомнить такие явления, как NVIDIA NVLink (NVLink Switch) и Cray Slingshot (и HPC-Ethernet  на его основе). Тоже протоколы.Тоже коммутаторы.

Поверх  Ethernet, то есть рядом с ним, живет lossless Ethernet, он же Data center bridging, и PFC (Priority Flow Control) и ECN (Explicit Congestion Notification).
Рядом живет Ultra Ethernet.  

Выше по стеку (и это единственная причина учить стек DOD) живет IP, вместе с TCP, UDP, ICMP и так далее. В том числе ipv6, который давно надо бы учить в школе.

На следущем шаге, в первую очередь стоит вспомнить про 4 основные группы протоколов: блочные, файловые, объектные, и "мутанты прочие".

С блочными совсем недавно было все совсем просто – есть FCP, есть iSCSI. В 2007 к iSCSI почти добавился iSCSI Extensions for RDMA (iSER), но сейчас производители систем хранения данных его почти не поддерживают. Можно считать, что умер раньше, чем FC. Подробности в rfc5046 - Internet Small Computer System Interface (iSCSI) Extensions for Remote Direct Memory Access (RDMA).

Недавно к этой парочке добавился RDMA over fabric (NVMe-oF). Но, как сказать «недавно». Книга NVMe Over Fibre Channel for Dummies первого издания вышла в, кажется, 2018. В 2022 было уже третье издание.
Стандарт от 2016 года, умеет его даже Oracle -
Oracle Linux UEK5 introduced NVMe over Fabrics which allows transferring NVMe storage commands over a Infiniband or Ethernet network using RDMA Technology.

С использованием этого стандарта сейчас могут работать почти все современных системы хранения данных. И включается очень просто.
Единственное "но" - "современные системы хранения данных". Никак не HP StorageWorks Modular Smart Array (MSA) 500 G2 и его ровесники типа StorageWorks Enterprise Virtual Array (EVA).

Есть большая проблема, и эта проблема – люди. Некоторые люди принципиально не понимают, чем отличается iSCSI от NVMEof, с учетом DCB, и в попытке рассказать «да это почти то же самое» придумывают свою терминологию, вместо использования английского. Возможно, это жертвы цыганских курсов по вкатыванию в ИТ, пытаются что-то вспомнить.

С файловыми протоколами тоже все просто. Есть много лет используемый SMB. Причем, это не только «файловые шары под Windows», это еще и s2d.

Networking Hardware. Storage Spaces Direct uses SMB3, including SMB Direct and SMB Multichannel, over Ethernet to communicate between servers. We strongly recommend using 10+ GbE with remote-direct memory access (RDMA), either iWARP or RoCE.
Storage Spaces Direct overview

Есть NFS. Не понимаю, почему его так любят некоторые граждане, ввиду всего интима с стандартом 4.1
NFS очень много где «есть», особенно при использовании систем хранения от Netapp.

С объектными стандартами, или протоколами, тоже все относительно просто. Есть Amazon S3, и есть его вариации и реализации (Minio, Seaweed, etc). Рассмотрение остальных 20+ вариантов, начиная с Azure Blob Storage, выходит за пределы заметки, написанной за 30 минут. В том числе потому, что для доступа к Azure используется NFS, и не только. Если вы можете это прочитать в статье Access data from Azure Blob Storage by using multiple protocols, то вам не нужны очки. Даже от Specsavers.

Отдельно живут разнообразные мутации, проприетарные, и не очень. Из того, что сразу можно вспомнить, это vSAN и его приприетарный Reliable Data Transport (RDT). Он объектный, но, по моему особо ценному мнению, все же мутант.
Сюда же можно отнести RADOS (Reliable Autonomic Distributed Object Store) и messenger v2 protocol. Надеюсь, вы знаете, что это, и где используется.

Итого

Знание всего вышеперечисленного нужно в трех случаях

Первый случай. Вы проходите интервью, и вас спрашивают все подряд, в том числе, с чем работали, и что знаете. Тут могут и про классовую адресацию спросить. Если спросят – БЕГИТЕ ОТТУДА.

Второй случай. Вы работаете в фирме, где активно используются все вышеперечисленное, и еще немного всякого. Например, Longhorn.

Третий случай. Вам надо выбрать, на что вы будете переходить с FC (FCP) – на Arista (AMD - Xilinx) или на Mellanox (Nvidia).

В список не попали  Network block device, DRBD (потому что там протоколы означают совсем другое) и много чего еще, но про это или было сказано раньше, или, может, кто-то в комментариях напишет.

Заключение

После всего сказанного, сами протоколы не так важны, как решение, или набор решений, которые будут выбраны для работы бизнес-задач. Нужно хранить много мелких файлов - будет что-то на тему s3. Сами s3 ноды могут (и будут) в контейнерах или в VM, а под ними уже будет NFS, SMB, и что там еще нужно.
Нужно хранить не так много файлов, например нужна одна, но большая база данных - будет выбрано то, что дешевле внедрить и эксплуатировать, с заданной надежностью. И так далее.
PS. Longhorn был «не очень», таким и остался. Достаточно посмотреть результаты  тестов 2 летней давности на serverfault, или на v2-data-engine. Я даже сначала не понял, почему тестирование для 1.7 и 1.10.1 настолько совпадает.

Литература для отставших в развитии на уровне 1993 года

6G: The Next Horizon
ЕМС. От хранения данных к управлению информацией (2009)
EMC Information Storage and Management (2009)

Показать полностью
57

Две истории про бекапы⁠⁠

Серия Кудахтеры: захоронение данных

На днях случились две занимательные истории про бекапы.

История первая.

Послушайте!
Ведь, если ЦОДы зажигают —
значит — это кому-нибудь нужно?

В Южной Корее сгорел ЦОД - G-Drive Fire Destroys 125,000 Officials' Data. Бекапов не было.
Все бы ничего, но это было официальное корейское государственное облако.
Согласно официальной части «просто загорелись литиевые батареи при переносе».
Неофициально злые языки говорят, что облако давно взломали или северные корейцы, или китайцы, и слили оттуда все, что было интересного, поэтому

Все было ясно. Дом был обречен. Он не мог не сгореть. И, действительно, в двенадцать часов ночи он запылал, подожженный сразу с шести концов.

Объемы данных заявлены как 858 терабайт. Бекапы, а что бекапы, ну не смогли:

The actual number of users is about 17% of all central government officials. According to the Ministry of the Interior and Safety, as of last August, 125,000 public officials from 74 ministries are using it. The stored data amounts to 858TB (terabytes), equivalent to 449.5 billion A4 sheets.

Вся эта история, конечно, вранье.

Система хранения данных 5 летней давности (из 2020 года), даже среднего сегмента, то есть обычная, серийная, продаваемая в розницу – это 36 SSD дисков формата PALM, размещаемые в систему хранения высотой 2 юнита, включенных через NVME.

Например, Huawei dorado 5000 v6 с дисками Huawei 15.36TB SSD NVMe Palm Disk Unit(7")

Или, система из того же ценового диапазона, 8 летней давности (из 2017 года) - HPE Nimble Storage All Flash Array AF60 или AF80, с заявленной емкостью системы хранения от 1.8 до 3.7 петабайт, с SSD дисками комплектом в 24 штуки - HPE Nimble Storage AF40/60/80 All Flash Array 184TB (24x7.68TB) FIO Flash Bundle.
Диски 2.5 и по 7.68TB Тб, так что потребуется больше дисков, больше места, и больше денег. Старая система, ничего не поделать.

В 2025 году петабайт, да еще с учетом сжатия и дедупликации, это даже не половина стойки.
Все современные системы хранения данных, кроме уж совсем SOHO (small office - home office):
и продаваемые как системы хранения данных,
и продаваемые как программно-определяемые системы хранения данных,
и продаваемые как гиперконвергентые среды (Storage space direct, vSAN) для гиперскейлеров и частных облаков,

Все они:
Во первых имеют в составе функционал репликации на «другой удаленный ЦОД» - то есть функционал метрокластера, синхронный или асинхронный. Это не бекап, это только репликация, но она спасет от пожара, потопа, и так далее (лицензируется отдельно).
Во вторых, так или иначе, интегрируются с системами резервного копирования, в том числе с офлайн хранением – с классическими ленточными библиотеками (LTO) или их эмуляцией, Virtual Tape Library (тот же QUADstor).

Что-то там еще пытаются рассказать, что такие объемы записать на кассеты нельзя .. ну что ж. Посчитаем.
Кассета Quantum LTO-9 – это 18 терабайт не сжатых данных.
10 кассет – 180 терабайт. 100 кассет – 1800 терабайт, 2.5 раза выполнить полный бекап этих 850 Тб
Расширяемая ленточная библиотека HPE Storage MSL3040 Tape Library идет с комплектом на 40 слотов, расширяется до 640 слотов.
Сам привод для дисков (стример), например HPE Storage LTO Ultrium Tape Drives, точнее HPE StoreEver MSL LTO-9 Ultrium 45000 Fibre Channel Drive Upgrade Kit (R6Q74A) какой-то странный, я что-то не пойму, почему везде пишут, что он не FC, а SAS 12G.
Но, какая разница. Для библиотеки (HPE StoreEver MSL 3040 Tape Library) заявлена скорость:
Maximum Data Transfer (Native) 22.5 TB/hr (21 LTO-9 drives)
Maximum Data Transfer (Native) 51.4 TB/hr (48 LTO-9 drives)
Источник: QuickSpecs, официальный сайт HPE.

То есть для «обычных» 4 приводов скорость составит около 4 терабайт \ час, 98-100 Тб\сутки. 850 заявленных терабайт можно было записать за 8-10 дней на 4 дисках, или, для записи «за сутки» потребовалось бы 35 приводов из максимум 48.

Деление полученного бекапа на несколько потоков для записи, Aux copy with Maximum streams для Commvault (не путать с Multiplexing, он не для этого) – функционал не очевидный, и возможно что-то надо покрутить – подпилить, но решаемый.

Так что, было бы желание, а коммерческие решения есть на рынке очень давно. Но, желания не было.

История вторая

Летом 2025 года Газпромбанк торжественно отчитался, цитата:

Москва, 18 июня 2025 года – Газпромбанк успешно завершил один из самых масштабных ИТ-проектов последних лет — переход на полностью импортозамещённую автоматизированную банковскую систему (АБС) ЦФТ, в основе которой лежит программно-аппаратный комплекс Скала^р (продукт Группы Rubytech) для построения доверенной ИТ-инфраструктуры финансового сектора на базе технологии Postgres Pro Enterprise.

Официальный сайт Газпромбанка, статья Газпромбанк завершил переход на импортозамещённую автоматизированную банковскую систему

Перешел и перешел, молодцы. Но попалась мне на глаза реклама ООО «Постгрес Профессиональный», под видом статьи Как Газпромбанк перешел на российскую СУБД. Поскольку это реклама под видом «колонки» (то, что реклама написано внизу, серыми буквами), то дата не проставлена.

Понравилась мне оттуда цитата:

Приведу пример с резервным копированием и восстановлением данных. Высокая скорость этих процессов была для нас одним из ключевых требований, потому что при наступлении фатальной ошибки критически важно быстро восстановиться из резервной копии. Postgres Pro Enterprise делает это за два часа, иностранные решения, которые мы тестировали, — за 14.

Возникает вопрос, как так это у них получается.

Если (по неизвестным причинам) использовать не средства резервного копирования (которые все равно используют RMAN), а сам RMAN, то он, если я правильно прочитал, позволяет выполнять параллельное восстановление, цитата:

As long as there are many backup pieces into a backup set, RMAN will use an appropriate number of channels - if allocated - to restore the database.
Ex:
7 backup pieces and 6 channels allocated - RMAN will use the whole 6 channels in parallel
6 backup pieces and 6 channels allocated - RMAN will use the whole 6 channels in parallel
5 backup pieces and 6 channels allocated - RMAN will use only 5 channels - one will be IDLE
rman restore datafile : how to force parallelism ?

Если говорить про Microsoft SQL, то там есть SMB multichannel, и давным давно есть Accelerated database recovery, ADR и Multi-Threaded Version Cleanup (MTVC)
Accelerated Database Recovery enhancements in SQL Server 2022

У Postgre тоже есть параллельное исполнение:

By using multiple concurrent jobs, you can reduce the time it takes to restore a large database on a multi-vCore target server. The number of jobs can be equal to or less than the number of vCPUs that are allocated for the target server.
Best practices for pg_dump and pg_restore for Azure Database for PostgreSQL

Но не в 7 же раз разница.

Заключение

Не знаю, как после первой истории не вспомнить загадку про трех черепах:
Три черепахи ползут по дороге. Одна черепаха говорит: “Впереди меня две черепахи”. Другая черепаха говорит: “Позади меня две черепахи”. Третья черепаха говорит: “Впереди меня две черепахи и позади меня две черепахи”. Как такое может быть?

Вторая история просто интересная.

PS. И про первую историю, пишут что: Gov't official in charge of state computer network dies after fall at Sejong complex.

Как говорил один мой знакомый, покойник: я слишком много знал.

Две истории про бекапы

PS. Тега commvault нет

Показать полностью 1
24

Тестирование локальных дисков и систем хранения данных: подводные камни. Часть 1 - общая⁠⁠

Серия Кудахтеры: захоронение данных

Для лиги лени: ничего нового, просто запускаю DiskSPD.

Про тестирование и дисков, и систем хранении написаны сотни статей, и ничего нового вы тут не увидите, проходите мимо.
Тестирование локальных дисков и систем хранения данных: подводные камни. Часть 1 - общая
Тестирование локальных дисков и систем хранения данных: подводные камни. Часть 2 - виртуализация
Тестирование локальных дисков и систем хранения данных: подводные камни. Часть 3 – цифры и итоги

Зачем я прогнал эти тесты?
Конечно, во славу сатаны и для слез Греты. Одна из систем на текущей работе оперирует с несколькими базами данных – там и MS SQL, и Postgre, и MySQL, и, по моему, где-то был SQL Lite. Объемы небольшие – 25, 30 терабайт на базу. Не было задач для Tibero и Oracle RAC. Firebird на этой работе нет. На Oracle нет денег, на MS SQL еле выбили бюджет.
Система считает кое-какую аналитику, в связи с этим вычитывает из базы, которая еще не data lake или data warehouse, но что-то такое между этим. DWH тоже есть.
Проблема, которую соседи из DBA решают – что так медленно считается. Сейчас отчет генерируется 5-6  часов, это не устраивает бизнес, это не устраивает заказчиков, внутренних и внешних.
Точнее, бизнес это не устраивает настолько, что он был готов выделить большой бюджет с июля (финансовый год начинается 1 июля, если кто-то не в курсе), маленький "прямо сейчас", и выделить (списать) время на тесты.

С чем приходится иметь дело.
Это легаси поверх легаси. Сделано когда-то давно, в 2016-2017 годах, в режиме «надо вчера, берем сначал укропу, потом кошачью жопу». Поэтому, "надо было быстро", был взят MS Hyper-V, а не Broadcom ESXi. И не Nutanix Acropolis, который тоже KVM. Можно было взять Huawei FusionSphere, но не взяли.
Тут кто-то спросит, почему не KVM, не Xen. Хорошо, если не спросит про bhyve. Очевидно, спрашивающий не имеет ни малейшего представления о том, как тупил, и как отставал в развитии ванильный KVM в те годы, особенно под нагрузкой. Да и сейчас не лучше, взять что планировщик, что сбор событий для мониторинга.

Это легаси, и люди, которые это делали, уже уволились. Поэтому всплывает и совершенно очевидное «просто забыли», и не очень очевидное.

Железо и инструменты

На первом месте по оценке дисковой подсистемы, конечно, идут Microsoft DiskSPD и ATTO Disk Benchmark for Windows.
Оба очень неудобны, потому что:

Microsoft DiskSPD хорошо настраивается, воспроизводится, можно немного покодить и сделать хоть пакетное задание, хоть чего, но результаты выгружаются в никак не структурированный текстовый файл. Можно (GPT мне сделал за 5 минут, я бы провозился час) парсер эти логов в csv \ excel, но с xml иметь дело было бы проще.

ATTO Disk Benchmark поддерживает пакетные задания, дает воспроизводимые и вполне совпадающие с DiskSPD результаты, но максимальный размер тестируемого файла – 32 Гб.
На серверах по 1.5 Тб памяти, столько можно закешировать. 1.5 по современным меркам мало, сервера старые. На новых будут брать по 3 Тб, или что-то около того, не помню спецификацию. Я просил 6 Тб, почему-то решили скроить и на этом тоже, или не нашли в продаже модули по 512 Гб не помню. На новых материнских платах по 24 слота памяти. Если ставить модули 256 Гб, те же HPE P07654-B21, можно поставить 6144 Гб.
Очень жаль, что по размерности в сервера не лезут платы расширения типа BC61MRTC Huawei 12 slot memory riser board for huawei fusion server rh5885h v3. PN 03022SPP. Были у коллег такие, очень полезное решение.

Разумеется, есть FIO, и под линуксы я его люблю, не умею, но практикую.

Дальше возникают Nutanix XRay и VDbench \ HCIBench. Первое – оболочка для Fio, второе – имитатор рабочей нагрузки, а мне надо другое, такое как SQLIOSim и, особенно, HammerDB

Проблема со статьями и описаниями.

Проблема в том, что все вокруг забито CEO калом. Может попасться, цитата с одной помойки, причем из копроблога:

В тестирование лучше не лезть, если:

вы хотите с помощью синтетики имитировать поведение сложного приложения (например, базы данных);

Бред написан, хотя откуда там алмазы. Как раз имитация «сложного поведения как получится», это одна из задач нагрузочного тестирования. Вместе с выявлением узких мест по стеку под нагрузкой, как и умение найти, и наблюдать эти места, с нужной частотой и нужной реакцией - To strive, to seek, to find, как говорили древние.

Такого бреда в копроблогах полно. Впрочем, кому-то и GUI над DiskSPD в виде Crystalmark сойдет, а кто-то тестирует скорость путем копирования файла. Это (тестирование копированием) еще не самый плохой вариант, если вы хотите прикинуть скорость копировать.

Прочие проблемные места: Железо на уровне BIOS.
В BIOS современных серверов есть два десятка настроек, отвечающих за скорости, из которых важнейшими для нас являются кино и цирк* «зеленый» режим работы, все эти performance mode, авторазгон, NUMA и C2-C6 state. И, иногда, MWAIT, если вы работаете с виртуализацией. Не стоит забывать и о режиме работы PCIe, особенно если вы используете нормальные современные SSD, включенные через NVME. Как же я скучаю по оптанам, как они работали.
Особенно, если у вас PCIe линий мало, или стоят райзеры во фронт панелях, это придется учитывать.

Прочие проблемные места и выбор нужного железа: power-loss protection.
Просто процитирую: some enterprise drives that should work, is not recognized as devices with power-loss protection, and that means Storage Spaces will only send synchronous writes to the devices, and not use the internal buffer in the device, and that will degrade performance a lot on most drives.

Выбор нужного железа: прошивка.

У Micron выложена «последняя нужная версия прошивки для вашего SSD NVME», и две утилиты – для GUI (убогая) и CLI (топ за свои деньги).

У Kioxa ничего такого не нашел. Утилита есть, узнать про существование случайно взятой KIOXIA CD8P-R Series (2.5-inch) можно, спецификация есть, на странице KIOXIA Ecosystem Member: Vmware (не MS) есть какие-то списки, но чтобы найти, что для Model:KPM6XVUG1T60 есть прошивка 0102, и для KPM6XRUG960G серии PM6 есть прошивка 0102, надо очень постараться.

Список совместимости на Windows Server Catalog сделан плохо, но он хотя бы есть, и в нем:
KIOXIA Corporation, DapuStor Corporation, Huawei Technologies Co., Ltd. (внезапно), Infrasky Solutions – кто это? По маркировке это Intel), primeLine Solutions GmbH, Intel Corporation (с оптанами), Samsung Electronics CO., LTD. (с дисками HPE MZXL515THALA-00H3 MPK76H5Q и похожими), Sandisk Technologies, Inc. , SK Hynix, Western Digital Technologies, Inc.

Размер кластера файловой системы, и выбор между ReFS и NTFS.
ReFS прекрасная система, только работает не то чтобы уж очень экстравагантно, но весьма специфично, тем более для случая с SQL. И есть нюанс, про который ниже.

Режим работы parity для Storage space и storage space direct, плюс кеширование и работа с числом колонок (NumberOfColumns) делают очень, очень больно. Особенно если у вас Allocation Unit Size (FS cluster size) – 4 кб, по умолчанию. А все почему? Потому что я не читал статью Storage Spaces and Slow Parity Performance.

Отступление.

Как же у автора статьи Storage Spaces and Slow Parity Performance все просто. Берем три диска, делаем -Interleave 32KB, делаем 3 колонки, делаем 64Кб NTFS, и готово. Stripe size 96 Кб, data size 64 Кб, 64 Кб записи кладется на два блока данных как 1:1, охапка дров и плов готов.
Вот бы мне перед тестами прочитать про AutoWriteCacheSize и Interleave для New-VirtualDisk.
попробую посчитать:

$ntfs_aus = ($number_of_columns - 1) * $interleave
Но ntfs_aus можно выбрать только из ряда 4,8,16,32,64 – и при этом, поскольку дальше мы идем в виртуализацию с ее vhdx с выбором его выбором LogicalSectorSizeBytes и PhysicalSectorSizeBytes между 512 и 4096, в любом сочетании, и учитывая как с этим Даталайн похлебал двумя руками с Read-Modify-Write.

Для 4 колонок – то есть, 4 дисков, и блока 4к, это будет решением уравнения
4к = (4-1) *х – но 4096 на 3 не очень делится.
Для 6 колонок, соответственно:
4к = (6-1) *х, но 4096 и на 5 не очень делится.
Остается что-то типа
64к = (5-1) *х, и тогда получаем 64/4 – interleave по 16к, NTFS 64k.
Но, оперируя на гипервизоре с NTFS 64k с дисками LogicalSectorSizeBytes \ PhysicalSectorSizeBytes 4096, получим блоки по 4к на диски с разметкой 64к, и привет Read-Modify-Write. Это что, получается надо ставить 5 колонок, и interleave в 1к ? Выглядит дико, как будет работать, если будет работать – не понятно. Про бекапы в таком случае лучше не забывать.

В сегодня лет до меня в очередной раз дошел термин full stripe, что еще раз говорит не только о пользе чтения,  но и пользе записи написания текста.

Почему эти блоки важны?

Потому что MS SQL пишет страницы данных – и это 64 Кб. Windows пишет блоками по, кажется, 4 кб. Linux – 8 кб, Postgre вроде тоже 8, но MySQL - 16 KB.
ESXi – 32 Кб (если вы зачем-то отдали диски через iSCSI или NFS).
Внизу все равно физические диски – или очень старые с их 512 \ 512e, или новые, 4k. Причем еще надо посмотреть, что там для SAS SSD и SAS NVME, какая там разметка (если этот термин вообще применим к SSD).

Все грустно у пакетишки.

И, наконец, Mirror-accelerated parity, MAP

Чудовищно недооцененный режим работы для storage space и S2D , storage space direct

Идея простая, пишем данные на зеркало, потом в фоновом режиме переносим. Проблема в том, что он плохо документирован, настраивается только из poweshell, дефолтные настройки неудобные и кривые, и в целом командная строка и пресет к нему ориентирован на то, чтобы иметь два дисковых пула, HDD и SSD. Этакий tiering, хотя это он и есть. Сейчас кругом SAS SSD и NVME SSD, но никаких изменений не внесено. Есть и есть, но не развивается.

Но при этом в одной статье пишут про StorageBusCache для MAP, а в другой -

Storage Bus Layer (SBL) cache isn't supported in single server configuration. All flat single storage type configurations (for example all-NVMe or all-SSD) is the only supported storage type for single server.

Вот с этим грузом знаний мы постараемся долететь до второй части.

Ссылки

Use DISKSPD to test workload storage performance

Github Microsoft diskspd

GitHub VMFleet

Next Generation Performance Tools: VMFleet 2.0

VMFleet 2.0 - Quick Start Guide

ATTO Disk Benchmark Windows

ETCD Performance and Optimization. Оригинал от Matteo Olivi and Mike Spreitzer утерян где-то в IBM, но остался в виде статьи Storage speed suitable for etcd? Let's ask fio в инернетах.
Оригинал был тут https://www.ibm.com/blogs/bluemix/2019/04/using-fio-to-tell-whether-your-storage-is-fast-enough-for-etcd/. Есть перевод от Фланта - Как с fio проверить диски на достаточную производительность для etcd

index : fio

fio - Flexible I/O tester rev. 3.38

Performance benchmarking with Fio on Nutanix

Тестирование производительности гиперконвергентных систем и SDS своими руками.
Облако на Microsoft Hyper-V, часть 3: хранилище Storage Spaces в части Read-Modify-Write
Ссылок нет, потому что не хватало еще ссылаться на оптимизационные помойки

Enterprise Storage Benchmarking Guide и его перевод - Руководство по синтетическому бенчмаркингу корпоративных систем хранения данных и лучшие практики. Часть 1. Общая теория, методы и подходы

Тестирование СХД

Use the SQLIOSim utility to simulate SQL Server activity on a disk subsystem

Use the SQLIOSim utility to simulate SQL Server activity on a disk subsystem on Linux

SQL Server Distributed Replay overview - Distributed Replay deprecation in SQL Server 2022

SqlQueryStress

SQL Hammer (everything is a nail) . Примечание от рецензента: из РФ ссылка не работает,  поэтому начинать лучше тут, github  - shutdownhook.

HammerDB

Database files and filegroups

Storage Spaces and Slow Parity Performance

New-VirtualDisk

Mirror-accelerated parity

Storage Spaces Direct Mirroring vs MRV (Parity) performance

Don't do it: consumer-grade solid-state drives (SSD) in Storage Spaces Direct

Storage Spaces series:
Part 1 Storage Spaces – Current / Old Setup
Part 2 Storage Spaces parity in Server 2025
Part 3 Storage Spaces 2025 Mirror-accelerated Parity and Storage Bus Cache

Kioxia SSD Utility Management Software

Choose drives for Azure Stack HCI and Windows Server clusters

Windows Server Catalog (HCL)

Примечание от рецензента: не раскрыта тема LRC (local reconstruction codes) и Parallel Failure Rebuild
LRC Erasure Coding in Windows Storage Spaces (2013 Storage Developer Conference.) Наконец раскрывают тему Рида, Соломона и Галуа, на странице 21.  

Maximally Recoverable Local Reconstruction Codes или MS research.

* важнейшими для нас являются кино и цирк

Перефраз цитаты Луначарского:
Владимир Ильич несколько раз мне указывал на то, что из всех областей искусств наибольшее государственное значение в настоящий момент может и должно иметь кино
Показать полностью

Производительность систем хранения данных: успехи импортозамещения⁠⁠

Серия Кудахтеры: захоронение данных

Для лиги лени. «российский топ» сравним, 1.6 против 2.0 очков,  с китайской СХД «нижнего ценового сегмента» из 2020 года.

Прислали тут новости по импортозамещению, посмотри, пишут, как мощны очередные лапищи.
Посмотрел.

Март 2016. HPE 3PAR StoreServ 8450 Storage System, система хранения данных среднего ценового диапазона, выдала 545164 IOPS в тесте Performance (SPC-1 IOPS).

Декабрь 2017. Huawei OceanStor Dorado5000 V3, система хранения данных среднего ценового диапазона, all-flash, выдала 800465 IOPS в тесте Performance (SPC-1 IOPS).

Декабрь 2018. Huawei OceanStor 5600 V5, гибридная система хранения данных среднего ценового диапазона, выдала 1100252 IOPS в тесте Performance (SPC-1 IOPS).

Март 2020. Huawei OceanStor 5310 V5, гибридная система хранения данных, самого низа среднего ценового диапазона, выдала 1600658 IOPS в тесте Performance (SPC-1 IOPS).

Август 2020. Huawei OceanStor 5510 V5, гибридная система хранения данных, среднего ценового диапазона, выдала 3800781 IOPS в тесте Performance (SPC-1 IOPS). Пруфы

Май 2025. Компания YADRO объявила о выходе первой на российском рынке All-Flash системы хранения данных TATLIN.AFA с end-to-end NVMe-архитектурой .. TATLIN.AFA — система хранения данных старшего уровня с рекордной производительностью, высокой надёжностью и отказоустойчивостью для решения самых амбициозных и требовательных задач настоящего и будущего. Отличается высокой производительностью: до 2 млн операций ввода-вывода в секунду (IOPS). Источник.

То есть, производительность старшей аналоговнетной системы находится на уровне «чуть выше дна в 2020», или, если открыть Micron 7500 SSD key specifications, то на уровне производительности 2 (двух) модулей Micron 7500 PCIe Gen4 1x4, NVMe v2.0b , для которых заявлен миллион IOPS на чтение блоком 4к.

Зато проплатили блог на самой SEO – помойке всего рунета.

Какие-то еще комментарии? Избыточны. Кроме подтверждения корреляции: если у фирмы в 2025 году есть блог на самой SEO – помойке рунета, то ее продукция полный шлак.

Показать полностью
3

Производительность систем хранения данных: зато свое-4⁠⁠

Серия Кудахтеры: захоронение данных

Для лиги лени: российские облака на таком же, как у всех,  Intel \ Micron \ KIOXIA inside теряют 90% производительности железа на «своих и опенсорс решениях».

На одном CEO-ресурсе вышла очередная реклама «зато свое». Интересны только цифры, цитата:

Локальные диски:
При SLA bs=4k, iodepth=16, randaccess, скорость чтения — 75 000 IOPS, скорость записи — 50 000 IOPS.
Ceph:
При идентичных условиях SLA Ceph обеспечивает скорость чтения на уровне 16 000 IOPS и скорость записи в 8000 IOPS.
High-IOPS:
При идентичных условиях SLA скорость чтения — 45 000 IOPS, скорость записи — 30 000 IOPS.

КАК? Как у них это получилось?
Вышедшие полтора года назад (Oct 17, 2023 диски Micron 7500 дают:
- Sequential 128KB READ: Up to 7000 MB/s ; - Sequential 128KB WRITE: Up to 5900 MB/s
- Random 4KB READ: Up to 1,100,000 IOPS; - Random 4KB WRITE: Up to 410,000 IOPS

Samsung:
Samsung 980 Pro SSD Random Write 4K QD32 Up to 1,000,000 IOPS
Samsung 990 PRO - while 4TB even higher random read speed of up to 1,600K IOPS.

Broadcom MegaRAID 9670W-16i RAID Card
4KB Random Reads (IOPs) - 7,006,027 ; 4KB Random Writes (IOPs) - 2,167,101
NVME Raid – We Need To Go Deeper, или что там на глубине. GPU over NVME, с водяным охлаждением
Xinnor xiRAID 4.1 уже дает 65 миллионов IOPS на чтение, и поддерживает HA.

Еще в 2017 году для Microsoft Ignite – Micron собрал кластер на почти миллион IOPS - Microsoft storage spaces direct is an IO performance beast.

Что Microsoft S2D, что Broadcom vSAN, что Nutanix – все они, на самом обычном железе, уже несколько лет выдают 5-10 миллионов IOPS.
СХД Huawei на том же самом железе от Intel выдает от 5 до 20 миллионов IOPS, в зависимости от модели.

С чем бы это еще сравнить? Azure managed disk types:
Azure Premium SSD v2 - 80,000 IOPS
Azure Ultra Disk  - 400,000 IOPS
И это с репликацией в соседний ЦОД, а не «без репликации».

Концовка.

Я не понимаю, как в российских облаках умудряются терять скорость локальных дисков с пары миллионов до пары десятков тысяч IOPS.На точно таком же железе, с тем же самым Intel Inside. Это же не рокет сайнс и не AI-accelerated cloud на чипах Ascend.
Точно так же не понимаю, как можно строить такие конструкции, где шансы получить кашу вместо данных значимо растут.
Может и понимаю. Осенью 2024 году баг «viostor Reset to device» из апреля 2022 – в российских облаках у коллег воспроизводился на отлично. Российская техподдержка только мычала «попробуйте включить и выключить».
И, какие они российские. Китайские или корейские сервера, американские Cisco и Arista в сети, и американская VMware Cloud Foundation – для тех, кому надо чтобы работало. Или то, что описано сверху – для всех остальных.
Колокол уже прозвонил, Broadcom уже объявил конец эпохи - Announcing the VMware Cloud Foundation 9.0 Beta Program. Еще год-два и российским облакам придется слезать с VCF 8, а на VCF 9 уже будет совсем другая цена, и лицензии.
Reminder: vSphere 7 to reach End of Service on Oct 2, 2025
VMware ESXi 8.0 will reach the end of general support on October 11, 2027

Показать полностью
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества